

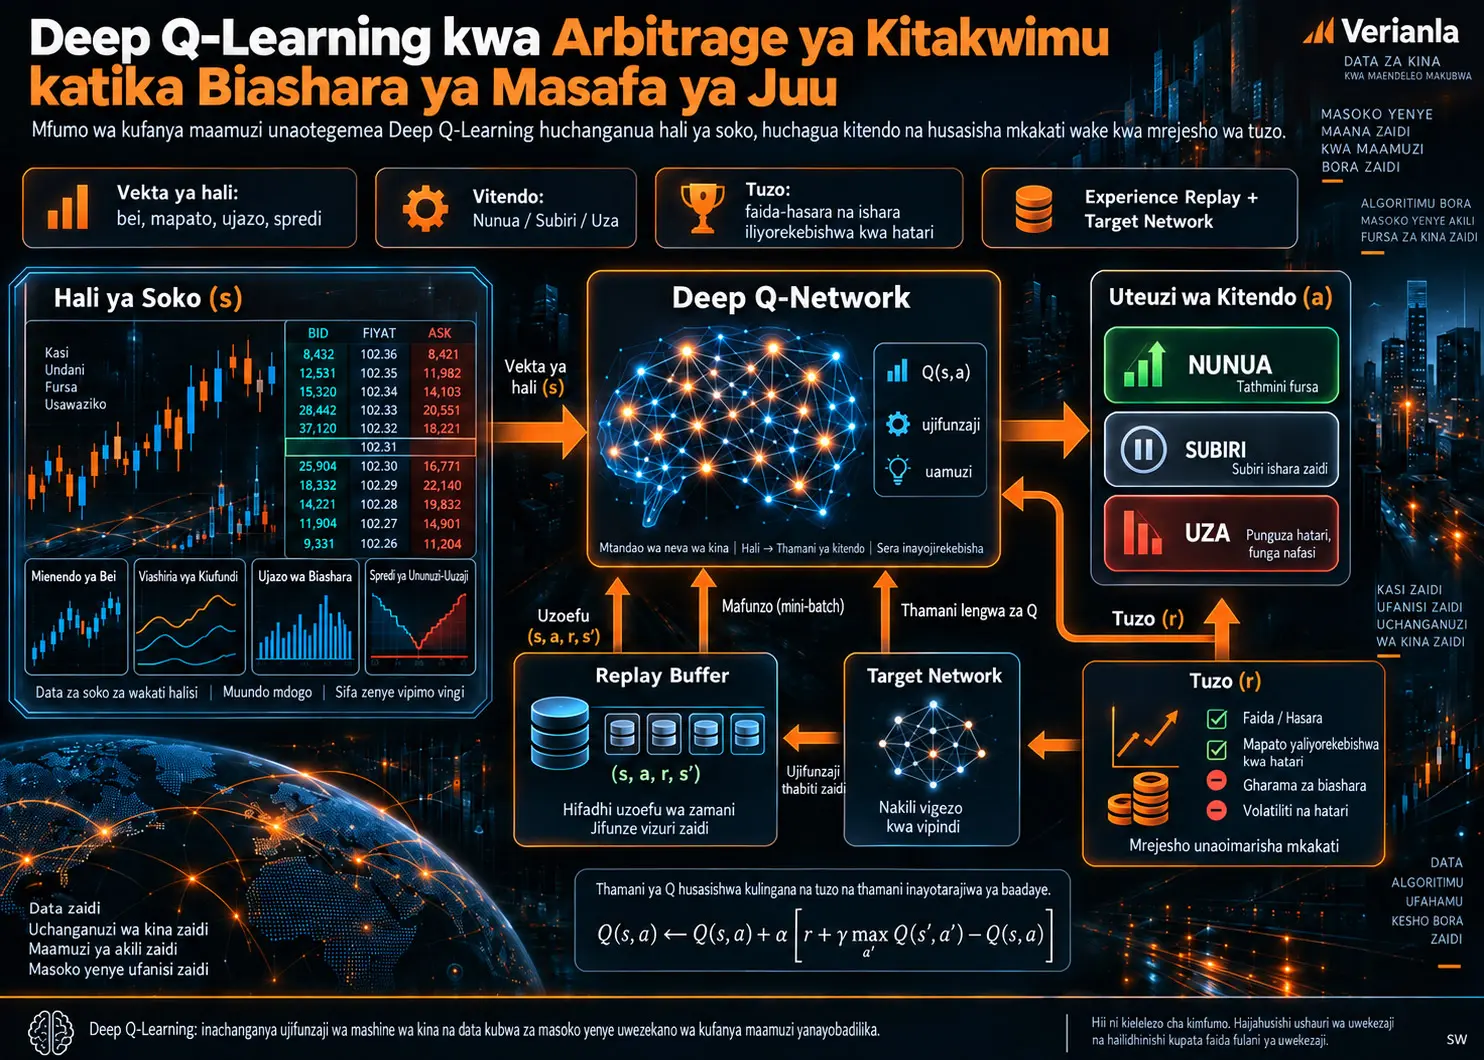
Deep Q-Learning ni mkabala wa model-free wa kujifunza kufanya maamuzi ambapo wakala wa ujifunzaji kwa uimarishaji hukadiria kwa mtandao wa neva wa kina thamani za muda mrefu zinazotarajiwa za vitendo tofauti katika hali fulani ya soko. Utafiti unaochunguzwa unaeleza jinsi mkabala huu unavyoweza kutumiwa kwa arbitrage ya kitakwimu katika biashara ya masafa ya juu (High-Frequency Trading, HFT) kupitia sasisho la Q-Learning, Q-function inayotegemea mtandao wa neva, mtandao lengwa, experience replay na muundo wa hali-kitendo-tuzo. Chanzo kinadai kwamba Deep Q-Learning inaweza kujirekebisha kulingana na hali za soko zinazobadilika; hata hivyo, sehemu kuu ya PDF haitoi data za kina za backtest au matokeo ya kiasi ya utendaji yanayoweza kuthibitisha dai hilo.
Katika mfumo wa HFT unaopendekezwa, hali ya soko inaweza kujumuisha vigezo kama mienendo ya hivi karibuni ya bei, mapato, viashiria vya kiufundi, kiasi cha biashara na bid-ask spread. Wakala huchagua kati ya vitendo kama kununua, kushikilia nafasi au kuuza kulingana na hali hiyo. Faida/hasara iliyopatikana au utendaji uliorekebishwa kwa hatari hubadilishwa kuwa ishara ya tuzo; kisha Q-network hujifunza kutokana na uzoefu uliotokea na kusasisha maamuzi yake ya baadaye.
Jambo lenye kufundisha zaidi katika utafiti ni kwamba linachukulia tatizo la HFT si kama utabiri wa bei wa mara moja, bali kama tatizo la kufanya maamuzi mfululizo. Hata hivyo, kufaa kwa mbinu kimawazo hakuthibitishi peke yake kwamba inaleta ubora wa kiuchumi katika soko halisi. Kutokupimwa kwa kiasi kwa njia ya kiempiria katika chanzo kwa mambo muhimu kwa HFT kama latency, mienendo ya kitabu cha oda, ada za miamala, slippage, market impact, gharama ya ukokotoaji wa wakati halisi na mabadiliko ya regime ni kizuizi muhimu.
Kwa nini biashara ya masafa ya juu ni tatizo la kufanya maamuzi mfululizo?
Mifumo ya biashara ya masafa ya juu haitoi tu jibu kwa swali “bei inayofuata itapanda au kushuka?” Wakala wa biashara huchunguza hali ya sasa ya soko, huchagua kitendo, huona mpito wa soko kwenda hali inayofuata na matokeo ya kifedha ya muamala, kisha hufanya uamuzi mpya. Kwa hiyo mchakato wa biashara ni mlolongo wa maamuzi yanayohusiana kwa muda.
Muundo huu unaendana na ufafanuzi wa msingi wa tatizo katika ujifunzaji kwa uimarishaji. Wakala huchunguza hali \(s\) kutoka kwenye mazingira, hutekeleza kitendo \(a\), hupokea tuzo \(r\) na kuhamia hali mpya \(s'\). Lengo la kujifunza ni kuunda sera inayozingatia si tu mapato ya muamala wa sasa bali pia tuzo zinazoweza kutokea baadaye.
Deep Q-Learning ni nini?
Deep Q-Learning ni mbinu ya ujifunzaji kwa uimarishaji inayokadiria kwa mtandao wa neva wa kina kitendakazi cha thamani ya hali-kitendo cha Q-Learning ya kawaida badala ya kukihifadhi katika jedwali kubwa; hivyo thamani zinazotarajiwa za vitendo tofauti zinaweza kukadiriwa katika nafasi kubwa za hali zinazoundwa na ingizo za vipimo vingi kama bei, mapato, kiasi na microstructure ya soko.
Katika tabular Q-Learning ya kawaida, thamani tofauti inaweza kuhifadhiwa kwa kila jozi ya hali-kitendo. Lakini hali katika soko la fedha inapoundwa na uchunguzi mwingi wa bei, mapato, wastani unaosogea, viashiria vya volatility, kiasi na vigezo kama bid-ask spread, idadi ya hali zinazowezekana huwa kubwa sana. Deep Q-Learning hushughulikia tatizo hili la ukubwa kwa ukadiriaji wa funksi unaotegemea mtandao wa neva.
Sasisho la Q-Learning
Chanzo kinatoa sasisho la msingi la Q-Learning kwa namna ifuatayo:
\[ Q(s,a) \leftarrow Q(s,a) + \alpha \left[ r+\gamma\max_{a'}Q(s',a')-Q(s,a) \right] \]
Katika mlinganyo huu, \(Q(s,a)\), katika hali \(s\), inawakilisha thamani ya jumla inayotarajiwa ya kitendo \(a\). \(r\) ni tuzo ya papo hapo inayozingatiwa baada ya kitendo. \(s'\) ni hali mpya inayotokea baada ya muamala. \(\max_{a'}Q(s',a')\) inaonyesha thamani ya juu zaidi ya baadaye iliyokadiriwa kati ya vitendo vinavyopatikana katika hali mpya.
\(\alpha\) ni kiwango cha ujifunzaji na huamua ni kwa kiasi gani uchunguzi mpya utabadilisha thamani ya sasa ya Q. \(\gamma\) ni kipengele cha discount; kadiri thamani inavyokaribia 1, uzito wa tuzo za baadaye huongezeka, na kadiri inavyokaribia 0, tuzo ya muda wa karibu huwa na uzito mkubwa zaidi.
Tofauti iliyo ndani ya mabano ya mraba katika mlinganyo ni kosa kati ya makadirio ya sasa ya Q na lengo linaloundwa na tuzo iliyozingatiwa pamoja na makadirio ya baadaye. Mchakato wa kujifunza hutumia kosa hili kurekebisha makadirio ya thamani mara kwa mara.
Mtandao wa neva hukadiriaje thamani ya Q?
Katika Deep Q-Learning, thamani za Q hazihifadhiwi katika jedwali lenye seli tofauti. Chanzo kinatoa mkabala wa jumla ufuatao:
\[ Q(s,a;\theta)=f(s;\theta) \]
\(\theta\) inawakilisha vigezo vinavyojifunzwa vya mtandao wa neva; \(s\) hali ya ingizo inayowakilisha soko; na \(f\) ugeuzaji wa kitendakazi unaotekelezwa na mtandao wa neva. Tokeo la mtandao ni vekta ya thamani za Q zilizokadiriwa kwa vitendo vinavyopatikana.
Kwa mfano, ikiwa nafasi ya vitendo imefafanuliwa kama kununua, kusubiri na kuuza, mtandao unaweza kutoa makadirio matatu tofauti ya thamani kwa vitendo hivyo vitatu katika hali ileile ya soko. Sera ya maamuzi hutumia makadirio haya kuchagua kitendo.
Kwa nini mtandao lengwa hutumiwa?
Katika Deep Q-Learning, ikiwa mtandao unaojifunza hubadilisha kwa wakati mmoja na kwa kuendelea makadirio ya sasa pamoja na lengo lake la kujifunza, mafunzo yanaweza kutokuwa thabiti. Chanzo kinaeleza mkabala wa kutumia target network tofauti inayosasishwa kwa vipindi ili kupunguza tatizo hili.
Kitendakazi cha hasara kimetolewa katika chanzo kama ifuatavyo:
\[ L(\theta)= E\left[ \left( r+\gamma\max_{a'}Q(s',a';\theta^-) -Q(s,a;\theta) \right)^2 \right] \]
Hapa \(\theta\) ni vigezo vya Q-network ya sasa na \(\theta^-\) ni vigezo vya mtandao lengwa. \(Q(s,a;\theta)\) ni makadirio ya mtandao wa sasa; \(r+\gamma\max Q(s',a';\theta^-)\) huunda lengo la mafunzo. Kwa kupunguza thamani inayotarajiwa ya tofauti iliyopandishwa mraba, lengo ni kuusogeza mtandao wa sasa karibu na thamani lengwa za Q.
Kutoibadilisha target network pamoja na mtandao mkuu katika kila hatua hufanya lengo la kujifunza libaki thabiti zaidi kwa vipindi vifupi. Chanzo kinawasilisha hili kama mojawapo ya mifumo inayopunguza hatari ya oscillation na divergence katika mafunzo ya Q-Learning.
Kwa nini Experience Replay hutumiwa?
Experience replay inalenga kupunguza uhusiano mkubwa kati ya sampuli zinazofuatana na kuwezesha uzoefu wa zamani kutumika tena kwa kuhifadhi uzoefu wa \((s,a,r,s')\) katika replay buffer na kuchagua mini-batch za nasibu kutoka kwenye kumbukumbu hii wakati wa mafunzo, badala ya wakala kujifunza uchunguzi wa soko mfululizo moja kwa moja katika mpangilio uleule.
Katika mfululizo wa muda wa kifedha, uchunguzi unaofuatana mara nyingi huwa na uhusiano mkubwa. Kufundisha mtandao wa neva kwa uchunguzi michache ya mwisho inayofuatana pekee kunaweza kufanya ujifunzaji utegemee kupita kiasi regime nyembamba ya soko. Replay buffer huongeza utofauti wa sampuli kwa kuleta pamoja sampuli kutoka vipindi tofauti katika kundi moja la mafunzo.
Chanzo kinaeleza sasisho la mini-batch kimawazo kwa namna ifuatayo:
\[ \Delta\theta = E_{(s,a,r,s')\sim U(D)} \left[ \nabla_\theta \left( r+\gamma\max_{a'}Q(s',a';\theta^-) -Q(s,a;\theta) \right)^2 \right] \]
\(D\) inawakilisha replay buffer, \(U(D)\) sampuli ya uniform kutoka kwenye kumbukumbu hiyo, na \(\Delta\theta\) mabadiliko ya vigezo vya mtandao wakati wa mafunzo.
Vekta ya hali kwa HFT
Ufafanuzi wa hali ya HFT unaopendekezwa na chanzo unategemea makundi matatu makuu ya taarifa: mienendo ya hivi karibuni ya bei na mapato, viashiria vya kiufundi, na vigezo vya microstructure ya soko. Vekta ya jumla ya hali inaonyeshwa kama ifuatavyo:
\[ s=[p_1,p_2,\ldots,p_n,i_1,i_2,\ldots,i_m,v,b] \]
Hapa \(p\) inawakilisha mienendo ya bei, \(i\) viashiria vya kiufundi, \(v\) kiasi cha biashara na \(b\) bid-ask spread. Chanzo kinataja wastani unaosogea, Bollinger Bands na Relative Strength Index (RSI) kama mifano ya viashiria vya kiufundi.
Usemi huu si schema kamili ya data. Makala haibainishi ni lag ngapi za bei zitatumiwa, viashiria gani vitachaguliwa, data itachukuliwa kwa azimio gani la muda, au ingizo zitanormalishwa vipi.
Nafasi ya vitendo
Chanzo kinafafanua vitendo vitatu vya msingi:
- Buy: kununua mali kwa matarajio ya kuongezeka kwa bei.
- Hold: kudumisha nafasi ya sasa bila kufungua muamala mpya.
- Sell: kupunguza au kufunga nafasi.
Katika mfumo halisi wa HFT, vitendo vya kina zaidi kama aina ya oda, kiwango cha bei, kiasi, uamuzi wa kughairi na nafasi kwenye foleni vinaweza kuhitajika. Hata hivyo, chanzo hakimodeli kiwango hiki pana cha execution.
Kitendakazi cha tuzo
Makala inachukulia faida au hasara ya muamala kama kipengele cha msingi cha tuzo na inaonya kwamba kutegemea faida ghafi pekee kunaweza kuhamasisha sera zinazochukua hatari kubwa. Tuzo iliyorekebishwa kwa hatari inawasilishwa kimawazo kama:
\[ r = \frac{\text{Beklenen Getiri}} {\text{Getirilerin Standart Sapması}} \]
Uwiano huu uko karibu na wazo la utendaji uliorekebishwa kwa hatari wa aina ya Sharpe. Hata hivyo, chanzo hakibainishi katika jaribio halisi la mafunzo tuzo hii ilihesabiwa katika dirisha gani la muda, chini ya dhana gani ya mapato yasiyo na hatari, au kwa kutumia mbinu gani ya scaling.
Uhusiano na arbitrage ya kitakwimu
Arbitrage ya kitakwimu inategemea kubaini kwa mbinu za kitakwimu mikengeuko ya muda ya jamaa kati ya vyombo vya kifedha au michakato ya bei inayohusiana na kufanya biashara kwa matarajio kwamba mikengeuko hiyo itarejea katika hali ya kawaida. Kwa mtazamo wa Deep Q-Learning, badala ya kutumia tu kizingiti kisichobadilika cha kuingia na kutoka, wakala hujaribu kurekebisha sera yake ya vitendo kwa kujifunza kutokana na hali ya soko na tuzo za zamani.
Uwezo huu wa kujirekebisha unaweza kinadharia kutoa faida ya kuitikia mabadiliko ya regime. Hata hivyo, hali ya non-stationary ya masoko ya fedha haihakikishi kwamba thamani za Q zilizojifunzwa zamani zitaendelea kuwa halali siku zijazo. Regime mpya za soko zinaweza kukinzana na uzoefu wa zamani ndani ya replay buffer, na usambazaji wa tuzo unaweza kubadilika kadiri muda unavyopita.
Mbinu na Matokeo ya Utafiti
Vipengele vya kimetodolojia vilivyofafanuliwa katika chanzo
| Kipengele | Jukumu lililofafanuliwa katika chanzo | Maelezo ya utekelezaji yanayokosekana katika chanzo |
|---|---|---|
| Hali \(s\) | Inawakilisha taarifa za soko kama bei, mapato, kiashiria cha kiufundi, kiasi na bid-ask spread. | Azimio la muda, ukubwa wa dirisha, normalization na seti kamili ya features hazijatolewa. |
| Kitendo \(a\) | Maamuzi ya Buy, Hold na Sell. | Kiasi cha oda, tofauti ya oda za limit/market na maelezo ya execution hayajatolewa. |
| Tuzo \(r\) | Faida/hasara au mapato yaliyorekebishwa kwa hatari. | Kitendakazi kamili cha tuzo na vigezo vilivyotumiwa katika utekelezaji halisi havijatolewa. |
| Q-Learning | Hujifunza tuzo ya muda mrefu kupitia sasisho la thamani linalotegemea Bellman. | Thamani halisi za majaribio za \(\alpha\) na \(\gamma\) hazijaripotiwa. |
| Q-network | Hukadiria thamani za Q za vitendo kutoka kwenye hali yenye vipimo vingi. | Idadi ya tabaka, idadi ya neuroni, vitendakazi vya uanzishaji na optimizer havijatolewa. |
| Target network | Hutoa makadirio tofauti ya Q ili kuweka lengo la kujifunza thabiti zaidi. | Marudio ya kusasisha hayajaelezwa. |
| Replay buffer | Huhifadhi uzoefu wa zamani na kuwezesha mafunzo ya mini-batch za nasibu. | Uwezo wa buffer, batch size na maelezo ya sampling hayajaripotiwa. |
| Funksi ya hasara | Hupunguza tofauti ya mraba kati ya makadirio ya sasa ya Q na Q lengwa. | Muda wa mafunzo, kigezo cha convergence na mikunjo ya ujifunzaji havijatolewa. |
Je, makala inathibitisha kwamba Deep Q-Learning ina faida zaidi katika HFT?
Hapana; ingawa muhtasari wa chanzo unadai kwamba uigaji na backtest zilitoa matokeo chanya kwa upande wa kujirekebisha, faida na mapato yaliyorekebishwa kwa hatari, sehemu kuu ya makala hairipoti seti ya data, kipindi cha backtest, benchmark, PnL, Sharpe ratio, drawdown, gharama ya miamala au matokeo ya umuhimu wa kitakwimu yanayoruhusu dai hili kutathminiwa kwa kujitegemea.
Tofauti hii ni ya msingi katika kutafsiri utafiti. Chanzo kinaeleza jinsi Deep Q-Learning inavyoweza kurekebishwa kwa arbitrage ya kitakwimu ya HFT na kujadili faida zake zinazowezekana. Lakini PDF iliyopo haitoi ushahidi wa kiempiria unaoweza kuzalishwa upya unaoonyesha kwamba mbinu ilizidi benchmark fulani kwa kiasi kwenye data fulani ya soko.
Tofauti ya ushahidi kati ya muhtasari na sehemu kuu
Muhtasari unatumia kauli “extensive simulations and backtests” na kusema kwamba kulikuwa na maboresho katika vipimo vya faida na mapato yaliyorekebishwa kwa hatari. Kinyume chake, sehemu kuu ya chanzo haina sehemu tofauti ya data, jaribio, matokeo au backtest. Hakuna mfululizo wa nambari wa mapato, jedwali la utendaji au ulinganisho wa modeli uliotolewa.
Kwa hiyo, kauli salama ya kisayansi kwa mtazamo wa Verianla ni hii: utafiti unaipa Deep Q-Learning msingi wa kimawazo kwa arbitrage ya kitakwimu ya HFT na unapendekeza usanifu unaoweza kutekelezwa; hata hivyo, kiwango cha ushahidi kinachotolewa na PDF hii hakitoshi kuthibitisha kwa kiasi ubora halisi wa kiuchumi wa mbinu hiyo.
Mapungufu kwa upande wa uwezo wa kuzalisha upya
- Soko la fedha au wigo wa mali uliotumiwa haujaainishwa.
- Chanzo cha data ya tick, trade au limit-order-book hakijatolewa.
- Vipindi vya Train, validation na test havijaripotiwa.
- Itifaki ya tathmini ya out-of-sample haijatolewa.
- Usanifu wa Q-network haujaainishwa.
- Learning rate, discount factor, batch size na uwezo wa replay-buffer havijatolewa.
- Vigezo vya epsilon-greedy au sera nyingine ya exploration havijaainishwa.
- Marudio ya kusasisha target network hayajatolewa.
- Ada za miamala, gharama ya bid-ask, slippage na market impact hazijamodeliwa.
- Latency au gharama ya miundombinu ya biashara haijaripotiwa.
- Benchmark za kulinganisha hazijatolewa.
- Sharpe ratio, maximum drawdown, turnover au mfululizo wa PnL haujaripotiwa.
Hitimisho linaloungwa mkono na utafiti
Chanzo kinaunga mkono kwamba Deep Q-Learning hutoa mfumo wa kimantiki wa HFT kwa kuwakilisha hali za soko zenye vipimo vingi kwa mtandao wa neva, kusasisha thamani za vitendo kwa kanuni ya Q-Learning, kujifunza tena kutokana na uzoefu wa zamani kupitia replay buffer na kuimarisha uthabiti wa lengo la mafunzo kwa target network.
Hitimisho lisiloungwa mkono na utafiti
Chanzo hakionyeshi kwa kiasi kwamba usanifu huu hutoa mapato bora kwa maana ya kitakwimu katika exchange, mali, kipindi cha biashara au miundombinu ya HFT ya wakati halisi iliyobainishwa, kwamba unabaki wenye faida baada ya gharama za miamala, au kwamba ni bora kuliko mbinu za kawaida za arbitrage ya kitakwimu.
Maelezo ya Chanzo na Mbinu
Utafiti asili: Harnessing Deep Q-Learning for Enhanced Statistical Arbitrage in High-Frequency Trading: A Comprehensive Exploration.
Mwandishi: Soumyadip Sarkar.
Chanzo: arXiv:2311.10718v1, q-fin.TR.
Tarehe: 13 Septemba 2023.
Kitambulishi cha kudumu: 10.48550/ARXIV.2311.10718.
Aina ya chanzo: arXiv preprint; chanzo hakitoi taarifa ya uchapishaji katika jarida/konferensi iliyopitiwa na rika.
Uhusiano wa taasisi: PDF ya chanzo haijaainisha uhusiano wa taasisi wa mwandishi; imetoa tu anwani ya barua pepe ya mawasiliano.
Leseni: Kwa kuwa hakuna leseni maalum ya wazi iliyothibitishwa katika PDF iliyochunguzwa na rekodi za kibibliografia, maandishi ya Verianla yanaeleza dhana za kisayansi katika muundo huru wa kielimu badala ya kuchapisha upya kauli ya chanzo.
Upatikanaji wa data: Chanzo hakibainishi seti maalum ya data au hifadhi ya data.
Ufadhili na mgongano wa maslahi: PDF haina tamko la wazi la ufadhili au mgongano wa maslahi.
Kizuizi kikuu cha kimetodolojia: Ingawa chanzo kinaeleza vipengele vya kihisabati na kimawazo vya Deep Q-Learning, hakitoi data, hyperparameters, mpangilio wa mafunzo na matokeo ya utendaji yanayohitajika kuunda upya utekelezaji wa kiempiria.
Kikomo cha tafsiri ya kifedha: Maudhui haya ya Verianla si pendekezo la mkakati wa biashara wala ushauri wa uwekezaji; ni maandishi ya kielimu ya kisayansi yanayoeleza muundo wa kimetodolojia na mipaka ya ushahidi ya utafiti wa chanzo.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *