


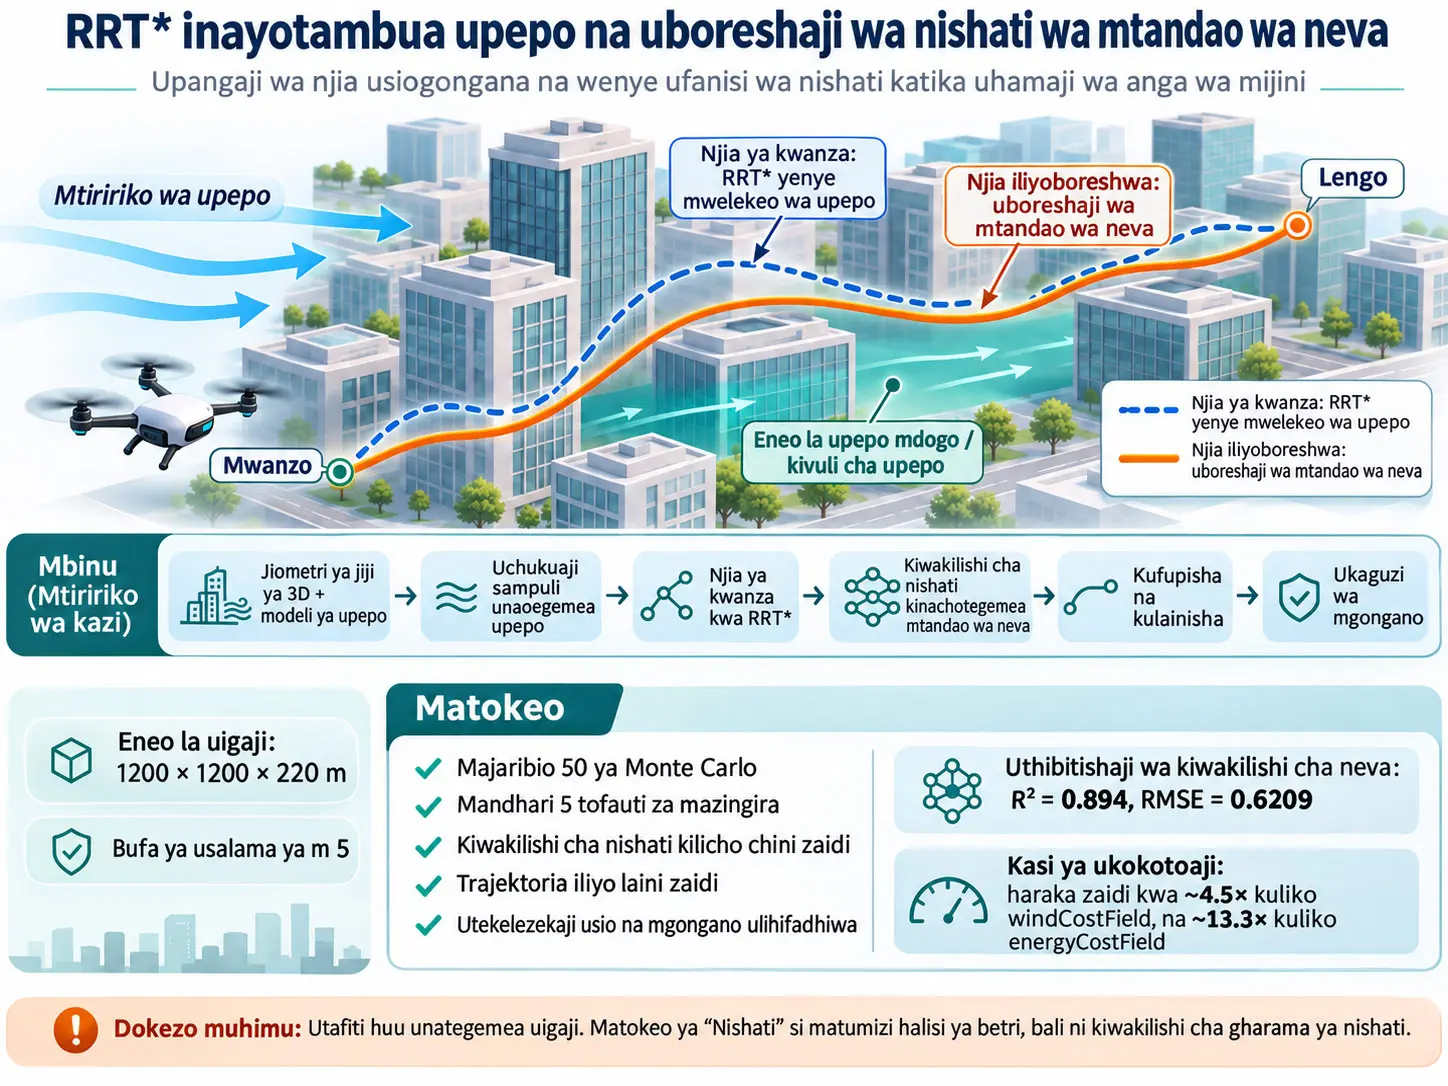
Utafiti huu unachunguza matumizi ya muundo wa upepo ndani ya jiji kama ingizo la upangaji, badala ya kuweka njia ya quadrotor moja inayosafiri katika mazingira ya mijini yenye msongamano kuwa fupi tu kijiometri. Mfumo unaopendekezwa ni mbinu ya upangaji mwendo inayounganisha RRT* yenye upendeleo wa upepo na uboreshaji wa gharama ya nishati kwa msingi wa mtandao wa neva. Muundo wa upepo unawakilisha wind shear inayobadilika kwa kimo, mzunguko wa mwelekeo wa aina ya Ekman, uga wa turbulence uliogandishwa, mabadiliko ya ghafla ya upepo, na maeneo ya kasi ndogo upande wa chini ya upepo wa majengo. Katika hatua ya kwanza, sampuli za RRT* zinaelekezwa kwenye maeneo yanayofaa zaidi kwa aerodynamics; katika hatua ya pili, mtandao wa neva wa feedforward hutumiwa kama surrogate ya uga wa gharama ya nishati ambao ni ghali zaidi kukokotoa, ili kuongoza ufupishaji na ulainishaji wa njia.
Matokeo makuu ya utafiti yanaonyesha kwamba, kwa kuzingatia surrogate ya nishati, njia zinazozingatia upepo zinaweza kuwa na gharama ndogo na kwamba uboreshaji wa neva huongeza kwa kiasi kikubwa ulaini wa njia. Hata hivyo, kipimo kinachopimwa hapa si nishati halisi ya umeme iliyotolewa kutoka kwenye betri. Utafiti haukufanya udhibiti wa ndege wa closed-loop, mienendo halisi ya chombo, matumizi halisi ya betri, wala jaribio la ndege la uwanjani. Kwa hiyo, matokeo hayawezi kufasiriwa kama “quadrotor itaokoa kiasi fulani cha nishati katika ndege halisi ya mijini”.
Kwa upande wa Türkiye, utafiti hautoi matokeo ya moja kwa moja ya uwanjani kutoka Türkiye. Hata hivyo, iwapo mbinu kama hii itathibitishwa upya kwa kutumia jiometri za majengo za eneo husika za pande tatu, hali halisi za upepo wa mijini nchini Türkiye, modeli ya mienendo na nguvu ya chombo cha anga kinachotumiwa, makosa ya uwekaji nafasi, mfumo wa udhibiti wa ndege, na korido halisi za ndege za kisheria, inaweza kuwa msingi wa utafiti kwa uhamaji wa anga mijini na upangaji wa njia za ndege zisizo na rubani. Bila urekebishaji huu, matokeo ya nambari ya utafiti hayapaswi kuchukuliwa kuwa yanatumika moja kwa moja kwa jiji lolote nchini Türkiye.
Kikomo muhimu zaidi cha tafsiri: Thamani za “energy” katika utafiti si vipimo halisi vya joule au watt-saa, bali ni surrogate ya gharama ya kimahesabu inayounganisha athari ya upepo na ukaribu wa vizuizi. Vivyo hivyo, kipimo cha “risk” si uwezekano halisi wa ajali; ni kipimo cha tathmini kinachowakilisha ukaribu wa kijiometri wa njia iliyopangwa kwa kulinganisha na vizuizi.
Tatizo ambalo utafiti unajaribu kutatua
Vipangaji vya familia ya kawaida ya RRT na RRT* vina ufanisi mkubwa katika kupita vizuizi katika mazingira changamano ya pande tatu. Hata hivyo, njia fupi kijiometri si lazima iwe nafuu kwa aerodynamics. Njia mbili zinaweza kuwa na urefu unaokaribiana; moja inaweza kupitia eneo wazi lenye upepo mkali, nyingine ikapita katika maeneo ya upepo wa kasi ndogo nyuma ya majengo. Utafiti unajaribu kuingiza tofauti hii katika upangaji wa njia.
Wazo kuu ni hili: uga wa upepo karibu na jengo si usumbufu wa nasibu unaopaswa kuepukwa tu. Kupungua kwa kasi upande wa chini ya upepo wa jengo ni taarifa ya anga ambayo mpangaji anaweza kutumia. Kwa hiyo, mbinu hubadilisha kwanza maeneo ambako njia inatafutwa, kisha huboresha njia iliyopatikana kulingana na surrogate ya gharama ya nishati.
Kivuli cha upepo kinatumiwaje katika upangaji wa njia?
Katika modeli ya utafiti, kivuli cha upepo ni eneo upande wa chini ya upepo wa jengo ambako kasi ya upepo ya eneo hupunguzwa ikilinganishwa na free stream; mpangaji hujaribu kuyatathmini maeneo haya kama korido zenye gharama ya chini ya aerodynamics.
1. Eneo la kazi na modeli ya vizuizi: Milinganyo (1)-(3)
Mlinganyo huu unafafanua eneo la kazi la ndege la pande tatu. Katika utafiti, \(L_x=L_y=1200\,\mathrm{m}\) na \(L_z=220\,\mathrm{m}\) zilichaguliwa. Kwa hiyo, eneo la simuleringi ni prisma ya mstatili yenye 1200 m × 1200 m kwa usawa na urefu wa 220 m kwa wima. Vipimo vya koordinati \(x\), \(y\) na \(z\) ni mita.
\(O_j\) ni ujazo unaokaliwa na jengo au muundo wa mijini wa \(j\). Kwa operesheni ya tofauti ya seti, ujazo wote wa vizuizi huondolewa kwenye eneo lote la kazi, na hivyo kupatikana nafasi huru \(\Omega_{\mathrm{free}}\) ambamo chombo kinaweza kuwepo kijiometri.
\(M(p)\) ni kiashiria cha occupancy map. Thamani ikiwa 1, nafasi iko ndani ya kizuizi; ikiwa 0, iko huru. Ramani imesampuliwa kwa azimio la anga la \(0.5\,\mathrm{m}\). Kiashiria hiki baadaye huwa msingi wa ukaguzi wa mgongano.
2. Upepo karibu na uso: Milinganyo (4)-(10)
\(u_*\) ni friction velocity; kipimo chake ni m/s. \(\tau_0\) inawakilisha turbulent shear stress karibu na uso, na \(\rho_a\) wiani wa hewa. Friction velocity si kasi halisi ya chombo, bali ni kipimo cha tabia cha kasi ya uhamishaji wa momentum katika atmospheric boundary layer.
Katika mkabala wa Prandtl mixing length, \(l_m=\kappa z\) hutumiwa na \(\kappa\approx0.41\) ni konstanti ya von Kármán. Mlinganyo unaweka uhusiano kati ya mabadiliko ya kasi ya wastani kwa kimo na uhamishaji wa turbulent momentum kwenye uso.
Huu ni wasifu wa kawaida wa upepo wa logarithmic. \(z_0\) ni aerodynamic roughness length na kipimo chake ni mita. Kihisabati, gradient ya kasi hupungua kwa \(1/z\); kwa hiyo, mabadiliko ya kasi huwa makali zaidi karibu na uso.
Kwa urahisi wa kukokotoa, utafiti hutumia ukaribishaji wa engineering power law wa wasifu wa logarithmic. \(U_{\mathrm{ref}}\) ni kasi rejea katika kimo \(z_{\mathrm{ref}}\), na \(\alpha\) ni exponent isiyo na kipimo ya wind shear.
Usemi huu unalinganisha mteremko wa wasifu wa logarithmic na power law katika kimo rejea. Utafiti umetumia \(\alpha\approx0.30\) kuwakilisha uso wa mijini uliojengwa kwa msongamano. Kadri \(\alpha\) inavyoongezeka, ndivyo unyeti wa kasi ya upepo kwa kimo unavyoongezeka.
Hapa \(V_0\) ni kasi ya msingi ya upepo katika kimo rejea \(z_{\mathrm{ref}}=10\,\mathrm{m}\). Kikomo cha chini \(z_{\min}=0.5\,\mathrm{m}\) hutumiwa kuzuia singularity ya nambari na gradients kubwa kupita kiasi zinazoweza kutokea wakati \(z\to0\). \(V(z)\) iko katika m/s. Kwa scenarios mahususi zilizotumiwa katika utafiti, thamani moja ya kudumu ya nambari ya \(V_0\) haikutolewa katika maandishi makuu ya mbinu; nguvu ya upepo ilibadilishwa kulingana na scenario.
Wakati \(\alpha=0.30\), exponent huwa \(\alpha-1=-0.70\). Kwa hiyo, gradient ya kasi hupungua kadri kimo kinavyoongezeka. Matokeo haya ya kihisabati hayamaanishi kwamba “kasi ya upepo hupungua”; katika modeli, kasi ya upepo huongezeka kwa kimo, lakini kiwango cha ongezeko kwa kila kitengo cha kimo hupungua hatua kwa hatua.
3. Mzunguko wa mwelekeo wa upepo kwa kimo: Milinganyo (11)-(14)
\(u\) na \(v\) ni vipengele vya upepo vya usawa, \(f_c\) ni Coriolis parameter, \(K\) ni eddy viscosity, na \(u_g\) ni geostrophic wind speed. Mlinganyo unawakilisha usawa wa horizontal momentum kati ya athari ya Coriolis, pressure gradient na turbulent friction.
\(\delta_e\) ni characteristic depth ya Ekman boundary layer. Mabadiliko ya pamoja ya vipengele viwili husababisha vector ya upepo kubadilisha mwelekeo kwa kimo.
\(\operatorname{atan2}\) hukokotoa pembe ya mwelekeo wa upepo kutoka kwa vipengele viwili vya usawa huku ikihifadhi taarifa sahihi ya quadrant.
Badala ya kukokotoa tabia kamili ya Ekman katika kila upanuzi wa node, utafiti hutumia ukaribishaji wa mzunguko wa mwelekeo wa mstari katika bendi ya kimo cha chini. \(\theta_0\) ni mwelekeo wa mwanzo karibu na uso, na \(\gamma\) ni mabadiliko ya mwelekeo ya takriban \(0.18^\circ\) kwa kila mita. Huu ni urahisishaji wa kimahesabu wa utafiti; si konstanti ya ulimwengu mzima kwa anga lote.
4. Ukali wa turbulence: Milinganyo (15)-(17)
\(T_i\) ni turbulence intensity isiyo na kipimo. \(\sigma_u\) inawakilisha standard deviation ya mabadiliko ya kasi, na \(V(z)\) kasi ya wastani ya upepo. Katika chanzo, kwa surface layer, scaling ya \(\sigma_u\approx A u_*\) na \(A\approx2.5\) hutumiwa kuhalalisha kupungua kwa turbulence intensity kwa kimo.
\(\beta\approx0.25\) ni exponent isiyo na kipimo ya kupungua. Kwa \(z\le z_{\mathrm{ref}}\), kwa kuwa denominator ni \(z_{\mathrm{ref}}\), turbulence intensity hushikiliwa katika \(T_{i,0}\); katika vimo vya juu zaidi hupungua kwa power law.
\(T_{\mathrm{lev}}\in\{1,\ldots,10\}\) ni kiwango cha turbulence cha simuleringi kinachofafanuliwa na mtumiaji. Hivyo turbulence intensity ya uso huwekwa kwa mstari kati ya \(0.04\) na \(0.30\). Ikumbukwe kwamba nambari hizi ni parameterization ya simuleringi ya utafiti, si madaraja yaliyopimwa ya turbulence ya jiji halisi.
5. Turbulence iliyogandishwa na uga wa gust: Milinganyo (18)-(21)
Chini ya dhana ya Taylor ya frozen turbulence, mabadiliko ya muda huwakilishwa kama pattern iliyofungwa angani. \(p=[x,y,z]^T\) inawakilisha nafasi, \(k_j\) spatial wave vector, na \(\phi_j\) awamu ya nasibu iliyofungwa. Utafiti umetumia \(N_g=8\) Fourier modes. Seed inapowekwa sawa, hali ileile ya simuleringi inaweza kurudiwa.
Kikomo hiki kinatokana na ukweli kwamba absolute value ya sine function haizidi 1. Kisha chanzo hunormalize uga kwenye intervalo \([-1,1]\).
Kwa kudhani awamu huru na zilizosambazwa sawasawa, expected value ya vipengele vya sine ni sifuri, na expected value ya mraba wake ni \(1/2\). Matokeo haya yanaeleza jinsi modeli inavyozalisha mabadiliko ya anga yenye wastani sifuri.
\(A_g\approx0.35\) ni scale ya fractional amplitude ya mabadiliko ya kasi. \(J_g\approx18^\circ\) ni angular scale ya mabadiliko ya mwelekeo. \(f_d\) ni uga wa pili wa spatial fluctuation ulio huru na uga wa kasi. Opereta \(\max(\cdot,0)\) huzuia kuzalishwa kwa kasi hasi ya upepo.
6. Wake ya jengo na kivuli cha upepo: Milinganyo (22)-(24)
\(\hat d\) ni unit vector katika mwelekeo wa upepo wa usawa.
\(c\) ni kitovu cha jengo. \(\xi\) hutoa kipengele cha nafasi cha downstream katika mwelekeo wa upepo, na \(\eta\) kipengele cha crosswind kilicho perpendicular kwa upepo. Vipimo vya urefu ni mita. Wakati \(\xi>0\), point iko upande wa chini ya upepo wa jengo.
\(s_w\) ni coefficient isiyo na kipimo ya attenuation inayotumika kwa kasi ya upepo, na chanzo hutumia \(s_{\min}\approx0.4\). \(\sigma_w\) inawakilisha upana wa transverse wa wake, na \(\lambda\) characteristic length ya downstream. Gaussian term hupunguza athari kadri umbali kutoka centerline unavyoongezeka; indicator function \(I_{[\xi>0]}\) inalenga kutumia athari upande wa chini ya upepo pekee.
Hoja ya tahadhari ya kihisabati ndani ya chanzo: Maandishi yanaeleza kipengele hiki kama urejeaji wa polepole wa deficit ya kasi downstream. Hata hivyo, factor iliyochapishwa katika mlinganyo \((1-e^{-\xi/\lambda})\) huongezeka kutoka 0 hadi 1 kadri \(\xi>0\) inavyoongezeka. Ikiwa vipengele vingine kwenye centerline vinachukuliwa kuwa thabiti, tabia hii hupunguza \(s_w\) kutoka 1 kuelekea \(s_{\min}\); yaani, kwa mtazamo wa kwanza, umbo lililochapishwa linaendana na attenuation kuongezeka downstream. Verianla hailisahihishi chanzo kimyakimya hapa; inahifadhi formula iliyochapishwa jinsi ilivyo na kuonyesha wazi kutolingana huku kati ya maelezo na formula.
RRT* yenye upendeleo wa upepo inatofautianaje kihisabati na RRT* ya kawaida?
Katika mkabala wa utafiti, gharama ya urefu wa njia na mantiki ya rewiring ya RRT* hazibadilishwi; kinachobadilishwa ni vimo ambavyo nodes mpya husampuliwa. Lengo ni kuweka sampuli mara nyingi zaidi katika vimo vyenye kasi ndogo ya upepo katika modeli.
7. Hisabati ya RRT* ya kawaida: Milinganyo (25)-(30)
Gharama hii ni urefu wa njia ya Euclidean kutoka mwanzo hadi node ya sasa. Kipimo chake ni mita. Katika hatua hii, upepo hauongezwi moja kwa moja kwenye gharama ya nishati.
Majirani walio ndani ya radius \(r_n\) kuzunguka node mpya hutambuliwa.
\(n\) ni idadi ya sampuli, \(d\) ni dimension ya configuration space, na \(\gamma\) ni parameter chanya ya tuning. Kadri idadi ya sampuli inavyoongezeka, radius ya neighborhood hupungua kwa udhibiti. Ili kuhifadhi hoja ya asymptotic optimality ya RRT*, utafiti haubadilishi muundo huu wa kawaida wa radius. Thamani moja ya nambari ya \(\gamma\) iliyotumiwa haijaelezwa wazi katika PDF iliyochunguzwa.
Node jirani inayopunguza gharama ya jumla ya kijiometri ya kufikia node mpya huchaguliwa kuwa parent.
Ikiwa kupitia node mpya kunatengeneza njia fupi, muunganisho husika wa mti uliopo hupangwa upya. Mojawapo ya tofauti kuu kati ya RRT* na RRT ni operesheni hii ya rewiring.
\(\sigma_n\) inawakilisha njia bora iliyopatikana baada ya sampuli \(n\), na \(\sigma^*\) njia bora ya kinadharia. Usemi huu unaonyesha lengo la asymptotic optimality la RRT* chini ya assumptions zinazofaa. Toleo la utafiti lenye upendeleo wa upepo linadai kuhifadhi matokeo haya kwa kutogusa gharama na kanuni ya rewiring na kubadilisha tu sampling distribution.
8. Kusampuli vimo vya upepo mdogo mara nyingi zaidi: Milinganyo (31)-(37)
\(\omega(z)\) ni uzito wa preference ya kimo. \(\eta_b\ge0\) ni nguvu ya bias. Wakati \(\eta_b=0\), vimo vyote hupata uzito sawa; kadri \(\eta_b\) inavyoongezeka, vimo vyenye kasi ndogo ya upepo wa modeli hupendelewa zaidi. \(z_{\mathrm{lo}}\) na \(z_{\mathrm{hi}}\) ni vimo vya chini na juu vinavyoruhusiwa kwa ndege. PDF haitoi wazi thamani moja ya nambari ya parameters hizi kwa majaribio yote yaliyotumiwa.
\(Z_0\) ni normalization constant. Kwa kugawanya kwa integral ya weight function, probability density halisi \(f_Z(z)\) yenye total probability ya 1 hupatikana.
\(F_Z\) ni cumulative distribution function na hubadilika kati ya 0 na 1.
Closed form hii hutumika kukokotoa normalization ya power-law weighting moja kwa moja. Hali maalum ya \(a=1\) ingefanya denominator kuwa sifuri katika formula hii, hivyo inahitaji logarithmic integral tofauti; chanzo kinatoa Mlinganyo (34) wazi kwa sharti \(a\ne1\).
Ikiwa \(\mu\sim U(0,1)\), kwa inverse-transform sampling \(F_Z^{-1}(\mu)\) hufuata kabisa distribution ya kimo inayotakiwa. Hivyo kimo chenye bias kinaweza kuzalishwa bila rejection sampling.
Wakati nafasi ya usawa inachukuliwa kutoka uniform distribution, kimo huchaguliwa kutoka distribution yenye bias kwa kutumia taarifa ya upepo. Zaidi ya hayo, kwa probability \(p_{\mathrm{goal}}\), sampuli hubadilishwa moja kwa moja na configuration ya lengo. Thamani kamili ya nambari ya \(p_{\mathrm{goal}}\) iliyotumiwa haijaelezwa wazi katika chanzo.
\(\lambda_b\in[0,1]\) hutoa mchanganyiko kati ya distribution yenye bias na uniform distribution. \(\lambda_b=1\) ni sampling ya kimo yenye upendeleo kamili wa upepo; \(\lambda_b=0\) ni sampling ya kimo iliyo uniform kabisa. Thamani za kati huunda mpito kati ya preference ya aerodynamics na diversity ya kimo. Katika maandishi ya PDF yaliyokaguliwa, thamani mahususi ya \(\lambda_b\) iliyotumiwa haijawekwa wazi.
Mbinu na Matokeo ya Utafiti
Mtandao wa neva unajifunza kiasi gani?
Mtandao wa neva haujifunzi moja kwa moja current ya betri, power ya motor, au nishati katika joule. Lengo la mtandao ni kukadiria takriban uga wa scalar \(c_E(p)\) unaozalishwa kutoka modeli ya analytical wind na hesabu ya ukaribu wa kizuizi katika utafiti. Tofauti hii ni muhimu sana: mtandao wa neva ni surrogate model ya surrogate ya gharama ya nishati.
Je, kupungua kwa neural energy surrogate kunaonyesha kwamba matumizi halisi ya betri yatapungua kwa uwiano huohuo?
Hapana. Thamani ndogo ya energy-proxy katika utafiti inaonyesha kwamba njia inayofaa zaidi imepatikana chini ya mathematical cost function iliyotumiwa; kwa kuwa nishati halisi ya betri, ramani ya ufanisi wa motor, mienendo ya chombo, control effort, speed profile, payload, maneuvers na anga halisi havikupimwa pamoja, haiwezi kubadilishwa kuwa asilimia ya akiba halisi ya betri.
9. Uga wa gharama ya nishati: Milinganyo (38)-(41)
\(c_E\) ni total scalar cost. \(c_W\) ni sehemu ya upepo/turbulence, na \(c_P\) ni sehemu ya ukaribu wa kizuizi. Kwa kuwa terms zote mbili hutumiwa kama normalized costs, hakuna kitengo cha joule hapa.
\(V_{\mathrm{ref}}\) ni reference wind speed na \(\kappa_T\approx1.5\) ni turbulence-cost coupling coefficient. Mraba wa wind-speed ratio hufanya gharama iwe nyeti kwa kasi kwa njia isiyo linear. Katika wind shadows ambako \(s_w<1\), effective speed hupungua. Kadri turbulence intensity inavyoongezeka, factor ya pili huongeza gharama.
Utegemezi wa quadratic hapa unapaswa kufasiriwa kama energy-proxy model iliyopitishwa na utafiti. Si sahihi kuujumlisha mlinganyo huu moja kwa moja kama sheria halisi ya electrical power ya multirotor.
Jumla ya probe points sita huundwa kuzunguka candidate point katika mwelekeo chanya na hasi wa axes x, y na z. Probe radius ni 5 m.
Term ya kwanza hutoa adhabu kubwa ikiwa point ya sasa iko ndani ya kizuizi; term ya pili huzingatia hali ya occupancy ya probes sita zinazozunguka kwa uzito mdogo. Muundo wa sigmoid hubadilisha sharp binary map kuwa smooth cost signal. Adhabu hii si uwezekano halisi wa mgongano.
10. Usanifu na mafunzo ya mtandao wa neva: Milinganyo (42)-(50)
Ingizo la mtandao ni nafasi ya pande tatu \(p=[x,y,z]\), na pato ni thamani moja ya scalar \(\hat c_\theta(p)\). Wakati wa mafunzo, input coordinates husanifishwa kwa mean sifuri na standard deviation ya moja kwa kila coordinate. Upana wa hidden layers ni 64, 48, 32 na 16.
Katika kila layer, linear transformation hutumika kwanza, kisha activation. \(W^{(\ell)}\) ni weight matrix na \(b^{(\ell)}\) ni bias vector.
Layer ya mwisho huzalisha linear output. \(\theta\) inawakilisha kwa pamoja weights na bias parameters zote zinazojifunzwa.
ReLU activation hutumiwa katika hidden layers. Negative pre-activations huwekwa sifuri, positive hupitishwa bila kubadilishwa.
Term ya kwanza ni mean squared error; ya pili ni L2 regularization inayozuia weights kukua kupita kiasi. Chanzo kinatoa mgawanyo wa training/validation kama %85 training na %15 validation; hata hivyo, thamani ya nambari ya \(\lambda\) haijaelezwa wazi katika maandishi ya PDF.
\(r_k\) ni residual error kati ya prediction na target. Sensitivity ya output layer huanza kutoka kwa error hii.
\(\odot\) ni element-wise Hadamard product. Error sensitivity hurudishwa nyuma kwa chain rule.
Mlinganyo wa kwanza hutoa gradient ya weights, na wa pili gradient ya biases. Term \(2\lambda W\) ni mchango wa L2 regularization.
Levenberg–Marquardt update hutumiwa katika mafunzo. \(\mu\) ni damping parameter; mbinu hubadilika kati ya tabia ya Gauss–Newton na gradient-type update iliyo makini zaidi. \(\mathrm{Jac}\) ni Jacobian matrix ya residuals kwa parameters. Chanzo hakiripoti thamani ya nambari ya \(\mu\) katika majaribio mahususi.
RMSE hupima ukubwa wa kawaida wa prediction error kwenye validation set. Thamani ndogo ina maana surrogate prediction iliyo karibu zaidi; hata hivyo, RMSE pekee haithibitishi physical accuracy ya modeli halisi ya nishati.
11. Mwelekeo wa uga wa gharama uliojifunzwa: Mlinganyo (51)
Mbinu ya central difference hukadiria mteremko wa eneo wa uso wa gharama ya nishati katika mwelekeo wa x, y na z. Utafiti umetumia \(h=4\,\mathrm{m}\). Matokeo hunormalize kuwa unit vector na kutumiwa zaidi kama taarifa ya mwelekeo kuliko magnitude. Ikiwa hakuna mtandao wa neva, chanzo huweka \(g_E\equiv0\) na mbinu hurudi kwenye geometric smoothing pekee.
12. Ufupishaji wa njia na collision gate: Milinganyo (52)-(55)
Line segment kati ya point mbili za njia husampuliwa kwa wingi katika intervals za takriban 2 m. Ikiwa kila sampuli iko katika free space, muunganisho hukubaliwa. Ikiwa hata sampuli moja inaingia kwenye inflated obstacle map, candidate connection hukataliwa.
Hii ni estimated mean cost ya sampuli \(m\) kwenye candidate shortcut.
Shortcut hukubaliwa tu ikiwa haina mgongano na haifanyi average energy-cost ya sehemu ya sasa ya njia kuwa mbaya kwa zaidi ya tolerance ya 0.05.
Njia ya polyline iliyofupishwa hugawanywa tena kuwa waypoints zilizo na spacing inayokaribiana. Chanzo kinafafanua symbol \(\delta_s\), lakini katika maandishi ya PDF yaliyokaguliwa hakitoi thamani moja wazi ya nambari ya \(\delta_s\).
13. Laplacian na energy-directed smoothing: Milinganyo (56)-(61)
Midpoint ya majirani wawili wa waypoint ya ndani hukokotolewa. Point hii inawakilisha local target ya njia iliyo laini zaidi kijiometri.
Jumla ya candidates tisa huzalishwa: moja ni half-step kuelekea Laplacian midpoint, na nane hutokana na fixed directional offsets. Chanzo hakiorodheshi wazi katika maandishi makuu vipengele vyote vya nambari vya offsets \(\Delta_q\).
Koordinati z ya candidate haiwezi kutoka nje ya flight band inayoruhusiwa.
Term ya kwanza ni curvature/smoothness penalty kupitia second difference, term ya pili ni learned energy-cost, na term ya tatu ni displacement penalty inayozuia kusogea mbali kupita kiasi kutoka point ya sasa. Chanzo kinatoa weights \((\beta_s,\beta_e,\beta_d)=(0.8,0.5,0.04)\).
Candidate yenye gharama ndogo zaidi huwa waypoint mpya tu ikiwa connections zake mbili za majirani pia hazina mgongano. Hivyo, hata kama mtandao wa neva unatoa pendekezo, uamuzi wa mwisho hupitia deterministic collision check.
Katika ukaguzi wa mwisho, jumla ya occupancy ya waypoints zilizoboreshwa kwenye inflated planning map lazima iwe sifuri. Matokeo haya yana maana ya “kutokuwa na mgongano” tu chini ya assumptions za deterministic map na safety buffer ya 5 m ya utafiti; positioning error au control deviation ya chombo halisi haijamodeliwa hapa.
Mpangilio wa simuleringi
Utafiti ulifanywa kwa kutumia MATLAB 2023b. Katika scenario ya msingi ya uwakilishi, start na goal positions ziliwekwa thabiti ndani ya mazingira ya mijini ya 1200 × 1200 × 220 m, hali ya upepo ikafanywa random upya katika kila run, na majaribio huru 50 ya Monte Carlo yakafanywa. Mbinu kuu za kulinganisha ni RRT, Goal-Biased RRT, Informed RRT* na BIT*. Hatua za utafiti pia zililinganishwa kama Uniform RRT*, Wind-Shear Biased na Biased + Neural.
Mihimili minne mikuu ya tathmini ni urefu wa njia, surrogate ya nishati, ulaini wa njia na obstacle-risk metric. Scale ya smoothness iliwasilishwa kwa mwelekeo wa kinyume katika comparison plots na thamani ya chini ina maana ya njia laini zaidi.
Kwa generalizability check, mipangilio mitano tofauti ya mazingira pia ilitathminiwa: ramani iliyopo, mpangilio wa Manhattan, sparse natural distribution, dense natural distribution na downtown cluster. Katika sehemu hii, mean na standard deviation za simulations 10 za Monte Carlo kwa kila mazingira ziliripotiwa.
Ulinganisho wa analytical wind model na CFD-lite
Chanzo hakijathibitisha analytical wake kwa full high-resolution CFD. Katika hali ya jengo moja na majengo matatu, chini ya uniform inflow wind ya 10 m/s, kulinganisha kulifanywa na CFD-inspired potential-flow approximation iliyofafanuliwa kama reference nyepesi zaidi. Kwa hiyo, jedwali lifuatalo halipaswi kufasiriwa kama “uthibitishaji wa uhakika kwa CFD halisi”.
| Configuration | Wastani |ΔV|/U∞ (%) | RMSE (m/s) | Pearson r | Wastani wa velocity deficit, CFD-lite (%) | Wastani wa velocity deficit, analytical (%) |
|---|---|---|---|---|---|
| Jengo 1 | 2.84 | 0.312 | 0.991 | 38.6 | 39.1 |
| Majengo 3 | 3.67 | 0.385 | 0.987 | 41.2 | 42.0 |
Katika ulinganisho huu, mean relative velocity difference ni chini ya %4 katika hali zote mbili, RMSE ni chini ya 0.4 m/s, na Pearson correlation ni zaidi ya 0.98. Matokeo haya yanaonyesha kwamba analytical model inaweza kutoa large-scale velocity deficit na wake patterns zinazofanana chini ya reference hii iliyorahisishwa. Hayamaanishi kwamba high-frequency turbulence structures au aerodynamics halisi ya majengo zimetatuliwa kikamilifu.
Matokeo ya kiasi katika mazingira matano ya mijini
| Scenario | Mbinu | Wastani wa Urefu | SD ya Urefu | Wastani wa Surrogate ya Nishati | SD ya Nishati | Wastani wa Smoothness | SD ya Smoothness | Wastani wa Risk | SD ya Risk |
|---|---|---|---|---|---|---|---|---|---|
| S1 Ramani Iliyopo | Uniform RRT* | 1240.7 | 48.4 | 1807.99 | 101.84 | 0.086 | 0.013 | 0.224 | 0.048 |
| S1 Ramani Iliyopo | Wind-Shear Biased | 1183.4 | 52.2 | 1412.71 | 120.74 | 0.079 | 0.010 | 0.270 | 0.059 |
| S1 Ramani Iliyopo | Biased + Neural | 1122.2 | 50.9 | 1021.52 | 122.23 | 0.055 | 0.008 | 0.308 | 0.073 |
| S2 Manhattan | Uniform RRT* | 1293.5 | 43.8 | 1923.25 | 212.02 | 0.088 | 0.011 | 0.229 | 0.052 |
| S2 Manhattan | Wind-Shear Biased | 1226.8 | 46.9 | 1556.10 | 145.66 | 0.081 | 0.012 | 0.285 | 0.054 |
| S2 Manhattan | Biased + Neural | 1173.2 | 45.2 | 1121.87 | 121.25 | 0.057 | 0.009 | 0.331 | 0.066 |
| S3 Sparse Natural | Uniform RRT* | 1142.0 | 46.6 | 1643.63 | 186.79 | 0.084 | 0.012 | 0.184 | 0.052 |
| S3 Sparse Natural | Wind-Shear Biased | 1094.4 | 46.1 | 1201.93 | 178.61 | 0.076 | 0.010 | 0.222 | 0.057 |
| S3 Sparse Natural | Biased + Neural | 1063.3 | 48.4 | 1078.45 | 187.28 | 0.054 | 0.009 | 0.270 | 0.073 |
| S4 Dense Natural | Uniform RRT* | 1395.5 | 51.1 | 2145.55 | 123.92 | 0.095 | 0.012 | 0.259 | 0.053 |
| S4 Dense Natural | Wind-Shear Biased | 1320.8 | 44.0 | 1611.65 | 156.66 | 0.085 | 0.012 | 0.309 | 0.061 |
| S4 Dense Natural | Biased + Neural | 1261.4 | 44.8 | 1321.17 | 123.09 | 0.060 | 0.009 | 0.364 | 0.072 |
| S5 Downtown | Uniform RRT* | 1333.4 | 53.7 | 2012.64 | 189.90 | 0.088 | 0.014 | 0.251 | 0.057 |
| S5 Downtown | Wind-Shear Biased | 1306.2 | 42.2 | 1545.36 | 195.66 | 0.081 | 0.011 | 0.288 | 0.047 |
| S5 Downtown | Biased + Neural | 1276.4 | 43.6 | 1287.66 | 110.13 | 0.057 | 0.008 | 0.344 | 0.076 |
Matokeo yaliyo wazi zaidi katika jedwali ni kwamba Biased + Neural huzalisha average energy-surrogate ya chini na smoothness value ya chini kuliko Uniform RRT* katika mazingira yote matano. Kwa sababu ya scale iliyotumiwa na chanzo, smoothness value ya chini ina maana ya njia laini zaidi.
Hata hivyo, jedwali pia linaonyesha trade-off muhimu: katika mbinu ya Biased + Neural, average risk metric ni kubwa kuliko thamani ya Uniform RRT* katika scenarios zote tano. Kwa mfano, katika S1 inaongezeka kutoka 0.224 hadi 0.308, katika S2 kutoka 0.229 hadi 0.331, na katika S4 kutoka 0.259 hadi 0.364. Kwa hiyo, kutoa matokeo kama “nishati ilipungua na risk haikubadilika” hakungekuwa mwaminifu kwa data ya chanzo.
Maelezo ya waandishi ni kwamba kwa kuwa korido za upepo wa chini hutokea karibu na nyuso za majengo zilizo upande wa chini ya upepo, energy refiner hupunguza kwa kiasi fulani geometric clearance. Licha ya hilo, njia katika simuleringi zilibaki bila mgongano kwa sababu kila candidate point ilikaguliwa dhidi ya inflated safety buffer ya 5 m. Dhana ya “salama” hapa ipo tu ndani ya masharti ya deterministic map na fixed buffer; haijumuishi positioning error halisi, control deviation, au tracking error inayosababishwa na upepo.
Kupungua kwa urefu wa njia pia kunaonekana katika jedwali; lakini utafiti hauwasilishi hili kama lengo kuu la kinadharia la mbinu. Ufupishaji umetathminiwa kama matokeo ya pili ya neural shortcut na smoothing operations.
Tafsiri ya scenario ya uwakilishi yenye runs 50
Katika mazingira ya uwakilishi, Uniform RRT*, mpangaji mwenye upendeleo wa upepo, na hatua ya upendeleo wa upepo + neural refinement zililinganishwa kwa kutumia runs 50 huru za Monte Carlo. Katika plots za chanzo, full method hukusanyika katika eneo la chini la energy surrogate na pia katika eneo bora kwa smoothness. Pareto evaluation ilitumika kuchunguza trade-off kati ya nishati, urefu wa njia, smoothness na obstacle risk.
Kwa kuwa raw point data za 50 × method katika graphs hizi hazikuchapishwa kama jedwali ndani ya PDF, Verianla haizalishi upya graph points kwa kuzikadiria. Trend iliyoripotiwa na chanzo imewasilishwa kwa maandishi; data sahihi ya nambari imegeuzwa tena kuwa jedwali tu pale ambapo imewasilishwa wazi katika chanzo kama jedwali.
Usahihi wa surrogate ya mtandao wa neva na muda wa ukokotoaji
| Kategoria | Metriki/Mbinu | Thamani |
|---|---|---|
| Usahihi | RMSE | 0.6209 |
| Usahihi | MAE | 0.481 |
| Usahihi | R² | 0.894 |
| Ukokotoaji | Neural surrogate, wastani | 1.85 ms; 1.54 µs/point |
| Ukokotoaji | Original windCostField | 8.40 ms; 7.00 µs/point |
| Ukokotoaji | Original energyCostField | 24.60 ms; 20.50 µs/point |
| Speedup | ikilinganishwa na windCostField | takriban 4.5× |
| Speedup | ikilinganishwa na energyCostField | takriban 13.3× |
| Mafunzo | Mafunzo ya offline ya mara moja | takriban 12 s |
\(R^2=0.894\) inaonyesha kwamba surrogate network inaweza kukamata sehemu kubwa ya variation katika analytical cost field; hata hivyo, si ulinganifu kamili. RMSE 0.6209 na MAE 0.481 si sifuri. Kwa hiyo, network inapaswa kutathminiwa si kama physical-reality model inayochukua nafasi ya original analytical field moja kwa moja, bali kama approximate function yenye gharama ndogo ya kukokotoa.
Speed comparison ni mahususi kwa implementation katika mazingira ya utafiti. Thamani za 4.5× na 13.3× si lazima zipatikane sawa kwenye processor, software, network size au implementation nyingine.
Hoja ambazo hazina thamani wazi ya nambari au hazijafafanuliwa kikamilifu katika utafiti
Chanzo kinatoa milinganyo ya mbinu kwa undani; hata hivyo, katika maandishi ya PDF yaliyokaguliwa, baadhi ya settings mahususi za utafiti hazina thamani moja wazi ya nambari. Hizi ni pamoja na exponent ya wind bias \(\eta_b\), mixing coefficient \(\lambda_b\), goal-sampling probability \(p_{\mathrm{goal}}\), \(z_{\mathrm{lo}}\) na \(z_{\mathrm{hi}}\) kwa majaribio yote, RRT* radius parameter \(\gamma\), idadi halisi ya samples/iterations katika planner, regularization coefficient \(\lambda\), Levenberg–Marquardt damping parameter \(\mu\), densification spacing \(\delta_s\), vipengele vyote vya nambari vya directional offsets nane \(\Delta_q\), na idadi halisi ya smoothing passes. Sehemu hizi hazijakadiriwa na Verianla.
Zaidi ya hayo, katika paragraph moja ya chanzo inayoorodhesha no-fly zones, kauli “NFZ-1” inaonekana mara mbili; maelezo na visuals za baadaye zinaonyesha maeneo manne kutoka NFZ-1 hadi NFZ-4. Kwa hiyo, badala ya kubuni namba tofauti ya eneo ambayo haijathibitishwa, Verianla imetumia kauli “maeneo manne ya no-fly”.
Matokeo yanasema nini kisayansi
Matokeo yanayoungwa mkono na utafiti ni kwamba, chini ya analytical urban-wind model iliyotumiwa na ufafanuzi wa energy surrogate uliotumiwa, kuingiza taarifa ya upepo katika sampling distribution na kisha kuboresha njia kwa neural cost surrogate kunaweza kuzalisha energy-surrogate values za chini na njia laini zaidi. Wind-biased sampler huchangia kutafuta maeneo yanayofaa zaidi, huku neural stage ikichangia kwa njia tofauti katika kufupisha njia iliyopatikana na kupunguza curvature yake.
Matokeo ambayo utafiti hauungi mkono ni muhimu angalau kwa kiwango hicho. Utafiti haukupima maisha halisi ya betri ya quadrotor; haukuonyesha ongezeko la flight time kwa asilimia maalum; haukufanya field validation katika anga halisi ya jiji; haukujaribu closed-loop flight control; haukumodeli positioning error au real-time sensor uncertainty; haukutatua uga mzima wa jiji kwa high-resolution CFD au LES; wala haukuthibitisha obstacle-risk score kama uwezekano halisi wa mgongano.
Kwa hiyo, utafiti huu una thamani kama uthibitishaji wa mbinu katika kiwango cha upangaji; si uthibitishaji wa mwisho wa usalama halisi wa uendeshaji wa UAM au faida halisi ya betri.
Maelezo ya Chanzo na Mbinu
Kichwa asilia: Wind-Aware RRT* with Neural Energy Refinement for Energy-Efficient Urban Air Mobility
Waandishi: Farhad Bagheri; Mohammadali Amiri Atashgah; Morteza Ebrahimi.
Mpangilio wa waandishi: Farhad Bagheri → Mohammadali Amiri Atashgah → Morteza Ebrahimi.
Mchango sawa: Chanzo hakina tamko la mchango sawa.
Mwandishi wa mawasiliano: Mohammadali Amiri Atashgah.
Taasisi 1: School of Aerospace Engineering, University of Tehran, Tehran 1439957131, Iran.
Taasisi 2: School of Intelligent Systems, University of Tehran, Tehran 1439957131, Iran.
Eneo: Uhamaji wa anga mijini, upangaji wa njia za ndege zisizo na rubani, sampling-based motion planning, urban wind modeling, na trajectory refinement kwa msingi wa artificial neural network.
Aina ya chanzo: Makala asilia ya utafiti; utafiti wa mbinu unaotegemea nambari/simuleringi.
Hali ya peer review: Algorithms huchapishwa na MDPI kama peer-reviewed open-access scientific journal. Utafiti uliowasilishwa ulikubaliwa na kuchapishwa kama Version of Record; si preprint.
Jarida: Algorithms.
Mchapishaji/jukwaa: MDPI.
Mwaka: 2026.
Juzuu / toleo / nambari ya makala: 19 / 8 / 652.
DOI: 10.3390/a19080652
Tarehe ya kupokelewa: 1 Julai 2026.
Tarehe ya marekebisho: 27 Julai 2026.
Tarehe ya kukubaliwa: 30 Julai 2026.
Tarehe ya kuchapishwa: 6 Agosti 2026.
Mhariri wa kitaaluma: Massimiliano Caramia.
Kiungo rasmi: https://doi.org/10.3390/a19080652
Leseni: Creative Commons Attribution 4.0 International (CC BY 4.0). Hakimiliki inabaki kwa waandishi na makala imechapishwa na MDPI kwa open access.
Mbinu: Eneo la simuleringi la pande tatu la 1200 × 1200 × 220 m; occupancy-map resolution ya 0.5 m; power-law wind shear; mzunguko wa mwelekeo wa aina ya Ekman; frozen turbulence kwa Fourier modes; building-wake attenuation model; wind-biased RRT* sampling; feedforward ReLU network yenye hidden layers [64, 48, 32, 16]; Levenberg–Marquardt training; %85/%15 training-validation split; neural shortcut na Laplacian/energy smoothing; deterministic collision gate.
Programu: MATLAB 2023b.
Mpangilio mkuu wa majaribio: Runs 50 huru za Monte Carlo katika representative scenario. Pia, tathmini 10 za Monte Carlo ziliripotiwa kwa kila moja ya mazingira matano tofauti.
Mbinu za kulinganisha: RRT, Goal-Biased RRT, Informed RRT*, BIT*; pia hatua za Uniform RRT*, Wind-Shear Biased na Biased + Neural zililinganishwa.
Ufadhili: Utafiti haukupokea ufadhili wa nje.
Upatikanaji wa data: Data zilizalishwa kwa numerical simulations zinazotumia MATLAB. Kwa mujibu wa tamko la waandishi, datasets zilizozalishwa zinapatikana kutoka kwa mwandishi wa mawasiliano kwa ombi linalofaa; hakuna public dataset iliyotumiwa.
Michango ya waandishi: Uundaji wa dhana: Farhad Bagheri na Morteza Ebrahimi. Mbinu, programu, formal analysis, investigation, data curation, uandishi wa draft ya kwanza na visualization: Farhad Bagheri. Validation: Farhad Bagheri na Morteza Ebrahimi. Review na editing: Farhad Bagheri na Mohammadali Amiri Atashgah. Supervision na project administration: Mohammadali Amiri Atashgah.
Shukrani/tamko: Waandishi waliripoti kwamba walitumia zana inayotegemea artificial intelligence kwa language editing na grammar correction, na kwamba wanabeba wenyewe wajibu wa maudhui ya makala.
Mgongano wa maslahi: Waandishi wametangaza kuwa hakuna mgongano wa maslahi.
Mipaka mikuu ya kimethodolojia: Hakuna closed-loop vehicle dynamics wala flight control. Energy metric si matumizi halisi ya betri bali ni aerodynamic energy-cost surrogate. Analytical wind na building-wake model hazitatui utata wote wa high-resolution real urban atmosphere. Obstacle clearance si independent primary optimization objective. Positioning uncertainty, wind-induced tracking deviation na control uncertainty hazijajumuishwa katika modeli.
Hoja ya tahadhari ndani ya chanzo 1: Downstream factor iliyochapishwa katika Mlinganyo (24) na simulizi la “downstream recovery” katika sehemu hiyo hiyo hazionekani kuendana kikamilifu kwa tabia ya kihisabati. Verianla haijabadilisha formula ya chanzo.
Hoja ya tahadhari ndani ya chanzo 2: Ingawa katika utangulizi cost field inaelezwa mahali fulani kwa ujumla kama mchanganyiko wa upepo, obstacle clearance na altitude, Mlinganyo rasmi uliotekelezwa wa (38) una umbo \(c_E=c_W+c_P\); altitude si term ya tatu iliyo huru, bali huathiri kwa njia isiyo ya moja kwa moja kupitia \(V(z)\) na \(T_i(z)\).
Hoja ya tahadhari ndani ya chanzo 3: Ingawa nafasi ya kiishara ya baadhi ya planner na refinement hyperparameters imeelezwa, thamani moja ya nambari iliyotumiwa katika jaribio haijaripotiwa katika maandishi ya PDF yaliyokaguliwa. Thamani hizi hazijakadiriwa na Verianla.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *