


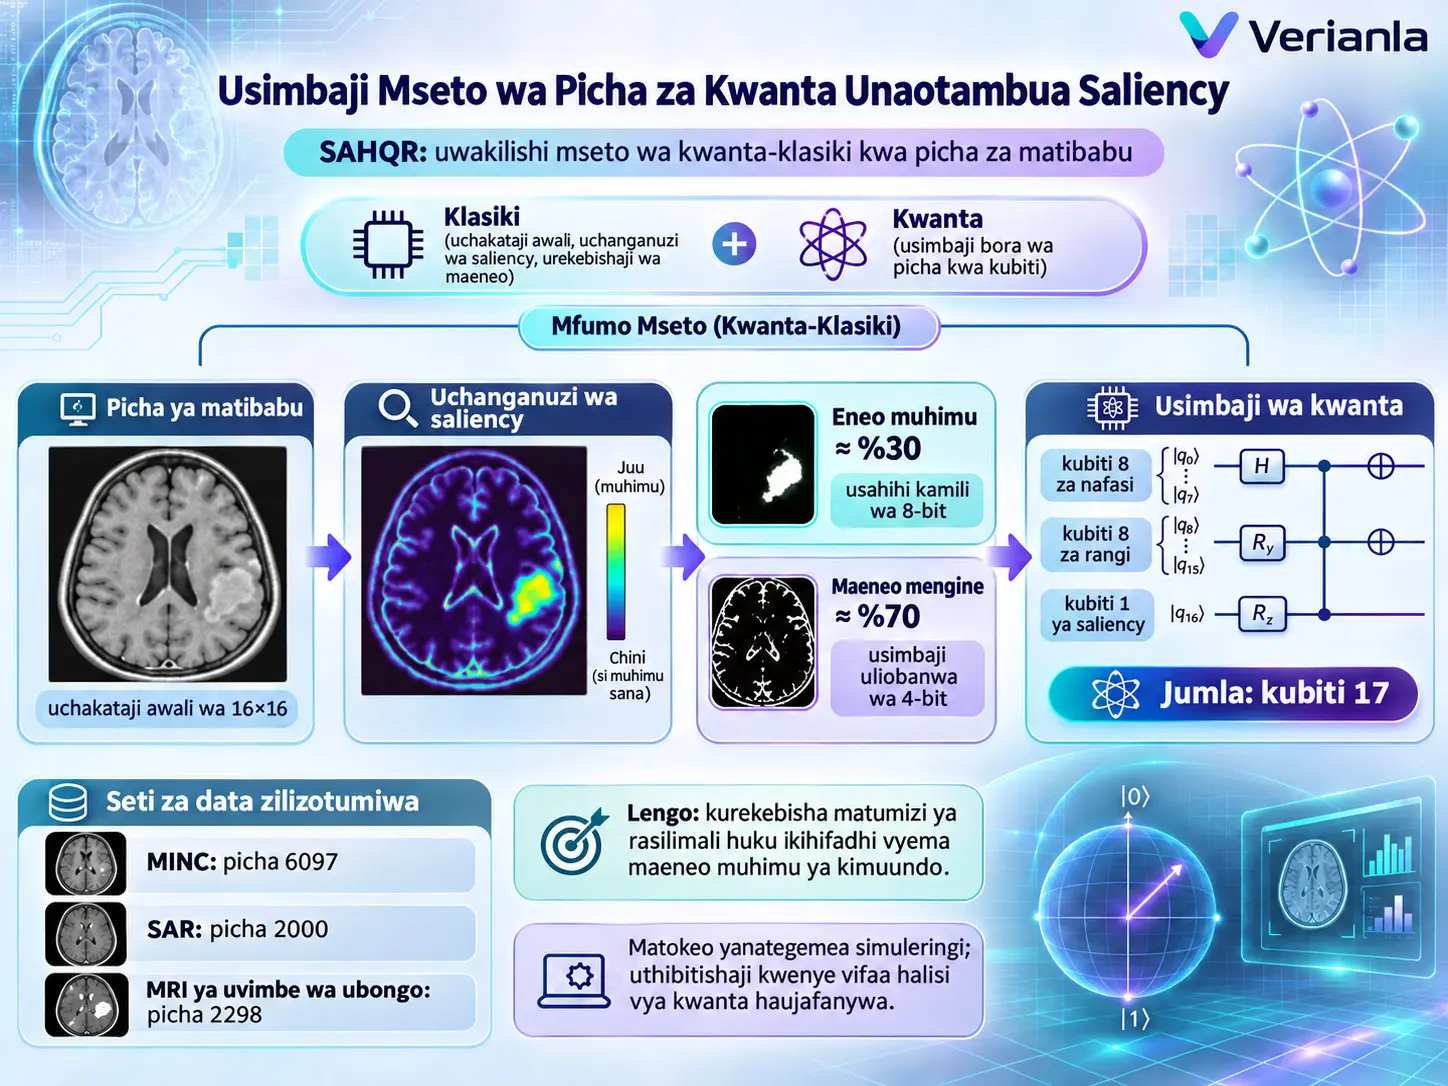
Saliency-Aware Hybrid Quantum Image Representation (SAHQR) ni mbinu mseto ya uwakilishi wa picha ya kwanta ambayo, badala ya kusimba maeneo yote ya picha katika hali ya kwanta kwa usahihi sawa, hutumia uchanganuzi wa kawaida wa saliency unaotegemea gradient kubaini maeneo yanayojitokeza kimuundo na kubadilisha usahihi wa usimbaji wa kwanta kulingana na taarifa hiyo ya umuhimu wa eneo. Katika utafiti, maeneo salient huwakilishwa kwa usahihi kamili wa 8-bit, huku maeneo non-salient yakiwakilishwa kwa usahihi uliobanwa wa 4-bit; pia qubit moja ya saliency hutumika kuonyesha kama eneo ni salient au la. Mbinu hiyo imelinganishwa na mbinu kumi zilizopo za uwakilishi wa picha ya kwanta na kutathminiwa kwa picha 6097 za matibabu za MINC, tile 2000 za Synthetic Aperture Radar (SAR), na picha 2298 za Brain Tumor MRI, jumla ya picha 10.395.
Katika majaribio ya MINC, picha zote zilibadilishwa kuwa pikseli 16×16 na kiwango cha kijivu cha 8-bit. Katika azimio hili SAHQR hutumia qubit 17: position qubit nane, color qubit nane na saliency flag qubit moja. Chanzo kinaripoti uwiano wa wastani wa salient-pixel katika picha za MINC kuwa %29,85. Kwa hiyo takribani %30 ya picha huwakilishwa kwa usahihi kamili wa 8-bit na takribani %70 kwa usimbaji uliobanwa wa 4-bit. Modeli ya kinadharia ya gate-count ya waandishi huhesabu takribani gate 1329,6 kwa muundo huu; baada ya Qiskit decomposition na optimization, wastani wa majaribio ulioripotiwa ni gate 346,12, circuit depth wastani 339,12 na muda wastani wa circuit-construction/encoding wa 33,15 ms.
Hata hivyo, SAHQR si mbinu bora katika kila kipimo cha chanzo. Kwa mfano, 2D-QSNA na QPIE hutumia qubit nane tu; encoding time wastani ya 2D-QSNA ni 0,82 ms na thamani ya compression katika jedwali la chanzo ni 256. Mchango mahsusi wa SAHQR si kupata idadi ya chini kabisa ya qubit, depth ya chini kabisa au gate chache zaidi; ni kuongeza utaratibu wa ugawaji wa rasilimali unaoweza kubadilisha usahihi wa usimbaji kulingana na maudhui ya picha. Chanzo pia kinasema wazi kwamba utafiti unapaswa kufasiriwa si kama uwakilishi bora wa picha kwa kila hali, bali kama proof of concept kwa saliency-aware quantum encoding.
Mizunguko ya kwanta katika utafiti haikuendeshwa kwenye kichakataji halisi cha kwanta. Hesabu kuu zilifanywa kwa Qiskit 0.45.0 statevector simulator kwenye Google Colab, huku uchanganuzi wa depolarizing noise, amplitude damping na readout error ukifanywa kwa uigaji wa Qiskit Aer noise model. Uthibitishaji kwenye vifaa halisi vya IBM Quantum, IonQ au Rigetti haukuwa ndani ya upeo wa utafiti na waandishi wanautaja kama kazi ya baadaye. Kwa hiyo matokeo hayapaswi kufasiriwa kama ushahidi wa ubora wa real quantum-hardware au matumizi ya kliniki.
Kikomo kingine muhimu kwa matumizi ya kitabibu ni kwamba utaratibu wa saliency uliotumika si ramani ya umuhimu wa kliniki iliyofafanuliwa na daktari au modeli ya segmentation. Saliency hutegemea ukubwa wa Sobel gradient na kimsingi hushika kingo, mipaka na contrast ya ndani. Kwa hiyo lebo “salient” katika chanzo si sawa na “eneo la uvimbe ambalo kwa hakika ni muhimu kwa utambuzi”. Waandishi pia wanaeleza kwamba uthibitishaji tofauti kwa kutumia annotations za wataalamu au segmentation mask unahitajika kwa umuhimu wa kliniki.
Tatizo kuu la utafiti
Katika uchakataji wa picha za kwanta, tatizo la kwanza ni jinsi ya kuiwakilisha picha yenyewe katika hali ya kwanta. Katika kompyuta ya kawaida, thamani na nafasi ya pikseli zinaweza kuhifadhiwa moja kwa moja kwa mfuatano wa biti. Katika kompyuta ya kwanta, nafasi, intensity, rangi au sifa nyingine za picha zinaweza kusimbwa katika computational basis states za qubit, probability amplitude au rotation angle.
Mbinu nyingi zilizopo huchakata pikseli zote kwa namna sawa bila kuangalia maudhui ya picha. Swali la utafiti wa chanzo ni hili: je, inawezekana kutambua mapema maeneo ya picha yaliyo muhimu kimuundo na kutenga sehemu kubwa zaidi ya rasilimali za kwanta kwa maeneo hayo?
Jibu la SAHQR ni muundo mseto. Saliency detection hufanywa kwenye kompyuta ya kawaida; saliency mask inayopatikana kisha hudhibiti ni pikseli ipi itawakilishwa kwa usahihi kamili au uliopunguzwa katika usimbaji wa picha ya kwanta.
Uwakilishi wa Picha ya Kwanta ni Nini?
Uwakilishi wa picha ya kwanta ni ulinganishaji unaosimba taarifa ya nafasi, intensity au rangi katika picha ya kidijitali ya kawaida kwenda kwenye basis states, amplitudes au rotation angles za hali fulani ya kwanta; lengo si tu kutumia qubit chache, bali pia kudhibiti gharama za state-preparation, circuit depth, gate count, retrieval na fidelity wakati wa kuiandaa picha kwa matumizi katika operesheni za kwanta zinazofuata.
Qubit ni nini?
Chanzo hutoa hali safi ya qubit moja kama
.
Hapa \(\alpha\) na \(\beta\) ni amplitude changamani za uwezekano na hutimiza
sharti la urekebishaji. Kipimo kinapofanywa, uwezekano wa matokeo \(|0\rangle\) ni \(|\alpha|^2\), na uwezekano wa matokeo \(|1\rangle\) ni \(|\beta|^2\).
Kikomo cha ufafanuzi: Ukweli kwamba nafasi ya hali ya qubit \(n\) ina ukubwa \(2^n\) haumaanishi kuwa thamani zote \(2^n\) za kawaida zinaweza kusomwa katika kipimo kimoja. Wakati wa kutathmini gharama halisi ya uwakilishi wa picha ya kwanta, gharama za state preparation na measurement/retrieval pia ni muhimu.
FRQI: Kusimba intensity ya pikseli kwenye pembe
Flexible Representation of Quantum Images (FRQI) huwakilisha picha ya kijivu ya \(2^n\times2^n\) kama
.
\(g_i\) ni kiwango cha kijivu kati ya 0–255. Nafasi ya pikseli huwakilishwa kwa position qubit \(2n\), na intensity kwa rotation angle ya color qubit moja.
Chanzo kinatoa qubit \(2n+1\), controlled rotation gate \(O(2^{2n})\), na katika hali mbaya zaidi circuit depth \(O(2^{2n})\) kwa FRQI.
NEQR: Kusimba intensity ya pikseli kwenye computational basis
\(|C_{yx}\rangle\) hubeba thamani ya kiwango cha kijivu ya \(q\)-bit ya pikseli kwenye computational basis. Tofauti muhimu ya NEQR dhidi ya FRQI ni kwamba huwakilisha intensity kama mfuatano wazi wa biti badala ya rotation angle.
Chanzo kinaripoti qubit \(2n+q\) na takribani gate/depth complexity \(O(q\,2^{2n})\) kwa NEQR.
GQIR: Vipimo holela vya picha
Generalized Quantum Image Representation (GQIR) inalenga kusaidia vipimo vya jumla vya \(M\times N\), badala ya kuishia kwenye picha za mraba ambazo vipimo vyake ni nguvu za mbili.
MCQI: Uwakilishi tofauti wa njia za RGB
Multi-Channel Quantum Image (MCQI) hubeba njia nyekundu, kijani na buluu katika quantum register tofauti. Matokeo yake ni kuongezeka kwa matumizi ya rasilimali.
QRMW: Picha za mawimbi mengi
\(K\) inaonyesha idadi ya spectral-band. QRMW hutumia band-selection register ya ziada kwa taarifa ya multi-spectral/hyperspectral.
EFRQI: Kutumia amplitude na phase pamoja
Enhanced FRQI hutumia usimbaji uliopanuliwa wa angle/phase unaobeba taarifa ya picha katika vigezo \(\theta_i\) na \(\phi_i\) kwa pamoja.
2D-QSNA: Amplitude encoding
Hapa thamani za pikseli za kawaida hurekebishwa na kuwekwa moja kwa moja kwenye quantum-state amplitude. Chanzo kinatoa uwakilishi wa qubit nane kwa pikseli 256; hata hivyo, kwa kuwa gharama ya state preparation katika amplitude encoding inaweza kufichwa katika fomula za kinadharia, kulinganisha gate-count kati ya mbinu kunahitaji tafsiri ya tahadhari. Makala pia inaeleza kikomo hiki katika sehemu yake ya cost-model.
INEQR
Chanzo kinachukulia INEQR kama aina iliyoboreshwa ya usimbaji wa njia za rangi katika familia ya NEQR.
QPIE: Uwakilishi wa probability-amplitude
ambapo \(p_i\) ni thamani ya uwezekano iliyorekebishwa kutoka intensity za pikseli.
QLR: Kuratibu za log-polar
Quantum Log-Polar Representation (QLR) inalenga kutoa muundo unaofaa kwa operesheni za rotation-invariant kwa kuwakilisha picha katika kuratibu za log-polar badala ya nafasi ya Cartesian.
| Mbinu | Qubit | Gate complexity | Depth |
|---|---|---|---|
| FRQI | \(2n+1\) | \(O(2^{2n})\) | \(O(2^{2n})\) |
| NEQR | \(2n+q\) | \(O(q2^{2n})\) | \(O(q2^{2n})\) |
| GQIR | \(2n+q\) | \(O(MN)\) | \(O(MN)\) |
| MCQI | \(2n+3q\) | \(O(3q2^{2n})\) | \(O(3\cdot2^{2n})\) |
| QRMW | \(2n+\log K+q\) | \(O(Kq2^{2n})\) | \(O(K2^{2n})\) |
| EFRQI | \(2n+1\) | \(O(2^{2n})\) | \(O(2^{2n})\) |
| 2D-QSNA | \(\log N\) | \(O(N)\) | \(O(\log N)\) |
| INEQR | \(2n+3q\) | \(O(3q2^{2n})\) | \(O(2^{2n})\) |
| QPIE | \(\log N\) | \(O(N)\) | \(O(N)\) |
| QLR | \(2n+q\) | \(O(q2^{2n})\) | \(O(2^{2n})\) |
Ulinganishaji wa jumla wa picha ya kwanta
Utafiti hufafanua hali safi ya kwanta ya vipimo \(2^n\) kama
na kuainisha quantum image representation kama ulinganishaji unaobadilisha picha ya kawaida \(I\) kuwa hali ya kwanta \(|I\rangle\)
.
Tatizo la uboreshaji wa malengo mengi
Fomula inahesabu nini? Inaruhusu uchaguzi wa quantum image representation kuzingatia si kipimo kimoja tu, bali uwiano wa gharama wenye uzani kati ya qubit, circuit depth, gate count na encoding time.
\(Q\): idadi ya qubit zinazohitajika. \(D\): circuit depth. \(G\): gate count. \(T\): encoding time. \(\lambda_1,\ldots,\lambda_4\) ni uzani unaobainisha umuhimu wa jamaa wa gharama hizi.
Kikomo cha chanzo: Katika majaribio ya makala, hakuna thamani maalum za nambari zilizoboreshwa zinazoripotiwa kwa uzani huu wa \(\lambda_i\). Mlinganyo ni zaidi ufafanuzi rasmi wa tatizo.
Kizuizi cha Fidelity
\(g_{yx}\) ni thamani ya pikseli ya awali, \(\widetilde g_{yx}\) ni thamani ya pikseli iliyopatikana upya, na \(\tau\) ni kizingiti cha chini kinachokubalika cha fidelity. Ufafanuzi huu wa fidelity si dhana ileile kabisa na quantum-state fidelity; chanzo hapa kinatumia kipimo cha image-fidelity kinachofafanuliwa kupitia usahihi wa ujenzi upya wa pikseli.
Fidelity yenye uzani wa saliency
Mlinganyo huu hufanya makosa katika pikseli zenye thamani kubwa ya saliency kuwa muhimu zaidi badala ya kuipa kila pikseli uzani sawa. Kwa hiyo lengo la kihisabati la SAHQR si “ubora sawa kila mahali”, bali kulinda ubora kwa nguvu zaidi katika maeneo yanayochukuliwa kuwa muhimu.
Mzunguko wa kwanta
Circuit depth ni njia ndefu zaidi ya gate-layer kutoka ingizo hadi pato; gate count ni idadi ya elementary operation katika mzunguko.
Ufafanuzi wa compression-ratio wa chanzo
Ufafanuzi huu hugawanya ukubwa wa kawaida wa biti \(M\times N\times q\) wa picha ya kawaida kwa idadi ya qubit \(n\) katika uwakilishi wa kwanta.
Kikomo muhimu cha tafsiri: Uwiano huu si kipimo cha moja kwa moja cha vifaa kinachothibitisha kuwa kumbukumbu ya kimwili ya quantum computer ni ndogo kuliko RAM ya kawaida kwa uwiano huo huo. Kuandaa, kudhibiti na kusoma hali ya kwanta kwa namna ya kawaida kuna gharama zake pia. Mlinganyo ni representation-resource metric ya utafiti wenyewe.
Tatizo la nambari ndani ya chanzo: Ingawa Mlinganyo (18) na Jedwali 5 hutoa ufafanuzi huu, nambari za “Compress.” katika Jedwali 7 hazilingani moja kwa moja na fomula hii. Zaidi ya hayo, kwa SAHQR, Jedwali 7 linaripoti 3,18 huku Jedwali 10 la compression ya kawaida likiripoti 9:1. Chanzo hakielezi vya kutosha kama thamani hizi tofauti zinatokana na ufafanuzi uleule au tofauti wa compression. Kwa hiyo thamani hizi hazipaswi kubadilishwa moja kuwa nyingine.
Scalability factor
Hiki ni kipimo rahisi cha rasilimali maalum kwa makala: representation inayotumia qubit chache hupata scalability score ya juu. Si kipimo cha jumla cha scalability ya kwanta; hakijumuishi athari nyingine za vifaa kama topology, gate fidelity, connectivity, state-preparation cost na error correction.
SAHQR ni Nini na Inagawaje Rasilimali za Kwanta?
SAHQR ni uwakilishi mseto wa picha ya kwanta unaozingatia maudhui, ambao hutenganisha picha katika maeneo salient na non-salient kwa kutumia ramani ya saliency inayotokana na Sobel gradients; huwakilisha pikseli salient kwa usahihi kamili wa 8-bit, pikseli non-salient kwa usimbaji uliobanwa wa 4-bit, na kuweka njia hizi mbili za usimbaji chini ya masharti kupitia saliency flag qubit moja katika mzunguko wa kwanta.
Utenganishaji wa kihisabati wa maeneo salient na non-salient
\(\Omega_S\) inaonyesha seti ya pikseli salient, \(\Omega_N\) seti ya pikseli non-salient, na \(\theta_s\) saliency threshold.
Hali ya kwanta ya SAHQR
Qubit ya mwisho ni saliency flag. \(|1\rangle\) inaonyesha eneo salient; \(|0\rangle\) inaonyesha eneo non-salient. Kwa hiyo precision regime mbili tofauti zipo ndani ya quantum state ileile.
Saliency inahesabiwaje?
\(S(y,x)\) ni thamani ya saliency iliyorekebishwa kati ya 0 na 1.
Opereta ya Sobel ya mlalo:
Opereta ya Sobel ya wima:
\(*\) inaonyesha operesheni ya convolution kati ya picha na kernel. Sobel gradient inapokuwa kubwa, intensity hubadilika haraka katika eneo hilo; kwa kawaida hii huashiria kingo au mpaka.
Kikomo cha kliniki: Ukubwa wa gradient hauchukui nafasi ya mtaalamu wa pathology, radiology au segmentation ya kitaalamu. Ukweli kwamba mpaka unaonekana wazi hauumaanishi lazima kuwa ndio eneo muhimu zaidi kwa utambuzi.
Adaptive threshold
\(\mu_S\) ni wastani wa thamani za saliency; \(\sigma_S\) ni mkengeuko wa kawaida. Chanzo kinatoa \(\alpha=0\) kama default.
Tatizo la uwazi ndani ya chanzo: Katika sehemu ya Dataset-statistics pia kuna kauli “saliency threshold \(\theta_s=0.5\) (adaptive)”. Hata hivyo, Mlinganyo (26) katika sehemu ya Method huunganisha threshold na mean saliency ya picha kwa default \(\alpha=0\). Chanzo hakielezi kwa kina jinsi kauli hizi mbili za threshold zilivyopatanishwa katika picha zote.
Usimbaji wa 8-bit wa eneo salient
Kwa kuwa \(q=8\) katika sehemu hii, kiwango cha kijivu cha 0–255 huwakilishwa kwa biti nane.
Usimbaji wa 4-bit wa eneo non-salient
Algorithimu ya chanzo huhesabu thamani iliyobanwa kama
. Operesheni hii hupunguza masafa ya 0–255 hadi masafa ya 0–15 yenye viwango 16. Kwa hiyo quantization ya biti nne hutumika kwa pikseli non-salient.
Usimbaji wa kwanta wenye masharti
\(U_{\mathrm{full}}\) ni position-controlled encoding unitary ya usahihi kamili; \(U_{\mathrm{comp}}\) ni toleo lililobanwa.
Qubit 17 zinapatikanaje?
Kwa picha ya 16×16, biti \(n=4\) zinahitajika kuwakilisha kila mhimili. Nafasi \(x\) na \(y\) hutumia position qubit nane kwa jumla. Qubit nane za color na qubit moja ya saliency zikiongezwa, jumla huwa qubit 17.
Modeli ya kinadharia ya gate-count
\(r\) ni uwiano wa salient-pixel:
Katika jaribio la chanzo
Kwa hiyo:
Ukweli kwamba 1329,6 ni nambari yenye sehemu haumaanishi kuwa mzunguko wa kimwili una “0,6 gate”; matokeo yana sehemu kwa sababu ni makadirio ya gate-count inayotarajiwa yaliyohesabiwa kutoka uwiano wa wastani wa salient.
Kwa nini gate ya kinadharia ni 1329,6 lakini wastani uliopimwa ni 346,12?
Chanzo hutoa hesabu ya kinadharia katika kiwango cha pre-decomposition. Kisha mbinu zote hufanyiwa transpile kwa Qiskit kwenda kwenye \(\{u3,cx\}\) basis gate set na optimization level 3 hutumika. Gate cancellation, merging na kuondolewa kwa redundant controlled-operation hubadilisha matokeo.
| Hatua | Idadi ya Gate |
|---|---|
| Thamani ghafi / pre-decomposition ya kinadharia | 1329,6 |
| Baada ya Decomposition | 1872 |
| Wastani baada ya Optimization | 346,12 |
Ni kawaida gate count kuongezeka kwanza baada ya decomposition; logical operation kubwa/zenye udhibiti mwingi hugawanywa kuwa basis gate ndogo. Baadaye transpiler huunganisha au kufuta sehemu kubwa ya gate hizo.
Uskalishaji wa Circuit depth
Katika dataset ya MINC, chanzo kinatoa circuit depth wastani wa 339,12. Ingawa depth ya mzunguko mmoja ni nambari kamili, wastani wa picha 6097 unaweza kuwa na sehemu.
Mbinu na Matokeo ya Utafiti
Seti za data
| Eneo la data | Idadi ya picha | Muundo / sifa ya chanzo | Azimio la tathmini ya kwanta |
|---|---|---|---|
| MINC Medical | 6097 | Picha za matibabu za MINC kutoka folda 13 | 16×16, kiwango cha kijivu cha 8-bit |
| ICEYE SAR | 2000 | Data ya SAR amplitude iliyogawanywa kuwa tile 256×256 ya 16-bit | 16×16, kiwango cha kijivu cha 8-bit |
| Brain Tumor MRI | 2298 | T1-weighted contrast-enhanced; glioma, meningioma, pituitary | Kutoka 512×512 hadi 16×16 |
Jumla ya picha katika maeneo matatu ya data:
Uchakataji wa awali wa MINC
- Faili za MINC hupakiwa kwa nibabel.
- 2B slice hutolewa kutoka picha volumetric.
- Thamani za intensity hurekebishwa kwenye masafa ya 0–255.
- Picha hubadilishwa ukubwa hadi pikseli 16×16.
- Data hubadilishwa kuwa muundo unsigned 8-bit integer.
Kwa dataset ya MINC chanzo kinatoa intensity wastani \(\mu=127.3\), mkengeuko wa kawaida \(\sigma=58.7\), intensity range 0–255 na jumla ya pikseli zilizochakatwa 1.560.832.
Usambazaji wa Saliency
Uwiano wa wastani wa salient katika MINC:
Mkengeuko wa kawaida wa salient-ratio katika chanzo:
unaripotiwa. Usambazaji huu mdogo unaonyesha kwamba ukubwa wa gradient-based saliency mask katika picha 6097 preprocessed za MINC ulikuwa unaofanana sana.
Mazingira ya kompyuta
| Kipengele | Thamani |
|---|---|
| Platform | Google Colab, Ubuntu 22.04 |
| GPU | NVIDIA Tesla T4 |
| Lugha ya programu | Python 3.10 |
| Kvant framework | Qiskit 0.45.0 |
| Image processing | NumPy 1.26.4, SciPy 1.11.4, nibabel 5.2.0 |
| Uoneshaji | Matplotlib 3.8.2 |
| Quantum backend kuu | Statevector simulator |
Jumla ya majaribio
Tathmini ya picha 6097 za MINC kwa mbinu 11:
huzalisha encoding operation. Matokeo yaliwekwa checkpoint kila picha 500.
Vigezo kumi vya tathmini
| ID | Kigezo | Njia ya hesabu katika chanzo |
|---|---|---|
| P1 | Qubit zinazohitajika | circuit.num_qubits |
| P2 | Circuit depth | circuit.depth() |
| P3 | Gate count | len(circuit.data) |
| P4 | Encoding time | Wall-clock time, ms |
| P5 | Scalability factor | \(100/n\) |
| P6 | Information loss | \(1-\mathrm{SSIM}(I,\widetilde I)\) |
| P7 | Compression ratio | \(M\times N\times q/n\) |
| P8 | Memory overhead | \(100n/n_{\mathrm{FRQI}}\) |
| P9 | Gate complexity | Gate count / num_qubits |
| P10 | Implementation score | Ugumu wa algorithimu, 1–5 |
Dokezo la chanzo: Ingawa Abstract inasema “ten criteria”, gate count haionekani kama kipengele tofauti katika orodha ya maneno huko; Table 2 na Table 5 hufafanua wazi vigezo kumi kama P1–P10. Verianla imetumia majedwali ya mbinu kama msingi.
Matokeo makuu ya mbinu 11 kwenye MINC
| Mbinu | Qubit | Gate, wast. ± ss | Depth | Muda (ms) | Chanzo “Compress.” | Gate complexity | Memory (%) | Implementation |
|---|---|---|---|---|---|---|---|---|
| FRQI | 9 | 121.61 ± 15.60 | 113.61 | 1.66 | 2.06 | 13.51 | 100.0 | 2 |
| NEQR | 16 | 312.38 ± 67.26 | 305.38 | 31.10 | 0.45 | 19.52 | 177.8 | 3 |
| GQIR | 12 | 97.96 ± 36.37 | 90.96 | 9.79 | 2.41 | 8.16 | 133.3 | 3 |
| MCQI | 18 | 923.13 ± 201.77 | 914.13 | 92.24 | 0.13 | 51.28 | 200.0 | 4 |
| QRMW | 18 | 1977.72 ± 254.19 | 312.16 | 20.62 | 0.37 | 109.87 | 200.0 | 4 |
| EFRQI | 9 | 87.97 ± 20.80 | 79.97 | 1.54 | 3.15 | 9.77 | 100.0 | 3 |
| 2D-QSNA | 8 | 3.74 ± 0.49 | 1.00 | 0.82 | 256.0 | 0.47 | 88.9 | 4 |
| INEQR | 16 | 341.69 ± 84.11 | 334.69 | 40.52 | 0.51 | 21.35 | 177.8 | 3 |
| QPIE | 8 | 4.21 ± 0.84 | 1.00 | 0.95 | 256.0 | 0.53 | 88.9 | 4 |
| QLR | 18 | 1944.38 ± 312.11 | 310.15 | 20.15 | 0.38 | 108.02 | 200.0 | 4 |
| SAHQR | 17 | 346.12 ± 71.30 | 339.12 | 33.15 | 3.18 | 21.63 | 177.8 | 3 |
Jedwali hili linaonyesha wazi kwa nini SAHQR haipaswi kuwasilishwa kama “bora kwa kila jambo”. Kuna mbinu za bei nafuu zaidi kwa qubit, gate, depth na encoding time. Sifa inayotofautisha SAHQR ni utaratibu wa content-aware differential precision.
Ujumbe wa kisayansi wa Figure 14–17
Chanzo katika Figure 14 hulinganisha performance metric kumi kwa mbinu 11 kwa upande mmoja; inasemekana SAHQR ina wasifu ulio na uwiano lakini si bora kwenye kila mhimili. Figure 15 hubadilisha ulinganisho huo kuwa radar graph iliyorekebishwa 0–1. Figure 16 huonyesha correlation kati ya profaili za metric za mbinu na chanzo huripoti takribani 0,90 correlation kati ya SAHQR na familia ya NEQR. Figure 17 huonyesha usambazaji wa salient ratio, uhusiano wa gate-count, ulinganisho wa gate wa SAHQR–NEQR na tabia kati ya folda 13 za MINC.
Kwa kuwa mfululizo wote wa pointi ghafi wa grafu hizi haujatolewa kama jedwali katika maandishi ya makala, Verianla haitoi thamani mpya za kati kutoka kwenye pikseli.
Uchanganuzi wa takwimu
Chanzo kinaeleza kwamba kilitumia descriptive statistics, independent t-test, significance threshold na Cohen's \(d\) effect size. Ulinganisho wote katika Table 9 umewekewa
.
| Ulinganisho | Metriki | t | Cohen's d | %95 CI ya chanzo |
|---|---|---|---|---|
| SAHQR – FRQI | Gate count | −215.72 | 0.85 | [0.82, 0.88] |
| SAHQR – FRQI | Circuit depth | −216.85 | 0.86 | [0.83, 0.89] |
| SAHQR – FRQI | Encoding time | −193.38 | 0.78 | [0.75, 0.81] |
| SAHQR – GQIR | Gate count | −218.95 | 0.88 | [0.85, 0.91] |
| SAHQR – MCQI | Gate count | 224.21 | 0.92 | [0.89, 0.95] |
| SAHQR – EFRQI | Gate count | −248.88 | 0.95 | [0.92, 0.97] |
| SAHQR – 2D-QSNA | Gate count | −358.29 | 1.10 | [1.05, 1.15] |
Kikomo cha tafsiri: Table 9 haifafanui wazi upande chanya/hasi wa t-statistic ulitokana na subtraction order gani. Kwa hiyo Verianla haitoi hitimisho “SAHQR ni bora” kwa kutegemea ishara ya t. Mwelekeo halisi wa gate/depth/time wa mbinu unapaswa kusomwa moja kwa moja kutoka wastani wa Table 7.
Chanzo hufasiri \(d\geq0.8\) kama effect kubwa. Hata hivyo, tofauti yenye umuhimu wa kitakwimu na mwelekeo unaofaa kiutendaji si dhana ileile; kwa idadi kubwa ya sampuli, hata tofauti ndogo au zisizofaa kwa gharama zinaweza kuwa muhimu kitakwimu.
Uigaji wa kelele
| Noise model | Lebo ya kiwango cha chanzo | Fidelity | PSNR (dB) |
|---|---|---|---|
| Depolarizing | Low | 0.95 | 32.1 |
| Depolarizing | High | 0.82 | 27.4 |
| Amplitude damping | Medium | 0.88 | 29.6 |
| Readout error | Medium | 0.90 | 30.2 |
Jedwali linaonyesha kwamba kelele kubwa, hasa katika hali ya depolarizing, hupunguza fidelity na PSNR. Lakini chanzo hakitoi thamani za nambari za error probability zinazolingana na lebo “Low”, “Medium” na “High” katika jedwali au maelezo husika. Kwa hiyo matokeo hayawezi kuunganishwa moja kwa moja na kiwango cha hitilafu cha kichakataji fulani halisi cha kwanta.
Je, SAHQR Imethibitishwa kwenye Vifaa Halisi vya Kwanta?
Hapana; mizunguko ya SAHQR katika utafiti ilitathminiwa kwa Qiskit statevector simulator na Qiskit Aer noise models, hakuna jaribio la vifaa lililofanywa kwenye IBM Quantum, IonQ, Rigetti au kichakataji kingine cha kimwili cha kwanta katika chanzo, na uthibitishaji wa real-hardware umeorodheshwa kama kazi ya baadaye.
Ulinganisho na JPEG ya kawaida
| Mbinu | Chanzo compression ratio | PSNR (dB) | SSIM |
|---|---|---|---|
| JPEG | 10:1 | 30.5 | 0.89 |
| Saliency-based classical compression | 12:1 | 31.8 | 0.91 |
| SAHQR | 9:1 | 32.6 | 0.93 |
Kulingana na chanzo, SAHQR katika ulinganisho huu hutoa PSNR na SSIM ya juu zaidi kwa gharama ya compression ratio ya chini; yaani lengo si compression ya juu kabisa bali trade-off inayohifadhi ubora wa picha vizuri zaidi.
Kutolingana ndani ya chanzo: SAHQR compression ratio hapa ni 9:1; Table 7 inaripoti 3,18. Makala haielezi wazi kama thamani hizi mbili ni za ufafanuzi tofauti wa kimetodolojia. Kwa hiyo Verianla haitumii moja badala ya nyingine.
Mabadiliko ya kijiometri
Chanzo kinaonyesha rotation za 90°, 180° na 270° pamoja na horizontal/vertical flip kwenye picha baada ya SAHQR na kuripoti kuwa miundo ya nafasi huhifadhiwa. Jaribio hili linaunga mkono uwezekano kwamba representation inaweza kuendana na operesheni za msingi za kijiometri za image-processing; lakini lilifanywa kwenye picha zilizopunguzwa hadi azimio la 16×16.
Tathmini ya Cross-domain
| Dataset | Picha | Qubit | Gate wastani | Depth wastani | Muda (ms) | Chanzo compression ratio | Scalability |
|---|---|---|---|---|---|---|---|
| MINC Medical | 6097 | 17 | 346.12 | 339.12 | 33.15 | 3.18 | 5.88 |
| SAR (ICEYE) | 2000 | 17 | 348.15 | 341.33 | 33.42 | 3.18 | 5.88 |
| Brain Tumor MRI | 2298 | 17 | 347.88 | 340.20 | 33.26 | 3.18 | 5.88 |
Jedwali hili linaonyesha kwamba idadi ya qubit inayotumika ni thabiti katika maeneo matatu, huku thamani za wastani za gate/depth/time zikiwa karibu na nyingine.
Kutolingana ndani ya chanzo: Maandishi ya 9.11.6 hutumia takribani gate 400 kwa picha za Brain Tumor na takribani 540 kwa SAR, wakati Table 12 hutoa 347,88 na 348,15 mtawalia. Verianla huhifadhi wastani sahihi katika jedwali la chanzo na haiunganishi thamani takriban 400/540 za maandishi kama matokeo yale yale.
Maandalizi ya data ya SAR
Chanzo kinafafanua picha ya ICEYE Complex Spotlight kama data ya tarehe 4 Septemba 2024. Picha asili ina pikseli 16.384×24.576 na data ya 16-bit amplitude. Picha hugawanywa katika tile 2000 zisizoingiliana za 256×256; tile zilizo na chini ya %30 ya pikseli halali huondolewa. Kwa kila tile, percentile za 2 na 98 hutumika kwa dynamic-range normalization, data hubadilishwa kutoka 16-bit hadi 8-bit grayscale, na hatimaye hubadilishwa ukubwa hadi pikseli 16×16.
Maandalizi ya data ya Brain Tumor MRI
Chanzo hutumia T1-weighted contrast-enhanced MRI scan 2298. Picha zina mifano ya glioma, meningioma na pituitary tumor na ziko katika muundo wa MATLAB HDF5. Picha asili za 512×512 hupunguzwa hadi pikseli 16×16 kwa tathmini ya usimbaji wa kwanta.
Matumizi ya picha za wagonjwa halisi katika dataset hii hayamaanishi kuwa SAHQR imethibitishwa kama mfumo wa utambuzi wa kliniki. Utafiti unatathmini vigezo vya representation/resource vya picha; usahihi wa utambuzi wa radiologist, sensitivity, specificity au clinical outcome haukutathminiwa.
Uwiano wa gharama–faida
| Kigezo | Baseline | SAHQR |
|---|---|---|
| Gate count | Chini zaidi | Ongezeko la wastani |
| Circuit depth | Chini zaidi | Juu zaidi |
| Compression efficiency | Wastani | Juu zaidi |
| Saliency preservation | Mdogo | Umeboreshwa |
Chanzo kinaweka SAHQR hasa kwa hali ambazo maeneo ya picha yana umuhimu tofauti, salient feature preservation ni muhimu zaidi kuliko uniform compression, na utekelezaji wa kwanta wa kiwango kidogo/kati unalengwa.
Kutolingana kwa Implementation score
Table 7 ya chanzo inatoa implementation ya 3 kwa SAHQR. Kwa upande mwingine, sehemu ya 9.12.6 inaandika kuwa muundo mseto huleta “higher implementation complexity (score 5)”. Chanzo hakielezi kama thamani hizi mbili ni za muktadha tofauti wa scoring. Kwa hiyo Verianla haisahihishi moja kimya kimya.
Matokeo yanayoungwa mkono na utafiti
- SAHQR ni mbinu mseto ya saliency-aware quantum image representation inayotumia viwango viwili tofauti vya usahihi wa usimbaji kulingana na maudhui ya picha.
- Katika picha preprocessed za dataset ya MINC, salient ratio wastani ni takribani %29,85.
- Mzunguko wa SAHQR wa 16×16 na 8-bit hutumia qubit 17 kulingana na fomula ya chanzo.
- Baada ya Qiskit optimization, gate count wastani kwenye MINC iliripotiwa kuwa 346,12 na depth wastani 339,12.
- Wasifu wa matumizi ya rasilimali wa SAHQR ulikaa sawa kwa picha 6097 za MINC, 2000 za SAR na 2298 za Brain Tumor MRI.
- Katika uigaji wa Aer noise, kuongezeka kwa kelele hupunguza fidelity na PSNR.
- Uasili mkuu wa SAHQR ni kutumia saliency-controlled differential precision badala ya uniform encoding kwa picha nzima.
- Utafiti unatoa msaada wa proof-of-concept kwa usimbaji wa picha ya kwanta unaozingatia maudhui.
Matokeo yasiyoungwa mkono na utafiti
- Haijaonyeshwa kuwa SAHQR ni bora kuliko mbinu zote za quantum image representation katika kila kipimo.
- Utendaji wa SAHQR kwenye vifaa halisi vya kwanta haujaonyeshwa.
- Quantum computational advantage au wall-clock quantum speedup dhidi ya classical compression haijathibitishwa.
- Uwakilishi wa qubit 17 haumaanishi kwamba kumbukumbu ya kimwili ni ndogo kuliko picha ya kawaida kwa uwiano wa Mlinganyo (18).
- Haijathibitishwa kuwa gradient saliency hutambua kwa uhakika eneo la uvimbe au anatomia lenye umuhimu wa kliniki.
- Matokeo ya 16×16 hayathibitishi utendaji wa deployment wa MRI, CT au SAR ya kliniki yenye azimio kubwa.
- Uigaji wa noise-model si real quantum-hardware noise validation.
- Matokeo ya PSNR na SSIM hayamaanishi mafanikio ya utambuzi wa kliniki.
- Uthibitishaji wa kliniki wa saliency kwa expert annotation, segmentation mask au tathmini ya radiologist haukufanywa.
Vikwazo vikuu vya utafiti
Waandishi wanakubali wazi kwamba kupunguza picha zote hadi pikseli 16×16 hupunguza kwa kiasi kikubwa maelezo ya kimuundo na kisemantiki katika picha halisi. Hili ni muhimu hasa kwa picha za matibabu na SAR; vidonda vidogo, mipaka myembamba au textures za radar katika azimio kubwa vinaweza kupunguzwa hadi pikseli chache.
Saliency inayotegemea gradient hutoa structural prominence pekee. Waandishi wanaeleza kuwa uthibitishaji wa kliniki kwa domain-informed saliency, expert annotation au segmentation mask unapaswa kufanywa katika kazi ya baadaye.
Gharama za noise, connectivity, transpilation, calibration, readout na sampling hazijajaribiwa kwenye quantum hardware halisi. Matokeo ya Qiskit Aer hayawezi kuwakilisha kikamilifu matatizo haya ya vifaa.
Mwelekeo wa kazi ya baadaye
Chanzo kinapendekeza azimio la juu zaidi, block/patch-based quantum image representation, image-specific adaptive threshold, deep-learning saliency, quantum image operations zinazofuata kama filtering/transformation/edge-detection, multi-scale encoding, uthibitishaji kwenye quantum hardware halisi na uthibitishaji wa kliniki unaotegemea expert-annotation.
Maelezo ya Chanzo na Mbinu
Kichwa asili: A Hybrid Quantum-Classical Framework for Saliency-Aware Medical Image Encoding.
Waandishi na mpangilio: Vrushali Nikam; Trupti Atre; Lavanya Santhosh; Asha Konasagara Nagaraja; Praveena Mydolalu Veerappa.
Corresponding author: Vrushali Nikam.
Taasisi 1: Computer Engineering, MET's Institute of Engineering—Bhujbal Knowledge City, Nashik 422003, India.
Taasisi 2: Computer Engineering, Gokhale Education Society's, R H Sapat College of Engineering Management Studies and Research, Nashik 422005, India.
Taasisi 3: CSE Programme, School of CSE, Dr. Ambedkar Institute of Technology, Bengaluru 560056, India.
Mchango sawa: Hakuna ishara ya uandishi wa kwanza sawa/mchango sawa inayoonekana katika chanzo kilichopakiwa.
Jarida: Quantum Reports.
Mchapishaji: MDPI, Basel, Switzerland.
Juzuu / namba / namba ya makala: 8 / 2 / 46.
DOI: 10.3390/quantum8020046.
Received: 10 Machi 2026.
Revised: 13 Aprili 2026.
Accepted: 2 Mei 2026.
Published: 7 Mei 2026.
Aina ya chanzo: Makala ya utafiti iliyopitiwa na wahakiki.
Hali ya uhakiki: Ni chapisho la jarida lililopitiwa na wahakiki.
Leseni: Creative Commons Attribution, CC BY 4.0; hakimiliki inabaki kwa waandishi.
Academic Editor: Mingxing Luo.
Mbinu kuu ya kisayansi: Classical gradient/Sobel saliency detection + saliency-controlled differential quantum image encoding + Qiskit statevector simulation + comparative resource evaluation dhidi ya mbinu kumi za quantum-image representation.
Ukubwa mkuu wa data: 6097 MINC + 2000 SAR + 2298 Brain Tumor MRI = picha 10.395.
Operesheni za majaribio ya MINC: picha 6097 × mbinu 11 = 67.067 encoding operation.
Vifaa vya kwanta: Hakuna physical quantum processor iliyotumika. Uchambuzi mkuu wa quantum circuit ni statevector simulation; noise tests ni Qiskit Aer simulation.
Mazingira ya kompyuta ya kawaida: Google Colab, Ubuntu 22.04, NVIDIA Tesla T4, Python 3.10.
Quantum software: Qiskit 0.45.0.
Qiskit transpilation: Vipimo vya kulinganisha circuit resource vilifanywa kwa decomposition kwenda kwenye \(\{u3,cx\}\) basis gate set ya kawaida na optimization level 3.
Mbinu ya takwimu: Descriptive statistics, independent t-tests na Cohen's d effect size. Maandishi ya chanzo pia yanataja ANOVA katika baadhi ya sehemu, lakini hakuna takwimu za kina za ANOVA zinazoripotiwa katika sehemu ya matokeo. Majedwali ya pairwise yanatoa threshold ya \(p<0.001\); exact p values hazionyeshwi moja moja.
Ufadhili: Utafiti unaripoti kwamba haukupokea external funding.
Mgongano wa maslahi: Waandishi wanatangaza kwamba hakuna conflict of interest.
Michango ya waandishi: Conceptualization, methodology, software, validation, visualization, supervision na project administration zilifanywa hasa na Vrushali Nikam; formal analysis, investigation, data curation na uandishi zilifanywa na waandishi wenza mbalimbali. Funding acquisition imeorodheshwa kwa Trupti Atre, Lavanya Santhosh, Asha Konasagara Nagaraja na Praveena Mydolalu Veerappa.
Upatikanaji wa data/msimbo: Chanzo kinasema kwamba vyanzo vya data vya MINC, Brain Tumor na ICEYE vinapatikana wazi na kwamba implementation code pamoja na experimental results zipo katika GitHub repository ya umma. Katika Data Availability Statement, lebo ya dataset ya tatu inaonekana kuandikwa kimakosa mara ya pili kama “Brain Tumor dataset”, ingawa katika utafiti wote domain ya tatu inafafanuliwa kama ICEYE SAR.
Tamko la matumizi ya akili bandia: Katika sehemu ya Acknowledgments inaelezwa kwamba Claude 3.5 Sonnet ilitumika kwa LaTeX formatting na technical-writing refinements, huku wajibu wa maudhui ya chapisho ukiwa kwa waandishi.
Kikomo kikuu cha kimetodolojia: Picha zote zimepunguzwa hadi azimio la 16×16. Deployment halisi ya azimio kubwa, quantum hardware halisi na clinical validation hazikufanywa.
Kikomo cha Saliency: Sobel-gradient saliency hupima structural prominence; si kipimo cha domain-specific au expert-validated diagnostic importance.
Kutolingana ndani ya chanzo 1: Ufafanuzi wa compression ratio katika Mlinganyo (18)/Jedwali 5 haulandani moja kwa moja kinambari na thamani za “Compress.” katika Jedwali 7.
Kutolingana ndani ya chanzo 2: Katika Jedwali 7, thamani ya SAHQR compression ni 3,18, lakini katika ulinganisho wa JPEG wa Jedwali 10 inatolewa 9:1; chanzo hakipatanishi tofauti hii wazi.
Kutolingana ndani ya chanzo 3: Jedwali 7 linatoa SAHQR implementation score ya 3, huku maandishi ya 9.12.6 yakitoa 5.
Kutolingana ndani ya chanzo 4: Cross-domain Jedwali 12 linatoa gate count wastani wa SAR na Brain Tumor kuwa takribani 348, huku maandishi ya 9.11.6 yakitumia takribani 540 na 400.
Tatizo la uwazi ndani ya chanzo 5: Dataset statistics inatoa \(\theta_s=0.5\), huku sehemu ya method ikifafanua adaptive threshold kama \(\theta_s=\mu_S+\alpha\sigma_S\), default \(\alpha=0\); matumizi haya mawili hayapatanishwi kwa kina.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *