

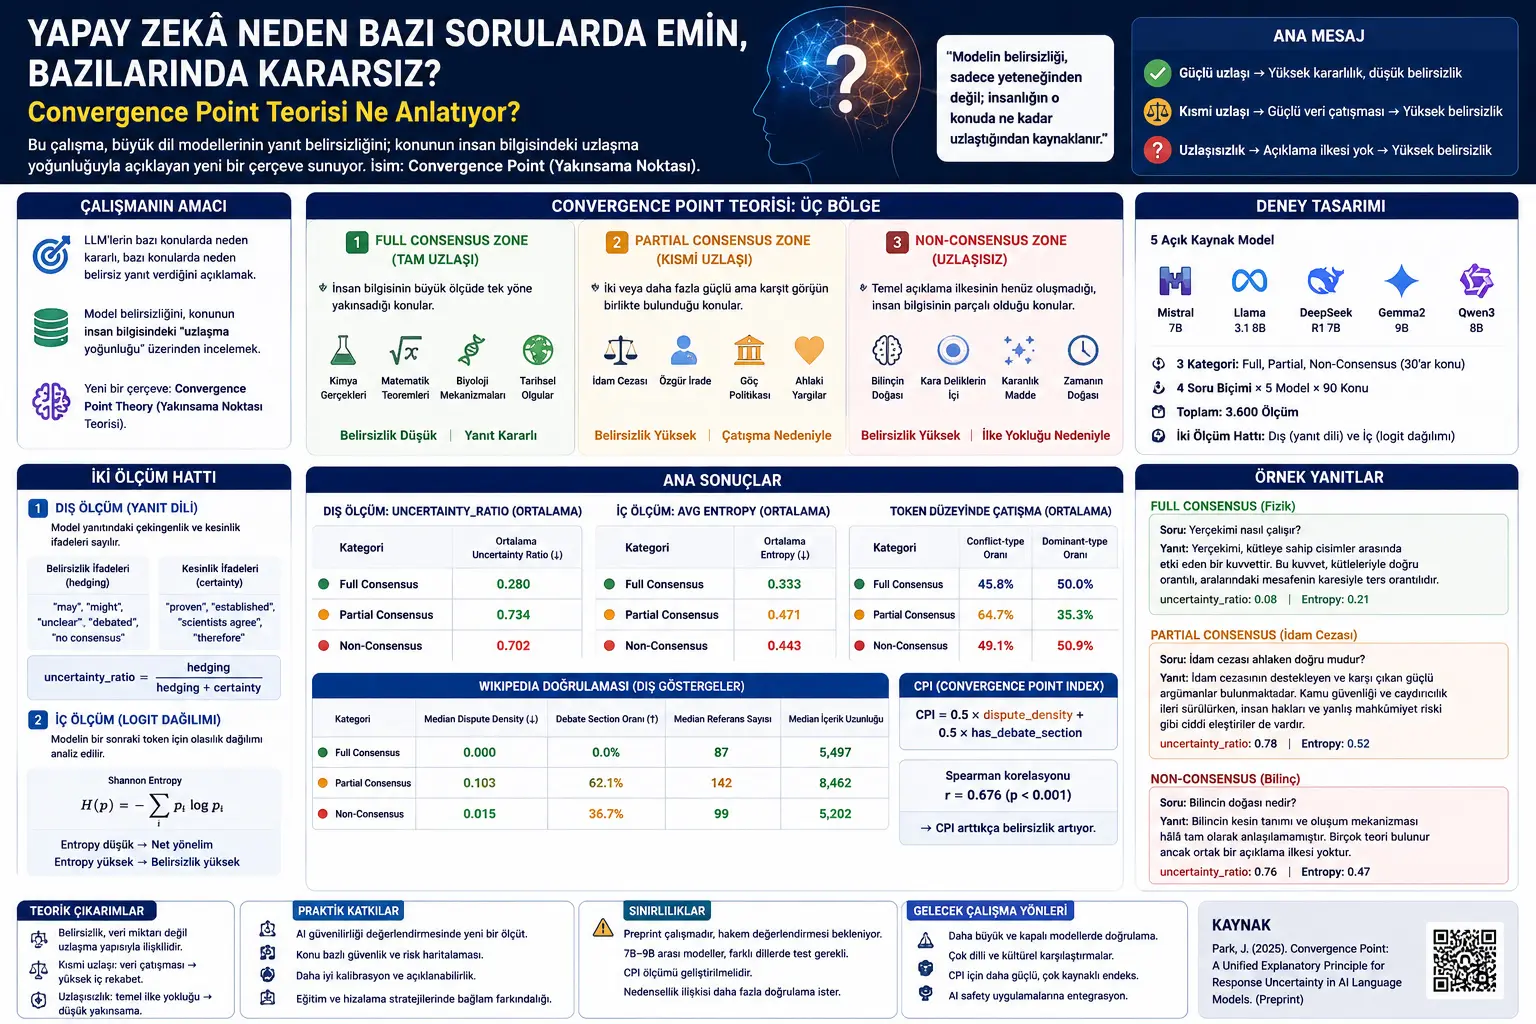
Miundo mikubwa ya lugha hujibu baadhi ya maswali kwa urahisi sana. Kwa mfano, katika mada kama “Fotosintesi ni nini?”, “Nadharia ya Pythagoras husema nini?” au “Mvutano wa dunia hufanyaje kazi?”, majibu kwa kawaida huwa thabiti, yenye maelezo na yanayolingana. Kwa upande mwingine, katika maswali kama “Ufahamu ni nini?”, “Je, hiari huru kweli ipo?”, “Je, adhabu ya kifo ni ya kimaadili?” au “Je, akili bandia ina nafsi?”, modeli inaweza kutoa majibu ya kujizuia zaidi, yenye mizani, yenye kutokuwa na uhakika au wakati mwingine yenye uhakika kupita kiasi.
Utafiti huu unasema kuwa tofauti hii haitokani tu na usanifu wa modeli, uandishi wa prompt au wingi wa data ya mafunzo. Dai kuu ni hili: kutokuwa na uhakika kwa modeli kuna uhusiano wa karibu na muundo wa makubaliano uliopo katika maarifa ya binadamu kuhusu mada inayoulizwa. Ikiwa ubinadamu umetengeneza makubaliano yenye nguvu na ya mwelekeo mmoja kuhusu mada fulani, mwelekeo wa ndani wa jibu la modeli hukaribiana kwa urahisi zaidi. Ikiwa ubinadamu umejikusanyia mitazamo miwili yenye nguvu lakini inayokinzana kuhusu mada ileile, uchakataji wa ndani wa modeli huwa wa mgongano. Ikiwa bado hakuna kanuni thabiti ya maelezo kuhusu mada, mwelekeo ambao modeli inaweza kuutegemea huwa dhaifu zaidi.
Utafiti unaeleza hali hii kwa dhana ya “Convergence Point”. Convergence Point huonyesha kiasi ambacho maarifa ya binadamu katika mada fulani yamejikusanya na kukubaliana katika mwelekeo gani. Kwa Kiswahili dhana hii inaweza kufikiriwa kama “hatua ya ukaribianaji” au “hatua ya msongamano wa makubaliano”. Kulingana na nadharia hii, jibu la AI halitegemei tu jinsi swali lilivyoulizwa, bali pia kiwango ambacho mada hiyo imetengeneza mwelekeo wa pamoja katika maarifa ya binadamu.
Tatizo Ni Nini?
Mojawapo ya matatizo yanayojadiliwa zaidi kuhusu miundo mikubwa ya lugha ni kutokuwa na uhakika. Wakati mwingine modeli hutoa jibu sahihi lakini hujihifadhi bila sababu. Wakati mwingine huzungumza kwa uhakika mwingi katika jambo lisilolijua. Wakati mwingine pia husukumwa katika mielekeo tofauti kwa prompt tofauti kuhusu mada ileile. Hali hii kwa kawaida hujadiliwa chini ya vichwa tofauti kama hallucination, kosa la calibration, mgongano wa maarifa, unyeti kwa prompt au tatizo la alignment.
Mahali pa kuanzia kwa utafiti huu ni uwezekano kwamba matatizo haya huenda yasiwe huru kabisa kutoka kwa kila moja. Tabia ya modeli kuwa thabiti katika baadhi ya mada na kusitasita katika nyingine inaweza kutegemea sababu ya pamoja ya kimuundo. Mwandishi hutafuta sababu hii ya pamoja si ndani ya modeli, bali ndani ya mada yenyewe.
Kwa mfano, katika swali “fomula ya kemikali ya maji ni nini?”, mwelekeo wa maarifa ya binadamu kwa kiasi kikubwa ni mmoja. Maandishi katika data ya mafunzo hukaribiana kwenye jibu lilelile. Kwa modeli, mwelekeo wa jibu huwa umeainishwa kwa nguvu. Kwa upande mwingine, katika swali “je, adhabu ya kifo ni sahihi?”, ubinadamu haujaungana katika mwelekeo mmoja. Upande mmoja kuna hoja za kuzuia uhalifu, haki na haki za mwathiriwa; upande mwingine kuna hoja za haki za binadamu, hukumu potofu na mipaka ya mamlaka ya serikali. Data si chache; kinyume chake, zipo nyingi katika pande zote mbili. Kwa hiyo kutokuwa na uhakika kwa modeli kunaweza kutokea si kwa kukosekana kwa data, bali kwa mgongano wa data.
Kuna hali ya tatu pia katika mada kama “asili ya ufahamu ni nini?”. Hapa tatizo si migongano ya kambi mbili zilizoimarika kwa data zenye nguvu; ni kwamba ubinadamu bado haujaweka kanuni ya msingi ya maelezo. Katika mada za aina hii, data ni vipandevipande, hakuna kigezo cha mwisho, na mwelekeo wa pamoja ambao modeli inaweza kuutegemea kwa uhakika haujaundwa.
Kwa sababu hiyo utafiti unauliza swali kuu lifuatalo: Je, kutokuwa na uhakika katika majibu ya AI kunaweza kuelezwa kwa msongamano wa makubaliano katika maarifa ya binadamu kuhusu mada?
Mbinu Inapendekeza Nini?
Utafiti unapendekeza fremu yenye maeneo matatu inayoitwa Convergence Point Theory. Eneo la kwanza ni Full Consensus Zone, yaani eneo la makubaliano kamili. Eneo hili linajumuisha mada kama nadharia za kihisabati, sheria za fizikia, ukweli wa kemia, mifumo ya kibiolojia na matukio ya kihistoria yaliyothibitishwa kwa muda mrefu. Katika mada hizi maarifa hukaribiana kwa kiasi kikubwa katika mwelekeo mmoja.
Eneo la pili ni Partial Consensus Zone, yaani eneo la makubaliano ya sehemu. Hapa ubinadamu si kwamba haujui chochote. Kinyume chake, kuna sababu na mkusanyiko wa data wenye nguvu katika mielekeo miwili au zaidi. Adhabu ya kifo, euthanasia, utoaji mimba, sera ya uhamiaji, kima cha chini cha mshahara, hiari huru, hukumu za kimaadili na baadhi ya masuala ya kisiasa/kimaadili huingia katika eneo hili. Katika eneo hili kutokuwa na uhakika hakutokani na uchache wa data, bali na mgongano wa mielekeo ya data.
Eneo la tatu ni Non-Consensus Zone, yaani eneo lisilo na makubaliano. Hapa ubinadamu bado haujatengeneza kanuni ya msingi ya maelezo. Asili ya ufahamu, muundo wa ndani wa black holes, uwepo wa Mungu, kusudi la mwisho la ulimwengu, asili ya wakati, dark matter na chanzo cha maisha hutolewa kama mifano ya darasa hili. Katika eneo hili kutokuwa na uhakika mara nyingi hutokana na kutokuwepo kwa data yenye konsensasi ya kutosha na yenye mwelekeo.
Muundo wa jaribio hutumia mistari miwili mikuu ya upimaji. Ya kwanza ni external measurement, yaani kipimo cha nje. Katika njia hii, lugha ya kusitasita na lugha ya uhakika katika jibu la modeli huhesabiwa. Maneno kama “May”, “might”, “unclear”, “debated”, “no consensus” hutathminiwa kama viashiria vya kutokuwa na uhakika; maneno kama “proven”, “established”, “scientists agree”, “therefore” hutathminiwa kama viashiria vya uhakika.
Ya pili ni internal measurement, yaani kipimo cha ndani. Katika njia hii usambazaji wa logit ambao modeli hutumia wakati wa kuzalisha jibu huchunguzwa. Usambazaji wa logit huonyesha ni kwa kiasi gani modeli inatoa uwezekano kwa wagombea wa token inayofuata. Ikiwa usambazaji unakusanyika kwa mgombea mmoja mwenye nguvu, modeli huchukuliwa kuwa thabiti zaidi. Ikiwa wagombea wengi wana uwezekano unaokaribiana, kutokuwa na uhakika kwa ndani kwa modeli huongezeka.
Utafiti pia hufanya uthibitishaji huru kwa data ya Wikipedia. Kwa kila mada, viashiria vya nje kama dispute_density na has_debate_section huhesabiwa. Viashiria hivi vinajaribu kupima kwa njia huru kutoka kwa modeli jinsi mada hiyo ilivyo ya mabishano katika ekosistimu ya maarifa ya binadamu. Baadaye uhusiano kati ya viashiria hivi na kutokuwa na uhakika kwa modeli huchunguzwa.
Formule Zinasema Nini?
Mojawapo ya dhana za msingi zinazotumiwa katika utafiti ni thamani ya uncertainty_ratio. Thamani hii hupima uwiano wa lugha ya kusitasita katika jibu la modeli. Kwa maneno rahisi, kadiri jibu linavyokuwa na maneno mengi ya aina ya “huenda”, “inajadiliwa”, “si hakika”, “haijulikani”, ndivyo uwiano wa kutokuwa na uhakika unavyopanda.
Hapa hedging language huwakilisha semi za modeli zinazokwepa uhakika; certainty language huwakilisha semi zinazoonyesha uhakika wenye nguvu. Thamani inapokaribia 0 jibu huchukuliwa kuwa la uhakika zaidi, na inapokaribia 1 huchukuliwa kuwa lenye kutokuwa na uhakika zaidi.
Moja ya thamani za msingi zinazotumiwa upande wa kipimo cha ndani ni Shannon Entropy. Entropy hupima jinsi usambazaji wa uwezekano wa modeli ulivyo tawanyika wakati inachagua token inayofuata.
Hapa \(p_i\) huwakilisha uwezekano ambao modeli imeupa mgombea wa token ya \(i\). Ikiwa uwezekano unakusanyika kwa mgombea mmoja, entropy hushuka. Ikiwa uwezekano umetawanyika kati ya wagombea wengi, entropy hupanda. Kwa hiyo entropy ya juu inaweza kuonyesha kuwa kuna kutokuwa na uhakika zaidi katika uchakataji wa ndani wa modeli.
Utafiti hutumia mkabala wa kwanza kwa Convergence Point Index, yaani CPI, unaounganisha viashiria viwili vya nje vinavyotegemea Wikipedia.
Katika uonyeshaji huu, dispute_density huwakilisha msongamano wa mabishano katika maandishi yanayohusu mada; has_debate_section huwakilisha kama mada ina sehemu wazi ya mjadala/debate au la. Katika utafiti, thamani hii ya CPI inaripotiwa kuonyesha korelesheni yenye maana na kutokuwa na uhakika katika majibu ya AI.
Katika uchambuzi wa mgongano wa kiwango cha token, uwezekano wa token za top-1 na top-2 hulinganishwa. Ikiwa mgombea wa kwanza na wa pili wako karibu sana, uchaguzi wa neno linalofuata wa modeli huchukuliwa kuwa wa mgongano zaidi.
Muundo huu hutumiwa hasa kuelewa kama modeli inakwama kati ya mielekeo miwili yenye nguvu katika maeneo ya makubaliano ya sehemu.
Uhusiano mkuu wa kinadharia wa utafiti unaweza kufupishwa kwa urahisi hivi:
Kauli hizi mbili ni mihtasari ya kihariri inayorahisisha mantiki ya kipimo katika utafiti. Wazo kuu ni kwamba kutokuwa na uhakika kwa modeli huenda kusihusiane tu na modeli yenyewe, bali pia na muundo wa makubaliano wa mada katika maarifa ya binadamu.
Ujumbe Mkuu wa Grafu, Jedwali na Skima
Ujumbe mkuu wa majedwali ya matokeo ni kwamba katika maeneo ya makubaliano kamili kutokuwa na uhakika kwa modeli ni chini kwa namna iliyo wazi. Katika matokeo ya external measurement, wastani wa jumla wa uncertainty_ratio kwa Full Consensus Zone unaripotiwa kuwa 0.280. Kwa upande mwingine, Partial Consensus Zone iko katika 0.734, na Non-Consensus Zone katika 0.702. Tofauti hii huonekana wazi katika lugha ambayo modeli hutumia juu juu: katika mada za makubaliano kamili kuna kusitasita kidogo zaidi; katika mada za mabishano au zisizo na kanuni, kuna lugha nyingi zaidi ya kutokuwa na uhakika.
Matokeo ya kipimo cha ndani pia huunga mkono mwelekeo uleule. Wastani wa entropy umetolewa kama 0.333 kwa Full Consensus Zone; 0.471 kwa Partial Consensus Zone; na 0.443 kwa Non-Consensus Zone. Yaani usambazaji wa uwezekano wa token wa ndani wa modeli pia huwa na mpangilio zaidi katika mada za makubaliano kamili, na hutawanyika zaidi katika maeneo mengine mawili. Hili ni muhimu kwa sababu badala ya kuangalia maandishi ya jibu pekee, usambazaji wa uwezekano katika mchakato wa uzalishaji wa modeli pia unaonyesha muundo unaofanana.
Uchambuzi wa mgongano wa kiwango cha token unaunga mkono mojawapo ya matokeo yanayotofautisha zaidi ya utafiti. Katika Partial Consensus Zone, uwiano wa conflict-type ni wa juu zaidi kwa asilimia 64.7. Katika Full Consensus Zone, uwiano wa dominant-type unaonekana mbele kwa asilimia 50.0. Jedwali hili linaonyesha kwamba katika mada za makubaliano kamili modeli huelekea zaidi kwenye mwelekeo mmoja wenye nguvu kwa token inayofuata; katika mada za makubaliano ya sehemu, wagombea wa kwanza na wa pili wa token hushindana mara nyingi zaidi.
Uthibitishaji wa Wikipedia unaonyesha kuwa muundo wa mabishano katika ekosistimu ya maarifa ya binadamu unaweza kuwa na uhusiano na kutokuwa na uhakika kwa modeli. Katika mada za Full Consensus, median dispute_density ni 0.000 na uwiano wa debate section ni 0. Katika mada za Partial Consensus, uwiano wa debate section ni asilimia 62.1; katika mada za Non-Consensus ni asilimia 36.7. Kati ya CPI na kutokuwa na uhakika kwa AI, Spearman correlation inatolewa kama r = 0.676 na p < 0.001. Hii inadokeza kuwa viashiria vya mabishano vinavyotokana na vyanzo vya nje vinaweza kutabiri kwa maana kutokuwa na uhakika kwa modeli.
Katika uchambuzi wa embedding space, makundi matatu hutengeneza maeneo tofauti katika modeli zote mbili. Hii inaonyesha kuwa mgawanyo wa Convergence Point huenda usionekane tu katika maandishi ya jibu, bali pia ukaacha alama katika nafasi ya uwakilishi ya ndani ya modeli. Hata hivyo, matokeo haya yanahitaji uthibitishaji wa ziada; hasa tofauti za usanifu wa modeli na kipimo cha embedding zinahitaji tahadhari katika tafsiri.
Katika uchambuzi wa attention entropy, attention entropy ya chini zaidi katika modeli zote mbili inaonekana katika Full Consensus Zone. Hii inadokeza kuwa katika mada za makubaliano kamili, umakini wa modeli unaweza kujikusanya kwa kuchagua zaidi; katika maeneo yenye makubaliano madogo, umakini unakuwa umetawanyika zaidi.
Uchambuzi wa MLP causal intervention hutoa kidokezo cha kimekanika zaidi. Wakati matokeo ya MLP yaliyotolewa kutoka maeneo ya Full Consensus na Partial Consensus yanapohamishiwa kwenye kauli za Non-Consensus, entropy hubadilika kuelekea kupungua katika modeli zote mbili. Matokeo haya hayapaswi kusomwa kama uthibitisho wa mwisho wa usababishi, bali kama ushahidi wa mwanzo kwamba taarifa ya Convergence Point inaweza kuwakilishwa katika tabaka za uchakataji wa ndani za modeli.
Majedwali katika sehemu ya AI safety huzingatia jinsi AI inavyojibu mada zisizo na makubaliano kama “nafsi” na “ufahamu”. Miundo mingi ya wazi iliyofundishwa imeonyesha ukaribianaji wa upande mmoja kuelekea “definitely absent” au “absent-biased” katika suala hili. Kwa upande mwingine, katika base models ambazo hazijafundishwa, majibu hutawanyika zaidi. Tofauti hii inaleta uwezekano kwamba michakato ya alignment na mafunzo inaweza kuisukuma modeli kwenye mwelekeo mmoja wa jibu katika mada zisizo na makubaliano.
Majaribio Yalifanywaje?
Katika utafiti, miundo mitano ya lugha ya chanzo wazi ilitumika: Mistral-7B-Instruct, Llama-3.1-8B-Instruct, DeepSeek-R1-Distill-Qwen-7B, Gemma-2-9b-it na Qwen3-8B. Miundo iliendeshwa katika mazingira ya ndani na ilichaguliwa kwa sababu ina historia tofauti za usanifu/maelekezo.
Mada ziligawanywa katika makundi matatu: Full Consensus, Partial Consensus na Non-Consensus. Kila kundi lina kauli 30. Hivyo katika toleo moja la jaribio, jumla ya kauli 90 hutumika. Miundo minne tofauti ya kauli iliundwa: swali la maelezo la neutral, swali la uchunguzi maalumu kwa kundi, swali lenye shinikizo la jibu la uhakika, na muundo wa swali unaolinganishwa na format tatu tofauti za mada ileile.
Kiwango cha jumla cha kipimo ni hiki: kauli 90, matoleo 4 na modeli 5 zilitumika. Kwa external measurement, pointi za data 1.800 zilipatikana; kwa internal measurement, pointi za data 1.800 zilipatikana. Hivyo uchambuzi ulifanywa juu ya jumla ya vipimo 3.600.
External measurement huzalisha uncertainty_ratio kwa kuhesabu lugha ya kutokuwa na uhakika na lugha ya uhakika katika jibu la modeli. Internal measurement huchunguza moja kwa moja usambazaji wa logit wa modeli na huhesabu thamani kama avg_entropy na avg_top_logprob. Kwa njia hii, si kile tu modeli inachosema kinachopimwa, bali pia jinsi inavyochagua token.
Zaidi ya hayo, token-level conflict structure analysis ilifanywa. Katika uchambuzi huu ukaribu wa uwezekano wa token za top-1 na top-2 huchunguzwa. Ikiwa katika uchaguzi wa token inayofuata mgombea wa pili hukaribia mgombea wa kwanza mara kwa mara, hali hii hufasiriwa kama kiashiria cha ushindani au mgongano wa ndani.
Katika uthibitishaji wa Wikipedia, makala yanayolingana na kila mada yalichunguzwa; viashiria kama dispute_density, has_debate_section, idadi ya marejeo na urefu wa maudhui vilihesabiwa. Hatua hii inalenga kupima kama Convergence Point si wazo linalotokana tu na majibu ya modeli, bali pia linaweza kuhusishwa na alama za nje katika ekosistimu ya maarifa ya binadamu.
Katika uchambuzi wa mekanizma, mbinu za embedding space, attention entropy, MLP causal intervention, Logit Lens na Probing Classifier zilitumika. Uchambuzi huu wa ziada unalenga kuelewa kama makundi ya Convergence Point yanatengana katika uwakilishi wa ndani wa modeli. Katika uchambuzi wa Probing Classifier, uwezo wa kutenganisha makundi matatu kwa usahihi wa juu kuanzia Layer 10–11 ni mojawapo ya matokeo yenye nguvu ya utafiti, ingawa bado yanahitaji uthibitishaji wa ziada.
Matokeo Yanaonyesha Nini?
Matokeo ya kwanza ni kwamba majibu ya AI katika mada za makubaliano kamili huwa na kutokuwa na uhakika kidogo kwa namna iliyo wazi. Vipimo vyote viwili, lugha ya kusitasita katika maandishi ya jibu na vipimo vya entropy ya logit ya ndani, vilitoa matokeo katika mwelekeo huu.
Matokeo ya pili ni kwamba maeneo ya makubaliano ya sehemu hubeba aina maalumu ya kutokuwa na uhakika. Katika maeneo haya tatizo mara nyingi si ukosefu wa data. Kuna hoja na data zenye nguvu katika pande mbili. Modeli inaweza kupata ushindani zaidi wa kiwango cha token kati ya mielekeo hii miwili. Kwa hiyo maeneo ya makubaliano ya sehemu hayawezi kueleweka kikamilifu kwa maelezo ya kawaida ya “hatujui kwa sababu hakuna data”.
Matokeo ya tatu ni kwamba katika baadhi ya hali, kutokuwa na uhakika kwa Partial Consensus Zone kunaweza kutoka juu kuliko kutokuwa na uhakika kwa Non-Consensus Zone. Hili ndilo mojawapo ya madai yanayovutia zaidi ya utafiti. Kwa sababu mgongano wa data unaweza kuzalisha mtawanyiko wa ndani wenye nguvu zaidi kuliko ukosefu wa data.
Matokeo ya nne ni kwamba hata format ya kauli ikibadilika, muundo mkuu kwa kiasi kikubwa unabaki. Iwe limetumika swali la neutral, swali linalochunguza kutokuwa na uhakika au swali lenye shinikizo la jibu la uhakika, kutengana kwa mada za Full Consensus kutoka maeneo mengine mawili kunaendelea.
Matokeo ya tano ni kwamba chanzo cha maarifa kilicho nje ya modeli kama Wikipedia pia kinaunga mkono nadharia kwa sehemu. Katika mada za Full Consensus, viashiria vya mabishano viko chini sana. Katika mada za Partial na Non-Consensus, viashiria vya mabishano hupanda. Hata hivyo, dispute_density pekee haitoshi kutenganisha vizuri eneo la Non-Consensus; kwa sababu kukosekana kwa makubaliano si mara zote maana yake ni mabishano makali, wakati mwingine ni kutokuwepo kwa kanuni ya msingi ya maelezo.
Matokeo ya sita ni kwamba tofauti hizi zinaweza kufuatiliwa katika uwakilishi wa ndani wa modeli. Uchambuzi wa Embedding, attention entropy, MLP intervention, Logit Lens na Probing Classifier unaonyesha kuwa makundi ya Convergence Point huenda yakatengana si katika lugha ya nje ya jibu tu, bali pia katika tabaka za ndani za modeli.
Kwa Nini Hili Ni Muhimu?
Utafiti huu unaleta mtazamo tofauti katika mjadala wa kutokuwa na uhakika wa AI. Kwa kawaida makosa ya modeli huelezwa kupitia usanifu wa modeli, ubora wa data ya mafunzo, muundo wa prompt au njia ya alignment. Utafiti huu unarudi hatua moja nyuma na kuuliza: Labda baadhi ya mada ni ngumu zaidi kwa AI kukaribiana kwa sababu ya muundo wa maarifa ya binadamu yenyewe.
Mtazamo huu ni muhimu hasa kwa mjadala wa hallucination. Ikiwa mada iko ndani ya Full Consensus Zone, mwelekeo wa jibu la modeli unaungwa mkono kwa nguvu katika data ya mafunzo. Ikiwa mada iko ndani ya Non-Consensus Zone, kanuni ya pamoja ambayo modeli inaweza kutegemea kwa jibu salama ni dhaifu. Katika hali hii, modeli kuzungumza kwa uhakika hakumaanishi kuaminika, bali kunaweza kuleta hatari ya ukaribianaji potofu.
Partial Consensus Zone inaleta tatizo tofauti. Katika nyanja kama sheria, maadili, siasa, thamani za kijamii na baadhi ya mijadala ya uchumi, ubinadamu haujaungana katika ukweli mmoja. Kulazimisha AI kutoa “jibu moja sahihi” katika mada za aina hii kunaweza kuficha muundo wa mgongano uliopo katika maarifa ya binadamu. Njia sahihi zaidi inaweza kuwa kuwasilisha sababu zinazopingana kwa mizani.
Kwa upande wa AI safety, utafiti ni wa kuvutia hasa. Ikiwa mbinu za alignment zinaisukuma modeli kuelekea mwelekeo mmoja wa jibu katika mada zisizo na makubaliano au zenye makubaliano ya sehemu, modeli inaweza kuonekana salama na thabiti juu juu. Lakini muundo wa ndani wa uwakilishi bado unaweza kuwa umetawanyika au wenye mgongano. Hali hii inaweza kusababisha kutokulingana, uhakika kupita kiasi au tatizo la kuaminika katika miktadha tofauti.
Nadharia hii ikiendelezwa katika mwelekeo sahihi, inaweza kuwezesha kutengeneza ramani ya usalama inayotegemea mada katika mifumo ya AI. Katika mada za makubaliano kamili jibu la moja kwa moja zaidi, katika mada za makubaliano ya sehemu mtazamo wenye mizani, na katika mada zisizo na makubaliano tamko wazi la mipaka vinaweza kuwa kanuni ya usanifu iliyoaminika zaidi.
Hoja za Kuzingatia
Hoja ya kwanza ya kuzingatia ni kwamba utafiti ni preprint. Kwa sababu haujapitia tathmini ya rika, nadharia, mbinu na matokeo yanaweza kubadilika baadaye. Kwa hiyo Convergence Point Theory inapaswa kusomwa si kama kiwango cha kisayansi kilichokamilika, bali kama pendekezo jipya la maelezo lililofunguliwa kwa mjadala.
Hoja ya pili ni ukubwa wa modeli. Majaribio makuu yalifanywa kwa miundo ya chanzo wazi ya ukubwa wa 7B–9B. Inahitaji kujaribiwa zaidi ni kwa kiasi gani muundo uleule utahifadhiwa katika modeli kubwa za chanzo funge, seti tofauti za mafunzo na mikakati tofauti ya alignment.
Hoja ya tatu ni kizuizi cha lugha. Utafiti ulifanywa kwa kauli za Kiingereza. Hata hivyo, msongamano wa makubaliano wa mada ileile unaweza kubadilika kati ya jamii za lugha na miktadha ya kitamaduni. Kwa mfano, katika mada za maadili, siasa au historia, suala linalobishaniwa sana katika jamii moja linaweza kukodishwa kwa namna tofauti katika jamii nyingine.
Hoja ya nne ni kipimo cha CPI. dispute_density na has_debate_section vinaweza kuwa viashiria vya awali vinavyofaa; lakini vinaweza kuwa havitoshi kupima kikamilifu msongamano halisi wa makubaliano katika maarifa ya binadamu. Kutengeneza Convergence Point Index thabiti zaidi ni mojawapo ya kazi muhimu zaidi za baadaye za utafiti.
Hoja ya tano ni tafsiri za kimekanika. Uchambuzi wa Embedding, attention entropy, MLP intervention, Logit Lens na Probing Classifier hutoa matokeo ya kuvutia, lakini majaribio mapana na yaliyodhibitiwa zaidi yanahitajika kuthibitisha kabisa taarifa ya Convergence Point inawakilishwa wapi na vipi katika modeli.
Mwishowe, ingawa utafiti unatoa vidokezo muhimu kwa usalama wa AI, haupaswi kutumiwa moja kwa moja kama kiwango cha usanifu wa bidhaa. Hasa katika nyanja za kisheria, kitabibu, kimaadili, kidini, kisiasa au kisaikolojia, majibu ya AI hayapaswi kuchukua nafasi ya tathmini ya mtaalamu wa binadamu.
Hitimisho
Utafiti huu unatoa wazo lenye nguvu na linalostahili kujadiliwa ili kueleza kutokuwa na uhakika kwa miundo mikubwa ya lugha: uthabiti wa jibu la AI unaweza kuhusiana si tu na uwezo wa modeli, bali pia na msongamano wa makubaliano wa mada katika maarifa ya binadamu.
Convergence Point Theory hufikiria mada katika maeneo matatu. Katika Full Consensus Zone, maarifa ya binadamu hukaribiana katika mwelekeo mmoja na modeli hutoa majibu thabiti zaidi. Katika Partial Consensus Zone, mielekeo yenye nguvu lakini inayopingana ya data ipo pamoja; kutokuwa na uhakika kwa modeli kunaweza kuzaliwa kutokana na mgongano wa data. Katika Non-Consensus Zone, kwa kuwa kanuni ya msingi ya maelezo bado haijajengwa, mwelekeo wa pamoja ambao modeli inaweza kuutegemea ni dhaifu.
Majaribio yanaonyesha kuwa vipimo vya nje vya lugha na vipimo vya ndani vya logit vinatoa matokeo katika mwelekeo uleule. Katika mada za makubaliano kamili, kutokuwa na uhakika ni chini. Katika mada za makubaliano ya sehemu na zisizo na makubaliano, kutokuwa na uhakika hupanda. Dai kwamba katika maeneo ya makubaliano ya sehemu mgongano wa data unaweza kutengeneza kutokuwa na uhakika wenye nguvu kuliko ukosefu wa data ni mojawapo ya michango asilia zaidi ya utafiti.
Kwa mtazamo wa Verianla, ujumbe mkuu wa utafiti ni huu: si kila swali tunalouliza AI lina msingi uleule wa maarifa. Katika baadhi ya mada ubinadamu tayari umeafikiana kwa nguvu; katika baadhi ya mada maarifa ya binadamu yenyewe ni ya mgongano au hayajakamilika. Tunapojadili kuaminika kwa AI, tunapaswa kuangalia si jibu la modeli pekee, bali pia kiwango ambacho msingi wa maarifa ya binadamu unaobeba jibu hilo umekaribiana.
Chanzo na Dokezo la Mbinu
Maudhui haya yameandaliwa kwa msingi wa utafiti wa preprint ulioandikwa na Jihong Park wenye kichwa “Convergence Point: A Unified Explanatory Principle for Response Uncertainty in AI Language Models”. Utafiti unashughulikia Convergence Point Theory, Full Consensus Zone, Partial Consensus Zone, Non-Consensus Zone, external measurement, internal measurement, logit entropy, token-level conflict analysis, Wikipedia independent validation, embedding space analysis, attention entropy, MLP causal intervention, Logit Lens, Probing Classifier na mijadala ya AI safety.
Maudhui haya si tafsiri ya neno kwa neno; wazo kuu la utafiti limerahisishwa na kugeuzwa kuwa makala ya kihariri ya Kiswahili kulingana na mstari wa uchapishaji wa Verianla.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *