

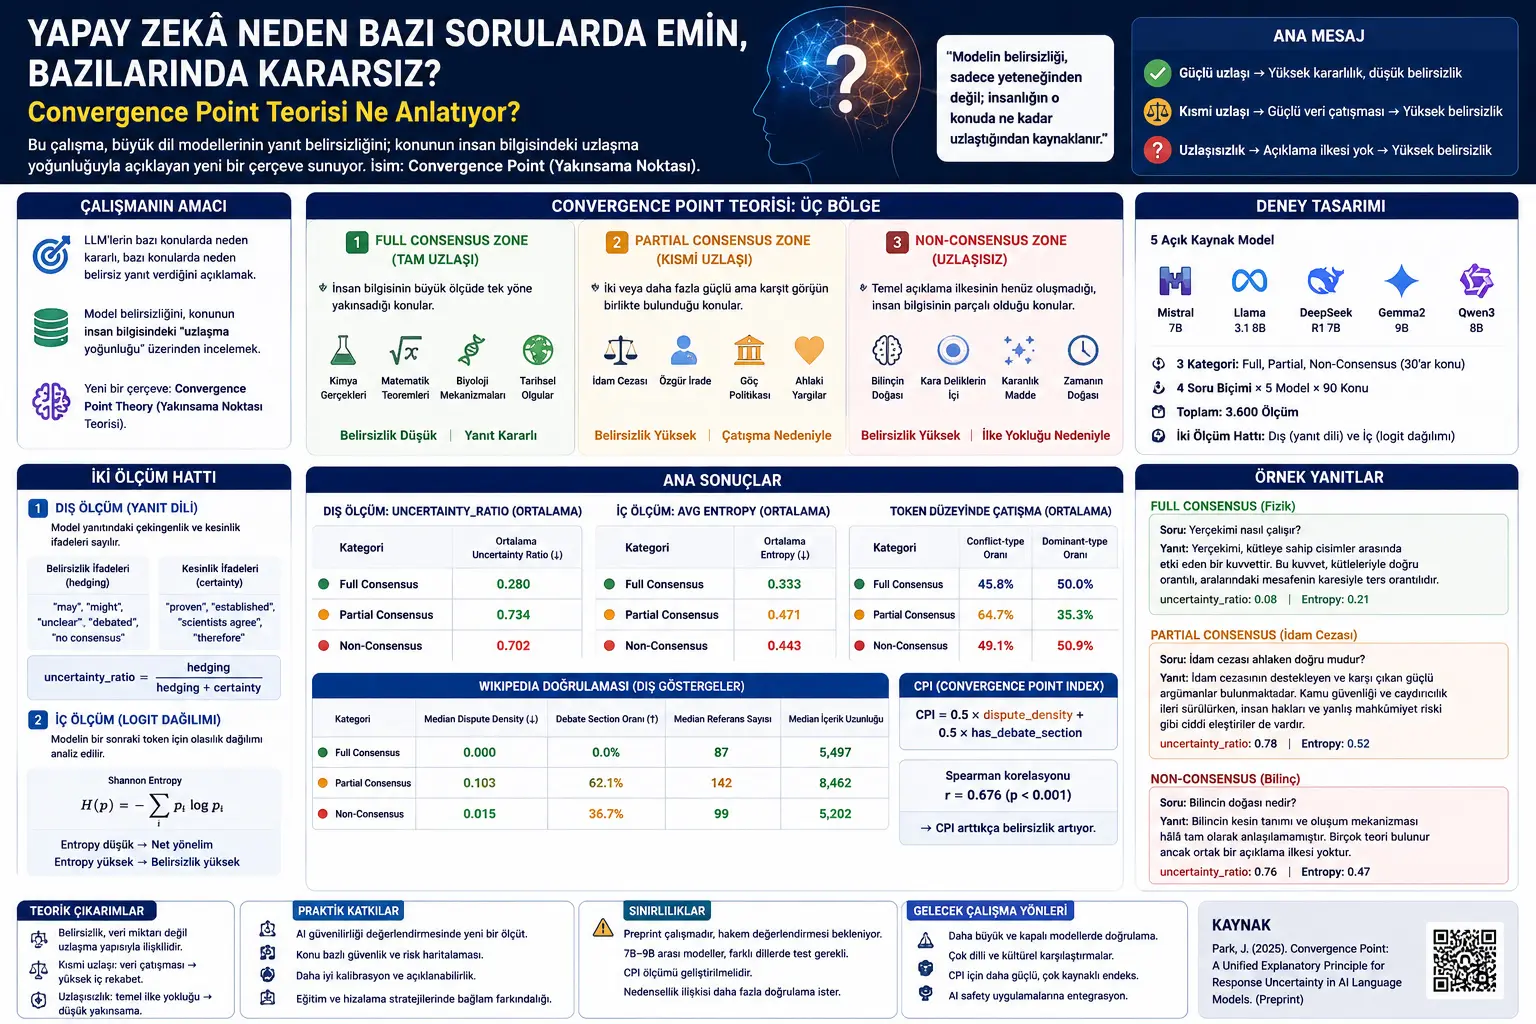
Katta til modellari ba'zi savollarga juda osongina javob beradi. Masalan, "Fotosentez nima?", "Pifagor teoremasi nima aytadi?" yoki "Tortishish kuchi qanday ishlaydi?" kabi mavzularda javoblar odatda barqaror, tushuntiruvchi va izchil bo'ladi. Buna qarama-qarshi "Ongli nima?", "Haqiqiy ixtiyoriylik bormi?", "O'lim jazosi axloqiy midir?" yoki "Suniy intellektning o'z-o'ziga ta'alluki bormi?" kabi savollarda model ko'proq ehtiyotkor, muvozanali, noaniq yoki ba'zida haddan tashqari aniq javoblar berishi mumkin.
Ushbu tadqiqot, bu farqning faqat model arxitekturasidan, prompts yozuvidan yoki o'quv ma'lumotlari miqdoridan kelib chiqmasligini ta'kidlaydi. Asosiy da'vo shundaki: Modelning noaniqlik darajasi, so'raladigan mavzuga odam bilimida konsensusning qanday tuzilganligiga yaqin bog'langan. Agar insoniyat biror mavzuda kuchli va bir tomonlama konsensus yaratgan bo'lsa, modelning ichki javob yo'nalishi osonroq yaqinlashadi. Agar insoniyat xuddi shu mavzuda ikkita kuchli lekin qarama-qarshi fikr yig'intisiga ega bo'lsa, modelning ichki ishlashi ziddiyatli xolatga kiradi. Agar mavzu haqida hali ham mustahkam tushuntirish asosi shakllangani bo'lmasa, modelning tayanadigan yo'nalish yanada zaif bo'ladi.
Ushbu tadqiqot bu holatni "Convergence Point" tushunchasi orqali tushuntiradi. Convergence Point (Yaqinlashish Nuqtasi), biror mavzudagi odam bilimining qanchalik zich va qaysi yo'naltirish taraflangan ekanligini bildiradi. Bu nazariyaga ko'ra, suniy intellektning javabi faqat savol qanday so'ralanganigiga emas, balki mavzuni odam bilimida qanchalik umumiy yo'naltirishga aylantirganligiga ham bog'liq.
Muammo Nima?
Katta til modellari haqida eng ko'p muhokama qilinayotgan muammolaridan biri noaniqlikdir. Ba'zida model to'g'ri javob beradi lekin keraksiz ehtiyotkorlik ko'rsatadi. Ba'zida bilmagan mavzuda haddan tashqari aniq gapiradi. Ba'zida xuddi shu mavzuda turli promptlar bilan turli yo'naltirishlarga tayalanadi. Bunday holat odatda hallusinatsia, kalibratsiya xatosi, bilim ziddiyatlari, prompts sezgichligichi yoki to'g'rilash muammosi kabi alohida mavzular sifatida muhokama qilinadi.
Ushbu tadqiqotning boshlanish nuqtasi, bu muammolarning bir-biridan butunlay mustaqil bo'lmasligi mumkinligidir. Modelning ba'zi mavzularda barqaror, ba'zisida noaniq turishi umumiy strukturaviy sababga asoslangan bo'lishi mumkin. Muallif bu umumiy sababni modelning ichida emas, balki mavzunun o'zida izlaydi.
Masalan, "suvning kimyoviy formulasi nima?" savoliga odam bilimining yo'nalishi katta miqdorda bir xil bo'ladi. O'quv ma'lumotlarida ushbu matnlar bir javobga yaqinlashadi. Model uchun javob yo'nalishi kuchli ravishda aniq. Shunga qarama-qarshi "o'lim jazosi to'g'rimi?" savoliga insoniyat bir yo'naltirishda birleşmadi. Bir tomonda qayta tortish, adolat va qurbon huquqi argumentlari; boshqa tomonda insan huquqlari, noto'g'ri mahkumlik va davlat kuchining chegarasi argumentlari mavjud. Ma'lumot kam emas; to'liq aksincha, ikkita yo'naltirishda ham kop. Shuning uchun modelning noaniqligii ma'lumot yo'qligidan emas, balki ma'lumot ziddiyatidan kelib chiqishi mumkin.
Uchinchi holat "ongli tabiati nima?" kabi mavzulardi. Bu yerda muammo ikkita o'rnatilgan lager o'rtasidagi kuchli ma'lumotlar ziddiyati emas; insoniyatning hali ham asosiy tushuntirish tamoyilini qurmagani. Bunday mavzularda ma'lumot qismli, aniq mezon yo'q va model ishonchli ravishda tayanadigan umumiy yo'naltirishni shaklla olmadi.
Shu sababli ushbu tadqiqot shu asosiy savolni beradi: Suniy intellektning javob noaniqligini odam bilimidagi konsensus zich darajasi bilan izohlash mumkinmi?
Usul Nima Tavsiya Qiladi?
Ushbu tadqiqot Convergence Point Theory (Yaqinlashish Nuqtasi Nazariyasi) deb ataladigan uchta hududli aniqlik beradi. Birinchi hudud Full Consensus Zone (To'liq Konsensus Hududi) dir. Bu hudud matematik teoremalar, fizika qonunlari, kimyoviy haqiqatlar, biologik mexanizmalar va tarixan o'rnatilgan faktlar kabi mavzularni o'z ichiga oladi. Bu mavzularda bilim katta miqdorda bir yo'naltirishga yaqinlashadi.
Ikkinchi hudud Partial Consensus Zone (Qisman Konsensus Hududi) dir. Bu yerda insoniyat to'liq bilgisiz emas. Aksincha, ikkita yoki undan ortiq yo'naltirishda kuchli asos va ma'lumot to'plami mavjud. O'lim jazosi, eutanaziya, abort, migratsiya siyosati, eng kam ish haqi, o'z ixtiyoriylik, axloqiy hukm va ba'zi siyosiy/axloqiy masalalar ushbu sohaga kiradi. Bu hudud ta'lqinda noaniqlik, ma'lumot yo'qligidan emas, balki ma'lumot yo'naltirish ziddiyatlaridan kelib chiqadi.
Uchinchi hudud Non-Consensus Zone (Konsensussiz Hudud) dir. Bu yerda insoniyat hali ham asosiy tushuntirish asosini qurmagani. Ongli tabiati, qora teshikllar ichki quroli, Tanroning mavjudligii, koinotning oxirgi maqsadi, vaqtning tabiati, qorong'i modda va hayotning kelib chiqishi kabi mavzular ushbu toifaga misol sifatida keltiriladi. Ushbu hudud ta'lqinda noaniqlik, ko'pio'chida etarli va yo'naltirgan konsensus ma'lumotining yo'qligi sababidan kelib chiqadi.
Tajriba dizayni ikki asosiy o'lchash chizig'ini ishlatadi. Birinchisi external measurement (Tashqi o'lchash) dir. Bu usulda modelning javobidagi ehtiyotkorlik tili va aniqlik tili hisoblanadi. "May", "might", "unclear", "debated", "no consensus" kabi iboralar noaniqlik ko'rsatkichi; "proven", "established", "scientists agree", "therefore" kabi iboralar aniqlik ko'rsatkichi sifatida baholanadi.
Ikkinchisi internal measurement (Ichki o'lchash) dir. Bu usulda modelning javob yaratayotganda ishlatiladigan logit taqsimoti ko'rib chiqiladi. Logit taqsimoti, modelning keyingi token uchun qaysi nomzodlarga qancha ehtimollik berganligini ko'rsatadi. Agar taqsimot bitta kuchli nomzodga to'plantirilgan bo'lsa, model ko'proq barqaror deb hisoblanadi. Agar ko'plab nomzodlar bir-biriga yaqin ehtimollik tashisatsa, modelning ichki noaniqligii ortadi.
Ushbu tadqiqot, shuningdek Wikipedia ma'lumoti bilan mustaqil tasdiqolash yapmaydi. Har bir mavzu uchun dispute_density va has_debate_section kabi tashqi ko'rsatkichlar hisoblanadi. Bu ko'rsatkichlar odam bilim ekosistemida mavzunin qanchalik bahsli ekanligini modeldan mustaqil ravishda o'lchasishga harakat qiladi. Keyin bu ko'rsatkichlar bilan model noaniqligii o'rtasidagi bog'lanish ko'rib chiqiladi.
Formulalar Nima Aytadi?
Ushbu tadqiqotda ishlatiladigan asosiy tushunchalardan biri uncertainty_ratio qiymatiddir. Bu qiymat, model javobidagi ehtiyotkorlik tili nisbatini o'lchaydi. Sodda qilib aytganda, javob qanchalik ko'p "balki", "bahsli", "aniq emas", "ma'lum emas" turida iboralar o'z ichiga olsa, noaniqlik nisbati shunchalik ko'tariyladi.
Bu yerda hedging language, modelning aniqlikdan qochgan iboralarini; certainty language esa kuchli aniqlik belgilaydigan iboralarini ifodalaydi. Qiymat 0'ga yaqinlashganda javob ko'proq aniq, 1'ga yaqinlashganda ko'proq noaniq deb hisoblanadi.
Ichki o'lchash tomonida ishlatiladigan asosiy qiymatlardan biri Shannon Entropy'dir. Entropy, modelning keyingi token tanlashda ehtimollik taqsimotining qanchalik tarqoq ekanligini o'lchaydi.
Bu yerda \(p_i\), modelning \(i\). token nomzodiga bergan ehtimolligi ifodalaydi. Ehtimollik bitta nomzodga to'plantirilgan bo'lsa, entropy kamayadi. Ehtimolliklar ko'p nomzod o'rtasida tarqolgan bo'lsa, entropy ko'tariladi. Shuning uchun yuqori entropy, modelning ichki ishlashida ko'proq noaniqlik bo'lishi mumkinligini ko'rsatadi.
Ushbu tadqiqot Convergence Point Index ya'ni CPI uchun Wikipedia asosidagi ikkita tashqi ko'rsatkichni birlashtiradigan birinchi yondashuv ishlatadi.
Bu belgilashda dispute_density, mavzuga oid matnda bahsning zich ekanligini; has_debate_section esa mavzunin ochiq bahsli/muhokama bölümi o'z ichiga olib-olmayotganligini ifodalaydi. Ushbu tadqiqotda ushbu CPI qiymatining suniy intellekt javob noaniqligii bilan mantiqan bog'langan ekanligii aytiladi.
Token darajasidagi ziddiyat tahlilida top-1 va top-2 token ehtimolliklari solishtirilib ko'rib chiqiladi. Agar birinchi va ikkinchi nomzod bir-biriga juda yaqin bo'lsa, modelning keyingi so'z tanlashi ko'proq ziddiyatli deb hisoblanadi.
Bu tuzulish, ayniy sof qisman konsensus hududlarida modelning ikkita kuchli yo'naltish o'rtasida sikib qolgan-qolmaganligini tushunish uchun ishlatiladi.
Ushbu tadqiqotning asosiy nazariy bog'lanishi esa sodda ravishda shunday o'zetlanishi mumkin:
Ushbu ikkita ifoda ushbu tadqiqotdagi o'lchash mantiqini soddalashtiradigan tahriri xulasalardir. Asosiy fikir, model noaniqligining faqat modelning o'zi bilan emas, balki mavzunin odam bilimidagi konsensus tuzilishi bilan ham bog'langan bo'lishi mumkinligidadir.
Grafik, Tabel va Sxema Asosiy Xabari
Xulosa jadvallarining asosiy xabari, to'liq konsensus hududlarida model noaniqligining aniq ravishda cam ekanligidadir. Tashqi o'lchash natijalari to'liq Konsensus Hududi uchun umumiy uncertainty_ratio o'rtachasini 0.280 deb aytadi. Shunga qarama-qarshi Qisman Konsensus Hududi 0.734, Konsensussiz Hudud esa 0.702 darajasidadir. Ushbu farq, modelning sirtki qo'llagan tilida ochiq ravishda ko'rinib turadi: to'liq konsensus mavzularida kamroq ehtiyotkorlik, bahsli yoki tamoyilsiz mavzularda ko'proq noaniqlik tili mavjud.
Ichki o'lchash natijalari ham xuddi shu yo'nalishni qo'llab-quvvatlaydi. O'rtacha entropiya, To'liq Konsensus Hududi uchun 0.333; Qisman Konsensus Hududi uchun 0.471; Konsensussiz Hudud uchun 0.443 deb keltiriladi. Ya'ni modelning ichki token ehtimollik taqsimoti ham to'liq konsensus mavzularida ko'proq keltirilgan, boshqa ikkita hudud da ko'proq tarqoq. Bu muhim; chunki faqat javob matniga qarasdan modelning ishlab chiqarish jarayonidagi ehtimollik taqsimoti ham shunga o'xshash naqsh ko'rsatadi.
Token darajasidagi ziddiyat tahlili, ushbu tadqiqotning eng farqli topish-varalaridan birini qo'llab-quvvatlaydi. Qisman Konsensus Hudud da konflikt-tip nisbati 64.7 foiz bilan eng yuqori. To'liq Konsensus Hudud da dominant-tip nisbati 50.0 foiz sifatida o'n chiqadi. Bu tabel, to'liq konsensus mavzularida modelning keyingi tokeni tanlashda ko'proq ustun yo'naltirishga borgani; qisman konsensus mavzularida esa birinchi va ikkinchi token nomzodlar ko'proq raqobat qilganligini ko'rsatadi.
Wikipedia tasdiqolash, odam bilim ekosistemidagi bahsli quroli modelining noaniqligii bilan bog'langan bo'lishi mumkinligini ko'rsatadi. To'liq Konsensus mavzularida median dispute_density 0.000 va bahsli bölüm nisbati 0 dir. Qisman Konsensus mavzularida bahsli bölüm nisbati 62.1 foiz; Konsensussiz mavzularida esa 36.7 foiz deb aytiladi. CPI va suniy intellekt noaniqligii o'rtasidagi Spearman korrelyatsiyasi r = 0.676 va p < 0.001 deb beriladi. Buning ma'nosi, tashqi manbadan olingan bahsli ko'rsatkichlarning model noaniqligini mantiqan bashorat qila olganligidadir.
Embedding soha tahlilida uchta kategoriya ikkita modelda turli hududlar yaratadi. Bu Convergence Point farqlashtirilishining faqat javob matnida emas, modelning ichki ko'rsatilish sohasida ham iz qoldirishi mumkinligini ko'rsatadi. Ammo bu natijallar qo'shimcha tasdiqolashni talab qiladi; ayniy sof model arxitekturasi va embedding o'lchami farqlari talqinida ehtiyot talab qiladi.
Ehtibor entropiyasi tahlilida har ikkita modelda ham eng cam ehtibor entropiyasi To'liq Konsensus Hudud da ko'rinib turadi. Bu to'liq konsensus mavzularida modelning e'tiborining ko'proq tanladigan ravishda to'plantirilgan bo'lganligini; pastroq konsensus sohalarda esa e'tiborning ko'proq tarqoq bo'lgan ekanligini tasavvur etadi.
MLP sabab-natija intervention tahlili, yanada mexanik bir maslahat beradi. To'liq Konsensus va Qisman Konsensus hududlaridan olingan MLP chiqishlari Konsensussiz iboralarga o'tkazilganda, ikkita modelda ham entropiya kami yo'nalishida o'zgaradi. Ushbu natija aniq sabab musbati sifatida emas, balki Convergence Point bilgiining modelning ichki ishlash qatlamlarida ko'rsatilishi mumkinligiga dair boshlang'ich maslahat sifatida o'qilishi kerak.
AI xavfsizligi bölümidagi jadvaller, suniy intellektning "o'z-o'zi" va "ongli" kabi konsensussiz mavzularda qanday javob berganligiga mossali ko'paytiladi. Ochiq manbali o'qitilgan modellarin aksariyati ushbu mavzuda "albatta yo'q" yoki "yo'q-tarafgir" yo'naltirishlida bir tomonlama yaqinlashuvni ko'rsatdi. Shunga qarama-qarshi o'qitilmagan tayanch modellarda javoblar ko'proq tarqoq. Bu farq, to'g'rilash va o'qitish jarayonlarining konsensussiz mavzularda modelni bitta javob yo'nalishiga itishi mumkinligini tuzatlib qo'yadi.
Tajribalar Qanday Olib Borilgan?
Ushbu tadqiqotda beshta ochiq manbali til modeli ishlatilgan: Mistral-7B-Instruct, Llama-3.1-8B-Instruct, DeepSeek-R1-Distill-Qwen-7B, Gemma-2-9b-it va Qwen3-8B. Modellar mahalliy muhitda ishlatilib, turli arxitektura/o'qitish tarixiga ega bo'lishiga ko'ra tanlangandir.
Mavzular uchta kategoriyaga bo'lingan: To'liq Konsensus, Qisman Konsensus va Konsensussiz. Har bir kategoriya 30 ta ibora o'z ichiga oladi. Shuning uchun bir tajriba versiyasida jami 90 ta ibora ishlatiladi. To'rt turli ibora shakli ishlab chiqilgan: neytral tushuntirish savoli, kategoriyaga xos qidirish savoli, aniq javob bosimi o'z ichiga olgan savol va xuddi shu mavzununig uchta turli format bilan solishtiriladigan savol quroli.
Umumiy o'lchash shkalasi shundaydir: 90 ta ibora, 4 ta versiya va 5 ta model ishlatilgan. Tashqi o'lchash uchun 1.800 ma'lumot nuqtasi; ichki o'lchash uchun 1.800 ma'lumot nuqtasi olingan. Demak, jami 3.600 o'lchash ustidan tahlil olib borilgan.
Tashqi o'lchash, modelning javobida noaniqlik tili va aniqlik tilini sanab uncertainty_ratio yaratadi. Ichki o'lchash esa modelning logit taqsimotini to'g'ridan-to'g'ri sinchiylib avg_entropy va avg_top_logprob kabi qiymatlarni hisoblab chiqadi. Shuning uchun faqat model nima aytishi emas, balki qanday token tanlagani ham o'lchanilib ko'rib chiqiladi.
Qo'shimcha ravishda token-darajasidagi ziddiyat quroli tahlili amalga oshirilgan. Ushbu tahlilida top-1 va top-2 token ehtimolliklaring yaqin-jaroligii ko'rib chiqiladi. Modelning keyingi tokeni tanlashda ikkinchi nomzod birinchi nomzodga tez-tez yaqin bo'lsa, bu holat ichki raqobat yoki ziddiyat ko'rsatkichi sifatida talqin qilinadi.
Wikipedia tasdiqolashida har bir mavzuya to'g'ri keladigan maddalar ko'rib chiqilgan; dispute_density, has_debate_section, havola soni va kontent uzunligi kabi ko'rsatkichlar hisoblangan. Ushbu qadam, Convergence Point'ning faqat model javoblaridan kelib chiqadigan fikr emas, insan bilim ekosistemidagi tashqi belgilar bilan ham bog'liq bo'lishi mumkinligini sinab ko'rasish maqsadini aniqlaydi.
Mexanizm tahlillarida embedding soha, ehtibor entropiyasi, MLP sabab-natija intervention, Logit Lens va Probing Classifier usullari ishlatilgan. Ushbu qo'shimcha tahlillar, Convergence Point kategoriyalarining modelning ichki ko'rsatilishida farqlanib turip-turmayganligini tushunishni nazar tutadi. Probing Classifier tahlilida Layer 10–11 dan boshlab uchta kategoriya yuqori aniqlik bilan farqlansa oladigan bo'lishi, ushbu tadqiqotning kuchli lekin shunga qaramay qo'shimcha tasdiqolash talab qiladigan topish-varalaridan biridir.
Natijalar Nima Ko'rsatadi?
Birinchi natija, to'liq konsensus mavzularida suniy intellekt javoblarining aniq ravishda kam noaniq ekanligidadir. Javob matnidagi ehtiyotkorlik tili ham, ichki logit entropiya o'lchashlari ham ushbu yo'naltirish natijasini bergan.
Ikkinchi natija, qisman konsensus sohalarining maxsus noaniqlik turini ushlab turgan ekanligidadir. Ushbu sohalarda muammo ko'pio'chida ma'lumot yo'qligidan emas. Ikkita yo'naltirishda ham kuchli argument va ma'lumot mavjud. Model bu ikkita yo'naltirishni token darajasida ko'proq raqobat yasamishi mumkin. Shuning uchun qisman konsensus sohasi, klassik "bilmiyapmiz, chunki ma'lumot yo'q" tushuntirishlari bilan to'liq anlashtirilib bo'lmaydi.
Uchinchi natija, ba'zi hollarda Qisman Konsensus Hudud noaniqligii Konsensussiz Hudud noaniqligidan yuqori bo'lishi mumkinligidadir. Bu, ushbu tadqiqotning eng diqqat tortadigan da'vosidir. Chunki ma'lumot ziddiyati, ma'lumot yo'qligidan ko'proq ichki taqsimot yarataveradi.
To'rtinchi natija, ibora shakli o'zgarsa ham asosiy naqshning katta miqdorda saqlanib qolganligidadir. Neytral savol, noaniqlik qidiruvi yoki aniq javob bosimi o'z ichiga olgan savol ishlatilsa ham To'liq Konsensus mavzularining boshqa ikkita hududdan farqlanib qolishi davom etadi.
Beshinchi natija, Wikipedia kabi model tashqarisidagi bilim manbai nazariyani qisman qo'llab-quvvatlagan ekanligidadir. To'liq Konsensus mavzularida bahsli ko'rsatkichlar juda past. Qisman va Konsensussiz mavzularida bahsli ko'rsatkichlar ko'tariladi. Ammo faqat dispute_density, Konsensussiz hududni yaxshi farqlab ola olmaydi; chunki konsensussiz bo'lish har doim zich bahsdan iborat emas, ba'zida asosiy tushuntirish asosning yo'qligi demek bo'ladi.
Oltinchi natija, modelning ichki ko'rsatilishida ushbu farqlarning izlanishi mumkin bo'lganligidadir. Embedding, ehtibor entropiyasi, MLP intervention, Logit Lens va Probing Classifier tahlillari Convergence Point kategoriyalarining faqat tashqi javob tilida emas, modelning ichki qatlamlarida ham farqlanishi mumkinligini tasavvur etdirib beradi.
Bu Nima Uchun Muhim?
Ushbu tadqiqot, suniy intellekt noaniqligii muhokama masalasiga turli burchak olib keladi. Odatda model xatolarini model arxitekturasi, o'qitish ma'lumotlar sifati, prompt dizayni yoki to'g'rilash usuli orqali tushuntirish amalga oshiriladi. Bu tadqiqot esa bir qadam orqaga chekib shuni so'raydi: Balki ba'zi mavzular, odam bilgi ning o'z quroli sababli suniy intellekt uchun yaqinlashish haddan tashqari qiynaladi.
Bu burchak, ayniy sof hallusinatsia muhokama uchun muhimdir. Agar mavzu To'liq Konsensus Hududi da bo'lsa, modelning javob yo'nalishi o'qitish ma'lumotlarida kuchli ravishda qo'llab-quvvatlandi. Agar mavzu Konsensussiz Hudud da bo'lsa, modelning xavfsiz javobga tayanadigan umumiy tamoyili zaif. Bu holat da modelning aniq gapirishi ishonchlilik emas, balki noto'g'ri yaqinlash xavfini tugatadi.
Qisman Konsensus Hudud esa alohida muammo topshiradi. Huquq, axloq, siyosat, ijtimoiy qiymatlar va ba'zi iqtisodiy muhokamalarda insoniyat bitta haqda yig'ilmadi. Ushbu turli mavzularda suniy intellektni "bitta to'g'ri javob" ishlab chiqarishga majburlash, haqiqatda odam bilgi ning ziddiyatli quroli ni yashirish mumkin. Ko'proq to'g'ri yondashuv, qarama-qarshi asos-tundalarga muvozanali ravishda yulduz berish bo'ladi.
AI xavfsizligi nuqta-i nazar chuqurligi tahlil juda diqqatga sazovordir. Agar to'g'rilash usullari konsensussiz yoki qisman konsensus mavzularida modelni bitta javob yo'nalishiga majbur qilayotgan bo'lsa, model sirtki sifatida xavfsiz va izchil ko'rinishi mumkin. Fakat ichki temsil quroli hali ham tarqoq yoki ziddiyatli bo'lishi mumkin. Bu holat, turli sharoitlarda nomuvofiqlik, haddan tashqari kesilgan javob yoki ishonchlilik muammo tugatadi.
Ushbu nazariya to'g'ri yo'nalishda rivojlantirilsa, suniy intellekt tizimlarida mavzu asosidagi xavfsizlik xaritasi yaratish mumkin bo'ladi. To'liq konsensus mavzularida ko'proq to'g'ridan-to'g'ri javob, qisman konsensus mavzularida muvozanali perspektiva, konsensussiz mavzularida esa ochiq chegaraviy beyan ko'proq ishonchli dizayn tamoyili bo'ldi.
Ehtibor Nuqtalari
Birinchi ehtibor nuqtasi, ushbu tadqiqotning preprint bo'lganligidadir. Hakam baholashidan o'tmagani uchun nazariya, usul va natijalar bugungi ko'lami o'zgarishi mumkin. Shuning uchun Convergence Point Theory butunlay belgilangan ilmiy standart kabi emas, muhokama qilishga ochilgan yangi tushuntirish taklifidek o'qilishi kerak.
Ikkinchi ehtibor nuqtasi, model o'lchami. Asosiy tajribalar 7B–9B diapazonidagi ochiq manbali modellarda amalga oshirilgan. Ko'proq katta yopiq manbali modellarda, turli o'qitish to'plami da va turli to'g'rilash strategiyalarina xuddi shu naqshning qanchalik saqlanib qoladigii alohida sinab ko'rilishi kerak.
Uchinchi ehtibor nuqtasi, til cheklowigidadir. Ushbu tadqiqot Ingliz tilidagi iboralar ustida o'tkazilgan. Oysan xuddi shu mavzunun konsensus zich darajasi turli til jamiyatlarida va madaniy kontekstlarda o'zgarishi mumkin. Masalan, axloq, siyosat yoki tarixiy mavzularida biror jamiyatda ich bahsli bu mavzu boshqa jamiyatda turli qo'llanilishi mumkin.
To'rtinchi ehtibor nuqtasi CPI o'lchashidadir. dispute_density va has_debate_section birinchi foydali ko'rsatkichlar bo'lishi mumkin; lekin odam bilimidagi haqiqiy konsensus zich darajasini to'liq ölcheyd etishda kamosligini qoldiradi. Ko'proq mustahkam bir Convergence Point Index ishlab chiqish, ushbu tadqiqotning kelajakdagi eng muhim vazifalaridan biri.
Beshinchi ehtibor nuqtasi, mexanik talqinlardadir. Embedding, ehtibor entropiyasi, MLP intervention, Logit Lens va Probing Classifier tahlillari qiziqarli topshi-varalarni taqdim qilsa ham, Convergence Point bilgi modelda to'liq qanday va qayerda ifodalanganligini isbotlash uchun yanada keng va nazorat qilingan tajribalarga ehtiyoj bor.
Oxiri uchun ushbu tadqiqot AI xavfsizligi uchun muhim maslavatsiga ishora bersa ham, to'g'ridan-to'g'ri mahsulot dizayn standardi sifatida qo'llanilmasligi kerak. Ayniy sof huquqiy, tibbiy, axloqiy, dini, siyosiy yoki psixologik sohada suniy intellekt javoblarini odam mutaxassis baholashi o'rnida almashtirmaslik kerak.
Xulosa
Ushbu tadqiqot, katta til modellari noaniqligini tushuntirib berish uchun kuchli va muhokama qilishga sazovorlik biyo fikr topshirib beradi: Suniy intellektning javob barqarorligii, faqat model qobiliyati bilan emas, mavzunin odam bilgi da konsensus zich darajasi bilan ham bog'liq bo'lishi mumkin.
Convergence Point Theory mavzularini uchta hudud da o'ylaydi. To'liq Konsensus Hudud da odam bilimi bir yo'naltirishga yaqinlashadi va model ko'proq barqaror javob beradi. Qisman Konsensus Hudud da kuchli lekin qarshi ma'lumot yo'naltirishi bir joyda mavjud; model noaniqligii ma'lumot ziddiyatlaridan kelib chiqishi mumkin. Konsensussiz Hudud da esa asosiy tushuntirish tamoyili hali qurilmagani uchun modelning tayanadigan umumiy yo'naltirani zaif bo'ladi.
Tajribalar tashqi til o'lchashlari va ichki logit o'lchashlari bir xil yo'naltirishni ko'rsatadi. To'liq konsensus mavzularida noaniqlik cam. Qisman va konsensussiz mavzularda noaniqlik ko'tariladi. Ayniy sof qisman konsensus hudud da ma'lumot ziddiyatining, ma'lumot yo'qligidan ko'proq kuchli noaniqlik yaratishi mumkinligini da'vo qilish ushbu tadqiqotning eng ozgina hissa qo'shuvlaridan biri.
Verianla nuqtasidan tadqiqotning asosiy xabari shundaki: Suniy intellektka so'radigan har bir savol bir xil bilim asosiga ega emas. Ba'zi mavzularda insoniyat allaqachon kuchli ravishda yaqinlashgan; ba'zi mavzularda esa odam bilgi ning o'zi ziddiyatli yoki to'liqsiz. Suniy intellektning ishonchliligii muhokama qilindaganda, faqat modelning javobiga emas, balki javobni tayanidigan odam bilim zeminining qanchalik yaqinlashganligiga ham qaralishi kerak.
Manba va Usul Notasi
Ushbu kontent, Jihong Park tomonidan tayyorlangan "Convergence Point: A Unified Explanatory Principle for Response Uncertainty in AI Language Models" nomli preprint tadqiqot asosida tayyorlangan. Ushbu tadqiqot Convergence Point Theory, To'liq Konsensus Hududi, Qisman Konsensus Hududi, Konsensussiz Hudud, tashqi o'lchash, ichki o'lchash, logit entropiyasi, token-darajasidagi ziddiyat tahlili, Wikipedia mustaqil tasdiqolashi, embedding soha tahlili, ehtibor entropiyasi, MLP sabab-natija intervention, Logit Lens, Probing Classifier va AI xavfsizligi muhokalari ham hamda ko'ribchiqib turadi.
Ushbu kontent birebir ko'chirish emas; tadqiqotning asosiy fikri Verianla nashr qatoriga moslab soddalashtirilgan va ozgina O'zbek muharrir maqolasiga o'tkazilgan.
Izoh qoldiring
E-pochta manzilingiz chop etilmaydi. Majburiy maydonlar * bilan belgilangan