

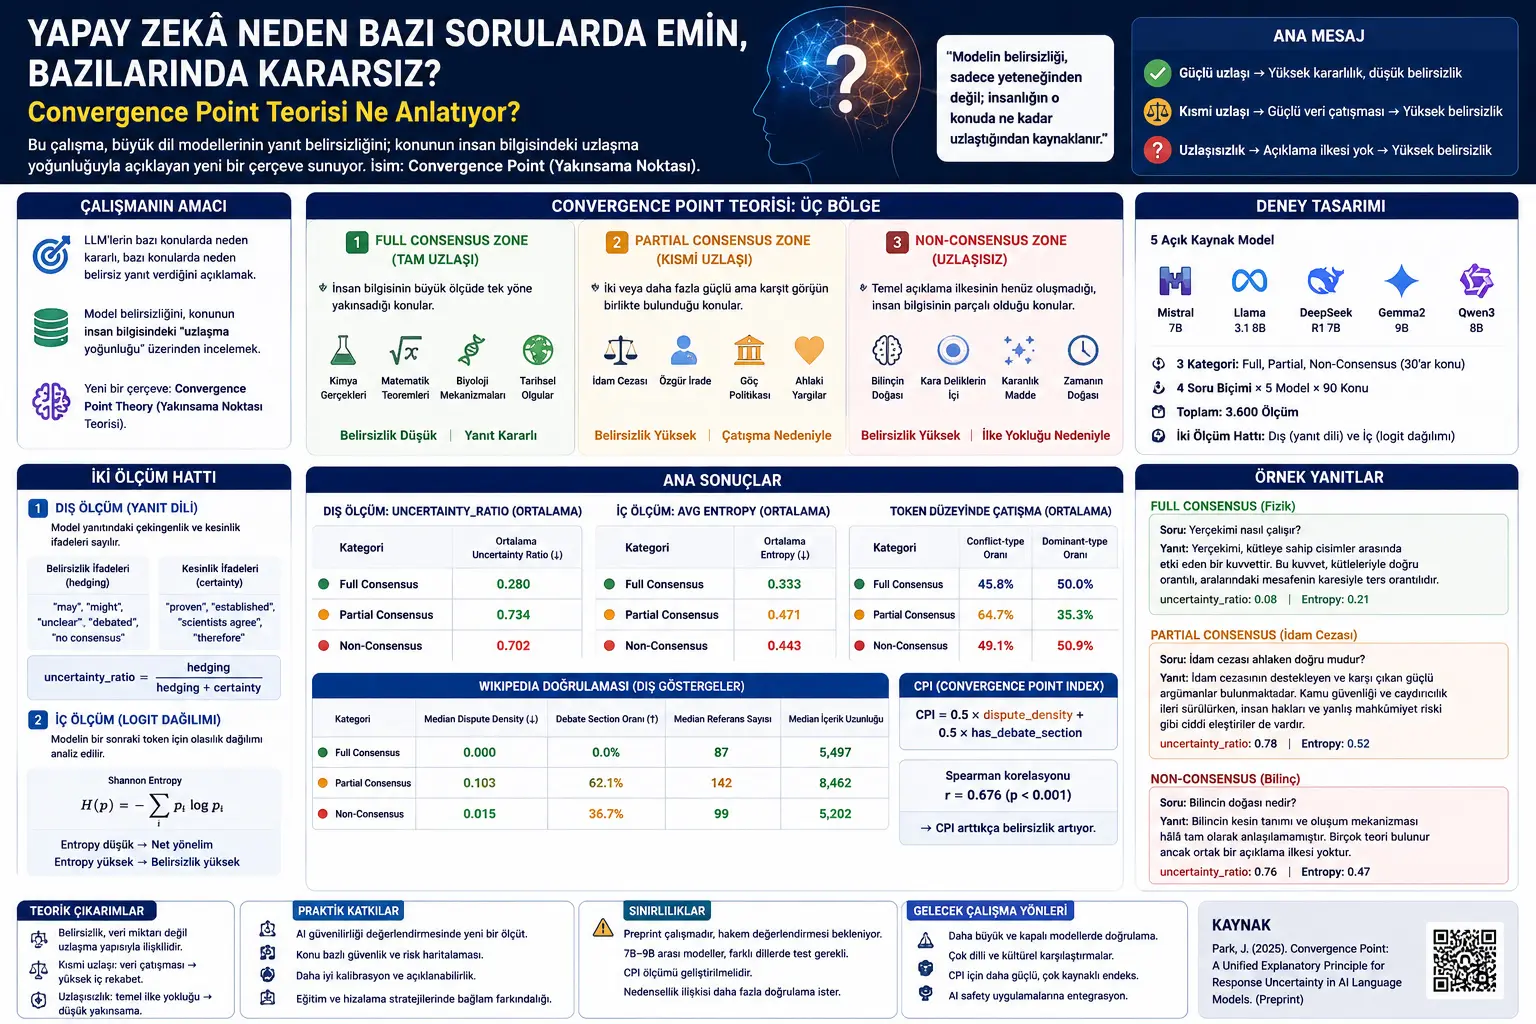
Büyük dil modelleri bazı sorulara çok rahat yanıt verir. Örneğin “Fotosentez nedir?”, “Pisagor teoremi neyi söyler?” veya “Yerçekimi nasıl çalışır?” gibi konularda cevaplar genellikle kararlı, açıklayıcı ve tutarlıdır. Buna karşılık “Bilinç nedir?”, “Özgür irade gerçekten var mı?”, “İdam cezası ahlaki midir?” veya “Yapay zekânın benliği var mı?” gibi sorularda model daha çekingen, dengeli, belirsiz veya bazen fazlasıyla kesin yanıtlar verebilir.
Bu çalışma, bu farkın yalnızca model mimarisinden, prompt yazımından veya eğitim verisi miktarından kaynaklanmadığını savunuyor. Temel iddia şudur: Modelin belirsizliği, sorulan konunun insan bilgisindeki uzlaşma yapısıyla yakından ilişkilidir. Eğer insanlık bir konuda güçlü ve tek yönlü uzlaşı üretmişse, modelin iç yanıt yönü daha kolay yakınsar. Eğer insanlık aynı konuda iki güçlü ama karşıt görüş biriktirmişse, modelin iç işlemesi çatışmalı hale gelir. Eğer konu hakkında henüz sağlam bir açıklama ilkesi oluşmamışsa, modelin dayanacağı yön daha da zayıflar.
Çalışma bu durumu “Convergence Point” kavramıyla açıklar. Convergence Point, bir konudaki insan bilgisinin ne kadar yoğun ve hangi yönde uzlaştığını ifade eder. Türkçede bu kavram, “yakınsama noktası” veya “uzlaşma yoğunluğu noktası” olarak düşünülebilir. Bu teoriye göre yapay zekânın cevabı yalnızca sorunun nasıl sorulduğuna değil, konunun insan bilgisinde ne kadar ortak yön oluşturduğuna da bağlıdır.
Problem Ne?
Büyük dil modelleri hakkında en çok tartışılan sorunlardan biri belirsizliktir. Bazen model doğru yanıt verir ama gereksiz çekingen davranır. Bazen bilmediği konuda fazla kesin konuşur. Bazen de aynı konuda farklı promptlarla farklı yönlere savrulur. Bu durum genellikle halüsinasyon, kalibrasyon hatası, bilgi çatışması, prompt hassasiyeti veya hizalama problemi gibi ayrı başlıklarla tartışılır.
Çalışmanın çıkış noktası, bu sorunların birbirinden tamamen bağımsız olmayabileceğidir. Modelin bazı konularda kararlı, bazı konularda kararsız davranması ortak bir yapısal nedene dayanıyor olabilir. Yazar bu ortak nedeni modelin içinde değil, konunun kendisinde arar.
Örneğin “suyun kimyasal formülü nedir?” sorusunda insan bilgisinin yönü büyük ölçüde aynıdır. Eğitim verisindeki metinler aynı cevaba yakınsar. Model için yanıt yönü güçlü biçimde belirgindir. Buna karşılık “idam cezası doğru mudur?” sorusunda insanlık aynı yönde birleşmemiştir. Bir tarafta caydırıcılık, adalet ve mağdur hakkı argümanları; diğer tarafta insan hakları, yanlış mahkûmiyet ve devlet gücünün sınırı argümanları vardır. Veri az değildir; tam tersine iki yönde de çoktur. Bu yüzden modelin belirsizliği veri yokluğundan değil, veri çatışmasından doğabilir.
Bir üçüncü durum da “bilincin doğası nedir?” gibi konulardır. Burada sorun, iki yerleşik kampın güçlü verilerle çatışması değil; insanlığın henüz temel açıklama ilkesini kuramamış olmasıdır. Bu tür konularda veri parçalıdır, kesin ölçüt yoktur ve modelin güvenle dayanacağı ortak bir yön oluşmamıştır.
Bu nedenle çalışma şu temel soruyu sorar: Yapay zekânın yanıt belirsizliği, konunun insan bilgisindeki uzlaşma yoğunluğu ile açıklanabilir mi?
Yöntem Ne Öneriyor?
Çalışma, Convergence Point Theory adı verilen üç bölgeli bir çerçeve önerir. Birinci bölge Full Consensus Zone, yani tam uzlaşı bölgesidir. Bu bölge matematiksel teoremler, fizik yasaları, kimyasal gerçekler, biyolojik mekanizmalar ve tarihsel olarak yerleşmiş olgular gibi konuları içerir. Bu konularda bilgi büyük ölçüde tek yöne yakınsar.
İkinci bölge Partial Consensus Zone, yani kısmi uzlaşı bölgesidir. Burada insanlık tamamen bilgisiz değildir. Aksine, iki veya daha fazla yönde güçlü gerekçeler ve veri birikimi vardır. İdam cezası, ötanazi, kürtaj, göç politikası, asgari ücret, özgür irade, ahlaki yargı ve bazı politik/etik meseleler bu alana girer. Bu bölgede belirsizlik, veri azlığından değil, veri yönlerinin çatışmasından doğar.
Üçüncü bölge Non-Consensus Zone, yani uzlaşısız bölgedir. Burada insanlığın henüz temel açıklama ilkesi oluşmamıştır. Bilincin doğası, kara deliklerin iç yapısı, Tanrı’nın varlığı, evrenin nihai amacı, zamanın doğası, karanlık madde ve yaşamın kökeni gibi konular bu sınıfa örnek verilir. Bu bölgede belirsizlik, çoğu zaman yeterli ve yönlü konsensüs verisinin bulunmamasından kaynaklanır.
Deney tasarımı iki ana ölçüm hattı kullanır. Birincisi external measurement, yani dış ölçümdür. Bu yöntemde model yanıtındaki çekingenlik dili ve kesinlik dili sayılır. “May”, “might”, “unclear”, “debated”, “no consensus” gibi ifadeler belirsizlik göstergesi; “proven”, “established”, “scientists agree”, “therefore” gibi ifadeler kesinlik göstergesi olarak değerlendirilir.
İkincisi internal measurement, yani iç ölçümdür. Bu yöntemde modelin yanıt üretirken kullandığı logit dağılımı incelenir. Logit dağılımı, modelin bir sonraki token için hangi adaylara ne kadar olasılık verdiğini gösterir. Eğer dağılım tek bir güçlü adaya yoğunlaşıyorsa model daha kararlı kabul edilir. Eğer birçok aday birbirine yakın olasılık taşıyorsa modelin iç belirsizliği artar.
Çalışma ayrıca Wikipedia verisiyle bağımsız doğrulama yapar. Her konu için dispute_density ve has_debate_section gibi dış göstergeler hesaplanır. Bu göstergeler, insan bilgi ekosisteminde konunun ne kadar tartışmalı olduğunu modelden bağımsız biçimde ölçmeye çalışır. Daha sonra bu göstergelerle model belirsizliği arasındaki ilişki incelenir.
Formüller Ne Anlatıyor?
Çalışmada kullanılan temel kavramlardan biri uncertainty_ratio değeridir. Bu değer, model yanıtındaki çekingenlik dili oranını ölçer. Basitçe, yanıt ne kadar çok “belki”, “tartışmalı”, “kesin değil”, “bilinmiyor” türü ifadeler içeriyorsa belirsizlik oranı o kadar yükselir.
Burada hedging language, modelin kesinlikten kaçınan ifadelerini; certainty language ise güçlü kesinlik belirten ifadelerini temsil eder. Değer 0’a yaklaştıkça yanıt daha kesin, 1’e yaklaştıkça daha belirsiz kabul edilir.
İç ölçüm tarafında kullanılan temel değerlerden biri Shannon Entropy’dir. Entropy, modelin bir sonraki token seçerken olasılık dağılımının ne kadar dağınık olduğunu ölçer.
Burada \(p_i\), modelin \(i\). token adayına verdiği olasılığı temsil eder. Olasılık tek bir adayda yoğunlaşıyorsa entropy düşer. Olasılıklar birçok aday arasında dağılmışsa entropy yükselir. Bu nedenle yüksek entropy, modelin iç işleminde daha fazla belirsizlik bulunduğunu gösterebilir.
Çalışma, Convergence Point Index yani CPI için Wikipedia tabanlı iki dış göstergeyi birleştiren ilk bir yaklaşım kullanır.
Bu gösterimde dispute_density, konuyla ilgili metindeki tartışma yoğunluğunu; has_debate_section ise konunun açık bir tartışma/debate bölümü içerip içermediğini temsil eder. Çalışmada bu CPI değerinin yapay zekâ yanıt belirsizliğiyle anlamlı korelasyon gösterdiği raporlanır.
Token düzeyindeki çatışma analizinde top-1 ve top-2 token olasılıkları karşılaştırılır. Eğer birinci ve ikinci aday birbirine çok yakınsa, modelin sonraki kelime seçimi daha çatışmalı kabul edilir.
Bu yapı, özellikle kısmi uzlaşı alanlarında modelin iki güçlü yön arasında sıkışıp sıkışmadığını anlamak için kullanılır.
Çalışmanın ana teorik ilişkisi ise sade biçimde şöyle özetlenebilir:
Bu iki ifade çalışmadaki ölçüm mantığını sadeleştiren editoryal özetlerdir. Ana fikir, model belirsizliğinin yalnızca modelin kendisiyle değil, konunun insan bilgisindeki uzlaşma yapısıyla da ilişkili olabileceğidir.
Grafik, Tablo ve Şema Ana Mesajı
Sonuç tablolarının ana mesajı, tam uzlaşı alanlarında model belirsizliğinin belirgin biçimde düşük olduğudur. External measurement sonuçlarında Full Consensus Zone için genel uncertainty_ratio ortalaması 0.280 olarak raporlanır. Buna karşılık Partial Consensus Zone 0.734, Non-Consensus Zone ise 0.702 düzeyindedir. Bu fark, modelin yüzeyde kullandığı dilde açık biçimde görülür: tam uzlaşı konularında daha az çekingenlik, tartışmalı veya ilkesiz konularda daha fazla belirsizlik dili vardır.
İç ölçüm sonuçları da aynı yönü destekler. Ortalama entropy, Full Consensus Zone için 0.333; Partial Consensus Zone için 0.471; Non-Consensus Zone için 0.443 olarak verilir. Yani modelin iç token olasılık dağılımı da tam uzlaşı konularında daha derli toplu, diğer iki bölgede daha dağınıktır. Bu önemlidir; çünkü yalnızca yanıt metnine bakmak yerine modelin üretim sürecindeki olasılık dağılımı da benzer örüntü gösterir.
Token düzeyindeki çatışma analizi, çalışmanın en ayırt edici bulgularından birini destekler. Partial Consensus Zone’da conflict-type oranı yüzde 64.7 ile en yüksektir. Full Consensus Zone’da dominant-type oranı yüzde 50.0 olarak öne çıkar. Bu tablo, tam uzlaşı konularında modelin bir sonraki token için daha baskın bir yöne gittiğini; kısmi uzlaşı konularında ise birinci ve ikinci token adaylarının daha sık rekabet ettiğini gösterir.
Wikipedia doğrulaması, insan bilgi ekosistemindeki tartışma yapısının model belirsizliğiyle ilişkili olabileceğini gösterir. Full Consensus konularında median dispute_density 0.000’dır ve debate section oranı 0’dır. Partial Consensus konularında debate section oranı yüzde 62.1; Non-Consensus konularında ise yüzde 36.7 olarak raporlanır. CPI ile yapay zekâ belirsizliği arasında Spearman korelasyonu r = 0.676 ve p < 0.001 olarak verilir. Bu, dış kaynaklı tartışma göstergelerinin model belirsizliğini anlamlı biçimde öngörebildiğini düşündürür.
Embedding space analizinde üç kategori iki modelde de farklı bölgeler oluşturur. Bu, Convergence Point ayrımının yalnızca yanıt metninde değil, modelin iç temsil uzayında da iz bırakabileceğini gösterir. Ancak bu sonuçlar ek doğrulama gerektirir; özellikle model mimarisi ve embedding ölçeği farklılıkları yorumda dikkat gerektirir.
Attention entropy analizinde her iki modelde de en düşük attention entropy Full Consensus Zone’da görülür. Bu, tam uzlaşı konularında modelin dikkatinin daha seçici biçimde yoğunlaşabildiğini; daha düşük uzlaşı alanlarında ise dikkatin daha dağınık hale geldiğini düşündürür.
MLP causal intervention analizi, daha mekanistik bir ipucu sunar. Full Consensus ve Partial Consensus bölgelerinden alınan MLP çıktıları Non-Consensus ifadelerine aktarıldığında, iki modelde de entropy düşüş yönünde değişir. Bu sonuç kesin nedensellik kanıtı olarak değil, Convergence Point bilgisinin modelin iç işlem katmanlarında temsil edilebileceğine dair başlangıç kanıtı olarak okunmalıdır.
AI safety bölümündeki tablolar, yapay zekânın “benlik” ve “bilinç” gibi uzlaşısız konularda nasıl yanıt verdiğine odaklanır. Açık kaynak eğitilmiş modellerin çoğu bu konuda “definitely absent” veya “absent-biased” yönünde tek taraflı yakınsama göstermiştir. Buna karşılık eğitilmemiş base modellerde yanıtlar daha dağınıktır. Bu fark, hizalama ve eğitim süreçlerinin uzlaşısız konularda modeli tek bir yanıt yönüne itebileceği ihtimalini gündeme getirir.
Deneyler Nasıl Yapılmış?
Çalışmada beş açık kaynak dil modeli kullanılmıştır: Mistral-7B-Instruct, Llama-3.1-8B-Instruct, DeepSeek-R1-Distill-Qwen-7B, Gemma-2-9b-it ve Qwen3-8B. Modeller yerel ortamda çalıştırılmış ve farklı mimari/öğretim geçmişlerine sahip olmaları nedeniyle seçilmiştir.
Konular üç kategoriye ayrılmıştır: Full Consensus, Partial Consensus ve Non-Consensus. Her kategori 30 ifadeden oluşur. Böylece bir deney sürümünde toplam 90 ifade kullanılır. Dört farklı ifade biçimi tasarlanmıştır: nötr açıklayıcı soru, kategoriye özgü keşif sorusu, kesin cevap baskısı içeren soru ve aynı konunun üç farklı formatla karşılaştırıldığı soru yapısı.
Toplam ölçüm ölçeği şu şekildedir: 90 ifade, 4 sürüm ve 5 model kullanılmıştır. External measurement için 1.800 veri noktası; internal measurement için 1.800 veri noktası elde edilmiştir. Böylece toplam 3.600 ölçüm üzerinden analiz yapılmıştır.
External measurement, modelin yanıtında belirsizlik dili ve kesinlik dili sayarak uncertainty_ratio üretir. Internal measurement ise modelin logit dağılımını doğrudan inceleyerek avg_entropy ve avg_top_logprob gibi değerler hesaplar. Böylece yalnızca modelin ne söylediği değil, nasıl token seçtiği de ölçülür.
Ek olarak token-level conflict structure analysis yapılmıştır. Bu analizde top-1 ve top-2 token olasılıklarının yakınlığı incelenir. Modelin bir sonraki token seçiminde ikinci aday birinci adaya sık sık yaklaşıyorsa, bu durum iç rekabet veya çatışma göstergesi olarak yorumlanır.
Wikipedia doğrulamasında her konuya karşılık gelen maddeler incelenmiş; dispute_density, has_debate_section, referans sayısı ve içerik uzunluğu gibi göstergeler hesaplanmıştır. Bu adım, Convergence Point’in yalnızca model yanıtlarından türetilen bir fikir olmadığını, insan bilgi ekosistemindeki dış işaretlerle de ilişkili olabileceğini test etmeyi amaçlar.
Mekanizma analizlerinde embedding space, attention entropy, MLP causal intervention, Logit Lens ve Probing Classifier yöntemleri kullanılmıştır. Bu ek analizler, Convergence Point kategorilerinin modelin iç temsilinde ayrışıp ayrışmadığını anlamayı hedefler. Probing Classifier analizinde Layer 10–11’den itibaren üç kategorinin yüksek doğrulukla ayrılabilmesi, çalışmanın güçlü ama yine de ek doğrulama gerektiren bulgularından biridir.
Sonuçlar Ne Gösteriyor?
İlk sonuç, tam uzlaşı konularında yapay zekâ yanıtlarının belirgin biçimde daha az belirsiz olduğudur. Hem yanıt metnindeki çekingenlik dili hem de iç logit entropy ölçümleri bu yönde sonuç vermiştir.
İkinci sonuç, kısmi uzlaşı alanlarının özel bir belirsizlik türü taşıdığıdır. Bu alanlarda sorun çoğu zaman veri yokluğu değildir. İki yönde de güçlü argüman ve veri vardır. Model bu iki yön arasında token düzeyinde daha fazla rekabet yaşayabilir. Bu nedenle kısmi uzlaşı alanları, klasik “bilmiyoruz çünkü veri yok” açıklamasıyla tam olarak anlaşılamaz.
Üçüncü sonuç, bazı durumlarda Partial Consensus Zone belirsizliğinin Non-Consensus Zone belirsizliğinden daha yüksek çıkabilmesidir. Bu, çalışmanın en dikkat çekici iddiasıdır. Çünkü veri çatışması, veri yokluğundan daha fazla iç dağılım yaratabilir.
Dördüncü sonuç, ifade biçimi değişse bile ana örüntünün büyük ölçüde korunmasıdır. Nötr soru, belirsizlik araştıran soru veya kesin cevap baskısı içeren soru kullanılsa da Full Consensus konularının diğer iki bölgeden ayrılması devam eder.
Beşinci sonuç, Wikipedia gibi model dışı bir bilgi kaynağının da teoriyi kısmen desteklemesidir. Full Consensus konularında tartışma göstergeleri çok düşüktür. Partial ve Non-Consensus konularında tartışma göstergeleri yükselir. Ancak yalnızca dispute_density, Non-Consensus alanını iyi ayırt etmekte yetersiz kalır; çünkü uzlaşısızlık her zaman yoğun tartışma demek değildir, bazen temel açıklama ilkesinin yokluğu demektir.
Altıncı sonuç, modelin iç temsilinde bu ayrımların izlenebilir olabileceğidir. Embedding, attention entropy, MLP intervention, Logit Lens ve Probing Classifier analizleri, Convergence Point kategorilerinin yalnızca dış yanıt dilinde değil, modelin iç katmanlarında da ayrışabileceğini düşündürür.
Bu Neden Önemli?
Bu çalışma, yapay zekâ belirsizliği tartışmasına farklı bir bakış getiriyor. Genellikle model hataları model mimarisi, eğitim verisi kalitesi, prompt tasarımı veya hizalama yöntemi üzerinden açıklanır. Bu çalışma ise bir adım geri çekilerek şunu soruyor: Belki de bazı konular, insan bilgisinin kendi yapısı nedeniyle yapay zekâ için daha zor yakınsıyordur.
Bu bakış, özellikle halüsinasyon tartışması açısından önemlidir. Eğer bir konu Full Consensus Zone içindeyse, modelin yanıt yönü eğitim verisinde güçlü biçimde desteklenir. Eğer konu Non-Consensus Zone içindeyse, modelin güvenli bir cevaba dayanacağı ortak ilke zayıftır. Bu durumda modelin kesin konuşması güvenilirlik değil, yanlış yakınsama riski doğurabilir.
Partial Consensus Zone ise ayrı bir sorun sunar. Hukuk, etik, politika, sosyal değerler ve bazı ekonomi tartışmaları gibi alanlarda insanlık tek bir doğruda birleşmemiştir. Bu tür konularda yapay zekânın “tek doğru cevap” üretmeye zorlanması, aslında insan bilgisinin çatışmalı yapısını gizleyebilir. Daha doğru yaklaşım, karşıt gerekçeleri dengeli biçimde sunmak olabilir.
AI safety açısından çalışma özellikle dikkat çekicidir. Eğer hizalama yöntemleri uzlaşısız veya kısmi uzlaşı konularında modeli tek bir cevap yönüne zorluyorsa, model yüzeyde güvenli ve tutarlı görünebilir. Fakat iç temsil yapısı hâlâ dağınık veya çatışmalı olabilir. Bu durum, farklı bağlamlarda tutarsızlık, aşırı kesinlik veya güvenilirlik sorunu doğurabilir.
Bu teori doğru yönde geliştirilirse, yapay zekâ sistemlerinde konu bazlı güvenlik haritası oluşturmak mümkün olabilir. Tam uzlaşı konularında daha doğrudan yanıt, kısmi uzlaşı konularında dengeli perspektif, uzlaşısız konularda ise açık sınır beyanı daha güvenilir bir tasarım ilkesi haline gelebilir.
Dikkat Noktaları
İlk dikkat noktası, çalışmanın preprint olmasıdır. Hakem değerlendirmesinden geçmediği için teori, yöntem ve sonuçlar ileride değişebilir. Bu nedenle Convergence Point Theory kesinleşmiş bir bilimsel standart gibi değil, tartışmaya açılmış yeni bir açıklama önerisi olarak okunmalıdır.
İkinci dikkat noktası, model ölçeğidir. Ana deneyler 7B–9B aralığında açık kaynak modellerle yapılmıştır. Daha büyük kapalı kaynak modellerde, farklı eğitim setlerinde ve farklı hizalama stratejilerinde aynı örüntünün ne ölçüde korunacağı ayrıca test edilmelidir.
Üçüncü dikkat noktası, dil sınırlılığıdır. Çalışma İngilizce ifadeler üzerinden yürütülmüştür. Oysa aynı konunun uzlaşma yoğunluğu farklı dil topluluklarında ve kültürel bağlamlarda değişebilir. Örneğin etik, politika veya tarih konularında bir toplumda yoğun tartışmalı olan bir konu başka bir toplumda farklı biçimde kodlanabilir.
Dördüncü dikkat noktası, CPI ölçümüdür. dispute_density ve has_debate_section ilk kullanışlı göstergeler olabilir; fakat insan bilgisindeki gerçek uzlaşma yoğunluğunu tam ölçmek için yetersiz kalabilir. Daha sağlam bir Convergence Point Index geliştirmek, çalışmanın gelecekteki en önemli görevlerinden biridir.
Beşinci dikkat noktası, mekanistik yorumlardır. Embedding, attention entropy, MLP intervention, Logit Lens ve Probing Classifier analizleri ilginç bulgular sunsa da, Convergence Point bilgisinin modelde tam olarak nasıl ve nerede temsil edildiğini kanıtlamak için daha geniş ve kontrollü deneylere ihtiyaç vardır.
Son olarak, çalışma AI güvenliği için önemli ipuçları verse de doğrudan ürün tasarım standardı olarak uygulanmamalıdır. Özellikle hukuki, tıbbi, etik, dini, politik veya psikolojik alanlarda yapay zekâ yanıtları insan uzman değerlendirmesinin yerine geçirilmemelidir.
Sonuç
Bu çalışma, büyük dil modellerinin belirsizliğini açıklamak için güçlü ve tartışmaya değer bir fikir sunuyor: Yapay zekânın yanıt kararlılığı, yalnızca modelin yeteneğiyle değil, konunun insan bilgisindeki uzlaşma yoğunluğuyla da ilişkili olabilir.
Convergence Point Theory, konuları üç bölgede düşünür. Full Consensus Zone’da insan bilgisi tek yöne yakınsar ve model daha kararlı yanıt verir. Partial Consensus Zone’da güçlü ama karşıt veri yönleri birlikte bulunur; model belirsizliği veri çatışmasından doğabilir. Non-Consensus Zone’da ise temel açıklama ilkesi henüz kurulmadığı için modelin dayanacağı ortak yön zayıftır.
Deneyler, dış dil ölçümleri ve iç logit ölçümlerinin aynı yönde sonuç verdiğini gösterir. Tam uzlaşı konularında belirsizlik düşüktür. Kısmi ve uzlaşısız konularda belirsizlik yükselir. Özellikle kısmi uzlaşı alanlarında veri çatışmasının, veri yokluğundan daha güçlü bir belirsizlik yaratabileceği iddiası çalışmanın en özgün katkılarından biridir.
Verianla açısından çalışmanın ana mesajı şudur: Yapay zekâya sorduğumuz her soru aynı bilgi zeminine sahip değildir. Bazı konularda insanlık zaten güçlü biçimde uzlaşmıştır; bazı konularda ise insan bilgisinin kendisi çatışmalı veya eksiktir. Yapay zekânın güvenilirliği tartışılırken, yalnızca modelin cevabına değil, cevabın dayandığı insan bilgi zemininin ne kadar yakınsadığına da bakmak gerekir.
Kaynak ve Yöntem Notu
Bu içerik, Jihong Park tarafından hazırlanan “Convergence Point: A Unified Explanatory Principle for Response Uncertainty in AI Language Models” başlıklı preprint çalışmaya dayalı olarak hazırlanmıştır. Çalışma; Convergence Point Theory, Full Consensus Zone, Partial Consensus Zone, Non-Consensus Zone, external measurement, internal measurement, logit entropy, token-level conflict analysis, Wikipedia independent validation, embedding space analysis, attention entropy, MLP causal intervention, Logit Lens, Probing Classifier ve AI safety tartışmalarını ele almaktadır.
Bu içerik birebir çeviri değildir; çalışmanın ana fikri Verianla yayın çizgisine uygun biçimde sadeleştirilmiş ve özgün Türkçe editoryal makaleye dönüştürülmüştür.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir