

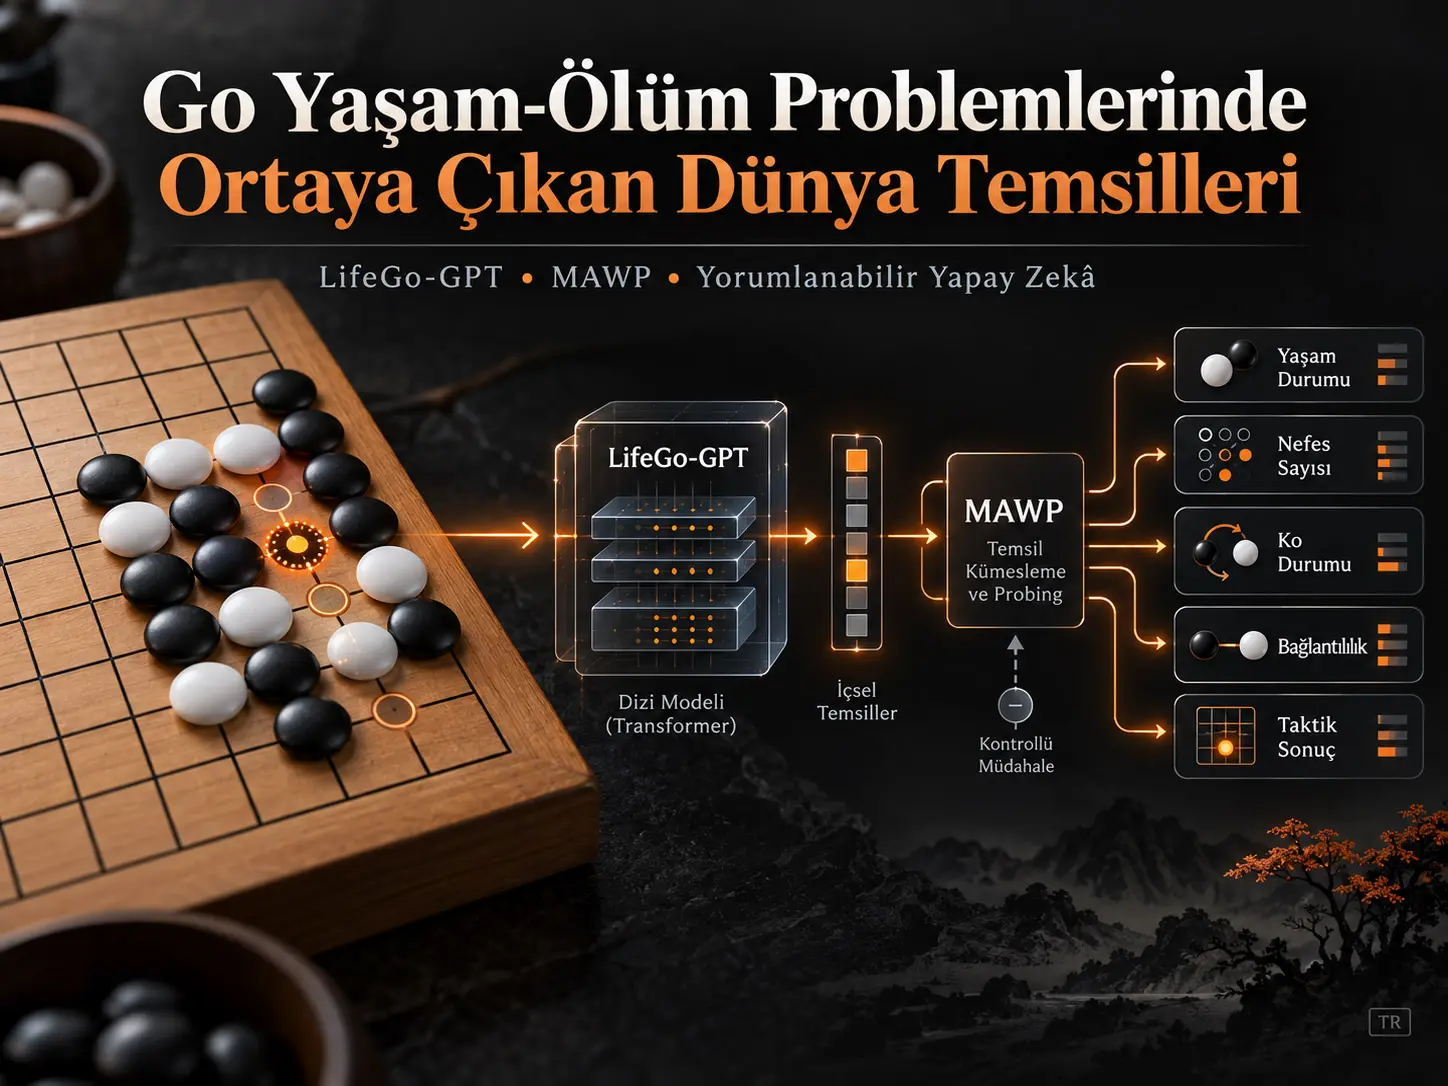
LifeGo-GPT, yerel Go yaşam-ölüm problemlerinin tahta durumlarını ve çözüm hamlelerini seri token dizileri olarak işleyen GPT-tipi bir otoregresif Transformer modelidir. Çalışmanın temel sorusu yalnız modelin doğru hamle üretip üretmediği değildir; araştırmacılar modelin hiçbir açık Go kuralı veya stratejik kavram etiketi verilmeden, gizli aktivasyonlarında “nefesler” (liberties), yaşam durumu, bağlantılılık ve ko gibi taktiksel özelliklerle ilişkili yapılandırılmış iç temsiller geliştirip geliştirmediğini inceliyor. Yaklaşık 10.000 yerel tsumego problemiyle eğitilen LifeGo-GPT, doğrulama verisinde %98,6 hamle yasallığı, %94,7 ± 0,6 kanonik çözüm dizisi doğruluğu ve %92,1 sonuç geçerliliği raporlamaktadır.
Modelin iç durumlarını çözümlemek için araştırmacılar Multi-Aspect World Probe (MAWP) adlı çok başlıklı bir probing sistemi geliştiriyor. MAWP, LifeGo-GPT'nin ara katmanlarından alınan gizli temsilleri ortak bir özellik çıkarıcıdan geçirerek beş taktiksel boyutu ayrı ayrı tahmin etmeye çalışıyor: yaşam durumu, nefes sayısı, ko durumu, bağlantılılık ve taktiksel sonuç. Böylece modelin yalnız “doğru hamleyi” seçmesi değil, bu seçime eşlik eden iç durumun Go'nun bilinen taktiksel yapılarıyla ne kadar hizalandığı araştırılabiliyor.
Çalışma yalnız korelasyonel probing ile yetinmiyor. Araştırmacılar LifeGo-GPT'nin altıncı Transformer katmanındaki belirli gizli temsillere semantik olarak yönlendirilmiş müdahaleler uyguluyor ve sonraki hamle logitlerinin nasıl değiştiğini ölçüyor. 1000 problemde müdahale sonrası top-1 hamle %95,4 oranında değişirken rastgele gürültü enjeksiyonunda bu oran %5,6, aynı büyüklükte fakat rastgele yönlü perturbasyonda %18,7 olmuştur. İlk beş aday hamlede ortalama mutlak logit değişimi 3,21'dir. Bu farklar iç temsillerin model davranışıyla işlevsel ilişki taşıdığına işaret etmektedir; ancak yazarlar bunun belirli bir “Go kavramının” kesin nedensel kontrolünün kanıtı olmadığını özellikle vurgulamaktadır.
Çalışmanın kapsamı yerel yaşam-ölüm problemleriyle sınırlıdır. LifeGo-GPT tam Go oyunu için profesyonel motorların yerine geçen genel bir Go ajanı değildir. KataGo yerel karşılaştırmada %99,2 hamle yasallığı, %96,5 ± 0,4 dizi doğruluğu ve %97,8 sonuç geçerliliğiyle daha güçlüdür. Araştırmanın esas bilimsel katkısı, sıra tahminiyle eğitilen bir modelin yüksek boyutlu ve uzamsal bir strateji ortamında yapılandırılmış ara temsiller geliştirip geliştiremeyeceğini ve bu temsillerin davranış üzerinde işlevsel etkisinin ölçülüp ölçülemeyeceğini incelemesidir.
Go Yaşam-Ölüm Problemleri Neden Bir “Mikro-Dünya” Olarak Kullanılıyor?
Go yaşam-ölüm veya tsumego problemleri, tam bir Go oyununun bütün stratejik karmaşıklığını taşımadan nefes, göz, bağlantılılık, ko ve yaşama/ölme durumu gibi açıkça tanımlanabilir yerel taktiksel kavramları içerdikleri için Transformer modellerinin iç dünya temsillerini incelemeye uygun kontrollü bir mikro-dünya sağlar.
Go'nun tam 19 × 19 tahtasında bir hamlenin değeri yerel taş gruplarından bölge kontrolüne, uzun mesafeli etkileşimlerden global saldırı-savunma dengesine kadar çok sayıda faktöre bağlıdır. Bu durum yalnız tahmini değil, tahminin neden verildiğini yorumlamayı da güçleştirir.
Yaşam-ölüm problemleri ise tipik olarak tahtanın sınırlı bir bölgesine odaklanır. Amaç belirli bir taş grubunun kusursuz oyunda yaşayıp yaşamayacağını belirlemektir. Problem alanı daha küçük olmasına rağmen temel Go taktiğini korur: nefes noktaları, göz oluşturma, yakalama yarışları, bağlantı, ko ve kritik hamle noktaları birlikte rol oynayabilir.
Kaynak Figure 1'de önce yerel bir yaşam-ölüm başlangıç konumu, ardından numaralandırılmış çözüm hamleleri gösterilmektedir. Bir grubun güvenli biçimde yaşayabilmesinin temel örneği iki gerçek göz oluşturmasıdır. Çalışma bu tür problemleri, sıra modelinin yalnız token korelasyonlarını mı ezberlediğini yoksa tahta durumuna benzeyen daha yapılandırılmış gizli temsiller mi geliştirdiğini incelemek için kullanmaktadır.
Dünya temsili burada ne anlama geliyor?
“World representation” ifadesi bu çalışmada modelin Go tahtasını insan gibi bilinçli biçimde “anladığı” anlamına gelmez. Kavram, modelin gizli aktivasyonlarında dış ortamın önemli yapısal özelliklerinin çözümlenebilir biçimde temsil edilmesini ifade eder.
Örneğin LifeGo-GPT'nin gizli durumlarından bir taş grubunun kaç nefesi olduğu, grubun yaşam durumu veya bağlantılılık yapısı güvenilir biçimde tahmin edilebiliyorsa bu bilgi modelin temsil uzayında mevcuttur. Ancak bilginin gizli temsilden okunabilmesi tek başına modelin karar verirken o bilgiyi kullandığını göstermez. Çalışmanın müdahale deneylerini eklemesinin temel nedeni budur.
Go tahtası bir dil modeli girdisine nasıl dönüştürülüyor?
Her tsumego örneği başlangıçta SGF biçimindedir. Araştırmacılar problemi iki parçadan oluşan seri bir token dizisine dönüştürür:
- hedef taş grubunun çevresindeki başlangıç tahta düzeni,
- problemin referans çözüm hamle dizisi.
Standart 19 × 19 Go tahtasında 361 kesişim vardır ve her koordinat benzersiz bir token kimliğine eşlenir. Koordinat sözlüğü bu nedenle 361 temel konum içerir. Tahta durumu ile çözüm dizisini ayırmak ve dizinin sınırlarını belirtmek için ayrıca <BOS>, <SEP> ve <EOS> gibi özel tokenlar kullanılır.
Koordinatlar 1–361 arasında sayısal kimliklerle temsil edilmesine rağmen araştırmacılar bu sayısal sıraya açık geometrik anlam yüklememektedir. Kimlikler kategorik indeksler olarak rastgele başlatılan öğrenilebilir embeddinglere gider. Böylece modelin “361 sayısı koordinat olarak 360'ın yanındadır” gibi doğrudan sayısal bir geometri kullanması amaçlanmaz; uzamsal düzen eğitim verisinden öğrenilmelidir.
Kaynak Figure 2, Go taş tahtasının bu seri metin-benzeri temsile dönüştürülmesini gösterir. Bu dönüşüm çalışmanın temel deneysel fikridir: iki boyutlu taktiksel bir dünya, decoder-only sıra modeline doğrusal token dizisi olarak verilir.
LifeGo-GPT Açık Go Kuralları Verilmeden Nasıl Eğitiliyor?
LifeGo-GPT, açık “nefes”, “göz”, “ko” veya “şu hamle yasaktır” kurallarıyla programlanmak yerine seri tahta-durum ve çözüm tokenlarında bir sonraki tokenı tahmin etmeyi öğrenen standart otoregresif hedefle eğitilir; taktiksel düzenliliklerin modelin gizli temsil uzayında eğitim verisinden ortaya çıkması beklenir.
Bir sonraki token olasılığı
Serileştirilmiş bir problem:
\[ x=(x_1,x_2,\ldots,x_n) \]
olarak gösterilir. Model her \(t\) adımında önceki tokenlara koşullu olarak sonraki tokenın olasılığını hesaplar:
\[ p_{\theta}(x_t\mid x_{
Burada \(h_t\), son Transformer katmanının \(t\). pozisyonda ürettiği gizli temsil; \(W_o\), gizli temsili sözlük boyutundaki çıkış logitlerine dönüştüren projeksiyon matrisidir; \(\theta\) ise model parametrelerini gösterir.
Bu denklem modelin “Go kuralı” hesaplamasını doğrudan kodlamaz. Modelin görevi, geçmiş tahta ve hamle tokenlarından sonraki uygun tokenın olasılık dağılımını öğrenmektir.
Dil modeli kaybı
Eğitimde teacher forcing kullanılarak standart negatif log-olasılık kaybı minimize edilir:
\[ \mathcal{L}_{LM} = -\sum_{t=1}^{n} \log p_{\theta}(x_t\mid x_{
Düşük kayıp, modelin kaynak çözüm dizilerindeki sıradaki tokenlara daha yüksek olasılık vermesi anlamına gelir. Bu eğitim amacı doğrudan “iki göz oluştur”, “self-atari yapma” veya “nefesi koru” gibi sembolik komutlar içermez.
Veri seti nasıl oluşturuldu?
Kaynak veriler 101 Weiqi, Xingzhen Go Platform ve Jueyi Go Platform gibi kamuya açık çevrimiçi Go kaynaklarının yanı sıra Weiqi Life-and-Death Encyclopedia ve Fayang Lun gibi derlenmiş problem kaynaklarından toplanmıştır.
Veri setinde yaklaşık 10.000 yaşam-ölüm senaryosu bulunmaktadır. Güçlük dağılımı yaklaşık olarak:
| Zorluk düzeyi | Yaklaşık pay | Kaynakta verilen tipik özellik |
|---|---|---|
| Kolay | 5/10 | Küçük yerel gruplar, sınırlı nefesler, birkaç hamlede çözülebilen yakalama yapıları |
| Orta | 3/10 | Yakalama yarışları, göz alanı rekabeti, birden fazla makul varyasyon |
| Zor | 2/10 | İç içe geçmiş grup mücadeleleri, çok sayıda olası yaşam şekli ve uzun ufuklu taktik |
Bazı problemlerin birden fazla geçerli çözümü bulunabilmektedir. Eğitim hedefi olarak kaynak materyaldeki kanonik çözüm dizisi kullanılır; değerlendirmede ise aynı nihai yaşam-ölüm sonucuna götüren alternatif yollar ayrıca sonuç geçerliliği kapsamında kabul edilmektedir.
Veri sızıntısı nasıl azaltılmaya çalışıldı?
Veri artırmadan önce tam tekrarlar problem düzeyinde kaldırılmıştır. Rotasyon veya yansıma nedeniyle geometrik olarak eşdeğer olan tahta durumları kanonikleştirilerek fazladan tekrarlar belirlenmiştir.
Eğitim ve doğrulama bölmesi, artırılmış örnek düzeyinde değil özgün problem düzeyinde yapılmıştır. Böylece aynı problemin dönüştürülmüş varyantlarının hem eğitim hem doğrulama tarafında bulunması engellenmeye çalışılmıştır. Veri seti yaklaşık 8:2 eğitim/doğrulama oranında ayrılmıştır.
Renk tersleme yalnız problemin anlamının oyuncu rengi değişiminden etkilenmediği durumlarda uygulanmıştır. Araştırmacılar ayrıca yakın-tekrar örneklerini denetleyerek doğrulama sızıntısı ve yapay olarak şişmiş doğruluk riskini azaltmaya çalıştıklarını belirtmektedir.
LifeGo-GPT mimarisi ve eğitim ayarları
| Hiperparametre | Değer |
|---|---|
| Transformer katmanı | 8 |
| Attention head | 8 |
| Gizli boyut | 512 |
| Optimizer | Adam |
| Learning rate | \(1\times10^{-4}\) |
| Batch size | 64 |
| Maksimum eğitim epoch'u | 100 |
| Gradient clipping | Maksimum norm = 1,0 |
| Erken durdurma | Doğrulama performansına göre |
Bütün token ve positional embedding parametreleri rastgele başlatılmıştır. Model önceden eğitilmiş bir doğal dil GPT'sinin Go'ya doğrudan aktarılması değildir.
Kaynak Figure 3 eğitim ve doğrulama kaybının epoch boyunca düzenli biçimde azaldığını gösterir. Şeklin ham sayısal serisi ayrıca tablo halinde verilmediği için Verianla tarafından grafikten kesin ara değerler türetilmemiştir.
Kaynak terminolojisi notu: Yöntem metni modeli GPT-tipi decoder-only Transformer olarak tanımlarken Tablo 1 katman sayısını “Transformer encoder depth” biçiminde açıklamaktadır. Burada yöntem anlatımındaki decoder-only tanımı korunmuş, tablo ifadesi kaynak içi terminoloji farkı olarak değerlendirilmiştir.
Model Başarısı Nasıl Ölçülüyor?
Çalışma LifeGo-GPT'yi üç ayrı ölçütle değerlendirir: Move Legality tahmin edilen hamlenin o anda yasal olup olmadığını, Sequence Correctness üretilen hamle dizisinin kanonik çözüme uyup uymadığını ve Outcome Validity oluşan son durumun doğru yaşam-ölüm sonucuna ulaşıp ulaşmadığını ölçer.
Move Legality
Modelin ürettiği koordinat mevcut tahta durumunda geçerli bir Go hamlesine karşılık geliyorsa yasal sayılır. Bu metrik modelin temel kural yapısını dolaylı biçimde öğrenip öğrenmediğine ilişkin ilk göstergedir.
Sequence Correctness
Üretilen çözüm dizisi kaynak problemdeki kanonik çözümle karşılaştırılır. Kaynak açıklamasına göre kanonik diziyle tam eşleşmeyen alternatif yollar bu metrik altında yanlış kabul edilir.
Outcome Validity
Tahmin edilen hamleler tahtada uygulanır ve hedef grubun nihai yaşam-ölüm durumu harici KataGo motoru kullanılarak doğrulanır. Kanonik diziden farklı olsa bile aynı doğru yaşam-ölüm durumuna ulaşan alternatif çözüm bu metrikte geçerli sayılabilir.
Yorum notu: Bu tanımlar altında Outcome Validity'nin Sequence Correctness'a göre daha kapsayıcı görünmesi beklenebilir; buna rağmen LifeGo-GPT için kaynak %94,7 Sequence Correctness ve %92,1 Outcome Validity raporlamaktadır. Kaynak bu ilişkinin nedenini ayrıca açıklamadığı için Verianla bunun sebebini varsaymamaktadır.
Çalışmanın Yöntemi ve Bulguları
LifeGo-GPT'nin karşılaştırmalı sonuçları
| Yöntem | Hamle yasallığı | Dizi doğruluğu | Sonuç geçerliliği |
|---|---|---|---|
| Eğitilmemiş Transformer | %15,8 | %12,3 ± 2,1 | %10,5 |
| LifeGo-GPT | %98,6 | %94,7 ± 0,6 | %92,1 |
| KataGo, yalnız yerel | %99,2 | %96,5 ± 0,4 | %97,8 |
| Leela Zero, yalnız yerel | %98,9 | %92,4 ± 0,7 | %90,7 |
| RZS | %88,6 | %78,3 ± 1,5 | %72,4 |
| ANN | %96,3 | %94,5 ± 0,9 | %89,4 |
LifeGo-GPT eğitim almamış Transformer temel çizgisinin çok üzerine çıkmaktadır. Yerel tsumego görevinde LifeGo-GPT'nin dizi doğruluğu Leela Zero ve RZS'nin üzerinde, ANN'e çok yakın ve KataGo'nun altında raporlanmıştır.
KataGo üç ana ölçütün tamamında LifeGo-GPT'den daha yüksek değerlere sahiptir. Bu nedenle sonuç “LifeGo-GPT profesyonel Go motorlarından daha güçlüdür” şeklinde yorumlanamaz. Kaynak da profesyonel motorların özellikle daha karmaşık ve tam-tahta durumlarında daha güçlü olduğunu açıkça belirtmektedir.
LifeGo-GPT'nin bilimsel önemi farklıdır: model Go kuralları ayrı bir sembolik sistem olarak verilmeden yalnız seri problem verisinden yüksek oranda yasal ve doğru yerel hamle dizileri öğrenmiştir. Araştırmanın sonraki bölümleri bu başarının altında nasıl bir gizli temsil yapısı bulunduğunu incelemektedir.
Hata örnekleri hangi durumlarda yoğunlaşıyor?
Kaynak hata analizinde üç ana problem sınıfı tanımlamaktadır:
- çok aşamalı muhakeme gerektiren karmaşık yaşam-ölüm problemleri,
- daha derin taktiksel bağımlılıklar içeren uzun çözüm dizileri,
- birden fazla hamlenin benzer sonuçlar verebildiği belirsiz konumlar.
Bu hata örüntüsü, modelin yerel taktiksel düzenleri güçlü biçimde yakalamasına rağmen uzun menzilli bağımlılık ve yüksek belirsizlik altında sınırlı kaldığını göstermektedir.
Multi-Aspect World Probe (MAWP) Nedir?
Multi-Aspect World Probe (MAWP), LifeGo-GPT'nin gizli Transformer temsillerinden tek bir toplu “tahta durumu” etiketi çıkarmak yerine beş ayrı taktiksel özelliği ortak bir özellik kodlayıcı üzerinden paralel olarak çözümlemeye çalışan modüler bir probing çerçevesidir.
MAWP neden tek prob yerine birden fazla boyut kullanıyor?
Bir Go taş grubunun yaşam durumu tek bir faktöre bağlı değildir. Nefesler, grup bağlantısı, ko durumu ve ortaya çıkan taktik sonuç birbirine bağlıdır. Tek başlıklı bir prob, gizli temsilde hangi alt kavramın gerçekten mevcut olduğunu ayırmakta zorlanabilir.
MAWP bu nedenle ortak bir MLP tabanlı özellik çıkarıcının çıktısını beş paralel sınıflandırma başlığına gönderir:
| Başlık | Kaynak adı | Tahmin edilen kavram |
|---|---|---|
| A1 | Life Status | Taş/grubun ölü, canlı veya durumu belirsiz olması |
| A2 | Liberty Count | Nefes sayısı: sıfır, bir veya birden fazla |
| A3 | Ko Status | Ko noktası, ko tehdidi veya ilgisiz durum |
| A4 | Connectivity | İzole, bağlı veya potansiyel olarak ölümcül biçimde iç içe geçmiş yapı |
| A5 | Tactical Outcome | Öldürme, yaşama, seki veya karşılıklı ölüm sonucu |
Kaynak Figure 4, LifeGo-GPT'den seçilen gizli durumun ortak MLP özellik kodlayıcıya girdiğini ve buradan beş ayrı MAWP başlığına dağıldığını açıkça göstermektedir.
Kaynak içi kavram notu: Makalenin giriş, özet ve sonuçlarında “eyes” yani göz yapısı temel ortaya çıkan temsiller arasında anılmaktadır ve MAWP'nin kavramsal anlatımında da “eye structure” örneği verilir. Bununla birlikte Figure 4 ve beş açık başlık listesinde bağımsız bir “Eye Structure” prob başlığı bulunmamaktadır. Bu nedenle Verianla, göz yapısını altıncı bir MAWP çıkışı olarak eklememektedir.
Gizli temsilin matematiksel gösterimi
Seçilen Transformer katmanındaki temsil:
\[ x_t^{(l)}\in\mathbb{R}^{N\times d} \tag{3} \]
şeklinde verilir. Burada \(l\) seçilen katmanı, \(N\) yerel tahta noktalarının sayısını ve \(d\) gizli temsil boyutunu gösterir.
Ortak özellik çıkarıcı \(\phi(x)\) kullanıldıktan sonra her semantik boyut için ayrı softmax sınıflandırıcı çalışır:
\[ h_i(\phi(x)) = \operatorname{softmax}\left(W_i\phi(x)\right), \qquad i=1,\ldots,5. \tag{4} \]
Her tahta noktası \(p\) için ortak latent temsil:
\[ z_{t,p} = \phi\left(x_{t,p}^{(l)}\right), \qquad p\in\{1,\ldots,N\} \tag{5} \]
ve \(i\). taktiksel boyutun tahmini:
\[ \hat y_{t,p}^{(i)} = h_i(z_{t,p}) \tag{6} \]
olarak yazılır.
MAWP'nin toplam kaybı
Beş probing görevinin cross-entropy kayıpları ağırlıklı olarak toplanır:
\[ \mathcal{L}_{probe} = \sum_{i=1}^{5} \lambda_i \cdot \mathcal{L}_{CE} \left( h_i(\phi(x)), y^{(i)} \right). \tag{7} \]
Kaynak varsayılan olarak bütün başlıklara eşit ağırlık verir:
\[ \lambda_i=\frac{1}{5}. \]
Bu seçim, beş semantik probun modelin tahta durumunu anlamasına eşit katkı yaptığı varsayımına dayanır. Araştırmacılar görev güçlüğü veya sınıf dengesizliğine göre farklı ağırlıkların mümkün olduğunu ancak çalışmada eşit ağırlığın kullanıldığını belirtmektedir.
MAWP etiketleri nasıl oluşturuluyor?
Prob etiketleri yalnız elle atanmış yorumlardan oluşmamaktadır. Araştırmacılar KataGo tabanlı analiz ile deterministik son işleme kurallarını birleştirmektedir.
Önce hedef taş grubu belirlenir ve aynı renkteki taşların bağlı bileşeni hesaplanır. Nefes sayısı, bu bağlı grubun komşuluğundaki farklı boş kesişimlerin sayılmasıyla elde edilir.
Yaşam durumu, sabit bir arama bütçesi altında güçlü Go motoruyla doğrulanır. Kaynak otomatik etiket oluşturma bölümünde motor sonucunun alive, dead, seki ve unresolved etiketlerine eşlendiğini belirtmektedir. Tutarsız veya belirsiz motor çıktıları probing veri setinden çıkarılır.
Bağlantılılık, yerel tahta üzerinde aynı renkteki taşların dört-komşuluk ilişkisiyle tanımlanır. Ko etiketleri yalnız motorun principal variation çıktısı ve yerel kural denetimi explicit ko yapısını doğruladığında atanır. Taktiksel sonuç, referans çözüm uygulandıktan sonra hedef grubun terminal yaşam-ölüm durumunun yeniden değerlendirilmesiyle belirlenir.
Burada da küçük bir kaynak ayrımı vardır: A1 başlık tanımı dead/live/undetermined sınıflarını verirken otomatik etiketleme metni alive/dead/seki/unresolved kümesini kullanmaktadır. Kaynak bu iki etiket şemasının birbirine nasıl dönüştürüldüğünü ayrıntılandırmamaktadır; Verianla bu eşlemeyi tahmin etmemektedir.
Bir Özelliğin Gizli Temsilden Okunabilmesi Modelin Onu Kullandığını Kanıtlar mı?
Hayır. Bir probing sınıflandırıcısının gizli aktivasyonlardan nefes veya yaşam durumu bilgisini çıkarması, bu bilginin temsil içinde mevcut olduğunu gösterir; fakat LifeGo-GPT'nin hamle kararını gerçekten bu özellik üzerinden verdiğini tek başına kanıtlamaz. Çalışma bu nedenle gözlemsel probing'i hedefli temsil müdahaleleriyle tamamlamaktadır.
Müdahale benchmarkı
Araştırmacılar müdahale deneyleri için 1000 yaşam-ölüm vakasından oluşan ayrı bir değerlendirme benchmarkı oluşturmuştur. Her vakada başlangıç siyah-beyaz taş konumları, müdahale hedefi ve doğru hamle dizisi bulunmaktadır.
Müdahale doğrudan giriş tahtasını değiştirmez. Araştırmacılar LifeGo-GPT'nin gizli temsil uzayındaki hedef konumu değiştirerek örneğin bir taşın renginin çevrilmesini semantik olarak taklit eden bir dönüşüm uygular.
Bütün müdahaleler 6. katmanda yapılmıştır. Yazarların gerekçesi şöyledir:
- alt katmanlarda aktivasyonlar daha çok yüzeysel token ilişkileri ve yerel örüntülerle ilgilidir;
- en üst katmanlar nihai tahmine fazla özelleşmiş olabilir;
- 6. katman, bileşimsel tahta/taktik bilgilerinin oluştuğu fakat karar çıktısından henüz tamamen ayrışmamış bir ara seviye olarak seçilmiştir.
Müdahale denklemi
Hedef gizli temsil üzerindeki müdahale kaynakta:
\[ \widetilde{x}_t^{(l)} = do\left( x_{t,g}^{(l)} \leftarrow \psi(x_{t,g}^{(l)},c) \right) \tag{8} \]
şeklinde yazılır. \(g\), müdahale edilen tahta konumunu; \(c\), müdahaleden sonra semantik olarak taklit edilen özelliği; \(\psi\), temsil uzayındaki dönüşümü ifade eder.
Müdahale sonrası ve öncesi tahmin farkı:
\[ \Delta a = f_{\theta} \left( \widetilde{x}_t^{(l)} \right) - f_{\theta} \left( x_t^{(l)} \right) \tag{9} \]
olarak değerlendirilir. Burada amaç yalnız tahminin değişip değişmediğini değil, müdahalenin hamle tercih logitlerini hangi ölçüde kaydırdığını incelemektir.
Figure 5 ve Figure 6 ne gösteriyor?
Figure 5 müdahale öncesindeki yerel tahta durumunu ve hamle-logit haritasını gösterir. Kaynak renk ölçeğinde daha sıcak renkler daha düşük tahmin olasılıklarını, daha soğuk renkler ise daha yüksek skorları temsil etmektedir.
Figure 6 aynı örneğin müdahale sonrası durumunu gösterir. Yüksek skorlu bölgelerin daha kararlı dış konumlara doğru kaydığı gözlenmiştir. Araştırmacılar bunu gizli temsil değişikliğinin modelin taktiksel tercihini sistematik biçimde etkilediğine ilişkin örnek olarak sunar.
Müdahale deneylerinin nicel sonucu
| Müdahale/ölçüm | Sonuç |
|---|---|
| Semantik yönlendirilmiş müdahale sonrası top-1 hamlenin değişmesi | %95,4 |
| İlk beş aday üzerindeki ortalama mutlak logit değişimi | 3,21 |
| Rastgele gürültü enjeksiyonunda top-1 hamle değişimi | %5,6 |
| Aynı büyüklükte rastgele yön perturbasyonunda top-1 hamle değişimi | %18,7 |
Semantik olarak hedeflenmiş müdahalenin rastgele gürültüden ve aynı büyüklükteki rastgele yön perturbasyonundan çok daha büyük davranış değişikliği oluşturması, etkinin yalnız modelin herhangi bir gizli durum değişimine aşırı hassas olmasından kaynaklanmadığı yönündeki argümanı desteklemektedir.
Müdahale Sonuçları Kesin Nedensel Kanıt mıdır?
Hayır. Kaynak, hedeflenmiş müdahalelerin rastgele kontrollerden çok daha güçlü tahmin değişimleri oluşturmasını iç temsillerin karar süreciyle işlevsel bağlantısı lehine kanıt olarak değerlendirir; ancak büyük bir tahmin değişiminin belirli bir semantik değişkenin hassas ve bağımsız biçimde kontrol edildiğini kesin olarak göstermediğini açıkça kabul eder.
Güçlü bir sıra modeli, semantik anlam taşıyan kritik bölgelerde yapılan yapılandırılmış değişikliklere genel olarak yüksek duyarlılık gösterebilir. Böyle bir durumda müdahalenin etkisi yalnız “yaşam durumu değişkeninin nedensel kontrolü”nden değil, daha geniş bir temsil bozulmasından da kaynaklanabilir.
Rastgele perturbasyon kontrolleri bu açıklamayı kısmen sınırlar ancak tamamen ortadan kaldırmaz. Dolayısıyla makalenin en güvenli sonucu:
Probe sonuçları taktiksel bilginin gizli temsillerde kodlandığını; müdahale sonuçları ise bu yapılandırılmış temsil bileşenlerinin tahmin davranışıyla işlevsel olarak ilişkili olduğunu göstermektedir. Belirli semantik değişkenlerin kesin ve bağımsız nedensel kontrolü henüz kanıtlanmış değildir.
Model derinliği ablasyonu
Araştırmacılar 2, 4, 6 ve 8 Transformer katmanlı LifeGo-GPT varyantları eğitmiş ve her modelde üç probing yaklaşımını karşılaştırmıştır:
- linear probe,
- standart nonlinear probe,
- MAWP.
Kaynak Figure 7'nin temel nitel sonucu, MAWP'nin bütün incelenen derinliklerde linear probe'dan ve genel olarak standart nonlinear probe'dan daha yüksek prob doğruluğuna sahip olmasıdır. Fark özellikle orta ve daha derin katmanlarda belirginleşmektedir.
Yazarlar daha derin Transformer katmanlarının düşük seviyeli token ilişkilerinden daha bütünleşik uzamsal ve taktiksel temsillere geçtiğini yorumlamaktadır. Bu yorum, nefes ve bağlantılılık gibi kavramların daha derin katmanlardan daha iyi çözümlenebilmesiyle ilişkilendirilmektedir.
Grafik yorum sınırı: Metin, prob doğruluğunun model derinliğiyle bütün yöntemlerde “tutarlı biçimde arttığını” ifade etmektedir. Bununla birlikte Figure 7'nin çubukları görsel olarak incelendiğinde nonlinear ve MAWP serilerinin 8 katmana kadar tamamen monoton artmadığı görülmektedir. Ham sayısal tablo verilmediği için Verianla grafikten kesin değer çıkarmamış ve yalnız açıkça güvenilir nitel eğilimi aktarmıştır.
Veri artırma ablasyonu
Figure 8, tahta düzeyindeki simetri tabanlı veri artırmanın etkisini inceler. Kaynakta üç durum gösterilmektedir:
- artırma yok,
- rotasyon,
- yansıma/flip.
Yazarların yorumuna göre veri artırma kaldırıldığında özellikle daha derin katmanlarda prob doğruluğu düşmektedir. Simetriye duyarlı artırma, aynı yaşam-ölüm yapısının farklı yönelimlerde görünmesine rağmen modelin ortak yapısal özellikleri öğrenmesini teşvik etmektedir.
Bu sonuç yalnız nihai hamle başarımına ilişkin değildir. Yazarlar artırmanın iç temsil tutarlılığını ve dönüşümlere karşı daha kararlı özellikler öğrenilmesini de desteklediğini ileri sürmektedir.
Çalışmanın desteklediği sonuçlar
Çalışma, yerel Go yaşam-ölüm dizilerinden eğitilen GPT-tipi bir modelin yüksek hamle yasallığı ve çözüm başarımı geliştirebildiğini desteklemektedir.
MAWP deneyleri, LifeGo-GPT'nin gizli temsillerinden yaşam durumu, nefes sayısı, ko, bağlantılılık ve taktiksel sonuç gibi yapılandırılmış bilgilerin çözümlenebildiğini desteklemektedir.
Hedeflenmiş temsil müdahalelerinin rastgele perturbasyonlara göre çok daha büyük hamle-tercihi değişimi yaratması, bu yapılandırılmış özelliklerin model davranışında yalnız pasif korelatlar olmayabileceğine ve işlevsel önem taşıdığına ilişkin kanıt sağlar.
Model derinliği ve simetri tabanlı veri artırma deneyleri, iç temsil kalitesinin yalnız nihai tahmin başarımından değil mimari derinlik ve eğitim verisinin dönüşüm yapısından da etkilendiğini göstermektedir.
Çalışmanın desteklemediği sonuçlar
Çalışma LifeGo-GPT'nin Go oyununu insan gibi “anladığını” veya bilinçli stratejik kavramlara sahip olduğunu kanıtlamaz. Probing sonuçları, gizli aktivasyonlardan belirli bilgilerin çözümlenebildiğini gösterir.
Çalışma belirli bir semantik özelliğin tamamen izole ve kesin biçimde nedensel kontrol edildiğini de kanıtlamaz. Yazarlar müdahale sonuçlarını kesin causal identification yerine causal relevance lehine kanıt olarak sınırlandırmaktadır.
LifeGo-GPT'nin başarısı tam tahta Go'ya doğrudan genellenemez. Deneyler yerel yaşam-ölüm problemlerine odaklanmıştır; KataGo gibi profesyonel motorların tam tahta oyunda daha güçlü olduğu kaynak tarafından açıkça belirtilmiştir.
Yaklaşık 10.000 problemden oluşan veri kümesi farklı kamu kaynaklarından ve klasik problem koleksiyonlarından derlenmiştir. Sonuçların başka Go problem koleksiyonlarında, farklı zorluk dağılımlarında veya tamamen bağımsız bir veri üretim sürecinde aynı değerleri vereceği bu çalışma tarafından gösterilmemiştir.
Figure 7 ve Figure 8'de gösterilen probe/augmentation sonuçlarının ham sayısal serileri makalede tablo halinde verilmediğinden Verianla bu grafiklerden hassas sayılar türetmemiştir.
Tam tahta Go'ya ölçekleme nasıl düşünülüyor?
Sonuç bölümünde yazarlar yerel yaşam-ölüm temsillerinin tam Go oyununa nasıl entegre edilebileceğini gelecekteki araştırma yönü olarak tartışmaktadır. Önerilen kavramsal yaklaşım, yerel yaşam-ölüm modelini tek başına bütün oyunu yöneten ajan yapmak yerine global karar sisteminin taktiksel bir alt modülü olarak kullanmaktır.
Bu çerçevede yerel modül nefes, göz, bağlantılılık ve yaşam-ölüm durumları gibi “yerel durum gerçekliğini” temsil ederken daha geniş sistem bölge tahmini, saldırı-savunma öncelikleri ve global stratejik değer gibi bilgileri birleştirir.
Aynı yerel şeklin farklı tam-tahta bağlamlarında farklı stratejik öneme sahip olabilmesi bu ayrımın neden gerekli olduğunu gösterir. Bu bölüm çalışmanın deneysel sonucu değil, yazarların geleceğe yönelik önerdiği mimari perspektiftir.
Dil modelleri ve Go'nun gelecekte birleştirilmesi
Kaynak ayrıca önceden eğitilmiş çok dilli Transformerların sembolik oyun ortamlarıyla birleştirilmesini gelecek çalışma alanı olarak önermektedir. Tahta dizilerinin insan yorumları, oyun notasyonu veya taktiksel açıklamalarla birlikte işlenmesi, hem yorumlanabilirlik hem de belirsiz konumlardaki karar verme açısından araştırılabilir.
Yazarlar gizli uzaydaki müdahale tekniklerinin gelecekte insanın model davranışını yönlendirebildiği, hata ayıklayabildiği veya belirli özellikleri değiştirebildiği kontrol edilebilir oyun ajanlarına temel oluşturabileceğini de öne sürmektedir. Bu öneriler mevcut deneyde gerçekleştirilmiş sistemler değildir.
Kaynak ve Yöntem Notu
Özgün çalışma: Probing Emergent World Representations in Go Life-and-Death Problems
Yazarlar: Zhikai Yang; Zhigang Meng; Zhiqiang Wen.
Sorumlu yazar: Zhigang Meng.
Kurumlar: School of Computer Science and Artificial Intelligence, Hunan University of Technology, Zhuzhou, Çin; Hunan Provincial Video Cultural and Creative Research Base, Changsha, Çin; School of Computer Science and Engineering, Changsha University, Changsha, Çin.
Dergi: AI.
Yayınevi: MDPI.
Kaynak türü: Hakemli özgün araştırma makalesi; Transformer tabanlı sıra modelleme, yorumlanabilir yapay zekâ, probing ve temsil müdahalesi içeren hesaplamalı çalışma.
Yayın bilgisi: AI 2026, cilt 7, sayı 5, makale 170.
DOI: 10.3390/ai7050170
Gönderim: 10 Mart 2026.
Revizyon: 22 Nisan 2026.
Kabul: 7 Mayıs 2026.
Yayın: 14 Mayıs 2026.
Sürüm notu: MDPI'nin resmî sürüm geçmişinde makalenin HTML/PDF kayıtlarının 20 Mayıs 2026'da güncellendiği görülmektedir; bibliyografik yayın tarihi 14 Mayıs 2026 olarak kalmaktadır.
Lisans: Creative Commons Attribution (CC BY), açık erişim.
Finansman: Çalışma Natural Science Foundation of Hunan Province, China (Grant No. 2024JJ7149), Hunan Provincial Video Cultural and Creative Research Base ve Hunan Provincial Education Department Scientific Research Fund (Grant No. 22A0414) tarafından desteklenmiştir.
Kurumsal etik kurul: Uygulanabilir değil.
Bilgilendirilmiş onam: Uygulanabilir değil.
Veri erişilebilirliği: Yazarlar çalışmada sunulan verilerin makale içinde bulunduğunu, ek bilgi için sorumlu yazara başvurulabileceğini belirtmektedir.
Teşekkür: Yazarlar Hunan University of Technology, Hunan Provincial Video Cultural and Creative Research Base ve Changsha University'ye destekleri için teşekkür etmektedir.
Çıkar çatışması: Yazarlar çıkar çatışması olmadığını beyan etmiştir.
Yazar katkıları: Kavramsallaştırma Zhikai Yang ve Zhigang Meng; yazılım Zhikai Yang; metodoloji Zhiqiang Wen ve Zhikai Yang; doğrulama, araştırma ve kaynaklar Zhikai Yang ve Zhigang Meng; ilk taslak Zhikai Yang ve Zhigang Meng; gözden geçirme ve düzenleme Zhigang Meng ve Zhiqiang Wen tarafından gerçekleştirilmiştir.
Temel yöntemsel sınırlar: Deneyler yaklaşık 10.000 yerel tsumego problemiyle sınırlıdır; tam-tahta Go değerlendirmesi yapılmamıştır. MAWP'nin gizli temsillerden bilgi çözebilmesi tek başına karar mekanizmasında nedensel kullanım kanıtı değildir. Müdahale deneyleri işlevsel önem lehine güçlü farklar üretse de yazarlar kesin semantik değişken kontrolü iddiasında bulunmamaktadır. Figure 7–8 için ham sayısal tablolar verilmemiştir. LifeGo-GPT'nin dış problem koleksiyonlarında veya farklı veri dağılımlarında aynı performansı koruyup korumadığı bu çalışmada kapsamlı biçimde sınanmamıştır.
Kaynak içi tutarsızlık notu: Yöntem modeli decoder-only Transformer olarak tanımlarken Tablo 1 katman derinliğini “Transformer encoder” ifadesiyle açıklamaktadır. MAWP anlatısında göz yapısı merkezi kavram olarak geçmesine rağmen beş açık MAWP başlığı arasında ayrı Eye Structure başlığı bulunmamaktadır. Life Status başlığı ve otomatik etiketleme bölümündeki sınıf kümeleri birebir aynı yazılmamıştır. Figure 7 metni prob doğruluğunun derinlikle tutarlı biçimde arttığını söylerken grafik görseli bütün yöntemlerde tamamen monoton bir artış göstermemektedir. Ayrıca Sequence Correctness ve Outcome Validity tanımlarının kapsam ilişkisine rağmen LifeGo-GPT için %94,7 ve %92,1 değerlerinin neden bu sırada olduğu kaynakta açıklanmamıştır.
Verianla yöntem notu: Bu içerik kaynak makalenin satır satır çevirisi değildir. Problem tanımı, veri hazırlama, otoregresif eğitim, LifeGo-GPT mimarisi, değerlendirme ölçütleri, MAWP probing yapısı, Denklem (1)–(9), müdahale deneyi, ablasyonlar, grafiklerin bilimsel mesajı ve yorum sınırları korunarak bağımsız bir Türkçe bilimsel öğrenme yapısı oluşturulmuştur. Kaynakta bulunmayan başarı değeri, prob doğruluğu veya nedensel sonuç eklenmemiştir.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir