

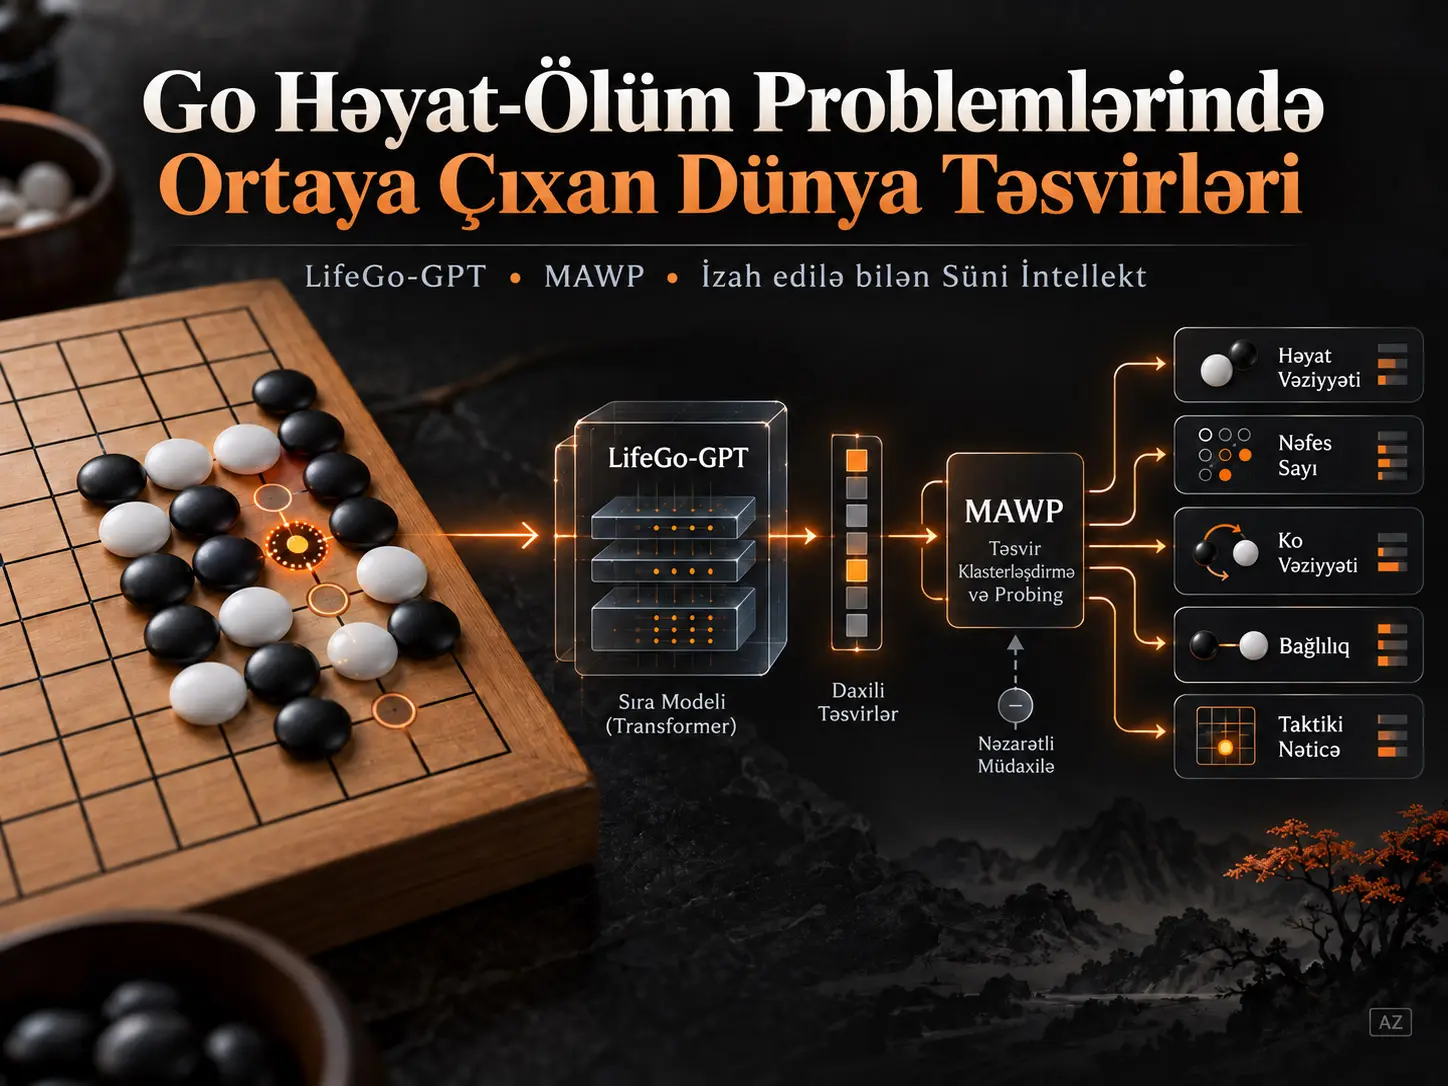
LifeGo-GPT yerli Go həyat-ölüm problemlərinin lövhə vəziyyətlərini və həll gedişlərini ardıcıl token sıraları kimi emal edən GPT-tipli avtoreqressiv Transformer modelidir. Tədqiqatın əsas sualı yalnız modelin düzgün gediş yaradıb-yaratmaması deyil; tədqiqatçılar modelə heç bir açıq Go qaydası və ya strateji anlayış etiketi verilmədən, onun gizli aktivləşmələrində “nəfəslər” (liberties), həyat vəziyyəti, bağlılıq və ko kimi taktiki xüsusiyyətlərlə əlaqəli strukturlaşdırılmış daxili təsvirlər inkişaf etdirib-etdirmədiyini araşdırırlar. Təxminən 10.000 yerli tsumego problemi ilə öyrədilən LifeGo-GPT doğrulama verilənlərində %98,6 gediş qanuniliyi, %94,7 ± 0,6 kanonik həll ardıcıllığı dəqiqliyi və %92,1 nəticə etibarlılığı bildirir.
Modelin daxili vəziyyətlərini təhlil etmək üçün tədqiqatçılar Multi-Aspect World Probe (MAWP) adlı çoxbaşlı probing sistemi hazırlayırlar. MAWP, LifeGo-GPT-nin aralıq qatlarından alınan gizli təsvirləri ortaq xüsusiyyət çıxarıcıdan keçirərək beş taktiki ölçünü ayrıca proqnozlaşdırmağa çalışır: həyat vəziyyəti, nəfəs sayı, ko vəziyyəti, bağlılıq və taktiki nəticə. Beləliklə, modelin yalnız “düzgün gedişi” seçməsi deyil, bu seçimi müşayiət edən daxili vəziyyətin Go-nun məlum taktiki strukturları ilə nə dərəcədə uyğunlaşdığı da araşdırıla bilir.
Tədqiqat yalnız korrelyasiya əsaslı probing ilə kifayətlənmir. Tədqiqatçılar LifeGo-GPT-nin altıncı Transformer qatındakı müəyyən gizli təsvirlərə semantik yönümlü müdaxilələr tətbiq edir və sonrakı gediş logitlərinin necə dəyişdiyini ölçürlər. 1000 problemdə müdaxilədən sonra top-1 gediş %95,4 nisbətində dəyişdiyi halda, təsadüfi səs-küy inyeksiyasında bu göstərici %5,6, eyni böyüklükdə, lakin təsadüfi istiqamətli perturbasiyada %18,7 olmuşdur. İlk beş namizəd gedişdə orta mütləq logit dəyişməsi 3,21-dir. Bu fərqlər daxili təsvirlərin model davranışı ilə funksional əlaqə daşıdığına işarə edir; lakin müəlliflər bunun müəyyən bir “Go anlayışının” dəqiq səbəb-nəticə nəzarətinin sübutu olmadığını xüsusi vurğulayırlar.
Tədqiqatın əhatəsi yerli həyat-ölüm problemləri ilə məhdudlaşır. LifeGo-GPT tam Go oyunu üçün peşəkar mühərrikləri əvəz edən ümumi Go agenti deyil. KataGo yerli müqayisədə %99,2 gediş qanuniliyi, %96,5 ± 0,4 ardıcıllıq dəqiqliyi və %97,8 nəticə etibarlılığı ilə daha güclüdür. Tədqiqatın əsas elmi töhfəsi ardıcıllıq proqnozu ilə öyrədilən modelin yüksəkölçülü və məkan xarakterli strategiya mühitində strukturlaşdırılmış aralıq təsvirlər inkişaf etdirib-etdirmədiyini və bu təsvirlərin davranış üzərində funksional təsirinin ölçülüb-ölçülə bilməyəcəyini araşdırmaqdır.
Go Həyat-Ölüm Problemləri Niyə “Mikro-Dünya” Kimi İstifadə Olunur?
Go həyat-ölüm və ya tsumego problemləri, tam bir Go oyununun bütün strateji mürəkkəbliyini daşımadan nəfəs, göz, bağlılıq, ko və yaşama/ölmə vəziyyəti kimi açıq şəkildə müəyyən edilə bilən yerli taktiki anlayışları ehtiva etdiklərinə görə Transformer modellərinin daxili dünya təsvirlərini öyrənmək üçün uyğun, nəzarət olunan mikro-dünya təqdim edir.
Go-nun tam 19 × 19 lövhəsində bir gedişin dəyəri yerli daş qruplarından ərazi nəzarətinə, uzaq məsafəli qarşılıqlı təsirlərdən qlobal hücum-müdafiə balansına qədər çoxsaylı amildən asılıdır. Bu vəziyyət yalnız proqnoz verməyi deyil, proqnozun niyə verildiyini şərh etməyi də çətinləşdirir.
Həyat-ölüm problemləri isə adətən lövhənin məhdud bir sahəsinə fokuslanır. Məqsəd müəyyən daş qrupunun qüsursuz oyunda yaşayıb-yaşamayacağını müəyyən etməkdir. Problem sahəsi daha kiçik olsa da, əsas Go taktikası qorunur: nəfəs nöqtələri, göz yaratma, tutma yarışları, bağlantı, ko və kritik gediş nöqtələri birlikdə rol oynaya bilər.
Mənbənin Figure 1-də əvvəlcə yerli həyat-ölüm başlanğıc mövqeyi, sonra isə nömrələnmiş həll gedişləri göstərilir. Bir qrupun təhlükəsiz şəkildə yaşaya bilməsinin əsas nümunəsi iki həqiqi göz yaratmasıdır. Tədqiqat bu cür problemlərdən ardıcıllıq modelinin yalnız token korrelyasiyalarını əzbərləyib-əzbərləmədiyini, yoxsa lövhə vəziyyətinə bənzər daha strukturlaşdırılmış gizli təsvirlər inkişaf etdirib-etdirmədiyini araşdırmaq üçün istifadə edir.
Dünya təsviri burada nə deməkdir?
“World representation” ifadəsi bu tədqiqatda modelin Go lövhəsini insan kimi şüurlu şəkildə “anladığı” mənasına gəlmir. Anlayış, modelin gizli aktivləşmələrində xarici mühitin mühüm struktur xüsusiyyətlərinin çözümlənə bilən şəkildə təmsil olunmasını ifadə edir.
Məsələn, LifeGo-GPT-nin gizli vəziyyətlərindən bir daş qrupunun neçə nəfəsi olduğu, qrupun həyat vəziyyəti və ya bağlılıq quruluşu etibarlı şəkildə proqnozlaşdırıla bilirsə, bu informasiya modelin təsvir məkanında mövcuddur. Lakin informasiyanın gizli təsvirdən oxuna bilməsi təkbaşına modelin qərar verərkən həmin informasiyadan istifadə etdiyini göstərmir. Tədqiqatın müdaxilə təcrübələrini əlavə etməsinin əsas səbəbi budur.
Go lövhəsi dil modeli girişinə necə çevrilir?
Hər tsumego nümunəsi ilkin olaraq SGF formatındadır. Tədqiqatçılar problemi iki hissədən ibarət ardıcıl token sırasına çevirirlər:
- hədəf daş qrupunun ətrafındakı başlanğıc lövhə quruluşu,
- problemin istinad həll gedişləri ardıcıllığı.
Standart 19 × 19 Go lövhəsində 361 kəsişmə vardır və hər koordinat unikal token kimliyinə xəritələnir. Buna görə koordinat lüğəti 361 əsas mövqedən ibarətdir. Lövhə vəziyyəti ilə həll ardıcıllığını ayırmaq və ardıcıllığın sərhədlərini göstərmək üçün əlavə olaraq <BOS>, <SEP> və <EOS> kimi xüsusi tokenlardan istifadə olunur.
Koordinatlar 1–361 arasında ədədi kimliklərlə təmsil olunsa da, tədqiqatçılar bu ədədi ardıcıllığa açıq həndəsi məna yükləmirlər. Kimliklər kateqorik indekslər kimi təsadüfi başladılan öyrənilə bilən embeddinglərə ötürülür. Beləliklə, modelin “361 sayı koordinat kimi 360-a qonşudur” tipli birbaşa ədədi həndəsədən istifadə etməsi nəzərdə tutulmur; məkan quruluşu təlim verilənlərindən öyrənilməlidir.
Mənbənin Figure 2-si Go daş lövhəsinin bu ardıcıl mətnəbənzər təsvirə çevrilməsini göstərir. Bu çevrilmə tədqiqatın əsas eksperimental ideyasıdır: ikiölçülü taktiki dünya decoder-only ardıcıllıq modelinə xətti token sırası kimi verilir.
LifeGo-GPT Açıq Go Qaydaları Verilmədən Necə Öyrədilir?
LifeGo-GPT açıq “nəfəs”, “göz”, “ko” və ya “bu gediş qadağandır” qaydaları ilə proqramlaşdırılmaq əvəzinə ardıcıl lövhə-vəziyyəti və həll tokenlarında növbəti tokenı proqnozlaşdırmağı öyrənən standart avtoreqressiv məqsədlə təlim edilir; taktiki qanunauyğunluqların modelin gizli təsvir məkanında təlim verilənlərindən ortaya çıxması gözlənilir.
Növbəti token ehtimalı
Seriyalaşdırılmış problem:
\[ x=(x_1,x_2,\ldots,x_n) \]
kimi göstərilir. Model hər \(t\) addımında əvvəlki tokenlara şərtlənmiş şəkildə növbəti tokenın ehtimalını hesablayır:
\[ p_{\theta}(x_t\mid x_{
Burada \(h_t\), son Transformer qatının \(t\)-ci mövqedə yaratdığı gizli təsvir; \(W_o\), gizli təsviri lüğət ölçüsündə çıxış logitlərinə çevirən proyeksiya matrisi; \(\theta\) isə model parametrlərini göstərir.
Bu tənlik modelin “Go qaydası” hesablamasını birbaşa kodlamır. Modelin vəzifəsi keçmiş lövhə və gediş tokenlarından növbəti uyğun tokenın ehtimal paylanmasını öyrənməkdir.
Dil modeli itkisi
Təlimdə teacher forcing istifadə edilərək standart mənfi log-ehtimal itkisi minimallaşdırılır:
\[ \mathcal{L}_{LM} = -\sum_{t=1}^{n} \log p_{\theta}(x_t\mid x_{
Aşağı itki modelin mənbə həll ardıcıllıqlarındakı növbəti tokenlara daha yüksək ehtimal verməsi deməkdir. Bu təlim məqsədi birbaşa “iki göz yarat”, “self-atari etmə” və ya “nəfəsi qoru” kimi simvolik əmrlər ehtiva etmir.
Verilənlər dəsti necə yaradılıb?
Mənbə verilənləri 101 Weiqi, Xingzhen Go Platform və Jueyi Go Platform kimi açıq onlayn Go mənbələri ilə yanaşı Weiqi Life-and-Death Encyclopedia və Fayang Lun kimi toplanmış problem mənbələrindən götürülmüşdür.
Verilənlər dəstində təxminən 10.000 həyat-ölüm ssenarisi vardır. Çətinlik bölgüsü təxminən belədir:
| Çətinlik səviyyəsi | Təxmini pay | Mənbədə verilən tipik xüsusiyyət |
|---|---|---|
| Asan | 5/10 | Kiçik yerli qruplar, məhdud nəfəs sayı, bir neçə gedişdə həll olunan tutma quruluşları |
| Orta | 3/10 | Tutma yarışları, göz sahəsi rəqabəti, bir neçə ağlabatan variasiya |
| Çətin | 2/10 | Bir-birinə keçmiş qrup mübarizələri, çoxsaylı mümkün həyat formaları və uzun üfüqlü taktika |
Bəzi problemlərin birdən çox etibarlı həlli ola bilər. Təlim hədəfi kimi mənbə materialındakı kanonik həll ardıcıllığı istifadə olunur; qiymətləndirmədə isə eyni yekun həyat-ölüm nəticəsinə aparan alternativ yollar nəticə etibarlılığı çərçivəsində ayrıca qəbul edilir.
Veri sızması necə azaldılmağa çalışılıb?
Veri artırılmasından əvvəl tam təkrarlar problem səviyyəsində silinmişdir. Rotasiya və ya əks etdirmə səbəbindən həndəsi baxımdan ekvivalent olan lövhə vəziyyətləri kanonikləşdirilərək əlavə təkrarlar müəyyən edilmişdir.
Təlim və doğrulama bölünməsi artırılmış nümunə səviyyəsində deyil, orijinal problem səviyyəsində aparılmışdır. Beləliklə, eyni problemin çevrilmiş variantlarının həm təlim, həm də doğrulama tərəfində olması qarşısı alınmağa çalışılmışdır. Verilənlər dəsti təxminən 8:2 təlim/doğrulama nisbətində bölünmüşdür.
Rəng inversiyası yalnız problemin mənasının oyunçu rənginin dəyişməsindən təsirlənmədiyi hallarda tətbiq edilmişdir. Tədqiqatçılar həmçinin yaxın-təkrar nümunələri yoxlayaraq doğrulama sızması və süni şəkildə şişirdilmiş dəqiqlik riskini azaltmağa çalışdıqlarını bildirirlər.
LifeGo-GPT arxitekturası və təlim parametrləri
| Hiperparametr | Dəyər |
|---|---|
| Transformer qatı | 8 |
| Attention head | 8 |
| Gizli ölçü | 512 |
| Optimizer | Adam |
| Learning rate | \(1\times10^{-4}\) |
| Batch size | 64 |
| Maksimum təlim epoch-u | 100 |
| Gradient clipping | Maksimum norm = 1,0 |
| Erkən dayandırma | Doğrulama performansına görə |
Bütün token və positional embedding parametrləri təsadüfi başladılmışdır. Model əvvəlcədən öyrədilmiş təbii dil GPT-sinin Go-ya birbaşa köçürülməsi deyil.
Mənbə Figure 3-də təlim və doğrulama itkisinin epoch boyunca müntəzəm azaldığını göstərir. Şəklin xam ədədi sırası ayrıca cədvəl şəklində verilmədiyinə görə Verianla qrafikdən dəqiq aralıq dəyərlər çıxarmamışdır.
Mənbə terminologiyası qeydi: Metod mətni modeli GPT-tipli decoder-only Transformer kimi təsvir edərkən, Cədvəl 1 qat sayını “Transformer encoder depth” kimi açıqlayır. Burada metod izahındakı decoder-only təsviri qorunmuş, cədvəl ifadəsi mənbə daxilində terminoloji fərq kimi qiymətləndirilmişdir.
Model Uğuru Necə Ölçülür?
Tədqiqat LifeGo-GPT-ni üç ayrıca ölçü ilə qiymətləndirir: Move Legality proqnozlaşdırılan gedişin həmin anda qanuni olub-olmadığını, Sequence Correctness yaradılan gediş ardıcıllığının kanonik həllə uyğun olub-olmadığını və Outcome Validity yaranan son vəziyyətin düzgün həyat-ölüm nəticəsinə çatıb-çatmadığını ölçür.
Move Legality
Modelin yaratdığı koordinat mövcud lövhə vəziyyətində etibarlı Go gedişinə uyğun gəlirsə, qanuni sayılır. Bu metrik modelin əsas qayda strukturunu dolayı yolla öyrənib-öyrənmədiyinin ilk göstəricisidir.
Sequence Correctness
Yaradılan həll ardıcıllığı mənbə problemdəki kanonik həllə müqayisə olunur. Mənbə izahına görə kanonik ardıcıllıqla tam uyğun gəlməyən alternativ yollar bu metrikdə yanlış sayılır.
Outcome Validity
Proqnozlaşdırılan gedişlər lövhədə tətbiq edilir və hədəf qrupun yekun həyat-ölüm vəziyyəti xarici KataGo mühərriki ilə yoxlanılır. Kanonik ardıcıllıqdan fərqli olsa belə, eyni düzgün həyat-ölüm vəziyyətinə çatan alternativ həll bu metrikdə etibarlı sayıla bilər.
Şərh qeydi: Bu təriflər altında Outcome Validity-nin Sequence Correctness-dan daha əhatəli görünməsi gözlənilə bilər; buna baxmayaraq LifeGo-GPT üçün mənbə %94,7 Sequence Correctness və %92,1 Outcome Validity bildirir. Mənbə bu əlaqənin səbəbini ayrıca açıqlamadığı üçün Verianla səbəb barədə fərziyyə irəli sürmür.
Tədqiqatın Metodu və Nəticələri
LifeGo-GPT-nin müqayisəli nəticələri
| Metod | Gediş qanuniliyi | Ardıcıllıq dəqiqliyi | Nəticə etibarlılığı |
|---|---|---|---|
| Öyrədilməmiş Transformer | %15,8 | %12,3 ± 2,1 | %10,5 |
| LifeGo-GPT | %98,6 | %94,7 ± 0,6 | %92,1 |
| KataGo, yalnız yerli | %99,2 | %96,5 ± 0,4 | %97,8 |
| Leela Zero, yalnız yerli | %98,9 | %92,4 ± 0,7 | %90,7 |
| RZS | %88,6 | %78,3 ± 1,5 | %72,4 |
| ANN | %96,3 | %94,5 ± 0,9 | %89,4 |
LifeGo-GPT öyrədilməmiş Transformer baza xəttindən xeyli yüksək nəticə göstərir. Yerli tsumego tapşırığında LifeGo-GPT-nin ardıcıllıq dəqiqliyi Leela Zero və RZS-dən yüksək, ANN-ə çox yaxın və KataGo-dan aşağı bildirilmişdir.
KataGo üç əsas ölçünün hamısında LifeGo-GPT-dən daha yüksək dəyərlərə malikdir. Buna görə nəticəni “LifeGo-GPT peşəkar Go mühərriklərindən daha güclüdür” kimi şərh etmək olmaz. Mənbə də peşəkar mühərriklərin xüsusilə daha mürəkkəb və tam-lövhə vəziyyətlərində daha güclü olduğunu açıq şəkildə bildirir.
LifeGo-GPT-nin elmi əhəmiyyəti fərqlidir: model Go qaydaları ayrıca simvolik sistem kimi verilmədən yalnız ardıcıl problem verilənlərindən yüksək dərəcədə qanuni və düzgün yerli gediş ardıcıllıqları öyrənmişdir. Tədqiqatın sonrakı bölmələri bu uğurun altında hansı gizli təsvir quruluşunun dayandığını araşdırır.
Səhv nümunələri hansı hallarda cəmlənir?
Mənbə səhv analizində üç əsas problem sinfi müəyyən edir:
- çoxmərhələli məntiq yürütmə tələb edən mürəkkəb həyat-ölüm problemləri,
- daha dərin taktiki asılılıqlar ehtiva edən uzun həll ardıcıllıqları,
- bir neçə gedişin oxşar nəticə verə bildiyi qeyri-müəyyən mövqelər.
Bu səhv nümunəsi modelin yerli taktiki qanunauyğunluqları güclü şəkildə tutmasına baxmayaraq, uzunməsafəli asılılıq və yüksək qeyri-müəyyənlik altında məhdud qaldığını göstərir.
Multi-Aspect World Probe (MAWP) Nədir?
Multi-Aspect World Probe (MAWP), LifeGo-GPT-nin gizli Transformer təsvirlərindən tək bir ümumi “lövhə vəziyyəti” etiketi çıxarmaq əvəzinə beş ayrı taktiki xüsusiyyəti ortaq xüsusiyyət kodlayıcısı üzərindən paralel şəkildə təhlil etməyə çalışan modul probing çərçivəsidir.
MAWP niyə tək prob əvəzinə birdən çox ölçü istifadə edir?
Bir Go daş qrupunun həyat vəziyyəti tək bir amildən asılı deyil. Nəfəslər, qrup bağlantısı, ko vəziyyəti və yaranan taktiki nəticə bir-biri ilə bağlıdır. Təkbaşlı prob gizli təsvirdə hansı alt anlayışın həqiqətən mövcud olduğunu ayırmaqda çətinlik çəkə bilər.
MAWP buna görə ortaq MLP əsaslı xüsusiyyət çıxarıcısının nəticəsini beş paralel təsnifat başlığına göndərir:
| Başlıq | Mənbə adı | Proqnozlaşdırılan anlayış |
|---|---|---|
| A1 | Life Status | Daş/qrupun ölü, canlı və ya vəziyyəti qeyri-müəyyən olması |
| A2 | Liberty Count | Nəfəs sayı: sıfır, bir və ya birdən çox |
| A3 | Ko Status | Ko nöqtəsi, ko təhdidi və ya əlaqəsiz vəziyyət |
| A4 | Connectivity | İzolyasiya olunmuş, bağlı və ya potensial olaraq ölümcül şəkildə iç-içə keçmiş quruluş |
| A5 | Tactical Outcome | Öldürmə, yaşama, seki və ya qarşılıqlı ölüm nəticəsi |
Mənbə Figure 4, LifeGo-GPT-dən seçilən gizli vəziyyətin ortaq MLP xüsusiyyət kodlayıcısına daxil olduğunu və oradan beş ayrıca MAWP başlığına paylandığını açıq şəkildə göstərir.
Mənbə daxilində anlayış qeydi: Məqalənin giriş, xülasə və nəticə hissələrində “eyes”, yəni göz quruluşu əsas ortaya çıxan təsvirlər arasında qeyd olunur və MAWP-nin konseptual izahında da “eye structure” nümunəsi verilir. Bununla belə, Figure 4 və beş açıq başlıq siyahısında ayrıca “Eye Structure” prob başlığı yoxdur. Buna görə Verianla göz quruluşunu altıncı MAWP çıxışı kimi əlavə etmir.
Gizli təsvirin riyazi göstərimi
Seçilən Transformer qatındakı təsvir:
\[ x_t^{(l)}\in\mathbb{R}^{N\times d} \tag{3} \]
kimi verilir. Burada \(l\) seçilən qatı, \(N\) yerli lövhə nöqtələrinin sayını və \(d\) gizli təsvir ölçüsünü göstərir.
Ortaq xüsusiyyət çıxarıcısı \(\phi(x)\) istifadə edildikdən sonra hər semantik ölçü üçün ayrıca softmax təsnifləndiricisi işləyir:
\[ h_i(\phi(x)) = \operatorname{softmax}\left(W_i\phi(x)\right), \qquad i=1,\ldots,5. \tag{4} \]
Hər lövhə nöqtəsi \(p\) üçün ortaq latent təsvir:
\[ z_{t,p} = \phi\left(x_{t,p}^{(l)}\right), \qquad p\in\{1,\ldots,N\} \tag{5} \]
və \(i\)-ci taktiki ölçünün proqnozu:
\[ \hat y_{t,p}^{(i)} = h_i(z_{t,p}) \tag{6} \]
kimi yazılır.
MAWP-nin ümumi itkisi
Beş probing tapşırığının cross-entropy itkiləri çəkili şəkildə toplanır:
\[ \mathcal{L}_{probe} = \sum_{i=1}^{5} \lambda_i \cdot \mathcal{L}_{CE} \left( h_i(\phi(x)), y^{(i)} \right). \tag{7} \]
Mənbə standart olaraq bütün başlıqlara bərabər çəki verir:
\[ \lambda_i=\frac{1}{5}. \]
Bu seçim beş semantik probun modelin lövhə vəziyyətini anlamağına bərabər töhfə verdiyi fərziyyəsinə əsaslanır. Tədqiqatçılar tapşırıq çətinliyi və ya sinif balanssızlığına görə fərqli çəkilərin mümkün olduğunu, lakin tədqiqatda bərabər çəkinin istifadə edildiyini bildirirlər.
MAWP etiketləri necə yaradılır?
Prob etiketləri yalnız əl ilə verilmiş şərhlərdən ibarət deyil. Tədqiqatçılar KataGo əsaslı analizlə deterministik son emal qaydalarını birləşdirirlər.
Əvvəlcə hədəf daş qrupu müəyyən edilir və eyni rəngli daşların bağlı komponenti hesablanır. Nəfəs sayı həmin bağlı qrupun qonşuluğundakı fərqli boş kəsişmələrin sayılması ilə əldə edilir.
Həyat vəziyyəti sabit axtarış büdcəsi altında güclü Go mühərriki ilə doğrulanır. Mənbə avtomatik etiket yaratma bölməsində mühərrik nəticəsinin alive, dead, seki və unresolved etiketlərinə xəritələndiyini bildirir. Uyğunsuz və ya qeyri-müəyyən mühərrik nəticələri probing verilənlər dəstindən çıxarılır.
Bağlılıq yerli lövhədə eyni rəngli daşların dörd-qonşuluq əlaqəsi ilə müəyyən edilir. Ko etiketləri yalnız mühərrikin principal variation çıxışı və yerli qayda yoxlaması explicit ko quruluşunu təsdiqlədikdə təyin edilir. Taktiki nəticə istinad həlli tətbiq edildikdən sonra hədəf qrupun terminal həyat-ölüm vəziyyətinin yenidən qiymətləndirilməsi ilə müəyyən edilir.
Burada da kiçik bir mənbə fərqi var: A1 başlıq tərifi dead/live/undetermined siniflərini verir, avtomatik etiketləmə mətni isə alive/dead/seki/unresolved dəstindən istifadə edir. Mənbə bu iki etiket sxeminin bir-birinə necə çevrildiyini təfərrüatlandırmır; Verianla bu uyğunlaşdırmanı təxmin etmir.
Bir Xüsusiyyətin Gizli Təsvirdən Oxuna Bilməsi Modelin Ondan İstifadə Etdiyini Sübut Edirmi?
Xeyr. Probing təsnifləndiricisinin gizli aktivləşmələrdən nəfəs və ya həyat vəziyyəti məlumatını çıxarması bu məlumatın təsvir daxilində mövcud olduğunu göstərir; lakin LifeGo-GPT-nin gediş qərarını həqiqətən bu xüsusiyyət üzərindən verdiyini təkbaşına sübut etmir. Buna görə tədqiqat müşahidə əsaslı probing-i hədəflənmiş təsvir müdaxilələri ilə tamamlayır.
Müdaxilə benchmarkı
Tədqiqatçılar müdaxilə təcrübələri üçün 1000 həyat-ölüm halından ibarət ayrıca qiymətləndirmə benchmarkı yaratmışdır. Hər halda başlanğıc qara-ağ daş mövqeləri, müdaxilə hədəfi və düzgün gediş ardıcıllığı vardır.
Müdaxilə birbaşa giriş lövhəsini dəyişdirmir. Tədqiqatçılar LifeGo-GPT-nin gizli təsvir məkanındakı hədəf mövqeni dəyişdirərək, məsələn, bir daşın rənginin çevrilməsini semantik şəkildə təqlid edən transformasiya tətbiq edirlər.
Bütün müdaxilələr 6-cı qatda aparılmışdır. Müəlliflərin əsaslandırması belədir:
- aşağı qatlarda aktivləşmələr daha çox səthi token əlaqələri və yerli nümunələrlə bağlıdır;
- ən yuxarı qatlar yekun proqnoza həddindən artıq ixtisaslaşmış ola bilər;
- 6-cı qat kompozisional lövhə/taktiki məlumatların formalaşdığı, lakin qərar çıxışından hələ tam ayrılmadığı aralıq səviyyə kimi seçilmişdir.
Müdaxilə tənliyi
Hədəf gizli təsvir üzərində müdaxilə mənbədə belə yazılır:
\[ \widetilde{x}_t^{(l)} = do\left( x_{t,g}^{(l)} \leftarrow \psi(x_{t,g}^{(l)},c) \right) \tag{8} \]
Burada \(g\) müdaxilə edilən lövhə mövqeyini; \(c\) müdaxilədən sonra semantik olaraq təqlid edilən xüsusiyyəti; \(\psi\) isə təsvir məkanındakı transformasiyanı göstərir.
Müdaxilədən sonra və əvvəl proqnoz fərqi:
\[ \Delta a = f_{\theta} \left( \widetilde{x}_t^{(l)} \right) - f_{\theta} \left( x_t^{(l)} \right) \tag{9} \]
kimi qiymətləndirilir. Burada məqsəd yalnız proqnozun dəyişib-dəyişmədiyini deyil, müdaxilənin gediş seçimi logitlərini hansı dərəcədə dəyişdirdiyini araşdırmaqdır.
Figure 5 və Figure 6 nəyi göstərir?
Figure 5 müdaxilədən əvvəl yerli lövhə vəziyyətini və gediş-logit xəritəsini göstərir. Mənbə rəng şkalasında daha isti rənglər daha aşağı proqnoz ehtimallarını, daha soyuq rənglər isə daha yüksək balları təmsil edir.
Figure 6 eyni nümunənin müdaxilədən sonrakı vəziyyətini göstərir. Yüksək ballı sahələrin daha sabit xarici mövqelərə doğru sürüşdüyü müşahidə edilmişdir. Tədqiqatçılar bunu gizli təsvir dəyişikliklərinin modelin taktiki üstünlüklərinə sistematik təsir etdiyini göstərən nümunə kimi təqdim edirlər.
Müdaxilə təcrübələrinin kəmiyyət nəticəsi
| Müdaxilə/ölçüm | Nəticə |
|---|---|
| Semantik yönümlü müdaxilədən sonra top-1 gedişin dəyişməsi | %95,4 |
| İlk beş namizəd üzrə orta mütləq logit dəyişməsi | 3,21 |
| Təsadüfi səs-küy inyeksiyasında top-1 gediş dəyişməsi | %5,6 |
| Eyni böyüklükdə təsadüfi istiqamət perturbasiyasında top-1 gediş dəyişməsi | %18,7 |
Semantik olaraq hədəflənmiş müdaxilənin təsadüfi səs-küydən və eyni böyüklükdə təsadüfi istiqamət perturbasiyasından xeyli böyük davranış dəyişikliyi yaratması, təsirin yalnız modelin istənilən gizli vəziyyət dəyişikliyinə həddindən artıq həssas olmasından qaynaqlanmadığı arqumentini dəstəkləyir.
Müdaxilə Nəticələri Qəti Səbəb-Nəticə Sübutudurmu?
Xeyr. Mənbə hədəflənmiş müdaxilələrin təsadüfi nəzarətlərdən xeyli güclü proqnoz dəyişiklikləri yaratmasını daxili təsvirlərin qərar prosesi ilə funksional bağlılığı lehində sübut kimi qiymətləndirir; lakin böyük proqnoz dəyişməsinin müəyyən bir semantik dəyişənin dəqiq və müstəqil şəkildə idarə olunduğunu qəti göstərmədiyini açıq şəkildə qəbul edir.
Güclü ardıcıllıq modeli semantik məna daşıyan kritik sahələrdə aparılan strukturlaşdırılmış dəyişikliklərə ümumiyyətlə yüksək həssaslıq göstərə bilər. Bu halda müdaxilənin təsiri yalnız “həyat vəziyyəti dəyişəninin səbəb-nəticə nəzarəti”ndən deyil, daha geniş təsvir pozuntusundan da qaynaqlana bilər.
Təsadüfi perturbasiya nəzarətləri bu izahı qismən məhdudlaşdırır, lakin tam aradan qaldırmır. Buna görə məqalənin ən təhlükəsiz nəticəsi:
Probe nəticələri taktiki məlumatın gizli təsvirlərdə kodlandığını; müdaxilə nəticələri isə bu strukturlaşdırılmış təsvir komponentlərinin proqnoz davranışı ilə funksional olaraq əlaqəli olduğunu göstərir. Müəyyən semantik dəyişənlərin dəqiq və müstəqil səbəb-nəticə nəzarəti hələ sübut olunmayıb.
Model dərinliyi ablasyonu
Tədqiqatçılar 2, 4, 6 və 8 Transformer qatlı LifeGo-GPT variantları öyrədib və hər modeldə üç probing yanaşmasını müqayisə etmişdir:
- linear probe,
- standart nonlinear probe,
- MAWP.
Mənbə Figure 7-nin əsas keyfiyyət nəticəsi MAWP-nin bütün araşdırılan dərinliklərdə linear probe-dan və ümumən standart nonlinear probe-dan daha yüksək prob dəqiqliyinə malik olmasıdır. Fərq xüsusilə orta və daha dərin qatlarda daha aydın olur.
Müəlliflər daha dərin Transformer qatlarının aşağı səviyyəli token əlaqələrindən daha inteqrə olunmuş məkan və taktiki təsvirlərə keçdiyini şərh edirlər. Bu şərh nəfəs və bağlılıq kimi anlayışların daha dərin qatlardan daha yaxşı çözümlənə bilməsi ilə əlaqələndirilir.
Qrafik şərh sərhədi: Mətn prob dəqiqliyinin model dərinliyi ilə bütün metodlarda “ardıcıl şəkildə artdığını” bildirir. Bununla belə, Figure 7 çubuqları vizual olaraq nəzərdən keçirildikdə nonlinear və MAWP sıralarının 8 qata qədər tam monoton artmadığı görünür. Xam ədədi cədvəl verilmədiyinə görə Verianla qrafikdən dəqiq dəyər çıxarmamış və yalnız açıq şəkildə etibarlı keyfiyyət meylini ötürmüşdür.
Veri artırma ablasyonu
Figure 8 lövhə səviyyəsində simmetriya əsaslı veri artırmanın təsirini araşdırır. Mənbədə üç vəziyyət göstərilir:
- artırma yoxdur,
- rotasiya,
- əks etdirmə/flip.
Müəlliflərin şərhinə görə veri artırma çıxarıldıqda xüsusilə daha dərin qatlarda prob dəqiqliyi azalır. Simmetriyaya həssas artırma eyni həyat-ölüm quruluşunun fərqli istiqamətlərdə görünməsinə baxmayaraq modelin ortaq struktur xüsusiyyətləri öyrənməsini təşviq edir.
Bu nəticə yalnız yekun gediş performansına aid deyil. Müəlliflər artırmanın daxili təsvir ardıcıllığını və çevrilmələrə qarşı daha sabit xüsusiyyətlərin öyrənilməsini də dəstəklədiyini irəli sürürlər.
Tədqiqatın dəstəklədiyi nəticələr
Tədqiqat yerli Go həyat-ölüm ardıcıllıqlarından öyrədilən GPT-tipli modelin yüksək gediş qanuniliyi və həll performansı inkişaf etdirə bildiyini dəstəkləyir.
MAWP təcrübələri LifeGo-GPT-nin gizli təsvirlərindən həyat vəziyyəti, nəfəs sayı, ko, bağlılıq və taktiki nəticə kimi strukturlaşdırılmış məlumatların çözümlənə bildiyini dəstəkləyir.
Hədəflənmiş təsvir müdaxilələrinin təsadüfi perturbasiyalara nisbətən xeyli böyük gediş seçimi dəyişməsi yaratması bu strukturlaşdırılmış xüsusiyyətlərin model davranışında yalnız passiv korrelyatlar olmaya biləcəyinə və funksional əhəmiyyət daşıdığına dair sübut təqdim edir.
Model dərinliyi və simmetriya əsaslı veri artırma təcrübələri daxili təsvir keyfiyyətinin yalnız yekun proqnoz performansından deyil, arxitektura dərinliyindən və təlim verilənlərinin transformasiya quruluşundan da təsirləndiyini göstərir.
Tədqiqatın dəstəkləmədiyi nəticələr
Tədqiqat LifeGo-GPT-nin Go oyununu insan kimi “anladığını” və ya şüurlu strateji anlayışlara malik olduğunu sübut etmir. Probing nəticələri gizli aktivləşmələrdən müəyyən məlumatların çözümlənə bildiyini göstərir.
Tədqiqat müəyyən semantik xüsusiyyətin tam izolyasiya olunmuş və dəqiq şəkildə səbəb-nəticə üzrə idarə olunduğunu da sübut etmir. Müəlliflər müdaxilə nəticələrini qəti causal identification deyil, causal relevance lehində sübut kimi məhdudlaşdırırlar.
LifeGo-GPT-nin uğuru tam lövhə Go-ya birbaşa ümumiləşdirilə bilməz. Təcrübələr yerli həyat-ölüm problemlərinə fokuslanmışdır; KataGo kimi peşəkar mühərriklərin tam lövhə oyunda daha güclü olduğu mənbə tərəfindən açıq şəkildə bildirilmişdir.
Təxminən 10.000 problemdən ibarət verilənlər dəsti müxtəlif açıq mənbələrdən və klassik problem kolleksiyalarından toplanmışdır. Nəticələrin başqa Go problem kolleksiyalarında, fərqli çətinlik bölgülərində və ya tamamilə müstəqil veri yaratma prosesində eyni dəyərləri verəcəyi bu tədqiqat tərəfindən göstərilməmişdir.
Figure 7 və Figure 8-də göstərilən probe/augmentation nəticələrinin xam ədədi sıraları məqalədə cədvəl şəklində verilmədiyinə görə Verianla bu qrafiklərdən dəqiq rəqəmlər çıxarmamışdır.
Tam lövhə Go-ya miqyaslama necə düşünülür?
Nəticə bölməsində müəlliflər yerli həyat-ölüm təsvirlərinin tam Go oyununa necə inteqrasiya oluna biləcəyini gələcək tədqiqat istiqaməti kimi müzakirə edirlər. Təklif olunan konseptual yanaşma yerli həyat-ölüm modelini təkbaşına bütün oyunu idarə edən agent etmək əvəzinə qlobal qərar sisteminin taktiki alt modulu kimi istifadə etməkdir.
Bu çərçivədə yerli modul nəfəs, göz, bağlılıq və həyat-ölüm vəziyyəti kimi “yerli vəziyyət reallığını” təmsil etdiyi halda, daha geniş sistem ərazi proqnozu, hücum-müdafiə prioritetləri və qlobal strateji dəyər kimi məlumatları birləşdirir.
Eyni yerli formanın fərqli tam-lövhə kontekstlərində fərqli strateji əhəmiyyət daşıya bilməsi bu fərqin niyə lazım olduğunu göstərir. Bu bölmə tədqiqatın eksperimental nəticəsi deyil, müəlliflərin gələcəyə yönəlmiş memarlıq perspektividir.
Dil modelləri və Go-nun gələcəkdə birləşdirilməsi
Mənbə həmçinin əvvəlcədən öyrədilmiş çoxdilli Transformerların simvolik oyun mühitləri ilə birləşdirilməsini gələcək tədqiqat sahəsi kimi təklif edir. Lövhə ardıcıllıqlarının insan şərhləri, oyun notasiyası və ya taktiki izahlarla birlikdə işlənməsi həm şərh ediləbilərlik, həm də qeyri-müəyyən mövqelərdə qərarvermə baxımından araşdırıla bilər.
Müəlliflər gizli məkandakı müdaxilə texnikalarının gələcəkdə insanın model davranışını yönləndirə, sazlama aparıb səhvləri aşkarlaya və ya müəyyən xüsusiyyətləri dəyişə bildiyi idarə olunan oyun agentləri üçün əsas yarada biləcəyini də irəli sürürlər. Bu təkliflər mövcud təcrübədə həyata keçirilmiş sistemlər deyil.
Mənbə və Metod Qeydi
Orijinal tədqiqat: Probing Emergent World Representations in Go Life-and-Death Problems
Müəlliflər: Zhikai Yang; Zhigang Meng; Zhiqiang Wen.
Məsul müəllif: Zhigang Meng.
Qurumlar: School of Computer Science and Artificial Intelligence, Hunan University of Technology, Zhuzhou, Çin; Hunan Provincial Video Cultural and Creative Research Base, Changsha, Çin; School of Computer Science and Engineering, Changsha University, Changsha, Çin.
Jurnal: AI.
Nəşriyyat: MDPI.
Mənbə növü: Rəyli orijinal tədqiqat məqaləsi; Transformer əsaslı ardıcıllıq modelləşdirilməsi, izah edilə bilən süni intellekt, probing və təsvir müdaxiləsi ehtiva edən hesablama tədqiqatı.
Nəşr məlumatı: AI 2026, cild 7, say 5, məqalə 170.
DOI: 10.3390/ai7050170
Göndərilmə: 10 Mart 2026.
Reviziya: 22 Aprel 2026.
Qəbul: 7 May 2026.
Nəşr: 14 May 2026.
Versiya qeydi: MDPI-nin rəsmi versiya tarixçəsində məqalənin HTML/PDF qeydlərinin 20 May 2026-da yeniləndiyi görünür; biblioqrafik nəşr tarixi 14 May 2026 olaraq qalır.
Lisenziya: Creative Commons Attribution (CC BY), açıq giriş.
Maliyyələşdirmə: Tədqiqat Natural Science Foundation of Hunan Province, China (Grant No. 2024JJ7149), Hunan Provincial Video Cultural and Creative Research Base və Hunan Provincial Education Department Scientific Research Fund (Grant No. 22A0414) tərəfindən dəstəklənmişdir.
İnstitusional etik komitə: Tətbiq olunmur.
Məlumatlandırılmış razılıq: Tətbiq olunmur.
Verilənlərə əlçatanlıq: Müəlliflər tədqiqatda təqdim olunan verilənlərin məqalə daxilində olduğunu, əlavə məlumat üçün məsul müəllifə müraciət edilə biləcəyini bildirirlər.
Təşəkkür: Müəlliflər Hunan University of Technology, Hunan Provincial Video Cultural and Creative Research Base və Changsha University-yə dəstəklərinə görə təşəkkür edirlər.
Maraqlar toqquşması: Müəlliflər maraqlar toqquşması olmadığını bəyan etmişdir.
Müəllif töhfələri: Konseptuallaşdırma Zhikai Yang və Zhigang Meng; proqram təminatı Zhikai Yang; metodologiya Zhiqiang Wen və Zhikai Yang; doğrulama, tədqiqat və resurslar Zhikai Yang və Zhigang Meng; ilkin qaralama Zhikai Yang və Zhigang Meng; nəzərdən keçirmə və redaktə Zhigang Meng və Zhiqiang Wen tərəfindən həyata keçirilmişdir.
Əsas metodoloji məhdudiyyətlər: Təcrübələr təxminən 10.000 yerli tsumego problemi ilə məhduddur; tam-lövhə Go qiymətləndirilməsi aparılmayıb. MAWP-nin gizli təsvirlərdən məlumat çözümləyə bilməsi təkbaşına qərar mexanizmində səbəb-nəticə istifadəsinin sübutu deyil. Müdaxilə təcrübələri funksional əhəmiyyət lehində güclü fərqlər yaratsa da, müəlliflər dəqiq semantik dəyişən nəzarəti iddiasında deyillər. Figure 7–8 üçün xam ədədi cədvəllər verilməyib. LifeGo-GPT-nin xarici problem kolleksiyalarında və ya fərqli veri paylanmalarında eyni performansı qoruyub-qorumadığı bu tədqiqatda geniş şəkildə sınanmayıb.
Mənbə daxilində uyğunsuzluq qeydi: Metod modeli decoder-only Transformer kimi təsvir edərkən, Cədvəl 1 qat dərinliyini “Transformer encoder” ifadəsi ilə açıqlayır. MAWP izahında göz quruluşu mərkəzi anlayış kimi keçir, lakin beş açıq MAWP başlığı arasında ayrıca Eye Structure başlığı yoxdur. Life Status başlığı və avtomatik etiketləmə bölməsindəki sinif dəstləri sözbəsöz eyni yazılmayıb. Figure 7 mətni prob dəqiqliyinin dərinliklə ardıcıl artdığını bildirərkən qrafik vizualı bütün metodlarda tam monoton artım göstərmir. Bundan əlavə Sequence Correctness və Outcome Validity təriflərinin əhatə əlaqəsinə baxmayaraq LifeGo-GPT üçün %94,7 və %92,1 dəyərlərinin niyə bu qaydada olduğu mənbədə izah edilmir.
Verianla metod qeydi: Bu məzmun mənbə məqalənin sətir-sətir tərcüməsi deyil. Problem tərifi, veri hazırlığı, avtoreqressiv təlim, LifeGo-GPT arxitekturası, qiymətləndirmə ölçüləri, MAWP probing quruluşu, Tənlik (1)–(9), müdaxilə təcrübəsi, ablasyonlar, qrafiklərin elmi mesajı və şərh sərhədləri qorunaraq müstəqil Azərbaycan dilində elmi öyrənmə quruluşu yaradılmışdır. Mənbədə olmayan uğur dəyəri, prob dəqiqliyi və ya səbəb-nəticə nəticəsi əlavə edilməmişdir.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib