

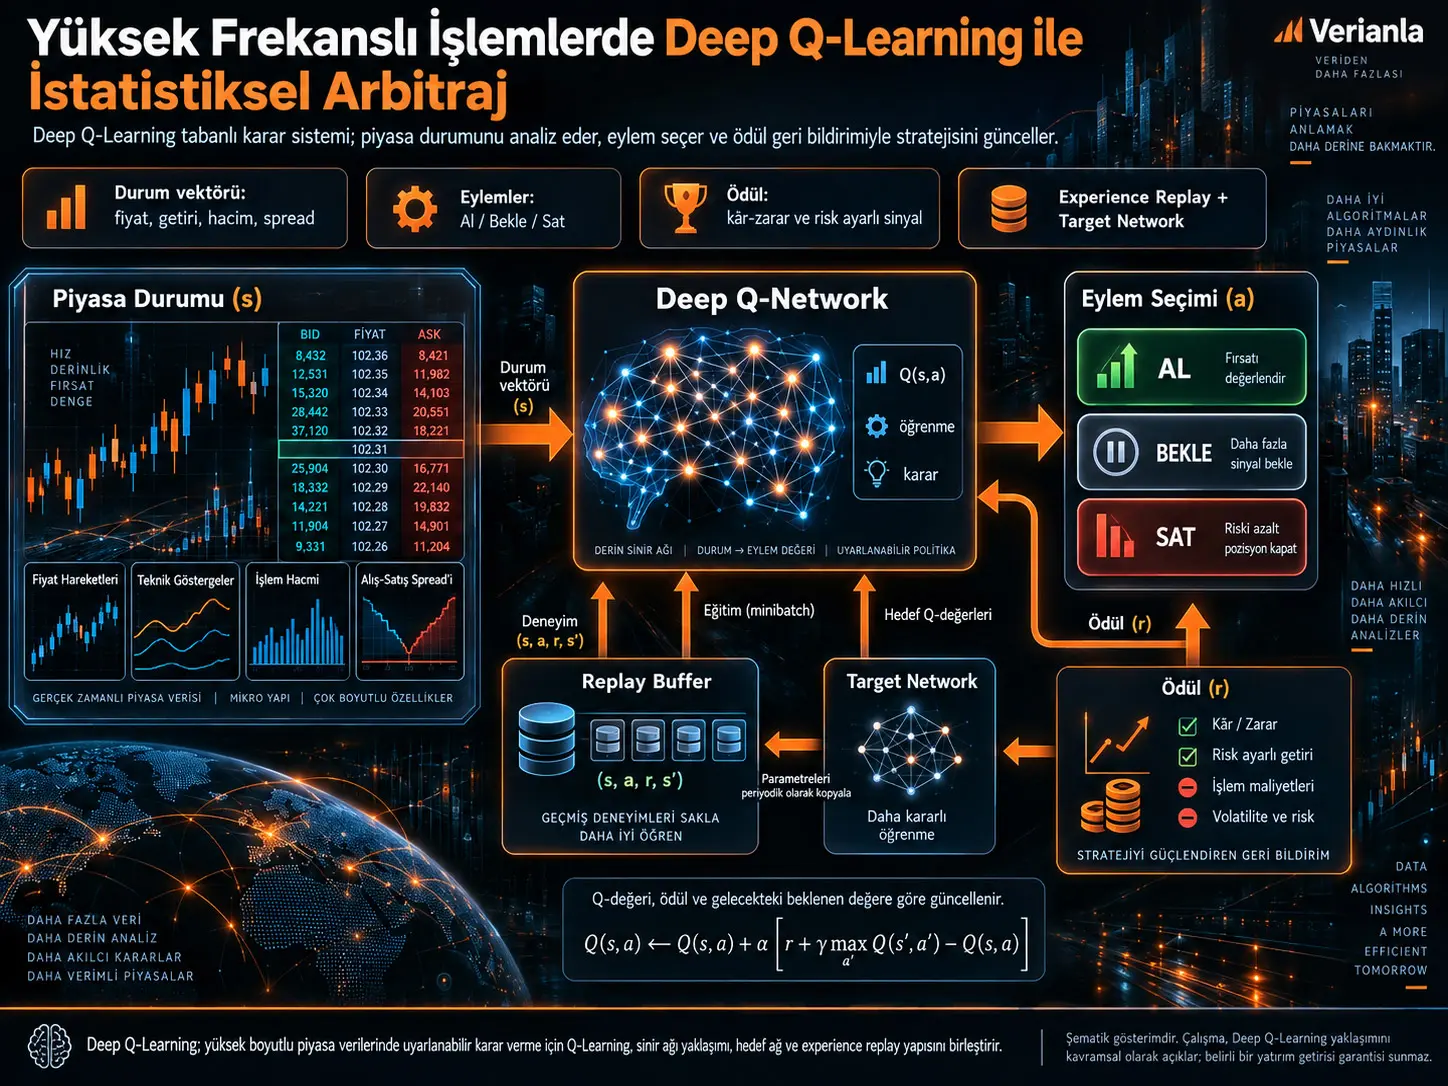
Deep Q-Learning, bir pekiştirmeli öğrenme ajanının belirli bir piyasa durumunda farklı eylemlerin beklenen uzun dönem değerlerini derin bir sinir ağıyla yaklaşık olarak hesapladığı model-free bir karar öğrenme yaklaşımıdır. İncelenen çalışma, bu yaklaşımın yüksek frekanslı işlemlerde (High-Frequency Trading, HFT) istatistiksel arbitraj için nasıl kullanılabileceğini Q-Learning güncellemesi, sinir ağı tabanlı Q-fonksiyonu, hedef ağ, experience replay ve durum-eylem-ödül tasarımı üzerinden açıklamaktadır. Kaynak, Deep Q-Learning'in değişken piyasa koşullarına uyarlanabileceğini ileri sürmektedir; ancak PDF'nin gövdesi bu iddiayı doğrulayacak ayrıntılı backtest verileri veya nicel performans sonuçları sunmamaktadır.
Önerilen HFT çerçevesinde piyasa durumu; son fiyat hareketleri, getiriler, teknik göstergeler, işlem hacmi ve bid-ask spread gibi değişkenlerden oluşabilir. Ajan bu duruma göre satın alma, pozisyonu koruma veya satma gibi eylemler arasından seçim yapar. Gerçekleşen kâr/zarar ya da risk ayarlı performans ödül sinyaline dönüştürülür; Q-ağı daha sonra gerçekleşen deneyimlerden öğrenerek gelecekteki kararlarını günceller.
Çalışmanın en öğretici yönü, HFT problemini tek seferlik fiyat tahmini olarak değil, ardışık karar verme problemi olarak ele almasıdır. Bununla birlikte bir yöntemin kavramsal olarak uygun olması, gerçek piyasada ekonomik üstünlük sağladığını tek başına göstermez. Gecikme, emir defteri dinamikleri, işlem ücretleri, slippage, piyasa etkisi, gerçek zamanlı hesaplama maliyeti ve rejim değişimleri gibi HFT açısından kritik faktörlerin kaynakta ampirik olarak nicelleştirilmemesi önemli bir sınırlılıktır.
Yüksek frekanslı işlem neden ardışık karar problemidir?
Yüksek frekanslı işlem sistemleri yalnız “bir sonraki fiyat yukarı mı aşağı mı?” sorusuna yanıt üretmez. Bir işlem ajanı mevcut piyasa durumunu gözlemler, bir eylem seçer, piyasanın sonraki durumuna geçişini ve işlemin finansal sonucunu görür, ardından yeni karar verir. Dolayısıyla işlem süreci zaman içinde birbirine bağlı kararların oluşturduğu bir dizidir.
Bu yapı pekiştirmeli öğrenmenin temel problem tanımıyla uyumludur. Bir ajan çevreden bir durum \(s\) gözlemler, bir eylem \(a\) uygular, bir ödül \(r\) alır ve yeni duruma \(s'\) geçer. Öğrenmenin amacı yalnız mevcut işlemden elde edilen getiriyi değil, gelecekte oluşabilecek ödülleri de hesaba katan bir politika geliştirmektir.
Deep Q-Learning Nedir?
Deep Q-Learning, klasik Q-Learning'deki durum-eylem değer fonksiyonunu büyük bir tabloyla saklamak yerine bir derin sinir ağıyla yaklaşık olarak hesaplayan pekiştirmeli öğrenme yöntemidir; böylece fiyat, getiri, hacim ve piyasa mikro yapısı gibi çok boyutlu girdilerin oluşturduğu geniş durum uzaylarında farklı eylemlerin beklenen değerleri tahmin edilebilir.
Klasik tabular Q-Learning'de her durum-eylem çifti için ayrı bir değer saklanabilir. Fakat finansal piyasadaki bir durum; çok sayıda fiyat gözlemi, getiri, hareketli ortalama, volatilite göstergesi, hacim ve bid-ask spread gibi değişkenlerden oluştuğunda olası durumların sayısı son derece büyür. Deep Q-Learning bu ölçek sorununu sinir ağı tabanlı fonksiyon yaklaşımıyla ele alır.
Q-Learning güncellemesi
Kaynakta temel Q-Learning güncellemesi şu şekilde verilmektedir:
\[ Q(s,a) \leftarrow Q(s,a) + \alpha \left[ r+\gamma\max_{a'}Q(s',a')-Q(s,a) \right] \]
Bu denklemde \(Q(s,a)\), \(s\) durumunda \(a\) eyleminin beklenen toplam değerini temsil eder. \(r\), eylemden sonra gözlenen anlık ödüldür. \(s'\), işlemden sonra oluşan yeni durumdur. \(\max_{a'}Q(s',a')\), yeni durumda mevcut eylemler arasındaki en yüksek tahmini gelecek değeri gösterir.
\(\alpha\) öğrenme oranıdır ve yeni gözlemin mevcut Q-değerini ne ölçüde değiştireceğini belirler. \(\gamma\) iskonto katsayısıdır; değer 1'e yaklaştıkça gelecekteki ödüllere verilen ağırlık artar, 0'a yaklaştıkça yakın dönem ödülü daha baskın hale gelir.
Denklemde köşeli parantez içindeki fark, mevcut Q tahmini ile gözlenen ödül ve geleceğe ilişkin tahminin oluşturduğu hedef arasındaki hatadır. Öğrenme süreci bu hatayı kullanarak değer tahminlerini tekrar tekrar düzeltir.
Sinir ağı Q-değerini nasıl yaklaşıklar?
Deep Q-Learning'de Q-değerleri ayrı hücrelerden oluşan bir tabloda saklanmaz. Kaynak aşağıdaki genel yaklaşımı verir:
\[ Q(s,a;\theta)=f(s;\theta) \]
\(\theta\), sinir ağının öğrenilen parametrelerini; \(s\), piyasayı temsil eden giriş durumunu; \(f\), sinir ağının gerçekleştirdiği fonksiyon dönüşümünü ifade eder. Ağın çıktısı, kullanılabilir eylemler için tahmini Q-değerlerinden oluşan bir vektördür.
Örneğin eylem uzayı satın al, bekle ve sat olarak tanımlanmışsa ağ aynı piyasa durumunda bu üç eylem için üç farklı değer tahmini üretebilir. Karar politikası bu tahminleri kullanarak eylem seçer.
Hedef ağ neden kullanılır?
Deep Q-Learning'de öğrenilen ağ hem mevcut tahmini hem de kendi öğrenme hedefini sürekli aynı anda değiştirirse eğitim kararsız hale gelebilir. Kaynak bu sorunu azaltmak için periyodik olarak güncellenen ayrı bir target network kullanılması yaklaşımını açıklar.
Kayıp fonksiyonu kaynakta şu biçimde verilmektedir:
\[ L(\theta)= E\left[ \left( r+\gamma\max_{a'}Q(s',a';\theta^-) -Q(s,a;\theta) \right)^2 \right] \]
Burada \(\theta\) güncel Q-ağının, \(\theta^-\) ise hedef ağın parametreleridir. \(Q(s,a;\theta)\) mevcut ağın tahminidir; \(r+\gamma\max Q(s',a';\theta^-)\) ise eğitimin hedefini oluşturur. Kare farkın beklenen değeri küçültülerek mevcut ağın hedef Q-değerlerine yaklaşması amaçlanır.
Hedef ağın her adımda ana ağla aynı anda değiştirilmemesi, öğrenme hedefinin kısa süreler boyunca daha kararlı kalmasını sağlar. Kaynak bunu Q-Learning eğitimindeki salınım ve sapma riskini azaltan mekanizmalardan biri olarak sunmaktadır.
Experience Replay Neden Kullanılır?
Experience replay, ajanın ardışık piyasa gözlemlerini doğrudan aynı sırayla öğrenmek yerine \((s,a,r,s')\) deneyimlerini bir replay buffer içinde saklayıp eğitim sırasında bu bellekten rastgele mini-batch'ler seçmesini sağlayarak ardışık örnekler arasındaki güçlü korelasyonu azaltmayı ve geçmiş deneyimlerin tekrar kullanılmasını amaçlar.
Finansal zaman serilerinde birbirini izleyen gözlemler çoğu zaman yüksek derecede ilişkilidir. Sinir ağının yalnız son birkaç ardışık gözlemle eğitilmesi, öğrenmenin dar bir piyasa rejimine aşırı bağımlı hale gelmesine yol açabilir. Replay buffer daha farklı dönemlerden örnekleri aynı eğitim grubunda bir araya getirerek örnek çeşitliliğini artırır.
Kaynak mini-batch güncellemesini kavramsal olarak şu biçimde ifade eder:
\[ \Delta\theta = E_{(s,a,r,s')\sim U(D)} \left[ \nabla_\theta \left( r+\gamma\max_{a'}Q(s',a';\theta^-) -Q(s,a;\theta) \right)^2 \right] \]
\(D\) replay buffer'ı, \(U(D)\) bu bellekten uniform örneklemeyi, \(\Delta\theta\) ise ağ parametrelerinin eğitim sırasında değişimini ifade eder.
HFT için durum vektörü
Kaynağın önerdiği HFT durum tanımı üç ana bilgi grubuna dayanır: son fiyat hareketleri ve getiriler, teknik göstergeler ve piyasa mikro yapısı değişkenleri. Genel durum vektörü şu şekilde gösterilir:
\[ s=[p_1,p_2,\ldots,p_n,i_1,i_2,\ldots,i_m,v,b] \]
Burada \(p\) fiyat hareketlerini, \(i\) teknik göstergeleri, \(v\) işlem hacmini ve \(b\) bid-ask spread'i temsil eder. Kaynak teknik gösterge örnekleri olarak hareketli ortalamalar, Bollinger Bands ve Relative Strength Index'i (RSI) anmaktadır.
Bu ifade kesin bir veri şeması değildir. Makale kaç fiyat gecikmesi kullanılacağını, hangi göstergelerin seçileceğini, verinin hangi zaman çözünürlüğünde örnekleneceğini veya girdilerin nasıl normalize edileceğini belirtmemektedir.
Eylem uzayı
Kaynak üç temel eylem tanımlar:
- Buy: fiyat artışı beklentisiyle varlık satın almak.
- Hold: yeni işlem açmadan mevcut pozisyonu korumak.
- Sell: pozisyonu azaltmak veya kapatmak.
Gerçek bir HFT sisteminde emir türü, fiyat seviyesi, miktar, iptal kararı ve kuyruk konumu gibi daha ayrıntılı eylemler gerekebilir. Ancak kaynak bu daha geniş execution düzeyini modellememektedir.
Ödül fonksiyonu
Makale işlem kâr veya zararını temel ödül bileşeni olarak ele almakta ve yalnız ham kârın yüksek risk alan politikaları teşvik edebileceğine dikkat çekmektedir. Risk ayarlı ödül kavramsal olarak:
\[ r = \frac{\text{Beklenen Getiri}} {\text{Getirilerin Standart Sapması}} \]
biçiminde sunulmuştur. Bu oran Sharpe tipi risk-ayarlı performans fikrine yakındır. Ancak kaynak gerçek bir eğitim deneyinde bu ödülün hangi zaman penceresinde, hangi risksiz getiri varsayımıyla veya hangi ölçekleme yöntemiyle hesaplandığını belirtmemektedir.
İstatistiksel arbitraj ile bağlantı
İstatistiksel arbitraj, ilişkili finansal araçlar veya fiyat süreçleri arasındaki geçici göreli sapmaların istatistiksel yöntemlerle saptanıp bunların normalleşeceği beklentisi üzerine işlem üretmeye dayanır. Deep Q-Learning perspektifinde ajan, yalnız sabit bir giriş-çıkış eşiği kullanmak yerine piyasa durumundan ve geçmiş ödüllerden öğrenerek eylem politikasını uyarlamaya çalışır.
Bu uyarlanabilirlik teorik olarak rejim değişikliklerine tepki verme avantajı sunabilir. Bununla birlikte finansal piyasaların non-stationary olması, geçmişte öğrenilmiş Q-değerlerinin gelecekte geçerliliğini garanti etmez. Yeni piyasa rejimleri replay buffer içindeki eski deneyimlerle çelişebilir ve ödül dağılımı zaman içinde değişebilir.
Çalışmanın Yöntemi ve Bulguları
Kaynakta tanımlanan yöntemsel bileşenler
| Bileşen | Kaynakta tanımlanan rol | Kaynakta eksik kalan uygulama ayrıntısı |
|---|---|---|
| Durum \(s\) | Fiyat, getiri, teknik gösterge, hacim ve bid-ask spread gibi piyasa bilgilerini temsil eder. | Zaman çözünürlüğü, pencere boyutu, normalizasyon ve kesin özellik seti verilmemiştir. |
| Eylem \(a\) | Buy, Hold ve Sell kararları. | Emir miktarı, limit/market emir ayrımı ve execution ayrıntıları verilmemiştir. |
| Ödül \(r\) | Kâr/zarar veya risk ayarlı getiri. | Gerçek uygulamada kullanılan kesin ödül fonksiyonu ve parametreleri verilmemiştir. |
| Q-Learning | Bellman tabanlı değer güncellemesiyle uzun dönem ödülü öğrenir. | \(\alpha\) ve \(\gamma\) için gerçek deney değerleri raporlanmamıştır. |
| Q-network | Yüksek boyutlu durumdan eylem Q-değerlerini tahmin eder. | Katman sayısı, nöron sayısı, aktivasyon fonksiyonları ve optimizer verilmemiştir. |
| Target network | Öğrenme hedefini daha kararlı tutmak için ayrı Q-tahmini sağlar. | Güncelleme sıklığı açıklanmamıştır. |
| Replay buffer | Geçmiş deneyimleri saklar ve rastgele mini-batch eğitimine olanak verir. | Buffer kapasitesi, batch size ve sampling ayrıntıları raporlanmamıştır. |
| Kayıp fonksiyonu | Mevcut Q tahmini ile hedef Q arasındaki karesel farkı azaltır. | Eğitim süresi, convergence ölçütü ve öğrenme eğrileri verilmemiştir. |
Makale Deep Q-Learning'in HFT'de Daha Kârlı Olduğunu Kanıtlıyor mu?
Hayır; kaynak özetinde simülasyon ve backtestlerin adaptasyon, kârlılık ve risk ayarlı getiriler açısından olumlu sonuç verdiği ileri sürülse de makalenin gövdesinde bu iddiayı bağımsız olarak değerlendirmeyi sağlayacak veri seti, backtest dönemi, benchmark, PnL, Sharpe oranı, drawdown, işlem maliyeti veya istatistiksel anlamlılık sonuçları raporlanmamaktadır.
Bu ayrım çalışmanın yorumlanmasında merkezî öneme sahiptir. Kaynak Deep Q-Learning'in HFT istatistiksel arbitrajına nasıl uyarlanabileceğini açıklamakta ve yöntemin potansiyel avantajlarını tartışmaktadır. Fakat mevcut PDF, yöntemin belirli piyasa verileri üzerinde belirli bir benchmark'ı nicel olarak geçtiğini gösterecek yeniden üretilebilir ampirik kanıt sağlamamaktadır.
Özet ile gövde arasındaki kanıt farkı
Özet “extensive simulations and backtests” ifadesini kullanmakta ve kârlılık metrikleri ile risk ayarlı getirilerde iyileşme bulunduğunu belirtmektedir. Buna karşılık kaynak gövdesinde ayrı bir veri, deney, sonuç veya backtest bölümü bulunmaz. Sayısal getiri serisi, performans tablosu veya model karşılaştırması verilmemiştir.
Bu nedenle Verianla açısından güvenli bilimsel ifade şudur: çalışma Deep Q-Learning'i HFT istatistiksel arbitrajı için kavramsal olarak gerekçelendirmekte ve uygulanabilir bir mimari önermektedir; ancak bu PDF'nin sunduğu kanıt düzeyi yöntemin gerçek ekonomik üstünlüğünü nicel olarak doğrulamak için yeterli değildir.
Yeniden üretilebilirlik açısından eksikler
- Kullanılan finansal piyasa veya varlık evreni belirtilmemiştir.
- Tick, trade veya limit-order-book veri kaynağı verilmemiştir.
- Train, validation ve test dönemleri raporlanmamıştır.
- Out-of-sample değerlendirme protokolü verilmemiştir.
- Q-network mimarisi belirtilmemiştir.
- Learning rate, discount factor, batch size ve replay-buffer kapasitesi verilmemiştir.
- Epsilon-greedy veya başka bir exploration politikasının parametreleri belirtilmemiştir.
- Target network güncelleme sıklığı verilmemiştir.
- İşlem komisyonları, bid-ask maliyeti, slippage ve market impact modellenmemiştir.
- Latency veya işlem altyapısı maliyeti raporlanmamıştır.
- Karşılaştırma benchmark'ları verilmemiştir.
- Sharpe ratio, maximum drawdown, turnover veya PnL serisi raporlanmamıştır.
Çalışmanın desteklediği sonuç
Kaynak, Deep Q-Learning'in yüksek boyutlu piyasa durumlarını sinir ağıyla temsil etmek, eylem değerlerini Q-Learning ilkesiyle güncellemek, replay buffer aracılığıyla geçmiş deneyimlerden tekrar öğrenmek ve target network ile eğitim hedefini stabilize etmek için mantıksal bir HFT çerçevesi sunduğunu desteklemektedir.
Çalışmanın desteklemediği sonuç
Kaynak; bu mimarinin belirli bir borsa, varlık, işlem dönemi veya gerçek zamanlı HFT altyapısında istatistiksel olarak üstün getiri sağladığını, işlem maliyetlerinden sonra kârlı kaldığını ya da klasik istatistiksel arbitraj yöntemlerinden daha iyi olduğunu nicel olarak göstermemektedir.
Kaynak ve Yöntem Notu
Özgün çalışma: Harnessing Deep Q-Learning for Enhanced Statistical Arbitrage in High-Frequency Trading: A Comprehensive Exploration.
Yazar: Soumyadip Sarkar.
Kaynak: arXiv:2311.10718v1, q-fin.TR.
Tarih: 13 Eylül 2023.
Kalıcı tanımlayıcı: 10.48550/ARXIV.2311.10718.
Kaynak türü: arXiv preprint; kaynakta hakemli dergi/konferans yayın bilgisi verilmemektedir.
Kurumsal afiliyasyon: Kaynak PDF'de yazar için kurumsal afiliyasyon belirtilmemiş, yalnız iletişim e-posta adresi verilmiştir.
Lisans: İncelenen PDF ve bibliyografik kayıtlarda belirli bir açık lisans doğrulanmadığından Verianla metni kaynak ifadesini yeniden yayımlamak yerine bilimsel kavramları bağımsız öğretici yapıda açıklamaktadır.
Veri erişilebilirliği: Kaynak belirli bir veri seti veya veri deposu tanımlamamaktadır.
Finansman ve çıkar çatışması: PDF'de açık finansman veya çıkar çatışması bildirimi yer almamaktadır.
Temel yöntemsel sınırlılık: Kaynakta Deep Q-Learning'in matematiksel ve kavramsal bileşenleri açıklansa da ampirik uygulamanın yeniden oluşturulması için gereken veri, hiperparametre, eğitim düzeni ve performans sonuçları sunulmamıştır.
Finansal yorum sınırı: Bu Verianla içeriği bir işlem stratejisi önerisi veya yatırım tavsiyesi değildir; kaynak çalışmanın yöntemsel yapısını ve kanıt sınırlarını açıklayan bilimsel eğitim metnidir.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir