

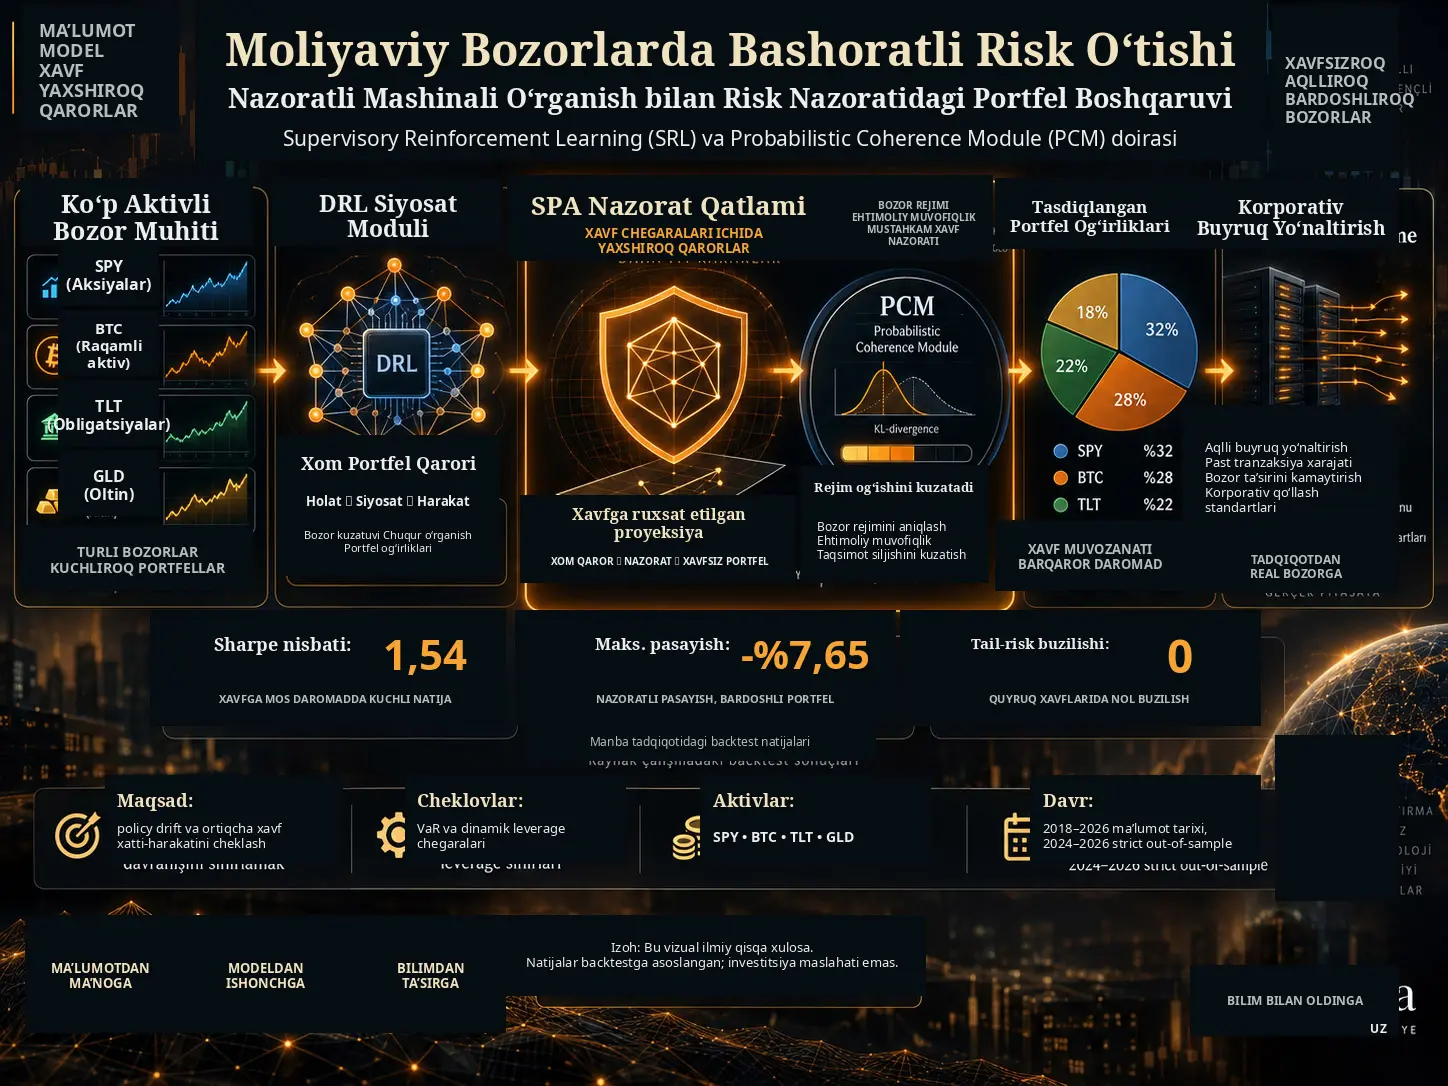
Moliyaviy bozorlarda Deep Reinforcement Learning (DRL) o‘tmish ma’lumotlaridan qat’iy portfel qoidalarini o‘rganish o‘rniga, o‘zgarib turuvchi bozor holatlariga qarab uzluksiz ravishda og‘irliklar ishlab chiqaradigan modellarni yaratish imkonini beradi. Biroq bu moslashuvchanlik bir vaqtning o‘zida xavf ham tug‘diradi: model o‘qitish davrida yetarlicha ko‘rmagan bozor rejimiga duch kelganda haddan tashqari jamlangan yoki risk chegaralaridan chiqib ketadigan portfellarni yaratishi mumkin. Stephen Muli Kithimbaning tadqiqoti bu muammoni DRL modelining qaror ishlab chiqish qobiliyatini yo‘qotmasdan, uning oldiga alohida matematik risk nazoratchisini qo‘yish orqali hal etishni maqsad qilgan Supervisory Reinforcement Learning (SRL) doirasini ta’riflaydi.
SRL markazidagi Supervisory Projection Architecture (SPA) DRL modeli ishlab chiqargan xom portfel og‘irligini to‘g‘ridan-to‘g‘ri bozorga yuborish o‘rniga, uni ruxsat etilgan risk hududidagi eng yaqin portfelga proyeksiya qiladi. Bu hudud leverage va Value-at-Risk (VaR) kabi cheklovlar bilan belgilanadi. Unga qo‘shilgan Probabilistic Coherence Module (PCM) esa joriy bozor taqsimotining tayanch rejimdan qanchalik uzoqlashganini Kullback–Leibler divergence orqali kuzatadi; bozor tuzilishidagi og‘ish belgilangan chegaradan oshganda risk limitlarini toraytirib, portfelni himoyaviyroq holatga o‘tkazishni maqsad qiladi.
Manbada SPY, BTC, TLT va GLD yordamida o‘tkazilgan tarixiy va sintetik sinovlarda to‘liq SRL+PCM arxitekturasi uchun Sharpe koeffitsiyenti 1,54, yillik volatillik %11,14 va maksimal drawdown -%7,65 deb qayd etilgan. SAC bilan taqqoslashda Sharpe 0,75 va maksimal drawdown -%39,54 bo‘lgan. Biroq bu raqamlar tarixiy backtest va simulyatsiya natijalaridir; ular jonli savdo natijasi yoki kelajakda olinadigan daromad kafolati emas.
DRL Portfellarida “Policy Drift” Nima?
Tadqiqotda policy drift DRL modelining o‘qitish jarayonida o‘rgangan holat–harakat munosabatlari bozor taqsimoti o‘zgarganda ishonchliligini yo‘qotishi va odatiy sharoitda ishlab chiqarmaydigan darajada agressiv portfel qarorlarini hosil qilishi sifatida ko‘rib chiqiladi.
Moliyaviy bozorlar statsionar tizimlar emas. Volatillik, likvidlik, korrelyatsiya, foiz muhiti va bozor mikrostrukturasi vaqt o‘tishi bilan o‘zgarishi mumkin. Shu sababli o‘tmish ma’lumotlarida yaxshi ishlagan siyosat boshqa rejimda out-of-distribution holatlarga duch kelishi mumkin.
DRL nuqtai nazaridan asosiy muammo shundaki, model bu yangi holatlarda ham harakat ishlab chiqarishi kerak. Neural network holat fazosining o‘qitish davrida yetarlicha ifodalanmagan qismida ham matematik ravishda portfel og‘irligini hisoblay oladi; biroq hisoblangan harakat iqtisodiy yoki risk nuqtai nazaridan ishonchli bo‘lishiga kafolat yo‘q.
Manba ayniqsa uchta xavfga e’tibor qaratadi:
- aktivlarning haddan tashqari konsentratsiyasi,
- gross leverage ortishi,
- tail-risk chegaralarining kech aniqlanishi.
Shu sababli tadqiqot “model risk chegaralarini o‘qitish jarayonida o‘rganishini kutish” bilan “model nima ishlab chiqarmasin, buyruqdan oldin uni matematik risk filtridan o‘tkazish” o‘rtasida farq qiladi.
Soft risk jazosi va hard risk cheklovi o‘rtasidagi farq
An’anaviy riskga sezgir reinforcement learning tizimlarida VaR, drawdown yoki leverage kabi risk o‘lchovlari reward function ichiga jazo atamasi sifatida qo‘shilishi mumkin. Bunday yondashuvda model risk chegarasini buzsa, pastroq reward olib, vaqt o‘tishi bilan bunday qilmaslikni o‘rganishga harakat qiladi.
Kithimba taklif qilgan arxitekturada esa risk chegarasi faqat reward ichida ifodalanmaydi. Model ishlab chiqargan portfel harakati tranzaksiyadan oldin matematik ravishda ruxsat etilgan to‘plamga ko‘chiriladi.
Shu tariqa ikki alohida funksiya yuzaga keladi:
| Qatlam | Asosiy vazifa |
|---|---|
| DRL Policy Engine | Daromad/alpha imkoniyatlarini izlab, maqsadli portfel og‘irliklarini ishlab chiqarish |
| Supervisory Layer | Ishlab chiqarilgan og‘irlikning institutsional risk chegaralaridan oshib ketishini oldini olish |
Nazorat Qatlami Xom Portfel Qarorini Qanday O‘zgartiradi?
Modelning asosiy amali convex projection muammosidir. DRL tarmog‘i avval xom maqsadli taqsimotni ishlab chiqaradi:
\[ a_t=\pi_\theta(s_t) \]
Bu yerda \(s_t\) bozorning kuzatilgan holatini, \(\pi_\theta\) DRL siyosatini, \(a_t\) esa model xohlagan xom portfel og‘irliklarini anglatadi.
Nazorat qatlami keyin bu vektorni ruxsat etilgan risk to‘plamiga proyeksiya qiladi:
\[ w_t^*=\Pi_{\Omega_t}(a_t) \]
Bu yerdagi \(\Omega_t\), \(t\) vaqtda qabul qilinadigan portfellardan tashkil topgan risk hududidir.
Proyeksiya muammosi manbaning asosiy mantiqiga ko‘ra:
\[ w_t^* = \arg\min_{w\in\Omega_t} \frac{1}{2}\|w-a_t\|_2^2 \]
ko‘rinishidadir.
Boshqacha aytganda, tizim DRL modelining fikrini butunlay yo‘q qilish o‘rniga, risk qoidalariga javob beradigan portfellar orasidan xom qarorga Evklid masofasi bo‘yicha eng yaqin taqsimotni qidiradi.
Risk hududi doimiy emas
Tadqiqotda ruxsat etilgan to‘plam:
\[ \Omega_t=f(C_t,\Sigma_t,L_t) \]
ko‘rinishida ta’riflanadi.
Bu yerda:
- \(C_t\): bozorning tayanch taqsimotdan uzoqligini o‘lchaydigan coherence ko‘rsatkichi,
- \(\Sigma_t\): joriy covariance/regime matritsasi,
- \(L_t\): dinamik leverage chegarasi.
Shuning uchun risk nazoratchisi faqat “portfelda BTC ko‘pi bilan shuncha bo‘lsin” kabi qat’iy qoida emas. Bozor rejimi o‘zgargan sari ruxsat etilgan portfel geometriyasi ham o‘zgarishi ko‘zda tutiladi.
Leverage chegarasi
Manbada qo‘llanilgan asosiy cheklovlardan biri:
\[ \sum_{i=1}^{N}|w_i| \leq L_{\max}(s_t) \]
ko‘rinishidadir. Bu ifoda portfelning jami gross exposure darajasini cheklaydi.
Value-at-Risk chegarasi
Ikkinchi markaziy cheklov:
\[ z_{1-\alpha}\sqrt{w^T\Sigma_t w} \leq VaR_{\max} \]
ko‘rinishidadir.
Manbaning algoritm misolida %95 darajasiga mos keladigan \(z=1.645\) qiymati ishlatiladi.
Bu tuzilma model kutilayotgan daromad nuqtai nazaridan jozibador deb bilgan portfelni, covariance matritsasi bildirgan risk belgilangan VaR chegarasidan oshsa, kichraytirish imkonini beradi.
Probabilistic Coherence Module Bozor Rejimi O‘zgarganini Qanday Aniqlaydi?
PCM joriy bozor xususiyatlarining tayanch deb qabul qilingan taqsimotdan qanchalik uzoqlashganini Kullback–Leibler divergence bilan o‘lchashni maqsad qiladi.
Manbada joriy bozor:
\[ p_t\sim\mathcal{N}(\mu_t,\Sigma_t) \]
va tayanch rejim:
\[ q_0\sim\mathcal{N}(\mu_0,\Sigma_0) \]
tarzida modellashtirilgan.
Coherence metrikasi:
\[ C_t=D_{KL}(p_t\parallel q_0) \]
asosida yaratiladi.
Ikki ko‘p o‘zgaruvchili Gaussian taqsimoti uchun manba determinant, trace va o‘rtacha qiymat farqlarini o‘z ichiga olgan yopiq shakldagi KL ifodasidan foydalanadi.
Chegara oshib ketganda nima bo‘ladi?
Manbaning 9-sahifasidagi 2-rasmda \(C_t\) vaqt bo‘yicha kuzatiladi va \(\tau_c\) deb nomlangan breach threshold bilan taqqoslanadi. \(C_t\) chegaradan yuqoriga chiqqanda supervisor pastroq risk tolerantligiga o‘tadi. :contentReference[oaicite:12]{index=12}
Bu mexanizm tadqiqotda dynamic leverage braking deb ataladi. Maqsad bozor taqsimotidagi o‘zgarish DRL modelining qayta o‘rganishini kutmasdan pozitsiya chegaralarini toraytirishdir.
Covariance yangilanishi
Tadqiqotda covariance tuzilmasi order-book imbalance xususiyatlaridan foydalanib exponential smoothing orqali yangilanadi:
\[ \Sigma_t = (1-\lambda)\Sigma_{t-1} + \lambda(\Phi_t\Phi_t^T) \]
va namunaviy qo‘llanmada:
\[ \lambda=0.05 \]
ishlatiladi.
\(\Phi_t\) joriy limit-order-book imbalance vektorini anglatadi.
Konveks Proyeksiyaning Matematik Kafolati Nima?
Manbaning asosiy nazariy natijasi shuki, risk to‘plami \(\Omega_t\) bo‘sh bo‘lmagan, yopiq va konveks bo‘lib qolgan taqdirda orthogonal projection operatori non-expansive bo‘ladi.
Ikki xom harakat \(a\) va \(b\) uchun:
\[ \|\Pi_{\Omega_t}(a)-\Pi_{\Omega_t}(b)\|_2 \leq \|a-b\|_2 \]
hosil bo‘ladi.
Buning ma’nosi shuki, supervisor ikki DRL qarori orasidagi masofani kattalashtirmaydi. Proyeksiya xom siyosatdagi o‘zgarishni undan kattaroq portfel o‘zgarishiga aylantira olmaydi.
Tadqiqot buni ketma-ket network update-lariga ham kengaytirib, projected operational update-ning conditional variance-i underlying network parameter step bilan chegaralanganini ko‘rsatadi.
Bu natija muhim bo‘lsa-da, to‘g‘ri talqin qilinishi kerak: matematik kafolat portfel zarar ko‘rmasligini kafolatlamaydi. Kafolat proyeksiya operatorining ko‘rsatilgan konveks to‘plam va matematik farazlar ostidagi geometrik xatti-harakatiga taalluqlidir.
Tadqiqot Usuli va Natijalari
Aktivlar to‘plami
| Ticker | Ifodalaydigan aktiv sinfi |
|---|---|
| SPY | AQSh aksiyalari |
| BTC | Raqamli aktiv |
| TLT | Uzoq muddatli AQSh G‘aznachilik obligatsiyalari / qat’iy daromad |
| GLD | Oltin / qattiq xomashyo |
Vaqt bo‘linishi
Manbaning tajriba protokoli uch blokka bo‘lingan:
| Davr | Vazifa |
|---|---|
| Yanvar 2018 – Dekabr 2022 | In-sample training |
| Yanvar 2023 – Dekabr 2023 | Hyperparameter validation |
| Yanvar 2024 – Mart 2026 | Strict out-of-sample walk-forward test |
Shuning uchun tadqiqot ma’lumotlari 2018-yilgacha cho‘zilsa-da, belgilangan strict out-of-sample sinov davri 2024–Mart 2026 hisoblanadi.
Tranzaksiya xarajati
Backtestlarda round-turn uchun 5 bazis punkt tranzaksiya xarajati qo‘llanilgan. Manba shuningdek doimiy seed=42 ishlatilganini bildiradi.
Taqqoslangan modellar
- LSTM Portfolio
- A2C
- PPO
- Unconstrained SAC
- Taklif qilingan SRL + PCM
Daromad qatorining ekonometrik tekshiruvlari
Manba backtestdan oldin turli statistik testlarni qayd etadi.
ADF: Barcha test tickerlarida unit-root null gipotezasi %1 darajada rad etilgani bildiriladi.
Ljung–Box: Manba \(Q=48.2,\ p<0.01\) ni qayd etib, return qatorlarida qoldiq avtokorrelyatsiya mavjudligini aytadi.
ARCH-LM: \(p<0.01\) natijasi volatillik klasterlanishining dalili sifatida talqin qilinadi.
Jarque–Bera: Normal taqsimot rad etiladi. Manba SPY uchun kurtosis 5,82, BTC uchun 14,21 ni bildiradi.
Manbada qayd etilgan natijalar
| Model | Yillik daromad | Yillik volatillik | Sharpe | Sortino | Maks. drawdown | Tail-risk breach |
|---|---|---|---|---|---|---|
| LSTM Portfolio | %9,14 | %13,10 | 0,50 | 0,62 | -%18,40 | 14 |
| A2C | %11,42 | %16,50 | 0,54 | 0,68 | -%24,50 | 22 |
| PPO | %14,85 | %19,12 | 0,64 | 0,81 | -%29,10 | 31 |
| SAC | %19,82 | %26,41 | 0,75 | 0,94 | -%39,54 | 51 |
| SRL + PCM | %17,21 | %11,14 | 1,54 | 2,08 | -%7,65 | 0 |
Jadval muhim farqni ko‘rsatadi: taklif etilgan model manbada eng yuqori nominal yillik daromadni bermaydi. SAC uchun %19,82, SRL+PCM uchun %17,21 qayd etilgan. Taklif etilgan arxitekturaning da’vo qilinayotgan ustunligi pastroq volatillik va drawdown tufayli yuqoriroq riskga moslashtirilgan natijadir.
Sharpe ishonch oraliqlari
Manbada SRL+PCM uchun Sharpe:
1,54 [1,41–1,67]
deb berilgan. Boshqa modellar uchun:
- SAC: 0,75 [0,61–0,89]
- PPO: 0,64 [0,53–0,75]
- A2C: 0,54 [0,45–0,63]
- LSTM: 0,50 [0,42–0,58]
Manba bu baholashni 5.000 block-bootstrap iteratsiyasi bilan bog‘laydi.
Ablation tahlili nimani ko‘rsatadi?
Manbaning ablation jadvalida risk qatlamlari bosqichma-bosqich qo‘shiladi:
| Konfiguratsiya | Sharpe | O‘sish | Manbada qayd etilgan drawdown kamayishi | Cohen's d |
|---|---|---|---|---|
| Unconstrained DRL | 0,75 | — | Tayanch | 0,00 |
| Faqat SPA | 1,12 | +0,37 | %64,1 | 0,68 |
| SRL + PCM | 1,54 | +0,42 | %80,6 | 1,15 |
Bu natijalar tadqiqotning backtest dizaynida risk nazoratining natijalar farqidagi rolini ajratishga urinadi. Biroq ablation natijalari baribir ayni tadqiqot muhitiga taalluqli va boshqa bozor, xarajat yoki hyperparameter tuzilmalarida ayni miqdordagi ta’sirni kafolatlamaydi.
Q3 2022 aralashuv misollari
Manbaning III-jadvali supervisor xom portfel taqsimotlarini qanday o‘zgartirganiga doir uch misol keltiradi.
- 15 Iyul 2022, SPY: taklif qilingan +0,65 og‘irlik qabul qilinadigan hududda qolganligi uchun +0,65 holicha o‘tkazilgan.
- 19 Avgust 2022, BTC: +0,85 xom og‘irlik risk chegarasida kesilib +0,52 gacha tushirilgan.
- 13 Sentyabr 2022, SPY: +0,95 xom og‘irlik coherence breach dan so‘ng +0,15 gacha tushirilgan.
Manba oxirgi hodisa uchun %4,3 lik mahalliy bozor pasayishidan qochilganini bildiradi. Bu tadqiqotning simulyatsiya qilingan/backtest aralashuv misoli bo‘lib, jonli investitsiya hisobida tasdiqlangan operatsiya emas.
Tizimning Eng Muhim Cheklovlari Nimalar?
1. Optimallashtirish kechikishi
DRL modelining forward pass jarayoni tez bo‘lishi mumkin; biroq undan keyin ishlaydigan iterative convex optimizer qo‘shimcha kechikish hosil qiladi. Manba past o‘lchamli \(N=4\) tizimda 1,2–4,5 ms, \(N=100\) darajasida esa 15–40 ms oralig‘ida solver latency ni qayd etadi.
Muallif shu sababli mavjud arxitektura sub-second high-frequency execution dan ko‘ra bir necha soatlik yoki kunlik qayta muvozanatlash uchun mosroq ekanini ta’kidlaydi.
2. Konveks bo‘lmagan qoidalar
Matematik kafolat risk hududining yopiq va konveks bo‘lishiga bog‘liq. Biroq haqiqiy portfellarda:
- minimal lot hajmi,
- binary concentration qoidalari,
- step-function transaction costs
kabi diskret shartlar bo‘lishi mumkin.
Bular feasible set ni non-convex qilganda oddiy quadratic projection endi ayni matematik kafolatni bermaydi. Manba bunday holatlarda Mixed-Integer Non-Linear Programming kabi murakkabroq usullar kerak bo‘lishi mumkinligini bildiradi.
3. Juda tez rejim buzilishlarida o‘lchov kechikishi
PCM bozor o‘zgarishini darhol “biladigan” tizim emas. Yangi order-book kuzatuvlari to‘plangan sari divergence ni o‘lchaydi. Manba flash crash singari hodisalarda taxminan 2–5 soniyalik inference lag yuzaga kelishi va shu vaqt davomida baseline risk parametrlari amal qilishini qayd etadi.
4. Pseudo-code va chop etilgan Python kodi o‘rtasidagi farq
Tadqiqotning Algorithm 1 bo‘limida:
\[ \sum_i w_i=1 \]
ko‘rinishidagi fully-invested sharti aniq mavjud.
Bunga qarshi 18–19-sahifalarda berilgan SupervisoryProjectionArchitecture klassining project_action() funksiyasi bu equality constraint ni optimizer ga qo‘shmaydi. Kod faqat:
- gross leverage chegarasi,
- VaR chegarasi,
- \(0\leq w_i\leq1\) bounds
ni qo‘llaydi.
Shunday qilib, maqoladagi algoritmik tavsif bilan chop etilgan executable blueprint aynan bir xil feasible portfolio set ni to‘liq belgilamaydi. Qayta ishlab chiqarish tadqiqotida bu farqni bartaraf etish kerak.
5. Backtest va real bozor qo‘llanmasi bir xil narsa emas
Manbadagi natijalar tarixiy ma’lumotlar, belgilangan transaction cost modeli va sintetik perturbation ssenariylari asosida hisoblangan. Slippage, bozor ta’siri, ma’lumot kechikishi, sig‘im limiti, broker xatti-harakati va modelni yangilash xatolari jonli muhitda boshqacha bo‘lishi mumkin.
Kelajakdagi tadqiqot yo‘nalishlari
Muallif uchta asosiy rivojlantirish yo‘nalishini belgilaydi:
Differentiable optimization: convex solver ni Cvxpylayers yoki OptNet turidagi tuzilmalar bilan bevosita neural network computation graph ichiga kiritish.
Meta-supervisor: non-convex va diskret risk qoidalari uchun ikkinchi DRL agentidan yuqori darajadagi nazoratchi sifatida foydalanish.
Multi-Agent Reinforcement Learning: aksiyalar, fixed-income, digital asset va turli mintaqaviy portfel agentlarini markazlashtirilgan supervisor ostida birlashtirish.
Tadqiqot qo‘llab-quvvatlaydigan natijalar
- Yopiq va konveks risk to‘plamiga orthogonal projection non-expansive operator sifatida ta’riflanishi mumkin.
- DRL harakati va riskni qo‘llash matematik jihatdan alohida qatlamlarga ajratilishi mumkin.
- Manbaning sinov muhitida SRL+PCM taqqoslangan modellarga qaraganda yuqoriroq Sharpe va pastroq maksimal drawdown bergan.
- PCM qo‘shilishi manbada SPA-only tuzilmasiga nisbatan qo‘shimcha riskga moslashtirilgan natija oshishi bilan bog‘langan.
- Dinamik bozor og‘ishini KL divergence asosidagi trigger orqali risk chegaralariga bog‘lash hisoblab bo‘ladigan supervisory mexanizmni taqdim etadi.
Tadqiqot qo‘llab-quvvatlamaydigan natijalar
- SRL+PCM barcha bozor davrlarida yoki barcha portfellarda ustun ekanini isbotlamaydi.
- Sharpe 1,54 qiymati kelajakda saqlanishini ko‘rsatmaydi.
- “0 breach” natijasi real bozorlarda hech qanday risk chegarasi buzilmasligini kafolatlamaydi.
- Konveks proyeksiya kapital yo‘qotilishini matematik ravishda yo‘q qilmaydi.
- Backtest natijalari jonli investitsiya natijalariga teng emas.
- Tadqiqot SPY, BTC, TLT yoki GLD uchun investitsiya tavsiyasi ishlab chiqarmaydi.
Manba va Usul Haqida Izoh
To‘liq asl sarlavha:A Supervisory Machine Learning Framework for Predictive Risk Switching in Financial Markets
Muallif: Stephen Muli Kithimba.
Institutsional tavsif: Independent Researcher, Financial Technology (FinTech), Chicago, Illinois, USA.
Yozilgan sana: 15 Mart 2026.
SSRN: 20 sahifalik preprint; Iyun 2026.
DOI: 10.2139/ssrn.6830019. Alohida versiyada Zenodo DOI: 10.5281/zenodo.20389884.
Taqriz holati: SSRN working paper / preprint. Ko‘rib chiqilgan yozuv taqrizli jurnal nashri emas.
Mualliflik huquqi: SSRN yozuvi All Rights Reserved sifatida ko‘rsatilgan.
Manfaatlar to‘qnashuvi: SSRN yozuviga ko‘ra bildirilmagan.
Moliyalashtirish: Muallif tadqiqot tashqi moliyalashtirishsiz mustaqil olib borilganini bildiradi.
Tadqiqot tuzilishi: Matematik SRL/SPA/PCM arxitekturasi, nazariy projection natijalari, to‘rt aktivli portfolio backtest, model taqqoslashlari, block-bootstrap va ablation tahlili.
Ma’lumot davri: Yanvar 2018–Mart 2026. Tajriba protokoliga ko‘ra strict out-of-sample davri Yanvar 2024–Mart 2026.
Aktivlar: SPY, BTC, TLT, GLD.
Benchmark modellar: LSTM Portfolio, A2C, PPO va SAC.
Manbada qayd etilgan SRL+PCM natijalari: yillik daromad %17,21; yillik volatillik %11,14; Sharpe 1,54; Sortino 2,08; maksimal drawdown -%7,65.
Muhim qayta ishlab chiqarish qaydi: Algorithm 1 da mavjud fully-invested equality constraint PDF oxiridagi Python implementatsiyasida yo‘q. Shu sababli chop etilgan kod va formal algoritm ayni optimallashtirish muammosini to‘liq tarzda ifodalamaydi.
Bibliografik ehtiyotkorlik: Manbalar ro‘yxatidagi ayrim yozuvlar ushbu tekshiruv vaqtida mustaqil nashriyot yozuvi bilan tasdiqlanmagani uchun Verianla bayonining asosiy ilmiy tayanchi sifatida ishlatilmagan.
Moliyaviy talqin chegarasi: Natijalar o‘tmish ma’lumotlari asosida olingan tadqiqot natijalaridir. Ular investitsiya tavsiyasi, kutilayotgan kelajak daromadi yoki kapital yo‘qotilishiga qarshi kafolat emas.
Izoh qoldiring
E-pochta manzilingiz chop etilmaydi. Majburiy maydonlar * bilan belgilangan