

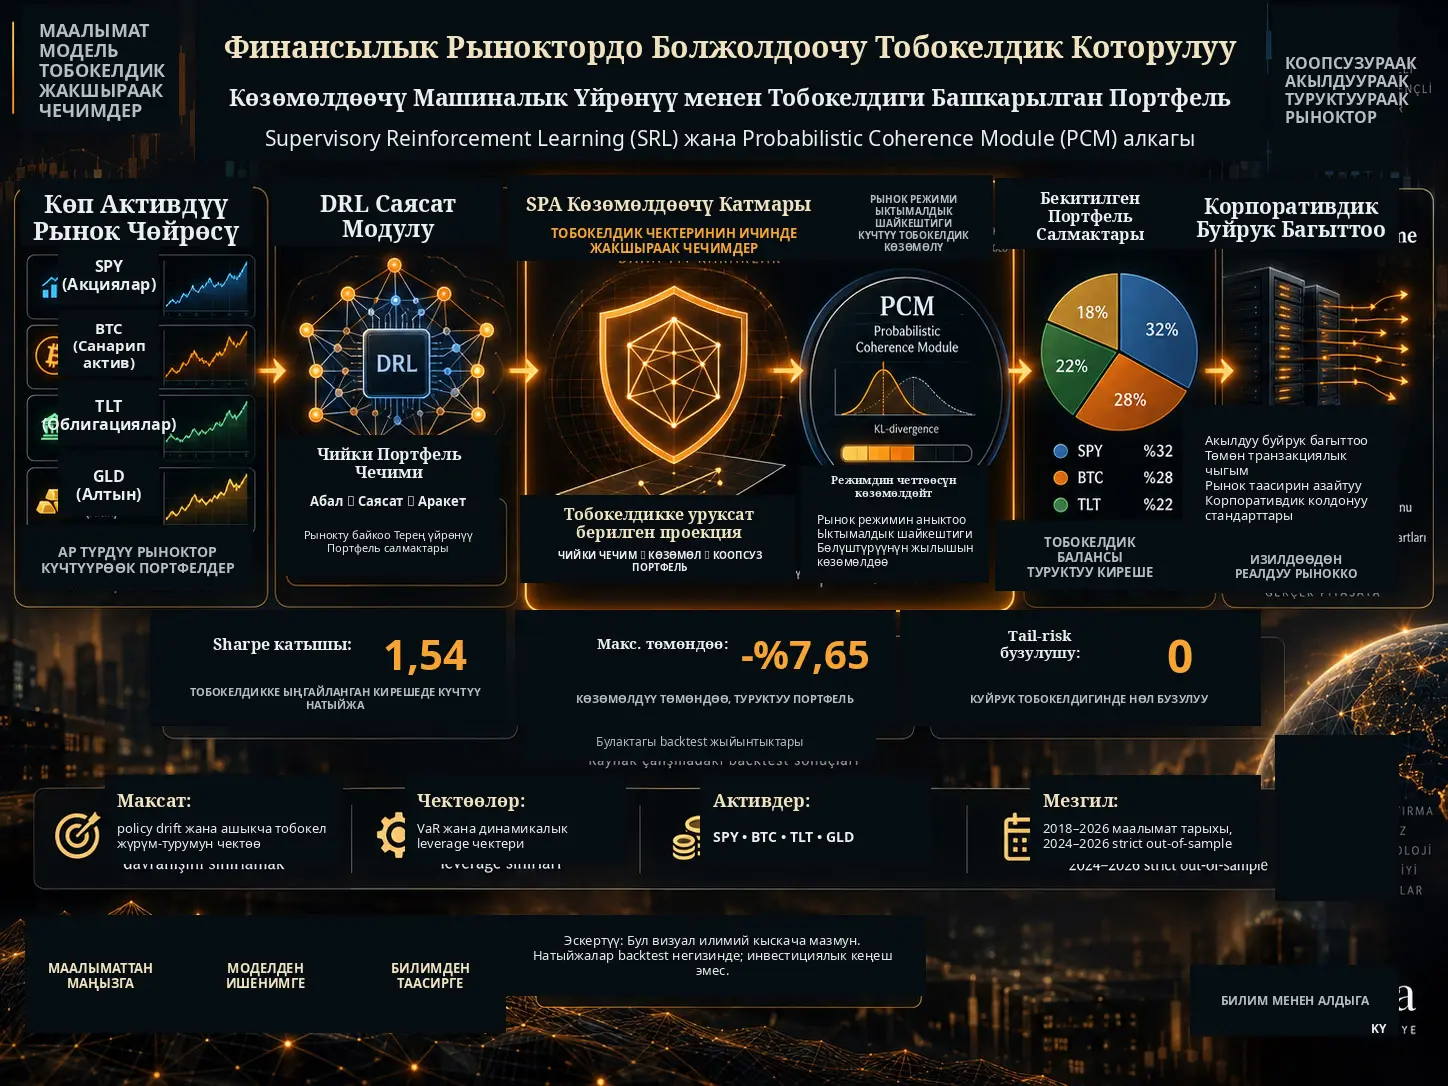
Финансылык рыноктордо Deep Reinforcement Learning (DRL) өткөн маалыматтардан туруктуу портфель эрежесин үйрөнүүнүн ордуна, өзгөрүп турган рынок абалдарына жараша үзгүлтүксүз салмактарды чыгара алган моделдерди түзүүгө мүмкүндүк берет. Бирок мындай ийкемдүүлүк ошол эле учурда тобокелдик жаратат: модель окутуу мезгилинде жетиштүү көрбөгөн рынок режимине туш болгондо ашыкча топтолгон же тобокелдик чектеринен чыгып кеткен портфелдерди түзүшү мүмкүн. Stephen Muli Kithimbaнын эмгеги бул көйгөйдү DRL моделинин чечим чыгаруу жөндөмүн жоготпостон, анын алдына өзүнчө математикалык тобокелдик көзөмөлчүсүн жайгаштыруу аркылуу чечүүгө багытталган Supervisory Reinforcement Learning (SRL) алкагын аныктайт.
SRLдин өзөгүндөгү Supervisory Projection Architecture (SPA) DRL модели чыгарган чийки портфель салмагын түздөн-түз рынокко жөнөтпөстөн, аны уруксат берилген тобокелдик аймагындагы эң жакын портфелге проекциялайт. Бул аймак leverage жана Value-at-Risk (VaR) сыяктуу чектөөлөр менен аныкталат. Ага кошулган Probabilistic Coherence Module (PCM) учурдагы рынок бөлүштүрүүсү таяныч режимден канчалык алыстаганын Kullback–Leibler divergence аркылуу көзөмөлдөйт; рынок түзүмүндөгү четтөө белгиленген босогодон өткөндө тобокелдик чектерин кыскартып, портфелди коргонуучу абалга өткөрүүнү максат кылат.
Булакта SPY, BTC, TLT жана GLD колдонулган тарыхый жана синтетикалык тесттерде толук SRL+PCM архитектурасы үчүн Sharpe катышы 1,54, жылдык волатилдүүлүк %11,14 жана максималдуу drawdown -%7,65 деп билдирилген. SAC менен салыштырганда Sharpe 0,75 жана максималдуу drawdown -%39,54 болгон. Бирок бул сандар тарыхый backtest жана симуляция жыйынтыктары; алар жандуу соодадагы көрсөткүч же келечектеги кирешеге кепилдик эмес.
DRL Портфелдериндеги “Policy Drift” Деген Эмне?
Изилдөөдө policy drift DRL модели окутуу учурунда үйрөнгөн абал–аракет байланыштары рынок бөлүштүрүүсү өзгөргөндө ишенимдүүлүгүн жоготуп, кадимки шарттарда чыгарбай тургандай агрессивдүү портфель чечимдерин түзүшү катары каралат.
Финансылык рыноктор туруктуу системалар эмес. Волатилдүүлүк, ликвиддүүлүк, корреляция, пайыздык чөйрө жана рынок микротүзүмү убакыттын өтүшү менен өзгөрүшү мүмкүн. Ошондуктан өткөн маалыматта жакшы иштеген саясат башка режимде out-of-distribution абалдарга туш болушу мүмкүн.
DRL жагынан негизги көйгөй — модель мындай жаңы абалдарда да аракет чыгарышы керек. Neural network абал мейкиндигинин окутуу учурунда жетиштүү көрсөтүлбөгөн бөлүгүндө да математикалык түрдө портфель салмагын эсептей алат; бирок эсептелген аракеттин экономикалык же тобокелдик жагынан ишенимдүү экенине кепилдик жок.
Булак өзгөчө үч коркунучка көңүл бурат:
- активдердин ашыкча топтолушу,
- gross leverage өсүшү,
- tail-risk чектеринин кеч аныкталышы.
Ошондуктан изилдөө “модель тобокелдик чектерин окутуу учурунда үйрөнсүн деп күтүү” менен “модель эмне чыгарбасын, буйрук берилерден мурун аны математикалык тобокелдик фильтринен өткөрүү” ортосунда айырма жүргүзөт.
Soft risk жазасы менен hard risk чектөөсүнүн айырмасы
Салттуу тобокелдикке сезимтал reinforcement learning системаларында VaR, drawdown же leverage сыяктуу тобокелдик көрсөткүчтөрү reward function ичине жаза мүчөсү катары кошулушу мүмкүн. Бул ыкмада модель тобокелдик чегин бузганда төмөнүрөөк reward алып, убакыттын өтүшү менен муну кылбоону үйрөнүүгө аракеттенет.
Kithimba сунуштаган архитектурада болсо тобокелдик чеги reward ичинде гана көрсөтүлбөйт. Модель чыгарган портфель аракети операциянын алдында математикалык жактан уруксат берилген көптүккө жылдырылат.
Ошентип эки өзүнчө функция пайда болот:
| Катмар | Негизги милдет |
|---|---|
| DRL Policy Engine | Киреше/alpha мүмкүнчүлүктөрүн изилдеп, максаттуу портфель салмактарын чыгаруу |
| Supervisory Layer | Чыгарылган салмактын институционалдык тобокелдик чектерин ашып кетишине жол бербөө |
Көзөмөлдөөчү Катмар Чийки Портфель Чечимин Кантип Өзгөртөт?
Моделдин негизги операциясы convex projection маселеси. DRL тармагы адегенде чийки максаттуу бөлүштүрүүнү чыгарат:
\[ a_t=\pi_\theta(s_t) \]
Бул жерде \(s_t\) рыноктун байкалган абалын, \(\pi_\theta\) DRL саясатын, \(a_t\) болсо модель каалаган чийки портфель салмактарын билдирет.
Андан кийин көзөмөлдөөчү катмар бул векторду уруксат берилген тобокелдик көптүгүнө проекциялайт:
\[ w_t^*=\Pi_{\Omega_t}(a_t) \]
Бул жердеги \(\Omega_t\) — \(t\) убактысында кабыл алынуучу портфелдер түзгөн тобокелдик аймагы.
Проекция маселеси булактын негизги логикасы боюнча:
\[ w_t^* = \arg\min_{w\in\Omega_t} \frac{1}{2}\|w-a_t\|_2^2 \]
түрүндө берилет.
Башкача айтканда, система DRL моделинин идеясын толугу менен жок кылбастан, тобокелдик эрежелерине жооп берген портфелдердин ичинен чийки чечимге Евклид аралыгы боюнча эң жакын бөлүштүрүүнү издейт.
Тобокелдик аймагы туруктуу эмес
Изилдөөдө уруксат берилген көптүк:
\[ \Omega_t=f(C_t,\Sigma_t,L_t) \]
деп аныкталат.
Бул жерде:
- \(C_t\): рыноктун таяныч бөлүштүрүүдөн алыстыгын өлчөгөн coherence көрсөткүчү,
- \(\Sigma_t\): учурдагы covariance/regime матрицасы,
- \(L_t\): динамикалык leverage чеги.
Демек тобокелдик көзөмөлчүсү “портфелде BTC мындан ашпасын” деген сыяктуу гана туруктуу эреже эмес. Рынок режими өзгөргөн сайын уруксат берилген портфель геометриясы да өзгөрүшү көздөлөт.
Leverage чеги
Булакта колдонулган негизги чектөөлөрдүн бири:
\[ \sum_{i=1}^{N}|w_i| \leq L_{\max}(s_t) \]
түрүндө. Бул туюнтма портфелдин жалпы gross exposure деңгээлин чектейт.
Value-at-Risk чеги
Экинчи борбордук чектөө:
\[ z_{1-\alpha}\sqrt{w^T\Sigma_t w} \leq VaR_{\max} \]
түрүндө.
Булактын алгоритм мисалында %95 деңгээлине туура келген \(z=1.645\) мааниси колдонулат.
Бул түзүм модель күтүлгөн киреше жагынан жагымдуу деп эсептеген портфелди covariance матрицасы көрсөткөн тобокелдик белгиленген VaR чегинен ашса, кичирейтүүгө мүмкүндүк берет.
Probabilistic Coherence Module Рынок Режиминин Өзгөргөнүн Кантип Түшүнөт?
PCM учурдагы рынок өзгөчөлүктөрү таяныч деп кабыл алынган бөлүштүрүүдөн канчалык алыстаганын Kullback–Leibler divergence менен өлчөөнү көздөйт.
Булакта учурдагы рынок:
\[ p_t\sim\mathcal{N}(\mu_t,\Sigma_t) \]
жана таяныч режим:
\[ q_0\sim\mathcal{N}(\mu_0,\Sigma_0) \]
деп моделденет.
Coherence метрикасы:
\[ C_t=D_{KL}(p_t\parallel q_0) \]
аркылуу түзүлөт.
Эки көп өзгөрмөлүү Gaussian бөлүштүрүүсү үчүн булак determinant, trace жана орточо маанилердин айырмаларын камтыган жабык формадагы KL туюнтмасын колдонот.
Босого ашса эмне болот?
Булактын 9-бетиндеги 2-сүрөттө \(C_t\) убакыт боюнча көзөмөлдөнүп, \(\tau_c\) деп аталган breach threshold менен салыштырылат. \(C_t\) босогодон жогору чыкканда supervisor төмөнүрөөк тобокелдик толеранттуулугуна өтөт. :contentReference[oaicite:12]{index=12}
Бул механизм изилдөөдө dynamic leverage braking деп аталат. Максат — рынок бөлүштүрүүсүндөгү өзгөрүү DRL моделинин кайра үйрөнүшүн күтпөстөн позиция чектерин кыскартуу.
Covariance жаңыртуусу
Изилдөөдө covariance түзүмү order-book imbalance өзгөчөлүктөрүн колдонуп exponential smoothing аркылуу жаңыртылат:
\[ \Sigma_t = (1-\lambda)\Sigma_{t-1} + \lambda(\Phi_t\Phi_t^T) \]
жана мисал колдонмодо:
\[ \lambda=0.05 \]
колдонулат.
\(\Phi_t\) учурдагы limit-order-book imbalance векторун билдирет.
Конвекс Проекциянын Математикалык Кепилдиги Эмне?
Булактын негизги теориялык жыйынтыгы — тобокелдик көптүгү \(\Omega_t\) бош эмес, жабык жана конвекс бойдон калса, orthogonal projection оператору non-expansive болот.
Эки чийки аракет \(a\) жана \(b\) үчүн:
\[ \|\Pi_{\Omega_t}(a)-\Pi_{\Omega_t}(b)\|_2 \leq \|a-b\|_2 \]
алынат.
Мунун мааниси — supervisor эки DRL чечиминин ортосундагы аралыкты чоңойтпойт. Проекция чийки саясаттагы өзгөрүүнү андан чоң портфель өзгөрүүсүнө айландыра албайт.
Изилдөө муну ырааттуу network update-терге да кеңейтип, projected operational updateтин conditional varianceсы underlying network parameter step менен чектелерин көрсөтөт.
Бул жыйынтык маанилүү болгону менен туура чечмелениши керек: математикалык кепилдик портфель зыян тартпайт деген кепилдик эмес. Кепилдик проекция операторунун көрсөтүлгөн конвекс көптүк жана математикалык божомолдор астындагы геометриялык жүрүм-турумуна байланыштуу.
Изилдөөнүн Ыкмасы жана Жыйынтыктары
Активдер ааламы
| Ticker | Өкүлү болгон актив классы |
|---|---|
| SPY | АКШ акциялары |
| BTC | Санарип актив |
| TLT | Узак мөөнөттүү АКШ Казыналык облигациялары / туруктуу киреше |
| GLD | Алтын / катуу товар |
Убакыт бөлүштүрүүсү
Булактын эксперимент протоколу үч блокко бөлүнөт:
| Мезгил | Функция |
|---|---|
| Январь 2018 – Декабрь 2022 | In-sample training |
| Январь 2023 – Декабрь 2023 | Hyperparameter validation |
| Январь 2024 – Март 2026 | Strict out-of-sample walk-forward test |
Ошондуктан изилдөөнүн маалымат тарыхы 2018-жылга чейин созулганына карабастан, аныкталган strict out-of-sample тест мезгили 2024–Март 2026 болуп саналат.
Операциялык чыгым
Backtestтерде round-turn үчүн 5 базистик пункт операциялык чыгым колдонулган. Булак ошондой эле туруктуу seed=42 колдонгонун билдирет.
Салыштырылган моделдер
- LSTM Portfolio
- A2C
- PPO
- Unconstrained SAC
- Сунушталган SRL + PCM
Киреше катарларынын эконометрикалык текшерүүлөрү
Булак backtestке чейин бир нече статистикалык тесттерди берет.
ADF: Бардык тест tickerлеринде unit-root null гипотезасы %1 деңгээлде четке кагылганы билдирилет.
Ljung–Box: Булак \(Q=48.2,\ p<0.01\) деп билдирип, return катарларында калган автокорреляция бар экенин айтат.
ARCH-LM: \(p<0.01\) жыйынтыгы волатилдүүлүк топтолушунун далили катары чечмеленет.
Jarque–Bera: Нормалдуу бөлүштүрүү четке кагылат. Булак SPY үчүн kurtosis 5,82, BTC үчүн 14,21 деп билдирет.
Булакта билдирилген көрсөткүчтөр
| Модель | Жылдык киреше | Жылдык волатилдүүлүк | Sharpe | Sortino | Макс. drawdown | Tail-risk breach |
|---|---|---|---|---|---|---|
| LSTM Portfolio | %9,14 | %13,10 | 0,50 | 0,62 | -%18,40 | 14 |
| A2C | %11,42 | %16,50 | 0,54 | 0,68 | -%24,50 | 22 |
| PPO | %14,85 | %19,12 | 0,64 | 0,81 | -%29,10 | 31 |
| SAC | %19,82 | %26,41 | 0,75 | 0,94 | -%39,54 | 51 |
| SRL + PCM | %17,21 | %11,14 | 1,54 | 2,08 | -%7,65 | 0 |
Таблица маанилүү айырманы көрсөтөт: сунушталган модель булакта эң жогорку номиналдык жылдык кирешени бербейт. SAC үчүн %19,82, SRL+PCM үчүн %17,21 деп билдирилген. Сунушталган архитектуранын айтылган артыкчылыгы төмөнүрөөк волатилдүүлүк жана drawdown аркылуу жогорураак тобокелдикке ылайыкташтырылган көрсөткүч болуп саналат.
Sharpe ишеним интервалдары
Булакта SRL+PCM үчүн Sharpe:
1,54 [1,41–1,67]
деп берилет. Башка моделдер үчүн:
- SAC: 0,75 [0,61–0,89]
- PPO: 0,64 [0,53–0,75]
- A2C: 0,54 [0,45–0,63]
- LSTM: 0,50 [0,42–0,58]
Булак бул баалоону 5.000 block-bootstrap итерациясы менен байланыштырат.
Ablation анализи эмнени көрсөтөт?
Булактын ablation таблицасында тобокелдик катмарлары этап-этабы менен кошулат:
| Конфигурация | Sharpe | Өсүш | Булакта билдирилген drawdown азайышы | Cohen's d |
|---|---|---|---|---|
| Unconstrained DRL | 0,75 | — | Таяныч | 0,00 |
| SPA гана | 1,12 | +0,37 | %64,1 | 0,68 |
| SRL + PCM | 1,54 | +0,42 | %80,6 | 1,15 |
Бул жыйынтыктар изилдөөнүн backtest дизайнында тобокелдик көзөмөлүнүн көрсөткүч айырмасындагы ролун бөлүп көрсөтүүгө аракет кылат. Бирок ablation жыйынтыктары ошол эле изилдөө чөйрөсүнө таандык жана башка рынок, чыгым же hyperparameter түзүмдөрүндө ошол эле өлчөмдөгү таасирге кепилдик бербейт.
Q3 2022 кийлигишүү мисалдары
Булактын III таблицасы supervisor чийки портфель бөлүштүрүүлөрүн кантип өзгөрткөнүн көрсөткөн үч мисал берет.
- 15 Июль 2022, SPY: сунушталган +0,65 салмак кабыл алынуучу аймакта калгандыктан +0,65 бойдон өткөрүлгөн.
- 19 Август 2022, BTC: +0,85 чийки салмак тобокелдик чегинде кесилип +0,52ге түшүрүлгөн.
- 13 Сентябрь 2022, SPY: +0,95 чийки салмак coherence breach болгондон кийин +0,15ке түшүрүлгөн.
Булак акыркы окуяда %4,3 жергиликтүү рынок төмөндөшүнөн качылганын билдирет. Бул изилдөөнүн симуляцияланган/backtest кийлигишүү мисалы; жандуу инвестиция эсебинде тастыкталган операция эмес.
Системанын Эң Маанилүү Чектөөлөрү Кайсылар?
1. Оптималдаштыруу кечигүүсү
DRL моделинин forward pass'и тез болушу мүмкүн; бирок андан кийин иштеген iterative convex optimizer кошумча кечигүү жаратат. Булак төмөн өлчөмдүү \(N=4\) системада 1,2–4,5 ms, \(N=100\) деңгээлинде 15–40 ms аралыгында solver latency билдирет.
Автор ушул себептен азыркы архитектура sub-second high-frequency executionга караганда бир нече сааттык же күнүмдүк кайра тең салмактоо үчүн ылайыгыраак экенин айтат.
2. Конвекс эмес эрежелер
Математикалык кепилдик тобокелдик аймагынын жабык жана конвекс болушуна көз каранды. Бирок реалдуу портфелдерде:
- минималдуу lot өлчөмү,
- binary concentration эрежелери,
- step-function transaction costs
сыяктуу дискреттик шарттар болушу мүмкүн.
Бул шарттар feasible setти non-convex кылганда жөнөкөй quadratic projection мурдагыдай математикалык кепилдикти бербейт. Булак мындай учурларда Mixed-Integer Non-Linear Programming сыяктуу татаалыраак ыкмалар керек болушу мүмкүн экенин белгилейт.
3. Өтө тез режим үзүлүүлөрүндө өлчөө кечигүүсү
PCM рынок өзгөрүшүн дароо “билген” система эмес. Жаңы order-book байкоолору топтолгон сайын divergence өлчөйт. Булак flash crash сыяктуу окуяларда болжол менен 2–5 секунддук inference lag пайда болушу мүмкүн экенин жана ушул убакытта baseline risk параметрлери күчүндө каларын белгилейт.
4. Pseudo-code менен басылган Python кодунун айырмасы
Изилдөөнүн Algorithm 1 бөлүмүндө:
\[ \sum_i w_i=1 \]
түрүндөгү fully-invested шарты ачык көрсөтүлгөн.
Ал эми 18–19-беттерде берилген SupervisoryProjectionArchitecture классынын project_action() функциясы бул equality constraintти optimizerге кошпойт. Код болгону:
- gross leverage чегин,
- VaR чегин,
- \(0\leq w_i\leq1\) bounds
колдонот.
Демек макаладагы алгоритмдик сүрөттөмө менен басылган executable blueprint так эле бир feasible portfolio setти толук аныктабайт. Кайра өндүрүү изилдөөсүндө бул айырма жоюлушу керек.
5. Backtest менен реалдуу рынок колдонмосу бир нерсе эмес
Булактын көрсөткүч жыйынтыктары тарыхый маалыматтар, белгиленген transaction cost модели жана синтетикалык perturbation сценарийлери боюнча эсептелген. Slippage, рынок таасири, маалымат кечигүүсү, сыйымдуулук чеги, брокердин жүрүм-туруму жана модель жаңыртуу каталары жандуу чөйрөдө башкача болушу мүмкүн.
Келечектеги изилдөө багыттары
Автор үч негизги өнүктүрүү багытын аныктайт:
Differentiable optimization: convex solverди Cvxpylayers же OptNet түрүндөгү түзүмдөр менен түздөн-түз neural network computation graph ичине киргизүү.
Meta-supervisor: non-convex жана дискреттик тобокелдик эрежелери үчүн экинчи DRL агентин жогорку деңгээлдеги көзөмөлчү катары колдонуу.
Multi-Agent Reinforcement Learning: акция, fixed-income, digital asset жана ар түрдүү аймактык портфель агенттерин борборлоштурулган supervisor астында бириктирүү.
Изилдөө колдогон жыйынтыктар
- Жабык жана конвекс тобокелдик көптүгүнө orthogonal projection non-expansive оператор катары аныкталышы мүмкүн.
- DRL аракети менен тобокелдикти колдонуу математикалык жактан өзүнчө катмарларга бөлүнүшү мүмкүн.
- Булактын тест чөйрөсүндө SRL+PCM салыштырылган моделдерге караганда жогорураак Sharpe жана төмөнүрөөк максималдуу drawdown берген.
- PCM кошулушу булакта SPA-only түзүмүнө салыштырмалуу кошумча тобокелдикке ылайыкташтырылган көрсөткүч өсүшү менен байланышкан.
- Динамикалык рынок четтөөсүн KL divergence негизиндеги trigger аркылуу тобокелдик чектерине байланыштыруу эсептелүүчү supervisory механизмди сунуштайт.
Изилдөө колдобогон жыйынтыктар
- SRL+PCM бардык рынок мезгилдеринде же бардык портфелдерде артык экенин далилдебейт.
- Sharpe 1,54 мааниси келечекте сакталарына кепилдик бербейт.
- “0 breach” жыйынтыгы реалдуу рыноктордо эч бир тобокелдик чеги бузулбайт деген кепилдик эмес.
- Конвекс проекция капитал жоготуусун математикалык жактан жок кылбайт.
- Backtest жыйынтыктары жандуу инвестиция көрсөткүчүнө барабар эмес.
- Изилдөө SPY, BTC, TLT же GLD боюнча инвестициялык кеңеш бербейт.
Булак жана Ыкма Жөнүндө Эскертүү
Толук оригинал аталышы:A Supervisory Machine Learning Framework for Predictive Risk Switching in Financial Markets
Автор: Stephen Muli Kithimba.
Институционалдык аныктама: Independent Researcher, Financial Technology (FinTech), Chicago, Illinois, USA.
Жазылган күнү: 15 Март 2026.
SSRN: 20 беттик preprint; Июнь 2026.
DOI: 10.2139/ssrn.6830019. Өзүнчө версиясында Zenodo DOI: 10.5281/zenodo.20389884.
Рецензия статусу: SSRN working paper / preprint. Каралган жазуу рецензияланган журнал басылмасы эмес.
Автордук укук: SSRN жазуусу All Rights Reserved катары көрсөтүлгөн.
Кызыкчылыктардын кагылышы: SSRN жазуусуна ылайык билдирилген эмес.
Каржылоо: Автор изилдөө тышкы каржылоосуз өз алдынча жүргүзүлгөнүн билдирет.
Изилдөө түзүмү: Математикалык SRL/SPA/PCM архитектурасы, теориялык projection жыйынтыктары, төрт активдүү portfolio backtest, модель салыштыруулары, block-bootstrap жана ablation анализи.
Маалымат мезгили: Январь 2018–Март 2026. Эксперимент протоколуна ылайык strict out-of-sample мезгили Январь 2024–Март 2026.
Активдер: SPY, BTC, TLT, GLD.
Benchmark моделдер: LSTM Portfolio, A2C, PPO жана SAC.
Булакта билдирилген SRL+PCM көрсөткүчү: жылдык киреше %17,21; жылдык волатилдүүлүк %11,14; Sharpe 1,54; Sortino 2,08; максималдуу drawdown -%7,65.
Критикалык кайра өндүрүү эскертүүсү: Algorithm 1де бар fully-invested equality constraint PDFнин аягындагы Python implementациясында жок. Ошондуктан басылган код менен формалдуу алгоритм бир эле оптималдаштыруу маселесин толук чагылдырбайт.
Библиографиялык этияттык: Булак тизмесиндеги айрым жазуулар бул текшерүүдө көз карандысыз басма жазуусу менен ырасталбагандыктан Verianla түшүндүрмөсүнүн негизги илимий таянычы катары колдонулган эмес.
Финансылык чечмелөө чеги: Жыйынтыктар өткөн маалыматтарда түзүлгөн изилдөө жыйынтыктары. Алар инвестициялык кеңеш, күтүлгөн келечектеги киреше же капитал жоготуусуна каршы кепилдик эмес.
Пикир калтырыңыз
E-mail дарегиңиз жарыяланбайт. Милдеттүү талаалар * менен белгиленген