

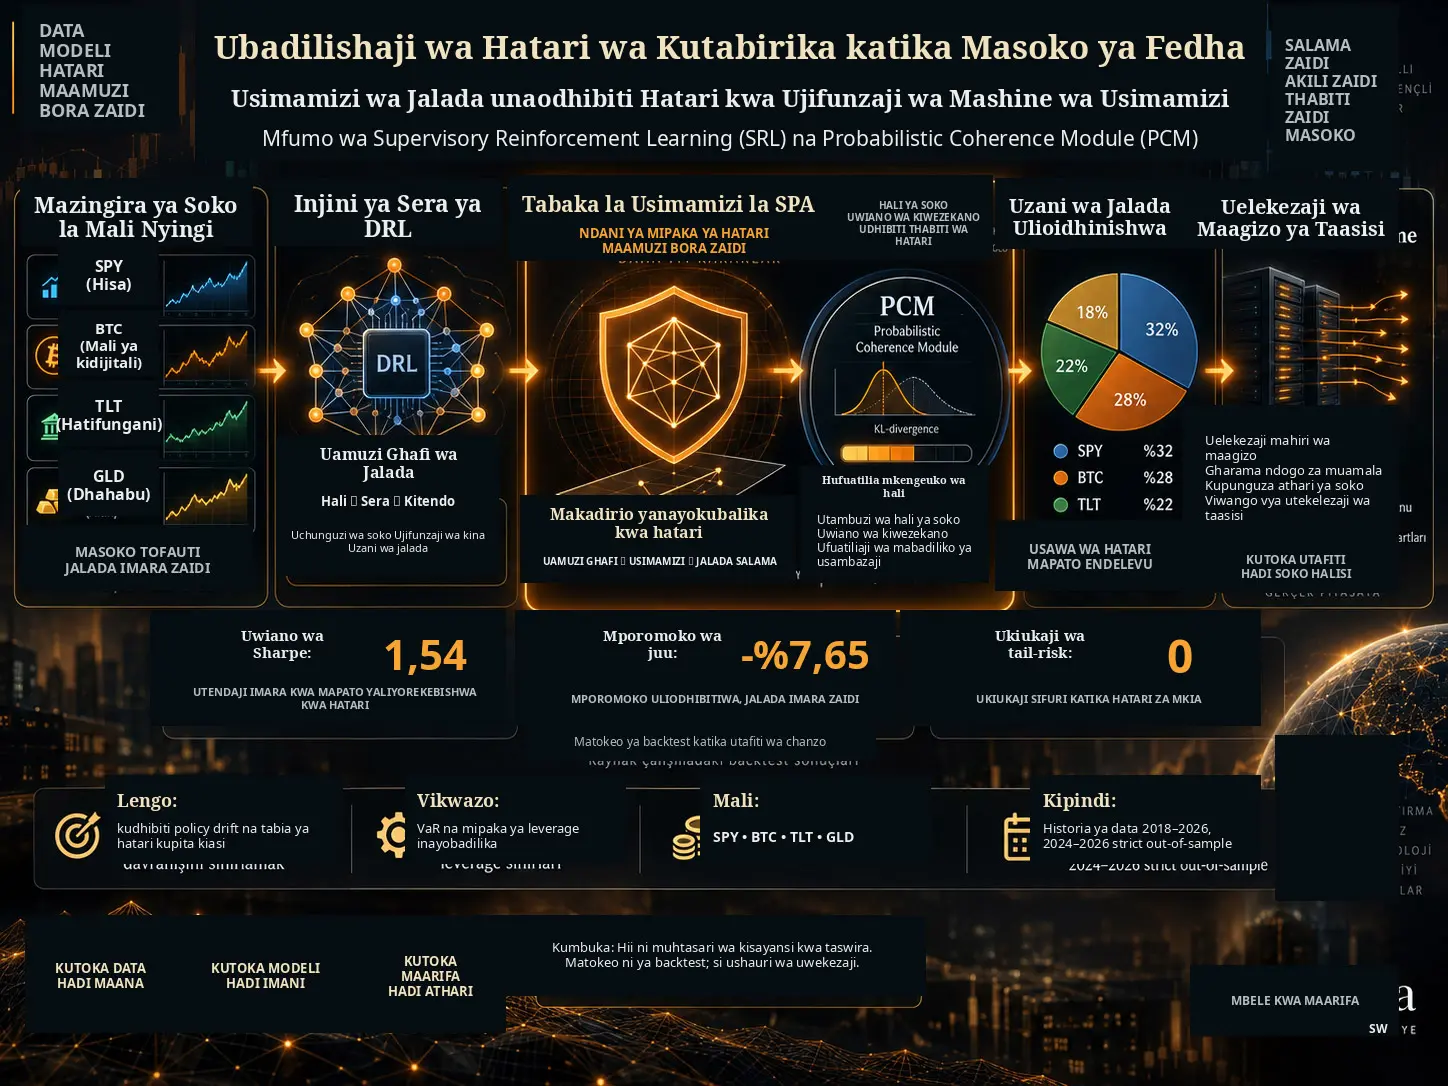
Katika masoko ya fedha, Deep Reinforcement Learning (DRL) huwezesha uundaji wa modeli zinazoweza kuzalisha uzani wa jalada kwa mfululizo kulingana na hali za soko zinazobadilika, badala ya kujifunza kanuni moja thabiti ya jalada kutoka katika data ya zamani. Hata hivyo, unyumbufu huu pia huleta hatari: modeli inapokutana na utawala wa soko ambao haukuwakilishwa vya kutosha katika kipindi cha mafunzo, inaweza kuzalisha majalada yenye mkusanyiko mkubwa kupita kiasi au yanayozidi mipaka ya hatari. Utafiti wa Stephen Muli Kithimba unafafanua mfumo wa Supervisory Reinforcement Learning (SRL) unaolenga kutatua tatizo hili kwa kuweka msimamizi tofauti wa kihisabati wa hatari mbele ya maamuzi ya modeli ya DRL bila kuondoa uwezo wa modeli yenyewe wa kutoa maamuzi.
Supervisory Projection Architecture (SPA), iliyo katikati ya SRL, haitumi uzani ghafi wa jalada unaozalishwa na modeli ya DRL moja kwa moja sokoni; badala yake, huuprojekta kwenda kwenye jalada la karibu zaidi ndani ya eneo la hatari linaloruhusiwa. Eneo hili hufafanuliwa na vizuizi kama leverage na Value-at-Risk (VaR). Probabilistic Coherence Module (PCM) inayoongezwa juu yake hufuatilia kwa kutumia Kullback–Leibler divergence ni kwa kiasi gani usambazaji wa sasa wa soko umejitenga na utawala wa marejeo; inapobainika kwamba mkengeuko wa muundo wa soko umevuka kizingiti kilichowekwa, hulenga kubana mipaka ya hatari ili kufanya jalada liwe la kujihami zaidi.
Katika chanzo, majaribio ya kihistoria na ya sintetiki yaliyotumia SPY, BTC, TLT na GLD yaliripoti kwa usanifu kamili wa SRL+PCM uwiano wa Sharpe wa 1,54, volatility ya mwaka ya %11,14 na maximum drawdown ya -%7,65. Katika ulinganisho na SAC, Sharpe ilikuwa 0,75 na maximum drawdown -%39,54. Hata hivyo, takwimu hizi ni matokeo ya backtest ya kihistoria na uigaji; si utendaji wa biashara ya moja kwa moja wala dhamana ya mapato yatakayopatikana siku zijazo.
“Policy Drift” katika Majalada ya DRL ni Nini?
Katika utafiti, policy drift inachukuliwa kuwa hali ambapo uhusiano wa hali–kitendo uliojifunzwa na modeli ya DRL wakati wa mafunzo unapoteza uaminifu wake usambazaji wa soko unapobadilika, na modeli inaanza kutoa maamuzi ya jalada yenye ukali zaidi kuliko yale ambayo ingetengeneza katika hali za kawaida.
Masoko ya fedha si mifumo tuli. Volatility, liquidity, correlation, mazingira ya viwango vya riba na muundo mdogo wa soko vinaweza kubadilika kadiri muda unavyopita. Kwa hiyo, sera inayofanya kazi vizuri kwenye data ya zamani inaweza kukutana na hali za out-of-distribution katika utawala tofauti.
Kwa upande wa DRL, tatizo kuu ni kwamba modeli bado inalazimika kutoa kitendo katika hali hizi mpya. Neural network inaweza kuhesabu kihisabati uzani wa jalada hata katika sehemu ya nafasi ya hali ambayo haikuwakilishwa vya kutosha wakati wa mafunzo; lakini hakuna dhamana kwamba kitendo hicho kilichohesabiwa ni cha kuaminika kiuchumi au kwa upande wa hatari.
Chanzo kinaangazia hasa hatari tatu:
- mkusanyiko mkubwa kupita kiasi wa mali,
- kuongezeka kwa gross leverage,
- kuchelewa kutambuliwa kwa mipaka ya tail-risk.
Kwa hiyo, utafiti unatofautisha kati ya “kusubiri modeli ijifunze mipaka ya hatari wakati wa mafunzo” na “bila kujali modeli inazalisha nini, kuipitisha kwanza kwenye kichujio cha kihisabati cha hatari kabla ya agizo.”
Tofauti kati ya adhabu ya soft risk na kizuizi cha hard risk
Katika mifumo ya kawaida ya reinforcement learning inayozingatia hatari, vipimo vya hatari kama VaR, drawdown au leverage vinaweza kuongezwa kwenye reward function kama kipengele cha adhabu. Katika mbinu hii, modeli inapokiuka mpaka wa hatari hupokea reward ya chini na hujaribu kujifunza kutoifanya tena kadiri muda unavyopita.
Katika usanifu unaopendekezwa na Kithimba, mpaka wa hatari hauwakilishwi ndani ya reward pekee. Kitendo cha jalada kinachozalishwa na modeli huhamishwa, kabla ya muamala, kwenda kwenye seti inayoruhusiwa kihisabati.
Hivyo, kazi mbili tofauti hutokea:
| Tabaka | Kazi kuu |
|---|---|
| DRL Policy Engine | Kuchunguza fursa za mapato/alpha na kuzalisha uzani lengwa wa jalada |
| Supervisory Layer | Kuzuia uzani unaozalishwa usivuke mipaka ya hatari ya taasisi |
Tabaka la Usimamizi Linabadilishaje Uamuzi Ghafi wa Jalada?
Operesheni ya msingi ya modeli ni tatizo la convex projection. Mtandao wa DRL kwanza huzalisha mgao ghafi unaolengwa:
\[ a_t=\pi_\theta(s_t) \]
Hapa \(s_t\) inawakilisha hali ya soko iliyozingatiwa, \(\pi_\theta\) sera ya DRL, na \(a_t\) uzani ghafi wa jalada unaotakiwa na modeli.
Kisha tabaka la usimamizi huiprojekta vekta hii kwenye seti ya hatari inayoruhusiwa:
\[ w_t^*=\Pi_{\Omega_t}(a_t) \]
Hapa \(\Omega_t\) ni eneo la hatari linaloundwa na majalada yanayokubalika katika wakati \(t\).
Tatizo la projection, kwa mantiki ya msingi ya chanzo, ni:
\[ w_t^* = \arg\min_{w\in\Omega_t} \frac{1}{2}\|w-a_t\|_2^2 \]
ni hivyo.
Kwa maneno mengine, badala ya kufuta kabisa wazo la modeli ya DRL, mfumo hutafuta kati ya majalada yanayotimiza sheria za hatari mgao ulio karibu zaidi na uamuzi ghafi kwa umbali wa Euclidean.
Eneo la hatari si la kudumu
Katika utafiti, seti inayoruhusiwa hufafanuliwa kama:
\[ \Omega_t=f(C_t,\Sigma_t,L_t) \]
hufafanuliwa hivyo.
Hapa:
- \(C_t\): kiashiria cha coherence kinachopima umbali wa soko kutoka kwenye usambazaji wa marejeo,
- \(\Sigma_t\): matrix ya sasa ya covariance/regime,
- \(L_t\): mpaka wa dinamik wa leverage.
Kwa hiyo, msimamizi wa hatari si sheria ya kudumu tu kama “BTC isiwe zaidi ya kiasi fulani katika jalada.” Lengo ni kwamba jiometri ya majalada yanayoruhusiwa nayo ibadilike kadiri utawala wa soko unavyobadilika.
Mpaka wa leverage
Moja ya vizuizi vya msingi vinavyotumiwa katika chanzo ni:
\[ \sum_{i=1}^{N}|w_i| \leq L_{\max}(s_t) \]
Usemi huu huweka kikomo kwenye kiwango cha jumla cha gross exposure cha jalada.
Mpaka wa Value-at-Risk
Kizuizi cha pili cha msingi ni:
\[ z_{1-\alpha}\sqrt{w^T\Sigma_t w} \leq VaR_{\max} \]
ni wa muundo huu.
Katika mfano wa algoriti wa chanzo, kwa kiwango cha %95 hutumiwa thamani inayolingana ya \(z=1.645\).
Muundo huu huruhusu jalada ambalo modeli inaliona kuwa la kuvutia kwa mapato yanayotarajiwa kupunguzwa ikiwa hatari inayoashiriwa na matrix ya covariance inazidi mpaka wa VaR uliowekwa.
Probabilistic Coherence Module Inatambuaje Mabadiliko ya Utawala wa Soko?
PCM inalenga kupima kwa Kullback–Leibler divergence ni kwa kiwango gani sifa za sasa za soko zimejitenga na usambazaji unaochukuliwa kuwa wa marejeo.
Katika chanzo, soko la sasa huwakilishwa kama:
\[ p_t\sim\mathcal{N}(\mu_t,\Sigma_t) \]
na utawala wa marejeo kama:
\[ q_0\sim\mathcal{N}(\mu_0,\Sigma_0) \]
hivyo ndivyo inavyomodeliwa.
Kipimo cha coherence huundwa kupitia:
\[ C_t=D_{KL}(p_t\parallel q_0) \]
ndipo huundwa.
Kwa usambazaji miwili ya Gaussian yenye vigezo vingi, chanzo hutumia usemi wa KL wa umbo lililofungwa unaojumuisha determinant, trace na tofauti za wastani.
Nini hutokea kizingiti kinapozidiwa?
Katika ukurasa wa 9 wa chanzo, Kielelezo 2 kinaonyesha \(C_t\) hufuatiliwa kwa muda na kulinganishwa na breach threshold iitwayo \(\tau_c\). \(C_t\) inapopita juu ya kizingiti, supervisor huhamia kwenye uvumilivu wa chini zaidi wa hatari. :contentReference[oaicite:12]{index=12}
Utaratibu huu unaitwa dynamic leverage braking katika utafiti. Lengo ni kubana mipaka ya nafasi bila kusubiri modeli ya DRL ijifunze upya baada ya mabadiliko katika usambazaji wa soko.
Usasishaji wa covariance
Katika utafiti, muundo wa covariance unasasishwa kwa exponential smoothing kwa kutumia sifa za order-book imbalance:
\[ \Sigma_t = (1-\lambda)\Sigma_{t-1} + \lambda(\Phi_t\Phi_t^T) \]
na katika mfano wa matumizi:
\[ \lambda=0.05 \]
hutumiwa.
\(\Phi_t\) inawakilisha vekta ya papo hapo ya limit-order-book imbalance.
Dhamana ya Kihisabati ya Convex Projection ni Nini?
Matokeo ya msingi ya kinadharia ya chanzo ni kwamba mradi seti ya hatari \(\Omega_t\) ibaki isiyo tupu, imefungwa na ni convex, operator ya orthogonal projection huwa non-expansive.
Kwa vitendo viwili ghafi \(a\) na \(b\):
\[ \|\Pi_{\Omega_t}(a)-\Pi_{\Omega_t}(b)\|_2 \leq \|a-b\|_2 \]
hupatikana.
Maana yake ni kwamba supervisor haiongezi umbali kati ya maamuzi mawili ya DRL. Projection haiwezi kugeuza mabadiliko ya sera ghafi kuwa mabadiliko makubwa zaidi ya jalada.
Utafiti unaipanua hoja hii pia kwa network update zinazofuatana na kuonyesha kwamba conditional variance ya projected operational update inadhibitiwa na underlying network parameter step.
Ingawa matokeo haya ni muhimu, yanapaswa kutafsiriwa kwa usahihi: dhamana ya kihisabati haihakikishi kwamba jalada halitapata hasara. Dhamana inahusu tabia ya kijiometri ya operator ya projection chini ya seti ya convex iliyobainishwa na dhana za kihisabati.
Mbinu na Matokeo ya Utafiti
Ulimwengu wa mali
| Ticker | Darasa la mali linalowakilishwa |
|---|---|
| SPY | Hisa za Marekani |
| BTC | Mali ya kidijitali |
| TLT | Hati za Hazina za Marekani za muda mrefu / mapato ya kudumu |
| GLD | Dhahabu / bidhaa ngumu |
Mgawanyo wa muda
Itifaki ya majaribio ya chanzo imegawanywa katika vitalu vitatu:
| Kipindi | Kazi |
|---|---|
| Januari 2018 – Desemba 2022 | In-sample training |
| Januari 2023 – Desemba 2023 | Hyperparameter validation |
| Januari 2024 – Machi 2026 | Strict out-of-sample walk-forward test |
Kwa hiyo, ingawa historia ya data ya utafiti inaanzia 2018, kipindi kilichofafanuliwa cha strict out-of-sample test ni 2024–Machi 2026.
Gharama ya muamala
Katika backtest, gharama ya muamala ya pointi 5 za msingi kwa round-turn ilitumika. Chanzo pia kinasema kuwa kilitumia seed=42 ya kudumu.
Modeli zilizolinganishwa
- LSTM Portfolio
- A2C
- PPO
- Unconstrained SAC
- SRL + PCM iliyopendekezwa
Ukaguzi wa kiekonometriki wa mfululizo wa mapato
Chanzo kinaripoti majaribio mbalimbali ya takwimu kabla ya backtest.
ADF: Inaripotiwa kwamba nadharia tete ya null ya unit-root ilikataliwa katika kiwango cha %1 kwa ticker zote zilizojaribiwa.
Ljung–Box: Chanzo kinaripoti \(Q=48.2,\ p<0.01\) na kusema kuwa kuna autocorrelation iliyobaki katika mfululizo wa return.
ARCH-LM: Matokeo ya \(p<0.01\) yanafasiriwa kama ushahidi wa volatility clustering.
Jarque–Bera: Usambazaji wa kawaida unakataliwa. Chanzo kinaripoti kurtosis 5,82 kwa SPY na 14,21 kwa BTC.
Utendaji ulioripotiwa katika chanzo
| Modeli | Mapato ya mwaka | Volatility ya mwaka | Sharpe | Sortino | Maks. drawdown | Tail-risk breach |
|---|---|---|---|---|---|---|
| LSTM Portfolio | %9,14 | %13,10 | 0,50 | 0,62 | -%18,40 | 14 |
| A2C | %11,42 | %16,50 | 0,54 | 0,68 | -%24,50 | 22 |
| PPO | %14,85 | %19,12 | 0,64 | 0,81 | -%29,10 | 31 |
| SAC | %19,82 | %26,41 | 0,75 | 0,94 | -%39,54 | 51 |
| SRL + PCM | %17,21 | %11,14 | 1,54 | 2,08 | -%7,65 | 0 |
Jedwali linaonyesha tofauti muhimu: modeli iliyopendekezwa haitoi mapato ya juu zaidi ya mwaka kwa thamani ya kawaida katika chanzo. SAC imeripotiwa kuwa %19,82 na SRL+PCM %17,21. Faida inayodaiwa ya usanifu uliopendekezwa ni utendaji wa juu zaidi uliorekebishwa kwa hatari kutokana na volatility na drawdown za chini.
Vipindi vya kujiamini vya Sharpe
Katika chanzo, Sharpe ya SRL+PCM imetolewa kama:
1,54 [1,41–1,67]
Kwa modeli nyingine:
- SAC: 0,75 [0,61–0,89]
- PPO: 0,64 [0,53–0,75]
- A2C: 0,54 [0,45–0,63]
- LSTM: 0,50 [0,42–0,58]
Chanzo kinahusisha tathmini hii na iteresheni 5.000 za block-bootstrap.
Uchambuzi wa ablation unaonyesha nini?
Katika jedwali la ablation la chanzo, tabaka za hatari huongezwa hatua kwa hatua:
| Usanidi | Sharpe | Ongezeko | Upungufu wa drawdown ulioripotiwa katika chanzo | Cohen's d |
|---|---|---|---|---|
| Unconstrained DRL | 0,75 | — | Marejeo | 0,00 |
| SPA pekee | 1,12 | +0,37 | %64,1 | 0,68 |
| SRL + PCM | 1,54 | +0,42 | %80,6 | 1,15 |
Matokeo haya yanajaribu kutenganisha mchango wa udhibiti wa hatari katika tofauti ya utendaji ndani ya muundo wa backtest wa utafiti. Hata hivyo, matokeo ya ablation bado yanahusu mazingira yaleyale ya utafiti na hayahakikishi athari ya ukubwa huo huo chini ya soko, gharama au muundo tofauti wa hyperparameter.
Mifano ya uingiliaji wa Q3 2022
Jedwali III la chanzo linatoa mifano mitatu ya jinsi supervisor alivyobadilisha mgao ghafi wa jalada.
- 15 Julai 2022, SPY: uzani uliopendekezwa wa +0,65 uliruhusiwa kama +0,65 kwa sababu ulibaki ndani ya eneo linalokubalika.
- 19 Agosti 2022, BTC: uzani ghafi wa +0,85 ulikatwa kwenye mpaka wa hatari na kupunguzwa hadi +0,52.
- 13 Septemba 2022, SPY: uzani ghafi wa +0,95 ulipunguzwa hadi +0,15 baada ya coherence breach.
Chanzo kinasema kwamba katika tukio la mwisho iliepukwa kushuka kwa soko la ndani kwa %4,3. Huu ni mfano wa uingiliaji uliosimuliwa/backtest katika utafiti; si muamala uliothibitishwa kwenye akaunti halisi ya uwekezaji.
Vikwazo Muhimu Zaidi vya Mfumo ni Vipi?
1. Ucheleweshaji wa uboreshaji
Forward pass ya modeli ya DRL inaweza kuwa ya haraka; lakini iterative convex optimizer inayofanya kazi baada yake huongeza ucheleweshaji. Chanzo kinaripoti katika mfumo wa vipimo vichache wa \(N=4\) solver latency ya 1,2–4,5 ms, na katika kiwango cha \(N=100\) 15–40 ms.
Kwa sababu hiyo, mwandishi anasema usanifu wa sasa unafaa zaidi kwa rebalancing ya kila baada ya saa kadhaa au kila siku kuliko sub-second high-frequency execution.
2. Sheria zisizo convex
Dhamana ya kihisabati inategemea eneo la hatari kuwa limefungwa na convex. Hata hivyo, katika majalada halisi kunaweza kuwa na masharti ya kutenganika kama:
- ukubwa wa minimum lot,
- sheria za binary concentration,
- step-function transaction costs
Masharti haya ya kutenganika yanaweza kuwepo.
Haya yanapofanya feasible set kuwa non-convex, quadratic projection rahisi haitoi tena dhamana ileile ya kihisabati. Chanzo kinasema katika hali kama hizo mbinu ngumu zaidi kama Mixed-Integer Non-Linear Programming zinaweza kuhitajika.
3. Ucheleweshaji wa kipimo katika mabadiliko ya haraka sana ya utawala
PCM si mfumo unao“jua” mabadiliko ya soko mara moja. Hupima divergence kadiri uchunguzi mpya wa order-book unavyokusanywa. Chanzo kinaeleza kuwa katika matukio kama flash crash kunaweza kutokea inference lag ya takriban sekunde 2–5 na kwamba baseline risk parameters zinaweza kuendelea kutumika katika muda huo.
4. Tofauti kati ya Pseudo-code na msimbo wa Python uliochapishwa
Katika sehemu ya Algorithm 1 ya utafiti:
\[ \sum_i w_i=1 \]
sharti la fully-invested limeonyeshwa wazi.
Kwa upande mwingine, kazi ya project_action() ya darasa la SupervisoryProjectionArchitecture iliyotolewa katika kurasa 18–19 haiongezi equality constraint hii kwenye optimizer. Msimbo unatumia tu:
- mpaka wa gross leverage,
- mpaka wa VaR,
- \(0\leq w_i\leq1\) bounds
Haya ndiyo yanayotumika.
Kwa hiyo, maelezo ya algoriti katika makala na executable blueprint iliyochapishwa hayafafanui kikamilifu feasible portfolio set ileile. Katika utafiti wa uzalishaji-upya, tofauti hii inahitaji kurekebishwa.
5. Backtest si sawa na matumizi ya soko halisi
Matokeo ya utendaji katika chanzo yamehesabiwa kwa data ya kihistoria, modeli maalum ya transaction cost na matukio ya sintetiki ya perturbation. Slippage, athari ya soko, ucheleweshaji wa data, kikomo cha uwezo, tabia ya broker na makosa ya kusasisha modeli yanaweza kuwa tofauti katika mazingira halisi.
Mielekeo ya utafiti wa baadaye
Mwandishi anataja maeneo matatu makuu ya maendeleo:
Differentiable optimization: kuingiza convex solver moja kwa moja ndani ya neural network computation graph kwa miundo kama Cvxpylayers au OptNet.
Meta-supervisor: kutumia wakala wa pili wa DRL kama msimamizi wa kiwango cha juu kwa sheria za hatari za non-convex na za kutenganika.
Multi-Agent Reinforcement Learning: kuunganisha mawakala wa jalada wa hisa, fixed-income, digital asset na maeneo mbalimbali chini ya supervisor wa kati.
Matokeo yanayoungwa mkono na utafiti
- Orthogonal projection kwenda kwenye seti ya hatari iliyofungwa na convex inaweza kufafanuliwa kama operator ya non-expansive.
- Kitendo cha DRL na utekelezaji wa hatari vinaweza kutenganishwa kihisabati katika tabaka tofauti.
- Katika mazingira ya majaribio ya chanzo, SRL+PCM ilitoa Sharpe ya juu zaidi na maximum drawdown ya chini zaidi kuliko modeli zilizolinganishwa.
- Kuongezwa kwa PCM kumehusishwa katika chanzo na ongezeko la ziada la utendaji uliorekebishwa kwa hatari ikilinganishwa na muundo wa SPA-only.
- Kuunganisha mkengeuko wa dinamik wa soko na mipaka ya hatari kwa trigger inayotegemea KL divergence hutoa utaratibu wa supervisory unaoweza kuhesabiwa.
Matokeo yasiyoungwa mkono na utafiti
- Hauthibitishi kwamba SRL+PCM ni bora katika vipindi vyote vya soko au kwa majalada yote.
- Hauonyeshi kwamba thamani ya Sharpe 1,54 itadumu siku zijazo.
- Matokeo ya “0 breach” hayatoi dhamana kwamba hakuna mpaka wa hatari utakaovukwa katika masoko halisi.
- Convex projection haiondoi kihisabati uwezekano wa kupoteza mtaji.
- Matokeo ya backtest si sawa na utendaji wa uwekezaji wa moja kwa moja.
- Utafiti hautoi ushauri wa uwekezaji kwa SPY, BTC, TLT au GLD.
Maelezo ya Chanzo na Mbinu
Kichwa kamili cha asili:A Supervisory Machine Learning Framework for Predictive Risk Switching in Financial Markets
Mwandishi: Stephen Muli Kithimba.
Maelezo ya kitaasisi: Independent Researcher, Financial Technology (FinTech), Chicago, Illinois, USA.
Tarehe ya kuandikwa: 15 Machi 2026.
SSRN: preprint ya kurasa 20; Juni 2026.
DOI: 10.2139/ssrn.6830019. Katika toleo tofauti Zenodo DOI: 10.5281/zenodo.20389884.
Hali ya mapitio: SSRN working paper / preprint. Rekodi iliyokaguliwa si chapisho la jarida lililopitiwa na wataalamu.
Hakimiliki: Rekodi ya SSRN imeorodheshwa kama All Rights Reserved.
Mgongano wa maslahi: Kulingana na rekodi ya SSRN, haujaripotiwa.
Ufadhili: Mwandishi anaripoti kwamba utafiti ulifanywa kwa kujitegemea bila ufadhili wa nje.
Muundo wa utafiti: Usanifu wa kihisabati wa SRL/SPA/PCM, matokeo ya kinadharia ya projection, portfolio backtest ya mali nne, ulinganisho wa modeli, block-bootstrap na uchambuzi wa ablation.
Kipindi cha data: Januari 2018–Machi 2026. Kulingana na itifaki ya majaribio, kipindi cha strict out-of-sample ni Januari 2024–Machi 2026.
Mali: SPY, BTC, TLT, GLD.
Modeli za benchmark: LSTM Portfolio, A2C, PPO na SAC.
Utendaji wa SRL+PCM ulioripotiwa katika chanzo: mapato ya mwaka %17,21; volatility ya mwaka %11,14; Sharpe 1,54; Sortino 2,08; maximum drawdown -%7,65.
Maelezo muhimu ya uzalishaji-upya: fully-invested equality constraint iliyo katika Algorithm 1 haipo katika utekelezaji wa Python mwishoni mwa PDF. Kwa hiyo, msimbo uliochapishwa na algoriti rasmi haziwakilishi kikamilifu tatizo lilelile la uboreshaji.
Tahadhari ya kibibliografia: Kwa kuwa baadhi ya rekodi katika orodha ya marejeo hazikuweza kuthibitishwa wakati wa ukaguzi huu kwa rekodi huru ya mchapishaji, hazikutumiwa kama msingi mkuu wa kisayansi wa maelezo ya Verianla.
Mpaka wa tafsiri ya kifedha: Matokeo ni matokeo ya utafiti yaliyotengenezwa kwa data ya zamani. Si ushauri wa uwekezaji, mapato ya baadaye yanayotarajiwa, wala dhamana dhidi ya kupoteza mtaji.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *