

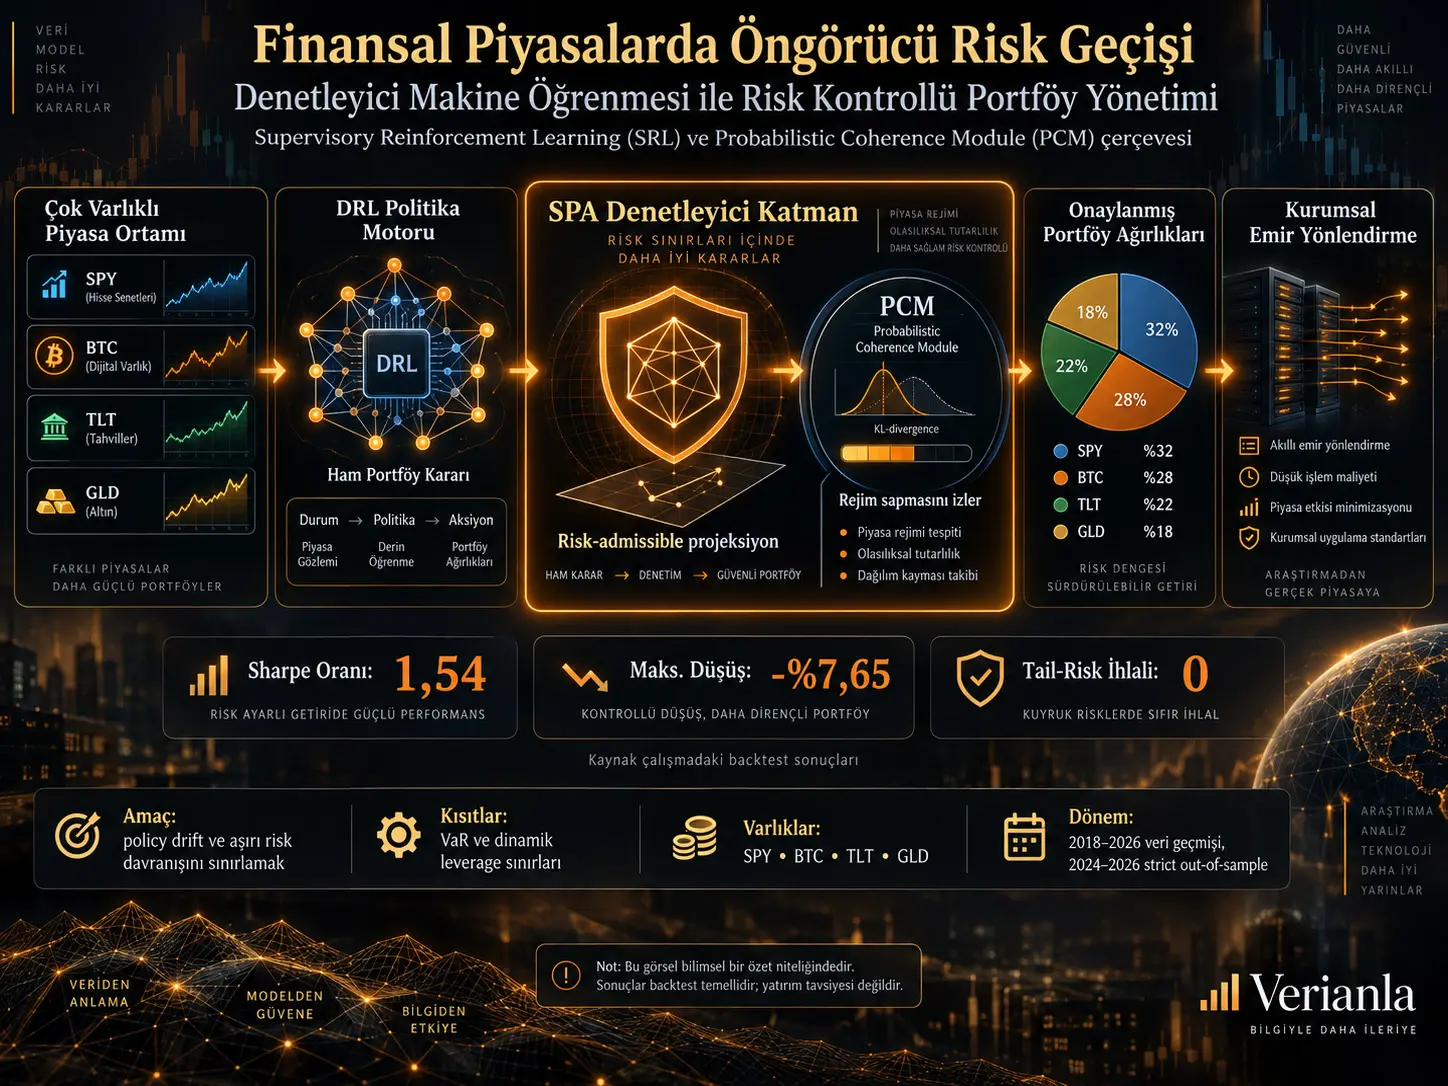
Finansal piyasalarda Deep Reinforcement Learning (DRL), geçmiş verilerden sabit bir portföy kuralı öğrenmek yerine değişen piyasa durumlarına göre sürekli ağırlık üretebilen modeller geliştirmeyi mümkün kılar. Ancak bu esneklik aynı zamanda bir risk yaratır: model, eğitim döneminde yeterince görülmemiş bir piyasa rejimiyle karşılaştığında aşırı yoğunlaşmış veya risk sınırlarının dışına çıkan portföyler üretebilir. Stephen Muli Kithimba'nın çalışması bu problemi, DRL modelinin karar üretme yeteneğini ortadan kaldırmadan önüne ayrı bir matematiksel risk denetçisi yerleştirerek çözmeyi amaçlayan Supervisory Reinforcement Learning (SRL) çerçevesini tanımlamaktadır.
SRL'nin merkezindeki Supervisory Projection Architecture (SPA), DRL modelinin ürettiği ham portföy ağırlığını doğrudan piyasaya göndermek yerine onu izin verilen risk bölgesindeki en yakın portföye projekte eder. Bu bölge leverage ve Value-at-Risk (VaR) gibi kısıtlarla tanımlanır. Buna eklenen Probabilistic Coherence Module (PCM) ise güncel piyasa dağılımının referans rejimden ne kadar uzaklaştığını Kullback–Leibler divergence üzerinden takip eder; piyasa yapısındaki sapma belirlenen eşiği geçtiğinde risk sınırlarını daraltarak portföyün daha savunmacı hale gelmesini amaçlar.
Kaynakta SPY, BTC, TLT ve GLD kullanılarak yapılan tarihsel ve sentetik testlerde tam SRL+PCM mimarisi için Sharpe oranı 1,54, yıllık volatilite %11,14 ve maksimum drawdown -%7,65 olarak raporlanmıştır. SAC karşılaştırmasında Sharpe 0,75 ve maksimum drawdown -%39,54'tür. Ancak bu rakamlar tarihsel backtest ve simülasyon sonuçlarıdır; canlı işlem performansı veya gelecekte elde edilecek getiri garantisi değildir.
DRL Portföylerinde “Policy Drift” Nedir?
Çalışmada policy drift, bir DRL modelinin eğitim sırasında öğrendiği durum–eylem ilişkilerinin piyasa dağılımı değiştiğinde güvenilirliğini kaybetmesi ve normal koşullarda üretmeyeceği ölçüde agresif portföy kararları oluşturması olarak ele alınmaktadır.
Finansal piyasalar durağan sistemler değildir. Volatilite, likidite, korelasyon, faiz ortamı ve piyasa mikro yapısı zaman içinde değişebilir. Bu nedenle geçmiş veri üzerinde iyi çalışan bir politika, farklı bir rejimde out-of-distribution durumlarla karşılaşabilir.
DRL açısından temel sorun, modelin bu yeni durumlarda yine bir eylem üretmek zorunda olmasıdır. Neural network, durum uzayının eğitim sırasında yeterince temsil edilmemiş bölümünde de matematiksel olarak portföy ağırlığı hesaplayabilir; ancak hesaplanan eylemin ekonomik veya risk açısından güvenilir olduğu garanti edilmez.
Kaynak özellikle üç tehlikeye dikkat çekmektedir:
- aşırı varlık yoğunlaşması,
- gross leverage artışı,
- tail-risk sınırlarının geç fark edilmesi.
Bu nedenle çalışma, “modelin risk sınırlarını eğitim sırasında öğrenmesini beklemek” ile “model ne üretirse üretsin emirden önce matematiksel bir risk filtresinden geçirmek” arasında ayrım yapmaktadır.
Soft risk cezası ile hard risk kısıtı arasındaki fark
Geleneksel risk-duyarlı reinforcement learning sistemlerinde VaR, drawdown veya leverage gibi risk ölçütleri reward function içine ceza terimi olarak eklenebilir. Bu yaklaşımda model risk sınırını ihlal ettiğinde daha düşük reward alarak zaman içinde bunu yapmamayı öğrenmeye çalışır.
Kithimba'nın önerdiği mimaride ise risk sınırı yalnız reward içinde temsil edilmez. Modelin ürettiği portföy eylemi, işlemden önce matematiksel olarak izin verilen kümeye taşınır.
Böylece iki ayrı fonksiyon ortaya çıkar:
| Katman | Ana görev |
|---|---|
| DRL Policy Engine | Getiri/alpha fırsatlarını keşfederek hedef portföy ağırlıklarını üretmek |
| Supervisory Layer | Üretilen ağırlığın kurumsal risk sınırlarını aşmasını engellemek |
Denetleyici Katman Ham Portföy Kararını Nasıl Değiştiriyor?
Modelin temel işlemi bir convex projection problemidir. DRL ağı önce ham hedef tahsisi üretir:
\[ a_t=\pi_\theta(s_t) \]
Burada \(s_t\) piyasanın gözlenen durumunu, \(\pi_\theta\) DRL politikasını ve \(a_t\) modelin istediği ham portföy ağırlıklarını temsil eder.
Denetleyici katman daha sonra bu vektörü izin verilen risk kümesine projekte eder:
\[ w_t^*=\Pi_{\Omega_t}(a_t) \]
Buradaki \(\Omega_t\), zaman \(t\)'de kabul edilebilir portföylerin oluşturduğu risk bölgesidir.
Projeksiyon problemi kaynağın temel mantığıyla:
\[ w_t^* = \arg\min_{w\in\Omega_t} \frac{1}{2}\|w-a_t\|_2^2 \]
şeklindedir.
Başka bir ifadeyle sistem, DRL modelinin fikrini tamamen silmek yerine risk kurallarını karşılayan portföyler arasında ham karara Öklid uzaklığı bakımından en yakın tahsisi arar.
Risk alanı sabit değil
Çalışmada izin verilen küme:
\[ \Omega_t=f(C_t,\Sigma_t,L_t) \]
olarak tanımlanmaktadır.
Burada:
- \(C_t\): piyasanın referans dağılımdan uzaklığını ölçen coherence göstergesi,
- \(\Sigma_t\): güncel covariance/regime matrisi,
- \(L_t\): dinamik leverage sınırıdır.
Dolayısıyla risk denetçisi yalnız “portföyde BTC en fazla şu kadar olsun” gibi sabit bir kural değildir. Piyasa rejimi değiştikçe izin verilen portföy geometrisinin de değişmesi amaçlanmaktadır.
Leverage sınırı
Kaynakta kullanılan temel kısıtlardan biri:
\[ \sum_{i=1}^{N}|w_i| \leq L_{\max}(s_t) \]
şeklindedir. Bu ifade portföyün toplam gross exposure seviyesini sınırlar.
Value-at-Risk sınırı
İkinci merkezi kısıt:
\[ z_{1-\alpha}\sqrt{w^T\Sigma_t w} \leq VaR_{\max} \]
biçimindedir.
Kaynağın algoritma örneğinde %95 düzeyine karşılık gelen \(z=1.645\) değeri kullanılmaktadır.
Bu yapı, modelin beklenen getiri açısından cazip gördüğü bir portföyü, covariance matrisinin ima ettiği risk belirlenen VaR sınırını aşıyorsa küçültebilmesini sağlar.
Probabilistic Coherence Module Piyasa Rejiminin Değiştiğini Nasıl Anlıyor?
PCM, güncel piyasa özelliklerinin referans kabul edilen dağılımdan ne kadar uzaklaştığını Kullback–Leibler divergence ile ölçmeyi amaçlamaktadır.
Kaynakta güncel piyasa:
\[ p_t\sim\mathcal{N}(\mu_t,\Sigma_t) \]
ve referans rejim:
\[ q_0\sim\mathcal{N}(\mu_0,\Sigma_0) \]
olarak modellenmiştir.
Coherence metriği:
\[ C_t=D_{KL}(p_t\parallel q_0) \]
üzerinden oluşturulur.
İki çok değişkenli Gaussian dağılımı için kaynak, determinant, trace ve ortalama farklarını içeren kapalı biçimli KL ifadesini kullanmaktadır.
Eşik aşılırsa ne oluyor?
Kaynağın 9. sayfasındaki Şekil 2'de \(C_t\) zaman içinde izlenmekte ve \(\tau_c\) isimli breach threshold ile karşılaştırılmaktadır. \(C_t\) eşik üzerinde çıktığında supervisor daha düşük risk toleransına geçmektedir. :contentReference[oaicite:12]{index=12}
Bu mekanizma çalışma içinde dynamic leverage braking olarak adlandırılır. Amaç, piyasa dağılımındaki değişiklik DRL modelinin yeniden öğrenmesini beklemeden pozisyon sınırlarını daraltmaktır.
Covariance güncellemesi
Çalışmada covariance yapısı order-book imbalance özellikleri kullanılarak exponential smoothing ile güncellenmektedir:
\[ \Sigma_t = (1-\lambda)\Sigma_{t-1} + \lambda(\Phi_t\Phi_t^T) \]
ve örnek uygulamada:
\[ \lambda=0.05 \]
kullanılmaktadır.
\(\Phi_t\), anlık limit-order-book imbalance vektörünü temsil etmektedir.
Konveks Projeksiyonun Matematiksel Güvencesi Nedir?
Kaynağın temel teorik sonucu, risk kümesi \(\Omega_t\) boş olmayan, kapalı ve konveks kaldığı sürece orthogonal projection operatörünün non-expansive olmasıdır.
İki ham eylem \(a\) ve \(b\) için:
\[ \|\Pi_{\Omega_t}(a)-\Pi_{\Omega_t}(b)\|_2 \leq \|a-b\|_2 \]
elde edilir.
Bunun anlamı, supervisor'ın iki DRL kararının arasındaki mesafeyi büyütmemesidir. Projeksiyon ham politika değişimini daha büyük bir portföy değişimine dönüştüremez.
Çalışma bunu ardışık network update'leri için de genişleterek projected operational update'in conditional variance'ının underlying network parameter step ile sınırlandığını göstermektedir.
Bu sonuç önemli olmakla birlikte doğru yorumlanmalıdır: matematiksel garanti portföyün zarar etmeyeceğini garanti etmez. Garanti, projeksiyon operatörünün belirtilen konveks küme ve matematiksel varsayımlar altındaki geometrik davranışıyla ilgilidir.
Çalışmanın Yöntemi ve Bulguları
Varlık evreni
| Ticker | Temsil ettiği varlık sınıfı |
|---|---|
| SPY | ABD hisse senetleri |
| BTC | Dijital varlık |
| TLT | Uzun vadeli ABD Hazine tahvilleri / sabit getiri |
| GLD | Altın / sert emtia |
Zaman ayrımı
Kaynağın deney protokolü üç bloğa ayrılmıştır:
| Dönem | İşlev |
|---|---|
| Ocak 2018 – Aralık 2022 | In-sample training |
| Ocak 2023 – Aralık 2023 | Hyperparameter validation |
| Ocak 2024 – Mart 2026 | Strict out-of-sample walk-forward test |
Bu nedenle çalışmanın veri geçmişi 2018'e kadar uzansa da tanımlanan strict out-of-sample test dönemi 2024–Mart 2026'dır.
İşlem maliyeti
Backtestlerde round-turn başına 5 baz puan işlem maliyeti uygulanmıştır. Kaynak ayrıca sabit seed=42 kullandığını belirtmektedir.
Karşılaştırılan modeller
- LSTM Portfolio
- A2C
- PPO
- Unconstrained SAC
- Önerilen SRL + PCM
Getiri serisinin ekonometrik kontrolleri
Kaynak, backtest öncesinde çeşitli istatistiksel testler raporlamaktadır.
ADF: Tüm test ticker'larında unit-root null hipotezinin %1 düzeyinde reddedildiği belirtilmektedir.
Ljung–Box: Kaynak \(Q=48.2,\ p<0.01\) raporlamakta ve return serilerinde kalan otokorelasyon bulunduğunu ifade etmektedir.
ARCH-LM: \(p<0.01\) sonucu volatilite kümelenmesine kanıt olarak yorumlanmaktadır.
Jarque–Bera: Normal dağılım reddedilmektedir. Kaynak SPY için kurtosis 5,82, BTC için 14,21 bildirmektedir.
Kaynakta raporlanan performans
| Model | Yıllık getiri | Yıllık volatilite | Sharpe | Sortino | Maks. drawdown | Tail-risk breach |
|---|---|---|---|---|---|---|
| LSTM Portfolio | %9,14 | %13,10 | 0,50 | 0,62 | -%18,40 | 14 |
| A2C | %11,42 | %16,50 | 0,54 | 0,68 | -%24,50 | 22 |
| PPO | %14,85 | %19,12 | 0,64 | 0,81 | -%29,10 | 31 |
| SAC | %19,82 | %26,41 | 0,75 | 0,94 | -%39,54 | 51 |
| SRL + PCM | %17,21 | %11,14 | 1,54 | 2,08 | -%7,65 | 0 |
Tablo önemli bir ayrımı göstermektedir: önerilen model kaynakta en yüksek nominal yıllık getiriyi üretmemektedir. SAC için %19,82, SRL+PCM için %17,21 raporlanmıştır. Önerilen mimarinin iddia edilen avantajı daha düşük volatilite ve drawdown sayesinde daha yüksek risk-ayarlı performanstır.
Sharpe güven aralıkları
Kaynakta SRL+PCM için Sharpe:
1,54 [1,41–1,67]
olarak verilmektedir. Diğer modeller için:
- SAC: 0,75 [0,61–0,89]
- PPO: 0,64 [0,53–0,75]
- A2C: 0,54 [0,45–0,63]
- LSTM: 0,50 [0,42–0,58]
Kaynak bu değerlendirmeyi 5.000 block-bootstrap iterasyonuyla ilişkilendirmektedir.
Ablation analizi ne gösteriyor?
Kaynağın ablation tablosunda risk katmanları aşamalı biçimde eklenmektedir:
| Konfigürasyon | Sharpe | Artış | Kaynakta bildirilen drawdown azalması | Cohen's d |
|---|---|---|---|---|
| Unconstrained DRL | 0,75 | — | Referans | 0,00 |
| Yalnız SPA | 1,12 | +0,37 | %64,1 | 0,68 |
| SRL + PCM | 1,54 | +0,42 | %80,6 | 1,15 |
Bu sonuçlar çalışmanın backtest tasarımında risk kontrolünün performans farkındaki rolünü ayırmaya çalışmaktadır. Ancak ablation sonuçları yine aynı araştırma ortamına aittir ve farklı piyasa, maliyet veya hyperparameter yapılarında aynı büyüklükte etki garanti etmez.
Q3 2022 müdahale örnekleri
Kaynağın Tablo III'ü supervisor'ın ham portföy tahsislerini nasıl değiştirdiğine üç örnek verir.
- 15 Temmuz 2022, SPY: önerilen +0,65 ağırlık kabul edilebilir bölgede kaldığı için +0,65 geçirilmiştir.
- 19 Ağustos 2022, BTC: +0,85 ham ağırlık risk sınırında kesilerek +0,52'ye indirilmiştir.
- 13 Eylül 2022, SPY: +0,95 ham ağırlık coherence breach sonrasında +0,15'e düşürülmüştür.
Kaynak son olay için %4,3'lük lokal piyasa düşüşünden kaçınıldığını ifade etmektedir. Bu, çalışmanın simüle edilmiş/backtest müdahale örneğidir; canlı yatırım hesabında doğrulanmış bir işlem değildir.
Sistemin En Önemli Sınırlılıkları Nelerdir?
1. Optimizasyon gecikmesi
DRL modelinin forward pass'i hızlı olabilir; ancak ardından çalışan iterative convex optimizer ek gecikme yaratır. Kaynak düşük boyutlu \(N=4\) sistemde 1,2–4,5 ms, \(N=100\) düzeyinde ise 15–40 ms aralığında solver latency raporlamaktadır.
Yazar bu nedenle mevcut mimarinin sub-second high-frequency execution yerine çok saatlik veya günlük yeniden dengeleme için daha uygun olduğunu belirtmektedir.
2. Konveks olmayan kurallar
Matematiksel garanti risk alanının kapalı ve konveks olmasına bağlıdır. Ancak gerçek portföylerde:
- minimum lot büyüklüğü,
- binary concentration kuralları,
- step-function transaction costs
gibi ayrık koşullar bulunabilir.
Bunlar feasible set'i non-convex hale getirdiğinde basit quadratic projection artık aynı matematiksel güvenceyi sağlamaz. Kaynak böyle durumlarda Mixed-Integer Non-Linear Programming gibi daha karmaşık yöntemlere ihtiyaç duyulabileceğini belirtmektedir.
3. Çok hızlı rejim kırılmalarında ölçüm gecikmesi
PCM piyasa değişimini anında “bilen” bir sistem değildir. Yeni order-book gözlemleri biriktikçe divergence ölçer. Kaynak flash crash benzeri olaylarda yaklaşık 2–5 saniyelik bir inference lag oluşabileceğini ve bu süre boyunca baseline risk parametrelerinin geçerli kalabileceğini belirtmektedir.
4. Pseudo-code ile basılı Python kodu arasında fark
Çalışmanın Algorithm 1 bölümünde:
\[ \sum_i w_i=1 \]
şeklindeki fully-invested koşulu açıkça bulunmaktadır.
Buna karşılık sayfa 18–19'da verilen SupervisoryProjectionArchitecture sınıfının project_action() fonksiyonu bu equality constraint'i optimizer'a eklememektedir. Kod yalnız:
- gross leverage sınırı,
- VaR sınırı,
- \(0\leq w_i\leq1\) bounds
uygulamaktadır.
Dolayısıyla makaledeki algoritmik tarif ile basılı executable blueprint tam olarak aynı feasible portfolio set'ini tanımlamamaktadır. Yeniden üretim çalışmasında bu farkın giderilmesi gerekir.
5. Backtest ile gerçek piyasa uygulaması aynı şey değildir
Kaynağın performans sonuçları tarihsel veri, belirlenmiş transaction cost modeli ve sentetik perturbation senaryoları üzerinde hesaplanmıştır. Slippage, piyasa etkisi, veri gecikmesi, kapasite limiti, aracı kurum davranışı ve model güncelleme hataları canlı ortamda farklı olabilir.
Gelecek araştırma yönleri
Yazar üç ana geliştirme alanı tanımlamaktadır:
Differentiable optimization: convex solver'ın Cvxpylayers veya OptNet türü yapılarla doğrudan neural network computation graph içine alınması.
Meta-supervisor: non-convex ve ayrık risk kuralları için ikinci bir DRL ajanının üst düzey denetçi olarak kullanılması.
Multi-Agent Reinforcement Learning: hisse senedi, fixed-income, digital asset ve farklı bölgesel portföy ajanlarının merkezi bir supervisor altında birleştirilmesi.
Çalışmanın desteklediği sonuçlar
- Kapalı ve konveks bir risk kümesine orthogonal projection non-expansive bir operatör olarak tanımlanabilir.
- DRL eylemi ile risk uygulaması matematiksel olarak ayrı katmanlara ayrılabilir.
- Kaynağın test ortamında SRL+PCM, karşılaştırılan modellerden daha yüksek Sharpe ve daha düşük maksimum drawdown üretmiştir.
- PCM eklenmesi kaynakta SPA-only yapıya göre ek risk-ayarlı performans artışıyla ilişkilendirilmiştir.
- Dinamik piyasa sapmasını KL divergence tabanlı bir trigger ile risk sınırlarına bağlamak hesaplanabilir bir supervisory mekanizma sunmaktadır.
Çalışmanın desteklemediği sonuçlar
- SRL+PCM'nin bütün piyasa dönemlerinde veya bütün portföylerde üstün olduğunu kanıtlamaz.
- Sharpe 1,54 değerinin gelecekte korunacağını göstermez.
- “0 breach” sonucu gerçek piyasalarda hiçbir risk sınırının aşılmayacağını garanti etmez.
- Konveks projeksiyon sermaye kaybını matematiksel olarak ortadan kaldırmaz.
- Backtest sonuçları canlı yatırım performansıyla eşdeğer değildir.
- Çalışma SPY, BTC, TLT veya GLD için yatırım tavsiyesi üretmez.
Kaynak ve Yöntem Notu
Tam özgün başlık:A Supervisory Machine Learning Framework for Predictive Risk Switching in Financial Markets
Yazar: Stephen Muli Kithimba.
Kurumsal tanım: Independent Researcher, Financial Technology (FinTech), Chicago, Illinois, USA.
Yazım tarihi: 15 Mart 2026.
SSRN: 20 sayfalık preprint; Haziran 2026.
DOI: 10.2139/ssrn.6830019. Ayrı sürümde Zenodo DOI: 10.5281/zenodo.20389884.
Hakemlik durumu: SSRN working paper / preprint. İncelenen kayıt hakemli dergi yayını değildir.
Telif: SSRN kaydı All Rights Reserved olarak listelenmektedir.
Çıkar çatışması: SSRN kaydına göre bildirilmemiştir.
Fon: Yazar çalışmanın dış fon olmadan bağımsız yürütüldüğünü bildirmektedir.
Araştırma yapısı: Matematiksel SRL/SPA/PCM mimarisi, teorik projection sonuçları, dört varlıklı portfolio backtest, model karşılaştırmaları, block-bootstrap ve ablation analizi.
Veri dönemi: Ocak 2018–Mart 2026. Deney protokolüne göre strict out-of-sample dönem Ocak 2024–Mart 2026'dır.
Varlıklar: SPY, BTC, TLT, GLD.
Benchmark modeller: LSTM Portfolio, A2C, PPO ve SAC.
Kaynakta raporlanan SRL+PCM performansı: yıllık getiri %17,21; yıllık volatilite %11,14; Sharpe 1,54; Sortino 2,08; maksimum drawdown -%7,65.
Kritik yeniden üretilebilirlik notu: Algorithm 1'de yer alan fully-invested equality constraint, PDF'nin sonundaki Python implementasyonunda bulunmamaktadır. Bu nedenle basılı kod ile formel algoritma aynı optimizasyon problemini eksiksiz biçimde temsil etmemektedir.
Bibliyografik dikkat: Kaynakçadaki bazı kayıtlar bu kontrol sırasında bağımsız yayıncı kaydıyla doğrulanamadığından Verianla anlatımının ana bilimsel dayanağı olarak kullanılmamıştır.
Finansal yorum sınırı: Sonuçlar geçmiş veri üzerinde oluşturulmuş araştırma sonuçlarıdır. Yatırım tavsiyesi, beklenen gelecek getirisi veya sermaye kaybına karşı garanti değildir.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir