

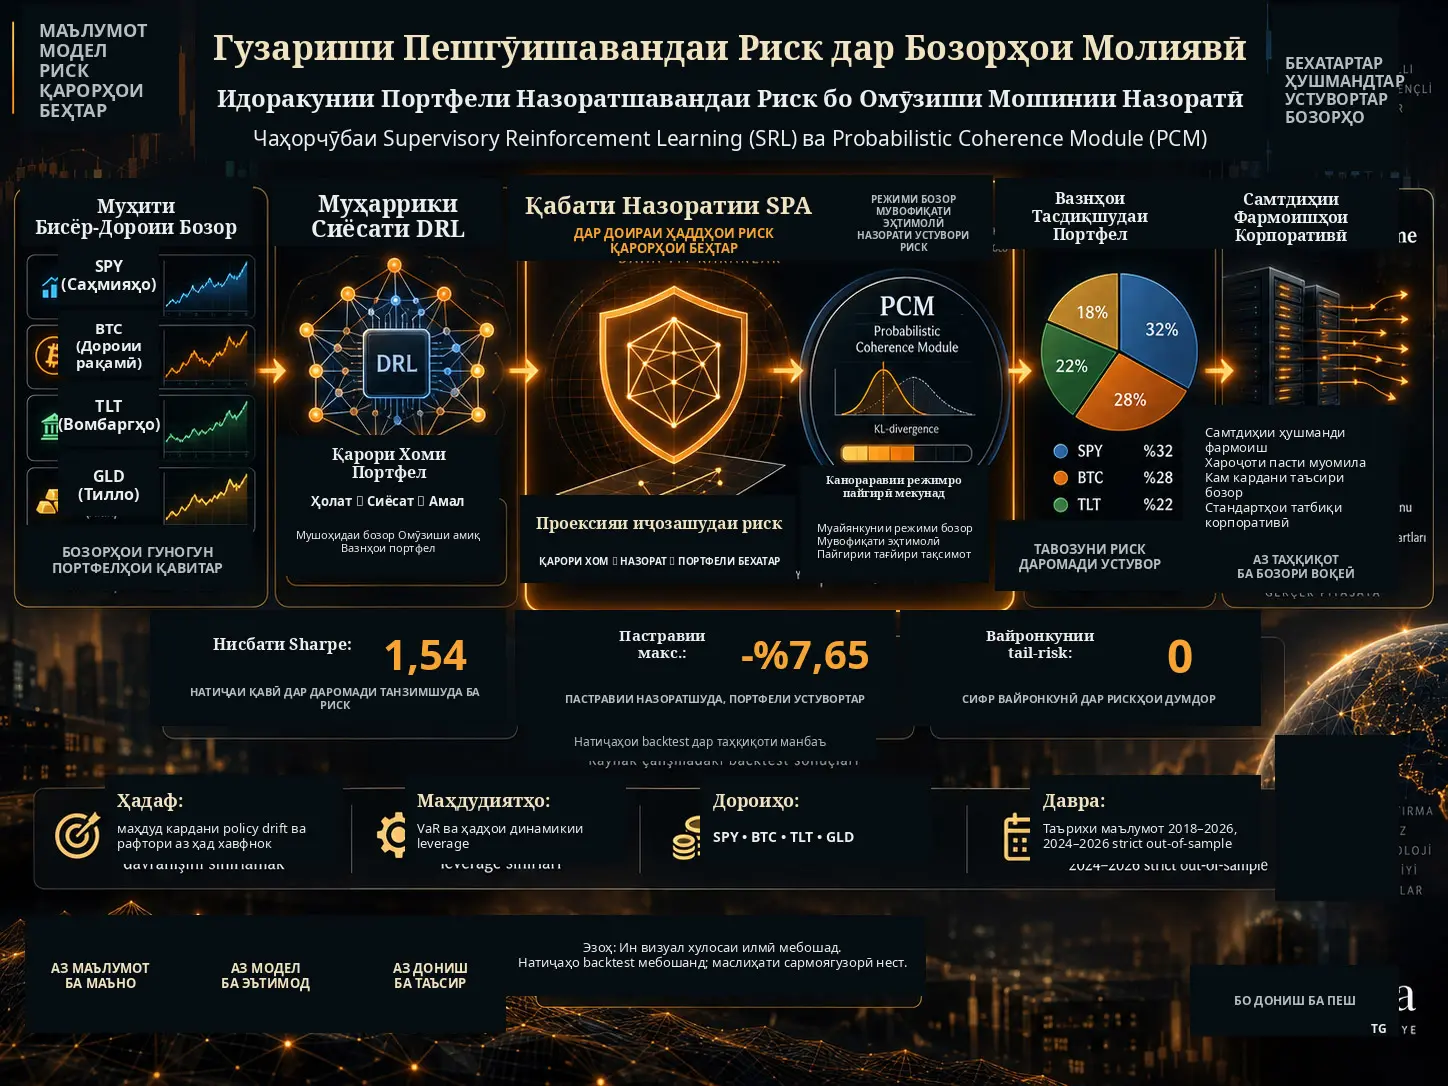
Дар бозорҳои молиявӣ Deep Reinforcement Learning (DRL) ба ҷойи омӯхтани қоидаи собити портфел аз маълумоти гузашта, имкон медиҳад моделҳое сохта шаванд, ки мувофиқи ҳолатҳои тағйирёбандаи бозор пайваста вазнҳои нав тавлид мекунанд. Аммо ҳамин чандирӣ ҳамзамон як хатар эҷод мекунад: вақте модел бо режими бозоре рӯ ба рӯ мешавад, ки дар давраи омӯзиш ба қадри кофӣ дида нашудааст, метавонад портфелҳои аз ҳад зиёд мутамарказ ё берун аз ҳудудҳои риск тавлид кунад. Кори Stephen Muli Kithimba чаҳорчӯбаи Supervisory Reinforcement Learning (SRL)-ро тавсиф мекунад, ки ҳадафаш ҳалли ин масъала бо ҷойгир кардани як нозири ҷудогонаи математикии риск пеш аз қабули қарорҳои модели DRL, бе аз байн бурдани қобилияти худи модел барои тавлиди қарор аст.
Supervisory Projection Architecture (SPA), ки дар маркази SRL қарор дорад, вазни хоми портфели аз ҷониби модели DRL тавлидшударо мустақиман ба бозор намефиристад, балки онро ба наздиктарин портфел дар минтақаи иҷозатдодашудаи риск проексия мекунад. Ин минтақа бо маҳдудиятҳое чун leverage ва Value-at-Risk (VaR) муайян мешавад. Probabilistic Coherence Module (PCM), ки ба он илова шудааст, бо истифода аз Kullback–Leibler divergence назорат мекунад, ки тақсимоти ҷории бозор то чӣ андоза аз режими истинодӣ дур шудааст; вақте инҳирофи сохтори бозор аз ҳадди муайяншуда мегузарад, бо танг кардани ҳудудҳои риск портфелро ба ҳолати муҳофизакортар гузаронидан мехоҳад.
Дар манбаъ, дар санҷишҳои таърихӣ ва синтетикӣ бо истифода аз SPY, BTC, TLT ва GLD барои меъмории пурраи SRL+PCM таносуби Sharpe 1,54, ноустувории солона %11,14 ва maximum drawdown -%7,65 гузориш шудааст. Дар муқоиса бо SAC, Sharpe 0,75 ва maximum drawdown -%39,54 мебошад. Аммо ин рақамҳо натиҷаҳои backtest-и таърихӣ ва симулятсия мебошанд; онҳо нишондиҳандаи савдои зинда ё кафолати даромади оянда нестанд.
“Policy Drift” дар Портфелҳои DRL Чист?
Дар таҳқиқот policy drift ҳамчун ҳолате баррасӣ мешавад, ки муносибатҳои ҳолат–амали аз ҷониби модели DRL ҳангоми омӯзиш омӯхташуда бо тағйир ёфтани тақсимоти бозор эътимоднокии худро аз даст медиҳанд ва модел қарорҳои портфелии хеле хашмгинтар аз он чизеро, ки дар шароити муқаррарӣ тавлид мекард, ба вуҷуд меорад.
Бозорҳои молиявӣ системаҳои статсионарӣ нестанд. Ноустуворӣ, пардохтпазирӣ, коррелятсия, муҳити фоизӣ ва микросохтори бозор метавонанд бо гузашти вақт тағйир ёбанд. Аз ин рӯ, сиёсате, ки дар маълумоти гузашта хуб кор кардааст, метавонад дар режими дигар бо ҳолатҳои out-of-distribution рӯ ба рӯ шавад.
Мушкилоти асосӣ аз нуқтаи назари DRL ин аст, ки модел дар ин ҳолатҳои нав ҳам бояд амал тавлид кунад. Neural network метавонад ҳатто дар қисми фазои ҳолатҳо, ки ҳангоми омӯзиш ба қадри кофӣ намояндагӣ нашудааст, вазни портфелро математикӣ ҳисоб кунад; аммо кафолате нест, ки амали ҳисобшуда аз нигоҳи иқтисодӣ ё риск боэътимод бошад.
Манбаъ махсусан ба се хатар ишора мекунад:
- тамаркузи аз ҳад зиёди дороиҳо,
- афзоиши gross leverage,
- дер муайян шудани ҳудудҳои tail-risk.
Аз ин рӯ, таҳқиқот байни “интизор шудан, ки модел ҳудудҳои рискро ҳангоми омӯзиш ёд гирад” ва “новобаста аз он ки модел чӣ тавлид мекунад, пеш аз фармоиш онро аз филтри математикии риск гузаронидан” фарқ мегузорад.
Фарқи байни ҷаримаи soft risk ва маҳдудияти hard risk
Дар системаҳои анъанавии reinforcement learning-и ҳассос ба риск, ченакҳои риск монанди VaR, drawdown ё leverage метавонанд ҳамчун ҷузъи ҷаримавӣ ба reward function илова шаванд. Дар ин равиш, вақте модел ҳудуди рискро вайрон мекунад, reward-и камтар мегирад ва кӯшиш мекунад бо мурури вақт чунин рафтор накунад.
Дар меъмории пешниҳодкардаи Kithimba бошад, ҳудуди риск танҳо дар reward ифода намешавад. Амали портфелии аз ҷониби модел тавлидшуда пеш аз анҷоми амалиёт ба маҷмӯаи аз нигоҳи математикӣ иҷозатдодашуда интиқол дода мешавад.
Ҳамин тавр ду вазифаи ҷудогона ба вуҷуд меоянд:
| Қабат | Вазифаи асосӣ |
|---|---|
| DRL Policy Engine | Бо ҷустуҷӯи имкониятҳои даромад/alpha вазнҳои ҳадафии портфелро тавлид кардан |
| Supervisory Layer | Нагузоштан, ки вазни тавлидшуда аз ҳудудҳои институтсионалии риск гузарад |
Қабати Назоратӣ Қарори Хоми Портфелро Чӣ Гуна Тағйир Медиҳад?
Амали асосии модел масъалаи convex projection мебошад. Шабакаи DRL аввал тақсимоти хоми ҳадафиро тавлид мекунад:
\[ a_t=\pi_\theta(s_t) \]
Дар ин ҷо \(s_t\) ҳолати мушоҳидашудаи бозор, \(\pi_\theta\) сиёсати DRL ва \(a_t\) вазнҳои хоми портфелии дилхоҳи моделро ифода мекунад.
Сипас қабати назоратӣ ин векторро ба маҷмӯаи иҷозатдодашудаи риск проексия мекунад:
\[ w_t^*=\Pi_{\Omega_t}(a_t) \]
Дар ин ҷо \(\Omega_t\) минтақаи рискест, ки аз портфелҳои қобили қабул дар вақти \(t\) ташкил шудааст.
Масъалаи проексия бо мантиқи асосии манбаъ чунин аст:
\[ w_t^* = \arg\min_{w\in\Omega_t} \frac{1}{2}\|w-a_t\|_2^2 \]
мебошад.
Ба ибораи дигар, система ба ҷойи пурра нест кардани фикри модели DRL, дар байни портфелҳое, ки қоидаҳои рискро риоя мекунанд, тақсимотеро меҷӯяд, ки аз рӯи масофаи Евклидӣ ба қарори хом наздиктарин бошад.
Минтақаи риск собит нест
Дар таҳқиқот маҷмӯаи иҷозатдодашуда чунин муайян мешавад:
\[ \Omega_t=f(C_t,\Sigma_t,L_t) \]
муайян карда мешавад.
Дар ин ҷо:
- \(C_t\): нишондиҳандаи coherence, ки дурии бозорро аз тақсимоти истинодӣ чен мекунад,
- \(\Sigma_t\): матритсаи ҷории covariance/regime,
- \(L_t\): ҳудуди динамикии leverage мебошад.
Аз ин рӯ, нозири риск танҳо қоидаи собите мисли “дар портфел BTC аз ин миқдор бештар набошад” нест. Ҳадаф ин аст, ки бо тағйир ёфтани режими бозор геометрияи портфелҳои иҷозатдодашуда низ тағйир ёбад.
Ҳудуди leverage
Яке аз маҳдудиятҳои асосии истифодашуда дар манбаъ:
\[ \sum_{i=1}^{N}|w_i| \leq L_{\max}(s_t) \]
мебошад. Ин ифода сатҳи умумии gross exposure-и портфелро маҳдуд мекунад.
Ҳудуди Value-at-Risk
Маҳдудияти марказии дуюм:
\[ z_{1-\alpha}\sqrt{w^T\Sigma_t w} \leq VaR_{\max} \]
мебошад.
Дар намунаи алгоритмии манбаъ барои сатҳи %95 қимати мувофиқи \(z=1.645\) истифода мешавад.
Ин сохтор имкон медиҳад портфеле, ки модел аз нигоҳи даромади интизоршаванда ҷолиб мешуморад, агар риски аз ҷониби матритсаи covariance ифодашуда аз ҳудуди муайяншудаи VaR бештар шавад, хурд карда шавад.
Probabilistic Coherence Module Чӣ Гуна Тағйир Ёфтани Режими Бозорро Мефаҳмад?
PCM мехоҳад бо Kullback–Leibler divergence чен кунад, ки хусусиятҳои ҷории бозор то чӣ андоза аз тақсимоти ҳамчун истинод қабулшуда дур шудаанд.
Дар манбаъ бозори ҷорӣ:
\[ p_t\sim\mathcal{N}(\mu_t,\Sigma_t) \]
ва режими истинодӣ:
\[ q_0\sim\mathcal{N}(\mu_0,\Sigma_0) \]
модел карда шудаанд.
Меъёри coherence:
\[ C_t=D_{KL}(p_t\parallel q_0) \]
сохта мешавад.
Барои ду тақсимоти Gaussian-и бисёртағйирёбанда манбаъ ифодаи пӯшидаи KL-ро истифода мебарад, ки determinant, trace ва фарқҳои миёнаро дар бар мегирад.
Агар ҳад гузаронда шавад, чӣ рӯй медиҳад?
Дар саҳифаи 9-и манбаъ, дар Шакли 2, \(C_t\) бо гузашти вақт пайгирӣ шуда, бо breach threshold бо номи \(\tau_c\) муқоиса мешавад. Вақте \(C_t\) аз ҳад боло меравад, supervisor ба таҳаммулпазирии пасттари риск мегузарад. :contentReference[oaicite:12]{index=12}
Ин механизм дар таҳқиқот dynamic leverage braking номида мешавад. Ҳадаф он аст, ки бе интизор шудани аз нав омӯхтани модели DRL ҳудудҳои мавқеъ дар посух ба тағйири тақсимоти бозор танг карда шаванд.
Навсозии covariance
Дар таҳқиқот сохтори covariance бо истифода аз хусусиятҳои order-book imbalance тавассути exponential smoothing нав карда мешавад:
\[ \Sigma_t = (1-\lambda)\Sigma_{t-1} + \lambda(\Phi_t\Phi_t^T) \]
ва дар намунаи татбиқ:
\[ \lambda=0.05 \]
истифода мешавад.
\(\Phi_t\) вектори фаврии limit-order-book imbalance-ро ифода мекунад.
Кафолати Математикии Проексияи Конвексӣ Чист?
Натиҷаи асосии назариявии манбаъ ин аст, ки то замоне ки маҷмӯаи риск \(\Omega_t\) ғайрихолӣ, пӯшида ва конвексӣ мемонад, оператори orthogonal projection non-expansive мебошад.
Барои ду амали хом \(a\) ва \(b\):
\[ \|\Pi_{\Omega_t}(a)-\Pi_{\Omega_t}(b)\|_2 \leq \|a-b\|_2 \]
ба даст меояд.
Маънои ин он аст, ки supervisor масофаи байни ду қарори DRL-ро калон намекунад. Проексия наметавонад тағйири сиёсати хомро ба тағйири аз он ҳам калонтар дар портфел табдил диҳад.
Таҳқиқот ин натиҷаро ба network update-ҳои пайдарпай низ тавсеа медиҳад ва нишон медиҳад, ки conditional variance-и projected operational update бо underlying network parameter step маҳдуд мешавад.
Ин натиҷа муҳим аст, аммо бояд дуруст тафсир шавад: кафолати математикӣ кафолат намедиҳад, ки портфел зарар намебинад. Кафолат ба рафтори геометрии оператори проексия дар доираи маҷмӯаи конвексии муайяншуда ва фарзияҳои математикӣ дахл дорад.
Усул ва Натиҷаҳои Таҳқиқот
Олами дороиҳо
| Ticker | Синфи дороие, ки ифода мекунад |
|---|---|
| SPY | Саҳмияҳои ИМА |
| BTC | Дороиҳои рақамӣ |
| TLT | Облигацияҳои дарозмуддати Хазинадории ИМА / даромади собит |
| GLD | Тилло / моли сахт |
Тақсимоти вақт
Протоколи таҷрибавии манбаъ ба се блок ҷудо шудааст:
| Давра | Функсия |
|---|---|
| Январ 2018 – Декабр 2022 | In-sample training |
| Январ 2023 – Декабр 2023 | Hyperparameter validation |
| Январ 2024 – Март 2026 | Strict out-of-sample walk-forward test |
Аз ин рӯ, гарчанде таърихи маълумоти таҳқиқот то соли 2018 мерасад, давраи таърифшудаи strict out-of-sample санҷиш 2024–Март 2026 мебошад.
Хароҷоти муомила
Дар backtest-ҳо барои ҳар round-turn 5 банди базисӣ хароҷоти муомила татбиқ шудааст. Манбаъ инчунин истифодаи seed=42-и собитро зикр мекунад.
Моделҳои муқоисашуда
- LSTM Portfolio
- A2C
- PPO
- Unconstrained SAC
- SRL + PCM-и пешниҳодшуда
Назоратҳои эконометрикии силсилаи даромад
Манбаъ пеш аз backtest чанд санҷиши омориро гузориш мекунад.
ADF: Гуфта мешавад, ки дар ҳамаи ticker-ҳои санҷишӣ гипотезаи null-и unit-root дар сатҳи %1 рад шудааст.
Ljung–Box: Манбаъ \(Q=48.2,\ p<0.01\)-ро гузориш карда, мавҷудияти автокоррелятсияи боқимондаро дар силсилаи return зикр мекунад.
ARCH-LM: Натиҷаи \(p<0.01\) ҳамчун далели clustering-и ноустуворӣ тафсир мешавад.
Jarque–Bera: Тақсимоти нормалӣ рад мешавад. Манбаъ барои SPY kurtosis 5,82 ва барои BTC 14,21 гузориш мекунад.
Нишондодҳои гузоришшуда дар манбаъ
| Модел | Даромади солона | Ноустувории солона | Sharpe | Sortino | Макс. drawdown | Tail-risk breach |
|---|---|---|---|---|---|---|
| LSTM Portfolio | %9,14 | %13,10 | 0,50 | 0,62 | -%18,40 | 14 |
| A2C | %11,42 | %16,50 | 0,54 | 0,68 | -%24,50 | 22 |
| PPO | %14,85 | %19,12 | 0,64 | 0,81 | -%29,10 | 31 |
| SAC | %19,82 | %26,41 | 0,75 | 0,94 | -%39,54 | 51 |
| SRL + PCM | %17,21 | %11,14 | 1,54 | 2,08 | -%7,65 | 0 |
Ҷадвал фарқи муҳимро нишон медиҳад: модели пешниҳодшуда дар манбаъ баландтарин даромади номиналии солонаро намедиҳад. Барои SAC %19,82 ва барои SRL+PCM %17,21 гузориш шудааст. Афзалияти иддаошудаи меъмории пешниҳодшуда аз иҷрои баландтари мутобиқшуда ба риск ба шарофати ноустуворӣ ва drawdown-и пасттар иборат аст.
Фосилаҳои эътимоди Sharpe
Дар манбаъ Sharpe барои SRL+PCM:
1,54 [1,41–1,67]
оварда шудааст. Барои моделҳои дигар:
- SAC: 0,75 [0,61–0,89]
- PPO: 0,64 [0,53–0,75]
- A2C: 0,54 [0,45–0,63]
- LSTM: 0,50 [0,42–0,58]
Манбаъ ин арзёбиро бо 5.000 итератсияи block-bootstrap мепайвандад.
Таҳлили ablation чиро нишон медиҳад?
Дар ҷадвали ablation-и манбаъ қабатҳои риск тадриҷан илова мешаванд:
| Конфигуратсия | Sharpe | Афзоиш | Коҳиши drawdown, ки дар манбаъ гузориш шудааст | Cohen's d |
|---|---|---|---|---|
| Unconstrained DRL | 0,75 | — | Истинод | 0,00 |
| Танҳо SPA | 1,12 | +0,37 | %64,1 | 0,68 |
| SRL + PCM | 1,54 | +0,42 | %80,6 | 1,15 |
Ин натиҷаҳо мекӯшанд нақши назорати рискро дар фарқи иҷрои тарҳи backtest-и таҳқиқот ҷудо кунанд. Аммо натиҷаҳои ablation боз ҳам ба ҳамин муҳити таҳқиқотӣ тааллуқ доранд ва таъсири ҳамон андозаро дар бозор, хароҷот ё сохтори hyperparameter-и дигар кафолат намедиҳанд.
Намунаҳои дахолати Q3 2022
Ҷадвали III-и манбаъ се намуна медиҳад, ки supervisor тақсимоти хоми портфелро чӣ гуна тағйир додааст.
- 15 Июл 2022, SPY: вазни пешниҳодшудаи +0,65 дар минтақаи қобили қабул монд ва аз ин рӯ +0,65 гузаронида шуд.
- 19 Август 2022, BTC: вазни хоми +0,85 дар ҳудуди риск бурида шуда, ба +0,52 паст карда шуд.
- 13 Сентябр 2022, SPY: вазни хоми +0,95 пас аз coherence breach ба +0,15 коҳиш дода шуд.
Манбаъ мегӯяд, ки дар ҳодисаи охирин аз коҳиши маҳаллии %4,3 бозор канорагирӣ шуд. Ин намунаи дахолати симулятсионӣ/backtest-и таҳқиқот аст; он амалиёти дар ҳисоби сармоягузории зинда тасдиқшуда нест.
Маҳдудиятҳои Муҳимтарини Система Кадомҳоянд?
1. Таъхири оптимизатсия
Forward pass-и модели DRL метавонад зуд бошад; аммо iterative convex optimizer, ки баъд аз он кор мекунад, таъхири иловагӣ эҷод мекунад. Манбаъ дар системаи камандозаи \(N=4\) solver latency-и 1,2–4,5 ms ва дар сатҳи \(N=100\) 15–40 ms гузориш мекунад.
Аз ин рӯ, муаллиф мегӯяд, ки меъмории мавҷуда барои азнавмувозинаткунии чандсоата ё рӯзона нисбат ба sub-second high-frequency execution мувофиқтар аст.
2. Қоидаҳои ғайриконвексӣ
Кафолати математикӣ ба пӯшида ва конвексӣ будани минтақаи риск вобаста аст. Аммо дар портфелҳои воқеӣ метавонанд шартҳои дискретӣ ба мисли:
- андозаи minimum lot,
- қоидаҳои binary concentration,
- step-function transaction costs
вуҷуд дошта бошанд.
Вақте онҳо feasible set-ро non-convex мекунанд, quadratic projection-и оддӣ дигар ҳамон кафолати математикиро намедиҳад. Манбаъ мегӯяд, ки дар чунин ҳолатҳо усулҳои мураккабтар мисли Mixed-Integer Non-Linear Programming лозим шуда метавонанд.
3. Таъхири андозагирӣ дар шикастҳои хеле тези режим
PCM системае нест, ки тағйири бозорро фавран “медонад”. Он бо ҷамъ шудани мушоҳидаҳои нави order-book divergence-ро чен мекунад. Манбаъ зикр мекунад, ки дар ҳодисаҳои монанди flash crash метавонад тақрибан 2–5 сония inference lag ба вуҷуд ояд ва дар ин муддат baseline risk параметрҳо амалкунанда бимонанд.
4. Фарқи байни Pseudo-code ва коди чопшудаи Python
Дар бахши Algorithm 1-и таҳқиқот:
\[ \sum_i w_i=1 \]
шарти fully-invested ба таври равшан вуҷуд дорад.
Аммо функсияи project_action()-и синфи SupervisoryProjectionArchitecture, ки дар саҳифаҳои 18–19 дода шудааст, ин equality constraint-ро ба optimizer илова намекунад. Код танҳо:
- ҳудуди gross leverage,
- ҳудуди VaR,
- \(0\leq w_i\leq1\) bounds
татбиқ мекунад.
Аз ин рӯ, тавсифи алгоритмии мақола ва executable blueprint-и чопшуда маҳз як feasible portfolio set-ро пурра муайян намекунанд. Дар таҳқиқоти такрористеҳсолӣ ин фарқ бояд бартараф карда шавад.
5. Backtest ва татбиқи бозори воқеӣ як чиз нестанд
Натиҷаҳои иҷрои манбаъ аз рӯи маълумоти таърихӣ, модели муайяншудаи transaction cost ва сенарияҳои синтетикии perturbation ҳисоб шудаанд. Slippage, таъсири бозор, таъхири маълумот, маҳдудияти иқтидор, рафтори брокер ва хатогиҳои навсозии модел дар муҳити зинда метавонанд дигар бошанд.
Самтҳои таҳқиқоти оянда
Муаллиф се самти асосии рушдро муайян мекунад:
Differentiable optimization: ворид кардани convex solver бо сохторҳои навъи Cvxpylayers ё OptNet мустақиман ба neural network computation graph.
Meta-supervisor: истифодаи агенти дуюми DRL ҳамчун нозири сатҳи боло барои қоидаҳои non-convex ва дискретии риск.
Multi-Agent Reinforcement Learning: якҷо кардани агентҳои портфелии саҳмия, fixed-income, digital asset ва минтақаҳои гуногун зери supervisor-и марказӣ.
Натиҷаҳое, ки таҳқиқот дастгирӣ мекунад
- Orthogonal projection ба маҷмӯаи пӯшида ва конвексии риск метавонад ҳамчун оператори non-expansive муайян шавад.
- Амали DRL ва татбиқи риск метавонанд аз нигоҳи математикӣ ба қабатҳои ҷудогона тақсим шаванд.
- Дар муҳити санҷишии манбаъ SRL+PCM нисбат ба моделҳои муқоисашуда Sharpe-и баландтар ва maximum drawdown-и пасттар дод.
- Илова шудани PCM дар манбаъ бо афзоиши иловагии иҷрои мутобиқшуда ба риск нисбат ба сохтори SPA-only алоқаманд карда шудааст.
- Пайваст кардани инҳирофи динамикии бозор ба ҳудудҳои риск тавассути trigger-и асосёфта ба KL divergence механизми ҳисобшавандаи supervisory пешниҳод мекунад.
Натиҷаҳое, ки таҳқиқот дастгирӣ намекунад
- Исбот намекунад, ки SRL+PCM дар ҳамаи давраҳои бозор ё ҳамаи портфелҳо бартарӣ дорад.
- Нишон намедиҳад, ки қимати Sharpe 1,54 дар оянда нигоҳ дошта мешавад.
- Натиҷаи “0 breach” кафолат намедиҳад, ки дар бозорҳои воқеӣ ҳеҷ як ҳудуди риск вайрон намешавад.
- Проексияи конвексӣ талафи сармояро аз нигоҳи математикӣ бартараф намекунад.
- Натиҷаҳои backtest ба иҷрои сармоягузории зинда баробар нестанд.
- Таҳқиқот барои SPY, BTC, TLT ё GLD тавсияи сармоягузорӣ намедиҳад.
Ёддошт оид ба Манбаъ ва Усул
Унвони пурраи аслӣ:A Supervisory Machine Learning Framework for Predictive Risk Switching in Financial Markets
Муаллиф: Stephen Muli Kithimba.
Тавсифи институтсионалӣ: Independent Researcher, Financial Technology (FinTech), Chicago, Illinois, USA.
Санаи навиштан: 15 Март 2026.
SSRN: preprint-и 20 саҳифагӣ; Июн 2026.
DOI: 10.2139/ssrn.6830019. Дар версияи ҷудогона Zenodo DOI: 10.5281/zenodo.20389884.
Ҳолати баррасӣ: SSRN working paper / preprint. Сабти санҷидашуда нашри маҷаллаи рецензияшуда нест.
Ҳуқуқи муаллиф: Сабти SSRN ҳамчун All Rights Reserved нишон дода шудааст.
Бархӯрди манфиатҳо: Тибқи сабти SSRN гузориш нашудааст.
Маблағгузорӣ: Муаллиф мегӯяд, ки таҳқиқот мустақилона ва бе маблағгузории беруна анҷом дода шудааст.
Сохтори таҳқиқот: Меъмории математикии SRL/SPA/PCM, натиҷаҳои назариявии projection, portfolio backtest-и чаҳордороӣ, муқоисаҳои моделҳо, block-bootstrap ва таҳлили ablation.
Давраи маълумот: Январ 2018–Март 2026. Тибқи протоколи таҷриба давраи strict out-of-sample Январ 2024–Март 2026 мебошад.
Дороиҳо: SPY, BTC, TLT, GLD.
Моделҳои benchmark: LSTM Portfolio, A2C, PPO ва SAC.
Иҷрои SRL+PCM, ки дар манбаъ гузориш шудааст: даромади солона %17,21; ноустувории солона %11,14; Sharpe 1,54; Sortino 2,08; maximum drawdown -%7,65.
Ёддошти муҳими такрористеҳсолӣ: fully-invested equality constraint, ки дар Algorithm 1 мавҷуд аст, дар татбиқи Python дар охири PDF нест. Аз ин рӯ, коди чопшуда ва алгоритми формалӣ як масъалаи оптимизатсияро ба таври комил яксон ифода намекунанд.
Эҳтиёти библиографӣ: Азбаски баъзе сабтҳои рӯйхати манбаъҳо ҳангоми ин санҷиш бо сабти мустақили ношир тасдиқ нашуданд, онҳо ҳамчун такягоҳи асосии илмии шарҳи Verianla истифода нашудаанд.
Ҳудуди тафсири молиявӣ: Натиҷаҳо натиҷаҳои таҳқиқотӣ мебошанд, ки бар асоси маълумоти гузашта ба даст омадаанд. Онҳо тавсияи сармоягузорӣ, даромади интизоршавандаи оянда ё кафолат аз талафи сармоя нестанд.
Шарҳ гузоред
Нишонии почтаи электронии шумо нашр намешавад. Майдонҳои ҳатмӣ бо * нишон дода шудаанд