

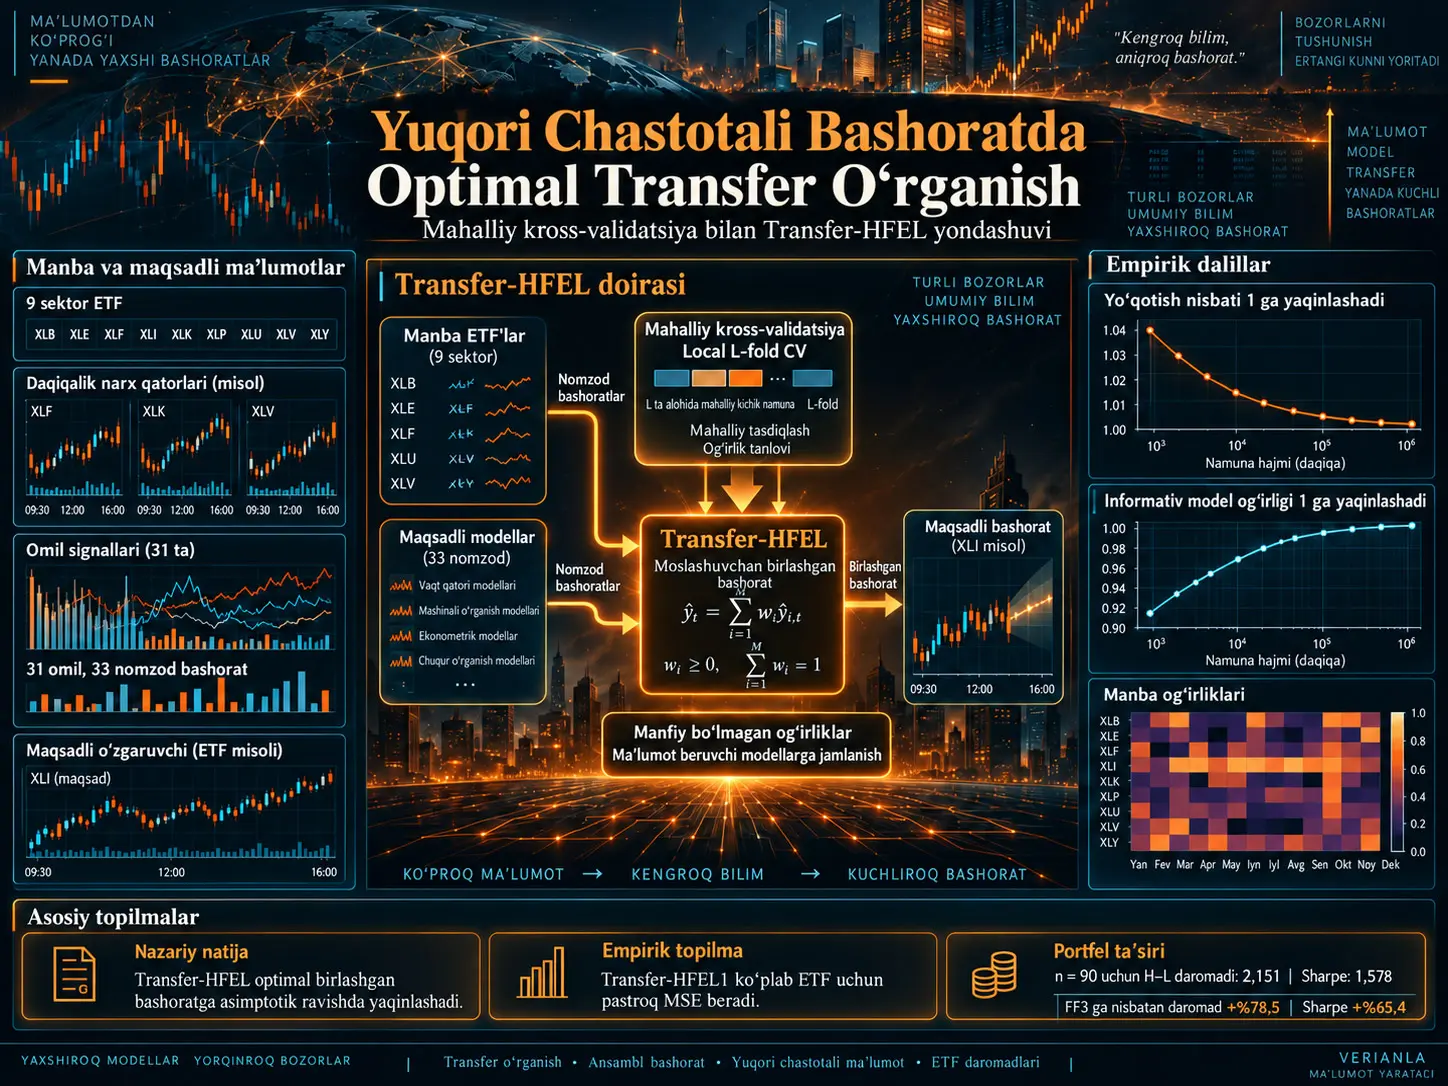
Yuqori Chastotali Ansambl O‘rganish orqali Transfer O‘rganish (Transfer Learning through High-Frequency Ensemble Learning; Transfer-HFEL) — maqsadli aktiv va turli manba aktivlardan yaratilgan bir nechta yuqori chastotali bashoratlarni mahalliy L-qavatli kross-validatsiya orqali tanlangan, manfiy bo‘lmagan va yig‘indisi birga teng og‘irliklar ostida birlashtiradigan transfer o‘rganish hamda ansambl bashoratlash doirasidir. Tadqiqot manba va maqsad populyatsiyalar turli ma’lumot hosil qilish jarayonlariga, turli axborot to‘plamlariga va noto‘g‘ri spetsifikatsiyalangan modellarga ega bo‘lishi mumkin bo‘lgan state-space tuzilmani quradi. Nazariy jihatdan barcha nomzod modellar noto‘g‘ri spetsifikatsiyalangan bo‘lsa ham Transfer-HFEL erishib bo‘lmaydigan optimal ansamblning bashorat yo‘qotishiga asimptotik ravishda yaqinlasha olishi; to‘g‘ri va informativ modellar mavjud bo‘lganda esa og‘irlik ushbu modellarda jamlanishi ko‘rsatiladi. To‘qqizta sektor ETFining 2015-yildagi daqiqalik chastotadagi daromadlari bo‘yicha qo‘llanmada usul ko‘p hollarda simple averaging, FULL, Fama–French uch omilli va Fama–French besh omil plus momentum kabi taqqoslashlarga nisbatan pastroq bashorat xatosini beradi. Tadqiqotning o‘z portfel tajribasida Transfer-HFEL1 ning \(n=90\) holatidagi yilliklashtirilgan H–L daromadi FF3 benchmark-idan taxminan %78,5; Sharpe nisbati esa taxminan %65,4 yuqori. Bu natijalar ko‘rsatilgan tanlanma va portfel dizayniga xos; kelajakdagi bozor natijalariga kafolat bermaydi.
Tadqiqotning g‘ayrioddiyroq topilmasi shundan iboratki, umumiy sistematik parametrlarni bevosita boshqa aktivlardan transfer qiladigan tuzilmadan ko‘ra, manba aktivlarda ishlatilgan tushuntiruvchi o‘zgaruvchilarga ortogonal bo‘lib qoladigan va klassik omillar tilida idiosyncratic komponentga o‘xshash axborotni transfer qilish kuchliroq bashorat yutuqlarini beradi. Mualliflar bu natijani klassik ma’noda “idiosyncratic risk premiyasining mavjudligi” deb talqin qilmaydi. Ehtimoliy izohlar qatoriga model misspecification, tez o‘zgaruvchi risk premiyalari, yetishmayotgan common factors hamda order-flow imbalance, bid–ask bounce, asynchronous trading va ETF arbitrage kabi mikrostruktura ishqalanishlari kiradi.
Muammo: Nega bitta yuqori chastotali bashorat modelini tanlash yetarli bo‘lmasligi mumkin?
Yuqori chastotali moliyaviy ma’lumotlarda ayni maqsad o‘zgaruvchi uchun ko‘plab maqbul bashorat modellarini tuzish mumkin. Modellar turli predictor to‘plamlaridan foydalanishi, boshqa aktivlardan axborot tashishi, turli econometric yondashuvlarga asoslanishi yoki maqsad va manba populyatsiyalar o‘rtasida haqiqiy cross-sectional heterogeneity mavjud bo‘lishi mumkin. Bunday holatda tadqiqotchining muammosi faqat “qaysi model eng yaxshi?” emas. Asosiy muammo har bir model olib keladigan foydali axborotni qanday og‘irliklar bilan birlashtirishdir.
Standart model averaging usullarining muhim qismi bitta populyatsiyaning past chastotali ma’lumotlari uchun ishlab chiqilgan. Transfer-HFEL esa geterogen populyatsiyalardan kelgan bashoratlarni bir xil ansambl ichida birlashtirishni maqsad qiladi va parametrlar doimiy bo‘lishi shart bo‘lmagan yuqori chastotali state-space tuzilishga ruxsat beradi.
Maqsad va manba populyatsiyalarning umumiy ma’lumot hosil qilish jarayoni
Maqsad ma’lumoti:
\[ \{Y^{(0)},V^{(0)}\}_{0\leq t\leq T} \]
va \(m=1,\ldots,M\) uchun manba ma’lumotlari:
\[ \{Y^{(m)},V^{(m)}\}_{0\leq t\leq T} \]
sifatida aniqlanadi.
m-chi populyatsiyaning yuqori chastotali increment-i:
\[ \Delta_i^nY^{(m)} = g^{(m)} \left( V_{t_{n,i}}^{(m)}, \theta_{t_{n,i}}^{(m)} \right) + Z_{n,i}^{(m)} + R_{n,i}^{(m)} \]
ko‘rinishidadir.
Bu yerda \(g^{(m)}(\cdot)\) kuzatilgan yoki latent feature-larni parametrlar bilan birlashtiradigan umumiy funksiyani; \(\theta^{(m)}\) vaqt davomida o‘zgarishi mumkin bo‘lgan parametr vektorini; \(Z^{(m)}\) martingale tipidagi xato komponentini; \(R^{(m)}\) esa kichikroq tartibli residual/discretization komponentini ifodalaydi.
State-space feature tuzilishi:
\[ V_{t_{n,i}}^{(m)} = \int V^{(m)} \left( \zeta_{t_{n,i}}, \epsilon_{t_{n,i}} \right) F_\epsilon(d\epsilon) \]
ko‘rinishida berilgan. \(\zeta_t\) latent jarayon, \(\epsilon_t\) vaqtinchalik i.i.d. shock va \(V^{(m)}(\cdot)\) kuzatiladigan feature-ni latent holatdan hosil qiladigan, ma’lum bo‘lishi shart bo‘lmagan o‘zgartirishdir.
Bu umumiy shakl faqat return regression uchun ishlatilmaydi. Tadqiqot doirasi trading volume, bid–ask spread, duration, turnover va boshqa yuqori chastotali o‘zgaruvchilarga ham qo‘llanadigan qilib tuzilgan.
High-frequency regression xususiy holati
Tadqiqotning birinchi misolida predictor increment-i umumiy Itô semimartingale hisoblanadi:
\[ V_{t_{n,i}}^{(m)}=\Delta_i^nX^{(m)} \]
va model continuous hamda jump komponentlariga ruxsat beradi:
\[ \Delta_i^nY^{(m)} = \left(\beta_{t_{n,i-1}}^{(m)}\right)^\top \Delta_i^nX^{(m)\circ} + \left(\ddot{\beta}_{t_{n,i-1}}^{(m)}\right)^\top \sum_{t_{n,i-1}\leq s\leq t_{n,i}} \Delta X_s^{(m)} + \Delta_i^nZ^{(m)} + R_{n,i}^{(m)} \]
Bu yerda continuous regressors va jump regressors uchun turli coefficient komponentlari mavjud. \(R_{n,i}^{(m)}\) discrete sampling sabab yuzaga keladigan approximation/discretization xatosini olib yuradi.
General feature xususiy holati
Ikkinchi misolda model lagged returns, trading volume, bid–ask spread, turnover va transaction-return autocovariance kabi bevosita kuzatiladigan, biroq shovqinli feature-lar bilan ishlashi mumkin:
\[ \Delta_i^nY^{(m)} = g^{(m)} \left( V_{t_{n,i}}^{(m)}, \theta_{t_{n,i}}^{(m)} \right) + Z_{n,i}^{(m)} \]
Bu tuzilma Transfer-HFEL faqat klassik chiziqli factor regression-ga bog‘lanib qolmaganini ko‘rsatadi.
Transfer-HFEL nima?
Transfer-HFEL maqsad populyatsiyadan ishlab chiqilgan muqobil bashoratlarni geterogen manba populyatsiyalardan transfer qilingan bashoratlar bilan bitta convex ensemble ichida birlashtiradi va ularning og‘irliklarini yuqori chastotali vaqtga bog‘liqlikni hisobga oladigan mahalliy L-qavatli kross-validatsiya mezoni orqali tanlaydi.
Nomzod bashoratlar qanday yaratiladi?
Tadqiqotda jami \(M+K\) ta bashorat mavjud. Ularning:
- \(M\) tasi manba domain-lardan keladi,
- \(K\) tasi maqsad domain-ning turli predictor modellaridan keladi.
m-chi nomzod bashorat umumiy ko‘rinishda:
\[ \Delta_i^n\widehat{Y}^{(0)}_m \]
bilan ifodalanadi.
Manba modellarda avval manba ma’lumotlari asosida parametr baholanishi va olingan axborot target domain bashoratiga ko‘chirilishi mumkin. Target modellarda esa turli predictor quyi to‘plamlaridan foydalanib model-selection uncertainty ansamblga kiritiladi.
Ansambl og‘irliklari
Og‘irlik vektori:
\[ w\in\mathcal W \]
va:
\[ \mathcal W= \left\{ w\in[0,1]^{M+K}: \sum_{m=0}^{M+K-1}w^{(m)}=1 \right\} \]
ko‘rinishida cheklanadi.
Demak, har bir og‘irlik manfiy bo‘la olmaydi va barcha og‘irliklar yig‘indisi birga teng.
Birlashtirilgan forecast:
\[ \Delta_i^n\widehat{Y}^{(0)}(w) = \sum_{m=0}^{M+K-1} w^{(m)} \Delta_i^n\widehat{Y}^{(0)}_m \]
ko‘rinishidadir.
Bu constraint-lar modelning manba signalini teskari ishorali cheksiz hedge sifatida ishlatishiga yo‘l qo‘ymaydi. Usul buning o‘rniga foydali axborot tashuvchi manbalarga musbat og‘irlik taqsimlashga harakat qiladi.
Transfer-HFEL1: idiosyncratic/orthogonal komponent transferi
Tadqiqotning empirik qo‘llanmasidagi birinchi transfer turi manba aktivining o‘z regressors-lari bilan tushuntirilmaydigan komponentini maqsad bashoratiga olib o‘tuvchi tuzilmadir:
\[ h= \Delta_i^nY^{(m)} - \left( \widehat{\beta}_{t_{n,i}}^{(m)} \right)^\top \Delta_i^nX^{(m)} \,1_{\{ \|\Delta_i^nX^{(m)}\| \leq u_n^{(m)} \}} \]
Bu komponent manba regression-ining conditioning variables-lariga ortogonal bo‘lib qolgan axborot sifatida talqin qilinadi. Maqola buni klassik asset-pricing terminologiyasidagi diversifiable yoki idiosyncratic risk komponentiga o‘xshatadi.
Transfer-HFEL2: parameter transfer
Ikkinchi yondashuv manbada baholangan parametrlarni maqsad aktivining predictor-lariga qo‘llaydi:
\[ h= \left( \widehat{\beta}_{t_{n,i}}^{(m)} \right)^\top \Delta_i^nX^{(0)} \,1_{\{ \|\Delta_i^nX^{(0)}\| \leq u_n^{(0)} \}} \]
Bu tuzilma umumiy yoki systematic axborotni parametr orqali transfer qilishni ifodalaydi.
Ikki yondashuv o‘rtasidagi farq muhim: Transfer-HFEL1 manba aktivining target predictors orqali bevosita ifodalanmagan residual/cross-sectional axborotini tashiydi, Transfer-HFEL2 esa ko‘proq umumiy coefficient tuzilishini target-ga qo‘llashga tayanadi.
Mahalliy L-Qavatli Kross-Validatsiya nega kerak?
Mahalliy L-qavatli kross-validatsiya yuqori chastotali ma’lumotlarda random yoki butun tanlanmani qamrab oluvchi global fold-lar vaqt bog‘liqligi va o‘zgaruvchan covariance tuzilishini buzishi mumkinligi sababli validatsiyani qisqa va bir-biriga yaqin vaqt bloklari ichida amalga oshiradi; shu orqali fold-larning taxminan bir xil mahalliy ma’lumot hosil qilish jarayonidan kelishi ko‘zlanadi.
Standart cross-validation muammosi
Past chastotali mashinali o‘rganishda kuzatuvlarni tasodifiy train va validation guruhlariga ajratish ko‘pincha qabul qilinadi. Ammo high-frequency returns:
- serial dependence,
- volatility clustering,
- time-varying covariance,
- microstructure noise,
- asynchronous observation
kabi tuzilmalarga ega bo‘lishi mumkin.
Tasodifiy bo‘linish vaqt bo‘yicha yaqin, o‘zaro bog‘liq kuzatuvlarni ajratib yuborishi va validation setining kelajakda haqiqatan uchraydigan sharoitlarni ifodalashini qiyinlashtirishi mumkin. Juda uzun global folds esa o‘zgarayotgan bozor rejimlarini bitta DGP sifatida qabul qilish xavfini oshiradi.
Local L-fold tuzilishi
Usul avval \([0,T]\) intervalini \(H_n\) ta mahalliy vaqt blokiga ajratadi. Har bir blokning vaqt kengligi asimptotik ravishda qisqararkan, blok boshiga observation soni \(k_n\) miqdorida o‘sadi.
Har bir mahalliy blok keyin \(L\) fold-ga bo‘linadi.
j-chi blok va p-chi fold uchun model shu blokdagi p-chi fold chiqarib tashlangan holda baholanadi. Validation error faqat shu mahalliy fold ustida hisoblanadi.
Cross-validation criterion:
\[ CV(w) = \sum_{j=1}^{H_n} \sum_{p=1}^{L} \sum_i \left( \Delta_i^n\widetilde{Y}^{(0)}_{[j,-p]}(w) - \Delta_i^nY^{(0)}_{[j,p]} \right)^2 \]
ko‘rinishidadir.
\(\Delta_i^n\widetilde{Y}^{(0)}_{[j,-p]}(w)\) p-chi validation fold chiqarilganda olingan target-side forecast-larning og‘irlikli kombinatsiyasidir.
Muhim texnik tafsilot: local L-fold jarayoni target data ustida qo‘llanadi. Source-domain parameter estimates target-ning p-chi fold-i chiqarilgani uchun qayta hisoblanmaydi; chunki bu fold source data tarkibiga kirmaydi.
Mahalliylikning statistik maqsadi
Local windows fold-larning bir xil qisqa muddatli covariance rejimiga yaqinroq bo‘lishini ta’minlaydi. Tadqiqot yondashuvi yuqori chastotali bozorda uzoq davr davomida global stationarity faraz qilish o‘rniga qisqa muddatli conditional stationarity-dan foydalanadi.
Asimptotik optimallik nimani anglatadi?
Transfer-HFEL ning asimptotik optimalligi tanlanma zichlashgani sari local cross-validation orqali tanlangan og‘irliklar yaratgan ansamblning quadratic prediction loss-i, haqiqiy ma’lumot hosil qilish jarayoni ma’lum bo‘lganida tanlanishi mumkin bo‘lgan infeasible optimal og‘irliklar loss-iga nisbatan ehtimollikda 1 ga yaqinlashishini anglatadi.
Prediction loss
Tadqiqot bashorat samaradorligini:
\[ L(w) = \sum_{i=k_n+1}^{n} \left( \Delta_i^n\widehat Y^{(0)}(w) - \Delta_i^n\mu^{(0)} \right)^2 \]
bilan o‘lchaydi.
Bu yerdagi \(\Delta_i^n\mu^{(0)}\) target DGP-ning bashorat qilinadigan/predictable komponentidir.
Theorem 1: infeasible minimum loss uchun quyi chegara
Barcha candidate models misspecified bo‘lganda tadqiqot ayrim regularity conditions ostida infeasible minimum loss-ning degenerativ ravishda nolga ketishiga yo‘l qo‘ymaydigan musbat quyi chegarani oladi. Bu texnik natija keyingi asymptotic-optimality isbotini qurishga yordam beradi.
Theorem 2: optimality
Asosiy natija:
\[ \frac{ L(\widehat w) }{ \inf_{w\in\mathcal W}L(w) } \xrightarrow{p}1 \]
ko‘rinishidadir.
Boshqacha aytganda, candidate modellarning barchasi turli darajada noto‘g‘ri bo‘lsa ham local-CV og‘irlikli ansambl asimptotik ravishda mavjud candidate set ichidagi eng yaxshi erishib bo‘lmaydigan kombinatsiyaning riskiga yaqinlashadi.
Bu “Transfer-HFEL haqiqiy DGP-ni aniq topadi” degani emas. Optimallik candidate forecast oilasidagi quadratic-loss benchmark-ga nisbatan belgilanadi.
Theorem 3: informativ modellarning og‘irligi
Target model to‘g‘ri spetsifikatsiyalangan va target bilan bir xil pseudo-true parameter axborotini bo‘lishadigan informative models to‘plami \(\mathcal D\) bo‘lsin.
Ushbu modellarga berilgan jami og‘irlik:
\[ \tau= \sum_{m\in\mathcal D}w^{(m)} \]
va uning bahosi:
\[ \widehat\tau= \sum_{m\in\mathcal D}\widehat w^{(m)} \]
bo‘lsa, tadqiqot:
\[ \widehat\tau\xrightarrow{p}1 \]
natijasini oladi.
Ya’ni tanlanma kattalashgani sari ansamblning jami og‘irligi informativ modellarga jamlanadi. Juda farqli yoki foydasiz manbalarning og‘irligi asimptotik ravishda nolga yaqinlashishi mumkin.
Bitta to‘g‘ri model xususiy holati
Bu natijaning tabiiy oqibati: faqat bitta model to‘g‘ri bo‘lsa, usul asimptotik ravishda barcha og‘irlikni o‘sha modelga berishga yaqinlashadi. Shu tariqa transfer learning-ning potensial negative-transfer xavfi og‘irlik tanlash orqali cheklanishga harakat qilinadi.
Theorem 4: parameter consistency
Eng katta target model to‘g‘ri spetsifikatsiyalanganida shared-parameter estimator uchun manba:
\[ \left\| \widehat\beta_t(\widehat w) - \beta^{(0)}_{t-\Delta_n} \right\| = O_p \left( k_n^{1/2}\Delta_n^{1/2} + k_n^{-1/2} \right) \]
tezlikni beradi.
Tadqiqot foydalanadigan small-window scheme ostida:
\[ k_n\asymp\Delta_n^{-\varsigma}, \qquad \varsigma<\frac12 \]
va ustun xato hadi:
\[ O_p(k_n^{-1/2}) \]
bo‘ladi.
Bu nazariy natijalarning chegarasi
Barcha asimptotik natijalar tadqiqotda berilgan regularity conditions ostida amal qiladi. Moliyaviy qo‘llanmada “teorema bor, demak usul har bir bozor rejimida yaxshiroq bashorat qiladi” degan xulosa chiqarib bo‘lmaydi. Finite-sample xulqi alohida simulyatsiya va real ma’lumot qo‘llanmasida tekshiriladi.
Tadqiqot Usuli va Natijalari
Monte Carlo dizayni
Tadqiqot avval finite-sample xulqini ikki ma’lumot hosil qilish jarayoni orqali tahlil qiladi.
DGP1 — to‘liq transfer qilinadigan tuzilma:
\[ dY_t^{(m)} = \left( \beta_t^{(m)}+\delta_m \right)^\top dX_t^{(m)} + Z_t^{(m)} \]
DGP2 — qisman transfer qilinadigan tuzilma:
\[ dY_t^{(m)} = \left( \beta_t^{(m)}+\delta_m \right)^\top dX_t^{(m)} + \left( \alpha_t^{(m)} \right)^\top dU_t^{(m)} + Z_t^{(m)} \]
DGP2 da \(\beta_t^{(m)}\) populyatsiyalar o‘rtasida transfer qilinadi, \(\alpha_t^{(m)}\) esa model-specific axborot tashiydi.
Predictor va residual jarayonlar continuous diffusion va jump komponentlarini birgalikda o‘z ichiga oladi. Volatility jarayonlari Cox–Ingersoll–Ross tipidagi dynamics bilan, jump sizes esa double-exponential taqsimot bilan modellashtirilgan.
| Element | Manbada ishlatilgan qiymat/tuzilma |
|---|---|
| Asosiy predictor o‘lchami | d = 40 |
| Manba model soni M | 3, 5, 7 |
| Sample size n | 3600, 8800, 12300, 17600, 21100 |
| Sampling tuzilishi | 1 daqiqalik chastota |
| Manba-target parameter shift | \(\delta_m=0.1(m-1)(-1)^m\) |
| Predictor jump intensity | \(\lambda_X^J=7\) |
| DGP2 U jump intensity | \(\lambda_U^J=6\) |
| Residual jump intensity | \(\lambda_Z^J=14\) |
Manbadagi simulyatsiya ta’rifidagi nomuvofiqlik
Simulyatsiya ssenariylarini raqamlashda manba matnining o‘zida nomuvofiqlik mavjud. Dastlabki ta’rifda Scenario 1 target model correctly specified, Scenario 2 target model misspecified deb yozilgan. Keyingi natija paragrafida esa bu ikki scenario raqami teskari qo‘llanadi. Rasm sarlavhalari shartni bevosita “model misspecification” va “target model correctly specified” deb bergani uchun Verianla bayonida ilmiy shart asos qilib olingan, scenario raqami qat’iylashtirilmagan.
Bundan tashqari, asosiy matnda misspecified target 40 predictor-ning so‘nggi uchta komponentini chiqarib 37 o‘lchamga tushirilgani aytilsa, simulyatsiya parametrlar jadvali izohida misspecified holatda so‘nggi beshta komponent chiqarilgani yozilgan. Manba bu farqni tushuntirmaydi.
1-rasm: oracle loss-ga yaqinlashish
Manbaning 26-sahifasidagi 1-rasm model misspecification ostida:
\[ \frac{ L(\widehat w) }{ \inf_w L(w) } \]
nisbatini sample size-ga qarshi ko‘rsatadi.
DGP1 va DGP2 hamda \(M=3,5,7\) konfiguratsiyalarining barchasida nisbat tanlanma kattalashgani sari 1 ga yaqinlashadi. Manbadagi misolda DGP2 va \(M=5\) uchun nisbat \(n=3600\) da taxminan 1,020 bo‘lsa, \(n=21100\) da 1,001 dan pastga tushadi.
Bu naqsh Theorem 2 dagi asymptotic optimality natijasiga mos keladi.
2-rasm: informativ model og‘irliklari
27-sahifadagi 2-rasm target model correctly specified bo‘lganda informativ modellarga berilgan jami og‘irlikni ko‘rsatadi.
Barcha simulyatsiya konfiguratsiyalarida og‘irlik tanlanma kattalashgani sari 1 ga yaqinlashadi. Manba misolida DGP2, \(M=3\) holatida informative-weight yig‘indisi \(n=8800\) da 0,95 dan oshadi va kattaroq tanlanmalarda 1 ga yaqinlashadi.
Bu topilma Theorem 3 ning finite-sample ekvivalenti sifatida talqin qilinadi.
Real ma’lumot: to‘qqizta sektor ETFi
Empirik tadqiqot 2015-yil yanvar–dekabr oralig‘idagi AQShning to‘qqizta sektor ETFining daqiqalik log daromadlaridan foydalanadi.
| Kod | Sektor |
|---|---|
| XLB | Materials |
| XLE | Energy |
| XLF | Financials |
| XLI | Industrials |
| XLK | Technology |
| XLP | Consumer Staples |
| XLU | Utilities |
| XLV | Healthcare |
| XLY | Consumer Discretionary |
Har bir ETF target sifatida tanlanganda qolgan sakkizta ETF source domain vazifasini bajaradi.
31 predictor/factor
Model jami 31 exogenous factor ishlatadi. Ularning 25 tasi tadqiqotning factor-zoo to‘plamidan, oltitasi Fama–French five-factor-plus-momentum tuzilmasidan keladi.
Omillar asosan:
- Size,
- Profitability,
- Low Risk,
- Leverage
toifalariga ajratilgan.
Manba jadvalida short interest, cash-flow-to-price variance, pension funding status, operating profitability, R&D capital-to-assets, Altman Z-score, market beta, downside beta, return volatility, turnover va zero-trade o‘lchovlari kabi o‘zgaruvchilar mavjud.
Omillar return chastotasiga moslashtirish uchun log o‘zgartirish va differencing amallaridan o‘tkaziladi.
33 ta nomzod bashorat qanday hosil bo‘ladi?
Har bir target ETF uchun candidate set:
- barcha 31 omildan foydalanadigan 1 ta target FULL model,
- 8 ta source-ETF model,
- 24 ta target-domain subset model
bo‘lib, jami:
33 ta bashorat
ni o‘z ichiga oladi.
24 subset model:
- 12 single-factor,
- 4 three-factor,
- 4 five-factor,
- 4 ten-factor
modeldan iborat.
Taqqoslangan usullar
Empirik qo‘llanma:
- Transfer-HFEL1,
- Transfer-HFEL2,
- SA1,
- SA2,
- FULL,
- Fama–French uch omil (FF3),
- Fama–French five-factor plus momentum (FF5P1)
usullarini taqqoslaydi.
SA1 va SA2 tegishli Transfer-HFEL candidate setlarining equal-weight versiyalaridir. Shu tariqa optimal og‘irlik tanlash qiymatini ishlatilgan modellarning faqat diversifikatsiyasidan ajratishga harakat qilinadi.
Yo‘qolgan ma’lumot tajribasi
Covariates missing completely at random farazi ostida:
\[ p\in\{0,\ 25\%,\ 45\%,\ 65\%\} \]
missing ulushlari ishlatilgan.
Turli target domain-lar turli observation yo‘qotishlariga ega bo‘ladigan qilib asynchronous missing pattern yaratiladi. Parameter estimation uchun complete-case analysis qo‘llanadi.
Transfer-HFEL bashorat aniqligi
Manba natijalariga ko‘ra Transfer-HFEL usullari ayni candidate setlardan foydalanadigan simple averaging usullaridan ko‘p ETF va missing-rate holatlarida yaxshiroq natija ko‘rsatadi.
Missing data bo‘lmaganda Transfer-HFEL1 ning SA1 ga nisbatan MSE yaxshilanishlari manba matnida taxminan:
%15,9–%49,2
oralig‘ida berilgan.
Transfer-HFEL2 ning SA2 ga nisbatan yutuqlari esa:
%10,0–%15,7
oralig‘idadir.
Manba shuningdek %45 missing-rate holatida simple averaging-ga nisbatan ayrim target-larda taxminan %52 gacha yaxshilanishni qayd etadi.
Tanlangan MSE natijalari
| Missing | Target | Transfer-HFEL1 | SA1 | Transfer-HFEL2 | FULL | FF3 |
|---|---|---|---|---|---|---|
| 0% | XLB | 0.820 | 1.347 | 1.364 | 1.162 | 1.458 |
| 0% | XLI | 0.479 | 0.914 | 0.963 | 0.861 | 1.110 |
| 0% | XLY | 0.517 | 1.017 | 1.052 | 0.941 | 1.204 |
| 45% | XLI | 0.220 | 0.447 | 0.435 | 0.713 | 0.566 |
| 45% | XLY | 0.239 | 0.499 | 0.472 | 0.772 | 0.616 |
| 65% | XLB | 0.556 | 0.951 | 0.897 | 1.405 | 1.079 |
| 65% | XLK | 0.444 | 0.865 | 0.823 | 1.295 | 1.008 |
| 65% | XLY | 0.344 | 0.726 | 0.685 | 1.111 | 0.885 |
Jadvaldagi absolute MSE darajalarini turli missing-rate satrlari o‘rtasida oddiygina “yo‘qolgan ma’lumot oshgani sari MSE pasaydi/oshdi” deb talqin qilish o‘rniga, manba tadqiqot qilganidek ayni missing-rate ichidagi usul taqqoslashlariga e’tibor qaratish kerak.
Idiosyncratic axborot transferi nega Common-Parameter transferidan muvaffaqiyatliroq bo‘lishi mumkin?
Tadqiqotning ETF qo‘llanmasida Transfer-HFEL1 source aktivlarning factor regressors-ga ortogonal qoladigan komponentlaridan cross-sectional axborotni tashiydi, Transfer-HFEL2 esa asosan umumiy parameter axborotini target-ga transfer qiladi; Transfer-HFEL1 ning pastroq MSE berishi ushbu residual komponent model misspecification, vaqt o‘tishi bilan o‘zgaruvchi risk premiyalari yoki market-microstructure ta’sirlari sababli bashorat uchun foydali axborot saqlashi mumkinligini ko‘rsatadi.
4-jadvaldagi bevosita taqqoslash
Manba 4-jadvalining “Gain (%)” ustuni Transfer-HFEL1 ning Transfer-HFEL2 ga nisbatan MSE ustunligini ko‘rsatadi. Masalan:
- XLB, missing %0: %39,9,
- XLI, missing %0: %50,3,
- XLY, missing %0: %50,8,
- XLK, missing %45: %46,5,
- XLY, missing %65: %49,8.
Bu taqqoslashlar tadqiqot qo‘llanmasida idiosyncratic-component transferi parameter-transfer versiyasidan kuchliroq ekanini ko‘rsatadi.
Weight heatmap-lar nimani ko‘rsatadi?
Manbaning 28-sahifasidagi 3-rasm Transfer-HFEL1, 29-sahifasidagi 4-rasm esa Transfer-HFEL2 og‘irliklarini target ETF va oy bo‘yicha ko‘rsatadi.
Og‘irliklar source ETF-lar o‘rtasida teng emas; target va oyga qarab sezilarli darajada o‘zgaradi. Masalan, XLE target bo‘lganda XLB ga berilgan og‘irlik ko‘plab oyda ancha yuqori ko‘rinadi. Manba XLE bashoratida XLB og‘irligi o‘n ikki oyning to‘qqiztasida 0,4 dan yuqori ekanini bildiradi.
2015-yil yanvar misolida XLE target bo‘lganda:
Transfer-HFEL1 → XLB og‘irligi 0,76
Transfer-HFEL2 → XLB og‘irligi 0,33
deb berilgan.
Har ikki usul ayni source ETF ni eng yuqori og‘irlik bilan tanlaydi, ammo og‘irlik magnitude-i keskin farq qiladi.
Mualliflarning iqtisodiy izohi
Energiya exploration va extraction faoliyatlari material input-larga bog‘liq; energiya va materials sektorlarida upstream–downstream aloqalar bo‘lishi mumkin. Shu sabab XLB manba axborotining XLE daromadlari uchun leading information olib kelishi iqtisodiy jihatdan mantiqiy deb ko‘rilishi mumkin.
Biroq tadqiqot bu misolni sababiy ishlab chiqarish zanjiri testi sifatida qurmaydi. Weight pattern bilan iqtisodiy sektor munosabati o‘rtasida talqin qilinadi.
Bu topilma klassik asset pricing-ga haqiqatan zidmi?
Birinchi qarashda idiosyncratic komponentning bashoratda foydaliroq bo‘lishi diversified idiosyncratic risk risk premiyasini olib yurmasligi kerak degan standart asset-pricing yondashuvi bilan ziddiyatli ko‘rinishi mumkin.
Manba uch izohga e’tibor qaratadi.
1. Model misspecification
31 omilning muhim qismi low-frequency characteristics kelib chiqishiga ega. High-frequency return dynamics uchun muhim ayrim common factors umuman modelga kiritilmagan bo‘lishi mumkin. Bunday holda regression residual-da ko‘rinadigan “idiosyncratic” axborot aslida omitted systematic information olib yurishi mumkin.
2. Time-varying risk premia
Historically estimated factor loadings risk exposure-ni ko‘rsatishi mumkin, ammo shu riskning oniy compensation qiymati qanday o‘zgarishini to‘liq ko‘rsatmaydi. High-frequency return dynamics tez o‘zgaruvchi risk premia ta’sirida bo‘lsa, cross-sectional residual komponentlar bu dinamikning bir qismini olib yurishi mumkin.
3. Market microstructure
Order-flow imbalance, bid–ask bounce, asynchronous trading va ETF arbitrage pressures past chastotali characteristics-larga ortogonal, lekin cross-sectionally correlated vaqtinchalik narx harakatlarini yaratishi mumkin. Factor regression ularni “idiosyncratic” deb tasniflasa ham, ular qisqa ufqli bashorat uchun foydali bo‘lishi mumkin.
Tadqiqot ushbu uch izohdan qaysi biri ustunligini alohida identification dizayni bilan ko‘rsatmaydi. Bular empirik topilmaning ehtimoliy mexanizmlaridir.
Missing data ostida source information
Manba target covariates yetishmaganda source data ning nisbiy qiymati oshishini ko‘rsatadi. Masalan, XLB uchun FULL modelga qarshi Transfer-HFEL1 MSE yaxshilanishi missing ulushi %25–%65 oralig‘ida taxminan %59,4–%60,4 sifatida beriladi. Shu target uchun FF3 ga nisbatan yaxshilanish taxminan %47,3–%48,5.
Bu natija target domain dagi observation soni kamayganda yaqin yoki bog‘liq source domain-lardan axborot transfer qilish bashorat xatosini kamaytirishi mumkinligi tarzida talqin qilinadi.
Iqtisodiy samaradorlik tajribasi
Tadqiqotning ikkinchi empirik qatlami sektor ETF-laridan individual aksiya daromadlariga o‘tadi. Jami 80 aksiya navbatma-navbat target asset sifatida tanlanadi. Target aksiyaning o‘z sektor ETFi source set dan chiqariladi va qolgan sakkiz sektor ETFi source dataset sifatida ishlatiladi.
Har bir estimation window ichida stock-return predictions hisoblanadi va aksiyalar bashoratlari bo‘yicha 10 decile portfolio ga ajratiladi.
Low eng past bashorat qilingan daromadli decile, High esa eng yuqori bashorat qilingan daromadli decile hisoblanadi.
Long-short natija:
\[ H-L = R_{\mathrm{High}} - R_{\mathrm{Low}} \]
ko‘rinishida hisoblanadi.
Manba 5-jadvalda:
- \(k_n=30\),
- \(L=5\),
- missing rate = %70,
- forecast horizon uchun \(n=40\) va \(n=90\)
sozlamalarini beradi.
n = 40 portfel natijalari
| Usul | Annualized return, H–L (\(\times10^{-2}\)) | Annualized Sharpe |
|---|---|---|
| Transfer-HFEL1 | 1.586 | 1.566 |
| SA1 | 0.858 | 0.919 |
| Transfer-HFEL2 | 1.421 | 1.409 |
| SA2 | 1.411 | 1.504 |
| FF3 | 1.035 | 1.132 |
| FF5P1 | 1.248 | 1.333 |
n = 90 portfel natijalari
| Usul | Annualized return, H–L (\(\times10^{-2}\)) | Annualized Sharpe |
|---|---|---|
| Transfer-HFEL1 | 2.151 | 1.578 |
| SA1 | 1.154 | 0.883 |
| Transfer-HFEL2 | 2.085 | 1.531 |
| SA2 | 1.939 | 1.478 |
| FF3 | 1.205 | 0.954 |
| FF5P1 | 1.662 | 1.282 |
n=90 holatida manba:
\[ \frac{2.151-1.205}{1.205} \approx 78.5\% \]
annualized-return improvement va:
\[ \frac{1.578-0.954}{0.954} \approx65.4\% \]
Sharpe improvement ni qayd etadi.
Ushbu foiz taqqoslashlari FF3 benchmark ga nisbatan. Jadval return satrlari masshtabini \(10^{-2}\) deb bergani uchun Verianla matnida 2,151 raqami bevosita “%215,1 daromad” deb qayta talqin qilinmagan.
Bu portfel natijasi nimani anglatadi?
Natija tadqiqot belgilagan sample, prediction horizon, missingness dizayni, stock sorting va long-short portfolio usuli ostida Transfer-HFEL1 bashoratlari kuchliroq cross-sectional ranking axborotiga ega ekanini ko‘rsatadi.
Natija quyidagilarni o‘z-o‘zidan ko‘rsatmaydi:
- tranzaksiya xarajatlaridan keyin ayni samaradorlik saqlanishini,
- slippage va market impact ahamiyatsiz ekanini,
- 2015-yildan tashqari bozor davrlarida ayni natijani,
- boshqa asset class-larda ayni samaradorlikni,
- kelajakdagi Sharpe nisbati 1,578 bo‘lishini.
Manba jadvalida transaction-cost yoki live-execution qatlami berilmagan. Shu sabab iqtisodiy samaradorlik tadqiqot tuzgan portfolio-return tajribasi doirasida talqin qilinishi kerak.
Tadqiqot qo‘llab-quvvatlaydigan natijalar
- Geterogen manba va maqsad forecast-larni local-CV asosidagi ansambl ichida birlashtiradigan Transfer-HFEL nazariy jihatdan ta’riflanishi mumkin.
- Ko‘rsatilgan regularity conditions ostida candidate modellar misspecified bo‘lganda Transfer-HFEL asymptotically optimal loss ga yaqinlashadi.
- Informative modellar mavjud bo‘lganda jami og‘irlik asimptotik ravishda ushbu modellarga jamlanadi.
- Monte Carlo natijalari nazariy convergence naqshlarini finite sample da qo‘llab-quvvatlaydi.
- 2015-yilgi to‘qqiz-sector-ETF qo‘llanmasida Transfer-HFEL ko‘plab taqqoslashlarda simple averaging va factor benchmarks ga nisbatan pastroq MSE beradi.
- Target data kamayganda source-domain axborotining nisbiy foydasi ayrim target-larda sezilarli ravishda ortadi.
- Tekshirilgan qo‘llanmada idiosyncratic-component transferi parameter transferidan yuqoriroq forecast gains beradi.
- 80-stock portfolio tajribasida Transfer-HFEL1 berilgan dizayn ostida FF3 va boshqa benchmark-larga nisbatan yuqoriroq H–L return va Sharpe qiymatlarini hosil qiladi.
Tadqiqot qo‘llab-quvvatlamaydigan natijalar
- Transfer-HFEL barcha moliya bozorlarida va barcha davrlarda eng yaxshi forecast usuli ekani ko‘rsatilmagan.
- Idiosyncratic risk klassik asset-pricing ma’nosida sistematik tarzda narxlanishi isbotlanmagan.
- Transfer-HFEL1 muvaffaqiyatining aniq mexanizmi model misspecification, time-varying risk premium yoki microstructure o‘rtasida ajratilmagan.
- Portfel natijalari live trading execution yoki net transaction-cost samaradorligi emas.
- Asimptotik optimallik finite sample da xatosiz bashorat degani emas.
- Informative source-larning iqtisodiy sababiyligini weight heatmap-lardan o‘z-o‘zicha chiqarib bo‘lmaydi.
- Yo‘qolgan ma’lumot natijalari missing-not-at-random yoki arbitrary missingness tuzilmalari uchun bevosita dalil emas; empirik tajriba MCAR tartibidan foydalanadi.
Qo‘llanish sohalari va kelajak tadqiqotlar
Manba Transfer-HFEL high-frequency return prediction dan tashqari:
- new-product pricing,
- portfolio optimization,
- factor selection,
- yetarli tarixiy ma’lumotga ega bo‘lmagan yangi moliyaviy mahsulotlarni bashoratlash
kabi sohalarga kengaytirilishi mumkinligini bildiradi.
Yangi listlangan equities, novel derivatives yoki emerging cryptocurrency pairs kabi aktivlarda target history qisqa bo‘lishi mumkin, bog‘liq aktivlar esa uzoqroq ma’lumot tarixini berishi mumkin. Shuningdek asynchronous trading va irregular observations source-target tanlanma hajmlariga turlicha ta’sir qilishi mumkin. Mualliflar bu muammolar Transfer-HFEL kelajakda kengaytirilishi mumkin bo‘lgan yo‘nalishlar ekanini ta’kidlaydi; joriy tadqiqot bu kengaytmalarni amalga oshirmaydi.
Manba va Usul Izohi
Asl tadqiqot:Optimal Transfer Learning for High-Frequency Prediction by Local Cross-validation.
Mualliflar: Dachuan Chen; Jia Li; Yuying Sun; Yue Tang.
Corresponding author: Yuying Sun.
Muassasalar: Dachuan Chen va Jia Li — School of Economics, Singapore Management University. Yuying Sun va Yue Tang — State Key Laboratory of Mathematical Sciences, Academy of Mathematics and Systems Science, Chinese Academy of Sciences; School of Economics and Management, University of Chinese Academy of Sciences.
Platforma: SSRN.
SSRN DOI: 10.2139/ssrn.7189238.
Bibliografik sana: SSRN qaydida Date Written 27 iyul 2026; Posted 6 avgust 2026.
Manba turi: Tadqiqot maqolasi/preprint. Ko‘rib chiqilgan bibliografik qaydda hakamlikdan o‘tgan jurnal nashri tasdiqlanmagan.
Litsenziya/mualliflik huquqi holati: SSRN qaydi ochiq Creative Commons qayta foydalanish litsenziyasini bermaydi va qayta foydalanish uchun ruxsat talab qilinishini bildiradi. Shu sabab Verianla matni manba tadqiqotdagi gap, paragraf, rasm yoki original jadval taqdimotini ko‘chirmaydi. Ilmiy faktlar, usul, matematika va natijalar mustaqil ta’limiy tuzilishda bayon qilinadi.
Moliyalashtirish: Dachuan Chen uchun Singapore Ministry of Education Tier 1 Grant No. 24-SOE-SMU-042 va National Natural Science Foundation of China Grant No. 12571515; Jia Li uchun Singapore Ministry of Education Tier 2 Grant T2EP40124-0021; Yuying Sun uchun Beijing Natural Science Foundation Grant JQ25030 va NSFC Grant Nos. 72322016 va 72073126 manbada ko‘rsatilgan.
Empirik ma’lumot: Asosiy ETF qo‘llanmasi 2015-yil yanvar–dekabr oralig‘idagi to‘qqiz sektor ETFining minute-level log returns ma’lumotlaridan foydalanadi. 31 exogenous factor va har bir target uchun 33 candidate forecast hosil qilinadi.
Simulyatsiya: DGP1 va DGP2 diffusion, CIR-type variance dynamics va jump komponentlarini o‘z ichiga oladigan high-frequency regression jarayonlaridir. Source model soni \(M=3,5,7\), sample size \(n=3600,8800,12300,17600,21100\) qiymatlarida o‘rganilgan.
Asosiy nazariy natija: Ko‘rsatilgan regularity conditions ostida Transfer-HFEL ning quadratic prediction loss-i candidate set ichidagi infeasible optimal combination loss-ga asimptotik ravishda yaqinlashadi. Correctly specified/informative modellar mavjud bo‘lganda og‘irliklar ushbu modellarga jamlanadi.
Asosiy empirik natija: Tekshirilgan ETF qo‘llanmasida Transfer-HFEL1 ko‘p taqqoslashlarda pastroq MSE ko‘rsatadi; idiosyncratic/orthogonal source information transferi parameter transferidan muvaffaqiyatliroq ko‘rinadi.
Iqtisodiy natija chegarasi: Manba portfolio returns va Sharpe ratios hisobot qiladi, biroq bu bo‘lim live execution, market impact va batafsil transaction-cost backtest sifatida loyihalanmagan. Shu sabab natijalar belgilangan tadqiqot portfelining samaradorlik o‘lchovlaridir.
Manba ichidagi nomuvofiqliklar: Simulyatsiyada Scenario 1/Scenario 2 ning correctly specified va misspecified holatlarga biriktirilishi natija paragrafida dastlabki ta’rifga nisbatan teskari ishlatilgan. Bundan tashqari misspecified target dan uch predictor yoki besh predictor chiqarilgani bo‘yicha asosiy matn va Table 1 izohi mos kelmaydi. Bu nuqtalar yashirincha tuzatilmagan.
Izoh qoldiring
E-pochta manzilingiz chop etilmaydi. Majburiy maydonlar * bilan belgilangan