

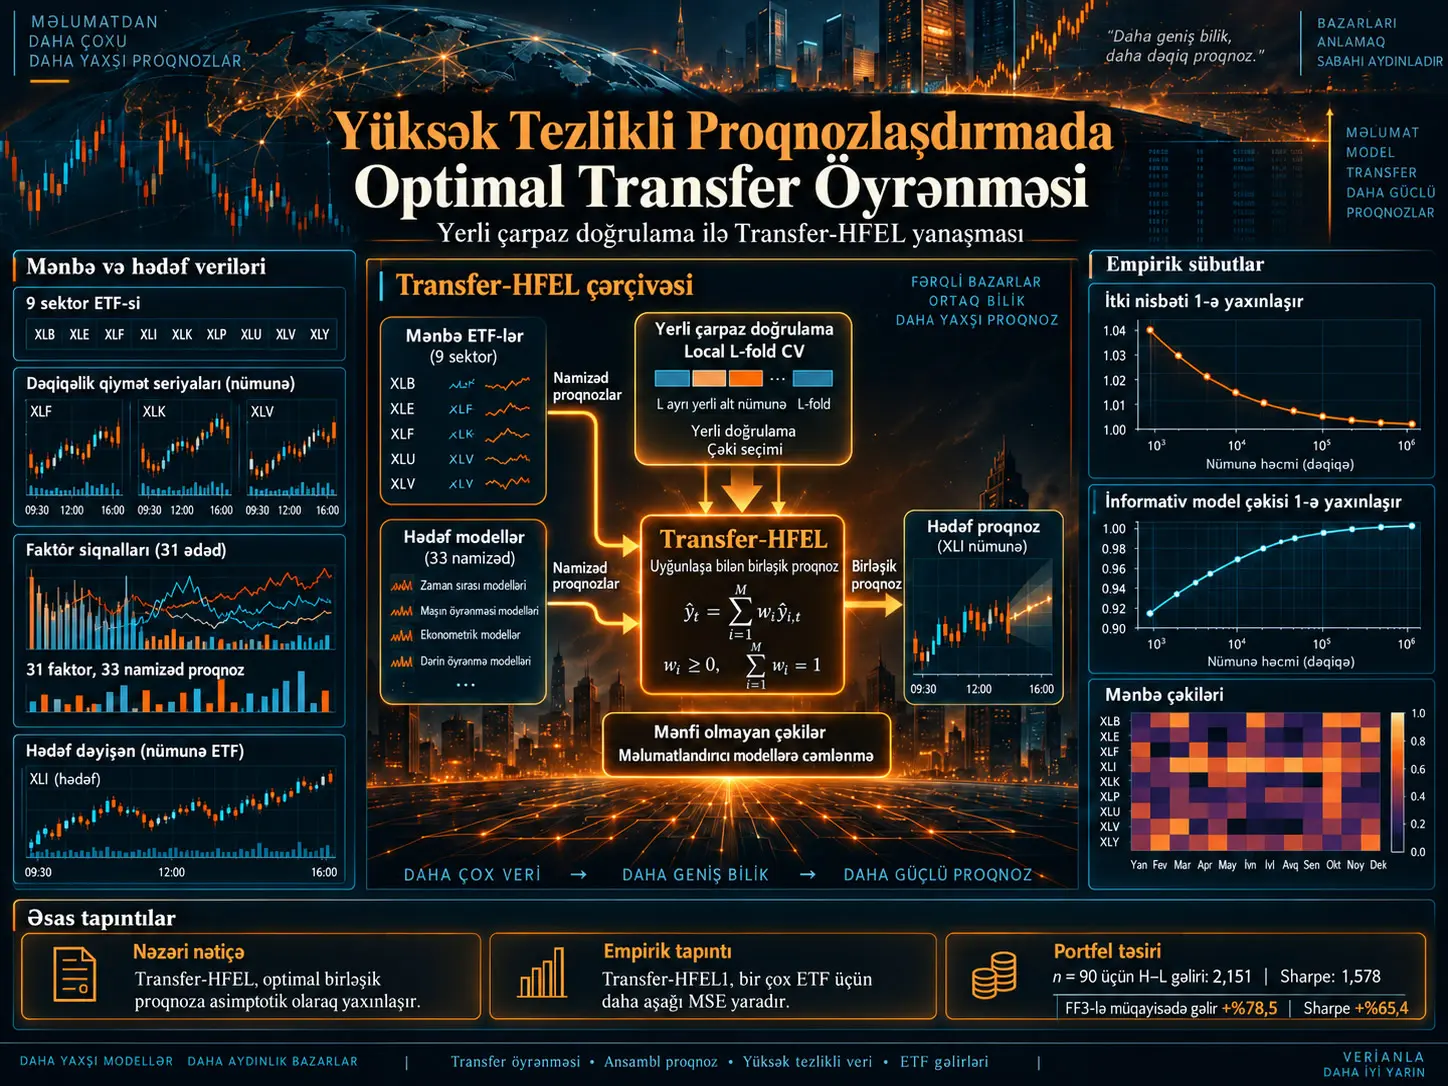
Yüksək Tezlikli Ansambl Öyrənməsi vasitəsilə Transfer Öyrənməsi (Transfer Learning through High-Frequency Ensemble Learning; Transfer-HFEL), hədəf aktivdən və heterogen mənbə aktivlərdən yaradılan bir neçə yüksək tezlikli proqnozu yerli L-qatlı çarpaz doğrulama ilə seçilən, mənfi olmayan və cəmi birə bərabər çəkilər altında birləşdirən transfer öyrənməsi və ansambl proqnozlaşdırma çərçivəsidir. Tədqiqat mənbə və hədəf populyasiyaların fərqli məlumat yaratma proseslərinə, fərqli informasiya dəstlərinə və yanlış spesifikasiya olunmuş modellərə malik ola biləcəyi vəziyyət-məkanı quruluşu yaradır. Nəzəri olaraq, bütün namizəd modellər yanlış spesifikasiya olunsa belə Transfer-HFEL-in əlçatmaz optimal ansamblın proqnoz itkisinə asimptotik olaraq yaxınlaşa bildiyi; düzgün və informativ modellər mövcud olduqda isə çəkinin bu modellərdə cəmləşdiyi göstərilir. Doqquz sektor ETF-sinin 2015-ci il dəqiqə tezlikli gəlirləri üzərində aparılan tətbiqdə üsul bir çox halda simple averaging, FULL, Fama–French üç amil və Fama–French beş amil üstəgəl momentum kimi müqayisə üsullarına nisbətən daha aşağı proqnoz xətası yaradır. Tədqiqatın öz portfel təcrübəsində Transfer-HFEL1-in \(n=90\) vəziyyətində illikləşdirilmiş H–L gəliri FF3 benchmark-ını təxminən %78,5; Sharpe nisbəti isə təxminən %65,4 üstələyir. Bu nəticələr göstərilən nümunəyə və portfel dizaynına xasdır; gələcək bazar performansına zəmanət vermir.
Tədqiqatın daha qeyri-adi nəticəsi, ümumi sistematik parametrləri birbaşa başqa aktivlərdən transfer edən quruluşdan daha çox, mənbə aktivlərdə istifadə olunan izahlı dəyişənlərə ortoqonal qalan və klassik amil terminologiyasında idiosinkratik komponentə bənzəyən informasiyanın transfer edilməsinin daha güclü proqnoz üstünlükləri yaratmasıdır. Müəlliflər bu nəticəni klassik mənada “idiosinkratik risk premiyasının mövcudluğu” kimi şərh etmirlər. Mümkün izahlar arasında model misspecification, sürətlə dəyişən risk premiyaları, çatışmayan common factors və order-flow imbalance, bid–ask bounce, asynchronous trading və ETF arbitrage kimi mikroyapı sürtünmələri var.
Problem: Niyə tək bir yüksək tezlikli proqnoz modelini seçmək kifayət etməyə bilər?
Yüksək tezlikli maliyyə məlumatlarında eyni hədəf dəyişən üçün çox sayda məqbul proqnoz modeli qurula bilər. Modellər fərqli predictor dəstlərindən istifadə edə, başqa aktivlərdən informasiya daşıya, fərqli econometric yanaşmalara əsaslana bilər və ya hədəf ilə mənbə populyasiyalar arasında həqiqi cross-sectional heterogeneity mövcud ola bilər. Bu halda tədqiqatçının qarşılaşdığı problem yalnız “hansı model ən yaxşıdır?” deyil. Əsas məsələ hər modelin daşıdığı faydalı informasiyanın hansı çəkilərlə bir araya gətiriləcəyidir.
Standart model averaging üsullarının mühüm hissəsi tək bir populyasiyanın aşağı tezlikli məlumatları üçün hazırlanmışdır. Transfer-HFEL isə heterogen populyasiyalardan gələn proqnozları eyni ansambl daxilində birləşdirməyi hədəfləyir və parametrlərin sabit olmasının məcburi olmadığı yüksək tezlikli vəziyyət-məkanı quruluşuna imkan verir.
Hədəf və mənbə populyasiyaların ümumi məlumat yaratma prosesi
Hədəf məlumatı:
\[ \{Y^{(0)},V^{(0)}\}_{0\leq t\leq T} \]
və \(m=1,\ldots,M\) üçün mənbə məlumatları:
\[ \{Y^{(m)},V^{(m)}\}_{0\leq t\leq T} \]
kimi müəyyən edilir.
m-ci populyasiyanın yüksək tezlikli increment-i:
\[ \Delta_i^nY^{(m)} = g^{(m)} \left( V_{t_{n,i}}^{(m)}, \theta_{t_{n,i}}^{(m)} \right) + Z_{n,i}^{(m)} + R_{n,i}^{(m)} \]
şəklindədir.
Burada \(g^{(m)}(\cdot)\) müşahidə olunan və ya latent feature-ları parametrlərlə birləşdirən ümumi funksiyanı; \(\theta^{(m)}\) zamanla dəyişə bilən parametr vektorunu; \(Z^{(m)}\) martingale tipli xəta komponentini; \(R^{(m)}\) isə daha kiçik tərtibli residual/discretization komponentini təmsil edir.
Vəziyyət-məkanı feature quruluşu:
\[ V_{t_{n,i}}^{(m)} = \int V^{(m)} \left( \zeta_{t_{n,i}}, \epsilon_{t_{n,i}} \right) F_\epsilon(d\epsilon) \]
şəklində verilir. \(\zeta_t\) latent proses, \(\epsilon_t\) müvəqqəti i.i.d. shock və \(V^{(m)}(\cdot)\) müşahidə olunan feature-ı latent vəziyyətdən yaradan, bilinməsi məcburi olmayan transformasiyadır.
Bu ümumi forma yalnız return regression üçün istifadə olunmur. Tədqiqatın çərçivəsi trading volume, bid–ask spread, duration, turnover və digər yüksək tezlikli dəyişənlərə də tətbiq edilə biləcək şəkildə qurulmuşdur.
High-frequency regression xüsusi halı
Tədqiqatın ilk nümunəsində predictor increment-i ümumi bir Itô semimartingale-dir:
\[ V_{t_{n,i}}^{(m)}=\Delta_i^nX^{(m)} \]
və model həm continuous, həm də jump komponentlərinə imkan verir:
\[ \Delta_i^nY^{(m)} = \left(\beta_{t_{n,i-1}}^{(m)}\right)^\top \Delta_i^nX^{(m)\circ} + \left(\ddot{\beta}_{t_{n,i-1}}^{(m)}\right)^\top \sum_{t_{n,i-1}\leq s\leq t_{n,i}} \Delta X_s^{(m)} + \Delta_i^nZ^{(m)} + R_{n,i}^{(m)} \]
Burada continuous regressors ilə jump regressors üçün fərqli coefficient komponentləri mövcuddur. \(R_{n,i}^{(m)}\), discrete sampling səbəbindən yaranan approximation/discretization xətasını daşıyır.
General feature xüsusi halı
İkinci nümunədə model lagged returns, trading volume, bid–ask spread, turnover və transaction-return autocovariance kimi birbaşa müşahidə olunan, lakin səs-küylü feature-larla işləyə bilər:
\[ \Delta_i^nY^{(m)} = g^{(m)} \left( V_{t_{n,i}}^{(m)}, \theta_{t_{n,i}}^{(m)} \right) + Z_{n,i}^{(m)} \]
Bu quruluş Transfer-HFEL-in yalnız klassik xətti factor regression-a bağlı olmadığını göstərir.
Transfer-HFEL nədir?
Transfer-HFEL hədəf populyasiyadan yaradılan alternativ proqnozları heterogen mənbə populyasiyalardan transfer edilən proqnozlarla tək bir convex ensemble daxilində birləşdirir və onların çəkilərini yüksək tezlikli zaman asılılığını nəzərə alan yerli L-qatlı çarpaz doğrulama meyarı ilə seçir.
Namizəd proqnozlar necə yaradılır?
Tədqiqatda cəmi \(M+K\) proqnoz var. Bunların:
- \(M\) ədədi mənbə domain-lərdən gəlir,
- \(K\) ədədi hədəf domain-in müxtəlif predictor modellərindən gəlir.
m-ci namizəd proqnoz ümumi şəkildə:
\[ \Delta_i^n\widehat{Y}^{(0)}_m \]
ilə göstərilir.
Mənbə modellərdə əvvəlcə mənbə məlumatları üzərində parametr qiymətləndirilməsi aparıla və əldə olunan informasiya target domain proqnozuna ötürülə bilər. Target modellərdə isə müxtəlif predictor alt dəstlərindən istifadə etməklə model-selection uncertainty ansambl daxilinə daxil edilir.
Ansambl çəkiləri
Çəki vektoru:
\[ w\in\mathcal W \]
və:
\[ \mathcal W= \left\{ w\in[0,1]^{M+K}: \sum_{m=0}^{M+K-1}w^{(m)}=1 \right\} \]
kimi məhdudlaşdırılır.
Beləliklə hər bir çəki mənfi ola bilməz və bütün çəkilərin cəmi birdir.
Birləşdirilmiş forecast:
\[ \Delta_i^n\widehat{Y}^{(0)}(w) = \sum_{m=0}^{M+K-1} w^{(m)} \Delta_i^n\widehat{Y}^{(0)}_m \]
şəklindədir.
Bu constraint-lər modelin bir mənbə siqnalını əks işarəli, sərhədsiz hedge kimi istifadə etməsinin qarşısını alır. Üsul bunun əvəzinə faydalı informasiya daşıyan mənbələrə müsbət çəki paylamağa çalışır.
Transfer-HFEL1: idiosyncratic/orthogonal komponent transferi
Tədqiqatın empirik tətbiqindəki ilk transfer forması, mənbə aktivin öz regressors-ları ilə izah olunmayan komponentini hədəf proqnoza daşıyan quruluşdur:
\[ h= \Delta_i^nY^{(m)} - \left( \widehat{\beta}_{t_{n,i}}^{(m)} \right)^\top \Delta_i^nX^{(m)} \,1_{\{ \|\Delta_i^nX^{(m)}\| \leq u_n^{(m)} \}} \]
Bu komponent mənbə regression-ının conditioning variables-larına ortoqonal qalan informasiya kimi şərh olunur. Məqalə bunu klassik asset-pricing terminologiyasındakı diversifiable və ya idiosyncratic risk komponentinə bənzədir.
Transfer-HFEL2: parameter transfer
İkinci yanaşma mənbədə qiymətləndirilmiş parametrləri hədəf aktivin predictor-larına tətbiq edir:
\[ h= \left( \widehat{\beta}_{t_{n,i}}^{(m)} \right)^\top \Delta_i^nX^{(0)} \,1_{\{ \|\Delta_i^nX^{(0)}\| \leq u_n^{(0)} \}} \]
Bu quruluş ümumi və ya systematic informasiyanın parametr vasitəsilə transfer edilməsini təmsil edir.
İki yanaşma arasındakı fərq kritikdir: Transfer-HFEL1 mənbə aktivin target predictors tərəfindən birbaşa təmsil olunmayan residual/cross-sectional informasiyasını daşıdığı halda, Transfer-HFEL2 daha çox ümumi coefficient quruluşunun target-a tətbiqinə əsaslanır.
Yerli L-Qatlı Çarpaz Doğrulama niyə lazımdır?
Yerli L-qatlı çarpaz doğrulama, yüksək tezlikli məlumatlarda random və ya bütün nümunəni əhatə edən global fold-ların zaman asılılığını və dəyişən covariance quruluşunu poza bilməsi səbəbindən doğrulamanı qısa və bir-birinə yaxın zaman blokları daxilində həyata keçirir; beləliklə fold-ların təxminən eyni yerli məlumat yaratma prosesindən gəlməsi hədəflənir.
Standart cross-validation problemi
Aşağı tezlikli maşın öyrənməsində müşahidələri təsadüfi train və validation qruplarına bölmək çox vaxt qəbulediləndir. Lakin high-frequency returns:
- serial dependence,
- volatility clustering,
- time-varying covariance,
- microstructure noise,
- asynchronous observation
kimi quruluşlara malik ola bilər.
Təsadüfi bölmə yaxın zamanlı asılı müşahidələri bir-birindən ayıra bilər və validation setinin gələcəkdə həqiqətən qarşılaşılacaq şərtləri təmsil etməsini çətinləşdirə bilər. Çox uzun global folds isə dəyişən bazar rejimlərini eyni DGP kimi qəbul etmək riskini artırır.
Local L-fold quruluşu
Üsul əvvəlcə \([0,T]\) intervalını \(H_n\) yerli zaman blokuna ayırır. Hər blokdakı zaman eni asimptotik olaraq kiçilərkən blok başına observation sayı \(k_n\) nisbətində artır.
Hər yerli blok daha sonra \(L\) fold-a bölünür.
j-ci blok və p-ci fold üçün model eyni blokdakı p-ci fold xaric edilərək qiymətləndirilir. Validation error yalnız həmin yerli fold üzərində hesablanır.
Cross-validation criterion:
\[ CV(w) = \sum_{j=1}^{H_n} \sum_{p=1}^{L} \sum_i \left( \Delta_i^n\widetilde{Y}^{(0)}_{[j,-p]}(w) - \Delta_i^nY^{(0)}_{[j,p]} \right)^2 \]
şəklindədir.
\(\Delta_i^n\widetilde{Y}^{(0)}_{[j,-p]}(w)\), p-ci validation fold-u çıxarılaraq əldə edilən target-side forecast-ların çəkili birləşməsidir.
Mühüm texniki detal ondan ibarətdir ki, local L-fold əməliyyatı target data üzərində tətbiq olunur. Source-domain parameter estimates target-ın p-ci fold-u çıxarıldığı üçün yenidən hesablanmır; çünki bu fold source data-nın bir hissəsi deyil.
Yerliliyin statistik məqsədi
Local windows fold-ların eyni qısa müddətli covariance rejiminə daha yaxın olmasını təmin edir. Tədqiqatın yanaşması yüksək tezlikli bazarda uzun müddət boyunca global stationarity fərz etmək əvəzinə qısa müddətli conditional stationarity-dən yararlanır.
Asimptotik optimallıq nə deməkdir?
Transfer-HFEL-in asimptotik optimallığı, nümunə sıxlaşdıqca local cross-validation ilə seçilən çəkilərin yaratdığı ansamblın quadratic prediction loss-unun, həqiqi məlumat yaratma prosesi bilinsəydi seçilə biləcək infeasible optimal çəkilərin loss-una nisbətinin ehtimalda 1-ə yaxınlaşması deməkdir.
Prediction loss
Tədqiqat proqnoz performansını:
\[ L(w) = \sum_{i=k_n+1}^{n} \left( \Delta_i^n\widehat Y^{(0)}(w) - \Delta_i^n\mu^{(0)} \right)^2 \]
ilə ölçür.
Buradakı \(\Delta_i^n\mu^{(0)}\), target DGP-nin proqnozlaşdırıla bilən/predictable komponentidir.
Theorem 1: infeasible minimum loss üçün aşağı sərhəd
Bütün candidate models misspecified olduqda tədqiqat müəyyən regularity conditions altında infeasible minimum loss-un degenerativ şəkildə sıfıra getməsinin qarşısını alan müsbət aşağı sərhəd əldə edir. Bu texniki nəticə sonrakı asymptotic-optimality isbatının qurulmasına kömək edir.
Theorem 2: optimality
Əsas nəticə:
\[ \frac{ L(\widehat w) }{ \inf_{w\in\mathcal W}L(w) } \xrightarrow{p}1 \]
şəklindədir.
Başqa sözlə, candidate modellərin hamısı müxtəlif dərəcələrdə yanlış olsa belə local-CV çəkili ansambl asimptotik olaraq mövcud candidate set daxilində ən yaxşı əlçatmaz kombinasiyanın riskinə yaxınlaşır.
Bu, “Transfer-HFEL həqiqi DGP-ni mütləq tapır” demək deyil. Optimallıq candidate forecast ailəsi daxilindəki quadratic-loss benchmark-a görədir.
Theorem 3: informativ modellərin çəkisi
Target model düzgün spesifikasiya olunub və target ilə eyni pseudo-true parameter informasiyasını paylaşan informative models çoxluğu \(\mathcal D\) olsun.
Bu modellərə verilən ümumi çəki:
\[ \tau= \sum_{m\in\mathcal D}w^{(m)} \]
və onun qiymətləndirilməsi:
\[ \widehat\tau= \sum_{m\in\mathcal D}\widehat w^{(m)} \]
olduqda tədqiqat:
\[ \widehat\tau\xrightarrow{p}1 \]
nəticəsini əldə edir.
Yəni nümunə böyüdükcə ümumi ansambl çəkisi informativ modellərdə cəmləşir. Çox fərqli və ya faydasız mənbələrin çəkisi asimptotik olaraq sıfıra yaxınlaşa bilər.
Tək düzgün model xüsusi halı
Bu nəticənin təbii nəticəsi odur ki, yalnız bir model düzgündürsə üsul asimptotik olaraq bütün çəkini həmin modelə verməyə yaxınlaşır. Beləliklə transfer learning-in potensial negative-transfer riski çəki seçimi vasitəsilə məhdudlaşdırılmağa çalışılır.
Theorem 4: parameter consistency
Ən böyük target model düzgün spesifikasiya olunduqda shared-parameter estimator üçün mənbə:
\[ \left\| \widehat\beta_t(\widehat w) - \beta^{(0)}_{t-\Delta_n} \right\| = O_p \left( k_n^{1/2}\Delta_n^{1/2} + k_n^{-1/2} \right) \]
nisbətini verir.
Tədqiqatın istifadə etdiyi small-window scheme altında:
\[ k_n\asymp\Delta_n^{-\varsigma}, \qquad \varsigma<\frac12 \]
və dominant xəta termini:
\[ O_p(k_n^{-1/2}) \]
olur.
Bu nəzəri nəticələrin sərhədi
Asimptotik nəticələrin hamısı tədqiqatda verilən regularity conditions altında keçərlidir. Maliyyə tətbiqində “teorem var, deməli üsul hər bazar rejimində daha yaxşı proqnoz verir” nəticəsi çıxarıla bilməz. Finite-sample davranışı ayrıca simulyasiya və real məlumat tətbiqi ilə sınaqdan keçirilir.
Tədqiqatın Metodu və Nəticələri
Monte Carlo dizaynı
Tədqiqat əvvəlcə finite-sample davranışını iki məlumat yaratma prosesi üzərindən araşdırır.
DGP1 — tam transfer edilə bilən quruluş:
\[ dY_t^{(m)} = \left( \beta_t^{(m)}+\delta_m \right)^\top dX_t^{(m)} + Z_t^{(m)} \]
DGP2 — qismən transfer edilə bilən quruluş:
\[ dY_t^{(m)} = \left( \beta_t^{(m)}+\delta_m \right)^\top dX_t^{(m)} + \left( \alpha_t^{(m)} \right)^\top dU_t^{(m)} + Z_t^{(m)} \]
DGP2-də \(\beta_t^{(m)}\) populyasiyalar arasında transfer edilə bildiyi halda \(\alpha_t^{(m)}\) model-specific informasiya daşıyır.
Predictor və residual prosesləri continuous diffusion və jump komponentlərini birlikdə ehtiva edir. Volatility prosesləri Cox–Ingersoll–Ross tipli dynamics ilə, jump sizes isə double-exponential paylanma ilə modelləşdirilmişdir.
| Element | Mənbədə istifadə olunan dəyər/quruluş |
|---|---|
| Əsas predictor ölçüsü | d = 40 |
| Mənbə model sayı M | 3, 5, 7 |
| Sample size n | 3600, 8800, 12300, 17600, 21100 |
| Sampling quruluşu | 1 dəqiqəlik tezlik |
| Mənbə-target parameter shift | \(\delta_m=0.1(m-1)(-1)^m\) |
| Predictor jump intensity | \(\lambda_X^J=7\) |
| DGP2 U jump intensity | \(\lambda_U^J=6\) |
| Residual jump intensity | \(\lambda_Z^J=14\) |
Mənbədəki simulyasiya təsviri uyğunsuzluğu
Simulyasiya ssenarilərinin nömrələnməsində mənbə mətnin öz daxilində uyğunsuzluq var. İlk tərifdə Scenario 1 target modelin correctly specified, Scenario 2 target modelin misspecified olduğu yazılır. Daha sonrakı nəticə paraqrafında isə bu iki scenario nömrəsi tərs şəkildə istifadə edilir. Şəkil başlıqları şərti birbaşa “model misspecification” və “target model correctly specified” kimi verdiyi üçün Verianla izahında elmi şərt əsas götürülmüş, scenario nömrəsi qəti şəkildə müəyyənləşdirilməmişdir.
Bundan əlavə, əsas mətndə misspecified target-ın 40 predictor-un son üç komponentini çıxararaq 37 ölçüyə endirildiyi bildirilərkən, simulyasiya parametr cədvəlinin qeydində misspecified vəziyyətdə son beş komponentin çıxarıldığı yazılır. Mənbə bu fərqi izah etmir.
Şəkil 1: oracle loss-a yaxınlaşma
Mənbənin 26-cı səhifəsindəki Şəkil 1 model misspecification altında:
\[ \frac{ L(\widehat w) }{ \inf_w L(w) } \]
nisbətini sample size-a qarşı göstərir.
DGP1 və DGP2 ilə \(M=3,5,7\) konfiqurasiyalarının hamısında nisbət nümunə böyüdükcə 1-ə yaxınlaşır. Mənbənin verdiyi nümunədə DGP2 və \(M=5\) üçün nisbət \(n=3600\)-də təxminən 1,020 olduğu halda \(n=21100\)-də 1,001-dən aşağı düşür.
Bu nümunə Theorem 2-dəki asymptotic optimality nəticəsi ilə uyğundur.
Şəkil 2: informativ model çəkiləri
27-ci səhifədəki Şəkil 2 target model correctly specified olduqda informativ modellərə verilən ümumi çəkini göstərir.
Bütün simulyasiya konfiqurasiyalarında çəki nümunə böyüdükcə 1-ə yaxınlaşır. Mənbənin nümunəsində DGP2, \(M=3\) vəziyyətində informative-weight cəmi \(n=8800\)-də 0,95-i keçir və daha böyük nümunələrdə 1-ə yaxınlaşır.
Bu nəticə Theorem 3-ün finite-sample qarşılığı kimi şərh olunur.
Real məlumat: doqquz sektor ETF-si
Empirik tədqiqat yanvar–dekabr 2015 arasında doqquz ABŞ sektor ETF-sinin dəqiqə səviyyəli log gəlirlərindən istifadə edir.
| Kod | Sektor |
|---|---|
| XLB | Materials |
| XLE | Energy |
| XLF | Financials |
| XLI | Industrials |
| XLK | Technology |
| XLP | Consumer Staples |
| XLU | Utilities |
| XLV | Healthcare |
| XLY | Consumer Discretionary |
Hər bir ETF target seçildikdə qalan səkkiz ETF source domain rolunu oynayır.
31 predictor/factor
Model ümumilikdə 31 exogenous factor istifadə edir. Bunların 25-i tədqiqatın factor-zoo dəstindən, altısı isə Fama–French five-factor-plus-momentum quruluşundan gəlir.
Amillər əsasən:
- Size,
- Profitability,
- Low Risk,
- Leverage
kateqoriyalarına bölünmüşdür.
Mənbə cədvəldə short interest, cash-flow-to-price variance, pension funding status, operating profitability, R&D capital-to-assets, Altman Z-score, market beta, downside beta, return volatility, turnover və zero-trade ölçüləri kimi dəyişənlər var.
Amillər return tezliyi ilə uyğunlaşdırmaq üçün log transformasiyası və differencing əməliyyatından keçirilir.
33 namizəd proqnoz necə yaranır?
Hər target ETF üçün candidate set:
- bütün 31 amildən istifadə edən 1 target FULL modeli,
- 8 source-ETF modeli,
- 24 target-domain subset model
olmaqla cəmi:
33 proqnoz
ehtiva edir.
24 subset model:
- 12 single-factor,
- 4 three-factor,
- 4 five-factor,
- 4 ten-factor
modeldən ibarətdir.
Müqayisə olunan üsullar
Empirik tətbiq:
- Transfer-HFEL1,
- Transfer-HFEL2,
- SA1,
- SA2,
- FULL,
- Fama–French üç amil (FF3),
- Fama–French five-factor plus momentum (FF5P1)
üsullarını müqayisə edir.
SA1 və SA2 müvafiq Transfer-HFEL candidate setlərinin equal-weight versiyalarıdır. Beləliklə optimal çəki seçiminin dəyəri istifadə olunan modellərin sadəcə diversifikasiyasından ayrılmağa çalışılır.
Çatışmayan məlumat təcrübəsi
Covariates missing completely at random fərziyyəsi altında:
\[ p\in\{0,\ 25\%,\ 45\%,\ 65\%\} \]
missing nisbətlərindən istifadə edilmişdir.
Müxtəlif target domain-lərin fərqli observation itkilərinə malik olacağı şəkildə asynchronous missing pattern yaradılır. Parameter estimation üçün complete-case analysis istifadə olunur.
Transfer-HFEL proqnoz dəqiqliyi
Mənbə nəticələrinə görə Transfer-HFEL üsulları eyni candidate setlərdən istifadə edən simple averaging üsullarını çoxsaylı ETF və missing-rate vəziyyətində üstələyir.
Missing data olmadıqda Transfer-HFEL1-in SA1-ə görə MSE yaxşılaşmaları mənbə mətndə təxminən:
%15,9–%49,2
intervalında verilir.
Transfer-HFEL2-nin SA2-yə görə üstünlükləri isə:
%10,0–%15,7
intervalındadır.
Mənbə həmçinin %45 missing-rate vəziyyətində simple averaging-ə qarşı bəzi hədəflərdə təxminən %52-yə çatan yaxşılaşma bildirir.
Seçilmiş MSE nəticələri
| Missing | Target | Transfer-HFEL1 | SA1 | Transfer-HFEL2 | FULL | FF3 |
|---|---|---|---|---|---|---|
| 0% | XLB | 0.820 | 1.347 | 1.364 | 1.162 | 1.458 |
| 0% | XLI | 0.479 | 0.914 | 0.963 | 0.861 | 1.110 |
| 0% | XLY | 0.517 | 1.017 | 1.052 | 0.941 | 1.204 |
| 45% | XLI | 0.220 | 0.447 | 0.435 | 0.713 | 0.566 |
| 45% | XLY | 0.239 | 0.499 | 0.472 | 0.772 | 0.616 |
| 65% | XLB | 0.556 | 0.951 | 0.897 | 1.405 | 1.079 |
| 65% | XLK | 0.444 | 0.865 | 0.823 | 1.295 | 1.008 |
| 65% | XLY | 0.344 | 0.726 | 0.685 | 1.111 | 0.885 |
Cədvəldəki absolute MSE səviyyələrini müxtəlif missing-rate sətirləri arasında sadəcə “çatışmayan məlumat artdıqca MSE azaldı/artdı” kimi şərh etmək əvəzinə, mənbə tədqiqatın etdiyi kimi eyni missing-rate daxilində üsul müqayisələrinə diqqət yetirmək lazımdır.
Idiosyncratic informasiya transferi niyə Common-Parameter transferindən daha uğurlu ola bilər?
Tədqiqatın ETF tətbiqində Transfer-HFEL1 source aktivlərin factor regressors-a ortoqonal qalan komponentlərindən cross-sectional informasiya daşıdığı halda Transfer-HFEL2 əsasən ümumi parameter informasiyasını target-a ötürür; Transfer-HFEL1-in daha aşağı MSE yaratması bu residual komponentin model misspecification, zamanla dəyişən risk premiyaları və ya market-microstructure təsirləri səbəbindən proqnoz üçün faydalı informasiya ehtiva edə biləcəyini düşündürür.
Cədvəl 4-dəki birbaşa müqayisə
Mənbə Cədvəl 4-ün “Gain (%)” sütunu Transfer-HFEL1-in Transfer-HFEL2-yə görə MSE üstünlüyünü göstərir. Məsələn:
- XLB, missing %0: %39,9,
- XLI, missing %0: %50,3,
- XLY, missing %0: %50,8,
- XLK, missing %45: %46,5,
- XLY, missing %65: %49,8.
Bu müqayisələr idiosyncratic-component transferinin tədqiqatın tətbiqində parameter-transfer versiyasından daha güclü olduğunu göstərir.
Weight heatmap-lər nə göstərir?
Mənbənin 28-ci səhifəsindəki Şəkil 3 Transfer-HFEL1, 29-cu səhifəsindəki Şəkil 4 isə Transfer-HFEL2 çəkilərini target ETF və aya görə göstərir.
Çəkilər source ETF-lər arasında bərabər deyil; target-a və aya görə mühüm dərəcədə dəyişir. Məsələn, XLE target olduqda XLB-yə verilən çəkinin bir çox ayda nəzərəçarpacaq dərəcədə yüksək olduğu görünür. Mənbə XLE proqnozunda XLB çəkisinin on iki ayın doqquzunda 0,4-dən yuxarı olduğunu bildirir.
Yanvar 2015 nümunəsində XLE target ikən:
Transfer-HFEL1 → XLB çəkisi 0,76
Transfer-HFEL2 → XLB çəkisi 0,33
kimi hesabat verilir.
Hər iki üsul eyni source ETF-ni ən yüksək çəki ilə seçsə də çəkinin magnitude-u ciddi şəkildə fərqlənir.
Müəlliflərin iqtisadi izahı
Enerji exploration və extraction fəaliyyətləri material input-lardan asılıdır; enerji və materials sektorları arasında upstream–downstream əlaqələr ola bilər. Buna görə XLB mənbə informasiyasının XLE gəlirləri üçün leading information daşıması iqtisadi baxımdan məqbul hesab edilə bilər.
Lakin tədqiqat bu nümunəni səbəbli istehsal zənciri testi kimi qurmur. Weight pattern ilə iqtisadi sektor münasibəti arasında şərh aparılır.
Bu nəticə klassik asset pricing-ə həqiqətən ziddirmi?
İlk baxışda idiosyncratic komponentin proqnoz baxımından daha faydalı olması, diversifikasiya edilmiş idiosyncratic risk-in risk premiyası daşımamalı olduğu standart asset-pricing yanaşması ilə gərgin görünə bilər.
Mənbə üç izah üzərində dayanır.
1. Model misspecification
31 amilin mühüm hissəsi low-frequency characteristics mənşəlidir. High-frequency return dynamics üçün vacib bəzi common factors modelə ümumiyyətlə daxil edilməmiş ola bilər. Bu halda regression residual-da görünən “idiosyncratic” informasiya əslində omitted systematic information daşıya bilər.
2. Time-varying risk premia
Historically estimated factor loadings risk exposure-u göstərə bilər, lakin həmin riskin ani compensation dəyərinin necə dəyişdiyini tam göstərmir. High-frequency return dynamics çox sürətlə dəyişən risk premia tərəfindən təsirlənirsə cross-sectional residual komponentlər bu dinamikanın bir hissəsini daşıya bilər.
3. Market microstructure
Order-flow imbalance, bid–ask bounce, asynchronous trading və ETF arbitrage pressures aşağı tezlikli characteristics-lərə ortoqonal, lakin cross-sectionally correlated müvəqqəti qiymət hərəkətləri yarada bilər. Factor regression bunları “idiosyncratic” kimi təsnif etsə də qısa üfüqlü proqnoz üçün faydalı ola bilər.
Tədqiqat bu üç izahdan hansının dominant olduğunu ayrıca identification dizaynı ilə göstərmir. Bunlar empirik nəticənin mümkün mexanizmləridir.
Missing data altında source information
Mənbə target covariates çatışmadıqda source data-nın nisbi dəyərinin artdığını göstərir. Məsələn, XLB üçün FULL modelə qarşı Transfer-HFEL1 MSE yaxşılaşması missing nisbəti %25–%65 arasında təxminən %59,4–%60,4 intervalında hesabat verilir. Eyni target üçün FF3-ə qarşı yaxşılaşma təxminən %47,3–%48,5-dir.
Bu nəticə target domain-in observation sayı azaldıqda yaxın və ya əlaqəli source domain-lərdən informasiya daşımağın proqnoz xətasını azalda biləcəyi kimi şərh olunur.
İqtisadi performans təcrübəsi
Tədqiqatın ikinci empirik qatı sektor ETF-lərindən fərdi səhm gəlirlərinə keçir. Cəmi 80 səhm növbə ilə target asset kimi seçilir. Target səhmin öz sektor ETF-si source set-dən çıxarılır və qalan səkkiz sektor ETF-si source dataset kimi istifadə olunur.
Hər estimation window daxilində stock-return predictions hesablanır və səhmlər proqnozlarına görə 10 decile portfolio-ya bölünür.
Low ən aşağı proqnozlaşdırılmış gəlirli decile, High isə ən yüksək proqnozlaşdırılmış gəlirli decile-dır.
Long-short nəticəsi:
\[ H-L = R_{\mathrm{High}} - R_{\mathrm{Low}} \]
kimi hesablanır.
Mənbə Cədvəl 5-də:
- \(k_n=30\),
- \(L=5\),
- missing rate = %70,
- forecast horizon üçün \(n=40\) və \(n=90\)
parametrləri verilir.
n = 40 portfel nəticələri
| Üsul | Annualized return, H–L (\(\times10^{-2}\)) | Annualized Sharpe |
|---|---|---|
| Transfer-HFEL1 | 1.586 | 1.566 |
| SA1 | 0.858 | 0.919 |
| Transfer-HFEL2 | 1.421 | 1.409 |
| SA2 | 1.411 | 1.504 |
| FF3 | 1.035 | 1.132 |
| FF5P1 | 1.248 | 1.333 |
n = 90 portfel nəticələri
| Üsul | Annualized return, H–L (\(\times10^{-2}\)) | Annualized Sharpe |
|---|---|---|
| Transfer-HFEL1 | 2.151 | 1.578 |
| SA1 | 1.154 | 0.883 |
| Transfer-HFEL2 | 2.085 | 1.531 |
| SA2 | 1.939 | 1.478 |
| FF3 | 1.205 | 0.954 |
| FF5P1 | 1.662 | 1.282 |
n=90 vəziyyətində mənbə:
\[ \frac{2.151-1.205}{1.205} \approx 78.5\% \]
annualized-return improvement və:
\[ \frac{1.578-0.954}{0.954} \approx65.4\% \]
Sharpe improvement hesabat verir.
Bu faiz müqayisələri FF3 benchmark-a görədir. Cədvəl return sətirlərinin miqyasını \(10^{-2}\) kimi verdiyi üçün Verianla mətnində 2,151 rəqəmi birbaşa “%215,1 gəlir” kimi yenidən şərh edilməmişdir.
Bu portfel nəticəsi nə deməkdir?
Nəticə tədqiqatın müəyyən etdiyi sample, prediction horizon, missingness dizaynı, stock sorting və long-short portfolio üsulu altında Transfer-HFEL1 proqnozlarının daha güclü cross-sectional ranking informasiyası daşıdığını göstərir.
Nəticə təkbaşına aşağıdakıları göstərmir:
- əməliyyat xərclərindən sonra eyni performansın qorunacağını,
- slippage və market impact-in əhəmiyyətsiz olduğunu,
- 2015-dən kənar bazar dövrlərində eyni nəticəni,
- başqa asset class-larda eyni performansı,
- gələcək Sharpe nisbətinin 1,578 olacağını.
Mənbə cədvəldə transaction-cost və ya live-execution qatı hesabat verilmir. Buna görə iqtisadi performans tədqiqatın yaratdığı portfolio-return təcrübəsi kontekstində şərh edilməlidir.
Tədqiqatın dəstəklədiyi nəticələr
- Heterogen mənbə və hədəf forecast-ları local-CV əsaslı ansambl daxilində birləşdirən Transfer-HFEL nəzəri olaraq müəyyən edilə bilər.
- Göstərilən regularity conditions altında candidate modellər misspecified olduqda Transfer-HFEL asymptotically optimal loss-a yaxınlaşır.
- Informative modellər mövcud olduqda ümumi çəki asimptotik olaraq bu modellərdə cəmləşir.
- Monte Carlo nəticələri nəzəri convergence nümunələrini finite sample-da dəstəkləyir.
- 2015-ci il doqquz-sector-ETF tətbiqində Transfer-HFEL bir çox müqayisədə simple averaging və factor benchmarks-a nisbətən daha aşağı MSE yaradır.
- Target data azaldıqda source-domain informasiyasının nisbi faydası bəzi hədəflərdə nəzərəçarpacaq dərəcədə artır.
- Araşdırılan tətbiqdə idiosyncratic-component transferi parameter transferindən daha yüksək forecast gains yaradır.
- 80-stock portfolio təcrübəsində Transfer-HFEL1 verilən dizayn altında FF3 və digər benchmark-lara nisbətən daha yüksək H–L return və Sharpe dəyərləri yaradır.
Tədqiqatın dəstəkləmədiyi nəticələr
- Transfer-HFEL-in bütün maliyyə bazarlarında və bütün dövrlərdə ən yaxşı forecast üsulu olduğu göstərilməyib.
- Idiosyncratic risk-in klassik asset-pricing mənasında sistematik şəkildə qiymətləndirildiyi sübut edilməyib.
- Transfer-HFEL1-in uğurunun dəqiq mexanizmi model misspecification, time-varying risk premium və ya microstructure arasında ayrılmayıb.
- Portfel nəticələri live trading execution və ya net transaction-cost performansı deyil.
- Asimptotik optimallıq finite sample-da xətasız proqnoz demək deyil.
- Informative source-ların iqtisadi səbəbliliyi weight heatmap-lərdən təkbaşına çıxarıla bilməz.
- Çatışmayan məlumat nəticələri missing-not-at-random və ya arbitrary missingness quruluşları üçün birbaşa sübut yaratmır; empirik təcrübə MCAR quruluşundan istifadə edir.
Tətbiq sahələri və gələcək tədqiqat
Mənbə Transfer-HFEL-in high-frequency return prediction xaricində:
- new-product pricing,
- portfolio optimization,
- factor selection,
- yetərsiz tarixçə məlumatına malik yeni maliyyə məhsullarının proqnozlaşdırılması
kimi sahələrə genişləndirilə biləcəyini bildirir.
Yeni listələnmiş equities, novel derivatives və ya emerging cryptocurrency pairs kimi aktivlərdə target history qısa ola bilər, əlaqəli aktivlər isə daha uzun məlumat tarixçəsi təmin edə bilər. Bundan əlavə asynchronous trading və irregular observations source-target nümunə ölçülərinə fərqli təsir göstərə bilər. Müəlliflər bu problemlərin Transfer-HFEL-in gələcəkdə genişləndirilə biləcəyi sahələr olduğunu bildirirlər; mövcud tədqiqat bu genişləndirmələri həyata keçirmir.
Mənbə və Metod Qeydi
Orijinal tədqiqat:Optimal Transfer Learning for High-Frequency Prediction by Local Cross-validation.
Müəlliflər: Dachuan Chen; Jia Li; Yuying Sun; Yue Tang.
Corresponding author: Yuying Sun.
Qurumlar: Dachuan Chen və Jia Li — School of Economics, Singapore Management University. Yuying Sun və Yue Tang — State Key Laboratory of Mathematical Sciences, Academy of Mathematics and Systems Science, Chinese Academy of Sciences; School of Economics and Management, University of Chinese Academy of Sciences.
Platforma: SSRN.
SSRN DOI: 10.2139/ssrn.7189238.
Bibliyografik tarix: SSRN qeydində Date Written 27 iyul 2026; Posted 6 avqust 2026.
Mənbə növü: Tədqiqat məqaləsi/preprint. Araşdırılan bibliyografik qeyddə resenziyalı jurnal nəşri təsdiqlənməyib.
Lisenziya/müəllif hüququ vəziyyəti: SSRN qeydi açıq Creative Commons yenidən istifadə lisenziyası vermir və yenidən istifadə üçün icazə lazım olduğunu bildirir. Buna görə Verianla mətni mənbə tədqiqatın cümlə, paraqraf, şəkil və ya orijinal cədvəl təqdimatını kopyalamır. Elmi faktlar, metod, riyaziyyat və nəticələr müstəqil tədris quruluşunda təqdim edilir.
Maliyyələşdirmə: Dachuan Chen üçün Singapore Ministry of Education Tier 1 Grant No. 24-SOE-SMU-042 və National Natural Science Foundation of China Grant No. 12571515; Jia Li üçün Singapore Ministry of Education Tier 2 Grant T2EP40124-0021; Yuying Sun üçün Beijing Natural Science Foundation Grant JQ25030 və NSFC Grant Nos. 72322016 və 72073126 mənbədə göstərilmişdir.
Empirik məlumat: Əsas ETF tətbiqi yanvar–dekabr 2015 arasındakı doqquz sektor ETF-sinin minute-level log returns məlumatlarından istifadə edir. 31 exogenous factor və target başına 33 candidate forecast yaradılır.
Simulyasiya: DGP1 və DGP2 diffusion, CIR-type variance dynamics və jump komponentləri ehtiva edən high-frequency regression prosesləridir. Source model sayı \(M=3,5,7\), sample size \(n=3600,8800,12300,17600,21100\) dəyərləri ilə araşdırılmışdır.
Əsas nəzəri nəticə: Göstərilən regularity conditions altında Transfer-HFEL-in quadratic prediction loss-u candidate set daxilindəki infeasible optimal combination loss-a asimptotik olaraq yaxınlaşır. Correctly specified/informative modellər olduqda çəkilər bu modellərdə cəmləşir.
Əsas empirik nəticə: Araşdırılan ETF tətbiqində Transfer-HFEL1 müqayisələrin çoxunda daha aşağı MSE göstərir; idiosyncratic/orthogonal source information transferi parameter transferindən daha uğurlu görünür.
İqtisadi nəticə sərhədi: Mənbə portfolio returns və Sharpe ratios hesabat verir, lakin bu bölmə live execution, market impact və ətraflı transaction-cost backtest-i kimi hazırlanmayıb. Buna görə nəticələr müəyyən edilmiş tədqiqat portfelinin performans ölçüləridir.
Mənbədaxili uyğunsuzluqlar: Simulyasiyada Scenario 1/Scenario 2-nin correctly specified və misspecified vəziyyətlərə təyini nəticə paraqrafında ilkin tərifə görə tərs istifadə olunur. Bundan əlavə misspecified target-dan üç predictor yoxsa beş predictor çıxarıldığı məsələsində əsas mətn ilə Table 1 qeydi uyğun gəlmir. Bu məqamlar səssiz şəkildə düzəldilməyib.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib