

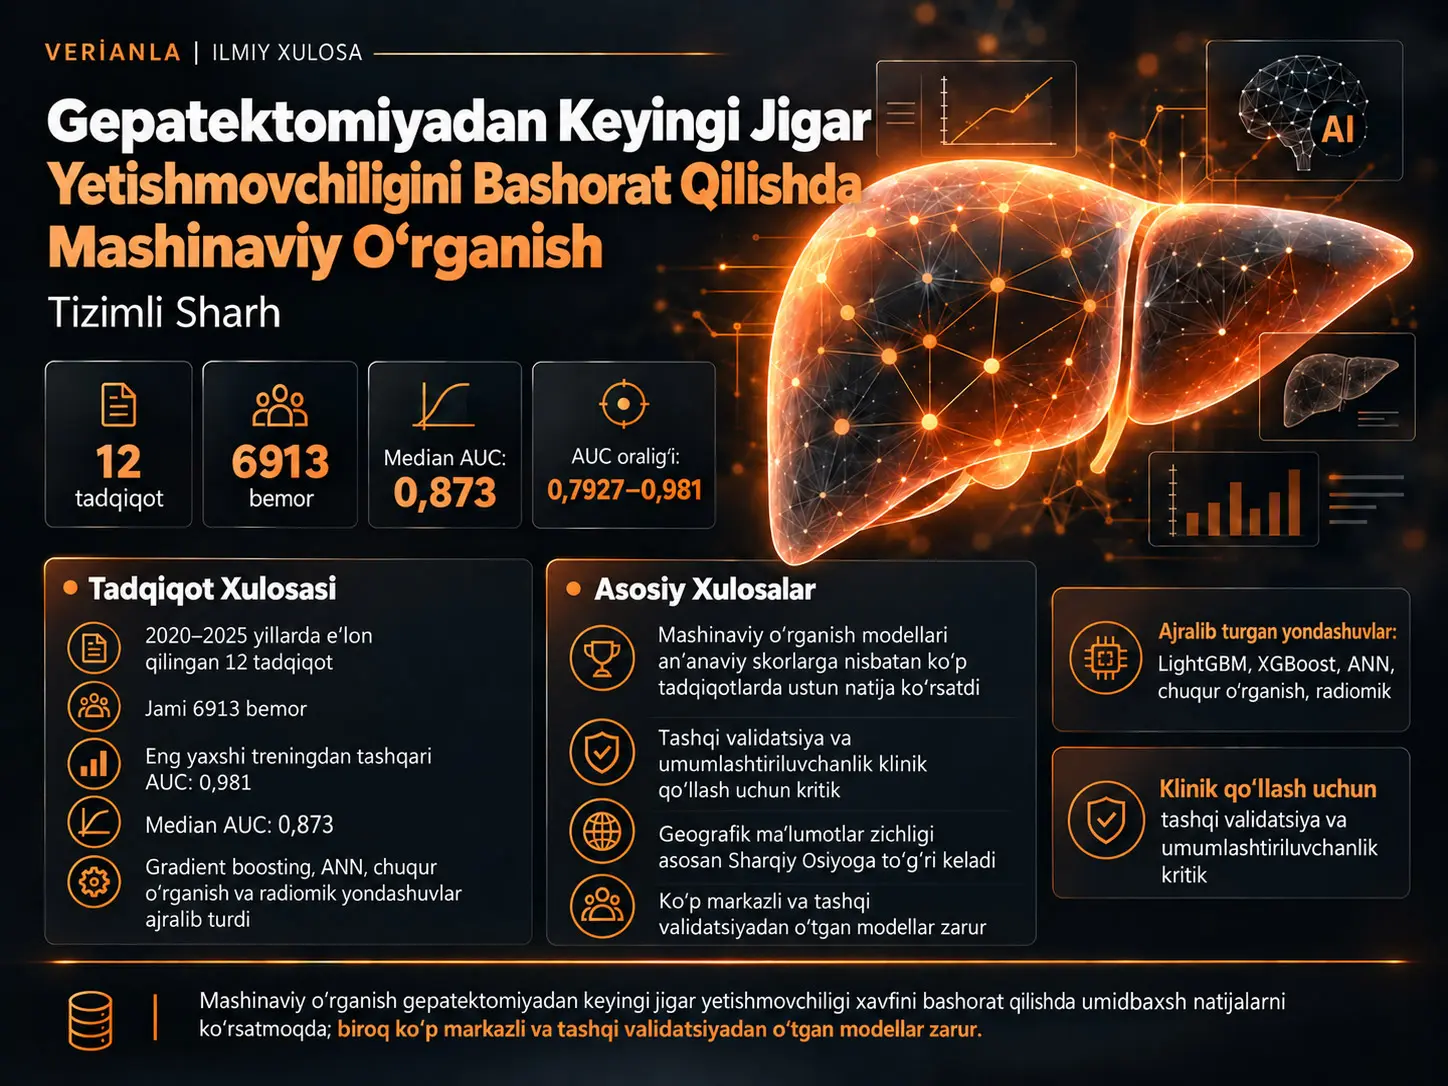
Gepatektomiyadan keyingi jigar yetishmovchiligi (Post-Hepatectomy Liver Failure, PHLF) — jigar rezektsiyasidan soʻng jigarning sintez, chiqarish va detoksifikatsiya funksiyalarini yetarli darajada davom ettira olmasligi bilan tavsiflanadigan jiddiy operatsiyadan keyingi asoratdir. Ushbu tizimli sharh PHLF xavfini bashorat qilish uchun ishlab chiqilgan mashinaviy oʻrganish modellarining farqlash samaradorligini, foydalanilgan bashoratlovchilarni, validatsiya usullarini, metodologik sifatini va klinik qoʻllanish imkoniyatini baholaydi. Yakuniy sharh 2020–2025 oraligʻida chop etilgan 12 tadqiqotni va jami 6913 bemorni qamrab oladi. Oʻqitish maʼlumotlaridan tashqarida xabar qilingan eng yaxshi AUC qiymatlari 0,7927 dan 0,981 gacha boʻlib, median AUC 0,873 ni tashkil etgan. Biroq tadqiqotlarning aksariyati retrospektiv ekani, PHLF taʼriflari bir xil emasligi va tashqi validatsiya cheklanganligi sababli bu samaradorlik qiymatlarini bevosita odatiy klinik foydalanishga tayyor tizimlar sifatida talqin qilmaslik kerak.
Sharhda gradient boosting oilasi, ayniqsa LightGBM va XGBoost, tez-tez uchraydigan yuqori samarali yondashuvlar qatoriga kiradi. Sunʼiy neyron tarmoqlari, chuqur oʻrganish, kompyuter tomografiyasi yoki magnit-rezonans tasvirlaridan radiomik xususiyatlarni ajratib oladigan modellar va ensemble tizimlari ham sezilarli farqlash samaradorligini koʻrsatgan. Eng koʻp ishlatilgan maʼlumot sohalari bilirubin va boshqa jigar zaxirasi koʻrsatkichlari, koagulyatsiya parametrlari, trombotsitlar soni, qoladigan jigar hajmi yoki rezektsiya koʻlami, tasvirlashga asoslangan radiomik xususiyatlar va perioperativ vaqtga bogʻliq maʼlumotlardan iborat boʻlgan.
Tadqiqotning eng kuchli xabarlaridan biri faqat yuqori AUC qiymatiga eʼtibor qaratmaslikdir. Ichki validatsiyada kuchli koʻringan model boshqa geografiyaga yoki bemorlar taqsimotiga koʻchirilganda samaradorligini yoʻqotishi mumkin. Masalan, Wang K va hamkasblarining vaqtga bogʻliq chuqur oʻrganish modelida AUC ichki baholashda 0,952, Xitoydagi tashqi validatsiyada 0,884 boʻlgan boʻlsa, Gʻarb MIMIC-IV kohortida 0,654 gacha tushgan. Bu misol klinik sunʼiy intellekt modellarida tashqi validatsiya va taqsimot siljishi nega asosiy xavfsizlik masalalari ekanini koʻrsatadi.
Sharhning umumiy bahosiga koʻra, mashinaviy oʻrganish anʼanaviy Child–Pugh, MELD, ALBI, FIB-4 va APRI kabi xavf vositalaridan tashqari koʻplab klinik oʻzgaruvchilarni birgalikda baholash salohiyatiga ega. Ammo mavjud tadqiqotlar bir xil bemor maʼlumotlari va bir xil natija taʼrifi asosida tuzilgan yagona umumiy taqqoslash emas. Shu sababli adabiyotda kuzatilgan ustunlik tendensiyasini “mashinaviy oʻrganish har bir bemorda va har bir markazda anʼanaviy ballardan aniq yaxshiroq” tarzida umumlashtirib boʻlmaydi.
Gepatektomiyadan Keyingi Jigar Yetishmovchiligi (PHLF) Nima?
PHLF — jigar toʻqimasi jarrohlik yoʻli bilan olib tashlangandan soʻng qolgan jigarning organizmning metabolik ehtiyojlarini qondiradigan sintez, chiqarish va detoksifikatsiya imkoniyatini saqlab qola olmasligi holatidir; sharhda qoʻllangan ISGLS doirasi buni operatsiyadan keyingi beshinchi kun yoki undan keyin oshgan INR bilan birga giperbilirubinemiya orqali taʼriflaydi.
Jigar rezektsiyasi gepatotsellyulyar karsinoma, intrahepatik xolangiokarsinoma va kolorektal saratonning jigar metastazlari kabi turli benign va malign kasalliklarda asosiy jarrohlik davolash usullaridan biridir. Jarrohlik texnikasi, anesteziya va perioperativ parvarishda yutuqlarga erishilgan boʻlsa-da, PHLF jigar jarrohligining eng jiddiy asoratlaridan biri boʻlib qolmoqda.
Manbada qayd etilgan PHLF insidensiyasi bemorlar populyatsiyasi, rezektsiya miqdori va asosiy jigar kasalligiga qarab %1,2 dan %32 gacha oʻzgarishi mumkinligi bildiriladi. PHLF xavfi faqat olib tashlangan jigar miqdoriga bogʻliq emas. Kelajakda qoladigan jigar toʻqimasining miqdori va funksional sifati, jigarning regeneratsiya qobiliyati, mavjud fibroz yoki sirroz, steatoz, portal gipertenziya, sarkopeniya va operatsiyaga bogʻliq stress omillari birgalikda rol oʻynashi mumkin.
Kelajakda qoladigan jigar nega muhim?
Future Liver Remnant (FLR) rezektsiyadan keyin bemorda qoladigan funksional jigar toʻqimasini anglatadi. Manbaning adabiyotlar sharhida kompyuter tomografiyasiga asoslangan volumetrik baholash uchun normal jigarda kamida taxminan %20 va funksiyasi buzilgan jigarda taxminan %40 FLR chegaralari keltiriladi. Biroq faqat hajmni oʻlchash qolgan toʻqimaning haqiqiy funksional imkoniyatini toʻliq koʻrsatmaydi.
Shu sababli indosiyanin yashil klirens testi (ICG), gepatobiliar sintigrafiya va gadoxetic acid bilan kuchaytirilgan magnit-rezonans tasvirlash kabi funksional yondashuvlar ishlab chiqilgan. Ushbu testlarning har birida foydalanish imkoniyati, standartlashtirish yoki populyatsiyalararo samaradorlik nuqtai nazaridan cheklovlar mavjud.
Anʼanaviy xavf ballari nega yetarli boʻlmasligi mumkin?
Child–Pugh tasnifi, MELD balli va Albumin–Bilirubin (ALBI) darajasi jigar funksiyasini turli oʻzgaruvchilar orqali baholaydi; biroq PHLF laboratoriya qiymatlari, qoladigan jigar hajmi, bemorning mavjud jigar kasalligi, operatsiya koʻlami va perioperativ oʻzgarishlar kabi koʻplab omillarning birgalikdagi taʼsiriga bogʻliq natijadir. Shu sababli manba klassik ballar yakka holda butun xavf tuzilmasini qamrab olishda cheklangan boʻlishi mumkinligini taʼkidlaydi.
Sharhda iqtibos keltirilgan avvalgi tizimli sharh va meta-tahlilda ALBI ning PHLF bashorati uchun birlashtirilgan AUC qiymati taxminan 0,67 ekani qayd etilgan. Bu topilma murakkabroq va koʻp oʻzgaruvchili modellarni oʻrganish sabablaridan biridir.
PHLF Bashoratida Mashinaviy Oʻrganish Nega Qoʻllanmoqda?
Mashinaviy oʻrganish laboratoriya maʼlumotlari, tasvirlash xususiyatlari, jarrohlik oʻzgaruvchilari va vaqt davomida oʻzgaruvchi perioperativ oʻlchovlar oʻrtasidagi nochiziqli va koʻp oʻzgaruvchili munosabatlarni bitta model ichida baholay olgani uchun PHLF kabi murakkab klinik xavfni individuallashtirilgan tarzda bashorat qilishda oʻrganilmoqda.
Koʻrib chiqilgan adabiyotlarda qoʻllangan usullar bitta algoritmdan iborat emas. Sunʼiy neyron tarmoqlari (Artificial Neural Networks, ANN), LightGBM, XGBoost, konvolyutsion neyron tarmoqlari (CNN), vaqtga bogʻliq chuqur oʻrganish modellari, radiomik yondashuvlar va ensemble tizimlari mavjud.
Bu modellarning maqsadi klassik gepatologiya bilimlarini yoʻq qilish emas. Sharhda yuqori samarali modellarda bilirubin, albumin, INR yoki protrombin vaqti, trombotsitlar soni, ICG-R15, qoladigan jigar miqdori va rezektsiya koʻlami kabi allaqachon klinik jihatdan mazmunli oʻzgaruvchilarning qayta-qayta paydo boʻlishi mashinaviy oʻrganish koʻp hollarda mavjud patofiziologik bilimlarni turli oʻzgaruvchilarga birgalikda vazn berish orqali kengaytirishini koʻrsatadi.
Radiomik maʼlumotlar nimani qoʻshadi?
Radiomika — CT yoki MRI kabi tibbiy tasvirlardan oddiy koʻz bilan bevosita oʻlchash qiyin boʻlgan koʻplab miqdoriy tasvir xususiyatlarini ajratib olish yondashuvidir. Sharhda Zhu, Li va Famularo tadqiqotlarida radiomik maʼlumotlar klinik yoki laboratoriya oʻzgaruvchilari bilan birga qoʻllangan modellar mavjud.
Sharhdagi tadqiqotlararo naqsh tasvirlash maʼlumoti ayrim modellarda faqat klinik maʼlumotga yoki faqat radiomik maʼlumotga nisbatan qoʻshimcha axborot berishi mumkinligiga ishora qiladi. Ammo bu natija yagona umumiy maʼlumotlar toʻplamida oʻtkazilgan nazoratli predictor-ablation tajribasi emas. Sharh mualliflari ham predictor guruhlarining muhimlik tartibini aniq belgilay oladigan umumiy leave-one-domain-out tahlili mavjud emasligini ochiq aytadi.
Perioperativ dinamik maʼlumot nima degani?
Statik preoperativ oʻlchov bemorning faqat bir vaqtdagi holatini ifodalaydi. Perioperativ dinamik maʼlumot esa operatsiyadan oldin, operatsiya paytida va erta operatsiyadan keyingi davrda vaqt bilan oʻzgaradigan laboratoriya yoki klinik oʻlchovlar hosil qilgan trayektoriyadan foydalanadi. Jin, Wang K va Shen tadqiqotlarida bunday vaqtga bogʻliq yoki fazaga xos maʼlumot tuzilmalari muhim tarkibiy qism boʻlgan.
Bu modellar yuqori farqlash qobiliyatini koʻrsatishi mumkin, biroq koʻproq maʼlumot va murakkabroq infratuzilmani talab qilishi mumkin. Bundan tashqari, Wang K tadqiqotidagi MIMIC-IV tashqi validatsiya pasayishi boyroq maʼlumotlardan foydalanish avtomatik ravishda boshqa kasalxonalar yoki geografiyalarda bir xil samaradorlikni kafolatlamasligini koʻrsatadi.
AUC Qiymati Ushbu Tizimli Sharhda Nimani Koʻrsatadi?
AUC — modelning PHLF rivojlangan va rivojlanmagan bemorlarni bir-biridan ajratish qobiliyatini umumlashtiruvchi farqlash kuchi oʻlchovidir; ushbu tizimli sharhda modellar oʻrtasidagi asosiy samaradorlik taqqoslashlaridan biri sifatida ishlatilgan, biroq AUC yolgʻiz oʻzi kalibratsiyani, klinik qaror foydasini yoki boshqa kasalxonadagi haqiqiy samaradorlikni koʻrsatmaydi.
Sharhda qayd etilgan eng yaxshi oʻqitishdan tashqari AUC qiymatlari 0,7927–0,981 oraligʻida boʻlgan va median qiymat 0,873 ni tashkil etgan. Biroq bu raqamlarning barchasi bir xil maʼlumotlar toʻplamidan, bir xil PHLF taʼrifidan yoki bir xil validatsiya protsedurasidan olinmagan. Ayrim tadqiqotlar random train/test ajratishdan foydalangan boʻlsa, boshqalari 5 karrali kross-validatsiya, vaqt boʻyicha validatsiya, tashqi kohort yoki prospektiv validatsiyadan foydalangan.
Shuning uchun 0,95 AUC bildirgan ichki ishlab chiqish tadqiqotini 0,88 AUC olgan mustaqil tashqi validatsiyali modeldan avtomatik ravishda “yaxshiroq” deb hisoblash metodologik jihatdan toʻgʻri emas. Sharhning muhim hissalaridan biri samaradorlik soni bilan birga validatsiya tuzilishiga ham eʼtibor qaratishidir.
Kalibratsiya nega alohida muhim?
Farqlash qobiliyati yuqori xavfli shaxslarni past xavflilardan tartiblash qobiliyatini koʻrsatadi. Klinik xavfni bashorat qilishda bundan tashqari model bergan ehtimollarning haqiqiy hodisa chastotalariga qanchalik mos kelishi, yaʼni kalibratsiya ham muhim. Sharh koʻplab tadqiqotlarda diskriminatsiya kalibratsiyaga qaraganda toʻliqroq hisobot qilinganini va shu sabab klinik taqqoslash cheklanganini bildiradi.
Tadqiqot Usuli va Natijalari
Tizimli sharh dizayni
Sharh PRISMA 2020 tamoyillari va Cochrane Handbook ning diagnostik test aniqligi boʻyicha tizimli sharhlarga doir tavsiyalariga muvofiq tuzilgan. Tadqiqot savoli va maʼlumotlarni ajratib olishni tashkil etishda CHARMS doirasidan foydalanilgan. Maqsadli populyatsiya har qanday sabab bilan gepatik rezektsiya oʻtkazilgan voyaga yetgan bemorlardir.
Indeks modellar PHLF ni bashorat qilish maqsadida ishlab chiqilgan yoki validatsiya qilingan mashinaviy oʻrganish yoki sunʼiy intellekt algoritmlaridir. Natija taʼrifi uchun ISGLS, “50-50” mezonlari, choʻqqi bilirubin qiymatining 7 mg/dL dan yuqori boʻlishi yoki boshqa validatsiya qilingan klinik PHLF taʼriflari qabul qilingan.
Adabiyotlar qanday qidirildi?
PubMed/MEDLINE, Embase, Web of Science Core Collection va Cochrane Library maʼlumotlar bazalari tashkil etilgan paytdan 15 Yanvar 2026 gacha qidirilgan. Qidiruv atamalari uchta asosiy guruhni birlashtirgan: mashinaviy oʻrganish/sunʼiy intellekt usullari, gepatektomiya/jigar rezektsiyasi konteksti va PHLF/jigar yetishmovchiligi natijalari.
Elektron qidiruvga qoʻshimcha ravishda kiritilgan tadqiqotlar va tegishli sharhlarning manbalar roʻyxatlari qoʻlda koʻrib chiqilgan; 2020–2025 davridagi asosiy gepatobiliar jarrohlik yigʻilishlarining tezislari tekshirilgan va nashr ogʻishishini kamaytirish maqsadida Google Scholar orqali kulrang adabiyot qidirilgan.
Kiritish va chiqarib tashlash mezonlari
Kiritilgan tadqiqotlarda 18 yosh yoki undan katta gepatektomiya bemorlarida kamida bitta ML modeli ishlab chiqilishi yoki validatsiya qilinishi hamda AUC, sezgirlik, spetsifiklik, musbat bashorat qiymati, manfiy bashorat qiymati yoki aniqlik kabi kamida bitta samaradorlik metrikasi hisobot qilinishi kerak edi. Faqat anʼanaviy logistik regressiyadan foydalangan tadqiqotlar ML tadqiqoti sifatida kiritilmagan.
Jigar transplantatsiyasiga oid, ammo gepatektomiyani oʻz ichiga olmagan tadqiqotlar, ablatsiya davolashlari, jarrohlik bilan bogʻliq boʻlmagan jigar yetishmovchiligi tadqiqotlari, sharhlar, tahririyat maqolalari, yetarli maʼlumot bermagan konferensiya tezislari, klinik holat hisobotlari va 50 dan kam bemorga ega tadqiqotlar chiqarib tashlangan.
Sarlavha/annotatsiya va toʻliq matn skriningi ikki mustaqil tadqiqotchi tomonidan oʻtkazilgan, kelishmovchiliklar konsensus yoki uchinchi baholovchi orqali hal qilingan. Tadqiqot tanlovi uchun baholovchilararo Cohen kappa qiymati 0,89 deb xabar qilingan.
PRISMA boʻyicha tadqiqot tanlovi
| Bosqich | Soni |
|---|---|
| PubMed yozuvlari | 156 |
| Embase yozuvlari | 134 |
| Web of Science yozuvlari | 98 |
| Cochrane Library yozuvlari | 42 |
| Toʻrtta maʼlumotlar bazasidan jami | 430 |
| Qoʻlda qidirish va konferensiyalardan qoʻshimcha yozuvlar | 12 |
| Olib tashlangan takroriy yozuvlar | 144 |
| Sarlavha/annotatsiya skriningiga qolgan noyob yozuvlar | 298 |
| Sarlavha/annotatsiya bosqichida chiqarilganlar | 241 |
| Toʻliq matni baholanganlar | 57 |
| Toʻliq matnda chiqarilganlar | 45 |
| Yakuniy tizimli sharhga kiritilganlar | 12 |
Toʻliq matnda chiqarib tashlangan 45 tadqiqotning 18 tasida ML/AI modeli boʻlmagani, 9 tasida PHLF birlamchi natija boʻlmagani, 8 tasi sharh yoki tahririyat maqolasi boʻlgani, 5 tasi takroriy bemor kohortlaridan foydalangani va 5 tasida yetarli maʼlumot boʻlmagani chiqarib tashlash sabablari sifatida xabar qilingan.
Maʼlumotlarni ajratib olish va sifatni baholash
CHARMS asosidagi standartlashtirilgan maʼlumot ajratib olish shakli avval uchta tasodifiy tadqiqotda sinovdan oʻtkazilgan, soʻng ikki baholovchi barcha kiritilgan tadqiqotlardan maʼlumotlarni mustaqil ravishda ajratib olgan va oʻzaro tekshirgan. Tadqiqot dizayni, bemor xususiyatlari, foydalanilgan algoritm, bashoratlovchilar, yetishmayotgan maʼlumotlarga yondashuv, samaradorlik metrikalari, kalibratsiya, qaror egri chizigʻi tahlili, validatsiya turi va anʼanaviy ballar bilan taqqoslash kabi oʻzgaruvchilar nishonga olingan.
Risk of bias baholashi PROBAST yordamida ishtirokchilar, bashoratlovchilar, natija va tahlil boʻyicha toʻrtta sohada rejalashtirilgan. Har bir soha past, yuqori yoki noaniq xavf sifatida baholangan; agar biror sohada yuqori xavf boʻlsa, umumiy xavfni yuqori deb qabul qilish koʻzda tutilgan.
Manba ichidagi muhim cheklov: Yakuniy natijalar boʻlimidagi 3-jadval oldingi PROBAST matritsasidagi ayrim manba qatorlari validatsiya qilinmagan yoki notoʻgʻri tasniflangani sababli ushbu matritsani saqlamaganini aniq qayd etadi. Shu sababli yakuniy PDF qoʻllab-quvvatlamaydigan tadqiqotga xos PROBAST ballari Verianla tomonidan qayta yaratilmagan.
Nega meta-tahlil oʻtkazilmadi?
Tadqiqotlar algoritmlar, bashoratlovchilar, PHLF taʼriflari va validatsiya strategiyalari jihatidan sezilarli darajada geterogen boʻlgani sababli rasmiy miqdoriy meta-tahlil oʻrniga narrativ sintez tanlangan. Bu qaror turli PHLF ogʻirliklari va turli validatsiya tuzilmalarini yagona umumiy samaradorlik raqamiga aylantirish chalgʻituvchi boʻlishi mumkinligini anglatadi.
Kiritilgan tadqiqotlarning umumiy tuzilishi
12 tadqiqot jami 6913 bemorni qamrab oladi. Alohida tadqiqotlar hajmi 101 dan 2074 gacha, median namuna hajmi 363,5 ni tashkil etadi. Toʻqqiz tadqiqot Xitoydan; bir tadqiqot Yaponiyadan va ikki tadqiqot koʻp millatli yoki Xitoydan tashqaridagi tashqi validatsiyani oʻz ichiga olgan tuzilishga ega. Yetti tadqiqot bir markazli, besh tadqiqot koʻp markazli. Tang va hamkasblarining tadqiqoti ushbu maʼlumotlar toʻplamida aniq prospektiv validatsiya kohortidan foydalangan yagona tadqiqotdir.
| Tadqiqot | Yil | Mamlakat/kontekst | N | Markaz tuzilishi |
|---|---|---|---|---|
| Mai va b. | 2020 | Xitoy | 353 | Bir markaz |
| Zhu WS va b. | 2020 | Xitoy | 101 | Bir markaz |
| Wang J va b. | 2022 | Xitoy | 875 | 8 markaz |
| Xu va b. | 2023 | Xitoy | 265 | Bir markaz |
| Li va b. | 2023 | Xitoy | 276 | Bir markaz |
| Tashiro va b. | 2024 | Yaponiya | 334 | Bir markaz |
| Jin va b. | 2024 | Xitoy | 226 | Bir markaz |
| Famularo va b. | 2025 | Italiya/Yevropa | 500 | 13 markaz |
| Tang va b. | 2025 | Xitoy | 374 | Bir markaz + prospektiv validatsiya |
| Yuan va b. | 2025 | Xitoy | 464 | Bir markaz |
| Wang K va b. | 2025 | Xitoy + MIMIC | 2074 | Koʻp markaz + tashqi kohort |
| Shen va b. | 2025 | Xitoy | 1071 | 3 markaz |
Qaysi modellar eng yuqori farqlash qobiliyatini koʻrsatdi?
| Tadqiqot | Model | Bildirilgan AUC | Validatsiya tuzilishi |
|---|---|---|---|
| Mai | ANN | 0,880 ishlab chiqish; 0,876 validatsiya | Ajratilgan validatsiya namunasi |
| Zhu | Radiomik asosli model | 0,894 | Ichki validatsiya |
| Wang J | LightGBM | 0,944 oʻqitish; 0,870 validatsiya; 0,822 test | Koʻp kohortli ajratish |
| Xu | CNN / chuqur oʻrganish | 0,7927 | 5 karrali kross-validatsiya |
| Li | Birlashtirilgan radiomik model | 0,84 oʻqitish; 0,82 test | Ajratilgan test namunasi |
| Tashiro | XGBoost | 0,863 | Oʻqitish/test ajratilishi |
| Jin | ANN | 0,766 preoperativ; 0,851 postoperativ; 0,720/0,731 vaqt boʻyicha | 5 karrali CV + vaqt boʻyicha validatsiya |
| Famularo | Averaging ensemble | 0,901 test | Oʻqitish/test ajratilishi |
| Tang | XGBoost | 0,983 oʻqitish; 0,981 validatsiya; 0,942 prospektiv | Ichki + prospektiv validatsiya |
| Yuan | LightGBM | 0,927 oʻqitish; 0,703 test; 0,808 validatsiya | Oʻqitish/test/validatsiya |
| Wang K | Vaqtga bogʻliq chuqur oʻrganish | 0,952 ichki; 0,884 tashqi Xitoy; 0,654 MIMIC | Tashqi + Gʻarb tashqi kohorti |
| Shen | PILOT, fazaga xos arxitektura | 0,754–0,904 oʻqitish; 0,740–0,895 validatsiya | Ikki tashqi kohort |
Manbadagi 2-rasm har bir tadqiqot uchun oʻqitishdan tashqarida qayd etilgan eng yaxshi AUC ni yonma-yon koʻrsatadi. Grafikda Tang 2025 taxminan 0,981 bilan eng yuqorida; undan keyin Famularo 2025 0,901, Shen 2025 0,895, Zhu 2020 0,894 va Wang K 2025 0,884 keladi. Biroq bu tartib modellar bir xil sharoitda taqqoslanganini anglatmaydi.
Tashqi Validatsiya PHLF Modellarida Nega Muhim?
Tashqi validatsiya model ishlab chiqilgan bemorlar guruhidan mustaqil kasalxona, vaqt davri yoki geografiyada oʻxshash samaradorlikni saqlab qolish-qolmasligini tekshiradi; PHLF adabiyotida Wang K modelining AUC si ichki baholashdagi 0,952 dan MIMIC-IV kohortida 0,654 gacha tushishi taqsimot siljishi klinik umumlashtiriluvchanlikni jiddiy oʻzgartirishi mumkinligini koʻrsatadi.
Sharhda umumlashtiriluvchanlik nuqtai nazaridan eng mazmunli belgilar random boʻlmagan validatsiya tuzilmalaridan kelgan. Jin va hamkasblari vaqt boʻyicha validatsiyada 0,720 va 0,731 AUC; Tang va hamkasblari prospektiv validatsiyada 0,942 AUC; Wang K va hamkasblari Xitoy tashqi kohortida 0,884 va MIMIC-IV da 0,654 AUC; Shen va hamkasblari ikki tashqi kohortda 0,740–0,895 oraligʻida AUC bildirgan.
Bu misollar model ishlab chiqish maʼlumotlariga juda oʻxshash ichki test toʻplamida kuchli samaradorlikka erishish klinik koʻchiriluvchanlik bilan bir xil emasligini koʻrsatadi.
Geografik jamlanish nega cheklov tugʻdiradi?
12 tadqiqotning toʻqqiztasi Xitoydan, bittasi Yaponiyadan. Manba bu adabiyot asosan Sharqiy Osiyo, gepatotsellyulyar karsinoma va ayrim kohortlarda HBV bilan bogʻliq jigar kasalligi ustunligiga ega ekanini taʼkidlaydi. Bunga qarshi ravishda Gʻarb bemor populyatsiyalarida yogʻli jigar kasalligi, alkogol bilan bogʻliq jigar kasalligi va kolorektal jigar metastazlari kabi boshqa holatlar taqsimoti boʻlishi mumkin.
Shuning uchun modelning bir mamlakat yoki kasalxona tizimida kuchli natija berishi boshqa qoʻllash geografiyasida ham bir xil kalibratsiya va farqlash qobiliyatini saqlashini anglatmaydi. Maqsadli qoʻllash geografiyasida tashqi validatsiya, zarur boʻlsa qayta kalibratsiya va holatlar tarkibidagi farqlarni ochiq hisobot qilish talab etiladi.
Qaysi bashoratlovchi guruhlari takror-takror uchraydi?
| Bashoratlovchi sohasi | Sharhda uchragan misollar | Ilmiy roli |
|---|---|---|
| Jigar zaxirasi / laboratoriya | Bilirubin, albumin, INR/protrombin vaqti | Jigarning sintez va chiqarish imkoniyatiga oid asosiy klinik signal |
| Gematologik/portal koʻrsatkichlar | Trombotsitlar soni | Portal gipertenziya va jigar kasalligi kontekstidagi xavf axborotiga hissa |
| Funksional testlar | ICG-R15 | Jigar funksional zaxirasini baholovchi maʼlumot |
| Rezektsiya/volumetriya | FLR, rezektsiya koʻlami, qoldiq hajm | Operatsiyadan keyin qoladigan funksional toʻqima va jarrohlik yukini ifodalash |
| Tasvirlash | CT/MRI radiomik xususiyatlari | Parenxima geterogenligini miqdoriy tasvir xususiyatlari bilan ifodalash |
| Dinamik perioperativ maʼlumot | Vaqt davomida oʻzgaruvchi laboratoriya va perioperativ oʻlchovlar | Bitta oʻlchov oʻrniga bemorning oʻzgaruvchi fiziologik kechishini modellashtirish |
Sharhning tadqiqotlararo talqiniga koʻra, statik preoperativ jigar zaxirasi oʻzgaruvchilaridan foydalangan modellar ichki maʼlumotlarda taxminan 0,81–0,88 AUC darajalariga erisha olgan. Tasvirlash radiomikasini qoʻshish ayrim original tadqiqotlarda faqat klinik yoki faqat radiomik submodellarga nisbatan yaxshilanish bergan. Dinamik perioperativ modellar esa kuchli farqlash qobiliyatini koʻrsatishi mumkin boʻlgan, ammo tashqi umumlashtiriluvchanlik borasida aniqroq muammolarga duch kelgan.
Tushuntiriluvchanlik qanday koʻrib chiqilgan?
Tadqiqotlarda tushuntiriluvchanlik uchun SHAP tahlillari, nomogrammalar, feature-importance koʻrsatkichlari, xavf guruhlari va veb-asosli vositalardan foydalanilgan. Ayniqsa yuqori xavfli klinik qarorlarda model faqat ehtimol berishi emas, qaysi oʻzgaruvchilar bashoratga hissa qoʻshganini kuzatish mumkin boʻlishi klinik qabul uchun muhimdir.
ML modellari anʼanaviy ballardan yaxshiroqmi?
Kiritilgan tadqiqotlar ichida bir xil kohortda oʻtkazilgan taqqoslashlar yoʻnalishi odatda ML asosli modellar foydasiga. Mai ning ANN modeli, Zhu ning radiomik modeli, Wang J ning LightGBM modeli, Tashiro ning XGBoost modeli, Jin ning ANN modeli va Tang ning XGBoost modeli kabi misollar anʼanaviy ballar yoki soddaroq klinik modellar bilan taqqoslanganda yuqoriroq farqlash samaradorligini hisobot qilgan.
Biroq tizimli sharhda barcha modellar hamda Child–Pugh, MELD, ALBI, FIB-4 yoki APRI bir xil bemor yozuvlarida qayta oʻqitilib sinovdan oʻtkazilgan birlashtirilgan benchmark bajarilmagan. Bemor darajasida uygʻunlashtirilgan xom maʼlumot boʻlmagani uchun bunday tahlil mumkin boʻlmagan. Shu sabab natija umumiy prospektiv tajriba bilan isbotlangan universal ustunlik emas; balki original tadqiqotlarning oʻz kohortlarida bildirgan natijalari yoʻnalishining izchilligidir.
Adabiyotdagi asosiy boʻshliqlar
Natija taʼrifining geterogenligi: Tadqiqotlar “severe PHLF”, “clinically significant PHLF”, umumiy PHLF va “postoperative liver failure” kabi turli yakuniy nuqtalardan foydalangan. Turli ogʻirlikdagi hodisalarni bashorat qiladigan modellar AUC qiymatlarini yonma-yon qoʻyish klinik taqqoslashni qiyinlashtiradi.
Toʻliq boʻlmagan samaradorlik hisobotlari: AUC tez-tez hisobot qilingan boʻlsa-da, sezgirlik, spetsifiklik, PPV, NPV, kalibratsiya qiyaligi/kesishmasi, qaror egri chizigʻi tahlili va confusion matrix maʼlumotlari izchil berilmagan.
Cheklangan tashqi validatsiya: Sharh bahosiga koʻra faqat toʻrtta tadqiqot vaqt boʻyicha, prospektiv yoki tashqi validatsiya tuzilishiga ega. Gʻarb maʼlumotlar toʻplamiga ochiq koʻchirish testi ayniqsa cheklangan.
Hisoblash xarajatining hisobot qilinmasligi: Kiritilgan tadqiqotlar oʻqitish vaqti, inference kechikishi, xotira ishlatilishi va CPU/GPU talablari kabi texnik joriy etish xarajatlarini tizimli ravishda hisobot qilmagan. Bu kamchilik ayniqsa kasalxona infratuzilmasida real vaqt qoʻllanilishini baholashni qiyinlashtiradi.
Bashoratlovchi soha ablasiyasi: Laboratoriya, koagulyatsiya, volumetriya, radiomika va vaqtga bogʻliq oʻzgaruvchilar guruhlarini bir xil model doirasida ketma-ket chiqarib, qayta oʻqitadigan toʻliq umumiy ablatsiya mavjud emas.
Taqsimot siljishi xavfsizligi: Ishonchi past holatlarni avtomatik qaror oʻrniga klinitsistga yoʻnaltiradigan selective prediction yoki cost-aware deferral kabi xavfsizlik mexanizmlari kiritilgan tadqiqotlarda rasmiy ravishda qoʻllanmagan.
Kelajak tadqiqotlari uchun tavsiyalar
Sharh mualliflari kelajakda birlamchi natija taʼrifi sifatida imkon qadar standartlashtirilgan, klinik jihatdan mazmunli ISGLS grade B/C PHLF dan foydalanishni; AUC bilan birga sezgirlik, spetsifiklik, PPV, NPV, kalibratsiya va qaror egri chizigʻi tahlilini hisobot qilishni; koʻp markazli va geografik jihatdan xilma-xil tashqi validatsiyalarni koʻpaytirishni tavsiya etadi.
Bundan tashqari, laboratoriya asosidagi jigar zaxirasi koʻrsatkichlarini tasvirlash va qisqa muddatli perioperativ vaqt maʼlumotlari bilan birlashtiradigan multimodal modellarni oʻrganish maqsadga muvofiq deb qaraladi. Biroq murakkabroq model haqiqatan ham klinik foyda beradimi-yoʻqmi, buni baholash uchun uni kuchli va arzonroq tayanch modellar bilan bevosita taqqoslash kerak.
Yakuniy bosqichda ehtiyoj faqat yuqoriroq AUC emas. Prospektiv qaror-taʼsir tadqiqotlari bashorat tizimi jarrohlik strategiyasini, FLR ni oshirish aralashuvlarini, postoperativ kuzatuv intensivligini yoki qutqaruv davolashlarini haqiqatan oʻzgartiradimi va bemorlar uchun klinik foyda yaratadimi, shuni koʻrsatishi kerak.
Tadqiqot qoʻllab-quvvatlaydigan xulosalar
Mavjud adabiyot ML asosli modellar PHLF xavfini farqlashda umidbaxsh samaradorlik koʻrsata olishini qoʻllab-quvvatlaydi. Gradient boosting, ANN/chuqur oʻrganish, radiomika va vaqtga bogʻliq modellarning barchasida klinik jihatdan mazmunli farqlash qobiliyati qayd etilgan. Jigar zaxirasi markerlari, tasvirlash va perioperativ maʼlumotlar birgalikda ishlatilganda kuchli modellar yaratish mumkinligiga oid izchil belgilar mavjud.
Sharh validatsiya dizayni model muvaffaqiyati qadar muhim ekanini ham qoʻllab-quvvatlaydi. Ayniqsa vaqt boʻyicha, prospektiv va mustaqil tashqi validatsiyalar modelning haqiqiy umumlashtiriluvchanligi haqida tasodifiy ichki test boʻlinmalariga qaraganda kuchliroq dalil beradi.
Tadqiqot qoʻllab-quvvatlamaydigan xulosalar
Sharh muayyan ML arxitekturasi PHLF uchun universal ravishda eng yaxshi model ekanini koʻrsatmaydi. 0,981 kabi yuqori AUC qiymatlari barcha kasalxona, mamlakat va bemor guruhlariga koʻchirilishi mumkin boʻlgan kafolatlangan samaradorlik qiymatlari emas.
Tadqiqot ML asosidagi PHLF bashorat vositalaridan odatiy klinik foydalanish bemor oʻlimini yoki asoratlar ulushini kamaytirishini isbotlaydigan qaror-taʼsir tajribasi emas. Kiritilgan modellarning aksariyati retrospektiv maʼlumotlarga asoslangan va koʻplab modellar mustaqil tashqi validatsiyadan oʻtmagan.
Mashinaviy oʻrganish klinitsist qarorini avtomatik ravishda oʻzgartirishi yoki operatsiya qarorini yakka oʻzi berishi kerak, degan xulosani ham ushbu tizimli sharhdan chiqarib boʻlmaydi. Manbaning kelajak istiqboli yanada shaffof, tashqi validatsiyadan oʻtgan, kalibrlangan va klinik qaror foydasi koʻrsatilgan tizimlarga ehtiyoj borligini taʼkidlaydi.
Manba va Usul Haqida Izoh
Original tadqiqot: Machine Learning Models for Predicting Post-Hepatectomy Liver Failure: A Systematic Review
Mualliflar: Calin Muntean; Vasile Gaborean; Razvan Constantin Vonica; Sebastian Aurelian Stefaniga; Alaviana Monique Faur; Catalin Vladut Ionut Feier.
Masʼul mualliflar: Vasile Gaborean va Razvan Constantin Vonica.
Muassasalar: “Victor Babeş” University of Medicine and Pharmacy Timişoara tarkibidagi Medical Informatics and Biostatistics, Thoracic Surgery Research Center, Surgical Semiology, Doctoral Studies va Abdominal Surgery and Phlebology Research Center boʻlimlari; “Lucian Blaga” University of Sibiu, Preclinical Department/Physiology; West University of Timişoara, Department of Computer Science; “Pius Brinzeu” Clinical Emergency Hospital, First Surgery Clinic.
Jurnal: AI.
Nashriyot: MDPI.
Manba turi: Tizimli sharh.
Nashr maʼlumoti: AI 2026, 7(5), 166.
DOI: 10.3390/ai7050166
Topshirilgan: 27 Mart 2026.
Qayta koʻrib chiqilgan: 25 Aprel 2026.
Qabul qilingan: 5 May 2026.
Nashr qilingan: 9 May 2026.
Rasmiy nashr manzili: https://www.mdpi.com/2673-2688/7/5/166
Litsenziya: Ochiq kirish, Creative Commons Attribution (CC BY).
Tizimli sharh doirasi: PRISMA 2020, Cochrane Handbook tavsiyalari, CHARMS va PROBAST qoʻllangan.
Roʻyxatdan oʻtkazish izohi: Maqolaning annotatsiya va usul boʻlimida protokol PROSPERO da roʻyxatdan oʻtkazilgani qayd etilgan. Xuddi shu usul boʻlimida Open Science Framework roʻyxati sifatida DOI 10.17605/OSF.IO/67CQ3 ham berilgan. PDF ichida alohida PROSPERO CRD roʻyxat raqami koʻrinmagani sababli bu ikki bayonot birlashtirilmagan yoki taxmin qilinmagan.
Moliyalashtirish: Maqolaning article processing charge toʻlovi Victor Babeş University of Medicine and Pharmacy Timişoara tomonidan qoplangani qayd etilgan.
Institutsional etika kengashi: Qoʻllanilmaydi.
Axborotlashtirilgan rozilik: Qoʻllanilmaydi.
Maʼlumotlar mavjudligi: Mualliflar ushbu tizimli sharh uchun yangi maʼlumot yaratilmagan yoki tahlil qilinmaganini bildiradi.
Manfaatlar toʻqnashuvi: Mualliflar manfaatlar toʻqnashuvi yoʻqligini bayon qilgan.
AI dan foydalanish bayonoti: Mualliflar ChatGPT v4.0 dan faqat maqola tili va oʻqilishini yaxshilash maqsadida foydalanganliklarini; ilmiy mazmun, sharhlar va xulosalar mualliflarga tegishli ekanini bildirgan.
Muallif hissalari: Konseptuallashtirish Calin Muntean, Vasile Gaborean va Razvan Constantin Vonica; metodologiya Calin Muntean, Sebastian Aurelian Stefaniga va Razvan Constantin Vonica; dasturiy taʼminot Sebastian Aurelian Stefaniga; validatsiya Calin Muntean, Vasile Gaborean va Razvan Constantin Vonica; formal tahlil Calin Muntean va Sebastian Aurelian Stefaniga; tadqiqot Calin Muntean va Alaviana Monique Faur; maʼlumotlar kuratsiyasi Calin Muntean va Alaviana Monique Faur tomonidan bajarilgan. Dastlabki loyiha Calin Muntean tomonidan tayyorlangan; koʻrib chiqish va tahrirga Vasile Gaborean, Razvan Constantin Vonica, Sebastian Aurelian Stefaniga va Catalin Vladut Ionut Feier hissa qoʻshgan.
Asosiy metodologik cheklovlar: Kiritilgan tadqiqotlarning aksariyati retrospektiv va bir markazli ekani; PHLF yakuniy nuqtasining geterogen taʼriflanishi; maʼlumotlarning geografik jihatdan Sharqiy Osiyoga ogʻishganligi; kalibratsiya, sezgirlik va spetsifiklikning izchil hisobot qilinmagani; tashqi validatsiya yetishmasligi; turli model oilalarini bevosita taqqoslab boʻlmasligi va hisoblash xarajatlari yetarli hisobot qilinmagani.
Verianla usul izohi: Ushbu matn manba maqolaning satrma-satr tarjimasi emas. Manbadagi klinik muammo, tizimli sharh usuli, bemor va tadqiqot sonlari, model samaradorliklari, validatsiya strategiyalari, bashoratlovchi sohalari, rasmlarning ilmiy xabari, muhokama va cheklovlar saqlangan holda mustaqil oʻquv tuzilmasi yaratilgan. Manbada boʻlmagan klinik natija, samaradorlik metrikasi yoki model muvaffaqiyati qoʻshilmagan.
Tibbiy talqin chegarasi: Bu yerda keltirilgan model samaradorliklari klinik qarorni qoʻllab-quvvatlash tadqiqotlariga tegishli. Ular yakka oʻzi biror bemorning operatsiyaga mosligini, PHLF xavfini yoki davolash rejasini belgilash uchun ishlatilmaydi; klinik qarorlar bemorga xos baholash va validatsiya qilingan mahalliy protokollarni talab qiladi.
Izoh qoldiring
E-pochta manzilingiz chop etilmaydi. Majburiy maydonlar * bilan belgilangan