

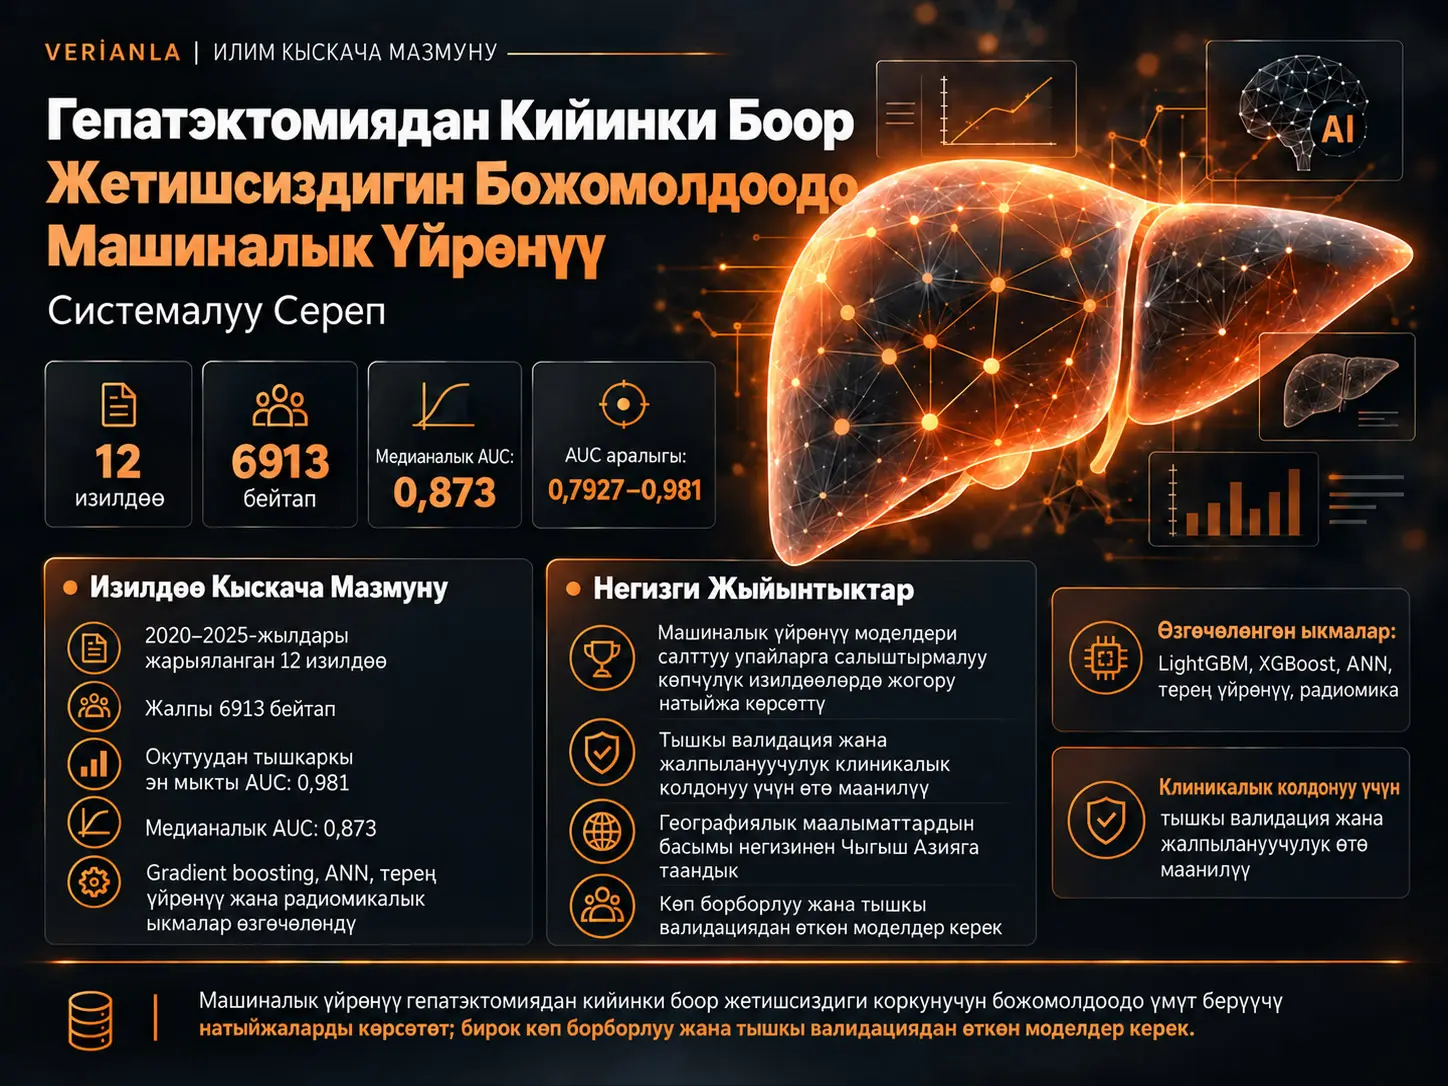
Гепатэктомиядан кийинки боор жетишсиздиги (Post-Hepatectomy Liver Failure, PHLF) — боор резекциясынан кийин боордун синтездөө, бөлүп чыгаруу жана детоксикация функцияларын жетиштүү деңгээлде уланта албай калышы менен мүнөздөлгөн олуттуу операциядан кийинки татаалдашуу. Бул системалуу сереп PHLF коркунучун божомолдоо үчүн иштелип чыккан машиналык үйрөнүү моделдеринин айырмалоо көрсөткүчтөрүн, колдонулган божомолдоочуларды, валидация ыкмаларын, методологиялык сапатын жана клиникалык колдонууга жарамдуулугун баалайт. Жыйынтык сереп 2020–2025 аралыгында жарыяланган 12 изилдөөнү жана жалпы 6913 бейтапты камтыйт. Окутуу маалыматтарынан тышкары билдирилген эң мыкты AUC маанилери 0,7927 менен 0,981 аралыгында өзгөрүп, медианалык AUC 0,873 болгон. Ошентсе да изилдөөлөрдүн көпчүлүгү ретроспективдүү болгону, PHLF аныктамалары бирдей эместиги жана тышкы валидация чектелүү калганы үчүн бул көрсөткүчтөрдү түздөн-түз күнүмдүк клиникалык колдонууга даяр системалар катары чечмелөөгө болбойт.
Серепте gradient boosting үй-бүлөсү, айрыкча LightGBM жана XGBoost, көп кездешкен жогорку натыйжалуу ыкмалардын катарына кирет. Жасалма нейрон тармактары, терең үйрөнүү, компьютердик томография же магниттик-резонанстык сүрөттөрдөн радиомикалык белгилерди чыгаруучу моделдер жана ensemble системалары да олуттуу айырмалоо жөндөмүн көрсөткөн. Эң көп колдонулган маалымат тармактарына билирубин жана боор резервинин башка көрсөткүчтөрү, коагуляция параметрлери, тромбоциттердин саны, калуучу боордун көлөмү же резекциянын масштабы, сүрөттөөгө негизделген радиомикалык белгилер жана периоперациялык убакыттык маалыматтар кирген.
Изилдөөнүн эң маанилүү билдирүүлөрүнүн бири — жалаң гана жогорку AUC маанисине көңүл бурбоо. Ички валидацияда күчтүү көрүнгөн модель башка географияга же бейтаптардын башка бөлүштүрүлүшүнө көчүрүлгөндө натыйжалуулугун жоготушу мүмкүн. Мисалы, Wang K жана кесиптештеринин убакыттык терең үйрөнүү моделинде AUC ички баалоодо 0,952, Кытайдагы тышкы валидацияда 0,884 болсо, Батыштагы MIMIC-IV когортунда 0,654кө чейин төмөндөгөн. Бул мисал клиникалык жасалма интеллект моделдеринде тышкы валидация менен бөлүштүрүүнүн жылышы эмне үчүн негизги коопсуздук маселелери экенин көрсөтөт.
Серептин жалпы баалоосуна ылайык, машиналык үйрөнүү салттуу Child–Pugh, MELD, ALBI, FIB-4 жана APRI сыяктуу тобокелдик куралдарынан тышкары көптөгөн клиникалык өзгөрмөлөрдү биргелешип баалоо мүмкүнчүлүгүнө ээ. Бирок учурдагы изилдөөлөр бир эле бейтап маалыматтары жана бир эле натыйжа аныктамасы боюнча түзүлгөн бирдиктүү жалпы салыштыруу эмес. Ошондуктан адабиятта байкалган артыкчылык тенденциясын “машиналык үйрөнүү ар бир бейтапта жана ар бир борбордо салттуу шкалалардан сөзсүз жакшы” деп жалпылоого болбойт.
Гепатэктомиядан Кийинки Боор Жетишсиздиги (PHLF) Деген Эмне?
PHLF — боор тканы хирургиялык жол менен алынгандан кийин калган боордун организмдин метаболизмдик муктаждыктарын камсыз кыла турган синтездөө, бөлүп чыгаруу жана детоксикация мүмкүнчүлүгүн сактай албай калышы; серепте колдонулган ISGLS алкагы муну операциядан кийинки бешинчи күнү же андан кийин жогорулаган INR менен коштолгон гипербилирубинемия аркылуу аныктайт.
Боор резекциясы гепатоцеллюлярдык карцинома, интрагепатикалык холангиокарцинома жана колоректалдык рактын боор метастаздары сыяктуу ар кандай залалсыз жана залалдуу ооруларда негизги хирургиялык дарылоолордун бири болуп саналат. Хирургиялык техникада, анестезияда жана периоперациялык кам көрүүдө өнүгүү болгонуна карабастан, PHLF боор хирургиясынын эң олуттуу татаалдашууларынын бири бойдон калууда.
Булак билдирилген PHLF кездешүүсү бейтаптардын популяциясына, резекциянын көлөмүнө жана негизги боор оорусуна жараша %1,2 менен %32 аралыгында өзгөрүшү мүмкүн экенин көрсөтөт. PHLF коркунучу алып салынган боордун көлөмүнө гана байланыштуу эмес. Келечекте калуучу боор тканынын көлөмү жана функциялык сапаты, боордун регенерация жөндөмү, учурдагы фиброз же цирроз, стеатоз, порталдык гипертензия, саркопения жана операцияга байланыштуу стресс факторлору биргелешип роль ойношу мүмкүн.
Келечекте калуучу боор эмне үчүн маанилүү?
Future Liver Remnant (FLR) — резекциядан кийин бейтапта кала турган функциялык боор тканы. Булактын адабияттык жыйынтыгында компьютердик томографияга негизделген көлөмдүк баалоо үчүн нормалдуу боордо кеминде болжол менен %20 жана функциясы бузулган боордо болжол менен %40 FLR чектери келтирилет. Бирок көлөмдү гана өлчөө калган ткандын чыныгы функциялык мүмкүнчүлүгүн толук көрсөтпөйт.
Ошондуктан индоцианин жашылынын клиренс тести (ICG), гепатобилиардык сцинтиграфия жана gadoxetic acid менен күчөтүлгөн магниттик-резонанстык сүрөттөө сыяктуу функциялык ыкмалар иштелип чыккан. Бул тесттердин ар биринде жеткиликтүүлүк, стандартташтыруу же популяциялар аралык натыйжалуулук боюнча чектөөлөр бар.
Салттуу тобокелдик шкалалары эмне үчүн жетишсиз болушу мүмкүн?
Child–Pugh классификациясы, MELD шкаласы жана Albumin–Bilirubin (ALBI) даражасы боор функциясын ар башка өзгөрмөлөр аркылуу баалайт; бирок PHLF лабораториялык көрсөткүчтөр, калган боордун көлөмү, бейтаптын учурдагы боор оорусу, операциянын масштабы жана периоперациялык өзгөрүүлөр сыяктуу көп факторлор биргелешип таасир эткен натыйжа болуп саналат. Ошондуктан булак классикалык шкалалар өз алдынча тобокелдиктин толук түзүмүн камтууда чектелүү болушу мүмкүн экенин баса белгилейт.
Серепте шилтеме берилген мурдагы системалуу серепте жана мета-анализде ALBIнин PHLF божомолу үчүн бириктирилген AUC мааниси болжол менен 0,67 экени айтылат. Бул жыйынтык татаалыраак жана көп өзгөрмөлүү моделдерди изилдөөнүн себептеринин бири.
PHLF Божомолунда Машиналык Үйрөнүү Эмне Үчүн Колдонулат?
Машиналык үйрөнүү лабораториялык маалыматтар, сүрөттөө белгилери, хирургиялык өзгөрмөлөр жана убакыттын өтүшү менен өзгөргөн периоперациялык өлчөөлөрдүн ортосундагы сызыктуу эмес жана көп өзгөрмөлүү байланыштарды бир эле моделдин ичинде баалай алгандыктан, PHLF сыяктуу татаал клиникалык тобокелдикти жекелештирилген түрдө божомолдоодо изилденүүдө.
Каралган адабиятта колдонулган ыкмалар бир гана алгоритмден турбайт. Жасалма нейрон тармактары (Artificial Neural Networks, ANN), LightGBM, XGBoost, конволюциялык нейрон тармактары (CNN), убакыттык терең үйрөнүү моделдери, радиомикалык ыкмалар жана ensemble системалары колдонулган.
Бул моделдердин максаты классикалык гепатологиялык билимди жокко чыгаруу эмес. Серепте жогорку натыйжалуу моделдерде билирубин, albumin, INR же протромбин убактысы, тромбоциттердин саны, ICG-R15, калган боордун көлөмү жана резекциянын масштабы сыяктуу клиникалык жактан маанилүү өзгөрмөлөрдүн кайра-кайра чыгышы машиналык үйрөнүү көп учурда учурдагы патофизиологиялык билимди ар башка өзгөрмөлөрдү биргелешип салмактоо аркылуу кеңейтерин көрсөтөт.
Радиомикалык маалымат эмнени кошот?
Радиомика — CT же MRI сыяктуу медициналык сүрөттөрдөн жөнөкөй көз менен түздөн-түз өлчөө кыйын болгон көп сандагы сандык сүрөт белгилерин чыгарып алуу ыкмасы. Серепте Zhu, Li жана Famularo изилдөөлөрүндө радиомикалык маалымат клиникалык же лабораториялык өзгөрмөлөр менен бирге колдонулган моделдер бар.
Серептеги изилдөөлөр аралык үлгү сүрөттөө маалыматы айрым моделдерде жалаң клиникалык маалыматка же жалаң радиомикалык маалыматка салыштырмалуу кошумча маалымат бере аларын көрсөтөт. Бирок бул жыйынтык бирдиктүү жалпы маалымат топтомунда жүргүзүлгөн көзөмөлдөнгөн predictor-ablation эксперименти эмес. Серептин авторлору да predictor топторунун маанилүүлүк тартибин так аныктай ала турган жалпы leave-one-domain-out анализи жок экенин ачык белгилешет.
Периоперациялык динамикалык маалымат деген эмне?
Статикалык предоперациялык өлчөө бейтаптын бир гана убактагы абалын билдирет. Периоперациялык динамикалык маалымат болсо операцияга чейин, операция учурунда жана эрте операциядан кийинки мезгилде убакыт өткөн сайын өзгөргөн лабораториялык же клиникалык өлчөөлөр түзгөн траекторияны колдонот. Jin, Wang K жана Shen изилдөөлөрүндө мындай убакыттык же фазага мүнөздүү маалымат түзүмдөрү маанилүү компонент болгон.
Бул моделдер жогорку айырмалоо жөндөмүн көрсөтүшү мүмкүн, бирок көбүрөөк маалыматты жана татаалыраак инфраструктураны талап кылышы мүмкүн. Мындан тышкары, Wang K изилдөөсүндөгү MIMIC-IV тышкы валидациясынын төмөндөшү байыраак маалыматты колдонуу ар башка ооруканаларда же географияларда бирдей натыйжалуулукту автоматтык түрдө кепилдебей турганын көрсөтөт.
AUC Мааниси Бул Системалуу Серепте Эмнени Көрсөтөт?
AUC — моделдин PHLF өнүккөн жана өнүкпөгөн бейтаптарды бири-биринен айырмалоо жөндөмүн жалпылаган айырмалоо күчүнүн көрсөткүчү; бул системалуу серепте моделдер аралык негизги натыйжалуулук салыштырууларынын бири катары колдонулган, бирок AUC өз алдынча калибрацияны, клиникалык чечимдин пайдасын же башка ооруканадагы чыныгы натыйжалуулукту көрсөтпөйт.
Серепте билдирилген эң мыкты окутуудан тышкаркы AUC маанилери 0,7927–0,981 аралыгында өзгөрүп, медианалык мааниси 0,873 болгон. Бирок бул сандардын баары бир эле маалымат топтомунан, бир эле PHLF аныктамасынан же бир эле валидация процедурасынан алынган эмес. Айрым изилдөөлөр random train/test бөлүүнү колдонсо, башкалары 5 катмарлуу кайчылаш валидацияны, убакыттык валидацияны, тышкы когортту же проспективдүү валидацияны колдонгон.
Ошондуктан 0,95 AUC билдирген ички иштеп чыгуу изилдөөсүн 0,88 AUC алган көз карандысыз тышкы валидациясы бар моделден автоматтык түрдө “жакшыраак” деп эсептөө методологиялык жактан туура эмес. Серептин маанилүү салымдарынын бири — натыйжалуулук саны менен катар валидация түзүмүнө да көңүл буруу.
Калибрация эмне үчүн өзүнчө маанилүү?
Айырмалоо жөндөмү жогорку тобокелдиктеги адамдарды төмөн тобокелдиктеги адамдардан иреттөө жөндөмүн көрсөтөт. Клиникалык тобокелдикти божомолдоодо мындан тышкары модел берген ыктымалдыктардын чыныгы окуялардын жыштыгына канчалык шайкеш келери, башкача айтканда калибрация да маанилүү. Сереп көптөгөн изилдөөлөрдө дискриминация калибрацияга караганда толугураак билдирилгенин жана ошондуктан клиникалык салыштыруу чектелүү калганын белгилейт.
Изилдөөнүн Ыкмасы жана Жыйынтыктары
Системалуу серептин дизайны
Сереп PRISMA 2020 принциптерине жана Cochrane Handbook китебинин диагностикалык тесттердин тактыгына арналган системалуу серептер боюнча сунуштарына ылайык түзүлгөн. Изилдөө суроосун жана маалыматтарды бөлүп алууну уюштурууда CHARMS алкагы колдонулган. Максаттуу популяция — кандайдыр бир себептен гепатикалык резекция жасалган бойго жеткен бейтаптар.
Индекс моделдер PHLFни божомолдоо үчүн иштелип чыккан же валидацияланган машиналык үйрөнүү же жасалма интеллект алгоритмдери. Натыйжанын аныктамасы үчүн ISGLS, “50-50” критерийлери, эң жогорку билирубин маанисинин 7 mg/dLден жогору болушу же башка валидацияланган клиникалык PHLF аныктамалары кабыл алынган.
Адабият кантип изделди?
PubMed/MEDLINE, Embase, Web of Science Core Collection жана Cochrane Library маалымат базалары түзүлгөн күнүнөн 15 Январь 2026га чейин изделген. Издөө терминдери үч негизги топту бириктирген: машиналык үйрөнүү/жасалма интеллект ыкмалары, гепатэктомия/боор резекциясы контексти жана PHLF/боор жетишсиздиги натыйжалары.
Электрондук издөөгө кошумча киргизилген изилдөөлөрдүн жана тиешелүү серептердин булак тизмелери кол менен текшерилген; 2020–2025 мезгилиндеги негизги гепатобилиардык хирургиялык жыйындардын тезистери каралган жана жарыялоо ыктоосун азайтуу максатында Google Scholar аркылуу боз адабият изделген.
Киргизүү жана чыгарып салуу критерийлери
Киргизилген изилдөөлөрдө 18 жаштагы же андан улуу гепатэктомия бейтаптарында кеминде бир ML модели иштелип чыгышы же валидацияланышы жана AUC, сезгичтик, спецификалуулук, оң божомолдук маани, терс божомолдук маани же тактык сыяктуу кеминде бир натыйжалуулук метрикасы билдирилиши керек болгон. Салттуу логистикалык регрессияны гана колдонгон изилдөөлөр ML изилдөөсү катары киргизилген эмес.
Боор трансплантациясын камтып, бирок гепатэктомияны камтыбаган изилдөөлөр, абляциялык дарылоолор, хирургияга байланышпаган боор жетишсиздиги изилдөөлөрү, серептер, редакциялык макалалар, жетиштүү маалымат камтыбаган конференция тезистери, клиникалык учур баяндамалары жана 50дөн аз бейтаптуу изилдөөлөр чыгарылган.
Аталыш/кыскача мазмун жана толук текст боюнча скрининг эки көз карандысыз изилдөөчү тарабынан жүргүзүлүп, пикир келишпестиктер консенсус же үчүнчү баалоочунун жардамы менен чечилген. Изилдөөлөрдү тандоодо баалоочулар аралык Cohen kappa мааниси 0,89 деп билдирилген.
PRISMA боюнча изилдөөлөрдү тандоо
| Баскыч | Саны |
|---|---|
| PubMed жазуулары | 156 |
| Embase жазуулары | 134 |
| Web of Science жазуулары | 98 |
| Cochrane Library жазуулары | 42 |
| Төрт маалымат базасынан жалпы | 430 |
| Кол менен издөөдөн жана конференциялардан кошумча жазуулар | 12 |
| Алып салынган кайталанма жазуулар | 144 |
| Аталыш/кыскача мазмун скринингине калган уникалдуу жазуулар | 298 |
| Аталыш/кыскача мазмун баскычында чыгарылгандар | 241 |
| Толук тексти баалангандар | 57 |
| Толук текстте чыгарылгандар | 45 |
| Жыйынтык системалуу серепке киргизилгендер | 12 |
Толук текстте чыгарылган 45 изилдөөнүн 18инде ML/AI модели болбогону, 9унда PHLF негизги натыйжа болбогону, 8и сереп же редакциялык макала болгону, 5и кайталанган бейтап когортторун колдонгону жана 5инде жетиштүү маалымат болбогону чыгарып салуунун себептери катары билдирилген.
Маалыматтарды бөлүп алуу жана сапатты баалоо
CHARMSке негизделген стандартташтырылган маалымат бөлүп алуу формасы адегенде үч кокус изилдөөдө сыналып, андан соң эки баалоочу киргизилген бардык изилдөөлөрдөн маалыматтарды көз карандысыз бөлүп алып, кайчылаш текшеришкен. Изилдөө дизайны, бейтаптын өзгөчөлүктөрү, колдонулган алгоритм, божомолдоочулар, жетишпеген маалыматка мамиле, натыйжалуулук метрикалары, калибрация, чечим ийри сызыгынын анализи, валидациянын түрү жана салттуу шкалалар менен салыштыруу сыяктуу өзгөрмөлөр максатталган.
Risk of bias баалоосу PROBAST менен катышуучулар, божомолдоочулар, натыйжа жана анализ болуп төрт тармакта пландалган. Ар бир тармак төмөн, жогорку же белгисиз тобокелдик катары бааланып; эгер кандайдыр бир тармак жогорку тобокелдикке ээ болсо, жалпы тобокелдик жогорку деп эсептелиши каралган.
Булак ичиндеги маанилүү чек: Жыйынтык натыйжалар бөлүмүндөгү 3-таблица мурдагы PROBAST матрицасында айрым булак саптары текшерилбеген же туура эмес классификациялангандыктан бул матрицаны сактабаганын ачык белгилейт. Ошондуктан жыйынтык PDF колдобогон изилдөөгө мүнөздүү PROBAST упайлары Verianla тарабынан кайра түзүлгөн эмес.
Эмне үчүн мета-анализ жүргүзүлгөн жок?
Изилдөөлөр алгоритмдер, божомолдоочулар, PHLF аныктамалары жана валидация стратегиялары боюнча олуттуу гетерогендүү болгондуктан, расмий сандык мета-анализдин ордуна баяндоочу синтез тандалган. Бул чечим PHLFнин ар башка оордук даражаларын жана ар башка валидация түзүмдөрүн бир жалпы натыйжалуулук санына айлантуу жаңылыштыкка алып келиши мүмкүн экенин билдирет.
Киргизилген изилдөөлөрдүн жалпы түзүмү
12 изилдөө жалпы 6913 бейтапты камтыйт. Жеке изилдөөлөрдүн өлчөмү 101ден 2074кө чейин, медианалык тандалма өлчөмү 363,5. Тогуз изилдөө Кытайдан; бир изилдөө Япониядан жана эки изилдөө көп улуттуу же Кытайдан тышкаркы тышкы валидацияны камтыган түзүмгө ээ. Жети изилдөө бир борборлуу, беш изилдөө көп борборлуу. Tang жана кесиптештеринин изилдөөсү бул маалымат топтомунда проспективдүү валидация когортун ачык колдонгон жалгыз изилдөө.
| Изилдөө | Жыл | Өлкө/контекст | N | Борбор түзүмү |
|---|---|---|---|---|
| Mai ж.б. | 2020 | Кытай | 353 | Бир борбор |
| Zhu WS ж.б. | 2020 | Кытай | 101 | Бир борбор |
| Wang J ж.б. | 2022 | Кытай | 875 | 8 борбор |
| Xu ж.б. | 2023 | Кытай | 265 | Бир борбор |
| Li ж.б. | 2023 | Кытай | 276 | Бир борбор |
| Tashiro ж.б. | 2024 | Япония | 334 | Бир борбор |
| Jin ж.б. | 2024 | Кытай | 226 | Бир борбор |
| Famularo ж.б. | 2025 | Италия/Европа | 500 | 13 борбор |
| Tang ж.б. | 2025 | Кытай | 374 | Бир борбор + проспективдүү валидация |
| Yuan ж.б. | 2025 | Кытай | 464 | Бир борбор |
| Wang K ж.б. | 2025 | Кытай + MIMIC | 2074 | Көп борбор + тышкы когорт |
| Shen ж.б. | 2025 | Кытай | 1071 | 3 борбор |
Кайсы моделдер эң жогорку айырмалоо жөндөмүн көрсөткөн?
| Изилдөө | Модель | Билдирилген AUC | Валидация түзүмү |
|---|---|---|---|
| Mai | ANN | 0,880 иштеп чыгуу; 0,876 валидация | Бөлүнгөн валидация тандалмасы |
| Zhu | Радиомикага негизделген модель | 0,894 | Ички валидация |
| Wang J | LightGBM | 0,944 окутуу; 0,870 валидация; 0,822 тест | Көп когорттуу бөлүү |
| Xu | CNN / терең үйрөнүү | 0,7927 | 5 катмарлуу кайчылаш валидация |
| Li | Бириктирилген радиомикалык модель | 0,84 окутуу; 0,82 тест | Бөлүнгөн тест тандалмасы |
| Tashiro | XGBoost | 0,863 | Окутуу/test бөлүү |
| Jin | ANN | 0,766 предоперациялык; 0,851 постоперациялык; 0,720/0,731 убакыттык | 5 катмарлуу CV + убакыттык валидация |
| Famularo | Averaging ensemble | 0,901 test | Окутуу/test бөлүү |
| Tang | XGBoost | 0,983 окутуу; 0,981 валидация; 0,942 проспективдүү | Ички + проспективдүү валидация |
| Yuan | LightGBM | 0,927 окутуу; 0,703 test; 0,808 валидация | Окутуу/test/валидация |
| Wang K | Убакыттык терең үйрөнүү | 0,952 ички; 0,884 тышкы Кытай; 0,654 MIMIC | Тышкы + Батыштагы тышкы когорт |
| Shen | PILOT, фазага мүнөздүү архитектура | 0,754–0,904 окутуу; 0,740–0,895 валидация | Эки тышкы когорт |
Булактагы 2-сүрөт ар бир изилдөө үчүн окутуудан тышкары билдирилген эң мыкты AUCни катар көрсөтөт. Графикте Tang 2025 болжол менен 0,981 менен эң жогоруда; андан кийин Famularo 2025 0,901, Shen 2025 0,895, Zhu 2020 0,894 жана Wang K 2025 0,884 турат. Бирок бул иреттөө моделдер бирдей шартта салыштырылган дегенди билдирбейт.
Тышкы Валидация PHLF Моделдеринде Эмне Үчүн Критикалык?
Тышкы валидация модель иштелип чыккан бейтаптар тобунан көз карандысыз ооруканада, убакыт мезгилинде же географияда окшош натыйжалуулукту сактай алар-албасын текшерет; PHLF адабиятында Wang K моделинин AUC маанисинин ички баалоодогу 0,952ден MIMIC-IV когортунда 0,654кө түшүшү бөлүштүрүүнүн жылышы клиникалык жалпыланууну олуттуу өзгөртө аларын көрсөтөт.
Серепте жалпылануу жагынан эң маанилүү белгилер random эмес валидация түзүмдөрүнөн чыккан. Jin жана кесиптештери убакыттык валидацияда 0,720 жана 0,731 AUC; Tang жана кесиптештери проспективдүү валидацияда 0,942 AUC; Wang K жана кесиптештери Кытайдагы тышкы когортто 0,884 жана MIMIC-IVде 0,654 AUC; Shen жана кесиптештери эки тышкы когортто 0,740–0,895 аралыгындагы AUC билдиришкен.
Бул мисалдар модель иштеп чыгуу маалыматтарына абдан окшош ички тест топтомунда күчтүү натыйжа алуу клиникалык көчүрүлүүчүлүк менен бирдей эмес экенин көрсөтөт.
Географиялык топтолуу эмне үчүн чектөө жаратат?
12 изилдөөнүн тогузу Кытайдан, бири Япониядан. Булак бул адабият негизинен Чыгыш Азия, гепатоцеллюлярдык карцинома жана айрым когорттордо HBV менен байланышкан боор оорусу басымдуу экенин белгилейт. Ал эми Батыш бейтап популяцияларында майлуу боор оорусу, алкоголь менен байланышкан боор оорусу жана колоректалдык боор метастаздары сыяктуу башка учурлардын бөлүштүрүлүшү болушу мүмкүн.
Ошондуктан модель бир өлкөдө же оорукана системасында күчтүү натыйжа бергени башка колдонуу географиясында ошол эле калибрацияны жана айырмалоо жөндөмүн сактайт дегенди билдирбейт. Максаттуу колдонуу географиясында тышкы валидация, зарыл болсо кайра калибрация жана учурлардын курамындагы айырмачылыктарды ачык билдирүү керек.
Кайсы божомолдоочу топтор кайра-кайра кездешет?
| Божомолдоочу тармак | Серепте кездешкен мисалдар | Илимий ролу |
|---|---|---|
| Боор резерви / лаборатория | Билирубин, albumin, INR/протромбин убактысы | Боордун синтездөө жана бөлүп чыгаруу мүмкүнчүлүгүнө байланышкан негизги клиникалык сигнал |
| Гематологиялык/порталдык көрсөткүчтөр | Тромбоциттердин саны | Порталдык гипертензия жана боор оорусу контекстиндеги тобокелдик маалыматына салым |
| Функциялык тесттер | ICG-R15 | Боордун функциялык резервин баалоочу маалымат |
| Резекция/волюметрия | FLR, резекциянын масштабы, калдык көлөм | Операциядан кийин кала турган функциялык ткандын көлөмүн жана хирургиялык жүктү көрсөтүү |
| Сүрөттөө | CT/MRI радиомикалык белгилери | Паренхиманын гетерогендүүлүгүн сандык сүрөт белгилери менен көрсөтүү |
| Динамикалык периоперациялык маалымат | Убакыт өткөн сайын өзгөргөн лабораториялык жана периоперациялык өлчөөлөр | Бир өлчөөдөн көрө бейтаптын өзгөрүп турган физиологиялык жүрүшүн моделдөө |
Серептин изилдөөлөр аралык чечмелөөсүнө ылайык, статикалык предоперациялык боор резерви өзгөрмөлөрүн колдонгон моделдер ички маалыматтарда болжол менен 0,81–0,88 AUC деңгээлине жетишкен. Сүрөттөө радиомикасын кошуу айрым түпкү изилдөөлөрдө жалаң клиникалык же жалаң радиомикалык субмоделдерге салыштырмалуу жакшыртуу берген. Динамикалык периоперациялык моделдер күчтүү айырмалоо жөндөмүн көрсөтө алган, бирок тышкы жалпылануу боюнча айкыныраак көйгөйлөргө туш болгон.
Түшүндүрүлүүчүлүк кандай каралган?
Изилдөөлөрдө түшүндүрүлүүчүлүк үчүн SHAP анализдери, номограммалар, feature-importance көрсөткүчтөрү, тобокелдик топтору жана веб-негизиндеги куралдар колдонулган. Айрыкча жогорку тобокелдиктеги клиникалык чечимдерде модель жалаң ыктымалдык бербестен, кайсы өзгөрмөлөр божомолго салым кошконун көзөмөлдөөгө мүмкүн болушу клиникалык кабыл алуу үчүн маанилүү.
ML моделдери салттуу шкалалардан жакшыбы?
Киргизилген изилдөөлөрдүн ичинде бир эле когортто жасалган салыштыруулардын багыты көбүнчө ML негизиндеги моделдердин пайдасына болгон. Maiнин ANN модели, Zhuнун радиомикалык модели, Wang Jнин LightGBM модели, Tashiroнун XGBoost модели, Jinдин ANN модели жана Tangдын XGBoost модели сыяктуу мисалдар салттуу шкалалар же жөнөкөй клиникалык моделдер менен салыштырганда жогорку айырмалоо натыйжалуулугун билдирген.
Бирок системалуу серепте бардык моделдер жана Child–Pugh, MELD, ALBI, FIB-4 же APRI бир эле бейтап жазуулары боюнча кайра окутулуп, текшерилген бириктирилген benchmark жүргүзүлгөн эмес. Бейтап деңгээлинде гармонияланган чийки маалымат болбогондуктан мындай анализ мүмкүн болгон эмес. Ошондуктан жыйынтык жалпы проспективдүү эксперимент менен далилденген универсалдуу артыкчылык эмес; түпкү изилдөөлөр өз когортторунда билдирген натыйжалардын ырааттуу багыты болуп саналат.
Адабияттагы негизги боштуктар
Натыйжа аныктамасынын гетерогендүүлүгү: Изилдөөлөр “severe PHLF”, “clinically significant PHLF”, жалпы PHLF жана “postoperative liver failure” сыяктуу ар башка акыркы чекиттерди колдонгон. Ар башка оордуктагы окуяларды божомолдогон моделдердин AUC маанилерин катар коюу клиникалык салыштырууну кыйындатат.
Толук эмес натыйжалуулук отчету: AUC көп билдирилгени менен сезгичтик, спецификалуулук, PPV, NPV, калибрациянын ылдыйлыгы/кесилишүүсү, чечим ийри сызыгынын анализи жана confusion matrix маалыматтары ырааттуу берилген эмес.
Чектелген тышкы валидация: Серептин баалоосуна ылайык, төрт гана изилдөө убакыттык, проспективдүү же тышкы валидация түзүмүнө ээ. Батыштагы маалымат топтомуна ачык көчүрүү сынагы айрыкча чектелүү.
Эсептөө чыгымынын билдирилбеши: Киргизилген изилдөөлөр окутуу убактысы, inference кечигүүсү, эс тутум колдонуу жана CPU/GPU талаптары сыяктуу техникалык жайылтуу чыгымдарын системалуу билдирген эмес. Бул жетишпестик айрыкча оорукана инфраструктурасында реалдуу убакыттагы колдонууга баа берүүнү кыйындатат.
Божомолдоочу тармак абляциясы: Лаборатория, коагуляция, волюметрия, радиомика жана убакыттык өзгөрмөлөр топторун бир эле модель алкагында кезеги менен алып чыгып, кайра окуткан толук жалпы абляция жок.
Бөлүштүрүүнүн жылышынын коопсуздугу: Ишеними төмөн учурларды автоматтык чечимдин ордуна клиницистке багыттаган selective prediction же cost-aware deferral сыяктуу коопсуздук механизмдери киргизилген изилдөөлөрдө расмий колдонулган эмес.
Келечектеги изилдөөлөр үчүн сунуштар
Серептин авторлору келечекте негизги натыйжа аныктамасы катары мүмкүн болушунча стандартташтырылган, клиникалык маанилүү ISGLS grade B/C PHLFти колдонууну; AUC менен катар сезгичтик, спецификалуулук, PPV, NPV, калибрация жана чечим ийри сызыгынын анализин билдирүүнү; көп борборлуу жана географиялык жактан ар түрдүү тышкы валидацияларды көбөйтүүнү сунушташат.
Мындан тышкары, лабораторияга негизделген боор резерви көрсөткүчтөрүн сүрөттөө жана кыска мөөнөттүү периоперациялык убакыттык маалыматтар менен бириктирген мультимодалдык моделдерди изилдөө маанилүү деп эсептелет. Бирок татаалыраак модель чындап эле клиникалык пайда береби же жокпу баалоо үчүн аны күчтүү жана арзаныраак базалык моделдер менен түз салыштыруу керек.
Акыркы баскычта муктаждык жалаң жогорку AUC эмес. Проспективдүү чечим-таасир изилдөөлөрү божомолдоо системасы хирургиялык стратегияны, FLR көбөйтүү аракеттерин, постоперациялык көзөмөлдүн интенсивдүүлүгүн же куткаруучу дарылоолорду чындап өзгөртөбү жана бейтаптар үчүн клиникалык пайда жаратабы — муну көрсөтүшү керек.
Изилдөө колдогон жыйынтыктар
Учурдагы адабият ML негизиндеги моделдер PHLF тобокелдигин айырмалоодо үмүттөндүргөн натыйжа көрсөтө аларын колдойт. Gradient boosting, ANN/терең үйрөнүү, радиомика жана убакыттык моделдердин баарында клиникалык маанилүү айырмалоо жөндөмү билдирилген. Боор резервинин маркерлери, сүрөттөө жана периоперациялык маалыматтар бирге колдонулганда күчтүү моделдер түзүлө аларына ырааттуу белгилер бар.
Сереп валидация дизайны модель ийгилиги сыяктуу эле маанилүү экенин да колдойт. Айрыкча убакыттык, проспективдүү жана көз карандысыз тышкы валидациялар моделдин чыныгы жалпылануу жөндөмү тууралуу кокус ички тест бөлүүлөрүнө караганда күчтүүрөөк далил берет.
Изилдөө колдобогон жыйынтыктар
Сереп белгилүү бир ML архитектурасы PHLF үчүн универсалдуу түрдө эң мыкты модель экенин көрсөтпөйт. 0,981 сыяктуу жогорку AUC маанилери бардык оорукана, өлкө жана бейтап топторуна көчүрүлө турган кепилденген натыйжалуулук көрсөткүчтөрү эмес.
Изилдөө ML негизиндеги PHLF божомолдоо куралдарын күнүмдүк клиникалык колдонуу бейтаптардын өлүмүн же татаалдашуулардын үлүшүн азайтарын далилдеген чечим-таасир эксперименти эмес. Киргизилген моделдердин көпчүлүгү ретроспективдүү маалыматтарга негизделген жана көп моделдерде көз карандысыз тышкы валидация жок.
Машиналык үйрөнүү клиницисттин чечимин автоматтык түрдө өзгөртүшү же операция тууралуу чечимди жалгыз өзү бериши керек деген жыйынтыкты да бул системалуу серептен чыгарууга болбойт. Булактын келечек көз карашы көбүрөөк ачык-айкын, тышкы валидациядан өткөн, калибрленген жана клиникалык чечим пайдасы көрсөтүлгөн системалар керек экенин баса белгилейт.
Булак жана Ыкма Жөнүндө Эскертүү
Түпкү изилдөө: Machine Learning Models for Predicting Post-Hepatectomy Liver Failure: A Systematic Review
Авторлор: Calin Muntean; Vasile Gaborean; Razvan Constantin Vonica; Sebastian Aurelian Stefaniga; Alaviana Monique Faur; Catalin Vladut Ionut Feier.
Жооптуу авторлор: Vasile Gaborean жана Razvan Constantin Vonica.
Мекемелер: “Victor Babeş” University of Medicine and Pharmacy Timişoara курамындагы Medical Informatics and Biostatistics, Thoracic Surgery Research Center, Surgical Semiology, Doctoral Studies жана Abdominal Surgery and Phlebology Research Center бөлүмдөрү; “Lucian Blaga” University of Sibiu, Preclinical Department/Physiology; West University of Timişoara, Department of Computer Science; “Pius Brinzeu” Clinical Emergency Hospital, First Surgery Clinic.
Журнал: AI.
Басма: MDPI.
Булактын түрү: Системалуу сереп.
Жарыя маалыматы: AI 2026, 7(5), 166.
DOI: 10.3390/ai7050166
Тапшырылган: 27 Март 2026.
Ревизия: 25 Апрель 2026.
Кабыл алынган: 5 Май 2026.
Жарыяланган: 9 Май 2026.
Расмий жарыя дареги: https://www.mdpi.com/2673-2688/7/5/166
Лицензия: Ачык жеткиликтүүлүк, Creative Commons Attribution (CC BY).
Системалуу сереп алкагы: PRISMA 2020, Cochrane Handbook сунуштары, CHARMS жана PROBAST колдонулган.
Каттоо эскертүүсү: Макаланын кыскача мазмун жана ыкма бөлүмүндө протокол PROSPEROдо катталган деп айтылат. Ошол эле ыкма бөлүмүндө Open Science Framework каттоосу катары DOI 10.17605/OSF.IO/67CQ3 да берилген. PDF ичинде өзүнчө PROSPERO CRD каттоо номери көрүнбөгөндүктөн бул эки билдирүү бириктирилген же болжолдонгон эмес.
Каржылоо: Макаланын article processing charge төлөмүн Victor Babeş University of Medicine and Pharmacy Timişoara төлөгөнү көрсөтүлгөн.
Институционалдык этика кеңеши: Колдонулбайт.
Маалымдалган макулдук: Колдонулбайт.
Маалыматтын жеткиликтүүлүгү: Авторлор бул системалуу сереп үчүн жаңы маалымат түзүлбөгөнүн же талданбаганын билдиришет.
Кызыкчылыктардын кагылышы: Авторлор кызыкчылыктардын кагылышы жок экенин билдиришкен.
AI колдонуу жөнүндө билдирүү: Авторлор ChatGPT v4.0ду макаланын тилин жана окулушун жакшыртуу максатында гана колдонушканын; илимий мазмун, чечмелөөлөр жана жыйынтыктар авторлорго таандык экенин билдиришкен.
Авторлордун салымы: Концептуалдаштыруу Calin Muntean, Vasile Gaborean жана Razvan Constantin Vonica; методология Calin Muntean, Sebastian Aurelian Stefaniga жана Razvan Constantin Vonica; программалык камсыздоо Sebastian Aurelian Stefaniga; валидация Calin Muntean, Vasile Gaborean жана Razvan Constantin Vonica; формалдык анализ Calin Muntean жана Sebastian Aurelian Stefaniga; изилдөө Calin Muntean жана Alaviana Monique Faur; маалыматтарды курациялоо Calin Muntean жана Alaviana Monique Faur тарабынан жүргүзүлгөн. Алгачкы долбоор Calin Muntean тарабынан даярдалган; карап чыгууга жана редакциялоого Vasile Gaborean, Razvan Constantin Vonica, Sebastian Aurelian Stefaniga жана Catalin Vladut Ionut Feier салым кошкон.
Негизги методологиялык чектөөлөр: Киргизилген изилдөөлөрдүн көпчүлүгүнүн ретроспективдүү жана бир борборлуу болушу; PHLF акыркы чекитинин гетерогендүү аныкталышы; маалыматтардын географиялык жактан Чыгыш Азияга басымдуу болушу; калибрация, сезгичтик жана спецификалуулуктун ыраатсыз билдирилиши; тышкы валидациянын жетишсиздиги; ар башка модель үй-бүлөлөрүнүн түз салыштырууга келбеши жана эсептөө чыгымдарынын жетиштүү билдирилбеши.
Verianla ыкма эскертүүсү: Бул текст булак макаланын сапма-сап котормосу эмес. Булактагы клиникалык көйгөй, системалуу сереп ыкмасы, бейтаптардын жана изилдөөлөрдүн саны, модель көрсөткүчтөрү, валидация стратегиялары, божомолдоочу тармактар, сүрөттөрдүн илимий билдирүүсү, талкуу жана чектөөлөр сакталуу менен өз алдынча окутуучу түзүм курулган. Булакта жок клиникалык натыйжа, натыйжалуулук метрикасы же модель ийгилиги кошулган эмес.
Медициналык чечмелөөнүн чеги: Бул жердеги модель көрсөткүчтөрү клиникалык чечимди колдоо изилдөөлөрүнө тиешелүү. Алар өз алдынча кайсы бир бейтаптын операцияга жарамдуулугун, PHLF тобокелдигин же дарылоо планын аныктоо үчүн колдонулбайт; клиникалык чечимдер бейтапка мүнөздүү баалоону жана валидацияланган жергиликтүү протоколдорду талап кылат.
Пикир калтырыңыз
E-mail дарегиңиз жарыяланбайт. Милдеттүү талаалар * менен белгиленген