

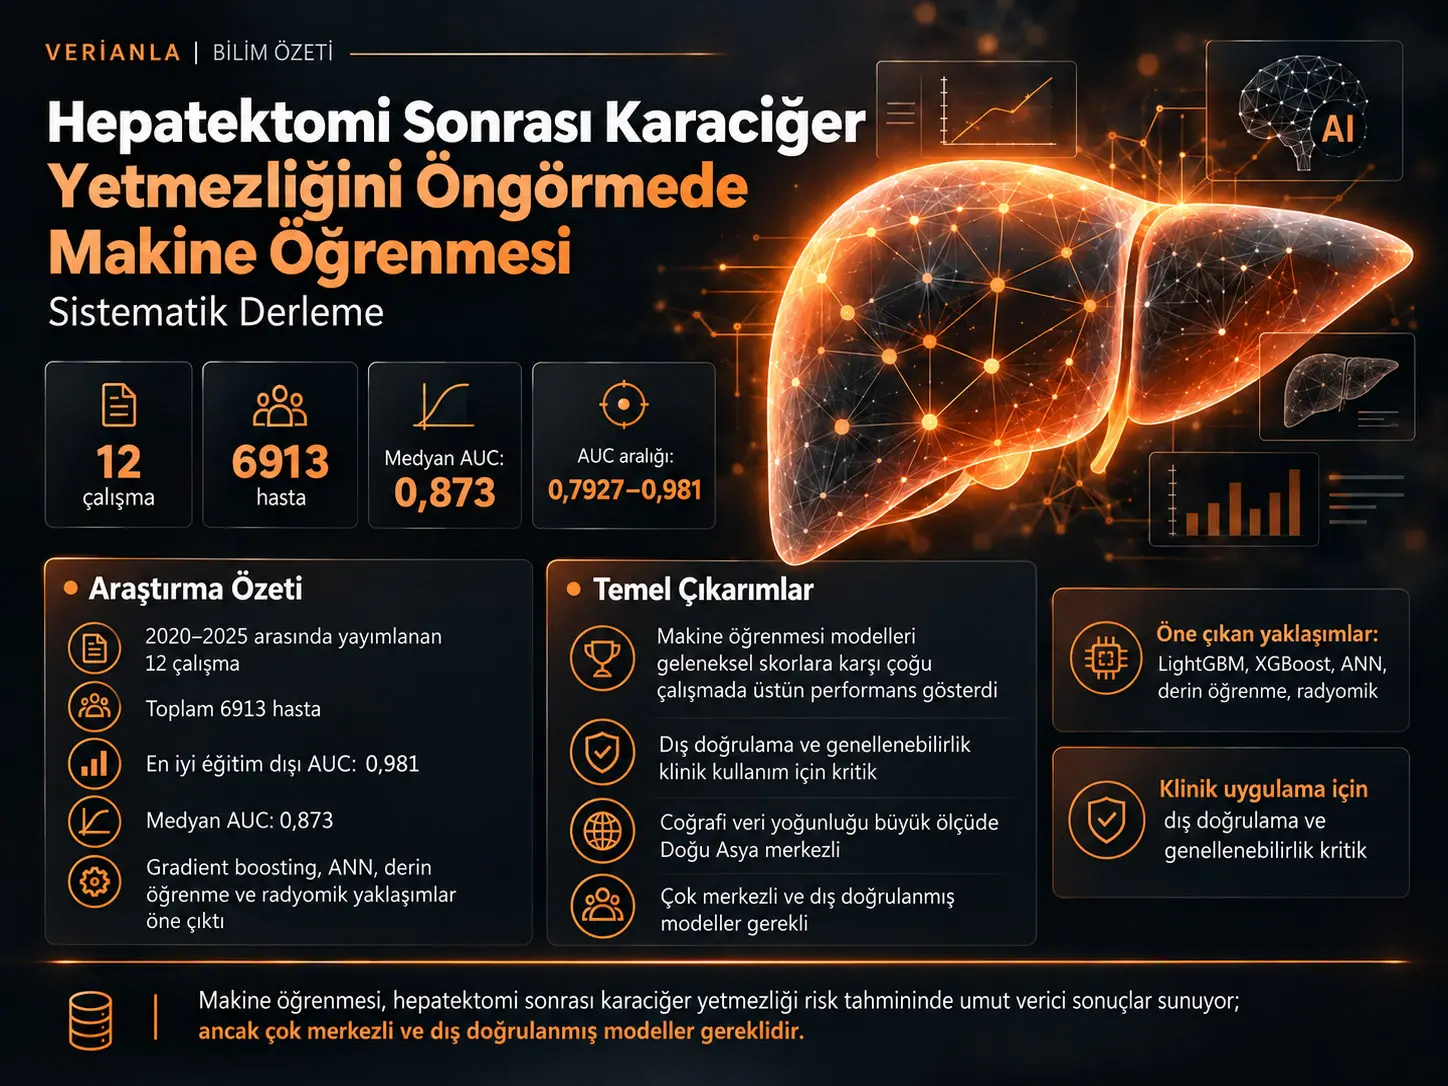
Hepatektomi sonrası karaciğer yetmezliği (Post-Hepatectomy Liver Failure, PHLF), karaciğer rezeksiyonundan sonra karaciğerin sentez, atılım ve detoksifikasyon işlevlerini yeterince sürdürememesiyle karakterize edilen ciddi bir ameliyat sonrası komplikasyondur. Bu sistematik derleme, PHLF riskini tahmin etmek için geliştirilen makine öğrenmesi modellerinin ayırt etme performansını, kullanılan öngördürücüleri, doğrulama yöntemlerini, yöntemsel kalitesini ve klinik uygulanabilirliğini değerlendirmektedir. Nihai inceleme 2020–2025 arasında yayımlanan 12 çalışmayı ve toplam 6913 hastayı kapsamaktadır. Eğitim verisi dışındaki en iyi bildirilen AUC değerleri 0,7927 ile 0,981 arasında değişmiş, medyan AUC 0,873 olmuştur. Bununla birlikte çalışmaların çoğunun retrospektif olması, PHLF tanımlarının aynı olmaması ve dış doğrulamanın sınırlı kalması nedeniyle bu performans değerleri doğrudan rutin klinik kullanıma hazır sistemler olarak yorumlanmamalıdır.
Derlemede gradient boosting ailesi, özellikle LightGBM ve XGBoost, sık görülen yüksek performanslı yaklaşımlar arasındadır. Yapay sinir ağları, derin öğrenme, bilgisayarlı tomografi veya manyetik rezonans görüntülerinden radyomik özellik çıkaran modeller ve ensemble sistemleri de anlamlı ayırt etme performansı göstermiştir. En sık kullanılan bilgi alanları bilirubin ve diğer karaciğer rezerv göstergeleri, koagülasyon parametreleri, trombosit sayısı, kalan karaciğer hacmi veya rezeksiyon kapsamı, görüntüleme tabanlı radyomik özellikler ve perioperatif zamansal veriler olmuştur.
Çalışmanın en güçlü mesajlarından biri yalnız yüksek AUC değerine odaklanmamaktır. İç doğrulamada güçlü görünen bir model farklı bir coğrafyaya veya hasta dağılımına taşındığında performans kaybedebilir. Örneğin Wang K ve arkadaşlarının zamansal derin öğrenme modelinde AUC iç değerlendirmede 0,952, Çin dış doğrulamasında 0,884 iken Batılı MIMIC-IV kohortunda 0,654'e düşmüştür. Bu örnek, klinik yapay zekâ modellerinde dış doğrulama ve dağılım kaymasının neden temel güvenlik konuları olduğunu göstermektedir.
Derlemenin genel değerlendirmesi, makine öğrenmesinin geleneksel Child–Pugh, MELD, ALBI, FIB-4 ve APRI gibi risk araçlarının ötesinde çok sayıda klinik değişkeni birlikte değerlendirebilme potansiyeline sahip olduğu yönündedir. Ancak mevcut çalışmalar aynı hasta verisi ve aynı sonuç tanımı üzerinde oluşturulmuş tek bir ortak karşılaştırma değildir. Bu nedenle literatürde gözlenen üstünlük eğilimi, “makine öğrenmesi her hastada ve her merkezde geleneksel skorlardan kesin olarak daha iyidir” biçiminde genellenemez.
Hepatektomi Sonrası Karaciğer Yetmezliği (PHLF) Nedir?
PHLF, karaciğer dokusunun cerrahi olarak çıkarılmasından sonra geride kalan karaciğerin organizmanın metabolik gereksinimlerini karşılayacak sentez, atılım ve detoksifikasyon kapasitesini sürdürememesi durumudur; derlemede kullanılan ISGLS çerçevesi bunu ameliyat sonrası beşinci gün veya sonrasında artmış INR ile birlikte hiperbilirubinemi üzerinden tanımlar.
Karaciğer rezeksiyonu; hepatoselüler karsinom, intrahepatik kolanjiyokarsinom ve kolorektal kanserin karaciğer metastazları dahil çeşitli benign ve malign hastalıklarda temel cerrahi tedavilerden biridir. Cerrahi teknik, anestezi ve perioperatif bakımda ilerleme sağlanmış olsa da PHLF karaciğer cerrahisinin en ciddi komplikasyonlarından biri olmayı sürdürmektedir.
Kaynak, bildirilen PHLF insidansının hasta popülasyonu, rezeksiyon miktarı ve altta yatan karaciğer hastalığına bağlı olarak %1,2 ile %32 arasında değişebildiğini aktarmaktadır. PHLF riski yalnız çıkarılan karaciğer miktarına bağlı değildir. Gelecekte kalacak karaciğer dokusunun miktarı ve fonksiyonel kalitesi, karaciğerin rejenerasyon kapasitesi, mevcut fibrozis veya siroz, steatoz, portal hipertansiyon, sarkopeni ve ameliyata ilişkin stres faktörleri birlikte rol oynayabilir.
Gelecekte kalacak karaciğer neden önemlidir?
Future Liver Remnant (FLR), rezeksiyondan sonra hastada kalacak fonksiyonel karaciğer dokusunu ifade eder. Kaynağın literatür özetinde bilgisayarlı tomografi tabanlı volumetrik değerlendirme için normal karaciğerde en az yaklaşık %20 ve fonksiyon açısından bozulmuş karaciğerde yaklaşık %40 FLR eşikleri aktarılmaktadır. Bununla birlikte yalnız hacim ölçümü, kalan dokunun gerçek fonksiyon kapasitesini tam olarak göstermez.
Bu nedenle indosiyanin yeşili temizlenme testi (ICG), hepatobiliyer sintigrafi ve gadoxetic acid ile güçlendirilmiş manyetik rezonans görüntüleme gibi fonksiyonel yaklaşımlar geliştirilmiştir. Bu testlerin her birinin kullanılabilirlik, standardizasyon veya popülasyonlar arası performans bakımından sınırlılıkları vardır.
Geleneksel risk skorları neden yeterli olmayabilir?
Child–Pugh sınıflaması, MELD skoru ve Albumin–Bilirubin (ALBI) derecesi karaciğer fonksiyonunu farklı değişkenlerden değerlendirir; ancak PHLF, laboratuvar değerleri, kalan karaciğer hacmi, hastanın mevcut karaciğer hastalığı, ameliyatın kapsamı ve perioperatif değişimler gibi çok sayıda etkenin birlikte etkilediği bir sonuçtur. Kaynak bu nedenle klasik skorların tek başına bütün risk yapısını yakalamakta sınırlı olabileceğini vurgulamaktadır.
Derlemede atıf yapılan önceki bir sistematik inceleme ve meta-analizde ALBI'nin PHLF öngörüsü için birleştirilmiş AUC değerinin yaklaşık 0,67 olduğu belirtilmektedir. Bu bulgu, daha karmaşık ve çok değişkenli modellerin araştırılmasının gerekçelerinden biridir.
PHLF Tahmininde Makine Öğrenmesi Neden Kullanılıyor?
Makine öğrenmesi, laboratuvar verileri, görüntüleme özellikleri, cerrahi değişkenler ve zaman içinde değişen perioperatif ölçümler arasındaki doğrusal olmayan ve çok değişkenli ilişkileri aynı model içinde değerlendirebildiği için PHLF gibi karmaşık bir klinik riskin bireyselleştirilmiş tahmininde araştırılmaktadır.
İncelenen literatürde kullanılan yöntemler tek bir algoritmadan oluşmamaktadır. Yapay sinir ağları (Artificial Neural Networks, ANN), LightGBM, XGBoost, konvolüsyonel sinir ağları (CNN), zamansal derin öğrenme modelleri, radyomik yaklaşımlar ve ensemble sistemleri yer almaktadır.
Bu modellerin amacı klasik hepatoloji bilgisini ortadan kaldırmak değildir. Derlemede yüksek performanslı modellerde tekrar tekrar bilirubin, albumin, INR veya protrombin zamanı, trombosit sayısı, ICG-R15, kalan karaciğer miktarı ve rezeksiyon kapsamı gibi zaten klinik olarak anlamlı değişkenlerin ortaya çıkması, makine öğrenmesinin çoğu durumda mevcut fizyopatolojik bilgiyi farklı değişkenleri birlikte ağırlıklandırarak genişlettiğini göstermektedir.
Radyomik veriler ne ekliyor?
Radyomik, CT veya MRI gibi tıbbi görüntülerden çıplak gözle doğrudan ölçülmesi güç olan çok sayıda nicel görüntü özelliğinin çıkarılması yaklaşımıdır. Derlemede Zhu, Li ve Famularo çalışmalarında radyomik bilgilerin klinik veya laboratuvar değişkenleriyle birlikte kullanıldığı modeller yer almaktadır.
Derlemedeki çalışmalar arası örüntü, görüntüleme bilgisinin bazı modellerde yalnız klinik veriye veya yalnız radyomik veriye göre ek bilgi sağlayabileceğine işaret etmektedir. Ancak bu sonuç tek bir ortak veri kümesinde gerçekleştirilen kontrollü predictor-ablation deneyi değildir. Derleme yazarları da predictor gruplarının önem sırasını kesin olarak belirleyebilecek ortak bir leave-one-domain-out analizin mevcut olmadığını açıkça belirtmektedir.
Perioperatif dinamik veri ne demektir?
Statik bir preoperatif ölçüm hastanın tek bir andaki durumunu temsil eder. Perioperatif dinamik veri ise ameliyat öncesi, ameliyat sırası ve erken ameliyat sonrası dönemde zamanla değişen laboratuvar veya klinik ölçümlerin oluşturduğu yörüngeyi kullanır. Jin, Wang K ve Shen çalışmalarında bu tür zamansal veya faza özgü veri yapıları önemli bir bileşen olmuştur.
Bu modeller yüksek ayrım gücü gösterebilse de daha fazla veri ve daha karmaşık altyapı gerektirebilir. Üstelik Wang K çalışmasındaki MIMIC-IV dış doğrulama düşüşü, daha zengin veri kullanmanın otomatik olarak farklı hastaneler veya coğrafyalarda aynı performansı garanti etmediğini göstermektedir.
AUC Değeri Bu Sistematik Derlemede Neyi Gösteriyor?
AUC, modelin PHLF gelişen ve gelişmeyen hastaları birbirinden ayırma yeteneğini özetleyen bir ayrım gücü ölçüsüdür; bu sistematik derlemede modeller arası temel performans karşılaştırmalarından biri olarak kullanılmıştır, ancak AUC tek başına kalibrasyonu, klinik karar yararını veya farklı bir hastanedeki gerçek performansı göstermez.
Derlemedeki en iyi bildirilen eğitim-dışı AUC değerleri 0,7927–0,981 arasında değişmiştir ve medyan değer 0,873'tür. Bununla birlikte bu sayıların tamamı aynı veri setinden, aynı PHLF tanımından veya aynı doğrulama prosedüründen gelmemektedir. Bazı çalışmalar random train/test ayrımı kullanırken bazıları 5 katlı çapraz doğrulama, zamansal doğrulama, harici kohort veya prospektif doğrulama kullanmıştır.
Dolayısıyla 0,95 AUC bildiren bir iç geliştirme çalışmasını, 0,88 AUC elde etmiş bağımsız dış doğrulamalı bir modelden otomatik olarak “daha iyi” saymak yöntemsel olarak doğru değildir. Derlemenin önemli katkılarından biri de performans sayısının yanında doğrulama yapısına dikkat çekmesidir.
Kalibrasyon neden ayrıca önemlidir?
Ayırt etme yeteneği, yüksek riskli kişileri düşük risklilerden sıralama yeteneğini gösterir. Klinik risk tahmininde bunun yanında modelin verdiği olasılıkların gerçek olay sıklıklarıyla ne kadar uyumlu olduğu, yani kalibrasyon da önemlidir. Derleme, birçok çalışmada diskriminasyonun kalibrasyondan daha eksiksiz raporlandığını ve bu nedenle klinik karşılaştırmanın sınırlı kaldığını belirtmektedir.
Çalışmanın Yöntemi ve Bulguları
Sistematik derlemenin tasarımı
Derleme PRISMA 2020 ilkelerine ve Cochrane Handbook'un tanısal test doğruluğu sistematik incelemelerine yönelik önerilerine göre yapılandırılmıştır. Araştırma sorusunun ve veri çıkarımının düzenlenmesinde CHARMS çerçevesi kullanılmıştır. Hedef popülasyon herhangi bir nedenle hepatik rezeksiyon uygulanan yetişkin hastalardır.
İndeks modeller, PHLF'yi tahmin etmek amacıyla geliştirilen veya doğrulanan makine öğrenmesi ya da yapay zekâ algoritmalarıdır. Sonuç tanımı için ISGLS, “50-50” kriterleri, tepe bilirubin değerinin 7 mg/dL'nin üzerinde olması veya başka doğrulanmış klinik PHLF tanımları kabul edilmiştir.
Literatür nasıl tarandı?
PubMed/MEDLINE, Embase, Web of Science Core Collection ve Cochrane Library veri tabanları başlangıçlarından 15 Ocak 2026'ya kadar taranmıştır. Arama terimleri üç ana kümeyi birleştirmiştir: makine öğrenmesi/yapay zekâ yöntemleri, hepatektomi/karaciğer rezeksiyonu bağlamı ve PHLF/karaciğer yetmezliği sonuçları.
Elektronik aramaya ek olarak dahil edilen çalışmaların ve ilgili derlemelerin kaynak listeleri manuel taranmış; 2020–2025 dönemindeki başlıca hepatobiliyer cerrahi toplantılarının özetleri gözden geçirilmiş ve yayın yanlılığını azaltma amacıyla Google Scholar üzerinden gri literatür aranmıştır.
Dahil etme ve dışlama ölçütleri
Dahil edilen çalışmaların 18 yaş veya üzerindeki hepatektomi hastalarında en az bir ML modeli geliştirmesi veya doğrulaması ve AUC, duyarlılık, özgüllük, pozitif öngörü değeri, negatif öngörü değeri veya doğruluk gibi en az bir performans metriği raporlaması gerekiyordu. Yalnızca geleneksel lojistik regresyon kullanan çalışmalar ML çalışması olarak dahil edilmedi.
Karaciğer transplantasyonu olup hepatektomi içermeyen çalışmalar, ablasyon tedavileri, cerrahi dışı karaciğer yetmezliği araştırmaları, derlemeler, editoryaller, yeterli veri içermeyen konferans özetleri, olgu sunumları ve 50'den az hastası olan çalışmalar dışlandı.
Başlık/özet ve tam metin taraması iki bağımsız araştırmacı tarafından yapılmış, anlaşmazlıklar uzlaşı veya üçüncü değerlendirici aracılığıyla çözülmüştür. Çalışma seçimi için değerlendiriciler arası Cohen kappa değeri 0,89 olarak raporlanmıştır.
PRISMA çalışma seçimi
| Aşama | Sayı |
|---|---|
| PubMed kayıtları | 156 |
| Embase kayıtları | 134 |
| Web of Science kayıtları | 98 |
| Cochrane Library kayıtları | 42 |
| Dört veri tabanından toplam | 430 |
| Manuel tarama ve konferanslardan ek kayıt | 12 |
| Çıkarılan tekrar kayıtlar | 144 |
| Başlık/özet taramasına kalan benzersiz kayıt | 298 |
| Başlık/özet aşamasında dışlanan | 241 |
| Tam metni değerlendirilen | 57 |
| Tam metinde dışlanan | 45 |
| Nihai sistematik derlemeye dahil edilen | 12 |
Tam metinde dışlanan 45 çalışmanın 18'inde ML/AI modeli bulunmaması, 9'unda PHLF'nin birincil sonuç olmaması, 8'inin derleme veya editoryal olması, 5'inin yinelenen hasta kohortlarını kullanması ve 5'inde yeterli veri bulunmaması dışlama nedenleri olarak raporlanmıştır.
Veri çıkarımı ve kalite değerlendirmesi
CHARMS tabanlı standartlaştırılmış veri çıkarım formu önce üç rastgele çalışmada denenmiş, ardından iki değerlendirici bütün dahil edilen çalışmalardan verileri bağımsız olarak çıkarmış ve çapraz kontrol etmiştir. Çalışma tasarımı, hasta özellikleri, kullanılan algoritma, öngördürücüler, eksik veri yaklaşımı, performans metrikleri, kalibrasyon, karar eğrisi analizi, doğrulama tipi ve geleneksel skorlarla karşılaştırma gibi değişkenler hedeflenmiştir.
Risk of bias değerlendirmesi PROBAST ile katılımcılar, öngördürücüler, sonuç ve analiz olmak üzere dört alanda planlanmıştır. Her alan düşük, yüksek veya belirsiz risk şeklinde değerlendirilmiş; herhangi bir alan yüksek risk taşıyorsa genel riskin yüksek kabul edilmesi öngörülmüştür.
Kaynak içi önemli sınır: Nihai sonuç bölümündeki Tablo 3, önceki PROBAST matrisindeki bazı kaynak satırlarının doğrulanmamış veya yanlış sınıflandırılmış olması nedeniyle bu matrisi korumadığını açıkça belirtmektedir. Bu nedenle nihai PDF'nin desteklemediği çalışmaya özgü PROBAST puanları Verianla tarafından yeniden oluşturulmamıştır.
Neden meta-analiz yapılmadı?
Çalışmalar algoritmalar, öngördürücüler, PHLF tanımları ve doğrulama stratejileri açısından belirgin biçimde heterojen olduğundan resmi nicel meta-analiz yerine anlatısal sentez tercih edilmiştir. Bu karar, farklı PHLF şiddetlerinin ve farklı doğrulama yapılarının tek bir ortak performans sayısına dönüştürülmesinin yanıltıcı olabileceği anlamına gelir.
Dahil edilen çalışmaların genel yapısı
12 çalışma toplam 6913 hastayı kapsamaktadır. Tekil çalışma büyüklükleri 101 ile 2074 arasında, medyan örneklem büyüklüğü 363,5'tir. Dokuz çalışma Çin kaynaklıdır; bir çalışma Japonya'dandır ve iki çalışma çok uluslu veya Çin dışı dış doğrulama içeren yapılara sahiptir. Yedi çalışma tek merkezli, beş çalışma çok merkezlidir. Tang ve arkadaşlarının çalışması, bu veri setinde açık biçimde prospektif doğrulama kohortu kullanan tek çalışmadır.
| Çalışma | Yıl | Ülke/bağlam | N | Merkez yapısı |
|---|---|---|---|---|
| Mai ve ark. | 2020 | Çin | 353 | Tek merkez |
| Zhu WS ve ark. | 2020 | Çin | 101 | Tek merkez |
| Wang J ve ark. | 2022 | Çin | 875 | 8 merkez |
| Xu ve ark. | 2023 | Çin | 265 | Tek merkez |
| Li ve ark. | 2023 | Çin | 276 | Tek merkez |
| Tashiro ve ark. | 2024 | Japonya | 334 | Tek merkez |
| Jin ve ark. | 2024 | Çin | 226 | Tek merkez |
| Famularo ve ark. | 2025 | İtalya/Avrupa | 500 | 13 merkez |
| Tang ve ark. | 2025 | Çin | 374 | Tek merkez + prospektif doğrulama |
| Yuan ve ark. | 2025 | Çin | 464 | Tek merkez |
| Wang K ve ark. | 2025 | Çin + MIMIC | 2074 | Çok merkez + dış kohort |
| Shen ve ark. | 2025 | Çin | 1071 | 3 merkez |
Hangi modeller en yüksek ayrım gücünü gösterdi?
| Çalışma | Model | Bildirilen AUC | Doğrulama yapısı |
|---|---|---|---|
| Mai | ANN | 0,880 geliştirme; 0,876 doğrulama | Ayrılmış doğrulama örneklemi |
| Zhu | Radyomik tabanlı model | 0,894 | İç doğrulama |
| Wang J | LightGBM | 0,944 eğitim; 0,870 doğrulama; 0,822 test | Çoklu kohort ayrımı |
| Xu | CNN / derin öğrenme | 0,7927 | 5 katlı çapraz doğrulama |
| Li | Kombine radyomik model | 0,84 eğitim; 0,82 test | Ayrılmış test örneklemi |
| Tashiro | XGBoost | 0,863 | Eğitim/test ayrımı |
| Jin | ANN | 0,766 preoperatif; 0,851 postoperatif; 0,720/0,731 zamansal | 5 katlı CV + zamansal doğrulama |
| Famularo | Averaging ensemble | 0,901 test | Eğitim/test ayrımı |
| Tang | XGBoost | 0,983 eğitim; 0,981 doğrulama; 0,942 prospektif | İç + prospektif doğrulama |
| Yuan | LightGBM | 0,927 eğitim; 0,703 test; 0,808 doğrulama | Eğitim/test/doğrulama |
| Wang K | Zamansal derin öğrenme | 0,952 iç; 0,884 dış Çin; 0,654 MIMIC | Dış + Batılı dış kohort |
| Shen | PILOT, faza özgü mimari | 0,754–0,904 eğitim; 0,740–0,895 doğrulama | İki dış kohort |
Kaynak Şekil 2, her çalışma için eğitim dışındaki en iyi bildirilen AUC'yi yan yana göstermektedir. Grafikte Tang 2025 yaklaşık 0,981 ile en üstte; Famularo 2025 0,901, Shen 2025 0,895, Zhu 2020 0,894 ve Wang K 2025 0,884 ile onu izlemektedir. Ancak bu sıralama modellerin aynı koşullarda karşılaştırıldığı anlamına gelmez.
Dış Doğrulama PHLF Modellerinde Neden Kritik?
Dış doğrulama, modelin geliştirildiği hasta grubundan bağımsız bir hastane, zaman dönemi veya coğrafyada benzer performansı koruyup korumadığını sınar; PHLF literatüründe Wang K modelinin AUC'sinin iç değerlendirmedeki 0,952'den MIMIC-IV kohortunda 0,654'e düşmesi, dağılım kaymasının klinik genellenebilirliği ciddi biçimde değiştirebileceğini göstermektedir.
Derlemede genellenebilirlik açısından en anlamlı işaretler random olmayan doğrulama yapılarından gelmiştir. Jin ve arkadaşları zamansal doğrulamada 0,720 ve 0,731 AUC; Tang ve arkadaşları prospektif doğrulamada 0,942 AUC; Wang K ve arkadaşları Çin dış kohortunda 0,884 ve MIMIC-IV'de 0,654 AUC; Shen ve arkadaşları iki dış kohortta 0,740–0,895 aralığında AUC bildirmiştir.
Bu örnekler model geliştirme verisine çok benzer bir iç test setinde güçlü performans elde etmenin klinik taşınabilirlikle aynı olmadığını gösterir.
Coğrafi yoğunlaşma neden sınırlılık oluşturuyor?
12 çalışmanın dokuzu Çin'den, biri Japonya'dandır. Kaynak bu literatürün büyük ölçüde Doğu Asya, hepatoselüler karsinom ve bazı kohortlarda HBV ilişkili karaciğer hastalığı ağırlıklı olduğunu vurgulamaktadır. Buna karşılık Batılı hasta popülasyonlarında yağlı karaciğer hastalığı, alkole bağlı karaciğer hastalığı ve kolorektal karaciğer metastazları gibi farklı vaka dağılımları bulunabilir.
Bu nedenle bir modelin bir ülkede veya hastane sisteminde güçlü sonuç vermesi başka bir uygulama coğrafyasında aynı kalibrasyonu ve ayrım gücünü koruyacağı anlamına gelmez. Hedef uygulama coğrafyasında dış doğrulama, gerektiğinde yeniden kalibrasyon ve vaka karması farklılıklarının açık raporlanması gerekir.
Hangi öngördürücü grupları tekrar tekrar görülüyor?
| Öngördürücü alanı | Derlemede görülen örnekler | Bilimsel rolü |
|---|---|---|
| Karaciğer rezervi / laboratuvar | Bilirubin, albumin, INR/protrombin zamanı | Karaciğerin sentez ve atılım kapasitesine ilişkin temel klinik sinyal |
| Hematolojik/portal göstergeler | Trombosit sayısı | Portal hipertansiyon ve karaciğer hastalığı bağlamındaki risk bilgisine katkı |
| Fonksiyonel testler | ICG-R15 | Karaciğer fonksiyon rezervini değerlendiren bilgi |
| Rezeksiyon/volumetri | FLR, rezeksiyon kapsamı, rezidüel hacim | Ameliyat sonrası kalacak fonksiyonel doku ve cerrahi yükü temsil etme |
| Görüntüleme | CT/MRI radyomik özellikleri | Parankim heterojenliğini nicel görüntü özellikleriyle temsil etme |
| Dinamik perioperatif veri | Zaman içinde değişen laboratuvar ve perioperatif ölçümler | Tek bir ölçüm yerine hastanın değişen fizyolojik seyrini modelleme |
Derlemenin çalışmalar arası yorumuna göre statik preoperatif karaciğer rezervi değişkenlerini kullanan modeller iç verilerde yaklaşık 0,81–0,88 AUC düzeylerine ulaşabilmiştir. Görüntüleme radyomiğinin eklenmesi bazı özgün çalışmalarda yalnız klinik veya yalnız radyomik alt modellere göre iyileşme sağlamıştır. Dinamik perioperatif modeller ise güçlü ayrım gücü gösterebilmiş, fakat dış genellenebilirlik konusunda daha belirgin sorunlarla karşılaşmıştır.
Açıklanabilirlik nasıl ele alınmış?
Çalışmalarda açıklanabilirlik için SHAP analizleri, nomogramlar, feature-importance gösterimleri, risk grupları ve web tabanlı araçlar kullanılmıştır. Özellikle yüksek riskli klinik kararlarda modelin yalnız bir olasılık vermesi değil, hangi değişkenlerin tahmine katkıda bulunduğunun izlenebilir olması klinik kabul açısından önem taşımaktadır.
ML modelleri geleneksel skorlardan daha mı iyi?
Dahil edilen çalışmalar içinde aynı kohort üzerinde yapılan karşılaştırmaların yönü genellikle ML tabanlı modeller lehinedir. Mai'nin ANN modeli, Zhu'nun radyomik modeli, Wang J'nin LightGBM modeli, Tashiro'nun XGBoost modeli, Jin'in ANN modeli ve Tang'ın XGBoost modeli gibi örnekler geleneksel skorlar veya daha basit klinik modellerle karşılaştırıldığında daha yüksek ayırt etme performansı raporlamıştır.
Ancak sistematik derlemede bütün modellerin ve Child–Pugh, MELD, ALBI, FIB-4 veya APRI'nin aynı hasta kayıtları üzerinde yeniden eğitilip test edildiği birleşik bir benchmark yapılmamıştır. Hasta düzeyinde harmonize ham veri bulunmadığı için böyle bir analiz mümkün olmamıştır. Bu nedenle sonuç, ortak bir prospektif deneyle kanıtlanmış evrensel üstünlük değil; özgün çalışmaların kendi kohortlarında raporladığı sonuçların tutarlı yönüdür.
Literatürdeki temel boşluklar
Sonuç tanımı heterojenliği: Çalışmalar “severe PHLF”, “clinically significant PHLF”, genel PHLF ve “postoperative liver failure” gibi farklı son noktalar kullanmıştır. Farklı şiddette olayları tahmin eden modellerin AUC değerlerinin yan yana konması klinik karşılaştırmayı zorlaştırmaktadır.
Eksik performans raporlama: AUC sık raporlanırken duyarlılık, özgüllük, PPV, NPV, kalibrasyon eğimi/kesişimi, karar eğrisi analizi ve confusion matrix verileri tutarlı biçimde verilmemiştir.
Sınırlı dış doğrulama: Derlemenin değerlendirmesine göre yalnız dört çalışma zamansal, prospektif veya dış doğrulama yapısına sahiptir. Batılı bir veri setine açık taşıma testi özellikle sınırlıdır.
Hesaplama maliyetinin raporlanmaması: Dahil edilen çalışmalar eğitim süresi, inference gecikmesi, bellek kullanımı ve CPU/GPU gereksinimleri gibi teknik dağıtım maliyetlerini sistematik biçimde raporlamamıştır. Bu eksiklik, özellikle hastane altyapısında gerçek zamanlı kullanım değerlendirmesini zorlaştırır.
Öngördürücü alanı ablasyonu: Laboratuvar, koagülasyon, volumetri, radyomik ve zamansal değişken gruplarını aynı model çerçevesinde sırayla çıkarıp yeniden eğiten eksiksiz bir ortak ablasyon bulunmamaktadır.
Dağılım kayması güvenliği: Düşük güvenli vakaları otomatik karar yerine klinisyene yönlendiren selective prediction veya cost-aware deferral gibi güvenlik mekanizmaları dahil edilen çalışmalarda resmi olarak uygulanmamıştır.
Gelecek araştırmalar için öneriler
Derleme yazarları gelecekte primer sonuç tanımı olarak mümkün olduğunca standartlaştırılmış, klinik açıdan anlamlı ISGLS grade B/C PHLF kullanımını; AUC'nin yanında duyarlılık, özgüllük, PPV, NPV, kalibrasyon ve karar eğrisi analizinin raporlanmasını; çok merkezli ve coğrafi olarak çeşitli dış doğrulamaların artırılmasını önermektedir.
Ayrıca laboratuvar temelli karaciğer rezervi göstergelerini görüntüleme ve kısa dönem perioperatif zamansal verilerle birleştiren multimodal modeller araştırılmaya değer görülmektedir. Bununla birlikte daha karmaşık modelin gerçekten klinik yarar sağlayıp sağlamadığını değerlendirebilmek için güçlü ve daha ucuz temel modellerle doğrudan karşılaştırılması gerekir.
Son aşamada ihtiyaç yalnız daha yüksek bir AUC değildir. Prospektif karar-etki çalışmaları, tahmin sisteminin cerrahi stratejiyi, FLR artırma girişimlerini, postoperatif izlem yoğunluğunu veya kurtarma tedavilerini gerçekten değiştirip değiştirmediğini ve hastalar açısından klinik fayda oluşturup oluşturmadığını göstermelidir.
Çalışmanın desteklediği sonuçlar
Mevcut literatür, ML tabanlı modellerin PHLF risk ayrımında umut verici performans gösterebildiğini desteklemektedir. Gradient boosting, ANN/derin öğrenme, radyomik ve zamansal modellerin hepsinde klinik açıdan anlamlı ayrım gücü bildirilmiştir. Karaciğer rezervi belirteçleri, görüntüleme ve perioperatif bilgiler birlikte kullanıldığında güçlü modeller oluşturulabildiğine ilişkin tutarlı işaretler vardır.
Derleme ayrıca doğrulama tasarımının model başarısı kadar önemli olduğunu desteklemektedir. Özellikle zamansal, prospektif ve bağımsız dış doğrulamalar modelin gerçek genellenebilirliği hakkında rastgele iç test bölmelerinden daha güçlü kanıt sağlar.
Çalışmanın desteklemediği sonuçlar
Derleme belirli bir ML mimarisinin PHLF için evrensel olarak en iyi model olduğunu göstermemektedir. 0,981 gibi yüksek AUC değerleri bütün hastane, ülke ve hasta gruplarına aktarılabilecek garanti edilmiş performans değerleri değildir.
Çalışma, ML tabanlı PHLF tahmin araçlarının rutin klinik kullanımının hasta ölümünü veya komplikasyon oranını azalttığını kanıtlayan bir karar-etki deneyi değildir. Dahil edilen modellerin çoğu retrospektif verilere dayanmaktadır ve birçok modelin bağımsız dış doğrulaması eksiktir.
Makine öğrenmesinin klinisyenin kararını otomatik olarak değiştirmesi veya ameliyat kararını tek başına vermesi gerektiği sonucu da bu sistematik derlemeden çıkarılamaz. Kaynağın gelecek perspektifi, daha şeffaf, dış doğrulanmış, kalibre edilmiş ve klinik karar yararı gösterilmiş sistemlere ihtiyaç olduğunu vurgulamaktadır.
Kaynak ve Yöntem Notu
Özgün çalışma: Machine Learning Models for Predicting Post-Hepatectomy Liver Failure: A Systematic Review
Yazarlar: Calin Muntean; Vasile Gaborean; Razvan Constantin Vonica; Sebastian Aurelian Stefaniga; Alaviana Monique Faur; Catalin Vladut Ionut Feier.
Sorumlu yazarlar: Vasile Gaborean ve Razvan Constantin Vonica.
Kurumlar: “Victor Babeş” University of Medicine and Pharmacy Timişoara bünyesindeki Medical Informatics and Biostatistics, Thoracic Surgery Research Center, Surgical Semiology, Doctoral Studies ve Abdominal Surgery and Phlebology Research Center birimleri; “Lucian Blaga” University of Sibiu, Preclinical Department/Physiology; West University of Timişoara, Department of Computer Science; “Pius Brinzeu” Clinical Emergency Hospital, First Surgery Clinic.
Dergi: AI.
Yayınevi: MDPI.
Kaynak türü: Sistematik derleme.
Yayın bilgisi: AI 2026, 7(5), 166.
DOI: 10.3390/ai7050166
Gönderim: 27 Mart 2026.
Revizyon: 25 Nisan 2026.
Kabul: 5 Mayıs 2026.
Yayın: 9 Mayıs 2026.
Resmî yayın adresi: https://www.mdpi.com/2673-2688/7/5/166
Lisans: Açık erişim, Creative Commons Attribution (CC BY).
Sistematik derleme çerçevesi: PRISMA 2020, Cochrane Handbook önerileri, CHARMS ve PROBAST kullanılmıştır.
Kayıt notu: Makalenin özet ve yöntem bölümü protokolün PROSPERO'da kayıtlı olduğunu belirtmektedir. Aynı yöntem bölümünde ayrıca Open Science Framework kaydı olarak DOI 10.17605/OSF.IO/67CQ3 verilmektedir. PDF içinde ayrı bir PROSPERO CRD kayıt numarası görünmediğinden bu iki ifade birleştirilmemiş veya tahmin edilmemiştir.
Finansman: Makalenin article processing charge bedelinin Victor Babeş University of Medicine and Pharmacy Timişoara tarafından ödendiği belirtilmiştir.
Kurumsal etik kurul: Uygulanabilir değil.
Bilgilendirilmiş onam: Uygulanabilir değil.
Veri erişilebilirliği: Yazarlar bu sistematik derleme için yeni veri oluşturulmadığını veya analiz edilmediğini bildirmektedir.
Çıkar çatışması: Yazarlar çıkar çatışması olmadığını beyan etmiştir.
AI kullanım beyanı: Yazarlar ChatGPT v4.0'ı yalnızca makalenin dilini ve okunabilirliğini iyileştirmek amacıyla kullandıklarını; bilimsel içerik, yorumlar ve sonuçların yazarlara ait olduğunu belirtmiştir.
Yazar katkıları: Kavramsallaştırma Calin Muntean, Vasile Gaborean ve Razvan Constantin Vonica; metodoloji Calin Muntean, Sebastian Aurelian Stefaniga ve Razvan Constantin Vonica; yazılım Sebastian Aurelian Stefaniga; doğrulama Calin Muntean, Vasile Gaborean ve Razvan Constantin Vonica; formal analiz Calin Muntean ve Sebastian Aurelian Stefaniga; araştırma Calin Muntean ve Alaviana Monique Faur; veri kürasyonu Calin Muntean ve Alaviana Monique Faur tarafından yürütülmüştür. İlk taslak Calin Muntean tarafından hazırlanmış; gözden geçirme ve düzenlemeye Vasile Gaborean, Razvan Constantin Vonica, Sebastian Aurelian Stefaniga ve Catalin Vladut Ionut Feier katkıda bulunmuştur.
Temel yöntemsel sınırlılıklar: Dahil edilen çalışmaların çoğunun retrospektif ve tek merkezli olması; PHLF son noktasının heterojen tanımlanması; coğrafi olarak Doğu Asya ağırlıklı veri; kalibrasyon, duyarlılık ve özgüllüğün tutarsız raporlanması; dış doğrulama eksikliği; farklı model ailelerinin doğrudan karşılaştırılabilir olmaması ve hesaplama maliyetlerinin yeterince raporlanmaması.
Verianla yöntem notu: Bu metin kaynak makalenin satır satır çevirisi değildir. Kaynaktaki klinik problem, sistematik derleme yöntemi, hasta ve çalışma sayıları, model performansları, doğrulama stratejileri, öngördürücü alanları, şekillerin bilimsel mesajı, tartışma ve sınırlılıklar korunarak bağımsız bir öğretim yapısı kurulmuştur. Kaynakta bulunmayan klinik sonuç, performans metriği veya model başarısı eklenmemiştir.
Tıbbi yorum sınırı: Buradaki model performansları klinik karar destek araştırmalarına aittir. Tek başına herhangi bir hastanın ameliyat uygunluğunu, PHLF riskini veya tedavi planını belirlemek amacıyla kullanılamaz; klinik kararlar hastaya özgü değerlendirme ve doğrulanmış yerel protokoller gerektirir.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir