

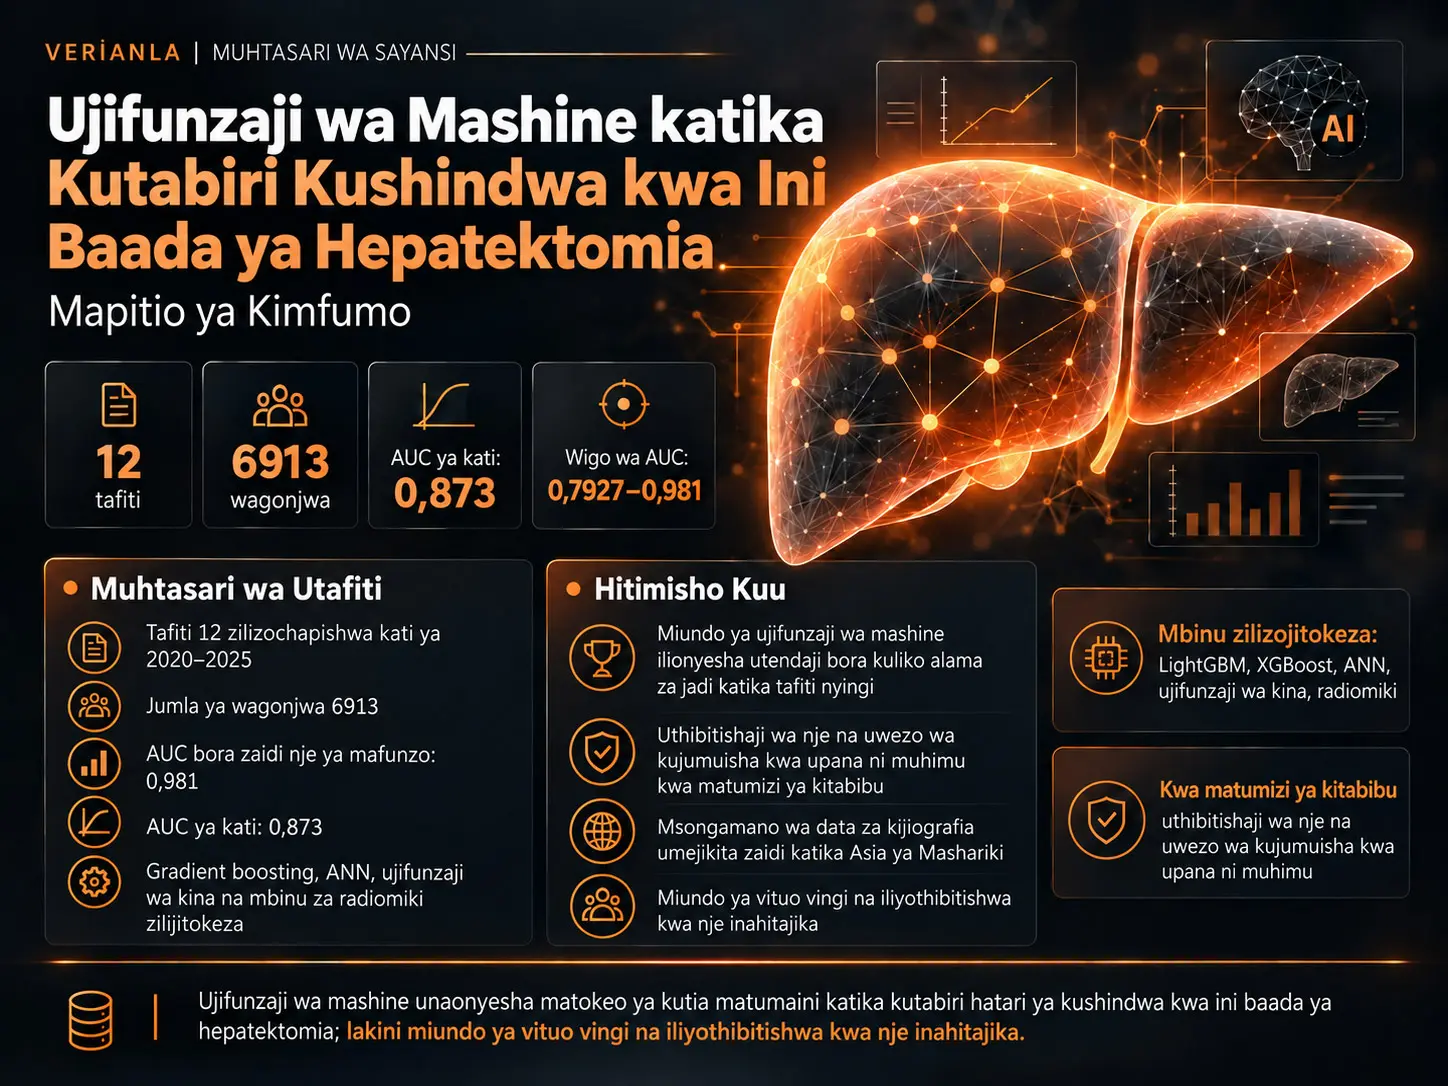
Kushindwa kwa ini baada ya hepatektomia (Post-Hepatectomy Liver Failure, PHLF) ni tatizo kubwa la baada ya upasuaji linalotambulika kwa ini kushindwa kuendelea kwa kiwango cha kutosha na kazi zake za usanisi, utoaji na uondoaji wa sumu baada ya resection ya ini. Mapitio haya ya kimfumo yanatathmini uwezo wa kutofautisha wa modeli za ujifunzaji wa mashine zilizotengenezwa kutabiri hatari ya PHLF, viashiria vilivyotumika, mbinu za uthibitishaji, ubora wa kimetodolojia na uwezekano wa matumizi ya kliniki. Mapitio ya mwisho yanajumuisha tafiti 12 zilizochapishwa kati ya 2020–2025 na jumla ya wagonjwa 6913. Thamani bora za AUC zilizoripotiwa nje ya data ya mafunzo zilitofautiana kati ya 0,7927 na 0,981, huku AUC ya wastani ikiwa 0,873. Hata hivyo, kwa sababu tafiti nyingi zilikuwa za kurejea nyuma, ufafanuzi wa PHLF haukuwa sawa na uthibitishaji wa nje ulikuwa mdogo, thamani hizi za utendaji hazipaswi kufasiriwa moja kwa moja kama mifumo iliyo tayari kwa matumizi ya kawaida ya kliniki.
Katika mapitio, familia ya gradient boosting, hasa LightGBM na XGBoost, ni miongoni mwa mbinu zenye utendaji wa juu zinazojitokeza mara kwa mara. Mitandao bandia ya neva, ujifunzaji wa kina, modeli zinazotoa sifa za radiomics kutoka picha za computed tomography au magnetic resonance, pamoja na mifumo ya ensemble, pia zimeonyesha uwezo wa maana wa kutofautisha. Maeneo ya taarifa yaliyotumika mara nyingi zaidi yalikuwa bilirubin na viashiria vingine vya hifadhi ya ini, vigezo vya kuganda kwa damu, idadi ya chembe sahani, ujazo wa ini litakalobaki au ukubwa wa resection, sifa za radiomics zinazotokana na picha na data za muda za perioperative.
Moja ya ujumbe muhimu zaidi wa utafiti huu ni kutolenga tu thamani kubwa ya AUC. Modeli inayoonekana kuwa na nguvu katika uthibitishaji wa ndani inaweza kupoteza utendaji inapohamishwa kwenda eneo tofauti la kijiografia au mgawanyo tofauti wa wagonjwa. Kwa mfano, katika modeli ya ujifunzaji wa kina wa muda ya Wang K na wenzake, AUC ilikuwa 0,952 katika tathmini ya ndani na 0,884 katika uthibitishaji wa nje nchini China, lakini ilishuka hadi 0,654 katika kohorti ya Magharibi ya MIMIC-IV. Mfano huu unaonyesha kwa nini uthibitishaji wa nje na mabadiliko ya mgawanyo ni masuala ya msingi ya usalama katika modeli za akili bandia za kliniki.
Tathmini ya jumla ya mapitio inaonyesha kuwa ujifunzaji wa mashine una uwezo wa kutathmini kwa pamoja vigezo vingi vya kliniki zaidi ya zana za kawaida za hatari kama Child–Pugh, MELD, ALBI, FIB-4 na APRI. Hata hivyo, tafiti zilizopo si ulinganisho mmoja wa pamoja uliojengwa juu ya data zilezile za wagonjwa na ufafanuzi uleule wa matokeo. Kwa hiyo, mwelekeo wa ubora unaoonekana katika fasihi hauwezi kujumlishwa kuwa “ujifunzaji wa mashine ni bora kwa uhakika kuliko alama za kawaida kwa kila mgonjwa na katika kila kituo.”
Kushindwa kwa Ini Baada ya Hepatektomia (PHLF) ni Nini?
PHLF ni hali ambapo, baada ya tishu za ini kuondolewa kwa upasuaji, ini lililobaki haliwezi kudumisha uwezo wa usanisi, utoaji na uondoaji wa sumu unaohitajika kukidhi mahitaji ya kimetaboliki ya mwili; mfumo wa ISGLS uliotumika katika mapitio unafafanua hali hii kwa hyperbilirubinemia pamoja na INR iliyoongezeka katika siku ya tano baada ya upasuaji au baadaye.
Resection ya ini ni mojawapo ya matibabu makuu ya upasuaji katika magonjwa mbalimbali yasiyo ya saratani na ya saratani, ikiwa ni pamoja na hepatocellular carcinoma, intrahepatic cholangiocarcinoma na metastasi za ini kutoka saratani ya colorectal. Ingawa kumekuwa na maendeleo katika mbinu za upasuaji, anesthesia na huduma za perioperative, PHLF bado ni mojawapo ya matatizo makubwa zaidi ya upasuaji wa ini.
Chanzo kinaeleza kuwa kiwango cha PHLF kilichoripotiwa kinaweza kutofautiana kutoka %1,2 hadi %32 kulingana na idadi ya wagonjwa, kiasi cha resection na ugonjwa wa msingi wa ini. Hatari ya PHLF haitegemei tu kiasi cha ini kilichoondolewa. Kiasi na ubora wa kiutendaji wa tishu ya ini itakayobaki, uwezo wa ini kujirekebisha, fibrosis au cirrhosis iliyopo, steatosis, portal hypertension, sarcopenia na sababu za msongo zinazohusiana na upasuaji zinaweza kuchangia kwa pamoja.
Kwa nini ini litakalobaki baadaye ni muhimu?
Future Liver Remnant (FLR) humaanisha tishu ya ini yenye kazi itakayobaki kwa mgonjwa baada ya resection. Katika muhtasari wa fasihi wa chanzo, viwango vya FLR vya angalau takribani %20 kwa ini la kawaida na takribani %40 kwa ini lenye upungufu wa kazi vimetajwa kwa tathmini ya volumetric inayotegemea computed tomography. Hata hivyo, kipimo cha ujazo pekee hakionyeshi kikamilifu uwezo halisi wa utendaji wa tishu iliyobaki.
Kwa hiyo, mbinu za kiutendaji kama indocyanine green clearance test (ICG), hepatobiliary scintigraphy na magnetic resonance imaging iliyoimarishwa kwa gadoxetic acid zimeendelezwa. Kila mojawapo ya vipimo hivi ina vikwazo kuhusu upatikanaji, usanifishaji au utendaji kati ya makundi ya watu.
Kwa nini alama za kawaida za hatari zinaweza kutotosha?
Uainishaji wa Child–Pugh, alama ya MELD na daraja la Albumin–Bilirubin (ALBI) hutathmini kazi ya ini kwa kutumia vigezo tofauti; lakini PHLF ni matokeo yanayoathiriwa kwa pamoja na mambo mengi kama thamani za maabara, ujazo wa ini litakalobaki, ugonjwa wa ini uliopo kwa mgonjwa, ukubwa wa upasuaji na mabadiliko ya perioperative. Kwa sababu hiyo, chanzo kinasisitiza kuwa alama za kawaida zinaweza kuwa na uwezo mdogo wa kunasa muundo mzima wa hatari zikitumika peke yake.
Katika mapitio ya awali ya kimfumo na meta-analysis yaliyotajwa katika mapitio haya, AUC iliyounganishwa ya ALBI kwa utabiri wa PHLF imeelezwa kuwa takribani 0,67. Matokeo haya ni mojawapo ya sababu za kuchunguza modeli tata zaidi zenye vigezo vingi.
Kwa Nini Ujifunzaji wa Mashine Unatumika Katika Utabiri wa PHLF?
Ujifunzaji wa mashine unachunguzwa kwa utabiri uliobinafsishwa wa hatari tata ya kliniki kama PHLF kwa sababu unaweza kutathmini ndani ya modeli moja mahusiano yasiyo ya mstari na yenye vigezo vingi kati ya data za maabara, sifa za picha, vigezo vya upasuaji na vipimo vya perioperative vinavyobadilika kwa muda.
Mbinu zilizotumika katika fasihi iliyochunguzwa hazijumuishi algoritimu moja tu. Zinajumuisha mitandao bandia ya neva (Artificial Neural Networks, ANN), LightGBM, XGBoost, convolutional neural networks (CNN), modeli za ujifunzaji wa kina wa muda, mbinu za radiomics na mifumo ya ensemble.
Lengo la modeli hizi si kuondoa maarifa ya kawaida ya hepatolojia. Katika mapitio, kujitokeza mara kwa mara kwa vigezo ambavyo tayari vina maana ya kliniki, kama bilirubin, albumin, INR au muda wa prothrombin, idadi ya chembe sahani, ICG-R15, kiasi cha ini litakalobaki na ukubwa wa resection, katika modeli zenye utendaji wa juu kunaonyesha kuwa mara nyingi ujifunzaji wa mashine hupanua maarifa yaliyopo ya pathophysiology kwa kuweka uzito wa pamoja kwa vigezo mbalimbali.
Data za radiomics zinaongeza nini?
Radiomics ni mbinu ya kutoa idadi kubwa ya sifa za kiasi kutoka picha za kitabibu kama CT au MRI ambazo ni vigumu kupimwa moja kwa moja kwa macho. Katika mapitio, tafiti za Zhu, Li na Famularo zinajumuisha modeli ambazo data za radiomics zilitumika pamoja na vigezo vya kliniki au maabara.
Mwelekeo unaoonekana kati ya tafiti katika mapitio unaashiria kuwa taarifa za picha zinaweza kuongeza taarifa katika baadhi ya modeli ikilinganishwa na data za kliniki pekee au radiomics pekee. Hata hivyo, matokeo haya si jaribio la predictor-ablation lililodhibitiwa lililofanywa kwenye seti moja ya pamoja ya data. Waandishi wa mapitio pia wanaeleza wazi kuwa hakuna uchambuzi wa pamoja wa leave-one-domain-out unaoweza kubainisha kwa uhakika mpangilio wa umuhimu wa vikundi vya predictor.
Data ya nguvu ya perioperative ina maana gani?
Kipimo tuli cha preoperative huwakilisha hali ya mgonjwa katika wakati mmoja tu. Data ya nguvu ya perioperative hutumia mwelekeo unaoundwa na vipimo vya maabara au kliniki vinavyobadilika kwa muda kabla ya upasuaji, wakati wa upasuaji na katika kipindi cha mapema baada ya upasuaji. Katika tafiti za Jin, Wang K na Shen, miundo kama hii ya data ya muda au ya awamu maalum ilikuwa sehemu muhimu.
Ingawa modeli hizi zinaweza kuonyesha uwezo mkubwa wa kutofautisha, zinaweza kuhitaji data zaidi na miundombinu tata zaidi. Zaidi ya hayo, kushuka kwa uthibitishaji wa nje wa MIMIC-IV katika utafiti wa Wang K kunaonyesha kuwa kutumia data tajiri zaidi hakuhakikishi moja kwa moja utendaji uleule katika hospitali au maeneo tofauti.
Thamani ya AUC Inaonyesha Nini Katika Mapitio Haya ya Kimfumo?
AUC ni kipimo cha uwezo wa kutofautisha kinachofupisha uwezo wa modeli kuwatenganisha wagonjwa wanaopata PHLF na wale wasiopata; katika mapitio haya ya kimfumo imetumika kama mojawapo ya ulinganisho mkuu wa utendaji kati ya modeli, lakini AUC pekee haionyeshi calibration, manufaa ya uamuzi wa kliniki au utendaji halisi katika hospitali tofauti.
Thamani bora za AUC zisizo za mafunzo zilizoripotiwa katika mapitio zilitofautiana kati ya 0,7927–0,981 na thamani ya wastani ilikuwa 0,873. Hata hivyo, namba hizi zote hazikutoka kwenye seti moja ya data, ufafanuzi mmoja wa PHLF au utaratibu mmoja wa uthibitishaji. Baadhi ya tafiti zilitumia random train/test split, huku nyingine zikitumia 5-fold cross-validation, uthibitishaji wa muda, kohorti ya nje au uthibitishaji wa mbele.
Kwa hiyo, si sahihi kimetodolojia kuhesabu kiotomatiki utafiti wa ndani wa ukuzaji unaoripoti 0,95 AUC kuwa “bora zaidi” kuliko modeli yenye uthibitishaji huru wa nje iliyopata 0,88 AUC. Moja ya michango muhimu ya mapitio ni kuangazia muundo wa uthibitishaji pamoja na namba ya utendaji.
Kwa nini calibration ni muhimu pia?
Uwezo wa kutofautisha unaonyesha uwezo wa kupanga watu walio katika hatari kubwa dhidi ya walio katika hatari ndogo. Katika utabiri wa hatari ya kliniki, ni muhimu pia kujua uwezekano unaotolewa na modeli unalingana kwa kiasi gani na marudio halisi ya matukio, yaani calibration. Mapitio yanaeleza kuwa katika tafiti nyingi discrimination iliripotiwa kwa ukamilifu zaidi kuliko calibration na hivyo ulinganisho wa kliniki ukabaki na mipaka.
Mbinu na Matokeo ya Utafiti
Muundo wa mapitio ya kimfumo
Mapitio yaliundwa kwa mujibu wa kanuni za PRISMA 2020 na mapendekezo ya Cochrane Handbook kuhusu mapitio ya kimfumo ya usahihi wa vipimo vya uchunguzi. Mfumo wa CHARMS ulitumika kupanga swali la utafiti na utoaji wa data. Idadi lengwa ilikuwa wagonjwa watu wazima waliofanyiwa hepatic resection kwa sababu yoyote.
Modeli za index ni algoritimu za ujifunzaji wa mashine au akili bandia zilizotengenezwa au kuthibitishwa kwa lengo la kutabiri PHLF. Kwa ufafanuzi wa matokeo, ISGLS, vigezo vya “50-50”, thamani ya kilele cha bilirubin kuwa juu ya 7 mg/dL au ufafanuzi mwingine wa kliniki wa PHLF uliothibitishwa ulikubaliwa.
Fasihi ilitafutwaje?
Hifadhidata za PubMed/MEDLINE, Embase, Web of Science Core Collection na Cochrane Library zilitafutwa tangu kuanzishwa kwake hadi 15 Januari 2026. Maneno ya utafutaji yaliunganisha makundi matatu makuu: mbinu za ujifunzaji wa mashine/akili bandia, muktadha wa hepatektomia/resection ya ini na matokeo ya PHLF/kushindwa kwa ini.
Mbali na utafutaji wa kielektroniki, orodha za marejeo za tafiti zilizojumuishwa na mapitio husika zilikaguliwa kwa mkono; muhtasari wa mikutano mikuu ya upasuaji wa hepatobiliary katika kipindi cha 2020–2025 ulipitiwa na fasihi kijivu ilitafutwa kupitia Google Scholar ili kupunguza upendeleo wa uchapishaji.
Vigezo vya kujumuisha na kuondoa
Tafiti zilizojumuishwa zilihitajika kutengeneza au kuthibitisha angalau modeli moja ya ML kwa wagonjwa wa hepatektomia wenye umri wa 18 au zaidi na kuripoti angalau kipimo kimoja cha utendaji kama AUC, sensitivity, specificity, positive predictive value, negative predictive value au accuracy. Tafiti zilizotumia logistic regression ya kawaida pekee hazikujumuishwa kama tafiti za ML.
Tafiti za upandikizaji ini ambazo hazikuhusisha hepatektomia, matibabu ya ablation, tafiti za kushindwa kwa ini zisizo za upasuaji, mapitio, makala za uhariri, muhtasari wa mikutano usio na data ya kutosha, ripoti za visa na tafiti zenye wagonjwa chini ya 50 ziliondolewa.
Uchunguzi wa kichwa/muhtasari na maandishi kamili ulifanywa na watafiti wawili huru, na tofauti zilisuluhishwa kwa makubaliano au kupitia mtathmini wa tatu. Thamani ya Cohen kappa kati ya watathmini kwa uteuzi wa tafiti iliripotiwa kuwa 0,89.
Uteuzi wa tafiti wa PRISMA
| Hatua | Idadi |
|---|---|
| Rekodi za PubMed | 156 |
| Rekodi za Embase | 134 |
| Rekodi za Web of Science | 98 |
| Rekodi za Cochrane Library | 42 |
| Jumla kutoka hifadhidata nne | 430 |
| Rekodi za ziada kutoka utafutaji wa mkono na mikutano | 12 |
| Rekodi rudufu zilizoondolewa | 144 |
| Rekodi za kipekee zilizobaki kwa uchunguzi wa kichwa/muhtasari | 298 |
| Zilizoondolewa katika hatua ya kichwa/muhtasari | 241 |
| Maandishi kamili yaliyotathminiwa | 57 |
| Zilizoondolewa baada ya maandishi kamili | 45 |
| Zilizojumuishwa katika mapitio ya mwisho ya kimfumo | 12 |
Kati ya tafiti 45 zilizoondolewa katika hatua ya maandishi kamili, sababu zilizoripotiwa zilikuwa kutokuwepo kwa modeli ya ML/AI katika 18, PHLF kutokuwa matokeo ya msingi katika 9, 8 kuwa mapitio au makala za uhariri, 5 kutumia kohorti zinazojirudia za wagonjwa na 5 kutokuwa na data ya kutosha.
Utoaji wa data na tathmini ya ubora
Fomu iliyosanifishwa ya utoaji data inayotegemea CHARMS ilijaribiwa kwanza katika tafiti tatu zilizochaguliwa kwa nasibu, kisha watathmini wawili walitoa data kwa kujitegemea kutoka tafiti zote zilizojumuishwa na kufanya ukaguzi wa msalaba. Vigezo vilivyolengwa vilijumuisha muundo wa utafiti, sifa za wagonjwa, algoritimu iliyotumika, viashiria, mbinu ya data iliyokosekana, vipimo vya utendaji, calibration, uchambuzi wa decision curve, aina ya uthibitishaji na ulinganisho na alama za kawaida.
Tathmini ya Risk of bias ilipangwa kwa kutumia PROBAST katika maeneo manne: washiriki, viashiria, matokeo na uchambuzi. Kila eneo lilitathminiwa kama hatari ndogo, kubwa au isiyoeleweka; ikiwa eneo lolote lilikuwa na hatari kubwa, hatari ya jumla ilipangwa kuhesabiwa kuwa kubwa.
Kikomo muhimu ndani ya chanzo: Jedwali 3 katika sehemu ya matokeo ya mwisho linaeleza wazi kuwa halikuhifadhi matrix ya awali ya PROBAST kwa sababu baadhi ya mistari ya chanzo katika matrix hiyo haikuthibitishwa au iliainishwa vibaya. Kwa hiyo, alama za PROBAST maalum kwa tafiti ambazo PDF ya mwisho haikuunga mkono hazikuundwa upya na Verianla.
Kwa nini meta-analysis haikufanywa?
Kwa sababu tafiti zilikuwa na utofauti mkubwa katika algoritimu, viashiria, ufafanuzi wa PHLF na mikakati ya uthibitishaji, narrative synthesis ilichaguliwa badala ya meta-analysis rasmi ya kiasi. Uamuzi huu unamaanisha kuwa kugeuza ukali tofauti wa PHLF na miundo tofauti ya uthibitishaji kuwa namba moja ya pamoja ya utendaji kunaweza kupotosha.
Muundo wa jumla wa tafiti zilizojumuishwa
Tafiti 12 zinajumuisha jumla ya wagonjwa 6913. Ukubwa wa kila utafiti ulitofautiana kati ya 101 na 2074, na ukubwa wa sampuli wa wastani ulikuwa 363,5. Tafiti tisa zilitoka China; moja ilitoka Japan na mbili zilikuwa na muundo wa kimataifa au uthibitishaji wa nje nje ya China. Tafiti saba zilikuwa za kituo kimoja na tano za vituo vingi. Utafiti wa Tang na wenzake ndio pekee katika seti hii ya data uliotumia wazi kohorti ya uthibitishaji wa mbele.
| Utafiti | Mwaka | Nchi/muktadha | N | Muundo wa vituo |
|---|---|---|---|---|
| Mai na wenz. | 2020 | China | 353 | Kituo kimoja |
| Zhu WS na wenz. | 2020 | China | 101 | Kituo kimoja |
| Wang J na wenz. | 2022 | China | 875 | Vituo 8 |
| Xu na wenz. | 2023 | China | 265 | Kituo kimoja |
| Li na wenz. | 2023 | China | 276 | Kituo kimoja |
| Tashiro na wenz. | 2024 | Japan | 334 | Kituo kimoja |
| Jin na wenz. | 2024 | China | 226 | Kituo kimoja |
| Famularo na wenz. | 2025 | Italia/Ulaya | 500 | Vituo 13 |
| Tang na wenz. | 2025 | China | 374 | Kituo kimoja + uthibitishaji wa mbele |
| Yuan na wenz. | 2025 | China | 464 | Kituo kimoja |
| Wang K na wenz. | 2025 | China + MIMIC | 2074 | Vituo vingi + kohorti ya nje |
| Shen na wenz. | 2025 | China | 1071 | Vituo 3 |
Ni modeli zipi zilionyesha uwezo mkubwa zaidi wa kutofautisha?
| Utafiti | Modeli | AUC iliyoripotiwa | Muundo wa uthibitishaji |
|---|---|---|---|
| Mai | ANN | 0,880 ukuzaji; 0,876 uthibitishaji | Sampuli tofauti ya uthibitishaji |
| Zhu | Modeli inayotegemea radiomics | 0,894 | Uthibitishaji wa ndani |
| Wang J | LightGBM | 0,944 mafunzo; 0,870 uthibitishaji; 0,822 test | Mgawanyo wa kohorti nyingi |
| Xu | CNN / ujifunzaji wa kina | 0,7927 | 5-fold cross-validation |
| Li | Modeli ya radiomics iliyounganishwa | 0,84 mafunzo; 0,82 test | Sampuli tofauti ya test |
| Tashiro | XGBoost | 0,863 | Mgawanyo wa mafunzo/test |
| Jin | ANN | 0,766 preoperative; 0,851 postoperative; 0,720/0,731 wa muda | 5-fold CV + uthibitishaji wa muda |
| Famularo | Averaging ensemble | 0,901 test | Mgawanyo wa mafunzo/test |
| Tang | XGBoost | 0,983 mafunzo; 0,981 uthibitishaji; 0,942 wa mbele | Ndani + uthibitishaji wa mbele |
| Yuan | LightGBM | 0,927 mafunzo; 0,703 test; 0,808 uthibitishaji | Mafunzo/test/uthibitishaji |
| Wang K | Ujifunzaji wa kina wa muda | 0,952 ndani; 0,884 nje China; 0,654 MIMIC | Nje + kohorti ya nje ya Magharibi |
| Shen | PILOT, usanifu maalum kwa awamu | 0,754–0,904 mafunzo; 0,740–0,895 uthibitishaji | Kohorti mbili za nje |
Kielelezo 2 cha chanzo kinaonyesha kwa kulinganisha AUC bora iliyoripotiwa nje ya mafunzo kwa kila utafiti. Katika grafu, Tang 2025 iko juu zaidi kwa takribani 0,981; ikifuatiwa na Famularo 2025 0,901, Shen 2025 0,895, Zhu 2020 0,894 na Wang K 2025 0,884. Hata hivyo, mpangilio huu haumaanishi kuwa modeli zililinganishwa chini ya hali sawa.
Kwa Nini Uthibitishaji wa Nje ni Muhimu Katika Modeli za PHLF?
Uthibitishaji wa nje hujaribu ikiwa modeli inaweza kudumisha utendaji unaofanana katika hospitali, kipindi cha muda au eneo la kijiografia lililo huru na kundi la wagonjwa ambako modeli ilitengenezwa; katika fasihi ya PHLF, kushuka kwa AUC ya modeli ya Wang K kutoka 0,952 katika tathmini ya ndani hadi 0,654 katika kohorti ya MIMIC-IV kunaonyesha kuwa mabadiliko ya mgawanyo yanaweza kubadilisha sana uwezo wa kujumlisha kliniki.
Katika mapitio, dalili zenye maana zaidi kuhusu uwezo wa kujumlisha zilitokana na miundo ya uthibitishaji isiyo ya random. Jin na wenzake waliripoti 0,720 na 0,731 AUC katika uthibitishaji wa muda; Tang na wenzake 0,942 AUC katika uthibitishaji wa mbele; Wang K na wenzake 0,884 katika kohorti ya nje nchini China na 0,654 AUC katika MIMIC-IV; Shen na wenzake AUC ya 0,740–0,895 katika kohorti mbili za nje.
Mifano hii inaonyesha kuwa kupata utendaji mkubwa katika seti ya ndani ya test inayofanana sana na data ya ukuzaji wa modeli si sawa na uwezo wa kuhamishwa kliniki.
Kwa nini mkusanyiko wa kijiografia ni kikwazo?
Tafiti tisa kati ya 12 zinatoka China na moja inatoka Japan. Chanzo kinasisitiza kuwa fasihi hii imejikita kwa kiasi kikubwa katika Asia Mashariki, hepatocellular carcinoma na, katika baadhi ya kohorti, ugonjwa wa ini unaohusiana na HBV. Kinyume chake, katika makundi ya wagonjwa wa Magharibi kunaweza kuwa na mgawanyo tofauti wa visa kama fatty liver disease, ugonjwa wa ini unaohusiana na pombe na metastasi za ini za colorectal.
Kwa hiyo, modeli kutoa matokeo mazuri katika nchi au mfumo mmoja wa hospitali hakumaanishi kuwa itadumisha calibration na uwezo uleule wa kutofautisha katika eneo jingine la matumizi. Uthibitishaji wa nje katika eneo lengwa la matumizi, recalibration inapohitajika na kuripoti wazi tofauti za case mix vinahitajika.
Ni vikundi gani vya viashiria vinavyoonekana mara kwa mara?
| Eneo la kiashiria | Mifano iliyoonekana katika mapitio | Jukumu la kisayansi |
|---|---|---|
| Hifadhi ya ini / maabara | Bilirubin, albumin, INR/muda wa prothrombin | Ishara kuu ya kliniki kuhusu uwezo wa ini wa usanisi na utoaji |
| Viashiria vya hematolojia/portal | Idadi ya chembe sahani | Mchango wa taarifa ya hatari katika muktadha wa portal hypertension na ugonjwa wa ini |
| Vipimo vya utendaji | ICG-R15 | Taarifa ya kutathmini hifadhi ya utendaji wa ini |
| Resection/volumetry | FLR, ukubwa wa resection, ujazo uliobaki | Kuwakilisha tishu yenye kazi itakayobaki baada ya upasuaji na mzigo wa upasuaji |
| Imaging | Sifa za radiomics za CT/MRI | Kuwakilisha heterogeneity ya parenchyma kwa sifa za kiasi za picha |
| Data ya nguvu ya perioperative | Vipimo vya maabara na perioperative vinavyobadilika kwa muda | Kumodeli mwenendo wa fiziolojia unaobadilika wa mgonjwa badala ya kipimo kimoja |
Kulingana na tafsiri ya mapitio kati ya tafiti, modeli zilizotumia vigezo tuli vya preoperative vya hifadhi ya ini ziliweza kufikia takribani 0,81–0,88 AUC katika data za ndani. Kuongezwa kwa radiomics ya imaging kuliboresha matokeo katika baadhi ya tafiti asilia ikilinganishwa na submodeli za kliniki pekee au radiomics pekee. Modeli za nguvu za perioperative ziliweza kuonyesha uwezo mkubwa wa kutofautisha, lakini zilikabiliwa na matatizo yaliyo wazi zaidi kuhusu uwezo wa kujumlisha nje.
Ufafanuzi wa modeli ulishughulikiwaje?
Tafiti zilitumia uchambuzi wa SHAP, nomograms, maonyesho ya feature-importance, vikundi vya hatari na zana za mtandaoni kwa ajili ya ufafanuzi. Hasa katika maamuzi ya kliniki yenye hatari kubwa, ni muhimu kwa kukubalika kliniki kwamba modeli isiwasilishe uwezekano tu, bali iwezekane kufuatilia ni vigezo gani vilivyochangia utabiri.
Je, modeli za ML ni bora kuliko alama za kawaida?
Katika tafiti zilizojumuishwa, mwelekeo wa ulinganisho uliofanywa kwenye kohorti ileile kwa ujumla unapendelea modeli zinazotegemea ML. Mifano kama ANN ya Mai, modeli ya radiomics ya Zhu, LightGBM ya Wang J, XGBoost ya Tashiro, ANN ya Jin na XGBoost ya Tang iliripoti uwezo wa juu zaidi wa kutofautisha ikilinganishwa na alama za kawaida au modeli rahisi za kliniki.
Hata hivyo, mapitio ya kimfumo hayakufanya benchmark moja iliyounganishwa ambapo modeli zote pamoja na Child–Pugh, MELD, ALBI, FIB-4 au APRI zilifundishwa upya na kujaribiwa kwenye rekodi zilezile za wagonjwa. Uchambuzi kama huo haukuwezekana kwa sababu hakukuwa na data ghafi iliyoharmonishwa katika kiwango cha mgonjwa. Kwa hiyo, matokeo si ubora wa jumla uliothibitishwa na jaribio moja la pamoja la mbele; ni mwelekeo thabiti wa matokeo yaliyoripotiwa na tafiti asilia katika kohorti zao.
Mapengo makuu katika fasihi
Utofauti wa ufafanuzi wa matokeo: Tafiti zilitumia endpoints tofauti kama “severe PHLF”, “clinically significant PHLF”, PHLF ya jumla na “postoperative liver failure”. Kuweka AUC za modeli zinazotabiri matukio ya ukali tofauti kando kwa kando kunafanya ulinganisho wa kliniki kuwa mgumu.
Kuripoti utendaji bila ukamilifu: Ingawa AUC iliripotiwa mara nyingi, sensitivity, specificity, PPV, NPV, calibration slope/intercept, decision curve analysis na data za confusion matrix hazikutolewa kwa uthabiti.
Uthibitishaji wa nje ulio mdogo: Kulingana na tathmini ya mapitio, tafiti nne tu zina muundo wa uthibitishaji wa muda, wa mbele au wa nje. Jaribio la wazi la kuhamisha kwenye seti ya data ya Magharibi ni dogo hasa.
Kutoripoti gharama za kompyuta: Tafiti zilizojumuishwa hazikuripoti kwa utaratibu gharama za kiufundi za deployment kama muda wa mafunzo, inference latency, matumizi ya kumbukumbu na mahitaji ya CPU/GPU. Upungufu huu hufanya tathmini ya matumizi ya muda halisi kuwa ngumu, hasa katika miundombinu ya hospitali.
Ablation ya eneo la viashiria: Hakuna ablation kamili ya pamoja inayotoa kwa zamu vikundi vya vigezo vya maabara, koagulesheni, volumetry, radiomics na muda ndani ya mfumo mmoja wa modeli na kuifundisha upya.
Usalama wa mabadiliko ya mgawanyo: Mifumo ya usalama kama selective prediction au cost-aware deferral inayowapeleka kwa klinisia visa vya uaminifu mdogo badala ya uamuzi wa kiotomatiki haikutekelezwa rasmi katika tafiti zilizojumuishwa.
Mapendekezo kwa tafiti zijazo
Waandishi wa mapitio wanapendekeza kwamba tafiti zijazo zitumie kadiri iwezekanavyo ISGLS grade B/C PHLF iliyosanifishwa na yenye maana ya kliniki kama ufafanuzi wa matokeo ya msingi; ziripoti sensitivity, specificity, PPV, NPV, calibration na decision curve analysis pamoja na AUC; na ziongeze uthibitishaji wa nje wa vituo vingi na wa maeneo tofauti ya kijiografia.
Zaidi ya hayo, modeli za multimodal zinazounganisha viashiria vya hifadhi ya ini vinavyotokana na maabara na imaging pamoja na data za muda mfupi za perioperative zinaonekana kustahili kuchunguzwa. Hata hivyo, ili kutathmini ikiwa modeli tata zaidi kweli inaleta manufaa ya kliniki, inapaswa kulinganishwa moja kwa moja na modeli msingi zenye nguvu na gharama ndogo zaidi.
Katika hatua ya mwisho, kinachohitajika si AUC kubwa zaidi pekee. Tafiti za mbele za decision-impact zinapaswa kuonyesha ikiwa mfumo wa utabiri kwa kweli hubadilisha mkakati wa upasuaji, hatua za kuongeza FLR, kiwango cha ufuatiliaji baada ya upasuaji au matibabu ya uokoaji, na kama huleta manufaa ya kliniki kwa wagonjwa.
Matokeo yanayoungwa mkono na utafiti
Fasihi iliyopo inaunga mkono kwamba modeli zinazotegemea ML zinaweza kuonyesha utendaji wenye matumaini katika kutofautisha hatari ya PHLF. Uwezo wa kutofautisha wenye maana ya kliniki umeripotiwa katika gradient boosting, ANN/ujifunzaji wa kina, radiomics na modeli za muda. Kuna dalili thabiti kwamba modeli zenye nguvu zinaweza kujengwa wakati viashiria vya hifadhi ya ini, imaging na taarifa za perioperative zinapotumika pamoja.
Mapitio pia yanaunga mkono kwamba muundo wa uthibitishaji ni muhimu sawa na mafanikio ya modeli. Hasa, uthibitishaji wa muda, wa mbele na huru wa nje hutoa ushahidi wenye nguvu zaidi kuhusu uwezo halisi wa modeli kujumlisha kuliko mgawanyo wa nasibu wa test za ndani.
Matokeo ambayo utafiti hauungi mkono
Mapitio hayaonyeshi kwamba usanifu fulani wa ML ndio modeli bora kwa ujumla kwa PHLF. Thamani kubwa za AUC kama 0,981 si thamani za utendaji zilizohakikishwa zinazoweza kuhamishwa kwa hospitali, nchi na makundi yote ya wagonjwa.
Utafiti huu si jaribio la decision-impact linalothibitisha kwamba matumizi ya kawaida ya kliniki ya zana za utabiri wa PHLF zinazotegemea ML hupunguza vifo vya wagonjwa au kiwango cha matatizo. Modeli nyingi zilizojumuishwa zinategemea data za kurejea nyuma na modeli nyingi hazina uthibitishaji huru wa nje.
Hitimisho kwamba ujifunzaji wa mashine unapaswa kubadilisha kiotomatiki uamuzi wa klinisia au kutoa peke yake uamuzi wa upasuaji pia haliwezi kutolewa kutoka mapitio haya ya kimfumo. Mtazamo wa baadaye wa chanzo unasisitiza haja ya mifumo iliyo wazi zaidi, iliyothibitishwa nje, iliyocalibrate na iliyoonyesha manufaa ya uamuzi wa kliniki.
Maelezo ya Chanzo na Mbinu
Utafiti asilia: Machine Learning Models for Predicting Post-Hepatectomy Liver Failure: A Systematic Review
Waandishi: Calin Muntean; Vasile Gaborean; Razvan Constantin Vonica; Sebastian Aurelian Stefaniga; Alaviana Monique Faur; Catalin Vladut Ionut Feier.
Waandishi wa mawasiliano: Vasile Gaborean na Razvan Constantin Vonica.
Taasisi: vitengo vya Medical Informatics and Biostatistics, Thoracic Surgery Research Center, Surgical Semiology, Doctoral Studies na Abdominal Surgery and Phlebology Research Center ndani ya “Victor Babeş” University of Medicine and Pharmacy Timişoara; “Lucian Blaga” University of Sibiu, Preclinical Department/Physiology; West University of Timişoara, Department of Computer Science; “Pius Brinzeu” Clinical Emergency Hospital, First Surgery Clinic.
Jarida: AI.
Mchapishaji: MDPI.
Aina ya chanzo: Mapitio ya kimfumo.
Taarifa ya uchapishaji: AI 2026, 7(5), 166.
DOI: 10.3390/ai7050166
Kuwasilishwa: 27 Machi 2026.
Marekebisho: 25 Aprili 2026.
Kukubaliwa: 5 Mei 2026.
Kuchapishwa: 9 Mei 2026.
Anwani rasmi ya uchapishaji: https://www.mdpi.com/2673-2688/7/5/166
Leseni: Ufikiaji wazi, Creative Commons Attribution (CC BY).
Mfumo wa mapitio ya kimfumo: PRISMA 2020, mapendekezo ya Cochrane Handbook, CHARMS na PROBAST zilitumika.
Dokezo la usajili: Muhtasari na sehemu ya mbinu ya makala inaeleza kuwa itifaki ilisajiliwa katika PROSPERO. Sehemu hiyo hiyo ya mbinu pia inatoa DOI 10.17605/OSF.IO/67CQ3 kama usajili wa Open Science Framework. Kwa kuwa namba tofauti ya usajili wa PROSPERO CRD haionekani katika PDF, taarifa hizi mbili hazikuunganishwa wala kukisiwa.
Ufadhili: Imeelezwa kuwa article processing charge ya makala ililipwa na Victor Babeş University of Medicine and Pharmacy Timişoara.
Kamati ya maadili ya taasisi: Haitumiki.
Ridhaa iliyoarifiwa: Haitumiki.
Upatikanaji wa data: Waandishi wanaeleza kuwa hakuna data mpya iliyoundwa au kuchambuliwa kwa mapitio haya ya kimfumo.
Mgongano wa maslahi: Waandishi wametangaza kuwa hawana mgongano wa maslahi.
Tamko la matumizi ya AI: Waandishi wanasema walitumia ChatGPT v4.0 kwa lengo pekee la kuboresha lugha na usomaji wa makala; maudhui ya kisayansi, tafsiri na hitimisho ni ya waandishi.
Michango ya waandishi: Uundaji wa dhana Calin Muntean, Vasile Gaborean na Razvan Constantin Vonica; methodology Calin Muntean, Sebastian Aurelian Stefaniga na Razvan Constantin Vonica; software Sebastian Aurelian Stefaniga; validation Calin Muntean, Vasile Gaborean na Razvan Constantin Vonica; formal analysis Calin Muntean na Sebastian Aurelian Stefaniga; investigation Calin Muntean na Alaviana Monique Faur; data curation Calin Muntean na Alaviana Monique Faur. Rasimu ya kwanza iliandaliwa na Calin Muntean; Vasile Gaborean, Razvan Constantin Vonica, Sebastian Aurelian Stefaniga na Catalin Vladut Ionut Feier walichangia mapitio na uhariri.
Vikwazo vikuu vya kimetodolojia: Tafiti nyingi zilizojumuishwa kuwa za kurejea nyuma na za kituo kimoja; ufafanuzi usiofanana wa endpoint ya PHLF; data kuwa na mkusanyiko mkubwa wa kijiografia katika Asia Mashariki; kuripoti calibration, sensitivity na specificity bila uthabiti; ukosefu wa uthibitishaji wa nje; kutoweza kulinganisha moja kwa moja familia tofauti za modeli na kutoripoti kwa kutosha gharama za kompyuta.
Dokezo la mbinu ya Verianla: Maandishi haya si tafsiri ya mstari kwa mstari ya makala chanzo. Muundo huru wa kufundishia umeundwa huku tatizo la kliniki, mbinu ya mapitio ya kimfumo, idadi ya wagonjwa na tafiti, utendaji wa modeli, mikakati ya uthibitishaji, maeneo ya viashiria, ujumbe wa kisayansi wa vielelezo, mjadala na vikwazo vya chanzo vikihifadhiwa. Hakuna matokeo ya kliniki, kipimo cha utendaji au mafanikio ya modeli ambayo hayapo katika chanzo yaliyoongezwa.
Kikomo cha tafsiri ya kitabibu: Utendaji wa modeli uliotajwa hapa unatokana na tafiti za usaidizi wa maamuzi ya kliniki. Hauwezi kutumika peke yake kuamua kufaa kwa upasuaji, hatari ya PHLF au mpango wa matibabu wa mgonjwa yeyote; maamuzi ya kliniki yanahitaji tathmini maalum ya mgonjwa na itifaki za eneo zilizothibitishwa.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *