

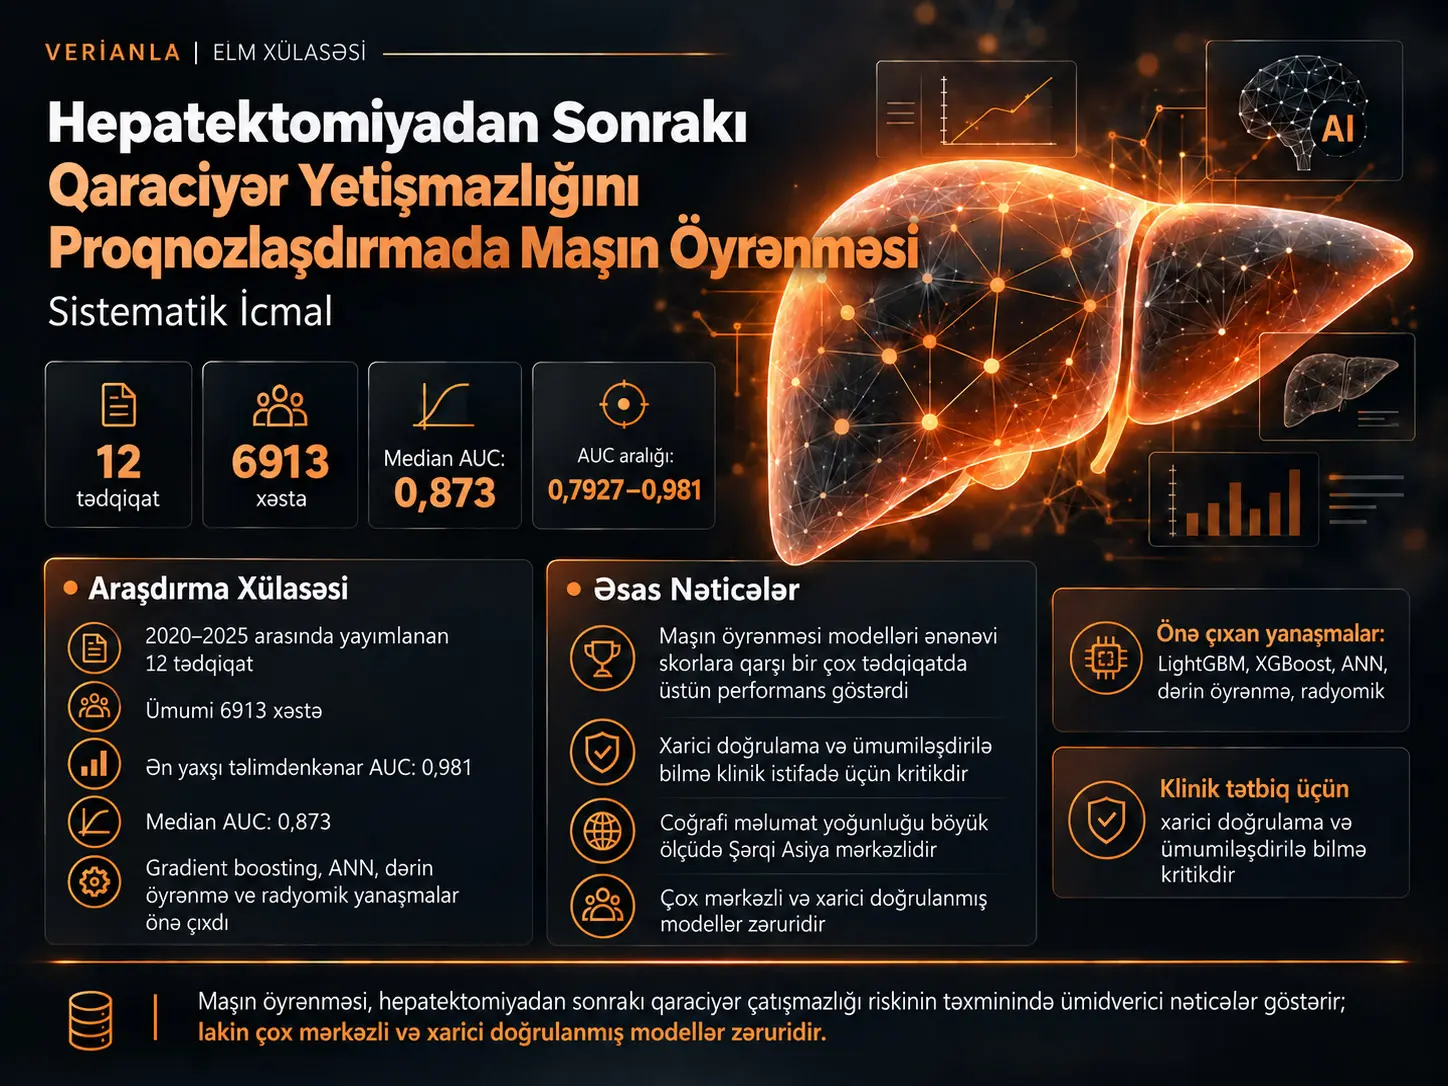
Hepatektomiyadan sonrakı qaraciyər çatışmazlığı (Post-Hepatectomy Liver Failure, PHLF), qaraciyər rezeksiyasından sonra qaraciyərin sintez, xaricetmə və detoksifikasiya funksiyalarını yetərincə davam etdirə bilməməsi ilə xarakterizə olunan ciddi əməliyyatdan sonrakı fəsaddır. Bu sistematik icmal PHLF riskini proqnozlaşdırmaq üçün hazırlanmış maşın öyrənməsi modellərinin ayırdetmə performansını, istifadə olunan proqnozlaşdırıcıları, doğrulama üsullarını, metodoloji keyfiyyətini və klinik tətbiq oluna bilməsini qiymətləndirir. Yekun icmal 2020–2025 arasında dərc edilmiş 12 tədqiqatı və ümumilikdə 6913 xəstəni əhatə edir. Təlim məlumatlarından kənarda bildirilən ən yaxşı AUC dəyərləri 0,7927 ilə 0,981 arasında dəyişmiş, median AUC 0,873 olmuşdur. Bununla belə, tədqiqatların əksəriyyətinin retrospektiv olması, PHLF təriflərinin eyni olmaması və xarici doğrulamanın məhdud qalması səbəbindən bu performans dəyərləri birbaşa gündəlik klinik istifadəyə hazır sistemlər kimi şərh edilməməlidir.
İcmalda gradient boosting ailəsi, xüsusilə LightGBM və XGBoost, tez-tez rast gəlinən yüksək performanslı yanaşmalar sırasındadır. Süni neyron şəbəkələri, dərin öyrənmə, kompüter tomoqrafiyası və ya maqnit-rezonans görüntülərindən radiomik xüsusiyyətlər çıxaran modellər və ensemble sistemləri də əhəmiyyətli ayırdetmə performansı göstərmişdir. Ən çox istifadə olunan məlumat sahələri bilirubin və digər qaraciyər ehtiyat göstəriciləri, koaqulyasiya parametrləri, trombosit sayı, qalan qaraciyər həcmi və ya rezeksiyanın həcmi, görüntüləməyə əsaslanan radiomik xüsusiyyətlər və perioperativ zaman məlumatları olmuşdur.
Tədqiqatın ən güclü mesajlarından biri yalnız yüksək AUC dəyərinə fokuslanmamaqdır. Daxili doğrulamada güclü görünən model fərqli coğrafiyaya və ya xəstə paylanmasına köçürüldükdə performansını itirə bilər. Məsələn, Wang K və həmkarlarının zaman ardıcıllı dərin öyrənmə modelində AUC daxili qiymətləndirmədə 0,952, Çin xarici doğrulamasında 0,884 olduğu halda, Qərb MIMIC-IV kohortunda 0,654-ə düşmüşdür. Bu nümunə klinik süni intellekt modellərində xarici doğrulama və paylanma sürüşməsinin niyə əsas təhlükəsizlik məsələləri olduğunu göstərir.
İcmalın ümumi qiymətləndirməsi maşın öyrənməsinin ənənəvi Child–Pugh, MELD, ALBI, FIB-4 və APRI kimi risk alətlərindən kənarda çoxsaylı klinik dəyişənləri birlikdə qiymətləndirmək potensialına malik olması istiqamətindədir. Lakin mövcud tədqiqatlar eyni xəstə məlumatı və eyni nəticə tərifi üzərində qurulmuş vahid ortaq müqayisə deyil. Buna görə ədəbiyyatda müşahidə olunan üstünlük meyli “maşın öyrənməsi hər xəstədə və hər mərkəzdə ənənəvi şkallardan qəti şəkildə daha yaxşıdır” şəklində ümumiləşdirilə bilməz.
Hepatektomiyadan Sonrakı Qaraciyər Çatışmazlığı (PHLF) Nədir?
PHLF, qaraciyər toxumasının cərrahi yolla çıxarılmasından sonra qalan qaraciyərin orqanizmin metabolik tələblərini qarşılayacaq sintez, xaricetmə və detoksifikasiya qabiliyyətini davam etdirə bilməməsi vəziyyətidir; icmalda istifadə olunan ISGLS çərçivəsi bunu əməliyyatdan sonrakı beşinci gün və ya daha sonra yüksəlmiş INR ilə birlikdə hiperbilirubinemiya əsasında müəyyənləşdirir.
Qaraciyər rezeksiyası hepatosellülyar karsinoma, intrahepatik xolangiokarsinoma və kolorektal xərçəngin qaraciyər metastazları daxil olmaqla müxtəlif xoşxassəli və bədxassəli xəstəliklərdə əsas cərrahi müalicələrdən biridir. Cərrahi texnika, anesteziya və perioperativ qulluqda irəliləyiş əldə edilsə də, PHLF qaraciyər cərrahiyyəsinin ən ciddi fəsadlarından biri olaraq qalır.
Mənbə bildirilən PHLF insidensiyasının xəstə populyasiyası, rezeksiyanın miqdarı və əsas qaraciyər xəstəliyindən asılı olaraq %1,2 ilə %32 arasında dəyişə bildiyini göstərir. PHLF riski yalnız çıxarılan qaraciyər miqdarından asılı deyil. Gələcəkdə qalacaq qaraciyər toxumasının miqdarı və funksional keyfiyyəti, qaraciyərin regenerasiya qabiliyyəti, mövcud fibroz və ya sirroz, steatoz, portal hipertenziya, sarkopeniya və əməliyyatla bağlı stress amilləri birlikdə rol oynaya bilər.
Gələcəkdə qalacaq qaraciyər niyə vacibdir?
Future Liver Remnant (FLR), rezeksiyadan sonra xəstədə qalacaq funksional qaraciyər toxumasını ifadə edir. Mənbənin ədəbiyyat xülasəsində kompüter tomoqrafiyasına əsaslanan volumetrik qiymətləndirmə üçün normal qaraciyərdə ən azı təxminən %20 və funksiyası pozulmuş qaraciyərdə təxminən %40 FLR hədləri göstərilir. Bununla belə, yalnız həcm ölçümü qalan toxumanın real funksional qabiliyyətini tam göstərmir.
Buna görə indosiyanin yaşılının klirens testi (ICG), hepatobiliar sintiqrafiya və gadoxetic acid ilə gücləndirilmiş maqnit-rezonans görüntüləmə kimi funksional yanaşmalar hazırlanmışdır. Bu testlərin hər birinin əlçatanlıq, standartlaşdırma və ya populyasiyalararası performans baxımından məhdudiyyətləri vardır.
Ənənəvi risk şkalları niyə kifayət etməyə bilər?
Child–Pugh təsnifatı, MELD şkalası və Albumin–Bilirubin (ALBI) dərəcəsi qaraciyər funksiyasını müxtəlif dəyişənlər əsasında qiymətləndirir; lakin PHLF laboratoriya göstəriciləri, qalan qaraciyər həcmi, xəstənin mövcud qaraciyər xəstəliyi, əməliyyatın həcmi və perioperativ dəyişikliklər kimi çoxsaylı amillərin birlikdə təsir etdiyi nəticədir. Mənbə buna görə klassik şkalaların təkbaşına bütün risk strukturunu əhatə etməkdə məhdud qala biləcəyini vurğulayır.
İcmalda istinad edilən əvvəlki sistematik icmal və meta-analizdə ALBI-nin PHLF proqnozu üçün birləşdirilmiş AUC dəyərinin təxminən 0,67 olduğu bildirilir. Bu tapıntı daha mürəkkəb və çoxdəyişənli modellərin araşdırılmasının əsaslandırmalarından biridir.
PHLF Proqnozunda Maşın Öyrənməsi Niyə İstifadə Olunur?
Maşın öyrənməsi laboratoriya məlumatları, görüntüləmə xüsusiyyətləri, cərrahi dəyişənlər və zaman ərzində dəyişən perioperativ ölçmələr arasındakı qeyri-xətti və çoxdəyişənli əlaqələri eyni model daxilində qiymətləndirə bildiyi üçün PHLF kimi mürəkkəb klinik riskin fərdiləşdirilmiş proqnozunda araşdırılır.
Nəzərdən keçirilən ədəbiyyatda istifadə olunan üsullar tək bir alqoritmdən ibarət deyil. Süni neyron şəbəkələri (Artificial Neural Networks, ANN), LightGBM, XGBoost, konvolyusion neyron şəbəkələri (CNN), zaman ardıcıllı dərin öyrənmə modelləri, radiomik yanaşmalar və ensemble sistemləri yer alır.
Bu modellərin məqsədi klassik hepatologiya biliklərini aradan qaldırmaq deyil. İcmalda yüksək performanslı modellərdə bilirubin, albumin, INR və ya protrombin vaxtı, trombosit sayı, ICG-R15, qalan qaraciyər miqdarı və rezeksiyanın həcmi kimi artıq klinik baxımdan mənalı dəyişənlərin təkrar-təkrar ortaya çıxması göstərir ki, maşın öyrənməsi əksər hallarda mövcud patofizioloji biliyi müxtəlif dəyişənləri birlikdə çəkiləndirməklə genişləndirir.
Radiomik məlumatlar nə əlavə edir?
Radiomika CT və ya MRI kimi tibbi görüntülərdən adi gözlə birbaşa ölçülməsi çətin olan çoxsaylı kəmiyyət görüntü xüsusiyyətlərinin çıxarılması yanaşmasıdır. İcmalda Zhu, Li və Famularo tədqiqatlarında radiomik məlumatların klinik və ya laboratoriya dəyişənləri ilə birlikdə istifadə olunduğu modellər yer alır.
İcmaldakı tədqiqatlararası nümunə görüntüləmə məlumatının bəzi modellərdə yalnız klinik məlumatla və ya yalnız radiomik məlumatla müqayisədə əlavə informasiya verə biləcəyinə işarə edir. Lakin bu nəticə vahid ortaq məlumat dəstində aparılmış nəzarətli predictor-ablation təcrübəsi deyil. İcmal müəllifləri də predictor qruplarının əhəmiyyət sırasını qəti şəkildə müəyyən edə biləcək ortaq leave-one-domain-out analizinin mövcud olmadığını açıq şəkildə bildirirlər.
Perioperativ dinamik məlumat nə deməkdir?
Statik preoperativ ölçmə xəstənin yalnız bir andakı vəziyyətini təmsil edir. Perioperativ dinamik məlumat isə əməliyyatdan əvvəl, əməliyyat zamanı və erkən əməliyyatdan sonrakı dövrdə zamanla dəyişən laboratoriya və ya klinik ölçmələrin yaratdığı trayektoriyadan istifadə edir. Jin, Wang K və Shen tədqiqatlarında bu tip zaman ardıcıllı və ya fazaya xas məlumat strukturları mühüm komponent olmuşdur.
Bu modellər yüksək ayırdetmə gücü göstərə bilsə də, daha çox məlumat və daha mürəkkəb infrastruktur tələb edə bilər. Üstəlik, Wang K tədqiqatındakı MIMIC-IV xarici doğrulama enişi daha zəngin məlumat istifadəsinin fərqli xəstəxanalarda və ya coğrafiyalarda eyni performansı avtomatik olaraq təmin etmədiyini göstərir.
AUC Dəyəri Bu Sistematik İcmalda Nəyi Göstərir?
AUC modelin PHLF inkişaf edən və inkişaf etməyən xəstələri bir-birindən ayırmaq qabiliyyətini ümumiləşdirən ayırdetmə gücü ölçüsüdür; bu sistematik icmalda modellər arasında əsas performans müqayisələrindən biri kimi istifadə edilmişdir, lakin AUC təkbaşına kalibrasiyanı, klinik qərar faydasını və ya fərqli xəstəxanadakı real performansı göstərmir.
İcmalda təlimdən kənarda bildirilən ən yaxşı AUC dəyərləri 0,7927–0,981 arasında dəyişmiş və median dəyər 0,873 olmuşdur. Bununla belə, bu rəqəmlərin hamısı eyni məlumat dəstindən, eyni PHLF tərifindən və ya eyni doğrulama prosedurundan gəlmir. Bəzi tədqiqatlar random train/test bölgüsündən istifadə etdiyi halda, digərləri 5 qat çarpaz doğrulama, zaman üzrə doğrulama, xarici kohort və ya prospektiv doğrulama istifadə etmişdir.
Buna görə 0,95 AUC bildirən daxili inkişaf tədqiqatını, 0,88 AUC əldə etmiş müstəqil xarici doğrulamalı modeldən avtomatik olaraq “daha yaxşı” saymaq metodoloji baxımdan düzgün deyil. İcmalın mühüm töhfələrindən biri də performans rəqəmi ilə yanaşı doğrulama strukturuna diqqət çəkməsidir.
Kalibrasiya niyə ayrıca vacibdir?
Ayırdetmə qabiliyyəti yüksək riskli şəxsləri aşağı riskli şəxslərdən sıralamaq qabiliyyətini göstərir. Klinik risk proqnozunda bununla yanaşı modelin verdiyi ehtimalların real hadisə tezlikləri ilə nə dərəcədə uyğun olması, yəni kalibrasiya da vacibdir. İcmal bir çox tədqiqatda diskriminasiyanın kalibrasiyadan daha tam hesabatlandığını və buna görə klinik müqayisənin məhdud qaldığını bildirir.
Tədqiqatın Metodu və Nəticələri
Sistematik icmalın dizaynı
İcmal PRISMA 2020 prinsiplərinə və Cochrane Handbook-un diaqnostik test dəqiqliyi üzrə sistematik icmallara dair tövsiyələrinə uyğun qurulmuşdur. Tədqiqat sualının və məlumat çıxarılmasının təşkilində CHARMS çərçivəsindən istifadə edilmişdir. Hədəf populyasiya hər hansı səbəbdən hepatik rezeksiyaya məruz qalan yetkin xəstələrdir.
İndeks modellər PHLF-ni proqnozlaşdırmaq məqsədilə hazırlanmış və ya doğrulanmış maşın öyrənməsi və ya süni intellekt alqoritmləridir. Nəticə tərifi üçün ISGLS, “50-50” meyarları, pik bilirubin dəyərinin 7 mg/dL-dən yüksək olması və ya başqa doğrulanmış klinik PHLF tərifləri qəbul edilmişdir.
Ədəbiyyat necə axtarıldı?
PubMed/MEDLINE, Embase, Web of Science Core Collection və Cochrane Library verilənlər bazaları yaradıldıqları tarixdən 15 Yanvar 2026-ya qədər axtarılmışdır. Axtarış terminləri üç əsas qrupu birləşdirmişdir: maşın öyrənməsi/süni intellekt üsulları, hepatektomiya/qaraciyər rezeksiyası konteksti və PHLF/qaraciyər çatışmazlığı nəticələri.
Elektron axtarışa əlavə olaraq daxil edilmiş tədqiqatların və əlaqəli icmalların istinad siyahıları əl ilə yoxlanılmış; 2020–2025 dövründə əsas hepatobiliar cərrahiyyə toplantılarının tezisləri nəzərdən keçirilmiş və nəşr qərəzini azaltmaq məqsədilə Google Scholar vasitəsilə boz ədəbiyyat axtarılmışdır.
Daxiletmə və xaricetmə meyarları
Daxil edilən tədqiqatların 18 yaş və ya daha yuxarı hepatektomiya xəstələrində ən azı bir ML modeli hazırlaması və ya doğrulaması və AUC, həssaslıq, spesifiklik, müsbət proqnostik dəyər, mənfi proqnostik dəyər və ya dəqiqlik kimi ən azı bir performans metrikasını hesabatlandırması tələb olunurdu. Yalnız ənənəvi logistik reqressiyadan istifadə edən tədqiqatlar ML tədqiqatı kimi daxil edilməmişdir.
Qaraciyər transplantasiyası aparılıb hepatektomiya daxil etməyən tədqiqatlar, ablasiya müalicələri, cərrahi olmayan qaraciyər çatışmazlığı araşdırmaları, icmallar, redaksiya məqalələri, kifayət qədər məlumat verməyən konfrans tezisləri, hadisə təqdimatları və 50-dən az xəstəsi olan tədqiqatlar xaric edilmişdir.
Başlıq/xülasə və tam mətn skrininqi iki müstəqil tədqiqatçı tərəfindən aparılmış, fikir ayrılıqları razılaşma və ya üçüncü qiymətləndirici vasitəsilə həll edilmişdir. Tədqiqat seçimi üçün qiymətləndiricilərarası Cohen kappa dəyəri 0,89 kimi bildirilmişdir.
PRISMA üzrə tədqiqat seçimi
| Mərhələ | Say |
|---|---|
| PubMed qeydləri | 156 |
| Embase qeydləri | 134 |
| Web of Science qeydləri | 98 |
| Cochrane Library qeydləri | 42 |
| Dörd verilənlər bazasından cəmi | 430 |
| Əl ilə axtarış və konfranslardan əlavə qeydlər | 12 |
| Çıxarılan təkrar qeydlər | 144 |
| Başlıq/xülasə skrininqinə qalan unikal qeydlər | 298 |
| Başlıq/xülasə mərhələsində xaric edilənlər | 241 |
| Tam mətni qiymətləndirilənlər | 57 |
| Tam mətndə xaric edilənlər | 45 |
| Yekun sistematik icmala daxil edilənlər | 12 |
Tam mətndə xaric edilən 45 tədqiqatın 18-də ML/AI modelinin olmaması, 9-da PHLF-nin əsas nəticə olmaması, 8-nin icmal və ya redaksiya məqaləsi olması, 5-in təkrarlanan xəstə kohortlarından istifadə etməsi və 5-də kifayət qədər məlumatın olmaması xaricetmə səbəbləri kimi bildirilmişdir.
Məlumatların çıxarılması və keyfiyyətin qiymətləndirilməsi
CHARMS əsaslı standartlaşdırılmış məlumat çıxarma forması əvvəlcə üç təsadüfi tədqiqatda sınaqdan keçirilmiş, sonra iki qiymətləndirici daxil edilən bütün tədqiqatlardan məlumatları müstəqil şəkildə çıxarmış və çarpaz yoxlamışdır. Tədqiqat dizaynı, xəstə xüsusiyyətləri, istifadə olunan alqoritm, proqnozlaşdırıcılar, çatışmayan məlumatlara yanaşma, performans metrikaları, kalibrasiya, qərar əyrisi analizi, doğrulama tipi və ənənəvi şkalalarla müqayisə kimi dəyişənlər hədəflənmişdir.
Risk of bias qiymətləndirilməsi PROBAST ilə iştirakçılar, proqnozlaşdırıcılar, nəticə və analiz olmaqla dörd sahədə planlaşdırılmışdır. Hər sahə aşağı, yüksək və ya qeyri-müəyyən risk kimi qiymətləndirilmiş; hər hansı sahə yüksək risk daşıyırsa ümumi riskin yüksək qəbul edilməsi nəzərdə tutulmuşdur.
Mənbədaxili mühüm məhdudiyyət: Yekun nəticələr bölməsindəki Cədvəl 3, əvvəlki PROBAST matrisində bəzi mənbə sətirlərinin doğrulanmamış və ya yanlış təsnif edilmiş olması səbəbindən həmin matrisi saxlamadığını açıq şəkildə bildirir. Buna görə yekun PDF tərəfindən dəstəklənməyən tədqiqata xas PROBAST balları Verianla tərəfindən yenidən yaradılmamışdır.
Niyə meta-analiz aparılmadı?
Tədqiqatlar alqoritmlər, proqnozlaşdırıcılar, PHLF tərifləri və doğrulama strategiyaları baxımından nəzərəçarpacaq dərəcədə heterogen olduğundan rəsmi kəmiyyət meta-analizi əvəzinə narrativ sintez seçilmişdir. Bu qərar müxtəlif PHLF ağırlıqlarının və fərqli doğrulama strukturlarının vahid ortaq performans rəqəminə çevrilməsinin yanıltıcı ola biləcəyi deməkdir.
Daxil edilən tədqiqatların ümumi quruluşu
12 tədqiqat ümumilikdə 6913 xəstəni əhatə edir. Ayrı-ayrı tədqiqatların ölçüləri 101 ilə 2074 arasında, median nümunə ölçüsü 363,5-dir. Doqquz tədqiqat Çin mənşəlidir; bir tədqiqat Yaponiyadandır və iki tədqiqat çoxmillətli və ya Çin xaricində xarici doğrulama daxil edən struktura malikdir. Yeddi tədqiqat tək mərkəzli, beş tədqiqat çoxmərkəzlidir. Tang və həmkarlarının tədqiqatı bu məlumat dəstində açıq şəkildə prospektiv doğrulama kohortu istifadə edən yeganə tədqiqatdır.
| Tədqiqat | İl | Ölkə/kontekst | N | Mərkəz quruluşu |
|---|---|---|---|---|
| Mai və b. | 2020 | Çin | 353 | Tək mərkəz |
| Zhu WS və b. | 2020 | Çin | 101 | Tək mərkəz |
| Wang J və b. | 2022 | Çin | 875 | 8 mərkəz |
| Xu və b. | 2023 | Çin | 265 | Tək mərkəz |
| Li və b. | 2023 | Çin | 276 | Tək mərkəz |
| Tashiro və b. | 2024 | Yaponiya | 334 | Tək mərkəz |
| Jin və b. | 2024 | Çin | 226 | Tək mərkəz |
| Famularo və b. | 2025 | İtaliya/Avropa | 500 | 13 mərkəz |
| Tang və b. | 2025 | Çin | 374 | Tək mərkəz + prospektiv doğrulama |
| Yuan və b. | 2025 | Çin | 464 | Tək mərkəz |
| Wang K və b. | 2025 | Çin + MIMIC | 2074 | Çoxmərkəz + xarici kohort |
| Shen və b. | 2025 | Çin | 1071 | 3 mərkəz |
Hansı modellər ən yüksək ayırdetmə gücünü göstərdi?
| Tədqiqat | Model | Bildirilən AUC | Doğrulama quruluşu |
|---|---|---|---|
| Mai | ANN | 0,880 hazırlama; 0,876 doğrulama | Ayrılmış doğrulama nümunəsi |
| Zhu | Radiomik əsaslı model | 0,894 | Daxili doğrulama |
| Wang J | LightGBM | 0,944 təlim; 0,870 doğrulama; 0,822 test | Çoxlu kohort bölgüsü |
| Xu | CNN / dərin öyrənmə | 0,7927 | 5 qat çarpaz doğrulama |
| Li | Kombinə radiomik model | 0,84 təlim; 0,82 test | Ayrılmış test nümunəsi |
| Tashiro | XGBoost | 0,863 | Təlim/test bölgüsü |
| Jin | ANN | 0,766 preoperativ; 0,851 postoperativ; 0,720/0,731 zaman üzrə | 5 qat CV + zaman üzrə doğrulama |
| Famularo | Averaging ensemble | 0,901 test | Təlim/test bölgüsü |
| Tang | XGBoost | 0,983 təlim; 0,981 doğrulama; 0,942 prospektiv | Daxili + prospektiv doğrulama |
| Yuan | LightGBM | 0,927 təlim; 0,703 test; 0,808 doğrulama | Təlim/test/doğrulama |
| Wang K | Zaman ardıcıllı dərin öyrənmə | 0,952 daxili; 0,884 xarici Çin; 0,654 MIMIC | Xarici + Qərb xarici kohortu |
| Shen | PILOT, fazaya xas arxitektura | 0,754–0,904 təlim; 0,740–0,895 doğrulama | İki xarici kohort |
Mənbədəki Şəkil 2 hər tədqiqat üçün təlimdən kənarda bildirilən ən yaxşı AUC-ni yanaşı göstərir. Qrafikdə Tang 2025 təxminən 0,981 ilə ən yuxarıda; Famularo 2025 0,901, Shen 2025 0,895, Zhu 2020 0,894 və Wang K 2025 0,884 ilə onu izləyir. Lakin bu sıralama modellərin eyni şərtlərdə müqayisə edildiyi anlamına gəlmir.
Xarici Doğrulama PHLF Modellərində Niyə Kritikdir?
Xarici doğrulama modelin hazırlandığı xəstə qrupundan müstəqil xəstəxana, zaman dövrü və ya coğrafiyada oxşar performansı qoruyub-qorumadığını sınaqdan keçirir; PHLF ədəbiyyatında Wang K modelinin AUC-sinin daxili qiymətləndirmədəki 0,952-dən MIMIC-IV kohortunda 0,654-ə düşməsi paylanma sürüşməsinin klinik ümumiləşdirilə bilməni ciddi şəkildə dəyişdirə biləcəyini göstərir.
İcmalda ümumiləşdirilə bilmə baxımından ən mənalı göstəricilər random olmayan doğrulama strukturlarından gəlmişdir. Jin və həmkarları zaman üzrə doğrulamada 0,720 və 0,731 AUC; Tang və həmkarları prospektiv doğrulamada 0,942 AUC; Wang K və həmkarları Çin xarici kohortunda 0,884 və MIMIC-IV-də 0,654 AUC; Shen və həmkarları iki xarici kohortda 0,740–0,895 aralığında AUC bildirmişdir.
Bu nümunələr model hazırlama məlumatına çox bənzər daxili test dəstində güclü performans əldə etməyin klinik daşına bilmə ilə eyni olmadığını göstərir.
Coğrafi cəmləşmə niyə məhdudiyyət yaradır?
12 tədqiqatın doqquzu Çindəndir, biri Yaponiyadandır. Mənbə bu ədəbiyyatın böyük ölçüdə Şərqi Asiya, hepatosellülyar karsinoma və bəzi kohortlarda HBV ilə əlaqəli qaraciyər xəstəliyi ağırlıqlı olduğunu vurğulayır. Bunun əksinə, Qərb xəstə populyasiyalarında yağlı qaraciyər xəstəliyi, alkoqolla əlaqəli qaraciyər xəstəliyi və kolorektal qaraciyər metastazları kimi fərqli hal paylanmaları ola bilər.
Buna görə modelin bir ölkədə və ya xəstəxana sistemində güclü nəticə verməsi başqa tətbiq coğrafiyasında eyni kalibrasiyanı və ayırdetmə gücünü qoruyacağı anlamına gəlmir. Hədəf tətbiq coğrafiyasında xarici doğrulama, lazım olduqda yenidən kalibrasiya və hal qarışığı fərqlərinin açıq şəkildə hesabatlandırılması tələb olunur.
Hansı proqnozlaşdırıcı qruplar təkrar-təkrar görünür?
| Proqnozlaşdırıcı sahəsi | İcmalda görülən nümunələr | Elmi rolu |
|---|---|---|
| Qaraciyər ehtiyatı / laboratoriya | Bilirubin, albumin, INR/protrombin vaxtı | Qaraciyərin sintez və xaricetmə qabiliyyəti ilə bağlı əsas klinik siqnal |
| Hematoloji/portal göstəricilər | Trombosit sayı | Portal hipertenziya və qaraciyər xəstəliyi kontekstində risk məlumatına töhfə |
| Funksional testlər | ICG-R15 | Qaraciyərin funksional ehtiyatını qiymətləndirən məlumat |
| Rezeksiya/volumetriya | FLR, rezeksiyanın həcmi, rezidual həcm | Əməliyyatdan sonra qalacaq funksional toxumanı və cərrahi yükü təmsil etmə |
| Görüntüləmə | CT/MRI radiomik xüsusiyyətləri | Parenxim heterogenliyini kəmiyyət görüntü xüsusiyyətləri ilə təmsil etmə |
| Dinamik perioperativ məlumat | Zamanla dəyişən laboratoriya və perioperativ ölçmələr | Tək ölçmə əvəzinə xəstənin dəyişən fizioloji gedişini modelləşdirmə |
İcmalın tədqiqatlararası şərhinə görə statik preoperativ qaraciyər ehtiyatı dəyişənlərindən istifadə edən modellər daxili məlumatlarda təxminən 0,81–0,88 AUC səviyyələrinə çata bilmişdir. Görüntüləmə radiomikasının əlavə edilməsi bəzi orijinal tədqiqatlarda yalnız klinik və ya yalnız radiomik alt modellərlə müqayisədə yaxşılaşma təmin etmişdir. Dinamik perioperativ modellər isə güclü ayırdetmə qabiliyyəti göstərə bilmiş, lakin xarici ümumiləşdirilə bilmə baxımından daha aydın problemlərlə qarşılaşmışdır.
İzaholunma necə nəzərə alınıb?
Tədqiqatlarda izaholunma üçün SHAP analizləri, nomoqramlar, feature-importance göstəriciləri, risk qrupları və veb əsaslı alətlər istifadə edilmişdir. Xüsusilə yüksək riskli klinik qərarlarda modelin yalnız ehtimal verməsi deyil, hansı dəyişənlərin proqnoza töhfə verdiyinin izlənə bilməsi klinik qəbul baxımından əhəmiyyət daşıyır.
ML modelləri ənənəvi şkalalardan daha yaxşıdırmı?
Daxil edilən tədqiqatlarda eyni kohort üzərində aparılan müqayisələrin istiqaməti ümumiyyətlə ML əsaslı modellərin xeyrinədir. Mai-nin ANN modeli, Zhu-nun radiomik modeli, Wang J-nin LightGBM modeli, Tashiro-nun XGBoost modeli, Jin-in ANN modeli və Tang-ın XGBoost modeli kimi nümunələr ənənəvi şkalalar və ya daha sadə klinik modellərlə müqayisədə daha yüksək ayırdetmə performansı bildirmişdir.
Lakin sistematik icmalda bütün modellərin və Child–Pugh, MELD, ALBI, FIB-4 və ya APRI-nin eyni xəstə qeydləri üzərində yenidən öyrədilib sınaqdan keçirildiyi birləşdirilmiş benchmark aparılmamışdır. Xəstə səviyyəsində harmonizasiya edilmiş xam məlumat mövcud olmadığından belə analiz mümkün olmamışdır. Buna görə nəticə ortaq prospektiv təcrübə ilə sübut edilmiş universal üstünlük deyil; orijinal tədqiqatların öz kohortlarında bildirdiyi nəticələrin ardıcıl istiqamətidir.
Ədəbiyyatdakı əsas boşluqlar
Nəticə tərifinin heterogenliyi: Tədqiqatlar “severe PHLF”, “clinically significant PHLF”, ümumi PHLF və “postoperative liver failure” kimi fərqli son nöqtələrdən istifadə etmişdir. Müxtəlif ağırlıqdakı hadisələri proqnozlaşdıran modellərin AUC dəyərlərinin yanaşı qoyulması klinik müqayisəni çətinləşdirir.
Natamam performans hesabatı: AUC tez-tez hesabatlandığı halda həssaslıq, spesifiklik, PPV, NPV, kalibrasiya meyli/kəsişməsi, qərar əyrisi analizi və confusion matrix məlumatları ardıcıl şəkildə verilməmişdir.
Məhdud xarici doğrulama: İcmalın qiymətləndirməsinə görə yalnız dörd tədqiqat zaman üzrə, prospektiv və ya xarici doğrulama strukturuna malikdir. Qərb məlumat dəstinə açıq daşınma sınağı xüsusilə məhduddur.
Hesablama xərcinin hesabatlandırılmaması: Daxil edilən tədqiqatlar təlim müddəti, inference gecikməsi, yaddaş istifadəsi və CPU/GPU tələbləri kimi texniki tətbiq xərclərini sistematik şəkildə hesabatlandırmamışdır. Bu çatışmazlıq xüsusilə xəstəxana infrastrukturlarında real vaxt istifadəsinin qiymətləndirilməsini çətinləşdirir.
Proqnozlaşdırıcı sahə ablasiyası: Laboratoriya, koaqulyasiya, volumetriya, radiomika və zaman dəyişən qruplarını eyni model çərçivəsində növbə ilə çıxarıb yenidən öyrədən tam ortaq ablasiya mövcud deyil.
Paylanma sürüşməsi təhlükəsizliyi: Aşağı etibarlı halları avtomatik qərar əvəzinə klinisistə yönəldən selective prediction və ya cost-aware deferral kimi təhlükəsizlik mexanizmləri daxil edilən tədqiqatlarda rəsmi şəkildə tətbiq edilməmişdir.
Gələcək tədqiqatlar üçün tövsiyələr
İcmal müəllifləri gələcəkdə birincili nəticə tərifi kimi mümkün qədər standartlaşdırılmış, klinik baxımdan mənalı ISGLS grade B/C PHLF istifadəsini; AUC ilə yanaşı həssaslıq, spesifiklik, PPV, NPV, kalibrasiya və qərar əyrisi analizinin hesabatlandırılmasını; çoxmərkəzli və coğrafi baxımdan müxtəlif xarici doğrulamaların artırılmasını tövsiyə edirlər.
Bundan əlavə, laboratoriya əsaslı qaraciyər ehtiyat göstəricilərini görüntüləmə və qısamüddətli perioperativ zaman məlumatları ilə birləşdirən multimodal modellər araşdırılmağa dəyər hesab olunur. Bununla belə, daha mürəkkəb modelin həqiqətən klinik fayda verib-vermədiyini qiymətləndirmək üçün güclü və daha ucuz baza modelləri ilə birbaşa müqayisə aparılmalıdır.
Son mərhələdə ehtiyac yalnız daha yüksək AUC deyil. Prospektiv qərar-təsir tədqiqatları proqnozlaşdırma sisteminin cərrahi strategiyanı, FLR artırma müdaxilələrini, postoperativ monitorinq intensivliyini və ya xilasetmə müalicələrini həqiqətən dəyişdirib-dəyişdirmədiyini və xəstələr üçün klinik fayda yaradıb-yaratmadığını göstərməlidir.
Tədqiqatın dəstəklədiyi nəticələr
Mövcud ədəbiyyat ML əsaslı modellərin PHLF riskinin ayırd edilməsində ümidverici performans göstərə bildiyini dəstəkləyir. Gradient boosting, ANN/dərin öyrənmə, radiomika və zaman ardıcıllı modellərin hamısında klinik baxımdan mənalı ayırdetmə gücü bildirilmişdir. Qaraciyər ehtiyat göstəriciləri, görüntüləmə və perioperativ məlumatlar birlikdə istifadə edildikdə güclü modellərin qurula bildiyinə dair ardıcıl göstəricilər vardır.
İcmal həmçinin doğrulama dizaynının model uğuru qədər vacib olduğunu dəstəkləyir. Xüsusilə zaman üzrə, prospektiv və müstəqil xarici doğrulamalar modelin real ümumiləşdirilə bilməsi haqqında təsadüfi daxili test bölgülərindən daha güclü sübut verir.
Tədqiqatın dəstəkləmədiyi nəticələr
İcmal müəyyən bir ML arxitekturasının PHLF üçün universal olaraq ən yaxşı model olduğunu göstərmir. 0,981 kimi yüksək AUC dəyərləri bütün xəstəxana, ölkə və xəstə qruplarına köçürülə biləcək zəmanətli performans dəyərləri deyil.
Tədqiqat ML əsaslı PHLF proqnoz alətlərinin rutin klinik istifadəsinin xəstə ölümünü və ya fəsad nisbətini azaltdığını sübut edən qərar-təsir təcrübəsi deyil. Daxil edilən modellərin əksəriyyəti retrospektiv məlumatlara əsaslanır və bir çox modelin müstəqil xarici doğrulaması yoxdur.
Maşın öyrənməsinin klinisistin qərarını avtomatik dəyişdirməli və ya əməliyyat qərarını təkbaşına verməli olduğu nəticəsi də bu sistematik icmaldan çıxarıla bilməz. Mənbənin gələcək perspektivi daha şəffaf, xaricdə doğrulanmış, kalibrasiya edilmiş və klinik qərar faydası göstərilmiş sistemlərə ehtiyac olduğunu vurğulayır.
Mənbə və Metod Qeydi
Orijinal tədqiqat: Machine Learning Models for Predicting Post-Hepatectomy Liver Failure: A Systematic Review
Müəlliflər: Calin Muntean; Vasile Gaborean; Razvan Constantin Vonica; Sebastian Aurelian Stefaniga; Alaviana Monique Faur; Catalin Vladut Ionut Feier.
Məsul müəlliflər: Vasile Gaborean və Razvan Constantin Vonica.
Qurumlar: “Victor Babeş” University of Medicine and Pharmacy Timişoara nəzdində Medical Informatics and Biostatistics, Thoracic Surgery Research Center, Surgical Semiology, Doctoral Studies və Abdominal Surgery and Phlebology Research Center bölmələri; “Lucian Blaga” University of Sibiu, Preclinical Department/Physiology; West University of Timişoara, Department of Computer Science; “Pius Brinzeu” Clinical Emergency Hospital, First Surgery Clinic.
Jurnal: AI.
Nəşriyyat: MDPI.
Mənbə növü: Sistematik icmal.
Nəşr məlumatı: AI 2026, 7(5), 166.
DOI: 10.3390/ai7050166
Təqdimetmə: 27 Mart 2026.
Reviziya: 25 Aprel 2026.
Qəbul: 5 May 2026.
Nəşr: 9 May 2026.
Rəsmi nəşr ünvanı: https://www.mdpi.com/2673-2688/7/5/166
Lisenziya: Açıq giriş, Creative Commons Attribution (CC BY).
Sistematik icmal çərçivəsi: PRISMA 2020, Cochrane Handbook tövsiyələri, CHARMS və PROBAST istifadə edilmişdir.
Qeydiyyat qeydi: Məqalənin xülasə və metod bölməsi protokolun PROSPERO-da qeydiyyatdan keçirildiyini bildirir. Eyni metod bölməsində Open Science Framework qeydiyyatı kimi DOI 10.17605/OSF.IO/67CQ3 də verilir. PDF daxilində ayrıca PROSPERO CRD qeydiyyat nömrəsi görünmədiyindən bu iki ifadə birləşdirilməmiş və ya təxmin edilməmişdir.
Maliyyələşdirmə: Məqalənin article processing charge ödənişinin Victor Babeş University of Medicine and Pharmacy Timişoara tərəfindən qarşılandığı bildirilmişdir.
İnstitusional etik komitə: Tətbiq edilmir.
Məlumatlandırılmış razılıq: Tətbiq edilmir.
Məlumatların əlçatanlığı: Müəlliflər bu sistematik icmal üçün yeni məlumat yaradılmadığını və ya analiz edilmədiyini bildirirlər.
Maraqlar toqquşması: Müəlliflər maraqlar toqquşmasının olmadığını bəyan etmişlər.
AI istifadəsi bəyanatı: Müəlliflər ChatGPT v4.0-dan yalnız məqalənin dilini və oxunaqlığını yaxşılaşdırmaq məqsədilə istifadə etdiklərini; elmi məzmunun, şərhlərin və nəticələrin müəlliflərə aid olduğunu bildirmişlər.
Müəllif töhfələri: Konseptuallaşdırma Calin Muntean, Vasile Gaborean və Razvan Constantin Vonica; metodologiya Calin Muntean, Sebastian Aurelian Stefaniga və Razvan Constantin Vonica; proqram təminatı Sebastian Aurelian Stefaniga; doğrulama Calin Muntean, Vasile Gaborean və Razvan Constantin Vonica; formal analiz Calin Muntean və Sebastian Aurelian Stefaniga; araşdırma Calin Muntean və Alaviana Monique Faur; məlumatların kurasiyası Calin Muntean və Alaviana Monique Faur tərəfindən aparılmışdır. İlk layihə Calin Muntean tərəfindən hazırlanmış; nəzərdən keçirmə və redaktəyə Vasile Gaborean, Razvan Constantin Vonica, Sebastian Aurelian Stefaniga və Catalin Vladut Ionut Feier töhfə vermişdir.
Əsas metodoloji məhdudiyyətlər: Daxil edilən tədqiqatların əksəriyyətinin retrospektiv və tək mərkəzli olması; PHLF son nöqtəsinin heterogen müəyyənləşdirilməsi; məlumatların coğrafi baxımdan Şərqi Asiya ağırlıqlı olması; kalibrasiya, həssaslıq və spesifikliyin qeyri-ardıcıl hesabatlandırılması; xarici doğrulamanın çatışmaması; müxtəlif model ailələrinin birbaşa müqayisə oluna bilməməsi və hesablama xərclərinin kifayət qədər hesabatlandırılmaması.
Verianla metod qeydi: Bu mətn mənbə məqalənin sətirbəsətir tərcüməsi deyil. Mənbədəki klinik problem, sistematik icmal metodu, xəstə və tədqiqat sayları, model performansları, doğrulama strategiyaları, proqnozlaşdırıcı sahələri, şəkillərin elmi mesajı, müzakirə və məhdudiyyətlər qorunaraq müstəqil tədris strukturu qurulmuşdur. Mənbədə olmayan klinik nəticə, performans metrikası və ya model uğuru əlavə edilməmişdir.
Tibbi şərh sərhədi: Buradakı model performansları klinik qərar dəstəyi tədqiqatlarına aiddir. Təkbaşına hər hansı xəstənin əməliyyata uyğunluğunu, PHLF riskini və ya müalicə planını müəyyən etmək üçün istifadə edilə bilməz; klinik qərarlar xəstəyə xas qiymətləndirmə və doğrulanmış yerli protokollar tələb edir.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib