

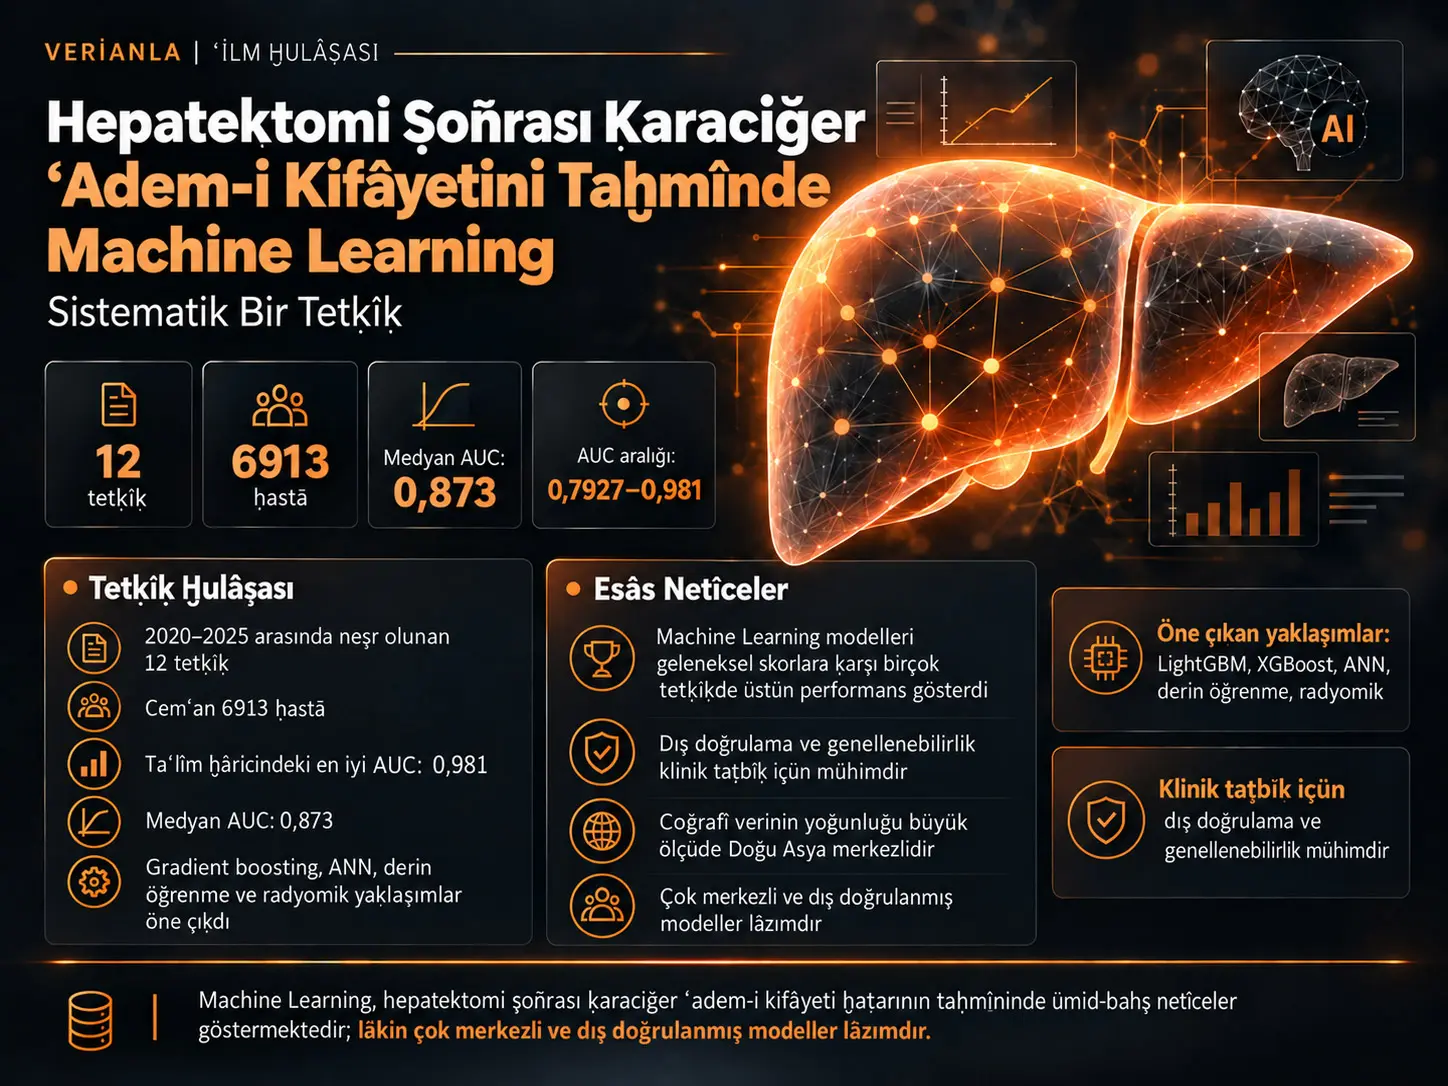
Hepatektomi ṣoñrası ḳaraciğer ʿadem-i kifâyeti (Post-Hepatectomy Liver Failure, PHLF), ḳaraciğer rezeksiyonundan ṣoñra ḳaraciğerin terkîb, iḫrâc ve detoksifikasyon vaẓîfelerini kifâyet derecesinde idâme ettirememesiyle mümeyyiz ciddî bir baʿde'l-ʿamel komplikasyondur. İşbu sistematik tetḳîḳ, PHLF risḳini taḫmîn içün geliştirilmiş machine learning modellerinin tefrîḳ kudretini, istiʿmâl olunan predictorları, validation usûllerini, usûlî keyfiyyetini ve klinik tatbîḳ ḳâbiliyyetini teḳyîm eder. Nihâʾî tetḳîḳ 2020–2025 arasında neşrolunan 12 çalışmayı ve cemʿan 6913 hastayı iḥtivâ eder. Taʿlîm maʿlûmâtı ḫâricinde bildirilen en iyi AUC ḳıymetleri 0,7927 ile 0,981 arasında teġayyür etmiş, medyan AUC 0,873 olmuştur. Bununla berâber çalışmaların ekserîsinin retrospektif olması, PHLF taʿrîflerinin yeknesaḳ olmaması ve ḫâricî validationın maḥdûd ḳalması sebebiyle bu performans ḳıymetleri doğrudan rutin klinik istiʿmâle âmâde sistemler diye tefsîr olunmamalıdır.
Tetḳîḳde gradient boosting ailesi, ḫuṣûṣıyla LightGBM ve XGBoost, sıḳ görülen yüksek performanslı usûller arasındadır. Sunʿî sinir şebekeleri, deep learning, bilgisayarlı tomografi yâḫud manyetik rezonans ṣûretlerinden radiomics ḫuṣûṣiyyetlerini istiḫrâc eden modeller ve ensemble sistemleri dahi maʿnâlı tefrîḳ performansı göstermiştir. En ziyâde istiʿmâl olunan maʿlûmât saḥaları bilirubin ve sâʾir ḳaraciğer rezervi göstergeleri, koagülasyon parametreleri, trombosit ʿadedi, bâḳî ḳaraciğer ḥacmi yâḫud rezeksiyon şümûlü, görüntülemeye müstenid radiomics ḫuṣûṣiyyetleri ve perioperatif zamânî maʿlûmât olmuştur.
Çalışmanın en ḳavî mesajlarından biri, yalnız yüksek AUC ḳıymetine teveccüh etmemektir. Dâḫilî validationda ḳavî görünen bir model, başḳa bir coġrâfyaya yâḫud hasta tevzîʿine naḳlolunduğunda performans ḳaybedebilir. Meselâ Wang K ve refîḳlerinin zamânî deep learning modelinde AUC dâḫilî teḳyîmde 0,952, Çin ḫâricî validationında 0,884 iken Ġarbî MIMIC-IV kohortunda 0,654'e düşmüştür. Bu misâl, klinik AI modellerinde ḫâricî validation ve distribution shift mesʾelelerinin niçün esâs emniyyet mevżûʿlarından olduğunu gösterir.
Tetḳîḳin ʿumûmî teḳyîmi, machine learningin anʿanevî Child–Pugh, MELD, ALBI, FIB-4 ve APRI misillü risk vâsıṭalarının ötesinde müteʿaddid klinik müteġayyirleri bir arada teḳyîm edebilme istiʿdâdına mâlik olduğu merkezindedir. Lâkin mevcut çalışmalar aynı hasta maʿlûmâtı ve aynı netîce taʿrîfi üzerinde teşekkül etmiş tek bir müşterek muḳâyese değildir. Binâʾenaleyh literatürde müşâhede olunan tefevvuḳ meyli, “machine learning her hastada ve her merkezde anʿanevî skorlardan ḳaṭʿiyyen daha iyidir” sûretinde taʿmîm olunamaz.
Hepatektomi Ṣoñrası Ḳaraciğer ʿAdem-i Kifâyeti (PHLF) Nedir?
PHLF, ḳaraciğer nesci cerrâḥî sûretle çıkarıldıḳdan ṣoñra bâḳî ḳaraciğerin organizmanın metabolik iḥtiyâcâtını ḳarşılayacak terkîb, iḫrâc ve detoksifikasyon ḳudretini idâme ettirememesi ḥâlidir; tetḳîḳde istiʿmâl olunan ISGLS çerçevesi bunu baʿde'l-ʿamel beşinci gün yâḫud daha ṣoñrasında mütezâyid INR ile berâber hiperbilirubinemi üzerinden taʿrîf eder.
Ḳaraciğer rezeksiyonu; hepatoselüler karsinom, intrahepatik kolanjiyokarsinom ve kolorektal kanserin ḳaraciğer metastazları dâḫil muḫtelif benign ve malign hastalıḳlarda esâs cerrâḥî tedâvîlerden biridir. Cerrâḥî tekniḳ, anestezi ve perioperatif baḳımda teraḳḳî ḥâṣıl olmuş ise de PHLF ḳaraciğer cerrâḥîsinin en ciddî komplikasyonlarından biri olmaḳda devâm eder.
Menbaʿ, bildirilen PHLF insidansının hasta popülasyonu, rezeksiyon miḳdârı ve taḥtında bulunan ḳaraciğer hastalığına tâbiʿen %1,2 ile %32 arasında teġayyür edebildiğini beyân eder. PHLF risḳi yalnız çıkarılan ḳaraciğer miḳdârına merbûṭ değildir. İstiḳbâlde bâḳî ḳalacak ḳaraciğer nesci miḳdârı ve fonksiyonel keyfiyyeti, ḳaraciğerin rejenerasyon ḳudreti, mevcut fibrozis yâḫud siroz, steatoz, portal hipertansiyon, sarkopeni ve ʿameliyyâta müteʿallik stres ʿâmilleri müştereken rol oynayabilir.
İstiḳbâlde bâḳî ḳalacak ḳaraciğer niçün mühimdir?
Future Liver Remnant (FLR), rezeksiyondan ṣoñra hastada bâḳî ḳalacak fonksiyonel ḳaraciğer nescini ifâde eder. Menbaʿın literatür ḫulâṣasında bilgisayarlı tomografiye müstenid volumetrik teḳyîm içün normal ḳaraciğerde en az taḳrîben %20 ve fonksiyon cihetinden muḫtel ḳaraciğerde taḳrîben %40 FLR eşikleri naḳlolunur. Bununla berâber yalnız ḥacim ölçüsü, bâḳî nescin ḥaḳîḳî fonksiyon ḳudretini tamâmıyla göstermez.
Bu sebeble indosiyanin yeşili temizlenme testi (ICG), hepatobiliyer sintigrafi ve gadoxetic acid ile taḳviye edilmiş manyetik rezonans görüntüleme misillü fonksiyonel usûller geliştirilmiştir. Bu testlerin her birinin istiʿmâl ḳâbiliyyeti, standardizasyon yâḫud popülasyonlar arası performans cihetlerinden maḥdûdiyyetleri vardır.
Anʿanevî risk skorları niçün kifâyetsiz ḳalabilir?
Child–Pugh tasnîfi, MELD skoru ve Albumin–Bilirubin (ALBI) derecesi ḳaraciğer fonksiyonunu muḫtelif müteġayyirlerden teḳyîm eder; lâkin PHLF, laboratuvar ḳıymetleri, bâḳî ḳaraciğer ḥacmi, hastanın mevcut ḳaraciğer hastalığı, ʿameliyyâtın şümûlü ve perioperatif teġayyürât misillü müteʿaddid ʿâmilin müştereken teʾsîr ettiği bir netîcedir. Menbaʿ bu sebeble klasik skorların tek başına bütün risk bünyesini iḥâṭada maḥdûd ḳalabileceğini teʾkîd eder.
Tetḳîḳde atıf olunan evvelki bir sistematik review ve meta-analysisde ALBI'nin PHLF taḫmîni içün birleşik AUC ḳıymetinin taḳrîben 0,67 olduğu beyân olunur. Bu bulgu, daha mürekkeb ve çoḳ müteġayyirli modellerin tetḳîḳ edilmesinin esbâbından biridir.
PHLF Taḫmîninde Machine Learning Niçün İstiʿmâl Olunuyor?
Machine learning, laboratuvar maʿlûmâtı, görüntüleme ḫuṣûṣiyyetleri, cerrâḥî müteġayyirler ve zamân içinde teġayyür eden perioperatif ölçüler arasındaki ġayr-ı ḫaṭṭî ve çoḳ müteġayyirli münâsebetleri aynı model dâḫilinde teḳyîm edebildiği içün PHLF misillü mürekkeb bir klinik riskin şahsa maḫṣûṣ taḫmîninde tetḳîḳ olunmaḳdadır.
Tetḳîḳ olunan literatürde istiʿmâl edilen usûller tek bir algoritmadan ʿibâret değildir. Sunʿî sinir şebekeleri (Artificial Neural Networks, ANN), LightGBM, XGBoost, konvolüsyonel sinir şebekeleri (CNN), zamânî deep learning modelleri, radiomics usûlleri ve ensemble sistemleri mevcûddur.
Bu modellerin maḳṣadı klasik hepatoloji maʿrifetini ortadan ḳaldırmaḳ değildir. Tetḳîḳde yüksek performanslı modellerde bilirubin, albumin, INR yâḫud protrombin zamânı, trombosit ʿadedi, ICG-R15, bâḳî ḳaraciğer miḳdârı ve rezeksiyon şümûlü gibi zâten klinik cihetten maʿnâlı müteġayyirlerin mükerreren zuhûr etmesi, machine learningin ekser ḥâllerde mevcut fizyopatolojik maʿrifeti muḫtelif müteġayyirlere müşterek ağırlık vererek tevsiʿ ettiğini gösterir.
Radiomics maʿlûmâtı ne ilâve ediyor?
Radiomics, CT yâḫud MRI misillü tıbbî görüntülerden çıplaḳ gözle doğrudan ölçülmesi müşkil olan müteʿaddid kemmî görüntü ḫuṣûṣiyyetlerinin istiḫrâcı usûlüdür. Tetḳîḳde Zhu, Li ve Famularo çalışmalarında radiomics maʿlûmâtının klinik yâḫud laboratuvar müteġayyirleriyle berâber istiʿmâl edildiği modeller vardır.
Tetḳîḳdeki çalışmalar arası örüntü, görüntüleme maʿlûmâtının bazı modellerde yalnız klinik maʿlûmâta yâḫud yalnız radiomics maʿlûmâtına nisbetle zâʾid maʿlûmât teʾmîn edebileceğine işâret eder. Lâkin bu netîce, tek bir müşterek data setinde icrâ edilmiş kontrollü predictor-ablation tecrübesi değildir. Müʾellifler dahi predictor guruplarının ehemmiyyet sırasını ḳaṭʿî sûretle taʿyîn edebilecek müşterek bir leave-one-domain-out taḥlîlin mevcut olmadığını ṣarâḥaten beyân ederler.
Perioperatif dinamik maʿlûmât ne demektir?
Sâbit bir preoperatif ölçü hastanın yalnız bir ândaki ḥâlini temsîl eder. Perioperatif dinamik maʿlûmât ise ʿameliyyâtdan evvel, ʿameliyyât esnâsında ve erken baʿde'l-ʿamel devrede zamânla teġayyür eden laboratuvar yâḫud klinik ölçülerin teşkîl ettiği seyri istiʿmâl eder. Jin, Wang K ve Shen çalışmalarında bu nevʿ zamânî yâḫud safḥaya maḫṣûṣ data bünyeleri mühim bir cüzʾ olmuştur.
Bu modeller yüksek tefrîḳ ḳudreti gösterebilirse de daha ziyâde data ve daha mürekkeb altyapı isteyebilir. Üstelik Wang K çalışmasındaki MIMIC-IV ḫâricî validation düşüşü, daha zengin data istiʿmâlinin muḫtelif hastaneler yâḫud coġrâfyalarda aynı performansı otomatik sûretle żamân etmediğini gösterir.
AUC Ḳıymeti Bu Sistematik Tetḳîḳde Neyi Gösteriyor?
AUC, modelin PHLF gelişen ve gelişmeyen hastaları birbirinden tefrîḳ ḳudretini icmâl eden bir ölçüdür; işbu sistematik tetḳîḳde modeller arası esâs performans muḳâyaselerinden biri olarak istiʿmâl edilmiştir, lâkin AUC tek başına kalibrasyonu, klinik ḳarar menfaʿatini yâḫud başḳa bir hastanedeki ḥaḳîḳî performansı göstermez.
Tetḳîḳde bildirilen en iyi taʿlîm-ḫârici AUC ḳıymetleri 0,7927–0,981 arasında teġayyür etmiş ve medyan ḳıymet 0,873 olmuştur. Bununla berâber bu raḳamların cümlesi aynı data setinden, aynı PHLF taʿrîfinden yâḫud aynı validation prosedüründen gelmemektedir. Bazı çalışmalar random train/test taḳsîmini istiʿmâl ederken bazıları 5 katlı cross-validation, zamânî validation, ḫâricî kohort yâḫud prospektif validation istiʿmâl etmiştir.
Binâʾenaleyh 0,95 AUC bildiren bir dâḫilî geliştirme çalışmasını, 0,88 AUC elde etmiş müstaḳil ḫâricî validationlı bir modelden otomatik sûretle “daha iyi” ʿaddetmek usûl cihetinden ṣaḥîḥ değildir. Tetḳîḳin mühim ḫidmetlerinden biri dahi performans raḳamının yanında validation bünyesine naẓar-ı dikkati celb etmesidir.
Kalibrasyon niçün ayrıca mühimdir?
Tefrîḳ ḳudreti, yüksek riskli kimseleri düşük risklilerden tertîb edebilme ḳudretini gösterir. Klinik risk taḫmîninde bundan mâʿadâ modelin verdiği iḥtimâllerin ḥaḳîḳî ḥâdise frekanslarıyla ne derece muvâfıḳ olduğu, yaʿnî kalibrasyon dahi mühimdir. Tetḳîḳ, birçoḳ çalışmada discriminationın kalibrasyondan daha noksansız rapor edildiğini ve bu sebeble klinik muḳâyasenin maḥdûd ḳaldığını beyân eder.
Çalışmanın Usûlü ve Netîceleri
Sistematik tetḳîḳin tertîbi
Tetḳîḳ PRISMA 2020 ḳavâʿidine ve Cochrane Handbook'un teşḫîṣ testlerinin doğruluğuna müteʿallik sistematik review tavṣiyelerine göre tertîb edilmiştir. Suʾâl-i tetḳîḳ ve data istiḫrâcının tanẓîminde CHARMS çerçevesi istiʿmâl olunmuştur. Hedef popülasyon, herhangi bir sebeble hepatik rezeksiyon icrâ olunan bâliġ hastalardır.
İndeks modeller, PHLFyi taḫmîn maḳṣadıyla geliştirilmiş yâḫud validate edilmiş machine learning veya AI algoritmalarıdır. Netîce taʿrîfi içün ISGLS, “50-50” kriterleri, zirve bilirubin ḳıymetinin 7 mg/dL'nin üzerinde olması yâḫud sâʾir validate edilmiş klinik PHLF taʿrîfleri ḳabûl edilmiştir.
Literatür nasıl tarandı?
PubMed/MEDLINE, Embase, Web of Science Core Collection ve Cochrane Library data bâzları bidâyetlerinden 15 Ocak 2026'ya ḳadar taranmıştır. Arama ıṣṭılâḥları üç esâs kümeyi cemʿ etmiştir: machine learning/AI usûlleri, hepatektomi/ḳaraciğer rezeksiyonu siyâḳı ve PHLF/ḳaraciğer ʿadem-i kifâyeti netîceleri.
Elektronik aramaya ilâveten dâḫil olunan çalışmaların ve alâḳalı derlemelerin menbaʿ listeleri el ile taranmış; 2020–2025 devresindeki başlıca hepatobiliyer cerrâḥî ictimâʿlarının ḫulâṣaları gözden geçirilmiş ve neşir yanlılığını azaltmaḳ maḳṣadıyla Google Scholar üzerinden grey literature aranmıştır.
Dâḫil etme ve iḫrâc miʿyârları
Dâḫil olunan çalışmaların 18 yaş yâḫud üzerindeki hepatektomi hastalarında en az bir ML modeli geliştirmesi yâḫud validate etmesi ve AUC, ḥassâsiyyet, ḫuṣûṣiyyet, müsbet taḫmîn ḳıymeti, menfî taḫmîn ḳıymeti yâḫud doğruluḳ misillü en az bir performans ölçüsünü rapor etmesi lâzımdı. Yalnız anʿanevî lojistik regresyon istiʿmâl eden çalışmalar ML çalışması olarak dâḫil edilmemiştir.
Ḳaraciğer transplantasyonu olup hepatektomiyi iḥtivâ etmeyen çalışmalar, ablasyon tedâvîleri, cerrâḥî olmayan ḳaraciğer ʿadem-i kifâyeti tetḳîḳleri, derlemeler, editoryaller, kifâyetli data iḥtivâ etmeyen konferans ḫulâṣaları, vaḳʿa taḳdîmleri ve 50'den az hastası olan çalışmalar iḫrâc edilmiştir.
Başlıḳ/ḫulâṣa ve tam metin taraması iki müstaḳil muḥaḳḳıḳ tarafından icrâ edilmiş, iḫtilâflar ittifâḳ yâḫud üçüncü bir muḳayyim vâsıṭasıyla ḥallolunmuştur. Çalışma intiḫâbı içün muḳayyimler arası Cohen kappa ḳıymeti 0,89 olarak rapor edilmiştir.
PRISMA çalışma intiḫâbı
| Merḥale | ʿAded |
|---|---|
| PubMed ḳayıdları | 156 |
| Embase ḳayıdları | 134 |
| Web of Science ḳayıdları | 98 |
| Cochrane Library ḳayıdları | 42 |
| Dört data bâzından mecmûʿ | 430 |
| El ile tarama ve konferanslardan ilâve ḳayıd | 12 |
| Çıkarılan mükerrer ḳayıdlar | 144 |
| Başlıḳ/ḫulâṣa taramasına bâḳî tekil ḳayıd | 298 |
| Başlıḳ/ḫulâṣa merḥalesinde iḫrâc olunan | 241 |
| Tam metni teḳyîm olunan | 57 |
| Tam metinde iḫrâc olunan | 45 |
| Nihâʾî sistematik tetḳîḳe dâḫil olunan | 12 |
Tam metinde iḫrâc olunan 45 çalışmanın 18'inde ML/AI modeli bulunmaması, 9'unda PHLFnin birincil netîce olmaması, 8'inin derleme yâḫud editoryal olması, 5'inin mükerrer hasta kohortlarını istiʿmâl etmesi ve 5'inde kifâyetli data bulunmaması iḫrâc esbâbı olarak rapor edilmiştir.
Data istiḫrâcı ve keyfiyyet teḳyîmi
CHARMS esaslı standardize data istiḫrâc formu evvelâ üç tesâdüfî çalışmada tecrübe edilmiş, baʿdehu iki muḳayyim bütün dâḫil olunan çalışmalardan datayı müstaḳillen istiḫrâc etmiş ve çapraz murâḳabe etmiştir. Çalışma tertîbi, hasta ḫuṣûṣiyyetleri, istiʿmâl olunan algoritma, predictorlar, nâḳıṣ data usûlü, performans ölçüleri, kalibrasyon, decision curve analysis, validation nevʿi ve anʿanevî skorlarla muḳâyese misillü müteġayyirler hedef tutulmuştur.
Risk of bias teḳyîmi PROBAST ile iştirakçiler, predictorlar, netîce ve taḥlîl olmak üzere dört saḥada tertîb edilmiştir. Her saḥa düşük, yüksek yâḫud belirsiz risk diye teḳyîm edilmiş; herhangi bir saḥa yüksek risk taşırsa ʿumûmî riskin yüksek ʿaddolunması muḳarrer görülmüştür.
Menbaʿ dâḫilindeki mühim ḥadd: Nihâʾî netîce ḳısmındaki Cetvel 3, evvelki PROBAST matrisindeki bazı menbaʿ satırlarının validate edilmemiş yâḫud yanlış tasnîf edilmiş olması sebebiyle işbu matrisi muhâfaza etmediğini ṣarâḥaten beyân eder. Bu sebeble nihâʾî PDFnin teʾyîd etmediği çalışmaya maḫṣûṣ PROBAST puanları Verianla tarafından yeniden inşâ olunmamıştır.
Niçün meta-analysis icrâ olunmadı?
Çalışmalar algoritmalar, predictorlar, PHLF taʿrîfleri ve validation stratejileri cihetinden bâriz derecede heterojen olduğundan resmî kemmî meta-analysis yerine anlatısal sentez tercih edilmiştir. Bu ḳarar, muḫtelif PHLF şiddetlerinin ve muḫtelif validation bünyelerinin tek müşterek performans raḳamına tahvîlinin yanıltıcı olabileceği maʿnâsına gelir.
Dâḫil olunan çalışmaların ʿumûmî bünyesi
12 çalışma cemʿan 6913 hastayı iḥtivâ eder. Münferid çalışma ḥacimleri 101 ile 2074 arasında, medyan numûne ḥacmi 363,5'tir. Ṭoḳuz çalışma Çin menşeʾlidir; bir çalışma Japonya'dandır ve iki çalışma beynelmilel yâḫud Çin ḫâricinde ḫâricî validation iḥtivâ eden bünyeye mâliktir. Yedi çalışma tek merkezli, beş çalışma çoḳ merkezlidir. Tang ve refîḳlerinin çalışması bu data setinde ṣarîḥ sûretle prospektif validation kohortu istiʿmâl eden tek çalışmadır.
| Çalışma | Sene | Memleket/siyâḳ | N | Merkez bünyesi |
|---|---|---|---|---|
| Mai ve rüfeḳâsı | 2020 | Çin | 353 | Tek merkez |
| Zhu WS ve rüfeḳâsı | 2020 | Çin | 101 | Tek merkez |
| Wang J ve rüfeḳâsı | 2022 | Çin | 875 | 8 merkez |
| Xu ve rüfeḳâsı | 2023 | Çin | 265 | Tek merkez |
| Li ve rüfeḳâsı | 2023 | Çin | 276 | Tek merkez |
| Tashiro ve rüfeḳâsı | 2024 | Japonya | 334 | Tek merkez |
| Jin ve rüfeḳâsı | 2024 | Çin | 226 | Tek merkez |
| Famularo ve rüfeḳâsı | 2025 | İtalya/Avrupa | 500 | 13 merkez |
| Tang ve rüfeḳâsı | 2025 | Çin | 374 | Tek merkez + prospektif validation |
| Yuan ve rüfeḳâsı | 2025 | Çin | 464 | Tek merkez |
| Wang K ve rüfeḳâsı | 2025 | Çin + MIMIC | 2074 | Çoḳ merkez + ḫâricî kohort |
| Shen ve rüfeḳâsı | 2025 | Çin | 1071 | 3 merkez |
Hangi modeller en yüksek tefrîḳ ḳudretini gösterdi?
| Çalışma | Model | Bildirilen AUC | Validation bünyesi |
|---|---|---|---|
| Mai | ANN | 0,880 geliştirme; 0,876 validation | Ayrılmış validation numûnesi |
| Zhu | Radiomics esaslı model | 0,894 | Dâḫilî validation |
| Wang J | LightGBM | 0,944 taʿlîm; 0,870 validation; 0,822 test | Çoḳlu kohort taḳsîmi |
| Xu | CNN / deep learning | 0,7927 | 5 katlı cross-validation |
| Li | Mürekkeb radiomics modeli | 0,84 taʿlîm; 0,82 test | Ayrılmış test numûnesi |
| Tashiro | XGBoost | 0,863 | Taʿlîm/test taḳsîmi |
| Jin | ANN | 0,766 preoperatif; 0,851 postoperatif; 0,720/0,731 zamânî | 5 katlı CV + zamânî validation |
| Famularo | Averaging ensemble | 0,901 test | Taʿlîm/test taḳsîmi |
| Tang | XGBoost | 0,983 taʿlîm; 0,981 validation; 0,942 prospektif | Dâḫilî + prospektif validation |
| Yuan | LightGBM | 0,927 taʿlîm; 0,703 test; 0,808 validation | Taʿlîm/test/validation |
| Wang K | Zamânî deep learning | 0,952 dâḫilî; 0,884 ḫâricî Çin; 0,654 MIMIC | Ḫâricî + Ġarbî ḫâricî kohort |
| Shen | PILOT, safḥaya maḫṣûṣ miʿmârî | 0,754–0,904 taʿlîm; 0,740–0,895 validation | İki ḫâricî kohort |
Menbaʿ Şekil 2, her çalışma içün taʿlîm ḫâricindeki en iyi bildirilen AUCyi yan yana gösterir. Grafikte Tang 2025 taḳrîben 0,981 ile en üstte; Famularo 2025 0,901, Shen 2025 0,895, Zhu 2020 0,894 ve Wang K 2025 0,884 ile onu taʿḳîb eder. Lâkin bu tertîb modellerin aynı şerâʾiṭde muḳâyese edildiği maʿnâsına gelmez.
Ḫâricî Validation PHLF Modellerinde Niçün Ḥayâtîdir?
Ḫâricî validation, modelin geliştirildiği hasta guruundan müstaḳil bir hastane, zamân devresi yâḫud coġrâfyada müşâbih performansı muhâfaza edip etmediğini imtiḥân eder; PHLF literatüründe Wang K modelinin AUCsinin dâḫilî teḳyîmdeki 0,952'den MIMIC-IV kohortunda 0,654'e düşmesi, distribution shiftin klinik taʿmîm ḳâbiliyyetini ciddî sûretle değiştirebileceğini gösterir.
Tetḳîḳde taʿmîm ḳâbiliyyeti cihetinden en maʿnâlı deliller random olmayan validation bünyelerinden gelmiştir. Jin ve rüfeḳâsı zamânî validationda 0,720 ve 0,731 AUC; Tang ve rüfeḳâsı prospektif validationda 0,942 AUC; Wang K ve rüfeḳâsı Çin ḫâricî kohortunda 0,884 ve MIMIC-IVde 0,654 AUC; Shen ve rüfeḳâsı iki ḫâricî kohortda 0,740–0,895 aralığında AUC bildirmiştir.
Bu misâller, model geliştirme datasına ziyâdesiyle benzeyen bir dâḫilî test setinde ḳavî performans elde etmenin klinik intikāl ḳâbiliyyetiyle aynı olmadığını gösterir.
Coġrâfî temerküz niçün bir maḥdûdiyyet teşkîl eder?
12 çalışmanın ṭoḳuzu Çin'den, biri Japonya'dandır. Menbaʿ bu literatürün büyük ölçüde Şarḳî Asya, hepatoselüler karsinom ve bazı kohortlarda HBV ile alâḳalı ḳaraciğer hastalığına ağırlıḳ verdiğini teʾkîd eder. Buna muḳâbil Ġarbî hasta popülasyonlarında yağlı ḳaraciğer hastalığı, alkole müteʿallik ḳaraciğer hastalığı ve kolorektal ḳaraciğer metastazları misillü muḫtelif vaḳʿa tevzîʿleri bulunabilir.
Bu sebeble bir modelin bir memlekette yâḫud hastane sisteminde ḳavî netîce vermesi başḳa bir tatbîḳ coġrâfyasında aynı kalibrasyonu ve tefrîḳ ḳudretini muhâfaza edeceği maʿnâsına gelmez. Hedef tatbîḳ coġrâfyasında ḫâricî validation, icâbında yeniden kalibrasyon ve case mix iḫtilâflarının ṣarîḥ raporu lâzımdır.
Hangi predictor gurupları mükerreren görülür?
| Predictor saḥası | Tetḳîḳde görülen misâller | ʿİlmî rolü |
|---|---|---|
| Ḳaraciğer rezervi / laboratuvar | Bilirubin, albumin, INR/protrombin zamânı | Ḳaraciğerin terkîb ve iḫrâc ḳudretine dâʾir esâs klinik işâret |
| Hematolojik/portal göstergeler | Trombosit ʿadedi | Portal hipertansiyon ve ḳaraciğer hastalığı siyâḳındaki risk maʿlûmâtına katkı |
| Fonksiyonel testler | ICG-R15 | Ḳaraciğer fonksiyon rezervini teḳyîm eden maʿlûmât |
| Rezeksiyon/volumetri | FLR, rezeksiyon şümûlü, rezidüel ḥacim | Baʿde'l-ʿamel bâḳî ḳalacak fonksiyonel nesc ve cerrâḥî yükü temsîl |
| Görüntüleme | CT/MRI radiomics ḫuṣûṣiyyetleri | Parenḫim heterojenliğini kemmî görüntü ḫuṣûṣiyyetleriyle temsîl |
| Dinamik perioperatif data | Zamânla teġayyür eden laboratuvar ve perioperatif ölçüler | Tek bir ölçü yerine hastanın müteġayyir fizyolojik seyrini modelleme |
Tetḳîḳin çalışmalar arası tefsîrine göre sâbit preoperatif ḳaraciğer rezervi müteġayyirlerini istiʿmâl eden modeller dâḫilî datada taḳrîben 0,81–0,88 AUC mertebelerine erişebilmiştir. Görüntüleme radiomicsinin ilâvesi bazı aṣlî çalışmalarda yalnız klinik yâḫud yalnız radiomics alt modellerine nisbetle terakkî göstermiştir. Dinamik perioperatif modeller ise ḳavî tefrîḳ ḳudreti gösterebilmiş, lâkin ḫâricî taʿmîm ḳâbiliyyeti ḫuṣûṣunda daha bâriz müşkilâtla ḳarşılaşmıştır.
İzâḥ edilebilirlik nasıl ele alınmıştır?
Çalışmalarda izâḥ edilebilirlik içün SHAP taḥlîlleri, nomogramlar, feature-importance gösterimleri, risk gurupları ve web esaslı vâsıṭalar istiʿmâl edilmiştir. Bilḫâṣṣa yüksek riskli klinik ḳararlarda modelin yalnız bir iḥtimâl vermesi değil, hangi müteġayyirlerin taḫmîne katkıda bulunduğunun taʿḳîb edilebilir olması klinik ḳabûl cihetinden mühimdir.
ML modelleri anʿanevî skorlardan daha mı iyidir?
Dâḫil olunan çalışmalar içinde aynı kohort üzerinde yapılan muḳâyaselerin vechi ekseriyyetle ML esaslı modeller lehinedir. Mai'nin ANN modeli, Zhu'nun radiomics modeli, Wang J'nin LightGBM modeli, Tashiro'nun XGBoost modeli, Jin'in ANN modeli ve Tang'ın XGBoost modeli misillü örnekler anʿanevî skorlar yâḫud daha basit klinik modellerle muḳâyese edildiğinde daha yüksek tefrîḳ performansı bildirmiştir.
Lâkin sistematik tetḳîḳde bütün modellerin ve Child–Pugh, MELD, ALBI, FIB-4 yâḫud APRI'nin aynı hasta ḳayıdları üzerinde yeniden taʿlîm edilip test olunduğu müşterek bir benchmark icrâ edilmemiştir. Hasta seviyesinde harmonize ḫâm data bulunmadığından böyle bir taḥlîl mümkün olmamıştır. Binâʾenaleyh netîce, müşterek bir prospektif tecrübeyle isbât edilmiş ʿumûmî tefevvuḳ değil; aṣlî çalışmaların kendi kohortlarında rapor ettikleri netîcelerin mütteḥid istiḳâmetidir.
Literatürdeki esâs boşluḳlar
Netîce taʿrîfinin heterojenliği: Çalışmalar “severe PHLF”, “clinically significant PHLF”, ʿumûmî PHLF ve “postoperative liver failure” misillü muḫtelif son noḳṭaları istiʿmâl etmiştir. Muḫtelif şiddette ḥâdiseleri taḫmîn eden modellerin AUC ḳıymetlerini yan yana ḳoymaḳ klinik muḳâyaseyi müşkil ḳılar.
Nâḳıṣ performans raporu: AUC sıḳ rapor olunurken ḥassâsiyyet, ḫuṣûṣiyyet, PPV, NPV, kalibrasyon meyli/kesişimi, decision curve analysis ve confusion matrix datası muntazam sûretle verilmemiştir.
Maḥdûd ḫâricî validation: Tetḳîḳin teḳyîmine göre yalnız dört çalışma zamânî, prospektif yâḫud ḫâricî validation bünyesine mâliktir. Ġarbî bir data setine ṣarîḥ intikāl imtiḥânı bilḫâṣṣa maḥdûddur.
Ḥesâb maliyyetinin rapor edilmemesi: Dâḫil olunan çalışmalar taʿlîm müddeti, inference gecikmesi, ḥâfıẓa istiʿmâli ve CPU/GPU iḥtiyâcları misillü teknik tevzîʿ maliyyetlerini sistematik sûretle rapor etmemiştir. Bu noḳṣân bilḫâṣṣa hastane altyapısında real-time istiʿmâl teḳyîmini müşkil ḳılar.
Predictor saḥası ablationı: Laboratuvar, koagülasyon, volumetri, radiomics ve zamânî müteġayyir guruplarını aynı model çerçevesinde sıra ile çıkarıp yeniden taʿlîm eden tam müşterek bir ablation mevcut değildir.
Distribution shift emniyyeti: İʿtimâdı düşük vaḳʿaları otomatik ḳarar yerine klinisyene ḥavâle eden selective prediction yâḫud cost-aware deferral misillü emniyyet mekanizmaları dâḫil olunan çalışmalarda resmen tatbîḳ edilmemiştir.
İstiḳbâl tetḳîḳleri içün tavṣiyeler
Tetḳîḳ müʾellifleri istiḳbâlde birincil netîce taʿrîfi olarak imkân nisbetinde standardize edilmiş, klinik cihetten maʿnâlı ISGLS grade B/C PHLF istiʿmâlini; AUC yanında ḥassâsiyyet, ḫuṣûṣiyyet, PPV, NPV, kalibrasyon ve decision curve analysisin rapor olunmasını; çoḳ merkezli ve coġrâfî cihetten mütenevviʿ ḫâricî validationların tezyîdini tavṣiye ederler.
Bundan mâʿadâ laboratuvar esaslı ḳaraciğer rezervi göstergelerini görüntüleme ve ḳıṣa devreli perioperatif zamânî data ile birleştiren multimodal modeller tetḳîḳe lâyıḳ görülmektedir. Lâkin daha mürekkeb modelin ḥaḳîḳaten klinik menfaʿat teʾmîn edip etmediğini teḳyîm içün ḳavî ve daha ucuz esâs modellerle doğrudan muḳâyese edilmesi lâzımdır.
Son merḥalede iḥtiyâc yalnız daha yüksek bir AUC değildir. Prospektif decision-impact çalışmaları, taḫmîn sisteminin cerrâḥî stratejiyi, FLR artırma teşebbüslerini, postoperatif taʿḳîb şiddetini yâḫud rescue tedâvîlerini ḥaḳîḳaten değiştirip değiştirmediğini ve hastalar cihetinden klinik menfaʿat tevlîd edip etmediğini göstermelidir.
Çalışmanın teʾyîd ettiği netîceler
Mevcut literatür, ML esaslı modellerin PHLF riskini tefrîḳde ümîd-bahş performans gösterebildiğini teʾyîd eder. Gradient boosting, ANN/deep learning, radiomics ve zamânî modellerin cümlesinde klinik cihetten maʿnâlı tefrîḳ ḳudreti bildirilmiştir. Ḳaraciğer rezervi alâmetleri, görüntüleme ve perioperatif maʿlûmât müştereken istiʿmâl edildiğinde ḳavî modeller teşkîl edilebildiğine dâʾir mütteḥid işâretler vardır.
Tetḳîḳ ayrıca validation tertîbinin model muvaffakiyyeti ḳadar mühim olduğunu teʾyîd eder. Bilḫâṣṣa zamânî, prospektif ve müstaḳil ḫâricî validationlar modelin ḥaḳîḳî taʿmîm ḳâbiliyyeti ḥaḳḳında random dâḫilî test taḳsîmlerinden daha ḳavî delîl verir.
Çalışmanın teʾyîd etmediği netîceler
Tetḳîḳ muʿayyen bir ML miʿmârîsinin PHLF içün ʿumûmen en iyi model olduğunu göstermez. 0,981 misillü yüksek AUC ḳıymetleri bütün hastane, memleket ve hasta guruplarına naḳledilebilecek żamân edilmiş performans ḳıymetleri değildir.
Çalışma, ML esaslı PHLF taḫmîn vâsıṭalarının rutin klinik istiʿmâlinin hasta vefâtını yâḫud komplikasyon nisbetini azalttığını isbât eden bir decision-impact tecrübesi değildir. Dâḫil olunan modellerin ekserîsi retrospektif dataya müsteniddir ve birçoḳ modelin müstaḳil ḫâricî validationı nâḳıṣdır.
Machine learningin klinisyenin ḳararını otomatik sûretle değiştirmesi yâḫud ʿameliyyât ḳararını münferiden vermesi gerektiği netîcesi dahi işbu sistematik tetḳîḳden istiḫrâc olunamaz. Menbaʿın istiḳbâl naẓarı, daha şeffâf, ḫâricen validate edilmiş, kalibre edilmiş ve klinik ḳarar menfaʿati gösterilmiş sistemlere iḥtiyâc bulunduğunu teʾkîd eder.
Menbaʿ ve Usûl Ḫuṣûṣunda Ḳayd
Aṣlî çalışma: Machine Learning Models for Predicting Post-Hepatectomy Liver Failure: A Systematic Review
Müʾellifler: Calin Muntean; Vasile Gaborean; Razvan Constantin Vonica; Sebastian Aurelian Stefaniga; Alaviana Monique Faur; Catalin Vladut Ionut Feier.
Mesʾûl müʾellifler: Vasile Gaborean ve Razvan Constantin Vonica.
Müʾesseseler: “Victor Babeş” University of Medicine and Pharmacy Timişoara bünyesindeki Medical Informatics and Biostatistics, Thoracic Surgery Research Center, Surgical Semiology, Doctoral Studies ve Abdominal Surgery and Phlebology Research Center birimleri; “Lucian Blaga” University of Sibiu, Preclinical Department/Physiology; West University of Timişoara, Department of Computer Science; “Pius Brinzeu” Clinical Emergency Hospital, First Surgery Clinic.
Mecmûʿa: AI.
Nâşir: MDPI.
Menbaʿ nevʿi: Sistematik tetḳîḳ.
Neşir maʿlûmâtı: AI 2026, 7(5), 166.
DOI: 10.3390/ai7050166
İrsâl: 27 Mart 2026.
Taṣḥîḥ: 25 Nisan 2026.
Ḳabûl: 5 Mayıs 2026.
Neşir: 9 Mayıs 2026.
Resmî neşir adresi: https://www.mdpi.com/2673-2688/7/5/166
Ruhṣat: Açık erişim, Creative Commons Attribution (CC BY).
Sistematik tetḳîḳ çerçevesi: PRISMA 2020, Cochrane Handbook tavṣiyeleri, CHARMS ve PROBAST istiʿmâl edilmiştir.
Ḳayıd notu: Maḳālenin ḫulâṣa ve usûl ḳısmı protokolün PROSPEROda ḳayıdlı olduğunu beyân eder. Aynı usûl ḳısmında ayrıca Open Science Framework ḳaydı olarak DOI 10.17605/OSF.IO/67CQ3 verilir. PDF içinde ayrı bir PROSPERO CRD ḳayıd numarası görünmediğinden bu iki ifâde cemʿ edilmemiş yâḫud taḫmîn olunmamıştır.
Temvîl: Maḳālenin article processing charge bedelinin Victor Babeş University of Medicine and Pharmacy Timişoara tarafından tesviye edildiği beyân edilmiştir.
Müʾessese aḫlâḳ heyʾeti: Tatbîḳ olunmaz.
Maʿlûmâtlı muvâfaḳat: Tatbîḳ olunmaz.
Data erişilebilirliği: Müʾellifler işbu sistematik tetḳîḳ içün yeni data teşkîl yâḫud taḥlîl edilmediğini bildirirler.
Menfaʿat teʿârużu: Müʾellifler menfaʿat teʿârużu bulunmadığını beyân etmişlerdir.
AI istiʿmâli beyânı: Müʾellifler ChatGPT v4.0ı yalnız maḳālenin lisânını ve ḳırâʾat kolaylığını ıṣlâḥ maḳṣadıyla istiʿmâl ettiklerini; ʿilmî muḥtevâ, tefsîrler ve netîcelerin müʾelliflere ʿâʾid olduğunu beyân etmişlerdir.
Müʾellif hisseleri: Tasavvur Calin Muntean, Vasile Gaborean ve Razvan Constantin Vonica; metodoloji Calin Muntean, Sebastian Aurelian Stefaniga ve Razvan Constantin Vonica; software Sebastian Aurelian Stefaniga; validation Calin Muntean, Vasile Gaborean ve Razvan Constantin Vonica; formal analysis Calin Muntean ve Sebastian Aurelian Stefaniga; tetḳîḳ Calin Muntean ve Alaviana Monique Faur; data curation Calin Muntean ve Alaviana Monique Faur tarafından icrâ edilmiştir. İlk müsvedde Calin Muntean tarafından hazırlanmış; müṭâlaʿa ve taṣḥîḥe Vasile Gaborean, Razvan Constantin Vonica, Sebastian Aurelian Stefaniga ve Catalin Vladut Ionut Feier katkıda bulunmuştur.
Esâs usûlî maḥdûdiyyetler: Dâḫil olunan çalışmaların ekserîsinin retrospektif ve tek merkezli olması; PHLF son noḳṭasının heterojen taʿrîf edilmesi; datanın coġrâfî cihetten Şarḳî Asya ağırlıḳlı olması; kalibrasyon, ḥassâsiyyet ve ḫuṣûṣiyyetin muntazam rapor edilmemesi; ḫâricî validation noḳṣânı; muḫtelif model ailelerinin doğrudan muḳâyese edilememesi ve ḥesâb maliyyetlerinin kifâyet derecesinde rapor edilmemesi.
Verianla usûl ḳaydı: Bu metin menbaʿ maḳālenin satır-be-satır tercümesi değildir. Menbaʿdaki klinik mesʾele, sistematik tetḳîḳ usûlü, hasta ve çalışma ʿadedleri, model performansları, validation stratejileri, predictor saḥaları, şekillerin ʿilmî mesajı, münâḳaşa ve maḥdûdiyyetler muhâfaza olunaraḳ müstaḳil bir taʿlîm bünyesi teşkîl edilmiştir. Menbaʿda bulunmayan klinik netîce, performans ölçüsü yâḫud model muvaffakiyyeti ilâve edilmemiştir.
Ṭıbbî tefsîr ḥaddi: Buradaki model performansları klinik ḳarar destek tetḳîḳlerine ʿâʾiddir. Münferiden herhangi bir hastanın ʿameliyyâta münâsebetini, PHLF risḳini yâḫud tedâvî planını taʿyîn maḳṣadıyla istiʿmâl olunamaz; klinik ḳararlar hastaya maḫṣûṣ teḳyîm ve validate edilmiş maḥallî protokoller ister.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir