

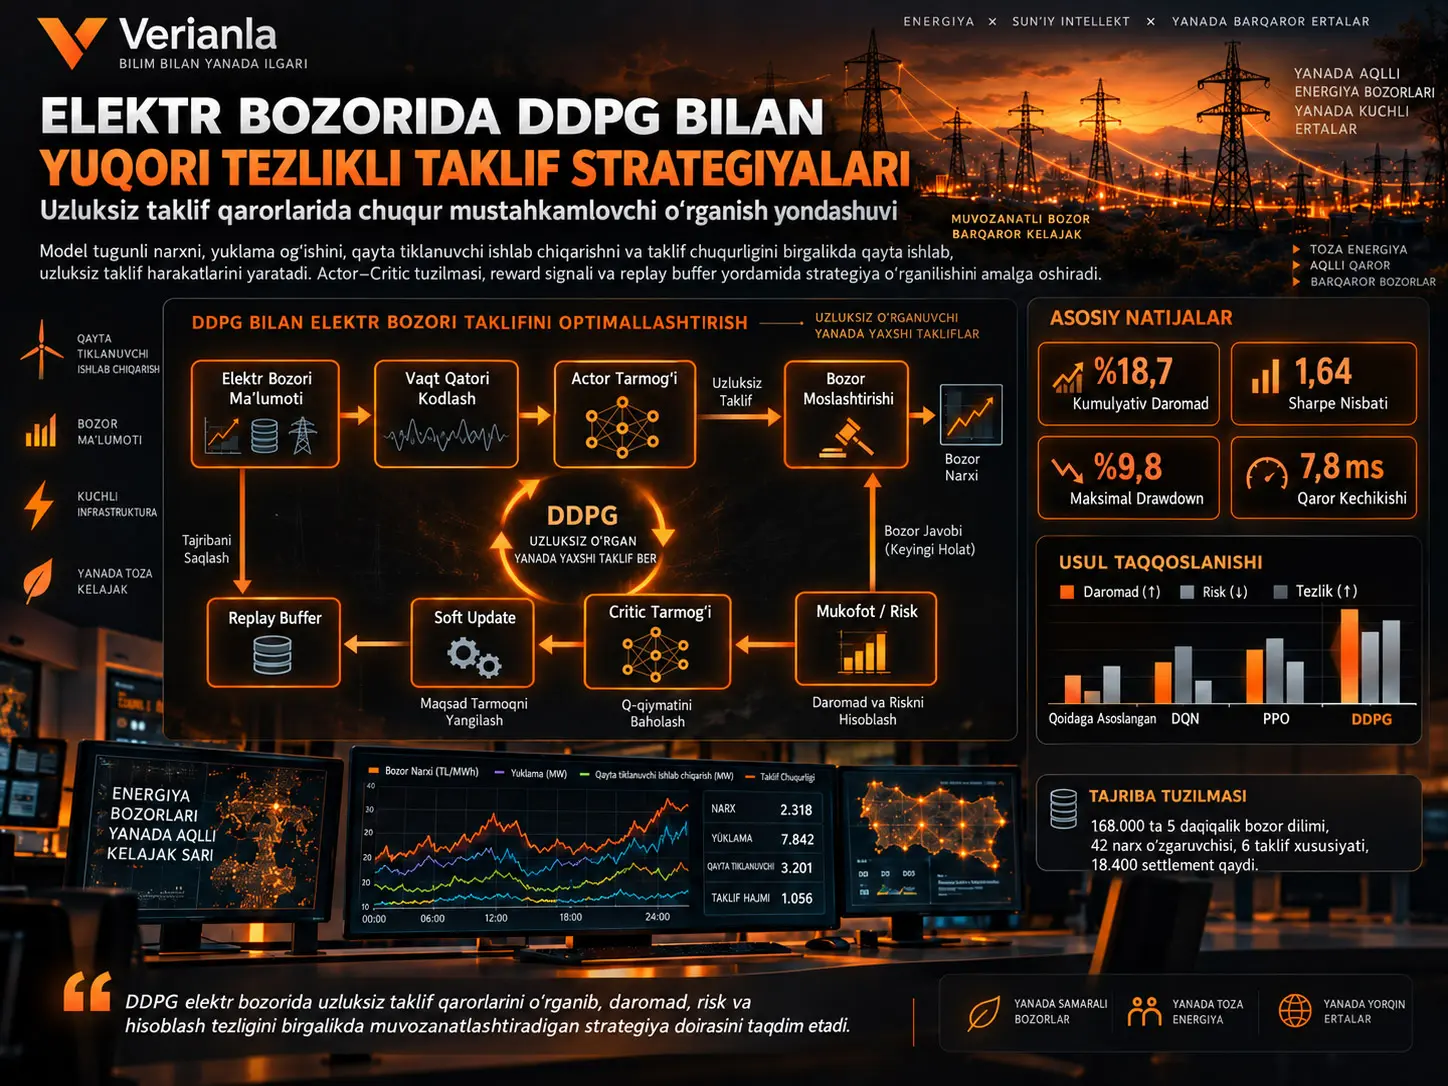
Elektr bozorlarda narx, yuklama, qayta tiklanuvchi energiya ishlab chiqarishi va savdo chuqurligi qisqa vaqt oralig‘ida birgalikda o‘zgarishi mumkin. Ushbu tadqiqot shu ko‘p o‘zgaruvchili muhitda taklif narxi va taklif miqdori kabi uzluksiz qarorlarni Deep Deterministic Policy Gradient (DDPG) orqali o‘rganish mumkinmi, degan savolni tekshiradi. Taklif etilgan tizim tugun bo‘yicha chegaraviy elektr narxi, yuklama og‘ishi, qayta tiklanuvchi ishlab chiqarish, taklif chuqurligi va sof pozitsiya ma’lumotlarini vaqt qatori tasviriga aylantiradi; Actor tarmog‘i uzluksiz taklif harakatlarini hosil qiladi, Critic tarmog‘i esa ushbu harakatlarning kutilayotgan qiymatini baholaydi. Daromad, execution og‘ishi, inventar bosimi va narx volatilligi bitta reward funksiyasida birgalikda baholanadi.
Tajriba muhiti 168.000 ta 5 daqiqalik bozor vaqt kesimi, 42 ta narx o‘zgaruvchisi, oltita taklif xususiyati va 18.400 ta settlement yozuvini o‘z ichiga oladi. Manbada DDPG uchun %18,7 kumulyativ daromad, 1,64 Sharpe koeffitsiyenti, %9,8 maksimal drawdown va 7,8 ms o‘rtacha qaror kechikishi qayd etilgan. Xuddi shu tajriba muhitida DDPG DQN, PPO va qoidalarga asoslangan taklif usullariga nisbatan yuqoriroq kumulyativ daromad va Sharpe koeffitsiyenti hamda pastroq maksimal drawdown olgani bildiriladi.
Biroq tadqiqotdagi “yuqori chastota” tushunchasini ehtiyotkorlik bilan talqin qilish kerak. Bozor holatlari 5 daqiqalik kesimlarda ifodalanganligi sababli tajriba aksiyalar va kripto bozorlarida qo‘llaniladigan mikrosoniyalik limit-buyurtmalar-kitobi HFT bilan bir xil vaqt masshtabida emas. 7,8 ms qiymati modelning qaror hisoblash kechikishini bildiradi; bozor ma’lumotlarining namuna olish oralig‘i esa 5 daqiqa. Shuningdek, ma’lumot manbasi qaysi haqiqiy elektr bozoriga tegishli ekani va ko‘plab muhim o‘qitish giperparametrlari aniq hisobot qilinmagani sababli natijalarni mustaqil qayta ishlab chiqish imkoniyati cheklangan.
Deep Deterministic Policy Gradient (DDPG) uzluksiz harakat fazolari uchun ishlab chiqilgan model-free, off-policy Actor–Critic mustahkamlovchi o‘rganish yondashuvidir. Actor muayyan bozor holatida qaysi harakat bajarilishini hosil qiladi; Critic esa shu holat–harakat juftligining kutilayotgan qiymatini baholaydi. Experience replay va sekin yangilanadigan target networks o‘qitish barqarorligini qo‘llab-quvvatlash uchun ishlatiladi.
| Element | Manbada keltirilgan qiymat |
|---|---|
| Bozor sohasi | Elektr bozorida uzluksiz taklif qarorlari |
| Asosiy usul | Deep Deterministic Policy Gradient (DDPG) |
| Bozor vaqt kesimi | 168.000 ta 5 daqiqalik time slice |
| Narx o‘zgaruvchilari | 42 |
| Taklif xususiyatlari | 6 |
| Settlement yozuvi | 18.400 |
| Taqqoslangan usullar | Rule-based, DQN, PPO, DDPG |
| DDPG kumulyativ daromadi | %18,7 |
| DDPG Sharpe koeffitsiyenti | 1,64 |
| DDPG maksimal drawdown | %9,8 |
| DDPG qaror kechikishi | 7,8 ms |
Nega elektr bozorida taklif qarori uzluksiz boshqaruv muammosi sifatida ko‘riladi?
Klassik tasniflash muammosi faqat “ol”, “sot” yoki “kut” kabi diskret variantlarni beradi. Elektr bozori taklif mexanizmida esa qaror ko‘pincha murakkabroq. Tizim ham taklif narxini, ham taklif qilinadigan energiya miqdorini belgilashi, shu bilan birga quvvat, pozitsiya va risk cheklovlariga rioya qilishi kerak.
Shuning uchun harakat fazosi:
- taklif qilinadigan quvvat miqdori,
- narx og‘ishi,
- pozitsiyani sozlash,
- riskni kamaytirish darajasi
kabi uzluksiz kattaliklardan iborat bo‘lishi mumkin.
DQN kabi usullar asosan diskret harakat tanlashga tayanadi. Uzluksiz taklif fazosidan DQN bilan foydalanish uchun harakatlarni ma’lum qutilarga ajratish kerak bo‘ladi. Bu esa narx va miqdorni bir vaqtda nozik masshtabda sozlash talab qilinadigan holatlarda aniqlikni pasaytirishi mumkin.
DDPG ning asosiy afzalligi Actor tarmog‘i bevosita uzluksiz sonli harakat hosil qilishidir.
Tadqiqotning umumiy ishlash sikli
Manbaning 1-rasmida tizim beshta asosiy qismda ko‘rsatilgan:
Ma’lumot kirishi → holat yaratish → siyosat chiqishi → bozor bilan o‘zaro ta’sir → parametrlarni yangilash.
Birinchi bosqichda tizimga:
- tugun bo‘yicha chegaraviy narx,
- savdo natijalari,
- yuklama og‘ishi,
- qayta tiklanuvchi ishlab chiqarish
kabi bozor oqimlari kiradi.
Ma’lumotlar sliding window va normalization amallaridan so‘ng umumiy state representation ga aylantiriladi. Actor Network shu holatdan uzluksiz bidding action hosil qiladi. Taklif bozor matching modulida baholanadi. Hosil bo‘lgan daromad va risk feedback Critic tomonidan ishlatiladi va tajriba replay buffer ga yoziladi. Keyin Actor, Critic va target network parametrlari yangilanadi.
DDPG Elektr Bozori Takliflarini Qanday O‘rganadi?
DDPG ning asosida ikkita neyron tarmoq mavjud. Actor bozor holatini harakatga aylantiradi. Critic esa Actor hosil qilgan taklifning joriy bozor sharoitida qanchalik qiymatli ekanini hisoblashga urinadi.
Actor ning vazifasi taxminan:
\[ \text{piyasa durumu} \rightarrow \text{teklif fiyatı ve miktarı} \]
mosligini o‘rganishdir.
Critic esa:
\[ Q(s,a) \]
funksiyasi orqali muayyan \(s\) holatida bajarilgan \(a\) harakatining kutilayotgan uzoq muddatli qiymatini baholaydi.
Vaqt oynasi
Model faqat joriy bozor kuzatuvidan foydalanmaydi. So‘nggi \(L\) vaqt kesimini bitta oynaga joylashtiradi:
\[ S_t= \{x_{t-L+1},x_{t-L+2},\ldots,x_t\} \]
Bu yerda \(x_t\) joriy bozor kuzatuvini, \(S_t\) esa qaror paytidagi tarixiy state window ni ifodalaydi.
Maqsad qisqa muddatli narx harakatlari, savdo intensivligi va yuklama o‘zgarishlarini faqat bitta nuqtadan emas, yaqin o‘tmishdagi naqshidan o‘rganishdir.
To‘rtta asosiy xususiyat guruhi
Tadqiqot kirishlarni to‘rtta toifaga ajratadi:
- Narx: tugun narxlari va narx og‘ishlari,
- Savdo: savdo hajmi, taklif navbati va execution ma’lumoti,
- Cheklov: quvvat va taklif limitlari,
- Volatillik: bozor tebranishini ifodalovchi o‘zgaruvchilar.
Bu geterogen o‘zgaruvchilar umumiy representation fazosiga:
\[ z_t= \sigma (W_p p_t+W_v v_t+W_c c_t+W_r r_t+b) \]
orqali o‘tkaziladi.
Bu amal narx, savdo, cheklov va volatillik ma’lumotlarini siyosat tarmog‘iga umumiy o‘lchamda uzatishni maqsad qiladi.
Tarixiy ma’lumotni vaznlash
Model faqat xususiyatlarni birlashtirmaydi; tarixiy trend, savdo feedback va constraint ma’lumotini ham state tarkibiga qo‘shadi:
\[ h_t= \sum_{i=0}^{L-1}\alpha_i z_{t-i} + \beta\Delta q_t + \gamma\Delta m_t + \eta(z_t\odot u_t) \]
Bu ifoda yaqin o‘tmishning turli qismlariga turli vaznlar berish va hajm/narx o‘zgarishlarini qaror holatiga kiritish imkonini beradi.
Nega Vaqt Qatori Kodlashidan Foydalaniladi?
Elektr narxi, yuklama og‘ishi va qayta tiklanuvchi ishlab chiqarish faqat joriy qiymatlari bilan emas, bir necha vaqt kesimi davomida kuzatilgan yo‘li tufayli ham qaror uchun ma’no kasb etishi mumkin.
Shu sabab manba tadqiqot to‘rt bosqichli temporal representation tuzilmasini yaratadi:
- mahalliy vaqt naqshini ajratib olish,
- attention aggregation,
- gated fusion,
- policy input mapping.
Attention mexanizmi
O‘tmishdagi har bir vaqt kesimi joriy taklif uchun bir xil darajada muhim bo‘lishi kutilmaydi. Manbada attention vazni:
\[ \alpha_{t,j} = \frac {\exp(q_tk_j^{T}/\sqrt{d_k})} {\sum_m\exp(q_tk_m^{T}/\sqrt{d_k})} \]
ko‘rinishida hisoblanadi.
So‘ng tarixiy tasvirlar:
\[ c_t= \sum_{j=t-L+1}^{t} \alpha_{t,j}e_j \]
orqali bitta context vector ichida birlashtiriladi.
Shu tariqa yaqin o‘tmishdagi narx sakrashi yoki savdo intensivligi kabi qaror uchun mazmunliroq bo‘laklarga yuqoriroq vazn berish ko‘zda tutiladi.
Risk va Daromad Bir Reward Funksiyasida Qanday Birlashtiriladi?
Agar mustahkamlovchi o‘rganish algoritmi faqat foydani maksimal qilishga o‘rgatilsa, qisqa muddatda haddan tashqari agressiv takliflar hosil qilishi mumkin. Shu sabab tadqiqotdagi reward funksiyasi faqat savdo daromadini emas, execution og‘ishini, inventory riskini va narx volatilligini ham jazolaydi.
Manbada reward:
\[ r_t= m_t(\pi_t^{clr}-\pi_t^{bid}) -\lambda_1|a_t-m_t| -\lambda_2\max(0,|e_{t+1}|-\bar e) -\lambda_3 Var(\pi_{t-w:t}) \]
ko‘rinishida tuzilgan.
Bu yerda birinchi qism amalga oshirilgan savdo hajmi bilan clearing va bidding narxi o‘rtasidagi farqdan kelib chiqadigan daromad komponentidir.
Keyingi hadlar mos ravishda:
- execution / action og‘ishi,
- ruxsat etilgan chegaradan oshgan sof pozitsiya,
- yuqori narx dispersiyasi
uchun jarima qo‘llaydi.
Shu tariqa model faqat “qaysi harakat eng ko‘p daromad beradi?” degan savolni emas, “daromad olayotganda pozitsiya va volatillik riskini qanday cheklayman?” degan savolni ham o‘rganishga urinadi.
Actor–Critic Arxitekturasi Qanday Yangilanadi?
Uzluksiz taklif hosil qilish
Actor tarmog‘i uzluksiz harakatni muayyan quyi va yuqori chegaralar orasida hosil qiladi:
\[ a_t= \Gamma(W_an_t+b_a) \]
va manbada masshtablash funksiyasi:
\[ \Gamma(x)= l+ \frac{u-l}{2}(1+\tanh(x)) \]
ko‘rinishida beriladi.
Shu bilan neyron tarmoqning xom chiqishi bozor ruxsat bergan taklif oralig‘iga o‘tkazilishi mumkin.
Critic qiymat bahosi
Critic joriy bozor holati va Actor tanlagan taklif qiymatini:
\[ q_t=Q(y_t,a_t;\theta^Q) \]
orqali baholaydi.
Target network
Bir qadamli market reward yuqori volatillikka ega bo‘lishi mumkinligi sababli manba target Actor va target Critic dan foydalanadi:
\[ \hat q_t= r_t+ \gamma Q'(y_{t+1}, \mu'(y_{t+1});\theta^{Q'}) \]
Target tarmoqlarni online tarmoqlar bilan bir vaqtda to‘liq almashtirish o‘rniga soft update qo‘llanadi:
\[ \theta^{Q'} \leftarrow \tau\theta^Q+(1-\tau)\theta^{Q'} \]
\[ \theta^{\mu'} \leftarrow \tau\theta^\mu+(1-\tau)\theta^{\mu'} \]
Bu yondashuv maqsad qiymatlarning o‘qitish paytida haddan tashqari tez o‘zgarishini cheklashga qaratilgan.
Tadqiqot Usuli va Natijalari
Tajriba ma’lumotlari tuzilishi
Manbada tajriba ma’lumotlar to‘plami:
- 168.000 ta 5 daqiqalik bozor vaqt kesimi,
- 42 ta narx o‘zgaruvchisi,
- 6 bidding feature,
- 18.400 settlement record
sifatida ta’riflanadi.
State input; node marginal price, real vaqt yuklama og‘ishi, taklif chuqurligi, qayta tiklanuvchi ishlab chiqarish va sof pozitsiyadan iborat.
Biroq manbada ma’lumotlar to‘plami qaysi haqiqiy elektr bozoridan olingani, geografik hududi va qamrab olingan aniq sana oralig‘i ochiq ko‘rsatilmagan. Tajribalar “unified matching environment” ichida olib borilgan.
DDPG qanday natijalar berdi?
| Model | Kumulyativ Daromad | Sharpe | Maksimal Drawdown | Qaror Kechikishi |
|---|---|---|---|---|
| Rule-based | %11,6 | 1,02 | %14,8 | 5,9 ms |
| DQN | %14,2 | 1,21 | %12,9 | 6,8 ms |
| PPO | %16,1 | 1,39 | %11,4 | 8,6 ms |
| DDPG | %18,7 | 1,64 | %9,8 | 7,8 ms |
Manba tajribasida DDPG eng yuqori kumulyativ daromad va Sharpe koeffitsiyentiga, shu bilan birga eng past maksimal drawdown ga ega.
Qoidalarga asoslangan usul 5,9 ms bilan eng tez qaror ishlab chiqarsa-da, samaradorlik va risk ko‘rsatkichlarida zaifroq natija beradi. DDPG ning 7,8 ms kechikishi PPO ning 8,6 ms qiymatidan past, DQN va rule-based usullaridan esa yuqori.
“7,8 ms” haqiqiy HFT deganimi?
Bu qiymat faqat modelning hisoblash/inference kechikishidir. Tadqiqotdagi market state ma’lumotlari 5 daqiqalik kesimlar bilan tashkil etilgan.
Demak:
5 daqiqalik bozor kuzatuvi + 7,8 ms model inference
tuzilmasi mikrosoniya darajasida uzluksiz limit-order-book yangilanishlari bilan ishlaydigan qimmatli qog‘ozlar HFT tizimlari bilan bevosita taqqoslanmasligi kerak.
Elektr bozori kontekstida tadqiqotni qisqa vaqt oralig‘idagi, tez va uzluksiz bidding control muammosi sifatida o‘qish aniqroq bo‘ladi.
Model qaysi bozor sharoitlarida kuchliroq reaksiya berdi?
Manbaning 5-rasmida narx og‘ishi va normallashtirilgan savdo chuqurligiga ko‘ra unit-time return heat map ko‘rsatilgan.
Yuqori reaksiya hududi:
- musbat spread: taxminan %0,8–%1,6,
- normalize transaction depth: 0,55–0,72
oralig‘ida jamlangan.
Bu hududda o‘rtacha birlik-vaqt daromadi 0,041–0,048 deb qayd etilgan.
Eng yuqori katakda:
- return: 0,052,
- action intensity: 0,81
qiymatlari berilgan.
Aksincha, narx og‘ishi %0,3 dan yoki transaction depth 0,30 dan pastga tushganda modelning action output i sezilarli kamayadi.
Bu natija o‘rganilgan siyosat barcha volatillik holatlarida maksimal taklif berish o‘rniga spread va bozor chuqurligidan birgalikda foydalanishini ko‘rsatadi.
Haftalik daromadlar
Manbaning 6-rasmidagi 12 test haftasida DDPG uchun:
- median haftalik daromad: 0,31,
- pastki kvartil: 0,27,
- yuqori kvartil: 0,36,
- eng past hafta: 0,18,
- eng yuqori hafta: 0,44
deb qayd etilgan.
DQN va PPO taqsimotlari ham asosan musbat ko‘rinadi, rule-based usulda esa pastki chekka noldan pastga tushadi.
Biroq faqat 12 haftalik kuzatuv va hisobot qilinmagan random-seed takrorlari sababli bu boxplot natijalarini statistik aniqlik yoki turli bozor davrlarida kafolatlangan ustunlik sifatida talqin qilib bo‘lmaydi.
Ablation tajribalari nimani ko‘rsatadi?
| Model Tuzilishi | Daromad | Sharpe | Drawdown | Kechikish |
|---|---|---|---|---|
| To‘liq model | %18,7 | 1,64 | %9,8 | 7,8 ms |
| Vaqt qatori kodlashisiz | %15,8 | 1,34 | %12,6 | 7,3 ms |
| Risk jarimasisiz | %17,2 | 1,22 | %13,7 | 7,7 ms |
| Target smoothing siz | %16,0 | 1,31 | %12,8 | 7,6 ms |
| Priority sampling siz | %16,4 | 1,36 | %12,1 | 7,5 ms |
Ablation natijalarining eng yaqqol misollaridan biri risk penalty komponentidir. Risk jarimasi olib tashlanganda daromad %17,2 bilan nisbatan yuqori bo‘lib qoladi, biroq maksimal drawdown %9,8 dan %13,7 gacha oshadi va Sharpe koeffitsiyenti 1,64 dan 1,22 gacha tushadi.
Bu natija tadqiqot dizaynida faqat xom daromadni maksimal qilish yetarli emasligi va reward ichidagi risk tuzatishi strategiya xulqiga sezilarli ta’sir ko‘rsatishi haqidagi fikrni qo‘llab-quvvatlaydi.
Priority sampling
Manba oddiy replay sampling o‘rniga vaqt yangiligi, temporal-difference error va risk exposure dan foydalanadigan namuna olish vaznini belgilaydi:
\[ \omega_i= \frac{ (\nu_i+\kappa_1|\delta_i|+\kappa_2r_i^{risk})^\zeta }{ \sum_{j=1}^{N} (\nu_j+\kappa_1|\delta_j|+\kappa_2r_j^{risk})^\zeta } \]
Shu bilan yuqori volatillik, yuqori prediction error yoki yuqori riskga ega namunalarning o‘qitish batch larida ko‘proq ko‘rinishi maqsad qilinadi.
Harakat uzluksizligi cheklovi
Tadqiqot Actor yangilanishiga ketma-ket takliflar orasidagi katta sakrashlarni jazolovchi qo‘shimcha regularization hadini qo‘shadi:
\[ \|\mu(y_i)-\mu(y_{i-1})\|_2^2 \]
Bu hadning maqsadi daromad oshishi izlanayotganda taklif narxi yoki miqdorining ketma-ket qarorlar orasida ortiqcha keskin o‘zgarishini kamaytirishdir.
DDPG ning Yuqoriroq Daromadi Haqiqiy Bozorda Ham Xuddi Shunday Kutilishi Mumkinmi?
Yo‘q. Tadqiqot ma’lum bir unified matching environment ichida DDPG qolgan uch usulga qaraganda yaxshiroq natija berganini bildiradi. Bu natijani barcha haqiqiy elektr bozorlariga yoki boshqa tartibga solish tuzilmasiga ega bozorlarga avtomatik tatbiq qilib bo‘lmaydi.
Buning bir necha sababi bor:
- Ma’lumotlar to‘plamining aniq bozor va geografik manbasi ochiq ko‘rsatilmagan.
- Turli elektr bozorlarda taklif, settlement va quvvat qoidalari farq qilishi mumkin.
- Model single-agent tuzilmasida.
- Raqobatchi bozor ishtirokchilarining strategik moslashuvi to‘liq modellashtirilmagan.
- Extreme-tail shock tuzilmasi reward modelida batafsilroq ko‘rib chiqilishi kerakligini manbaning o‘zi tan oladi.
- Cross-region va cross-market tasdiqlash bajarilmagan.
- Random-seed takrorlari va confidence intervals hisobot qilinmagan.
- Asosiy o‘qitish giperparametrlarining muhim qismi sonli ko‘rinishda berilmagan.
“%13,2 pastroq drawdown” iborasiga doir izoh
Manba matnining xulosa qismida maksimal pasayish %13,2 ga kamaygani aytiladi. Biroq 4-jadvalda maksimal drawdown qiymatlari Rule-based uchun %14,8, DQN uchun %12,9, PPO uchun %11,4 va DDPG uchun %9,8.
Bu jadvaldan bevosita:
- Rule-based → DDPG farqi: 5,0 foiz punkti,
- DQN → DDPG farqi: 3,1 foiz punkti,
- PPO → DDPG farqi: 1,6 foiz punkti
hisoblanadi.
Manba %13,2 qiymati qaysi taqqoslash bazasiga nisbatan hisoblanganini ko‘rsatmagani uchun Verianla bu nisbatni mustaqil samaradorlik natijasi sifatida takrorlamaydi.
Tadqiqotning kuchli tomonlari
- Elektr bozori bidding muammosini uzluksiz harakat fazosi sifatida modellashtirishi.
- Narx, savdo, cheklov va risk o‘zgaruvchilarini bitta state tuzilmasida birlashtirishi.
- Actor–Critic, replay buffer va target network tuzilmasini yopiq siklli bozor muhiti bilan birlashtirishi.
- Daromad bilan birga drawdown va latency ni hisobot qilishi.
- DQN, PPO va rule-based taqqoslashlarni birga berishi.
- To‘rtta muhim modul uchun ablation tajribasini o‘tkazishi.
Asosiy metodologik cheklovlar
- “HFT” deb ta’riflangan market input ning 5 daqiqalik vaqt kesimlari bilan ifodalanishi.
- Ma’lumot qaysi bozor va sanalardan olingani yetarlicha tushuntirilmagan.
- Train/validation/test bo‘linishi batafsil berilmagan.
- Actor va Critic tarmoq arxitekturasidagi qatlam o‘lchamlari hisobot qilinmagan.
- Learning rate, discount factor, soft-update coefficient va replay-buffer sig‘imi kabi asosiy qiymatlar yetishmaydi.
- Exploration noise tuzilmasi batafsil izohlanmagan.
- Taqqoslash modellari hyperparameter tuning jarayoni berilmagan.
- Bir nechta random seed va confidence interval hisobot qilinmagan.
- 12 haftalik test taqsimoti uzoq muddatli bozor rejimlarini ifodalash uchun cheklangan.
- Single-agent yondashuvi strategik raqib xatti-harakatini cheklangan darajada ifodalaydi.
Manba va Usul Izohi
Asl sarlavha: Exploration of deep deterministic policy gradient algorithm in high-frequency trading strategy in power market
Muallif: Yunpeng Feng.
Muassasa: School of Automation Science and Engineering, South China University of Technology, Guangzhou, Guangdong, China.
Jurnal: Ingegneria Sismica – International Journal of Earthquake Engineering.
Jild / son: Volume 43 / Issue 2; PDF da Anno XLIII – Num. 2 – 2026.
Sahifalar: 1–23.
Nashr sanasi: 30 Aprel 2026.
DOI: 10.65102/is2026549.
Litsenziya: Jurnalning rasmiy copyright siyosatiga ko‘ra Creative Commons Attribution 4.0 International (CC BY 4.0).
Tadqiqot turi: Deep reinforcement learning asosidagi uzluksiz elektr bozori bidding modeli; unified matching environment ichida taqqoslama tajriba va ablation tahlili.
Asosiy usul: Deep Deterministic Policy Gradient; Actor–Critic; target networks; experience replay; priority sampling; temporal feature encoding; attention aggregation; gated feature fusion.
Asosiy taqqoslashlar: DQN, PPO va rule-based bidding.
Asosiy natija: Manba tajribasida DDPG %18,7 kumulyativ daromad, 1,64 Sharpe koeffitsiyenti, %9,8 maksimal drawdown va 7,8 ms o‘rtacha decision latency ko‘rsatgan.
Ma’lumot: 168.000 ta 5 daqiqalik market time slice, 42 ta narx o‘zgaruvchisi, oltita bidding feature va 18.400 settlement record.
Ma’lumot kelib chiqishi ogohlantirishi: Manba ma’lumot kirish turlarini batafsil izohlasa-da, muayyan elektr bozorining nomi, geografik hududi va aniq sana oralig‘ini ochiq hisobot qilmaydi.
HFT terminologiyasi ogohlantirishi: 5 daqiqalik state kesimlari ishlatilgani sababli tadqiqotdagi yuqori chastota tushunchasini qimmatli qog‘oz bozorlaridagi mikrosoniyalik limit-order-book HFT ta’rifi bilan bevosita tenglashtirmaslik kerak.
Reproduksiya ogohlantirishi: Ko‘plab asosiy giperparametrlar, tarmoq o‘lchami, random seed va batafsil ma’lumot bo‘lish tartibi hisobot qilinmagani sababli mustaqil reproduksiya cheklangan.
Samaradorlik ogohlantirishi: Manbada “maximum back-off decreases by 13.2%” iborasi mavjud; biroq 4-jadval ushbu foizning tayanch qiymatini aniq qo‘llab-quvvatlamaydi. Shu sabab Verianla bayonida bevosita jadval qiymatlaridan foydalanilgan.
Umumlashtirilish: Natijalar maqoladagi unified matching environment va ma’lumot tuzilmasi bilan cheklangan; haqiqiy elektr bozoridagi jonli savdo samaradorligi sifatida talqin qilinmasligi kerak.
Izoh qoldiring
E-pochta manzilingiz chop etilmaydi. Majburiy maydonlar * bilan belgilangan