

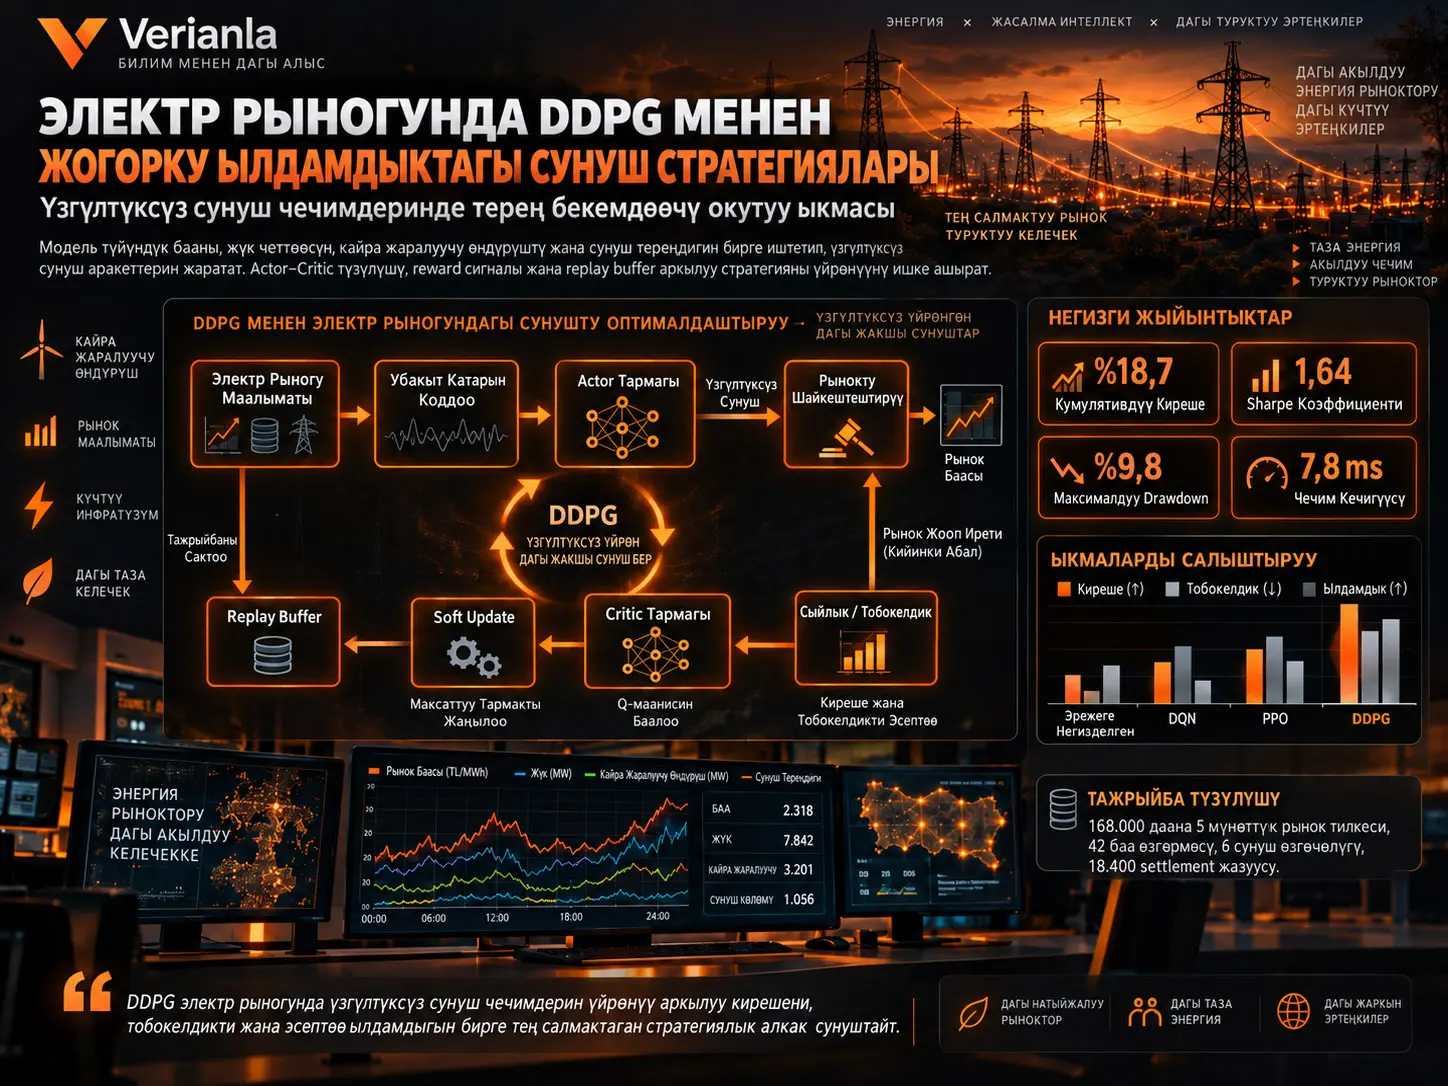
Электр рынокторунда баа, жүк, кайра жаралуучу энергия өндүрүшү жана соода тереңдиги кыска убакыт аралыктарында бирге өзгөрүшү мүмкүн. Бул изилдөө ушундай көп өзгөрмөлүү чөйрөдө сунуш баасы жана сунуш көлөмү сыяктуу үзгүлтүксүз чечимдерди Deep Deterministic Policy Gradient (DDPG) аркылуу үйрөнүүгө болобу деген суроону изилдейт. Сунушталган система түйүндүк маржиналдык электр баасын, жүктүн четтөөсүн, кайра жаралуучу өндүрүштү, сунуш тереңдигин жана таза позиция маалыматтарын убакыт катарларынын өкүлчүлүгүнө айлантат; Actor тармагы үзгүлтүксүз сунуш аракеттерин түзөт, Critic тармагы болсо бул аракеттердин күтүлгөн маанисин баалайт. Киреше, execution четтөөсү, инвентарь басымы жана баа волатилдүүлүгү бир эле reward функциясында чогуу бааланат.
Эксперименттик чөйрө 168.000 даана 5 мүнөттүк рынок убакыт тилкесин, 42 баа өзгөрмөсүн, алты сунуш өзгөчөлүгүн жана 18.400 settlement жазуусун камтыйт. Булакта DDPG үчүн %18,7 кумулятивдүү киреше, 1,64 Sharpe катышы, %9,8 максималдуу drawdown жана 7,8 ms орточо чечим кечигүүсү билдирилет. Ошол эле эксперименттик чөйрөдө DDPG DQN, PPO жана эрежеге негизделген сунуш ыкмаларына караганда жогорку кумулятивдүү киреше жана Sharpe катышын, төмөн максималдуу drawdown алгандыгы айтылат.
Ошол эле учурда изилдөөдөгү “жогорку жыштык” түшүнүгүн этият чечмелөө керек. Рынок абалдары 5 мүнөттүк тилкелер менен көрсөтүлгөндүктөн, эксперимент акция жана крипто рынокторунда колдонулган микросекунддук лимиттик-буйрутма-китеби HFT менен бирдей убакыт масштабында эмес. 7,8 ms мааниси моделдин чечим эсептөө кечигүүсүн билдирет; рынок маалыматынын үлгү алуу интервалы болсо 5 мүнөт. Мындан тышкары, маалымат булагы кайсы реалдуу электр рыногуна тиешелүү экени жана көптөгөн маанилүү окутуу гиперпараметрлери ачык билдирилбегендиктен, натыйжаларды көз карандысыз кайра өндүрүү мүмкүнчүлүгү чектелүү.
Deep Deterministic Policy Gradient (DDPG) үзгүлтүксүз аракет мейкиндиктери үчүн иштелип чыккан model-free, off-policy Actor–Critic бекемдөөчү окутуу ыкмасы. Actor белгилүү рынок абалында кайсы аракет аткарыларын түзөт; Critic болсо ошол абал–аракет жупунун күтүлгөн маанисин баалайт. Experience replay жана жай жаңыртылган target networks окутуунун туруктуулугун колдоо үчүн колдонулат.
| Элемент | Булакта билдирилген маани |
|---|---|
| Рынок тармагы | Электр рыногундагы үзгүлтүксүз сунуш чечимдери |
| Негизги ыкма | Deep Deterministic Policy Gradient (DDPG) |
| Рынок убакыт тилкеси | 168.000 даана 5 мүнөттүк time slice |
| Баа өзгөрмөлөрү | 42 |
| Сунуш өзгөчөлүктөрү | 6 |
| Settlement жазуусу | 18.400 |
| Салыштырылган ыкмалар | Rule-based, DQN, PPO, DDPG |
| DDPG кумулятивдүү кирешеси | %18,7 |
| DDPG Sharpe катышы | 1,64 |
| DDPG максималдуу drawdown | %9,8 |
| DDPG чечим кечигүүсү | 7,8 ms |
Эмне үчүн электр рыногунда сунуш чечими үзгүлтүксүз башкаруу маселеси катары каралат?
Классикалык классификация маселеси “ал”, “сат” же “күт” сыяктуу гана дискреттик варианттарды берет. Электр рыногунун сунуш механизминде чечим көбүнчө татаалыраак. Система сунуш баасын да, сунушталган энергия көлөмүн да аныктап, ошол эле учурда кубаттуулук, позиция жана тобокелдик чектөөлөрүн сакташы керек.
Ошондуктан аракет мейкиндиги:
- сунушталган кубат көлөмү,
- баанын четтөөсү,
- позицияны жөндөө,
- тобокелдикти азайтуу деңгээли
сыяктуу үзгүлтүксүз чоңдуктардан турушу мүмкүн.
DQN сыяктуу ыкмалар негизинен дискреттик аракет тандоого таянат. Үзгүлтүксүз сунуш мейкиндигин DQN менен колдонуу үчүн аракеттерди белгилүү кутуларга бөлүү керек. Бул баа менен көлөмдү бир убакта майда масштабда жөндөө зарыл болгон учурларда чечмелөө тактыгын төмөндөтүшү мүмкүн.
DDPGнин негизги артыкчылыгы — Actor тармагы түздөн-түз үзгүлтүксүз сандык аракетти чыгара алат.
Изилдөөнүн жалпы иштөө цикли
Булактын 1-сүрөтүндө система беш негизги бөлүк катары көрсөтүлгөн:
Маалымат киргизүү → абал түзүү → саясат чыгышы → рынок менен өз ара аракеттенүү → параметр жаңыртуу.
Биринчи этапта системага:
- түйүндүк маржиналдык баа,
- соода натыйжалары,
- жүктүн четтөөсү,
- кайра жаралуучу өндүрүш
сыяктуу рынок агымдары келет.
Маалыматтар sliding window жана normalization операцияларынан кийин жалпы state representation формасына айландырылат. Actor Network бул абалдан үзгүлтүксүз bidding action түзөт. Сунуш рыноктун matching модулунда бааланат. Пайда болгон киреше жана risk feedback Critic тарабынан колдонулат жана тажрыйба replay buffer га жазылат. Андан кийин Actor, Critic жана target network параметрлери жаңыртылат.
DDPG Электр Рыногунун Сунуштарын Кантип Үйрөнөт?
DDPGнин негизинде эки нейрон тармагы турат. Actor рынок абалын аракетке айлантат. Critic болсо Actor чыгарган сунуш учурдагы рынок шартында канчалык баалуу экенин эсептөөгө аракет кылат.
Actorдун милдети болжол менен:
\[ \text{piyasa durumu} \rightarrow \text{teklif fiyatı ve miktarı} \]
дал келүүнү үйрөнүү.
Critic болсо:
\[ Q(s,a) \]
функциясы аркылуу белгилүү \(s\) абалында аткарылган \(a\) аракетинин күтүлгөн узак мөөнөттүү маанисин баалайт.
Убакыт терезеси
Модель учурдагы рынок байкоосун гана колдонбойт. Акыркы \(L\) убакыт тилкесин бир терезеге жайгаштырат:
\[ S_t= \{x_{t-L+1},x_{t-L+2},\ldots,x_t\} \]
Бул жерде \(x_t\) учурдагы рынок байкоосун, \(S_t\) болсо чечим учурундагы тарыхый state window ды билдирет.
Максат — кыска мөөнөттүү баа кыймылдарын, соода интенсивдүүлүгүн жана жүк өзгөрүүлөрүн бир гана чекиттен эмес, жакын өткөндөгү үлгүсүнөн үйрөнүү.
Төрт негизги өзгөчөлүк тобу
Изилдөө киргизүүлөрдү төрт категорияга бөлөт:
- Баа: түйүндүк баалар жана баа четтөөлөрү,
- Соода: соода көлөмү, сунуш кезеги жана execution маалыматы,
- Чектөө: кубаттуулук жана сунуш лимиттери,
- Волатилдүүлүк: рынок термелүүсүн көрсөткөн өзгөрмөлөр.
Бул гетерогендик өзгөрмөлөр жалпы representation мейкиндигине:
\[ z_t= \sigma (W_p p_t+W_v v_t+W_c c_t+W_r r_t+b) \]
аркылуу өткөрүлөт.
Бул операция баа, соода, чектөө жана волатилдүүлүк маалыматтарын саясат тармагына жалпы өлчөмдө жеткирүүнү көздөйт.
Тарыхый маалыматты салмактоо
Модель өзгөчөлүктөрдү гана бириктирбестен, тарыхый трендди, соода feedback маалыматтарын жана constraint маалыматын да state ичине кошот:
\[ h_t= \sum_{i=0}^{L-1}\alpha_i z_{t-i} + \beta\Delta q_t + \gamma\Delta m_t + \eta(z_t\odot u_t) \]
Бул туюнтма жакын өткөндүн ар түрдүү бөлүктөрүнө ар башка салмак берүүгө жана көлөм/баа өзгөрүүлөрүн чечим абалына кошууга мүмкүндүк берет.
Эмне Үчүн Убакыт Катарын Коддоо Колдонулат?
Электр баасы, жүк четтөөсү жана кайра жаралуучу өндүрүш учурдагы маанилери менен гана эмес, бир нече убакыт тилкеси ичинде басып өткөн жолу аркылуу да чечим үчүн мааниге ээ болушу мүмкүн.
Ошондуктан булак изилдөө төрт этаптуу temporal representation түзүмүн түзөт:
- жергиликтүү убакыт үлгүсүн чыгаруу,
- attention aggregation,
- gated fusion,
- policy input mapping.
Attention механизми
Өткөндөгү ар бир убакыт тилкеси учурдагы сунуш үчүн бирдей маанилүү деп күтүлбөйт. Булакта attention салмагы:
\[ \alpha_{t,j} = \frac {\exp(q_tk_j^{T}/\sqrt{d_k})} {\sum_m\exp(q_tk_m^{T}/\sqrt{d_k})} \]
түрүндө эсептелет.
Андан соң тарыхый өкүлчүлүктөр:
\[ c_t= \sum_{j=t-L+1}^{t} \alpha_{t,j}e_j \]
аркылуу бир context vector ичинде бириктирилет.
Ошентип, жакын өткөндөгү баа секириги же соода интенсивдүүлүгү сыяктуу чечим үчүн маанилүүрөөк бөлүктөргө жогорку салмак берүү максат кылынат.
Тобокелдик менен Киреше Бир Reward Функциясында Кантип Бириктирилет?
Эгер бекемдөөчү окутуу алгоритми пайданы гана максималдаштырууга үйрөтүлсө, кыска мөөнөттө өтө агрессивдүү сунуштарды чыгарышы мүмкүн. Ошондуктан изилдөөнүн reward функциясы соода кирешесин гана эмес, execution четтөөсүн, inventory тобокелдигин жана баа волатилдүүлүгүн да жазалайт.
Булакта reward:
\[ r_t= m_t(\pi_t^{clr}-\pi_t^{bid}) -\lambda_1|a_t-m_t| -\lambda_2\max(0,|e_{t+1}|-\bar e) -\lambda_3 Var(\pi_{t-w:t}) \]
түрүндө түзүлгөн.
Бул жерде биринчи бөлүк аткарылган соода көлөмү менен clearing жана bidding баасынын айырмасынан келип чыккан киреше компоненти.
Кийинки мүчөлөр тиешелүүлүгүнө жараша:
- execution / action четтөөсү,
- уруксат берилген чектен ашкан таза позиция,
- жогорку баа дисперсиясы
үчүн жаза колдонот.
Ошентип, модель “кайсы аракет эң көп киреше берет?” деген суроону гана эмес, “киреше алып жатып позиция жана волатилдүүлүк тобокелдигин кантип чектейм?” деген суроону да үйрөнүүгө аракет кылат.
Actor–Critic Архитектурасы Кантип Жаңыртылат?
Үзгүлтүксүз сунуш чыгаруу
Actor тармагы үзгүлтүксүз аракетти белгилүү төмөнкү жана жогорку чек арасында чыгарат:
\[ a_t= \Gamma(W_an_t+b_a) \]
жана булакта масштабдоо функциясы:
\[ \Gamma(x)= l+ \frac{u-l}{2}(1+\tanh(x)) \]
түрүндө берилет.
Мунун аркасында нейрон тармагынын чийки чыгышын рынок уруксат берген сунуш диапазонуна айландырууга болот.
Critic маанисин баалоо
Critic учурдагы рынок абалы менен Actor тандаган сунуштун маанисин:
\[ q_t=Q(y_t,a_t;\theta^Q) \]
аркылуу баалайт.
Target network
Бир кадамдык market reward жогорку волатилдүүлүккө ээ болушу мүмкүн болгондуктан, булак target Actor жана target Critic колдонот:
\[ \hat q_t= r_t+ \gamma Q'(y_{t+1}, \mu'(y_{t+1});\theta^{Q'}) \]
Target тармактарды online тармактар менен бир учурда толук алмаштыруунун ордуна soft update колдонулат:
\[ \theta^{Q'} \leftarrow \tau\theta^Q+(1-\tau)\theta^{Q'} \]
\[ \theta^{\mu'} \leftarrow \tau\theta^\mu+(1-\tau)\theta^{\mu'} \]
Бул ыкма максаттуу маанилердин окутуу учурунда өтө тез өзгөрүшүн чектөөнү көздөйт.
Изилдөөнүн Ыкмасы жана Жыйынтыктары
Эксперименттик маалымат түзүмү
Булакта эксперименттик маалымат топтому:
- 168.000 даана 5 мүнөттүк рынок убакыт тилкеси,
- 42 баа өзгөрмөсү,
- 6 bidding feature,
- 18.400 settlement record
деп сүрөттөлөт.
State input; node marginal price, реалдуу убакыттагы жүк четтөөсү, сунуш тереңдиги, кайра жаралуучу өндүрүш жана таза позициядан турат.
Бирок булакта маалымат топтому кайсы реалдуу электр рыногунан алынганы, географиялык аймагы жана камтыган так даталар аралыгы ачык айтылган эмес. Эксперименттер “unified matching environment” ичинде жүргүзүлөт.
DDPG кандай жыйынтык берди?
| Модель | Кумулятивдүү Киреше | Sharpe | Максималдуу Drawdown | Чечим Кечигүүсү |
|---|---|---|---|---|
| Rule-based | %11,6 | 1,02 | %14,8 | 5,9 ms |
| DQN | %14,2 | 1,21 | %12,9 | 6,8 ms |
| PPO | %16,1 | 1,39 | %11,4 | 8,6 ms |
| DDPG | %18,7 | 1,64 | %9,8 | 7,8 ms |
Булактагы экспериментте DDPG эң жогорку кумулятивдүү киреше жана Sharpe катышына, ошол эле учурда эң төмөн максималдуу drawdown га ээ.
Эрежеге негизделген ыкма 5,9 ms менен эң тез чечим чыгарганы менен, натыйжалуулук жана тобокелдик көрсөткүчтөрүндө алсызыраак жыйынтык берет. DDPGнин 7,8 ms кечигүүсү PPOнун 8,6 ms маанисинен төмөн, DQN жана rule-based ыкмаларынан болсо жогору.
“7,8 ms” чыныгы HFT дегенди билдиреби?
Бул маани моделдин эсептөө/inference кечигүүсүн гана билдирет. Изилдөөдөгү market state маалыматтары 5 мүнөттүк тилкелер менен уюштурулган.
Демек:
5 мүнөттүк рынок байкоосу + 7,8 ms model inference
түзүмү микросекунд деңгээлинде үзгүлтүксүз limit-order-book жаңыртуулары менен иштеген баалуу кагаздар HFT системалары менен түз салыштырылбашы керек.
Электр рыногу контекстинде изилдөөнү кыска убакыт интервалдуу, тез жана үзгүлтүксүз bidding control маселеси катары түшүнүү туурараак.
Модель кайсы рынок шарттарында күчтүүрөөк реакция берди?
Булактын 5-сүрөтүндө баа четтөөсүнө жана нормалдаштырылган соода тереңдигине жараша unit-time return heat map көрсөтүлөт.
Жогорку реакция аймагы:
- оң spread: болжол менен %0,8–%1,6,
- normalize transaction depth: 0,55–0,72
аралыгында топтолот.
Бул аймакта орточо бирдик-убакыт кирешеси 0,041–0,048 деп билдирилет.
Чоку уячада:
- return: 0,052,
- action intensity: 0,81
маанилери берилет.
Ал эми баа четтөөсү %0,3 деңгээлинен же transaction depth 0,30 деңгээлинен төмөндөгөндө моделдин action output у байкаларлык азаят.
Бул жыйынтык үйрөнүлгөн саясат бардык волатилдүүлүк абалдарында максималдуу сунуш чыгаруунун ордуна spread менен рынок тереңдигин чогуу колдонорун көрсөтөт.
Апталык кирешелер
Булактын 6-сүрөтүндөгү 12 тест аптасында DDPG үчүн:
- медианалык апталык киреше: 0,31,
- төмөнкү квартиль: 0,27,
- жогорку квартиль: 0,36,
- эң төмөн апта: 0,18,
- эң жогорку апта: 0,44
деп билдирилет.
DQN жана PPO бөлүштүрүүлөрү да негизинен оң көрүнөт, ал эми rule-based ыкмада төмөнкү чети нөлдөн төмөн түшөт.
Ошентсе да болгону 12 апталык байкоо жана билдирилбеген random-seed кайталоолору себептүү бул boxplot жыйынтыктарын статистикалык тактык же ар башка рынок мезгилдеринде кепилденген артыкчылык катары чечмелөөгө болбойт.
Ablation эксперименттери эмнени көрсөтөт?
| Модель Түзүмү | Киреше | Sharpe | Drawdown | Кечигүү |
|---|---|---|---|---|
| Толук модель | %18,7 | 1,64 | %9,8 | 7,8 ms |
| Убакыт катарын коддоосуз | %15,8 | 1,34 | %12,6 | 7,3 ms |
| Тобокелдик жазасы жок | %17,2 | 1,22 | %13,7 | 7,7 ms |
| Target smoothing жок | %16,0 | 1,31 | %12,8 | 7,6 ms |
| Priority sampling жок | %16,4 | 1,36 | %12,1 | 7,5 ms |
Ablation жыйынтыктарынын эң ачык мисалдарынын бири risk penalty компоненти. Тобокелдик жазасы алынып салынганда киреше %17,2 менен салыштырмалуу жогору бойдон калат, бирок максималдуу drawdown %9,8 деңгээлинен %13,7 деңгээлине өсөт жана Sharpe катышы 1,64 маанисинен 1,22 маанисине түшөт.
Бул жыйынтык изилдөө дизайнында чийки кирешени гана максималдаштыруу жетишсиз экенин жана reward ичиндеги тобокелдик түзөтүүсү стратегиянын жүрүм-турумуна олуттуу таасир берерин колдойт.
Priority sampling
Булак кадимки replay sampling ордуна убакыт жаңылыгын, temporal-difference error жана risk exposure колдонгон үлгүлөө салмагын аныктайт:
\[ \omega_i= \frac{ (\nu_i+\kappa_1|\delta_i|+\kappa_2r_i^{risk})^\zeta }{ \sum_{j=1}^{N} (\nu_j+\kappa_1|\delta_j|+\kappa_2r_j^{risk})^\zeta } \]
Ошентип, жогорку волатилдүүлүк, жогорку prediction error же жогорку тобокелдик алып жүргөн үлгүлөрдү окутуу batch тарында көбүрөөк көрүнүктүү кармоо максат кылынат.
Аракеттин үзгүлтүксүздүк чектөөсү
Изилдөө Actor жаңыртуусуна ырааттуу сунуштар ортосундагы чоң секириктерди жазалай турган кошумча regularization мүчөсүн кошот:
\[ \|\mu(y_i)-\mu(y_{i-1})\|_2^2 \]
Бул мүчөнүн максаты киреше өсүшү изделип жатканда сунуш баасынын же көлөмүнүн ырааттуу чечимдер арасында керексиз түрдө кескин өзгөрүшүн азайтуу.
DDPGнин Жогорку Кирешесин Реалдуу Рынокто Да Ошол Сыяктуу Күтүүгө Болобу?
Жок. Изилдөө белгилүү unified matching environment ичинде DDPG башка үч ыкмага караганда жакшы натыйжа бергенин билдирет. Бул жыйынтык бардык реалдуу электр рынокторуна же башка жөнгө салуу түзүмү бар рынокторго автоматтык түрдө жалпыланбайт.
Мунун бир нече себеби бар:
- Маалымат топтомунун белгилүү рыноктук жана географиялык булагы ачык аныкталган эмес.
- Ар башка электр рынокторунун сунуш, settlement жана кубаттуулук эрежелери өзгөрүшү мүмкүн.
- Модель single-agent түзүмүндө.
- Атаандаш рынок катышуучуларынын стратегиялык адаптациясы толук моделделбейт.
- Extreme-tail shock түзүмүн reward моделинде кененирээк кароо керек экенин булак өзү моюнга алат.
- Cross-region жана cross-market текшерүү жүргүзүлгөн эмес.
- Random-seed кайталоолору жана confidence intervals билдирилген эмес.
- Негизги окутуу гиперпараметрлеринин маанилүү бөлүгү сандык түрдө берилген эмес.
“%13,2 төмөн drawdown” билдирүүсү тууралуу эскертүү
Булак тексттин жыйынтык бөлүмүндө максималдуу артка тартылуу %13,2 азайганын айтат. Бирок 4-таблицада максималдуу drawdown маанилери Rule-based үчүн %14,8, DQN үчүн %12,9, PPO үчүн %11,4 жана DDPG үчүн %9,8.
Бул таблицадан түздөн-түз:
- Rule-based → DDPG айырмасы: 5,0 пайыздык пункт,
- DQN → DDPG айырмасы: 3,1 пайыздык пункт,
- PPO → DDPG айырмасы: 1,6 пайыздык пункт
деп эсептелет.
Булак %13,2 мааниси кайсы салыштыруу базасына карата эсептелгенин айтпагандыктан, Verianla бул катышты көз карандысыз натыйжалуулук жыйынтыгы катары кайталабайт.
Изилдөөнүн күчтүү жактары
- Электр рыногундагы bidding маселесин үзгүлтүксүз аракет мейкиндиги катары моделдештириши.
- Баа, соода, чектөө жана тобокелдик өзгөрмөлөрүн бир state түзүмүндө бириктириши.
- Actor–Critic, replay buffer жана target network түзүмүн жабык циклдүү рынок чөйрөсү менен бириктириши.
- Киреше менен катар drawdown жана latency көрсөткүчтөрүн билдириши.
- DQN, PPO жана rule-based салыштырууларын бирге бериши.
- Төрт маанилүү модуль үчүн ablation экспериментинин жүргүзүлүшү.
Негизги методологиялык чектөөлөр
- “HFT” деп аталган market input 5 мүнөттүк убакыт тилкелери менен көрсөтүлүшү.
- Маалымат кайсы рыноктон жана кайсы даталардан алынганы жетиштүү түшүндүрүлбөшү.
- Train/validation/test бөлүштүрүүсү толук берилбеши.
- Actor жана Critic тармак архитектурасынын катмар өлчөмдөрү билдирилбеши.
- Learning rate, discount factor, soft-update coefficient жана replay-buffer сыйымдуулугу сыяктуу негизги маанилердин жетишсиздиги.
- Exploration noise түзүмү толук түшүндүрүлбөшү.
- Салыштыруу моделдеринин hyperparameter tuning процесси берилбеши.
- Бир нече random seed жана confidence interval билдирилбеши.
- 12 апталык тест бөлүштүрүүсү узак мөөнөттүү рынок режимдерин чагылдыруу үчүн чектелүү болушу.
- Single-agent ыкмасы стратегиялык атаандаш жүрүм-турумун чектелүү көрсөтүшү.
Булак жана Ыкма Жөнүндө Эскертүү
Түпнуска аталышы: Exploration of deep deterministic policy gradient algorithm in high-frequency trading strategy in power market
Автор: Yunpeng Feng.
Мекеме: School of Automation Science and Engineering, South China University of Technology, Guangzhou, Guangdong, China.
Журнал: Ingegneria Sismica – International Journal of Earthquake Engineering.
Том / саны: Volume 43 / Issue 2; PDF ичинде Anno XLIII – Num. 2 – 2026.
Барактар: 1–23.
Жарыяланган күнү: 30 Апрель 2026.
DOI: 10.65102/is2026549.
Лицензия: Журналдын расмий copyright саясатына ылайык Creative Commons Attribution 4.0 International (CC BY 4.0).
Изилдөө түрү: Deep reinforcement learning негизиндеги үзгүлтүксүз электр рыногунун bidding модели; unified matching environment ичинде салыштырма эксперимент жана ablation анализи.
Негизги ыкма: Deep Deterministic Policy Gradient; Actor–Critic; target networks; experience replay; priority sampling; temporal feature encoding; attention aggregation; gated feature fusion.
Негизги салыштыруулар: DQN, PPO жана rule-based bidding.
Негизги жыйынтык: Булактагы экспериментте DDPG %18,7 кумулятивдүү киреше, 1,64 Sharpe катышы, %9,8 максималдуу drawdown жана 7,8 ms орточо decision latency көрсөткөн.
Маалымат: 168.000 даана 5 мүнөттүк market time slice, 42 баа өзгөрмөсү, алты bidding feature жана 18.400 settlement record.
Маалыматтын келип чыгышы боюнча эскертүү: Булак маалымат киргизүү түрлөрүн толук түшүндүргөнү менен, белгилүү электр рыногунун атын, географиялык аймакты жана так даталар аралыгын ачык билдирбейт.
HFT терминологиясы боюнча эскертүү: 5 мүнөттүк state тилкелери колдонулгандыктан, изилдөөдөгү жогорку жыштык түшүнүгү баалуу кагаздар рынокторундагы микросекунддук limit-order-book HFT аныктамасы менен түздөн-түз теңдештирилбеши керек.
Кайра өндүрүү боюнча эскертүү: Көптөгөн негизги гиперпараметрлер, тармак өлчөмү, random seed жана толук маалымат бөлүштүрүү процедурасы билдирилбегендиктен, көз карандысыз кайра өндүрүү чектелүү.
Натыйжалуулук боюнча эскертүү: Булакта “maximum back-off decreases by 13.2%” деген билдирүү бар; бирок 4-таблица бул пайыздын таяныч маанисин ачык колдобойт. Ошондуктан Verianla баянында түздөн-түз таблица маанилери колдонулган.
Жалпылануу: Жыйынтыктар макаладагы unified matching environment жана маалымат түзүмү менен чектелет; реалдуу электр рыногундагы жандуу соода натыйжалуулугу катары чечмеленбеши керек.
Пикир калтырыңыз
E-mail дарегиңиз жарыяланбайт. Милдеттүү талаалар * менен белгиленген