

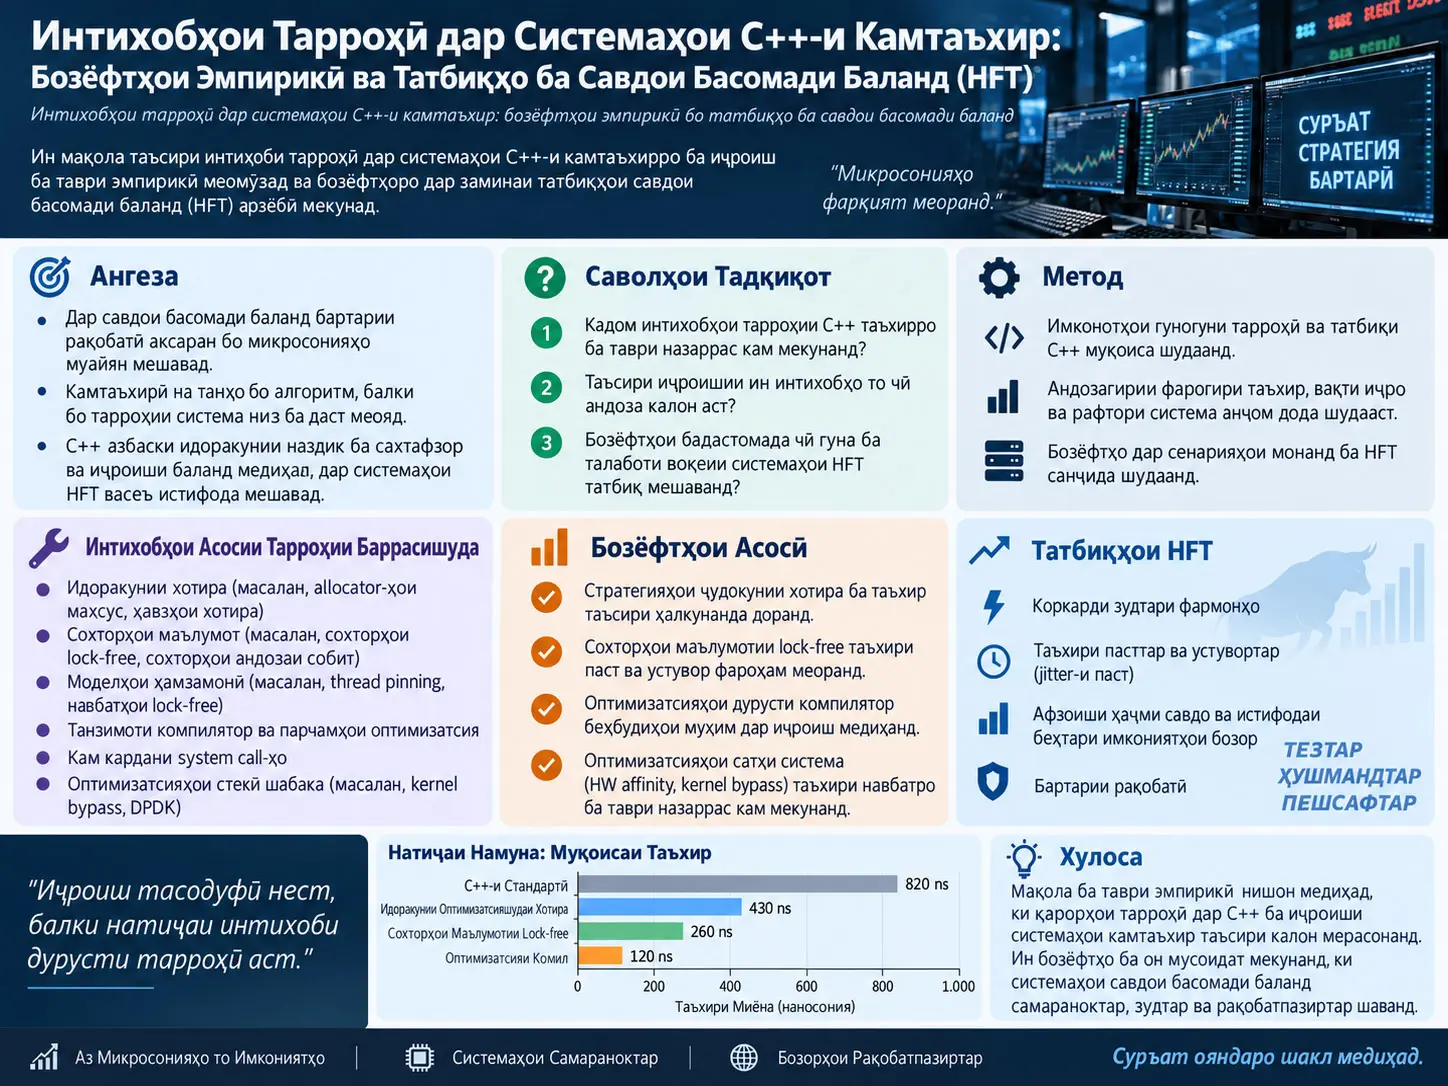
Дар системаҳои савдои басомади баланд, иҷроиш танҳо аз суръати як алгоритм вобаста нест. Таъхири tick-to-trade, яъне вақт аз расидани бастаи маълумоти бозор то фиристодани фармони мувофиқ, натиҷаи муштараки scheduler-и системаи амалиётӣ, interrupts, kernel housekeeping, page faults, рафтори TLB, cache locality, ҷараёни идоракунии C++, ҷудокунии хотира, thread synchronization ва стеки протоколи шабака мебошад.
Кори Khalid Mohammad ин қабатҳоро бо микроbenchmark-ҳои ҷудогона месанҷад ва нишон медиҳад, ки кадом интихобҳои тарроҳӣ ба таъхири маъмулӣ ва кадомҳо ба tail latency — ҷаҳишҳои камёб, вале хеле бузурги таъхир — таъсир мекунанд.
Хулосаи муҳим ин аст, ки як “беҳтарин оптимизатсия” вуҷуд надорад. Real-time scheduler median wakeup latency-ро кам мекунад, вале tail-ҳои чуқурро танҳо нест намекунад. Баръакс, CPU isolation дар сатҳи kernel, ҷудокунии RCU/workqueue ва interrupt steering p99.9 ва p99.99-ро қавитар фишурда мекунанд.
Дар хотира, пешакӣ populate кардани саҳифаҳо first-touch cost-и тақрибан 2 µs-ро дар таҷриба то сатҳи тақрибан 20 ns расонд. Explicit 2 MB HugeTLB нисбати 4 KB pageҳо TLB miss rate-ро аз %1,33 ба %0,09 ва cycles/access-ро аз тақрибан 290 ба 43,12 фаровард.
Дар C++ натиҷаҳо нозуктаранд: stateless lambda ба inline function наздик аст, аммо std::function тақрибан 5,68× гаронтар. dynamic_cast-и RTTI нисбати explicit tagging тақрибан 3,6× cycle бештар истифода кардааст. Object pool нисбати new/delete умумӣ тақрибан 3,7× тезтар аст ва tail latency-и heap allocation баландтар мемонад.
Data-oriented design нишон медиҳад, ки ҷойгиршавии маълумот метавонад аз қудрати ҳисоббарории CPU муҳимтар бошад. Sequential access ≈5,35 cycles/access аст, random pointer chasing бошад ≈378 cycles/access. False sharing вақти иҷроишро тақрибан 7,5× зиёд кардааст.
Дар шабака, Linux UDP path бо AF_XDP дар як мошин бо network namespace ва veth муқоиса шудааст. Kernel path миёна ≈200 µs буд, AF_XDP бошад ≈8 µs; p50 аз ≈218 µs ба 6 µs поён рафт. Бо вуҷуди ин p99-и AF_XDP ≈80 µs монд; bypass-и kernel tail latency-ро пурра нест намекунад.
Паёми муҳандисии манбаъ чунин аст: таъхири паст аз як функсияи тез не, балки аз хориҷ кардани манбаъҳои номуайяни slow path аз роҳи критикӣ ба вуҷуд меояд.
Меъёри асосӣ дар системаҳои камтаъхир чист?
Дар нармафзори умумӣ throughput ё шумори умумии амалиёт кофӣ буда метавонад. Дар HFT ҳатто як ҷаҳиши камёби таъхир аҳамияти иқтисодӣ дорад. Барои ҳамин бояд тамоми занҷири p50 → p99 → p99.9 → p99.99 → maximum дида шавад.
Оё scheduler танҳо кофӣ аст?
Не. Дар cyclictest, SCHED_FIFO барои wakeup latency-и маъмулӣ аз CFS тезтар аст, аммо tail-и чуқур аз interference-и kernel низ вобаста мебошад.
| Percentile | CFS | CFS Tuned | SCHED_FIFO |
|---|---|---|---|
| p50 | 55 µs | 55 µs | 5 µs |
| p99 | 67 µs | 811 µs | 15 µs |
| p99.9 | 1383 µs | 929 µs | 1287 µs |
| p99.99 | 3386 µs | 1916 µs | 2673 µs |
CPU isolation ва interrupt steering
Ҳатто thread-и pinшуда метавонад аз timer tick, RCU callback, kernel workqueue ё hardware interrupt қатъ шавад. Комбинатсияи isolcpus, nohz_full, rcu_nocbs, cpuset/cgroup ва workqueue relocation ядрои latency-critical-ро аз housekeeping ҷудо мекунад.
| Percentile | CFS | CFS + Isolation | RT | RT + Isolation |
|---|---|---|---|---|
| p50 | 55 µs | 55 µs | 5 µs | 5 µs |
| p99 | 67 µs | 61 µs | 15 µs | 10 µs |
| p99.9 | 1383 µs | 77 µs | 1287 µs | 33 µs |
| p99.99 | 3386 µs | 201 µs | 2673 µs | 174 µs |
| Меъёр | Бе isolation | Isolation | Isolation + IRQ Steering |
|---|---|---|---|
| p99.9 | 1287 µs | 33 µs | 40 µs |
| p99.99 | 2673 µs | 174 µs | 109 µs |
| Maximum | 4673 µs | 564 µs | 399 µs |
Median қариб тағйир намеёбад, аммо p99.9 ва p99.99 сахт беҳтар мешаванд. Як percentile тамоми тасвирро намедиҳад.
Page fault, huge pages ва VM tuning
Дар 512 MB anonymous mapping тақрибан 131.000 minor page fault мушоҳида шуда, first-touch cost тақрибан 2 µs барои ҳар саҳифа буд. MAP_POPULATE онро то 20 ns дар steady-state коҳиш дод.
| Сохтори саҳифа | Cycles / Access | dTLB Miss Rate |
|---|---|---|
| 4 KB | ≈290 | ≈%1,33 |
| Transparent Huge Pages | ≈241 | ≈%0,47 |
| Explicit HugeTLB 2 MB | 43,12 | %0,09 |
Explicit HugeTLB cycles/access-ро 6–7× кам мекунад. THP метавонад дар пасзамина collapse, split ва memory compaction иҷро карда, дар fragmented memory tail spike-и миллисониявӣ эҷод кунад.
| Percentile | Пешфарз | Пас аз VM tuning |
|---|---|---|
| p50 | 92 µs | 30 µs |
| p99 | 204 µs | 556 µs |
| p99.9 | 4415 µs | 4898 µs |
| p99.99 | 7630 µs | 7076 µs |
| Maximum | 9230 µs | 8013 µs |
Median беҳтар мешавад, вале p99 ва p99.9 бадтар. Аз ин рӯ hot path бояд аз runtime allocation дур бошад.
Mitigations, C-state ва C++
| Меъёр | Mitigations ON | Mitigations OFF |
|---|---|---|
| Raw syscall | 2850 cycles | 306 cycles |
| libc syscall | 2815 cycles | 278 cycles |
| Context switch | 24.301 cycles | 14.829 cycles |
| sched pipe | 7,76 µs/op | 4,76 µs/op |
Хомӯш кардани mitigations арзиши syscall ва context switch-ро кам мекунад, аммо хатари амниятиро зиёд мекунад; ин тавсияи умумӣ нест.
| Ҳолат | p99 | p99.9 | p99.99 |
|---|---|---|---|
| C-state ON / Idle | 54 µs | 57 µs | 175 µs |
| C-state OFF / Idle | 54 µs | 55 µs | 58 µs |
| C-state ON / Stress | 77 µs | 144 µs | 182 µs |
| C-state OFF / Stress | 70 µs | 149 µs | 197 µs |
| Dispatch | 1 навъ | 4 навъ | 8 навъ |
|---|---|---|---|
| Static | 1,32 ms | 8,75 ms | 10,02 ms |
| Virtual | 1,94 ms | 9,19 ms | 10,38 ms |
Virtual dispatch дар як навъ тақрибан 1,47× гаронтар аст. Аммо дар ABI-stable interfaces, plugin systems ва cold path dynamic polymorphism ҳанӯз метавонад дуруст бошад.
| Move | Wall Time |
|---|---|
| noexcept move | 101,6 s |
| non-noexcept move | 263,4 s |
| Callable | Relative Cost |
|---|---|
| Inline function | 1,00× |
| Stateless lambda | 1,03× |
| std::function | 5,68× |
noexcept дар std::vector reallocation 2,6× фарқ додааст. std::function аз lambda гаронтар аст, зеро type erasure ва indirect dispatch дорад. dynamic_cast низ нисбати explicit tagging харҷи бештар дорад.
PGO, allocation, cache ва concurrency
| Меъёр | Baseline | PGO |
|---|---|---|
| Execution Time | 1,791 s | 1,766 s |
| Cycles | 6,20 B | 6,11 B |
| Instructions | 12,77 B | 11,07 B |
| LLC Load Misses | 419 K | 398 K |
| Амалиёт | Median | p99.9 | Maximum |
|---|---|---|---|
| new | 82 cycles | 8586 cycles | 172.401 cycles |
| Pool allocate | 32 cycles | 246 cycles | 81.756 cycles |
| delete | 60 cycles | 433 cycles | 73.471 cycles |
| Pool deallocate | 34 cycles | 262 cycles | 52.153 cycles |
Object pool асосан дар tail фоида медиҳад. Sequential array ≈5,35 cycles/access, random pointer chasing ≈378 cycles/access; фарқ қариб 70×.
| Навъи дастрасӣ | Cycles / Access |
|---|---|
| Sequential array | ≈5,35 |
| Random pointer chasing | ≈378 |
Ҷудо кардани hot/cold data вақтро аз 1,08746 s ба 0,91845 s овард; cache misses аз 7,8×10⁷ ба 3,5×10⁷ поён рафт. False sharing бошад 4,16 s, cache-line padded 0,55 s буд.
| Тарҳ | Cycles | Вақт |
|---|---|---|
| False sharing | 2,73×10¹⁰ | 4,16 s |
| Cache-line padded | 3,61×10⁹ | 0,55 s |
AoS тақрибан 258 ms, SoA 145 ms буд. SIMD scalar 406 ms ва AVX 370 ms аст; беҳбудӣ тақрибан %7.
| Амалиёт | p50 | p99.9 | p99.99 |
|---|---|---|---|
| Lock Push | 80 | 17.785 | 32.115 cycles |
| Lock-Free Push | 47 | 294 | 378 cycles |
| Lock Pop | 81 | 12.958 | 46.048 cycles |
| Lock-Free Pop | 25 | 226 | 278 cycles |
Lock-free дар SPSC ring buffer tail-ро беҳтар мекунад, вале дар contention-и баланд CAS retry метавонад аз mutex бадтар шавад.
AF_XDP
Linux receive path: NIC → Driver → sk_buff → IP/UDP Stack → Socket → System Call → User Space. AF_XDP path: NIC → XDP → AF_XDP → UMEM → User Space.
| Роҳи шабака | Mean | p50 | p99 |
|---|---|---|---|
| Kernel Stack | ≈200 µs | ≈218 µs | ≈300 µs |
| AF_XDP | ≈8 µs | ≈6 µs | ≈80 µs |
Ин benchmark production HFT network нест; он namespace/veth дар як мошинро месанҷад.
Усул ва қайди манбаъ
| Ҷузъ | Муҳити истифодашуда |
|---|---|
| CPU | Intel Core i5-6500 @ 3,20 GHz |
| Ядро | 4 core / 1 thread per core |
| RAM | 3,7 GiB |
| NUMA | Як node |
| Linux kernel | 6.8.0-90-generic |
| Compiler | GCC 13.3.0 |
| Default build | -O2 |
| CPU governor | performance |
Сарлавҳаи аслӣ: Design Choices in Low-Latency C++ Systems: Empirical Insights with Applications to High-Frequency Trading
Муаллиф: Khalid Mohammad. Муассиса: Department of Computer Science, Indian Institute of Technology Kharagpur. Сана: 3 апрели 2026; SSRN: 17 апрели 2026; SSRN ID: 6513601; DOI: 10.2139/ssrn.6513601.
Навъи нашр: Preprint. Натиҷаҳо ба як Intel i5-6500 ва версияҳои муайяни Linux/GCC маҳдуданд; AF_XDP дар namespace/veth санҷида шудааст; тадқиқот trading alpha ё даромади стратегияро намесанҷад.
Шарҳ гузоред
Нишонии почтаи электронии шумо нашр намешавад. Майдонҳои ҳатмӣ бо * нишон дода шудаанд