

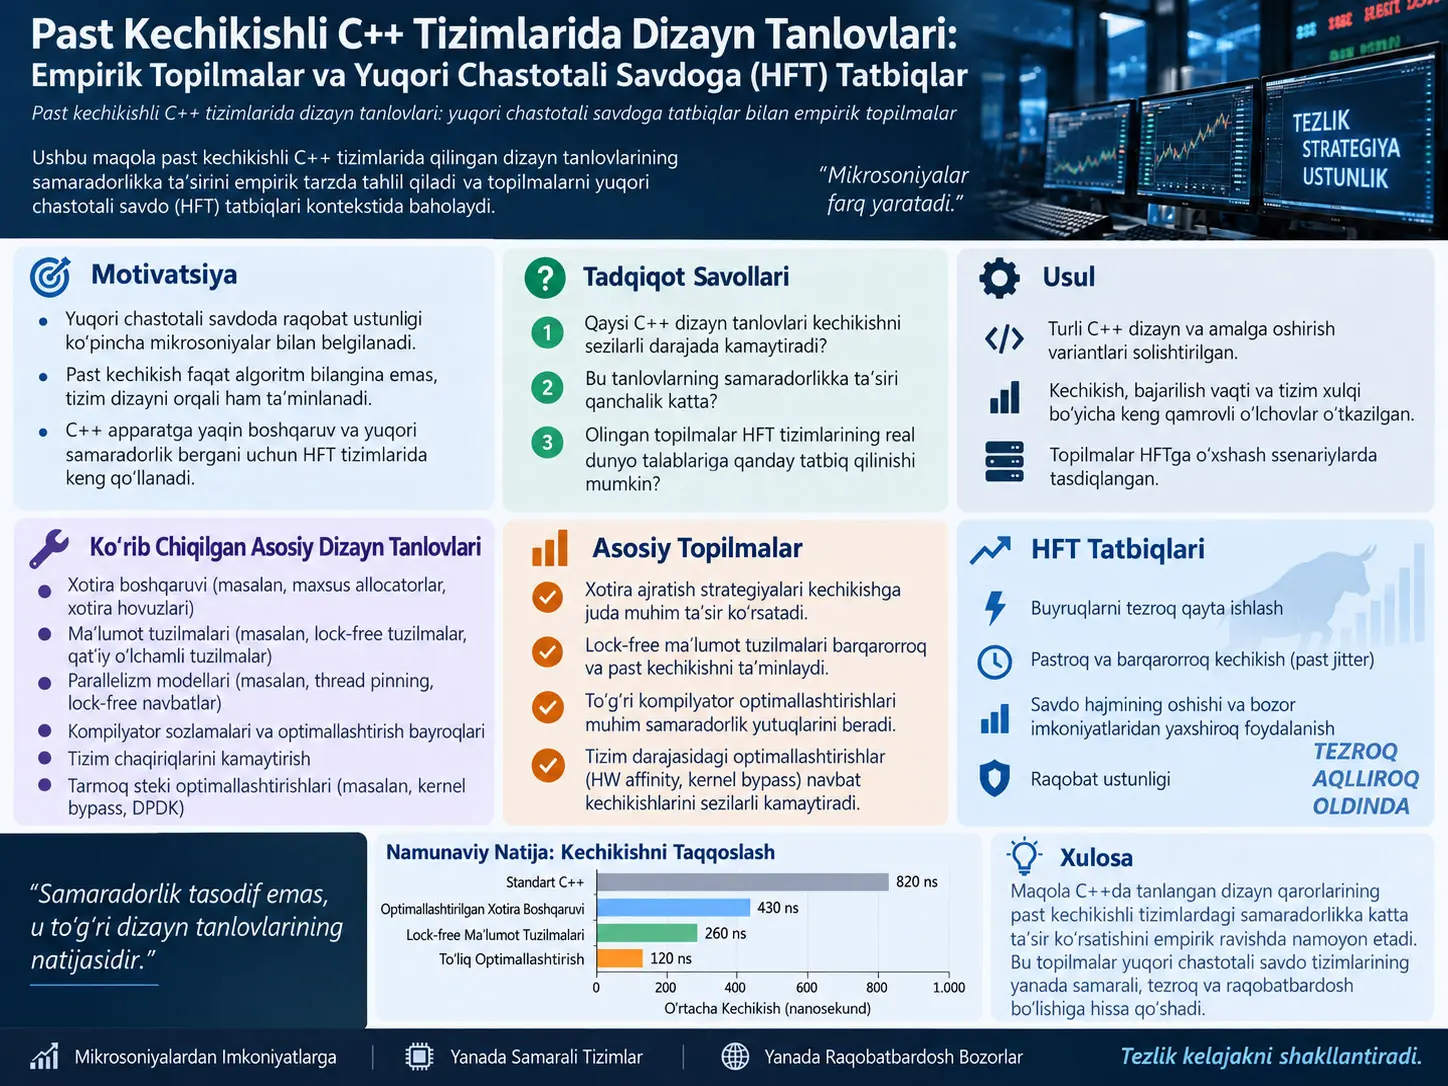
Yuqori chastotali savdo tizimlarida samaradorlik faqat bitta algoritm qanchalik tez ishlashiga bogʻliq emas. Bozor maʼlumotlari paketi tizimga kelgan paytdan unga mos buyruq tashqariga yuborilguniga qadar oʻtadigan tick-to-trade kechikishi operatsion tizim scheduler’i, interrupts, kernel housekeeping, page faults, TLB xatti-harakati, cache locality, C++ boshqaruv oqimi, xotira ajratish, thread synchronization va tarmoq protokol steki kabi koʻplab qatlamlarning qoʻshma natijasidir.
Khalid Mohammadning tadqiqoti shu qatlamlarni alohida mikrobenchmarklar orqali tekshiradi va past kechikishli dasturiy injiniringda qaysi dizayn tanlovlari odatiy kechikishga, qaysilari esa tail latency deb ataladigan kam uchraydigan, lekin juda katta kechikish sakrashlariga taʼsir qilishini oʻrganadi.
Asosiy xulosa shuki, yagona “eng yaxshi optimallashtirish” yoʻq. Real-time scheduler median wakeup latency’ni kuchli kamaytiradi, ammo juda chuqur tail holatlarini oʻzi yoʻq qila olmaydi. Kernel darajasidagi CPU isolation, RCU/workqueue ajratish va interrupt steering esa p99.9 hamda p99.99 kechikishlarini ancha kuchli siqadi.
Xotira tomonida sahifalarga birinchi murojaatda page fault yuzaga keltirish oʻrniga ularni oldindan populate qilish tajribada taxminan 2 µs first-touch xarajatini 20 ns atrofidagi kirish darajasiga tushirgan. Explicit 2 MB HugeTLB 4 KB sahifalarga nisbatan TLB miss nisbatini %1,33 dan %0,09 ga, cycles/access qiymatini esa taxminan 290 dan 43,12 ga kamaytirgan.
C++ qatlamida natijalar nozikroq. Stateless lambda bevosita ishlatilganda inline function’ga yaqin xarajatga ega, std::function esa shu tajribada taxminan 5,68× qimmatroq. RTTI asosidagi dynamic_cast explicit tagging’ga nisbatan taxminan 3,6× koʻproq cycle ishlatgan. Object pool umumiy new/delete ajratishiga nisbatan taxminan 3,7× tezlanish bergan; heap allocation’ning tail latency’si esa pool yondashuvidan ancha yuqori qolgan.
Data-oriented dizayn natijalari maʼlumot qanday joylashtirilishi protsessor hisoblash kuchidan ham muhim boʻlishi mumkinligini koʻrsatadi. Ketma-ket xotira kirishi taxminan 5,35 cycles/access boʻlsa, random pointer chasing taxminan 378 cycles/access talab qilgan. False sharing ikki threadli tajribada ish vaqtini taxminan 7,5× oshirgan; Structure of Arrays esa Array of Structures’ga qaraganda risk hisoblash siklini tezroq tugatgan.
Tarmoq qatlamida tadqiqot oddiy Linux UDP yoʻli bilan AF_XDP yoʻlini bitta mashinadagi network namespace va veth muhitida taqqoslaydi. Standart kernel yoʻlida oʻrtacha kechikish taxminan 200 µs boʻlsa, AF_XDP’da taxminan 8 µs ga tushadi; p50 ham taxminan 218 µs dan 6 µs ga kamayadi. Shunga qaramay AF_XDP p99 qiymati taxminan 80 µs boʻlib qoladi; yaʼni kernelning katta qismini bypass qilish tail latency’ni butunlay yoʻqotmaydi.
Manbaning umumiy injiniring xulosasi shunday: past kechikish bitta tez funksiyadan emas, balki kritik yoʻldagi noaniqlik manbalarini tizimli ravishda olib tashlashdan paydo boʻladi.
Past kechikishli tizimlarda asosiy mezon nima?
Umumiy maqsadli dasturlarda oʻrtacha throughput yoki umumiy operatsiyalar soni koʻpincha yetarli koʻrsatkich boʻladi. HFT tizimlarida esa kam uchraydigan bitta kechikish sakrashi ham iqtisodiy jihatdan muhim boʻlishi mumkin.
Shuning uchun faqat oʻrtacha latency emas, balki p50 → p99 → p99.9 → p99.99 → maksimum kechikish zanjiri birgalikda baholanishi kerak.
Scheduler tanlashning oʻzi past kechikish beradimi?
Yoʻq. cyclictest tajribasida SCHED_FIFO odatiy wakeup latency boʻyicha CFS’dan ancha tez, ammo chuqur tail holatlarida scheduler tanlovidan tashqari kernel interference ham rol oʻynaydi.
| Percentile | CFS | CFS Tuned | SCHED_FIFO |
|---|---|---|---|
| p50 | 55 µs | 55 µs | 5 µs |
| p99 | 67 µs | 811 µs | 15 µs |
| p99.9 | 1383 µs | 929 µs | 1287 µs |
| p99.99 | 3386 µs | 1916 µs | 2673 µs |
SCHED_FIFO p50 ni 55 µs dan 5 µs ga tushiradi, lekin p99.9 hali ham 1287 µs boʻlgani eng katta ogʻishlar faqat scheduler navbatidan kelmasligini bildiradi. Tuned CFS misolida p99.9 va p99.99 yaxshilansa-da, p99 67 µs dan 811 µs ga koʻtariladi; demak latency tuning butun taqsimotni bitta yoʻnalishda siljitmasligi mumkin.
CPU isolation tail latency’ga nega kuchli taʼsir qiladi?
Thread maʼlum CPU’ga pin qilingan boʻlsa ham, shu yadro timer tick, RCU callback, kernel workqueue yoki hardware interrupt bilan boʻlinishi mumkin. Tadqiqot isolcpus, nohz_full, rcu_nocbs, cpuset/cgroup va workqueue relocation’ni birga ishlatib, latency-critical yadroni kernel housekeeping faoliyatidan ajratishni maqsad qilgan.
| Percentile | CFS | CFS + Isolation | RT | RT + Isolation |
|---|---|---|---|---|
| p50 | 55 µs | 55 µs | 5 µs | 5 µs |
| p99 | 67 µs | 61 µs | 15 µs | 10 µs |
| p99.9 | 1383 µs | 77 µs | 1287 µs | 33 µs |
| p99.99 | 3386 µs | 201 µs | 2673 µs | 174 µs |
Bu yerda median deyarli oʻzgarmaydi, p99.9 va p99.99 esa keskin kichrayadi. Manbaning markaziy tezisi shunday: scheduler odatiy kechikishni, isolation esa ayniqsa ultra-tail xatti-harakatini kuchli belgilaydi.
Interrupt steering nimani qoʻshadi?
IRQ’larni latency-sensitive CPU’dan uzoqlashtirish chuqur quyruqni yanada siqadi.
| Oʻlchov | Isolation yoʻq | Isolation | Isolation + IRQ Steering |
|---|---|---|---|
| p99.9 | 1287 µs | 33 µs | 40 µs |
| p99.99 | 2673 µs | 174 µs | 109 µs |
| Maximum | 4673 µs | 564 µs | 399 µs |
p99.9 biroz oshsa ham p99.99 va maksimum yanada kamayadi; shuning uchun bitta percentile optimallashtirishning toʻliq tasviri boʻla olmaydi.
Page fault hot path’da nega muammo?
Linux anonymous memory’ni odatda demand paging bilan bogʻlaydi. Dastur sahifaga birinchi marta tegsa, page fault yuzaga keladi va kernel fizik sahifani ajratib, nolga tozalashi kerak boʻladi. 512 MB anonymous mapping tajribasida taxminan 131.000 minor page fault kuzatilgan va birinchi murojaat narxi sahifa boshiga taxminan 2 µs boʻlgan. MAP_POPULATE bilan esa steady-state birinchi kirish taxminan 20 ns gacha tushgan.
Prefaulting memory pressure muammosini hal qilmaydi; kernel shu xotirani reclaim qilishga urinishi mumkin. Shuning uchun mlock/mlockall xotirani fizik RAM’da ushlab turish vositasi sifatida baholangan.
Huge pages haqiqatan farq yaratadimi?
256 MB working set va 4 KB stride tajribasida:
| Sahifa tuzilishi | Cycles / Access | dTLB Miss Rate |
|---|---|---|
| 4 KB | ≈290 | ≈%1,33 |
| Transparent Huge Pages | ≈241 | ≈%0,47 |
| Explicit HugeTLB 2 MB | 43,12 | %0,09 |
Explicit HugeTLB 4 KB sahifalarga qaraganda cycles/access qiymatini taxminan 6–7 baravar kamaytiradi. THP esa fon rejimida collapse, split va memory compaction qilishi sababli xotira parchalanishi sharoitida millisekundli tail spike yaratishi mumkin; pre-reserved HugeTLB bunday runtime promotion mexanizmiga muhtoj emas.
Xotira sozlamalarini oʻzgartirish yetarlimi?
Allocator-pressure testi javobning asosan “yoʻq” ekanini koʻrsatadi.
| Percentile | Default | VM tuningdan keyin |
|---|---|---|
| p50 | 92 µs | 30 µs |
| p99 | 204 µs | 556 µs |
| p99.9 | 4415 µs | 4898 µs |
| p99.99 | 7630 µs | 7076 µs |
| Maximum | 9230 µs | 8013 µs |
Median yaxshilanadi, lekin p99 va p99.9 yomonlashadi; extreme-tail faqat cheklangan darajada yaxshilanadi. Shuning uchun latency-critical hot path ichida runtime allocation qilishdan koʻra xotirani oldindan ajratish ishonchliroq.
Spectre va Meltdown mitigations kechikishga qanday taʼsir qiladi?
Manba KPTI, IBRS, IBPB va boshqa speculative-execution mitigations kernel privilege transition xarajatini oʻlchaydi.
| Oʻlchov | Mitigations ON | Mitigations OFF |
|---|---|---|
| Raw syscall | 2850 cycles | 306 cycles |
| libc syscall | 2815 cycles | 278 cycles |
| Context switch | 24.301 cycles | 14.829 cycles |
| sched pipe | 7,76 µs/op | 4,76 µs/op |
Raw syscall xarajati taxminan %89, context switch xarajati taxminan %39 kamayadi. Bu faqat performans oʻlchovi; mitigations’ni oʻchirish protsessorni maʼlum speculative-execution hujumlariga nisbatan zaiflashtirishi mumkin.
C-state va CPU chastota boshqaruvi doimo oʻchirilishi kerakmi?
Manbaning oʻlchovlari bunday umumlashtirishni qoʻllab-quvvatlamaydi.
| Holat | p99 | p99.9 | p99.99 |
|---|---|---|---|
| C-state ON / Idle | 54 µs | 57 µs | 175 µs |
| C-state OFF / Idle | 54 µs | 55 µs | 58 µs |
| C-state ON / Stress | 77 µs | 144 µs | 182 µs |
| C-state OFF / Stress | 70 µs | 149 µs | 197 µs |
Idle muhitda chuqur C-state’larni oʻchirish p99.99 ni kuchli kamaytiradi, ammo tizim allaqachon stress ostida boʻlsa, foyda koʻrinmaydi va ayrim tail oʻlchovlari biroz yomonlashadi.
C++ qatlamidagi dizayn tanlovlari
Virtual dispatch vtable yuklash va indirect branch talab qiladi; CRTP kabi static polymorphism esa chaqiruv nishonini compile time’da aniqlashi mumkin. Bitta tipda virtual/static nisbati taxminan 1,47× boʻlgan; yuqori dispatch entropy’da vaqt farqi kichrayadi, ammo virtual variantda branch-miss koʻproq qoladi.
| Dispatch | 1 tip | 4 tip | 8 tip |
|---|---|---|---|
| Static | 1,32 ms | 8,75 ms | 10,02 ms |
| Virtual | 1,94 ms | 9,19 ms | 10,38 ms |
noexcept sof arithmetic pipeline’da katta oʻzgarish bermagan, ammo heap-owning type saqlaydigan std::vector reallocation’da noexcept move 101,6 s, non-noexcept move 263,4 s boʻlgan; farq taxminan 2,6×. Sabab std::vector kuchli exception guarantee uchun move oʻrniga copy yoʻliga oʻtishi mumkin.
| Move tuzilishi | Wall Time |
|---|---|
| noexcept move | 101,6 s |
| non-noexcept move | 263,4 s |
RTTI asosidagi dynamic_cast heterogeneous-message testida explicit tagged-union’dan taxminan 3,6× ko‘proq cycle va 7,6× ko‘proq instruction ishlatgan. Callable testida inline function 1,00×, stateless lambda 1,03×, std::function esa 5,68× xarajat ko‘rsatgan.
| Callable | Relative Cost |
|---|---|
| Inline function | 1,00× |
| Stateless lambda | 1,03× |
| std::function | 5,68× |
Compile-time C++ har doim tezroq degani emas. Type traits + if constexpr taxminan %5–6 execution-time kamaytirgan, variadic template pipeline taxminan %21 kamaytirgan, policy-based design instruction sonini −%43 va branch sonini −%36 tushirgan, ammo execution time deyarli bir xil qolgan. constexpr lookup table esa steady-state’da deyarli oʻzgarmasdan binary’ni ≈3 KB dan >400 KB gacha kattalashtirgan.
Branch hint, PGO va heap allocation
%99,9 bir tomonga ketadigan biased branch’da [[likely]] va [[unlikely]] taxminan %15–16 yaxshilanish bergan, ammo ular hardware branch predictor’ni bevosita boshqarmaydi; compiler code layout qarorlariga taʼsir qiladi. PGO tajribasida 50 million sintetik order uchun execution time 1,791 s dan 1,766 s ga tushgan, yaʼni taxminan %1,4.
| Oʻlchov | Baseline | PGO |
|---|---|---|
| Execution Time | 1,791 s | 1,766 s |
| Cycles | 6,20 B | 6,11 B |
| Instructions | 12,77 B | 11,07 B |
| LLC Load Misses | 419 K | 398 K |
Heap allocation hot path’da free-list/bin boshqaruvi, metadata, fragmentation, mmap/brk, page faults va cache/TLB taʼsirlarini olib kirishi mumkin. Bir million operation taqsimotida object pool ayniqsa p99.9 mintaqasida ustunlik ko‘rsatadi.
| Operatsiya | Median | p99.9 | Maximum |
|---|---|---|---|
| new | 82 cycles | 8586 cycles | 172.401 cycles |
| Pool allocate | 32 cycles | 246 cycles | 81.756 cycles |
| delete | 60 cycles | 433 cycles | 73.471 cycles |
| Pool deallocate | 34 cycles | 262 cycles | 52.153 cycles |
Cache-aware dizayn, false sharing va SoA
Manba zamonaviy CPU uchun xotira kirish miqyoslarini L1’da 4–5 cycle, L2’da 10–15, L3’da 30–50, DRAM’da 150–300 cycle deb beradi. Ketma-ket array kirishi ≈5,35 cycles/access, random pointer chasing esa ≈378 cycles/access; farq taxminan 70×.
| Kirish shakli | Cycles / Access |
|---|---|
| Sequential array | ≈5,35 |
| Random pointer chasing | ≈378 |
Hot va cold maʼlumotni ajratish Order tuzilmasidagi tez ishlatiladigan price/quantity maydonlarini kam ishlatiladigan maydonlardan ajratib, ish vaqtini 1,08746 s dan 0,91845 s ga tushirgan. Cache misses 7,8×10⁷ dan 3,5×10⁷ ga kamaygan.
False sharing’da ikki thread har xil oʻzgaruvchilarni yangilasa ham, ular bir 64-byte cache line’da boʻlsa, cache coherence line’ni yadrolar orasida koʻchiradi. Bu 4,16 s dan 0,55 s gacha farq yaratgan; yaʼni taxminan 7,5×.
| Tartib | Cycles | Vaqt |
|---|---|---|
| False sharing | 2,73×10¹⁰ | 4,16 s |
| Cache-line padded | 3,61×10⁹ | 0,55 s |
10 million level ustidagi risk-adjustment siklida Array of Structures taxminan 258 ms, Structure of Arrays esa 145 ms davom etgan. SoA L1D misses va LLC misses qiymatlarini sezilarli kamaytirgan; SIMD testida scalar 406 ms, AVX 370 ms bo‘lgan va bu taxminan %7 yaxshilanish sifatida talqin qilingan.
Lock-free va AF_XDP natijalari
Lock-free har doim tezroq emas, lekin SPSC ring buffer ssenarisida tail xatti-harakati keskin yaxshilangan.
| Operatsiya | p50 | p99.9 | p99.99 |
|---|---|---|---|
| Lock Push | 80 | 17.785 | 32.115 cycles |
| Lock-Free Push | 47 | 294 | 378 cycles |
| Lock Pop | 81 | 12.958 | 46.048 cycles |
| Lock-Free Pop | 25 | 226 | 278 cycles |
Lock-based versiya 36.791 syscall va 34.074 futex chaqirgan; lock-free versiyada ular mos ravishda 107 va 3 ta. Ammo kuchli contention sharoitida bir xil atomic ustida CAS retry ko‘payib, cache-line ping-pong sababli mutex’dan ham yomonroq natija berishi mumkin.
Klassik Linux receive yo‘li NIC → Driver → sk_buff → IP/UDP Stack → Socket → System Call → User Space, AF_XDP esa NIC → XDP → AF_XDP → UMEM → User Space sifatida modellashtirilgan.
| Tarmoq yoʻli | Mean | p50 | p99 |
|---|---|---|---|
| Kernel Stack | ≈200 µs | ≈218 µs | ≈300 µs |
| AF_XDP | ≈8 µs | ≈6 µs | ≈80 µs |
bpftrace o‘lchovlarida udp_rcv chaqiriqlari 1.221.304 dan 0 ga, skb_recv_udp 333 dan 0 ga tushgan. Biroq tajriba bitta fizik mashinadagi namespace/veth juftligida qilingan; u NIC DMA, switch, kabel, exchange gateway yoki production co-location tarmog‘ining real uchdan-uchga latency’sini o‘lchamaydi.
Tadqiqot usuli va umumiy natijalar
Tajriba muhiti
| Komponent | Manbada ishlatilgan muhit |
|---|---|
| CPU | Intel Core i5-6500 @ 3,20 GHz |
| Yadro | 4 core / 1 thread per core |
| RAM | 3,7 GiB |
| NUMA | Bitta node |
| Linux kernel | 6.8.0-90-generic |
| Compiler | GCC 13.3.0 |
| Default build | -O2 |
| CPU governor | performance |
Natijalarning umumiy andozasi shunday: scheduler median wakeup latency’ga kuchli taʼsir qiladi; kernel isolation va IRQ steering p99.9/p99.99 sohalarida katta yutuq beradi; hot path’da page fault, heap allocation, kernel syscall va mutex/futex kam uchraydigan katta latency spike’lar yaratishi mumkin; cache locality baʼzan arithmetic optimallashtirishlardan kattaroq farq beradi; kernel bypass o‘rtacha latency’ni keskin kamaytirsa ham residual tail latency qoladi.
Manbaning umumiy xabari: determinism “tezroq kod”dan ko‘ra unpredictable slow path’larni arxitekturadan chiqarish muammosidir.
Manba va usul eslatmasi
Asl sarlavha: Design Choices in Low-Latency C++ Systems: Empirical Insights with Applications to High-Frequency Trading
Muallif: Khalid Mohammad.
Muassasa: Department of Computer Science, Indian Institute of Technology Kharagpur.
Tadqiqot sanasi: 3-aprel 2026.
SSRN yuklangan sana: 17-aprel 2026.
SSRN ID: 6513601.
DOI: 10.2139/ssrn.6513601.
Nashr turi: Preprint.
Peer review holati: Ko‘rib chiqilgan ish preprintdir; hakamli jurnal maqolasi sifatida taqdim etilmasligi kerak.
Mualliflik huquqi / litsenziya: SSRN yozuvi barcha huquqlar saqlanishini va huquq egasining ruxsatisiz qayta foydalanishga ruxsat yo‘qligini bildiradi. Shu sabab manba shakllari yoki original jadval dizaynlari Verianla ichida qayta nashr etilmagan.
Manfaatlar to‘qnashuvi: SSRN yozuvida muallif ishga taʼsir qilishi mumkin bo‘lgan maʼlum moliyaviy manfaat yoki shaxsiy munosabat bildirmagan.
Asosiy usul: Linux system tuning, C++ til xususiyatlari, compiler optimizations, xotira va cache dizayni, lock-free concurrency va AF_XDP tarmoq yo‘li bo‘yicha nazoratli mikrobenchmarklar.
Asosiy ilmiy chegara: Natijalar bitta Intel i5-6500 tizimi va maʼlum Linux/GCC versiyalarida olingan. Boshqa CPU mikroarxitekturalari, NUMA tizimlari, yangi NIC’lar, boshqa kernels yoki ARM tizimlari boshqa natijalar berishi mumkin.
Tarmoq testi chegarasi: AF_XDP benchmark production HFT network’da emas, ayni mashinadagi namespace/veth muhitida qilingan.
HFT doirasi: Tadqiqot trading alpha, bozor prognozi yoki strategiya daromadini test qilmaydi; HFT ultra-low-latency software engineering uchun qo‘llanish maydoni sifatida ishlatiladi.
Izoh qoldiring
E-pochta manzilingiz chop etilmaydi. Majburiy maydonlar * bilan belgilangan