

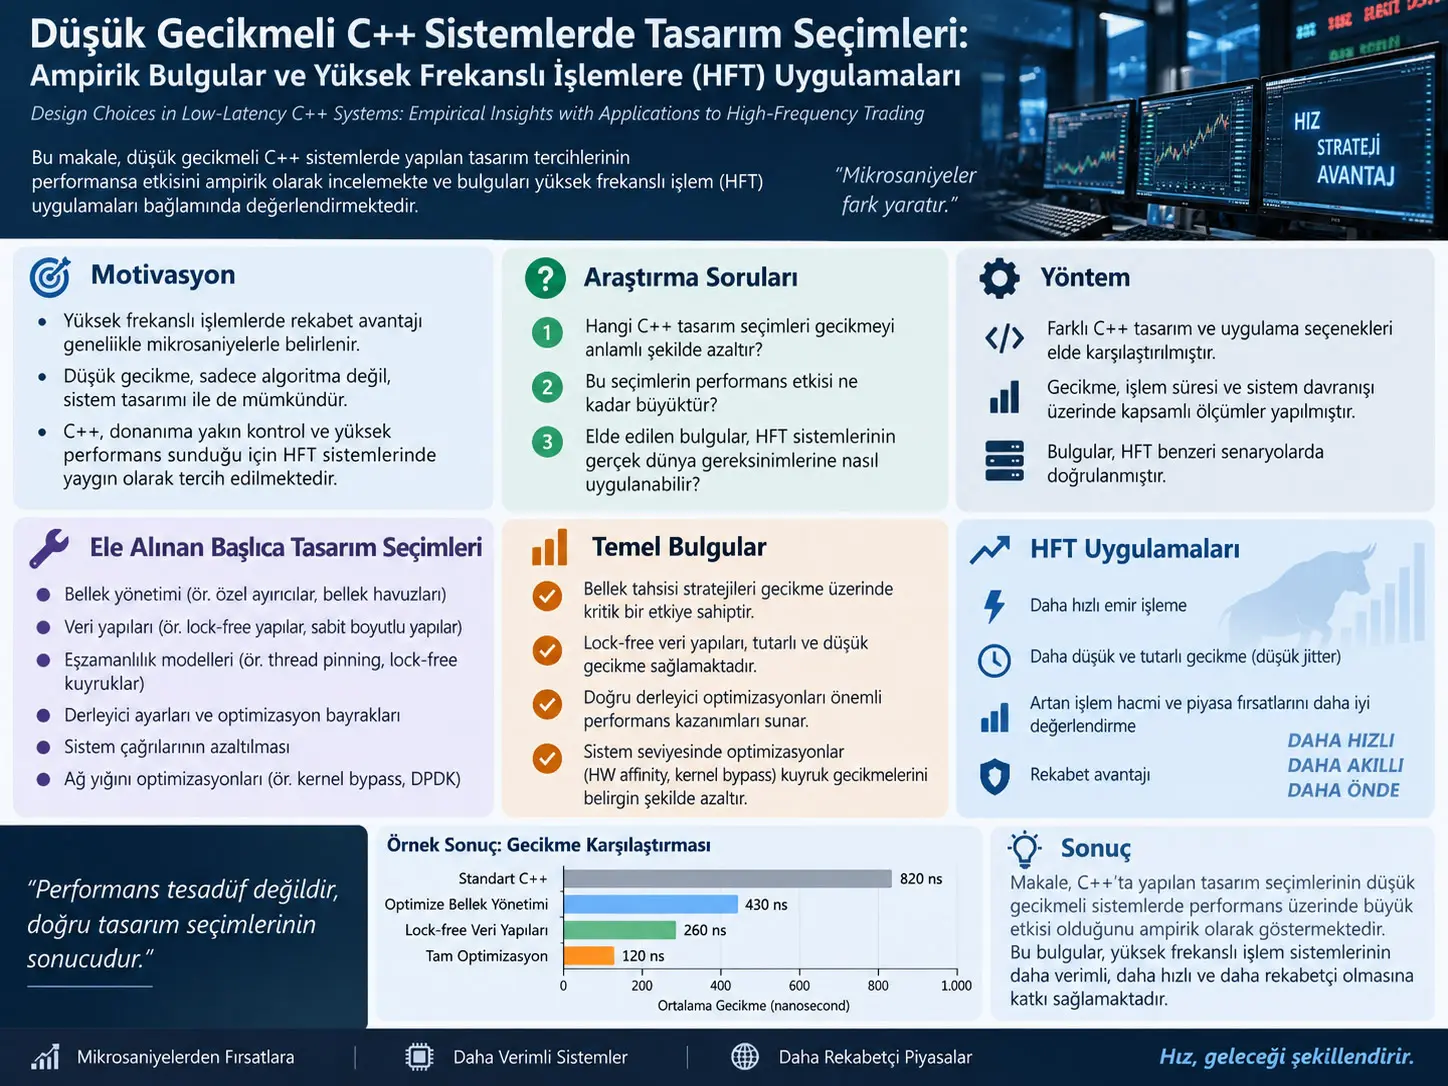
Yüksek frekanslı işlem sistemlerinde performans yalnız bir algoritmanın ne kadar hızlı çalıştığıyla belirlenmez. Bir piyasa verisi paketinin sisteme ulaşmasından buna karşılık gelen emrin dışarı gönderilmesine kadar geçen tick-to-trade gecikmesi; işletim sistemi zamanlayıcısı, interrupts, kernel housekeeping, page faults, TLB davranışı, cache locality, C++ kontrol akışı, bellek tahsisi, thread synchronization ve ağ protokol yığını gibi çok sayıda katmanın ortak sonucudur.
Khalid Mohammad'ın çalışması, bu katmanları tek tek mikrobenchmark'larla inceleyerek düşük gecikmeli yazılım mühendisliğinde hangi tasarım tercihlerinin tipik gecikmeyi, hangilerinin ise özellikle tail latency olarak adlandırılan nadir fakat çok büyük gecikme sıçramalarını etkilediğini araştırmaktadır.
Çalışmanın önemli sonucu, tek bir “en iyi optimizasyon” bulunmamasıdır. Gerçek-zamanlı scheduler kullanımı medyan wakeup latency'yi güçlü biçimde düşürürken çok derin tail'leri tek başına ortadan kaldırmamaktadır. Buna karşılık kernel-level CPU isolation, RCU/workqueue ayrıştırması ve interrupt steering p99.9 ve p99.99 gecikmelerini çok daha güçlü biçimde sıkıştırabilmektedir.
Bellek tarafında ilk erişimde page fault oluşturmak yerine sayfaları önceden populate etmek yaklaşık 2 µs düzeyindeki first-touch maliyetini çalışmanın deneyinde yaklaşık 20 ns erişim seviyesine indirmiştir. Explicit 2 MB HugeTLB kullanımı 4 KB sayfalara kıyasla TLB miss oranını %1,33'ten %0,09'a ve cycles/access değerini yaklaşık 290'dan 43,12'ye düşürmüştür.
C++ katmanında sonuçlar daha nüanslıdır. Stateless lambda doğrudan kullanıldığında inline fonksiyona yakın maliyet taşırken std::function aynı deneyde yaklaşık 5,68× maliyetlidir. RTTI tabanlı dynamic_cast çözümü explicit tagging'e kıyasla yaklaşık 3,6× daha fazla çevrim tüketmiştir. Object pool genel amaçlı new/delete tahsisine kıyasla yaklaşık 3,7× hızlanma sağlamış; heap allocation'ın tail latency'si ise pool yaklaşımından çok daha yüksek kalmıştır.
Data-oriented tasarım sonuçları, işlemcinin hesaplama gücünden çok verinin nasıl yerleştirildiğinin kritik olabileceğini göstermektedir. Sıralı bellek erişimi yaklaşık 5,35 cycles/access iken rastgele pointer chasing yaklaşık 378 cycles/access gerektirmiştir. False sharing iki thread'li deneyde çalışma süresini yaklaşık 7,5× artırmış; Structure of Arrays düzeni ise aynı risk hesaplama döngüsünü Array of Structures yaklaşımından belirgin biçimde daha hızlı tamamlamıştır.
Ağ katmanında çalışma, normal Linux UDP yoluyla AF_XDP yolunu aynı makinedeki network namespace ve veth ortamında karşılaştırmaktadır. Standart kernel yolunda ortalama yaklaşık 200 µs olan gecikme AF_XDP'de yaklaşık 8 µs'ye; p50 yaklaşık 218 µs'den 6 µs'ye düşmektedir. Bununla birlikte AF_XDP p99 değeri yaklaşık 80 µs olarak kalmaktadır; yani kernel'in büyük kısmını bypass etmek tail latency'yi tamamen ortadan kaldırmamaktadır.
Kaynağın genel mühendislik sonucu şudur: düşük gecikme tek bir hızlı fonksiyondan değil, kritik yol üzerindeki belirsizlik kaynaklarının sistematik biçimde ortadan kaldırılmasından doğar.
Düşük gecikmeli sistemlerde asıl ölçüt nedir?
Genel amaçlı yazılımlarda ortalama throughput veya toplam işlem sayısı çoğu zaman yeterli performans göstergeleridir. HFT sistemlerinde ise nadir meydana gelen bir gecikme sıçraması dahi ekonomik olarak önemli olabilir.
Bu nedenle yalnız ortalama latency değil:
p50 → p99 → p99.9 → p99.99 → maksimum gecikme
zincirinin tamamı değerlendirilmelidir.
Örneğin bir sistem işlemlerin %99'unu 10 µs içinde tamamlıyor olabilir; ancak her on bin işlemden birinin birkaç milisaniye sürmesi, kritik bir piyasa olayında sistemin rakibinden çok sonra reaksiyon vermesine neden olabilir.
Scheduler Seçmek Tek Başına Düşük Gecikme Sağlıyor mu?
Hayır. Kaynağın cyclictest deneyinde SCHED_FIFO tipik wakeup latency açısından CFS'den belirgin biçimde daha hızlıdır; ancak çok derin tail davranışında scheduler seçiminin ötesinde kernel interference devreye girmektedir.
| Percentile | CFS | CFS Tuned | SCHED_FIFO |
|---|---|---|---|
| p50 | 55 µs | 55 µs | 5 µs |
| p99 | 67 µs | 811 µs | 15 µs |
| p99.9 | 1383 µs | 929 µs | 1287 µs |
| p99.99 | 3386 µs | 1916 µs | 2673 µs |
SCHED_FIFO p50'yi 55 µs'den 5 µs'ye indirerek yaklaşık bir order-of-magnitude avantaj göstermektedir. Ancak p99.9 değerinin yine 1287 µs olması, en büyük sapmaların yalnız scheduler kuyruğundan kaynaklanmadığını göstermektedir.
Tuned CFS örneği de önemli bir uyarıdır. p99.9 ve p99.99 iyileşirken p99 67 µs'den 811 µs'ye yükselmektedir. Bu, latency tuning'in bütün dağılımı tek yönde hareket ettirmeyebileceğini gösterir.
CPU İzolasyonu Tail Latency'yi Neden Bu Kadar Etkiliyor?
Bir thread yalnızca belirli CPU'ya pin edilmiş olsa bile aynı çekirdek timer tick, RCU callback, kernel workqueue veya donanım interrupt'ı tarafından kesilebilir.
Çalışmada isolcpus, nohz_full, rcu_nocbs, cpuset/cgroup düzeni ve workqueue relocation birlikte kullanılarak latency-critical çekirdeğin kernel housekeeping faaliyetlerinden ayrılması hedeflenmiştir.
| Percentile | CFS | CFS + Isolation | RT | RT + Isolation |
|---|---|---|---|---|
| p50 | 55 µs | 55 µs | 5 µs | 5 µs |
| p99 | 67 µs | 61 µs | 15 µs | 10 µs |
| p99.9 | 1383 µs | 77 µs | 1287 µs | 33 µs |
| p99.99 | 3386 µs | 201 µs | 2673 µs | 174 µs |
Burada medyan neredeyse değişmezken p99.9 ve p99.99 dramatik biçimde küçülmektedir. Bu sonuç kaynağın merkezi savlarından birini destekler: scheduler tipik gecikmeyi, isolation ise özellikle ultra-tail davranışını belirgin biçimde etkiler.
Interrupt steering ne ekliyor?
IRQ'ların latency-sensitive CPU'ya yönlendirilmemesi de derin kuyruğu sıkıştırmaktadır.
| Ölçü | Isolation Yok | Isolation | Isolation + IRQ Steering |
|---|---|---|---|
| p99.9 | 1287 µs | 33 µs | 40 µs |
| p99.99 | 2673 µs | 174 µs | 109 µs |
| Maximum | 4673 µs | 564 µs | 399 µs |
p99.9 isolation sonrasında biraz yükselirken p99.99 ve maksimum değerler daha da küçülmektedir. Yine tek bir percentile'a bakarak optimizasyonun tamamını değerlendirmemek gerekir.
Page Fault Neden Hot Path'te Sorundur?
Linux anonymous memory'yi genellikle demand paging ile fiziksel belleğe bağlar. Program bir sayfaya ilk kez dokunduğunda page fault oluşabilir ve kernel fiziksel sayfayı tahsis edip sıfırlamak zorunda kalır.
Kaynağın 512 MB anonymous mapping deneyinde yaklaşık 131.000 minor page fault gözlenmiş ve ilk erişim maliyeti sayfa başına yaklaşık 2 µs olarak ölçülmüştür.
MAP_POPULATE ile sayfalar mmap aşamasında önceden hazırlanırken steady-state ilk erişim yaklaşık 20 ns düzeyine düşmüştür.
Ancak prefaulting başka bir problemi çözmez: memory pressure altında kernel aynı belleği reclaim etmeye çalışabilir. Çalışmada mlock/mlockall bu nedenle belleği fiziksel RAM'de tutmak için değerlendirilmiştir.
Huge Pages Gerçekten Fark Yaratıyor mu?
256 MB working set üzerinde 4 KB stride kullanılan deneyde:
| Sayfa Yapısı | Cycles / Access | dTLB Miss Rate |
|---|---|---|
| 4 KB | ≈290 | ≈%1,33 |
| Transparent Huge Pages | ≈241 | ≈%0,47 |
| Explicit HugeTLB 2 MB | 43,12 | %0,09 |
Explicit HugeTLB, 4 KB sayfalara göre cycles/access değerini yaklaşık 6–7 kat azaltmaktadır.
Kaynağın önemli ayrımı THP ile explicit HugeTLB arasındadır. THP arka planda collapse, split ve memory compaction çalıştırabileceği için bellek parçalanması altında milisaniye seviyesinde tail spike üretebilir. Pre-reserved HugeTLB ise runtime sırasında bu promotion mekanizmalarına ihtiyaç duymaz.
Bellek Ayarlarını Değiştirmek Yeterli mi?
Çalışmanın allocator-pressure testi bunun cevabını büyük ölçüde “hayır” olarak vermektedir.
| Percentile | Varsayılan | VM Tuning Sonrası |
|---|---|---|
| p50 | 92 µs | 30 µs |
| p99 | 204 µs | 556 µs |
| p99.9 | 4415 µs | 4898 µs |
| p99.99 | 7630 µs | 7076 µs |
| Maximum | 9230 µs | 8013 µs |
Medyan ciddi biçimde iyileşirken p99 ve p99.9 kötüleşmektedir. Extreme-tail ise yalnız sınırlı ölçüde iyileşmektedir.
Kaynağın burada ulaştığı tasarım sonucu nettir: latency-critical hot path içinde runtime allocation yapmak yerine mümkün olduğunca belleği önceden ayırmak daha güvenilir bir yaklaşım olabilir.
Spectre ve Meltdown Azaltmaları Gecikmeyi Nasıl Etkiliyor?
Kaynak, KPTI, IBRS, IBPB ve diğer speculative-execution güvenlik azaltmalarının kernel privilege transition maliyetini ölçmektedir.
| Ölçü | Mitigations ON | Mitigations OFF |
|---|---|---|
| Raw syscall | 2850 cycles | 306 cycles |
| libc syscall | 2815 cycles | 278 cycles |
| Context switch | 24.301 cycles | 14.829 cycles |
| sched pipe | 7,76 µs/op | 4,76 µs/op |
Raw syscall maliyeti deneyde yaklaşık %89 azalırken context-switch maliyeti yaklaşık %39 düşmektedir.
Bu sonuç yalnız performans etkisini ölçmektedir. Güvenlik azaltmalarını devre dışı bırakmak işlemciyi bilinen speculative-execution saldırı sınıflarına karşı daha savunmasız hale getirebilir. Dolayısıyla sonuç, genel amaçlı veya çok kiracılı sistemler için bir yapılandırma önerisi olarak değerlendirilmemelidir.
C-State ve CPU Frekans Yönetimi Her Zaman Kapatılmalı mı?
Kaynağın ölçümleri böyle bir genellemeyi desteklemiyor.
| Durum | p99 | p99.9 | p99.99 |
|---|---|---|---|
| C-state ON / Idle | 54 µs | 57 µs | 175 µs |
| C-state OFF / Idle | 54 µs | 55 µs | 58 µs |
| C-state ON / Stress | 77 µs | 144 µs | 182 µs |
| C-state OFF / Stress | 70 µs | 149 µs | 197 µs |
Idle ortamda derin C-state'leri kapatmak p99.99 değerini güçlü biçimde azaltmıştır. Sistem zaten yoğun çalışıyorsa aynı fayda görülmemiş ve bazı tail ölçüleri hafif kötüleşmiştir.
C++'ta Sanal Fonksiyonlardan Kaçınmak Ne Kazandırıyor?
Virtual dispatch vtable yükleme ve indirect branch gerektirir. CRTP gibi static polymorphism yaklaşımları ise çağrı hedefini compile time'da belirleyebilir.
| Dispatch | 1 Tip | 4 Tip | 8 Tip |
|---|---|---|---|
| Static | 1,32 ms | 8,75 ms | 10,02 ms |
| Virtual | 1,94 ms | 9,19 ms | 10,38 ms |
Tek tipte virtual/static oranı yaklaşık 1,47×'tir. Daha yüksek dispatch entropy'de toplam süre farkı küçülse de virtual sürümde branch-miss oranı daha yüksek kalmaktadır.
Bu sonuç, bütün virtual fonksiyonların kötü olduğu anlamına gelmez. Kaynak ABI-stable arayüzler, plugin sistemleri ve cold path'lerde dynamic polymorphism'in hâlâ mantıklı olabileceğini belirtmektedir.
noexcept Gerçekten Bir Performans Optimizasyonu mu?
Saf arithmetic pipeline testinde noexcept eklemek steady-state performansı anlamlı biçimde değiştirmemiştir.
Ancak heap-owning type içeren std::vector reallocation deneyinde durum tamamen değişmektedir:
| Move Yapısı | Wall Time |
|---|---|
| noexcept move | 101,6 s |
| non-noexcept move | 263,4 s |
Fark yaklaşık 2,6×'tir. Nedeni std::vector'ın güçlü exception guarantee'yi korumak amacıyla noexcept olmayan move yerine copy yoluna gidebilmesidir.
Dolayısıyla kaynağın çıkarımı, noexcept'un her fonksiyonu hızlandıran bir anahtar olmadığı; fakat container relocation ve object-lifetime semantiğinde ciddi dolaylı performans etkileri yaratabildiğidir.
RTTI ve std::function Hot Path İçin Ne Kadar Maliyetli?
dynamic_cast kullanılan heterogeneous-message testinde RTTI yaklaşımı explicit tagged-union sürümünden yaklaşık 3,6× daha fazla cycle ve yaklaşık 7,6× daha fazla instruction kullanmıştır.
Callable deneyinde ise:
| Callable | Relative Cost |
|---|---|
| Inline function | 1,00× |
| Stateless lambda | 1,03× |
| std::function | 5,68× |
Sonuç, lambda'nın kendisinin pahalı olmadığını; type erasure ve indirect dispatch'in maliyet yarattığını göstermektedir.
Compile-Time Programlama Her Zaman Daha Hızlı mı?
Hayır. Çalışmanın farklı C++ deneyleri bunun önemli bir karşı örneğini sunmaktadır.
| Teknik | Kaynakta Gözlenen Etki |
|---|---|
| Type traits + if constexpr | Yaklaşık %5–6 execution-time azalması |
| Variadic template pipeline | Yaklaşık %21 execution-time azalması |
| Policy-based design | Instruction −%43, branch −%36; execution time yaklaşık aynı |
| constexpr lookup table | Steady-state yaklaşık aynı; binary ≈3 KB'den >400 KB'ye |
Compile-time karar vermek runtime branch'lerini ortadan kaldırabilir; ancak modern CPU zaten branch'i çok iyi tahmin ediyorsa wall-clock latency aynı kalabilir. Benzer biçimde constexpr çalışma zamanındaki hesabı kaldırırken binary footprint'i büyütebilir.
Branch Hint ve PGO Ne Kadar Fayda Sağlıyor?
%99,9 oranında tek yöne giden oldukça biased bir branch üzerinde [[likely]] ve [[unlikely]] kullanımı kaynak benchmark'ında yaklaşık %15–16 iyileşme sağlamıştır.
Ancak bu attributes donanım branch predictor'ını doğrudan programlamaz; compiler'ın code layout kararlarını etkiler. Yanlış tahmin edilen workload'larda yarar azalabilir veya sonuç olumsuz olabilir.
PGO deneyinde 50 milyon sentetik order işleyen workload:
| Ölçü | Baseline | PGO |
|---|---|---|
| Execution Time | 1,791 s | 1,766 s |
| Cycles | 6,20 B | 6,11 B |
| Instructions | 12,77 B | 11,07 B |
| LLC Load Misses | 419 K | 398 K |
Wall-clock iyileşme yaklaşık 25 ms, yani yaklaşık %1,4'tür. Bu sonuç PGO'nun çok büyük tek-seferlik hızlanmadan çok, karmaşık production hot path'lerde biriken küçük iyileştirmeler sağlayabileceği fikriyle uyumludur.
Heap Allocation Neden Düşük Gecikmeli Sistemlerde Kaçınılıyor?
General-purpose allocator yalnız boş bir adres döndürmez. Free-list/bin yönetimi, metadata, fragmentation, olası mmap/brk çağrıları, page faults ve cache/TLB etkileri aynı hot path'e girebilir.
Bir milyon operation içeren latency dağılımında:
| İşlem | Median | p99.9 | Maximum |
|---|---|---|---|
| new | 82 cycles | 8586 cycles | 172.401 cycles |
| Pool allocate | 32 cycles | 246 cycles | 81.756 cycles |
| delete | 60 cycles | 433 cycles | 73.471 cycles |
| Pool deallocate | 34 cycles | 262 cycles | 52.153 cycles |
Object pool'un en büyük avantajı ortalama değerden çok p99.9 gibi tail bölgelerinde görünmektedir.
Ayrı benchmark'ta object pool ile general-purpose new/delete karşılaştırması yaklaşık 3,7× cycle avantajı göstermektedir.
Cache-Aware Tasarım Neden Algoritmanın Kendisi Kadar Önemli?
Kaynak modern bir CPU için yaklaşık memory-access ölçeklerini L1'de 4–5 cycle, L2'de 10–15, L3'te 30–50 ve DRAM'de 150–300 cycle olarak vermektedir.
Aynı mantıksal işi yapan iki traversal bunun etkisini çok açık gösterir:
| Erişim Biçimi | Cycles / Access |
|---|---|
| Sequential array | ≈5,35 |
| Random pointer chasing | ≈378 |
Fark yaklaşık 70×'dir.
CPU aynı arithmetic işlemlerini yapmasına rağmen rastgele erişimde cache miss ve DRAM bekleme süresi baskın hale gelmektedir.
Hot ve Cold Veriyi Ayırmak Ne Değiştiriyor?
Sık kullanılan price ve quantity alanlarını büyük Order yapısındaki seyrek kullanılan alanlardan ayırmak, benchmark'ta çalışma süresini 1,08746 saniyeden 0,91845 saniyeye indirmiştir.
Cache misses yaklaşık 7,8×10⁷'den 3,5×10⁷'ye düşmektedir.
Benzer biçimde nadir kullanılan cold code'un ayrı fonksiyona taşınması L1 instruction-cache miss'lerini yaklaşık %11, toplam execution time'ı yaklaşık %3 azaltmıştır.
False Sharing Neden Çok Büyük Bir Cezaya Dönüşebiliyor?
İki thread farklı değişkenleri güncellese bile bu değişkenler aynı 64-byte cache line üzerindeyse cache coherence protokolü bütün line'ı çekirdekler arasında taşımak zorunda kalabilir.
| Düzen | Cycles | Süre |
|---|---|---|
| False sharing | 2,73×10¹⁰ | 4,16 s |
| Cache-line padded | 3,61×10⁹ | 0,55 s |
Execution-time farkı yaklaşık 7,5×'tir ve iki sürüm yaklaşık aynı sayıda instruction retire etmektedir. Kaynak bunu cache-line ping-pong etkisiyle ilişkilendirmektedir.
AoS, SoA ve SIMD Sonuçları Ne Gösteriyor?
10 milyon level üzerinde risk-adjustment döngüsünde Array of Structures yaklaşık 258 ms, Structure of Arrays ise yaklaşık 145 ms sürmüştür.
SoA düzeni L1D misses değerini yaklaşık 3,08×10⁷'den 2,35×10⁷'ye, LLC misses değerini ise 1,16×10⁶'dan 2,36×10⁵'e indirmiştir.
SIMD testinde scalar sürüm yaklaşık 406 ms, AVX sürümü yaklaşık 370 ms sürmektedir. Kaynak bunu yaklaşık %7 civarında iyileşme olarak yorumlamaktadır.
Bulgular birlikte düşünüldüğünde, SIMD'nin en güçlü kullanım alanlarından biri verinin zaten contiguous ve vector-friendly biçimde düzenlendiği SoA benzeri hot path'lerdir.
Lock-Free Her Zaman Daha Hızlı mı?
Hayır. Kaynak özellikle bunun genellenmemesi gerektiğini vurgulamaktadır.
SPSC ring buffer senaryosunda ise tail davranışı çok güçlü biçimde iyileşmektedir:
| Operasyon | p50 | p99.9 | p99.99 |
|---|---|---|---|
| Lock Push | 80 | 17.785 | 32.115 cycles |
| Lock-Free Push | 47 | 294 | 378 cycles |
| Lock Pop | 81 | 12.958 | 46.048 cycles |
| Lock-Free Pop | 25 | 226 | 278 cycles |
Lock-based sürüm toplam 36.791 syscall ve 34.074 futex çağrısı üretirken lock-free sürümde bunlar sırasıyla 107 ve 3'tür.
Buna karşılık yüksek contention altında çok sayıda thread aynı atomic üzerinde sürekli CAS retry yapıyorsa lock-free tasarım cache-line ping-pong oluşturup mutex'ten daha kötü sonuç verebilir. Dolayısıyla “lock-free = otomatik olarak faster” sonucu kaynak tarafından desteklenmemektedir.
AF_XDP Kernel Ağ Yoluna Karşı Ne Kazandırıyor?
Klasik Linux receive yolu kabaca:
NIC → Driver → sk_buff → IP/UDP Stack → Socket → System Call → User Space
şeklindedir.
Kaynağın AF_XDP yapısı ise:
NIC → XDP → AF_XDP → UMEM → User Space
olarak modellenmiştir.
| Ağ Yolu | Mean | p50 | p99 |
|---|---|---|---|
| Kernel Stack | ≈200 µs | ≈218 µs | ≈300 µs |
| AF_XDP | ≈8 µs | ≈6 µs | ≈80 µs |
bpftrace ölçümlerinde udp_rcv çağrılarının 1.221.304'ten 0'a, skb_recv_udp çağrılarının 333'ten 0'a düştüğü belirtilmektedir. 100 paketlik strace örneğinde normal AF_INET yolu 100 recvfrom syscall üretirken AF_XDP hot path'inde recvfrom görülmemiştir.
Bununla birlikte bu benchmark aynı fiziksel makinedeki network namespace ve veth çifti üzerinde yapılmıştır. Dolayısıyla NIC DMA, switch, fiziksel kablo, exchange gateway veya co-location ağının gerçek uçtan uca latency'sini ölçmez. Deney esas olarak Linux yazılım ağ yolunun maliyetini izole etmektedir.
Çalışmanın Yöntemi ve Bulguları
Deney ortamı
| Bileşen | Kaynakta Kullanılan Ortam |
|---|---|
| CPU | Intel Core i5-6500 @ 3,20 GHz |
| Çekirdek | 4 core / 1 thread per core |
| RAM | 3,7 GiB |
| NUMA | Tek node |
| Linux kernel | 6.8.0-90-generic |
| Compiler | GCC 13.3.0 |
| Varsayılan build | -O2 |
| CPU governor | performance |
Sonuçların ortak deseni
Scheduler seçimi medyan wakeup latency üzerinde güçlü etki göstermektedir.
Kernel isolation ve IRQ steering özellikle p99.9 ve p99.99 bölgelerinde daha büyük kazanımlar sağlamaktadır.
Hot path'te page fault, heap allocation, kernel syscall ve mutex/futex gibi mekanizmalar nadir fakat büyük latency spike'ları üretebilmektedir.
Cache locality bazen arithmetic optimizasyonlardan çok daha büyük performans farkı yaratmaktadır.
Compile-time C++ teknikleri runtime kontrol akışını azaltabilmektedir; ancak instruction sayısının azalması her zaman wall-clock süresinin aynı oranda düşeceği anlamına gelmemektedir.
Kernel bypass benzeri ağ tasarımları ortalama latency'yi dramatik biçimde azaltabilse de residual tail latency tamamen ortadan kalkmamaktadır.
Kaynağın bütün deneylerinin ortak mesajı, determinism'in yalnız “daha hızlı kod” değil, unpredictable slow path'lerin mimari olarak sistemden çıkarılması problemi olduğudur.
Kaynak ve Yöntem Notu
Özgün başlık: Design Choices in Low-Latency C++ Systems: Empirical Insights with Applications to High-Frequency Trading
Yazar: Khalid Mohammad.
Kurum: Department of Computer Science, Indian Institute of Technology Kharagpur.
Çalışma tarihi: 3 Nisan 2026.
SSRN yüklenme tarihi: 17 Nisan 2026.
SSRN ID: 6513601.
DOI: 10.2139/ssrn.6513601.
Yayın türü: Preprint.
Hakemlik durumu: İncelenen çalışma preprinttir; hakemli dergi makalesi olarak sunulmamalıdır.
Telif / lisans: SSRN kaydı tüm hakların saklı olduğunu ve hak sahibinin izni olmadan yeniden kullanıma izin verilmediğini belirtmektedir. Bu nedenle kaynak şekilleri veya özgün tablo tasarımları Verianla içinde yeniden yayımlanmamıştır.
Çıkar çatışması: SSRN kaydında yazar, çalışmayı etkileyebilecek bilinen finansal çıkar veya kişisel ilişki bildirmemektedir.
Ana yöntem: Linux sistem tuning, C++ dil özellikleri, compiler optimizasyonları, bellek ve cache tasarımı, lock-free concurrency ve AF_XDP ağ yolu üzerine kontrollü mikrobenchmark'lar.
Temel bilimsel sınır: Sonuçlar tek bir Intel i5-6500 tabanlı sistem ve belirli Linux/GCC sürümlerinde elde edilmiştir. Farklı CPU mikro-mimarileri, NUMA sistemleri, yeni network interface controller'lar, farklı kernels veya ARM sistemleri farklı sonuçlar üretebilir.
Ağ testi sınırı: AF_XDP benchmark'ı fiziksel production HFT network'ü üzerinde değil aynı makinedeki namespace/veth ortamında yapılmıştır.
HFT kapsam sınırı: Çalışma trading alpha, piyasa tahmini veya strateji getirisi test etmemektedir. HFT, ultra-low-latency software engineering için uygulama alanı olarak kullanılmaktadır.
Güvenlik sınırı: Speculative-execution mitigations kapalı benchmark yalnız sistem çağrısı ve context-switch maliyetinin teknik ölçümüdür. Güvenlik azaltmalarının kaldırılması ayrı risk değerlendirmesi gerektirir.
Yorum ilkesi: Kaynağın sonuç bölümünün de vurguladığı gibi, mutlak benchmark değerlerinden çok katmanlar arasında tekrar eden tasarım ilkeleri önemlidir: kernel hot path'ini küçültmek, runtime allocation'dan kaçınmak, cache locality'yi korumak, kontrol akışını öngörülebilir hale getirmek ve tail latency'yi doğrudan ölçmek.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir