

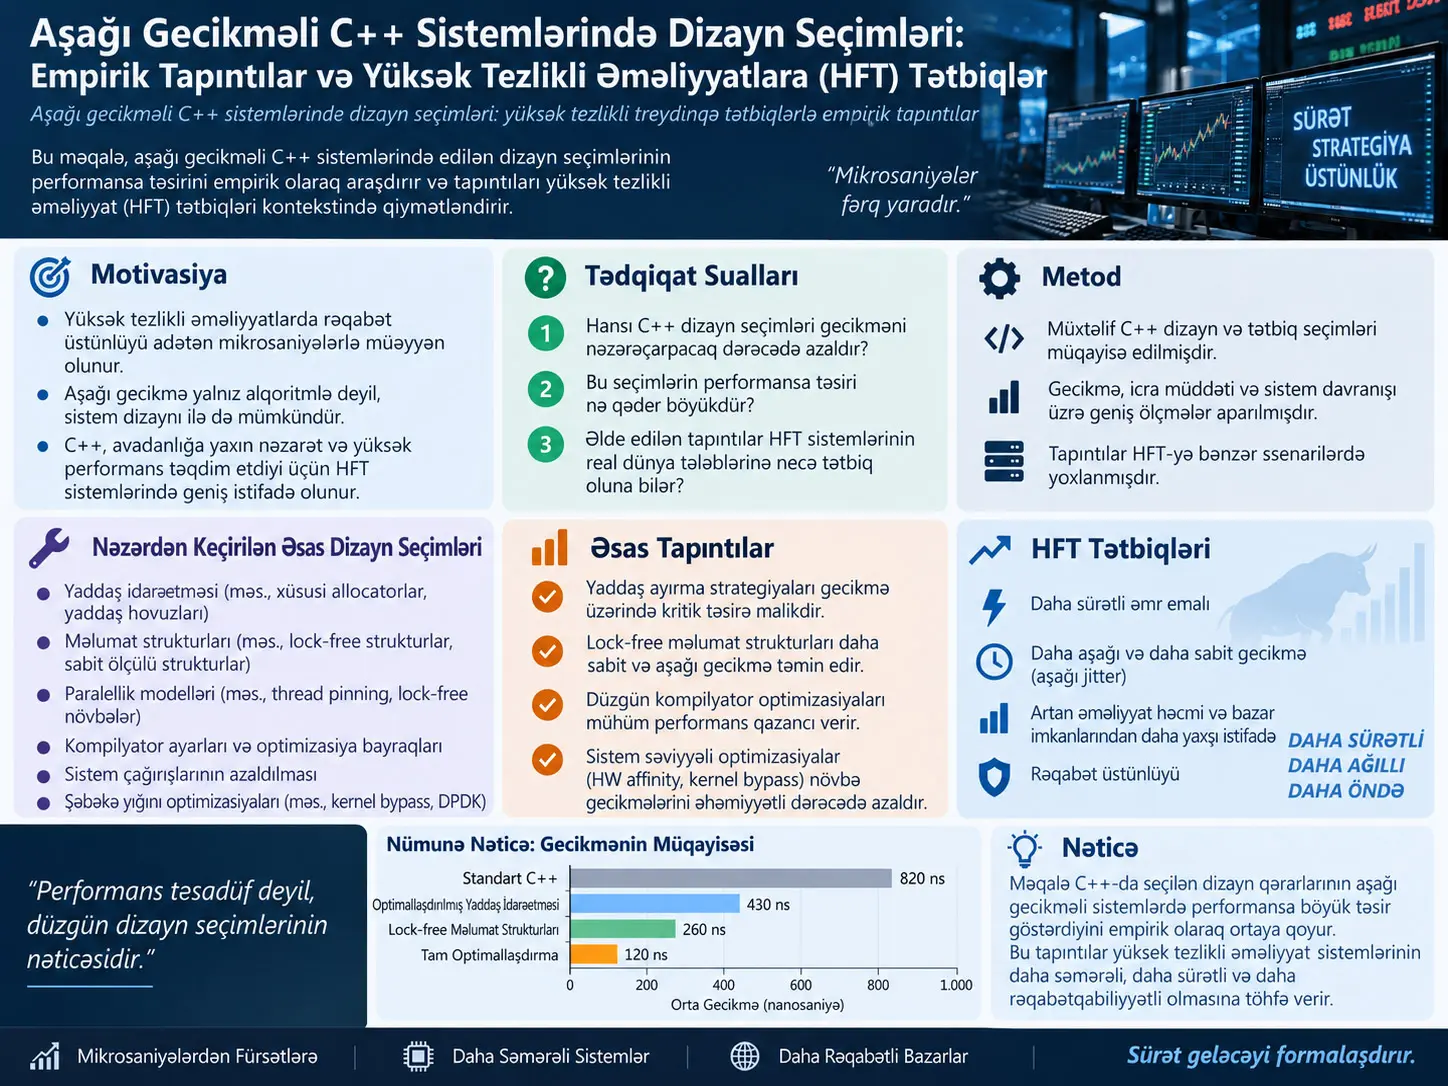
Yüksək tezlikli əməliyyat sistemlərində performans yalnız bir alqoritmin nə qədər sürətli işləməsi ilə müəyyənləşmir. Bir bazar məlumatı paketinin sistemə daxil olmasından ona uyğun əmrin xaricə göndərilməsinə qədər keçən tick-to-trade gecikməsi; əməliyyat sistemi scheduler’i, interrupts, kernel housekeeping, page faults, TLB davranışı, cache locality, C++ nəzarət axını, yaddaş ayırması, thread synchronization və şəbəkə protokol yığını kimi çoxlu qatın birlikdə yaratdığı nəticədir.
Khalid Mohammadın işi bu qatları ayrı-ayrı mikrobenchmark’larla araşdıraraq aşağı gecikməli proqram mühəndisliyində hansı dizayn seçimlərinin tipik gecikməni, hansılarının isə xüsusilə tail latency adlanan nadir, lakin çox böyük gecikmə sıçrayışlarını dəyişdirdiyini incələyir.
Əsas nəticə budur: tək bir “ən yaxşı optimizasiya” yoxdur. Real-time scheduler medyan wakeup latency-ni ciddi azaldır, amma çox dərin tail-ləri təkbaşına aradan qaldırmır. Bunun əksinə kernel səviyyəsində CPU isolation, RCU/workqueue ayrılması və interrupt steering p99.9 və p99.99 gecikmələrini daha güclü sıxışdırır.
Yaddaş tərəfində ilk toxunuşda page fault yaratmaq əvəzinə səhifələri əvvəlcədən populate etmək təcrübədə təxminən 2 µs first-touch xərcini təxminən 20 ns erişim səviyyəsinə endirmişdir. Açıq 2 MB HugeTLB istifadəsi 4 KB səhifələrlə müqayisədə TLB miss nisbətini %1,33-dən %0,09-a, cycles/access dəyərini isə təxminən 290-dan 43,12-yə salmışdır.
C++ qatında nəticələr daha nüanslıdır. Stateless lambda birbaşa istifadə ediləndə inline funksiyaya yaxın xərc daşıyır; std::function isə eyni təcrübədə təxminən 5,68× bahalıdır. RTTI əsaslı dynamic_cast explicit tagging ilə müqayisədə təxminən 3,6× daha çox cycle sərf etmişdir. Object pool ümumi new/delete ayırmasına qarşı təxminən 3,7× sürətlənmə vermiş, heap allocation’ın tail latency-si isə pool yanaşmasından xeyli yüksək qalmışdır.
Data-oriented dizayn nəticələri göstərir ki, bəzən kritik olan prosessorun hesab gücü deyil, verilənin necə yerləşdirilməsidir. Ardıcıllı yaddaş erişimi təxminən 5,35 cycles/access olduğu halda random pointer chasing təxminən 378 cycles/access tələb etmişdir. False sharing iki thread’li təcrübədə icra müddətini təxminən 7,5× artırmış, Structure of Arrays düzəni isə eyni risk hesablama dövrünü Array of Structures yanaşmasından daha tez bitirmişdir.
Şəbəkə qatında iş normal Linux UDP yolu ilə AF_XDP yolunu eyni maşındakı network namespace və veth mühitində müqayisə edir. Standart kernel yolunda orta gecikmə təxminən 200 µs ikən AF_XDP-də təxminən 8 µs-ə; p50 isə təxminən 218 µs-dən 6 µs-ə düşür. Bununla belə AF_XDP p99 dəyəri təxminən 80 µs olaraq qalır; yəni kernel’in böyük hissəsini bypass etmək tail latency-ni tam yox etmir.
Mənbənin ümumi mühəndislik nəticəsi belədir: aşağı gecikmə tək bir sürətli funksiyadan deyil, kritik yol üzərindəki qeyri-müəyyənlik mənbələrinin sistematik aradan qaldırılmasından yaranır.
Aşağı gecikməli sistemlərdə əsas ölçü nədir?
Ümumi məqsədli proqramlarda orta throughput və ya ümumi əməliyyat sayı çox vaxt kifayət edir. HFT sistemlərində isə nadir bir gecikmə sıçrayışı belə iqtisadi baxımdan əhəmiyyətli ola bilər.
Buna görə yalnız orta latency deyil:
p50 → p99 → p99.9 → p99.99 → maksimum gecikmə
zəncirinin hamısı qiymətləndirilməlidir.
Məsələn, sistem əməliyyatların %99-unu 10 µs içində tamamlayır ola bilər; lakin hər on min əməliyyatdan birinin bir neçə millisaniyə çəkməsi kritik bazar hadisəsində sistemin rəqibdən çox gec reaksiya verməsinə səbəb ola bilər.
Scheduler Seçmək Təkbaşına Aşağı Gecikmə Verirmi?
Xeyr. Mənbənin cyclictest təcrübəsində SCHED_FIFO tipik wakeup latency baxımından CFS-dən aydın şəkildə daha sürətlidir; lakin çox dərin tail davranışında scheduler seçimindən kənar kernel interference işə düşür.
| Percentile | CFS | CFS Tuned | SCHED_FIFO |
|---|---|---|---|
| p50 | 55 µs | 55 µs | 5 µs |
| p99 | 67 µs | 811 µs | 15 µs |
| p99.9 | 1383 µs | 929 µs | 1287 µs |
| p99.99 | 3386 µs | 1916 µs | 2673 µs |
SCHED_FIFO p50-ni 55 µs-dən 5 µs-ə endirərək təxminən bir order-of-magnitude üstünlük göstərir. Amma p99.9 dəyərinin yenə 1287 µs olması ən böyük sapmaların yalnız scheduler növbəsindən yaranmadığını göstərir.
Tuned CFS nümunəsi də mühüm xəbərdarlıqdır. p99.9 və p99.99 yaxşılaşarkən p99 67 µs-dən 811 µs-ə yüksəlir. Bu, latency tuning-in bütün paylanmanı eyni istiqamətdə hərəkət etdirməyə biləcəyini göstərir.
CPU İzolyasiyası Tail Latency-ni Niyə Bu Qədər Dəyişdirir?
Bir thread yalnız müəyyən CPU-ya pin edilmiş olsa belə, həmin nüvə timer tick, RCU callback, kernel workqueue və ya hardware interrupt tərəfindən kəsilə bilər.
İşdə isolcpus, nohz_full, rcu_nocbs, cpuset/cgroup düzəni və workqueue relocation birlikdə istifadə edilərək latency-critical nüvənin kernel housekeeping fəaliyyətlərindən ayrılması hədəflənmişdir.
| Percentile | CFS | CFS + Isolation | RT | RT + Isolation |
|---|---|---|---|---|
| p50 | 55 µs | 55 µs | 5 µs | 5 µs |
| p99 | 67 µs | 61 µs | 15 µs | 10 µs |
| p99.9 | 1383 µs | 77 µs | 1287 µs | 33 µs |
| p99.99 | 3386 µs | 201 µs | 2673 µs | 174 µs |
Burada medyan demək olar dəyişmədiyi halda p99.9 və p99.99 dramatik kiçilir. Bu, mənbənin əsas tezisini dəstəkləyir: scheduler tipik gecikməni, isolation isə xüsusilə ultra-tail davranışını müəyyən dərəcədə formalaşdırır.
Interrupt steering nə əlavə edir?
IRQ-ların latency-sensitive CPU-ya yönləndirilməməsi də dərin quyruğu sıxışdırır.
| Ölçü | Isolation Yox | Isolation | Isolation + IRQ Steering |
|---|---|---|---|
| p99.9 | 1287 µs | 33 µs | 40 µs |
| p99.99 | 2673 µs | 174 µs | 109 µs |
| Maximum | 4673 µs | 564 µs | 399 µs |
p99.9 isolation sonrasında bir qədər artsa da p99.99 və maksimum dəyərlər daha da kiçilir. Yenə tək bir percentile-a baxaraq optimizasiyanın tamamını qiymətləndirmək doğru deyil.
Page Fault Hot Path-də Niyə Problemdir?
Linux anonymous memory-ni adətən demand paging ilə fiziki yaddaşa bağlayır. Proqram bir səhifəyə ilk dəfə toxunanda page fault yarana bilər və kernel fiziki səhifəni ayırıb sıfırlamalı olur.
Mənbənin 512 MB anonymous mapping təcrübəsində təxminən 131.000 minor page fault müşahidə edilmiş və ilk erişim xərci səhifə başına təxminən 2 µs ölçülmüşdür.
MAP_POPULATE ilə səhifələr mmap mərhələsində əvvəlcədən hazırlananda steady-state ilk erişim təxminən 20 ns səviyyəsinə düşmüşdür.
Ancaq prefaulting başqa problemi həll etmir: memory pressure altında kernel eyni yaddaşı reclaim etməyə çalışa bilər. Buna görə işdə mlock/mlockall yaddaşı fiziki RAM-də saxlamaq üçün qiymətləndirilmişdir.
Huge Pages Həqiqətən Fərq Yaradırmı?
256 MB working set üzərində 4 KB stride istifadə olunan təcrübədə:
| Səhifə Quruluşu | Cycles / Access | dTLB Miss Rate |
|---|---|---|
| 4 KB | ≈290 | ≈%1,33 |
| Transparent Huge Pages | ≈241 | ≈%0,47 |
| Explicit HugeTLB 2 MB | 43,12 | %0,09 |
Explicit HugeTLB, 4 KB səhifələrlə müqayisədə cycles/access dəyərini təxminən 6–7 dəfə azaldır.
Mənbənin vacib fərqi THP ilə explicit HugeTLB arasındadır. THP arxa planda collapse, split və memory compaction işlədə bildiyi üçün yaddaş parçalanması altında millisaniyə səviyyəsində tail spike yarada bilər. Pre-reserved HugeTLB isə runtime zamanı bu promotion mexanizmlərinə ehtiyac duymur.
Yaddaş Ayarlarını Dəyişmək Yetərlidirmi?
İşin allocator-pressure testi bu suala böyük ölçüdə “xeyr” cavabı verir.
| Percentile | Varsayılan | VM Tuning Sonrası |
|---|---|---|
| p50 | 92 µs | 30 µs |
| p99 | 204 µs | 556 µs |
| p99.9 | 4415 µs | 4898 µs |
| p99.99 | 7630 µs | 7076 µs |
| Maximum | 9230 µs | 8013 µs |
Medyan ciddi yaxşılaşır, amma p99 və p99.9 pisləşir. Extreme-tail isə yalnız məhdud dərəcədə yaxşılaşır.
Mənbənin dizayn nəticəsi aydındır: latency-critical hot path daxilində runtime allocation etmək yerinə yaddaşı mümkün qədər əvvəlcədən ayırmaq daha etibarlı yanaşmadır.
Spectre və Meltdown Azaltmaları Gecikməyə Necə Təsir Edir?
Mənbə KPTI, IBRS, IBPB və digər speculative-execution təhlükəsizlik mitigations-larının kernel privilege transition xərcini ölçür.
| Ölçü | Mitigations ON | Mitigations OFF |
|---|---|---|
| Raw syscall | 2850 cycles | 306 cycles |
| libc syscall | 2815 cycles | 278 cycles |
| Context switch | 24.301 cycles | 14.829 cycles |
| sched pipe | 7,76 µs/op | 4,76 µs/op |
Raw syscall xərci təcrübədə təxminən %89, context-switch xərci isə təxminən %39 azalır.
Bu nəticə yalnız performans təsirini ölçür. Təhlükəsizlik mitigations-larını söndürmək prosessoru məlum speculative-execution hücum siniflərinə qarşı daha həssas edə bilər. Ona görə bu nəticə ümumi məqsədli və ya çox kiracılı sistemlər üçün konfiqurasiya tövsiyəsi kimi oxunmamalıdır.
C-State və CPU Tezlik İdarəsi Həmişə Söndürülməlidirmi?
Mənbənin ölçmələri belə ümumiləşdirməni dəstəkləmir.
| Durum | p99 | p99.9 | p99.99 |
|---|---|---|---|
| C-state ON / Idle | 54 µs | 57 µs | 175 µs |
| C-state OFF / Idle | 54 µs | 55 µs | 58 µs |
| C-state ON / Stress | 77 µs | 144 µs | 182 µs |
| C-state OFF / Stress | 70 µs | 149 µs | 197 µs |
Idle mühitdə dərin C-state-ləri söndürmək p99.99 dəyərini ciddi azaldır. Sistem onsuz da yoğun işləyirsə eyni fayda görünmür və bəzi tail ölçüləri azca pisləşir.
C++-da Virtual Funksiyalardan Qaçmaq Nə Qazandırır?
Virtual dispatch vtable yükləmə və indirect branch tələb edir. CRTP kimi static polymorphism yanaşmaları isə çağırış hədəfini compile time-da müəyyən edə bilər.
| Dispatch | 1 Tip | 4 Tip | 8 Tip |
|---|---|---|---|
| Static | 1,32 ms | 8,75 ms | 10,02 ms |
| Virtual | 1,94 ms | 9,19 ms | 10,38 ms |
Tək tipdə virtual/static nisbəti təxminən 1,47×-dir. Daha yüksək dispatch entropy-də ümumi müddət fərqi kiçilsə də virtual sürümdə branch-miss nisbəti daha yüksək qalır.
Bu nəticə bütün virtual funksiyaların pis olduğu mənasına gəlmir. Mənbə ABI-stable interfeyslər, plugin sistemləri və cold path-lərdə dynamic polymorphism-in hələ də məntiqli ola biləcəyini bildirir.
noexcept Həqiqətən Performans Optimizasiyasıdırmı?
Saf arithmetic pipeline testində noexcept əlavə etmək steady-state performansı mənalı şəkildə dəyişdirməmişdir.
Lakin heap-owning type ehtiva edən std::vector reallocation təcrübəsində vəziyyət tam dəyişir:
| Move Quruluşu | Wall Time |
|---|---|
| noexcept move | 101,6 s |
| non-noexcept move | 263,4 s |
Fərq təxminən 2,6×-dir. Səbəb std::vector’ın güclü exception guarantee-ni qorumaq üçün noexcept olmayan move yerinə copy yoluna gedə bilməsidir.
Deməli, noexcept hər funksiyanı sürətləndirən açar deyil; amma container relocation və object-lifetime semantikasında ciddi dolayı performans təsirləri yarada bilər.
RTTI və std::function Hot Path üçün Nə Qədər Xərclidir?
dynamic_cast istifadə olunan heterogeneous-message testində RTTI yanaşması explicit tagged-union versiyasından təxminən 3,6× daha çox cycle və təxminən 7,6× daha çox instruction istifadə etmişdir.
Callable təcrübəsində isə:
| Callable | Relative Cost |
|---|---|
| Inline function | 1,00× |
| Stateless lambda | 1,03× |
| std::function | 5,68× |
Nəticə lambda-nın özünün bahalı olmadığını; type erasure və indirect dispatch-in xərc yaratdığını göstərir.
Compile-Time Proqramlama Həmişə Daha Sürətlidirmi?
Xeyr. İşin fərqli C++ təcrübələri buna mühüm əks nümunələr verir.
| Texnika | Mənbədə Gözlənən Təsir |
|---|---|
| Type traits + if constexpr | Təxminən %5–6 execution-time azalması |
| Variadic template pipeline | Təxminən %21 execution-time azalması |
| Policy-based design | Instruction −%43, branch −%36; execution time təxminən eyni |
| constexpr lookup table | Steady-state təxminən eyni; binary ≈3 KB-dən >400 KB-yə |
Compile-time qərar vermək runtime branch-lərini aradan qaldıra bilər; amma modern CPU branch-i çox yaxşı təxmin edirsə wall-clock latency eyni qala bilər. Eyni şəkildə constexpr runtime hesabını silsə də binary footprint-i böyüdə bilər.
Branch Hint və PGO Nə Qədər Fayda Verir?
%99,9 nisbətində tək istiqamətə gedən çox biased branch üzərində [[likely]] və [[unlikely]] istifadəsi mənbə benchmark’ında təxminən %15–16 yaxşılaşma vermişdir.
Ancaq bu attributes hardware branch predictor-ını birbaşa proqramlamır; compiler’ın code layout qərarlarına təsir edir. Yanlış təxmin olunan workload-larda fayda azala və ya nəticə mənfi ola bilər.
PGO təcrübəsində 50 milyon sintetik order işləyən workload:
| Ölçü | Baseline | PGO |
|---|---|---|
| Execution Time | 1,791 s | 1,766 s |
| Cycles | 6,20 B | 6,11 B |
| Instructions | 12,77 B | 11,07 B |
| LLC Load Misses | 419 K | 398 K |
Wall-clock yaxşılaşma təxminən 25 ms, yəni təxminən %1,4-dür. Bu nəticə PGO-nun çox böyük tək-seferlik sürətlənmədən çox, mürəkkəb production hot path-lərdə yığılan kiçik yaxşılaşmalar verə biləcəyi fikri ilə uyğundur.
Heap Allocation Aşağı Gecikməli Sistemlərdə Niyə Qaçınılan Bir Şeydir?
General-purpose allocator yalnız boş ünvan qaytarmır. Free-list/bin idarəsi, metadata, fragmentation, mümkün mmap/brk çağrıları, page faults və cache/TLB təsirləri eyni hot path-ə girə bilər.
Bir milyon operation ehtiva edən latency paylanmasında:
| Əməliyyat | Median | p99.9 | Maximum |
|---|---|---|---|
| new | 82 cycles | 8586 cycles | 172.401 cycles |
| Pool allocate | 32 cycles | 246 cycles | 81.756 cycles |
| delete | 60 cycles | 433 cycles | 73.471 cycles |
| Pool deallocate | 34 cycles | 262 cycles | 52.153 cycles |
Object pool’un ən böyük üstünlüyü orta dəyərdən çox p99.9 kimi tail bölgələrində görünür.
Ayrı benchmark-da object pool ilə general-purpose new/delete müqayisəsi təxminən 3,7× cycle üstünlüyü göstərir.
Cache-Aware Dizayn Niyə Alqoritmin Özü Qədər Vacibdir?
Mənbə modern CPU üçün təxmini memory-access miqyaslarını L1-də 4–5 cycle, L2-də 10–15, L3-də 30–50 və DRAM-də 150–300 cycle olaraq verir.
Eyni məntiqi işi edən iki traversal bu təsiri çox aydın göstərir:
| Erişim Biçimi | Cycles / Access |
|---|---|
| Sequential array | ≈5,35 |
| Random pointer chasing | ≈378 |
Fərq təxminən 70×-dir.
CPU eyni arithmetic əməliyyatları etsə də, random erişimdə cache miss və DRAM gözləmə vaxtı dominant olur.
Hot və Cold Verini Ayırmaq Nəyi Dəyişdirir?
Tez-tez istifadə edilən price və quantity sahələrini böyük Order strukturundakı seyrək istifadə olunan sahələrdən ayırmaq benchmark-da icra müddətini 1,08746 saniyədən 0,91845 saniyəyə endirmişdir.
Cache misses təxminən 7,8×10⁷-dən 3,5×10⁷-yə düşür.
Oxşar şəkildə nadir istifadə olunan cold code-un ayrı funksiyaya daşınması L1 instruction-cache miss-lərini təxminən %11, ümumi execution time-ı təxminən %3 azaltmışdır.
False Sharing Niyə Çox Böyük Cəriməyə Çevrilə Bilir?
İki thread fərqli dəyişənləri yeniləsə belə, bu dəyişənlər eyni 64-byte cache line üzərindədirsə, cache coherence protokolu bütün line-ı nüvələr arasında daşımalı ola bilər.
| Düzən | Cycles | Süre |
|---|---|---|
| False sharing | 2,73×10¹⁰ | 4,16 s |
| Cache-line padded | 3,61×10⁹ | 0,55 s |
Execution-time fərqi təxminən 7,5×-dir və iki versiya təxminən eyni sayda instruction retire edir. Mənbə bunu cache-line ping-pong təsiri ilə əlaqələndirir.
AoS, SoA və SIMD Nəticələri Nə Göstərir?
10 milyon level üzərində risk-adjustment dövründə Array of Structures təxminən 258 ms, Structure of Arrays isə təxminən 145 ms çəkmişdir.
SoA düzəni L1D misses dəyərini təxminən 3,08×10⁷-dən 2,35×10⁷-yə, LLC misses dəyərini isə 1,16×10⁶-dan 2,36×10⁵-ə endirmişdir.
SIMD testində scalar versiya təxminən 406 ms, AVX versiyası təxminən 370 ms çəkir. Mənbə bunu təxminən %7 ətrafında yaxşılaşma kimi şərh edir.
Nəticələr birlikdə düşünüldükdə, SIMD-nin ən güclü istifadə sahələrindən biri verilənin artıq contiguous və vector-friendly formada düzülmüş SoA tipli hot path-lərdir.
Lock-Free Həmişə Daha Sürətlidirmi?
Xeyr. Mənbə bunun xüsusilə ümumiləşdirilməməli olduğunu vurğulayır.
SPSC ring buffer ssenarisində isə tail davranışı çox güclü yaxşılaşır:
| Operasyon | p50 | p99.9 | p99.99 |
|---|---|---|---|
| Lock Push | 80 | 17.785 | 32.115 cycles |
| Lock-Free Push | 47 | 294 | 378 cycles |
| Lock Pop | 81 | 12.958 | 46.048 cycles |
| Lock-Free Pop | 25 | 226 | 278 cycles |
Lock-based versiya ümumilikdə 36.791 syscall və 34.074 futex çağırışı yaratdığı halda lock-free versiyada bunlar müvafiq olaraq 107 və 3-dür.
Bununla belə yüksək contention altında çoxlu thread eyni atomic üzərində davamlı CAS retry edirsə, lock-free dizayn cache-line ping-pong yaradıb mutex-dən pis nəticə verə bilər. Buna görə “lock-free = avtomatik faster” nəticəsi mənbə tərəfindən dəstəklənmir.
AF_XDP Kernel Şəbəkə Yoluna Qarşı Nə Qazandırır?
Klassik Linux receive yolu təxminən belədir:
NIC → Driver → sk_buff → IP/UDP Stack → Socket → System Call → User Space
formadadır.
Mənbənin AF_XDP quruluşu isə:
NIC → XDP → AF_XDP → UMEM → User Space
kimi modelləşdirilir.
| Şəbəkə Yolu | Mean | p50 | p99 |
|---|---|---|---|
| Kernel Stack | ≈200 µs | ≈218 µs | ≈300 µs |
| AF_XDP | ≈8 µs | ≈6 µs | ≈80 µs |
bpftrace ölçmələrində udp_rcv çağırışlarının 1.221.304-dən 0-a, skb_recv_udp çağırışlarının 333-dən 0-a düşdüyü bildirilir. 100 paketlik strace nümunəsində normal AF_INET yolu 100 recvfrom syscall yaradır, AF_XDP hot path-ində isə recvfrom görünmür.
Bununla belə bu benchmark eyni fiziki maşındakı network namespace və veth cütü üzərində aparılmışdır. Buna görə NIC DMA, switch, fiziki kabel, exchange gateway və ya co-location şəbəkəsinin real uçdan-uça latency-sini ölçmür. Təcrübə əsasən Linux proqram şəbəkə yolunun xərcini izolyasiya edir.
Çalışmanın Yöntemi və Bulguları
Deney ortamı
| Bileşen | Mənbədə İstifadə Olunan Mühit |
|---|---|
| CPU | Intel Core i5-6500 @ 3,20 GHz |
| Çekirdek | 4 core / 1 thread per core |
| RAM | 3,7 GiB |
| NUMA | Tək node |
| Linux kernel | 6.8.0-90-generic |
| Compiler | GCC 13.3.0 |
| Varsayılan build | -O2 |
| CPU governor | performance |
Nəticələrin ortaq nümunəsi
Scheduler seçimi medyan wakeup latency üzərində güclü təsir göstərir.
Kernel isolation və IRQ steering xüsusilə p99.9 və p99.99 bölgələrində daha böyük qazanc verir.
Hot path-də page fault, heap allocation, kernel syscall və mutex/futex kimi mexanizmlər nadir, amma böyük latency spike-ları yarada bilir.
Cache locality bəzən arithmetic optimizasiyalardan çox daha böyük performans fərqi yaradır.
Compile-time C++ texnikaları runtime nəzarət axınını azalda bilər; lakin instruction sayının azalması həmişə wall-clock müddətin eyni nisbətdə düşəcəyi mənasına gəlmir.
Kernel bypass tipli şəbəkə dizaynları orta latency-ni dramatik azaltsa da residual tail latency tam aradan qalxmır.
Mənbənin bütün təcrübələrinin ortaq mesajı budur: determinism yalnız “daha sürətli kod” deyil, unpredictable slow path-lərin memari olaraq sistemdən çıxarılması problemidir.
Kaynak və Yöntem Notu
Özgün başlık: Design Choices in Low-Latency C++ Systems: Empirical Insights with Applications to High-Frequency Trading
Yazar: Khalid Mohammad.
Kurum: Department of Computer Science, Indian Institute of Technology Kharagpur.
Çalışma tarihi: 3 Nisan 2026.
SSRN yüklenme tarihi: 17 Nisan 2026.
SSRN ID: 6513601.
DOI: 10.2139/ssrn.6513601.
Yayın türü: Preprint.
Hakemlik durumu: İncelenen iş preprintdir; hakemli jurnal məqaləsi kimi təqdim edilməməlidir.
Telif / lisans: SSRN qeydi bütün hüquqların saxlandığını və hüquq sahibinin icazəsi olmadan yenidən istifadəyə icazə verilmədiyini bildirir. Buna görə mənbə şəkilləri və özgün cədvəl dizaynları Verianla daxilində yenidən yayımlanmamışdır.
Çıkar çatışması: SSRN qeydində yazar işə təsir edə biləcək bilinən maliyyə marağı və ya şəxsi münasibət bildirmir.
Ana yöntem: Linux sistem tuning, C++ dil xüsusiyyətləri, compiler optimizasiyaları, yaddaş və cache dizaynı, lock-free concurrency və AF_XDP şəbəkə yolu üzrə kontrollu mikrobenchmark’lar.
Temel bilimsel sınır: Nəticələr tək bir Intel i5-6500 əsaslı sistem və müəyyən Linux/GCC versiyalarında əldə edilmişdir. Fərqli CPU mikro-memarlıqları, NUMA sistemləri, yeni network interface controller-lar, fərqli kernels və ya ARM sistemləri fərqli nəticələr verə bilər.
Ağ testi sınırı: AF_XDP benchmark’ı fiziki production HFT network’ü üzərində deyil, eyni maşındakı namespace/veth mühitində aparılmışdır.
HFT kapsam sınırı: İş trading alpha, bazar proqnozu və ya strategiya gəliri test etmir. HFT ultra-low-latency software engineering üçün tətbiq sahəsi kimi istifadə olunur.
Güvenlik sınırı: Speculative-execution mitigations qapalı benchmark yalnız sistem çağırışı və context-switch xərcinin texniki ölçümüdür. Təhlükəsizlik azaldılmalarının qaldırılması ayrıca risk qiymətləndirməsi tələb edir.
Yorum ilkesi: Mənbənin nəticə bölməsinin də vurğuladığı kimi, mütləq benchmark dəyərlərindən çox qatlar arasında təkrarlanan dizayn prinsipləri önəmlidir: kernel hot path-ini kiçiltmək, runtime allocation-dan qaçmaq, cache locality-ni qorumaq, nəzarət axınını öngörülə bilən etmək və tail latency-ni birbaşa ölçmək.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib