

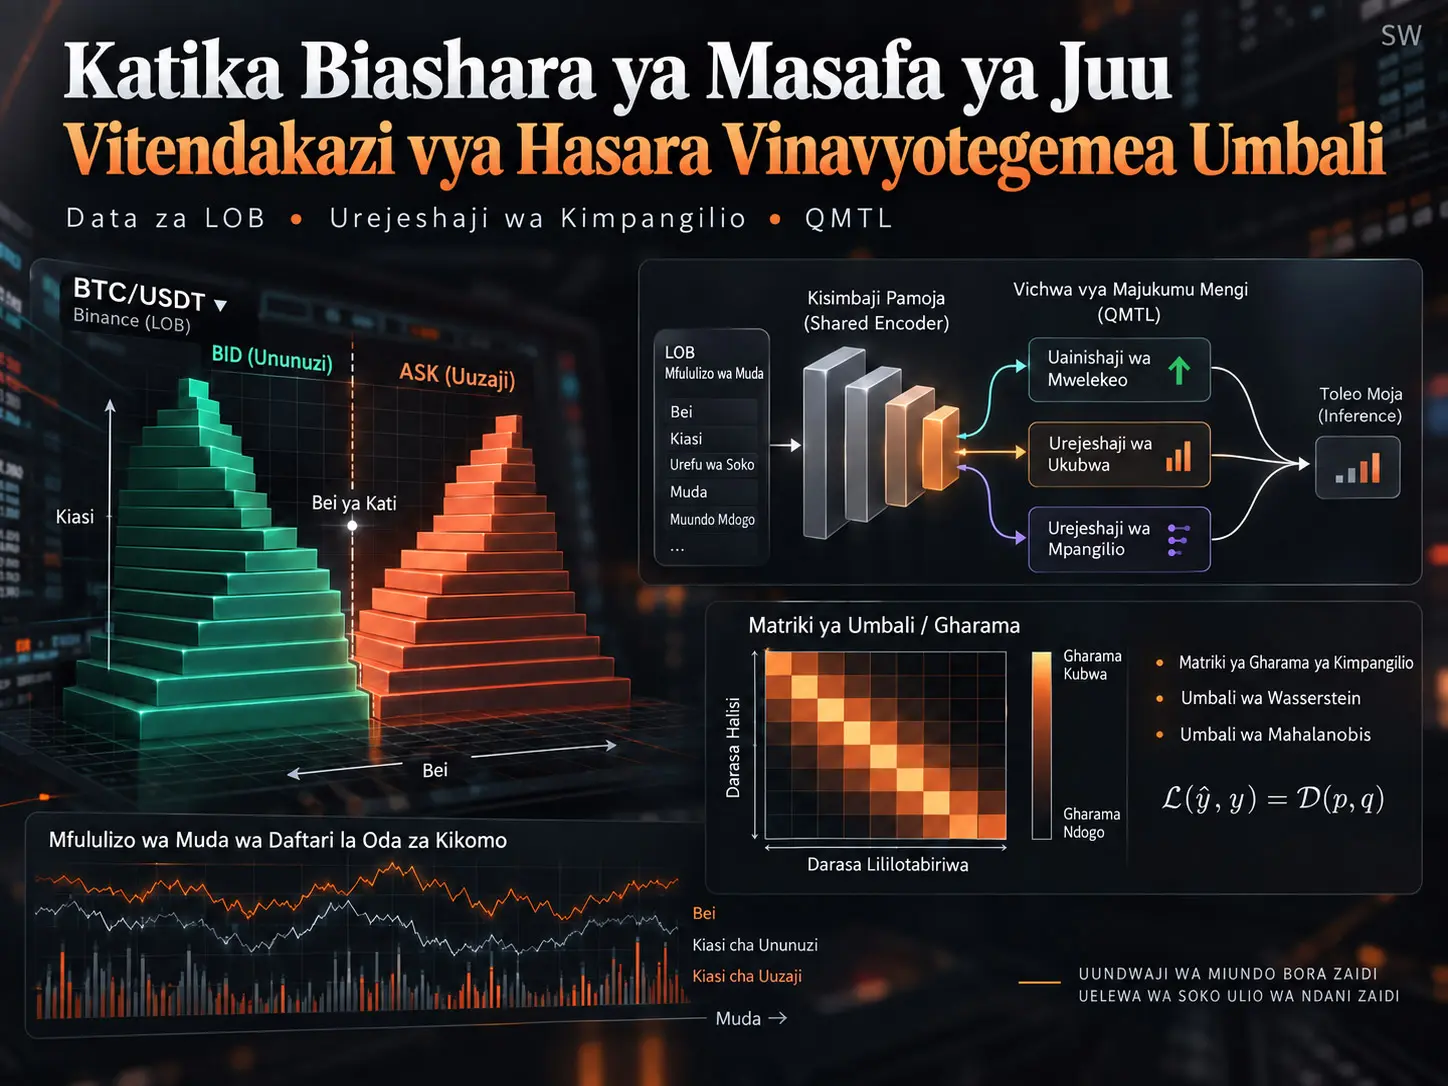
Utafiti huu unachunguza jinsi miundo ya ujifunzaji wa kina inayotabiri mwelekeo wa soko wa muda mfupi katika biashara ya masafa ya juu (High-Frequency Trading, HFT) inaweza kuboreshwa wakati wa mafunzo bila kupanua usanifu katika hatua ya utoaji wa utabiri. Utafiti ulitumia data za Limit Order Book (LOB) zilizopatikana kutoka soko la Binance BTC/USDT kupitia CryptoHFTData; mtiririko wa kitabu cha oda wa kipindi cha 1 Oktoba-30 Novemba 2025 ulisampuliwa kwa vipindi vya 250 ms, na mwendo wa baadaye wa bei ya kati ukagawanywa katika madarasa matatu: −1, 0 na +1. Mbinu kuu ni Ordinal Log-Loss (OLL), inayozingatia kwamba makosa kati ya madarasa hayana umuhimu sawa, matriki za gharama zinazotokana na usambazaji wa data, na mbinu ya Quasi-Multi-Task Learning (QMTL), inayotumia vichwa vingi vinavyotekeleza kazi ileile wakati wa mafunzo. Katika majaribio, matriki ya gharama iliyoundwa kwa umbali wa Wasserstein ilionyesha kwa ujumla utendaji thabiti zaidi dhidi ya cross-entropy ya kawaida na miundo mingine ya matriki ya gharama; QMTL pia ilitoa ushahidi wa kimajaribio kwamba katika baadhi ya usanifu na vipimo inaweza kuwa na manufaa hata pale ambapo baada ya mafunzo yenye vichwa vingi hubaki kichwa kimoja tu. Hata hivyo, matokeo yamewekewa mipaka na mali moja ya kripto, soko moja la ubadilishaji, data ya kihistoria ya miezi miwili na vipimo vya uainishaji; utafiti hauthibitishi utekelezaji wa oda kwa wakati halisi wala faida halisi ya biashara.
Kitabu cha Oda za Kikomo (Limit Order Book, LOB)ni muundo wa soko wa kielektroniki unaowakilisha oda za kununua na kuuza za kikomo zinazosubiri kwa mali fulani pamoja na viwango vya bei na ujazo wake. Ordinal Log-Loss (OLL)ni hasara ya uainishaji wa kiutaratibu inayoweza kuadhibu makosa ya uainishaji kwa viwango tofauti vya ukali kupitia matriki ya gharama. Quasi-Multi-Task Learning (QMTL) ni mbinu ya mafunzo ya kazi nyingi inayofundisha vichwa vingi vinavyotabiri lengo lilelile pamoja na kisimbaji cha pamoja, huku ikiruhusu vichwa hivyo vya ziada kuondolewa katika hatua ya utoaji wa utabiri.
| Kipengele | Thamani iliyotumiwa kwenye chanzo |
|---|---|
| Soko | Binance BTC/USDT |
| Chanzo cha data | CryptoHFTData |
| Kipindi | 1 Oktoba-30 Novemba 2025 |
| Usampulishaji wa muda | 250 ms |
| Kiwango cha LOB | Viwango 10 vya kwanza |
| Dirisha la ingizo | Picha za papo hapo 100 za LOB |
| Hatua ya dirisha | Sampuli 20 |
| Lebo | −1, 0, +1 |
| Uwekaji lebo | Triple Barrier Method; α = 0.001, k = 100 |
| Miundo iliyojaribiwa | Baseline CNN, DeepLOB, MLPLOB |
Kwa nini tatizo si tu kujenga modeli kubwa zaidi?
Katika biashara ya masafa ya juu, ubora wa utabiri wa modeli ni muhimu kama vile kasi ambayo utabiri huo unaweza kutolewa. Hata kama mtandao mkubwa wa neva unaongeza usahihi wa uainishaji, unaweza kupoteza thamani yake ya kiutendaji kwa matumizi yanayoathiriwa na ucheleweshaji ikiwa unaongeza muda wa utoaji wa utabiri. Kwa hiyo, lengo la utafiti si kuunda usanifu mpya na mkubwa zaidi wa HFT. Utafiti unachunguza kama kubadilisha utaratibu wa mafunzo wa usanifu uliopo kunaweza kutoa tabia bora ya utabiri kwa kutumia usanifu huohuo wa utoaji wa utabiri.
Chaguo hili linaelekeza utafiti katika njia mbili zinazokamilishana. Njia ya kwanza ni regression ya kiutaratibu, inayozingatia kwamba madarasa ya mwelekeo wa soko −1, 0 na +1 yana mpangilio wa asili. Njia ya pili ni QMTL, ambapo modeli hufanya kazi na vichwa vingi vya matokeo wakati wa mafunzo pekee. Mbinu zote mbili zinalenga kuimarisha taarifa ya mafunzo bila kulazimika kupanua mwili wa modeli wakati wa uwekaji.
Data ya LOB hubadilishwaje kuwa ingizo la modeli?
Katika picha moja ya papo hapo ya LOB, kila kiwango kina bei ya kununua, ujazo wa kununua, bei ya kuuza na ujazo wa kuuza. Utafiti unatumia viwango vya kwanza \(N=10\). Kwa hiyo picha moja ya LOB ina vipengele \(4N=40\). Wakati wa kuunda ingizo la modeli, picha \(W=100\) mfululizo huunganishwa na tenza ya ingizo kufikia ukubwa wa \(4N \times W = 40 \times 100\).
Mtiririko ghafi wa CryptoHFTData haujumuishi tu picha za papo hapo za kawaida; unajumuisha picha kamili za kila saa pamoja na masasisho ya mabadiliko katikati yake. Katika utafiti, mtiririko huu unaotegemea matukio kwanza huundwa upya, kisha husampuliwa kwa mpangilio wa kawaida katika vipindi vya \(\delta t=250\,\mathrm{ms}\). Ikiwa kuna mabadiliko mengi katika kipindi kimoja, hali ya mwisho huchaguliwa; ikiwa hakuna mabadiliko, hali ya awali ya LOB huendelezwa.
Dirisha la ingizo lina urefu wa sampuli 100, na ili kuunda nukta mpya ya data dirisha husogezwa mbele kwa sampuli 20. Kwa hiyo, maingizo jirani yanaingiliana kwa sehemu. Utafiti hutumia chaguo hili kuongeza kiasi cha data na kuunda sampuli zilizo thabiti zaidi dhidi ya mabadiliko madogo ya muda.
Bei ya kati na madarasa ya mwendo wa baadaye
Ikiwa bei bora ya kuuza inaonyeshwa kwa \(p_t^{a1}\) na bei bora ya kununua kwa \(p_t^{b1}\), spread ni:
\[ s_t=p_t^{a1}-p_t^{b1} \]
na bei ya kati ni:
\[ m_t=\frac{p_t^{a1}+p_t^{b1}}{2} \]
Hivyo ndivyo inavyofafanuliwa. Lengo la utafiti si kutabiri moja kwa moja kiwango cha bei cha baadaye kwa regression, bali kuainisha kama bei ya kati itashuka, itabaki tambarare au itapanda kwa kiwango chenye maana katika siku za usoni.
Maingizo hufanyiwa urekebishaji kwa z-score ya kawaida:
\[ \tilde{x}_i=\frac{x_i-\mu}{\sigma} \]
Chanzo kinaeleza kwamba sehemu za mafunzo, uthibitishaji na majaribio zilirekebishwa kila moja kwa kutumia thamani zake za \(\mu\) na \(\sigma\).
Uundaji wa lebo kwa Triple Barrier Method
Badala ya kuangalia tu mabadiliko ya wastani ya bei ya baadaye, utafiti hutumia Triple Barrier Method (TBM). Kwa bei ya kati ya sasa \(m_t\) na kizingiti cha jamaa \(\alpha\), vizuizi vya juu na chini ni:
\[ u_t=m_t(1+\alpha) \]
\[ \ell_t=m_t(1-\alpha) \]
Katika majaribio ya chanzo, \(\alpha=0.001\) na upeo wa muda \(k=100\) ulichaguliwa. Ikiwa kizuizi cha juu kinavukwa kwanza katika mfululizo wa bei za baadaye, lebo \(+1\) huundwa; ikiwa kizuizi cha chini kinavukwa kwanza, \(−1\); na ikiwa hakuna kinachovukwa hadi kizuizi cha muda, \(0\) huundwa. Kwa hiyo lebo haitegemei tu thamani ya bei ya baadaye katika wakati fulani, bali pia kizuizi gani cha bei hutokea kwanza ndani ya upeo uliowekwa.
Kwa Nini Regression ya Kiutaratibu Ni Muhimu Katika Tatizo Hili la HFT?
Regression ya kiutaratibu ni muhimu katika tatizo hili kwa sababu madarasa −1, 0 na +1 kwa asili yana mpangilio \(−1 \prec 0 \prec +1\), na si makosa yote ya uainishaji yanawakilisha mwelekeo uleule wa kiuchumi. Wakati darasa halisi ni +1, kutabiri 0, na wakati darasa halisi ni +1, kutabiri −1, si makosa yenye umbali sawa; utafiti unalenga kuingiza muundo huu katika funksheni ya hasara ili modeli ijifunze pia ukali wa makosa.
Cross-entropy ya kawaida ya madarasa mengi huthawabisha uwezekano uliotolewa kwa darasa sahihi, lakini haitumii moja kwa moja umbali kati ya madarasa yasiyo sahihi. Katika chanzo, cross-entropy ya kawaida huandikwa:
\[ \mathcal{L}_{CE}=-\mathbf{y}^{T}\log(\mathbf{p}) \]
Hapa \(\mathbf{y}\) ni uwakilishi wa one-hot wa darasa halisi, na \(\mathbf{p}\) ni uwezekano wa madarasa wa modeli.
Ordinal Log-Loss inayotumiwa katika utafiti huongeza matriki ya gharama \(\mathbf{C}\):
\[ \mathcal{L}_{OLL} =-\sum_{l\in\mathcal{L}}\log(1-p_l)c_{y,l}^{\alpha} \]
Katika utafiti wa chanzo, \(\alpha=1\) huchukuliwa kwa OLL. Hivyo usemi huwa:
\[ \mathcal{L}_{OLL} =-\mathbf{y}^{T}\mathbf{C}\log(\mathbf{1}-\mathbf{p}) \]
Katika mlinganyo huu, \(c_{y,l}\) huamua, wakati darasa halisi ni \(y\), uwezekano unaoelekezwa kwa darasa \(l\) utaadhibiwa kwa ukali kiasi gani. Sehemu muhimu ya utafiti inalenga hasa jinsi gharama hizi zinavyohesabiwa.
Mbinu nne za matriki ya gharama
Utafiti unalinganisha mbinu nne: Linear (L), SLACE (S), Mahalanobis (M) na Wasserstein (W). Matriki zote huhesabiwa kutoka kwenye data ya mafunzo pekee, na data ya uthibitishaji au majaribio haitumiki kuunda matriki ya gharama ili kuzuia uvujaji wa data. Ili kurahisisha ulinganisho, kila matriki hugawanywa kwa kipengele chake kikubwa zaidi na kupimwa katika masafa ya \([0,1]\).
Mbinu ya Linear inategemea tu mpangilio wa madarasa:
\[ c_{i,j}=|i-j| \]
Mbinu hii huadhibu kosa kati ya −1 na +1 kwa ukali zaidi kuliko kosa kati ya madarasa jirani; hata hivyo, haitumii jinsi usambazaji wa data za madarasa unavyofanana kwa kweli.
Mbinu inayotegemea SLACEhutumia thamani za proximity zinazotokana na marudio ya madarasa. Kutokana na kutokuwiana kukubwa sana kwa madarasa katika mkusanyiko wa data, matriki ya gharama inayotokea ni asymmetrical kwa kiwango kikubwa. Majaribio yanaonyesha kuwa sifa hii inaweza kuhusishwa hasa na mwelekeo wa kupita kiasi kuelekea darasa la neutral.
Mbinu ya Mahalanobishubadilisha ingizo la ukubwa wa \(40\times100\) kuwa vekta yenye urefu wa \(4000\), kisha hupima tofauti kati ya viwakilishi vya madarasa kwa kutumia covariance ya data:
\[ c_{i,j} = \sqrt{(\bar{\mathbf v}_i-\bar{\mathbf v}_j)^T \mathbf{\Sigma}^{-1} (\bar{\mathbf v}_i-\bar{\mathbf v}_j)} \]
Hapa \(\mathbf{\Sigma}\) ni matriki iliyokadiriwa ya covariance ya maingizo. Maandishi ya chanzo yanafafanua \(\bar{\mathbf v}_j\) kama wastani wa maingizo katika darasa husika. Hata hivyo, katika Mlinganyo (5.12) wa chanzo, kipengele cha kugawanya kwa idadi ya sampuli kwa wastani huu hakionekani; tofauti hii ya notation haijasahihishwa kimya kimya hapa.
Matriki ya Gharama Inayotegemea Wasserstein Huundwaje?
Matriki ya gharama inayotegemea Wasserstein hubadilisha maingizo ya LOB ya kila darasa kuwa uwakilishi wa Order Book Imbalance wa mwelekeo mmoja, huunda usambazaji tofauti wa OBI kwa madarasa −1, 0 na +1, na hufafanua gharama kati ya madarasa kama umbali wa Wasserstein-1 wa usambazaji huo. Hivyo adhabu haitegemei tu faharasa ya darasa, bali pia utengano wa kitakwimu wa madarasa katika data ya mafunzo.
Ikiwa kazi za usambazaji limbikizi za usambazaji mbili za mwelekeo mmoja ni \(U\) na \(V\), umbali wa Wasserstein-1 ni:
\[ W_1(u,v)=\int_{-\infty}^{+\infty}|U(x)-V(x)|\,dx \]
unaonyeshwa kwa namna hii.
Kwa kuwa maingizo ya LOB yana vipimo vingi, utafiti kwanza huondoa bei na hutumia tu ujazo wa kununua/kuuza. Ingizo hubadilishwa kuwa tenza \(X_{ijk}\) inayojumuisha mwelekeo wa kununua/kuuza, kiwango cha LOB na mihimili ya muda. Ubadilishaji wa OBI uliopendekezwa katika utafiti ni:
\[ \mathrm{OBI} = \sum_{i=1}^{2} \sum_{j=1}^{N} \sum_{k=1}^{W} (-1)^i\lambda^{j+k}X_{ijk} \]
Hapa \(\lambda\) hupunguza kwa njia ya kiexponential athari za viwango vya LOB vilivyo ndani zaidi na sampuli za muda za zamani zaidi. Katika majaribio, \(\lambda=0.5\) ilitumiwa. Thamani za OBI za kila lebo huunda usambazaji tofauti, na gharama:
\[ c_{i,j}=W_1(u_i,u_j) \]
hufafanuliwa hivyo.
Kielelezo 6 cha chanzo kinaonyesha usambazaji wa OBI uliowekewa sharti la darasa. Wakati madarasa −1 na +1 yakisogea katika pande tofauti za mhimili wa OBI, darasa la neutral linaonyesha usambazaji ulio katikati zaidi karibu na 0 na wenye mikia mipana zaidi. Muundo huu wa usambazaji hutumiwa kueleza kwa nini katika matriki ya gharama, umbali kati ya madarasa jirani unakaribiana lakini unatofautiana kwa maana na sifuri.
QMTL Inawezaje Kutumiwa Bila Kuongeza Gharama ya Utoaji wa Utabiri?
QMTL huunganisha vichwa vingi vya matokeo vinavyotabiri lengo lilelile kwenye kisimbaji cha pamoja wakati wa mafunzo; mafunzo yanapokamilika, vichwa vya ziada huondolewa na hutumiwa kichwa kimoja tu, kwa hiyo usanifu msingi wa utoaji wa utabiri wa modeli iliyowekwa si lazima uongezeke. Katika utafiti huu QMTL haitumiki kama ensemble; lengo ni kuhamisha athari ya mafunzo yenye vichwa vingi kwenye kisimbaji cha pamoja kwenda kwenye utoaji wa utabiri wa kichwa kimoja.
Katika QMTL, kila kichwa hutabiri lengo lilelile la −1/0/+1. Chanzo kinajadili chaguo tofauti za kuhamia kichwa kimoja mwishoni mwa mafunzo; katika majaribio, mbinu rahisi zaidi huchaguliwa na kichwa kimoja huhifadhiwa kwa nasibu. Chaguo hili limeainishwa hasa kama eneo wazi la kuboresha katika tafiti zijazo.
Gradient Normalization (GradNorm) hutumiwa kusawazisha hasara za vichwa vingi. Hasara ya jumla ya kazi nyingi:
\[ \mathcal{L}_{total}=\sum_{i=1}^{m}w_i\mathcal{L}_i \]
inaweza kufikiriwa kwa namna hii. GradNorm inalenga kurekebisha uzani \(w_i\) wakati wa mafunzo kulingana na kasi za jamaa za kujifunza za kazi. Katika utafiti huu, ingawa malengo ya kazi ni yale yale, GradNorm ilichaguliwa kwa sababu kasi za kujifunza za vichwa tofauti si sawa.
Usanifu mitatu iliyojaribiwa
Modeli ya Baselineinategemea vikundi vinne vya tabaka za convolution zinazochakata ingizo la LOB na tabaka moja iliyounganishwa kikamilifu inayotoa madarasa matatu. Katika urekebishaji wa QMTL, sehemu ya CNN hutumiwa kama kisimbaji cha pamoja na sehemu ya mwisho iliyounganishwa kikamilifu kama kichwa.
DeepLOBinaunganisha tabaka za convolution na muundo wa inception pamoja na LSTM. Katika utafiti, sehemu ya CNN na inception hutumiwa kama mwili wa pamoja, huku LSTM na sehemu ya mwisho iliyounganishwa kikamilifu zikitumiwa kama kichwa cha kazi. Kwa kuwa chaguo hili linaongeza gharama ya hesabu kwa kila kichwa, muda wa mafunzo wa QMTL huongezeka zaidi katika DeepLOB.
MLPLOBinajumuisha hasa tabaka zilizounganishwa kikamilifu na muundo wa MLP unaofanya uchakataji kwa kupishana kwenye mihimili ya anga/muda. Bloku za mwisho zilizounganishwa kikamilifu hutumiwa kama vichwa, na sehemu ya awali kama kisimbaji cha pamoja.
Mbinu na Matokeo ya Utafiti
Mgawanyo wa data na kutokuwiana kwa madarasa
Utafiti hutumia data ya Oktoba 2025 kwa mafunzo na uthibitishaji, na data ya Novemba 2025 kwa majaribio. Data ya Oktoba imegawanywa ndani yake kuwa %80 mafunzo na %20 uthibitishaji. Sehemu ya majaribio kuwa karibu nusu ya data yote si ya kawaida ikilinganishwa na tafiti za kawaida za machine learning; chanzo kinaeleza hali hii kwa ukubwa mkubwa sana wa data na kwamba kikwazo kikuu ni gharama ya hesabu ya mafunzo.
| Sehemu | Picha ya papo hapo ya LOB | Ingizo la modeli |
|---|---|---|
| Mafunzo | 8.570.879 | 428.540 |
| Uthibitishaji | 2.142.720 | 107.132 |
| Majaribio | 10.499.327 | 524.962 |
| Jumla | 21.212.926 | 1.060.634 |
| Sehemu | −1 | 0 | +1 |
|---|---|---|---|
| Mafunzo | 5.400 (%1,3) | 417.869 (%97,5) | 5.271 (%1,2) |
| Uthibitishaji | 1.050 (%1,0) | 104.936 (%98,0) | 1.146 (%1,1) |
| Majaribio | 5.932 (%1,1) | 513.518 (%97,8) | 5.512 (%1,0) |
Takriban %98 ya data kuwa katika darasa 0 kunaweza kufanya accuracy ghafi pekee iwe ya kupotosha. Modeli inaweza kupata accuracy ya juu sana kwa kutabiri sampuli zote kama 0, lakini isiwe na uwezo wa kutofautisha mienendo ya mwelekeo −1 na +1. Kwa hiyo utafiti hutumia uzani wa madarasa:
\[ w_i=\frac{N}{C\,n_i} \]
Hapa \(N\) ni idadi ya jumla ya sampuli, \(C\) ni idadi ya madarasa, na \(n_i\) ni idadi ya sampuli katika darasa husika.
Vipimo vya tathmini
Pamoja na Accuracy, precision, recall na F1-score, Cohen's kappa na Restricted Accuracy (RA) hutumiwa. Cohen's kappa:
\[ \kappa=\frac{p_o-p_e}{1-p_e} \]
hupima kwa usemi huu kiwango ambacho ulinganifu wa uainishaji unaoonekana ni wa juu kuliko ulinganifu unaotarajiwa kutokana na bahati pekee. Hasa katika mikusanyiko ya data yenye kutokuwiana kukubwa sana, inaweza kuwa na maelezo zaidi kuliko accuracy pekee.
Restricted Accuracy, kwa mujibu wa ufafanuzi wa utafiti, imeundwa hasa kufuatilia jinsi utabiri wa mwelekeo −1 na +1 unavyotenganishwa kwa usahihi. Katika kipeo cha Mlinganyo (3.16) wa chanzo, neno lilelile la \(n_{-1,+1}\) linaonekana kuchapishwa mara mbili. Kwa hiyo fomula haijaandikwa upya hapa kwa kufanya marekebisho ambayo hayapo kwenye chanzo; kipimo kimetafsiriwa kwa mujibu wa maelezo ya maneno ya mwandishi.
Itifaki ya mafunzo
- Vifaa: klasta ya NVIDIA A40 GPU; kila mafunzo ya modeli moja yanafanyika kwenye GPU moja.
- Optimizer: Adam.
- Learning rate: \(10^{-3}\).
- Weight decay: \(10^{-4}\).
- Early stopping: patience = 10 kwenye hasara iliyounganishwa ya uthibitishaji.
- Hatua ya majaribio: checkpoint yenye hasara bora zaidi ya uthibitishaji.
- Utabiri wa majaribio wa QMTL: kichwa kimoja tu, kilichochaguliwa kwa nasibu katika itifaki ya majaribio ya utafiti.
- Mishale ya makosa: muda wa kujiamini wa %95 kwa wastani wa majaribio yaliyorudiwa.
- Mchanganyiko wa gharama/kichwa wa Baseline: kila mchanganyiko marudio 100.
- Mchanganyiko wa usanifu wa hali ya juu: kila mchanganyiko marudio 40.
Katika sehemu kuu ya experiment setup ya chanzo, ukubwa wa mini-batch na random seed havijaripotiwa wazi. Taarifa hizi ni vigezo vinavyokosekana kwenye chanzo kwa upande wa ukamilifu wa kurudiwa kwa utafiti; hakuna thamani iliyobuniwa hapa.
Matriki za gharama zilizopatikana kutoka kwenye data
Thamani zifuatazo zimehesabiwa kutoka kwenye data ya mafunzo pekee na kurekebishwa ili thamani ya juu ya kila matriki iwe 1. Safu mlalo zinaonyesha darasa halisi, na safu wima darasa ambalo gharama inatumika kwake.
| Halisi \ Lengo | −1 | 0 | +1 |
|---|---|---|---|
| −1 | 0 | 0,500 | 1,000 |
| 0 | 0,500 | 0 | 0,500 |
| +1 | 1,000 | 0,500 | 0 |
| Halisi \ Lengo | −1 | 0 | +1 |
|---|---|---|---|
| −1 | 0 | 0,138 | 1,000 |
| 0 | 0,860 | 0 | 0,865 |
| +1 | 0,995 | 0,137 | 0 |
| Halisi \ Lengo | −1 | 0 | +1 |
|---|---|---|---|
| −1 | 0 | 0,796 | 1,000 |
| 0 | 0,796 | 0 | 0,921 |
| +1 | 1,000 | 0,921 | 0 |
| Halisi \ Lengo | −1 | 0 | +1 |
|---|---|---|---|
| −1 | 0 | 0,639 | 1,000 |
| 0 | 0,639 | 0 | 0,625 |
| +1 | 1,000 | 0,625 | 0 |
Tabia ya funksheni za hasara katika majaribio ya Baseline
Katika Kielelezo 7 cha chanzo, mipangilio yenye vichwa 1 hadi 5 vya QMTL inalinganishwa. Kwa kuwa kila mchanganyiko wa kichwa-hasara uliendeshwa mara 100, mielekeo kwenye grafu haitegemei uendeshaji mmoja wa mafunzo bali wastani wa marudio.
Mbinu ya Wasserstein ndiyo mbinu yenye nguvu na uthabiti zaidi kwa upande wa F1-score na Cohen's kappa. Kadiri idadi ya vichwa inavyoongezeka, ongezeko la hatua kwa hatua linaonekana pia katika thamani ya F1. Ingawa Mahalanobis hukaribia katika baadhi ya mipangilio, inaonyesha mabadiliko makubwa zaidi kati ya majaribio.
Mbinu inayotegemea SLACE inaonyesha tatizo kubwa la kutokuwiana kwa madarasa. Licha ya kutoa takriban %98 accuracy, Cohen's kappa iko karibu na sifuri na Restricted Accuracy ni sifuri. Ukaguzi wa utabiri kwenye chanzo unaonyesha kuwa modeli kwa vitendo huchagua darasa 0 pekee. Hili ni mfano wazi wa kwa nini accuracy ya juu pekee si kipimo cha kuaminika cha mafanikio katika uainishaji wenye kutokuwiana kukubwa sana.
Mbinu ya Linear pia huonyesha utendaji mdogo katika hali ya kichwa kimoja, lakini kadiri idadi ya vichwa inavyoongezeka huleta uboreshaji mkubwa katika precision na Restricted Accuracy. Mbinu ya Wasserstein huboresha matokeo yake ya kichwa kimoja ambayo tayari ni mazuri kwa kiwango kidogo zaidi lakini kinachoonekana katika mafunzo yenye vichwa vingi.
Mpangilio wa mbinu kwa upande wa accuracy ni tofauti na ule wa vipimo vingine. Katika maandishi ya chanzo, SLACE na Linear zimeripotiwa karibu %98, Wasserstein karibu %87, na Cross-Entropy pamoja na Mahalanobis karibu %76. Tofauti hii inaonyesha kwamba accuracy ya juu inaweza kwa kiasi kikubwa kutokana na kutabiri darasa 0 linalotawala, na kwamba inapaswa kutathminiwa pamoja na uwezo wa kunasa mienendo ya mwelekeo.
Gharama ya mafunzo ya QMTL
Ingawa mafunzo yenye vichwa vingi hayahamishiwi kwenye gharama ya utoaji wa utabiri, mafunzo yenyewe si bure. Kielelezo 8 cha chanzo kinaonyesha kuwa muda halisi wa mafunzo huongezeka kwa takriban mstari kadiri idadi ya vichwa inavyoongezeka. Hata hivyo, katika mipangilio mingi, kadiri idadi ya vichwa inavyoongezeka, idadi ya epoch zinazohitajika kufikia early stopping hupungua. Mwandishi anajadili kwamba tabia hii inaweza kuhusishwa na convergence ya haraka zaidi, athari ya regularization ya mafunzo yenye vichwa vingi, au mchanganyiko wa mifumo yote miwili; utafiti hauonyeshi ni mfumo upi ndio sababu mahususi.
Majaribio ya usanifu wa hali ya juu kwa DeepLOB na MLPLOB
Ili kupunguza gharama ya hesabu, katika usanifu wa hali ya juu ni Cross-Entropy (C) ya kawaida pekee iliyolinganishwa na Wasserstein (W), ambayo ndiyo mbinu ya gharama yenye mafanikio zaidi. Kielelezo 9 cha chanzo kinawasilisha matokeo kwa Baseline, DeepLOB na MLPLOB katika vichwa 1-5, kwa jumla ya marudio 40.
Katika muundo wa jumla, hasara ya Wasserstein hutoa matokeo bora kuliko toleo la Cross-Entropy la usanifu huohuo katika vipimo vingi. Isipokuwa ya kawaida iliyo wazi zaidi ni recall; katika usanifu wote mitatu, Cross-Entropy hufikia thamani za juu zaidi za recall. Kwa DeepLOB, precision na Restricted Accuracy, na kwa Baseline pia Restricted Accuracy, ni tofauti na ubora wa jumla wa Wasserstein katika baadhi ya mipangilio.
Katika MLPLOB, kadiri idadi ya vichwa inavyoongezeka pamoja na Wasserstein, baadhi ya vipimo kama F1-score, Cohen's kappa na accuracy huongezeka huku Restricted Accuracy ikipungua. Chanzo kinahusisha hili na mabadilishano ya utendaji kati ya uainishaji bora wa darasa la neutral, ambalo tayari ni takriban %98, na kuzingatia madarasa adimu ya ±1.
Katika DeepLOB, baadhi ya vipimo vya mwendo wa mwelekeo huboreka kadiri idadi ya vichwa inavyoongezeka, huku accuracy na Cohen's kappa zikiweza kupungua. Kwa hiyo athari ya QMTL inategemea usanifu na kipimo kilichochaguliwa; utafiti hauungi mkono hitimisho kwamba “vichwa vingi zaidi daima ni bora”.
Katika ulinganisho wa modeli, Baseline ni imara kwa F1 na precision; DeepLOB hutoa matokeo ya juu kwa accuracy na Cohen's kappa; MLPLOB ni imara kwa recall na hasa Restricted Accuracy. Kwa hiyo chanzo hakitangazi usanifu mmoja kuwa bora kwa malengo yote.
Je, Matokeo Haya Yanathibitisha Mkakati wa HFT Wenye Faida?
Hapana. Utafiti hupima vipimo vya uainishaji wa mwelekeo wa soko na tabia ya mafunzo kwenye data ya kihistoria ya BTC/USDT LOB; faida halisi, gharama za miamala, athari ya bid-ask spread, slippage, nafasi katika foleni ya oda, ucheleweshaji halisi wa mwisho hadi mwisho, au utendaji wa utekelezaji wa oda moja kwa moja si vigezo vikuu vya matokeo ya majaribio. Kwa hiyo F1, kappa au Restricted Accuracy ya juu haiwezi kutafsiriwa moja kwa moja kama mkakati wa HFT wenye faida.
Matokeo yanayoungwa mkono na utafiti
- Jukumu la mwelekeo wa soko wa −1, 0 na +1 linaweza kuundwa kama muundo wa kiutaratibu.
- Muundo wa matriki ya gharama ndani ya OLL unaweza kubadilisha sana tabia ya modeli.
- Katika mkusanyiko huu wa data, matriki ya gharama inayotegemea Wasserstein hutoa kwa ujumla matokeo thabiti zaidi kati ya mbinu mbadala zilizochunguzwa.
- QMTL inaweza kuboresha mafunzo kabla ya utoaji wa utabiri wa kichwa kimoja katika baadhi ya funksheni za hasara na usanifu.
- Kuondoa vichwa vya ziada baada ya mafunzo yenye vichwa vingi huzuia gharama ya hesabu ya vichwa hivyo kuhamia kwenye usanifu msingi wa uwekaji.
- Kutokana na kutokuwiana kukubwa kwa madarasa, accuracy pekee si kipimo cha kutosha cha tathmini.
Ujumla ambao utafiti hauuungi mkono
- Matokeo hayawezi kuenezwa moja kwa moja kwa masoko yote ya hisa, fedha za kigeni au kripto.
- Haijaonyeshwa kwamba matriki ya gharama ya Wasserstein itakuwa bora kuliko Cross-Entropy katika kila mkusanyiko wa data.
- Haijaonyeshwa kwamba vichwa vingi zaidi vya QMTL huongeza utendaji katika kila usanifu na kila kipimo.
- Kuongezeka kwa utendaji wa uainishaji hakuthibitishi kwamba faida halisi ya biashara itaongezeka.
- Utafiti haujathibitisha faida ya ucheleweshaji wa mwisho hadi mwisho katika miundombinu ya moja kwa moja ya HFT.
- Kwa kuwa BTC/USDT pekee na kipindi cha miezi miwili ndivyo vilivyochunguzwa, regimes tofauti za soko zinahitaji uthibitishaji tofauti.
Gharama ya hesabu na uendelevu
Tasnifu pia hupima gharama ya nishati ya mafunzo ya modeli. Katika kundi la mwisho la majaribio, Baseline ilitumia jumla ya saa 150,44 za mafunzo na 16,55 kWh; DeepLOB saa 726,02 na 177,87 kWh; MLPLOB saa 27,7 na 5,54 kWh. Kwa pamoja, zilitumia saa 904,16 za mafunzo ya GPU na 199,96 kWh za nishati.
| Modeli | Jumla ya muda wa mafunzo | Nguvu ya wastani | Nishati |
|---|---|---|---|
| Baseline | saa 150,44 | 110 W | 16,55 kWh |
| DeepLOB | saa 726,02 | 245 W | 177,87 kWh |
| MLPLOB | saa 27,7 | 200 W | 5,54 kWh |
| Jumla | saa 904,16 | - | 199,96 kWh |
Mwandishi anakadiria matumizi ya jumla ya nishati ya mafunzo ya modeli kuwa takriban 399,92 kWh ili kuzingatia mafunzo ya ziada yaliyofanywa wakati wa maendeleo. Matumizi yaliyokadiriwa ya kompyuta ya maendeleo yakiongezwa, takriban 487,92 kWh huhesabiwa kwa mradi. Lengo la sehemu hii ni kuonyesha kwamba faida inayowezekana ya nishati kutokana na kutumia modeli ndogo wakati wa utoaji wa utabiri inapaswa kutathminiwa pamoja na gharama ya ziada ya mafunzo inayotokana na taratibu ngumu zaidi za mafunzo.
Maelezo ya Chanzo na Mbinu
Kichwa asili: Distance-based Loss functions for High-Frequency Trading
Mwandishi: Jonathan Rodríguez Barja
Msimamizi wa tasnifu: Daniel P. Palomar
Tutor wa eneo: Jordi Castro
Taasisi: Universitat Politècnica de Catalunya - BarcelonaTech (UPC); utafiti ulifanywa katika HKUST. Hati hii ni ya programu ya shahada mbili ya Data Science & Engineering / Engineering Physics chini ya Centre de Formació Interdisciplinària Superior (CFIS).
Aina ya chanzo: Tasnifu ya mwisho ya shahada ya kwanza / Bachelor thesis / Treball Final de Grau.
Tarehe: Tarehe ya jalada la PDF ni Februari 2026; tarehe rasmi ya usajili kwenye repository ni 26 Februari 2026.
Jukwaa: UPCommons, hifadhi ya kitaaluma ya kitaasisi ya Universitat Politècnica de Catalunya.
Kitambulisho cha kudumu cha rekodi: 2117/457644.
DOI: DOI haijatajwa katika chanzo wala katika rekodi rasmi ya repository.
Jarida / jalada / toleo: Haitumiki; utafiti si makala ya jarida.
Hali ya uhakiki wa rika: Si makala ya jarida iliyohakikiwa na rika. Ni kazi ya mwisho ya shahada ya kwanza ya chuo kikuu.
Ufikiaji na leseni: Rekodi rasmi ya repository inatoa ufikiaji wazi na inaonyesha kazi chini ya leseni ya CC BY-NC-ND 4.0. Kutokana na sharti la NoDerivatives, maandishi ya Verianla hayakuundwa kama tafsiri au uandishi upya wa karibu wa maandishi ya chanzo; vielelezo vya chanzo havikutumiwa kwa kubadilishwa au kuwekwa katika mtindo mpya. Mbinu ya kisayansi, nambari zinazoweza kuthibitishwa, milinganyo na matokeo yamepangwa upya kwa maelezo huru ya kufundisha.
Chanzo cha data: Data ya Binance BTC/USDT LOB kupitia CryptoHFTData. Kipindi cha tarehe kilichotumiwa katika utafiti ni 1 Oktoba-30 Novemba 2025.
Programu na maendeleo: Utafiti ulirekebisha mfumo unaotegemea LibMTL; ukaongeza vipengele kama QMTL, early stopping na logging kwa Weights & Biases. Hakuna tamko tofauti kuhusu upatikanaji wa msimbo au leseni ya msimbo lililotolewa katika chanzo.
Ufadhili: Hakuna tamko tofauti la ufadhili katika muundo wa kawaida kwenye chanzo. Sehemu ya shukrani inataja usaidizi wa CFIS; tamko hili halijafasiriwa upya kama mfuko wa utafiti au ruzuku ya mradi.
Mgongano wa maslahi: Hakuna tamko tofauti la mgongano wa maslahi lililotambuliwa katika chanzo.
Mapungufu makuu ya kimethodolojia: Mali moja na soko moja la ubadilishaji; kipindi cha kihistoria cha miezi miwili pekee; kutokuwiana kukubwa kwa madarasa kukiwa na takriban %98 darasa la neutral; vipimo vya uainishaji badala ya faida halisi ya biashara; uchaguzi wa nasibu wa kichwa cha utoaji wa utabiri katika QMTL; utegemezi wa gharama ya Wasserstein kwa ubadilishaji wa OBI maalum kwa matumizi; na kutoripotiwa wazi kwa baadhi ya maelezo ya mafunzo, kama ukubwa wa mini-batch na random seed.
Tahadhari ya notation ndani ya chanzo 1: Katika kipeo cha Restricted Accuracy kwenye Mlinganyo (3.16), neno moja la uainishaji mtambuka linaonekana kurudiwa. Verianla haijasahihisha usemi huu kimya kimya.
Tahadhari ya notation ndani ya chanzo 2: Mlinganyo (5.12) unatoa usemi wa jumla kwa \(\bar{\mathbf v}_j\), ambao unaelezwa kwenye maandishi kama wastani wa darasa, lakini fomula inayoonekana haina neno la kugawanya kwa idadi ya sampuli za darasa. Tofauti hii imehifadhiwa pia katika maelezo ya mbinu ya Mahalanobis.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *