

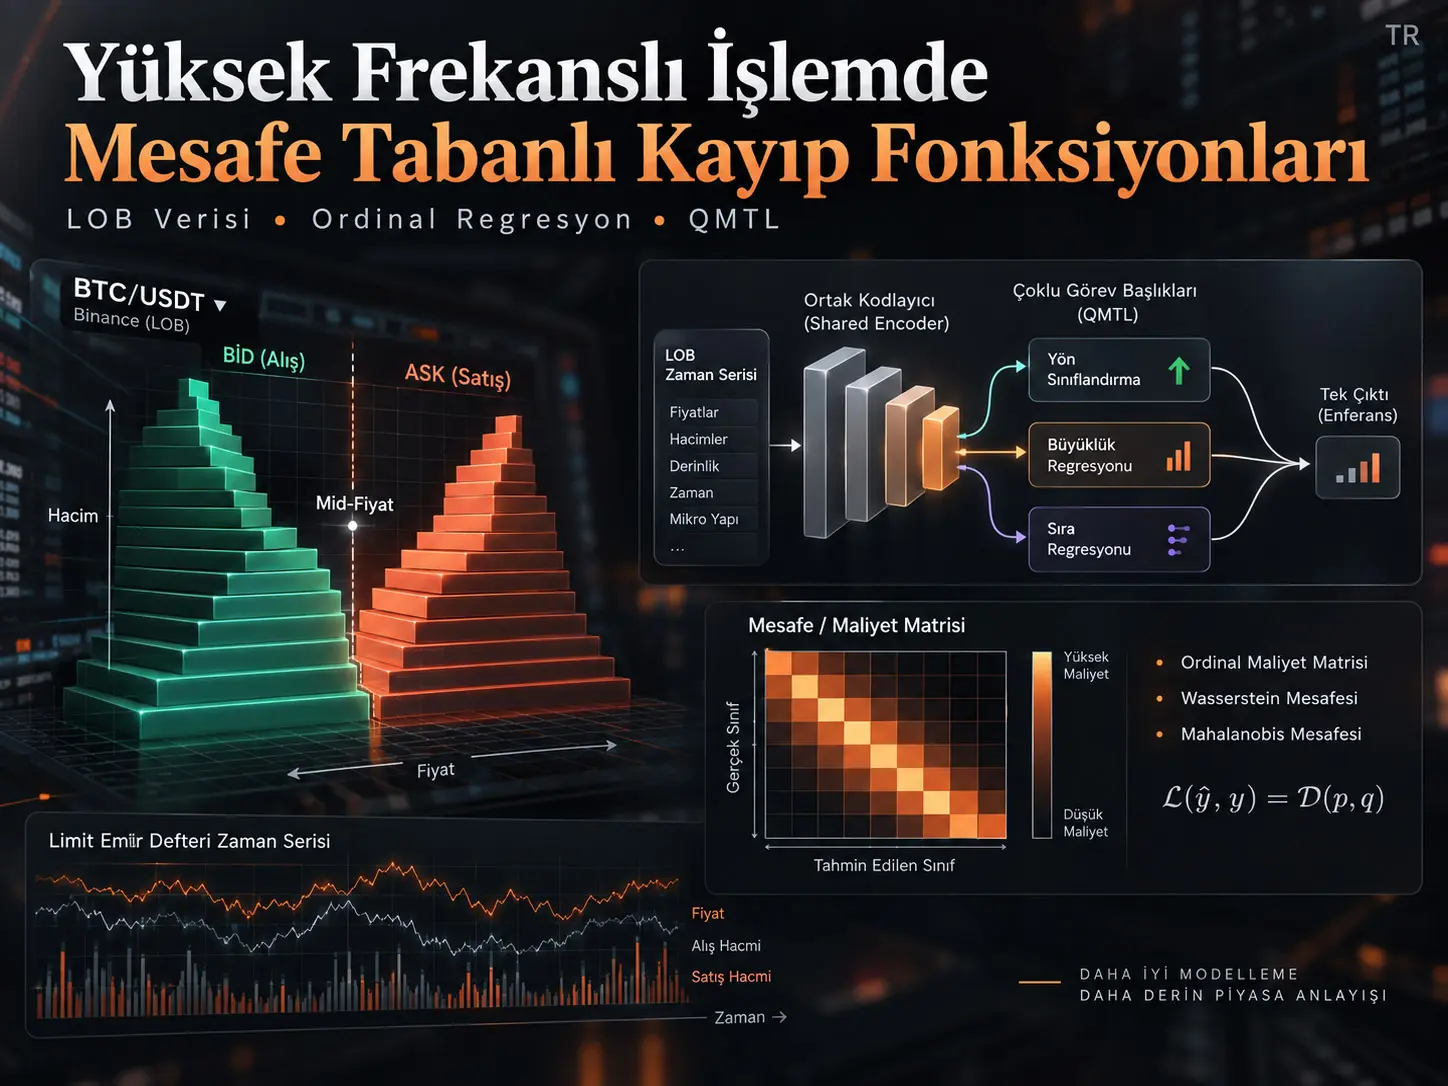
Bu çalışma, yüksek frekanslı işlemde (High-Frequency Trading, HFT) kısa vadeli piyasa yönünü tahmin eden derin öğrenme modellerinin, çıkarım aşamasındaki mimariyi büyütmeden eğitim sırasında nasıl geliştirilebileceğini inceler. Araştırmada Binance BTC/USDT piyasasından CryptoHFTData aracılığıyla elde edilen Limit Order Book (LOB) verileri kullanılmış; 1 Ekim-30 Kasım 2025 dönemindeki emir defteri akışı 250 ms aralıklarla örneklenmiş ve gelecekteki orta fiyat hareketi −1, 0 ve +1 olmak üzere üç sınıfa ayrılmıştır. Temel yöntemler, sınıflar arasındaki hataların aynı önemde olmadığını hesaba katan Ordinal Log-Loss (OLL) ile veri dağılımlarından türetilen maliyet matrisleri ve eğitim sırasında aynı görevi gerçekleştiren birden fazla baş kullanan Quasi-Multi-Task Learning (QMTL) yaklaşımıdır. Deneylerde Wasserstein uzaklığıyla oluşturulan maliyet matrisi, standart çapraz entropiye ve diğer maliyet matrisi tasarımlarına karşı genel olarak en tutarlı performansı göstermiş; QMTL ise bazı mimari ve metriklerde çok başlı eğitimin ardından yalnız tek baş bırakıldığında dahi yararlı olabileceğine ilişkin deneysel kanıt sağlamıştır. Bununla birlikte sonuçlar tek bir kripto varlığı, tek bir borsa, iki aylık tarihsel veri ve sınıflandırma metrikleriyle sınırlıdır; çalışma gerçek zamanlı emir yürütme veya net işlem kârlılığını kanıtlamaz.
Limit Emir Defteri (Limit Order Book, LOB), belirli bir varlığa ait bekleyen limit alış ve satış emirlerini fiyat seviyeleri ve hacimleriyle temsil eden elektronik piyasa yapısıdır. Ordinal Log-Loss (OLL), sınıflandırma hatalarını bir maliyet matrisi aracılığıyla farklı şiddetlerde cezalandırabilen ordinal sınıflandırma kaybıdır. Quasi-Multi-Task Learning (QMTL) ise aynı hedefi tahmin eden birden fazla başı ortak bir kodlayıcıyla birlikte eğitip, çıkarım aşamasında bu ek başları kaldırmaya olanak veren çok görevli eğitim yaklaşımıdır.
| Öğe | Kaynakta kullanılan değer |
|---|---|
| Piyasa | Binance BTC/USDT |
| Veri kaynağı | CryptoHFTData |
| Dönem | 1 Ekim-30 Kasım 2025 |
| Zaman örneklemesi | 250 ms |
| LOB seviyesi | İlk 10 seviye |
| Girdi penceresi | 100 LOB anlık görüntüsü |
| Pencere adımı | 20 örnek |
| Etiketler | −1, 0, +1 |
| Etiketleme | Triple Barrier Method; α = 0.001, k = 100 |
| Test edilen modeller | Baseline CNN, DeepLOB, MLPLOB |
Problem neden yalnız daha büyük bir model kurmak değildir?
Yüksek frekanslı işlemde bir modelin tahmin kalitesi kadar tahminin ne kadar hızlı üretilebildiği de önemlidir. Büyük bir sinir ağı sınıflandırma doğruluğunu artırsa bile çıkarım süresini büyütüyorsa gecikmeye duyarlı kullanım için pratik değerini kaybedebilir. Bu nedenle çalışmanın amacı yeni ve daha büyük bir HFT mimarisi geliştirmek değildir. Araştırma, mevcut mimarilerin eğitim prosedürünü değiştirerek aynı çıkarım mimarisiyle daha iyi tahmin davranışı elde edilip edilemeyeceğini araştırır.
Bu tercih çalışmayı iki tamamlayıcı yöne götürür. Birinci yön, −1, 0 ve +1 piyasa yönü sınıflarının doğal bir sırası bulunduğunu dikkate alan ordinal regresyondur. İkinci yön ise modelin yalnız eğitim sırasında birden fazla çıkış başıyla çalıştığı QMTL'dir. Her iki yaklaşım da dağıtım sırasında model gövdesini zorunlu olarak büyütmeden eğitim bilgisini zenginleştirmeyi amaçlar.
LOB verisi model girdisine nasıl dönüşür?
Bir LOB anlık görüntüsünde her seviye için alış fiyatı, alış hacmi, satış fiyatı ve satış hacmi bulunur. Çalışma ilk \(N=10\) seviyeyi kullanır. Tek bir LOB görüntüsü böylece \(4N=40\) özellik taşır. Model girdisi oluşturulurken ardışık \(W=100\) görüntü bir araya getirilir ve giriş tensörü \(4N \times W = 40 \times 100\) boyutuna ulaşır.
Ham CryptoHFTData akışı yalnız düzenli anlık görüntülerden oluşmaz; saatlik tam görüntülerle aradaki değişiklik güncellemelerini birlikte içerir. Çalışmada bu olay tabanlı akış önce yeniden yapılandırılır, ardından \(\delta t=250\,\mathrm{ms}\) aralıklarla düzenli örneklenir. Bir aralıkta birden fazla değişiklik varsa son durum seçilir; değişiklik yoksa önceki LOB durumu taşınır.
Girdi penceresi 100 örnek uzunluğundadır ve yeni bir veri noktası oluşturmak için pencere 20 örnek ilerletilir. Bu nedenle komşu girdiler kısmen örtüşür. Çalışma bu seçimi veri miktarını artırmak ve küçük zamansal kaymalara karşı daha kararlı örnekler oluşturmak amacıyla kullanır.
Orta fiyat ve gelecekteki hareket sınıfları
En iyi satış fiyatı \(p_t^{a1}\), en iyi alış fiyatı \(p_t^{b1}\) ile gösterildiğinde spread:
\[ s_t=p_t^{a1}-p_t^{b1} \]
ve orta fiyat:
\[ m_t=\frac{p_t^{a1}+p_t^{b1}}{2} \]
olarak tanımlanır. Çalışmanın hedefi doğrudan gelecekteki fiyat seviyesini regresyonla tahmin etmek değil, orta fiyatın yakın gelecekte anlamlı biçimde aşağı, yatay veya yukarı hareket edip etmeyeceğini sınıflandırmaktır.
Girdiler standart z-skoru ile normalize edilir:
\[ \tilde{x}_i=\frac{x_i-\mu}{\sigma} \]
Kaynak, eğitim, doğrulama ve test bölümlerinin kendi \(\mu\) ve \(\sigma\) değerleriyle ayrı ayrı normalize edildiğini belirtir.
Triple Barrier Method ile etiket üretimi
Çalışma, yalnız gelecekteki ortalama fiyat değişimine bakmak yerine Triple Barrier Method (TBM) kullanır. Mevcut orta fiyat \(m_t\) ve göreli eşik \(\alpha\) için üst ve alt bariyerler:
\[ u_t=m_t(1+\alpha) \]
\[ \ell_t=m_t(1-\alpha) \]
şeklindedir. Kaynak deneylerinde \(\alpha=0.001\) ve zaman ufku \(k=100\) seçilmiştir. Gelecek fiyat serisi boyunca önce üst bariyer aşılırsa etiket \(+1\), önce alt bariyer aşılırsa \(−1\), zaman bariyerine kadar ikisi de aşılmazsa \(0\) oluşturulur. Böylece etiket, yalnız gelecekteki fiyatın belirli bir andaki değerine değil, belirlenen ufuk içinde hangi fiyat bariyerinin önce gerçekleştiğine bağlıdır.
Ordinal Regresyon Bu HFT Probleminde Neden Önemlidir?
Ordinal regresyon bu problemde önemlidir çünkü −1, 0 ve +1 sınıfları doğal olarak \(−1 \prec 0 \prec +1\) sırasına sahiptir ve tüm sınıflandırma hataları aynı ekonomik yönü temsil etmez. Gerçek sınıf +1 iken 0 tahmin etmek ile gerçek sınıf +1 iken −1 tahmin etmek aynı uzaklıkta bir hata değildir; çalışma bu yapıyı kayıp fonksiyonuna taşıyarak modelin hataların şiddetini de öğrenmesini amaçlar.
Standart çok sınıflı çapraz entropi, doğru sınıfa verilen olasılığı ödüllendirir ancak yanlış sınıfların birbirine ne kadar uzak olduğunu doğrudan kullanmaz. Kaynakta klasik çapraz entropi:
\[ \mathcal{L}_{CE}=-\mathbf{y}^{T}\log(\mathbf{p}) \]
olarak yazılır. Burada \(\mathbf{y}\) gerçek sınıfın one-hot gösterimi, \(\mathbf{p}\) ise modelin sınıf olasılıklarıdır.
Çalışmanın kullandığı Ordinal Log-Loss ise bir maliyet matrisi \(\mathbf{C}\) ekler:
\[ \mathcal{L}_{OLL} =-\sum_{l\in\mathcal{L}}\log(1-p_l)c_{y,l}^{\alpha} \]
Kaynak çalışmada OLL için \(\alpha=1\) alınır. Böylece ifade:
\[ \mathcal{L}_{OLL} =-\mathbf{y}^{T}\mathbf{C}\log(\mathbf{1}-\mathbf{p}) \]
biçimine indirgenir. Bu denklemde \(c_{y,l}\), gerçek sınıf \(y\) iken \(l\) sınıfına yönelen olasılığın ne kadar ağır cezalandırılacağını belirler. Araştırmanın önemli bölümü tam olarak bu maliyetlerin nasıl hesaplanacağı üzerinedir.
Dört maliyet matrisi yaklaşımı
Çalışma dört yöntemi karşılaştırır: Linear (L), SLACE (S), Mahalanobis (M) ve Wasserstein (W). Tüm matrisler yalnız eğitim verisinden hesaplanır ve veri sızıntısını önlemek amacıyla doğrulama ya da test verisi maliyet matrisinin oluşturulmasında kullanılmaz. Karşılaştırmayı kolaylaştırmak için her matris kendi en büyük elemanına bölünerek \([0,1]\) aralığına ölçeklenir.
Linear yöntem yalnız sınıf sırasına dayanır:
\[ c_{i,j}=|i-j| \]
Bu yaklaşım −1 ile +1 arasındaki hatayı, komşu sınıflar arasındaki hatadan daha ağır cezalandırır; ancak sınıfların veri dağılımlarının gerçekte ne kadar benzediğini kullanmaz.
SLACE tabanlı yöntem, sınıf frekanslarından türetilen proximity değerlerini kullanır. Veri setindeki aşırı sınıf dengesizliği nedeniyle ortaya çıkan maliyet matrisi belirgin biçimde asimetriktir. Deneyler, bu özelliğin özellikle nötr sınıfa aşırı yönelmeyle ilişkili olabileceğini gösterir.
Mahalanobis yaklaşımı, \(40\times100\) boyutlu girdiyi uzunluğu \(4000\) olan vektöre dönüştürür ve sınıf temsilcileri arasındaki farkı veri kovaryansı ile ölçekler:
\[ c_{i,j} = \sqrt{(\bar{\mathbf v}_i-\bar{\mathbf v}_j)^T \mathbf{\Sigma}^{-1} (\bar{\mathbf v}_i-\bar{\mathbf v}_j)} \]
Burada \(\mathbf{\Sigma}\) girdilerin tahmini kovaryans matrisidir. Kaynak metin \(\bar{\mathbf v}_j\) niceliğini ilgili sınıftaki girdilerin ortalaması olarak tanımlar. Bununla birlikte kaynak Denklem (5.12)'de bu ortalamaya ait örnek sayısına bölme terimi görünmemektedir; bu notasyon farkı burada sessizce düzeltilmemiştir.
Wasserstein Tabanlı Maliyet Matrisi Nasıl Oluşturulur?
Wasserstein tabanlı maliyet matrisi, her sınıfın LOB girdilerini tek boyutlu bir Order Book Imbalance temsilcisine dönüştürür, −1, 0 ve +1 sınıfları için ayrı OBI dağılımları oluşturur ve sınıflar arasındaki maliyeti bu dağılımların Wasserstein-1 uzaklığı olarak tanımlar. Böylece ceza yalnız sınıf indeksine değil, sınıfların eğitim verisindeki istatistiksel ayrışmasına bağlı hale gelir.
Bir boyutlu iki dağılımın kümülatif dağılım fonksiyonları \(U\) ve \(V\) ise Wasserstein-1 uzaklığı:
\[ W_1(u,v)=\int_{-\infty}^{+\infty}|U(x)-V(x)|\,dx \]
şeklinde ifade edilir.
LOB girdileri çok boyutlu olduğu için çalışma önce fiyatları çıkarır ve yalnız alış/satış hacimlerini kullanır. Girdi, alış/satış yönü, LOB seviyesi ve zaman eksenlerini içeren \(X_{ijk}\) tensörüne dönüştürülür. Çalışmada önerilen OBI haritalaması:
\[ \mathrm{OBI} = \sum_{i=1}^{2} \sum_{j=1}^{N} \sum_{k=1}^{W} (-1)^i\lambda^{j+k}X_{ijk} \]
biçimindedir. \(\lambda\), daha derin LOB seviyelerinin ve daha eski zaman örneklerinin etkisini üstel olarak azaltır. Deneylerde \(\lambda=0.5\) kullanılmıştır. Her etiketin OBI değerleri ayrı bir dağılım meydana getirir ve maliyet:
\[ c_{i,j}=W_1(u_i,u_j) \]
olarak tanımlanır.
Kaynak Şekil 6'da sınıfa koşullu OBI dağılımları gösterilir. −1 ve +1 sınıfları OBI ekseninin farklı yönlerine kayarken nötr sınıf 0 çevresinde daha merkezi ve daha geniş kuyruklu bir dağılım sergiler. Bu dağılım yapısı, maliyet matrisinde komşu sınıflar arasındaki uzaklıkların neden birbirine yakın ancak sıfırdan anlamlı biçimde farklı olduğunu açıklamak için kullanılır.
QMTL Çıkarım Maliyetini Artırmadan Nasıl Kullanılabilir?
QMTL, eğitim sırasında ortak bir kodlayıcıya aynı hedefi tahmin eden birden fazla çıkış başı bağlar; eğitim tamamlandığında ek başlar kaldırılıp yalnız tek baş kullanıldığı için dağıtılan modelin temel çıkarım mimarisi büyümek zorunda değildir. Bu çalışmada QMTL bir ensemble olarak kullanılmaz; amaç, çok başlı eğitimin ortak kodlayıcı üzerinde oluşturduğu eğitim etkisini tek başlı çıkarıma taşımaktır.
QMTL'de her baş aynı −1/0/+1 hedefini tahmin eder. Kaynak, eğitim sonunda tek başa geçiş için farklı seçenekleri tartışır; deneylerde en basit yaklaşım seçilir ve başlardan biri rastgele tutulur. Bu seçim özellikle gelecek çalışmalar için açık bir geliştirme alanı olarak belirtilmiştir.
Birden fazla başın kayıplarını dengelemek için Gradient Normalization (GradNorm) kullanılır. Genel çok görevli kayıp:
\[ \mathcal{L}_{total}=\sum_{i=1}^{m}w_i\mathcal{L}_i \]
şeklinde düşünülebilir. GradNorm, görevlerin göreli öğrenme hızlarına göre \(w_i\) ağırlıklarını eğitim sırasında ayarlamayı amaçlar. Bu çalışmada görevlerin hedefleri aynı olsa da farklı başların öğrenme hızlarının eşit olmaması nedeniyle GradNorm tercih edilmiştir.
Test edilen üç mimari
Baseline model, LOB girdisini işleyen dört evrişimsel katman grubunu ve üç sınıfa çıkan tam bağlantılı bir katmanı temel alır. QMTL uyarlamasında CNN bölümü ortak kodlayıcı, son tam bağlantılı bölüm ise baş olarak kullanılır.
DeepLOB, evrişimsel katmanları bir inception yapısı ve LSTM ile birleştirir. Araştırmada CNN ve inception kısmı ortak gövde, LSTM ile son tam bağlantılı bölüm ise görev başı olarak kullanılır. Bu seçim baş başına hesaplama maliyetini yükselttiği için QMTL'nin eğitim süresi DeepLOB'da daha belirgin artar.
MLPLOB, ağırlıklı olarak tam bağlantılı katmanlardan ve uzamsal/zamansal eksenler üzerinde dönüşümlü işlem yapan MLP yapısından oluşur. Son tam bağlantılı bloklar baş, önceki bölüm ortak kodlayıcı olarak ele alınır.
Çalışmanın Yöntemi ve Bulguları
Veri bölünmesi ve sınıf dengesizliği
Çalışma Ekim 2025 verisini eğitim ve doğrulama, Kasım 2025 verisini ise test için kullanır. Ekim verisi kendi içinde %80 eğitim ve %20 doğrulama olarak ayrılmıştır. Test bölümünün toplam verinin yaklaşık yarısını oluşturması klasik makine öğrenmesi çalışmalarına göre sıra dışıdır; kaynak bunu veri miktarının çok büyük, asıl darboğazın ise eğitim hesaplama maliyeti olmasıyla açıklar.
| Bölüm | LOB anlık görüntüsü | Model girdisi |
|---|---|---|
| Eğitim | 8.570.879 | 428.540 |
| Doğrulama | 2.142.720 | 107.132 |
| Test | 10.499.327 | 524.962 |
| Toplam | 21.212.926 | 1.060.634 |
| Bölüm | −1 | 0 | +1 |
|---|---|---|---|
| Eğitim | 5.400 (%1,3) | 417.869 (%97,5) | 5.271 (%1,2) |
| Doğrulama | 1.050 (%1,0) | 104.936 (%98,0) | 1.146 (%1,1) |
| Test | 5.932 (%1,1) | 513.518 (%97,8) | 5.512 (%1,0) |
Verinin yaklaşık %98'inin 0 sınıfında bulunması, ham doğruluğun tek başına yanıltıcı olmasına yol açabilir. Model tüm örnekleri 0 olarak tahmin ederek çok yüksek accuracy elde edebilir ancak −1 ve +1 yön hareketlerini ayırt etme yeteneğine sahip olmayabilir. Bu nedenle çalışma sınıf ağırlıkları kullanır:
\[ w_i=\frac{N}{C\,n_i} \]
Burada \(N\) toplam örnek sayısı, \(C\) sınıf sayısı ve \(n_i\) ilgili sınıfın örnek sayısıdır.
Değerlendirme metrikleri
Accuracy, precision, recall ve F1-score yanında Cohen's kappa ve Restricted Accuracy (RA) kullanılır. Cohen's kappa:
\[ \kappa=\frac{p_o-p_e}{1-p_e} \]
ifadesiyle gözlenen sınıflandırma uyuşmasının yalnız şansla beklenen uyuşmadan ne kadar yüksek olduğunu ölçer. Özellikle aşırı dengesiz veri setlerinde yalnız accuracy değerine göre daha açıklayıcı olabilir.
Restricted Accuracy, çalışmanın tanımına göre özellikle −1 ve +1 yön tahminlerinin birbirine karşı ne kadar doğru ayrıldığını izlemek için tasarlanmıştır. Kaynak Denklem (3.16)'nın paydasında aynı \(n_{-1,+1}\) terimi iki kez basılmış görünmektedir. Bu nedenle formül burada kaynakta bulunmayan bir düzeltme yapılarak yeniden yazılmamış; metrik yazarın sözel açıklamasına göre yorumlanmıştır.
Eğitim protokolü
- Donanım: NVIDIA A40 GPU kümesi; her tek model eğitimi bir GPU üzerinde.
- Optimizer: Adam.
- Learning rate: \(10^{-3}\).
- Weight decay: \(10^{-4}\).
- Early stopping: birleşik doğrulama kaybı üzerinde patience = 10.
- Test aşaması: en iyi doğrulama kaybına sahip checkpoint.
- QMTL test tahmini: başlardan yalnız biri ve çalışmadaki deney protokolünde rastgele seçim.
- Hata çubukları: tekrar deneylerinin ortalaması için %95 güven aralığı.
- Baseline maliyet/kafa kombinasyonları: her kombinasyon 100 tekrar.
- Gelişmiş mimari kombinasyonları: her kombinasyon 40 tekrar.
Kaynağın ana deney setup bölümünde mini-batch büyüklüğü ve rastgelelik seed'i açık biçimde raporlanmamıştır. Bu bilgiler yeniden üretilebilirliğin tamlığı açısından kaynakta eksik kalan parametrelerdir; burada değer uydurulmamıştır.
Veriden elde edilen maliyet matrisleri
Aşağıdaki değerler yalnız eğitim verisinden hesaplanmış ve her matrisin maksimum değeri 1 olacak biçimde normalize edilmiştir. Satırlar gerçek sınıfı, sütunlar maliyet uygulanan sınıfı gösterir.
| Gerçek \ Hedef | −1 | 0 | +1 |
|---|---|---|---|
| −1 | 0 | 0,500 | 1,000 |
| 0 | 0,500 | 0 | 0,500 |
| +1 | 1,000 | 0,500 | 0 |
| Gerçek \ Hedef | −1 | 0 | +1 |
|---|---|---|---|
| −1 | 0 | 0,138 | 1,000 |
| 0 | 0,860 | 0 | 0,865 |
| +1 | 0,995 | 0,137 | 0 |
| Gerçek \ Hedef | −1 | 0 | +1 |
|---|---|---|---|
| −1 | 0 | 0,796 | 1,000 |
| 0 | 0,796 | 0 | 0,921 |
| +1 | 1,000 | 0,921 | 0 |
| Gerçek \ Hedef | −1 | 0 | +1 |
|---|---|---|---|
| −1 | 0 | 0,639 | 1,000 |
| 0 | 0,639 | 0 | 0,625 |
| +1 | 1,000 | 0,625 | 0 |
Baseline deneylerinde kayıp fonksiyonlarının davranışı
Kaynak Şekil 7'de 1 ile 5 QMTL başı arasındaki konfigürasyonlar karşılaştırılır. Her baş-kayıp kombinasyonu 100 kez çalıştırıldığı için grafikteki eğilimler tek bir eğitim koşusuna değil, tekrarların ortalamasına dayanır.
Wasserstein yöntemi F1-score ve Cohen's kappa açısından en güçlü ve en tutarlı yöntemdir. Baş sayısı arttıkça F1 değerinde de kademeli bir yükselme görülür. Mahalanobis bazı konfigürasyonlarda yaklaşsa da deneyler arasında daha yüksek varyans sergiler.
SLACE tabanlı yöntem ise önemli bir sınıf dengesizliği problemi ortaya çıkarır. Yaklaşık %98 accuracy vermesine rağmen Cohen's kappa sıfıra yakın, Restricted Accuracy ise sıfırdır. Kaynağın tahmin denetimi modelin fiilen yalnız 0 sınıfını seçtiğini gösterir. Bu sonuç, aşırı dengesiz sınıflandırmada yüksek accuracy'nin tek başına başarı ölçütü olarak neden güvenilir olmadığının açık bir örneğidir.
Linear yöntem de bir başlı durumda düşük performans gösterirken baş sayısı arttığında precision ve Restricted Accuracy değerlerinde belirgin iyileşme sağlar. Wasserstein yöntemi zaten güçlü olan tek başlı sonuçlarını çok başlı eğitimde daha mütevazı fakat gözlenebilir biçimde iyileştirir.
Accuracy açısından yöntemlerin sıralaması diğer metriklerden farklıdır. Kaynak metinde SLACE ve Linear yaklaşık %98, Wasserstein yaklaşık %87, Cross-Entropy ile Mahalanobis ise yaklaşık %76 düzeyinde raporlanır. Bu fark, yüksek accuracy'nin büyük ölçüde baskın 0 sınıfını tahmin etmekten kaynaklanabileceğini ve yön hareketlerini yakalama başarısıyla birlikte değerlendirilmesi gerektiğini gösterir.
QMTL'nin eğitim maliyeti
Çok başlı eğitim çıkarım maliyetine taşınmasa da eğitim ücretsiz değildir. Kaynak Şekil 8, baş sayısı arttıkça gerçek eğitim süresinin yaklaşık doğrusal biçimde yükseldiğini gösterir. Bununla birlikte birçok konfigürasyonda baş sayısı arttıkça erken durdurmaya ulaşmak için gereken epoch sayısı azalır. Yazar bu davranışın daha hızlı yakınsama, çok başlı eğitimin düzenlileştirici etkisi veya her iki mekanizmanın birleşimiyle ilişkili olabileceğini tartışır; çalışma bu mekanizmalardan hangisinin kesin neden olduğunu göstermemektedir.
DeepLOB ve MLPLOB ile gelişmiş mimari deneyleri
Hesaplama maliyetini sınırlamak amacıyla gelişmiş mimarilerde yalnız standart Cross-Entropy (C) ile en başarılı maliyet yaklaşımı olan Wasserstein (W) karşılaştırılmıştır. Kaynak Şekil 9'da Baseline, DeepLOB ve MLPLOB için 1-5 baş arasında toplam 40 tekrar üzerinden sonuçlar sunulur.
Genel örüntüde Wasserstein kaybı aynı mimarinin Cross-Entropy sürümünden metriklerin çoğunda daha iyi sonuç verir. En belirgin ortak istisna recall'dır; üç mimaride de Cross-Entropy recall açısından daha yüksek değerlere ulaşır. DeepLOB için precision ve Restricted Accuracy, Baseline için de Restricted Accuracy bazı konfigürasyonlarda genel Wasserstein üstünlüğünün istisnalarıdır.
MLPLOB'da Wasserstein ile baş sayısı arttıkça F1-score, Cohen's kappa ve accuracy gibi bazı metrikler yükselirken Restricted Accuracy azalır. Kaynak bunu, zaten yaklaşık %98 oranında bulunan nötr sınıfın daha iyi sınıflandırılması ile daha seyrek ±1 sınıflarına odaklanma arasında oluşan bir performans değiş tokuşuyla ilişkilendirir.
DeepLOB'da bazı yön-hareketi metrikleri baş sayısıyla iyileşirken accuracy ve Cohen's kappa düşebilmektedir. Dolayısıyla QMTL etkisi mimariye ve seçilen metriğe bağlıdır; çalışma “daha fazla baş her zaman daha iyidir” sonucunu desteklemez.
Modeller arası karşılaştırmada Baseline F1 ve precision açısından güçlüdür; DeepLOB accuracy ve Cohen's kappa açısından yüksek sonuçlar verir; MLPLOB ise recall ve özellikle Restricted Accuracy açısından güçlü davranır. Kaynak bu nedenle tek bir mimariyi tüm amaçlar için üstün ilan etmez.
Bu Sonuçlar Kârlı Bir HFT Stratejisini Kanıtlar mı?
Hayır. Çalışma tarihsel BTC/USDT LOB verisinde piyasa yönü sınıflandırma metriklerini ve eğitim davranışını ölçer; net kâr, işlem maliyetleri, bid-ask spread etkisi, slippage, emir kuyruğu konumu, gerçek uçtan uca gecikme veya canlı emir yürütme performansı deneylerin temel çıktı değişkenleri değildir. Bu nedenle daha yüksek F1, kappa veya Restricted Accuracy doğrudan kârlı bir HFT stratejisi olarak yorumlanamaz.
Çalışmanın desteklediği sonuçlar
- −1, 0 ve +1 piyasa yönü görevi ordinal bir yapı olarak modellenebilir.
- OLL içindeki maliyet matrisinin tasarımı model davranışını güçlü biçimde değiştirebilir.
- Bu veri setinde Wasserstein tabanlı maliyet matrisi, incelenen alternatifler içinde genel olarak en tutarlı sonuçları verir.
- QMTL bazı kayıp fonksiyonları ve mimarilerde tek başlı çıkarım öncesi eğitimi iyileştirebilir.
- Çok başlı eğitim sonrasında ek başların kaldırılması, temel dağıtım mimarisine ek başların hesaplama maliyetinin taşınmasını engeller.
- Aşırı sınıf dengesizliği nedeniyle accuracy tek başına yeterli değerlendirme metriği değildir.
Çalışmanın desteklemediği genellemeler
- Sonuçlar bütün hisse, döviz veya kripto piyasalarına otomatik olarak genellenemez.
- Wasserstein maliyet matrisinin her veri setinde Cross-Entropy'den üstün olacağı gösterilmemiştir.
- Daha fazla QMTL başının her mimari ve her metrikte performansı artırdığı gösterilmemiştir.
- Sınıflandırma performansındaki artış gerçek işlem kârının artacağını kanıtlamaz.
- Çalışma canlı HFT altyapısında uçtan uca gecikme avantajını doğrulamamıştır.
- Yalnız BTC/USDT ve iki aylık dönem incelendiği için farklı piyasa rejimleri için ayrıca doğrulama gerekir.
Hesaplama maliyeti ve sürdürülebilirlik
Tez, model eğitimlerinin enerji maliyetini de ölçer. Son deney grubunda Baseline toplam 150,44 saat eğitim ve 16,55 kWh; DeepLOB 726,02 saat ve 177,87 kWh; MLPLOB 27,7 saat ve 5,54 kWh tüketmiştir. Üçü birlikte 904,16 saat GPU eğitimi ve 199,96 kWh enerji oluşturmuştur.
| Model | Toplam eğitim süresi | Ortalama güç | Enerji |
|---|---|---|---|
| Baseline | 150,44 saat | 110 W | 16,55 kWh |
| DeepLOB | 726,02 saat | 245 W | 177,87 kWh |
| MLPLOB | 27,7 saat | 200 W | 5,54 kWh |
| Toplam | 904,16 saat | - | 199,96 kWh |
Yazar, geliştirme sırasında gerçekleştirilen ek eğitimleri hesaba katmak için toplam model eğitim tüketimini yaklaşık 399,92 kWh olarak tahmin eder. Geliştirme bilgisayarının tahmini tüketimi de eklendiğinde proje için yaklaşık 487,92 kWh hesaplanır. Bu bölümün amacı, çıkarımda küçük model kullanmanın olası enerji yararı ile daha karmaşık eğitim prosedürlerinin ek eğitim maliyetinin birlikte değerlendirilmesi gerektiğini göstermektir.
Kaynak ve Yöntem Notu
Özgün başlık: Distance-based Loss functions for High-Frequency Trading
Yazar: Jonathan Rodríguez Barja
Tez danışmanı: Daniel P. Palomar
Yerel tutor: Jordi Castro
Kurumlar: Universitat Politècnica de Catalunya - BarcelonaTech (UPC); çalışma HKUST'de gerçekleştirilmiştir. Belge Centre de Formació Interdisciplinària Superior (CFIS) kapsamındaki Data Science & Engineering / Engineering Physics çift lisans programına aittir.
Kaynak türü: Lisans bitirme tezi / Bachelor thesis / Treball Final de Grau.
Tarih: PDF kapak tarihi Şubat 2026; resmî repository kayıt tarihi 26 Şubat 2026.
Platform: UPCommons, Universitat Politècnica de Catalunya kurumsal akademik arşivi.
Kalıcı kayıt tanımlayıcısı: 2117/457644.
DOI: Kaynakta ve resmî repository kaydında DOI belirtilmemiştir.
Dergi / cilt / sayı: Uygulanamaz; çalışma bir dergi makalesi değildir.
Hakemlik durumu: Hakemli dergi makalesi değildir. Üniversite lisans bitirme çalışmasıdır.
Erişim ve lisans: Resmî repository kaydı açık erişim sağlamakta ve eseri CC BY-NC-ND 4.0 lisansı altında göstermektedir. NoDerivatives koşulu nedeniyle Verianla metni kaynak metnin çevirisi veya yakın yeniden yazımı olarak oluşturulmamış; kaynak figürleri değiştirilerek ya da yeniden stilize edilerek kullanılmamıştır. Bilimsel yöntem, doğrulanabilir sayılar, denklemler ve sonuçlar bağımsız öğretici anlatımla yeniden yapılandırılmıştır.
Veri kaynağı: CryptoHFTData üzerinden Binance BTC/USDT LOB verisi. Çalışmada kullanılan tarih aralığı 1 Ekim-30 Kasım 2025'tir.
Yazılım ve geliştirme: Çalışma LibMTL tabanlı bir çerçeveyi uyarlamış; QMTL, early stopping ve Weights & Biases ile logging gibi bileşenler eklemiştir. Kaynakta ayrı bir kod erişilebilirliği veya kod lisansı beyanı verilmemiştir.
Finansman: Kaynakta standart biçimli ayrı bir finansman beyanı bulunmamaktadır. Teşekkür bölümünde CFIS desteği belirtilmektedir; bu ifade bir araştırma fonu veya proje hibesi olarak yeniden yorumlanmamıştır.
Çıkar çatışması: Kaynakta ayrı bir çıkar çatışması beyanı tespit edilmemiştir.
Temel yöntemsel sınırlılıklar: Tek varlık ve tek borsa; yalnız iki aylık tarihsel dönem; yaklaşık %98 nötr sınıf içeren güçlü sınıf dengesizliği; gerçek ticaret kârlılığı yerine sınıflandırma metrikleri; QMTL'de çıkarım başının rastgele seçilmesi; Wasserstein maliyetinin uygulamaya özgü OBI haritalamasına bağlı olması; bazı eğitim ayrıntılarının, örneğin mini-batch büyüklüğü ve random seed'in açık raporlanmaması.
Kaynak içi notasyon uyarısı 1: Denklem (3.16)'daki Restricted Accuracy paydasında bir çapraz sınıflandırma terimi yinelenmiş görünmektedir. Verianla bu ifadeyi sessizce düzeltmemiştir.
Kaynak içi notasyon uyarısı 2: Denklem (5.12) metinde sınıf ortalaması olarak açıklanan \(\bar{\mathbf v}_j\) için toplam ifadesi vermekte, ancak görünür formülde sınıf örnek sayısına bölme terimi bulunmamaktadır. Mahalanobis yönteminin anlatımında bu fark ayrıca korunmuştur.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir