

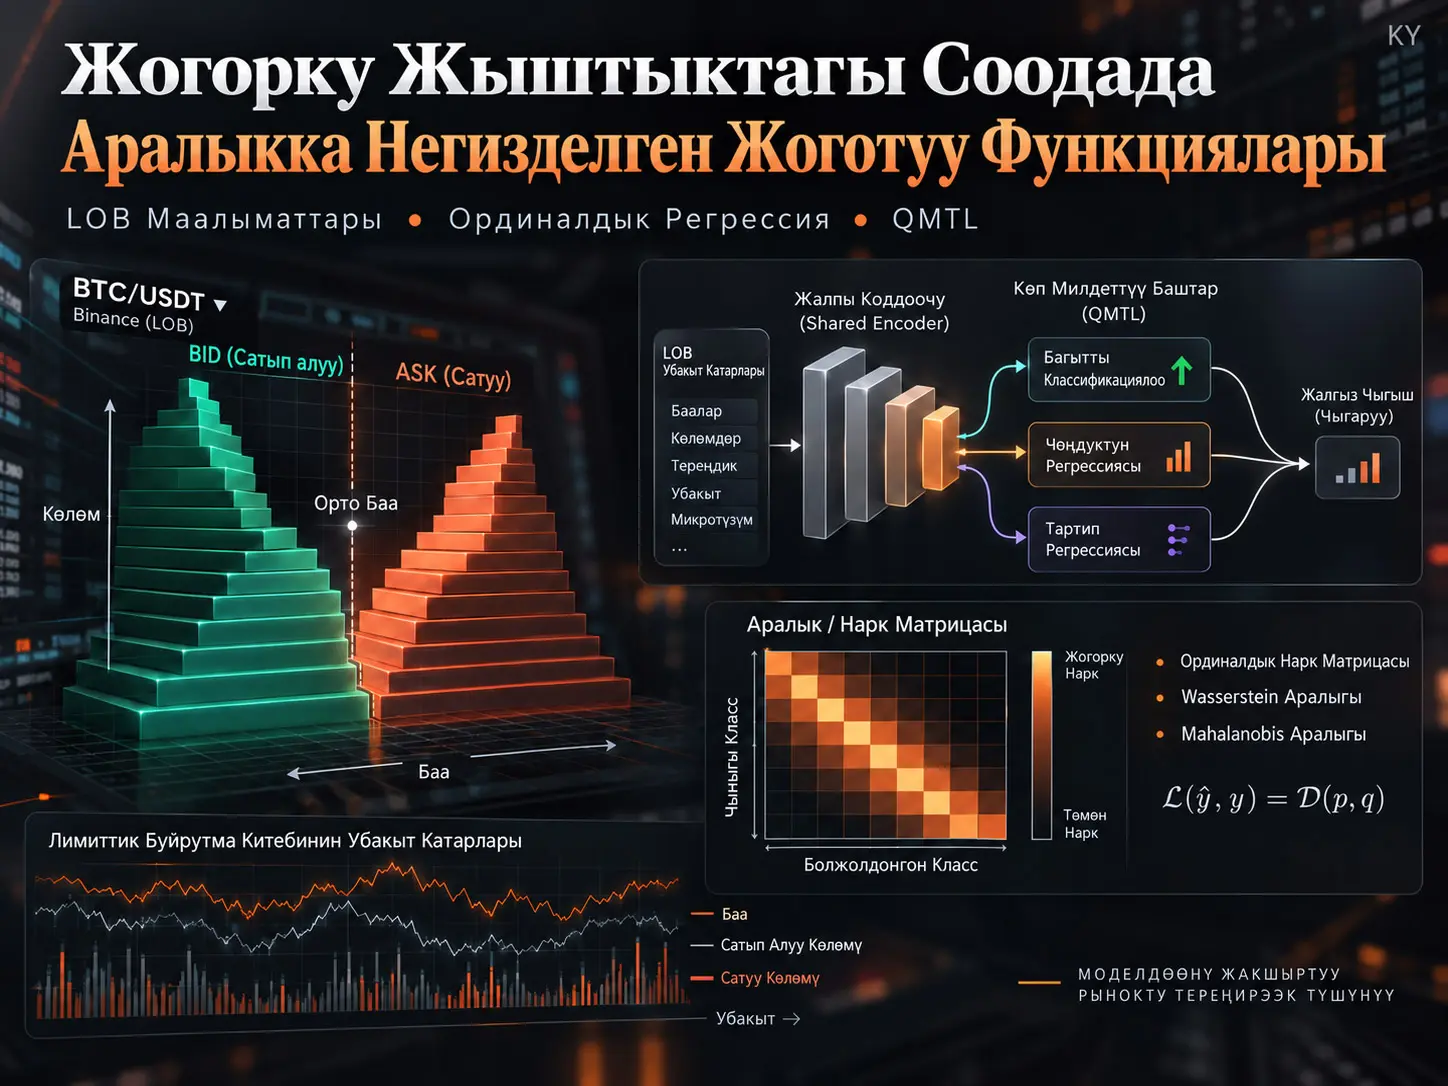
Бул изилдөө жогорку жыштыктагы соодада (High-Frequency Trading, HFT) кыска мөөнөттүү рынок багытын болжолдогон терең үйрөнүү моделдерин болжол чыгаруу баскычындагы архитектураны чоңойтпостон, окутуу учурунда кантип жакшыртууга болорун изилдейт. Изилдөөдө Binance BTC/USDT рыногунан CryptoHFTData аркылуу алынган Limit Order Book (LOB) маалыматтары колдонулган; 1 октябрь-30 ноябрь 2025 мезгилиндеги буйрутмалар китебинин агымы 250 ms аралык менен үлгүлөнүп, келечектеги орточо баанын кыймылы −1, 0 жана +1 болуп үч класска бөлүнгөн. Негизги ыкмалар — класстар арасындагы каталар бирдей мааниге ээ эместигин эске алган Ordinal Log-Loss (OLL), маалымат бөлүштүрүүлөрүнөн алынган чыгым матрицалары жана окутуу учурунда бир эле тапшырманы аткарган бир нече башты колдонгон Quasi-Multi-Task Learning (QMTL) ыкмасы. Эксперименттерде Wasserstein аралыгы менен түзүлгөн чыгым матрицасы стандарттык кайчылаш энтропияга жана башка чыгым матрицасынын түзүлүштөрүнө салыштырмалуу жалпысынан эң туруктуу көрсөткүчтү берген; QMTL болсо айрым архитектураларда жана метрикаларда көп баштуу окутуудан кийин бир гана баш калтырылганда да пайдалуу болушу мүмкүн экенине эксперименттик далил берген. Ошентсе да жыйынтыктар бир криптоактив, бир биржа, эки айлык тарыхый маалымат жана классификация метрикалары менен чектелет; изилдөө реалдуу убакыттагы буйрутманы аткарууну же таза соода кирешелүүлүгүн далилдебейт.
Лимиттик Буйрутмалар Китеби (Limit Order Book, LOB)белгилүү бир активге тиешелүү күтүп турган лимиттик сатып алуу жана сатуу буйрутмаларын баа деңгээлдери жана көлөмдөрү менен чагылдырган электрондук рынок түзүмү. Ordinal Log-Loss (OLL)классификация каталарын чыгым матрицасы аркылуу ар кандай оордукта жазалай ала турган иреттик классификация жоготуусу. Quasi-Multi-Task Learning (QMTL) болсо бир эле максатты болжолдогон бир нече башты жалпы коддоочу менен бирге окутуп, болжол чыгаруу баскычында бул кошумча баштарды алып салууга мүмкүндүк берген көп тапшырмалуу окутуу ыкмасы.
| Элемент | Булакта колдонулган маани |
|---|---|
| Рынок | Binance BTC/USDT |
| Маалымат булагы | CryptoHFTData |
| Мезгил | 1 октябрь-30 ноябрь 2025 |
| Убакыт боюнча үлгүлөө | 250 ms |
| LOB деңгээли | Алгачкы 10 деңгээл |
| Киргизүү терезеси | 100 LOB көз ирмемдик көрүнүшү |
| Терезе кадамы | 20 үлгү |
| Белгилер | −1, 0, +1 |
| Белгилөө | Triple Barrier Method; α = 0.001, k = 100 |
| Сыналган моделдер | Baseline CNN, DeepLOB, MLPLOB |
Эмне үчүн маселе жөн гана чоңураак модель куруу эмес?
Жогорку жыштыктагы соодада моделдин болжол сапаты канчалык маанилүү болсо, болжолдун канчалык тез чыгарылары да ошончолук маанилүү. Чоң нейрон тармагы классификация тактыгын жогорулатса да, болжол чыгаруу убактысын узартса, кечигүүгө сезгич колдонуу үчүн практикалык маанисин жоготушу мүмкүн. Ошондуктан изилдөөнүн максаты жаңы жана чоңураак HFT архитектурасын иштеп чыгуу эмес. Изилдөө учурдагы архитектуралардын окутуу жол-жобосун өзгөртүү аркылуу ошол эле болжол чыгаруу архитектурасы менен жакшыраак болжол жүрүм-турумуна жетүүгө болобу же жокпу, ошону изилдейт.
Бул тандоо изилдөөнү бири-бирин толуктаган эки багытка алып барат. Биринчи багыт −1, 0 жана +1 рынок багыты класстарынын табигый ирети бар экенин эске алган иреттик регрессия. Экинчи багыт болсо модель окутуу учурунда гана бир нече чыгыш башы менен иштеген QMTL. Эки ыкма тең жайгаштыруу учурунда моделдин негизги бөлүгүн сөзсүз чоңойтпостон, окутуу маалыматын байытууну көздөйт.
LOB маалыматы моделдин киргизүүсүнө кантип айланат?
Бир LOB көз ирмемдик көрүнүшүндө ар бир деңгээл үчүн сатып алуу баасы, сатып алуу көлөмү, сатуу баасы жана сатуу көлөмү бар. Изилдөө алгачкы \(N=10\) деңгээлди колдонот. Ошентип, бир LOB көрүнүшү \(4N=40\) белгиге ээ. Моделдин киргизүүсү түзүлгөндө удаалаш \(W=100\) көрүнүш бириктирилип, киргизүү тензору \(4N \times W = 40 \times 100\) өлчөмүнө жетет.
Чийки CryptoHFTData агымы туруктуу көз ирмемдик көрүнүштөрдөн гана турбайт; ал саат сайын алынган толук көрүнүштөрдү жана алардын ортосундагы өзгөртүү жаңыртууларын чогуу камтыйт. Изилдөөдө бул окуяга негизделген агым алгач кайра түзүлүп, андан кийин \(\delta t=250\,\mathrm{ms}\) аралык менен туруктуу үлгүлөнөт. Бир аралыкта бир нече өзгөрүү болсо, акыркы абал тандалат; өзгөрүү болбосо мурунку LOB абалы сакталат.
Киргизүү терезесинин узундугу 100 үлгү жана жаңы маалымат чекитин түзүү үчүн терезе 20 үлгүгө жылдырылат. Ошондуктан кошуна киргизүүлөр жарым-жартылай бири-бирин каптайт. Изилдөө бул тандоону маалымат көлөмүн көбөйтүү жана майда убакыт жылыштарына туруктуураак үлгүлөрдү түзүү үчүн колдонот.
Орточо баа жана келечектеги кыймыл класстары
Эң жакшы сатуу баасы \(p_t^{a1}\), эң жакшы сатып алуу баасы \(p_t^{b1}\) менен белгиленгенде spread:
\[ s_t=p_t^{a1}-p_t^{b1} \]
ал эми орточо баа:
\[ m_t=\frac{p_t^{a1}+p_t^{b1}}{2} \]
деп аныкталат. Изилдөөнүн максаты келечектеги баа деңгээлин түздөн-түз регрессия менен болжолдоо эмес, орточо баа жакынкы келечекте олуттуу түрдө төмөн, өзгөрүүсүз же жогору багытта кыймылдайбы-жокпу классификациялоо.
Киргизүүлөр стандарттык z-упай менен нормалдаштырылат:
\[ \tilde{x}_i=\frac{x_i-\mu}{\sigma} \]
Булак окутуу, валидация жана тест бөлүктөрү өздөрүнүн \(\mu\) жана \(\sigma\) маанилери менен өз-өзүнчө нормалдаштырылганын көрсөтөт.
Triple Barrier Method менен белги түзүү
Изилдөө келечектеги орточо баа өзгөрүүсүн гана карагандын ордуна Triple Barrier Method (TBM) колдонот. Учурдагы орточо баа \(m_t\) жана салыштырмалуу босого \(\alpha\) үчүн жогорку жана төмөнкү тоскоолдуктар:
\[ u_t=m_t(1+\alpha) \]
\[ \ell_t=m_t(1-\alpha) \]
түрүндө болот. Булактагы эксперименттерде \(\alpha=0.001\) жана убакыт горизонту \(k=100\) тандалган. Келечектеги баа катары боюнча адегенде жогорку тоскоолдук бузулса, белги \(+1\), адегенде төмөнкү тоскоолдук бузулса \(−1\), убакыт тоскоолдугуна чейин экөө тең бузулбаса \(0\) түзүлөт. Демек, белги келечектеги баанын белгилүү бир учурдагы маанисине гана эмес, белгиленген горизонт ичинде кайсы баа тоскоолдугу биринчи ишке ашканына көз каранды.
Бул HFT Маселесинде Иреттик Регрессия Эмне Үчүн Маанилүү?
Иреттик регрессия бул маселеде маанилүү, анткени −1, 0 жана +1 класстары табигый түрдө \(−1 \prec 0 \prec +1\) иретине ээ жана бардык классификация каталары бирдей экономикалык багытты билдирбейт. Чыныгы класс +1 болгондо 0 деп болжолдоо менен чыныгы класс +1 болгондо −1 деп болжолдоо бирдей аралыктагы ката эмес; изилдөө бул түзүмдү жоготуу функциясына киргизип, модель каталардын оордугун да үйрөнүшүн көздөйт.
Стандарттык көп класстуу кайчылаш энтропия туура класска берилген ыктымалдуулукту сыйлайт, бирок туура эмес класстар бири-биринен канчалык алыс экенин түздөн-түз колдонбойт. Булакта классикалык кайчылаш энтропия:
\[ \mathcal{L}_{CE}=-\mathbf{y}^{T}\log(\mathbf{p}) \]
деп жазылат. Бул жерде \(\mathbf{y}\) чыныгы класстын one-hot көрсөтүлүшү, \(\mathbf{p}\) болсо моделдин класс ыктымалдыктары.
Изилдөөдө колдонулган Ordinal Log-Loss болсо \(\mathbf{C}\) чыгым матрицасын кошот:
\[ \mathcal{L}_{OLL} =-\sum_{l\in\mathcal{L}}\log(1-p_l)c_{y,l}^{\alpha} \]
Булактагы изилдөөдө OLL үчүн \(\alpha=1\) алынат. Ошондо туюнтма:
\[ \mathcal{L}_{OLL} =-\mathbf{y}^{T}\mathbf{C}\log(\mathbf{1}-\mathbf{p}) \]
түрүнө келтирилет. Бул теңдемеде \(c_{y,l}\), чыныгы класс \(y\) болгондо \(l\) классына багытталган ыктымалдуулук канчалык катуу жазаланарын аныктайт. Изилдөөнүн маанилүү бөлүгү дал ушул чыгымдар кантип эсептелерине арналган.
Төрт чыгым матрицасынын ыкмасы
Изилдөө төрт ыкманы салыштырат: Linear (L), SLACE (S), Mahalanobis (M) жана Wasserstein (W). Бардык матрицалар окутуу маалыматтарынан гана эсептелет жана маалыматтын сыртка чыгып кетишин алдын алуу үчүн валидация же тест маалыматтары чыгым матрицасын түзүүдө колдонулбайт. Салыштырууну жеңилдетүү үчүн ар бир матрица өзүнүн эң чоң элементине бөлүнүп, \([0,1]\) аралыгына масштабдалат.
Linear ыкмасы класстардын иретине гана негизделет:
\[ c_{i,j}=|i-j| \]
Бул ыкма −1 менен +1 ортосундагы катаны кошуна класстар арасындагы катага караганда катуураак жазалайт; бирок класстардын маалымат бөлүштүрүүлөрү чындыгында канчалык окшош экенин колдонбойт.
SLACE негизиндеги ыкмакласс жыштыктарынан алынган proximity маанилерин колдонот. Маалымат топтомундагы өтө күчтүү класс теңсиздигинен улам пайда болгон чыгым матрицасы айкын асимметриялуу. Эксперименттер бул өзгөчөлүк өзгөчө нейтралдуу класска ашыкча багытталуу менен байланыштуу болушу мүмкүн экенин көрсөтөт.
Mahalanobis ыкмасы\(40\times100\) өлчөмүндөгү киргизүүнү узундугу \(4000\) болгон векторго айландырып, класс өкүлдөрүнүн айырмасын маалымат ковариациясы менен масштабдайт:
\[ c_{i,j} = \sqrt{(\bar{\mathbf v}_i-\bar{\mathbf v}_j)^T \mathbf{\Sigma}^{-1} (\bar{\mathbf v}_i-\bar{\mathbf v}_j)} \]
Бул жерде \(\mathbf{\Sigma}\) киргизүүлөрдүн бааланган ковариация матрицасы. Булак тексти \(\bar{\mathbf v}_j\) чоңдугун тиешелүү класстагы киргизүүлөрдүн орточосу катары аныктайт. Бирок булактын Теңдеме (5.12)-синде бул орточого тиешелүү үлгү санына бөлүү мүчөсү көрүнбөйт; бул нотациялык айырма бул жерде үнсүз түрдө оңдолгон эмес.
Wasserstein Негизиндеги Чыгым Матрицасы Кантип Түзүлөт?
Wasserstein негизиндеги чыгым матрицасы ар бир класстын LOB киргизүүлөрүн бир өлчөмдүү Order Book Imbalance өкүлчүлүгүнө айлантат, −1, 0 жана +1 класстары үчүн өзүнчө OBI бөлүштүрүүлөрүн түзөт жана класстар арасындагы чыгымды ушул бөлүштүрүүлөрдүн Wasserstein-1 аралыгы катары аныктайт. Ошентип, жаза класс индексине гана эмес, класстардын окутуу маалыматтарындагы статистикалык ажырымга да көз каранды болот.
Бир өлчөмдүү эки бөлүштүрүүнүн кумулятивдүү бөлүштүрүү функциялары \(U\) жана \(V\) болсо, Wasserstein-1 аралыгы:
\[ W_1(u,v)=\int_{-\infty}^{+\infty}|U(x)-V(x)|\,dx \]
түрүндө берилет.
LOB киргизүүлөрү көп өлчөмдүү болгондуктан, изилдөө адегенде бааларды алып салып, сатып алуу/сатуу көлөмдөрүн гана колдонот. Киргизүү сатып алуу/сатуу багытын, LOB деңгээлин жана убакыт окторун камтыган \(X_{ijk}\) тензоруна айлантылат. Изилдөөдө сунушталган OBI чагылдыруусу:
\[ \mathrm{OBI} = \sum_{i=1}^{2} \sum_{j=1}^{N} \sum_{k=1}^{W} (-1)^i\lambda^{j+k}X_{ijk} \]
түрүндө. \(\lambda\) тереңирээк LOB деңгээлдеринин жана эскирээк убакыт үлгүлөрүнүн таасирин экспоненциалдуу түрдө азайтат. Эксперименттерде \(\lambda=0.5\) колдонулган. Ар бир белгинин OBI маанилери өзүнчө бөлүштүрүү түзөт жана чыгым:
\[ c_{i,j}=W_1(u_i,u_j) \]
деп аныкталат.
Булактын 6-сүрөтүндө класска шартталган OBI бөлүштүрүүлөрү көрсөтүлөт. −1 жана +1 класстары OBI огунун ар башка багыттарына жылганда, нейтралдуу класс 0 айланасында борборлошконураак жана куйругу кеңирээк бөлүштүрүүнү көрсөтөт. Бул бөлүштүрүү түзүмү чыгым матрицасында кошуна класстар арасындагы аралыктар эмне үчүн бири-бирине жакын, бирок нөлдөн маанилүү деңгээлде айырмаланарын түшүндүрүү үчүн колдонулат.
QMTL Болжол Чыгаруу Чыгымын Өстүрбөстөн Кантип Колдонулат?
QMTL окутуу учурунда жалпы коддоочуга бир эле максатты болжолдогон бир нече чыгыш башын туташтырат; окутуу бүткөндө кошумча баштар алынып, бир гана баш колдонулгандыктан, жайгаштырылган моделдин негизги болжол чыгаруу архитектурасын чоңойтуу талап кылынбайт. Бул изилдөөдө QMTL ensemble катары колдонулбайт; максат көп баштуу окутуунун жалпы коддоочуда пайда кылган окутуу таасирин бир баштуу болжол чыгарууга өткөрүү.
QMTLде ар бир баш бир эле −1/0/+1 максатын болжолдойт. Булак окутуунун аягында бир башка өтүүнүн ар кандай варианттарын талкуулайт; эксперименттерде эң жөнөкөй ыкма тандалып, баштардын бири туш келди сакталат. Бул тандоо айрыкча келечектеги изилдөөлөр үчүн ачык өнүктүрүү багыты катары көрсөтүлгөн.
Бир нече баштын жоготууларын тең салмактоо үчүн Gradient Normalization (GradNorm) колдонулат. Жалпы көп тапшырмалуу жоготуу:
\[ \mathcal{L}_{total}=\sum_{i=1}^{m}w_i\mathcal{L}_i \]
деп каралышы мүмкүн. GradNorm тапшырмалардын салыштырмалуу үйрөнүү ылдамдыктарына жараша \(w_i\) салмактарын окутуу учурунда жөндөөнү көздөйт. Бул изилдөөдө тапшырмалардын максаттары бирдей болсо да, ар башка баштардын үйрөнүү ылдамдыктары тең болбогондуктан GradNorm тандалган.
Сыналган үч архитектура
Baseline модельLOB киргизүүсүн иштеткен төрт конволюциялык катмар тобуна жана үч класска чыгуучу толук байланышкан катмарга негизделет. QMTL адаптациясында CNN бөлүгү жалпы коддоочу, акыркы толук байланышкан бөлүк болсо баш катары колдонулат.
DeepLOBконволюциялык катмарларды inception түзүмү жана LSTM менен бириктирет. Изилдөөдө CNN жана inception бөлүгү жалпы өзөк, LSTM менен акыркы толук байланышкан бөлүк болсо тапшырма башы катары колдонулат. Бул тандоо ар бир баш үчүн эсептөө чыгымын жогорулаткандыктан, QMTLдин окутуу убактысы DeepLOBдо көбүрөөк өсөт.
MLPLOBнегизинен толук байланышкан катмарлардан жана мейкиндик/убакыт окторунда кезектешип иштеген MLP түзүмүнөн турат. Акыркы толук байланышкан блоктор баш, мурунку бөлүк жалпы коддоочу катары алынат.
Изилдөөнүн Ыкмасы жана Жыйынтыктары
Маалыматты бөлүү жана класс теңсиздиги
Изилдөө 2025-жылдын октябрь маалыматтарын окутуу жана валидация үчүн, 2025-жылдын ноябрь маалыматтарын тест үчүн колдонот. Октябрь маалыматтары өз ичинде %80 окутуу жана %20 валидация болуп бөлүнгөн. Тест бөлүгүнүн жалпы маалыматтын болжол менен жарымын түзүшү классикалык машиналык үйрөнүү изилдөөлөрүнө салыштырмалуу адаттан тыш; булак муну маалымат көлөмүнүн өтө чоң болушу, ал эми негизги тар жер окутуудагы эсептөө чыгымы экендиги менен түшүндүрөт.
| Бөлүк | LOB көз ирмемдик көрүнүшү | Моделдин киргизүүсү |
|---|---|---|
| Окутуу | 8.570.879 | 428.540 |
| Валидация | 2.142.720 | 107.132 |
| Тест | 10.499.327 | 524.962 |
| Жалпы | 21.212.926 | 1.060.634 |
| Бөлүк | −1 | 0 | +1 |
|---|---|---|---|
| Окутуу | 5.400 (%1,3) | 417.869 (%97,5) | 5.271 (%1,2) |
| Валидация | 1.050 (%1,0) | 104.936 (%98,0) | 1.146 (%1,1) |
| Тест | 5.932 (%1,1) | 513.518 (%97,8) | 5.512 (%1,0) |
Маалыматтын болжол менен %98 бөлүгү 0 класста болушу чийки тактыктын өзүнчө жаңылыштыруучу болушуна алып келиши мүмкүн. Модель бардык үлгүлөрдү 0 деп болжолдоп өтө жогорку accuracy ала алат, бирок −1 жана +1 багыт кыймылдарын ажырата билбеши мүмкүн. Ошондуктан изилдөө класс салмактарын колдонот:
\[ w_i=\frac{N}{C\,n_i} \]
Бул жерде \(N\) жалпы үлгү саны, \(C\) класстардын саны жана \(n_i\) тиешелүү класстын үлгү саны.
Баалоо метрикалары
Accuracy, precision, recall жана F1-score менен катар Cohen's kappa жана Restricted Accuracy (RA) колдонулат. Cohen's kappa:
\[ \kappa=\frac{p_o-p_e}{1-p_e} \]
туюнтмасы аркылуу байкалган классификация шайкештиги кокустуктан гана күтүлгөн шайкештиктен канчалык жогору экенин өлчөйт. Айрыкча өтө теңсиз маалымат топтомдорунда accuracy маанисине гана караганда көбүрөөк түшүндүрмө бере алат.
Restricted Accuracy изилдөөнүн аныктамасына ылайык, өзгөчө −1 жана +1 багыт болжолдору бири-биринен канчалык туура ажыратыларын көзөмөлдөө үчүн түзүлгөн. Булактагы Теңдеме (3.16)-нын бөлгүчүндө ошол эле \(n_{-1,+1}\) мүчөсү эки жолу басылгандай көрүнөт. Ошондуктан формула бул жерде булакта жок оңдоо киргизилип кайра жазылган эмес; метрика автордун сөздүк түшүндүрмөсүнө жараша чечмеленген.
Окутуу протоколу
- Жабдуу: NVIDIA A40 GPU кластери; ар бир жеке моделди окутуу бир GPUда.
- Optimizer: Adam.
- Learning rate: \(10^{-3}\).
- Weight decay: \(10^{-4}\).
- Early stopping: бириктирилген валидация жоготуусунда patience = 10.
- Тест баскычы: эң жакшы валидация жоготуусуна ээ checkpoint.
- QMTL тест болжолу: баштардын бирөө гана жана изилдөөдөгү эксперименттик протоколдо туш келди тандоо.
- Ката тилкелери: кайталанган эксперименттердин орточосу үчүн %95 ишеним аралыгы.
- Baseline чыгым/баш комбинациялары: ар бир комбинация 100 кайталоо.
- Өркүндөтүлгөн архитектура комбинациялары: ар бир комбинация 40 кайталоо.
Булактын негизги эксперимент setup бөлүмүндө mini-batch өлчөмү жана кокустук seed-и ачык түрдө билдирилген эмес. Бул маалыматтар кайра өндүрүлүүчүлүктүн толуктугу жагынан булакта жетишпей калган параметрлер; бул жерде маани ойлоп табылган эмес.
Маалыматтан алынган чыгым матрицалары
Төмөнкү маанилер окутуу маалыматтарынан гана эсептелип, ар бир матрицанын максималдуу мааниси 1 болчудай нормалдаштырылган. Катарлар чыныгы классты, мамычалар чыгым колдонулган классты көрсөтөт.
| Чыныгы \ Максат | −1 | 0 | +1 |
|---|---|---|---|
| −1 | 0 | 0,500 | 1,000 |
| 0 | 0,500 | 0 | 0,500 |
| +1 | 1,000 | 0,500 | 0 |
| Чыныгы \ Максат | −1 | 0 | +1 |
|---|---|---|---|
| −1 | 0 | 0,138 | 1,000 |
| 0 | 0,860 | 0 | 0,865 |
| +1 | 0,995 | 0,137 | 0 |
| Чыныгы \ Максат | −1 | 0 | +1 |
|---|---|---|---|
| −1 | 0 | 0,796 | 1,000 |
| 0 | 0,796 | 0 | 0,921 |
| +1 | 1,000 | 0,921 | 0 |
| Чыныгы \ Максат | −1 | 0 | +1 |
|---|---|---|---|
| −1 | 0 | 0,639 | 1,000 |
| 0 | 0,639 | 0 | 0,625 |
| +1 | 1,000 | 0,625 | 0 |
Baseline эксперименттеринде жоготуу функцияларынын жүрүм-туруму
Булактын 7-сүрөтүндө 1ден 5ке чейинки QMTL башы бар конфигурациялар салыштырылат. Ар бир баш-жоготуу комбинациясы 100 жолу иштетилгендиктен, графиктеги тенденциялар бир окутуу жүрүшүнө эмес, кайталоолордун орточосуна негизделет.
Wasserstein ыкмасы F1-score жана Cohen's kappa жагынан эң күчтүү жана эң туруктуу ыкма. Баштардын саны көбөйгөн сайын F1 маанисинде да акырындык менен өсүү байкалат. Mahalanobis айрым конфигурацияларда жакындаганы менен, эксперименттер арасында жогору вариация көрсөтөт.
SLACE негизиндеги ыкма болсо олуттуу класс теңсиздиги маселесин көрсөтөт. Болжол менен %98 accuracy бергенине карабастан, Cohen's kappa нөлгө жакын, Restricted Accuracy болсо нөл. Булактагы болжолду текшерүү моделдин иш жүзүндө 0 классын гана тандаганын көрсөтөт. Бул жыйынтык өтө теңсиз классификацияда жогорку accuracy өзүнчө эмне үчүн ишенимдүү ийгилик көрсөткүчү эмес экенинин ачык мисалы.
Linear ыкмасы да бир баштуу учурда төмөн көрсөткүч бергени менен, баштардын саны көбөйгөндө precision жана Restricted Accuracy маанилеринде олуттуу жакшыруу берет. Wasserstein ыкмасы ансыз деле күчтүү бир баштуу жыйынтыктарын көп баштуу окутууда азыраак, бирок байкаларлык деңгээлде жакшыртат.
Accuracy боюнча ыкмалардын ирети башка метрикалардан айырмаланат. Булак текстинде SLACE жана Linear болжол менен %98, Wasserstein болжол менен %87, Cross-Entropy менен Mahalanobis болсо болжол менен %76 деңгээлде билдирилет. Бул айырма жогорку accuracy негизинен үстөмдүк кылган 0 классын болжолдоодон келип чыгышы мүмкүн экенин жана аны багыт кыймылдарын кармоо ийгилиги менен кошо баалоо керектигин көрсөтөт.
QMTLдин окутуу чыгымы
Көп баштуу окутуу болжол чыгаруу чыгымына өтпөсө да, окутуу бекер эмес. Булактын 8-сүрөтү баштардын саны көбөйгөн сайын чыныгы окутуу убактысы болжол менен сызыктуу өсөрүн көрсөтөт. Ошол эле учурда көптөгөн конфигурацияларда баштардын саны көбөйгөн сайын early stopping ге жетүү үчүн керек болгон epoch саны азаят. Автор бул жүрүм-турум ылдамыраак жакындашуу, көп баштуу окутуунун регулярдаштыруучу таасири же эки механизмдин айкалышы менен байланыштуу болушу мүмкүн экенин талкуулайт; изилдөө бул механизмдердин кайсынысы так себеп экенин көрсөтпөйт.
DeepLOB жана MLPLOB менен өркүндөтүлгөн архитектура эксперименттери
Эсептөө чыгымын чектөө үчүн өркүндөтүлгөн архитектураларда стандарттык Cross-Entropy (C) менен эң ийгиликтүү чыгым ыкмасы болгон Wasserstein (W) гана салыштырылган. Булактын 9-сүрөтүндө Baseline, DeepLOB жана MLPLOB үчүн 1-5 баш аралыгында жалпы 40 кайталоонун жыйынтыктары берилет.
Жалпы көрүнүштө Wasserstein жоготуусу ошол эле архитектуранын Cross-Entropy версиясына караганда метрикалардын көбүндө жакшы жыйынтык берет. Эң көрүнүктүү жалпы өзгөчөлүк recall; үч архитектурада тең Cross-Entropy recall боюнча жогору маанилерге жетет. DeepLOB үчүн precision жана Restricted Accuracy, Baseline үчүн да Restricted Accuracy айрым конфигурацияларда Wassersteinдин жалпы артыкчылыгынан өзгөчө учурлар.
MLPLOBдо Wasserstein менен баштардын саны көбөйгөн сайын F1-score, Cohen's kappa жана accuracy сыяктуу айрым метрикалар өсүп, Restricted Accuracy төмөндөйт. Булак муну буга чейин эле болжол менен %98 түзгөн нейтралдуу классты жакшыраак классификациялоо менен сейрек кездешкен ±1 класстарына көңүл буруунун ортосундагы көрсөткүч алмашуусу менен байланыштырат.
DeepLOBдо айрым багыт-кыймыл метрикалары баштардын саны менен жакшырганда, accuracy жана Cohen's kappa төмөндөшү мүмкүн. Демек, QMTL таасири архитектурага жана тандалган метрикага көз каранды; изилдөө “көбүрөөк баш ар дайым жакшы” деген жыйынтыкты колдобойт.
Моделдерди салыштырганда Baseline F1 жана precision боюнча күчтүү; DeepLOB accuracy жана Cohen's kappa боюнча жогорку жыйынтык берет; MLPLOB болсо recall жана өзгөчө Restricted Accuracy боюнча күчтүү. Ошондуктан булак бир архитектураны бардык максаттар үчүн артык деп жарыялабайт.
Бул Жыйынтыктар Кирешелүү HFT Стратегиясын Далилдейби?
Жок. Изилдөө тарыхый BTC/USDT LOB маалыматтарында рынок багытын классификациялоо метрикаларын жана окутуу жүрүм-турумун өлчөйт; таза киреше, транзакция чыгымдары, bid-ask spread таасири, slippage, буйрутма кезегиндеги орун, чыныгы баштан-аяк кечигүү же жандуу буйрутманы аткаруу көрсөткүчтөрү эксперименттердин негизги чыгыш өзгөрмөлөрү эмес. Ошондуктан жогору F1, kappa же Restricted Accuracy түздөн-түз кирешелүү HFT стратегиясы катары чечмелене албайт.
Изилдөө колдогон жыйынтыктар
- −1, 0 жана +1 рынок багыты тапшырмасын иреттик түзүм катары моделдөөгө болот.
- OLL ичиндеги чыгым матрицасынын түзүлүшү моделдин жүрүм-турумун олуттуу өзгөртө алат.
- Бул маалымат топтомунда Wasserstein негизиндеги чыгым матрицасы каралган альтернативалардын ичинен жалпысынан эң туруктуу жыйынтыктарды берет.
- QMTL айрым жоготуу функцияларында жана архитектураларда бир баштуу болжол чыгаруудан мурдагы окутууну жакшырта алат.
- Көп баштуу окутуудан кийин кошумча баштарды алып салуу кошумча баштардын эсептөө чыгымынын негизги жайгаштыруу архитектурасына өтүшүнө жол бербейт.
- Күчтүү класс теңсиздигинен улам accuracy өзүнчө жетиштүү баалоо метрикасы эмес.
Изилдөө колдобогон жалпылоолор
- Жыйынтыктарды бардык акция, валюта же крипто рынокторуна автоматтык түрдө жалпылоого болбойт.
- Wasserstein чыгым матрицасы ар бир маалымат топтомунда Cross-Entropyден артык болору көрсөтүлгөн эмес.
- Көбүрөөк QMTL башы ар бир архитектурада жана ар бир метрикада көрсөткүчтү жогорулатары көрсөтүлгөн эмес.
- Классификация көрсөткүчүнүн өсүшү чыныгы соода кирешеси көбөйөрүн далилдебейт.
- Изилдөө жандуу HFT инфраструктурасында баштан-аяк кечигүү артыкчылыгын ырастаган эмес.
- BTC/USDT жана эки айлык мезгил гана изилденгендиктен, башка рынок режимдери үчүн өзүнчө текшерүү керек.
Эсептөө чыгымы жана туруктуулук
Тезис моделдерди окутуунун энергия чыгымын да өлчөйт. Акыркы эксперимент тобунда Baseline жалпы 150,44 саат окутуу жана 16,55 kWh; DeepLOB 726,02 саат жана 177,87 kWh; MLPLOB 27,7 саат жана 5,54 kWh керектеген. Үчөө биригип 904,16 саат GPU окутуусун жана 199,96 kWh энергияны түзгөн.
| Модель | Жалпы окутуу убактысы | Орточо кубат | Энергия |
|---|---|---|---|
| Baseline | 150,44 саат | 110 W | 16,55 kWh |
| DeepLOB | 726,02 саат | 245 W | 177,87 kWh |
| MLPLOB | 27,7 саат | 200 W | 5,54 kWh |
| Жалпы | 904,16 саат | - | 199,96 kWh |
Автор иштеп чыгуу учурунда жүргүзүлгөн кошумча окутууларды эске алуу үчүн жалпы модель окутуу керектөөсүн болжол менен 399,92 kWh деп баалайт. Иштеп чыгуу компьютерин болжолдуу керектөөсү да кошулганда, долбоор үчүн болжол менен 487,92 kWh эсептелет. Бул бөлүктүн максаты болжол чыгарууда кичинекей модель колдонуунун мүмкүн болгон энергия пайдасы менен татаалыраак окутуу жол-жоболорунун кошумча окутуу чыгымын бирге баалоо керек экенин көрсөтүү.
Булак жана Ыкма Жөнүндө Эскертүү
Түпнуска аталышы: Distance-based Loss functions for High-Frequency Trading
Автор: Jonathan Rodríguez Barja
Тезис жетекчиси: Daniel P. Palomar
Жергиликтүү tutor: Jordi Castro
Мекемелер: Universitat Politècnica de Catalunya - BarcelonaTech (UPC); изилдөө HKUSTде жүргүзүлгөн. Документ Centre de Formació Interdisciplinària Superior (CFIS) алкагындагы Data Science & Engineering / Engineering Physics кош бакалавр программасына таандык.
Булактын түрү: Бакалаврдык бүтүрүү тезиси / Bachelor thesis / Treball Final de Grau.
Дата: PDF мукабасынын датасы февраль 2026; расмий repository каттоо датасы 26 февраль 2026.
Платформа: UPCommons, Universitat Politècnica de Catalunya мекемелик академиялык архиви.
Туруктуу жазуу идентификатору: 2117/457644.
DOI: Булакта жана расмий repository жазуусунда DOI көрсөтүлгөн эмес.
Журнал / том / номер: Колдонулбайт; изилдөө журналдык макала эмес.
Рецензиялоо абалы: Рецензияланган журналдык макала эмес. Университеттик бакалаврдык бүтүрүү иши.
Жеткиликтүүлүк жана лицензия: Расмий repository жазуусу ачык жеткиликтүүлүктү камсыздап, эмгекти CC BY-NC-ND 4.0 лицензиясы алдында көрсөтөт. NoDerivatives шартына байланыштуу Verianla тексти булак текстинин котормосу же жакын кайра жазылышы катары түзүлгөн эмес; булактагы фигуралар өзгөртүлүп же кайра стилдештирилип колдонулган эмес. Илимий ыкма, текшерилүүчү сандар, теңдемелер жана жыйынтыктар өз алдынча окутуучу баяндоо менен кайра түзүмдөлгөн.
Маалымат булагы: CryptoHFTData аркылуу Binance BTC/USDT LOB маалыматы. Изилдөөдө колдонулган дата аралыгы 1 октябрь-30 ноябрь 2025.
Программалык камсыздоо жана иштеп чыгуу: Изилдөө LibMTL негизиндеги алкакты ылайыкташтырган; QMTL, early stopping жана Weights & Biases менен logging сыяктуу компоненттерди кошкон. Булакта коддун өзүнчө жеткиликтүүлүгү же код лицензиясы жөнүндө билдирүү берилген эмес.
Каржылоо: Булакта стандарттуу формадагы өзүнчө каржылоо билдирүүсү жок. Ыраазычылык бөлүмүндө CFIS колдоосу айтылат; бул билдирүү изилдөө фонду же долбоордук грант катары кайра чечмеленген эмес.
Кызыкчылыктардын кагылышы: Булакта кызыкчылыктардын кагылышы жөнүндө өзүнчө билдирүү табылган эмес.
Негизги методологиялык чектөөлөр: Бир актив жана бир биржа; эки айлык тарыхый мезгил гана; болжол менен %98 нейтралдуу классты камтыган күчтүү класс теңсиздиги; чыныгы соода кирешелүүлүгүнүн ордуна классификация метрикалары; QMTLде болжол чыгаруу башынын туш келди тандалышы; Wasserstein чыгымынын колдонмого мүнөздүү OBI чагылдыруусуна көз карандылыгы; mini-batch өлчөмү жана random seed сыяктуу айрым окутуу деталдарынын ачык билдирилбегени.
Булактагы нотация боюнча эскертүү 1: Теңдеме (3.16)дагы Restricted Accuracy бөлгүчүндө кайчылаш классификация мүчөсү кайталангандай көрүнөт. Verianla бул туюнтманы үнсүз оңдогон эмес.
Булактагы нотация боюнча эскертүү 2: Теңдеме (5.12) текстте класс орточосу катары түшүндүрүлгөн \(\bar{\mathbf v}_j\) үчүн суммалоо туюнтмасын берет, бирок көрүнгөн формулада класс үлгүлөрүнүн санына бөлүү мүчөсү жок. Mahalanobis ыкмасынын баяндоосунда бул айырма өзүнчө сакталган.
Пикир калтырыңыз
E-mail дарегиңиз жарыяланбайт. Милдеттүү талаалар * менен белгиленген