

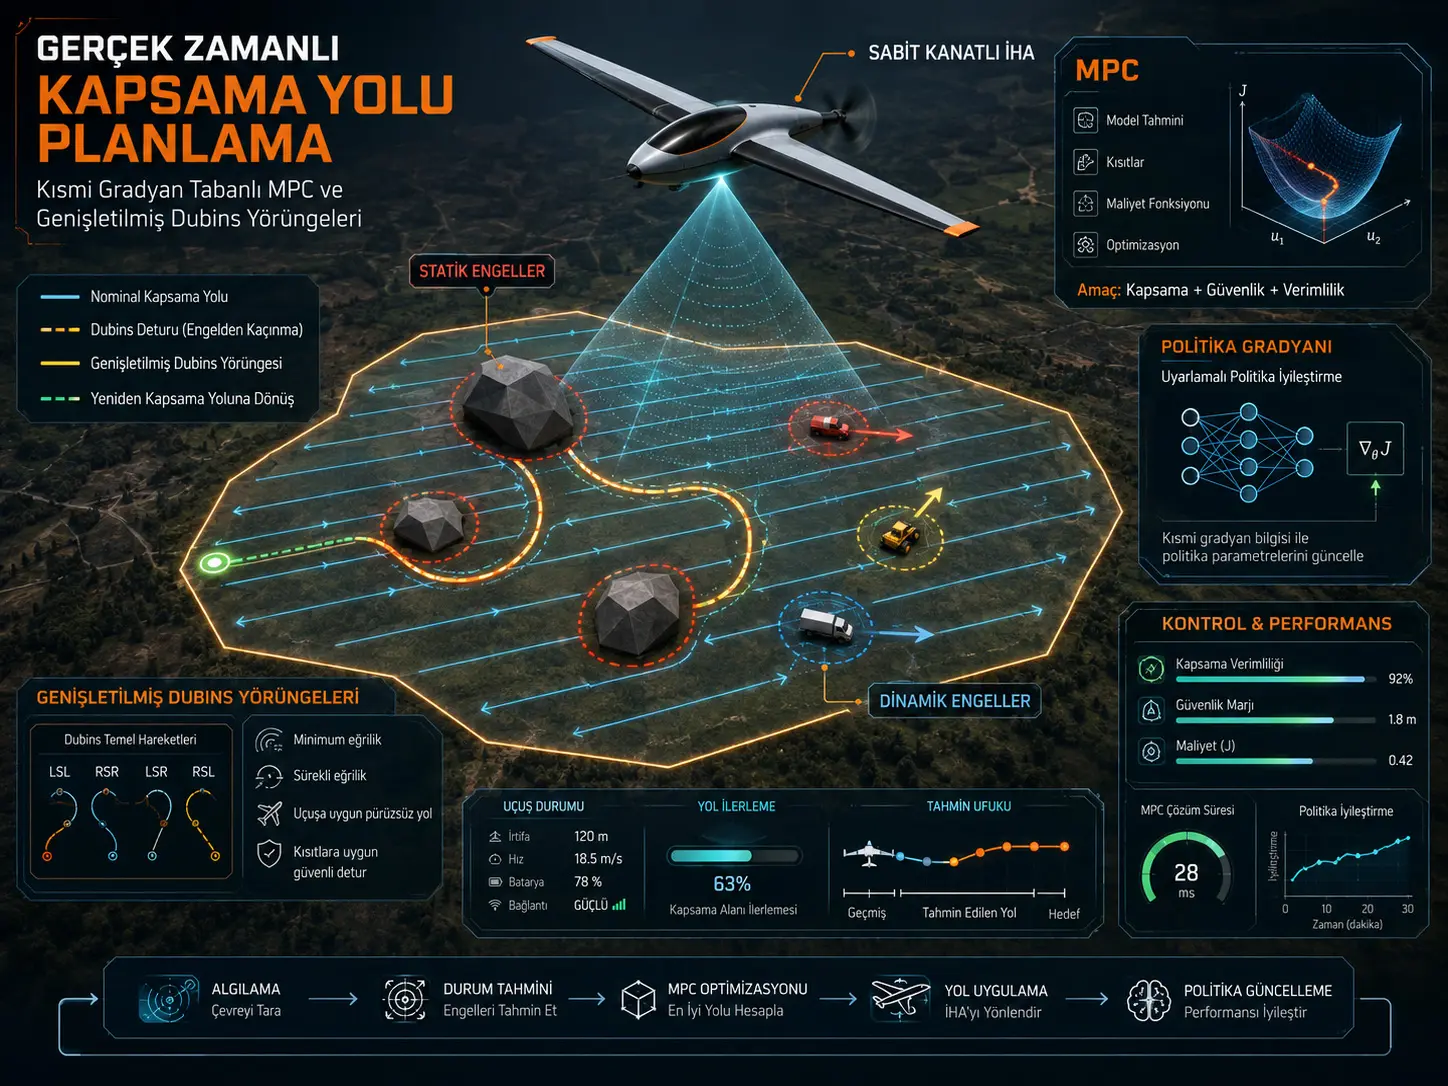
Utafiti huu unatengeneza mfumo mseto wa upangaji njia na udhibiti unaowezesha ndege isiyo na rubani yenye mabawa yasiyobadilika kuruka kwa kufunika eneo lote katika mazingira yanayoweza kuwa na vizuizi tuli na vinavyosogea ambavyo havijulikani kabisa mapema. Mbinu kwanza hutengeneza offline njia ya kawaida ya ufunikaji katika muundo wa back-and-forth; katika awamu ya online ya safari ya ndege, hutumia kwa pamoja Model Predictive Control (MPC), sasisho la udhibiti linalotegemea Policy Gradient (PG), na jiometria ya Dubins Path iliyopanuliwa kwa virtual waypoints (ADP). Katika scenarios tatu za simulation, PG-MPC iliyopendekezwa imepunguza mzigo wa juu wa computation na kuongeza optimization convergence rate ikilinganishwa na gradient-based NLP-MPC ya kawaida, hasa katika mazingira changamano. Katika scenario ya tatu, ambayo ndiyo ngumu zaidi, maximum computation time ilishuka kutoka sekunde 0,9157 hadi sekunde 0,5404, lakini bado ilizidi kidogo kikomo cha sampling cha real-time cha sekunde 0,5 kilichowekwa na utafiti wenyewe. Matokeo yanategemea simulation pekee; utafiti huu hauna flight test ya kimwili ya fixed-wing UAV wala uthibitisho wa kinadharia wa closed-loop stability wa muundo uliounganishwa wa PG-MPC.
Architecture iliyopendekezwa ina tabaka mbili. Awamu ya offline hutengeneza nominal route yenye parallel sweep lines zinazofunika eneo lote la lengo kulingana na camera field of view na jiometria ya eneo. Katika awamu ya online, vizuizi vipya vinavyodhaniwa kugunduliwa na LiDAR huongezwa katika environment model; MPC hu-optimize control inputs na predicted state; sehemu ya Policy Gradient husasisha control policy kulingana na hali mpya; na extended Dubins method hulenga kuirudisha kwenye coverage line, kupitia njia laini zaidi inayolingana na turning-radius constraints za fixed-wing flight, ndege ambayo imeondoka kwenye nominal line ili kuepuka kizuizi.
Faida ya PG-MPC si sawa katika vipimo vyote vya computation. Katika Scenario 1 na Scenario 2, average processing time ni juu kidogo kuliko NLP-MPC ya kawaida. Kwa upande mwingine, peak processing times hupungua kwa kiasi kikubwa kadiri complexity ya mazingira inavyoongezeka. Katika Scenario 2, maximum time imeshuka kutoka 0,718 s hadi 0,3621 s; katika Scenario 3, kutoka 0,9157 s hadi 0,5404 s. Convergence rate imeongezeka kutoka %92,30 hadi %96,87 katika Scenario 2 na kutoka %91,919 hadi %94,34 katika Scenario 3.
Mbinu ya Augmented Dubins Path inalenga kutoa transitions laini zaidi na zinazolingana vizuri zaidi na kinematic turning constraints za fixed-wing vehicle kuliko Dubins Path ya kawaida. Hata hivyo, faida hii ya kijiometri si bila gharama: katika Table 4, ADP imezalisha slightly longer total path na slightly higher total execution time kuliko DP ya kawaida katika scenarios zote tatu. Kwa hiyo utafiti hauungi mkono hitimisho kwamba “ADP hupunguza njia katika kila hali”.
Kwa mtazamo wa Türkiye: Kuwapo kwa watafiti kutoka Adana Alparslan Türkeş Science and Technology University na Gebze Technical University katika timu ya utafiti, pamoja na ufadhili kutoka TÜBİTAK, kunatoa mfano halisi wa wigo wa kazi za kitaaluma za ndani katika control na path planning kwa autonomous fixed-wing systems. Mbinu iliyotengenezwa inaweza kinadharia kuchunguzwa kwa large-area environmental monitoring, post-disaster scanning au coverage missions zinazofanana. Hata hivyo, matokeo yote ya sasa ni ya simulation; mafanikio ya mission katika anga halisi ya Türkiye, kwa sensors halisi au kwenye fixed-wing platform halisi, hayajathibitishwa na utafiti huu.
Utafiti unajaribu kutatua tatizo gani?
Coverage Path Planning (CPP) ni tatizo la kutengeneza njia ambayo air robot itatumia kutazama au kupita juu ya eneo lote la lengo linaloweza kufikiwa. Katika fixed-wing UAVs, tatizo hili ni gumu zaidi kuliko katika multirotor systems kwa sababu vehicle haiwezi kugeukia mahali pake, ina minimum turning radius na kinematic constraints zinazohusiana na continuous forward motion.
Tatizo la pili linalolengwa na utafiti ni kwamba mazingira hayajulikani kikamilifu mapema. Classical back-and-forth coverage paths zinaweza geometrically kuscan eneo lote; lakini wakati wa flight, ikiwa jengo, no-fly zone au moving aerial vehicle ambayo haikuwa kwenye ramani hapo awali itaonekana, njia lazima ipangwe upya locally.
Kwa hiyo utafiti unajaribu kuunganisha mahitaji matatu katika mathematical framework moja:
- kuhifadhi coverage integrity ya eneo,
- kufuata kinematic na control constraints za fixed-wing vehicle,
- kujibu online kwa vizuizi vipya tuli na dynamic.
Kwa nini framework imeundwa kwa hatua mbili?
System ina phases mbili kuu, offline na online. Katika awamu ya offline, ideal nominal coverage route huandaliwa bila kuzingatia vizuizi. Katika awamu ya online, vehicle inapofuata route hii, hugundua vizuizi vipya kulingana na sensor information, husasisha short-term control decisions na, inapohitajika, huondoka kwenye nominal path na kurudi tena kwenye coverage pattern ileile.
Figure 4, inayoonyesha system architecture ya utafiti, inaonyesha separation hii wazi. Upande wa kushoto kuna determination ya boundary ya eneo, sweep-line generation na nominal back-and-forth route; upande wa kulia kuna feature detection/localization, MPC, policy update na Augmented Dubins Path components.
Nominal coverage path inatengenezwaje?
Eneo la lengo limewekwa model kama convex polygon yenye irregular edges ili kupunguza computational complexity. Wakati sweep direction inapoamuliwa, distance kutoka kila polygon edge hadi vertex iliyo mbali zaidi huhesabiwa; smallest value kati ya candidate maximum widths hutumiwa kuamua direction ya coverage lines.
Route inayopatikana ni classical zigzag au back-and-forth structure inayoundwa na parallel scan lines. Endpoint ya kila sweep segment hutumiwa kama starting reference ya segment inayofuata.
Camera inaathiri vipi spacing ya coverage lines?
Utafiti unahusisha distance kati ya flight lines zilizo jirani na camera viewing angle, image overlap na flight altitude. Katika source, line spacing imetolewa hivi:
\[ d= 2\frac{A(1-v)}{\tan(\mu)} \]
Hapa \(A\) ni flight altitude, \(v\) ni required image overlap ratio, na \(\mu\) ni half-angle ya vertical field of view ya camera. Verianla inahifadhi source formula bila kuibadilisha.
Ni fixed-wing platform gani iliyodhaniwa katika simulation?
| Parameter | Source value |
|---|---|
| UAV mass | 3,9 kg |
| Minimum cruise speed | 10 m/s |
| Cruise altitude | 100 m |
| Endurance | 460 dakika |
| Minimum turning radius | 28 m |
| Camera focal length | 2,75 mm |
| Camera sensor | 6,45 × 3,63 mm |
| Camera resolution | 11,9 MP |
| Horizontal / vertical FoV | 102° / 67° |
| LiDAR maximum range | 60 m |
| LiDAR minimum range | 0,05 m |
| LiDAR FoV | 70° |
| LiDAR scan frequency | 10 Hz |
Values hizi ni parameters za agent na perception system katika simulation; flight test ya physical aircraft yenye specifications hizi haikufanyika katika utafiti.
Movement model ya fixed-wing UAV imeelezewaje?
General three-dimensional kinematics imetolewa katika source kama:
\[ \dot{x}=V\cos\theta\cos\psi \]
\[ \dot{y}=V\cos\theta\sin\psi \]
\[ \dot{z}=V\sin\theta \]
\[ \dot{\theta}=q \]
\[ \dot{\psi}=r= \frac{g\tan\phi} {V\cos\theta} \]
.
Kwa sababu flight altitude imechukuliwa kuwa constant katika utafiti, \(\dot{z}=0\), \(\theta=0\) na \(q=0\) zimetumika, na control problem imepunguzwa kuwa planar motion. Simplification hii haiwakilishi full six-degree-of-freedom aerodynamic model ya fixed-wing flight halisi.
Environment scenarios ziliundwaje?
Utafiti umetumia mazingira matatu tofauti ya simulation:
- Scenario 1: basic environment bila static au moving obstacle.
- Scenario 2: previously unknown static polygonal obstacles na moving obstacle.
- Scenario 3: multiple dynamic obstacles katika eneo lilelile ili kuongeza environmental complexity.
Moving obstacles husogea kwenye closed trajectories kwa constant speed ya 20 m/s. Static obstacles zimeundwa kama convex na non-convex polygons.
Katika Figure 3, scenario ya pili ina polygon obstacles na one dynamic obstacle, na scenario ya tatu ina multiple dynamic obstacles zinazotembea kwenye different closed trajectories.
Vizuizi hugunduliwaje wakati wa flight?
Katika simulation structure, LiDAR hutoa distance/depth data ya mazingira. Figure 6 inaonyesha pixel-wise relative-depth map kando ya sample environment image. Kizuizi kipya kinapogunduliwa, geometric information yake huongezwa kwenye environment model na MPC constraints husasishwa.
Hata hivyo, LiDAR results hizi si sensor data zilizorekodiwa kwenye real flight; ni outputs za perception model ya simulation environment.
Jukumu la MPC ni nini?
Model Predictive Control hutabiri future states kupitia finite prediction horizon katika kila control step na kuhesabu upya optimal control sequence. Katika utafiti, continuous system imediscretize chini ya zero-order hold assumption na state-space model imeundwa kama:
\[ X_{k+1}=A_kX_k+B_ku_k \]
\[ Y_k=C_kX_k \]
.
Katika planar case, state vector inajumuisha position na velocity components, huku control vector ikiwa na x- na y-direction control inputs.
Optimization inajaribu kupunguza nini kwa wakati mmoja?
CPP imeformulate kama constrained Multi-Objective Optimization Problem. Combined cost katika source ni:
\[ J= \sum_{k=1}^{N} \left\{ \|p_k-p_{ref}\| + Q_u\|u_k\| + Q_d\|d(p_k,Z)\| \right\} \]
.
Vipengele vitatu vikuu ni:
- distance kati ya current position na target/reference point,
- control effort,
- cross-track deviation kutoka nominal zigzag coverage line.
Katika utafiti path deviation weight \(Q_d=5\), na control-effort weight \(Q_u=2\). Kwa hivyo kufuata nominal coverage path kunapewa weight kubwa kuliko kupunguza control command.
Obstacle safety inageuzwaje kuwa mathematical constraint?
Static polygonal obstacles hupanuliwa kwa Minkowski sum approach ili kujumuisha physical vehicle size na safety distance. Expanded safety region imeelezwa kama:
\[ O_i^{aug} = \left\{ P_i^{aug}\in\mathbb{R}^2 \mid dist(P_i^{aug},O_i)\leq\delta \right\} \]
.
Katika optimization parameters, static obstacle safety margin ni 50 m, dynamic obstacle radius ni 30 m, na minimum separation distance ni 8 m.
Equation consistency note: Dynamic obstacle penalty expression katika Equation (11) ya source si katika mathematical form ileile na dynamic obstacle expression katika Equation (14), ambayo baadaye inasummarize combined optimization. Verianla haijazi kimya kimya tofauti hii kwa equation moja.
Sehemu ya Policy Gradient inafanyaje kazi?
Katika utafiti, PG inamaanisha Policy Gradient katika method text yote. System state hubadilishwa kuwa probability distribution ya five discrete movement commands:
- geuka kushoto,
- enda moja kwa moja,
- geuka kulia,
- ongeza kasi,
- punguza kasi.
Policy imeelezwa kwa linear function approximation kama:
\[ h_u(X)=\eta(X)^T\vartheta_u \]
na action probabilities huhesabiwa kwa SoftMax kama:
\[ Q(u|X)= \frac{e^{h_u(X)}} {\sum_{u'}e^{h_{u'}(X)}} \]
.
Kwa nini Critic imeongezwa?
Kwa sababu variance ya reward/cost signal inaweza kuwa kubwa katika pure Policy Gradient updates, linear value-function approximator imetumika:
\[ V(X_k)=w^T\eta(X_k) \]
Temporal-Difference error inahesabiwa kama:
\[ \delta_k= J_k+\lambda V(X_{k+1})-V(X_k) \]
.
Policy parameter inasasishwa kwa rule:
\[ \vartheta_u \leftarrow \vartheta_u+ \alpha\delta_k \eta(X_k) \left( I(u_k)-Q(u_k|X_k) \right) \]
.
Watafiti wanasema learning process hii hufanyika online bila kuhitaji pre-collected dataset au experience replay.
Augmented Dubins Path inatofautianaje na classical Dubins?
Classical Dubins problem hutumia combinations zinazowezekana za curves kati ya configurations mbili kwa forward-moving vehicle yenye fixed minimum turning radius. Utafiti unaongeza virtual waypoint na kupanua feasible trajectory family kutoka classical six types hadi ten types:
\[ D= \{ LSL,RSR,RSL,LSR,RLR,LRL, RLSLR,LRSRL,SLR,SRL \} \]
Kati ya new paths, RLSLR na LRSRL zina four curves + one straight segment; SLR na SRL zina two curves + one straight segment.
Figure 7 inaonyesha geometry ya virtual waypoints hizi inayowezesha turn kuanza baadaye na direction changes kufanyika katika maeneo yaliyobana zaidi karibu na waypoint.
Kwa nini ADP si lazima iwe fupi zaidi?
Matokeo ya utafiti wenyewe yanaonyesha kwamba main goal ya ADP si absolute minimum distance. Additional virtual waypoints na transitions zinazoendana vizuri zaidi na kinematics zinaweza kuongeza kidogo distance na execution time.
| Smoothing | Scenario 1 time (s) | Scenario 2 time (s) | Scenario 3 time (s) | Scenario 1 distance (m) | Scenario 2 distance (m) | Scenario 3 distance (m) |
|---|---|---|---|---|---|---|
| DP | 27.223 | 27.447 | 27.990,30 | 272.233,4 | 274.474,5 | 279.903,1 |
| ADP | 27.294 | 27.532 | 28.127,72 | 272.937,3 | 275.325,7 | 281.277,21 |
Matokeo ya jedwali yanaonyesha kwamba ingawa ADP imetoa slightly longer distance na time kuliko classical DP katika scenarios zote tatu, kwa tathmini ya waandishi imetoa local transitions laini zaidi na zinazotekelezeka vizuri zaidi kinematically.
Learning parameters zilichaguliwaje?
Policy learning rate na discount factor hazikuchukuliwa moja kwa moja kama single values; zilitathminiwa kwa sensitivity analysis inayotegemea 100 simulation runs.
Kwa learning rate:
\[ 0.0001,\;0.0005,\;0.001,\;0.005,\;0.01 \]
na kwa discount factor:
\[ 0.90,\;0.93,\;0.96,\;0.99 \]
zilijaribiwa.
Correlation maps katika Figure 9 zinaonyesha kwamba low-to-moderate learning rates na discount-factor region ya 0,93–0,96 zilitoa balance inayofaa zaidi kati ya cost na computation time. Katika final model, learning rate 0,001 na discount factor 0,96 zilichaguliwa.
Ni zipi main optimization parameters katika simulation?
| Parameter | Value | Explanation |
|---|---|---|
| Sampling time | 0,5 s | MPC control update interval |
| Prediction horizon | 100 | MPC prediction horizon |
| Policy learning rate | 0,001 | PG update |
| Discount factor | 0,96 | Weight of future TD effect |
| Minimum separation | 8 m | Obstacle / agent safety separation |
| Control input lower bound | −2 m/s² | Minimum acceleration command |
| Control input upper bound | 2 m/s² | Maximum acceleration command |
| Number of static obstacles | 4 | Polygonal obstacles |
| Obstacle safety margin | 50 m | Static obstacle buffer distance |
| Dynamic obstacle radius | 30 m | Dynamic obstacle model |
| Waypoint acceptance threshold | 20 m | Threshold for moving to next segment |
| Control effort weight | 2 | \(Q_u\) |
| Path deviation weight | 5 | \(Q_d\) |
Je, PG-MPC ni real-time?
Inatimiza real-time criterion yake katika Scenario 2; worst case ya Scenario 3, hata hivyo, inazidi kikomo cha sekunde 0,5. Watafiti wanasema kwamba ili control cycle ihesabiwe kuwa real-time, jumla ya perception, optimization na control operations haipaswi kuzidi sampling interval. Sampling interval ni sekunde 0,5.
Katika Figure 10, maximum computation time kwa Scenario 2 ni takriban sekunde 0,36. Table 4 inatoa value hii kama sekunde 0,3621, chini ya kikomo cha sekunde 0,5.
Hata hivyo, kwa Scenario 3 maximum PG-MPC value ni sekunde 0,5404. Kwa hiyo “real-time feasibility” result ya utafiti haipaswi kueleweka kwamba every control cycle katika scenario ngumu zaidi ilibaki chini ya sekunde 0,5.
Ni zipi results kamili kati ya classical NLP-MPC na PG-MPC?
| Metric | NLP-MPC S1 | NLP-MPC S2 | NLP-MPC S3 | PG-MPC S1 | PG-MPC S2 | PG-MPC S3 |
|---|---|---|---|---|---|---|
| Average computation time (s) | 0,095 | 0,1618 | 0,1898 | 0,128 | 0,2000 | 0,1891 |
| Maximum computation time (s) | 0,2295 | 0,7180 | 0,9157 | 0,2549 | 0,3621 | 0,5404 |
| Optimization convergence rate (%) | 99,993 | 92,30 | 91,919 | 99,993 | 96,87 | 94,34 |
| Constraint violation occurrence (%) | 0 | 5,67 | 3,2938 | 0 | 4,22 | 3,2864 |
Jedwali linaonyesha kwamba faida ya method iliyopendekezwa ni hasa limiting peak processing burden na kuongeza convergence rate katika complex scenarios. Hata hivyo, PG-MPC si faster kuliko classical NLP-MPC katika average computation time kwa Scenario 1 na Scenario 2.
Constraint violation inashuka kutoka %5,67 hadi %4,22 katika Scenario 2, wakati katika Scenario 3 inabadilika kidogo sana kutoka %3,2938 hadi %3,2864. Source inatafsiri results hizi kama improved constraint satisfaction; lakini separate statistical significance test haijaripotiwa.
Matokeo yanayoungwa mkono na utafiti
- Back-and-forth CPP, MPC, online Policy Gradient update na augmented Dubins smoothing zimeweza kutumika pamoja katika simulation framework moja.
- Muundo uliopendekezwa unaweza locally kuondoka kwenye nominal coverage path na kurudi kwenye route katika simulations zenye static na dynamic obstacles.
- PG-MPC imepunguza maximum computation time kuliko classical NLP-MPC katika Scenario 2 na Scenario 3.
- Katika Scenario 2, convergence rate imeongezeka kutoka %92,30 hadi %96,87.
- Katika Scenario 3, convergence rate imeongezeka kutoka %91,919 hadi %94,34.
- Katika Scenario 2, constraint violation occurrence imeshuka kutoka %5,67 hadi %4,22.
- Augmented Dubins approach inatoa local transitions laini zaidi na zinazotekelezeka kinematically kuliko classical Dubins katika simulation images.
- Katika Scenario 2, maximum processing time ya PG-MPC ya 0,3621 s imebaki chini ya sampling period ya 0,5 s.
Matokeo ambayo utafiti hauungi mkono au haujapima
- Method haijathibitishwa kwa flight test kwenye real fixed-wing UAV.
- Performance haijapimwa chini ya real LiDAR noise, sensor delay au packet loss.
- Physical flight success chini ya real wind na atmospheric disturbance haijaonyeshwa.
- Real actuator saturation na aerodynamic model uncertainty hazijajaribiwa kwenye hardware.
- Hakuna rigorous theoretical proof ya closed-loop stability ya combined PG-MPC system.
- Haijaonyeshwa kwamba every control cycle katika Scenario 3 hubaki chini ya real-time limit ya sekunde 0,5; maximum time ni 0,5404 s.
- Haijaonyeshwa kwamba ADP hutoa shorter route kuliko classical Dubins path; cumulative distance ni slightly higher katika scenarios zote tatu.
- Haijaonyeshwa kwamba PG-MPC hutoa lower average computation time kuliko classical NLP-MPC katika every case.
- Haijathibitishwa kwamba simulation results zinaweza kugeneralize kwa real disaster, agriculture au environmental monitoring missions kwa performance numbers zilezile.
- Utafiti hautumii full six-degree-of-freedom aerodynamic fixed-wing model; control problem imepunguzwa kuwa constant-altitude planar model.
Mbinu na Matokeo ya Utafiti
Software na computing environment
Framework imetekelezwa katika MATLAB R2024b. Kompyuta iliyotumika kuendesha simulations ilikuwa na:
- 4,7 GHz Intel Core i7 processor,
- 16 GB RAM,
- NVIDIA RTX 3070 GPU
. Source inasema kompyuta ilikuwa na GPU, lakini haionyeshi separately kwamba optimization computations zote ziliharakishwa kwenye GPU.
Offline planning algorithm
Algorithm 1 huhesabu distance kati ya kila edge ya convex polygon na vertices zake zote. Kwa kila edge, vertex iliyo mbali zaidi huchaguliwa, na smallest value kati ya maximum distances hizi hutumiwa kama direction sweep orientation.
Parallel sweep lines huwekwa kwenye eneo kwa kutumia camera footprint width na image overlap requirement. Nominal route inalenga full coverage bila kuingiza unknown obstacle yoyote.
Online PG-MPC loop
Online system hufanya operations zifuatazo katika kila control step:
- Current state \(X_k\) hupokelewa.
- Detected static na moving obstacles huongezwa kwenye environment model.
- Policy features huhesabiwa.
- Control-action probabilities huundwa kupitia SoftMax.
- Control input huamuliwa.
- New state hutabiriwa.
- Instantaneous cost huhesabiwa.
- TD error hupatikana.
- Critic parameter husasishwa.
- Policy parameters husasishwa.
- Local path husawazishwa kwa Augmented Dubins geometry.
Utafiti unaita cycle hii online learning na unasema haihitaji fully pre-trained policy.
Multi-threaded structure
PG-MPC implementation imemodeliwa kama multi-threaded architecture inayounga mkono concurrent operation ya optimization, perception na navigation modules. Lengo ni kuwakilisha kwa makadirio asynchronous task structure ya real flight computer.
Hata hivyo, architecture hii si Hardware-in-the-Loop au flight-test benchmark iliyotekelezwa kwenye physical avionics computer.
Scenario 1 inaonyesha nini?
Obstacle-free baseline scenario inajaribu ikiwa framework inaweza kufuata nominal coverage pattern. Katika classical na proposed optimizer zote mbili, convergence rate ni %99,993 na constraint violation ni %0.
Katika hali hii rahisi zaidi, maximum computation time ya PG-MPC ni 0,2549 s, juu kidogo kuliko 0,2295 s ya NLP-MPC. Kwa hiyo proposed PG update haina direct speed advantage katika easy environment.
Scenario 2 inaonyesha nini?
Static na moving obstacles zinapoongezwa, maximum computation time ya classical NLP-MPC inapanda hadi 0,718 s, wakati PG-MPC inabaki 0,3621 s.
Convergence rate katika scenario hiyo hiyo inabadilika kutoka %92,30 hadi %96,87, na constraint violation kutoka %5,67 hadi %4,22.
Scenario hii inaonyesha moja ya advantages zilizo wazi zaidi za utafiti kwa “peak computation burden”.
Scenario 3 inaonyesha nini?
Scenario ya tatu yenye multiple dynamic obstacles ndiyo condition ngumu zaidi. Maximum computation time ya classical NLP-MPC ni 0,9157 s, na ya PG-MPC ni 0,5404 s.
Source inaripoti change hii kama reduction ya takriban %41,1. Ingawa PG-MPC inatoa peak-time advantage kubwa, value ya 0,5404 s iko juu ya sampling interval ya 0,5 s. Kwa hiyo, kulingana na strict real-time criterion iliyowekwa ndani ya utafiti, kuna isolated worst-case exceedance.
Convergence rate imeongezeka kutoka %91,919 hadi %94,34; constraint violation occurrence imepungua kwa kiasi kidogo sana kutoka %3,2938 hadi %3,2864.
Ujumbe mkuu wa Figure 10 ni upi?
Figure 10 inaonyesha kwamba computation time na objective cost huongezeka karibu na certain obstacle regions katika mazingira. Haya ni maeneo ambayo controller inaweka priority kwenye collision avoidance na feasibility constraints badala ya kufuata nominal path moja kwa moja.
Kwa sababu computation load si constant katika mazingira yote, inaonyesha pia kwa nini worst-case time ni muhimu zaidi kuliko average time. Katika real-time flight-control application, metric inayoweka control-cycle deadline mara nyingi ni peak computation time, si average.
Figure 11 inaonyesha nini?
Figure 11 inalinganisha MPC-ADP na MPC-DP paths side by side katika scenarios tatu. Katika obstacle-free case, structures zote mbili zinafuata karibu nominal sweep pattern. Static na dynamic obstacles zinapoongezwa, local deviations hutokea.
Katika zoomed regions, ADP turns kuonekana gradual zaidi kuliko classical DP ndiyo visual basis ya maelezo ya waandishi ya “smoother and dynamically feasible”.
Hata hivyo, Table 4 ya utafiti huo huo inaonyesha kwamba ADP imeongeza total distance kidogo katika scenarios zote tatu. Smoothness inayoonekana kwenye figure na total path length si performance measure moja.
Trade-off kuu ya method ni ipi?
Data za utafiti hazitoi result ya algorithm “iliyo bora kwa kila kipengele”. Proposed method ina advantage hasa kwa peak optimisation time na convergence katika complex obstacle environments; lakini online policy update huongeza average computation burden katika baadhi ya scenarios.
Vivyo hivyo, Augmented Dubins route geometry hutoa transitions laini zaidi na zinazotekelezeka kinematically lakini inaleta additional distance ndogo na execution time.
Kwa hiyo engineering trade-off kuu ya framework ni kuweka priority si kwa pure minimum computation time au minimum distance pekee, bali kwa combination ya coverage continuity + kinematic feasibility + dynamic-obstacle adaptation.
Nguvu za utafiti
- Unaunganisha coverage planning na online control katika optimization structure moja.
- Unazingatia wazi minimum-turn behavior ya fixed-wing vehicle kupitia Dubins geometry.
- Unashughulikia unknown static na dynamic obstacles katika framework moja.
- Unaunganisha Policy Gradient moja kwa moja ndani ya MPC update.
- Unafanya sensitivity analysis kwa learning rate na discount factor.
- Unatoa quantitative comparison na classical NLP-MPC chini ya conditions zilezile.
- Unaripoti average na maximum computation time separately.
- Unatoa convergence na constraint violation metrics kwa pamoja.
- Unalinganisha DP na ADP smoothing costs separately.
Mapungufu makuu ya utafiti
- Validation yote ni simulation.
- Hakuna physical fixed-wing UAV flight test.
- Real sensor noise na communication delay hazijajaribiwa.
- Wind na real atmospheric disturbance zimeachwa kwa future work.
- Actuator uncertainties na real flight-computer deadline behavior hazijajaribiwa.
- Model inatumia constant-altitude, low-fidelity planar dynamics approach.
- Hakuna rigorous theoretical analysis ya closed-loop PG-MPC stability.
- Worst-case time ya Scenario 3 iko juu ya 0,5 s control period.
- ADP inazalisha additional path length na execution time, ingawa ni ndogo.
- Terminology ya “Partial Gradient” katika title ya study haioani na “Policy Gradient” ndani ya method.
Future studies zinapaswa kushughulikia matatizo gani?
Waandishi wanataja application ya method kwenye real fixed-wing platforms kama important future step. Validation hii inapendekezwa kujumuisha wind disturbances, sensor noise, communication delays na actuator uncertainties.
Utafiti pia unakubali wazi kwamba rigorous closed-loop stability analysis ya combined PG-MPC structure haijafanywa na inaitaja kama future theoretical direction.
Zaidi ya hayo, integration ya robust nonlinear control approaches kama Sliding Mode Control inapendekezwa ili kuongeza disturbance rejection na robustness kwa model uncertainty.
Maelezo ya Chanzo na Mbinu
Kichwa kamili cha asili cha utafiti: Real-Time Coverage Path Planning for Fixed-Wing Aerial Robots Using Partial Gradient-Based MPC and Augmented Dubins Trajectories
Waandishi: Mohammad Khaneghaei; Benyamin Ebrahimi; Davood Asadi; Onder Tutsoy; Seyed-Yaser Nabavi-Chashmi; Hassan Haghighi.
Mpangilio wa waandishi: Mpangilio asili wa source umehifadhiwa kama ulivyo.
Equal contribution/co-first author: Haijatajwa kwenye source.
Corresponding author: Davood Asadi.
Taasisi: Department of Electrical Engineering, Adana Alparslan Turkeş Science and Technology University, Adana, Türkiye; Department of Aerospace Engineering, Adana Alparslan Turkeş Science and Technology University, Adana, Türkiye; College of Arts, Technology and Environment, University of the West England, Bristol, UK; Department of Aeronautical Engineering, Gebze Technical University, Gebze, Türkiye; Laboratoire d’Informatique et Systèmes, Aix-Marseille University, Marseille, France.
Affiliation note: Affiliation ya tatu katika source imetolewa kama “University of the West England”. Verianla imehifadhi bibliographic record kama ilivyo kwenye source na haijaandika upya jina la institution kimya kimya.
Title terminology note: Original title inatumia “Partial Gradient-Based MPC”. PG method katika body ya makala, hata hivyo, imeelezwa kama “Policy Gradient” na equations zimeundwa kulingana na approach hii. Verianla haijabadilisha original title.
Source type: Peer-reviewed research article; algorithm-development na simulation-based comparative validation study.
Journal: Aerospace
Publisher: MDPI
Volume / issue / article number: 13(8), 713
Publication date: 9 Agosti 2026
DOI: 10.3390/aerospace13080713
Official publication link: https://www.mdpi.com/2226-4310/13/8/713
DOI link: https://doi.org/10.3390/aerospace13080713
Peer-review status: Utafiti ni research article iliyochapishwa katika peer-reviewed journal Aerospace.
License: Creative Commons Attribution (CC BY) open-access license.
Funding: Utafiti umefadhiliwa na Türkiye Bilimsel ve Teknolojik Araştırma Kurumu (TÜBİTAK) chini ya grants 125M675 na 223M312.
Data availability: Imeripotiwa kwamba data zitapatikana upon request.
Conflict of interest: Waandishi hawakuripoti known competing financial interests au personal relationships ambazo zingeweza kuathiri utafiti.
Author contributions: Mohammad Khaneghaei; review and editing, initial draft, visualization, validation, methodology, resources, investigation, formal analysis, data curation na conceptualization. Benyamin Ebrahimi; review and editing, initial draft, visualization, validation, methodology, investigation, formal analysis, data curation na conceptualization. Davood Asadi; review and editing, initial draft, supervision, investigation, formal analysis, data curation na conceptualization. Onder Tutsoy; review and editing, initial draft, validation, methodology, resources na supervision. Seyed-Yaser Nabavi-Chashmi; review and editing, validation na supervision. Hassan Haghighi; review and editing na validation.
Simulation level: Comparisons zote zinategemea simulations zilizofanywa katika MATLAB R2024b. Utafiti hauna real fixed-wing UAV flight experiment, hardware-in-the-loop test au field demonstration.
Real-time limit: Source inaeleza real-time criterion kama computation/control time kutopaswa kuzidi 0,5 s sampling interval. PG-MPC inatimiza hili katika Scenario 2 kwa maximum value ya 0,3621 s; katika Scenario 3 inabaki juu ya limit kwa maximum value ya 0,5404 s. Kwa hiyo Verianla haitumii kauli kwamba “every control step ni definitely real-time katika all scenarios”.
Equation consistency note: Dynamic obstacle penalty term katika Equation (11) ya source na combined problem expression katika Equation (14) hazijawasilishwa katika mathematical form ileile. Verianla haijarekebisha tofauti hii kwa assumption.
ADP interpretation limit: Advantage ya Augmented Dubins Path ni kutengeneza transition laini zaidi na kinematically feasible. Values za Table 4 katika source zinaonyesha kwamba ADP imezalisha slightly higher cumulative distance na execution time kuliko classical DP katika scenarios zote tatu.
Stability limit: Waandishi wanasema wazi kwamba hawajatoa rigorous theoretical analysis ya closed-loop stability ya combined PG-MPC system na wameiacha kwa future work.
Scientific limit: Model results zilipatikana chini ya synthetic static/dynamic obstacles, idealized perception model na constant-altitude planar fixed-wing dynamics. Effects za real wind, sensor noise, communication delay, actuator uncertainty na physical flight system hazijatathminiwa experimentally.
Content production method: Scientific method, equations, simulation parameters, performance metrics, figure interpretations na limitations katika maelezo haya ya Verianla yanategemea source study iliyopakiwa. External verification imetumika tu kukagua bibliographic identity, official publication record na peer-review information; hakuna new scientific performance result kutoka external sources au algorithmic conclusion isiyokuwa kwenye source iliyoongezwa kwenye main text.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *