

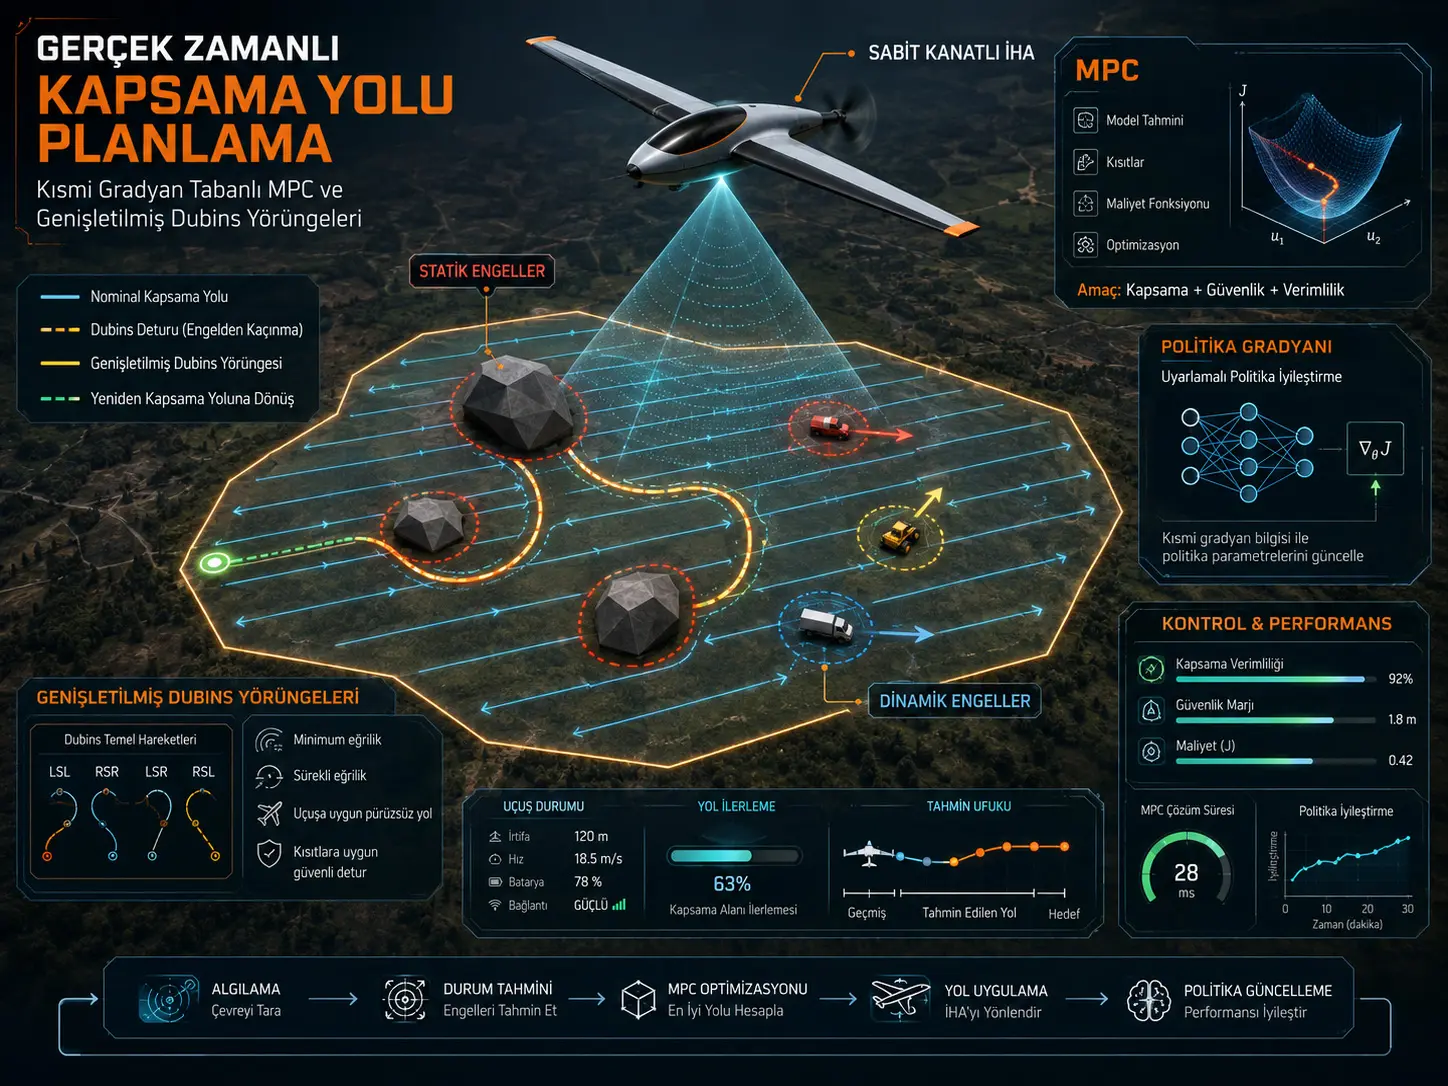
Bu araştırma, sabit kanatlı bir insansız hava aracının önceden tamamen bilinmeyen statik ve hareketli engeller içerebilen bir bölgede bütün alanı kapsayacak biçimde uçmasını sağlayan hibrit bir yol planlama ve kontrol çerçevesi geliştirmektedir. Yöntem önce çevrimdışı olarak back-and-forth biçiminde nominal bir kapsama yolu üretmekte; uçuşun çevrimiçi aşamasında ise Model Predictive Control (MPC), Policy Gradient (PG) tabanlı kontrol güncellemesi ve sanal waypoint'lerle genişletilmiş Dubins Path (ADP) geometrisini birlikte kullanmaktadır. Üç simülasyon senaryosunda önerilen PG-MPC, özellikle karmaşık çevrelerde klasik gradient-based NLP-MPC'ye göre maksimum hesaplama yükünü düşürmüş ve optimizasyon yakınsama oranını artırmıştır. En zor üçüncü senaryoda maksimum hesaplama süresi 0,9157 saniyeden 0,5404 saniyeye düşmüş, ancak çalışmanın kendi 0,5 saniyelik gerçek zamanlı örnekleme sınırını az da olsa aşmıştır. Sonuçlar yalnız simülasyona dayanmaktadır; fiziksel sabit kanatlı İHA uçuşu ve birleşik PG-MPC yapısının teorik kapalı çevrim kararlılık kanıtı bu çalışmada bulunmamaktadır.
Önerilen mimari iki katmanlıdır. Çevrimdışı aşama, kamera görüş alanı ve bölge geometrisine göre bütün hedef alanı kapsayan paralel sweep line'lardan oluşan nominal rota üretir. Çevrimiçi aşamada LiDAR tarafından algılandığı varsayılan yeni engeller çevre modeline eklenir; MPC kontrol girişlerini ve tahmin edilen durumu optimize eder; Policy Gradient bölümü kontrol politikasını yeni durumlara göre günceller; genişletilmiş Dubins yöntemi ise engelden kaçınmak için nominal hattan çıkan aracın sabit kanatlı uçuşun dönüş yarıçapı kısıtlarına uygun, daha düzgün bir yolla tekrar kapsama hattına dönmesini amaçlar.
PG-MPC'nin avantajı bütün hesaplama ölçütlerinde aynı değildir. Scenario 1 ve Scenario 2'de ortalama işlem süresi klasik NLP-MPC'den biraz daha yüksektir. Buna karşılık çevrenin karmaşıklığı arttığında tepe işlem süreleri belirgin biçimde düşmektedir. Scenario 2'de maksimum süre 0,718 s'den 0,3621 s'ye, Scenario 3'te 0,9157 s'den 0,5404 s'ye gerilemiştir. Yakınsama oranı Scenario 2'de %92,30'dan %96,87'ye, Scenario 3'te %91,919'dan %94,34'e yükselmiştir.
Augmented Dubins Path yaklaşımı klasik Dubins Path'e göre daha düzgün ve sabit kanatlı aracın kinematik dönüş sınırlarına daha uygun geçişler sağlamayı hedeflemektedir. Ancak bu geometrik avantaj ücretsiz değildir: Tablo 4'te ADP, üç senaryonun tamamında klasik DP'ye göre biraz daha uzun toplam yol ve biraz daha yüksek toplam execution time üretmiştir. Dolayısıyla çalışma “ADP her durumda yolu kısaltır” sonucunu desteklememektedir.
Türkiye açısından: Araştırma ekibinde Adana Alparslan Türkeş Bilim ve Teknoloji Üniversitesi ile Gebze Teknik Üniversitesi araştırmacılarının bulunması ve çalışmanın TÜBİTAK tarafından desteklenmesi, sabit kanatlı otonom sistemlerde yerli akademik kontrol ve yol planlama çalışmalarının kapsamına ilişkin somut bir örnek sunmaktadır. Geliştirilen yaklaşım teorik olarak geniş alan çevresel izleme, afet sonrası tarama veya benzeri kapsama görevleri için araştırılabilir. Bununla birlikte mevcut sonuçların tamamı simülasyondur; Türkiye'deki gerçek hava sahasında, gerçek sensörlerle veya gerçek sabit kanatlı platform üzerinde görev başarısı bu çalışmayla kanıtlanmış değildir.
Araştırmanın çözmeye çalıştığı problem nedir?
Coverage Path Planning (CPP), bir hava robotunun erişilebilir hedef bölgenin tamamını gözlemleyecek veya üzerinden geçecek şekilde yol üretmesi problemidir. Sabit kanatlı İHA'larda bu problem multirotor sistemlerden daha zordur; çünkü araç yerinde dönemez, minimum dönüş yarıçapına ve sürekli ileri harekete bağlı kinematik sınırlara sahiptir.
Araştırmanın hedeflediği ikinci sorun çevrenin önceden tam bilinmemesidir. Klasik back-and-forth kapsama yolları geometrik olarak bütün bölgeyi tarayabilir; ancak uçuş sırasında daha önce haritada bulunmayan bina, yasak bölge veya hareketli hava aracı ortaya çıktığında yolun yerel olarak yeniden düzenlenmesi gerekir.
Bu nedenle çalışma üç gereksinimi aynı matematiksel çerçevede birleştirmeye çalışmaktadır:
- bölgenin kapsama bütünlüğünü korumak,
- sabit kanatlı aracın kinematik ve kontrol sınırlarına uymak,
- yeni statik ve dinamik engellere çevrimiçi olarak tepki vermek.
Çerçeve neden iki aşamalı tasarlandı?
Sistem çevrimdışı ve çevrimiçi olmak üzere iki ana fazdan oluşmaktadır. Çevrimdışı aşamada engeller hesaba katılmadan ideal nominal kapsama rotası hazırlanır. Çevrimiçi aşamada ise araç bu rotayı takip ederken sensör bilgisine göre yeni engelleri algılar, kısa vadeli kontrol kararlarını günceller ve gerektiğinde nominal yoldan ayrılıp yeniden aynı kapsama düzenine döner.
Çalışmanın sistem mimarisini gösteren Şekil 4 bu ayrımı açık biçimde göstermektedir. Sol tarafta bölge sınırının belirlenmesi, sweep-line üretimi ve nominal back-and-forth rota; sağ tarafta feature detection/localization, MPC, policy update ve Augmented Dubins Path bileşenleri bulunmaktadır.
Nominal kapsama yolu nasıl oluşturuluyor?
Hedef bölge, hesaplama karmaşıklığını azaltmak amacıyla düzensiz kenarlara sahip fakat konveks bir poligon olarak modellenmiştir. Sweep yönü belirlenirken her poligon kenarından en uzak köşeye olan mesafe hesaplanır; aday maksimum genişlikler arasından en küçük olan, kapsama çizgilerinin yönünü belirlemek için kullanılır.
Ortaya çıkan rota paralel tarama çizgilerinden oluşan klasik zigzag veya back-and-forth yapısıdır. Her sweep segmentinin bitiş noktası sonraki segmentin başlangıç referansı olarak kullanılmaktadır.
Kamera kapsama çizgilerinin aralığını nasıl etkiliyor?
Çalışma, komşu uçuş hatları arasındaki mesafeyi kamera görüş açısı, görüntü örtüşmesi ve uçuş irtifasıyla ilişkilendirmektedir. Kaynakta hat aralığı şu biçimde verilmiştir:
\[ d= 2\frac{A(1-v)}{\tan(\mu)} \]
Burada \(A\) uçuş irtifası, \(v\) gerekli görüntü overlap oranı ve \(\mu\) kameranın dikey görüş alanının yarı açısıdır. Verianla kaynak formülü değiştirmeden aktarmaktadır.
Simülasyonda nasıl bir sabit kanatlı platform varsayıldı?
| Parametre | Kaynak değeri |
|---|---|
| İHA kütlesi | 3,9 kg |
| Minimum cruise hızı | 10 m/s |
| Cruise irtifası | 100 m |
| Endurance | 460 dakika |
| Minimum dönüş yarıçapı | 28 m |
| Kamera odak uzaklığı | 2,75 mm |
| Kamera sensörü | 6,45 × 3,63 mm |
| Kamera çözünürlüğü | 11,9 MP |
| Yatay / dikey FoV | 102° / 67° |
| LiDAR maksimum menzili | 60 m |
| LiDAR minimum menzili | 0,05 m |
| LiDAR FoV | 70° |
| LiDAR tarama frekansı | 10 Hz |
Bu değerler simülasyondaki ajan ve algılama sisteminin parametreleridir; çalışmada bu özelliklere sahip fiziksel bir hava aracının uçuş testi yapılmamıştır.
Sabit kanatlı İHA'nın hareket modeli nasıl tanımlandı?
Genel üç boyutlu kinematik kaynakta:
\[ \dot{x}=V\cos\theta\cos\psi \]
\[ \dot{y}=V\cos\theta\sin\psi \]
\[ \dot{z}=V\sin\theta \]
\[ \dot{\theta}=q \]
\[ \dot{\psi}=r= \frac{g\tan\phi} {V\cos\theta} \]
olarak verilmektedir.
Araştırmada uçuş irtifası sabit kabul edildiği için \(\dot{z}=0\), \(\theta=0\) ve \(q=0\) alınmış; kontrol problemi düzlemsel harekete indirgenmiştir. Bu basitleştirme gerçek sabit kanatlı uçuşun tam altı serbestlik dereceli aerodinamik modelini temsil etmemektedir.
Çevre senaryoları nasıl oluşturuldu?
Çalışmada üç farklı simülasyon ortamı kullanılmıştır:
- Scenario 1: statik veya hareketli engel içermeyen temel çevre.
- Scenario 2: önceden bilinmeyen statik poligonal engeller ve hareketli engel.
- Scenario 3: çevresel karmaşıklığı artırmak amacıyla aynı bölgede birden fazla dinamik engel.
Hareketli engeller kapalı yörüngelerde sabit 20 m/s hızla hareket etmektedir. Statik engeller hem konveks hem non-konveks poligonlar şeklinde oluşturulmuştur.
Şekil 3'te ikinci senaryoda poligon engellerle bir dinamik engel, üçüncü senaryoda ise farklı kapalı yörüngelerde hareket eden çok sayıda dinamik engel görülmektedir.
Engeller uçuş sırasında nasıl algılanıyor?
Simülasyon yapısında LiDAR, çevreye ilişkin mesafe/depth verisi üretmektedir. Şekil 6, örnek ortam görüntüsünün yanında pixel-wise relative-depth haritasını göstermektedir. Yeni bir engel algılandığında geometrik bilgisi çevre modeline eklenmekte ve MPC kısıtları güncellenmektedir.
Ancak bu LiDAR sonuçları gerçek uçuşta kaydedilmiş sensör verileri değildir; simülasyon ortamının perception modelinin çıktılarıdır.
MPC'nin görevi nedir?
Model Predictive Control, her kontrol adımında sonlu bir prediction horizon üzerinden gelecekteki durumları tahmin eder ve en uygun kontrol dizisini yeniden hesaplar. Çalışmada sürekli sistem zero-order hold varsayımıyla ayrıklaştırılmış ve durum uzayı modeli:
\[ X_{k+1}=A_kX_k+B_ku_k \]
\[ Y_k=C_kX_k \]
biçiminde kurulmuştur.
Planar durumda durum vektörü konum ve hız bileşenlerini, kontrol vektörü ise x ve y yönlü kontrol girişlerini içermektedir.
Optimizasyon neyi aynı anda azaltmaya çalışıyor?
CPP, constrained Multi-Objective Optimization Problem olarak formüle edilmiştir. Kaynaktaki birleşik maliyet:
\[ J= \sum_{k=1}^{N} \left\{ \|p_k-p_{ref}\| + Q_u\|u_k\| + Q_d\|d(p_k,Z)\| \right\} \]
şeklindedir.
Üç ana bileşen şunlardır:
- mevcut konum ile hedef/reference nokta arasındaki mesafe,
- kontrol eforu,
- nominal zigzag kapsama hattından cross-track sapma.
Çalışmada path deviation ağırlığı \(Q_d=5\), control-effort ağırlığı \(Q_u=2\) olarak seçilmiştir. Böylece nominal kapsama yoluna bağlılık kontrol komutunun küçüklüğünden daha yüksek ağırlık almaktadır.
Engel güvenliği nasıl matematiksel kısıta dönüştürülüyor?
Statik poligonal engeller fiziksel araç boyutunu ve emniyet mesafesini içerecek biçimde Minkowski sum yaklaşımıyla genişletilmektedir. Genişletilmiş güvenlik bölgesi:
\[ O_i^{aug} = \left\{ P_i^{aug}\in\mathbb{R}^2 \mid dist(P_i^{aug},O_i)\leq\delta \right\} \]
olarak tanımlanmıştır.
Optimizasyon parametrelerinde statik engel safety margin değeri 50 m, dinamik engel yarıçapı 30 m ve minimum separation distance 8 m'dir.
Denklem tutarlılığı notu: Kaynağın Denklem (11)'indeki dinamik engel ceza ifadesiyle daha sonra birleşik optimizasyonu özetleyen Denklem (14)'teki dinamik engel ifadesi aynı matematiksel formda değildir. Verianla bu farkı sessizce tek bir denkleme dönüştürmemektedir.
Policy Gradient bölümü nasıl çalışıyor?
Araştırmada PG, yöntem metni boyunca Policy Gradient yaklaşımını ifade etmektedir. Sistem durumu, beş ayrı hareket komutunun olasılık dağılımına dönüştürülür:
- sola dön,
- düz git,
- sağa dön,
- hızlan,
- yavaşla.
Politika lineer bir fonksiyon yaklaşımıyla:
\[ h_u(X)=\eta(X)^T\vartheta_u \]
olarak tanımlanmakta ve SoftMax kullanılarak eylem olasılıkları:
\[ Q(u|X)= \frac{e^{h_u(X)}} {\sum_{u'}e^{h_{u'}(X)}} \]
şeklinde hesaplanmaktadır.
Critic neden eklenmiş?
Saf Policy Gradient güncellemelerinde reward/cost sinyalinin varyansı yüksek olabildiği için çalışmada lineer bir value-function approximator kullanılmıştır:
\[ V(X_k)=w^T\eta(X_k) \]
Temporal-Difference hata:
\[ \delta_k= J_k+\lambda V(X_{k+1})-V(X_k) \]
olarak hesaplanmaktadır.
Politika parametresi ise:
\[ \vartheta_u \leftarrow \vartheta_u+ \alpha\delta_k \eta(X_k) \left( I(u_k)-Q(u_k|X_k) \right) \]
kuralıyla güncellenmektedir.
Araştırmacılar bu öğrenme sürecinin önceden toplanmış bir veri setine veya experience replay'e ihtiyaç duymadan çevrimiçi olarak gerçekleştiğini belirtmektedir.
Augmented Dubins Path klasik Dubins'ten nasıl farklı?
Klasik Dubins problemi sabit minimum dönüş yarıçapına sahip ileri hareket eden bir aracın iki konfigürasyon arasındaki uygun eğri kombinasyonlarını kullanır. Çalışma sanal waypoint ekleyerek uygulanabilir yörünge ailesini klasik altı tipten on tipe çıkarmaktadır:
\[ D= \{ LSL,RSR,RSL,LSR,RLR,LRL, RLSLR,LRSRL,SLR,SRL \} \]
Yeni yollardan RLSLR ve LRSRL dört eğri + bir düz segment; SLR ve SRL ise iki eğri + bir düz segment içermektedir.
Şekil 7, bu sanal waypoint'lerin dönüşün daha geç başlatılmasını ve yön değişikliklerinin waypoint yakınındaki daha sınırlı bölgelerde gerçekleştirilmesini sağlayan geometrisini göstermektedir.
ADP neden daha kısa olmak zorunda değil?
Çalışmanın kendi sonuçları, ADP'nin temel amacının minimum mutlak mesafe olmadığını göstermektedir. Ek sanal waypoint'ler ve daha kinematik uyumlu geçişler küçük bir mesafe ve execution-time artışı oluşturabilir.
| Smoothing | Scenario 1 süre (s) | Scenario 2 süre (s) | Scenario 3 süre (s) | Scenario 1 mesafe (m) | Scenario 2 mesafe (m) | Scenario 3 mesafe (m) |
|---|---|---|---|---|---|---|
| DP | 27.223 | 27.447 | 27.990,30 | 272.233,4 | 274.474,5 | 279.903,1 |
| ADP | 27.294 | 27.532 | 28.127,72 | 272.937,3 | 275.325,7 | 281.277,21 |
Tablodaki sonuç, ADP'nin üç senaryoda da klasik DP'den biraz daha uzun mesafe ve süre üretmesine karşın yazarların değerlendirmesine göre daha düzgün ve kinematik olarak daha uygulanabilir lokal geçişler oluşturduğudur.
Öğrenme parametreleri nasıl seçildi?
Policy learning rate ve discount factor doğrudan tek bir değer olarak varsayılmamış; 100 simülasyon çalıştırmasına dayanan sensitivity analysis ile değerlendirilmiştir.
Learning rate için:
\[ 0.0001,\;0.0005,\;0.001,\;0.005,\;0.01 \]
değerleri; discount factor için:
\[ 0.90,\;0.93,\;0.96,\;0.99 \]
değerleri denenmiştir.
Şekil 9'daki korelasyon haritaları, düşük–orta öğrenme oranlarının ve 0,93–0,96 discount factor bölgesinin cost ile computation time arasında daha uygun bir denge verdiğini göstermektedir. Nihai modelde learning rate 0,001, discount factor 0,96 seçilmiştir.
Simülasyondaki ana optimizasyon parametreleri nelerdir?
| Parametre | Değer | Açıklama |
|---|---|---|
| Sampling time | 0,5 s | MPC kontrol güncelleme aralığı |
| Prediction horizon | 100 | MPC tahmin ufku |
| Policy learning rate | 0,001 | PG güncellemesi |
| Discount factor | 0,96 | Gelecek TD etkisinin ağırlığı |
| Minimum separation | 8 m | Engel / ajan emniyet ayrımı |
| Control input alt sınır | −2 m/s² | Minimum acceleration command |
| Control input üst sınır | 2 m/s² | Maksimum acceleration command |
| Statik engel sayısı | 4 | Poligonal engeller |
| Obstacle safety margin | 50 m | Statik engel buffer mesafesi |
| Dynamic obstacle radius | 30 m | Dinamik engel modeli |
| Waypoint acceptance threshold | 20 m | Sonraki segmente geçiş eşiği |
| Control effort weight | 2 | \(Q_u\) |
| Path deviation weight | 5 | \(Q_d\) |
PG-MPC gerçek zamanlı mı?
Scenario 2'de kendi gerçek zaman ölçütünü karşılıyor; Scenario 3'teki en kötü durum ise 0,5 saniyelik sınırı aşıyor. Araştırmacılar bir kontrol çevriminin gerçek zamanlı sayılabilmesi için perception, optimization ve control işlemlerinin toplamının sampling interval'i aşmaması gerektiğini belirtmektedir. Sampling interval 0,5 saniyedir.
Şekil 10'da Scenario 2 için maksimum computation time yaklaşık 0,36 saniyedir. Tablo 4 bu değeri 0,3621 saniye olarak vermektedir ve 0,5 saniyelik sınırın altındadır.
Ancak Scenario 3 için PG-MPC maksimum değeri 0,5404 saniyedir. Bu nedenle çalışmanın “real-time feasibility” sonucu en zor senaryoda bütün kontrol çevrimlerinin 0,5 saniyenin altında kaldığı anlamına gelmemelidir.
Klasik NLP-MPC ile PG-MPC arasındaki tam sonuçlar nedir?
| Metrik | NLP-MPC S1 | NLP-MPC S2 | NLP-MPC S3 | PG-MPC S1 | PG-MPC S2 | PG-MPC S3 |
|---|---|---|---|---|---|---|
| Ortalama computation time (s) | 0,095 | 0,1618 | 0,1898 | 0,128 | 0,2000 | 0,1891 |
| Maksimum computation time (s) | 0,2295 | 0,7180 | 0,9157 | 0,2549 | 0,3621 | 0,5404 |
| Optimization convergence rate (%) | 99,993 | 92,30 | 91,919 | 99,993 | 96,87 | 94,34 |
| Constraint violation occurrence (%) | 0 | 5,67 | 3,2938 | 0 | 4,22 | 3,2864 |
Tablo, önerilen yöntemin avantajının özellikle karmaşık senaryolarda tepe işlem yükünü sınırlamak ve yakınsama oranını yükseltmek olduğunu göstermektedir. Buna karşılık PG-MPC, Scenario 1 ve 2'de ortalama hesaplama süresi bakımından klasik NLP-MPC'den daha hızlı değildir.
Constraint violation Scenario 2'de %5,67'den %4,22'ye düşerken Scenario 3'te %3,2938'den %3,2864'e yalnız çok küçük bir değişim göstermektedir. Kaynak bu sonuçları improved constraint satisfaction olarak yorumlamaktadır; ancak ayrıca bir istatistiksel anlamlılık testi raporlanmamıştır.
Çalışmanın desteklediği sonuçlar
- Back-and-forth CPP, MPC, çevrimiçi Policy Gradient güncellemesi ve augmented Dubins smoothing aynı simülasyon çerçevesinde birlikte uygulanabilmiştir.
- Önerilen yapı, statik ve dinamik engellerin bulunduğu simülasyonlarda nominal kapsama yolundan yerel olarak ayrılıp yeniden rotaya dönebilmektedir.
- PG-MPC Scenario 2 ve Scenario 3'te klasik NLP-MPC'ye göre maksimum hesaplama süresini azaltmıştır.
- Scenario 2'de convergence rate %92,30'dan %96,87'ye yükselmiştir.
- Scenario 3'te convergence rate %91,919'dan %94,34'e yükselmiştir.
- Scenario 2'de constraint violation occurrence %5,67'den %4,22'ye düşmüştür.
- Augmented Dubins yaklaşımı simülasyon görsellerinde klasik Dubins'e göre daha düzgün ve kinematik olarak daha uygulanabilir lokal geçişler üretmektedir.
- Scenario 2'de PG-MPC'nin maksimum işlem süresi 0,3621 s ile 0,5 s örnekleme periyodunun altında kalmıştır.
Çalışmanın desteklemediği veya test etmediği sonuçlar
- Yöntem gerçek bir sabit kanatlı İHA üzerinde uçuş testiyle doğrulanmamıştır.
- Gerçek LiDAR gürültüsü, sensör gecikmesi veya paket kaybı altında performans ölçülmemiştir.
- Gerçek rüzgâr ve atmosferik disturbance altında fiziksel uçuş başarısı gösterilmemiştir.
- Gerçek aktüatör doygunluğu ve aerodinamik model belirsizliği donanım üzerinde test edilmemiştir.
- Birleşik PG-MPC sisteminin kapalı çevrim kararlılığı için rigoröz teorik kanıt verilmemiştir.
- Scenario 3'te bütün kontrol çevrimlerinin 0,5 saniyelik gerçek zamanlı sınırın altında kaldığı gösterilmemiştir; maksimum süre 0,5404 s'dir.
- ADP'nin klasik Dubins yolundan daha kısa rota ürettiği gösterilmemiştir; üç senaryoda da kümülatif mesafe biraz daha yüksektir.
- PG-MPC'nin klasik NLP-MPC'den her durumda daha düşük ortalama computation time sağladığı gösterilmemiştir.
- Simülasyon sonuçlarının gerçek afet, tarım veya çevresel izleme görevlerine aynı performans rakamlarıyla genellenebileceği kanıtlanmamıştır.
- Çalışma tam altı serbestlik dereceli aerodinamik fixed-wing model kullanmamaktadır; kontrol problemi sabit irtifalı planar modele indirgenmiştir.
Çalışmanın Yöntemi ve Bulguları
Yazılım ve hesaplama ortamı
Çerçeve MATLAB R2024b ortamında uygulanmıştır. Simülasyonların çalıştırıldığı bilgisayar:
- 4,7 GHz Intel Core i7 işlemci,
- 16 GB RAM,
- NVIDIA RTX 3070 GPU
içermektedir. Kaynak bilgisayarın GPU içerdiğini belirtmektedir; fakat bütün optimizasyon hesaplarının GPU üzerinde hızlandırıldığını ayrıca göstermemektedir.
Çevrimdışı planlama algoritması
Algorithm 1, konveks poligonun her kenarıyla bütün köşeleri arasındaki uzaklığı hesaplar. Her kenar için en uzak vertex seçilir ve bu maksimum uzaklıklar arasından en küçük olan direction sweep orientation olarak kullanılır.
Kamera footprint genişliği ve görüntü overlap gereksinimi kullanılarak paralel sweep çizgileri bölgeye yerleştirilir. Nominal rota herhangi bir bilinmeyen engel içermeden tam kapsama sağlamayı hedefler.
Çevrimiçi PG-MPC döngüsü
Online sistem her kontrol adımında temel olarak şu işlemleri gerçekleştirir:
- Mevcut durum \(X_k\) alınır.
- Algılanmış statik ve hareketli engeller çevre modeline eklenir.
- Politika özellikleri hesaplanır.
- SoftMax üzerinden kontrol action olasılıkları oluşturulur.
- Kontrol girdisi belirlenir.
- Yeni durum tahmin edilir.
- Anlık maliyet hesaplanır.
- TD error bulunur.
- Critic parametresi güncellenir.
- Policy parametreleri güncellenir.
- Yerel yol Augmented Dubins geometrisiyle yumuşatılır.
Çalışma bu çevrimi çevrimiçi learning olarak tanımlamakta ve önceden tamamen eğitilmiş bir politika gerektirmediğini belirtmektedir.
Çok iş parçacıklı yapı
PG-MPC uygulaması optimization, perception ve navigation modüllerinin eşzamanlı çalışmasını destekleyen multi-threaded architecture olarak modellenmiştir. Amaç gerçek uçuş bilgisayarındaki asenkron görev yapısını yaklaşık olarak temsil etmektir.
Ancak bu mimari fiziksel avionics bilgisayarında çalıştırılmış bir Hardware-in-the-Loop veya flight-test benchmark'ı değildir.
Scenario 1 ne gösteriyor?
Engelsiz temel senaryo, framework'ün nominal kapsama desenini takip etmesini test etmektedir. Klasik ve önerilen optimizer'ın her ikisinde de convergence rate %99,993 ve constraint violation %0'dır.
Bu en kolay durumda PG-MPC'nin maksimum hesaplama süresi 0,2549 s, NLP-MPC'nin 0,2295 s değerinden biraz daha yüksektir. Dolayısıyla önerilen PG güncellemesinin kolay ortamda doğrudan bir hız avantajı bulunmamaktadır.
Scenario 2 ne gösteriyor?
Statik ve hareketli engeller eklendiğinde classical NLP-MPC'nin maksimum computation time değeri 0,718 s'ye yükselirken PG-MPC 0,3621 s'de kalmaktadır.
Convergence rate aynı senaryoda %92,30'dan %96,87'ye, constraint violation değeri %5,67'den %4,22'ye değişmektedir.
Bu senaryo, çalışmanın “peak computation burden” bakımından en açık avantajlarından birini göstermektedir.
Scenario 3 ne gösteriyor?
Çok sayıda dinamik engelin bulunduğu üçüncü senaryo en zor koşuldur. Klasik NLP-MPC'nin maksimum hesaplama süresi 0,9157 s, PG-MPC'ninki 0,5404 s'dir.
Kaynak bu değişimi yaklaşık %41,1 azalma olarak raporlamaktadır. PG-MPC büyük bir tepe-süre avantajı sağlasa da 0,5404 s değeri 0,5 s sampling interval'in üzerindedir. Bu nedenle çalışma içinde tanımlanan katı gerçek zaman ölçütü açısından tekil worst-case aşımı vardır.
Yakınsama oranı %91,919'dan %94,34'e yükselmiş; constraint violation occurrence ise %3,2938'den %3,2864'e çok sınırlı miktarda azalmıştır.
Şekil 10'un temel mesajı nedir?
Şekil 10, çevredeki belirli engel bölgelerinin yakınında hesaplama süresinin ve objective cost'un yükseldiğini göstermektedir. Bu noktalar controller'ın doğrudan nominal yolu takip etmek yerine collision avoidance ve feasibility koşullarına öncelik verdiği bölgelerdir.
Hesaplama yükünün çevrenin tamamında sabit olmaması, yöntemin worst-case süresinin ortalama süreden neden daha önemli olduğunu da göstermektedir. Gerçek zamanlı bir flight-control uygulamasında kontrol çevriminin deadline'ını belirleyen metrik çoğu zaman ortalama değil tepe hesaplama süresidir.
Şekil 11 ne gösteriyor?
Şekil 11, üç senaryoda MPC-ADP ve MPC-DP yollarını yan yana karşılaştırmaktadır. Engelsiz durumda iki yapı nominal sweep pattern'e yakın ilerler. Statik ve dinamik engeller eklendiğinde lokal sapmalar oluşur.
Yakınlaştırılmış bölgelerde ADP dönüşlerinin klasik DP'ye göre daha kademeli görünmesi, yazarların “smoother and dynamically feasible” yorumunun görsel dayanağıdır.
Buna karşılık aynı çalışmanın Tablo 4'ü ADP'nin toplam mesafesini üç senaryonun tamamında biraz artırdığını göstermektedir. Şekildeki düzgünlük ile toplam yol uzunluğu aynı performans ölçütü değildir.
Yöntemin temel trade-off'u nedir?
Çalışmanın verileri tek bir “her açıdan daha iyi” algoritma sonucu vermemektedir. Önerilen yöntem özellikle karmaşık engel ortamlarında peak optimisation time ve convergence açısından avantaj göstermektedir; ancak online policy update ortalama hesaplama yükünü bazı senaryolarda artırır.
Benzer biçimde Augmented Dubins rota geometrisi daha düzgün ve kinematik olarak uygulanabilir geçişler sağlarken az miktarda ek mesafe ve execution time doğurmaktadır.
Dolayısıyla çerçevenin temel mühendislik ödünleşimi, salt minimum hesaplama zamanı veya minimum mesafe yerine kapsama sürekliliği + kinematik uygulanabilirlik + dinamik engel adaptasyonu kombinasyonuna öncelik vermesidir.
Çalışmanın güçlü yönleri
- Kapsama planlaması ve çevrimiçi kontrolü tek optimizasyon yapısında birleştirmektedir.
- Sabit kanatlı aracın minimum dönüş davranışını Dubins geometrisiyle açıkça hesaba katmaktadır.
- Bilinmeyen statik ve dinamik engelleri aynı çerçevede ele almaktadır.
- Policy Gradient'i MPC güncellemesine doğrudan entegre etmektedir.
- Öğrenme oranı ve discount factor için sensitivity analysis gerçekleştirmektedir.
- Klasik NLP-MPC ile aynı koşullarda nicel karşılaştırma sunmaktadır.
- Average ve maximum computation time değerlerini ayrı raporlamaktadır.
- Convergence ve constraint violation metriklerini birlikte vermektedir.
- DP ve ADP smoothing maliyetlerini ayrıca karşılaştırmaktadır.
Çalışmanın temel sınırlılıkları
- Bütün doğrulama simülasyondur.
- Fiziksel fixed-wing UAV uçuş testi yoktur.
- Gerçek sensör noise ve communication delay test edilmemiştir.
- Rüzgâr ve gerçek atmosferik disturbance gelecekteki çalışmaya bırakılmıştır.
- Aktüatör belirsizlikleri ve gerçek flight-computer deadline davranışı test edilmemiştir.
- Model sabit irtifalı, düşük doğruluklu planar dynamics yaklaşımı kullanmaktadır.
- Kapalı çevrim PG-MPC kararlılığının rigoröz teorik analizi yapılmamıştır.
- Scenario 3 worst-case süresi 0,5 s kontrol periyodunun üzerindedir.
- ADP küçük de olsa ek yol uzunluğu ve execution time üretmektedir.
- Çalışmanın başlığındaki “Partial Gradient” ile yöntem içindeki “Policy Gradient” terminolojisi uyuşmamaktadır.
Gelecek çalışmalar hangi sorunları ele almalı?
Yazarlar yöntemin gerçek sabit kanatlı platformlarda uygulanmasını önemli gelecek adım olarak belirtmektedir. Bu doğrulamanın rüzgâr bozucuları, sensör gürültüsü, communication delays ve actuator uncertainties içermesi önerilmektedir.
Araştırma ayrıca birleşik PG-MPC yapısının rigorous closed-loop stability analysis'inin yapılmadığını açıkça kabul etmekte ve bunun teorik olarak incelenmesini gelecek çalışma yönü olarak tanımlamaktadır.
Ek olarak Sliding Mode Control gibi robust nonlinear control yaklaşımlarının disturbance rejection ve model uncertainty dayanıklılığını artırmak için çerçeveye entegre edilmesi önerilmektedir.
Kaynak ve Yöntem Notu
Tam özgün çalışma adı: Real-Time Coverage Path Planning for Fixed-Wing Aerial Robots Using Partial Gradient-Based MPC and Augmented Dubins Trajectories
Yazarlar: Mohammad Khaneghaei; Benyamin Ebrahimi; Davood Asadi; Onder Tutsoy; Seyed-Yaser Nabavi-Chashmi; Hassan Haghighi.
Yazar sırası: Kaynaktaki özgün sıra aynen korunmuştur.
Eş katkı/eş birinci yazar: Kaynakta belirtilmemiştir.
Sorumlu yazar: Davood Asadi.
Kurumlar: Department of Electrical Engineering, Adana Alparslan Turkeş Science and Technology University, Adana, Türkiye; Department of Aerospace Engineering, Adana Alparslan Turkeş Science and Technology University, Adana, Türkiye; College of Arts, Technology and Environment, University of the West England, Bristol, UK; Department of Aeronautical Engineering, Gebze Technical University, Gebze, Türkiye; Laboratoire d’Informatique et Systèmes, Aix-Marseille University, Marseille, France.
Afiliyasyon notu: Kaynağın üçüncü afiliyasyonu “University of the West England” biçiminde verilmiştir. Verianla bibliyografik kaydı kaynakta bulunduğu biçimiyle korumuş ve kurum adını sessizce yeniden yazmamıştır.
Başlık terminolojisi notu: Özgün başlık “Partial Gradient-Based MPC” ifadesini kullanmaktadır. Makale gövdesindeki PG yöntemi ise “Policy Gradient” olarak tanımlanmış ve denklemler bu yaklaşıma göre kurulmuştur. Verianla özgün başlığı değiştirmemiştir.
Kaynak türü: Hakemli araştırma makalesi; algoritma geliştirme ve simülasyon tabanlı karşılaştırmalı doğrulama çalışmasıdır.
Dergi: Aerospace
Yayınevi: MDPI
Cilt / sayı / makale numarası: 13(8), 713
Yayın tarihi: 9 Ağustos 2026
DOI: 10.3390/aerospace13080713
Resmî yayın bağlantısı: https://www.mdpi.com/2226-4310/13/8/713
DOI bağlantısı: https://doi.org/10.3390/aerospace13080713
Hakemlik durumu: Çalışma hakemli Aerospace dergisinde yayımlanmış araştırma makalesidir.
Lisans: Creative Commons Attribution (CC BY) açık erişim lisansı.
Finansman: Çalışma Türkiye Bilimsel ve Teknolojik Araştırma Kurumu (TÜBİTAK) tarafından 125M675 ve 223M312 numaralı destekler kapsamında finanse edilmiştir.
Veri erişilebilirliği: Verilerin talep üzerine sağlanacağı belirtilmiştir.
Çıkar çatışması: Yazarlar bilinen rekabet eden finansal çıkar veya çalışmayı etkileyebilecek kişisel ilişki bildirmemiştir.
Yazar katkıları: Mohammad Khaneghaei; gözden geçirme ve düzenleme, ilk taslak, görselleştirme, doğrulama, metodoloji, kaynaklar, araştırma, biçimsel analiz, veri kürasyonu ve kavramsallaştırma. Benyamin Ebrahimi; gözden geçirme ve düzenleme, ilk taslak, görselleştirme, doğrulama, metodoloji, araştırma, biçimsel analiz, veri kürasyonu ve kavramsallaştırma. Davood Asadi; gözden geçirme ve düzenleme, ilk taslak, denetim, araştırma, biçimsel analiz, veri kürasyonu ve kavramsallaştırma. Onder Tutsoy; gözden geçirme ve düzenleme, ilk taslak, doğrulama, metodoloji, kaynaklar ve denetim. Seyed-Yaser Nabavi-Chashmi; gözden geçirme ve düzenleme, doğrulama ve denetim. Hassan Haghighi; gözden geçirme ve düzenleme ve doğrulama.
Simülasyon düzeyi: Bütün karşılaştırmalar MATLAB R2024b'de yürütülmüş simülasyonlara dayanmaktadır. Çalışma gerçek sabit kanatlı İHA uçuş deneyi, hardware-in-the-loop testi veya saha demonstrasyonu içermemektedir.
Gerçek zamanlılık sınırı: Kaynak gerçek zaman kriterini computation/control süresinin 0,5 s sampling interval'i aşmaması olarak tanımlamaktadır. PG-MPC Scenario 2'de 0,3621 s maksimum değerle bunu karşılamakta; Scenario 3'te 0,5404 s maksimum değerle sınırın üzerinde kalmaktadır. Bu nedenle Verianla “bütün senaryolarda her kontrol adımı kesin biçimde gerçek zamanlıdır” ifadesini kullanmamaktadır.
Denklem tutarlılığı notu: Kaynağın dinamik obstacle penalty terimi Denklem (11) ile birleşik problem ifadesi Denklem (14)'te aynı matematiksel biçimde sunulmamaktadır. Verianla bu farklılığı varsayımla düzeltmemiştir.
ADP yorum sınırı: Augmented Dubins Path'in avantajı daha düzgün ve kinematik olarak uygulanabilir transition üretmesidir. Kaynağın Tablo 4 değerleri ADP'nin üç senaryoda da klasik DP'den biraz daha yüksek kümülatif mesafe ve execution time ürettiğini göstermektedir.
Kararlılık sınırı: Yazarlar birleşik PG-MPC sisteminin closed-loop stability'si için rigoröz teorik analiz sunmadıklarını ve bunu gelecek çalışma olarak bıraktıklarını açıkça belirtmektedir.
Bilimsel sınır: Model sonuçları sentetik statik/dinamik engeller, idealize perception modeli ve sabit irtifalı planar fixed-wing dinamikleri altında elde edilmiştir. Gerçek rüzgâr, sensor noise, communication delay, actuator uncertainty ve fiziksel uçuş sistemi etkileri deneysel olarak değerlendirilmemiştir.
İçerik üretim yöntemi: Bu Verianla açıklamasındaki bilimsel yöntem, denklemler, simülasyon parametreleri, performans metrikleri, şekil yorumları ve sınırlılıklar yüklenen kaynak çalışmaya dayanmaktadır. Dış doğrulama yalnız bibliyografik kimlik, resmî yayın kaydı ve hakemlik bilgisinin kontrolü için kullanılmış; dış kaynaklardan yeni bilimsel performans sonucu veya kaynakta bulunmayan algoritmik sonuç ana metne eklenmemiştir.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir