


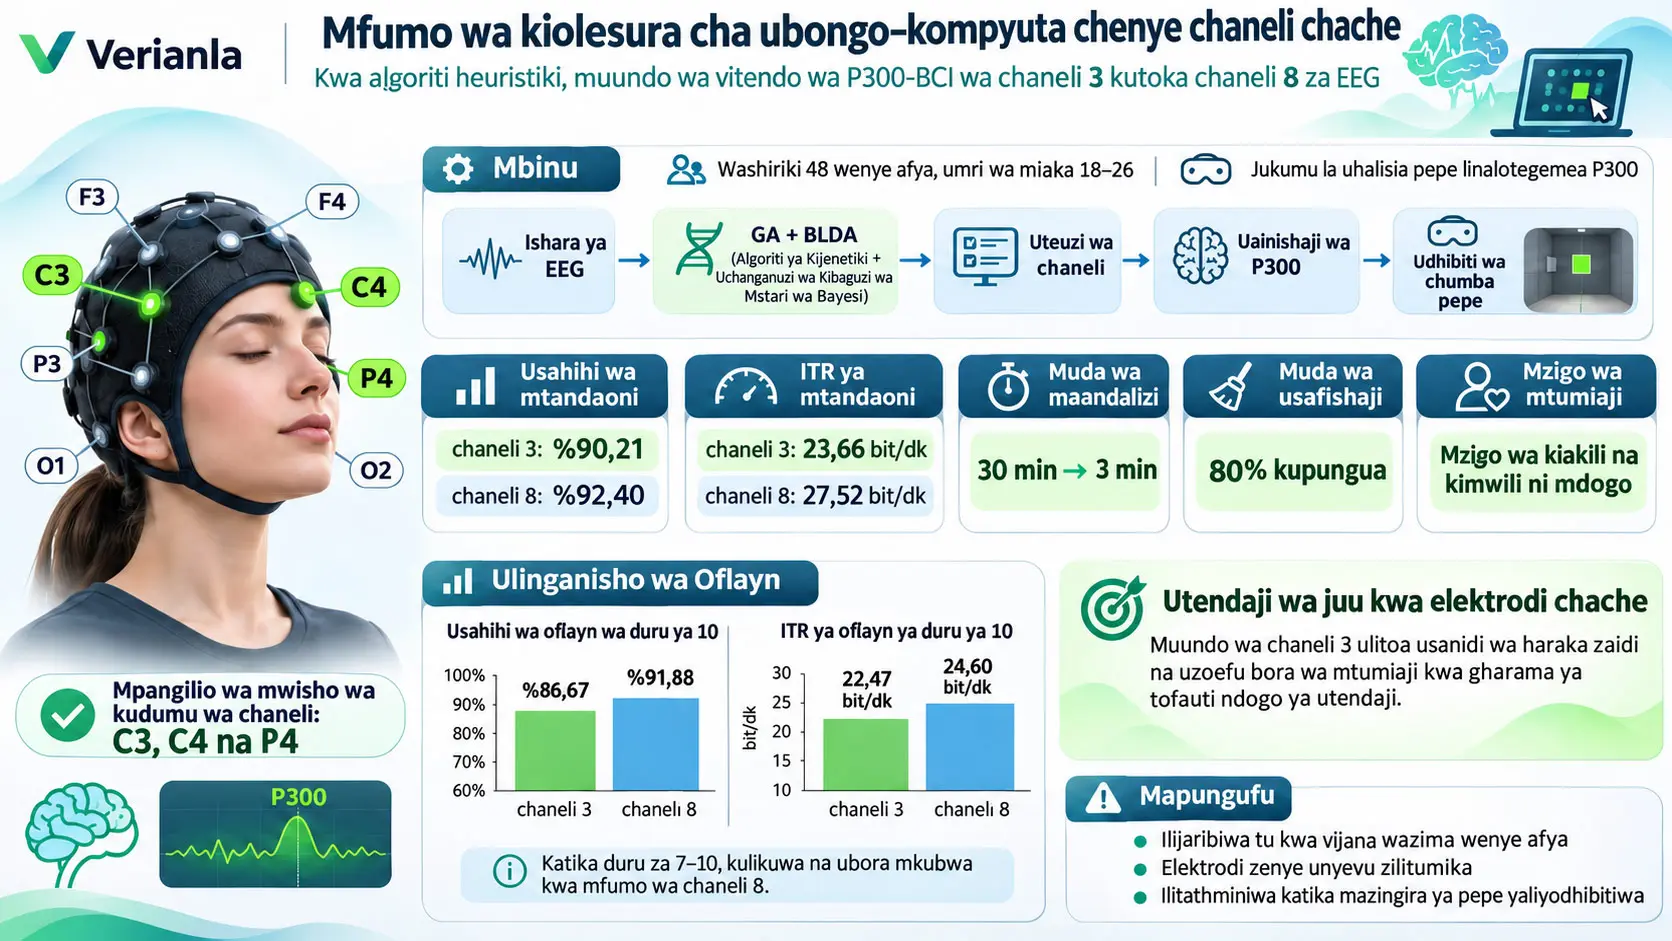
Kiolesura cha ubongo–kompyuta kinachotegemea P300 (Brain–Computer Interface, BCI) ni mbinu ya mwingiliano wa binadamu–mashine inayolenga kutuma amri kwa mfumo wa kompyuta kwa kuainisha majibu ya EEG yanayohusiana na tukio ambayo mtumiaji hutoa kwa malengo ya kuona. Utafiti huu ulichunguza ni kwa kiwango gani mfumo wa kawaida wa P300-BCI wenye chaneli nane unaweza kuhifadhi utendaji wa uainishaji na uzoefu wa mtumiaji huku ukipunguza idadi ya elektrodi. Watafiti walitumia Genetic Algorithm (GA) pamoja na mbinu ya Bayesian Linear Discriminant Analysis (BLDA), wakachagua mpangilio thabiti wa chaneli tatu kutoka chaneli F3, F4, C3, C4, P3, P4, O1 na O2, na kuamua mchanganyiko wa mwisho utakaotumiwa kwa washiriki wote 48 kuwa C3, C4 na P4.
Utafiti ulihusisha wajitolea 48 wenye afya wenye umri wa 18-26; washiriki 12 walikuwa wanawake na washiriki 36 walikuwa wanaume. Iliripotiwa kuwa washiriki walikuwa na uoni wa kawaida au uliorekebishwa kuwa wa kawaida, hawakuwa na historia ya ugonjwa wa neva au wa akili, na hawakuwa wamewahi kushiriki katika majaribio ya EEG hapo awali. Data za EEG zilirekodiwa kwa elektrodi nane zenye unyevunyevu kwa kiwango cha usampulishaji cha 250 Hz; impidansi ya mgusano ilipunguzwa hadi chini ya 10 kΩ katika chaneli zote.
Katika uteuzi wa chaneli wa GA-BLDA, data za kila mshiriki zilichakatwa kwanza kando. Kila mchanganyiko wa chaneli uliokuwa mgombea ndani ya GA uliwakilishwa na vekta bainari ya biti nane, usahihi wa uthibitishaji mtambuka wa sehemu 10 wa kiainishaji cha BLDA kilichofunzwa kwa chaneli zilizochaguliwa ukahesabiwa, na matumizi ya chaneli nyingi kupita kiasi yakaadhibiwa katika fitness function. Kisha michanganyiko bora iliyopatikana kwa watu 48 iliunganishwa, marudio ya kuchaguliwa kwa chaneli yakahesabiwa, na chaneli tatu zilizotokea mara nyingi zaidi, C3, C4 na P4, zikawekwa kuwa thabiti.
Mpangilio wa chaneli tatu ulifikia usahihi wa wastani wa %86,67 katika raundi ya mwisho, yaani raundi ya 10. ya uchochezi ya jaribio la offline, ilhali mfumo wa chaneli nane ulitoa usahihi wa %91,88. Katika hatua hii tofauti ilikuwa takriban pointi 5,2 za asilimia, na katika raundi za 7-10. iliripotiwa tofauti yenye umuhimu wa kitakwimu kwa upande wa chaneli nane. Katika raundi hiyo hiyo ya 10., kiwango cha uhamishaji taarifa kilikuwa 22,47 bit/dk kwa chaneli tatu na 24,60 bit/dk kwa chaneli nane.
Katika uthibitishaji wa online, usahihi wa wastani wa mfumo wa chaneli tatu ulipatikana kuwa %90,21 ± 5,36, na usahihi wa wastani wa mfumo wa chaneli nane kuwa %92,40 ± 5,55. Chanzo kinaripoti kuwa tofauti ya usahihi wa online haikufikia umuhimu wa kitakwimu. Kiwango cha wastani cha uhamishaji taarifa wa online kilikuwa 23,66 ± 4,02 bit/dk kwa chaneli tatu na 27,52 ± 3,76 bit/dk kwa chaneli nane.
Kupunguza idadi ya elektrodi kutoka nane hadi tatu hakukupunguza tu utata wa kimwili wa mfumo wa uainishaji, bali pia kulipunguza muda wa maandalizi ya mtumiaji kutoka dakika 30 hadi dakika 3. Chanzo kinaripoti mabadiliko haya kama upungufu wa %90 wa muda wa maandalizi. Muda wa kusafisha baada ya jaribio pia ulipungua kwa %80. Katika tathmini ya NASA-TLX, mpangilio wa chaneli tatu ulionyesha alama za chini katika vipimo vya mental demand, physical demand na kipimo kinachoitwa “performance” katika chanzo.
Matokeo haya hayamaanishi kwamba elektrodi tatu hubeba taarifa sawa kabisa na elektrodi nane katika kila hali. Katika raundi za offline 7-10., mfumo wa chaneli nane ulionyesha faida ya utendaji yenye umuhimu wa kitakwimu. Aidha, utafiti ulifanywa tu kwa watu wazima vijana wenye afya, katika mazingira yanayodhibitiwa ya uhalisia pepe, na kwa elektrodi zenye unyevunyevu. Utafiti huu haujaonyesha kuwa utendaji huohuo utadumishwa kwa wagonjwa wa kliniki, kwa watu wazee, kwa elektrodi kavu, au katika hali halisi za maisha zenye mwendo mkubwa na kelele za mazingira.
Kiolesura cha ubongo–kompyuta ni nini?
Kiolesura cha ubongo–kompyuta ni mfumo wa mawasiliano wa binadamu–mashine unaobadilisha ishara zinazopimwa kutoka katika shughuli za ubongo kuwa amri ambazo kompyuta au kifaa cha nje kinaweza kuelewa. Katika utafiti huu, ishara ya ubongo inapimwa kupitia ngozi ya kichwa kwa elektroensefalografia (Electroencephalography, EEG). Badala ya kubonyeza kitufe kwa mwendo wa misuli, mtumiaji huangazia lengo maalumu la kuona katika mazingira pepe, na mfumo hukadiria kutoka kwenye jibu la EEG ni lengo lipi lililochaguliwa.
P300 inaashiria nini?
P300 ni mojawapo ya vipengele vya majibu ya umeme yanayohusiana na tukio ambavyo vinaweza kutokea katika EEG wakati umakini unaelekezwa kwenye lengo au kichocheo adimu. Jina lake linatokana na kipengele cha potenshali chanya kinachoonekana kwa kawaida katika kipimo cha muda wa mamia ya milisekunde baada ya kichocheo. Badala ya kutumia nukta moja finyu ya muda, utafiti huu ulichakata taarifa ya EEG katika kipindi cha 0-600 ms baada ya kuanza kwa kichocheo kwa madhumuni ya uainishaji.
Mantiki ya msingi ya BCI inayotegemea P300 ni hii: chaguo nyingi kwenye skrini humulika kwa zamu; mtumiaji huangazia tu chaguo lengwa; vichocheo lengwa na visivyo lengwa havitoi jibu sawa la kitakwimu kwenye EEG. Kiainishaji hujifunza tofauti hii na kukadiria chaguo ambalo mtumiaji anajaribu kuchagua.
Kwa nini chaneli chache za EEG zinahitajika?
Mfumo wa EEG wa chaneli nyingi unaweza kukusanya taarifa pana zaidi ya anga; hata hivyo, kila elektrodi mpya huongeza kazi za kuandaa kofia, kutumia jeli ya kuendesha umeme, kukagua impidansi, kuweka nyaya na kusafisha baada ya jaribio. Kwa hiyo, kupunguza idadi ya chaneli kunaweza kupunguza si tu mzigo wa ukokotoaji bali pia mchakato wa maandalizi ya kimwili unaowekwa kwa mtumiaji halisi.
Kwa upande mwingine, hatari muhimu hutokea: kadiri idadi ya chaneli inavyopungua, sehemu ndogo zaidi ya ngozi ya kichwa husampuliwa na uwezekano wa kupoteza baadhi ya taarifa za ishara huongezeka. Kwa hiyo, swali kuu si “kutumia idadi ndogo kabisa ya elektrodi inayowezekana”. Tatizo la kisayansi ni kubaini ni kwa kiwango gani idadi ya elektrodi inaweza kupunguzwa huku upotevu wa utendaji ukiwekwa katika kiwango kinachokubalika.
Elektrodi za EEG ziliwekwa wapi?
Mfumo wa awali ulitumia chaneli nane kulingana na kiwango cha kimataifa cha uwekaji elektrodi cha 10-20:
| Chaneli | Ilitumika mwanzoni? | Ipo ndani ya chaneli tatu thabiti za mwisho? |
|---|---|---|
| F3 | Ndiyo | Hapana |
| F4 | Ndiyo | Hapana |
| C3 | Ndiyo | Ndiyo |
| C4 | Ndiyo | Ndiyo |
| P3 | Ndiyo | Hapana |
| P4 | Ndiyo | Ndiyo |
| O1 | Ndiyo | Hapana |
| O2 | Ndiyo | Hapana |
C3 na C4 ni lebo za eneo la kati, ilhali P4 ni lebo ya eneo la parietali. Algoriti ya uteuzi wa chaneli ya utafiti ilitoa chaneli hizi tatu kutoka katika upangaji wa pamoja wa marudio ya matokeo ya uteuzi wa offline ya washiriki wote 48.
Ishara ya EEG ilirekodiwaje?
Katika utafiti, kofia ya EEG inayovaliwa iliyotengenezwa na South China Brain Control Technology Co., Ltd. ilitumika. Mfumo uliunganishwa na kompyuta kupitia Bluetooth 4.2 na chaneli nane zikarekodiwa kwa wakati halisi.
Kiwango cha usampulishaji:
\[ f_s=250\ \mathrm{Hz} \]
kwa hiyo mfumo hurekodi sampuli 250 kwa sekunde kwa kila chaneli. Pasta ya kuendesha umeme iliwekwa kwenye eneo la mgusano la elektrodi zenye unyevunyevu na impidansi ya mgusano ikaandaliwa kuwa:
\[ Z<10\ \mathrm{k\Omega} \]
Impidansi ya elektrodi–ngozi iliyo chini na inayodhibitiwa ni muhimu kwa kurekodi kwa uthabiti zaidi ishara za biopotenshali za kiwango cha mikrovolti kama EEG.
Sehemu ya EEG ilichakatwaje awali?
Kwa kila flash moja ya kuona, mwanzo wa kichocheo ulikubaliwa kuwa \(t=0\), na:
\[ [-200,\ 600]\ \mathrm{ms} \]
sehemu ya EEG katika kipindi hicho ikatolewa.
Mlolongo wa uchakataji wa awali ni kama ifuatavyo:
- Amplitudo ya wastani ya sehemu ya kabla ya kichocheo kati ya −200 na 0 ms huhesabiwa.
- Wastani huu hutolewa kutoka katika sehemu nzima ya −200 hadi 600 ms ili kufanya baseline correction.
- Bendi ya 0,1-25 Hz huhifadhiwa kwa kichujio cha IIR band-pass cha daraja la nne.
- Kichujio cha notch hutumika kupunguza mwingiliano wa gridi ya umeme ya 50 Hz.
- Ishara iliyochujwa hufanyiwa downsample mara 5.
Kufanya downsample mara 5 kwa kiwango cha awali cha usampulishaji cha 250 Hz hupunguza msongamano wa usampulishaji wenye ufanisi wa mfululizo wa data uliochakatwa hadi moja ya tano. Chanzo kilifanya hivi hasa ili kupunguza ukubwa wa data na mzigo wa ukokotoaji unaofuata.
Kwa nini baseline correction hufanywa?
Kiwango kamili cha volti cha sehemu ya EEG kinaweza kuwa na mabadiliko ya polepole yasiyotegemea jibu la P300 au tofauti za msingi kati ya sehemu. Baseline correction huchukua wastani wa kipindi cha −200-0 ms kabla ya kichocheo kama rejea na kukiweka upya katikati kipande chote kulingana na rejea hiyo.
Kwa namna ya kufundisha, operesheni inaweza kufikiriwa kama:
\[ x_{\mathrm{corr}}(t) = x(t) - \overline{x}_{[-200,0]} \]
Uwakilishi huu wa kihisabati si mlinganyo tofauti wenye nambari katika chanzo; ni uwakilishi wa maelezo wa operesheni ya kutoa baseline ambayo chanzo kimeeleza kwa maandishi.
Vipengele vilitolewaje?
Baada ya uchujaji na downsampling, sehemu ya 0-600 ms baada ya kichocheo ilitumika kama dirisha la uchambuzi. Chanzo kinasema kuwa kipindi hiki kina sampuli 150 katika usampulishaji wa awali wa 250 Hz na sampuli 30 baada ya downsampling mara 5.
Dirisha la 0-600 ms liligawanywa katika madirisha madogo manne yaliyo sawa:
0-150 ms, 150-300 ms, 300-450 ms na 450-600 ms.
Vipengele viwili vya kikoa cha muda vilihesabiwa katika kila dirisha dogo:
- amplitudo ya wastani ya EEG,
- variansi ya amplitudo ya EEG.
Vipengele hivi vya chaneli zote zilizochaguliwa viliunganishwa ili kuunda vekta ya vipengele ya raundi moja ya uchochezi.
Kisha vekta za vipengele za raundi 10 za uchochezi zilizofanywa kwa lengo lilelile ziliwekwa pamoja na kukokotolewa wastani. Lengo lilikuwa kupunguza kelele ya asili ya mandharinyuma ya EEG na kuimarisha taarifa ya P300 inayoweza kujirudia inayohusiana na lengo.
Mbinu hii ya averaging ina gharama ya asili: raundi nyingi zaidi za uchochezi zinaweza kuongeza usahihi wa uainishaji, huku zikiongeza muda unaohitajika kutoa amri. Hii pia ndiyo sababu kuu ya kihisabati ya ITR kupungua kadiri idadi ya raundi inavyoongezeka wakati Accuracy inaongezeka katika utafiti.
Uthibitishaji mtambuka wa sehemu 10 hufanya nini?
10-fold cross-validation ni mpangilio wa tathmini unaogawa mkusanyiko wa data katika sehemu kumi na kujaribu kuzuia modeli kuzoea data ileile kwa kuikariri tu. Chanzo kilifanya mgawanyo wa data katika kiwango cha trial na katika kila iteresheni kilitumia takriban %90 ya data kwa mafunzo na %10 kwa majaribio.
Kila moja ya sehemu kumi huwa sehemu ya majaribio kwa zamu. Kwa njia hii, utendaji hautegemei mgawanyo mmoja wa nasibu wa mafunzo-majaribio.
Usahihi wa fitness katika uteuzi wa chaneli pia unategemea utendaji huu wa uthibitishaji mtambuka wa sehemu 10 wa BLDA.
Uteuzi wa Chaneli wa GA-BLDA Hufanyaje Kazi?
Katika mfumo wa GA-BLDA, Genetic Algorithm ni utaratibu wa uteuzi unaotafuta kwa kiwango cha jumla seti ndogo zinazowezekana kutoka chaneli nane za EEG, ilhali BLDA ni kiainishaji cha fitness kinachotathmini usahihi wa uainishaji wa kila seti ya chaneli mgombea; seti ndogo bora ambazo GA hupata kwa kila mtu baadaye hupangwa kwa marudio kwa washiriki 48 na kubadilishwa kuwa mpangilio thabiti wa C3-C4-P4.
Mchanganyiko wa chaneli huwekewaje msimbo katika algoriti ya kijeni?
Kila suluhisho mgombea ni vekta bainari yenye vipengele nane:
\[ \mathbf{x}_i= [x_{i1},x_{i2},\ldots,x_{i8}] \]
Hapa:
\[ x_{ij}= \begin{cases} 1,& j.\ kanal\ seçilmişse\\ 0,& j.\ kanal\ seçilmemişse \end{cases} \]
Kwa mfano, mtu mmoja anaweza kuwa na 1 katika nafasi tatu tu zinazowakilisha C3, C4 na P4. Chanzo huzalisha populesheni ya kwanza kwa nasibu; hivyo hakuna dhana ya awali ya mtu binafsi kwamba elektrodi fulani itachaguliwa mwanzoni.
Kwa nini fitness function si usahihi pekee?
Algoriti inayoongeza tu usahihi wa uainishaji inaweza kupendelea kutumia chaneli nyingi zaidi. Kwa kuwa lengo la utafiti ni usahihi wa juu pamoja na chaneli chache, chanzo kilitumia fitness function yenye uzito ya lengo moja ifuatayo:
\[ f(\mathbf{x}) = Acc(\mathbf{x}) - \lambda \frac{\|\mathbf{x}\|_1}{N} \tag{4} \]
Hapa:
- \(f(\mathbf{x})\): alama ya fitness ya mchanganyiko wa chaneli mgombea,
- \(Acc(\mathbf{x})\): usahihi wa uainishaji uliohesabiwa kwa BLDA na 10-fold cross-validation,
- \(\lambda\): mgawo wa uzito unaodhibiti nguvu ya adhabu itakayotumika kwa idadi ya chaneli,
- \(\|\mathbf{x}\|_1\): idadi ya chaneli zilizochaguliwa,
- \(N=8\): jumla ya idadi ya chaneli wagombea.
\(\|\mathbf{x}\|_1/N\) ni uwiano wa chaneli zilizochaguliwa. Kadiri chaneli nyingi zinavyotumika, neno hili hukua na adhabu kubwa zaidi hutolewa kutoka kwenye alama ya fitness.
Kwa mfano, kati ya suluhisho mbili zenye usahihi sawa, suluhisho linalotumia chaneli tatu huwa na neno la adhabu ya chaneli lililo dogo kuliko suluhisho linalotumia chaneli nane. Hivyo algoriti haitafuti tu mchanganyiko “ulio sahihi zaidi”, bali ule unaotoa mpangilio wa elektrodi uliopunguzwa zaidi huku ukihifadhi usahihi.
Dokezo la uwezo wa kurudiwa: Chanzo kinaeleza kile \(\lambda\) inadhibiti, lakini hakiripoti thamani ya nambari ya \(\lambda\) iliyotumika. Kwa hiyo, uzalishaji upya kamili wa kihesabu wa fitness function hauwezekani kwa taarifa za PDF pekee.
Operesheni za kijeni ni zipi?
Chanzo kinatumia mifumo mitatu ya msingi:
- Elitism: suluhisho lenye thamani ya fitness ya juu zaidi katika kizazi hicho huhamishwa bila kubadilishwa kwenda kwenye populesheni mpya.
- Exchange/Crossover: michanganyiko mipya huundwa kwa kubadilisha sehemu kati ya biti za chaneli za watu wengine.
- Variation/Mutation: baadhi ya biti hubadilishwa kwa uwezekano kutoka 0 hadi 1 au kutoka 1 hadi 0 ili kuunda nukta mpya za utafutaji.
Jukumu la elitism ni kuzuia suluhisho bora lililopo lisipotee wakati wa operesheni za kijeni. Crossover huunganisha upya miundo ya suluhisho zilizopo. Mutation huzalisha michanganyiko mipya ya chaneli katika populesheni na kupunguza hatari ya utafutaji kukwama mapema katika suluhisho la ndani.
GA husimama lini?
Chanzo kinatumia masharti mawili ya kusimamisha:
- Ikiwa suluhisho bora la sasa halibadiliki kwa idadi iliyowekwa ya iteresheni zinazofuatana.
- Ikiwa idadi ya juu ya iteresheni imefikiwa.
Kikomo cha pili ni iteresheni 10 katika mpangilio wa mwisho wa uboreshaji. Hata hivyo, thamani ya nambari ya kigezo \(T\), kinachoonyesha idadi ya suluhisho lilelile bora zinazofuatana katika sharti la kwanza, haijatolewa katika PDF.
Vigezo vya GA vilichaguliwaje?
Badala ya kuanza vigezo vinne vya GA moja kwa moja kwa thamani moja, watafiti walivichanganua kwa muundo wa jaribio la orthogonal:
| Kigezo | Viwango vilivyojaribiwa |
|---|---|
| Ukubwa wa populesheni | 10, 20, 30, 50, 100 |
| Idadi ya iteresheni | 5, 10, 20, 30, 50 |
| Mutation rate | 0,01; 0,03; 0,05; 0,07; 0,09 |
| Elite retention rate | 0,05; 0,10; 0,15; 0,20; 0,25 |
Kwa muundo wa orthogonal \(L_{25}(5^4)\) wenye sababu nne na viwango vitano, michanganyiko 25 ya vigezo ilitathminiwa badala ya kujaribu michanganyiko yote ya kinadharia moja baada ya nyingine.
Usahihi wa juu zaidi wa chaneli tatu ulipatikana kuwa %88,0 katika usanidi wa Orthogonal Experiment 12. Mipangilio ya GA iliyotumika katika uchambuzi uliofuata:
| Kigezo | Thamani |
|---|---|
| Ukubwa wa populesheni | 30 |
| Iteresheni ya juu | 10 |
| Mutation rate | 0,07 |
| Elite retention rate | 0,05 |
Chanzo hakiripoti kigezo tofauti cha uwezekano kwa crossover; kinaeleza kuwa operesheni ya Exchange ilifanywa.
Unasibu ulidhibitiwaje?
Populesheni ya awali ya GA, mgawanyo wa data wa cross-validation, nukta za crossover na operesheni za mutation zina unasibu. Watafiti walisema kwamba waliweka global pseudorandom seed thabiti katika mazingira ya Python ili kudhibiti utofauti huu.
Chanzo kinadai kuwa kwa njia hii njia ya algoriti inaweza kurudiwa kwa data na vigezo vilevile vya offline.
Hata hivyo, thamani ya nambari ya seed haijaripotiwa katika PDF. Kwa hiyo, taarifa kwamba “fixed seed ilitumika” inaeleza mantiki ya mbinu, lakini maandishi ya makala pekee hayatoshi kwa mtafiti huru kuunda random state ileile.
Marudio ya kuchaguliwa kwa chaneli yalikuwaje?
| Chaneli | Marudio yaliyoripotiwa katika chanzo | Nafasi |
|---|---|---|
| C3 | 1,00 | 1 |
| C4 | 0,95 | 2 |
| P4 | 0,90 | 3 |
| P3 | 0,80 | 4 |
| F3 | 0,50 | 5 |
| F4 | 0,40 | 6 |
| O2 | 0,20 | 7 |
| O1 | 0,10 | 8 |
Kwa nini chaneli tatu zilichaguliwa, si mbili au nne?
Katika vigezo vya Orthogonal Experiment 12, chanzo kililinganisha usahihi wa wastani kwa kuongeza idadi ya chaneli:
| Idadi ya chaneli | Usahihi wa wastani | Tafsiri ikilinganishwa na chaneli tatu |
|---|---|---|
| 1 | %65,0 | Chini kwa kiasi chenye umuhimu kuliko chaneli tatu |
| 2 | %80,0 | Chini kwa kiasi chenye umuhimu kuliko chaneli tatu |
| 3 | %88,0 | Mpangilio uliochaguliwa |
| 4 | %89,0 | Hakuna uboreshaji wenye umuhimu |
| 5-8 | Takriban %90-%92 | Chanzo hakiripoti uboreshaji wenye umuhimu ikilinganishwa na chaneli tatu |
Usahihi huongezeka wazi wakati wa kutoka chaneli moja hadi chaneli tatu. Baada ya chaneli tatu, faida inayotolewa na elektrodi za ziada hupungua. Chanzo kilitafsiri uwanda huu wa utendaji kama hatua bora zaidi ya usawa kati ya idadi ya elektrodi na usahihi, na kikachagua chaneli tatu kwa mfumo wa mwisho wenye chaneli chache.
Je, Mfumo Huu Kweli ni BCI “Isiyohitaji Kalibrasheni”?
Hapana; utafiti unaondoa utafutaji wa chaneli unaotegemea GA na kuhesabu upya mchanganyiko wa chaneli kwa mtumiaji mpya, lakini kabla ya jaribio rasmi la online kiainishaji cha BLDA hufunzwa kwa data za offline calibration za mtu huyo; kwa hiyo, kauli “zero-calibration-cost” inapaswa kueleweka kama kuondolewa kwa gharama ya algoriti ya uteuzi wa chaneli mahsusi kwa mtumiaji, si kuondolewa kwa kalibrasheni ya jumla ya kiainishaji cha EEG.
Kwa nini jaribio la awali na jaribio rasmi vilitenganishwa?
Katika utafiti, mchakato ulitenganishwa kwa muda ili kupunguza matumaini yasiyo halisi ambayo yangeweza kutokea kwa kutumia data ileile moja kwa moja kwa namna ileile, kwa kugundua chaneli tatu na pia kuthibitisha ubora wa chaneli hizo tatu.
Katika hatua ya kwanza, data za offline za chaneli nane za watu wote 48 zilikusanywa na uteuzi wa chaneli wa GA-BLDA ukatumika kupata mchanganyiko wa C3-C4-P4.
Baada ya wiki mbili, jaribio rasmi la kulinganisha lilianza. Data rasmi za offline calibration zilitumika safari hii kufunza modeli ya BLDA, kisha udhibiti wa online ukafanywa.
Kwa hiyo, ingawa orodha thabiti ya chaneli ilikuwa imeamuliwa mapema, kiainishaji cha wakati halisi si modeli ya jumla ya pretrained ambayo haitegemei kabisa data za mtumiaji.
Muundo wa AB/BA crossover uliundwaje?
Watu 48 waligawanywa kwa nasibu katika makundi mawili sawa:
| Kundi | Idadi ya washiriki | Experiment 1 | Washout | Experiment 2 |
|---|---|---|---|---|
| A | 24 | 8 chaneli | 48 saa | 3 chaneli |
| B | 24 | 3 chaneli | 48 saa | 8 chaneli |
Kwa kuwa mtu yuleyule alitumia mifumo yote miwili katika muundo wa crossover, athari ya tofauti za EEG kati ya watu katika ulinganisho inaweza kupunguzwa. Mantiki ya kufanya ulinganisho wa kitakwimu kati ya mifumo kwa paired-sample t-test pia ni kulinganisha kwa jozi matokeo ya mshiriki yuleyule katika hali mbili.
Chanzo kilitumia kipindi cha saa 48 kama washout ili kupunguza uchovu na athari za kujifunza/muscle-memory. Hata hivyo, hakuna modeli tofauti ya kitakwimu ya period effect, sequence effect au carryover-effect iliyoripotiwa.
Kazi ya VR P300 ilifanyaje kazi?
Kwa Unity3D 2022.3 LTS, iliandaliwa mandhari ya uhalisia pepe ya “udhibiti wa kazi za chumba”. Kiolesura cha kuona kiliwasilishwa kwenye monitori ya mwonekano wa 1920 × 1080, 60 Hz.
Katika mandhari hiyo kulikuwa na vitufe pepe vya udhibiti chini ya vitu shirikishi kama pazia, televisheni, mlango na taa. Vitufe hutumia hali tatu:
- nyeusi katika hali chaguomsingi,
- nyekundu kwa sekunde 2 wakati wa cue au recognition feedback,
- mabadiliko ya flash ya sekunde 0,1 kati ya nyeusi na kijani katika hatua ya stimulation.
Mtumiaji aliagizwa kuhesabu kimya wakati kitufe lengwa kinakuwa kijani na kuweka macho yake yakiwa thabiti wakati vitufe visivyo lengwa vinamulika.
Jaribio la offline calibration lilifanywaje?
Kila mshiriki alikamilisha trial 20. Trial moja ilikuwa na jumla ya sekunde 20:
| Hatua | Muda | Kitendo |
|---|---|---|
| Cue | 2 s | Kitufe lengwa huonyeshwa kwa rangi nyekundu |
| Stimulus | 16 s | Raundi 10 za uchochezi |
| Rest | 2 s | Mapumziko ya kuona |
Kila raundi ya uchochezi ni sekunde 1,6. Kila kimoja cha vitufe nane hufanya flash mara moja kwa mpangilio wa pseudo-random na flash cycle moja ni sekunde 0,2: sekunde 0,1 za mandharinyuma nyeusi na sekunde 0,1 za msisitizo wa kijani.
Jaribio la online lilitofautianaje?
Paradigma ya jumla ya uthibitishaji wa online inafanana na hatua ya offline, lakini muda wa kutambua lengo moja ulipunguzwa hadi sekunde 16,8 na idadi ya uchochezi ikapunguzwa kutoka raundi 10 hadi raundi 8.
Baada ya raundi nane kukamilika, modeli ya BLDA iliyofunzwa mapema ilikadiria lengo kutoka katika vipengele vya EEG vya wakati halisi, kitufe kilichokadiriwa kikaonyeshwa kwa rangi nyekundu kwa sekunde 2, na amri inayolingana ya Unity ikatekelezwa.
Modeli ya msingi ya kihisabati ya BLDA
Chanzo kinafafanua BLDA kwa namna ya regresheni ya mstari kwa uhusiano ufuatao:
\[ Y=\boldsymbol{\omega}^{T}F_i+z \tag{1} \]
Hapa:
- \(Y\): lengo la regresheni,
- \(F_i\): vekta ya vipengele vya \(i\). EEG,
- \(\boldsymbol{\omega}\): vekta ya uzito wa vipengele,
- \(z\): neno la kelele lenye usambazaji wa Gaussian.
\(\boldsymbol{\omega}^{T}F_i\) ni mchanganyiko wa mstari wenye uzito wa vipengele. Vipengele vyenye uzito mkubwa wa thamani kamili huchangia kwa nguvu zaidi katika matokeo ya makadirio.
Tofauti kuu ya mbinu ya Bayesian ni kutathmini kutokuwa na uhakika kwa uzito ndani ya usambazaji wa uwezekano badala ya kuichukulia \(\boldsymbol{\omega}\) kama vekta moja tu bora na thabiti.
Chanzo kinatoa predictive distribution function ya sampuli mpya ya \(F\) kama:
\[ p(y\mid\beta,\alpha,F,S) = \int p(y\mid\beta,F,\boldsymbol{\omega}) p(\boldsymbol{\omega}\mid\beta,\alpha,S) \,d\boldsymbol{\omega} \tag{2} \]
hivyo.
Intigro huunganisha makadirio juu ya vekta mbalimbali za uzito zinazowezekana kwa uzito wao wa posterior. Kwa maneno mengine, badala ya kuamua kwa thamani moja tu ya \(\boldsymbol{\omega}\), modeli huondoa kwa ujumlishaji kutokuwa na uhakika kwa uzito.
Kulingana na chanzo, \(\beta\) ni kigezo cha inverse variance cha kelele \(z\); \(\alpha\) ni kigezo cha variansi ya prior kinachohusiana na uzito.
Dokezo la nukuu: Maandishi ya chanzo yanaeleza usemi \(p(\boldsymbol{\omega}\mid\beta,\alpha,S)\) kama “posterior distribution ya predicted value y”; hata hivyo, katika usemi wa kihisabati kigezo cha usambazaji ni \(\boldsymbol{\omega}\). Verianla haibadilishi kimya kimya usemi huu wa istilahi kwa mlinganyo mpya, bali huhifadhi uwasilishaji wa kihisabati katika namna ya chanzo. Aidha, ishara \(S\) haijapewa ufafanuzi tofauti na wazi katika sehemu hii.
Thamani ya lengo la regresheni inayolingana na usambazaji wa makadirio:
\[ u=\boldsymbol{\mu}^{T}F \tag{3} \]
huhesabiwa nayo. Katika chanzo, \(\boldsymbol{\mu}\) inawakilisha wastani wa usambazaji wa posterior.
Kwa nini mbinu ya Bayesian inaweza kuwa na manufaa kwa EEG?
EEG ni biosignali yenye kelele inayoweza kubadilika kati ya mtu na mtu na kwa muda. Kutumia mbinu ya Bayesian kwa uzito katika BLDA hutoa mfumo wa uainishaji unaoweza kusaidia kupunguza hatari ya overfitting, hasa katika vipengele vya EEG vyenye vipimo vingi na kelele nyingi, kwa kudhibiti vigawo vya vipengele chini ya kutokuwa na uhakika.
Utafiti huu hauendelezi BLDA kama mbinu mpya. BLDA hutumika kama kiainishaji kinachotathmini utendaji wa wagombea wa chaneli wanaoundwa na GA, na kama decoder inayokadiria lengo katika jaribio rasmi.
Usahihi ulihesabiwaje?
Chanzo kinafafanua usahihi wa uainishaji kama:
\[ Acc= \frac{TP+TN} {TP+TN+FP+FN} \tag{5} \]
hivyo.
Hapa:
- \(TP\): true positive,
- \(TN\): true negative,
- \(FP\): false positive,
- \(FN\): idadi ya false negative.
Namba ya juu inawakilisha maamuzi sahihi, na namba ya chini inawakilisha maamuzi yote ya uainishaji. Matokeo yanaweza kuripotiwa kama uwiano kati ya 0 na 1 au kama asilimia.
Kiwango cha uhamishaji taarifa kilihesabiwaje?
Katika BCI, usahihi pekee hautoshi. Ikiwa mfumo unatoa amri sahihi baada ya muda mrefu sana, ufanisi wa mwingiliano wa wakati halisi unaweza kuwa mdogo. Kwa hiyo, utafiti ulitumia kipimo cha Information Transfer Rate (ITR):
\[ ITR= \frac{60}{RT} \left[ \log_2 M + Acc\log_2 Acc + (1-Acc) \log_2 \left( \frac{1-Acc}{M-1} \right) \right] \tag{6} \]
Hapa:
- \(M\): jumla ya idadi ya amri zinazoweza kuchaguliwa,
- \(Acc\): usahihi wa uainishaji,
- \(RT\): response time ya mfumo.
Usemi uliomo kwenye mabano ya mraba unawakilisha kiasi cha taarifa kinachobebwa na chaguo moja kwa biti. Kipengele cha \(60/RT\) hupima kiasi cha taarifa kwa kila chaguo kulingana na muda na kubadilisha matokeo kuwa bit/dakika.
Usahihi unapoongezeka, neno la taarifa la ITR kwa kawaida huongezeka. Kwa upande mwingine, stimulus round nyingi zaidi zinapotumika, response time huongezeka na \(60/RT\) hupungua. Kwa hiyo, kupata usahihi wa juu zaidi kwa marudio mengi zaidi hakumaanishi lazima ITR iongezeke.
Je, Mfumo wa Chaneli Tatu Kweli Ulitoa Utendaji Sawa na Mfumo wa Chaneli Nane?
Si kabisa: mfumo wa chaneli tatu kwa ujumla ulionyesha utendaji ulio karibu na chaneli nane na unaoweza kulinganishwa kitakwimu kwa usahihi wa online, lakini katika raundi za uchochezi za offline 7-10. chaneli nane zilionyesha ubora wenye umuhimu katika usahihi na ITR; kwa hiyo, matokeo yanapaswa kutafsiriwa si kama “utendaji ni sawa kabisa”, bali kama “sehemu kubwa ya utendaji ilihifadhiwa licha ya kupunguzwa kwa kiasi kikubwa kwa elektrodi”.
Usahihi wa offline ulibadilikaje?
| Raundi | Usahihi wa chaneli 3 | Usahihi wa chaneli 8 | Tafsiri ya chanzo |
|---|---|---|---|
| 1 | %40,00 | %43,85 | Usahihi wa mwanzo ni mdogo katika mifumo yote miwili |
| 10 | %86,67 | %91,88 | Katika raundi za 7-10. p < 0,05 kwa upande wa chaneli nane |
Katika mifumo yote miwili, usahihi uliongezeka kadiri idadi ya stimulus round ilivyoongezeka. Sababu ni kwamba averaging ya majibu ya P300 yanayorudiwa hufanya ishara inayohusiana na lengo ionekane zaidi ikilinganishwa na kelele ya asili ya EEG.
Hata hivyo, kwa kuwa chanzo hakitoi wastani wa raundi zote za kati za Figure 9 katika jedwali la nambari, Verianla haitengenezi thamani mpya sahihi za raundi za 2-9.
ITR ya offline ilibadilikaje?
| Raundi | ITR ya chaneli 3 | ITR ya chaneli 8 | Tafsiri ya chanzo |
|---|---|---|---|
| 1 | 71,91 bit/dk | 84,33 bit/dk | ITR ya juu zaidi katika raundi ya mapema |
| 10 | 22,47 bit/dk | 24,60 bit/dk | Katika raundi za 7-10. p < 0,05 kwa upande wa chaneli nane |
Kupungua kwa ITR licha ya kuongezeka kwa Accuracy si mkanganyiko. stimulus round nyingi zaidi huupa mfumo taarifa zaidi, lakini pia huongeza muda wa kutoa amri. Fomula ya ITR hutathmini usawa huu kati ya usahihi na kasi ndani ya kipimo kimoja.
Dokezo la kutokuwa na uhakika ndani ya chanzo: Katika sehemu ya Discussion, ±4,02 na ±3,76 zinaongezwa mtawalia kwenye thamani za ITR za offline za raundi ya mwisho za 22,47 na 24,60 bit/dk. Thamani hizo hizo za ± ni mikengeuko sanifu ya online ITR katika Table 3. Kwa kuwa maandishi ya Results ya Figure 10 hayaripoti mikengeuko hii sanifu kando kwa thamani za offline final-round, Verianla haitumii kama thamani za SD zilizothibitishwa za offline Figure 10.
Utendaji wa online ulikuwaje?
| Kipimo | Chaneli 3 | Chaneli 8 | Dokezo la kitakwimu |
|---|---|---|---|
| Accuracy | %90,21 ± 5,36 | %92,40 ± 5,55 | Katika maandishi ya Results ya chanzo, p > 0,05 kwa usahihi |
| ITR | 23,66 ± 4,02 bit/dk | 27,52 ± 3,76 bit/dk | Table 3 haitoi thamani tofauti ya p |
Katika mpangilio wa chaneli tatu, washiriki watano wenye nambari S26, S39, S41, S44 na S45 walipata usahihi wa online wa %100. Chanzo pia kinaripoti kuwa baadhi ya washiriki walionyesha matokeo ya chaneli tatu yaliyo juu kuliko matokeo yao wenyewe ya chaneli nane.
Matokeo haya ya mtu mmoja mmoja hayamaanishi kwamba “chaneli tatu ni bora kibayolojia kwa kila mtu”. Kwa sababu ya utofauti wa EEG wa mtu binafsi, baadhi ya watu walionyesha matokeo ya juu kwa mfumo wa chaneli tatu katika kikao fulani.
Kauli ya chanzo “hakuna upotevu wa utendaji wenye umuhimu” inapaswa kusomwaje?
Abstract na conclusion zinafupisha mfumo wa chaneli tatu kwa ujumla kama mfumo unaoweza kulinganishwa na chaneli nane na usio na hasara ya utendaji yenye umuhimu. Hata hivyo, sehemu ya kina ya Results ina hali yenye mchanganyiko zaidi:
- Katika usahihi wa Offline rounds 7-10, chaneli nane ni juu kwa kiasi chenye umuhimu.
- Katika ITR ya Offline rounds 7-10, chaneli nane ni juu kwa kiasi chenye umuhimu.
- Tofauti ya usahihi katika raundi ya mwisho ya offline ni takriban pointi 5,2 za asilimia kwa thamani kamili.
- Tofauti ya ITR katika raundi ya mwisho ya offline ni 2,13 bit/dk.
- Tofauti ya usahihi wa online katika chanzo ni p > 0,05.
Kwa hiyo, katika tathmini ya Verianla, sentensi “hakuna upotevu wenye umuhimu” haitanuliwi kwa uchambuzi wote wa ndani.
Ulinganisho upya na mbinu nyingine za uteuzi wa chaneli
Watafiti walitumia tena mbinu tatu wakilishi katika mkusanyiko wao wa data za offline wa washiriki 48 chini ya mazingira yaleyale ya tathmini:
| Mbinu | Paradigma | Idadi ya chaneli | Offline Accuracy | Offline ITR | Thamani ya p dhidi ya mbinu ya chaneli tatu |
|---|---|---|---|---|---|
| Hu et al. [32] | P300 + EOG | 4 | %84,30 ± 6,50 | 20,15 ± 4,80 bit/dk | 0,038 |
| Ma et al. [34] | P300 | 5 | %87,50 ± 5,80 | 23,10 ± 4,20 bit/dk | 0,285 |
| Martínez-Cagigal et al. [13] | P300 | 7 | %88,10 ± 5,40 | 23,50 ± 4,00 bit/dk | 0,164 |
| Utafiti huu | P300 | 3 | %86,67 ± 6,25 | 22,47 ± 4,02 bit/dk | Rejea |
Thamani za p katika jedwali hili ni ulinganisho wa paired-sample t-test kwa offline Accuracy pekee.
Dokezo la uthabiti ndani ya chanzo: Sentensi ya mjadala kabla ya Table 5 inaandika %87,50 na %88,10 mtawalia kwa mbinu za DFGA [13] na Adaptive Sparse Bayesian [34]; hata hivyo, katika safu zilizochapishwa za Table 5, Ma et al. [34] ni %87,50 na Martínez-Cagigal et al. [13] ni %88,10. Verianla huhifadhi safu za jedwali katika namna zilivyochapishwa katika chanzo na haibadilishi kimya kimya nafasi za thamani hizi mbili.
NASA-TLX ni nini?
NASA Task Load Index (NASA-TLX) ni mbinu ya dodoso inayotathmini mzigo wa kazi wa kihisia unaosababishwa na kazi kwa mtumiaji katika vipimo mbalimbali. Katika utafiti huu, vipimo sita vilitumika:
- Mental Demand,
- Physical Demand,
- Temporal Demand,
- Frustration,
- Performance,
- Effort.
Kila kipimo kilitathminiwa kwa skeli ya 0-100.
Je, chaneli tatu zilipunguza mzigo wa mtumiaji?
| Kipimo | Chaneli 3 | Chaneli 8 | Matokeo ya kitakwimu ya chanzo |
|---|---|---|---|
| Mental Demand | 19,27 ± 7,72 | 23,23 ± 8,09 | p < 0,05 |
| Physical Demand | 17,40 ± 7,72 | 25,21 ± 7,78 | p < 0,01 |
| Temporal Demand | 23,02 ± 6,82 | 22,81 ± 7,43 | p > 0,05 |
| Frustration | 22,60 ± 8,05 | 23,75 ± 8,60 | p > 0,05 |
| Performance | 20,10 ± 7,96 | 27,50 ± 8,12 | p < 0,01 |
| Effort | 22,50 ± 8,93 | 23,75 ± 9,02 | p > 0,05 |
Chanzo kinatafsiri thamani za chini za Mental Demand na Physical Demand kama mzigo wa chini wa kiakili na kimwili. Katika kipimo kidogo cha Performance, alama ya chini pia inatathminiwa kama matokeo bora.
Ingawa wastani wa mfumo wa chaneli tatu kwa Temporal Demand, Frustration na Effort kwa kiasi kikubwa uko chini, tofauti si yenye umuhimu wa kitakwimu. Kwa hiyo, haiwezi kusemwa kuwa uboreshaji wa uhakika umeonyeshwa katika vipimo hivi vitatu.
Muda wa maandalizi na kusafisha
| Kiashiria | Chaneli 8 | Chaneli 3 | Matokeo ya chanzo |
|---|---|---|---|
| Muda wa kuandaa vifaa | 30 dk | 3 dk | Upungufu wa %90 |
| Kusafisha baada ya jaribio | Rejea | Mfupi zaidi | Upungufu wa %80 |
Matokeo haya ni mojawapo ya faida kubwa zaidi katika dai la matumizi ya vitendo la utafiti. Kupungua kwa idadi ya elektrodi hakukupunguza tu ukubwa wa ukokotoaji wa algoriti, bali pia usakinishaji wa kimwili wa kofia.
Mbinu na Matokeo ya Utafiti
Sampuli ya washiriki
| Sifa | Thamani iliyoripotiwa katika chanzo |
|---|---|
| Jumla ya washiriki | 48 |
| Wanawake | 12 |
| Wanaume | 36 |
| Umri | 18-26 |
| Uoni | Wa kawaida au uliorekebishwa kuwa wa kawaida |
| Historia ya ugonjwa wa neva/akili | Hakuna |
| Uzoefu wa awali wa EEG | Hakuna |
| Ridhaa yenye taarifa | Ridhaa ya maandishi ilipatikana |
Sampuli hii inajumuisha watu wazima vijana wenye afya. Kwa hiyo, utendaji wa moja kwa moja wa kliniki haujaonyeshwa kwa wagonjwa wenye ulemavu wa mwendo, watu wenye jeraha la uti wa mgongo, wagonjwa wa ALS, watumiaji wazee au makundi mengine ya kliniki.
Vifaa vya EEG na vigezo vya uchakataji wa awali
| Kigezo | Thamani / mbinu |
|---|---|
| Kofia ya EEG | South China Brain Control Technology Co., Ltd. wearable EEG cap |
| Muunganisho | Bluetooth 4.2 |
| Aina ya elektrodi | Elektrodi yenye unyevunyevu |
| Chaneli | F3, F4, C3, C4, P3, P4, O1, O2 |
| Uwekaji | International 10-20 system |
| Usampulishaji | 250 Hz |
| Impidansi ya mgusano | <10 kΩ |
| Epoch | −200 hadi 600 ms |
| Baseline | Wastani wa −200 hadi 0 ms |
| Band-pass | IIR ya daraja la 4., 0,1-25 Hz |
| Notch | 50 Hz |
| Downsampling | ×5 |
| Feature window | 0-600 ms |
| Dirisha dogo | 4 × 150 ms |
| Vipengele | Wastani + variansi |
| Stimulus averaging | Raundi 10 kwa lengo lilelile |
| Cross-validation | 10-fold, mgawanyo wa 9:1 wa mafunzo-majaribio katika kiwango cha trial |
Mazingira ya programu na ukokotoaji
| Kipengele | Taarifa |
|---|---|
| CPU | Intel Core i7-11700K @ 3.60 GHz |
| RAM | 32 GB |
| Mfumo wa uendeshaji | Windows 10 64-bit |
| Programu ya EEG / GA / BLDA | Python 3.9 |
| Injini ya VR | Unity3D 2022.3 LTS |
| Monitori | 1920 × 1080, 60 Hz |
Hatua mbili kuu za data za jaribio
Jaribio la awali: EEG ya offline ya chaneli nane ilikusanywa kutoka kwa watu wote 48. Data hizi zilitumika kugundua chaneli tatu thabiti kupitia GA-BLDA.
Jaribio rasmi: Baada ya wiki mbili, ulinganisho wa AB/BA crossover ulifanywa. Katika kila hali ya chaneli, hatua ya offline calibration na online validation ilitumika.
Madhumuni haya mawili ya matumizi ya data yanapaswa kutenganishwa. Jaribio la awali hugundua mpangilio wa chaneli; jaribio rasmi hulinganisha utendaji wa mpangilio uliochaguliwa na chaneli nane.
Matokeo makuu ya uteuzi wa chaneli
C3 ilikuwa katika nafasi ya juu kwa washiriki wote na chanzo kilitoa marudio yake kuwa 1,00. C4 ina marudio ya 0,95 na P4 0,90. Hivyo C3-C4-P4 ikawa mchanganyiko wa mwisho wa chaneli thabiti.
Chanzo pia kinaeleza kuwa C4 ilichaguliwa na watu 46 pamoja na C3 katika mchanganyiko wa chaneli mbili. Kwa kuwa thamani za marudio zimeripotiwa katika chanzo kama uwiano wenye nafasi mbili za desimali, Verianla haikokotoi kinyume idadi sahihi ya watu kwa chaneli nyingine kutoka kwenye uwiano huu.
Muhtasari wa matokeo ya offline
Kadiri idadi ya stimulus round ilivyoongezeka, usahihi wa mifumo yote miwili uliongezeka na ITR yake ikapungua.
| Kipimo | Mwanzo wa chaneli 3 | Mwanzo wa chaneli 8 | Chaneli 3 raundi ya 10. | Chaneli 8 raundi ya 10. |
|---|---|---|---|---|
| Accuracy | %40,00 | %43,85 | %86,67 | %91,88 |
| ITR | 71,91 bit/dk | 84,33 bit/dk | 22,47 bit/dk | 24,60 bit/dk |
Chanzo kinaripoti p < 0,05 kwa upande wa chaneli nane kwa Accuracy na ITR katika raundi za 7-10.
Muhtasari wa matokeo ya online
Katika jaribio la online, mfumo wa chaneli tatu ulihifadhi usahihi wa juu:
| Mfumo | Accuracy | ITR |
|---|---|---|
| 3 chaneli | %90,21 ± 5,36 | 23,66 ± 4,02 bit/dk |
| 8 chaneli | %92,40 ± 5,55 | 27,52 ± 3,76 bit/dk |
Katika maandishi ya Results ya chanzo, tofauti ya online Accuracy imeripotiwa kuwa p > 0,05. Hakuna thamani tofauti ya p iliyotolewa kwa online ITR katika sehemu hiyo hiyo.
Mbadilishano kati ya urahisi wa maandalizi na utendaji
Faida kuu ya mfumo wa chaneli tatu haipo tu katika kipimo cha usahihi, bali pia katika usakinishaji wa mfumo. Idadi ya elektrodi:
\[ 8\rightarrow3 \]
imepunguzwa. Hii inamaanisha elektrodi tano zimeondolewa kwenye mfumo.
Muda wa maandalizi:
\[ 30\ \mathrm{dk} \rightarrow 3\ \mathrm{dk} \]
na chanzo kiliripoti upungufu wa %90.
Kwa upande mwingine, usahihi wa raundi ya mwisho ya offline:
\[ 91{,}88\% \rightarrow 86{,}67\% \]
ulikuwa hivyo.
Mchango wa kiuhandisi wa utafiti upo katika trade-off hii: kurahisisha sana usakinishaji wa kimwili kwa gharama ya tofauti ndogo ya utendaji.
Uchambuzi wa kitakwimu unapaswa kutafsiriwaje?
Kwa kuwa mifumo ililinganishwa kwa washiriki wale wale, chanzo kilitumia paired-sample t-test. Katika uchambuzi mbalimbali:
- \(p<0,05\),
- \(p<0,01\),
- na \(p>0,05\)
vizingiti viliripotiwa.
Thamani ya p si kitu kilekile na ukubwa wa tofauti iliyoonekana. Kwa mfano, tofauti ya takriban pointi 5,2 za asilimia katika usahihi wa offline wa raundi ya 10. ina umuhimu wa kitakwimu; kwa hiyo thamani ya p na tofauti kamili zinapaswa kutathminiwa pamoja.
Chanzo hakiripoti confidence interval tofauti wala effect size iliyosanifishwa. Aidha, hakuna mbinu tofauti ya multiple-comparison correction iliyoripotiwa kwa paired t-test zilizofanywa katika raundi nyingi na vipimo vidogo vya NASA-TLX. Kwa hiyo, Verianla huwasilisha thamani za p kama zilivyotolewa katika chanzo; haihesabu thamani mpya ya p iliyosahihishwa.
Hoja muhimu za uthabiti na uwezo wa kurudiwa ndani ya chanzo
1. Adhabu ya fitness \(\lambda\): Jukumu lake la kihisabati limeelezwa, lakini thamani ya nambari haijatolewa.
2. Kigezo cha stop cha GA \(T\): Idadi ya iteresheni zinazofuatana ambazo suluhisho bora linapaswa kutobadilika haijatolewa kwa nambari.
3. Random seed: Imeelezwa kuwa global seed thabiti ilitumika, lakini thamani ya seed haijaelezwa.
4. Kauli “Zero-calibration-cost”: Inaondoa kuendesha upya GA mahsusi kwa mtumiaji kwa uteuzi wa chaneli; katika uthibitishaji rasmi wa online BCI bado kuna offline BLDA calibration.
5. Tafsiri ya offline na online ya “hakuna tofauti yenye umuhimu”: Results za kina za offline zinaripoti tofauti yenye umuhimu kwa upande wa chaneli nane katika raundi za 7-10. Sentensi ya jumla ya abstract/conclusion haiwakilishi peke yake matokeo haya ya ndani.
6. Thamani za offline ITR ± katika Discussion: Thamani za ±4,02 na ±3,76 zilizoongezwa kwa ITR ya offline ya raundi ya mwisho ni sawa na mikengeuko sanifu ya online ITR katika Table 3; chanzo hakiripoti SD hizi kando kwa offline Figure 10 katika sehemu ya Results.
7. Mpangilio wa mbinu/thamani katika Table 5: Mpangilio wa “respectively” katika maandishi ya mjadala haulingani kikamilifu na uhusishaji wa thamani za 87,50 na 88,10 na mbinu katika safu za Table 5. Verianla huhifadhi jedwali kama lilivyochapishwa.
8. Nambari ya kamati ya maadili: Idhini ya Guangzhou Maritime University Ethics Committee imeripotiwa, lakini hakuna nambari ya protocol/approval iliyotajwa katika chanzo.
Matokeo yanayoungwa mkono na utafiti
- Kwa kutumia GA-BLDA, mpangilio thabiti wa P300-BCI wa chaneli tatu unaojumuisha C3, C4 na P4 ulipatikana.
- C3, C4 na P4 zina marudio matatu ya juu zaidi ya uteuzi wa chaneli katika uchambuzi wa watu wote 48.
- Chaneli tatu zilitoa usahihi wa juu wazi kuliko chaneli moja na mbili.
- Wakati wa kuongezeka hadi chaneli nne au zaidi, hakuna ongezeko la usahihi lenye umuhimu lililoripotiwa ikilinganishwa na chaneli tatu katika uchambuzi wa Orthogonal Experiment 12.
- Usahihi wa offline wa raundi ya 10. ni %86,67 kwa chaneli tatu na %91,88 kwa chaneli nane.
- ITR ya offline ya raundi ya 10. ni 22,47 kwa chaneli tatu na 24,60 bit/dk kwa chaneli nane.
- Usahihi wa online ni %90,21 ± 5,36 kwa chaneli tatu na %92,40 ± 5,55 kwa chaneli nane.
- Chanzo kimeripoti tofauti ya online Accuracy kuwa p > 0,05.
- Mpangilio wa chaneli tatu ulipunguza muda wa maandalizi kutoka dakika 30 hadi dakika 3.
- Muda wa kusafisha baada ya jaribio ulipunguzwa kwa %80.
- Mental Demand na Physical Demand zilikuwa chini kwa kiasi chenye umuhimu katika mfumo wa chaneli tatu.
- Mpangilio wa chaneli tatu uliweza kutoa usawa wa urahisi wa matumizi na utendaji katika kazi ya VR P300 iliyodhibitiwa.
Matokeo ambayo utafiti hauungi mkono
- Haijaonyeshwa kuwa chaneli tatu ni sawa kabisa na chaneli nane katika kila kipimo cha utendaji.
- Ubora wa chaneli nane katika raundi za offline 7-10. haujaondolewa.
- Mfumo si BCI isiyohitaji kalibrasheni kabisa; BLDA calibration ilitumika kabla ya matumizi ya online.
- Haijaonyeshwa kuwa mpangilio wa C3-C4-P4 ni bora kuliko mpangilio mahsusi kwa mtu kwa watumiaji wote duniani.
- Utendaji haujathibitishwa kwa watu wenye ulemavu wa mwendo, jeraha la uti wa mgongo, ALS, wazee au makundi mengine ya kliniki.
- Usahihi na uzoefu wa mtumiaji huohuo haujaonyeshwa kwa elektrodi kavu.
- Ustahimilivu haujaonyeshwa katika hali za mwendo mkubwa, matumizi ya simu na kelele nzito za mazingira.
- Haijaonyeshwa kuwa chaneli tatu huhifadhi taarifa zote za anga za EEG yenye msongamano mkubwa.
- Upungufu wa %90 wa muda wa maandalizi si lazima uwe sawa kiotomatiki kwa kofia nyingine za EEG au teknolojia nyingine za elektrodi.
- Matokeo ya NASA-TLX si ushahidi wa ufanisi wa kliniki au matumizi ya kila siku ya muda mrefu.
Mapungufu makuu ya utafiti
Azimio la anga lililopunguzwa: Chaneli tatu husampuli maeneo machache ya ngozi ya kichwa kuliko mifumo ya EEG ya chaneli nane au yenye msongamano mkubwa zaidi na hupunguza urudufu wa ishara.
Hatari ya kelele na motion artifact: Chaneli chache zinaweza kusababisha kupungua kwa vyanzo mbadala vya ishara safi katika mazingira ya simu yenye kelele nyingi.
Idadi ya washiriki: Sampuli inajumuisha tu watu wazima vijana wenye afya wenye umri wa 18-26.
Mpangilio thabiti wa jumla: C3-C4-P4 imewekwa thabiti kwa washiriki wote; huenda isiweke sawa kikamilifu tofauti za EEG za mtu binafsi.
Elektrodi yenye unyevunyevu: Licha ya dai la urahisi wa matumizi la utafiti, EEG bado ilikusanywa kwa mfumo wa wet-electrode unaohitaji conductive paste.
Mazingira yanayodhibitiwa: Matokeo yalipatikana katika mazingira ya kazi ya kuona yanayodhibitiwa na yanayotegemea Unity; si hali halisi za maisha ya kila siku ya simu.
Vigezo vya GA visivyokamilika: Baadhi ya maelezo ya uwezo wa kurudiwa kama \(\lambda\), thamani thabiti ya seed na stop patience \(T\) hayajaripotiwa kwa nambari.
Utoaji wa taarifa za kitakwimu: Maelezo ya confidence interval, effect size iliyosanifishwa na multiple-comparison correction hayajaripotiwa.
Chanzo kinapendekeza nini kwa tafiti za baadaye?
Waandishi wanapendekeza mwelekeo mkuu mitatu:
- Uboreshaji wa chaneli wa kidinamiki unaozingatia pamoja mpangilio thabiti wa jumla na tofauti za mtu binafsi.
- Modeli za deep learning ili kufidia upotevu wa taarifa unaotokana na kupunguza chaneli.
- Kupima uthabiti wa mfumo katika mazingira tata zaidi ya ulimwengu halisi kama multi-task interference na hali za matumizi ya simu.
Aidha, imeelezwa wazi kuwa uthibitishaji tofauti unahitajika katika mifumo ya elektrodi kavu na makundi ya kliniki.
Thamani ya vitendo ya utafiti huu ni nini?
Mchango mkuu wa utafiti ni tofauti kidogo na swali “ni mfumo upi hutoa usahihi wa juu zaidi wa uainishaji?” Elektrodi nane au zaidi zinaweza kuwa na faida ndogo ya utendaji; hata hivyo, kwa BCI inayoweza kutumika kila siku, muda wa maandalizi, usafishaji, faraja na gharama ya ukokotoaji pia ni muhimu.
Utafiti huu unaonyesha kwamba wakati wa kutoka chaneli nane hadi chaneli tatu, usahihi wa online unaweza kubaki juu na maandalizi ya kimwili yanaweza kupungua kwa kiwango kikubwa sana. Kwa hiyo, mpangilio wa C3-C4-P4 unapaswa kutathminiwa hasa kama maelewano ya kiuhandisi kati ya urahisi wa matumizi na utendaji wa uainishaji.
Ili hili liwe teknolojia saidizi ya kliniki, uthibitishaji huru unahitajika kwa makundi ya wagonjwa, watumiaji wazee, elektrodi kavu, mazingira yenye mwendo na matumizi halisi ya muda mrefu zaidi. Haya si matokeo ya utafiti wa sasa, bali ni hatua zinazofuata za uthibitishaji zinazohitajika kuhamisha ushahidi uliopo kwenda kwenye matumizi.
Maelezo ya Chanzo na Mbinu
Kichwa asilia: A Few-Channel Brain–Computer Interface System Based on a Heuristic Algorithm.
Waandishi: Junhong Luo; Jianbin Yu; Hui Cao; Qiyue Tan; Jinheng Chen; Jing Xiao.
Mpangilio wa waandishi: Mpangilio wa chanzo umehifadhiwa kama ulivyo.
Mchango sawa: Junhong Luo na Jianbin Yu walitoa mchango sawa.
Mwandishi anayewajibika: Jing Xiao.
Taasisi 1: School of Artificial Intelligence, Guangzhou Maritime University, Guangzhou 510725, China.
Taasisi 2: School of Mathematics and Statistics, Guangdong University of Technology, Guangzhou 510520, China.
Taasisi 3: School of Electronics and Communication Engineering, Guangzhou University, Guangzhou 510006, China.
Jarida: Biomimetics.
Mchapishaji: MDPI.
Juzuu / toleo / nambari ya makala: 11 / 9 / 613.
DOI: 10.3390/biomimetics11090613.
Kiungo rasmi: https://doi.org/10.3390/biomimetics11090613
Tarehe ya kuwasilisha: 21 Juni 2026.
Tarehe ya marekebisho: 15 Agosti 2026.
Tarehe ya kukubaliwa: 17 Agosti 2026.
Tarehe ya kuchapishwa: 1 Septemba 2026.
Aina ya chanzo: Makala asilia ya utafiti iliyopitiwa na wataalamu; jaribio la EEG la binadamu linalodhibitiwa, kiolesura cha ubongo–kompyuta cha P300 na utafiti wa uteuzi wa chaneli wa kiheuristiki.
Hali ya preprint: Hakuna nambari tofauti ya preprint iliyotajwa katika PDF ya chanzo na rekodi rasmi za MDPI Version of Record.
Leseni: Creative Commons Attribution (CC BY).
Sampuli: Washiriki 48 wenye afya; wanawake 12, wanaume 36; umri wa 18-26.
Maadili: Idhini ya Guangzhou Maritime University Ethics Committee imeripotiwa. Hakuna nambari tofauti ya protocol/approval iliyotajwa katika chanzo.
Ridhaa yenye taarifa: Ridhaa iliyoandikwa yenye taarifa ilipatikana kutoka kwa washiriki wote.
Vifaa vya EEG: South China Brain Control Technology Co., Ltd. wearable EEG cap; Bluetooth 4.2.
Elektrodi: F3, F4, C3, C4, P3, P4, O1 na O2; elektrodi yenye unyevunyevu; International 10-20 system.
Kiwango cha usampulishaji: 250 Hz.
Impidansi ya mgusano: Chini ya 10 kΩ katika chaneli zote.
Uchakataji wa awali: epoch ya −200 hadi 600 ms, baseline correction ya wastani wa −200 hadi 0 ms, IIR band-pass ya daraja la nne ya 0,1-25 Hz, notch ya 50 Hz na downsampling mara 5.
Utoaji wa vipengele: Dirisha la uchambuzi la 0-600 ms; madirisha madogo manne ya 150 ms; wastani na variansi katika kila dirisha dogo; averaging ya vipengele vya 10 stimulus round kwa lengo lilelile.
Cross-validation: 10-fold; mgawanyo wa takriban 9:1 wa mafunzo-majaribio katika kiwango cha trial.
Decoder: Bayesian Linear Discriminant Analysis (BLDA).
Uteuzi wa chaneli: Genetic Algorithm + tathmini ya BLDA fitness.
Uchanganuzi wa vigezo vya GA: Sababu nne × viwango vitano, muundo wa orthogonal \(L_{25}(5^4)\) wenye michanganyiko 25.
Mipangilio iliyochaguliwa ya GA: Populesheni 30, iteresheni ya juu 10, mutation rate 0,07, elite retention rate 0,05.
Thamani muhimu za GA ambazo hazijaripotiwa: Thamani ya nambari ya adhabu ya chaneli ya fitness \(\lambda\), thamani ya stop patience \(T\) na thamani ya nambari ya global random seed.
Mpangilio wa mwisho wa chaneli: C3, C4 na P4.
Marudio ya chaneli: C3=1,00; C4=0,95; P4=0,90; P3=0,80; F3=0,50; F4=0,40; O2=0,20; O1=0,10.
Muundo rasmi wa jaribio: AB/BA crossover; Group A n=24, Group B n=24; saa 48 za washout kabla ya kubadilisha mfumo.
Offline calibration: trial 20 kwa kila mshiriki; 2 s cue, 16 s stimulus na 2 s rest kwa kila trial; 10 round katika hatua ya stimulus.
Online validation: stimulus round nane; muda wa kutambua lengo moja 16,8 s; 2 s recognition feedback na utekelezaji wa amri ya Unity baada ya makadirio ya BLDA.
Vipimo vya utendaji: Classification Accuracy na Information Transfer Rate.
Mzigo wa mtumiaji: NASA-TLX; Mental Demand, Physical Demand, Temporal Demand, Frustration, Performance na Effort.
Takwimu: paired-sample t-test katika ulinganisho wa mifumo. Chanzo kinaripoti viwango vya p < 0,05, p < 0,01 na p > 0,05 katika uchambuzi mbalimbali.
Dokezo la ulinganisho mwingi: Chanzo hakiripoti mbinu ya multiple-comparison correction, effect size iliyosanifishwa au confidence interval.
Programu: Python 3.9; Unity3D 2022.3 LTS.
Mazingira ya vifaa: Intel Core i7-11700K @ 3.60 GHz; 32 GB RAM; Windows 10 64-bit.
Ufadhili: Utafiti haukupokea ufadhili wa nje.
Upatikanaji wa data: Imeripotiwa kuwa data zinapatikana kwa ombi kutoka kwa corresponding author.
Mgongano wa maslahi: Waandishi wametangaza kuwa hakuna mgongano wa maslahi.
Tamko la matumizi ya akili bandia: Hakuna tamko tofauti kuhusu matumizi ya akili bandia zalishi lililoripotiwa katika sehemu ya mwisho ya matamko ya makala ya chanzo.
Michango ya waandishi: Uundaji wa dhana Jing Xiao na Junhong Luo; mbinu Junhong Luo; programu Junhong Luo na Qiyue Tan; uthibitishaji Jianbin Yu na Jinheng Chen; uchambuzi rasmi Junhong Luo na Jianbin Yu; utafiti Junhong Luo; rasilimali Hui Cao na Jing Xiao; uratibu wa data Jianbin Yu; rasimu ya kwanza Junhong Luo; mapitio/uhariri Jianbin Yu, Jing Xiao na Hui Cao; uoneshaji Jianbin Yu; usimamizi Jing Xiao na Hui Cao; usimamizi wa mradi Jing Xiao; upatikanaji wa ufadhili Jing Xiao na Hui Cao.
Kikomo kikuu cha tafsiri: Utafiti unaonyesha kuwa mpangilio thabiti wa chaneli tatu C3-C4-P4 unaweza kuwa wa vitendo na wenye utendaji wa juu kwa watu wazima vijana 48 wenye afya katika kazi ya P300-VR iliyodhibitiwa. Matokeo hayajathibitishwa moja kwa moja kwa makundi ya wagonjwa wa kliniki, mifumo ya elektrodi kavu, matumizi ya muda mrefu nyumbani au mazingira halisi ya simu yenye mwendo/kelele nyingi.
Kikomo cha tafsiri ya “kalibrasheni”: Mpangilio thabiti wa chaneli unaondoa utafutaji wa chaneli wa subject-specific unaotegemea GA kwa mtumiaji mpya; lakini kwa jaribio rasmi la online, BLDA hufunzwa kwa data za offline calibration za mtu huyo. Kwa hiyo, utafiti hauonyeshi BCI ya calibration-free kabisa.
Dokezo la utendaji ndani ya chanzo: Ingawa abstract/conclusion kwa ujumla zinaeleza kutokuwepo kwa hasara ya utendaji yenye umuhimu, Results za kina za offline zinaripoti tofauti zenye umuhimu za Accuracy na ITR kwa upande wa chaneli nane katika rounds 7-10. Verianla imehifadhi matokeo ya kina kwa uwazi.
Dokezo la ITR ndani ya chanzo: Thamani za ±4,02 na ±3,76 zilizoongezwa kwenye thamani za offline final-round ITR katika sehemu ya Discussion ni sawa na mikengeuko sanifu ya ITR ya online katika Table 3. Kwa kuwa sehemu ya Results ya chanzo hairipoti SD hizi kando kwa thamani za Figure 10 final-round offline, Verianla haizitumii tena kama offline SD.
Dokezo la Table 5 ndani ya chanzo: Mpangilio wa “respectively” uliotumika kwa DFGA na Adaptive Sparse Bayesian katika maandishi ya mjadala haulingani na uhusishaji wa thamani za 87,50 na 88,10 na mbinu katika Table 5.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *