

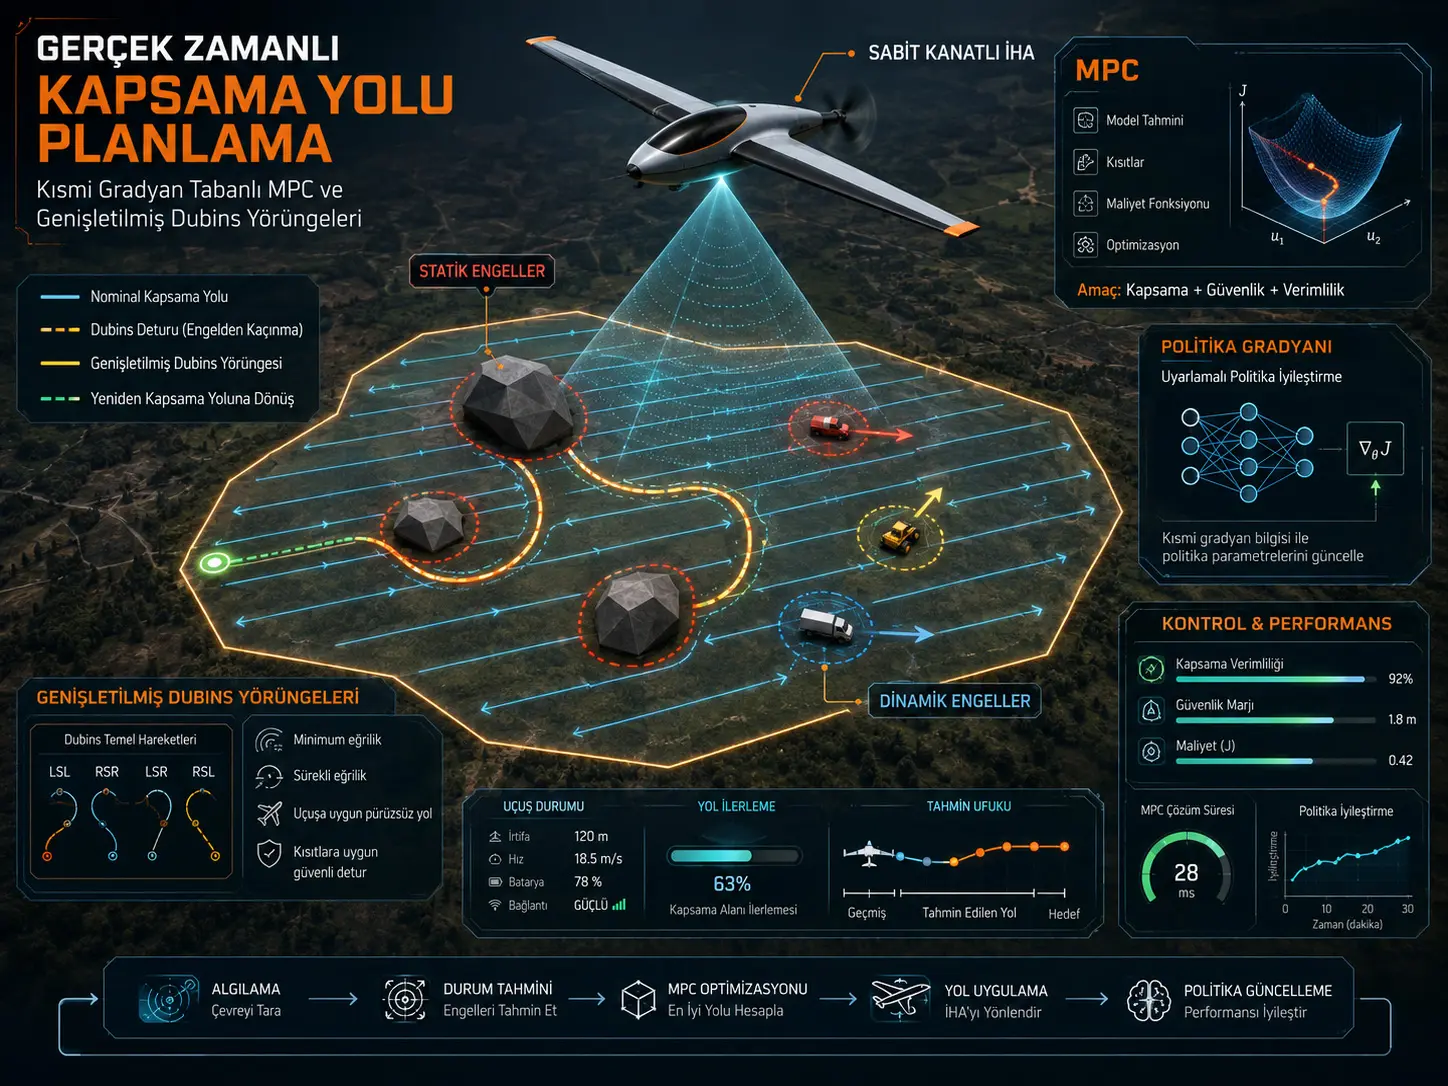
Ин таҳқиқот чаҳорчӯбаи гибридии банақшагирии масир ва идоракуниро таҳия мекунад, ки парвози як ҳавопаймои бесарнишини болсобитро дар минтақае бо монеаҳои эҳтимолан комилан номаълуми статикӣ ва ҳаракаткунанда барои фарогирии тамоми майдон таъмин мекунад. Усул аввал дар марҳилаи офлайн масири номиналии фарогириро ба шакли back-and-forth месозад; дар марҳилаи онлайни парвоз бошад Model Predictive Control (MPC), навсозии идоракунӣ бар асоси Policy Gradient (PG) ва геометрияи Dubins Path-и васеъшуда бо waypoint-ҳои виртуалӣ (ADP)-ро якҷо истифода мебарад. Дар се сенарияи симулятсионӣ PG-MPC-и пешниҳодшуда, махсусан дар муҳитҳои мураккаб, нисбат ба gradient-based NLP-MPC-и классикӣ сарбории максималии ҳисоббарориро кам карда ва сатҳи convergence-и оптимизатсияро баланд бардоштааст. Дар сенарияи сеюми аз ҳама мушкил вақти максималии ҳисоббарорӣ аз 0,9157 сония ба 0,5404 сония поин рафтааст, аммо ҳанӯз ҳам аз ҳадди намунагирии вақти ҳақиқии 0,5 сония, ки худи таҳқиқот муқаррар кардааст, андаке гузаштааст. Натиҷаҳо танҳо ба симулятсия асос меёбанд; дар ин таҳқиқот парвози воқеии UAV-и болсобит ва исботи назариявии устувории closed-loop-и сохтори якҷояи PG-MPC вуҷуд надорад.
Меъмории пешниҳодшуда дуқабата аст. Марҳилаи офлайн мувофиқи майдони диди камера ва геометрияи минтақа масири номиналиро аз sweep line-ҳои параллелӣ месозад, ки тамоми майдони ҳадафро фаро мегиранд. Дар марҳилаи онлайн монеаҳои наве, ки гӯё LiDAR муайян кардааст, ба модели муҳит илова мешаванд; MPC вурудҳои идоракунӣ ва ҳолати пешбинишударо оптимизатсия мекунад; қисми Policy Gradient сиёсати идоракуниро мувофиқи ҳолатҳои нав нав мекунад; усули васеъшудаи Dubins бошад ҳадаф дорад воситаеро, ки барои канорагирӣ аз монеа аз хатти номиналӣ берун шудааст, тавассути масири ҳамвортар ва мутобиқ ба маҳдудиятҳои радиуси гардиши парвози болсобит дубора ба хатти фарогирӣ баргардонад.
Бартарии PG-MPC дар ҳамаи меъёрҳои ҳисоббарорӣ яксон нест. Дар Scenario 1 ва Scenario 2 вақти миёнаи коркард нисбат ба NLP-MPC-и классикӣ каме баландтар аст. Аммо бо зиёд шудани мураккабии муҳит вақтҳои қуллавии коркард ба таври намоён коҳиш меёбанд. Дар Scenario 2 вақти максималӣ аз 0,718 s ба 0,3621 s ва дар Scenario 3 аз 0,9157 s ба 0,5404 s поин рафтааст. Сатҳи convergence дар Scenario 2 аз %92,30 ба %96,87 ва дар Scenario 3 аз %91,919 ба %94,34 афзудааст.
Равиши Augmented Dubins Path ҳадаф дорад нисбат ба Dubins Path-и классикӣ гузаришҳои ҳамвортар ва ба маҳдудиятҳои кинематикии гардиши воситаи болсобит мувофиқтар фароҳам кунад. Аммо ин бартарии геометрӣ ройгон нест: дар Ҷадвали 4 ADP дар ҳар се сенария нисбат ба DP-и классикӣ масофаи умумии каме дарозтар ва execution time-и умумии каме бештар тавлид кардааст. Аз ин рӯ, таҳқиқот хулосаи «ADP дар ҳар ҳолат роҳро кӯтоҳ мекунад»-ро дастгирӣ намекунад.
Аз дидгоҳи Türkiye: Ҳузури муҳаққиқони Adana Alparslan Türkeş Science and Technology University ва Gebze Technical University дар гурӯҳи таҳқиқотӣ ва дастгирии кор аз ҷониби TÜBİTAK намунаи мушаххасе аз доираи корҳои маҳаллии академикӣ дар идоракунӣ ва банақшагирии масир барои системаҳои автономии болсобит пешниҳод мекунад. Равиши таҳияшуда аз ҷиҳати назариявӣ метавонад барои мониторинги муҳити зист дар минтақаҳои васеъ, сканкунии баъди офат ё вазифаҳои шабеҳи фарогирӣ таҳқиқ шавад. Бо вуҷуди ин, ҳамаи натиҷаҳои мавҷуда симулятсионӣ мебошанд; муваффақияти вазифа дар фазои воқеии ҳавоии Türkiye, бо сенсорҳои воқеӣ ё дар платформаи воқеии болсобит бо ин таҳқиқот исбот нашудааст.
Таҳқиқот кадом мушкилро ҳал кардан мехоҳад?
Coverage Path Planning (CPP) масъалаи сохтани масирест, ки роботи ҳавоӣ тавассути он тамоми минтақаи ҳадафи дастрасро мушоҳида кунад ё аз болои он гузарад. Дар UAV-ҳои болсобит ин масъала нисбат ба системаҳои multirotor мушкилтар аст, зеро восита наметавонад дар ҷояш гардиш кунад ва маҳдудиятҳои кинематикии вобаста ба радиуси минималии гардиш ва ҳаракати доимии пешрав дорад.
Мушкилоти дуюме, ки таҳқиқот ҳадаф мегирад, он аст, ки муҳит аз пеш пурра маълум нест. Масирҳои классикии back-and-forth метавонанд аз ҷиҳати геометрӣ тамоми минтақаро скан кунанд; аммо агар ҳангоми парвоз бино, минтақаи мамнӯъ ё воситаи ҳавоии ҳаракаткунандае пайдо шавад, ки пештар дар харита набуд, масир бояд ба таври маҳаллӣ бозсозӣ шавад.
Аз ин рӯ, таҳқиқот мекӯшад се талабро дар як чаҳорчӯбаи математикӣ муттаҳид кунад:
- ҳифзи якпорчагии фарогирии минтақа,
- риояи маҳдудиятҳои кинематикӣ ва идоракунии воситаи болсобит,
- вокуниши онлайн ба монеаҳои нави статикӣ ва динамикӣ.
Чаро чаҳорчӯба ду марҳила дорад?
Система аз ду фазаи асосии офлайн ва онлайн иборат аст. Дар марҳилаи офлайн масири идеалии номиналии фарогирӣ бидуни ба ҳисоб гирифтани монеаҳо омода мешавад. Дар марҳилаи онлайн восита ҳангоми пайравӣ аз ин масир бар асоси маълумоти сенсор монеаҳои навро муайян мекунад, қарорҳои кӯтоҳмуддати идоракуниро нав мекунад ва ҳангоми зарурат аз масири номиналӣ хориҷ шуда, дубора ба ҳамон тартиби фарогирӣ бармегардад.
Шакли 4, ки меъмории системаи таҳқиқотро нишон медиҳад, ин ҷудокуниро равшан нишон медиҳад. Дар тарафи чап муайян кардани сарҳади минтақа, сохтани sweep-line ва масири номиналии back-and-forth; дар тарафи рост feature detection/localization, MPC, policy update ва ҷузъҳои Augmented Dubins Path ҷой доранд.
Масири номиналии фарогирӣ чӣ гуна сохта мешавад?
Минтақаи ҳадаф барои кам кардани мураккабии ҳисоббарорӣ ҳамчун полигони конвекс бо канораҳои номунтазам моделсозӣ шудааст. Ҳангоми муайян кардани самти sweep масофа аз ҳар канори полигон то дуртарин қулла ҳисоб мешавад; аз байни паҳноҳои максималии номзад хурдтаринаш барои муайян кардани самти хатҳои фарогирӣ истифода мешавад.
Масири ҳосилшуда сохтори классикии zigzag ё back-and-forth аз хатҳои параллелии сканкунӣ мебошад. Нуқтаи охири ҳар sweep segment ҳамчун истиноди оғози сегменти навбатӣ истифода мешавад.
Камера ба фосилаи хатҳои фарогирӣ чӣ гуна таъсир мерасонад?
Таҳқиқот фосилаи байни хатҳои ҳамсояи парвозро бо кунҷи диди камера, overlap-и тасвир ва баландии парвоз пайваст мекунад. Дар манбаъ фосилаи хатҳо чунин дода шудааст:
\[ d= 2\frac{A(1-v)}{\tan(\mu)} \]
Дар ин ҷо \(A\) баландии парвоз, \(v\) нисбати зарурии overlap-и тасвир ва \(\mu\) нимкунҷи майдони диди амудии камера мебошад. Verianla формулаи манбаъро бидуни тағйир пешниҳод мекунад.
Дар симулятсия чӣ гуна платформаи болсобит фарз шудааст?
| Параметр | Қимати манбаъ |
|---|---|
| Массаи UAV | 3,9 kg |
| Суръати минималии cruise | 10 m/s |
| Баландии cruise | 100 m |
| Endurance | 460 дақиқа |
| Радиуси минималии гардиш | 28 m |
| Фосилаи фокусии камера | 2,75 mm |
| Сенсори камера | 6,45 × 3,63 mm |
| Ҳалли камера | 11,9 MP |
| FoV-и уфуқӣ / амудӣ | 102° / 67° |
| Масофаи максималии LiDAR | 60 m |
| Масофаи минималии LiDAR | 0,05 m |
| LiDAR FoV | 70° |
| Басомади сканкунии LiDAR | 10 Hz |
Ин қиматҳо параметрҳои агент ва системаи дарки симулятсия мебошанд; дар таҳқиқот озмоиши парвози воситаи воқеии ҳавоӣ бо чунин хусусиятҳо анҷом дода нашудааст.
Модели ҳаракати UAV-и болсобит чӣ гуна таъриф шудааст?
Кинематикаи умумии сеченака дар манбаъ чунин дода шудааст:
\[ \dot{x}=V\cos\theta\cos\psi \]
\[ \dot{y}=V\cos\theta\sin\psi \]
\[ \dot{z}=V\sin\theta \]
\[ \dot{\theta}=q \]
\[ \dot{\psi}=r= \frac{g\tan\phi} {V\cos\theta} \]
.
Азбаски дар таҳқиқот баландии парвоз доимӣ ҳисобида шудааст, \(\dot{z}=0\), \(\theta=0\) ва \(q=0\) гирифта шуда, масъалаи идоракунӣ ба ҳаракати ҳамворӣ коҳиш дода шудааст. Ин соддасозӣ модели пурраи аэродинамикии парвози воқеии болсобитро бо шаш дараҷаи озодӣ ифода намекунад.
Сенарияҳои муҳит чӣ гуна сохта шуданд?
Дар таҳқиқот се муҳити гуногуни симулятсионӣ истифода шудааст:
- Scenario 1: муҳити асосӣ бидуни монеаи статикӣ ё ҳаракаткунанда.
- Scenario 2: монеаҳои полигоналии статикии пешакӣ номаълум ва як монеаи ҳаракаткунанда.
- Scenario 3: якчанд монеаи динамикӣ дар ҳамон минтақа барои зиёд кардани мураккабии муҳит.
Монеаҳои ҳаракаткунанда дар траекторияҳои пӯшида бо суръати доимии 20 m/s ҳаракат мекунанд. Монеаҳои статикӣ ҳамчун полигонҳои ҳам конвекс ва ҳам non-convex сохта шудаанд.
Дар Шакли 3, дар сенарияи дуюм монеаҳои полигоналӣ ва як монеаи динамикӣ, дар сенарияи сеюм бошад чанд монеаи динамикӣ дар траекторияҳои гуногуни пӯшида нишон дода шудаанд.
Монеаҳо ҳангоми парвоз чӣ гуна муайян мешаванд?
Дар сохтори симулятсионӣ LiDAR маълумоти масофа/depth-и муҳитро тавлид мекунад. Шакли 6 дар паҳлуи тасвири намунавии муҳит харитаи pixel-wise relative-depth-ро нишон медиҳад. Ҳангоми муайян шудани монеаи нав маълумоти геометрии он ба модели муҳит илова шуда, маҳдудиятҳои MPC нав карда мешаванд.
Аммо ин натиҷаҳои LiDAR маълумоти сенсории сабтшуда дар парвози воқеӣ нестанд; онҳо баромади perception model-и муҳити симулятсионӣ мебошанд.
Вазифаи MPC чист?
Model Predictive Control дар ҳар қадами идоракунӣ ҳолатҳои ояндаро дар prediction horizon-и маҳдуд пешбинӣ намуда, силсилаи мувофиқтарини идоракуниро аз нав ҳисоб мекунад. Дар таҳқиқот системаи пайваста бо фарзияи zero-order hold дискретӣ карда шуда, модели фазои ҳолат чунин сохта шудааст:
\[ X_{k+1}=A_kX_k+B_ku_k \]
\[ Y_k=C_kX_k \]
.
Дар ҳолати planar вектори ҳолат ҷузъҳои мавқеъ ва суръатро, вектори идоракунӣ бошад вурудҳои идоракунии самтҳои x ва y-ро дар бар мегирад.
Оптимизатсия ҳамзамон чиро кам кардан мехоҳад?
CPP ҳамчун constrained Multi-Objective Optimization Problem формулировка шудааст. Функсияи хароҷоти якҷоя дар манбаъ чунин аст:
\[ J= \sum_{k=1}^{N} \left\{ \|p_k-p_{ref}\| + Q_u\|u_k\| + Q_d\|d(p_k,Z)\| \right\} \]
.
Се ҷузъи асосӣ:
- масофа байни мавқеи ҷорӣ ва нуқтаи ҳадаф/reference,
- кӯшиши идоракунӣ,
- инҳирофи cross-track аз хатти номиналии zigzag-и фарогирӣ.
Дар таҳқиқот вазни path deviation \(Q_d=5\) ва вазни control-effort \(Q_u=2\) интихоб шудааст. Ҳамин тавр, пойбандӣ ба масири номиналии фарогирӣ нисбат ба хурд нигоҳ доштани фармони идоракунӣ вазни бештар дорад.
Бехатарӣ аз монеа чӣ гуна ба маҳдудияти математикӣ табдил дода мешавад?
Монеаҳои полигоналии статикӣ бо истифода аз равиши Minkowski sum тавре васеъ карда мешаванд, ки андозаи физикии восита ва фосилаи бехатариро дар бар гиранд. Минтақаи бехатарии васеъшуда чунин таъриф шудааст:
\[ O_i^{aug} = \left\{ P_i^{aug}\in\mathbb{R}^2 \mid dist(P_i^{aug},O_i)\leq\delta \right\} \]
.
Дар параметрҳои оптимизатсия safety margin-и монеаи статикӣ 50 m, радиуси монеаи динамикӣ 30 m ва minimum separation distance 8 m мебошад.
Эзоҳи мутобиқати муодила: Ифодаи ҷаримаи монеаи динамикӣ дар Муодилаи (11)-и манбаъ бо ифодаи монеаи динамикӣ дар Муодилаи (14), ки баъдтар масъалаи якҷояи оптимизатсияро ҷамъбаст мекунад, дар як шакли математикӣ нест. Verianla ин фарқро пинҳонӣ ба як муодила табдил намедиҳад.
Қисми Policy Gradient чӣ гуна кор мекунад?
Дар таҳқиқот PG дар тамоми матни метод Policy Gradient-ро ифода мекунад. Ҳолати система ба тақсимоти эҳтимолии панҷ фармони алоҳидаи ҳаракат табдил дода мешавад:
- ба чап гард,
- рост ҳаракат кун,
- ба рост гард,
- суръат гир,
- суст шав.
Сиёсат бо approximation-и хаттии функсия чунин таъриф мешавад:
\[ h_u(X)=\eta(X)^T\vartheta_u \]
ва бо истифода аз SoftMax эҳтимолҳои амал:
\[ Q(u|X)= \frac{e^{h_u(X)}} {\sum_{u'}e^{h_{u'}(X)}} \]
ҳисоб карда мешаванд.
Чаро Critic илова шудааст?
Азбаски дар навсозиҳои софи Policy Gradient дисперсияи сигнали reward/cost метавонад баланд бошад, дар таҳқиқот value-function approximator-и хаттӣ истифода шудааст:
\[ V(X_k)=w^T\eta(X_k) \]
Хатои Temporal-Difference:
\[ \delta_k= J_k+\lambda V(X_{k+1})-V(X_k) \]
ҳисоб карда мешавад.
Параметри сиёсат бошад бо қоидаи:
\[ \vartheta_u \leftarrow \vartheta_u+ \alpha\delta_k \eta(X_k) \left( I(u_k)-Q(u_k|X_k) \right) \]
нав мешавад.
Муҳаққиқон қайд мекунанд, ки ин раванди омӯзиш бидуни ниёз ба маҷмӯи маълумоти қаблан ҷамъшуда ё experience replay ба таври онлайн иҷро мешавад.
Augmented Dubins Path аз Dubins-и классикӣ чӣ фарқ дорад?
Масъалаи классикии Dubins барои воситаи танҳо ба пеш ҳаракаткунанда бо радиуси доимии минималии гардиш комбинатсияҳои мувофиқи каҷҳоро байни ду конфигуратсия истифода мебарад. Таҳқиқот бо илова кардани waypoint-и виртуалӣ оилаи траекторияҳои имконпазирро аз шаш навъи классикӣ ба даҳ навъ васеъ мекунад:
\[ D= \{ LSL,RSR,RSL,LSR,RLR,LRL, RLSLR,LRSRL,SLR,SRL \} \]
Аз роҳҳои нав RLSLR ва LRSRL чор каҷ + як сегменти рост; SLR ва SRL бошад ду каҷ + як сегменти рост доранд.
Шакли 7 геометрияи ин waypoint-ҳои виртуалиро нишон медиҳад, ки оғози гардишро дертар карда ва тағйири самтҳоро дар минтақаҳои маҳдудтар наздики waypoint анҷом медиҳад.
Чаро ADP ҳатман кӯтоҳтар нест?
Натиҷаҳои худи таҳқиқот нишон медиҳанд, ки ҳадафи асосии ADP минималӣ кардани масофаи мутлақ нест. Waypoint-ҳои иловагии виртуалӣ ва гузаришҳои аз ҷиҳати кинематикӣ мувофиқтар метавонанд афзоиши хурди масофа ва execution-time ба вуҷуд оранд.
| Smoothing | Scenario 1 вақт (s) | Scenario 2 вақт (s) | Scenario 3 вақт (s) | Scenario 1 масофа (m) | Scenario 2 масофа (m) | Scenario 3 масофа (m) |
|---|---|---|---|---|---|---|
| DP | 27.223 | 27.447 | 27.990,30 | 272.233,4 | 274.474,5 | 279.903,1 |
| ADP | 27.294 | 27.532 | 28.127,72 | 272.937,3 | 275.325,7 | 281.277,21 |
Натиҷаи ҷадвал нишон медиҳад, ки ADP дар ҳар се сенария нисбат ба DP-и классикӣ масофа ва вақти каме бештар тавлид кардааст, аммо аз рӯйи арзёбии муаллифон гузаришҳои маҳаллии ҳамвортар ва аз ҷиҳати кинематикӣ иҷрошавандаро фароҳам кардааст.
Параметрҳои омӯзиш чӣ гуна интихоб шуданд?
Policy learning rate ва discount factor мустақиман ҳамчун як қимати ягона фарз нашудаанд; онҳо тавассути sensitivity analysis бар асоси 100 иҷрои симулятсия арзёбӣ шудаанд.
Барои learning rate:
\[ 0.0001,\;0.0005,\;0.001,\;0.005,\;0.01 \]
ва барои discount factor:
\[ 0.90,\;0.93,\;0.96,\;0.99 \]
санҷида шудаанд.
Харитаҳои коррелятсионии Шакли 9 нишон медиҳанд, ки learning rate-ҳои паст–миёна ва минтақаи discount factor-и 0,93–0,96 байни cost ва computation time тавозуни мувофиқтар медиҳад. Дар модели ниҳоӣ learning rate 0,001 ва discount factor 0,96 интихоб шудааст.
Параметрҳои асосии оптимизатсия дар симулятсия кадоманд?
| Параметр | Қимат | Шарҳ |
|---|---|---|
| Sampling time | 0,5 s | Фосилаи навсозии идоракунии MPC |
| Prediction horizon | 100 | Уфуқи пешбинии MPC |
| Policy learning rate | 0,001 | Навсозии PG |
| Discount factor | 0,96 | Вазни таъсири ояндаи TD |
| Minimum separation | 8 m | Ҷудоии бехатарии монеа / агент |
| Ҳадди поёнии Control input | −2 m/s² | Minimum acceleration command |
| Ҳадди болоии Control input | 2 m/s² | Maximum acceleration command |
| Шумораи монеаҳои статикӣ | 4 | Монеаҳои полигоналӣ |
| Obstacle safety margin | 50 m | Фосилаи buffer-и монеаи статикӣ |
| Dynamic obstacle radius | 30 m | Модели монеаи динамикӣ |
| Waypoint acceptance threshold | 20 m | Ҳадди гузариш ба сегменти навбатӣ |
| Control effort weight | 2 | \(Q_u\) |
| Path deviation weight | 5 | \(Q_d\) |
Оё PG-MPC дар вақти ҳақиқӣ кор мекунад?
Дар Scenario 2 меъёри вақти ҳақиқии худро иҷро мекунад; дар Scenario 3 бошад ҳолати бадтарин аз ҳадди 0,5 сония мегузарад. Муҳаққиқон мегӯянд, ки барои real-time ҳисоб шудани як даври идоракунӣ маҷмӯи корҳои perception, optimization ва control набояд аз sampling interval зиёд бошад. Sampling interval 0,5 сония аст.
Дар Шакли 10 барои Scenario 2 максималии computation time тақрибан 0,36 сония аст. Ҷадвали 4 ин қиматро 0,3621 сония медиҳад ва он аз ҳадди 0,5 сония паст аст.
Аммо барои Scenario 3 қимати максималии PG-MPC 0,5404 сония мебошад. Аз ин рӯ, натиҷаи “real-time feasibility”-и таҳқиқот набояд чунин фаҳмида шавад, ки дар сенарияи душвортарин ҳамаи даврҳои идоракунӣ зери 0,5 сония мондаанд.
Натиҷаҳои пурраи NLP-MPC-и классикӣ ва PG-MPC кадоманд?
| Меъёр | NLP-MPC S1 | NLP-MPC S2 | NLP-MPC S3 | PG-MPC S1 | PG-MPC S2 | PG-MPC S3 |
|---|---|---|---|---|---|---|
| Миёнаи computation time (s) | 0,095 | 0,1618 | 0,1898 | 0,128 | 0,2000 | 0,1891 |
| Максималии computation time (s) | 0,2295 | 0,7180 | 0,9157 | 0,2549 | 0,3621 | 0,5404 |
| Optimization convergence rate (%) | 99,993 | 92,30 | 91,919 | 99,993 | 96,87 | 94,34 |
| Constraint violation occurrence (%) | 0 | 5,67 | 3,2938 | 0 | 4,22 | 3,2864 |
Ҷадвал нишон медиҳад, ки бартарии усули пешниҳодшуда махсусан дар сенарияҳои мураккаб маҳдуд кардани сарбории қуллавии коркард ва зиёд кардани convergence rate мебошад. Аммо PG-MPC дар Scenario 1 ва 2 аз рӯйи вақти миёнаи ҳисоббарорӣ аз NLP-MPC-и классикӣ тезтар нест.
Constraint violation дар Scenario 2 аз %5,67 ба %4,22 кам мешавад, дар Scenario 3 бошад аз %3,2938 ба %3,2864 танҳо тағйири хеле хурд дорад. Манбаъ ин натиҷаҳоро improved constraint satisfaction шарҳ медиҳад; аммо санҷиши алоҳидаи аҳамияти оморӣ гузориш нашудааст.
Натиҷаҳое, ки таҳқиқот дастгирӣ мекунад
- Back-and-forth CPP, MPC, навсозии онлайни Policy Gradient ва augmented Dubins smoothing дар як чаҳорчӯбаи симулятсионӣ якҷо истифода шудаанд.
- Сохтори пешниҳодшуда дар симулятсияҳои дорои монеаҳои статикӣ ва динамикӣ метавонад ба таври маҳаллӣ аз роҳи номиналии фарогирӣ хориҷ шуда, дубора ба маршрут баргардад.
- PG-MPC дар Scenario 2 ва Scenario 3 нисбат ба NLP-MPC-и классикӣ вақти максималии ҳисоббарориро кам кардааст.
- Дар Scenario 2 convergence rate аз %92,30 ба %96,87 афзудааст.
- Дар Scenario 3 convergence rate аз %91,919 ба %94,34 афзудааст.
- Дар Scenario 2 constraint violation occurrence аз %5,67 ба %4,22 коҳиш ёфтааст.
- Augmented Dubins дар тасвирҳои симулятсия нисбат ба Dubins-и классикӣ гузаришҳои маҳаллии ҳамвортар ва аз ҷиҳати кинематикӣ иҷрошавандаро тавлид мекунад.
- Дар Scenario 2 вақти максималии коркарди PG-MPC 0,3621 s буда, аз давраи намунагирии 0,5 s поён мондааст.
Натиҷаҳое, ки таҳқиқот дастгирӣ намекунад ё насанҷидааст
- Усул дар UAV-и воқеии болсобит бо озмоиши парвоз тасдиқ нашудааст.
- Кори система дар шароити садои воқеии LiDAR, таъхири сенсор ё талафи пакет чен нашудааст.
- Муваффақияти парвози физикӣ дар шароити шамоли воқеӣ ва atmospheric disturbance нишон дода нашудааст.
- Сатурасияи воқеии актуатор ва номуайянии модели аэродинамикӣ дар сахтафзор санҷида нашудааст.
- Барои устувории closed-loop-и системаи якҷояи PG-MPC исботи rigorозии назариявӣ дода нашудааст.
- Нишон дода нашудааст, ки дар Scenario 3 ҳамаи даврҳои идоракунӣ аз ҳадди 0,5 сонияи real-time поён мемонанд; вақти максималӣ 0,5404 s аст.
- Нишон дода нашудааст, ки ADP нисбат ба роҳи классикии Dubins маршрути кӯтоҳтар медиҳад; дар ҳар се сенария масофаи ҷамъшуда каме бештар аст.
- Нишон дода нашудааст, ки PG-MPC дар ҳар ҳолат нисбат ба NLP-MPC-и классикӣ computation time-и миёнаи камтар медиҳад.
- Исбот нашудааст, ки натиҷаҳои симулятсияро ба вазифаҳои воқеии офат, кишоварзӣ ё мониторинги муҳити зист бо ҳамон рақамҳои иҷроиш умумӣ кардан мумкин аст.
- Таҳқиқот модели пурраи аэродинамикии fixed-wing бо шаш дараҷаи озодиро истифода намекунад; масъалаи идоракунӣ ба модели planar бо баландии доимӣ коҳиш дода шудааст.
Усул ва Натиҷаҳои Таҳқиқот
Муҳити нармафзор ва ҳисоббарорӣ
Чаҳорчӯба дар муҳити MATLAB R2024b татбиқ шудааст. Компютере, ки симулятсияҳо дар он иҷро шудаанд, дорои:
- протсессори 4,7 GHz Intel Core i7,
- 16 GB RAM,
- NVIDIA RTX 3070 GPU
мебошад. Манбаъ мавҷудияти GPU-ро дар компютер нишон медиҳад; аммо алоҳида нишон намедиҳад, ки ҳамаи ҳисобҳои оптимизатсия дар GPU суръат бахшида шудаанд.
Алгоритми банақшагирии офлайн
Algorithm 1 масофаро байни ҳар канори полигони конвекс ва ҳамаи қуллаҳои он ҳисоб мекунад. Барои ҳар канор дуртарин vertex интихоб мешавад ва хурдтарини ин масофаҳои максималӣ ҳамчун direction sweep orientation истифода мешавад.
Бо истифода аз паҳноии camera footprint ва талаботи image overlap хатҳои параллелии sweep дар минтақа ҷойгир мешаванд. Масири номиналӣ ҳадаф дорад бе дохил кардани монеаи номаълум фарогирии пурраро таъмин кунад.
Даври онлайни PG-MPC
Системаи онлайн дар ҳар қадами идоракунӣ асосан амалҳои зеринро анҷом медиҳад:
- Ҳолати ҷорӣ \(X_k\) гирифта мешавад.
- Монеаҳои статикӣ ва ҳаракаткунандаи муайяншуда ба модели муҳит илова мешаванд.
- Хусусиятҳои сиёсат ҳисоб мешаванд.
- Бо SoftMax эҳтимолҳои control action сохта мешаванд.
- Вуруди идоракунӣ муайян мешавад.
- Ҳолати нав пешбинӣ мешавад.
- Хароҷоти фаврӣ ҳисоб мешавад.
- TD error ёфта мешавад.
- Параметри Critic нав мешавад.
- Параметрҳои Policy нав мешаванд.
- Роҳи маҳаллӣ бо геометрияи Augmented Dubins ҳамвор карда мешавад.
Таҳқиқот ин даврро online learning меномад ва мегӯяд, ки сиёсати пурра пешакӣ омӯзонидашударо талаб намекунад.
Сохтори бисёрришта
Татбиқи PG-MPC ҳамчун multi-threaded architecture моделсозӣ шудааст, ки кори ҳамзамони модулҳои optimization, perception ва navigation-ро дастгирӣ мекунад. Ҳадаф тақрибан инъикос кардани сохтори вазифаҳои асинхронӣ дар компютери воқеии парвоз аст.
Аммо ин меъморӣ Hardware-in-the-Loop ё flight-test benchmark-и иҷрошуда дар компютери физикии avionics нест.
Scenario 1 чиро нишон медиҳад?
Сенарияи асосии бидуни монеа пайравии framework аз нақши номиналии фарогириро месанҷад. Ҳам дар optimizer-и классикӣ ва ҳам пешниҳодшуда convergence rate %99,993 ва constraint violation %0 мебошад.
Дар ин ҳолати осонтарин вақти максималии ҳисоббарории PG-MPC 0,2549 s аст, ки аз 0,2295 s-и NLP-MPC каме баландтар мебошад. Пас навсозии PG дар муҳити осон бартарии мустақими суръат намедиҳад.
Scenario 2 чиро нишон медиҳад?
Бо илова шудани монеаҳои статикӣ ва ҳаракаткунанда максималии computation time-и classical NLP-MPC то 0,718 s боло меравад, дар ҳоле ки PG-MPC дар 0,3621 s мемонад.
Convergence rate дар ҳамин сенария аз %92,30 ба %96,87 ва constraint violation аз %5,67 ба %4,22 тағйир меёбад.
Ин сенария яке аз равшантарин бартариҳои таҳқиқотро аз ҷиҳати “peak computation burden” нишон медиҳад.
Scenario 3 чиро нишон медиҳад?
Сенарияи сеюм бо монеаҳои сершумори динамикӣ душвортарин шароит аст. Вақти максималии ҳисоббарории NLP-MPC-и классикӣ 0,9157 s ва PG-MPC 0,5404 s мебошад.
Манбаъ ин тағйирро тақрибан %41,1 коҳиш ҳисоб мекунад. Гарчанде PG-MPC бартарии бузурги вақти қуллавӣ медиҳад, қимати 0,5404 s аз sampling interval-и 0,5 s болотар аст. Аз ин рӯ, аз рӯйи меъёри сахти real-time дар худи таҳқиқот як ҳолати worst-case аз ҳад гузаштан мавҷуд аст.
Convergence rate аз %91,919 ба %94,34 баланд шуда, constraint violation occurrence бошад аз %3,2938 ба %3,2864 танҳо андаке коҳиш ёфтааст.
Паёми асосии Шакли 10 чист?
Шакли 10 нишон медиҳад, ки дар наздикии баъзе минтақаҳои монеадор computation time ва objective cost баланд мешаванд. Инҳо ҷойҳое мебошанд, ки controller ба ҷойи пайравии мустақим аз роҳи номиналӣ ба collision avoidance ва feasibility афзалият медиҳад.
Доимӣ набудани сарбории ҳисоббарорӣ дар тамоми муҳит инчунин нишон медиҳад, ки чаро worst-case time аз вақти миёна муҳимтар аст. Дар барномаи real-time flight-control метрикае, ки deadline-и даври идоракуниро муайян мекунад, аксаран вақти қуллавии ҳисоббарорӣ аст, на миёна.
Шакли 11 чиро нишон медиҳад?
Шакли 11 масирҳои MPC-ADP ва MPC-DP-ро дар се сенария паҳлу ба паҳлу муқоиса мекунад. Дар муҳити бидуни монеа ҳар ду сохтор ба nominal sweep pattern наздик ҳаракат мекунанд. Бо илова шудани монеаҳои статикӣ ва динамикӣ инҳирофҳои маҳаллӣ ба вуҷуд меоянд.
Дар минтақаҳои калонкардашуда тадриҷитар будани гардишҳои ADP нисбат ба DP-и классикӣ асоси визуалии шарҳи “smoother and dynamically feasible”-и муаллифон аст.
Аммо Ҷадвали 4-и ҳамин таҳқиқот нишон медиҳад, ки ADP масофаи умумиро дар ҳар се сенария каме зиёд мекунад. Ҳамвории намоён дар шакл ва дарозии умумии роҳ як меъёри иҷроиш нестанд.
Trade-off-и асосии усул чист?
Маълумоти таҳқиқот натиҷаи ягонаи «алгоритм аз ҳар ҷиҳат беҳтар аст»-ро намедиҳад. Усули пешниҳодшуда махсусан дар муҳитҳои мураккаби монеадор аз ҷиҳати peak optimisation time ва convergence бартарӣ нишон медиҳад; аммо online policy update дар баъзе сенарияҳо сарбории миёнаи ҳисоббарориро зиёд мекунад.
Ба ҳамин монанд, геометрияи Augmented Dubins гузаришҳои ҳамвортар ва аз ҷиҳати кинематикӣ иҷрошавандаро таъмин мекунад, аммо каме масофаи иловагӣ ва execution time меорад.
Пас trade-off-и муҳандисии асосии чаҳорчӯба на танҳо минималӣ кардани вақти ҳисоббарорӣ ё масофа, балки афзалият додан ба комбинатсияи пайвастагии фарогирӣ + иҷрошавандагии кинематикӣ + мутобиқшавӣ ба монеаҳои динамикӣ мебошад.
Ҷиҳатҳои қавии таҳқиқот
- Банақшагирии фарогирӣ ва идоракунии онлайнро дар як сохтори оптимизатсия муттаҳид мекунад.
- Рафтори минималии гардиши воситаи болсобитро бо геометрияи Dubins ошкоро ба ҳисоб мегирад.
- Монеаҳои статикии номаълум ва динамикиро дар як чаҳорчӯба баррасӣ мекунад.
- Policy Gradient-ро мустақим ба навсозии MPC ҳамгиро мекунад.
- Барои learning rate ва discount factor sensitivity analysis анҷом медиҳад.
- Бо NLP-MPC-и классикӣ дар шароити якхела муқоисаи миқдорӣ медиҳад.
- Average ва maximum computation time-ро алоҳида гузориш мекунад.
- Меъёрҳои convergence ва constraint violation-ро якҷо пешниҳод мекунад.
- Хароҷоти DP ва ADP smoothing-ро алоҳида муқоиса мекунад.
Маҳдудиятҳои асосии таҳқиқот
- Ҳамаи validation симулятсионӣ аст.
- Озмоиши парвози fixed-wing UAV-и физикӣ вуҷуд надорад.
- Sensor noise ва communication delay-и воқеӣ санҷида нашудааст.
- Шамол ва atmospheric disturbance-и воқеӣ ба кори оянда гузошта шудаанд.
- Номуайянии актуатор ва рафтори deadline-и flight-computer-и воқеӣ санҷида нашудааст.
- Модел равиши planar dynamics-и баландии доимӣ ва дақиқии пастро истифода мебарад.
- Таҳлили назариявии rigorозии устувории closed-loop PG-MPC анҷом дода нашудааст.
- Worst-case time-и Scenario 3 аз давраи идоракунии 0,5 s болотар аст.
- ADP ҳарчанд кам бошад ҳам масофаи иловагӣ ва execution time тавлид мекунад.
- Истилоҳи “Partial Gradient” дар номи таҳқиқот бо “Policy Gradient” дар дохили метод мувофиқ нест.
Таҳқиқоти оянда кадом масъалаҳоро бояд баррасӣ кунанд?
Муаллифон татбиқи усулро дар платформаҳои воқеии болсобит ҳамчун қадами муҳимми оянда нишон медиҳанд. Пешниҳод мешавад, ки ин validation халалҳои шамол, sensor noise, communication delays ва actuator uncertainties-ро дар бар гирад.
Таҳқиқот инчунин ошкоро қабул мекунад, ки rigorous closed-loop stability analysis-и сохтори якҷояи PG-MPC анҷом дода нашудааст ва онро ҳамчун самти кори назариявии оянда муайян мекунад.
Илова бар ин, пешниҳод мешавад, ки усулҳои robust nonlinear control ба монанди Sliding Mode Control барои баланд бардоштани disturbance rejection ва тобоварӣ ба model uncertainty ба чаҳорчӯба ҳамгиро карда шаванд.
Эзоҳи Манбаъ ва Усул
Номи пурраи аслии таҳқиқот: Real-Time Coverage Path Planning for Fixed-Wing Aerial Robots Using Partial Gradient-Based MPC and Augmented Dubins Trajectories
Муаллифон: Mohammad Khaneghaei; Benyamin Ebrahimi; Davood Asadi; Onder Tutsoy; Seyed-Yaser Nabavi-Chashmi; Hassan Haghighi.
Тартиби муаллифон: Тартиби аслии манбаъ айнан нигоҳ дошта шудааст.
Саҳми баробар/муаллифи аввали баробар: Дар манбаъ нишон дода нашудааст.
Муаллифи масъул: Davood Asadi.
Муассисаҳо: Department of Electrical Engineering, Adana Alparslan Turkeş Science and Technology University, Adana, Türkiye; Department of Aerospace Engineering, Adana Alparslan Turkeş Science and Technology University, Adana, Türkiye; College of Arts, Technology and Environment, University of the West England, Bristol, UK; Department of Aeronautical Engineering, Gebze Technical University, Gebze, Türkiye; Laboratoire d’Informatique et Systèmes, Aix-Marseille University, Marseille, France.
Эзоҳи affiliation: Affiliation-и сеюми манбаъ ба шакли “University of the West England” дода шудааст. Verianla сабти библиографиро ба ҳамон шакле, ки дар манбаъ ҳаст, нигоҳ дошта ва номи муассисаро пинҳонӣ бознависӣ накардааст.
Эзоҳи истилоҳоти унвон: Унвони аслӣ ибораи “Partial Gradient-Based MPC”-ро истифода мебарад. Усули PG дар матни асосии мақола бошад ҳамчун “Policy Gradient” таъриф шуда ва муодилаҳо мувофиқи ҳамин равиш сохта шудаанд. Verianla унвони аслиро тағйир надодааст.
Навъи манбаъ: Мақолаи илмии рецензияшуда; таҳияи алгоритм ва validation-и муқоисавии симулятсионӣ.
Маҷалла: Aerospace
Ношир: MDPI
Ҷилд / шумора / рақами мақола: 13(8), 713
Санаи нашр: 9 августи 2026
DOI: 10.3390/aerospace13080713
Пайванди расмии нашр: https://www.mdpi.com/2226-4310/13/8/713
Пайванди DOI: https://doi.org/10.3390/aerospace13080713
Ҳолати рецензия: Таҳқиқот мақолаи илмии нашршуда дар маҷаллаи рецензияшавандаи Aerospace мебошад.
Литсензия: Литсензияи дастраси кушоди Creative Commons Attribution (CC BY).
Маблағгузорӣ: Таҳқиқот аз ҷониби Türkiye Bilimsel ve Teknolojik Araştırma Kurumu (TÜBİTAK) дар доираи дастгириҳои рақами 125M675 ва 223M312 маблағгузорӣ шудааст.
Дастрасии маълумот: Гуфта шудааст, ки маълумот бо дархост пешниҳод мешавад.
Тазоди манфиатҳо: Муаллифон манфиатҳои молиявии рақобаткунандаи маълум ё муносибатҳои шахсие, ки метавонанд ба таҳқиқот таъсир расонанд, гузориш накардаанд.
Саҳми муаллифон: Mohammad Khaneghaei; бозбинӣ ва таҳрир, лоиҳаи аввал, визуализатсия, validation, методология, захираҳо, таҳқиқ, таҳлили формалӣ, data curation ва conceptualization. Benyamin Ebrahimi; бозбинӣ ва таҳрир, лоиҳаи аввал, визуализатсия, validation, методология, таҳқиқ, таҳлили формалӣ, data curation ва conceptualization. Davood Asadi; бозбинӣ ва таҳрир, лоиҳаи аввал, supervision, таҳқиқ, таҳлили формалӣ, data curation ва conceptualization. Onder Tutsoy; бозбинӣ ва таҳрир, лоиҳаи аввал, validation, методология, захираҳо ва supervision. Seyed-Yaser Nabavi-Chashmi; бозбинӣ ва таҳрир, validation ва supervision. Hassan Haghighi; бозбинӣ ва таҳрир ва validation.
Сатҳи симулятсия: Ҳамаи муқоисаҳо ба симулятсияҳои иҷрошуда дар MATLAB R2024b асос меёбанд. Таҳқиқот озмоиши парвози воқеии UAV-и болсобит, hardware-in-the-loop test ё намоиши саҳроиро дар бар намегирад.
Ҳадди real-time: Манбаъ меъёри real-time-ро чунин таъриф мекунад, ки computation/control time набояд аз sampling interval-и 0,5 s зиёд бошад. PG-MPC дар Scenario 2 бо қимати максималии 0,3621 s ин талабро иҷро мекунад; дар Scenario 3 бо қимати максималии 0,5404 s аз ҳад боло мемонад. Аз ин рӯ Verianla ибораи «дар ҳамаи сенарияҳо ҳар қадами идоракунӣ комилан real-time аст»-ро истифода намекунад.
Эзоҳи мутобиқати муодила: Термини dynamic obstacle penalty-и манбаъ дар Муодилаи (11) ва ифодаи масъалаи якҷоя дар Муодилаи (14) дар як шакли математикӣ пешниҳод нашудааст. Verianla ин фарқро бо фарзия ислоҳ накардааст.
Ҳадди тафсири ADP: Бартарии Augmented Dubins Path тавлиди transition-и ҳамвортар ва аз ҷиҳати кинематикӣ иҷрошаванда аст. Қиматҳои Ҷадвали 4-и манбаъ нишон медиҳанд, ки ADP дар ҳар се сенария нисбат ба DP-и классикӣ масофаи ҷамъшуда ва execution time-и каме баландтар тавлид мекунад.
Ҳадди устуворӣ: Муаллифон ошкоро мегӯянд, ки барои closed-loop stability-и системаи якҷояи PG-MPC таҳлили rigorозии назариявӣ пешниҳод накардаанд ва онро ба кори оянда гузоштаанд.
Ҳадди илмӣ: Натиҷаҳои модел дар шароити монеаҳои синтетикии статикӣ/динамикӣ, perception model-и идеализатсияшуда ва planar fixed-wing dynamics бо баландии доимӣ ба даст омадаанд. Таъсири шамоли воқеӣ, sensor noise, communication delay, actuator uncertainty ва системаи физикии парвоз таҷрибавӣ арзёбӣ нашудааст.
Усули тавлиди муҳтаво: Усули илмӣ, муодилаҳо, параметрҳои симулятсия, меъёрҳои иҷроиш, тафсирҳои шаклҳо ва маҳдудиятҳо дар ин шарҳи Verianla ба таҳқиқоти манбаи боршуда асос меёбанд. Санҷиши беруна танҳо барои тасдиқи ҳувияти библиографӣ, сабти расмии нашр ва маълумоти рецензия истифода шудааст; натиҷаи нави илмии иҷроиш ё хулосаи алгоритмие, ки дар манбаъ нест, аз манбаъҳои беруна ба матни асосӣ илова нашудааст.
Шарҳ гузоред
Нишонии почтаи электронии шумо нашр намешавад. Майдонҳои ҳатмӣ бо * нишон дода шудаанд