

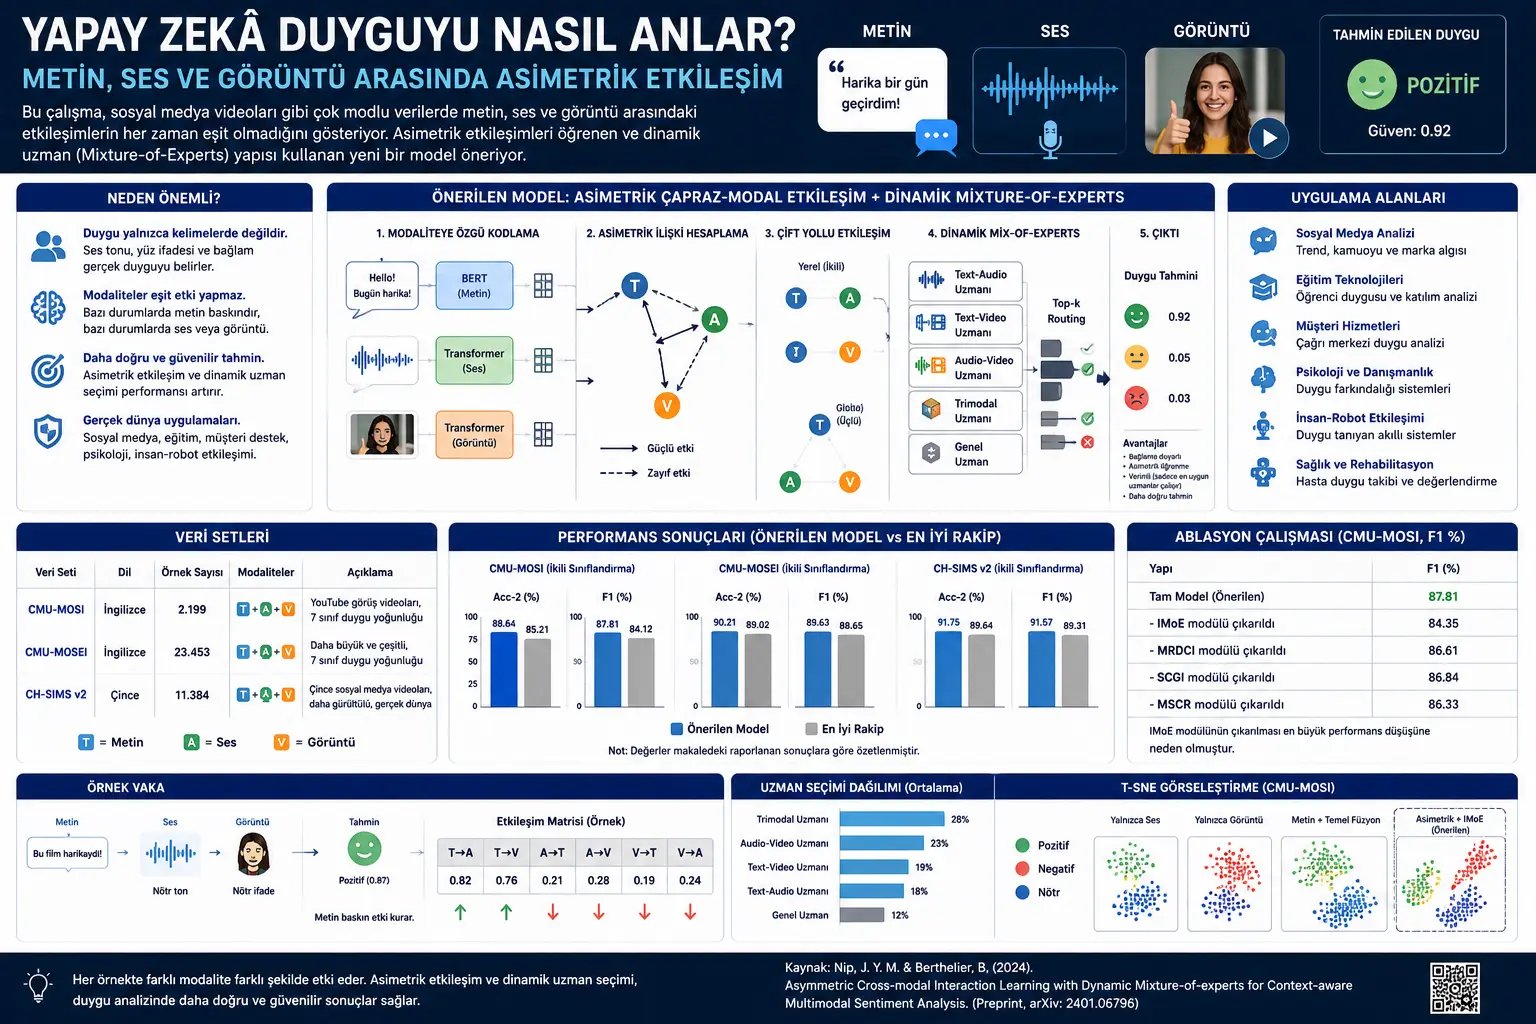
Hisia za binadamu mara nyingi hazionekani katika maneno pekee. Sentensi anayosema mtu hupata maana pamoja na sauti yake na mwonekano wa uso. Sentensi ileile, ikisemwa kwa sauti tambarare, inaweza kuonekana neutral; ikisemwa kwa toni ya kejeli, inaweza kuonekana hasi; ikisemwa pamoja na uso wenye msisimko, inaweza kutambulika kuwa chanya. Kwa sababu hiyo mifumo ya AI katika uchambuzi wa hisia lazima izingatie si maandishi pekee, bali pia vidokezo vya sauti na picha.
Utafiti huu unahoji dhana muhimu katika uchambuzi wa hisia wa multimodal: Je, mwingiliano kati ya maandishi, sauti na picha kweli ni wa ulinganifu? Yaani, kadiri maandishi yanavyoathiri sauti, je, sauti nayo huathiri maandishi kwa kiwango kilekile? Jibu la utafiti ni hapana. Kunaweza kuwa na athari zenye mwelekeo na zisizo sawia kati ya modaliti. Katika baadhi ya mifano, maandishi ndiyo chanzo kikuu cha maana; katika hali nyingine sauti au picha hurekebisha, huimarisha au hata kugeuza kutokuwa wazi kwa maandishi.
Kwa sababu hiyo makala inapendekeza modeli ya kujifunza mwingiliano wa cross-modal usio wa ulinganifu. Modeli huhesabu kivyake ni kwa kiasi gani kila modality inaathiri nyingine; kisha hutumia muundo wa dynamic Mixture-of-Experts kushughulikia aina tofauti za mwingiliano. Mixture-of-Experts inaweza kutafsiriwa kwa Kiswahili kama “mchanganyiko wa wataalamu”: badala ya kuendesha mitandao yote ya wataalamu katika kila mfano, modeli huchagua mitandao midogo michache ya wataalamu inayofaa zaidi kwa mfano husika, hivyo huzalisha uwakilishi unaonyumbulika na wenye ufanisi zaidi.
Tatizo Ni Nini?
Uchambuzi wa hisia wa multimodal hujaribu kutabiri hali ya hisia kwa kuunganisha aina tofauti za data kama maandishi, sauti na picha. Eneo hili ni muhimu kwa mitandao ya kijamii, tafsiri ya video za mtandaoni, teknolojia za elimu, mwingiliano wa binadamu na kompyuta, na mifumo ya AI inayotambua hisia. Hata hivyo, kuunganisha modaliti tofauti ni kazi ngumu kiufundi.
Changamoto ya kwanza ni kwamba modaliti hazibebi aina ileile ya taarifa. Maandishi kwa kawaida ni chanzo chenye msongamano mkubwa wa maana; yanaonyesha moja kwa moja kile mtu alichosema. Sauti hubeba vidokezo kama mkazo, kasi, pitch na toni ya hisia. Picha hutoa ishara za ziada kupitia sura ya uso, ishara, mimics na mkao wa mwili. Njia hizi tatu zinaweza kukamilishana; lakini hazifanyi kazi kwa nguvu ileile katika kila mfano.
Changamoto ya pili ni kwamba mbinu nyingi za awali huchukulia mwingiliano kati ya modaliti kuwa wa ulinganifu au sawa. Hata hivyo, katika mazungumzo halisi hili si sahihi kila wakati. Maandishi yanaweza kuamua kwa nguvu jinsi sauti itakavyotafsiriwa; lakini nguvu ya sauti kuathiri maandishi huenda isiwe ya kiwango kilekile. Vivyo hivyo, picha inaweza kuwa ya kuamua sana katika baadhi ya mifano, na katika baadhi nyingine inaweza kubeba karibu hakuna ishara ya hisia.
Changamoto ya tatu ni mwingiliano unaobadilika kulingana na muktadha. Katika hali kama ucheshi, ironi, kejeli, maandishi yasiyo wazi, usemi dhaifu wa hisia au video yenye kelele, modeli inahitaji kurekebisha kwa njia dynamic ni modality ipi itaaminiwa zaidi. Uzito wa kudumu au mbinu rahisi za kuunganisha haziwezi kutoa unyumbufu huu kila wakati.
Swali kuu la utafiti hutokea hapa: AI inaweza kujifunzaje vizuri zaidi mwingiliano wenye mwelekeo na unaotegemea mfano kati ya maandishi, sauti na picha?
Mbinu Inapendekeza Nini?
Utafiti unapendekeza modeli ya kujifunza mwingiliano wa cross-modal usio wa ulinganifu kwa uchambuzi wa hisia wa multimodal unaotambua muktadha. Wazo kuu la modeli ni kuhesabu athari ya kila modality juu ya modaliti nyingine katika mielekeo tofauti na kuchakata mwingiliano huu kwa mitandao ya wataalamu dynamic.
Kipengele cha kwanza ni moduli ya usimbaji maalumu kwa modality. Kwa maandishi hutumiwa BERT. BERT ni modeli yenye nguvu ya lugha inayowakilisha maneno ndani ya sentensi kulingana na muktadha. Kwa sauti na picha hutumiwa miundo ya Transformer encoder iliyoongezewa taarifa ya nafasi. Hivyo kila modality kwanza hugeuzwa kuwa uwakilishi wenye maana ndani yake.
Kipengele cha pili ni Modality Relation-aware Dual-path Cross-modal Interaction, yaani moduli ya mwingiliano wa cross-modal wa njia mbili unaotambua uhusiano wa modaliti. Moduli hii huhesabu uzito wa athari zenye mwelekeo kati ya maandishi, sauti na picha. Kwa mfano, athari kutoka maandishi kwenda sauti na athari kutoka sauti kwenda maandishi hazichukuliwi kuwa sawa; kila mwelekeo huwekewa modeli kwa uzito tofauti wa kuaminika.
Kipengele cha tatu ni muundo wa mwingiliano wa njia mbili. Modeli hujaribu kunasa mwingiliano wa ndani wa jozi na mwingiliano wa jumla wa watatu. Njia ya ndani huchunguza mahusiano ya jozi kama maandishi-sauti, maandishi-picha na sauti-picha. Njia ya jumla hunasa muundo mpana zaidi wa mwingiliano unaoundwa na modaliti tatu kwa pamoja.
Kipengele cha nne ni moduli ya Interaction-aware Mixture-of-Experts. Muundo huu huanzisha mitandao tofauti ya wataalamu kwa aina tofauti za mwingiliano wa cross-modal. Kuna wataalamu kama Text-Audio Expert, Text-Video Expert, Audio-Video Expert, Trimodal Expert na General Expert. Modeli haitumii wataalamu wote kwa uzito sawa katika kila mfano; huchagua wataalamu wachache wanaofaa zaidi kupitia mkakati wa top-k routing.
Kipengele cha tano ni moduli ya Semantically Complementary Global Interaction. Muundo huu unalenga kukamata tena vidokezo vya hisia vinavyokamilishana ambavyo vinaweza kupotea wakati wa mwingiliano usio wa ulinganifu. Kipengele cha sita ni moduli ya Modality-Specific Channel Refinement. Moduli hii hujaribu kulinda ishara muhimu za hisia ndani ya kila modality ili uwakilishi uliounganishwa usidhoofike.
Formule Zinasema Nini?
Katika utafiti kuna misemo mingi ya kihisabati. Formule zilizo hapa chini zimehamishwa kwa uaminifu iwezekanavyo kwa muundo wa alama wa makala na zimepewa maelezo rahisi kwa msomaji wa Verianla.
Modality ya maandishi husimbwa kwa BERT. Hapa \(X_t\) huwakilisha ingizo la maandishi; \(H_t\) huwakilisha mlolongo wa uwakilishi wa kimuktadha unaotolewa kutoka maandishi.
Katika modaliti za sauti na picha, taarifa ya nafasi huongezwa na uwakilishi hutolewa kwa Transformer encoder. Hapa \(m \in \{a,v\}\) huwakilisha modality ya sauti au picha.
Kisha modeli huproject modaliti kwenye kipimo cha pamoja. Kwa maandishi hutumiwa uwakilishi wa [CLS], na kwa sauti na picha hutumiwa average pooling.
Mekanizma ya kutambua uhusiano usio wa ulinganifu huhesabu athari yenye mwelekeo ya modality moja juu ya modality nyingine. Hapa \(w_{j \rightarrow i}\) huwakilisha uzito wa kuaminika wa athari kutoka modality chanzo \(j\) kwenda modality lengwa \(i\).
Kwa kutumia uzito huu, kila modality hupimwa upya kulingana na athari zenye mwelekeo zinazotoka modaliti nyingine. Hapa \(\odot\) huonyesha kuzidisha kipengele kwa kipengele.
Katika mwingiliano wa ndani wa jozi, uwakilishi ulioimarishwa wa modaliti mbili huunganishwa na hupitishwa katika ubadilishaji usio mstari.
Vectors tatu za mwingiliano wa jozi hupangwa juu ya nyingine ili kuunda muundo mpana wa uhusiano.
Katika muundo wa Mixture-of-Experts, wataalamu tofauti huchakata aina tofauti za mwingiliano. Kwa mfano wataalamu wa maandishi-sauti, maandishi-picha, sauti-picha, modaliti tatu na mtaalamu wa jumla huzingatia mifumo tofauti ya mwingiliano.
Mtandao wa routing, yaani uelekezaji, huamua ni wataalamu gani watachaguliwa kwa kila mfano. Modeli huchagua wataalamu \(k\) wanaofaa zaidi badala ya kuendesha wote.
Matokeo ya wataalamu waliochaguliwa huunganishwa kwa uzito.
Ili kuzuia expert collapse, hutumiwa hasara ya kusawazisha mzigo. Expert collapse ni hali ambayo modeli hujielekeza daima kwa wataalamu wachache wale wale na wataalamu wengine hawawezi kujifunza.
Upande wa regression, L1 loss hutumiwa kwa utabiri wa skor ya hisia. Hasara hii hupima tofauti kamili kati ya thamani ya hisia iliyotabiriwa na thamani halisi ya hisia.
Lengo la jumla la mafunzo huunganisha regression loss, contrastive loss inayotambua hisia na load balancing loss.
Ujumbe Mkuu wa Grafu, Jedwali na Skima
Skima ya usanifu wa modeli inaonyesha kuwa mfumo kwanza husimba ingizo la maandishi, sauti na picha kando kando, kisha huhesabu athari zenye mwelekeo kati ya modaliti hizi. Ujumbe mkuu wa skima ni huu: modeli haiuoni muungano wa “maandishi + sauti + picha” kama operesheni rahisi ya kujumlisha; hujifunza pia ni njia gani inaathiri njia nyingine kwa kiasi gani.
Skima ya uhusiano usio wa ulinganifu inaeleza kwamba mwingiliano wa modaliti si wa mwelekeo mmoja na si sawa. Kwa mfano katika mfano mmoja maandishi yanaweza kuwa na athari kubwa juu ya sauti na picha; lakini athari ya kurudi kutoka sauti au picha juu ya maandishi inaweza kuwa ndogo. Mtazamo huu ni muhimu hasa katika hali za ironi, maandishi yasiyo wazi na ishara dhaifu za hisia.
Skima ya Semantically Complementary Global Interaction inaonyesha kuwa modeli haitosheki na mwingiliano usio wa ulinganifu pekee. Baadhi ya vidokezo vya hisia vinaweza kudhoofika au kupotea wakati wa mwingiliano wenye mwelekeo. Kwa sababu hiyo modeli hujaribu kutoa taarifa ya hisia inayokamilishana, ya ndani na ya jumla, kutoka uwakilishi wa pamoja wa modaliti tatu.
Ujumbe mkuu wa jedwali la seti za data ni kwamba modeli ilijaribiwa juu ya data za uchambuzi wa hisia wa multimodal za Kiingereza na Kichina. CMU-MOSI ni benchmark ndogo zaidi na ya kawaida. CMU-MOSEI ni seti kubwa zaidi yenye mifano ya hisia iliyo pana zaidi. CH-SIMS v2, kama seti ya data ya Kichina, hujaribu modeli katika muktadha tofauti wenye kelele zaidi za ulimwengu halisi na semi dhaifu za hisia.
Majedwali ya utendaji yanaonyesha kuwa modeli iliyopendekezwa inatoa matokeo yenye nguvu hasa katika uainishaji wa hisia wa binary. Kwenye CMU-MOSI, ongezeko kubwa katika skor za Acc-2 na F1 huripotiwa. Kwenye CMU-MOSEI kuna maboresho madogo lakini thabiti. Kwenye CH-SIMS v2, matokeo chanya yanajitokeza katika mifano yenye kelele na ishara dhaifu za hisia.
Jedwali la ablation linaonyesha ni sehemu gani za modeli zinachangia kweli. Moduli ya IMoE inapoondolewa, mojawapo ya maporomoko makubwa zaidi katika skor ya F1 hutokea. Hii inaonyesha kuwa uteuzi dynamic wa wataalamu ni muhimu katika kunasa ishara nyembamba za hisia katika miktadha changamano. MRDCI na SCGI zinapoondolewa pia utendaji hushuka; hii inadokeza kuwa mwingiliano usio wa ulinganifu na uwakilishi wa jumla unaokamilishana ni msingi kwa modeli.
Uchambuzi wa mfano wa kesi unaonyesha hali ambayo maandishi yanabeba hisia hasi wazi, wakati sauti na picha hazitoi ishara dhahiri ya hisia. Matrix ya mwingiliano inaonyesha kuwa maandishi yana athari kubwa juu ya modaliti nyingine; athari ya kinyume ya sauti na picha juu ya maandishi inabaki ndogo. Mfano huu hufanya wazo la “si kila modality ina uzito sawa” kuwa la kushikika.
Usambazaji wa uteuzi wa wataalamu unaonyesha kuwa modeli haiporomoki kwenye mtaalamu mmoja tu. Ingawa Trimodal Expert na Audio-Video Expert huchaguliwa mara nyingi zaidi, wataalamu wengine pia hutumiwa kwa maana. Hii inaonyesha kuwa mekanizma ya top-k routing inaweza kuingiza wataalamu tofauti wa mwingiliano katika mifano tofauti.
Uonyeshaji wa T-SNE hueleza ubora wa uwakilishi wa modeli kwa njia ya kuona. Sauti au picha peke yake zinapotumiwa, makundi ya hisia huingiliana sana. Maandishi hutoa mgawanyo bora zaidi, lakini hisia neutral bado hutawanyika. Mwingiliano wa cross-modal na IMoE vinapoongezwa, mifano chanya, hasi na neutral huwa rahisi zaidi kutenganishwa. Hii inaonyesha kuwa modeli inaweza kuchora mpaka vizuri zaidi hasa kati ya hisia neutral na hisia chanya/hasi zilizo na polariti.
Majaribio Yalifanywaje?
Katika utafiti zilitumika seti tatu maarufu za data za uchambuzi wa hisia wa multimodal: CMU-MOSI, CMU-MOSEI na CH-SIMS v2. CMU-MOSI ni benchmark ya kawaida inayotokana na video za maoni za YouTube. CMU-MOSEI ni seti kubwa zaidi na iliyopanuliwa, yenye mgawanyo mpana zaidi wa mada. CH-SIMS v2 ni seti ya data inayotumika kwa uchambuzi wa hisia wa multimodal kwa Kichina na ina kelele halisi zaidi na usemi dhaifu wa hisia.
Modeli huchakata vipengele vya maandishi, sauti na picha kando kando. Upande wa maandishi, BERT-base hutumiwa, au BERT-base-cn kwa seti ya data ya Kichina. Upande wa sauti na picha, vipimo tofauti vya vipengele hutumiwa kulingana na seti ya data. Majaribio hutekelezwa kwa PyTorch na kuendeshwa kwenye GPU moja ya NVIDIA RTX 3090.
Tathmini hufanywa kwa vipimo vya regression na classification. Upande wa regression, MAE na Pearson correlation hutumiwa. MAE hupima wastani wa kosa kamili kati ya skor ya hisia iliyotabiriwa na skor halisi. Pearson correlation huonyesha uhusiano wa mstari kati ya utabiri na lebo halisi.
Upande wa classification, skor za Acc-7, Acc-5, Acc-2 na F1 huripotiwa. Acc-7 na Acc-5 hupima uainishaji wa hisia wa chembechembe zaidi. Acc-2 na F1 hutathmini uainishaji mpana lakini muhimu kwa vitendo kama kutenganisha chanya/hasi.
Modeli hulinganishwa na mbinu za kawaida za fusion, mbinu zinazotegemea Transformer, mikabala ya contrastive learning, mbinu za representation disentanglement, mekanizma za adaptive experts na mbinu zinazotegemea multimodal large language model. Kwa njia hii, nafasi ya modeli iliyopendekezwa haionekani tu dhidi ya mbinu za zamani, bali pia dhidi ya mikabala mipya yenye nguvu.
Pia hufanywa tafiti za ablation. Ablation ni njia ya kupima ni sehemu gani ya modeli inachangia kiasi gani kwenye utendaji kwa kuondoa vipengele kimoja kimoja. Mabadiliko ya utendaji yanachunguzwa vipengele kama MRDCI, APMR, GPTA, LBI, IMoE, SCGI na MSCR vinapoondolewa.
Matokeo Yanaonyesha Nini?
Matokeo ya kwanza ni kwamba katika uchambuzi wa hisia wa multimodal, kuchukulia mwingiliano kati ya modaliti kuwa wa ulinganifu ni mtazamo wenye mipaka. Maandishi, sauti na picha hazifanyi kazi kwa uzito uleule katika kila mfano. Katika baadhi ya hali maandishi ndiyo kiamua kikuu; katika nyingine sauti au picha hukamilisha maandishi, kuyarekebisha au kufanya hisia dhaifu ionekane.
Matokeo ya pili ni kwamba kuweka modeli kwa mwingiliano usio wa ulinganifu kunachangia kwa maana kwenye utendaji. Kushuka kwa skor ya F1 wakati moduli ya MRDCI inaondolewa kunaonyesha kuwa kujifunza mahusiano yenye mwelekeo ya modaliti ni muhimu katika utabiri wa hisia.
Matokeo ya tatu ni kwamba uteuzi dynamic wa wataalamu ni muhimu. Moduli ya IMoE inapoondolewa, utendaji hushuka kwa kiasi kikubwa. Hii inaonyesha kuwa mkakati uleule wa fusion kwa kila mfano hautoshi kila wakati; modeli inaweza kutoa matokeo bora zaidi kwa kuchagua wataalamu tofauti kulingana na muktadha.
Matokeo ya nne ni kwamba mwingiliano wa jumla unaokamilishana na uboreshaji wa channel maalumu kwa modality unaweza kupunguza kupotea kwa ishara za hisia. SCGI huimarisha vidokezo vya hisia vya pamoja na vya ndani-jumla kati ya modaliti tatu. MSCR hulinda ishara muhimu ambazo kila modality hubeba ndani yake.
Matokeo ya tano ni kwamba modeli ina faida hasa katika ishara dhaifu za hisia na mifano yenye kelele. Matokeo ya CH-SIMS v2 yanaonyesha kuwa modeli inaweza kufanya mgawanyo wenye nguvu zaidi katika hali ambazo kutenganisha hisia neutral kutoka madarasa chanya au hasi ni vigumu.
Matokeo ya sita ni kwamba kuendesha wataalamu wengi zaidi si lazima daima kuwe bora. Mkakati wa top-k sparse routing huchagua wataalamu wanaofaa zaidi pekee, hivyo hupunguza mzigo wa hesabu na kuzalisha uwakilishi unaofaa mfano. Katika utafiti, wataalamu 5 na mkakati wa top-2 activation hutoa mizani nzuri katika uainishaji mpana wa hisia na vipimo vya korelesheni.
Kwa Nini Hili Ni Muhimu?
Utafiti huu unaonyesha kuwa wazo la “tuunganishe njia nyingi zaidi za data” halitoshi peke yake katika uchambuzi wa hisia. Jambo kuu ni kuelewa jinsi njia hizi zinavyoathiriana na ni njia ipi inaaminika zaidi katika muktadha gani.
Katika video za mitandao ya kijamii, rekodi za elimu mtandaoni, mazungumzo ya huduma kwa wateja, mwingiliano wa binadamu na roboti, na programu zinazotambua hisia, maandishi, sauti na picha mara nyingi hupatikana pamoja. Lakini data hizi haziwi thabiti kila wakati. Mtu anaweza kutumia maneno chanya huku uso wake ukiwa hasi; toni ya sauti inaweza kugeuza maana ya maandishi; picha inaweza kuwa ya ubora mdogo; mazungumzo yanaweza kuwa yasiyo wazi au ya ironi.
Kwa hiyo miundo inayotambua muktadha na kujifunza mwingiliano usio wa ulinganifu hutoa hatua ya juu zaidi kuliko mtazamo wa kawaida wa “unganisha njia tatu na tabiri”. Modeli haijumlishi modaliti tu; hujaribu kujifunza mizani ya nguvu kati yao.
Utafiti pia unaonyesha kwa nini usanifu wa Mixture-of-Experts unaweza kuwa muhimu katika uchambuzi wa hisia wa multimodal. Ikiwa kila mfano unabeba muundo tofauti wa mwingiliano wa hisia, kuchagua wataalamu tofauti kulingana na muktadha kunaweza kuwa rahisi kubadilika na yenye ufanisi zaidi kuliko modeli moja ya jumla.
Hata hivyo, matumizi ya mifumo ya aina hii katika ulimwengu halisi yanahitaji tahadhari. Utambuzi wa hisia si chombo cha kusoma kwa uhakika ulimwengu wa ndani wa binadamu. Modeli huzalisha makadirio kutoka ishara za maandishi, sauti na picha katika data; makadirio haya hutegemea muktadha, utamaduni, ubora wa data, tabia ya mtumiaji na mipaka ya kimaadili.
Hoja za Kuzingatia
Hoja ya kwanza ya kuzingatia ni kwamba utafiti ni preprint. Kwa sababu haujapitia tathmini ya rika, mbinu, matokeo na madai yanaweza kubadilika baadaye. Kwa hiyo matokeo yanapaswa kusomwa kama matokeo ya utafiti yenye matumaini, si kama kiwango kilichokamilika.
Hoja ya pili ni mipaka ya kimaadili ya utambuzi wa hisia. Kukadiria hisia za mtu kiotomatiki kutoka maandishi, sauti na picha ni operesheni nyeti. Katika nyanja kama elimu, ajira, afya, usalama, ufuatiliaji au tathmini ya wateja, mifumo ya aina hii haipaswi kutumiwa peke yake kuwawekea watu lebo kiotomatiki.
Hoja ya tatu ni utegemezi wa seti ya data. Ingawa CMU-MOSI, CMU-MOSEI na CH-SIMS v2 ni benchmark zenye nguvu, data ya ulimwengu halisi inaweza kuwa changamano zaidi. Lugha tofauti, tamaduni, lafudhi, ubora wa kamera, miktadha ya kijamii na kanuni za sura ya uso zinaweza kubadilisha utendaji wa modeli.
Hoja ya nne ni uainishaji wa hisia wa chembechembe zaidi. Utafiti unaeleza kwamba baadhi ya moduli huimarisha uainishaji wa binary, lakini hazitoi faida ileile kila wakati katika vipimo vya hisia vya kina zaidi kama Acc-5 na Acc-7. Hii inaonyesha kuwa kutenganisha chanya/hasi ni rahisi zaidi; mipaka ya nguvu ya hisia na neutral ni migumu zaidi.
Hoja ya tano ni ugumu wa modeli. Wataalamu dynamic, top-k routing, mwingiliano usio wa ulinganifu na kazi nyingi za loss hutoa usanifu wenye nguvu lakini pia hufanya mfumo uwe changamano zaidi. Katika mazingira halisi ya uzalishaji, explainability, gharama ya hesabu, kuchelewa, faragha ya data na mahitaji ya matengenezo yanapaswa kutathminiwa pia.
Hitimisho
Utafiti huu unaweka katikati wazo muhimu katika uchambuzi wa hisia wa multimodal: uhusiano kati ya maandishi, sauti na picha si kila wakati sawa na wa ulinganifu. Katika baadhi ya mifano maandishi huongoza modaliti nyingine; katika baadhi sauti na picha hukamilisha maana ya maandishi; na katika baadhi nyingine modaliti zote tatu lazima zichakatwe kwa pamoja.
Modeli iliyopendekezwa hushughulikia uchangamano huu kwa mwingiliano wa cross-modal usio wa ulinganifu na muundo dynamic wa Mixture-of-Experts. MRDCI hunasa athari zenye mwelekeo kati ya modaliti. IMoE huchagua wataalamu wanaofaa kulingana na muktadha na kuchakata ishara nyembamba za hisia. SCGI huimarisha vidokezo vya jumla vinavyokamilishana ambavyo vinaweza kupotea. MSCR nayo hulinda ishara muhimu maalumu kwa modality.
Matokeo ya majaribio yanaonyesha kuwa modeli inaonyesha utendaji wenye nguvu katika seti tatu za benchmark na inaweza kutoa faida hasa katika uainishaji wa hisia wa binary, mifano yenye kelele na ishara dhaifu za hisia.
Kwa mtazamo wa Verianla, ujumbe mkuu wa utafiti ni huu: ili AI ielewe hisia za binadamu vizuri zaidi, haitoshi kutumia maandishi, sauti na picha kwa pamoja. Lazima pia ijifunze mahusiano ya nguvu yenye mwelekeo kati ya njia hizi, muktadha na mwingiliano maalumu kwa kila mfano.
Chanzo na Dokezo la Mbinu
Maudhui haya yameandaliwa kwa msingi wa utafiti wa preprint wenye kichwa “Asymmetric Cross-modal Interaction Learning with Dynamic Mixture-of-experts for Context-aware Multimodal Sentiment Analysis”. Utafiti unachunguza uchambuzi wa hisia wa multimodal, mwingiliano wa cross-modal usio wa ulinganifu, dynamic Mixture-of-Experts, top-k routing, semantically complementary global interaction na mbinu za modality-specific channel refinement kwenye seti za data za CMU-MOSI, CMU-MOSEI na CH-SIMS v2.
Maudhui haya si tafsiri ya neno kwa neno; wazo kuu la utafiti limerahisishwa na kugeuzwa kuwa makala ya kihariri ya Kiswahili kulingana na mstari wa uchapishaji wa Verianla.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *