

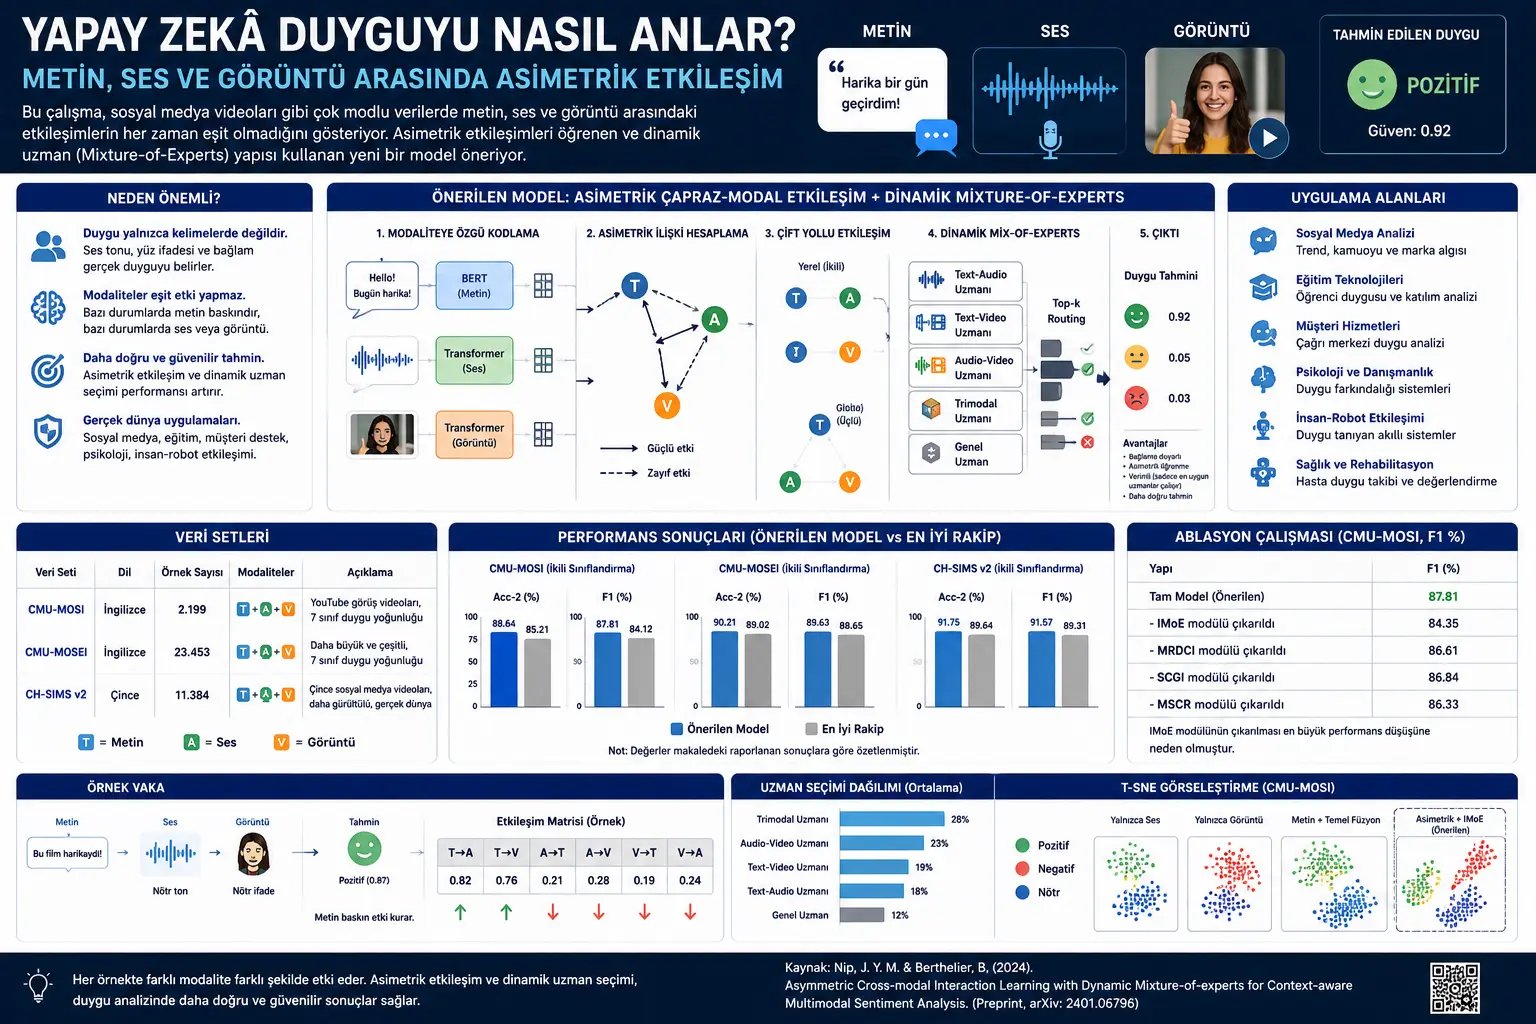
İnsan duygusu çoğu zaman yalnızca kelimelerde ortaya çıkmaz. Bir kişinin söylediği cümle, ses tonu ve yüz ifadesiyle birlikte anlam kazanır. Aynı cümle, düz bir ses tonuyla söylendiğinde nötr; alaycı bir tonla söylendiğinde olumsuz; heyecanlı bir yüz ifadesiyle söylendiğinde olumlu algılanabilir. Bu nedenle yapay zekâ sistemleri duygu analizinde yalnızca metni değil, ses ve görüntü ipuçlarını da dikkate almak zorundadır.
Bu çalışma, çok modlu duygu analizinde önemli bir varsayımı sorguluyor: Metin, ses ve görüntü arasındaki etkileşimler gerçekten simetrik midir? Yani metin sesi ne kadar etkiliyorsa, ses de metni aynı ölçüde mi etkiler? Araştırmanın cevabı hayırdır. Modaliteler arasında yönlü ve dengesiz etkiler olabilir. Bazı örneklerde metin baskın anlam kaynağıdır; bazı durumlarda ses veya görüntü metindeki belirsizliği düzeltir, güçlendirir veya tersine çevirebilir.
Makale bu nedenle asimetrik çapraz-modal etkileşim öğrenme modeli önerir. Model, hangi modalitenin diğerini ne kadar etkilediğini ayrı ayrı hesaplar; sonra farklı etkileşim türlerini işlemek için dinamik Mixture-of-Experts yapısı kullanır. Mixture-of-Experts, Türkçeye “uzmanlar karışımı” olarak çevrilebilir: Model her örnekte tüm uzmanları çalıştırmak yerine, o örneğe en uygun birkaç uzman alt ağı seçerek daha esnek ve verimli temsil üretir.
Problem Ne?
Çok modlu duygu analizi, metin, ses ve görüntü gibi farklı veri türlerini birleştirerek duygu durumunu tahmin etmeye çalışır. Bu alan sosyal medya, çevrimiçi video yorumlama, eğitim teknolojileri, insan-bilgisayar etkileşimi ve duygu farkındalıklı yapay zekâ sistemleri için önemlidir. Ancak farklı modaliteleri birleştirmek teknik olarak zordur.
İlk zorluk, modalitelerin aynı tür bilgi taşımamasıdır. Metin genellikle anlam yoğunluğu yüksek bir kaynaktır; kişi ne söylediğini doğrudan içerir. Ses ise vurgu, hız, perde ve duygu tonu gibi ipuçları taşır. Görüntü ise yüz ifadesi, jest, mimik ve beden duruşu üzerinden ek sinyaller sunar. Bu üç kanal birbirini tamamlayabilir; fakat her örnekte aynı güçte çalışmaz.
İkinci zorluk, önceki birçok yöntemin modaliteler arasındaki etkileşimi simetrik veya eşit kabul etmesidir. Oysa gerçek konuşmalarda bu her zaman doğru değildir. Metin, sesin nasıl yorumlanacağını güçlü biçimde belirleyebilir; fakat sesin metni etkileme gücü aynı ölçüde olmayabilir. Benzer şekilde, görüntü bazı örneklerde çok belirleyiciyken bazı örneklerde neredeyse hiç duygu sinyali taşımayabilir.
Üçüncü zorluk, bağlama göre değişen etkileşimdir. Mizah, ironi, alay, belirsiz metin, zayıf duygu ifadesi veya gürültülü video gibi durumlarda modelin hangi modaliteye daha fazla güveneceğini dinamik biçimde ayarlaması gerekir. Sabit ağırlıklar veya basit birleştirme yöntemleri bu esnekliği her zaman sağlayamaz.
Çalışmanın temel sorusu bu noktada ortaya çıkar: Yapay zekâ, metin, ses ve görüntü arasındaki yönlü ve örneğe bağlı etkileşimleri nasıl daha iyi öğrenebilir?
Yöntem Ne Öneriyor?
Çalışma, bağlam farkındalıklı çok modlu duygu analizi için asimetrik çapraz-modal etkileşim öğrenme modeli önerir. Modelin ana fikri, her modalitenin diğer modaliteler üzerindeki etkisini ayrı yönlerde hesaplamak ve bu etkileşimleri dinamik uzman ağlarıyla işlemektir.
İlk bileşen modaliteye özgü kodlama modülüdür. Metin için BERT kullanılır. BERT, cümle içindeki kelimeleri bağlam içinde temsil eden güçlü bir dil modelidir. Ses ve görüntü için ise pozisyon bilgisi eklenmiş Transformer encoder yapıları kullanılır. Böylece her modalite önce kendi içinde anlamlı bir temsil haline getirilir.
İkinci bileşen, Modality Relation-aware Dual-path Cross-modal Interaction yani modalite ilişkisi farkındalıklı çift yollu çapraz-modal etkileşim modülüdür. Bu modül, metin, ses ve görüntü arasındaki yönlü etki ağırlıklarını hesaplar. Örneğin metinden sese etki ile sesten metne etki aynı kabul edilmez; her yön ayrı güven ağırlığıyla modellenir.
Üçüncü bileşen, çift yollu etkileşim yapısıdır. Model hem yerel ikili etkileşimleri hem de global üçlü etkileşimi yakalamaya çalışır. Yerel yol, metin-ses, metin-görüntü ve ses-görüntü gibi ikili ilişkileri inceler. Global yol ise üç modalitenin birlikte oluşturduğu daha geniş etkileşim örüntüsünü yakalar.
Dördüncü bileşen, Interaction-aware Mixture-of-Experts modülüdür. Bu yapı, farklı çapraz-modal etkileşim türleri için farklı uzman ağları kurar. Text-Audio Expert, Text-Video Expert, Audio-Video Expert, Trimodal Expert ve General Expert gibi uzmanlar bulunur. Model her örnekte tüm uzmanları eşit kullanmaz; top-k routing stratejisiyle en uygun birkaç uzmanı seçer.
Beşinci bileşen, Semantically Complementary Global Interaction modülüdür. Bu yapı, asimetrik etkileşimler sırasında kaybolabilecek tamamlayıcı duygu ipuçlarını geri yakalamayı amaçlar. Altıncı bileşen ise Modality-Specific Channel Refinement modülüdür. Bu modül, her modalitenin kendi içinde taşıdığı önemli duygu sinyallerini koruyarak birleşik temsilin zayıflamasını önlemeye çalışır.
Formüller Ne Anlatıyor?
Çalışmada çok sayıda matematiksel ifade yer almaktadır. Aşağıdaki formüller, makaledeki sembol yapısına mümkün olduğunca sadık biçimde aktarılmış ve Verianla okuyucusu için sade açıklamalarla birlikte verilmiştir.
Metin modalitesi BERT ile kodlanır. Burada \(X_t\), metin girdisini; \(H_t\), metinden çıkarılan bağlamsal temsil dizisini ifade eder.
Ses ve görüntü modalitelerinde pozisyon bilgisi eklenir ve Transformer encoder ile temsil çıkarılır. Burada \(m \in \{a,v\}\), ses veya görüntü modalitesini temsil eder.
Model daha sonra modaliteleri ortak boyuta projekte eder. Metin için [CLS] temsili, ses ve görüntü için ortalama havuzlama kullanılır.
Asimetrik ilişki algılama mekanizması, bir modalitenin başka bir modalite üzerindeki yönlü etkisini hesaplar. Burada \(w_{j \rightarrow i}\), kaynak modalite \(j\)'den hedef modalite \(i\)'ye etki güven ağırlığını temsil eder.
Bu ağırlıklar kullanılarak her modalite, diğer modalitelerden gelen yönlü etkiye göre yeniden ölçeklenir. Burada \(\odot\), eleman bazlı çarpımı gösterir.
Yerel ikili etkileşimde iki modalitenin güçlendirilmiş temsilleri birleştirilir ve doğrusal olmayan dönüşümden geçirilir.
Üç ikili etkileşim vektörü yığılarak daha geniş ilişki yapısı oluşturulur.
Mixture-of-Experts yapısında farklı uzmanlar farklı etkileşim türlerini işler. Örneğin metin-ses, metin-görüntü, ses-görüntü, üçlü modalite ve genel uzmanlar ayrı etkileşim örüntülerine odaklanır.
Routing yani yönlendirme ağı, her örnek için hangi uzmanların seçileceğini belirler. Model, tüm uzmanları çalıştırmak yerine en uygun \(k\) uzmanı seçer.
Seçilen uzmanların çıktıları ağırlıklı biçimde birleştirilir.
Uzman çökmesini önlemek için yük dengeleme kaybı kullanılır. Uzman çökmesi, modelin sürekli aynı birkaç uzmana yönelmesi ve diğer uzmanların öğrenememesi durumudur.
Regresyon tarafında duygu puanı tahmini için L1 kaybı kullanılır. Bu kayıp, tahmin edilen duygu değeri ile gerçek duygu değeri arasındaki mutlak farkı ölçer.
Genel eğitim amacı; regresyon kaybı, duygu farkındalıklı kontrastif kayıp ve yük dengeleme kaybını birleştirir.
Grafik, Tablo ve Şema Ana Mesajı
Model mimarisi şeması, sistemin metin, ses ve görüntü girdilerini önce ayrı ayrı kodladığını, sonra bu modaliteler arasındaki yönlü etkileri hesapladığını gösterir. Şemanın ana mesajı şudur: Model, “metin + ses + görüntü” birleşimini basit bir toplama işlemi olarak görmez; hangi kanalın hangi kanalı ne kadar etkilediğini ayrıca öğrenir.
Asimetrik ilişki şeması, modalite etkileşimlerinin tek yönlü ve eşit olmadığını anlatır. Örneğin bir örnekte metin, ses ve görüntü üzerinde güçlü etki kurabilir; ancak ses veya görüntü metni aynı ölçüde değiştirmeyebilir. Bu yaklaşım, özellikle ironi, belirsiz metin ve zayıf duygu sinyali olan durumlarda önemlidir.
Semantically Complementary Global Interaction şeması, modelin yalnızca asimetrik etkileşimle yetinmediğini gösterir. Bazı duygu ipuçları, yönlü etkileşim sırasında zayıflayabilir veya kaybolabilir. Bu nedenle model, üç modalitenin ortak temsilinden hem yerel hem global tamamlayıcı duygu bilgisi çıkarmaya çalışır.
Veri seti tablosunun ana mesajı, modelin hem İngilizce hem Çince çok modlu duygu analizi verileri üzerinde test edildiğidir. CMU-MOSI daha küçük ve klasik bir benchmarktır. CMU-MOSEI daha büyük ve daha çeşitli duygu örnekleri içerir. CH-SIMS v2 ise Çince veri seti olarak, daha fazla gerçek dünya gürültüsü ve zayıf duygu ifadeleriyle modeli farklı bir bağlamda sınar.
Performans tabloları, önerilen modelin özellikle ikili duygu sınıflandırmasında güçlü sonuç verdiğini gösterir. CMU-MOSI üzerinde Acc-2 ve F1 skorlarında belirgin artış raporlanır. CMU-MOSEI’de daha küçük ama tutarlı iyileşmeler görülür. CH-SIMS v2 üzerinde ise gürültülü ve zayıf duygu sinyali içeren örneklerde olumlu sonuçlar öne çıkar.
Ablasyon tablosu, modelin hangi parçalarının gerçekten katkı verdiğini gösterir. IMoE modülü çıkarıldığında F1 skorunda en büyük düşüşlerden biri yaşanır. Bu, dinamik uzman seçiminin karmaşık bağlamlarda ince duygu sinyallerini yakalamada önemli olduğunu gösterir. MRDCI ve SCGI modülleri kaldırıldığında da performans düşer; bu da asimetrik etkileşim ve tamamlayıcı global temsilin model için temel olduğunu düşündürür.
Örnek vaka analizi, metnin açıkça olumsuz duygu taşıdığı, ses ve görüntünün ise belirgin duygu sinyali vermediği bir durumu gösterir. Etkileşim matrisi, metnin diğer modaliteler üzerinde güçlü etki kurduğunu; ses ve görüntünün metin üzerindeki ters etkisinin düşük kaldığını gösterir. Bu örnek, “her modalite eşit ağırlıkta değildir” fikrini somutlaştırır.
Uzman seçimi dağılımı, modelin yalnızca tek bir uzmana çökmediğini gösterir. Trimodal Expert ve Audio-Video Expert daha sık seçilse de diğer uzmanlar da anlamlı biçimde kullanılır. Bu, top-k routing mekanizmasının farklı örneklerde farklı etkileşim uzmanlarını devreye sokabildiğini gösterir.
T-SNE görselleştirmesi, modelin temsil kalitesini görsel olarak açıklar. Tek başına ses veya görüntü kullanıldığında duygu kümeleri çok iç içe geçer. Metin daha iyi ayrım sunsa da nötr duygu hâlâ dağınıktır. Çapraz-modal etkileşim ve IMoE eklendiğinde pozitif, negatif ve nötr örneklerin daha ayrışabilir hale geldiği görülür. Bu, modelin özellikle nötr duygu ile kutuplaşmış olumlu/olumsuz duygu arasındaki sınırı daha iyi çizebildiğini gösterir.
Deneyler Nasıl Yapılmış?
Çalışmada üç yaygın çok modlu duygu analizi veri seti kullanılmıştır: CMU-MOSI, CMU-MOSEI ve CH-SIMS v2. CMU-MOSI, YouTube görüş videolarından oluşan klasik bir benchmarktır. CMU-MOSEI, daha büyük ölçekli ve daha çeşitli konu dağılımına sahip genişletilmiş bir veri setidir. CH-SIMS v2 ise Çince çok modlu duygu analizi için kullanılan, daha gerçekçi gürültü ve zayıf duygu ifadeleri barındıran bir veri setidir.
Model metin, ses ve görüntü özelliklerini ayrı ayrı işler. Metin tarafında BERT-base veya Çince veri seti için BERT-base-cn kullanılır. Ses ve görüntü tarafında veri setine göre farklı özellik boyutları kullanılır. Deneyler PyTorch ile uygulanır ve tek bir NVIDIA RTX 3090 GPU üzerinde yürütülür.
Değerlendirme hem regresyon hem sınıflandırma ölçütleriyle yapılır. Regresyon tarafında MAE ve Pearson korelasyonu kullanılır. MAE, tahmin edilen duygu puanı ile gerçek duygu puanı arasındaki ortalama mutlak hatayı ölçer. Pearson korelasyonu, tahmin ile gerçek etiket arasındaki doğrusal ilişkiyi gösterir.
Sınıflandırma tarafında Acc-7, Acc-5, Acc-2 ve F1 skorları raporlanır. Acc-7 ve Acc-5, daha ince taneli duygu sınıflandırmasını ölçer. Acc-2 ve F1 ise olumlu/olumsuz ayrımı gibi daha kaba ama pratikte önemli duygu sınıflandırmasını değerlendirir.
Model, klasik füzyon yöntemleri, Transformer tabanlı yöntemler, kontrastif öğrenme yaklaşımları, temsil ayrıştırma yöntemleri, adaptif uzman mekanizmaları ve multimodal büyük dil modeli tabanlı yöntemlerle karşılaştırılır. Bu sayede önerilen modelin yalnızca eski yöntemlere değil, daha yeni güçlü yaklaşımlara karşı da nasıl konumlandığı görülür.
Ayrıca ablation çalışmaları yapılır. Ablation, modelden tek tek bileşen çıkararak hangi parçanın performansa ne kadar katkı verdiğini ölçme yöntemidir. MRDCI, APMR, GPTA, LBI, IMoE, SCGI ve MSCR gibi bileşenler çıkarıldığında performans değişimi incelenir.
Sonuçlar Ne Gösteriyor?
İlk sonuç, çok modlu duygu analizinde modaliteler arasındaki etkileşimi simetrik kabul etmenin sınırlı olduğudur. Metin, ses ve görüntü her örnekte aynı ağırlıkta çalışmaz. Bazı durumlarda metin baskın belirleyicidir; bazı durumlarda ses veya görüntü metni tamamlar, düzeltir veya zayıf duyguyu görünür hale getirir.
İkinci sonuç, asimetrik etkileşim modellemenin performansa anlamlı katkı verdiğidir. MRDCI modülü çıkarıldığında F1 skorunda belirgin düşüş yaşanması, yönlü modalite ilişkilerini öğrenmenin duygu tahmininde önemli olduğunu gösterir.
Üçüncü sonuç, dinamik uzman seçiminin kritik olduğudur. IMoE modülü çıkarıldığında performans ciddi biçimde düşer. Bu, her örnek için aynı füzyon stratejisinin yeterli olmadığını; modelin bağlama göre farklı uzmanları seçmesinin daha iyi sonuç verebildiğini gösterir.
Dördüncü sonuç, tamamlayıcı global etkileşim ve modaliteye özgü kanal iyileştirmenin duygu sinyallerinin kaybını azaltabildiğidir. SCGI, üç modalite arasındaki ortak ve yerel-global duygu ipuçlarını güçlendirir. MSCR ise her modalitenin kendi içinde taşıdığı önemli sinyalleri korur.
Beşinci sonuç, modelin özellikle zayıf duygu sinyalleri ve gürültülü örneklerde avantaj sağladığıdır. CH-SIMS v2 sonuçları, nötr duygunun olumlu veya olumsuz sınıflardan ayrılmasının zor olduğu durumlarda modelin daha güçlü ayrım yapabildiğini gösterir.
Altıncı sonuç, daha fazla uzman çalıştırmanın her zaman daha iyi olmadığıdır. Top-k sparse routing yaklaşımı, yalnızca en uygun uzmanları seçerek hem hesaplama yükünü azaltır hem de örneğe uygun temsil üretir. Çalışmada 5 uzman ve top-2 aktivasyon stratejisi, kaba duygu sınıflandırması ve korelasyon ölçütlerinde iyi bir denge sunar.
Bu Neden Önemli?
Bu çalışma, duygu analizinde “daha çok veri kanalını birleştirelim” düşüncesinin tek başına yeterli olmadığını gösterir. Asıl mesele, bu kanalların birbirini nasıl etkilediğini ve hangi bağlamda hangi kanalın daha güvenilir olduğunu anlayabilmektir.
Sosyal medya videoları, çevrimiçi eğitim kayıtları, müşteri destek görüşmeleri, insan-robot etkileşimi ve duygu farkındalıklı uygulamalarda metin, ses ve görüntü çoğu zaman birlikte bulunur. Ancak bu veriler her zaman tutarlı değildir. Kişi olumlu kelimeler kullanırken yüz ifadesi olumsuz olabilir; ses tonu metindeki anlamı tersine çevirebilir; görüntü düşük kaliteli olabilir; konuşma belirsiz veya ironik olabilir.
Bu nedenle bağlam farkındalıklı ve asimetrik etkileşim öğrenen modeller, klasik “üç kanalı birleştir ve tahmin yap” yaklaşımından daha ileri bir adım sunar. Model, yalnızca modaliteleri toplamaz; aralarındaki güç dengesini öğrenmeye çalışır.
Çalışma aynı zamanda Mixture-of-Experts mimarisinin çok modlu duygu analizinde neden önemli olabileceğini gösterir. Her örnek farklı bir duygu etkileşim örüntüsü taşıyorsa, tek bir genel model yerine farklı uzmanların bağlama göre seçilmesi daha esnek ve verimli olabilir.
Ancak bu tür sistemlerin gerçek dünyadaki kullanımı dikkat gerektirir. Duygu tanıma, insanın iç dünyasını kesin biçimde okuma aracı değildir. Model, verideki metin, ses ve görüntü sinyallerinden tahmin üretir; bu tahminler bağlama, kültüre, veri kalitesine, kullanıcı davranışına ve etik sınırlara bağlıdır.
Dikkat Noktaları
İlk dikkat noktası, çalışmanın preprint olmasıdır. Hakem değerlendirmesinden geçmediği için yöntem, sonuçlar ve iddialar ileride değişebilir. Bu nedenle bulgular umut verici araştırma sonucu olarak okunmalı, kesinleşmiş standart gibi değerlendirilmemelidir.
İkinci dikkat noktası, duygu tanımanın etik sınırlarıdır. Bir kişinin duygusunu metin, ses ve görüntüden otomatik olarak tahmin etmek hassas bir işlemdir. Eğitim, işe alım, sağlık, güvenlik, gözetim veya müşteri değerlendirme gibi alanlarda bu tür sistemler insanları otomatik etiketlemek için tek başına kullanılmamalıdır.
Üçüncü dikkat noktası, veri seti bağımlılığıdır. CMU-MOSI, CMU-MOSEI ve CH-SIMS v2 güçlü benchmarklar olsa da gerçek dünya verisi daha karmaşık olabilir. Farklı diller, kültürler, aksanlar, kamera kalitesi, sosyal bağlamlar ve yüz ifadesi normları modelin performansını değiştirebilir.
Dördüncü dikkat noktası, ince taneli duygu sınıflandırmasıdır. Çalışma bazı modüllerin ikili sınıflandırmayı güçlendirirken Acc-5 ve Acc-7 gibi daha ince duygu ölçütlerinde her zaman aynı faydayı sağlamadığını belirtir. Bu, olumlu/olumsuz ayrımının daha kolay; ince duygu yoğunluğu ve nötr sınırlarının ise daha zor olduğunu gösterir.
Beşinci dikkat noktası, model karmaşıklığıdır. Dinamik uzmanlar, top-k routing, asimetrik etkileşim ve çoklu kayıp fonksiyonları güçlü bir mimari sunsa da sistemi daha karmaşık hale getirir. Gerçek üretim ortamında açıklanabilirlik, hesaplama maliyeti, gecikme, veri gizliliği ve bakım gereksinimleri ayrıca değerlendirilmelidir.
Sonuç
Bu çalışma, çok modlu duygu analizinde önemli bir fikri merkeze alıyor: Metin, ses ve görüntü arasındaki ilişki her zaman eşit ve simetrik değildir. Bazı örneklerde metin diğer modaliteleri yönlendirir; bazı örneklerde ses ve görüntü metnin anlamını tamamlar; bazı durumlarda ise üç modalitenin birlikte işlenmesi gerekir.
Önerilen model, bu karmaşıklığı asimetrik çapraz-modal etkileşim ve dinamik Mixture-of-Experts yapısıyla ele alır. MRDCI, modaliteler arasındaki yönlü etkileri yakalar. IMoE, bağlama göre uygun uzmanları seçerek ince duygu sinyallerini işler. SCGI, kaybolabilecek tamamlayıcı global ipuçlarını güçlendirir. MSCR ise modaliteye özgü önemli sinyalleri korur.
Deneysel sonuçlar, modelin üç benchmark veri setinde güçlü performans gösterdiğini ve özellikle ikili duygu sınıflandırması, gürültülü örnekler ve zayıf duygu sinyallerinde avantaj sağlayabildiğini göstermektedir.
Verianla açısından çalışmanın ana mesajı şudur: Yapay zekânın insan duygusunu daha iyi anlaması için yalnızca metin, ses ve görüntüyü birlikte kullanması yetmez. Bu kanallar arasındaki yönlü güç ilişkisini, bağlamı ve örneğe özel etkileşimleri de öğrenmesi gerekir.
Kaynak ve Yöntem Notu
Bu içerik, “Asymmetric Cross-modal Interaction Learning with Dynamic Mixture-of-experts for Context-aware Multimodal Sentiment Analysis” başlıklı preprint çalışmaya dayalı olarak hazırlanmıştır. Çalışma; çok modlu duygu analizi, asimetrik çapraz-modal etkileşim, dinamik Mixture-of-Experts, top-k routing, semantik tamamlayıcı global etkileşim ve modaliteye özgü kanal iyileştirme yaklaşımlarını CMU-MOSI, CMU-MOSEI ve CH-SIMS v2 veri setleri üzerinde incelemektedir.
Bu içerik birebir çeviri değildir; çalışmanın ana fikri Verianla yayın çizgisine uygun biçimde sadeleştirilmiş ve özgün Türkçe editoryal makaleye dönüştürülmüştür.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir