

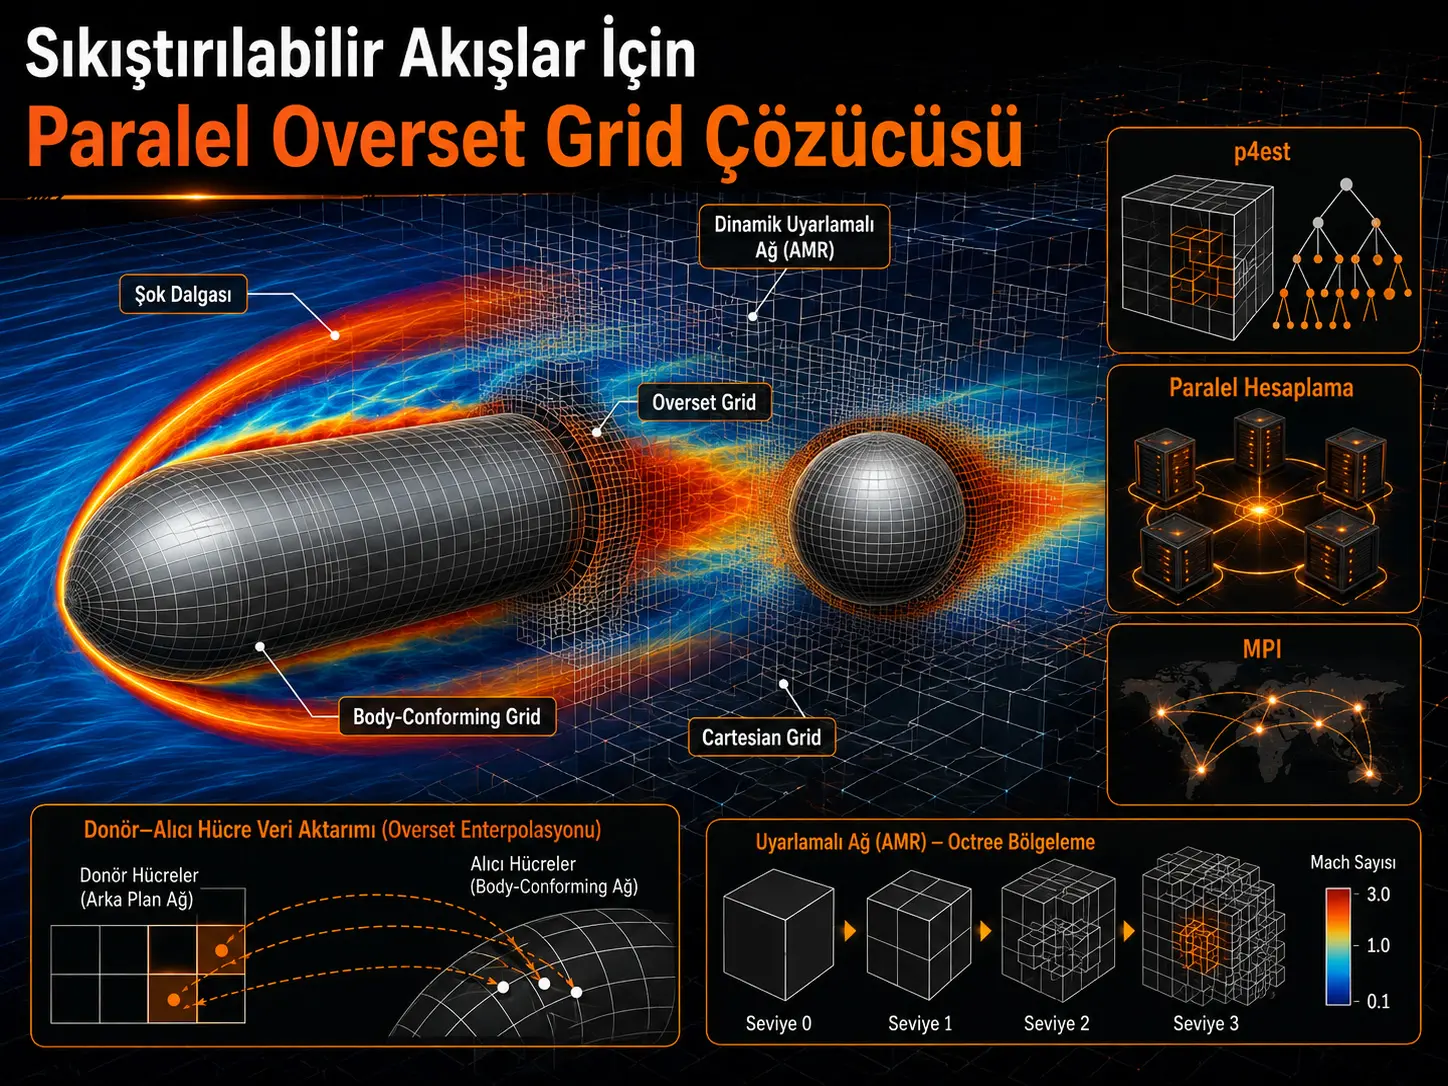
Utafiti huu unatengeneza kitatua cha Navier–Stokes chenye uwezo wa dinamik Adaptive Mesh Refinement (AMR), kinachofanya kazi sambamba na kutegemea finite-volume, kwa kutatua matatizo ya mtiririko wa tatu-dimensional unaobanika. Mbinu inaunganisha miundo miwili tofauti ya gridi: body-conforming grid inayofuata uso wa jiometri, na Cartesian off-body grid inayoweza kufanywa laini zaidi au mbaya zaidi kwa namna ya dinamik katika sehemu iliyobaki ya uwanja wa mtiririko. Uundaji wa gridi adaptivu ya Cartesian, shughuli za partition na usawazishaji wa mzigo hufanywa kwa maktaba ya wazi ya p4est octree.
Ubunifu mkuu wa programu katika utafiti huu ni kutenganishwa kwa data ya uwanja wa mtiririko kutoka kwenye eneo la data la node la p4est yenyewe. Katika muundo wa kawaida, density, velocity, temperature, vigezo vya turbulence, gradients na taarifa za MUSCL limiter hubebwa pamoja na node za p4est; katika usanifu uliopendekezwa, ndani ya p4est huhifadhiwa tu kiashiria cha anwani na taarifa ya MPI rank. Uwanja halisi wa mtiririko huhifadhiwa katika muundo tofauti wa data. Hivyo, gridi inapogawanywa upya, hakuna haja ya kusafirisha kupitia MPI data zote zinazoweza kuhesabiwa tena au ambazo tayari zimepoteza uhalali wake; inatosha kuhamisha tu vigezo vya msingi vya mtiririko.
Kitatua kilichotengenezwa kimejaribiwa katika matatizo mawili ya benchmark ya tatu-dimensional. Katika hali thabiti ambapo mtiririko wenye kasi ya Mach 2 unapita juu ya silinda nusu-isiyo na mwisho yenye pua butu, mgawo wa shinikizo la uso wa kihesabu umeonyesha ulinganifu wa jumla na matokeo ya majaribio, na gridi adaptivu imejikusanya kiotomatiki katika eneo la bow shock. Katika jaribio la pili, mwingiliano wa wimbi la mshtuko tambarare la Mach 2,89 na duara lililo katika hewa tulivu umewekewa modeli; reflected shock, triple point, difracted shock na wake vortex vimeweza kufuatiliwa kwa urekebishaji wa gridi wa kidinamiki.
Katika jaribio la utendaji sambamba, suluhisho thabiti la overset lilionyesha ufanisi sambamba wa %89,7 katika 32 MPI rank, %80 katika 64 rank na %65 katika 128 rank. Katika tatizo la kidinamiki la duara–shok, flow solver na AMR zilipotathminiwa pamoja, ufanisi sambamba katika 128 MPI rank uliripotiwa kuwa %61. Mbinu iliyosambazwa iliyopendekezwa imeleta ongezeko la %50 katika ufanisi wa jumla wa kitatua sambamba katika 32 MPI rank ikilinganishwa na utekelezaji wa awali wa master–slave. Hata hivyo, inapofikia 128 rank, ufanisi hupungua hasa katika hatua za interpolation na overset grid assembly kutokana na mgawanyo usio sawa wa idadi ndogo ya seli za donor–receiver kati ya rank.
Kwa mtazamo wa Türkiye: Utafiti huu unatokana moja kwa moja na kitatua cha CFD kilichotengenezwa katika İstanbul Teknik Üniversitesi. Kwa hiyo, kwa mtazamo wa Türkiye, si utekelezaji tu wa mbinu ya kigeni, bali ni mfano halisi wa kutengeneza mbinu ya kihesabu kuhusu kuunganisha mtiririko wa tatu-dimensional unaobanika, AMR ya kidinamiki, overset grid na vipengele vya hesabu sambamba ya MPI ndani ya kitatua hicho hicho cha ndani ya taasisi. Hata hivyo, makala inatoa uthibitishaji juu ya benchmark mbili na node moja ya HPC; jiometri za ndege halisi, uskalishaji wa supercomputer zenye node nyingi au uthibitishaji wa viwandani havijajaribiwa na utafiti huu.
Kwa nini overset grid na Adaptive Mesh Refinement zinatumika pamoja?
Lengo kuu ni kutumia azimio la juu katika maeneo yanayohitajika kimwili tu, badala ya kutatua eneo lote la hesabu kwa gridi laini sana kila wakati. Katika maeneo kama mawimbi ya mshtuko, gradients kali na maeneo ya separation, ukubwa wa seli hupunguzwa, wakati katika maeneo ya mbali gridi mbaya zaidi inaweza kutumika. Hivyo inawezekana kutatua tukio lilelile la kimwili kwa idadi ya jumla ya seli iliyo chini zaidi.
Mbinu ya overset hutenganisha adaptation hii na jiometri. Wakati body-conforming grid inatatua uso wa jiometri na boundary layer, mtiririko ulio mbali na jiometri huhesabiwa juu ya off-body Cartesian grid. Gridi mbili huwekwa juu ya nyingine, na katika maeneo ya makutano hufanywa interpolation kutoka seli za donor katika gridi nyingine kwa ajili ya seli za receiver.
Muundo huu una faida hasa katika matatizo yenye miundo ya tatu-dimensional inayosogea au miundo yenye shok kali; kwa sababu shughuli za refine/coarsen za Cartesian off-body grid hazilazimiki kuunda upya moja kwa moja jiometri changamano ya uso.
Ni milinganyo gani ya mtiririko inayotatuliwa?
Benchmark zote mbili zimewekewa modeli kwa milinganyo ya Navier–Stokes ya tatu-dimensional inayobanika. Kwa kuwa tatizo thabiti la mwili wenye pua butu ni turbulent, hutumia uundaji wa Reynolds-Averaged Navier–Stokes (RANS), wakati tatizo la muda la duara–shok hutumia uundaji wa laminar.
Uhifadhi wa mass:
\[ \frac{\partial \rho}{\partial t} + \frac{\partial \rho u_j}{\partial x_j} =0 \]
Uhifadhi wa momentum:
\[ \frac{\partial \rho u_i}{\partial t} + \frac{\partial \rho u_i u_j}{\partial x_j} = -\frac{\partial p}{\partial x_i} + \frac{\partial \tau_{ij}}{\partial x_j} \]
Uhifadhi wa nishati jumla:
\[ \frac{\partial \rho e_t}{\partial t} + \frac{\partial \rho e_t u_j}{\partial x_j} = -\frac{\partial p u_j}{\partial x_j} + \frac{\partial}{\partial x_j} \left( k\frac{\partial T}{\partial x_j} \right) + \frac{\partial u_i\tau_{ij}}{\partial x_j} \]
Katika benchmark thabiti, modeli ya turbulence ya k–ω SST 2003 imetumika kwa ajili ya kumodeli mikazo ya Reynolds. Gesi imechukuliwa kuwa kamilifu kikaloriki. Katika hali thabiti, mabadiliko ya viscosity kulingana na temperature yamewekewa modeli kwa sheria ya Sutherland, wakati katika benchmark ya muda dynamic viscosity imechukuliwa kuwa thabiti isiyotegemea temperature.
Flux za kihesabu huhesabiwaje?
Milinganyo imediscretize kwa mbinu ya finite-volume. Mlinganyo nusu-discrete wa seli moja umetolewa katika chanzo kwa umbo la jumla lifuatalo:
\[ \frac{\partial W_i}{\partial t} = \frac{1}{V_i} \sum_{j=1}^{J} \left(F_{v,ij}-F_{c,ij}\right)S_{ij} + Q_i \]
Katika flux za convective, skimu ya AUSM+up imetumika, na reconstruction ya MUSCL imetekelezwa kwa usahihi wa anga wa daraja la pili. Ili kukandamiza oscillations karibu na discontinuities kama shok, Venkatakrishnan slope limiter imetumika. Diffusive flux zimmehesabiwa kwa mbinu ya central difference ya daraja la pili, na integration ya muda imefanywa kwa mbinu ya explicit Euler ya daraja la kwanza.
Katika suluhisho thabiti, time step kwa kila seli huamuliwa kienyeji kulingana na nambari ya Courant thabiti; katika matatizo ya transient, time step inayotumika kwa seli zote imechaguliwa kama thamani ya chini zaidi inayopatikana kutoka kwenye sharti la Courant.
Gridi za off-body na body-conforming zinaunganishwaje?
Off-body Cartesian grid huundwa na blocks zilizo na idadi thabiti ya seli katika viwango tofauti vya refinement. Tofauti ya juu zaidi kati ya viwango vya refinement vya grid block mbili jirani huhifadhiwa kama 1; kwa maneno mengine, sharti la 2:1 balance hudumishwa.
Kwenye uso wa pamoja wa seli za Cartesian zilizo katika viwango tofauti vya refinement, mbinu ya hanging-cell hutumika badala ya overset interpolation ya kawaida. Flux ya uso ya seli moja mbaya huhesabiwa kwa jumla ya flux za seli laini jirani:
\[ F_i=\sum_{j=1}^{4}F_j \]
Katika eneo ambalo gridi za body-conforming na Cartesian zinafunikana, uhusiano wa donor–receiver hutumika. Sifa moja ya mtiririko katika seli ya receiver huhesabiwa kwa inverse-distance interpolation:
\[ \phi_i= \frac{\sum_{j=1}^{J}w_j\phi_j} {\sum_{j=1}^{J}w_j} \]
na uzito:
\[ w_j= \frac{1} {|x_{c,j}-x_{c,i}|} \]
kama ifuatavyo.
p4est hufanya nini katika mfumo huu?
p4est ni maktaba ya wazi inayosimamia kwa sambamba makusanyo ya octree, yaani muundo wa “forest of octrees”. Katika utafiti, kila octree node kifizikia inalingana na block moja ya Cartesian grid. Node hupangwa kando ya Morton au Z-order space-filling curve.
Muundo huu huruhusu p4est kufanya:
- grid refinement na coarsening,
- 2:1 balance,
- partitioning,
- kuunda ghost-layer,
- kusambaza grid blocks kati ya MPI rank
.
Matumizi ya p4est katika utafiti huu yanategemea kabisa CPU na MPI. Hakuna device offloading kwenda GPU au accelerator nyingine iliyotekelezwa.
Tatizo la usanifu wa kumbukumbu uliotangulia lilikuwa nini?
Katika modeli ya kawaida ya data ya mtumiaji ya p4est, block ya data yenye ukubwa ulioamuliwa na mtumiaji kwa kila node hu-allocate na kusimamiwa na p4est. Katika kitatua cha CFD, block hii haibebi tu namba chache kama density au velocity; lazima ibebe data ya mtiririko ya grid block yote.
Chanzo kinatenganisha makundi matatu ya data:
- Gp: sifa za msingi za mtiririko \([\rho,u,v,w,T,k,\omega]\),
- Gs: sifa za pili kama viscosity, pressure na gradients za mtiririko,
- Gl: istilahi za MUSCL limiter.
Katika muundo wa kawaida, makundi haya yote ya data lazima yahifadhiwe pamoja na p4est node na kusafirishwa wakati wa partition. Hata hivyo, sehemu muhimu ya Gs inaweza kuhesabiwa upya kutoka Gp; zaidi ya hayo, gradients na thamani za limiter zinahusu iteration iliyotangulia katika hatua ya grid migration, kwa hiyo zitatengenezwa upya tayari katika iteration mpya.
Muundo uliopendekezwa wa data iliyotenganishwa hufanyaje kazi?
Watafiti wanaondoa data ya mtiririko kutoka eneo la allocation la p4est na kuiweka katika muundo tofauti wa data wa q. Katika eneo la mtumiaji la p4est node, huhifadhiwa tu:
- pointer inayoonyesha anwani ya data ya mtiririko katika kumbukumbu,
- MPI rank ambayo node inamilikiwa nayo
.
Mabadiliko haya madogo hutatua matatizo mawili muhimu.
Kuzuia upotevu wa data wakati wa coarsen–balance
Katika mtiririko wa kawaida wa p4est, kundi la node linapofanyiwa coarsen, sifa za mtiririko za seli child huunganishwa katika seli parent kwa wastani uliopimwa kwa volume:
\[ \phi_i= \sum_{j=1}^{J} \left( \frac{\phi_j V_j}{V_i} \right) \]
Lakini ikiwa parent node inayojitokeza inavunja sharti la 2:1 balance, mwito unaofuata wa p4est_balance unaweza ku-refine node hii tena. Katika hali hii, data iliyokuwa imepimwa wastani kutoka kwa children kwenda parent baadaye husambazwa tena kwa children, na taarifa asilia ya azimio la juu hupotea.
Katika muundo uliopendekezwa, kwa kuwa uwanja wa mtiririko umetenganishwa na node allocation ya p4est, data halisi za children hazifutwi mara moja wakati wa coarsen. Ikiwa shughuli ya balance inafuta coarsen, data za zamani huunganishwa tena na child node zilizotengenezwa upya. Ni pale tu matokeo ya coarsen yanapokuwa kweli ya kudumu ndipo data za children zilizomaskiwa huachiliwa.
Kupunguza trafiki isiyo ya lazima ya MPI wakati wa Load balancing
p4est_partition inapogawa upya grid blocks kati ya MPI rank, mbinu ya kawaida hubeba data zote za mtumiaji za node. Watafiti, hata hivyo, wanahakikisha kuwa kundi la Gp pekee ndilo linalotumwa kwa MPI rank mpya. Gs na Gl hutengenezwa upya katika mzunguko mpya wa suluhisho.
Hivyo, ingawa hatua ya partition hugawanywa katika hatua mbili za mawasiliano, kiasi cha jumla cha data inayobebwa hupunguzwa. Dai la utafiti ni kwamba mbinu hii inapunguza muda wa mawasiliano na solver runtime ya jumla.
Kwa nini miunganisho ya overset hujengwa upya wakati gridi ya dinamik inabadilika?
Cartesian grid inapofanyiwa refine au coarsen, jozi zilizopo za seli donor–receiver zinaweza kupoteza uhalali wake. Baada ya Load balancing, umiliki wa MPI rank wa grid blocks pia hubadilika. Kwa hiyo baada ya kila mwito wa AMR, overset grid assembly lazima ifanywe tena.
Katika mbinu ya awali ya master–slave, jiometri za receiver zilitumwa kwa MPI rank moja ya kati, master rank ilihifadhi taarifa yote ya body-conforming grid, na donor search ilifanywa katika sehemu moja. Hii iliongeza matumizi ya kumbukumbu na pia iliunda kikwazo cha kati kadiri idadi ya MPI rank ilivyoongezeka.
Katika mbinu mpya, grid assembly inafanywa kuwa ya kusambazwa kikamilifu.
Mbinu ya bounding box inapunguzaje mawasiliano?
Kila partition ya Cartesian na body-conforming grid huwakilishwa na bounding box yenye koordinati za chini na za juu. Bounding box za seli za receiver hutangazwa kwa MPI rank, na taarifa za kina za jiometri hubadilishwa tu kati ya partition zinazokatana.
Kukatana kwa partition mbili katika mwelekeo fulani wa koordinati hujaribiwa kwa sharti:
\[ x_{A,max}\geq x_{B,min} \quad\land\quad x_{A,min}\leq x_{B,max} \]
.
Hivyo rank moja haihitaji kutuma seli zake zote za grid kwa rank nyingine zote.
Utafutaji wa donor katika body-conforming grid unaharakishwaje?
Kwa body-conforming grid, Alternating Digital Tree (ADT) huundwa. Kila seli huwakilishwa kama tree node na kuwekwa katika muundo wa binary tree kulingana na koordinati za bounding box.
Wakati donor anatafutwa kwa ajili ya seli ya receiver, utafutaji huanza kwenye mzizi wa mti. Ikiwa bounding box hazikatani, tawi moja la mti huondolewa kikamilifu kwa msaada wa ulinganisho wa koordinati. Ikiwa kuna kukatana, seli huongezwa kwenye orodha ya candidate donor na utafutaji huendelea katika matawi ya chini. Hatimaye, candidate ambayo centroid yake iko karibu zaidi na seli ya receiver huchaguliwa kama donor, na majirani wake wa karibu pia hutumika kwa interpolation stencil.
Kwa kuwa body-conforming grid imefanyiwa partition mapema na jiometri yake haibadiliki wakati wa suluhisho, ADT inaweza kuundwa mara moja tu mwanzoni mwa suluhisho na kuhifadhiwa katika kumbukumbu.
Kodi ya Morton hutumikaje katika utafutaji wa donor wa Cartesian?
Kwa kuwa Cartesian grid tayari inasimamiwa na p4est octree forest, hakuna haja ya kuunda spatial tree tofauti. Koordinati za seli ya receiver hubadilishwa kuwa mfuatano wa biti kulingana na kiwango cha juu zaidi cha refinement, na biti hizi katika vipimo vitatu huunganishwa katika kodi moja ya Morton.
Vikundi husika vya biti vya kodi ya Morton husomwa kwa mpangilio ili kuamua ni child node gani ndani ya octree iendewe, na leaf node inapofikiwa, grid block ya Cartesian inayojumuisha pointi ya receiver hupatikana.
Mfumo huu hutumia kwa mara ya pili muundo wa data wa anga wa p4est uliopo tayari kwa ajili ya donor search.
Benchmark ya kwanza iliundwaje?
Tatizo la kwanza la uthibitishaji ni mtiririko thabiti na turbulent unaobanika ambapo free stream ya Mach 2 hupita juu ya silinda nusu-isiyo na mwisho yenye pua butu.
| Parameta ya free stream | Thamani iliyotumika katika chanzo |
|---|---|
| Nambari ya Mach | 2 |
| Nambari ya Reynolds | 353.100 |
| Temperature | 242,3 K |
| Kiwango cha turbulence | %0,05 |
Ingawa tatizo ni axisymmetric, robo ya eneo la hesabu imewekewa modeli kwa tatu-dimensional ili kuonyesha utendaji wa tatu-dimensional wa kitatua.
Cartesian grid ilianzishwa kwa 3 × 3 × 3 octree forest na kila node iliwakilisha grid block ya seli 2 × 2 × 2. Kiwango cha juu zaidi cha refinement ni 5. Kigezo cha refinement ni Mach gradient na thamani za kizingiti zilitumika kama:
\[ Q_{lower}=0.185, \qquad Q_{upper}=0.218 \]
. Seli ya kwanza ya ukuta ya body-conforming grid iliundwa ili iwe takriban \(y^+=5\), na kigezo cha convergence kiliamuliwa kuwa %0,01 kwa cumulative residual relative error.
Ni seli ngapi zilitumika katika utafiti wa convergence ya gridi?
Viwango vitatu vya gridi vilinganishwa:
| Azimio la gridi | Kiwango cha juu zaidi cha refinement | Idadi ya seli katika hali thabiti |
|---|---|---|
| Mbaya | 4 | 334.627 |
| Wastani — suluhisho kuu | 5 | 1.419.996 |
| Laini | 6 | 3.697.852 |
Ulinganisho wa mikunjo ya mgawo wa shinikizo umeonyesha kuwa gridi ya wastani inatosha kwa tatizo. Kwa sababu hiyo, watafiti walitumia gridi ya wastani ya takriban seli milioni 1,42 katika uchambuzi wa utendaji.
Je, matokeo ya mwili wenye pua butu yanalingana na jaribio?
Kwa ujumla ndiyo. Usambazaji wa kihesabu wa \(C_p\) umeonyesha ulinganifu mzuri na matokeo ya majaribio ya rejea. Hata hivyo, katika eneo la stagnation point \(s/D=0\) na katika eneo karibu na tip-base ya mwili \(s/D>0.8\), suluhisho linakadiria thamani za majaribio kwa kiwango cha chini kidogo.
Kulingana na ulinganisho wa utafiti, matokeo ya kitatua kilichotengenezwa yanaonekana kuwa karibu zaidi na data ya majaribio kuliko matokeo ya awali ya kihesabu ya scFLOW yaliyotolewa kwenye grafu ileile. Ulinganisho huu ni halali tu kwa benchmark hii na masharti yaliyotumika; haumaanishi ubora wa jumla wa programu ya CFD.
Katika picha za Numerical schlieren na Mach contour, inaonekana kuwa Cartesian grid adaptivu imefikia kiwango cha juu zaidi cha refinement kando ya mstari wa bow shock. Hivyo discontinuity ya shok hudumishwa katika azimio la juu bila kutumia gridi laini isiyo ya lazima katika maeneo ya mbali.
Benchmark thabiti iliskalishwa vipi kwa sambamba?
Katika jaribio la strong-scaling, grid yenye seli 1.419.996 iliwekwa thabiti na idadi ya MPI rank ikaongezwa hatua kwa hatua. Idadi ya seli za receiver katika gridi hii ni 34.970. Kwa kila idadi ya rank, muda wa wall-clock wa 100 iterations za suluhisho ulipimwa.
Speed-up:
\[ S_f=\frac{T_1}{T_N} \]
na ufanisi sambamba:
\[ \eta=\frac{S_f}{N}\times100 \]
vimefafanuliwa hivyo.
Verianla Live: Ufanisi sambamba wa kitatua cha overset kulingana na idadi ya MPI rank
Thamani zifuatazo zinaonyesha ufanisi sambamba wa kitatua cha overset-grid uliopimwa katika benchmark thabiti ya mwili wenye pua butu ya Mach 2, wakati takriban seli milioni 1,42 ziliwekwa thabiti. Haya si matokeo ya weak-scaling, bali ni matokeo ya strong-scaling.
| Idadi ya MPI rank | Ufanisi sambamba (%) | Aina ya jaribio | Chanzo |
|---|---|---|---|
| 32 | 89,7 | Strong scaling — overset solver | Kielelezo 12 na maandishi ya matokeo |
| 64 | 80 | Strong scaling — overset solver | Kielelezo 12 na maandishi ya matokeo |
| 128 | 65 | Strong scaling — overset solver | Kielelezo 12 na maandishi ya matokeo |
Maelezo ya chanzo cha Verianla Live: Uonyeshaji huu huundwa kutoka kwenye jedwali hili linaloonekana la data ya kisayansi. Jedwali huhifadhiwa kama source-of-truth ya kisayansi.
Solver imeonyesha strong scaling hadi 32 MPI rank. Wakati ufanisi sambamba katika 32 rank ulikuwa %89,7, ulipungua hadi %80 katika 64 rank na %65 katika 128 rank. Katika 128 rank, tofauti ya utendaji sambamba kati ya suluhisho la overset na rejea ya single-grid yenye idadi ileile ya seli iliripotiwa kuwa takriban %7 kwa kiwango cha juu zaidi.
Kwa nini Interpolation inaskalika vibaya zaidi kuliko solver ya jumla?
Hesabu inayofanywa kwa ajili ya Interpolation imezuiliwa kwa seli za donor–receiver. Kadiri idadi ya MPI rank inavyoongezeka, idadi ya receiver kwa kila rank hupungua sana na seli za overlap hazisambazwi sawasawa kati ya rank.
Ufanisi sambamba wa sehemu ya Interpolation computation hushuka takriban hadi viwango hivi:
- hadi 32 MPI rank %70,
- katika 64 MPI rank %44,
- katika 128 MPI rank %30
.
Hata hivyo, kwa kuwa interpolation huchangia tu takriban %0,2 ya gharama ya jumla ya iteration katika 1 rank na %5,11 katika 128 rank, ufanisi huu mdogo wa sub-routine huathiri utendaji wa jumla wa solver kwa kiwango kidogo tu.
Mbinu mpya ni bora kiasi gani kuliko kitatua cha awali cha master–slave?
Chanzo kinaripoti kwamba, ikilinganishwa na mbinu ya awali ya master–slave ya kundi lilelile la utafiti, mbinu mpya iliyosambazwa imeongeza ufanisi wa jumla wa solver sambamba kwa %50 katika 32 MPI rank.
Matokeo haya ni ulinganisho uliofanywa kwa hardware, grid na benchmark maalumu. Utafiti haujaonyesha kwamba algoritmi mpya itatoa faida kamili ya %50 katika kila tatizo au kila usanifu wa HPC.
Kwa nini benchmark ya pili ni ngumu zaidi?
Tatizo la pili si thabiti. Wimbi la mshtuko tambarare linalosonga kwa kasi ya Mach 2,89 hugonga duara lililo katika hewa tulivu mwanzoni; baada ya muda, reflected shock, incident shock, triple point, difracted shock na miundo ya vortex hujitokeza.
Kwa kuwa miundo hii ya mtiririko inasogea, eneo la grid laini pia lazima lisogee kadiri muda unavyopita. Kwa hiyo gridi thabiti iliyofanyiwa refine mara moja tu haitoshi; AMR huitwa tena na tena wakati wa suluhisho.
Nambari ya Reynolds ya mtiririko imetolewa kama 7800 na imewekewa modeli ya laminar. Kwa hewa iliyotumika, chanzo kinatoa:
- \(R=287.2\) J/(kg·K),
- \(c_p=1005.2\) J/(kg·K),
- \(\gamma=1.4\)
kama thamani.
Kwa nini data za Region 1 na Region 2 katika benchmark ya duara zinapaswa kusomwa kwa uangalifu?
Maandishi ya chanzo yanasema kuwa Region 1 ni tulivu, na Region 2 ni eneo la post-shock lenye kasi ya mwisho katika mwelekeo wa x. Kinyume chake, Tablo 2 iliyochapishwa inatoa thamani hizi:
| Kiasi kilichotolewa katika chanzo | Region 1 | Region 2 |
|---|---|---|
| Density — imetambulishwa katika jedwali kama kg/m³ | 5,1432014 | 1,4 |
| Temperature — imetambulishwa katika jedwali kama K | 0,006123676 | 0,002487067 |
| Velocity — imetambulishwa katika jedwali kama m/s | 2,0451168 | 0 |
Thamani za velocity ziko kinyume na ufafanuzi wa maandishi wa Region: jedwali linaonyesha Region 1 kama inayosonga na Region 2 kama tulivu. Pia, utoaji wa thamani za temperature katika mpangilio wa 10−3 zikiwa na lebo ya K unaonekana kama tatizo la uskalishaji/lebo lisilolingana na temperature halisi yenye vipimo. Kwa kuwa chanzo hakielezi hili, Verianla hairekebishi kwa dhana kitengo cha namba hizi au mpangilio wa Region.
AMR ya kidinamiki iliundwaje?
Cartesian grid ilianzishwa kwa 10 × 5 × 5 base octree node na kila node ilikuwa na grid block ya seli 2 × 2 × 2. Kiwango cha juu zaidi cha refinement ni 5. AMR iliitwa mara moja kila 25 flow-solver iterations.
Kigezo cha refinement ni density gradient:
\[ Q_{lower}=0.6, \qquad Q_{upper}=0.625 \]
Seli ya kwanza ya body-conforming grid ilihakikishwa kuwa takriban \(y^+\approx2.5\), na gridi ilipanuliwa 2,5D nje ya uso wa duara.
Suluhisho liliendeshwa kwa CFL = 0,7; time step ya kimataifa isiyo na kipimo ilibadilika kulingana na iteration takriban kati ya \(9.2\times10^{-5}\) na \(1.5\times10^{-4}\).
Kwa nini chanzo kinapingana kuhusu idadi ya seli katika benchmark ya duara?
Katika sehemu moja ya utafiti, kwa “initial overset grid system” hutolewa seli 3.241.936 na seli 54.294 za receiver. Lakini katika sehemu ya baadaye inayosimulia maendeleo ya mtiririko kwa muda, imeandikwa kwamba katika \( \bar{t}=1.832 \) gridi iliongezeka kutoka seli 2.232.704 za awali hadi seli 3.241.936.
Kwa kuwa kauli hizi mbili haziungi mkono idadi ileile ya “awali” ya seli, hapa inahifadhiwa kama kutokulingana ndani ya chanzo. Kwa upande mwingine, thamani ya seli 3.241.936 kwa \( \bar{t}=1.832 \) inaonekana katika miktadha yote miwili, na hiyo ndiyo gridi iliyochaguliwa kama hali ya kidinamiki yenye mzigo mkubwa katika jaribio la strong-scaling.
Wimbi la shok lilikua vipi kuzunguka duara?
Picha za Numerical schlieren na Mach zinaonyesha maendeleo ya mtiririko katika nukta kadhaa za muda usio na kipimo:
- \(\bar{t}=0\): incident shock tambarare iko takriban 0,6D kutoka katikati ya duara.
- \(\bar{t}\approx0.307\): shok inapofikia uso wa duara, reflected shock hutokea.
- \(\bar{t}=0.615\): triple point huonekana wazi katika makutano ya incident na reflected shock.
- \(\bar{t}=1.832\): diffracted shock na triple point husonga kuelekea eneo la wake la duara na vortex moja huonekana.
Mistari ya gridi adaptivu inaonyesha kuwa kiwango cha juu cha refinement kinafuata miundo ya shok inayosonga. Watafiti pia wanaeleza kwamba katika \( \bar{t}=1.832 \), katika eneo ambalo reflected shock inaungana na triple point, kulikuwa na upotevu mdogo katika ubora wa tracking kutokana na kudhoofika kwa density gradient.
Ulinganisho wa experimental schlieren ulionyesha nini?
Picha ya Numerical schlieren imelinganishwa na picha ya majaribio ya kawaida ya Bryson na Gross. Imeripotiwa kuwa nafasi za reflected shock, triple point na transmitted shock zinalingana vizuri kwa ujumla na jaribio.
Kuna tofauti ndogo katika reflected shock standoff distance. Waandishi wanapendekeza kuwa tofauti hii inaweza kutokana na artefacts za upigaji picha zinazosababishwa na deformation zinazoonekana katika picha ya majaribio. Maelezo haya ni tafsiri ya waandishi; utafiti haujajaribu kwa njia ya majaribio sababu ya tofauti hii kando.
Ni shughuli gani hutokea katika mwito mmoja wa AMR ya kidinamiki?
Katika utafiti, mchakato wa AMR umegawanywa katika segmenti tano zinazofuatana:
- Cell flagging: seli hutathminiwa kwa sensor function na kuwekewa alama kwa refine/coarsen.
- Grid adaptation: blocks zilizopewa alama hufanyiwa refine au coarsen.
- Load balancing: grid blocks hugawanywa upya kati ya MPI rank na ghost layer huundwa.
- Connectivities: miunganisho ya seli jirani hujengwa upya na ku-cache.
- Grid assembly: jozi za overset donor–receiver, coefficients za interpolation na communication tables huundwa upya.
Katika tatizo la kidinamiki, hatua hizi tano zote hurudiwa mara moja kila 25 solver iterations.
Gharama ya kihesabu ya AMR ni kiasi gani?
Shughuli ya AMR huchukua muda mfupi kuliko iteration moja ya flow-solver katika idadi zote za MPI rank; hata hivyo iko katika kiwango kilekile. Kwa kuwa AMR hufanya kazi mara moja tu kila 25 iterations, athari yake ya jumla hupunguzwa kwa kuwa ya nadra.
Katika 128 MPI rank, muda wa mwito mmoja wa AMR umeripotiwa kuwa takriban %8 ya muda wa jumla wa 25 flow-solver iterations zinazopita kati ya AMR mbili.
Sehemu ghali zaidi ya AMR ni overset grid assembly. Katika idadi za rank zilizochunguzwa, grid assembly inaunda angalau %53 ya muda wa AMR.
Tatizo la kidinamiki liliskalishwa vipi katika 128 MPI rank?
Utendaji wa scaling wa mchakato wa AMR peke yake si wenye nguvu kama solver. Sababu kuu ni kwamba hoja za donor/receiver na maeneo ya overlap hayasambazwi sawasawa kati ya MPI rank.
Hata hivyo, kwa sababu AMR huitwa mara moja tu kila 25 iterations, mfumo mzima wa flow solver + AMR huonyesha tabia bora zaidi katika idadi kubwa za rank. Utafiti unaripoti takriban %61 ufanisi sambamba katika 128 MPI rank kwa benchmark ya kidinamiki.
Katika sehemu ya matokeo, imeelezwa kuwa hatua za AMR na overset-grid-assembly zilifikia takriban %42 ya ufanisi sambamba katika 64 MPI rank.
Je, Load balancing kweli inafanya kazi?
Ndiyo; kuna faida inayoweza kupimwa katika benchmark iliyotumika. Watafiti walilinganisha hali ileile ya dynamic grid kwa 32 MPI rank wakiwa wamewasha na kuzima load balancing.
Katika hali ya load-balanced, usambazaji wa normalize CPU workload wa rank umekuwa wa aina moja zaidi. Chanzo kinaripoti angalau %17,4 kupungua kwa workload katika MPI rank.
Kwa kuangalia muda wa wall-clock unaojumuisha ghost-layer na inter-grid communication, iteration ya solver iliyo load-balanced ilichukua muda %10,1 mfupi zaidi kuliko iteration ambayo load balancing haikutekelezwa.
Kipimo hiki ni cha hali moja baada ya adaptation. Waandishi wanaeleza kuwa katika suluhisho halisi, kwa kuwa AMR huitwa mara nyingi, faida inaweza kujikusanya katika kipindi chote cha suluhisho.
Matokeo yanayoungwa mkono na utafiti
- Kwa p4est, AMR ya tatu-dimensional block-based Cartesian imeweza kuunganishwa na body-conforming overset grid ndani ya kitatua kilekile cha CFD ya mtiririko unaobanika.
- Usanifu unaotenganisha data ya mtiririko na p4est node allocation hupunguza data migration isiyo ya lazima na kuzuia upotevu usio wa lazima wa taarifa ya mtiririko wakati wa coarsen–balance.
- Kwa miundo ya utafutaji ya distributed bounding-box, ADT na octree, overset reassembly isiyohitaji master rank ya kati imetekelezwa.
- Katika benchmark ya mwili wenye pua butu ya Mach 2, mgawo wa shinikizo la uso uliokokotolewa kwa ujumla unaendana na data ya majaribio.
- Adaptive grid imefikia kiwango cha juu cha refinement karibu na bow shock.
- Katika benchmark ya duara–shok, miundo ya reflected shock, triple point, diffracted/transmitted shock na vortex imekamatwa kwa njia ya kihesabu.
- Katika benchmark thabiti, overset solver imeonyesha %65 ufanisi sambamba katika 128 MPI rank.
- Mfumo wa dynamic solver + AMR umeonyesha takriban %61 ufanisi sambamba katika 128 MPI rank.
- Jaribio la load balancing katika 32 MPI rank limeleta punguzo la %10,1 katika muda wa wall-clock iteration.
- Mbinu mpya iliyosambazwa imeleta ongezeko la %50 katika ufanisi wa jumla sambamba katika 32 MPI rank ikilinganishwa na toleo la awali la master–slave.
Matokeo ambayo utafiti hauungi mkono au haujayajaribu
- Haijaonyeshwa kwamba kitatua kitatoa usahihi uleule au utendaji uleule wa scaling katika matatizo yote ya CFD ya mtiririko unaobanika.
- GPU au accelerator offloading haijajaribiwa katika utafiti.
- Hakujafanywa scaling test zaidi ya 128 cores au juu ya zaidi ya HPC node moja.
- Hakujafanywa industrial validation katika jiometri ya ndege halisi, kombora, roketi au turbomachinery.
- Tofauti ya majaribio katika maeneo ya stagnation na tip-base katika benchmark ya mwili wenye pua butu haijaondolewa kabisa.
- Katika benchmark ya duara, miundo yote ya shok haijafuatiliwa kwa ukamilifu; karibu na \( \bar{t}=1.832 \) kulionekana upotevu mdogo wa tracking kutokana na density gradient kudhoofika.
- Haijaonyeshwa kwamba overset grid assembly iko load-balanced kwa namna bora katika MPI rank za juu.
- Kutokulingana kwa ndani katika chanzo kuhusu hali za awali za Region 1/Region 2 na idadi ya seli za awali hakujatatuliwa.
- Ufanisi sambamba wa %65 au %61 uliopatikana kwenye node moja hauwezi kujumuishwa moja kwa moja kwa mazingira ya supercomputer yenye node nyingi.
Mbinu na Matokeo ya Utafiti
Usanifu wa kitatua cha kihesabu
Programu iliyotengenezwa ni kitatua cha tatu-dimensional density-based finite-volume cha Navier–Stokes kwa mtiririko unaobanika. Katika tatizo thabiti la turbulent, modeli ya k–ω SST 2003 imetumika. Katika flux za convective, AUSM+up imetumika; katika reconstruction ya daraja la pili MUSCL, na karibu na discontinuity Venkatakrishnan limiter imetekelezwa. Istilahi za Diffusive zimehesabiwa kwa mbinu ya central ya daraja la pili, na integration ya muda kwa explicit Euler.
Usanifu wa Grid una vipengele viwili:
- structured body-conforming grid iliyofanyiwa partition mapema, inayotatua jiometri na mtiririko wa karibu na ukuta,
- block-based adaptive Cartesian off-body grid inayosimamiwa na p4est octree forest.
Kigezo cha refinement na coarsening
Katika kila Cartesian grid block, parameta ya mtiririko iliyochaguliwa \(Q\) hulinganishwa na vizingiti vya chini na juu:
- ikiwa \(Q>Q_{upper}\), refine,
- ikiwa \(Q<Q_{lower}\), coarsen
hutekelezwa.
Mpangilio wa grid adaptation upande wa p4est ni:
p4est_refinep4est_balancep4est_coarsenp4est_balance
. Mwito wa pili wa balance ni muhimu ili kurejesha sharti la 2:1 balance baada ya coarsen.
Mantiki ya computational ya usanifu wa data uliopendekezwa
Katika muundo wa data uliopendekezwa, p4est hushughulika tu na taarifa za grid topology na partition ownership, wakati vectors za suluhisho la kimwili huhifadhiwa na solver katika kumbukumbu tofauti.
Wakati wa Load balancing, inachukuliwa kuwa inatosha kuhamisha tu:
\[ G_p=[\rho,u,v,w,T,k,\omega] \]
kundi la data ya msingi. Pressure, viscosity na thamani za secondary zinazoweza kutofautishwa huhesabiwa upya; thamani za gradient na MUSCL limiter hutengenezwa upya wakati wa solver cycle mpya.
Mbinu hii inalenga kupunguza kiasi cha mawasiliano hasa idadi ya MPI rank inapoongezeka.
Algoritmi ya Overset reassembly
Baada ya mabadiliko ya dynamic grid, kujenga upya uhusiano wa receiver–donor kunaweza kufikiriwa katika hatua tatu:
- Kwa kutumia partition bounding box, huamuliwa ni MPI rank zipi zinaweza kuingiliana kijiometria.
- Candidate donor za body-conforming grid hutafutwa kwa ADT, na candidate donor za Cartesian hutafutwa kwa muundo wa p4est octree/Morton.
- Baada ya kubaini jozi za donor–receiver, coefficients za interpolation na jedwali za inter-grid MPI communication huundwa.
Mbinu hii huondoa hitaji la kuhifadhi nakala ya body-conforming grid yote juu ya master rank.
Matokeo makuu ya kihesabu ya benchmark thabiti
| Kiasi kilichopimwa au kutumika | Matokeo |
|---|---|
| Nambari ya Mach | 2 |
| Nambari ya Reynolds | 353.100 |
| Idadi ya seli za grid kuu | 1.419.996 |
| Idadi ya seli za receiver | 34.970 |
| Ufanisi sambamba wa 32 MPI rank | %89,7 |
| Ufanisi sambamba wa 64 MPI rank | %80 |
| Ufanisi sambamba wa 128 MPI rank | %65 |
| Tofauti ya utendaji katika 128 rank ikilinganishwa na single-grid | Takriban %7 kwa kiwango cha juu zaidi |
Benchmark hii inajaribu usahihi wa kihesabu wa kitatua na pia tabia ya strong-scaling kadiri idadi ya MPI rank inavyoongezeka wakati ukubwa wa tatizo umewekwa thabiti.
Matokeo makuu ya kihesabu ya benchmark ya kidinamiki
| Kiasi kilichopimwa au kutumika | Matokeo yaliyotolewa katika chanzo |
|---|---|
| Nambari ya Mach ya Incident shock | 2,89 |
| Nambari ya Reynolds | 7800 |
| Kipindi cha mwito wa AMR | Mara moja kila 25 solver iterations |
| Kiwango cha juu zaidi cha refinement | 5 |
| Vizingiti vya density-gradient refine | 0,6 / 0,625 |
| Idadi ya seli za gridi katika \(\bar{t}=1.832\) | 3.241.936 |
| Ufanisi sambamba wa 128 MPI rank solver + AMR | %61 |
| Sehemu ya muda wa AMR katika kipindi cha 25 iterations katika 128 rank | Takriban %8 |
| Sehemu ya chini zaidi ya Grid assembly ndani ya muda wa AMR | %53 |
| Faida ya wall-clock ya 32 rank load balancing | %10,1 |
Kwa nini ufanisi sambamba si wa ideal?
Utafiti unaonyesha kuwa kipengele kikuu kinachozuia ufanisi sambamba katika idadi kubwa ya MPI rank si gharama ya jumla ya mawasiliano ya MPI peke yake. Idadi za seli za donor–receiver katika eneo la overset overlap hazisambazwi kwa uzito maalumu wakati wa shughuli ya p4est ya space-filling-curve partition.
Kwa matokeo hayo, baadhi ya rank zinaweza kuwa na hoja nyingi za interpolation, wakati baadhi zinaweza kuwa na chache sana. Kadiri idadi ya MPI rank inavyoongezeka, kiasi cha hesabu kwa kila receiver cell hupungua, na communication latency pamoja na workload imbalance huonekana wazi zaidi.
Athari hii inaonekana hasa katika sub-routines za grid assembly na interpolation. Kwa kuwa hesabu ya Navier–Stokes inayofanywa na flow solver katika seli zote husambazwa kwa mpangilio zaidi, scaling ya solver ya jumla hubaki imara zaidi.
Mchango mkuu wa kihandisi wa utafiti
Mchango mkuu wa utafiti si kutengeneza mlinganyo mpya wa Navier–Stokes au shock-capturing flux mpya. Ubunifu unalenga jinsi vipengele vilivyopo na vilivyothibitishwa vya CFD vinavyoweza kuunganishwa ndani ya parallel dynamic overset AMR kwa usanifu bora zaidi wa data na mawasiliano.
Hasa:
- kutenganisha data ya mtiririko na p4est grid management,
- migration ya solution variables zinazohitajika tu,
- kuhifadhi taarifa ya mtiririko wakati wa coarsen–balance,
- distributed overset assembly badala ya master rank,
- matumizi ya pamoja ya ADT na octree kulingana na aina ya grid
ndiyo kiini cha michango ya kialgoritmi ya utafiti.
Vikwazo vikuu
- Scaling tests zimefanywa juu ya dual-socket HPC node moja.
- Kiwango cha juu zaidi cha jaribio ni 128 MPI rank.
- GPU haijatumika.
- Benchmark mbili tu zimechunguzwa.
- Overset assembly workload haisawazishwi moja kwa moja kwa uzito kati ya MPI rank.
- Katika idadi kubwa ya rank, communication na kupungua kwa msongamano wa receiver-cell huzuia utendaji wa assembly.
- Ufafanuzi wa Region na idadi ya seli za mwanzo katika benchmark ya duara hauendani ndani ya chanzo.
- Hakujafanywa uthibitishaji kwa jiometri ya ndege ya viwanda au chombo cha anga halisi.
Maelezo ya Chanzo na Mbinu
Jina kamili la kazi asilia: A Parallel Solver on a Dynamically Adaptive Overset Grid for Compressible Flow Problems
Waandishi: Mohamad El Hajj Ali Barada; Bayram Celik.
Mpangilio wa waandishi: Mpangilio asilia katika chanzo umehifadhiwa kama ulivyo.
Mchango sawa/mwandishi wa kwanza sawa: Haujaelezwa katika chanzo.
Mwandishi anayewajibika: Mohamad El Hajj Ali Barada.
Taasisi: Aeronautical and Astronautical Engineering Program, Istanbul Technical University, Istanbul 34469, Turkey; Department of Astronautical Engineering, imeandikwa katika chanzo kama “Istanbul Tehnical University”, Istanbul 34469, Turkey.
Maelezo ya tahajia ya affiliation: Katika affiliation ya kwanza kumeandikwa “Istanbul Technical University”, na katika affiliation ya pili kumeandikwa “Istanbul Tehnical University”. Verianla inaeleza kwamba kuna ishara thabiti kuwa hili ni kosa la tahajia katika affiliation ya pili; lakini haibadilishi kimya kimya maandishi ya chanzo asilia.
Aina ya chanzo: Makala ya utafiti iliyopitiwa na wahakiki; utafiti wa mbinu ya kihesabu unaojumuisha kitatua cha CFD ya tatu-dimensional unaobanika, hesabu sambamba, dynamic adaptive mesh refinement na uthibitishaji wa benchmark.
Jarida: Aerospace
Mchapishaji: MDPI
Juzuu / nambari ya makala: 13, 656
Tarehe ya kuchapishwa: 20 Temmuz 2026
DOI: 10.3390/aerospace13070656
Kiungo rasmi cha uchapishaji: https://www.mdpi.com/2226-4310/13/7/656
Kiungo cha DOI: https://doi.org/10.3390/aerospace13070656
Hali ya uhakiki: Utafiti ni makala ya utafiti iliyochapishwa katika jarida la Aerospace lililopitiwa na wahakiki.
Leseni: Creative Commons Attribution 4.0 International (CC BY 4.0).
Ufadhili: Utafiti haukupokea ufadhili wa nje.
Upatikanaji wa data: Imeelezwa kuwa data iliyowasilishwa katika utafiti inaweza kupatikana kutoka kwa mwandishi anayewajibika kwa ombi la busara.
Mgongano wa maslahi: Waandishi hawakuripoti mgongano wa maslahi.
Michango ya waandishi: Bayram Celik; anawajibika kwa mapitio na uhariri, usimamizi na upatikanaji wa rasilimali za hesabu. Mohamad El Hajj Ali Barada; alifanya rasimu ya kwanza, computational software development, uchambuzi wa data, metodolojia na uundaji wa dhana.
Jukwaa la hesabu: Benchmark ziliendeshwa juu ya dual-socket HPC compute node moja. Node ina processors mbili za AMD EPYC 7742, frequency ya msingi ya 2,25 GHz na jumla ya 128 CPU cores. p4est na kitatua ziliendeshwa katika kiwango cha CPU kinachotegemea MPI; GPU au device offloading haikutumika.
Maelezo ya kutokulingana kwa Region 1 / Region 2: Maelezo ya maandishi ya benchmark ya duara–shok yanafafanua Region 1 kama tulivu na Region 2 kama eneo la post-shock lenye kasi ya mwisho. Tablo 2 katika chanzo, hata hivyo, inatoa velocity kwa Region 1 kuwa 2,0451168 na kwa Region 2 kuwa 0. Verianla haikubadilisha kwa dhana mpangilio wa maeneo.
Maelezo ya kitengo cha Tablo 2: Katika jedwali hilo hilo, thamani za temperature zinatolewa kama 0,006123676 na 0,002487067, na kitengo kimeandikwa K. Kwa kuwa chanzo hakielezi ikiwa namba hizi ndogo sana ni temperature iliyofanywa isiyo na kipimo, thamani hazijatafsiriwa kama temperature halisi ya Kelvin.
Maelezo ya kutokulingana kwa idadi ya seli za mwanzo: Sehemu moja ya chanzo inaripoti seli 3.241.936 kwa “initial overset grid” katika benchmark ya duara. Sehemu inayofuata inaeleza kuwa katika \( \bar{t}=1.832 \), gridi ilifikia seli 3.241.936 kutoka seli 2.232.704 za mwanzo. Kwa kuwa thamani hizi mbili za mwanzo hazilingani, Verianla haikurekebisha kimya kimya mojawapo.
Kikomo cha uthibitishaji wa kihesabu: Kitatua kimetathminiwa kwa benchmark mbili: mwili nusu-isiyo na mwisho wenye pua butu wa Mach 2 na mwingiliano wa shok tambarare–duara wa Mach 2,89. Uthibitishaji umefanywa kwa data zilizopo za rejea ya majaribio; utafiti wenyewe si kampeni mpya ya majaribio ya kimwili.
Kikomo cha utendaji sambamba: Matokeo ya ufanisi sambamba kama %89,7, %80, %65 na %61 yaliyorepotiwa yanahusu ukubwa maalumu wa grid, idadi ya MPI rank na HPC node moja ndani ya utafiti. Hayawezi kujumuishwa moja kwa moja kwa mifumo yenye node nyingi au inayotegemea GPU.
Mbinu ya uzalishaji wa maudhui: Mbinu za kisayansi, milinganyo, masharti ya benchmark, idadi za seli, matokeo ya MPI na vikwazo katika maelezo haya ya Verianla vinategemea utafiti wa chanzo kilichochunguzwa. Udhibiti wa nje umetumika tu kwa ajili ya kuthibitisha kibibliografia utambulisho wa uchapishaji na hali ya uhakiki wa jarida; hakuna matokeo mapya ya CFD, data mpya ya benchmark au thamani ya utendaji wa kihesabu isiyokuwapo katika chanzo iliyoongezwa kwenye maandishi kuu.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *