

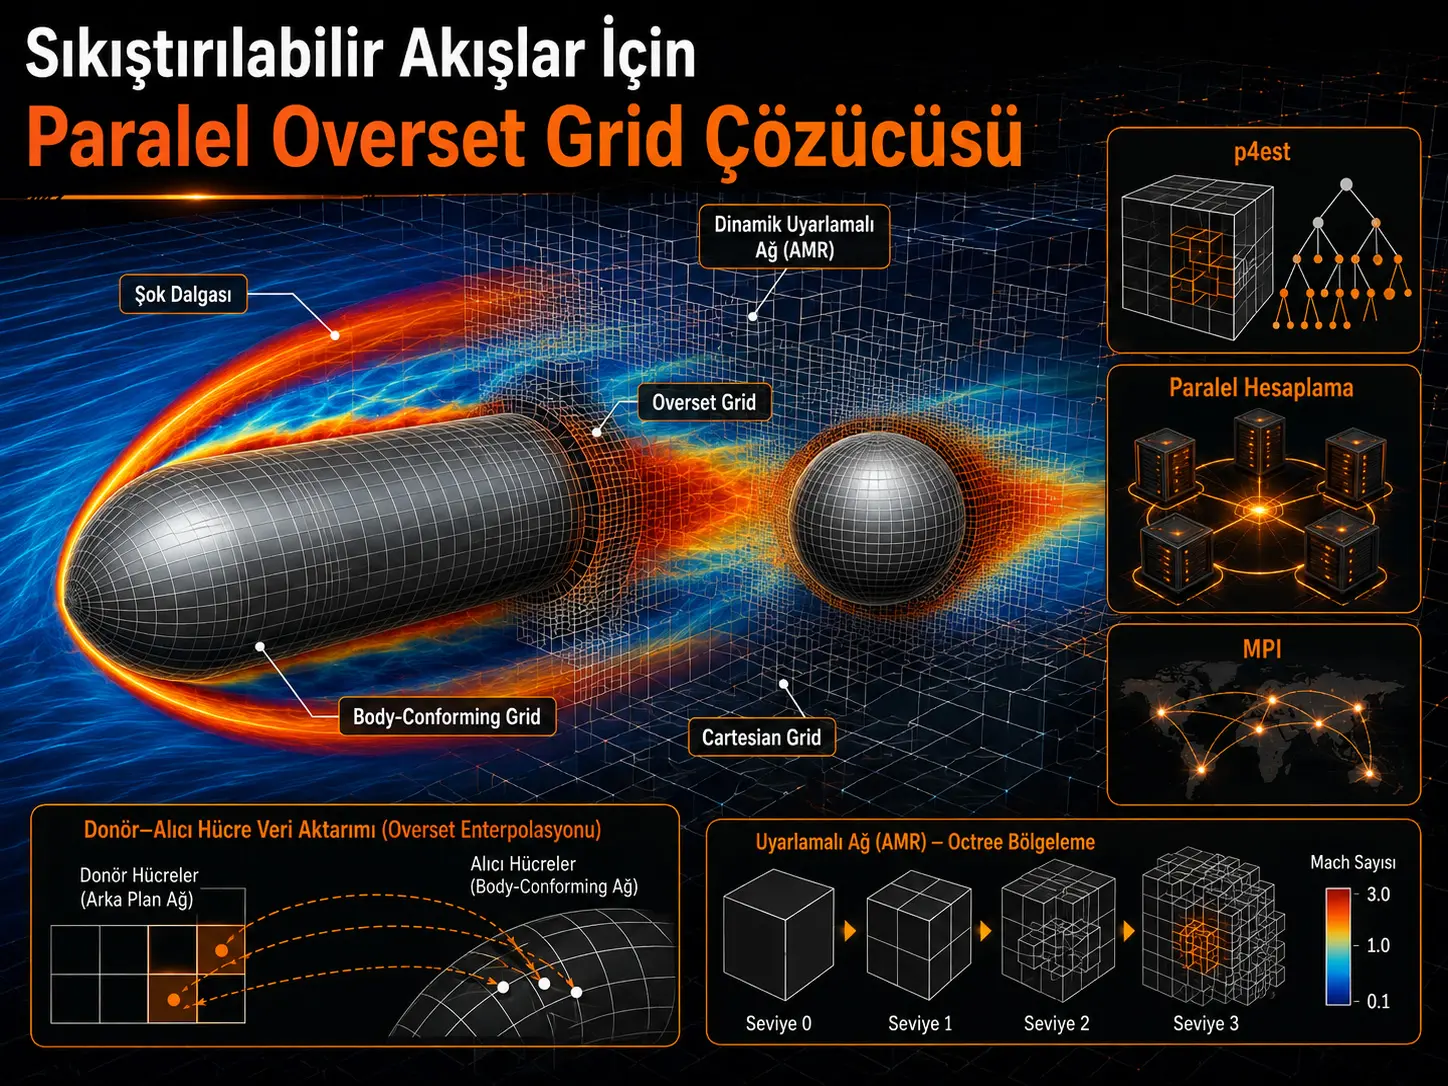
Бул изилдөө үч өлчөмдүү кысылма агым маселелерин чечүү үчүн параллелдүү иштеген, finite-volume негизиндеги жана динамикалык Adaptive Mesh Refinement (AMR) жөндөмүнө ээ Navier–Stokes чечүүчүсүн иштеп чыгат. Ыкма эки башка тор түзүлүшүн бириктирет: геометриянын бетин ээрчиген body-conforming grid жана агым талаасынын калган бөлүгүндө динамикалык түрдө майдаланып же ириңдетиле алган Cartesian off-body grid. Адаптивдүү Cartesian торун түзүү, partition иштерин жүргүзүү жана жүктү тең салмактоо ачык булактуу p4est octree китепканасы менен аткарылат.
Изилдөөнүн негизги программалык жаңылыгы — агым талаасынын маалыматтарын p4estтин өзүнүн node маалымат талаасынан ажыратуу. Классикалык түзүлүштө тыгыздык, ылдамдык, температура, турбуленттүүлүк өзгөрмөлөрү, градиенттер жана MUSCL limiter маалыматтары p4est nodeдору менен бирге ташылса, сунушталган архитектурада p4est ичинде бир гана дарек көрсөткүчү жана MPI rank маалыматы сакталат. Чыныгы агым талаасы өзүнчө маалымат түзүлүшүндө сакталат. Ошентип тор кайра бөлүнгөндө кайра эсептелиши мүмкүн болгон же эми жарактуулугун жоготкон бардык маалыматтарды MPI аркылуу ташуунун зарылдыгы болбойт; негизги агым өзгөрмөлөрүн гана өткөрүү жетиштүү болот.
Иштелип чыккан чечүүчү эки үч өлчөмдүү benchmark маселесинде сыноодон өткөрүлгөн. Mach 2 ылдамдыктагы агым жарым чексиз туюк мурундуу цилиндрдин үстүнөн өткөн туруктуу абалда сандык беттик басым коэффициенти эксперименттик натыйжалар менен жалпысынан шайкештик көрсөткөн жана адаптивдүү тор bow shock аймагында автоматтык түрдө тыгыздашкан. Экинчи тестте Mach 2,89 болгон тегиз шок толкунунун кыймылсыз абадагы шар менен өз ара аракеттенүүсү моделденген; чагылган шок, triple point, дифракцияланган шок жана wake вихри динамикалык тор ылайыкташтыруусу менен байкалган.
Параллелдүү өндүрүмдүүлүк экспериментинде туруктуу overset чечими 32 MPI rankта %89,7, 64 rankта %80 жана 128 rankта %65 параллелдүү натыйжалуулук көрсөткөн. Динамикалык шар–шок маселесинде flow solver менен AMR бирге бааланганда 128 MPI rankтагы параллелдүү натыйжалуулук %61 деп билдирилген. Сунушталган бөлүштүрүлгөн ыкма мурдагы master–slave колдонмосуна салыштырмалуу 32 MPI rankта жалпы чечүүчүнүн параллелдүү натыйжалуулугун %50 жогорулаткан. Бирок 128 rankка чыкканда, айрыкча donor–receiver уячаларынын аз санда болуп rankтар арасында тең эмес бөлүштүрүлүшүнөн улам interpolation жана overset grid assembly этаптарында натыйжалуулук төмөндөйт.
Türkiye жагынан: Изилдөө түздөн-түз İstanbul Teknik Üniversitesiде иштелип чыккан CFD чечүүчүсүнө негизделет. Ошондуктан Türkiye жагынан бул чет өлкөлүк бир ыкманы жөн гана колдонуу эмес, үч өлчөмдүү кысылма агым, динамикалык AMR, overset grid жана параллелдүү MPI эсептөө компоненттерин ошол эле мекеме ичиндеги чечүүчүдө бириктирүүгө байланышкан конкреттүү сандык ыкма иштеп чыгуу мисалы болуп саналат. Бирок макала эки benchmark жана бир гана HPC түйүнү үстүндө текшерүү сунуштайт; чыныгы учак геометриялары, көп түйүндүү суперкомпьютердик масштабдануу же өнөр жайлык текшерүү бул изилдөөдө сыналган эмес.
Overset grid жана Adaptive Mesh Refinement эмне үчүн бирге колдонулат?
Негизги максат — бүт эсептөө аймагын дайыма өтө майда тор менен чечүүнүн ордуна, жогорку ажыратууну физикалык жактан зарыл болгон аймактарда гана колдонуу. Шок толкундары, күчтүү градиенттер жана бөлүнүү аймактары сыяктуу жерлерде уяча өлчөмү кичирейтилсе, алыскы аймактарда ири тор колдонулушу мүмкүн. Ошентип ошол эле физикалык окуяны жалпы уяча саны азыраак болгон шартта чечүү мүмкүн болот.
Overset ыкмасы бул адаптацияны геометриядан ажыратат. Геометриянын бетин жана чек ара катмарын body-conforming grid чечсе, геометриядан алыстагы агым off-body Cartesian grid үстүндө эсептелет. Эки тор бири-биринин үстүнө кабатталат жана кесилиш аймактарындагы receiver уячалар үчүн башка тордогу donor уячалардан интерполяция жүргүзүлөт.
Бул түзүлүш өзгөчө үч өлчөмдүү кыймылдуу же күчтүү шок түзүлүштөрү бар маселелерде артыкчылыктуу; анткени Cartesian off-body gridдин refine/coarsen иштери татаал беттик геометрияны түздөн-түз кайра жаратууга мажбур эмес.
Кайсы агым теңдемелери чечилет?
Эки benchmark тең үч өлчөмдүү кысылма Navier–Stokes теңдемелери менен моделденген. Туруктуу туюк мурундуу дене маселеси турбуленттүү болгондуктан Reynolds-Averaged Navier–Stokes (RANS) формулировкасы, ал эми өтмө шар–шок маселеси ламинардык формулировка колдонулат.
Массанын сакталышы:
\[ \frac{\partial \rho}{\partial t} + \frac{\partial \rho u_j}{\partial x_j} =0 \]
Импульстун сакталышы:
\[ \frac{\partial \rho u_i}{\partial t} + \frac{\partial \rho u_i u_j}{\partial x_j} = -\frac{\partial p}{\partial x_i} + \frac{\partial \tau_{ij}}{\partial x_j} \]
Жалпы энергиянын сакталышы:
\[ \frac{\partial \rho e_t}{\partial t} + \frac{\partial \rho e_t u_j}{\partial x_j} = -\frac{\partial p u_j}{\partial x_j} + \frac{\partial}{\partial x_j} \left( k\frac{\partial T}{\partial x_j} \right) + \frac{\partial u_i\tau_{ij}}{\partial x_j} \]
Туруктуу benchmarkта Reynolds чыңалууларын моделдөө үчүн k–ω SST 2003 турбуленттүүлүк модели колдонулган. Газ калориялык жактан кемчиликсиз деп кабыл алынган. Туруктуу абалда илешкектиктин температурага жараша өзгөрүшү Sutherland мыйзамы менен моделденсе, өтмө benchmarkта динамикалык илешкектик температурадан көз каранды эмес туруктуу деп алынган.
Сандык агымдар кантип эсептелет?
Теңдемелер finite-volume ыкмасы менен дискреттештирилген. Бир уячанын жарым-дискреттик теңдемеси булакта төмөнкү жалпы формада берилет:
\[ \frac{\partial W_i}{\partial t} = \frac{1}{V_i} \sum_{j=1}^{J} \left(F_{v,ij}-F_{c,ij}\right)S_{ij} + Q_i \]
Конвективдүү агымдарда AUSM+up схемасы колдонулган, экинчи тартиптеги мейкиндик тактыгы үчүн MUSCL реконструкциясы аткарылган. Шок сыяктуу үзүлүүлөрдүн жанында термелүүлөрдү басуу үчүн Venkatakrishnan slope limiter колдонулган. Diffusive fluxтар экинчи тартиптеги борбордук айырма ыкмасы менен эсептелген, убакыт интеграциясы биринчи тартиптеги explicit Euler ыкмасы менен жүргүзүлгөн.
Туруктуу чечимде ар бир уяча үчүн убакыт кадамы туруктуу Courant санына жараша локалдуу аныкталса, transient маселелерде бардык уячалар үчүн колдонулган убакыт кадамы Courant шартынан алынган минималдуу маани катары тандалган.
Off-body жана body-conforming торлор кантип биригет?
Off-body Cartesian grid ар кандай refinement деңгээлдеринде туруктуу сандагы уячаларды камтыган блоктордон турат. Кошуна эки grid блогунун refinement деңгээлдеринин ортосундагы максималдуу айырма 1 катары сакталат; башкача айтканда 2:1 balance шарты сакталат.
Ар кандай refinement деңгээлдериндеги Cartesian уячаларынын жалпы бетинде классикалык overset interpolation ордуна hanging-cell ыкмасы колдонулат. Бир ири уячанын беттик агымы кошуна майда уячалардын агымдарынын суммасы менен эсептелет:
\[ F_i=\sum_{j=1}^{4}F_j \]
Body-conforming жана Cartesian торлор бири-бирин каптаган аймакта болсо donor–receiver мамилеси колдонулат. Receiver уячасындагы бир агым касиети inverse-distance интерполяциясы менен:
\[ \phi_i= \frac{\sum_{j=1}^{J}w_j\phi_j} {\sum_{j=1}^{J}w_j} \]
жана салмак:
\[ w_j= \frac{1} {|x_{c,j}-x_{c,i}|} \]
катары эсептелет.
p4est бул системада эмне кылат?
p4est octree коллекцияларын, башкача айтканда “forest of octrees” түзүлүшүн параллелдүү башкарган ачык булактуу китепкана. Изилдөөдө ар бир octree node физикалык жактан бир Cartesian grid блогуна туура келет. Nodeдор Morton же Z-order space-filling curve боюнча иреттелет.
Бул түзүлүш p4estке:
- grid refinement жана coarsening,
- 2:1 balance,
- partitioning,
- ghost-layer түзүү,
- MPI rankтар арасында grid блокторун бөлүштүрүү
иштерин аткарууга мүмкүндүк берет.
Изилдөөдөгү p4est колдонулушу толугу менен CPU жана MPI негизиндеги. GPU же башка accelerator үчүн device offloading колдонулган эмес.
Мурунку эс архитектурасынын көйгөйү эмне болгон?
p4estтин классикалык колдонуучу маалымат моделинде ар бир node үчүн колдонуучу белгилеген өлчөмдөгү маалымат блогу p4est тарабынан allocate кылынып башкарылат. CFD чечүүчүсүндө бул блок бир гана тыгыздык же ылдамдык сыяктуу бир нече санды камтыбайт; бүт grid блогунун агым маалыматтарын ташышы керек.
Булак үч маалымат тобун ажыратат:
- Gp: негизги агым касиеттери \([\rho,u,v,w,T,k,\omega]\),
- Gs: илешкектик, басым жана агым градиенттери сыяктуу экинчи касиеттер,
- Gl: MUSCL limiter терминдери.
Классикалык түзүлүштө бул маалымат топторунун баары p4est nodeу менен бирге сакталып, partition маалында ташылышы керек. Ал эми Gsтин маанилүү бөлүгү Gpден кайра эсептелиши мүмкүн; мындан тышкары градиенттер жана limiter маанилери grid migration этабында мурдагы итерацияга тиешелүү болгондуктан жаңы итерацияда баары бир кайра түзүлөт.
Сунушталган ажыратылган маалымат түзүлүшү кантип иштейт?
Изилдөөчүлөр агым маалыматтарын p4estтин allocation аймагынан чыгарып, өзүнчө q маалымат түзүлүшүндө сакташат. p4est nodeунун колдонуучу аймагында болсо бир гана:
- агым маалыматынын эстеги дарегин көрсөткөн pointer,
- node тиешелүү болгон MPI rank
сакталат.
Бул чакан өзгөртүү эки маанилүү көйгөйдү чечет.
Coarsen–balance учурунда маалымат жоготуунун алдын алуу
Классикалык p4est агымында бир топ node coarsen кылынганда бала уячалардын агым касиеттери parent уячада көлөм салмактуу орточо менен бириктирилет:
\[ \phi_i= \sum_{j=1}^{J} \left( \frac{\phi_j V_j}{V_i} \right) \]
Бирок пайда болгон parent node 2:1 balance шартын бузса, кийинки p4est_balance чакыруусу бул nodeду кайра refine кылышы мүмкүн. Бул учурда адегенде балдардан parentке орточолонгон маалымат кийин кайра балдарга бөлүштүрүлүп, баштапкы жогорку ажыратуудагы маалымат жоголот.
Сунушталган түзүлүштө агым талаасы p4estтин node allocationынан өзүнчө болгондуктан coarsen иши учурунда балдардын чыныгы маалыматтары дароо жок кылынбайт. Эгер balance иши coarsenды артка кайтарса, эски маалыматтар кайра түзүлгөн бала nodeдорго байланыштырылат. Coarsen натыйжасы чындап туруктуу болуп калганда гана маскаланган бала маалыматтары бошотулат.
Load balancing учурунда керексиз MPI трафигин азайтуу
p4est_partition тор блокторун MPI rankтар арасында кайра бөлүштүргөндө классикалык ыкма nodeдун бардык колдонуучу маалыматтарын ташыйт. Изилдөөчүлөр болсо Gp тобунун гана жаңы MPI rankка жөнөтүлүшүн камсыз кылышат. Gs жана Gl жаңы чечим циклинде кайра түзүлөт.
Ошентип partition этабы эки байланыш кадамына бөлүнсө да жалпы ташылган маалымат көлөмү азаят. Изилдөөнүн жүйөсү боюнча бул ыкма байланыш убактысын жана жалпы solver runtimeды төмөндөтөт.
Динамикалык тор өзгөргөндө overset байланыштары эмне үчүн кайра курулат?
Cartesian grid refine же coarsen кылынганда учурдагы donor–receiver уяча жуптары жарактуулугун жоготушу мүмкүн. Load balancingден кийин grid блокторунун MPI rank ээлиги да өзгөрөт. Ошондуктан ар бир AMR чакыруусунан кийин overset grid assembly кайра жасалышы зарыл.
Мурдагы master–slave ыкмасында receiver геометриялары борбордук бир MPI rankка жөнөтүлүп, master rank бүт body-conforming grid маалыматын сактап, donor издөөсүн бир эле жерде жүргүзчү. Бул эс керектөөсүн көбөйтүп, MPI rank саны өскөн сайын борбордук тар моюн жаратчу.
Жаңы ыкмада grid assembly толугу менен бөлүштүрүлгөн абалга келтирилет.
Bounding box ыкмасы байланышты кантип чектейт?
Ар бир Cartesian жана body-conforming grid partition минимум жана максимум координаталарын камтыган bounding box менен берилет. Receiver уячалардын bounding boxтору MPI rankтарга жарыяланат жана толук геометрия маалыматы бир гана кесилишкен partitionдор арасында алмашылат.
Эки partitionдун белгилүү бир координата багытында кесилишүүсү:
\[ x_{A,max}\geq x_{B,min} \quad\land\quad x_{A,min}\leq x_{B,max} \]
шарты менен текшерилет.
Ошентип бир rank бардык grid уячаларын бардык башка rankтарга жөнөтүүгө муктаж болбойт.
Body-conforming grid donor издөөсү кантип тездетилет?
Body-conforming grid үчүн Alternating Digital Tree (ADT) түзүлөт. Ар бир уяча tree node катары көрсөтүлөт жана bounding box координаталары боюнча binary tree түзүлүшүнө жайгаштырылат.
Receiver уяча үчүн donor изделгенде издөө дарактын тамырынан башталат. Bounding boxтор кесилишпеген учурда координаталарды салыштыруу аркылуу дарактын бир бутагы толугу менен четтетилет. Кесилиш болсо, уяча талапкер donor тизмесине кошулат жана издөө төмөнкү бутактарда уланат. Натыйжада centroidи receiver уячага эң жакын талапкер donor катары тандалат жана interpolation stencil үчүн анын айланасындагы кошуналар да колдонулат.
Body-conforming grid алдын ала partition кылынган жана чечим учурунда геометриясы өзгөрбөгөндүктөн ADT чечимдин башында бир гана жолу түзүлүп, эсте сактала алат.
Cartesian donor издөөсүндө Morton коду кантип колдонулат?
Cartesian grid буга чейин эле p4est octree forest тарабынан башкарылгандыктан өзүнчө spatial tree түзүүнүн кереги жок. Receiver уячанын координаталары эң жогорку refinement деңгээлине жараша бит тизмегине айландырылып, үч өлчөмдө бул биттер бир Morton кодунда бириктирилет.
Morton кодунун тиешелүү бит топтору кезеги менен окулуп, octree ичинде кайсы child nodeго баруу керектиги аныкталат жана leaf nodeго жеткенде receiver чекитин камтыган Cartesian grid блогу табылат.
Бул система donor издөө үчүн p4estтин буга чейин бар болгон мейкиндик маалымат түзүлүшүн экинчи жолу колдонот.
Биринчи benchmark кантип түзүлгөн?
Биринчи текшерүү маселеси — Mach 2 эркин агымы жарым чексиз туюк мурундуу цилиндрдин үстүнөн өткөн туруктуу жана турбуленттүү кысылма агым.
| Эркин агым параметри | Булакта колдонулган маани |
|---|---|
| Mach саны | 2 |
| Reynolds саны | 353.100 |
| Температура | 242,3 K |
| Турбуленттүүлүк интенсивдүүлүгү | %0,05 |
Маселе октук симметриялуу болсо да, чечүүчүнүн үч өлчөмдүү өндүрүмдүүлүгүн көрсөтүү үчүн эсептөө аймагынын төрттөн бири үч өлчөмдүү түрдө моделденген.
Cartesian grid 3 × 3 × 3 octree forest менен башталган жана ар бир node 2 × 2 × 2 уячадан турган grid блогун билдирген. Максималдуу refinement деңгээли 5. Refinement критерийи Mach градиенти жана босого маанилер:
\[ Q_{lower}=0.185, \qquad Q_{upper}=0.218 \]
катары колдонулган. Body-conforming gridдин биринчи дубал уячасы болжол менен \(y^+=5\) боло тургандай курулган жана жакындашуу критерийи cumulative residual relative error үчүн %0,01 деп белгиленген.
Тор жакындашуусу боюнча изилдөөдө канча уяча колдонулган?
Үч тор деңгээли салыштырылган:
| Тор ажыратуусу | Максималдуу refinement деңгээли | Туруктуу абалдагы уяча саны |
|---|---|---|
| Ири | 4 | 334.627 |
| Орто — негизги чечим | 5 | 1.419.996 |
| Майда | 6 | 3.697.852 |
Басым коэффициентинин ийри сызыктарын салыштыруу орто тор бул маселе үчүн жетиштүү экенин көрсөткөн. Ошондуктан изилдөөчүлөр өндүрүмдүүлүк анализдеринде болжол менен 1,42 миллион уячалуу орто торду колдонгон.
Туюк мурундуу дене натыйжасы эксперимент менен шайкешпи?
Жалпысынан ооба. Сандык \(C_p\) бөлүштүрүлүшү таяныч эксперименттик натыйжалар менен жакшы шайкештик көрсөткөн. Бирок stagnation point аймагында \(s/D=0\) жана дененин уч-табан бөлүгүнө жакын \(s/D>0.8\) аймагында чечим эксперименттик маанилерди бир аз төмөн баалайт.
Изилдөөнүн салыштыруусуна ылайык, иштелип чыккан чечүүчүнүн натыйжасы ошол эле графикте берилген мурдагы scFLOW сандык натыйжасына караганда эксперименттик маалыматка жакыныраак көрүнөт. Бул салыштыруу ушул benchmark жана колдонулган шарттар үчүн гана жарактуу; жалпы CFD программалык артыкчылыгын билдирбейт.
Numerical schlieren жана Mach contour сүрөттөрүндө адаптивдүү Cartesian gridдин bow shock сызыгы боюнча эң жогорку refinement деңгээлине өткөнү көрүнөт. Ошентип алыскы аймактарда керексиз майда тор колдонулбай, шок үзүлүүсү жогорку ажыратууда сакталат.
Туруктуу benchmark параллелдүү түрдө кантип масштабданды?
Strong-scaling экспериментинде 1.419.996 уячалуу grid туруктуу сакталган жана MPI rank саны баскычтап көбөйтүлгөн. Бул тордогу receiver уячалардын саны 34.970. Ар бир rank саны үчүн 100 чечим итерациясынын wall-clock убактысы өлчөнгөн.
Speed-up:
\[ S_f=\frac{T_1}{T_N} \]
жана параллелдүү натыйжалуулук:
\[ \eta=\frac{S_f}{N}\times100 \]
деп аныкталган.
Verianla Live: Overset чечүүчүнүн MPI rank санына жараша параллелдүү натыйжалуулугу
Төмөнкү маанилер туруктуу Mach 2 туюк мурундуу дене benchmarkында болжол менен 1,42 миллион уяча туруктуу кармалганда өлчөнгөн overset-grid чечүүчүнүн параллелдүү натыйжалуулугу. Булар weak-scaling эмес, strong-scaling натыйжалары.
| MPI rank саны | Параллелдүү натыйжалуулук (%) | Тест түрү | Булак |
|---|---|---|---|
| 32 | 89,7 | Strong scaling — overset solver | Фигура 12 жана жыйынтык тексти |
| 64 | 80 | Strong scaling — overset solver | Фигура 12 жана жыйынтык тексти |
| 128 | 65 | Strong scaling — overset solver | Фигура 12 жана жыйынтык тексти |
Verianla Live булак эскертүүсү: Визуалдаштыруу бул көрүнгөн илимий маалымат таблицасынан түзүлөт. Таблица илимий source-of-truth катары сакталат.
Solver 32 MPI rankка чейин күчтүү масштабдануу көрсөткөн. 32 rankтагы параллелдүү натыйжалуулук %89,7 болсо, 64 rankта %80ге жана 128 rankта %65ке төмөндөйт. 128 rankта overset чечими менен ошол эле уяча санына ээ single-grid таянычынын ортосундагы параллелдүү өндүрүмдүүлүк айырмасы эң көп болжол менен %7 деп билдирилген.
Interpolation эмне үчүн жалпы solverга караганда начарыраак масштабданат?
Interpolation үчүн жасалган эсептөө donor–receiver уячалары менен чектелет. MPI rank саны көбөйгөн сайын ар бир rankка туура келген receiver саны өтө азаят жана overlap уячалары rankтар арасында тең бөлүштүрүлбөйт.
Interpolation computation сегментинин параллелдүү натыйжалуулугу болжол менен:
- 32 MPI rankка чейин %70,
- 64 MPI rankта %44,
- 128 MPI rankта %30
деңгээлдерине түшөт.
Бирок interpolation жалпы итерация наркынын 1 rankта болгону болжол менен %0,2син жана 128 rankта %5,11ин түзгөндүктөн, бул төмөнкү суб-рутин натыйжалуулугу жалпы solver өндүрүмдүүлүгүнө чектелген өлчөмдө таасир этет.
Жаңы ыкма мурдагы master–slave чечүүчүдөн канчалык жакшы?
Булак ошол эле изилдөө тобунун мурдагы master–slave ыкмасы менен салыштырганда жаңы бөлүштүрүлгөн ыкма 32 MPI rankта жалпы solver параллелдүү натыйжалуулугун %50 жогорулатканын билдирет.
Бул натыйжа белгилүү аппараттык камсыздоо, grid жана benchmark үчүн жасалган салыштыруу. Жаңы алгоритм ар бир маселеде же ар бир HPC архитектурасында так %50 пайда берет деп изилдөө көрсөткөн эмес.
Экинчи benchmark эмне үчүн татаалыраак?
Экинчи маселе туруктуу эмес. Mach 2,89 ылдамдыкта жылган тегиз шок толкуну башында кыймылсыз абада турган шарга урунуп, убакыт ичинде чагылган шок, incident shock, triple point, difracted shock жана vortex түзүлүштөрү пайда болот.
Бул агым түзүлүштөрү кыймылда болгондуктан майда grid аймагы да убакыт ичинде жылышы керек. Ошондуктан бир жолу гана refine кылынган туруктуу тор жетишсиз; AMR чечим маалында кайра-кайра чакырылат.
Агымдын Reynolds саны 7800 деп берилген жана ламинардык моделденген. Колдонулган аба үчүн булак:
- \(R=287.2\) J/(kg·K),
- \(c_p=1005.2\) J/(kg·K),
- \(\gamma=1.4\)
маанилерин берет.
Шар benchmarkындагы Region 1 жана Region 2 маалыматтары эмне үчүн этият окулушу керек?
Булак тексти Region 1 кыймылсыз, Region 2 болсо post-shock жана чектүү x-багыттагы ылдамдыкты камтыган аймак экенин айтат. Бирок жарыяланган Tablo 2 төмөнкү маанилерди берет:
| Булакта берилген чоңдук | Region 1 | Region 2 |
|---|---|---|
| Тыгыздык — таблицада kg/m³ деп белгиленген | 5,1432014 | 1,4 |
| Температура — таблицада K деп белгиленген | 0,006123676 | 0,002487067 |
| Ылдамдык — таблицада m/s деп белгиленген | 2,0451168 | 0 |
Ылдамдык маанилери тексттик Region аныктамасы менен тескери багытта: таблица Region 1ди кыймылдуу, Region 2ни кыймылсыз кылып көрсөтөт. Мындан тышкары температура маанилеринин K белгиси менен 10−3 тартибинде берилиши чыныгы өлчөмдүү температурага туура келбеген масштабдоо/белгилөө көйгөйүнө окшойт. Булак муну түшүндүрбөгөндүктөн Verianla бул сандардын бирдигин же Region тартибин божомол менен оңдобойт.
Динамикалык AMR кантип түзүлдү?
Cartesian grid 10 × 5 × 5 base octree node менен башталган жана ар бир node 2 × 2 × 2 уячалуу grid блогун камтыган. Максималдуу refinement деңгээли 5. AMR ар 25 flow-solver итерациясында бир чакырылган.
Refinement критерийи density gradient:
\[ Q_{lower}=0.6, \qquad Q_{upper}=0.625 \]
Body-conforming gridдин биринчи уячасы болжол менен \(y^+\approx2.5\) болушу камсыз кылынган жана тор шар бетинен 2,5D сыртка узартылган.
Чечим CFL = 0,7 менен жүргүзүлгөн; глобалдык өлчөмсүз убакыт кадамы итерацияга жараша болжол менен \(9.2\times10^{-5}\) менен \(1.5\times10^{-4}\) арасында өзгөргөн.
Шар benchmarkындагы уяча саны боюнча булак эмне үчүн карама-каршы?
Изилдөөнүн бир бөлүгүндө “initial overset grid system” үчүн 3.241.936 уяча жана 54.294 receiver уяча берилет. Бирок агымдын убакыт ичиндеги өнүгүшү баяндалган кийинки бөлүмдө, \( \bar{t}=1.832 \) учурунда gridдин 2.232.704 баштапкы уячадан 3.241.936 уячага чыккандыгы жазылат.
Бул эки сөз айкашы ошол эле “баштапкы” уяча санын колдобогондуктан, бул жерде булак ичиндеги карама-каршылык катары сакталат. Ошол эле учурда \( \bar{t}=1.832 \) үчүн 3.241.936 уяча мааниси эки контекстте тең көрүнөт жана strong-scaling тестинде жогорку жүктөлгөн динамикалык абал катары тандалган тор ушул.
Шок толкуну шар айланасында кантип өнүктү?
Numerical schlieren жана Mach сүрөттөрү агымдын бир нече өлчөмсүз убакыт чекиттериндеги өнүгүшүн көрсөтөт:
- \(\bar{t}=0\): тегиз incident shock шар борборунан болжол менен 0,6D алыста.
- \(\bar{t}\approx0.307\): шок шар бетине жеткенде reflected shock пайда болот.
- \(\bar{t}=0.615\): incident жана reflected shock кесилишинде triple point айкындалат.
- \(\bar{t}=1.832\): diffracted shock жана triple point шар wake аймагына жылат жана бир vortex көрүнөт.
Адаптивдүү тор сызыктары жогорку refinement деңгээли кыймылдаган шок түзүлүштөрүн ээрчип жатканын көрсөтөт. Изилдөөчүлөр \( \bar{t}=1.832 \) учурунда reflected shock triple pointке байланышкан аймакта density gradient алсырагандан улам байкоо сапатында чакан жоготуу болгонун да белгилешет.
Эксперименттик schlieren салыштыруусу эмнени көрсөттү?
Numerical schlieren сүрөтү классикалык Bryson жана Gross эксперименттик сүрөтү менен салыштырылган. Reflected shock, triple point жана transmitted shock жайгашуулары жалпысынан эксперимент менен жакшы шайкешкени билдирилген.
Reflected shock standoff distance жагынан чакан айырма бар. Авторлор бул айырма эксперименттик сүрөттө көрүнгөн деформациялардан улам сүрөттөө artefactтарынан келип чыгышы мүмкүн деп сунушташат. Бул түшүндүрмө автордук жоромол; изилдөө бул айырманын себебин өзүнчө эксперименттик түрдө сынаган эмес.
Бир динамикалык AMR чакыруусунда кайсы иштер жүрөт?
Изилдөөдө AMR процесси беш ырааттуу сегментке бөлүнөт:
- Cell flagging: уячалар sensor function менен бааланып refine/coarsen үчүн белгиленет.
- Grid adaptation: белгиленген блоктор refine же coarsen кылынат.
- Load balancing: grid блоктору MPI rankтар арасында кайра бөлүштүрүлөт жана ghost layerлар түзүлөт.
- Connectivities: кошуна уяча байланыштары кайра курулуп cache кылынат.
- Grid assembly: overset donor–receiver жуптары, interpolation коэффициенттери жана communication таблицалары кайра түзүлөт.
Динамикалык маселеде бул беш этаптын баары ар 25 solver итерациясында бир кайталанат.
AMRдин эсептөө наркы канча?
AMR иши бардык MPI rank сандарында бир flow-solver итерациясынан кыскараак созулат; бирок ошол эле тартипте турат. AMR ар 25 итерацияда гана иштегендиктен жалпы таасири сейректелет.
128 MPI rankта бир AMR чакыруусунун убактысы эки AMR ортосунда өткөн 25 flow-solver итерациясынын жалпы убактысынын болжол менен %8и деп билдирилген.
AMRдин эң кымбат бөлүгү overset grid assembly. Каралган rank сандарында grid assembly AMR убактысынын эң аз %53үн түзөт.
Динамикалык маселе 128 MPI rankта кантип масштабданды?
AMR процессинин өз алдынча scaling өндүрүмдүүлүгү solver сыяктуу күчтүү эмес. Мунун негизги себеби donor/receiver суроолору жана overlap аймактары MPI rankтар арасында тең бөлүштүрүлбөгөндүгү.
Ошого карабастан AMR ар 25 итерацияда гана чакырылгандыктан бүт flow solver + AMR системасы жогорку rank сандарында жакшыраак иштейт. Изилдөө динамикалык benchmark үчүн 128 MPI rankта болжол менен %61 параллелдүү натыйжалуулук билдирет.
Жыйынтык бөлүмүндө AMR жана overset-grid-assembly этаптары 64 MPI rankта болжол менен %42 параллелдүү натыйжалуулукка жеткени айтылат.
Load balancing чындап иштейби?
Ооба; колдонулган benchmarkта өлчөнө турган пайда бар. Изилдөөчүлөр 32 MPI rank үчүн ошол эле динамикалык grid абалын load balancing күйгүзүлгөн жана өчүрүлгөн түрдө салыштырышкан.
Load-balanced абалда rankтардын normalize CPU workload бөлүштүрүлүшү бир калыпка жакыныраак болгон. Булак MPI rankтарда эң аз %17,4 workload азайышын билдирет.
Ghost-layer жана inter-grid communication камтылган wall-clock убакыт боюнча караганда load-balanced solver итерациясы load balancing колдонулбаган итерациядан %10,1 кыскараак созулган.
Бул өлчөм бир adaptationдан кийинки бир гана абал үчүн. Авторлор чыныгы чечимде AMR көп жолу чакырылгандыктан пайда чечим бою топтолушу мүмкүн экенин белгилешет.
Изилдөө колдогон жыйынтыктар
- p4est менен үч өлчөмдүү block-based Cartesian AMR, body-conforming overset grid менен ошол эле кысылма CFD чечүүчүсүндө бириктириле алган.
- Агым маалыматтарын p4est node allocationынан ажыраткан архитектура керексиз data migrationды азайтып, coarsen–balance маалында агым маалыматынын керексиз жоголушун алдын алат.
- Distributed bounding-box, ADT жана octree издөө түзүлүштөрү менен борбордук master rank талап кылбаган overset reassembly колдонулган.
- Mach 2 туюк мурундуу дене benchmarkында эсептелген беттик басым коэффициенти жалпысынан эксперименттик маалымат менен шайкеш.
- Adaptive grid bow shock айланасында жогорку refinement деңгээлине өткөн.
- Шар–шок benchmarkында reflected shock, triple point, diffracted/transmitted shock жана vortex түзүлүштөрү сандык түрдө кармала алган.
- Туруктуу benchmarkта overset solver 128 MPI rankта %65 параллелдүү натыйжалуулук көрсөткөн.
- Динамикалык solver + AMR системасы 128 MPI rankта болжол менен %61 параллелдүү натыйжалуулук көрсөткөн.
- 32 MPI rankтагы load balancing эксперименти wall-clock iteration убактысында %10,1 азайуу берген.
- Жаңы бөлүштүрүлгөн ыкма мурдагы master–slave версияга салыштырмалуу 32 MPI rankта жалпы параллелдүү натыйжалуулукта %50 өсүш берген.
Изилдөө колдобогон же сынабаган жыйынтыктар
- Чечүүчү бардык кысылма CFD маселелеринде ошол эле тактыкты же scaling өндүрүмдүүлүгүн берери көрсөтүлгөн эмес.
- Изилдөөдө GPU же accelerator offloading сыналган эмес.
- 128 өзөктөн жогору же бир нече HPC node үстүндө scaling тести жасалган эмес.
- Чыныгы учак, ракета, космостук ракета же турбомашина геометриясында өнөр жайлык validation жасалган эмес.
- Туюк мурундуу дене benchmarkында stagnation жана tip-base аймактарындагы эксперименттик айырма толугу менен жоюлган эмес.
- Шар benchmarkында бардык шок түзүлүштөрү кемчиликсиз байкалган эмес; \( \bar{t}=1.832 \) тегерегинде алсыраган density gradient себебинен чакан tracking жоготуусу байкалган.
- Overset grid assembly жогорку MPI rankтарда идеалдуу түрдө load-balanced экендиги көрсөтүлгөн эмес.
- Булакта Region 1/Region 2 баштапкы абалдары менен баштапкы уяча санындагы ички карама-каршылыктар чечилген эмес.
- Бир түйүндө алынган %65 же %61 параллелдүү натыйжалуулук көп түйүндүү суперкомпьютер чөйрөсүнө түздөн-түз жалпылана албайт.
Изилдөөнүн Ыкмасы жана Жыйынтыктары
Сандык чечүүчү архитектурасы
Иштелип чыккан программа үч өлчөмдүү density-based finite-volume кысылма Navier–Stokes чечүүчүсү болуп саналат. Туруктуу турбуленттүү маселеде k–ω SST 2003 модели колдонулган. Конвективдүү агымдарда AUSM+up, экинчи тартиптеги реконструкцияда MUSCL жана үзүлүү жанында Venkatakrishnan limiter колдонулган. Diffusive терминдер экинчи тартиптеги борбордук ыкма менен, убакыт интеграциясы explicit Euler менен эсептелген.
Grid архитектурасы эки компоненттен турат:
- геометрияны жана дубалга жакын агымды чечкен алдын ала partition кылынган structured body-conforming grid,
- p4est octree forest тарабынан башкарылган block-based adaptive Cartesian off-body grid.
Refinement жана coarsening критерийи
Ар бир Cartesian grid блогунда тандалган агым параметри \(Q\), төмөнкү жана жогорку босоголор менен салыштырылат:
- \(Q>Q_{upper}\) болсо refine,
- \(Q<Q_{lower}\) болсо coarsen
иши колдонулат.
p4est тарабында grid adaptation тартиби:
p4est_refinep4est_balancep4est_coarsenp4est_balance
түрүндө. Экинчи balance чакыруусу coarsenдан кийин 2:1 balance шартын кайра камсыз кылуу үчүн зарыл.
Сунушталган маалымат архитектурасынын computational логикасы
Сунушталган маалымат түзүлүшүндө p4est бир гана grid topology жана partition ownership маалыматы менен алектенсе, физикалык чечим векторлору solver тарабынан өзүнчө эсте сакталат.
Load balancing учурунда бир гана:
\[ G_p=[\rho,u,v,w,T,k,\omega] \]
негизги маалымат тобун өткөрүү жетиштүү деп кабыл алынган. Басым, илешкектик жана дифференциалдануучу secondary маанилер кайра эсептелет; градиент жана MUSCL limiter маанилери жаңы solver cycle маалында кайра түзүлөт.
Бул ыкма айрыкча MPI rank саны өскөндө байланыш көлөмүн азайтууну көздөйт.
Overset reassembly алгоритми
Динамикалык grid өзгөргөндөн кийин receiver–donor мамилесин кайра куруу үч этапта каралышы мүмкүн:
- Partition bounding boxтору колдонулуп, кайсы MPI rankтар геометриялык жактан өз ара аракеттене алаары аныкталат.
- Body-conforming grid donor талапкерлери ADT, Cartesian donor талапкерлери болсо p4est octree/Morton түзүлүшү менен изделет.
- Donor–receiver жуптары аныкталгандан кийин interpolation коэффициенттери жана inter-grid MPI communication таблицалары түзүлөт.
Бул ыкма master rank үстүндө бүт body-conforming gridдин көчүрмөсүн кармоо зарылдыгын жок кылат.
Туруктуу benchmarkтын негизги сандык натыйжалары
| Өлчөнгөн же колдонулган чоңдук | Натыйжа |
|---|---|
| Mach саны | 2 |
| Reynolds саны | 353.100 |
| Негизги grid уяча саны | 1.419.996 |
| Receiver уяча саны | 34.970 |
| 32 MPI rank параллелдүү натыйжалуулугу | %89,7 |
| 64 MPI rank параллелдүү натыйжалуулугу | %80 |
| 128 MPI rank параллелдүү натыйжалуулугу | %65 |
| 128 rankта single-gridге салыштырмалуу өндүрүмдүүлүк айырмасы | Эң көп болжол менен %7 |
Бул benchmark чечүүчүнүн сандык тактыгын да, маселе өлчөмү туруктуу болгондо MPI rank саны көбөйгөн сайын strong-scaling жүрүм-турумун да сынайт.
Динамикалык benchmarkтын негизги сандык натыйжалары
| Өлчөнгөн же колдонулган чоңдук | Булакта берилген натыйжа |
|---|---|
| Incident shock Mach саны | 2,89 |
| Reynolds саны | 7800 |
| AMR чакыруу аралыгы | Ар 25 solver итерациясында бир |
| Максималдуу refinement деңгээли | 5 |
| Density-gradient refine босоголору | 0,6 / 0,625 |
| \(\bar{t}=1.832\) тор уяча саны | 3.241.936 |
| 128 MPI rank solver + AMR параллелдүү натыйжалуулугу | %61 |
| 128 rankта AMRдин 25 итерациялык аралыктагы убакыт үлүшү | Болжол менен %8 |
| Grid assemblyнин AMR убактысындагы минималдуу үлүшү | %53 |
| 32 rank load balancing wall-clock пайдасы | %10,1 |
Параллелдүү натыйжалуулук эмне үчүн идеалдуу эмес?
Изилдөө жогорку MPI rank санында параллелдүү натыйжалуулукту чектеген негизги фактор жалпы MPI байланыш наркы гана эмес экенин көрсөтөт. Overset overlap аймагындагы donor–receiver уячаларынын саны p4estтин space-filling-curve partition иши учурунда атайын салмак менен бөлүштүрүлбөйт.
Натыйжада айрым rankтарда көп сандагы interpolation суроосу болсо, айрым rankтарда өтө аз болушу мүмкүн. MPI rank саны өскөн сайын receiver уячага туура келген эсептөө көлөмү кичирейип, communication latency жана workload imbalance көбүрөөк байкалат.
Бул таасир айрыкча grid assembly жана interpolation суб-рутиндеринде көрүнөт. Flow solver бардык уячаларда аткарган Navier–Stokes эсеби болсо бир кыйла иреттүү бөлүштүрүлгөндүктөн жалпы solver scaling күчтүүрөөк бойдон калат.
Изилдөөнүн инженердик жагынан негизги салымы
Изилдөөнүн негизги салымы жаңы Navier–Stokes теңдемесин же жаңы shock-capturing flux иштеп чыгуу эмес. Жаңылык учурдагы жана текшерилген CFD курулуш бөлүктөрүн параллелдүү динамикалык overset AMR ичинде кыйла натыйжалуу маалымат жана байланыш архитектурасы менен кантип бириктирүүгө болоруна багытталган.
Айрыкча:
- p4est grid management менен агым маалыматын ажыратуу,
- зарыл болгон solution variables гана migration кылуу,
- coarsen–balance учурунда агым маалыматын сактоо,
- master rank ордуна distributed overset assembly,
- ADT жана octreeни grid түрүнө жараша бирге колдонуу
изилдөөнүн алгоритмдик салымдарынын борборунда турат.
Негизги чектөөлөр
- Scaling тесттери бир гана dual-socket HPC node үстүндө жасалган.
- Эң жогорку тест масштабы 128 MPI rank.
- GPU колдонулган эмес.
- Эки гана benchmark каралган.
- Overset assembly workloadу MPI rankтар арасында түздөн-түз салмакталган түрдө тең салмакталбайт.
- Жогорку rank санында communication жана азайган receiver-cell тыгыздыгы assembly өндүрүмдүүлүгүн чектейт.
- Шар benchmarkындагы Region аныктамалары жана баштапкы уяча саны булак ичинде карама-каршы.
- Чыныгы өнөр жайлык учак же космостук аппарат геометриясы менен текшерүү жүргүзүлгөн эмес.
Булак жана Ыкма Жөнүндө Эскертүү
Толук оригиналдуу иштин аталышы: A Parallel Solver on a Dynamically Adaptive Overset Grid for Compressible Flow Problems
Авторлор: Mohamad El Hajj Ali Barada; Bayram Celik.
Авторлордун тартиби: Булактагы оригиналдуу тартип так сакталган.
Тең салым/тең биринчи автор: Булакта көрсөтүлгөн эмес.
Жооптуу автор: Mohamad El Hajj Ali Barada.
Мекемелер: Aeronautical and Astronautical Engineering Program, Istanbul Technical University, Istanbul 34469, Turkey; Department of Astronautical Engineering, булакта “Istanbul Tehnical University” түрүндө жазылган, Istanbul 34469, Turkey.
Аффилиация жазылышы боюнча эскертүү: Биринчи аффилиацияда “Istanbul Technical University”, экинчи аффилиацияда болсо “Istanbul Tehnical University” деп жазылган. Verianla мунун экинчи аффилиациядагы жазылыш катасы экенин көрсөткөн күчтүү белги бар экенин белгилейт; бирок оригиналдуу булак текстин үнсүз өзгөртпөйт.
Булак түрү: Рецензияланган изилдөө макаласы; үч өлчөмдүү кысылма CFD чечүүчүсүн, параллелдүү эсептөөнү, динамикалык adaptive mesh refinementти жана benchmark текшерүүсүн камтыган сандык ыкма изилдөөсү.
Журнал: Aerospace
Басма: MDPI
Том / макала номери: 13, 656
Жарыяланган күнү: 20 Temmuz 2026
DOI: 10.3390/aerospace13070656
Расмий жарыя шилтемеси: https://www.mdpi.com/2226-4310/13/7/656
DOI шилтемеси: https://doi.org/10.3390/aerospace13070656
Рецензия абалы: Изилдөө рецензияланган Aerospace журналында жарыяланган изилдөө макаласы.
Лицензия: Creative Commons Attribution 4.0 International (CC BY 4.0).
Каржылоо: Изилдөө тышкы каржылоо алган эмес.
Маалымат жеткиликтүүлүгү: Изилдөөдө берилген маалыматтар негиздүү суроо-талап боюнча жооптуу автордон алына алары билдирилген.
Кызыкчылыктардын кагылышы: Авторлор кызыкчылыктардын кагылышын билдиришкен эмес.
Автордук салымдар: Bayram Celik; кароо жана редакциялоо, көзөмөл жана эсептөө ресурстарын алууга жооптуу. Mohamad El Hajj Ali Barada; биринчи долбоор, computational software development, маалымат талдоо, методология жана концептуалдаштырууну аткарган.
Эсептөө платформасы: Benchmarkтар dual-socket бир HPC compute node үстүндө жүргүзүлгөн. Node эки AMD EPYC 7742 процессоруна, 2,25 GHz негизги жыштыкка жана жалпы 128 CPU өзөгүнө ээ. p4est жана чечүүчү MPI негизиндеги CPU деңгээлинде иштетилген; GPU же device offloading колдонулган эмес.
Region 1 / Region 2 карама-каршылык эскертүүсү: Шар–шок benchmarkынын тексттик түшүндүрмөсү Region 1ди кыймылсыз, Region 2ни post-shock чектүү ылдамдыктагы аймак катары аныктайт. Булактагы Tablo 2 болсо ылдамдык маанисин Region 1 үчүн 2,0451168, Region 2 үчүн 0 деп берет. Verianla аймак тартибин божомол менен тескери айландырган эмес.
Tablo 2 бирдик эскертүүсү: Ошол эле таблицада температура маанилери 0,006123676 жана 0,002487067 деп берилип, бирдиги K катары белгиленген. Булак бул өтө кичине сандардын өлчөмсүздүрүлгөн температура экенин же эмес экенин түшүндүрбөгөндүктөн, маанилер чыныгы Kelvin температурасы катары жоромолдонгон эмес.
Баштапкы уяча саны боюнча карама-каршылык эскертүүсү: Булактын бир бөлүгү шар benchmarkында “initial overset grid” үчүн 3.241.936 уяча билдирет. Кийинки бөлүм болсо \( \bar{t}=1.832 \) учурунда тор 2.232.704 баштапкы уячадан 3.241.936 уячага жеткенин билдирет. Эки баштапкы маани бири-бирине туура келбегендиктен Verianla алардын бирин үнсүз оңдогон эмес.
Сандык текшерүү чеги: Чечүүчү эки benchmark менен бааланган: Mach 2 жарым чексиз туюк мурундуу дене жана Mach 2,89 тегиз шок–шар өз ара аракеттенүүсү. Текшерүүлөр учурдагы эксперименттик таяныч маалыматтар менен жүргүзүлгөн; изилдөөнүн өзү жаңы физикалык эксперимент кампаниясы эмес.
Параллелдүү өндүрүмдүүлүк чеги: Билдирилген %89,7, %80, %65 жана %61 сыяктуу параллелдүү натыйжалуулук натыйжалары изилдөөнүн ичиндеги белгилүү grid өлчөмдөрү, MPI rank сандары жана бир HPC node үчүн жарактуу. Көп түйүндүү же GPU негизиндеги системаларга түздөн-түз жалпылана албайт.
Мазмун өндүрүү ыкмасы: Бул Verianla түшүндүрмөсүндөгү илимий ыкмалар, теңдемелер, benchmark шарттары, уяча сандары, MPI натыйжалары жана чектөөлөр каралган булак изилдөөсүнө негизделет. Тышкы текшерүү бир гана жарыя идентификациясы жана журналдын рецензия абалын библиографиялык тастыктоо максатында колдонулган; сырттан жаңы CFD натыйжасы, жаңы benchmark маалыматы же булакта жок сандык өндүрүмдүүлүк мааниси негизги текстке кошулган эмес.
Пикир калтырыңыз
E-mail дарегиңиз жарыяланбайт. Милдеттүү талаалар * менен белгиленген