

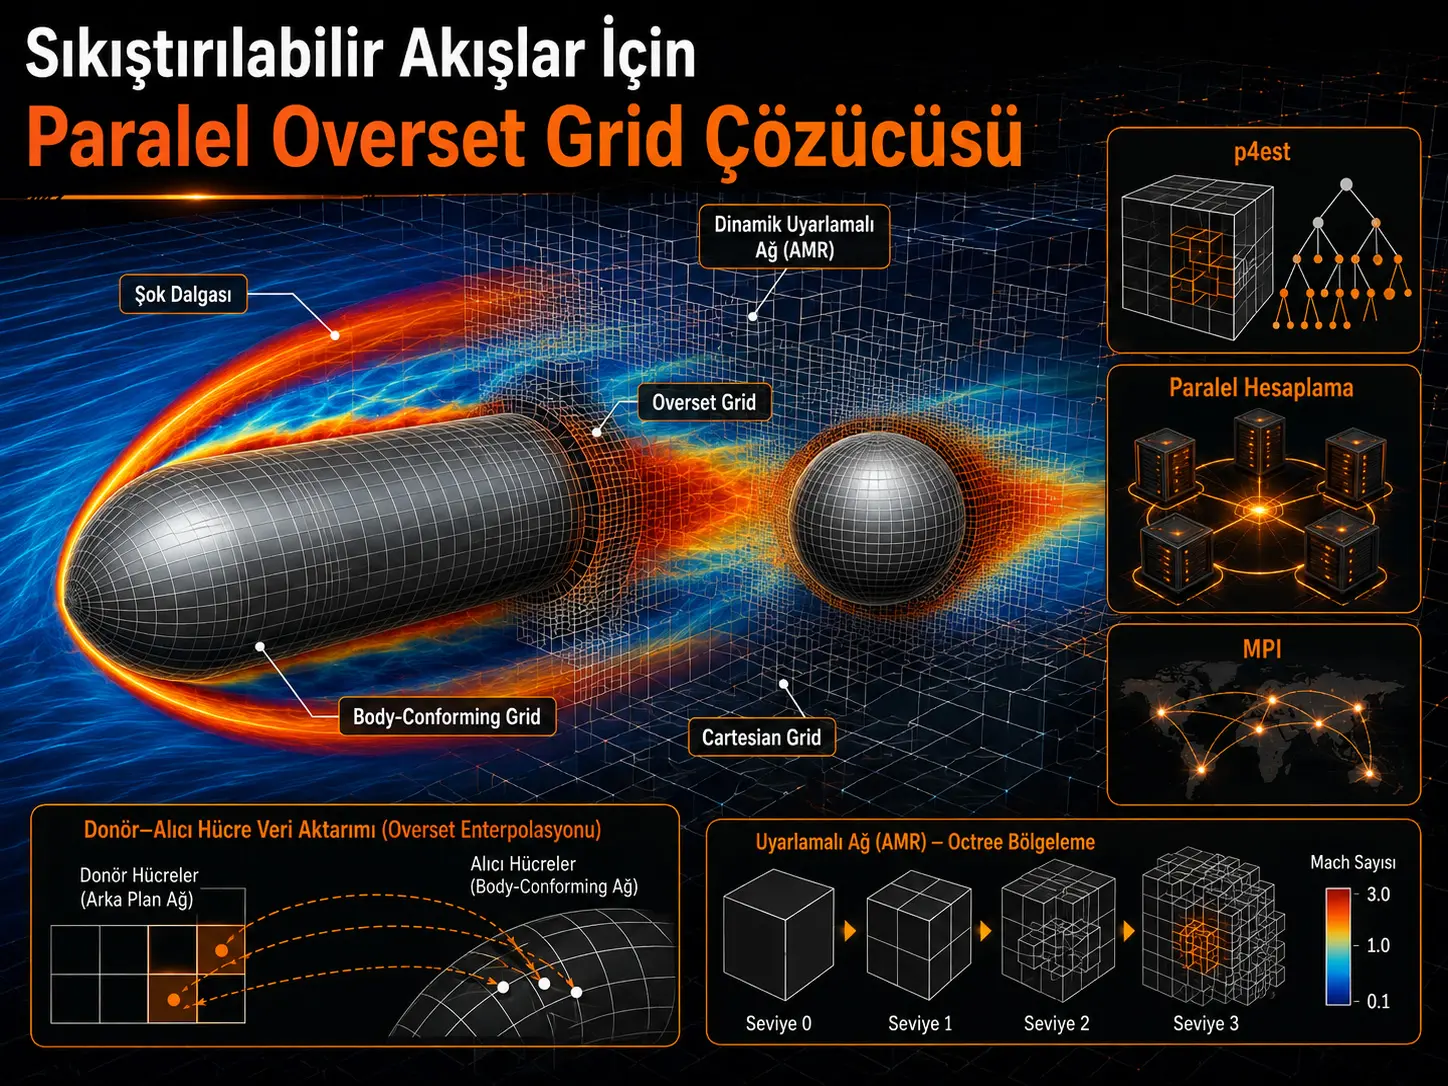
Bu tədqiqat üçölçülü sıxıla bilən axın problemlərini həll etmək üçün paralel işləyən, sonlu həcm əsaslı və dinamik Adaptive Mesh Refinement (AMR) qabiliyyətinə malik Navier–Stokes həlledicisi hazırlayır. Metod iki fərqli tor quruluşunu bir araya gətirir: geometriyanın səthini izləyən body-conforming grid və axın sahəsinin qalan hissəsində dinamik olaraq incəldilib kobudlaşdırıla bilən Cartesian off-body grid. Adaptiv Cartesian torun yaradılması, partition əməliyyatları və yükün balanslaşdırılması açıq mənbəli p4est octree kitabxanası ilə həyata keçirilir.
Tədqiqatın əsas proqram təminatı yeniliyi axın sahəsi məlumatlarının p4est-in öz node məlumat sahəsindən ayrılmasıdır. Klassik quruluşda sıxlıq, sürət, temperatur, turbulentlik dəyişənləri, qradiyentlər və MUSCL limiter məlumatları p4est node-ları ilə birlikdə daşındığı halda, təklif edilən arxitekturada p4est daxilində yalnız ünvan göstəricisi və MPI rank məlumatı saxlanılır. Gerçək axın sahəsi ayrıca bir məlumat quruluşunda saxlanılır. Beləliklə tor yenidən bölümləndikdə yenidən hesablana bilən və ya artıq etibarlılığını itirmiş bütün məlumatların MPI üzərindən daşınmasına ehtiyac qalmır; yalnız əsas axın dəyişənlərinin ötürülməsi kifayət edir.
Hazırlanan həlledici iki üçölçülü benchmark problemində sınaqdan keçirilmişdir. Mach 2 sürətindəki axının yarı sonsuz küt burunlu silindr üzərindən keçdiyi stasionar halda sayısal səth təzyiq əmsalı eksperimental nəticələrlə ümumi olaraq uyğunluq göstərmiş və adaptiv tor bow shock bölgəsində avtomatik olaraq sıxlaşmışdır. İkinci testdə Mach 2,89-luq müstəvi şok dalğasının durğun havadakı kürə ilə qarşılıqlı təsiri modelləşdirilmiş; əks olunan şok, triple point, difrakte şok və wake vorteksi dinamik tor uyğunlaşdırması ilə izlənə bilmişdir.
Paralel performans təcrübəsində stasionar overset həll 32 MPI rank-da %89,7, 64 rank-da %80 və 128 rank-da %65 paralel səmərəlilik göstərmişdir. Dinamik kürə–şok problemində flow solver ilə AMR birlikdə qiymətləndirildikdə 128 MPI rank-dakı paralel səmərəlilik %61 kimi hesabat verilmişdir. Təklif edilən paylanmış yanaşma əvvəlki master–slave tətbiqi ilə müqayisədə 32 MPI rank-da ümumi həlledici paralel səmərəliliyində %50 artım təmin etmişdir. Bununla birlikdə 128 rank-a çıxıldıqda xüsusilə az saydakı donor–receiver hüceyrəsinin rank-lar arasında qeyri-bərabər paylanması səbəbilə interpolation və overset grid assembly mərhələlərində səmərəlilik azalır.
Türkiye baxımından: Tədqiqat birbaşa İstanbul Teknik Üniversitesi-də hazırlanmış bir CFD həlledicisinə əsaslanır. Buna görə Türkiye baxımından yalnız xarici bir metodun tətbiqi deyil, üçölçülü sıxıla bilən axın, dinamik AMR, overset grid və paralel MPI hesablama komponentlərinin eyni qurumdaxili həlledicidə birləşdirilməsinə dair konkret bir sayısal metod hazırlama nümunəsidir. Bununla birlikdə məqalə iki benchmark və tək HPC düyünü üzərində doğrulama təqdim edir; gerçək təyyarə geometriyaları, çoxdüyünlü superkompüter miqyaslanması və ya sənaye doğrulaması bu tədqiqat tərəfindən sınaqdan keçirilməmişdir.
Overset grid və Adaptive Mesh Refinement nə üçün birlikdə istifadə olunur?
Əsas məqsəd bütün hesablama sahəsini davamlı olaraq çox incə torla həll etmək əvəzinə yüksək ayırdetməni yalnız fiziki baxımdan zəruri bölgələrdə istifadə etməkdir. Şok dalğaları, güclü qradiyentlər və ayrılma bölgələri kimi sahələrdə hüceyrə ölçüsü kiçildilərkən uzaq sahələrdə daha kobud tor istifadə edilə bilər. Beləliklə eyni fiziki hadisəni daha aşağı ümumi hüceyrə sayı ilə həll etmək mümkün olur.
Overset yanaşması bu adaptasiyanı geometriyadan ayırır. Geometriyanın səthini və sərhəd qatını body-conforming grid həll edərkən, geometriyadan uzaqdakı axın off-body Cartesian grid üzərində hesablanır. İki tor bir-birinin üzərinə bindirilir və kəsişmə bölgələrindəki receiver hüceyrələr üçün digər tordakı donor hüceyrələrdən interpolasiya aparılır.
Bu quruluş xüsusilə üçölçülü hərəkətli və ya güclü şok quruluşlarının olduğu problemlərdə üstünlüklüdür; çünki Cartesian off-body grid-in refine/coarsen əməliyyatları birbaşa mürəkkəb səth geometriyasını yenidən yaratmağa məcbur deyil.
Hansı axın tənlikləri həll edilir?
Hər iki benchmark üçölçülü sıxıla bilən Navier–Stokes tənlikləri ilə modelləşdirilmişdir. Stasionar küt burunlu cisim problemi turbulent olduğuna görə Reynolds-Averaged Navier–Stokes (RANS) formulyasiyası, keçici kürə–şok problemi isə laminar formulyasiya istifadə edir.
Kütlənin qorunması:
\[ \frac{\partial \rho}{\partial t} + \frac{\partial \rho u_j}{\partial x_j} =0 \]
Momentumun qorunması:
\[ \frac{\partial \rho u_i}{\partial t} + \frac{\partial \rho u_i u_j}{\partial x_j} = -\frac{\partial p}{\partial x_i} + \frac{\partial \tau_{ij}}{\partial x_j} \]
Ümumi enerjinin qorunması:
\[ \frac{\partial \rho e_t}{\partial t} + \frac{\partial \rho e_t u_j}{\partial x_j} = -\frac{\partial p u_j}{\partial x_j} + \frac{\partial}{\partial x_j} \left( k\frac{\partial T}{\partial x_j} \right) + \frac{\partial u_i\tau_{ij}}{\partial x_j} \]
Stasionar benchmark-da Reynolds gərginliklərini modelləşdirmək üçün k–ω SST 2003 turbulentlik modeli istifadə edilmişdir. Qaz kalorik olaraq mükəmməl qəbul edilmişdir. Stasionar halda viskozitenin temperatur dəyişimi Sutherland qanunu ilə modelləşdirilərkən keçici benchmark-da dinamik viskozite temperaturdan asılı olmayan sabit kimi götürülmüşdür.
Sayısal axınlar necə hesablanır?
Tənliklər sonlu həcm metodu ilə diskretləşdirilmişdir. Bir hüceyrənin yarı-diskret tənliyi mənbədə bu ümumi biçimdə verilir:
\[ \frac{\partial W_i}{\partial t} = \frac{1}{V_i} \sum_{j=1}^{J} \left(F_{v,ij}-F_{c,ij}\right)S_{ij} + Q_i \]
Konvektiv axınlarda AUSM+up sxemi istifadə edilmiş, ikinci tərtib məkan dəqiqliyi üçün MUSCL rekonstruksiyası tətbiq edilmişdir. Şok kimi kəsilmələrin yaxınında salınımları basdırmaq məqsədilə Venkatakrishnan slope limiter istifadə edilmişdir. Diffusive flux-lar ikinci tərtib mərkəzi fərq yanaşması ilə hesablanmış, zaman inteqrasiyası birinci tərtib explicit Euler metodu ilə aparılmışdır.
Stasionar həll prosesində hər hüceyrə üçün zaman addımı sabit Courant sayına görə lokal olaraq müəyyən edilərkən, transient problemlərdə bütün hüceyrələr üçün istifadə edilən zaman addımı Courant şərtindən əldə edilən minimum dəyər kimi seçilmişdir.
Off-body və body-conforming torlar necə birləşir?
Off-body Cartesian grid fərqli refinement səviyyələrində sabit sayda hüceyrə ehtiva edən bloklardan ibarətdir. Qonşu iki grid blokunun refinement səviyyələri arasındakı maksimum fərq 1 kimi saxlanılır; başqa ifadə ilə 2:1 balance şərti qorunur.
Fərqli refinement səviyyələrindəki Cartesian hüceyrələrin ortaq səthində klassik overset interpolation əvəzinə hanging-cell yanaşması istifadə edilir. Bir kobud hüceyrənin səth axını qonşu incə hüceyrələrin axınlarının cəmi ilə hesablanır:
\[ F_i=\sum_{j=1}^{4}F_j \]
Body-conforming və Cartesian torların bir-birini örtdüyü bölgədə isə donor–receiver əlaqəsi istifadə edilir. Receiver hüceyrəsindəki bir axın xassəsi inverse-distance interpolasiyası ilə:
\[ \phi_i= \frac{\sum_{j=1}^{J}w_j\phi_j} {\sum_{j=1}^{J}w_j} \]
və çəki:
\[ w_j= \frac{1} {|x_{c,j}-x_{c,i}|} \]
kimi hesablanır.
p4est bu sistemdə nə edir?
p4est octree kolleksiyalarını, yəni bir “forest of octrees” quruluşunu paralel olaraq idarə edən açıq mənbəli kitabxanadır. Tədqiqatda hər octree node-u fiziki olaraq bir Cartesian grid blokuna uyğun gəlir. Node-lar Morton və ya Z-order space-filling curve boyunca sıralanır.
Bu quruluş p4est-in:
- grid refinement və coarsening,
- 2:1 balance,
- partitioning,
- ghost-layer yaratma,
- MPI rank-lar arasında grid bloklarının paylanması
əməliyyatlarını yerinə yetirməsinə imkan verir.
Tədqiqatdakı p4est istifadəsi tamamilə CPU və MPI əsaslıdır. GPU və ya başqa bir accelerator-a device offloading tətbiq edilməmişdir.
Əvvəlki yaddaş arxitekturasının problemi nə idi?
p4est-in klassik istifadəçi məlumatı modelində hər node üçün istifadəçi tərəfindən müəyyən edilən ölçüdə bir məlumat bloku p4est tərəfindən allocate edilib idarə edilir. CFD həlledicisində bu blok yalnız sıxlıq və ya sürət kimi bir neçə ədəd ehtiva etmir; bütün grid blokunun axın məlumatlarını daşımalıdır.
Mənbə üç məlumat qrupunu ayırır:
- Gp: əsas axın xassələri \([\rho,u,v,w,T,k,\omega]\),
- Gs: viskozite, təzyiq və axın qradiyentləri kimi ikincil xassələr,
- Gl: MUSCL limiter terminləri.
Klassik quruluşda bu məlumat qruplarının hamısının p4est node-u ilə birlikdə saxlanması və partition zamanı daşınması lazımdır. Halbuki Gs-nin mühüm bir hissəsi Gp-dən yenidən hesablana bilər; bundan əlavə, qradiyentlər və limiter dəyərləri grid migration mərhələsində əvvəlki iterasiyaya aid olduqlarına görə yeni iterasiyada onsuz da yenidən yaradılacaqdır.
Təklif edilən ayrılmış məlumat quruluşu necə işləyir?
Tədqiqatçılar axın məlumatlarını p4est-in allocation sahəsindən çıxararaq ayrıca bir q məlumat quruluşunda saxlayırlar. p4est node-unun istifadəçi sahəsində isə yalnız:
- axın məlumatının yaddaşdakı ünvanını göstərən pointer,
- node-un aid olduğu MPI rank
saxlanılır.
Bu kiçik dəyişiklik iki mühüm problemi həll edir.
Coarsen–balance zamanı məlumat itkisinə yol verilməməsi
Klassik p4est axınında bir qrup node coarsen edildikdə uşaq hüceyrələrin axın xassələri parent hüceyrədə həcm çəkili orta ilə birləşdirilir:
\[ \phi_i= \sum_{j=1}^{J} \left( \frac{\phi_j V_j}{V_i} \right) \]
Lakin ortaya çıxan parent node 2:1 balance şərtini pozursa sonrakı p4est_balance çağırışı bu node-u yenidən refine edə bilər. Bu halda əvvəlcə uşaqlardan parent-a ortalanmış məlumat daha sonra yenidən uşaqlara paylanmış olur və özgün yüksək ayırdetməli informasiya itir.
Təklif edilən quruluşda axın sahəsi p4est-in node allocation-ından ayrı olduğuna görə coarsen əməliyyatı zamanı uşaqların gerçək məlumatları dərhal yox edilmir. Əgər balance əməliyyatı coarsen-ı geri alarsa, köhnə məlumatlar yenidən yaradılan uşaq node-lara bağlanır. Yalnız coarsen nəticəsi həqiqətən qalıcı olduqda maskalanmış uşaq məlumatları sərbəst buraxılır.
Load balancing zamanı lazımsız MPI trafikinin azaldılması
p4est_partition tor bloklarını MPI rank-lar arasında yenidən payladıqda klassik yanaşma node-un bütün istifadəçi məlumatını daşıyır. Tədqiqatçılar isə yalnız Gp qrupunun yeni MPI rank-a göndərilməsini təmin edirlər. Gs və Gl yeni həll çevrimində təkrar yaradılır.
Beləliklə partition mərhələsi iki rabitə addımına ayrılsa da ümumi daşınan məlumat miqdarı azaldılır. Tədqiqatın iddiası bu yanaşmanın rabitə müddətini və ümumi solver runtime-ını azaltmasıdır.
Dinamik tor dəyişəndə overset bağlantıları nə üçün yenidən qurulur?
Cartesian grid refine və ya coarsen edildikdə mövcud donor–receiver hüceyrə cütləri etibarlılığını itirə bilər. Load balancing sonrasında grid bloklarının MPI rank sahibliyi də dəyişir. Buna görə hər AMR çağırışından sonra overset grid assembly yenidən aparılmalıdır.
Əvvəlki master–slave yanaşmasında receiver geometriyaları mərkəzi bir MPI rank-a göndərilir, master rank bütün body-conforming grid məlumatını saxlayır və donor axtarışını tək nöqtədə həyata keçirirdi. Bu həm yaddaş sərfini artırır, həm də MPI rank sayı yüksəldikcə mərkəzi darboğaz yaradırdı.
Yeni metodda grid assembly tamamilə paylanmış hala gətirilir.
Bounding box yanaşması rabitəni necə məhdudlaşdırır?
Hər Cartesian və body-conforming grid partition minimum və maksimum koordinatlarını ehtiva edən bounding box ilə təmsil olunur. Receiver hüceyrələrin bounding box-ları MPI rank-lara elan edilir və yalnız kəsişən partition-lar arasında ətraflı geometriya məlumatı dəyişdirilir.
İki partition-un müəyyən bir koordinat istiqamətində kəsişməsi:
\[ x_{A,max}\geq x_{B,min} \quad\land\quad x_{A,min}\leq x_{B,max} \]
şərti ilə sınanır.
Beləliklə bir rank-ın bütün grid hüceyrələrini bütün digər rank-lara göndərməsinə ehtiyac qalmır.
Body-conforming grid donor axtarışı necə sürətləndirilir?
Body-conforming grid üçün Alternating Digital Tree (ADT) yaradılır. Hər hüceyrə bir tree node-u kimi təmsil edilir və bounding box koordinatlarına görə binary tree quruluşuna yerləşdirilir.
Receiver hüceyrə üçün donor axtarılarkən ağacın kökündən başlanır. Bounding box-ların kəsişmədiyi halda koordinat müqayisəsi yardımı ilə ağacın bir qolu tamamilə aradan qaldırılır. Kəsişmə varsa hüceyrə namizəd donor siyahısına əlavə edilir və axtarış alt qollarda davam edir. Nəticədə centroid-i receiver hüceyrəyə ən yaxın namizəd donor kimi seçilir və interpolation stencil üçün ətrafındakı qonşular da istifadə edilir.
Body-conforming grid əvvəlcədən partition edildiyi və həll zamanı geometriyası dəyişmədiyi üçün ADT həllin əvvəlində yalnız bir dəfə yaradılıb yaddaşda saxlanıla bilir.
Cartesian donor axtarışında Morton kodu necə istifadə olunur?
Cartesian grid onsuz da p4est octree forest tərəfindən idarə edildiyinə görə ayrıca spatial tree yaradılmasına ehtiyac yoxdur. Receiver hüceyrənin koordinatları ən yüksək refinement səviyyəsinə görə bit ardıcıllığına çevrilir və üç ölçüdə bu bitlər bir Morton kodunda birləşdirilir.
Morton kodunun əlaqədar bit qrupları ardıcıl oxunaraq octree daxilində hansı child node-a gediləcəyi müəyyən edilir və yarpaq node-a çatıldıqda receiver nöqtəsini əhatə edən Cartesian grid bloku tapılmış olur.
Bu sistem donor axtarışı üçün p4est-in onsuz da mövcud olan məkan məlumat quruluşundan ikinci dəfə istifadə edir.
İlk benchmark necə quruldu?
İlk doğrulama problemi Mach 2 sərbəst axının yarı sonsuz küt burunlu silindr üzərindən keçdiyi stasionar və turbulent sıxıla bilən axındır.
| Sərbəst axın parametri | Mənbədə istifadə edilən dəyər |
|---|---|
| Mach sayı | 2 |
| Reynolds sayı | 353.100 |
| Temperatur | 242,3 K |
| Turbulentlik intensivliyi | %0,05 |
Problem oxasimmetrik olmasına baxmayaraq, həlledicinin üçölçülü performansını göstərmək məqsədilə hesablama sahəsinin dörddə biri üçölçülü olaraq modelləşdirilmişdir.
Cartesian grid 3 × 3 × 3 octree forest ilə başladılmış və hər node 2 × 2 × 2 hüceyrəlik grid blokunu təmsil etmişdir. Maksimum refinement səviyyəsi 5-dir. Refinement meyarı Mach qradiyentidir və eşik dəyərləri:
\[ Q_{lower}=0.185, \qquad Q_{upper}=0.218 \]
kimi istifadə edilmişdir. Body-conforming grid-in ilk divar hüceyrəsi təxminən \(y^+=5\) olacaq şəkildə qurulmuş və yaxınsama meyarı cumulative residual relative error üçün %0,01 kimi müəyyən edilmişdir.
Tor yaxınsama tədqiqatında neçə hüceyrə istifadə edildi?
Üç tor səviyyəsi müqayisə edilmişdir:
| Tor ayırdetməsi | Maksimum refinement səviyyəsi | Stasionar vəziyyətdəki hüceyrə sayı |
|---|---|---|
| Kobud | 4 | 334.627 |
| Orta — əsas həll | 5 | 1.419.996 |
| İncə | 6 | 3.697.852 |
Təzyiq əmsalı əyrilərinin müqayisəsi orta torun problem üçün kifayət olduğunu göstərmişdir. Tədqiqatçılar buna görə performans analizlərində təxminən 1,42 milyon hüceyrəlik orta toru istifadə etmişdir.
Küt burunlu cisim nəticəsi təcrübə ilə uyğun gəlirmi?
Ümumi olaraq bəli. Sayısal \(C_p\) paylanması istinad eksperimental nəticələrlə yaxşı uyğunluq göstərmişdir. Bununla birlikdə stagnation point bölgəsində \(s/D=0\) və cismin uc-tabanına yaxın \(s/D>0.8\) bölgəsində həll eksperimental dəyərləri bir qədər aşağı qiymətləndirir.
Tədqiqatın müqayisəsinə görə hazırlanmış həlledicinin nəticəsi eyni qrafikdə verilən əvvəlki scFLOW sayısal nəticəsindən eksperimental verilərə daha yaxın görünür. Bu müqayisə yalnız bu benchmark və istifadə edilən şərtlər üçün keçərlidir; ümumi bir CFD proqram üstünlüyü anlamına gəlmir.
Numerical schlieren və Mach contour görüntülərində adaptiv Cartesian grid-in bow shock xətti boyunca ən yüksək refinement səviyyəsinə keçdiyi görünür. Beləliklə uzaq bölgələrdə lazımsız incə tor istifadə edilmədən şok kəsilməsi yüksək ayırdetmədə saxlanılır.
Stasionar benchmark paralel olaraq necə miqyaslandı?
Strong-scaling təcrübəsində 1.419.996 hüceyrəlik grid sabit saxlanmış və MPI rank sayı mərhələli şəkildə artırılmışdır. Bu tordakı receiver hüceyrə sayı 34.970-dir. Hər rank sayı üçün 100 həll iterasiyasının wall-clock müddəti ölçülmüşdür.
Speed-up:
\[ S_f=\frac{T_1}{T_N} \]
və paralel səmərəlilik:
\[ \eta=\frac{S_f}{N}\times100 \]
kimi müəyyən edilmişdir.
Verianla Live: Overset həlledicinin MPI rank sayına görə paralel səmərəliliyi
Aşağıdakı dəyərlər stasionar Mach 2 küt burunlu cisim benchmark-ında təxminən 1,42 milyon hüceyrə sabit saxlanarkən ölçülən overset-grid həlledicisinin paralel səmərəliliyidir. Bunlar weak-scaling deyil, strong-scaling nəticələridir.
| MPI rank sayı | Paralel səmərəlilik (%) | Test növü | Mənbə |
|---|---|---|---|
| 32 | 89,7 | Strong scaling — overset solver | Şəkil 12 və nəticə mətni |
| 64 | 80 | Strong scaling — overset solver | Şəkil 12 və nəticə mətni |
| 128 | 65 | Strong scaling — overset solver | Şəkil 12 və nəticə mətni |
Verianla Live mənbə qeydi: Görsəlləşdirmə bu görünən elmi məlumat cədvəlindən yaradılır. Cədvəl elmi source-of-truth kimi qorunur.
Solver 32 MPI rank-a qədər güclü miqyaslanma göstərmişdir. 32 rank-dakı paralel səmərəlilik %89,7 ikən 64 rank-da %80-ə və 128 rank-da %65-ə düşür. 128 rank-da overset həll ilə eyni hüceyrə sayına malik single-grid istinadı arasındakı paralel performans fərqi ən çox təxminən %7 kimi hesabat verilmişdir.
Interpolation niyə ümumi solver-dan daha pis miqyaslanır?
Interpolation üçün aparılan hesablama donor–receiver hüceyrələri ilə məhduddur. MPI rank sayı yüksəldikcə hər rank-a düşən receiver sayı çox azalır və overlap hüceyrələri rank-lar arasında bərabər paylanmır.
Interpolation computation segmentinin paralel səmərəliliyi təxminən:
- 32 MPI rank-a qədər %70,
- 64 MPI rank-da %44,
- 128 MPI rank-da %30
səviyyələrinə enir.
Buna qarşılıq interpolation ümumi iterasiya xərclərinin yalnız təxminən %0,2-ni 1 rank-da və %5,11-ni 128 rank-da təşkil etdiyi üçün bu aşağı alt-rutin səmərəliliyi ümumi solver performansına məhdud ölçüdə təsir edir.
Yeni yanaşma əvvəlki master–slave həlledicidən nə qədər daha yaxşıdır?
Mənbə eyni tədqiqat qrupunun əvvəlki master–slave yanaşması ilə müqayisə edildikdə yeni paylanmış metodun 32 MPI rank-da ümumi solver paralel səmərəliliyini %50 artırdığını bildirir.
Bu nəticə müəyyən donanım, grid və benchmark üçün aparılan müqayisədir. Yeni algoritmin hər problemdə və ya hər HPC arxitekturasında tam %50 qazanc təmin edəcəyi tədqiqat tərəfindən göstərilməmişdir.
İkinci benchmark niyə daha çətindir?
İkinci problem stasionar deyil. Mach 2,89 sürətində irəliləyən müstəvi şok dalğası başlanğıcda durğun havada olan kürəyə çırpılır; zaman içində əks olunan şok, incident shock, triple point, difracted shock və vortex quruluşları yaranır.
Bu axın quruluşları hərəkət etdiyi üçün incə grid bölgəsinin də zaman içində hərəkət etməsi lazımdır. Buna görə yalnız bir dəfə refine edilmiş sabit tor kifayət deyil; AMR həll zamanı təkrar-təkrar çağırılır.
Axın Reynolds sayı 7800 kimi verilmiş və laminar modelləşdirilmişdir. İstifadə olunan hava üçün mənbə:
- \(R=287.2\) J/(kg·K),
- \(c_p=1005.2\) J/(kg·K),
- \(\gamma=1.4\)
dəyərlərini verir.
Kürə benchmark-ındakı Region 1 və Region 2 məlumatları nə üçün diqqətlə oxunmalıdır?
Mənbə mətni Region 1-in durğun, Region 2-nin isə post-shock və sonlu x-istiqamətli sürət ehtiva edən bölgə olduğunu söyləyir. Buna qarşılıq yayımlanan Tablo 2 bu dəyərləri verir:
| Mənbədə verilən böyüklük | Region 1 | Region 2 |
|---|---|---|
| Sıxlıq — cədvəldə kg/m³ kimi etiketlənmiş | 5,1432014 | 1,4 |
| Temperatur — cədvəldə K kimi etiketlənmiş | 0,006123676 | 0,002487067 |
| Sürət — cədvəldə m/s kimi etiketlənmiş | 2,0451168 | 0 |
Sürət dəyərləri mətn üzrə Region tərifi ilə əks istiqamətdədir: cədvəl Region 1-i hərəkətli, Region 2-ni durğun göstərir. Bundan əlavə temperatur dəyərlərinin K etiketi ilə 10−3 mərtəbəsində verilməsi gerçək ölçülü temperaturla uyğunlaşmayan bir miqyaslandırma/etiket problemi görünüşü daşıyır. Mənbə bunu açıqlamadığı üçün Verianla bu rəqəmlərin vahidini və ya Region sırasını fərziyyə ilə düzəltmir.
Dinamik AMR necə quruldu?
Cartesian grid 10 × 5 × 5 base octree node ilə başladılmış və hər node 2 × 2 × 2 hüceyrəlik grid blokunu ehtiva etmişdir. Maksimum refinement səviyyəsi 5-dir. AMR hər 25 flow-solver iterasiyasında bir çağırılmışdır.
Refinement meyarı density gradient-dir:
\[ Q_{lower}=0.6, \qquad Q_{upper}=0.625 \]
Body-conforming grid ilk hüceyrəsinin təxminən \(y^+\approx2.5\) olması təmin edilmiş və tor kürə səthindən 2,5D kənara uzadılmışdır.
Həll CFL = 0,7 ilə aparılmış; qlobal ölçüsüz zaman addımı iterasiyaya görə təxminən \(9.2\times10^{-5}\) ilə \(1.5\times10^{-4}\) arasında dəyişmişdir.
Kürə benchmark-ındakı hüceyrə sayında mənbə niyə ziddiyyətlidir?
Tədqiqatın bir bölməsində “initial overset grid system” üçün 3.241.936 hüceyrə və 54.294 receiver hüceyrə verilir. Lakin axının zaman içində inkişafının izah edildiyi sonrakı bölmədə, \( \bar{t}=1.832 \) anında grid-in 2.232.704 başlanğıc hüceyrəsindən 3.241.936 hüceyrəyə çıxdığı yazılır.
Bu iki ifadə eyni “başlanğıc” hüceyrə sayını dəstəkləmədiyindən burada mənbədaxili uyğunsuzluq kimi qorunur. Buna qarşılıq \( \bar{t}=1.832 \) üçün 3.241.936 hüceyrə dəyəri hər iki kontekstdə də görünür və güclü miqyaslanma testində yüksək yüklü dinamik vəziyyət kimi seçilən tor budur.
Şok dalğası kürə ətrafında necə inkişaf etdi?
Numerical schlieren və Mach görüntüləri axının bir neçə ölçüsüz zaman nöqtəsindəki inkişafını göstərir:
- \(\bar{t}=0\): müstəvi incident shock kürə mərkəzindən təxminən 0,6D uzaqdadır.
- \(\bar{t}\approx0.307\): şok kürə səthinə çatdıqda reflected shock yaranır.
- \(\bar{t}=0.615\): incident və reflected shock-un kəsişməsində triple point müəyyənləşir.
- \(\bar{t}=1.832\): diffracted shock və triple point kürə wake bölgəsinə irəliləyir və bir vortex görünür.
Adaptiv tor xətləri yüksək refinement səviyyəsinin hərəkət edən şok quruluşlarını izlədiyini göstərir. Tədqiqatçılar \( \bar{t}=1.832 \) anında reflected shock-un triple point-ə bağlandığı bölgədə density gradient-in zəifləməsi səbəbilə izləmə keyfiyyətində kiçik itki olduğunu da bildirirlər.
Eksperimental schlieren müqayisəsi nə göstərdi?
Numerical schlieren görüntüsü klassik Bryson və Gross eksperimental görüntüsü ilə müqayisə edilmişdir. Reflected shock, triple point və transmitted shock mövqelərinin ümumi olaraq təcrübə ilə yaxşı uyğunlaşdığı hesabat verilmişdir.
Reflected shock standoff distance baxımından kiçik fərq vardır. Müəlliflər bu fərqin eksperimental görüntüdə görünən deformasiyalar səbəbilə görüntüləmə artefaktlarından qaynaqlana biləcəyini təklif edirlər. Bu açıqlama müəllif şərhidir; tədqiqat bu fərqin səbəbini ayrıca eksperimental olaraq sınamamışdır.
Bir dinamik AMR çağırışında hansı əməliyyatlar baş verir?
Tədqiqatda AMR prosesi beş ardıcıl seqmentə ayrılır:
- Cell flagging: hüceyrələr sensor function ilə qiymətləndirilir və refine/coarsen üçün işarələnir.
- Grid adaptation: işarələnən bloklar refine və ya coarsen edilir.
- Load balancing: grid blokları MPI rank-lar arasında yenidən paylanır və ghost layer-lar yaradılır.
- Connectivities: qonşu hüceyrə bağlantıları yenidən qurulur və cache edilir.
- Grid assembly: overset donor–receiver cütləri, interpolation əmsalları və communication cədvəlləri yenidən yaradılır.
Dinamik problemdə bu beş mərhələnin hamısı hər 25 solver iterasiyasında bir təkrarlanır.
AMR-nin hesablama xərci nə qədərdir?
AMR əməliyyatı bütün MPI rank saylarında tək bir flow-solver iterasiyasından daha qısa sürür; lakin eyni mərtəbədədir. AMR yalnız hər 25 iterasiyada bir işlədiyi üçün ümumi təsiri seyrəkləşdirilir.
128 MPI rank-da bir AMR çağırışının müddəti iki AMR arasında keçən 25 flow-solver iterasiyasının ümumi müddətinin təxminən %8-i kimi hesabat verilmişdir.
AMR-nin ən bahalı hissəsi overset grid assembly-dir. İncelənən rank saylarında grid assembly AMR müddətinin ən az %53-ünü təşkil edir.
Dinamik problem 128 MPI rank-da necə miqyaslandı?
AMR prosesinin təkbaşına scaling performansı solver qədər güclü deyil. Bunun əsas səbəbi donor/receiver sorğularının və overlap bölgələrinin MPI rank-lar arasında bərabər paylanmamasıdır.
Buna baxmayaraq AMR-nin yalnız 25 iterasiyada bir çağırılması səbəbilə bütün flow solver + AMR sistemi yüksək rank saylarında daha yaxşı davranır. Tədqiqat dinamik benchmark üçün 128 MPI rank-da təxminən %61 paralel səmərəlilik hesabat verir.
Nəticə bölməsində AMR və overset-grid-assembly mərhələlərinin 64 MPI rank-da təxminən %42 paralel səmərəliliyə çatdığı bildirilir.
Load balancing həqiqətən işə yarayırmı?
Bəli; istifadə edilən benchmark-da ölçülə bilən qazanc vardır. Tədqiqatçılar 32 MPI rank üçün eyni dinamik grid vəziyyətini load balancing açıq və qapalı biçimdə müqayisə etmişdir.
Load-balanced vəziyyətdə rank-ların normalize CPU workload paylanması daha homogen hala gəlmişdir. Mənbə MPI rank-larda ən az %17,4 workload azalması hesabat verir.
Ghost-layer və inter-grid communication daxil wall-clock müddət üzərindən baxıldıqda load-balanced solver iterasiyası load balancing tətbiq edilməyən iterasiyadan %10,1 daha qısa sürmüşdür.
Bu ölçüm tək bir adaptation sonrası vəziyyət üçündür. Müəlliflər gerçək həldə AMR bir çox dəfə çağırıldığından qazancın həll boyunca toplana biləcəyini bildirirlər.
Tədqiqatın dəstəklədiyi nəticələr
- p4est ilə üçölçülü block-based Cartesian AMR, body-conforming overset grid ilə eyni sıxıla bilən CFD həlledicisində birləşdirilə bilmişdir.
- Axın məlumatlarını p4est node allocation-ından ayıran arxitektura lazımsız data migration-ını azaldır və coarsen–balance zamanı axın məlumatının lazımsız itkisini önləyir.
- Distributed bounding-box, ADT və octree axtarış quruluşları ilə mərkəzi master rank tələb etməyən overset reassembly tətbiq edilə bilmişdir.
- Mach 2 küt burunlu cisim benchmark-ında hesablanan səth təzyiq əmsalı ümumi olaraq eksperimental məlumatla uyğundur.
- Adaptive grid bow shock ətrafında yüksək refinement səviyyəsinə keçmişdir.
- Kürə–şok benchmark-ında reflected shock, triple point, diffracted/transmitted shock və vortex quruluşları sayısal olaraq yaxalana bilmişdir.
- Stasionar benchmark-da overset solver 128 MPI rank-da %65 paralel səmərəlilik göstərmişdir.
- Dinamik solver + AMR sistemi 128 MPI rank-da təxminən %61 paralel səmərəlilik göstərmişdir.
- 32 MPI rank-dakı load balancing təcrübəsi wall-clock iteration müddətində %10,1 azalma təmin etmişdir.
- Yeni paylanmış yanaşma əvvəlki master–slave versiyaya görə 32 MPI rank-da ümumi paralel səmərəlilikdə %50 artım təmin etmişdir.
Tədqiqatın dəstəkləmədiyi və ya sınaqdan keçirmədiyi nəticələr
- Həlledicinin bütün sıxıla bilən CFD problemlərində eyni dəqiqlik və ya scaling performansı verəcəyi göstərilməmişdir.
- Tədqiqatda GPU və ya accelerator offloading sınaqdan keçirilməmişdir.
- 128 nüvədən kənarda və ya birdən çox HPC node üzərində scaling testi aparılmamışdır.
- Gerçək təyyarə, raket, roket və ya turbomaşın geometriyasında sənaye validasiyası aparılmamışdır.
- Küt burunlu cisim benchmark-ında stagnation və tip-base bölgələrindəki eksperimental fərq tamamilə aradan qaldırılmamışdır.
- Kürə benchmark-ında bütün şok quruluşları qüsursuz biçimdə izlənməmiş; \( \bar{t}=1.832 \) civarında zəifləyən density gradient səbəbilə kiçik tracking itkisi görülmüşdür.
- Overset grid assembly-nin yüksək MPI rank-larda ideal şəkildə load-balanced olduğu göstərilməmişdir.
- Mənbədə Region 1/Region 2 başlanğıc vəziyyətləri ilə hüceyrə başlanğıc sayındakı daxili uyğunsuzluqlar həll edilməmişdir.
- Tək düyündə əldə edilən %65 və ya %61 paralel səmərəlilik çoxdüyünlü superkompüter mühitinə birbaşa ümumiləşdirilə bilməz.
Tədqiqatın Metodu və Nəticələri
Sayısal həlledici arxitekturası
Hazırlanan proqram təminatı üçölçülü density-based finite-volume sıxıla bilən Navier–Stokes həlledicisidir. Stasionar turbulent problemdə k–ω SST 2003 modeli istifadə edilmişdir. Konvektiv axınlarda AUSM+up, ikinci tərtib rekonstruksiyada MUSCL və kəsilmə yaxınında Venkatakrishnan limiter tətbiq edilmişdir. Diffusive terminlər ikinci tərtib mərkəzi metodla, zaman inteqrasiyası explicit Euler ilə hesablanmışdır.
Grid arxitekturası iki komponentdən ibarətdir:
- geometriyanı və yaxın divar axınını həll edən əvvəlcədən partition edilmiş structured body-conforming grid,
- p4est octree forest tərəfindən idarə edilən block-based adaptive Cartesian off-body grid.
Refinement və coarsening meyarı
Hər Cartesian grid blokunda seçilən axın parametri \(Q\), alt və üst eşiklərlə müqayisə edilir:
- \(Q>Q_{upper}\) isə refine,
- \(Q<Q_{lower}\) isə coarsen
əməliyyatı tətbiq edilir.
p4est tərəfində grid adaptation sırası:
p4est_refinep4est_balancep4est_coarsenp4est_balance
biçimindədir. İkinci balance çağırışı coarsen sonrasında 2:1 balance şərtini yenidən təmin etmək üçün zəruridir.
Təklif edilən məlumat arxitekturasının computational məntiqi
Təklif edilən məlumat quruluşunda p4est yalnız grid topology və partition ownership məlumatı ilə məşğul olduğu halda, fiziki həll vektorları solver tərəfindən ayrı yaddaşda saxlanılır.
Load balancing zamanı yalnız:
\[ G_p=[\rho,u,v,w,T,k,\omega] \]
əsas məlumat qrupunun ötürülməsi kifayət hesab edilmişdir. Təzyiq, viskozite və diferensiallaşdırıla bilən secondary dəyərlər yenidən hesablanır; qradiyent və MUSCL limiter dəyərləri yeni solver cycle zamanı yenidən yaradılır.
Bu yanaşma xüsusilə MPI rank sayı yüksəldikdə rabitə həcmini azaltmağı hədəfləyir.
Overset reassembly algoritmi
Dinamik grid dəyişiklikdən sonra receiver–donor əlaqəsinin yenidən qurulması üç mərhələdə düşünülə bilər:
- Partition bounding box-ları istifadə edilərək hansı MPI rank-ların geometrik olaraq qarşılıqlı təsir göstərə biləcəyi müəyyən edilir.
- Body-conforming grid donor namizədləri ADT, Cartesian donor namizədləri isə p4est octree/Morton quruluşu ilə axtarılır.
- Donor–receiver cütləri müəyyən edildikdən sonra interpolation əmsalları və inter-grid MPI communication cədvəlləri yaradılır.
Bu metod master rank üzərində bütün body-conforming grid-in kopyasını saxlamaq ehtiyacını aradan qaldırır.
Stasionar benchmark-ın əsas sayısal nəticələri
| Ölçülən və ya istifadə edilən böyüklük | Nəticə |
|---|---|
| Mach sayı | 2 |
| Reynolds sayı | 353.100 |
| Əsas grid hüceyrə sayı | 1.419.996 |
| Receiver hüceyrə sayı | 34.970 |
| 32 MPI rank paralel səmərəliliyi | %89,7 |
| 64 MPI rank paralel səmərəliliyi | %80 |
| 128 MPI rank paralel səmərəliliyi | %65 |
| 128 rank-da single-grid-ə görə performans fərqi | Ən çox təxminən %7 |
Bu benchmark həlledicinin həm sayısal dəqiqliyini, həm də sabit problem ölçüsündə MPI rank sayı artdıqca strong-scaling davranışını sınayır.
Dinamik benchmark-ın əsas sayısal nəticələri
| Ölçülən və ya istifadə edilən böyüklük | Mənbədə verilən nəticə |
|---|---|
| Incident shock Mach sayı | 2,89 |
| Reynolds sayı | 7800 |
| AMR çağırış aralığı | Hər 25 solver iterasiyasında bir |
| Maksimum refinement səviyyəsi | 5 |
| Density-gradient refine eşikləri | 0,6 / 0,625 |
| \(\bar{t}=1.832\) tor hüceyrə sayı | 3.241.936 |
| 128 MPI rank solver + AMR paralel səmərəliliyi | %61 |
| 128 rank-da AMR-nin 25 iterasiyalı aralıqdakı müddət payı | Təxminən %8 |
| Grid assembly-nin AMR müddətindəki minimum payı | %53 |
| 32 rank load balancing wall-clock qazancı | %10,1 |
Paralel səmərəlilik niyə ideal deyil?
Tədqiqat yüksək MPI rank sayında paralel səmərəliliyi məhdudlaşdıran əsas ünsürün yalnız ümumi MPI rabitə xərci olmadığını göstərir. Overset overlap bölgəsindəki donor–receiver hüceyrə sayları p4est-in space-filling-curve partition əməliyyatı zamanı xüsusi bir ağırlıqla paylanmır.
Bunun nəticəsi olaraq bəzi rank-larda çox sayda interpolation sorğusu olduğu halda, bəzi rank-larda çox az ola bilər. MPI rank sayı yüksəldikcə receiver hüceyrə başına düşən hesablama miqdarı kiçilir və communication latency ilə workload imbalance daha nəzərə çarpan hala gəlir.
Bu təsir xüsusilə grid assembly və interpolation alt-rutinlərində görünür. Flow solver-ın bütün hüceyrələrdə apardığı Navier–Stokes hesabı isə daha nizamlı paylandığı üçün ümumi solver scaling-i daha güclü qalır.
Tədqiqatın mühəndislik baxımından əsas töhfəsi
Tədqiqatın əsas töhfəsi yeni bir Navier–Stokes tənliyi və ya yeni bir shock-capturing flux hazırlamaq deyil. Yenilik mövcud və doğrulanmış CFD quruluş daşlarının paralel dinamik overset AMR daxilində daha səmərəli məlumat və rabitə arxitekturası ilə necə birləşdirilə biləcəyinə yönəlir.
Xüsusilə:
- p4est grid management ilə axın məlumatının ayrılması,
- yalnız zəruri solution variables-ların migration-ı,
- coarsen–balance zamanı axın məlumatının qorunması,
- master rank əvəzinə distributed overset assembly,
- ADT və octree-nin grid növünə görə birlikdə istifadə edilməsi
tədqiqatın algoritmik töhfələrinin mərkəzindədir.
Əsas məhdudiyyətlər
- Scaling testləri tək bir dual-socket HPC node üzərində aparılmışdır.
- Ən yüksək test miqyası 128 MPI rank-dır.
- GPU istifadə edilməmişdir.
- Yalnız iki benchmark incələnmişdir.
- Overset assembly workload-u MPI rank-lar arasında birbaşa ağırlıqlı olaraq balanslaşdırılmır.
- Yüksək rank sayında communication və azalan receiver-cell sıxlığı assembly performansını məhdudlaşdırır.
- Kürə benchmark-ındakı Region tərifləri və başlanğıc hüceyrə sayı mənbə daxilində uyğunsuzdur.
- Gerçək sənaye təyyarəsi və ya kosmik aparat geometriyası ilə doğrulama aparılmamışdır.
Mənbə və Metod Qeydi
Tam özgün çalışma adı: A Parallel Solver on a Dynamically Adaptive Overset Grid for Compressible Flow Problems
Müəlliflər: Mohamad El Hajj Ali Barada; Bayram Celik.
Müəllif sırası: Mənbədəki özgün sıra eynilə qorunmuşdur.
Bərabər töhfə/bərabər birinci müəllif: Mənbədə göstərilməmişdir.
Məsul müəllif: Mohamad El Hajj Ali Barada.
Qurumlar: Aeronautical and Astronautical Engineering Program, Istanbul Technical University, Istanbul 34469, Turkey; Department of Astronautical Engineering, mənbədə “Istanbul Tehnical University” biçimində yazılmışdır, Istanbul 34469, Turkey.
Afiliyasiya yazım qeydi: İlk afiliyasiyada “Istanbul Technical University”, ikinci afiliyasiyada isə “Istanbul Tehnical University” yazılır. Verianla bunun ikinci afiliyasiyadakı yazım xətası olduğuna dair güclü bir işarə bulunduğunu qeyd edir; lakin özgün mənbə mətnini səssizcə dəyişdirmir.
Mənbə növü: Hakemli tədqiqat məqaləsi; üçölçülü sıxıla bilən CFD həlledicisi, paralel hesablama, dinamik adaptive mesh refinement və benchmark doğrulaması ehtiva edən sayısal metod tədqiqatı.
Jurnal: Aerospace
Nəşriyyat: MDPI
Cild / məqalə nömrəsi: 13, 656
Nəşr tarixi: 20 Temmuz 2026
DOI: 10.3390/aerospace13070656
Rəsmi nəşr bağlantısı: https://www.mdpi.com/2226-4310/13/7/656
DOI bağlantısı: https://doi.org/10.3390/aerospace13070656
Hakemlik vəziyyəti: Tədqiqat hakemli Aerospace jurnalında yayımlanmış tədqiqat məqaləsidir.
Lisenziya: Creative Commons Attribution 4.0 International (CC BY 4.0).
Maliyyələşdirmə: Tədqiqat xarici maliyyələşdirmə almamışdır.
Məlumat əlçatanlığı: Tədqiqatda təqdim edilən məlumatların məqbul tələb əsasında məsul müəllifdən əldə edilə bildiyi bildirilmişdir.
Maraqlar toqquşması: Müəlliflər maraqlar toqquşması bildirməmişdir.
Müəllif töhfələri: Bayram Celik; gözdən keçirmə və redaktə, nəzarət və hesablama resurslarının əldə edilməsindən məsuldur. Mohamad El Hajj Ali Barada; ilk qaralama, computational software development, məlumat analizi, metodologiya və konseptuallaşdırmanı həyata keçirmişdir.
Hesablama platforması: Benchmark-lar dual-socket tək HPC compute node üzərində aparılmışdır. Node iki AMD EPYC 7742 prosessoruna, 2,25 GHz əsas tezliyə və ümumilikdə 128 CPU nüvəsinə malikdir. p4est və həlledici MPI əsaslı CPU səviyyəsində işlədilmiş; GPU və ya device offloading istifadə edilməmişdir.
Region 1 / Region 2 uyğunsuzluq qeydi: Kürə–şok benchmark-ının mətn izahı Region 1-i durğun, Region 2-ni post-shock sonlu sürətli bölgə kimi tanıdır. Mənbədəki Tablo 2 isə sürət dəyərini Region 1 üçün 2,0451168, Region 2 üçün 0 verir. Bölgə sırasını Verianla fərziyyə ilə tərsinə çevirməmişdir.
Tablo 2 vahid qeydi: Eyni cədvəldə temperatur dəyərləri 0,006123676 və 0,002487067 kimi verilir və vahid K kimi etiketlənir. Mənbə bu çox kiçik rəqəmlərin ölçüsüzləşdirilmiş temperatur olub-olmadığını açıqlamadığından dəyərlər gerçək Kelvin temperaturu kimi şərh edilməmişdir.
Başlanğıc hüceyrə sayı uyğunsuzluq qeydi: Mənbənin bir bölməsi kürə benchmark-ında “initial overset grid” üçün 3.241.936 hüceyrə bildirir. Sonrakı bölmə isə \( \bar{t}=1.832 \) anında torun 2.232.704 başlanğıc hüceyrəsindən 3.241.936 hüceyrəyə çatdığını bildirir. İki başlanğıc dəyəri bir-biri ilə uyuşmadığından Verianla bunlardan birini səssizcə düzəltməmişdir.
Sayısal doğrulama sərhədi: Həlledici iki benchmark ilə qiymətləndirilmişdir: Mach 2 yarı sonsuz küt burunlu cisim və Mach 2,89 müstəvi şok–kürə qarşılıqlı təsiri. Doğrulamalar mövcud eksperimental istinad məlumatları ilə aparılmışdır; tədqiqatın özü yeni bir fiziki təcrübə kampaniyası deyil.
Paralel performans sərhədi: Hesabat verilən %89,7, %80, %65 və %61 kimi paralel səmərəlilik nəticələri tədqiqat daxilindəki müəyyən grid ölçüləri, MPI rank sayları və tək HPC node-u üçün keçərlidir. Çoxdüyünlü və ya GPU əsaslı sistemlərə birbaşa ümumiləşdirilə bilməz.
Məzmun istehsal metodu: Bu Verianla izahındakı elmi metodlar, tənliklər, benchmark şərtləri, hüceyrə sayları, MPI nəticələri və məhdudiyyətlər incələnən mənbə tədqiqatına əsaslanır. Xarici yoxlama yalnız nəşr kimliyi və jurnalın hakemlik vəziyyətinin bibliyografik doğrulanması məqsədilə istifadə edilmiş; kənardan yeni CFD nəticəsi, yeni benchmark məlumatı və ya mənbədə olmayan sayısal performans dəyəri əsas mətnə əlavə edilməmişdir.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib