

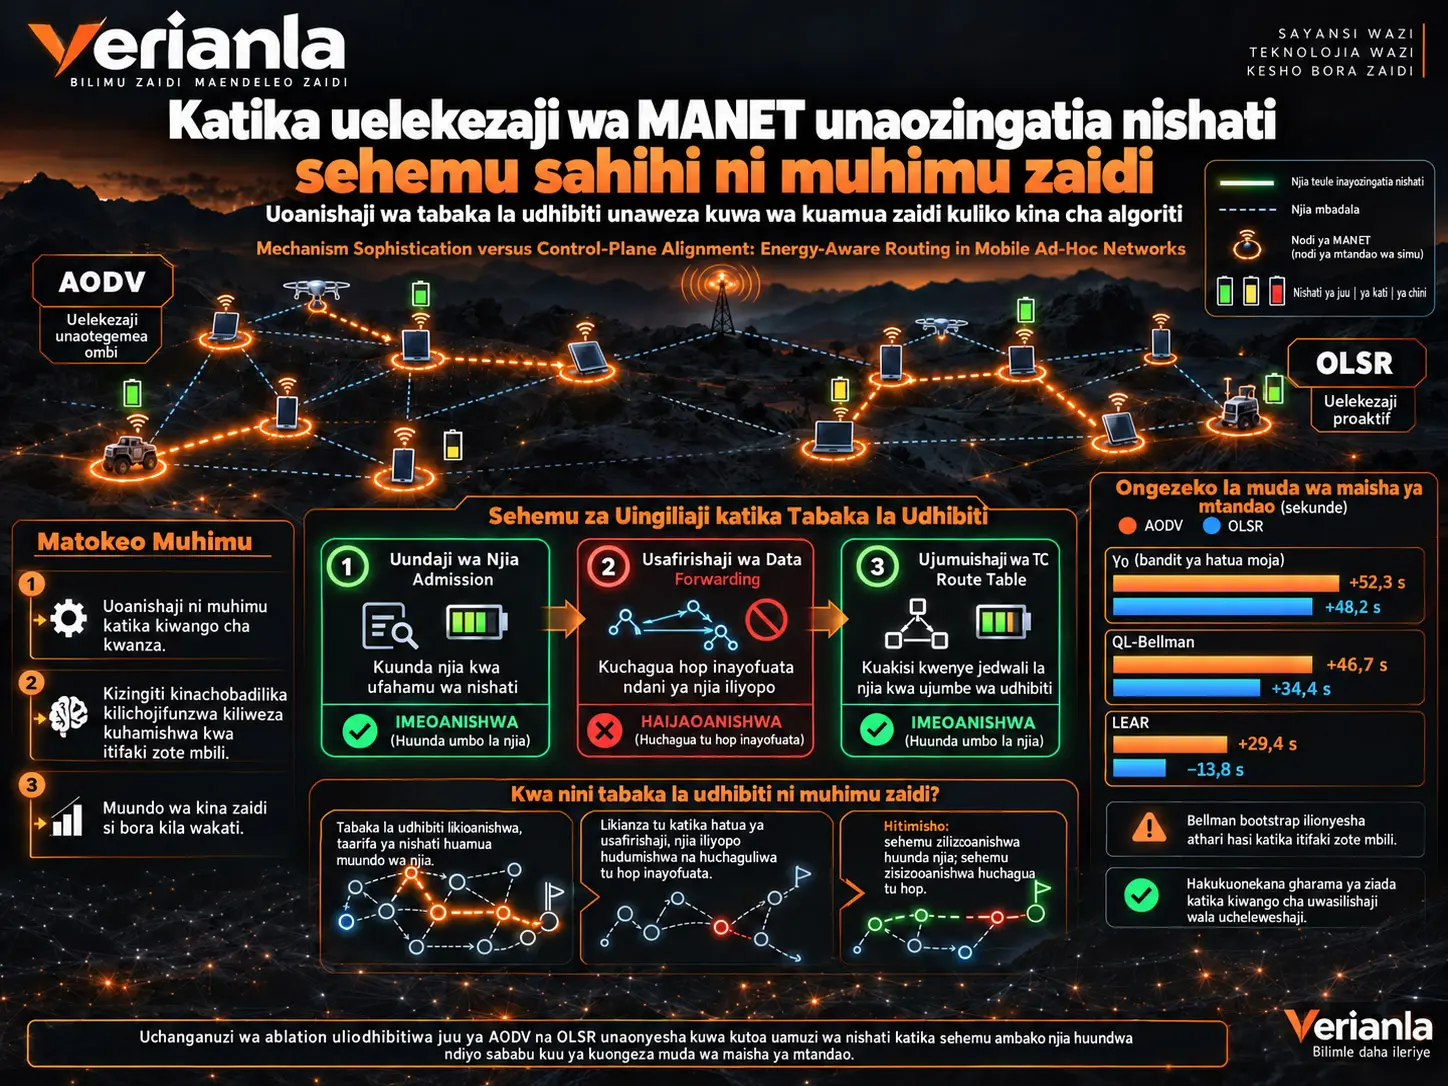
Mbinu za uelekezaji zinazotengenezwa ili kuokoa nishati katika mitandao ya ad hoc ya simu zinaweza kutumia mbinu za kujifunza zinazozidi kuwa changamano. Hata hivyo, je, uwezo wa utaratibu kuongeza muda wa maisha ya mtandao unatokana na kiwango chake cha uchangamano, au ni muhimu zaidi kwamba uamuzi wa nishati utekelezwe katika sehemu sahihi ya itifaki ya uelekezaji? Utafiti huu unafanya uchanganuzi wa ablation unaodhibitiwa kwenye itifaki za AODV na OLSR ili kutenganisha athari hizi mbili.
Dhana kuu ya utafiti ni uoanishaji wa tabaka la udhibiti. Uamuzi wa nishati huhesabiwa kuwa umeoanishwa ikiwa unatekelezwa katika sehemu ambayo itifaki huunda njia au kuunda route table. Katika AODV, sehemu hii hutokea wakati wa kupokea na kusambaza tena ujumbe wa RREQ. Katika OLSR, uamuzi wa nishati lazima uunganishwe na utaratibu wa willingness unaoathiri uteuzi wa MPR au na ujumuishaji wa taarifa za topology-control kwenye route table. Kinyume chake, mabadiliko ya next-hop yanayofanywa wakati wa kusambaza paketi ya data ni uingiliaji wa baadaye kimuundo kwa sababu njia tayari imeundwa.
Waandishi wanachukua QL-Bellman, utaratibu wa veto ya nishati uliooanishwa na unaojifunza, kuwa mahali pa kuanzia. Kisha wanaondoa vipengele kimoja baada ya kingine, kama vile kitendo, taarifa ya nishati, uoanishaji, kujifunza na Bellman bootstrap, ili kupima ni kipengele kipi kinachobeba faida ya muda wa maisha ya mtandao. Majaribio yanafanywa kwenye ns-3 kwa nodi 50 zinazotembea, mizigo sita ya trafiki na seed 20 za nasibu zilizooanishwa kwa kila hali.
Matokeo yanaonyesha kuwa kuweka utaratibu katika sehemu sahihi ya udhibiti ni jambo la msingi. Kizingiti cha nishati kinachobadilika kilichojifunzwa kinaongeza muda wa maisha katika AODV na OLSR, ilhali LEAR yenye kizingiti kisichobadilika ni yenye manufaa katika AODV lakini hupunguza muda wa maisha katika OLSR. Muhimu zaidi, Bellman bootstrap inayobeba thamani ya jirani kwenda mbele hupunguza utendaji katika itifaki zote mbili. Katika rejimu hii ya majaribio, muda wa juu zaidi wa wastani wa maisha unapatikana kwa toleo la bandit la hatua moja lenye \(\gamma=0\), ambalo huondoa bootstrap.
Tofauti kati ya tabaka la udhibiti na tabaka la data
Katika itifaki ya uelekezaji, tabaka la udhibiti linajumuisha taratibu zinazoamua ni njia zipi zitakazokuwepo na jinsi taarifa za uelekezaji zitakavyoundwa kwenye mtandao. Tabaka la data, kwa upande mwingine, hutumia maamuzi hayo ya uelekezaji yaliyoundwa kusafirisha paketi halisi.
Kwa hiyo, ni muhimu utaratibu unaozingatia nishati ufanye kazi katika tabaka gani na katika hatua gani. Ikiwa nodi yenye nishati kidogo inaondolewa kwenye njia inayotarajiwa kabla ya njia kuundwa, seti ya njia ambazo trafiki yote ya data inayofuata itatumia hubadilika. Taarifa hiyo hiyo ya nishati ikitumika wakati wa usambazaji wa paketi, utaratibu hauwezi tena kubadilisha ni njia zipi zinapatikana; unaweza tu kufanya uamuzi kati ya chaguo zilizokwisha undwa.
Uoanishaji wa Tabaka la Udhibiti Unamaanisha Nini?
Katika utafiti, utaratibu huhesabiwa kuwa umeoanishwa ikiwa sehemu yake ya kitendo inaendana na hatua ya itifaki ya kuunda njia au kuunda route-state. Hili si suala la kuchagua mahali pazuri tu; hoja ni kwamba sehemu ya kitendo hubadilisha kazi ya kisababishi ya utaratibu.
Uoanishaji katika AODV
AODV ni itifaki tendaji. Inapohitajika, ugunduzi wa njia hufanywa na ujumbe wa RREQ husambazwa katika mtandao ili kuunda njia zinazowezekana.
Ikiwa utaratibu wa veto ya nishati unaamua kama nodi itakubali na kusambaza tena ujumbe wa RREQ, nodi yenye nishati kidogo inaweza isiingie kabisa kwenye njia inayotarajiwa. Hivyo, uamuzi wa nishati huunda moja kwa moja ni njia zipi zitakazokuwepo.
Taratibu za AODV zilizoanishwa katika utafiti hufanya kazi katika sehemu hii.
Uoanishaji katika OLSR
OLSR, kwa upande mwingine, ni itifaki proaktif. Badala ya kugundua njia inapohitajika, huhifadhi taarifa za topolojia kila wakati na kutumia muundo wa Multipoint Relay (MPR).
Kwa hiyo, haiwezekani kuhamisha utaratibu wa RREQ veto wa AODV kwenda OLSR neno kwa neno. Sehemu za udhibiti zinazolingana kiutendaji ni kuunganisha kiwango cha nishati na utaratibu wa willingness unaoathiri uteuzi wa MPR na na ujumuishaji wa taarifa za topology-control katika route table ya ndani.
Tofauti hii ndiyo msingi wa hoja kuu ya makala: haitoshi kutathmini uhamishikaji wa algoritimu kati ya itifaki kwa kuangalia tu kama kanuni ya uamuzi ni ileile; lazima pia ichunguzwe kama uamuzi bado unagusa sehemu ya kuunda njia katika itifaki mpya.
Utaratibu unaofanya kazi mahali pasipofaa
Katika chanzo, toleo la override linahamisha uamuzi wa nishati katika AODV kwenda hatua ya data-forwarding. Taarifa ya nishati bado ipo na utaratibu wa kujifunza bado unaweza kufanya kazi; lakini njia tayari imeundwa.
Toleo hili linaweza kufanya next-hop reselection tu kati ya njia zilizopo. Kupotea kwa sehemu kubwa ya faida ya muda wa maisha katika majaribio ni mojawapo ya misingi mikuu ya tafsiri ya waandishi kwamba uoanishaji si hyperparameter tu, bali ni sifa ya kimuundo inayoamua kile ambacho utaratibu unaweza kufanya.
Utaratibu wa Veto ya Nishati wa QL-Bellman Unafanyaje Kazi?
Utaratibu wa rejea ni mfumo wa admission-control uliosambazwa unaogawanya hali ya nishati katika makundi machache mapana na kujifunza mtandaoni kati ya vitendo viwili. Vitendo ni rahisi: kukubali ujumbe wa udhibiti unaoingia au kuupinga kwa veto.
Kuweka hali ya nishati katika viwango bainifu
Nishati iliyorekebishwa
\[ e\in[0,1] \]
hugawanywa katika hali nne pana:
\[ s=\lfloor 4e\rfloor. \]
Kutumia hali nne ni chaguo la makusudi. Ikiwa hali zitagawanywa kwa undani sana, kila hali inaweza kutembelewa mara chache na mifano ya kutosha kwa kujifunza mtandaoni isijitokeze.
Ishara ya tuzo
Tuzo inayotegemea nishati ina viwango vitatu:
\[ r= \begin{cases} +1, & e\geq\theta_{\mathrm{hi}},\\ -1, & e<\theta_{\mathrm{lo}},\\ 0, & \text{diğer durumlarda}. \end{cases} \]
Katika chanzo
\[ \theta_{\mathrm{hi}}=0.66, \qquad \theta_{\mathrm{lo}}=0.33 \]
hutumiwa.
Sasisho la Bellman
Kwa kitendo cha kukubali:
\[ q_{\mathrm{acc}} \leftarrow (1-\alpha)q_{\mathrm{acc}} + \alpha \left( r+\gamma V_{\mathrm{nbr}} \right), \]
na kwa kitendo cha veto:
\[ q_{\mathrm{veto}} \leftarrow (1-\alpha)q_{\mathrm{veto}} + \alpha(-r). \]
Kipengele
\[ \gamma V_{\mathrm{nbr}} \]
hapa ni Bellman bootstrap inayobeba thamani ya nodi jirani hadi kwenye uamuzi wa sasa.
Katika usanidi mkuu wa QL-Bellman
\[ \alpha=0.3,\qquad \gamma=0.9 \]
hutumiwa.
\(\gamma=0\) inapowekwa, athari ya bootstrap ya thamani ya baadaye/jirani huondolewa kabisa na utaratibu hubadilika kuwa bandit ya hatua moja.
Mbinu na Matokeo ya Utafiti
Muundo wa ablation
| Toleo | Ishara ya nishati | Sehemu sahihi ya kitendo | Kujifunza | Bellman bootstrap | Wazo linalojaribiwa |
|---|---|---|---|---|---|
| Vanilla | Hakuna | Hakuna | Hakuna | Hakuna | Itifaki isiyobadilishwa |
| QL-Bellman | Ipo | Ipo | Ipo | Ipo | Utaratibu kamili wa rejea |
| LEAR | Ipo | Ipo | Hakuna | Hakuna | Kizingiti kisichobadilika |
| \(\gamma_0\) | Ipo | Ipo | Ipo | Hakuna | Je, bootstrap inahitajika? |
| veto-off | Ipo | Ipo | Ipo | Ipo | Kujifunza lakini kutotenda |
| blind | Nasibu | Ipo | Hapana | Hapana | Thamani ya taarifa ya nishati |
| override | Ipo | Si sahihi / forwarding | Ipo | Ipo | Athari ya sehemu ya kitendo |
Kwa nini “mashindano ya algoritimu” ya kawaida hayafanywi?
Badala ya kuweka matokeo ya mifumo tofauti ya programu sambamba, utafiti huwasha na kuzima vipengele kwa compile-time flag katika msingi uleule wa msimbo. Imethibitishwa kwamba wakati flag zote zimezimwa, faili ya binary ni byte-identical na itifaki ya ns-3 ambayo haijabadilishwa.
Pia, matoleo yameoanishwa kwa seed zilezile za nasibu. Kwa njia hii, seed ileile huzalisha uhamaji na hali za awali za nishati zinazofanana katika matoleo yote. Kipimo cha tofauti:
\[ \Delta HND = HND_{\mathrm{varyant}} - HND_{\mathrm{vanilla}} \]
hufanywa kupitia tofauti iliyoanishwa katika hali ileile ya majaribio.
Mazingira ya majaribio ya ns-3
| Kigezo | Thamani |
|---|---|
| Simulata | ns-3.46.1 |
| Idadi ya nodi | 50 |
| Eneo | 1000 × 1000 m |
| Uhamaji | Random Waypoint |
| Kasi | 1–5 m/s |
| Kusubiri | 0–2 s |
| Redio | IEEE 802.11g, 54 Mbps |
| Muundo wa masafa | 250 m cap |
| Paketi | 512 B UDP |
| Trafiki | Paketi 4/s kwa kila mtiririko |
| Idadi ya mitiririko | 10, 15, 20, 25, 30, 35 |
| Nishati ya awali | 3,3–3,7 J |
| Muda | 500 s |
| Seed ya nasibu | 20 kwa kila seli |
Kwa nini Half-Node-Death hutumiwa?
Kipimo kikuu cha utendaji ni Half-Node-Death (HND), yaani muda ambao nodi ya 25 hufa katika mtandao wenye nodi 50.
Kwa kuwa hakina unyeti kupita kiasi kwa nodi moja kufa mapema sana au kuchelewa sana, ni kipimo cha jumla zaidi cha end-of-life kinachowakilisha muda wa matumizi wa mtandao.
Katika chanzo, katika seli zote 1560 za majaribio, nodi ya 25 ilikufa kabla ya kumalizika kwa jaribio la sekunde 500. Kwa hiyo, matokeo ya HND hayakucensored wala kukadiriwa.
Matokeo ya muda wa maisha
| Utaratibu | AODV ΔHND | OLSR ΔHND |
|---|---|---|
| \(\gamma_0\) bandit ya hatua moja | +52,3 s | +48,2 s |
| QL-Bellman | +46,7 s | +34,4 s |
| LEAR | +29,4 s | −13,8 s |
| Blind veto | +12,2 s | +4,9 s |
| Veto-off | +0,4 s | −0,3 s |
| Override | −2,6 s | Katika chanzo AODV-only |
Je, Faida Kubwa Zaidi Inatokana na Kina cha Kialgoritimu?
Katika majaribio haya, hapana. Faida kubwa zaidi ya muda wa maisha haikutolewa na sasisho kamili la Bellman, bali na toleo la bandit la hatua moja lenye \(\gamma=0\), ambalo halifanyi bootstrap ya thamani ya jirani. Hata hivyo, matokeo haya hayamaanishi kwamba “kujifunza kwa uimarishaji hakuhitajiki”. Kanuni ya uamuzi inayobadilika na kujifunzwa badala ya kizingiti kisichobadilika ilitoa mchango muhimu, hasa katika OLSR.
Utenganishaji wa mchango kwa AODV
Uchanganuzi wa additive scale wa chanzo ni:
\[ \underbrace{+29.4}_{\text{hizalanmış sabit veto}} + \underbrace{22.9}_{\text{öğrenilmiş kural}} - \underbrace{5.6}_{\text{Bellman bootstrap}} = \underbrace{46.7}_{\text{QL-Bellman toplamı}} \quad\mathrm{s} \]
kwa namna hii.
Yaani, katika AODV, kuweka kizingiti cha nishati katika sehemu sahihi hutoa faida kubwa ya awali; kujifunza huongeza faida zaidi juu yake; bootstrap ya hatua nyingi huchukua nyuma sehemu ya faida hiyo.
Utenganishaji wa mchango kwa OLSR
Katika OLSR, TC veto iliyojifunzwa na kuanishwa:
\[ +48.2\ \mathrm{s} \]
hutoa faida, huku Bellman bootstrap:
\[ -13.8\ \mathrm{s} \]
ikichangia na kufanya faida ya jumla ya QL-Bellman kuwa:
\[ +34.4\ \mathrm{s} \]
.
Mbinu ya LEAR willingness yenye kizingiti kisichobadilika katika OLSR, kama utaratibu tofauti, hutoa:
\[ -13.8\ \mathrm{s} \]
.
Kwa nini Bellman bootstrap inaweza kuwa imeleta madhara?
Maelezo ya chanzo yanaangazia sababu mbili za kimuundo:
- Kitendo ni cha aina mbili tu, admit au veto; kwa hiyo huenda kusiwe na muundo tajiri wa maamuzi ambao mnyororo mrefu wa thamani wa hatua nyingi unaweza kutumia.
- Katika mtandao unaotembea na unaotumia nishati kila wakati, thamani iliyojifunzwa ya jirani inaweza kupitwa na wakati haraka. Bootstrap inaweza kusambaza thamani hiyo ya zamani katika hop mbalimbali na kuongeza kelele.
Kwa hiyo, katika hali za utafiti, kujifunza kwa kina kidogo na kwa hatua moja kulitengeneza sehemu ya kazi iliyo thabiti zaidi.
Kwa Nini Kizingiti Kisichobadilika cha Nishati Hufanya Kazi katika AODV lakini Hushindwa katika OLSR?
LEAR kutoa faida ya muda wa maisha ya +29,4 s katika AODV lakini kushuka hadi −13,8 s katika OLSR kunaonyesha kwamba aina ileile ya kizingiti cha nishati haiwezi kuhamishwa moja kwa moja kati ya familia tofauti za itifaki. Chanzo hakielezi hili kwa mpangilio mbaya wa kizingiti pekee; kinabainisha kwamba wakati kizingiti cha OLSR willingness kilichunguzwa kati ya 0,1 na 0,5, thamani zote zisizobadilika zilipunguza muda wa maisha.
Veto ya \(\gamma_0\) iliyojifunzwa, bila kurekebishwa upya, hutoa:
\[ +52.3\ \mathrm{s} \]
kwa AODV na
\[ +48.2\ \mathrm{s} \]
kwa OLSR.
Kwa hiyo, matokeo ya “rule quality” ya utafiti yanaonyesha kuwa kizingiti kinachobadilika kilichojifunzwa kina ustahimilivu zaidi kwa mabadiliko ya itifaki kuliko kizingiti kisichobadilika.
Athari ya kitakwimu ya uoanishaji
| Itifaki | Lever | Wastani wa ΔHND | Muda wa kujiamini wa %95 | p | Cliff's δ |
|---|---|---|---|---|---|
| AODV | Alignment | +46,3 s | [+41,2, +51,3] | <10⁻⁴ | +1,00 |
| AODV | Point | +49,3 s | [+44,0, +54,4] | <10⁻⁴ | +1,00 |
| AODV | Intelligence | +34,5 s | [+29,9, +39,2] | <10⁻⁴ | +1,00 |
| AODV | Rule quality | +17,3 s | [+13,4, +21,9] | <10⁻⁴ | +1,00 |
| AODV | Bellman bootstrap | −5,5 s | [−9,0, −2,2] | 0,0037 | −0,60 |
| OLSR | Alignment | +34,8 s | [+28,7, +40,9] | <10⁻⁴ | +1,00 |
| OLSR | Rule quality | +48,2 s | [+42,0, +54,6] | <10⁻⁴ | +1,00 |
| OLSR | Bellman bootstrap | −13,7 s | [−16,8, −10,7] | <10⁻⁴ | −1,00 |
\(\delta=+1\) inaonyesha kwamba seed zote 20 zilizooanishwa na kulinganishwa zilitoa matokeo katika mwelekeo uleule. Kwa hiyo, athari kubwa kama uoanishaji, matumizi ya taarifa ya nishati na kanuni iliyojifunzwa hazikutokana tu na hali chache za pembeni katika wastani.
Je, Muda Mrefu Zaidi wa Maisha ya Mtandao Unapatikana kwa Kujinyima Uwasilishaji wa Paketi?
Kwa taratibu zenye faida chanya ya muda wa maisha zilizochunguzwa katika chanzo, hakuna biashara ya aina hiyo iliyoonekana. Mabadiliko ya PDR ni ama chanya au hayana tofauti ya kitakwimu; end-to-end delay pia ni ya kawaida au ya chini zaidi katika sehemu kuu za kazi zinazozingatia nishati.
Athari ya uoanishaji kwenye PDR
Kwa AODV, uoanishaji:
\[ \Delta PDR=+1.77 \]
pointi za asilimia; kwa OLSR:
\[ \Delta PDR=+1.07 \]
pointi za asilimia zimeripotiwa.
Katika AODV, kupunguza trafiki ya RREQ yenye thamani ndogo kunaweza kupunguza migongano na mzigo wa congestion katika mazingira yasiyotumia waya. Katika OLSR, kwa kuwa TC veto haipunguzi kiwango cha flooding kwa njia ileile, tafsiri ya chanzo inalenga zaidi kuhamisha trafiki mbali na nodi ambazo nishati yake inakaribia kuisha.
Matokeo ya ucheleweshaji
Toleo la \(\gamma_0\) katika AODV dhidi ya vanilla limeleta tofauti ya:
\[ -1.48\ \mathrm{ms} \]
lakini kwa kuwa muda wa kujiamini unajumuisha sifuri, hakuna kupungua au kuongezeka kwa kasi kwa maana kulikoonyeshwa.
Katika OLSR:
\[ -2.08\ \mathrm{ms} \]
na muda wa kujiamini wa %95
\[ [-3.01,-1.19]\ \mathrm{ms} \]
umeripotiwa, yaani ni haraka zaidi katika hali hizi za utafiti.
Kinyume chake, override isiyoanishwa vizuri katika AODV iliongeza takriban +5,45 ms na signal-blind veto +4,69 ms ya ucheleweshaji.
Hitimisho zinazoungwa mkono na utafiti
- Katika usanifu wa AODV na OLSR uliochunguzwa, kuoanisha uamuzi wa nishati na route-construction ni sehemu kubwa na ya lazima ya faida ya muda wa maisha ya mtandao.
- Kujifunza pekee hakutoi faida ya muda wa maisha ikiwa utaratibu hautekelezi kitendo hicho kwa kweli.
- Uamuzi unaotegemea nishati ni bora zaidi kwa uwazi kuliko kutumia veto ya nasibu.
- Kizingiti kinachobadilika kilichojifunzwa kinaweza kuhamishwa kwa itifaki zote mbili, huku kanuni ya LEAR isiyobadilika ikishindwa katika OLSR.
- Katika rejimu hii ya majaribio, kuongeza Bellman bootstrap kulipunguza muda wa maisha katika itifaki zote mbili.
- Bandit ya hatua moja yenye \(\gamma=0\) ilitoa faida ya juu zaidi ya wastani wa HND kati ya matoleo yaliyopimwa.
- Faida chanya ya muda wa maisha haikupatikana kwa gharama ya kuwasilisha paketi chache au kuongeza ucheleweshaji.
Tafsiri ambazo utafiti hauungi mkono
- Utafiti hauungi mkono hitimisho kwamba “kujifunza kwa uimarishaji hakuhitajiki”; kizingiti kinachobadilika kilichojifunzwa kina mchango muhimu chanya.
- Haijaonyeshwa kwamba Bellman bootstrap ni hatari katika mitandao yote au matatizo yote ya RL.
- Haijathibitishwa kwamba uoanishaji wa tabaka la udhibiti ni sheria ya ulimwengu kwa familia zote za itifaki.
- Matokeo yalipatikana kwenye itifaki mbili, familia ya hali zenye nodi 50 na mizigo sita ya trafiki.
- Haijathibitishwa kwamba athari ya ukubwa huo huo ipo katika DSR, OLSRv2 au itifaki nyingine.
- Matokeo si usambazaji halisi wa kimwili wa MANET uwanjani, bali ni simulering ya ns-3.
- Haijaonyeshwa kwamba matokeo yatabaki yale yale kwa msongamano tofauti wa nodi, miundo tofauti ya uhamaji na migawanyo tofauti ya nishati ya awali.
Dokezo la Chanzo na Mbinu
Kichwa asili: Mechanism Sophistication versus Control-Plane Alignment: Energy-Aware Routing in Mobile Ad-Hoc Networks
Waandishi: Redha Mili; Salim Chikhi.
Dokezo la utambulisho wa waandishi: PDF iliyochunguzwa ni toleo la tathmini la double-blind na halionyeshi majina ya waandishi. Utambulisho wa waandishi umethibitishwa kutoka rekodi ya bibliografia ya SSRN.
Ushirika: SSRN inaorodhesha University of Constantine 2 kwa Salim Chikhi; kwa Redha Mili, taarifa ya ushirika haijaainishwa kwenye SSRN.
Aina ya chanzo: Utafiti wa ablation unaodhibitiwa na simulering ya mtandao katika eneo la mitandao ya ad hoc ya simu na kujifunza kwa uimarishaji.
Jukwaa: SSRN.
SSRN Abstract ID: 6963867.
DOI: 10.2139/ssrn.6963867.
Tarehe ya kuchapishwa SSRN: 18 Juni 2026.
Hali ya mapitio ya wenzao: PDF iliyochunguzwa inaonyesha wazi kauli “Preprint not peer reviewed”.
Mbinu ya hakimiliki/leseni: PDF haitaji leseni wazi ya Creative Commons au leseni nyingine ya wazi ya matumizi tena. Kwa hiyo, maandishi ya Verianla yameandaliwa kwa mtazamo wa tahadhari kuhusu hakimiliki; sentensi za chanzo, michoro asili na miundo asili ya picha hazijachapishwa tena. Ukweli wa kisayansi, matokeo ya nambari na muundo wa mbinu umeelezwa kwa simulizi huru ya kielimu na majedwali yaliyopangwa upya.
Simulata: ns-3.46.1.
Upeo wa majaribio: Nodi 50 zinazotembea, mizigo sita ya trafiki, itifaki za AODV na OLSR, seed 20 zilizooanishwa, muda wa kazi wa sekunde 500.
Kipimo cha msingi: Half-Node-Death (HND), yaani muda wa kifo cha nodi ya 25.
Vipimo vya pili: Packet Delivery Ratio (PDR) na end-to-end delay katika kiwango cha programu.
Takwimu: Tofauti za seed zilizooanishwa; bootstrap ya sampuli upya 10.000 yenye muda wa kujiamini wa %95; exact paired Wilcoxon signed-rank test; Cliff's delta.
Censoring: Chanzo kinaripoti kwamba hakuna hata seli moja kati ya 1560 iliyocensored kwa HND.
Uzalishaji upya: Chanzo kinasema kwamba script za campaign, usanidi wa energy-model wa ns-3 na per-node death trace ghafi za run zote zilichapishwa pamoja na makala.
Kizuizi kikuu: Kwa maneno ya waandishi wenyewe, utafiti ni matokeo ya decomposition yaliyopimwa kwenye itifaki mbili; si nadharia ya jumla kwamba “alignment daima ni muhimu kuliko sophistication” inayoweza kutumika kwa mifumo yote ya mitandao.
Ujenzi upya wa picha: Unafaa. Mchoro asili wenye nguvu zaidi unaweza kuonyesha jinsi ishara ileile ya nishati inavyobadilika kuwa majukumu matatu tofauti ya kisababishi katika sehemu za AODV RREQ admission, data forwarding na OLSR TC integration.
Verianla Live / Live Figure: Inafaa. Katika mitiririko ya AODV na OLSR, unapobadilisha sehemu ya kitendo ya utaratibu wa nishati, inaweza kuonyeshwa kwa uhuishaji wa data zisizobadilika jinsi njia “inavyoundwa”, “inavyotumika tu” au “route table inavyoundwa upya”.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *