

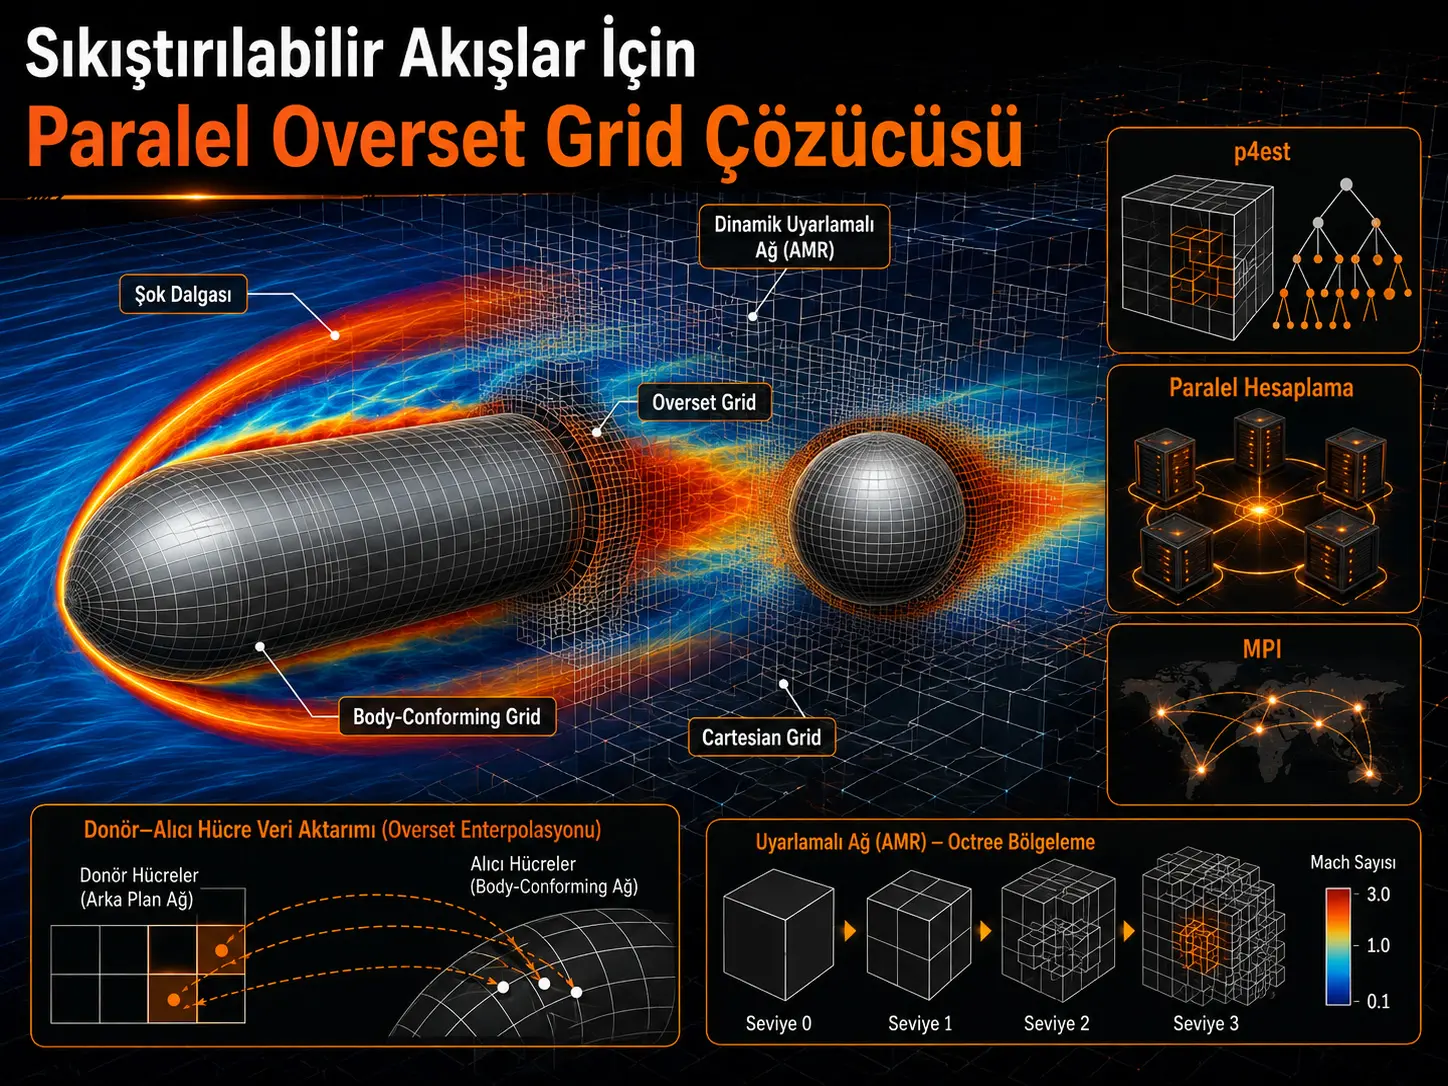
Bu tadqiqot uch o‘lchamli siqiluvchan oqim muammolarini yechish uchun parallel ishlaydigan, finite-volume asosidagi va dinamik Adaptive Mesh Refinement (AMR) qobiliyatiga ega Navier–Stokes yechuvchisini ishlab chiqadi. Usul ikki xil to‘r tuzilmasini birlashtiradi: geometriya sirtini kuzatuvchi body-conforming grid va oqim sohasining qolgan qismida dinamik ravishda mayinlashtirilishi yoki qo‘pollashtirilishi mumkin bo‘lgan Cartesian off-body grid. Adaptiv Cartesian to‘rni yaratish, partition amallari va yukni balanslash ochiq manbali p4est octree kutubxonasi bilan bajariladi.
Tadqiqotning asosiy dasturiy yangiligi oqim sohasi ma’lumotlarining p4estning o‘z node ma’lumot maydonidan ajratilishidir. Klassik tuzilmada zichlik, tezlik, harorat, turbulentlik o‘zgaruvchilari, gradientlar va MUSCL limiter ma’lumotlari p4est node’lari bilan birga ko‘chirilsa, taklif qilingan arxitekturada p4est ichida faqat manzil ko‘rsatkichi va MPI rank ma’lumoti saqlanadi. Haqiqiy oqim sohasi alohida ma’lumot tuzilmasida saqlanadi. Shu tariqa to‘r qayta bo‘linganda qayta hisoblanishi mumkin bo‘lgan yoki endi haqiqiyligini yo‘qotgan barcha ma’lumotlarni MPI orqali ko‘chirishga hojat qolmaydi; faqat asosiy oqim o‘zgaruvchilarini uzatish yetarli bo‘ladi.
Ishlab chiqilgan yechuvchi ikki uch o‘lchamli benchmark muammosida sinovdan o‘tkazilgan. Mach 2 tezlikdagi oqim yarim cheksiz to‘mtoq burunli silindr ustidan o‘tadigan barqaror holatda sonli sirt bosimi koeffitsiyenti eksperimental natijalar bilan umumiy jihatdan moslik ko‘rsatgan va adaptiv to‘r bow shock mintaqasida avtomatik ravishda zichlashgan. Ikkinchi testda Mach 2,89 li tekis shok to‘lqinining turg‘un havodagi shar bilan o‘zaro ta’siri modellashtirilgan; qaytgan shok, triple point, difraksiyalangan shok va wake vorteksi dinamik to‘r moslashuvi bilan kuzatilgan.
Parallel samaradorlik tajribasida barqaror overset yechim 32 MPI rankda %89,7, 64 rankda %80 va 128 rankda %65 parallel samaradorlik ko‘rsatgan. Dinamik shar–shok muammosida flow solver va AMR birgalikda baholanganda 128 MPI rankdagi parallel samaradorlik %61 deb xabar qilingan. Taklif qilingan taqsimlangan yondashuv avvalgi master–slave tatbiqiga nisbatan 32 MPI rankda umumiy yechuvchi parallel samaradorligini %50 oshirgan. Shunga qaramay 128 rankga chiqilganda, ayniqsa donor–receiver hujayralarining kam soni ranklar orasida notekis taqsimlangani sababli interpolation va overset grid assembly bosqichlarida samaradorlik pasayadi.
Türkiye nuqtai nazaridan: Tadqiqot to‘g‘ridan-to‘g‘ri İstanbul Teknik Üniversitesi’da ishlab chiqilgan CFD yechuvchisiga tayanadi. Shu sababli Türkiye nuqtai nazaridan bu faqat xorijiy usulni qo‘llash emas, balki uch o‘lchamli siqiluvchan oqim, dinamik AMR, overset grid va parallel MPI hisoblash komponentlarini bir muassasa ichidagi yechuvchida birlashtirishga oid aniq sonli usul ishlab chiqish namunasidir. Biroq maqola ikki benchmark va bitta HPC tuguni ustida tekshiruv beradi; real samolyot geometriyalari, ko‘p tugunli superkompyuter miqyoslanishi yoki sanoat tekshiruvi bu tadqiqotda sinovdan o‘tkazilmagan.
Overset grid va Adaptive Mesh Refinement nima uchun birga ishlatilmoqda?
Asosiy maqsad butun hisoblash sohasini doimiy ravishda juda mayda to‘r bilan yechish o‘rniga yuqori aniqlikni faqat fizik jihatdan zarur bo‘lgan mintaqalarda ishlatishdir. Shok to‘lqinlari, kuchli gradientlar va ajralish mintaqalari kabi sohalarda hujayra o‘lchami kichraytirilsa, uzoq sohalarda qo‘polroq to‘r ishlatilishi mumkin. Shu tariqa bir xil fizik hodisani kamroq umumiy hujayra soni bilan yechish mumkin bo‘ladi.
Overset yondashuvi bu adaptatsiyani geometriyadan ajratadi. Geometriya sirtini va chegaraviy qatlamni body-conforming grid yechar ekan, geometriyadan uzoqdagi oqim off-body Cartesian grid ustida hisoblanadi. Ikki to‘r bir-birining ustiga joylashtiriladi va kesishish mintaqalaridagi receiver hujayralar uchun boshqa to‘rdagi donor hujayralardan interpolatsiya qilinadi.
Bu tuzilma ayniqsa uch o‘lchamli harakatlanuvchi yoki kuchli shok tuzilmalari mavjud muammolarda afzallikka ega; chunki Cartesian off-body gridning refine/coarsen amallari murakkab sirt geometriyasini bevosita qayta yaratishga majbur emas.
Qaysi oqim tenglamalari yechilmoqda?
Ikkala benchmark ham uch o‘lchamli siqiluvchan Navier–Stokes tenglamalari bilan modellashtirilgan. Barqaror to‘mtoq burunli jism muammosi turbulent bo‘lgani uchun Reynolds-Averaged Navier–Stokes (RANS) formulatsiyasi, vaqtinchalik shar–shok muammosi esa laminar formulatsiyadan foydalanadi.
Massaning saqlanishi:
\[ \frac{\partial \rho}{\partial t} + \frac{\partial \rho u_j}{\partial x_j} =0 \]
Impulsning saqlanishi:
\[ \frac{\partial \rho u_i}{\partial t} + \frac{\partial \rho u_i u_j}{\partial x_j} = -\frac{\partial p}{\partial x_i} + \frac{\partial \tau_{ij}}{\partial x_j} \]
Umumiy energiyaning saqlanishi:
\[ \frac{\partial \rho e_t}{\partial t} + \frac{\partial \rho e_t u_j}{\partial x_j} = -\frac{\partial p u_j}{\partial x_j} + \frac{\partial}{\partial x_j} \left( k\frac{\partial T}{\partial x_j} \right) + \frac{\partial u_i\tau_{ij}}{\partial x_j} \]
Barqaror benchmarkda Reynolds kuchlanishlarini modellashtirish uchun k–ω SST 2003 turbulentlik modeli ishlatilgan. Gaz kalorik jihatdan mukammal deb qabul qilingan. Barqaror holatda yopishqoqlikning haroratga bog‘liq o‘zgarishi Sutherland qonuni bilan modellashtirilgan bo‘lsa, vaqtinchalik benchmarkda dinamik yopishqoqlik haroratdan mustaqil doimiy sifatida olingan.
Sonli oqimlar qanday hisoblanadi?
Tenglamalar finite-volume usuli bilan diskretlashtirilgan. Bitta hujayraning yarim-diskret tenglamasi manbada quyidagi umumiy ko‘rinishda berilgan:
\[ \frac{\partial W_i}{\partial t} = \frac{1}{V_i} \sum_{j=1}^{J} \left(F_{v,ij}-F_{c,ij}\right)S_{ij} + Q_i \]
Konvektiv oqimlarda AUSM+up sxemasi ishlatilgan, ikkinchi tartibli fazoviy aniqlik uchun MUSCL rekonstruksiyasi qo‘llangan. Shok kabi uzilishlar yaqinida tebranishlarni bostirish maqsadida Venkatakrishnan slope limiter ishlatilgan. Diffusive flux’lar ikkinchi tartibli markaziy farq yondashuvi bilan hisoblangan, vaqt integratsiyasi esa birinchi tartibli explicit Euler usuli bilan bajarilgan.
Barqaror yechimda har bir hujayra uchun vaqt qadami sobit Courant soniga ko‘ra lokal aniqlansa, transient muammolarda barcha hujayralar uchun ishlatiladigan vaqt qadami Courant shartidan olingan minimal qiymat sifatida tanlangan.
Off-body va body-conforming to‘rlar qanday birlashadi?
Off-body Cartesian grid turli refinement darajalarida sobit sonli hujayralarga ega bloklardan tashkil topadi. Qo‘shni ikki grid blokining refinement darajalari orasidagi maksimal farq 1 qilib saqlanadi; boshqacha aytganda 2:1 balance sharti saqlanadi.
Turli refinement darajalaridagi Cartesian hujayralarning umumiy sirtida klassik overset interpolation o‘rniga hanging-cell yondashuvi qo‘llanadi. Bitta qo‘pol hujayraning sirt oqimi qo‘shni mayda hujayralar oqimlarining yig‘indisi bilan hisoblanadi:
\[ F_i=\sum_{j=1}^{4}F_j \]
Body-conforming va Cartesian to‘rlar bir-birini yopadigan mintaqada esa donor–receiver munosabati ishlatiladi. Receiver hujayradagi bir oqim xossasi inverse-distance interpolatsiyasi bilan:
\[ \phi_i= \frac{\sum_{j=1}^{J}w_j\phi_j} {\sum_{j=1}^{J}w_j} \]
va og‘irlik:
\[ w_j= \frac{1} {|x_{c,j}-x_{c,i}|} \]
sifatida hisoblanadi.
p4est bu tizimda nima qiladi?
p4est octree kolleksiyalarini, ya’ni “forest of octrees” tuzilmasini parallel boshqaradigan ochiq manbali kutubxonadir. Tadqiqotda har bir octree node fizik jihatdan bitta Cartesian grid blokiga mos keladi. Node’lar Morton yoki Z-order space-filling curve bo‘ylab tartiblanadi.
Bu tuzilma p4estga:
- grid refinement va coarsening,
- 2:1 balance,
- partitioning,
- ghost-layer yaratish,
- MPI ranklar orasida grid bloklarini taqsimlash
amallarini bajarish imkonini beradi.
Tadqiqotdagi p4est ishlatilishi to‘liq CPU va MPI asosidadir. GPU yoki boshqa accelerator’ga device offloading qo‘llanmagan.
Avvalgi xotira arxitekturasining muammosi nima edi?
p4estning klassik foydalanuvchi ma’lumot modeli har bir node uchun foydalanuvchi belgilagan o‘lchamdagi ma’lumot blokini p4est tomonidan allocate qilib boshqaradi. CFD yechuvchisida bu blok faqat zichlik yoki tezlik kabi bir nechta sonni o‘z ichiga olmaydi; butun grid blokining oqim ma’lumotlarini tashishi kerak.
Manba uch ma’lumot guruhini ajratadi:
- Gp: asosiy oqim xossalari \([\rho,u,v,w,T,k,\omega]\),
- Gs: yopishqoqlik, bosim va oqim gradientlari kabi ikkilamchi xossalar,
- Gl: MUSCL limiter hadlari.
Klassik tuzilmada bu ma’lumot guruhlarining barchasi p4est node’i bilan birga saqlanishi va partition vaqtida ko‘chirilishi kerak. Holbuki Gsning muhim qismi Gpdan qayta hisoblanishi mumkin; bundan tashqari gradientlar va limiter qiymatlari grid migration bosqichida oldingi iteratsiyaga tegishli bo‘lgani uchun yangi iteratsiyada baribir qayta ishlab chiqiladi.
Taklif qilingan ajratilgan ma’lumot tuzilmasi qanday ishlaydi?
Tadqiqotchilar oqim ma’lumotlarini p4estning allocation maydonidan chiqarib, alohida q ma’lumot tuzilmasida saqlaydilar. p4est node’ining foydalanuvchi maydonida esa faqat:
- oqim ma’lumotining xotiradagi manzilini ko‘rsatuvchi pointer,
- node tegishli bo‘lgan MPI rank
saqlanadi.
Bu kichik o‘zgarish ikki muhim muammoni hal qiladi.
Coarsen–balance vaqtida ma’lumot yo‘qolishining oldini olish
Klassik p4est oqimida bir guruh node coarsen qilinganda child hujayralarning oqim xossalari parent hujayrada hajm bo‘yicha og‘irliklangan o‘rtacha bilan birlashtiriladi:
\[ \phi_i= \sum_{j=1}^{J} \left( \frac{\phi_j V_j}{V_i} \right) \]
Biroq paydo bo‘lgan parent node 2:1 balance shartini buzsa, keyingi p4est_balance chaqiruvi bu node’ni yana refine qilishi mumkin. Bu holatda avval childlardan parentga o‘rtachalashtirilgan ma’lumot keyin yana childlarga tarqatilgan bo‘ladi va asl yuqori aniqlikdagi axborot yo‘qoladi.
Taklif qilingan tuzilmada oqim sohasi p4estning node allocation’idan alohida bo‘lgani uchun coarsen amalida childlarning haqiqiy ma’lumotlari darhol yo‘q qilinmaydi. Agar balance amali coarsenni bekor qilsa, eski ma’lumotlar qayta yaratilgan child node’larga ulanadi. Faqat coarsen natijasi haqiqatan doimiy bo‘lsa, maskalangan child ma’lumotlari bo‘shatiladi.
Load balancing vaqtida keraksiz MPI trafigini kamaytirish
p4est_partition to‘r bloklarini MPI ranklar orasida qayta taqsimlaganda klassik yondashuv node’ning barcha foydalanuvchi ma’lumotini ko‘chiradi. Tadqiqotchilar esa faqat Gp guruhining yangi MPI rankga yuborilishini ta’minlaydilar. Gs va Gl yangi yechim siklida qayta yaratiladi.
Shu tariqa partition bosqichi ikki aloqa qadamiga ajralsa ham, jami ko‘chiriladigan ma’lumot miqdori kamayadi. Tadqiqotning da’vosi shuki, bu yondashuv aloqa vaqtini va umumiy solver runtime’ini kamaytiradi.
Dinamik to‘r o‘zgarganda overset bog‘lanishlari nega qayta quriladi?
Cartesian grid refine yoki coarsen qilinganda mavjud donor–receiver hujayra juftlari haqiqiyligini yo‘qotishi mumkin. Load balancingdan so‘ng grid bloklarining MPI rank egaligi ham o‘zgaradi. Shu sababli har bir AMR chaqiruvidan keyin overset grid assembly qayta bajarilishi shart.
Avvalgi master–slave yondashuvida receiver geometriyalari markaziy bir MPI rankga yuborilar, master rank butun body-conforming grid ma’lumotini saqlar va donor qidiruvini bitta nuqtada bajarardi. Bu xotira sarfini oshiradi hamda MPI rank soni oshgani sari markaziy tor joy hosil qiladi.
Yangi usulda grid assembly to‘liq taqsimlangan holga keltiriladi.
Bounding box yondashuvi aloqani qanday cheklaydi?
Har bir Cartesian va body-conforming grid partition minimal va maksimal koordinatalarini o‘z ichiga olgan bounding box bilan ifodalanadi. Receiver hujayralarning bounding box’lari MPI ranklarga e’lon qilinadi va faqat kesishuvchi partitionlar o‘rtasida batafsil geometriya ma’lumoti almashiladi.
Ikki partitionning muayyan koordinata yo‘nalishida kesishishi:
\[ x_{A,max}\geq x_{B,min} \quad\land\quad x_{A,min}\leq x_{B,max} \]
sharti bilan tekshiriladi.
Shunday qilib bir rank barcha grid hujayralarini barcha boshqa ranklarga yuborishi kerak bo‘lmaydi.
Body-conforming grid donor qidiruvi qanday tezlashtiriladi?
Body-conforming grid uchun Alternating Digital Tree (ADT) yaratiladi. Har bir hujayra tree node sifatida ifodalanadi va bounding box koordinatalariga ko‘ra binary tree tuzilmasiga joylashtiriladi.
Receiver hujayra uchun donor qidirilganda daraxtning ildizidan boshlanadi. Bounding boxlar kesishmasa, koordinata taqqoslashi yordamida daraxtning bir tarmog‘i to‘liq chiqarib tashlanadi. Kesishish mavjud bo‘lsa, hujayra nomzod donor ro‘yxatiga qo‘shiladi va qidiruv pastki tarmoqlarda davom etadi. Natijada centroid’i receiver hujayraga eng yaqin nomzod donor sifatida tanlanadi va interpolation stencil uchun atrofidagi qo‘shnilar ham ishlatiladi.
Body-conforming grid oldindan partition qilingani va yechim vaqtida geometriyasi o‘zgarmagani uchun ADT yechim boshida faqat bir marta yaratiladi va xotirada saqlanishi mumkin.
Cartesian donor qidiruvida Morton kodi qanday ishlatiladi?
Cartesian grid allaqachon p4est octree forest tomonidan boshqarilgani uchun alohida spatial tree yaratishga hojat yo‘q. Receiver hujayraning koordinatalari eng yuqori refinement darajasiga ko‘ra bitlar ketma-ketligiga aylantiriladi va uch o‘lchamda bu bitlar bitta Morton kodida birlashtiriladi.
Morton kodining tegishli bit guruhlari ketma-ket o‘qilib, octree ichida qaysi child node’ga borilishi aniqlanadi va leaf node’ga yetilganda receiver nuqtasini qamrab oluvchi Cartesian grid bloki topilgan bo‘ladi.
Bu tizim donor qidiruvi uchun p4estning allaqachon mavjud bo‘lgan fazoviy ma’lumot tuzilmasidan ikkinchi marta foydalanadi.
Birinchi benchmark qanday qurildi?
Birinchi tekshiruv muammosi Mach 2 erkin oqimning yarim cheksiz to‘mtoq burunli silindr ustidan o‘tadigan barqaror va turbulent siqiluvchan oqimidir.
| Erkin oqim parametri | Manbada ishlatilgan qiymat |
|---|---|
| Mach soni | 2 |
| Reynolds soni | 353.100 |
| Harorat | 242,3 K |
| Turbulentlik intensivligi | %0,05 |
Muammo o‘qsimmetrik bo‘lsa-da, yechuvchining uch o‘lchamli samaradorligini ko‘rsatish uchun hisoblash sohasining to‘rtdan biri uch o‘lchamli qilib modellashtirilgan.
Cartesian grid 3 × 3 × 3 octree forest bilan boshlangan va har bir node 2 × 2 × 2 hujayrali grid blokini ifodalagan. Maksimal refinement darajasi 5. Refinement mezoni Mach gradientidir va chegara qiymatlari:
\[ Q_{lower}=0.185, \qquad Q_{upper}=0.218 \]
sifatida ishlatilgan. Body-conforming gridning birinchi devor hujayrasi taxminan \(y^+=5\) bo‘ladigan tarzda qurilgan va yaqinlashish mezoni cumulative residual relative error uchun %0,01 deb belgilangan.
To‘r yaqinlashuvi tadqiqotida nechta hujayra ishlatildi?
Uch to‘r darajasi taqqoslangan:
| To‘r aniqligi | Maksimal refinement darajasi | Barqaror holatdagi hujayra soni |
|---|---|---|
| Qo‘pol | 4 | 334.627 |
| O‘rta — asosiy yechim | 5 | 1.419.996 |
| Mayin | 6 | 3.697.852 |
Bosim koeffitsiyenti egri chiziqlarining taqqoslanishi o‘rta to‘r muammo uchun yetarli ekanini ko‘rsatgan. Shu sababli tadqiqotchilar samaradorlik tahlillarida taxminan 1,42 million hujayrali o‘rta to‘rdan foydalangan.
To‘mtoq burunli jism natijasi tajriba bilan mos keladimi?
Umuman olganda, ha. Sonli \(C_p\) taqsimoti referens eksperimental natijalar bilan yaxshi moslik ko‘rsatgan. Shunga qaramay stagnation point mintaqasida \(s/D=0\) va jismning uch-tub qismiga yaqin \(s/D>0.8\) mintaqasida yechim eksperimental qiymatlarni biroz past baholaydi.
Tadqiqot taqqoslashiga ko‘ra ishlab chiqilgan yechuvchining natijasi o‘sha grafikda berilgan avvalgi scFLOW sonli natijasidan eksperimental ma’lumotlarga yaqinroq ko‘rinadi. Bu taqqoslash faqat ushbu benchmark va ishlatilgan shartlar uchun amal qiladi; umumiy CFD dasturi ustunligini anglatmaydi.
Numerical schlieren va Mach contour tasvirlarida adaptiv Cartesian gridning bow shock chizig‘i bo‘ylab eng yuqori refinement darajasiga o‘tgani ko‘rinadi. Shu tariqa uzoq mintaqalarda keraksiz mayda to‘r ishlatilmasdan shok uzilishi yuqori aniqlikda saqlanadi.
Barqaror benchmark parallel tarzda qanday miqyoslandi?
Strong-scaling tajribasida 1.419.996 hujayrali grid sobit saqlangan va MPI rank soni bosqichma-bosqich oshirilgan. Bu to‘rdagi receiver hujayra soni 34.970. Har bir rank soni uchun 100 yechim iteratsiyasining wall-clock vaqti o‘lchangan.
Speed-up:
\[ S_f=\frac{T_1}{T_N} \]
va parallel samaradorlik:
\[ \eta=\frac{S_f}{N}\times100 \]
sifatida ta’riflangan.
Verianla Live: Overset yechuvchining MPI rank soniga ko‘ra parallel samaradorligi
Quyidagi qiymatlar barqaror Mach 2 to‘mtoq burunli jism benchmarkida taxminan 1,42 million hujayra sobit saqlanganida o‘lchangan overset-grid yechuvchi parallel samaradorligidir. Bular weak-scaling emas, strong-scaling natijalaridir.
| MPI rank soni | Parallel samaradorlik (%) | Test turi | Manba |
|---|---|---|---|
| 32 | 89,7 | Strong scaling — overset solver | Shakl 12 va natija matni |
| 64 | 80 | Strong scaling — overset solver | Shakl 12 va natija matni |
| 128 | 65 | Strong scaling — overset solver | Shakl 12 va natija matni |
Verianla Live manba izohi: Vizualizatsiya ushbu ko‘rinadigan ilmiy ma’lumot jadvalidan yaratiladi. Jadval ilmiy source-of-truth sifatida saqlanadi.
Solver 32 MPI rankgacha kuchli miqyoslanish ko‘rsatgan. 32 rankdagi parallel samaradorlik %89,7 bo‘lsa, 64 rankda %80 ga va 128 rankda %65 ga tushadi. 128 rankda overset yechim bilan bir xil hujayra soniga ega single-grid referensi orasidagi parallel samaradorlik farqi ko‘pi bilan taxminan %7 deb xabar qilingan.
Interpolation nima uchun umumiy solverdan yomonroq miqyoslanadi?
Interpolation uchun bajariladigan hisob donor–receiver hujayralari bilan cheklangan. MPI rank soni oshgani sari har bir rankga to‘g‘ri keladigan receiver soni juda kamayadi va overlap hujayralari ranklar orasida teng taqsimlanmaydi.
Interpolation computation segmentining parallel samaradorligi taxminan:
- 32 MPI rankgacha %70,
- 64 MPI rankda %44,
- 128 MPI rankda %30
darajalariga tushadi.
Bunga qaramay interpolation jami iteratsiya xarajatining faqat taxminan %0,2 sini 1 rankda va %5,11 ini 128 rankda tashkil qilgani uchun bu past subroutine samaradorligi umumiy solver samaradorligiga cheklangan darajada ta’sir qiladi.
Yangi yondashuv avvalgi master–slave yechuvchidan qanchalik yaxshiroq?
Manba, xuddi shu tadqiqot guruhining avvalgi master–slave yondashuvi bilan taqqoslanganda, yangi taqsimlangan usul 32 MPI rankda umumiy solver parallel samaradorligini %50 oshirganini bildiradi.
Bu natija muayyan apparat, grid va benchmark uchun qilingan taqqoslashdir. Yangi algoritm har bir muammo yoki har bir HPC arxitekturasida aynan %50 foyda berishi tadqiqot tomonidan ko‘rsatilmagan.
Ikkinchi benchmark nima uchun qiyinroq?
Ikkinchi muammo barqaror emas. Mach 2,89 tezlikda ilgarilayotgan tekis shok to‘lqini boshlanishda turg‘un havodagi sharga uriladi; vaqt davomida qaytgan shok, incident shock, triple point, difracted shock va vortex tuzilmalari yuzaga keladi.
Bu oqim tuzilmalari harakat qilgani uchun mayda grid mintaqasi ham vaqt davomida harakat qilishi kerak. Shuning uchun faqat bir marta refine qilingan sobit to‘r yetarli emas; AMR yechim jarayonida qayta-qayta chaqiriladi.
Oqim Reynolds soni 7800 deb berilgan va laminar modellashtirilgan. Ishlatilgan havo uchun manba:
- \(R=287.2\) J/(kg·K),
- \(c_p=1005.2\) J/(kg·K),
- \(\gamma=1.4\)
qiymatlarini beradi.
Shar benchmarkidagi Region 1 va Region 2 ma’lumotlarini nega ehtiyotkor o‘qish kerak?
Manba matni Region 1 turg‘un, Region 2 esa post-shock va chekli x-yo‘nalishli tezlikka ega mintaqa ekanini aytadi. Bunga qarshi nashr qilingan Tablo 2 quyidagi qiymatlarni beradi:
| Manbada berilgan kattalik | Region 1 | Region 2 |
|---|---|---|
| Zichlik — jadvalda kg/m³ deb belgilangan | 5,1432014 | 1,4 |
| Harorat — jadvalda K deb belgilangan | 0,006123676 | 0,002487067 |
| Tezlik — jadvalda m/s deb belgilangan | 2,0451168 | 0 |
Tezlik qiymatlari matndagi Region ta’rifi bilan teskari yo‘nalishda: jadval Region 1ni harakatli, Region 2ni turg‘un ko‘rsatadi. Shuningdek harorat qiymatlarining K yorlig‘i bilan 10−3 tartibida berilishi real o‘lchamli haroratga mos kelmaydigan miqyoslash/yorliq muammosi ko‘rinishini beradi. Manba buni izohlamagani uchun Verianla bu sonlarning birligini yoki Region tartibini faraz bilan tuzatmaydi.
Dinamik AMR qanday sozlandi?
Cartesian grid 10 × 5 × 5 base octree node bilan boshlangan va har bir node 2 × 2 × 2 hujayrali grid blokini o‘z ichiga olgan. Maksimal refinement darajasi 5. AMR har 25 flow-solver iteratsiyasida bir chaqirilgan.
Refinement mezoni density gradient:
\[ Q_{lower}=0.6, \qquad Q_{upper}=0.625 \]
Body-conforming grid birinchi hujayrasi taxminan \(y^+\approx2.5\) bo‘lishi ta’minlangan va to‘r shar sirtidan 2,5D tashqariga uzaytirilgan.
Yechim CFL = 0,7 bilan yuritilgan; global o‘lchamsiz vaqt qadami iteratsiyaga qarab taxminan \(9.2\times10^{-5}\) bilan \(1.5\times10^{-4}\) orasida o‘zgargan.
Shar benchmarkidagi hujayra sonida manba nima uchun ziddiyatli?
Tadqiqotning bir bo‘limida “initial overset grid system” uchun 3.241.936 hujayra va 54.294 receiver hujayra berilgan. Biroq oqimning vaqt davomida rivojlanishi bayon qilingan keyingi bo‘limda, \( \bar{t}=1.832 \) vaqtida grid 2.232.704 boshlang‘ich hujayradan 3.241.936 hujayraga chiqqani yozilgan.
Bu ikki ifoda bir xil “boshlang‘ich” hujayra sonini qo‘llab-quvvatlamagani uchun bu yerda manba ichidagi nomuvofiqlik sifatida saqlanadi. Bunga qarshi \( \bar{t}=1.832 \) uchun 3.241.936 hujayra qiymati ikkala kontekstda ham ko‘rinadi va kuchli miqyoslanish testida yuqori yuklangan dinamik holat sifatida tanlangan to‘r aynan shudir.
Shok to‘lqini shar atrofida qanday rivojlandi?
Numerical schlieren va Mach tasvirlari oqimning bir necha o‘lchamsiz vaqt nuqtalaridagi rivojlanishini ko‘rsatadi:
- \(\bar{t}=0\): tekis incident shock shar markazidan taxminan 0,6D uzoqda.
- \(\bar{t}\approx0.307\): shok shar sirtiga yetganda reflected shock hosil bo‘ladi.
- \(\bar{t}=0.615\): incident va reflected shock kesishmasida triple point yaqqollashadi.
- \(\bar{t}=1.832\): diffracted shock va triple point shar wake mintaqasiga siljiydi va bir vortex ko‘rinadi.
Adaptiv to‘r chiziqlari yuqori refinement darajasi harakatlanayotgan shok tuzilmalarini kuzatayotganini ko‘rsatadi. Tadqiqotchilar \( \bar{t}=1.832 \) vaqtida reflected shock triple pointga bog‘langan mintaqada density gradientning zaiflashishi sababli kuzatish sifatida kichik yo‘qotish borligini ham bildiradi.
Eksperimental schlieren taqqoslash nimani ko‘rsatdi?
Numerical schlieren tasviri klassik Bryson va Gross eksperimental tasviri bilan taqqoslangan. Reflected shock, triple point va transmitted shock joylashuvlari umumiy jihatdan tajriba bilan yaxshi mos kelgani xabar qilingan.
Reflected shock standoff distance jihatidan kichik farq mavjud. Mualliflar bu farq eksperimental tasvirda ko‘rinadigan deformatsiyalar sababli tasvirlash artefaktlaridan kelib chiqishi mumkinligini taklif qiladi. Bu izoh muallif talqinidir; tadqiqot bu farq sababini alohida eksperimental tarzda sinamagan.
Bitta dinamik AMR chaqiruvida qaysi amallar bajariladi?
Tadqiqotda AMR jarayoni besh ketma-ket segmentga ajratiladi:
- Cell flagging: hujayralar sensor function bilan baholanib refine/coarsen uchun belgilanadi.
- Grid adaptation: belgilangan bloklar refine yoki coarsen qilinadi.
- Load balancing: grid bloklari MPI ranklar orasida qayta taqsimlanadi va ghost layerlar yaratiladi.
- Connectivities: qo‘shni hujayra bog‘lanishlari qayta quriladi va cache qilinadi.
- Grid assembly: overset donor–receiver juftlari, interpolation koeffitsiyentlari va communication jadvallari qayta yaratiladi.
Dinamik muammoda bu besh bosqichning barchasi har 25 solver iteratsiyasida takrorlanadi.
AMRning hisoblash xarajati qancha?
AMR amali barcha MPI rank sonlarida bitta flow-solver iteratsiyasidan qisqaroq davom etadi; biroq shu tartibdadir. AMR faqat har 25 iteratsiyada bir ishlagani uchun umumiy ta’siri siyraklashtiriladi.
128 MPI rankda bitta AMR chaqiruvining vaqti ikki AMR orasida o‘tadigan 25 flow-solver iteratsiyasining jami vaqtining taxminan %8 i sifatida xabar qilingan.
AMRning eng qimmat qismi overset grid assemblydir. Tekshirilgan rank sonlarida grid assembly AMR vaqtining kamida %53 ini tashkil qiladi.
Dinamik muammo 128 MPI rankda qanday miqyoslandi?
AMR jarayonining yakka holdagi scaling samaradorligi solver kabi kuchli emas. Buning asosiy sababi donor/receiver so‘rovlari va overlap mintaqalarining MPI ranklar orasida teng taqsimlanmasligidir.
Shunga qaramay AMR faqat 25 iteratsiyada bir chaqirilgani sababli butun flow solver + AMR tizimi yuqori rank sonlarida yaxshiroq harakat qiladi. Tadqiqot dinamik benchmark uchun 128 MPI rankda taxminan %61 parallel samaradorlik haqida xabar beradi.
Natija bo‘limida AMR va overset-grid-assembly bosqichlari 64 MPI rankda taxminan %42 parallel samaradorlikka erishgani bildiriladi.
Load balancing haqiqatdan ham ishlaydimi?
Ha; ishlatilgan benchmarkda o‘lchanadigan foyda mavjud. Tadqiqotchilar 32 MPI rank uchun bir xil dinamik grid holatini load balancing yoqilgan va o‘chirilgan holda taqqoslagan.
Load-balanced holatda ranklarning normalize CPU workload taqsimoti ko‘proq bir jinsli bo‘lgan. Manba MPI ranklarda kamida %17,4 workload kamayishi haqida xabar beradi.
Ghost-layer va inter-grid communicationni ham o‘z ichiga olgan wall-clock vaqt bo‘yicha qaralganda load-balanced solver iteratsiyasi load balancing qo‘llanmagan iteratsiyadan %10,1 qisqaroq davom etgan.
Bu o‘lchov bitta adaptationdan keyingi holat uchundir. Mualliflar real yechimda AMR ko‘p marta chaqirilgani uchun foyda yechim davomida yig‘ilishi mumkinligini bildiradi.
Tadqiqot qo‘llab-quvvatlaydigan natijalar
- p4est bilan uch o‘lchamli block-based Cartesian AMR, body-conforming overset grid bilan bir xil siqiluvchan CFD yechuvchisida birlashtirilgan.
- Oqim ma’lumotlarini p4est node allocation’idan ajratadigan arxitektura keraksiz data migrationni kamaytiradi va coarsen–balance paytida oqim axborotining keraksiz yo‘qolishini oldini oladi.
- Distributed bounding-box, ADT va octree qidiruv tuzilmalari bilan markaziy master rank talab qilmaydigan overset reassembly amalga oshirilgan.
- Mach 2 to‘mtoq burunli jism benchmarkida hisoblangan sirt bosimi koeffitsiyenti umumiy jihatdan eksperimental ma’lumot bilan mos.
- Adaptive grid bow shock atrofida yuqori refinement darajasiga o‘tgan.
- Shar–shok benchmarkida reflected shock, triple point, diffracted/transmitted shock va vortex tuzilmalari sonli tarzda ushlangan.
- Barqaror benchmarkda overset solver 128 MPI rankda %65 parallel samaradorlik ko‘rsatgan.
- Dinamik solver + AMR tizimi 128 MPI rankda taxminan %61 parallel samaradorlik ko‘rsatgan.
- 32 MPI rankdagi load balancing tajribasi wall-clock iteration vaqtida %10,1 kamayish bergan.
- Yangi taqsimlangan yondashuv avvalgi master–slave versiyaga nisbatan 32 MPI rankda umumiy parallel samaradorlikni %50 oshirgan.
Tadqiqot qo‘llab-quvvatlamagan yoki sinamagan natijalar
- Yechuvchining barcha siqiluvchan CFD muammolarida bir xil aniqlik yoki scaling samaradorligini berishi ko‘rsatilmagan.
- Tadqiqotda GPU yoki accelerator offloading sinovdan o‘tkazilmagan.
- 128 yadrodan tashqarida yoki bir nechta HPC node ustida scaling testi qilinmagan.
- Real samolyot, raketa, kosmik raketa yoki turbomashina geometriyasida sanoat validatsiyasi bajarilmagan.
- To‘mtoq burunli jism benchmarkida stagnation va tip-base mintaqalaridagi eksperimental farq to‘liq bartaraf etilmagan.
- Shar benchmarkida barcha shok tuzilmalari mukammal kuzatilmagan; \( \bar{t}=1.832 \) atrofida zaiflashgan density gradient sababli kichik tracking yo‘qotilishi ko‘rilgan.
- Overset grid assembly yuqori MPI ranklarda ideal tarzda load-balanced ekani ko‘rsatilmagan.
- Manbadagi Region 1/Region 2 boshlang‘ich holatlari va boshlang‘ich hujayra sonidagi ichki nomuvofiqliklar hal qilinmagan.
- Bitta tugunda olingan %65 yoki %61 parallel samaradorlik ko‘p tugunli superkompyuter muhitiga bevosita umumlashtirilmaydi.
Tadqiqot Usuli va Natijalari
Sonli yechuvchi arxitekturasi
Ishlab chiqilgan dastur uch o‘lchamli density-based finite-volume siqiluvchan Navier–Stokes yechuvchisidir. Barqaror turbulent muammoda k–ω SST 2003 modeli ishlatilgan. Konvektiv oqimlarda AUSM+up, ikkinchi tartibli rekonstruksiyada MUSCL va uzilish yaqinida Venkatakrishnan limiter qo‘llangan. Diffusive hadlar ikkinchi tartibli markaziy usul bilan, vaqt integratsiyasi explicit Euler bilan hisoblangan.
Grid arxitekturasi ikki komponentdan iborat:
- geometriyani va devorga yaqin oqimni yechadigan oldindan partition qilingan structured body-conforming grid,
- p4est octree forest tomonidan boshqariladigan block-based adaptive Cartesian off-body grid.
Refinement va coarsening mezoni
Har bir Cartesian grid blokida tanlangan oqim parametri \(Q\), pastki va yuqori chegara qiymatlar bilan taqqoslanadi:
- \(Q>Q_{upper}\) bo‘lsa refine,
- \(Q<Q_{lower}\) bo‘lsa coarsen
amali qo‘llanadi.
p4est tomonida grid adaptation tartibi:
p4est_refinep4est_balancep4est_coarsenp4est_balance
ko‘rinishidadir. Ikkinchi balance chaqiruvi coarsendan keyin 2:1 balance shartini qayta ta’minlash uchun zarur.
Taklif qilingan ma’lumot arxitekturasining computational mantiqi
Taklif qilingan ma’lumot tuzilmasida p4est faqat grid topology va partition ownership ma’lumotlari bilan shug‘ullanadi, fizik yechim vektorlari esa solver tomonidan alohida xotirada saqlanadi.
Load balancing vaqtida faqat:
\[ G_p=[\rho,u,v,w,T,k,\omega] \]
asosiy ma’lumot guruhini uzatish yetarli deb qabul qilingan. Bosim, yopishqoqlik va differensiallanuvchi secondary qiymatlar qayta hisoblanadi; gradient va MUSCL limiter qiymatlari yangi solver cycle davomida qayta yaratiladi.
Bu yondashuv ayniqsa MPI rank soni oshganda aloqa hajmini kamaytirishni maqsad qiladi.
Overset reassembly algoritmi
Dinamik grid o‘zgarishidan keyin receiver–donor munosabatini qayta qurish uch bosqichda ko‘rilishi mumkin:
- Partition bounding boxlari yordamida qaysi MPI ranklar geometrik jihatdan o‘zaro ta’sirlashishi mumkinligi aniqlanadi.
- Body-conforming grid donor nomzodlari ADT, Cartesian donor nomzodlari esa p4est octree/Morton tuzilmasi bilan qidiriladi.
- Donor–receiver juftlari aniqlangandan so‘ng interpolation koeffitsiyentlari va inter-grid MPI communication jadvallari yaratiladi.
Bu usul master rank ustida butun body-conforming grid nusxasini saqlash zaruratini yo‘q qiladi.
Barqaror benchmarkning asosiy sonli natijalari
| O‘lchangan yoki ishlatilgan kattalik | Natija |
|---|---|
| Mach soni | 2 |
| Reynolds soni | 353.100 |
| Asosiy grid hujayra soni | 1.419.996 |
| Receiver hujayra soni | 34.970 |
| 32 MPI rank parallel samaradorligi | %89,7 |
| 64 MPI rank parallel samaradorligi | %80 |
| 128 MPI rank parallel samaradorligi | %65 |
| 128 rankda single-gridga nisbatan samaradorlik farqi | Ko‘pi bilan taxminan %7 |
Bu benchmark yechuvchining ham sonli aniqligini, ham muammo hajmi sobit bo‘lganda MPI rank soni oshishi bilan strong-scaling xatti-harakatini sinaydi.
Dinamik benchmarkning asosiy sonli natijalari
| O‘lchangan yoki ishlatilgan kattalik | Manbada berilgan natija |
|---|---|
| Incident shock Mach soni | 2,89 |
| Reynolds soni | 7800 |
| AMR chaqiruv oralig‘i | Har 25 solver iteratsiyasida bir |
| Maksimal refinement darajasi | 5 |
| Density-gradient refine chegaralari | 0,6 / 0,625 |
| \(\bar{t}=1.832\) to‘r hujayra soni | 3.241.936 |
| 128 MPI rank solver + AMR parallel samaradorligi | %61 |
| 128 rankda AMRning 25 iteratsiyali oraliqdagi vaqt ulushi | Taxminan %8 |
| Grid assemblyning AMR vaqtidagi minimal ulushi | %53 |
| 32 rank load balancing wall-clock foydasi | %10,1 |
Parallel samaradorlik nega ideal emas?
Tadqiqot yuqori MPI rank sonida parallel samaradorlikni cheklovchi asosiy omil faqat umumiy MPI aloqa xarajati emasligini ko‘rsatadi. Overset overlap mintaqasidagi donor–receiver hujayra sonlari p4estning space-filling-curve partition jarayonida maxsus og‘irlik bilan taqsimlanmaydi.
Natijada ayrim ranklarda ko‘p sonli interpolation so‘rovlari bo‘lsa, ayrim ranklarda juda oz bo‘lishi mumkin. MPI rank soni oshgani sari receiver hujayraga to‘g‘ri keladigan hisoblash miqdori kichrayadi va communication latency hamda workload imbalance yanada yaqqol ko‘rinadi.
Bu ta’sir ayniqsa grid assembly va interpolation subroutine’larida kuzatiladi. Flow solverning barcha hujayralarda bajaradigan Navier–Stokes hisobi esa tartibliroq taqsimlangani uchun umumiy solver scalingi kuchliroq qoladi.
Tadqiqotning muhandislik nuqtai nazaridan asosiy hissasi
Tadqiqotning asosiy hissasi yangi Navier–Stokes tenglamasi yoki yangi shock-capturing flux ishlab chiqish emas. Yangilik mavjud va tekshirilgan CFD qurilish bloklarini parallel dinamik overset AMR ichida samaraliroq ma’lumot va aloqa arxitekturasi bilan qanday birlashtirish mumkinligiga qaratilgan.
Xususan:
- p4est grid management bilan oqim ma’lumotini ajratish,
- faqat zarur solution variables migrationi,
- coarsen–balance vaqtida oqim axborotini saqlash,
- master rank o‘rniga distributed overset assembly,
- ADT va octreeni grid turiga ko‘ra birgalikda ishlatish
tadqiqotning algoritmik hissalari markazidadir.
Asosiy cheklovlar
- Scaling testlari bitta dual-socket HPC node ustida bajarilgan.
- Eng yuqori test miqyosi 128 MPI rank.
- GPU ishlatilmagan.
- Faqat ikki benchmark ko‘rib chiqilgan.
- Overset assembly workload MPI ranklar orasida bevosita og‘irliklangan holda balanslanmaydi.
- Yuqori rank sonida communication va kamaygan receiver-cell zichligi assembly samaradorligini cheklaydi.
- Shar benchmarkidagi Region ta’riflari va boshlang‘ich hujayra soni manba ichida nomuvofiq.
- Real sanoat samolyoti yoki kosmik apparat geometriyasi bilan tekshiruv bajarilmagan.
Manba va Usul Haqida Izoh
To‘liq original ish nomi: A Parallel Solver on a Dynamically Adaptive Overset Grid for Compressible Flow Problems
Mualliflar: Mohamad El Hajj Ali Barada; Bayram Celik.
Mualliflar tartibi: Manbadagi original tartib aynan saqlangan.
Teng hissa/teng birinchi muallif: Manbada ko‘rsatilmagan.
Mas’ul muallif: Mohamad El Hajj Ali Barada.
Muassasalar: Aeronautical and Astronautical Engineering Program, Istanbul Technical University, Istanbul 34469, Turkey; Department of Astronautical Engineering, manbada “Istanbul Tehnical University” shaklida yozilgan, Istanbul 34469, Turkey.
Afiliatsiya yozuvi izohi: Birinchi afiliatsiyada “Istanbul Technical University”, ikkinchi afiliatsiyada esa “Istanbul Tehnical University” yozilgan. Verianla buning ikkinchi afiliatsiyadagi imlo xatosi ekaniga kuchli ishora borligini qayd etadi; biroq original manba matnini jimgina o‘zgartirmaydi.
Manba turi: Taqrizdan o‘tgan tadqiqot maqolasi; uch o‘lchamli siqiluvchan CFD yechuvchisi, parallel hisoblash, dinamik adaptive mesh refinement va benchmark tekshiruvini o‘z ichiga olgan sonli usul tadqiqoti.
Jurnal: Aerospace
Nashriyot: MDPI
Jild / maqola raqami: 13, 656
Nashr sanasi: 20 Temmuz 2026
DOI: 10.3390/aerospace13070656
Rasmiy nashr havolasi: https://www.mdpi.com/2226-4310/13/7/656
DOI havolasi: https://doi.org/10.3390/aerospace13070656
Taqriz holati: Ish taqrizdan o‘tgan Aerospace jurnalida nashr qilingan tadqiqot maqolasidir.
Litsenziya: Creative Commons Attribution 4.0 International (CC BY 4.0).
Moliyalashtirish: Tadqiqot tashqi moliyalashtirish olmagan.
Ma’lumotlar mavjudligi: Tadqiqotda taqdim etilgan ma’lumotlarni oqilona so‘rov asosida mas’ul muallifdan olish mumkinligi bildirilgan.
Manfaatlar to‘qnashuvi: Mualliflar manfaatlar to‘qnashuvi haqida bildirmagan.
Muallif hissalari: Bayram Celik; ko‘rib chiqish va tahrirlash, nazorat hamda hisoblash resurslarini olish uchun mas’ul. Mohamad El Hajj Ali Barada; dastlabki qo‘lyozma, computational software development, ma’lumot tahlili, metodologiya va konseptuallashtirishni bajargan.
Hisoblash platformasi: Benchmarklar dual-socket bitta HPC compute node ustida bajarilgan. Node ikki AMD EPYC 7742 protsessoriga, 2,25 GHz asosiy chastotaga va jami 128 CPU yadrosiga ega. p4est va yechuvchi MPI asosidagi CPU darajasida ishlatilgan; GPU yoki device offloading ishlatilmagan.
Region 1 / Region 2 nomuvofiqlik izohi: Shar–shok benchmarkining matniy izohi Region 1ni turg‘un, Region 2ni post-shock chekli tezlikli mintaqa sifatida ta’riflaydi. Manbadagi Tablo 2 esa tezlik qiymatini Region 1 uchun 2,0451168, Region 2 uchun 0 beradi. Verianla mintaqa tartibini faraz bilan teskari aylantirmagan.
Tablo 2 birlik izohi: Xuddi shu jadvalda harorat qiymatlari 0,006123676 va 0,002487067 sifatida berilgan hamda birlik K deb belgilangan. Manba bu juda kichik sonlar o‘lchamsizlashtirilgan harorat ekanini yoki emasligini izohlamagani uchun qiymatlar real Kelvin harorati sifatida talqin qilinmagan.
Boshlang‘ich hujayra soni nomuvofiqligi izohi: Manbaning bir bo‘limi shar benchmarkida “initial overset grid” uchun 3.241.936 hujayra bildiradi. Keyingi bo‘lim esa \( \bar{t}=1.832 \) vaqtida to‘r 2.232.704 boshlang‘ich hujayradan 3.241.936 hujayraga yetganini bildiradi. Ikki boshlang‘ich qiymat bir-biriga mos kelmagani uchun Verianla ulardan birini jimgina tuzatmagan.
Sonli tekshiruv chegarasi: Yechuvchi ikki benchmark bilan baholangan: Mach 2 yarim cheksiz to‘mtoq burunli jism va Mach 2,89 tekis shok–shar o‘zaro ta’siri. Tekshiruvlar mavjud eksperimental referens ma’lumotlari bilan bajarilgan; tadqiqotning o‘zi yangi fizik tajriba kampaniyasi emas.
Parallel samaradorlik chegarasi: Xabar qilingan %89,7, %80, %65 va %61 kabi parallel samaradorlik natijalari tadqiqot ichidagi muayyan grid o‘lchamlari, MPI rank sonlari va bitta HPC node uchun amal qiladi. Ko‘p tugunli yoki GPU asosli tizimlarga bevosita umumlashtirib bo‘lmaydi.
Kontent ishlab chiqarish usuli: Ushbu Verianla izohidagi ilmiy usullar, tenglamalar, benchmark shartlari, hujayra sonlari, MPI natijalari va cheklovlar ko‘rib chiqilgan manba ishga asoslanadi. Tashqi tekshiruv faqat nashr identifikatori va jurnalning taqriz holatini bibliografik tasdiqlash maqsadida ishlatilgan; tashqaridan yangi CFD natijasi, yangi benchmark ma’lumoti yoki manbada bo‘lmagan sonli samaradorlik qiymati asosiy matnga qo‘shilmagan.
Izoh qoldiring
E-pochta manzilingiz chop etilmaydi. Majburiy maydonlar * bilan belgilangan