

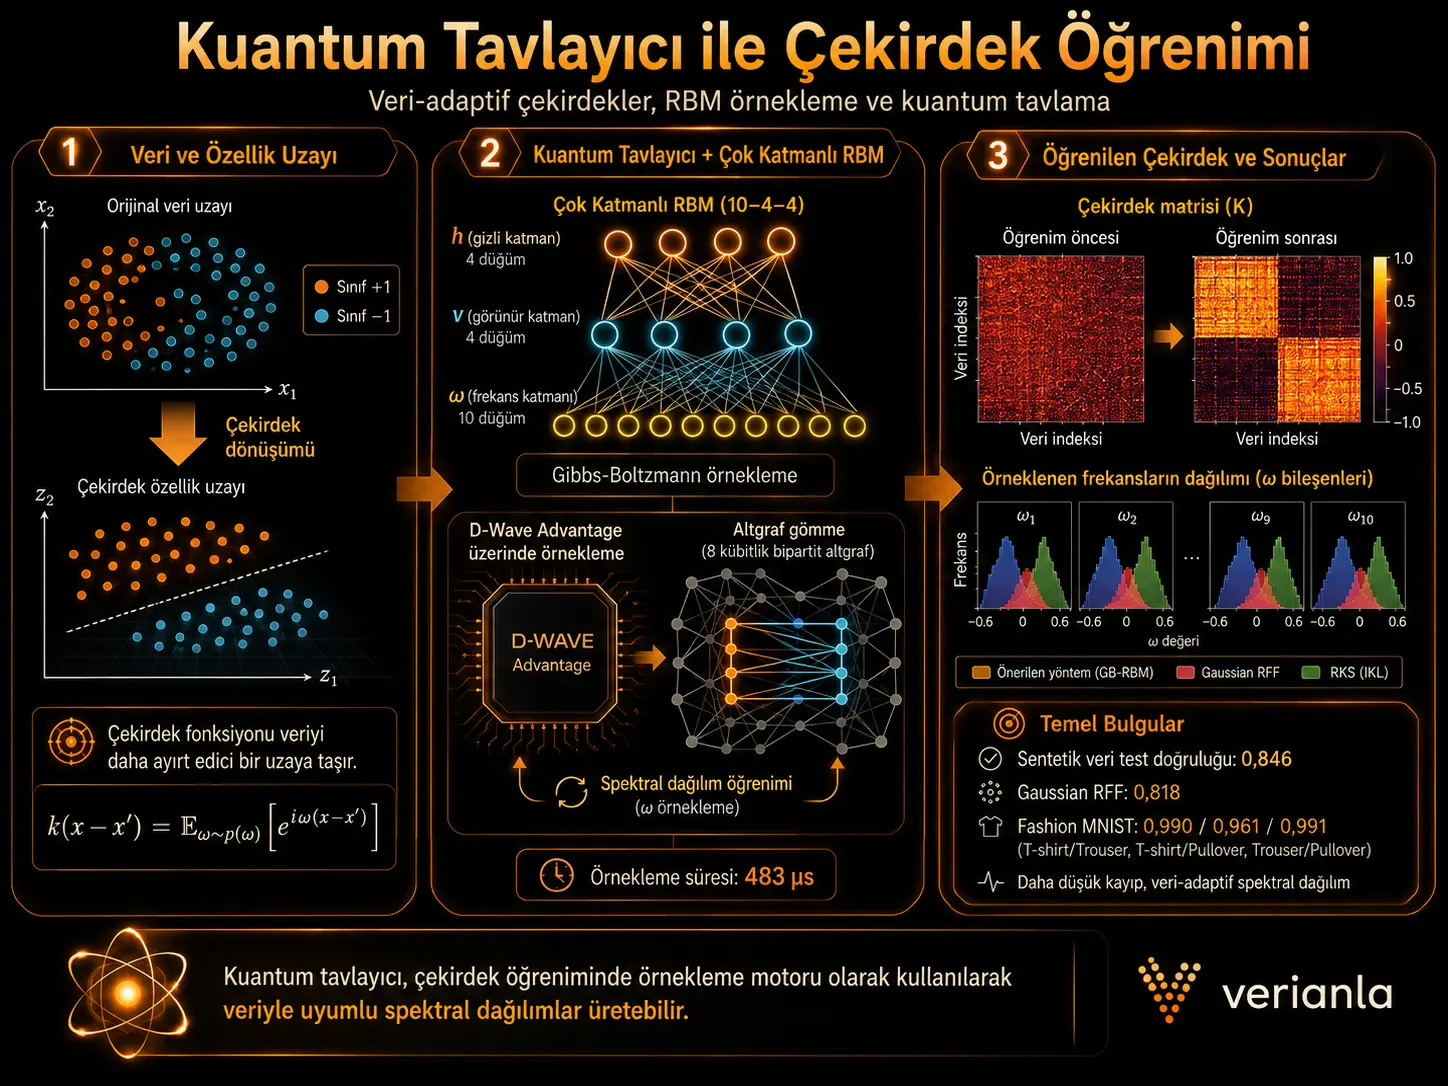
Utafiti huu unatengeneza mbinu mseto inayojifunza kazi ya kernel katika ujifunzaji wa mashine kulingana na data kwa kutumia sampuli za Gibbs-Boltzmann zinazozalishwa na quantum annealer. Watafiti wanajifunza usambazaji wa spektra unaobadilika kulingana na data kwa Restricted Boltzmann Machine (RBM) yenye tabaka nyingi; wanageuza masafa yanayotokana na usambazaji huo kuwa kazi ya kernel kupitia Random Fourier Feature (RFF), na katika hatua ya mwisho wanafanya uainishaji kwa kernel perceptron. Katika majaribio yaliyofanywa kwenye D-Wave Advantage, kwa data sintetiki ya vipimo 10 usahihi wa majaribio unaongezeka kutoka 0,818 wa Gaussian RFF hadi 0,846; na katika majukumu matatu ya uainishaji wa jozi ya Fashion MNIST, kernel iliyojifunza inapata usahihi wa 0,990, 0,961 na 0,991 mtawalia. Matokeo muhimu ya utafiti si tu ongezeko la usahihi, bali pia thamani ndogo zaidi za hasara ikilinganishwa na Gaussian RFF na RKS with IKL, matriki ya kernel inayolingana vyema zaidi na madarasa, na uwezo wa kujifunza usambazaji wa spektra unaobadilika kulingana na data wenye vilele viwili katika sehemu nyingi za masafa. Hata hivyo, majaribio hayathibitishi quantum speedup na yanategemea ukubwa mdogo wa modeli pamoja na majukumu machache ya uainishaji.
Jukumu la sehemu ya quantum hapa ni muhimu hasa: quantum annealer haiendeshi kiainishaji moja kwa moja wala haihesabu matriki ya kernel peke yake. Kifaa kinatumika kama injini ya uchukuaji sampuli inayozalisha sampuli zinazofanana na Gibbs-Boltzmann kwa vigeu vya kidijitali vinavyoonekana na vilivyofichwa vya Boltzmann machine. Vigeu endelevu vya masafa huundwa baadaye kwenye kompyuta ya kawaida kupitia tabaka la Gaussian-Bernoulli RBM. Kwa hiyo, mbinu hii inaonyesha muundo mseto unaounganisha hesabu za quantum na za kawaida katika mnyororo mmoja wa kujifunza.
Tatizo la kujifunza kernel ni nini?
Katika mbinu za kernel, lengo kuu ni kulinganisha data ambazo ni vigumu kutenganishwa kwa mstari katika nafasi ya vipengele inayofaa zaidi. Kielelezo 1 cha utafiti chanzo kinaonyesha hili kupitia madarasa mawili yaliyoingiliana katika vipimo viwili: nukta ambazo haziwezi kutenganishwa kwa mstari katika nafasi ya awali zinaweza kutenganishwa kwa ndege baada ya kuhamishwa katika nafasi ya vipimo vitatu kwa kuongeza kipimo cha ziada cha kipengele. Hapa kazi ya kernel inawakilisha kufanana kwa nukta mbili za data katika nafasi mpya ya vipengele badala ya kuhesabu moja kwa moja mabadiliko ya vipimo vya juu.
Tatizo ni kwamba haijulikani mapema ni kazi gani ya kernel inayofaa zaidi kwa seti fulani ya data. Ingawa kazi zenye umbo lililowekwa kama Gaussian kernel hutumiwa sana, watafiti wanalenga kujifunza kernel yenyewe kutoka kwenye data.
Kwa nini nadharia ya Bochner na Random Fourier Feature ni za msingi?
Utafiti unategemea ukweli kwamba kazi ya kernel isiyobadilika kwa uhamisho inaweza kuonyeshwa kama thamani tarajiwa ya Fourier ya usambazaji wa spektra:
\[ k(x-x')= \int_{\mathbb{R}^d} e^{i\omega(x-x')}dp(\omega) = \mathbb{E}_{\omega\sim p(\omega)} \left[e^{i\omega(x-x')}\right]. \]
Hapa \(x\) na \(x'\) ni nukta mbili za data, \(\omega\) ni vekta ya masafa yenye kipimo sawa na data, na \(p(\omega)\) ni usambazaji wa spektra unaobainisha kernel. Katika mbinu ya Random Fourier Feature, thamani hii tarajiwa inakadiriwa kwa idadi finyu ya sampuli \(S\) za masafa:
\[ k(x-x') \approx \frac{1}{S} \sum_s \cos\left[\omega_s(x-x')\right]. \]
Mabadiliko ya kipengele yanayolingana yanafafanuliwa katika chanzo kama
\[ \phi(x)= \frac{1}{\sqrt{S}} \left( \cos\omega_1x,\ldots,\cos\omega_Sx, \sin\omega_1x,\ldots,\sin\omega_Sx \right) \]
. Mabadiliko muhimu katika mbinu ya utafiti ni kwamba masafa hayachukuliwi kutoka katika usambazaji wa Gaussian uliowekwa; badala yake usambazaji \(p(\omega)\) unajifunzwa kulingana na data kwa Boltzmann machine.
Quantum annealer inafanya nini hapa?
Katika matumizi ya kawaida, quantum annealing huhusishwa na kutafuta hali za nishati ya chini za Ising Hamiltonian. Hamiltonian inayotegemea wakati inayotumiwa katika utafiti imetolewa kama ifuatavyo:
\[ H= \frac{A(s)}{2}\sum_i\hat{\sigma}_i^x+ \frac{B(s)}{2} \left( \sum_i h_i\hat{\sigma}_i^z+ \sum_{i<j}J_{ij}\hat{\sigma}_i^z\hat{\sigma}_j^z \right). \]
\(\hat{\sigma}^x\) na \(\hat{\sigma}^z\) zinawakilisha waendeshaji wa Pauli, \(h_i\) ni vipengele vya bias ya ndani, \(J_{ij}\) ni mwingiliano kati ya jozi za qubit, na \(s\) ni kigezo cha maendeleo ya annealing. Hata hivyo, matokeo ya quantum annealer halisi hayajumuishi hali ya msingi pekee. Wazo linalotumiwa na makala linaibuka hapa: kwa sababu ya athari za joto na mchakato wa kuganda, ukweli kwamba matokeo yanaweza kutoa sampuli zinazohusiana na usambazaji wa Gibbs-Boltzmann hugeuzwa kuwa sifa inayoweza kutumiwa katika mafunzo ya Boltzmann machine.
RBM yenye tabaka nyingi iliyopendekezwa inafanyaje kazi?
Modeli hutumia tabaka tatu za vigeu, na idadi ya nodi imewekwa kuwa
\[ \{N_\omega,N_v,N_h\}=\{10,4,4\} \]
. Hapa \(v\) inawakilisha vigeu vinne vya jozi vinavyoonekana, \(h\) vigeu vinne vya jozi vilivyofichwa, na \(\omega\) vekta endelevu ya masafa yenye vipimo 10.
Katika tabaka la kwanza la Boltzmann, sampuli huchukuliwa kutoka katika usambazaji
\[ P(v,h|b,c,w)= \frac{e^{-E(v,h|b,c,w)}}{Z(b,c,w)} \]
. Nishati imefafanuliwa kama
\[ E(v,h|b,c,w) = -\sum_i b_iv_i -\sum_j c_jh_j -\sum_{ij}v_iw_{ij}h_j \]
. D-Wave Advantage hutumiwa kuchukua sampuli za vigeu \(v\) na \(h\).
Katika hatua ya pili, sampuli ya kidijitali \(v\) kutoka kwa quantum annealer hubadilishwa kwenye kompyuta ya kawaida kuwa masafa endelevu \(\omega\) kupitia Gaussian-Bernoulli RBM:
\[ P(\omega|a,u,v,\sigma) = \frac{1}{\sqrt{2\pi\sigma}} \exp \left[ -\frac{(\omega-(a+Uv))^2}{2\sigma^2} \right]. \]
Kwa hiyo, mbinu hii si kiainishaji cha quantum kikamilifu. Wakati quantum annealing inatekeleza sehemu ya uchukuaji sampuli wa RBM, uundaji wa vigeu endelevu, usasishaji wa vigezo, mabadiliko ya vipengele na uainishaji wa mwisho hufanywa pamoja na vipengele vya hesabu ya kawaida.
Inawekwaje kwenye D-Wave Advantage?
Kielelezo 2 cha utafiti chanzo kinaonyesha upande wa maunzi wa mbinu. Kwa sababu grafu ya qubit ya D-Wave Advantage haijaunganishwa kikamilifu, RBM yenye nodi nne zinazoonekana na nodi nne zilizofichwa huwekwa kwa mbinu ya minor embedding kwenye subgrafu ya pande mbili yenye qubit nane. Thamani za bias za RBM hulinganishwa na bias za qubit halisi, na uzito wa miunganisho inayoonekana-iliyofichwa hulinganishwa na vigawo vya mwingiliano vya jozi za qubit.
Ili kupunguza gharama ya majaribio, RBM 500 zenye vigezo sawa huingizwa kwa wakati mmoja katika subgrafu tofauti. Sampuli mbili huchukuliwa kutoka kila embedding na hivyo kupata jumla ya sampuli 1000. Muundo huu unaonyesha kwamba utafiti haukupendekeza maunzi kwa nadharia pekee; uchukuaji sampuli ulifanywa kwenye quantum annealer halisi.
Kujifunza hufanyika katika hatua mbili
Hatua ya kwanza ni kujifunza usambazaji wa spektra. Vigezo vya RBM husasishwa ili kuongeza kufanana kwa kernel kwa jozi za data za darasa moja na kutenganisha jozi za madarasa tofauti. Kiasi cha lengo kinachotumiwa katika chanzo ni
\[ L= \frac{1}{N^2} \sum_{ij} y_i y_j \mathbb{E}_{\omega} \left[e^{i\omega(x_i-x_j)}\right] \]
. Kwa kuwa sehemu tofauti za makala zina tofauti ya ishara katika istilahi ya mwelekeo wa uboreshaji, usemi huu umehifadhiwa hapa kama ulivyo katika chanzo.
Katika hatua ya pili, kernel iliyoundwa kutoka kwa usambazaji wa spektra uliojifunza hutumiwa ndani ya kernel perceptron:
\[ f(x)= \operatorname{sign} \left( \sum_i \alpha_i y_i k(x_i,x) \right). \]
Kwa sampuli zilizoainishwa vibaya, \(\alpha_i\) husasishwa na ili kupunguza overfitting, chanzo kinatumia kikomo cha 0,5 kwa ukubwa wa \(\alpha\).
Kielelezo 3: Kazi ya hasara inatuambia nini?
Kielelezo 3 kinalinganisha mkingamo wa kernel-learning kwa majukumu ya T-shirt/Trouser, T-shirt/Pullover na Trouser/Pullover ya Fashion MNIST na marejeo ya Gaussian RFF na RKS with IKL. Mkingamo wa mbinu iliyopendekezwa hushuka kadiri mafunzo yanavyoendelea na katika majukumu yote matatu hushuka chini ya viwango vya chini vya hasara vilivyoboreshwa vya mbinu mbili za marejeo. Kwa Gaussian RFF, vigezo vya wastani na variance vya usambazaji wa spektra viliboreshwa kwa Optuna, hivyo ulinganisho haukufanywa dhidi ya mpangilio wa kawaida wa Gaussian pekee.
Hakuna nambari mpya zilizoundwa kwa kusoma makadirio ya thamani za iteresheni za kati ambazo hazikutolewa wazi katika chanzo. Hitimisho salama kisayansi ni kwamba mbinu iliyopendekezwa ilipata hasara ya mwisho iliyo chini ya kiwango cha chini cha marejeo kilichoripotiwa na chanzo katika majukumu yote matatu.
Kielelezo 4: Je, matriki ya kernel kweli inabadilika?
Katika Kielelezo 4, matriki ya kernel kabla ya kujifunza haina vizuizi vya madarasa vilivyo wazi, ilhali baada ya kujifunza vizuizi viwili vikuu vya diagonal vinakuwa angavu na maeneo ya msalaba kati ya madarasa yanakuwa meusi. Kwa kuwa data zimepangwa kwa lebo +1 katika indeks 0–999 na −1 katika indeks 1000–1999, mwonekano huu unaonyesha kwamba thamani za \(k(x_i,x_j)\) kwa jozi za data zenye lebo sawa zimeongezeka huku thamani za kernel kati ya lebo tofauti zikipungua.
Matokeo haya yanatoa ushahidi tofauti na kutazama usahihi wa mwisho wa uainishaji pekee: usambazaji wa spektra uliojifunza kweli unaunda upya jiometri ya kufanana kwa data kulingana na muundo wa madarasa.
Kielelezo 5: Kwa nini usambazaji wa spektra usio wa Gaussian ni muhimu?
Moja ya matokeo yanayotofautisha zaidi utafiti inaonekana katika Kielelezo 5. Kwa kuwa data za Fashion MNIST zimepunguzwa hadi vipimo 10 kwa PCA, vekta ya masafa \(\omega\) pia ina vipengele 10. Histogramu za masafa zilizochukuliwa kutoka kwa GB-RBM iliyofunzwa zinalinganishwa na Gaussian RFF na RKS with IKL.
Kulingana na kauli wazi ya chanzo, katika vipengele vyote isipokuwa \(\omega_7\), \(\omega_8\) na \(\omega_9\), histogramu za GB-RBM zinaonyesha vilele viwili vilivyo wazi. Kwa maneno mengine, katika vipengele 7 kati ya 10, muundo wenye vilele viwili ambao hauwakilishwi moja kwa moja na usambazaji wa spektra wa Gaussian uliowekwa unajifunzwa. Huu ndio mwonekano ulio wazi zaidi wa dai la utafiti kuhusu “kernel inayobadilika kulingana na data”.
Matokeo yanayoungwa mkono na utafiti
- Sampuli kutoka kwa quantum annealer zinaweza kutumiwa kwa vitendo katika mnyororo uliopendekezwa wa kujifunza kernel unaotegemea GB-RBM.
- Katika jaribio la data sintetiki, kernel iliyojifunza iliongeza usahihi wa test kutoka 0,818 wa Gaussian RFF hadi 0,846.
- Katika majukumu matatu ya jozi ya Fashion MNIST yaliyochunguzwa, kernel iliyojifunza ilitoa usahihi wa juu zaidi wa test.
- Ingawa tofauti dhidi ya Gaussian RFF katika Fashion MNIST ni ndogo, modeli iliyojifunza ilitoa thamani za hasara zilizoripotiwa na chanzo ambazo ni za chini katika majukumu yote matatu.
- Baada ya kujifunza, matriki ya kernel ilipata muundo unaoongeza kufanana ndani ya darasa moja na kupunguza kufanana kati ya madarasa tofauti.
- GB-RBM iliweza kujifunza usambazaji tofauti na usambazaji wa spektra wa Gaussian uliowekwa na wenye vilele viwili katika sehemu nyingi za masafa.
Matokeo ambayo utafiti hauungi mkono au hauyathibitishi
- Utafiti hauonyeshi quantum speedup iliyothibitishwa dhidi ya kompyuta za kawaida.
- Muda wa uchukuaji sampuli wa quantum wa mikrosakunde 483 peke yake hauthibitishi kwamba algoriti nzima ni ya haraka kuliko mbadala za kawaida.
- Faida ndogo ya usahihi katika majukumu matatu ya jozi ya Fashion MNIST haiwezi kujumlishwa kwa matatizo yote ya uainishaji wa picha.
- RBM ya ukubwa {10,4,4} iliyotumiwa katika jaribio haithibitishi kwamba tabia hiyo hiyo itadumu katika miundo mikubwa zaidi.
- Utafiti hauonyeshi ubora wa jumla wa fault-tolerant quantum computing wala “quantum advantage” ya ulimwengu wote.
- Haiwezi kuhitimishwa kwamba mbinu iliyopendekezwa ni bora kuliko Gaussian RFF au IKL kwa seti zote za data na mbinu zote za kernel.
Mbinu na Matokeo ya Utafiti
Jaribio 1: Data sintetiki ya vipimo 10
Sampuli sintetiki huzalishwa kutoka katika usambazaji
\[ x\sim\mathcal{N}(0,I_d),\qquad d=10 \]
. Lebo huamuliwa kwa usemi
\[ y=\operatorname{sign} \left( \|x\|^2-\sqrt{d} \right) \]
. Seti ya data ina sampuli 1000 za mafunzo na sampuli 1000 za test.
| Data | Kabla ya kujifunza kernel | Baada ya kujifunza kernel | Gaussian RFF |
|---|---|---|---|
| Mafunzo | 1,000 | 1,000 | 1,000 |
| Test | 0,677 | 0,846 | 0,818 |
Katika seti ya test sintetiki, mbinu iliyopendekezwa inapata 0,846 dhidi ya usahihi wa 0,818 wa Gaussian RFF. Tofauti kamili ni 0,028, yaani pointi 2,8 ikielezwa kwa pointi za asilimia. Ongezeko kutoka thamani ya 0,677 kabla ya kujifunza ni kubwa zaidi; hata hivyo, Gaussian RFF ndiyo msingi mkuu wa ulinganisho wa nje wa mbinu.
Jaribio 2: Uainishaji wa jozi wa Fashion MNIST
Watafiti wanachagua kwa nasibu picha 1000 kutoka kila moja ya madarasa mawili maalum ya Fashion MNIST na kupunguza vekta za picha za awali zenye vipimo 784 hadi vipimo 10 kwa kutumia PCA. Majukumu matatu ya jozi yanachunguzwa: T-shirt/Trouser, T-shirt/Pullover na Trouser/Pullover.
Mbinu iliyopendekezwa inatathminiwa dhidi ya hali tatu: hali kabla ya kernel-learning, Gaussian RFF yenye wastani na variance zilizoboreshwa, na Random Kitchen Sinks with Implicit Kernel Learning (RKS with IKL). Mtandao unaotumiwa katika msingi wa RKS with IKL una usanifu input-noise 10 → hidden (4,4) → output 10; batch size ni 200 na idadi ya random-feature ni 200 wakati wa mafunzo na 1000 wakati wa test.
Matokeo ya Fashion MNIST yanapaswa kutafsiriwaje?
Katika jukumu la T-shirt/Trouser, kernel iliyojifunza inapata usahihi wa test wa 0,990, Gaussian RFF 0,988 na RKS with IKL 0,975. Kwa T-shirt/Pullover, thamani ni 0,961, 0,959 na 0,949 mtawalia; na kwa Trouser/Pullover ni 0,991, 0,990 na 0,974.
Kuna hoja muhimu hapa: ingawa mbinu iliyopendekezwa ina usahihi wa juu zaidi wa test katika majukumu yote matatu, tofauti dhidi ya Gaussian RFF ni 0,002, 0,002 na 0,001 tu. Kwa hiyo, uzito wa kisayansi wa jaribio la Fashion MNIST hauko katika mruko mkubwa wa usahihi, bali katika kutoa usahihi sawa au juu kidogo kwa usambazaji wa spektra unaonyumbulika zaidi na hasara ndogo zaidi.
Ulinganisho wa kazi ya hasara
Kielelezo 3 kinaonyesha kwamba mbinu iliyopendekezwa inashuka chini ya marejeo ya mlalo yaliyoboreshwa kwa Gaussian RFF na RKS with IKL katika majukumu yote matatu. Chanzo kinatafsiri matokeo haya kama ishara kwamba usambazaji wa spektra uliojifunza unaweza kufaa data za mafunzo kuliko usambazaji wa Gaussian uliowekwa.
Kwa kuwa thamani kamili za hasara kwenye grafu hazikutolewa kama jedwali katika maandishi, hakuna nambari mpya zilizotolewa kwa kusoma makadirio ya pikseli kutoka kwenye kielelezo.
Ulinganisho wa matriki ya kernel
Katika Kielelezo 4, muundo wa vizuizi viwili wa matriki ya kernel unakuwa wazi zaidi baada ya mafunzo. Thamani za kernel huongezeka kwa jozi za sampuli zenye lebo sawa na hupungua kwa jozi zenye lebo tofauti. Hii inaunga mkono wazo kwamba mabadiliko ya mafanikio ya uainishaji hayatokani tu na coefficients za perceptron, bali pia na kernel yenyewe kuzoea jiometri ya data.
Muundo wa usambazaji wa spektra
Kielelezo 5 kinaonyesha vipengele vyote 10 vya masafa katika histogramu tofauti. Vipengele vya \(\omega_1\)–\(\omega_{10}\) vya GB-RBM iliyofunzwa vinalinganishwa na sampuli za Gaussian RFF na RKS with IKL. Kulingana na chanzo, usambazaji wa GB-RBM una muundo wenye vilele viwili katika vipengele vyote isipokuwa \(\omega_7\), \(\omega_8\) na \(\omega_9\). Hivyo, modeli iliyopendekezwa inaweza kuunda usambazaji unaonyumbulika zaidi kuliko dhana ya spektra ya Gaussian iliyowekwa inayojilimbikiza karibu na kilele kimoja.
Maunzi na muda
Katika jaribio la data sintetiki, muda wa jumla wa iteresheni moja ya mafunzo umetolewa katika chanzo kama takriban sekunde 0,4. Ndani yake, muda wa uchukuaji sampuli wa quantum annealer ni mikrosakunde 483. Kipimo hiki kinaonyesha kwamba uchukuaji sampuli ni sehemu ndogo ya muda wa jumla wa iteresheni.
Hata hivyo, taarifa hii haimaanishi kwamba “algoriti ya sekunde 0,4 ni ya haraka kuliko mbinu za kawaida”. Utafiti haukufanya jaribio lililodhibitiwa la quantum-speedup dhidi ya utekelezaji wa kawaida wa mwisho hadi mwisho ulio sawa. Waandishi pia wanaacha wazi kama quantum annealer hutoa quantum speedup halisi kama mashine ya uchukuaji sampuli kama swali la utafiti wa baadaye.
Vikwazo vikuu vya utafiti
- Idadi ya nodi za GB-RBM ilichaguliwa kuwa modeli ndogo inayoweza kuendeshwa kwa urahisi kwenye quantum annealer.
- Athari ya idadi ya nodi katika tabaka lililofichwa kwenye usambazaji wa \(\omega\) uliojifunza na usahihi wa utabiri haikuchunguzwa kwa utaratibu.
- Uthibitishaji kwenye modeli kubwa na seti pana zaidi za data unahitajika.
- Haijaonyeshwa kwamba uchukuaji sampuli kwa quantum annealing hutoa quantum speedup dhidi ya samplers za kawaida.
- Tathmini ya Fashion MNIST inategemea jozi tatu za madarasa badala ya tatizo lote la madarasa mengi.
- Kwa kuwa tofauti za usahihi dhidi ya Gaussian RFF kwenye Fashion MNIST ni ndogo, dai la ubora wa jumla haliungwi mkono.
Maelezo ya Chanzo na Mbinu
Utafiti asilia: Kernel Learning by Quantum Annealer
Waandishi: Yasushi Hasegawa; Hiroki Oshiyama; Masayuki Ohzeki.
Mwandishi wa mawasiliano: Yasushi Hasegawa.
Mchango sawa/uandishi wa kwanza wa pamoja: Hakuna taarifa kama hiyo katika chanzo.
Uhusiano wa taasisi: Graduate School of Information Sciences, Tohoku University, Sendai, Japan; Technology Strategy Division, SCSK Corporation, Koto, Tokyo, Japan; Department of Physics, Institute of Science Tokyo, Meguro, Tokyo, Japan; Sigma-i Co., Ltd., Minato, Tokyo, Japan.
Toleo la chanzo lililopakiwa: arXiv:2304.10144v2 [quant-ph], 8 Julai 2026.
Hali ya mapitio na uchapishaji: Hati iliyopakiwa ni toleo la arXiv v2; utafiti huo huo umechapishwa kama makala ya kisayansi iliyopitiwa na wenzao katika Journal of the Physical Society of Japan.
Jarida: Journal of the Physical Society of Japan.
Juzuu / toleo / nambari ya makala: 95 / 7 / 074002.
Tarehe ya uchapishaji: 15 Julai 2026, tarehe ya rekodi ya bibliografia.
DOI: 10.7566/JPSJ.95.074002
Taasisi inayochapisha: The Physical Society of Japan.
Rekodi rasmi ya uchapishaji: Rekodi ya DOI ya Journal of the Physical Society of Japan, 10.7566/JPSJ.95.074002.
Dokezo la metadata ya kichwa: Ingawa katika baadhi ya metadata za nje za ArXiv kichwa kinaonekana kama “Kernel Learning by quantum annealer”, kichwa kinachoonekana katika PDF iliyopakiwa na rekodi iliyochapishwa ya JPSJ ni “Kernel Learning by Quantum Annealer”. Katika makala hii, umbo la pili linalolingana na PDF ya chanzo na rekodi iliyochapishwa limehifadhiwa.
Leseni/hakimiliki: Toleo lililopakiwa halitaji leseni ya wazi ya Creative Commons kwa matumizi tena. Kwa hiyo, Vielelezo 1–5 vya utafiti chanzo havikunakiliwa moja kwa moja; badala yake data za nambari za jedwali na maelezo ya kisayansi ya utafiti zimetumiwa kuunda uonyeshaji asilia wa Verianla.
Ufadhili: Utafiti ulifadhiliwa na JSPS KAKENHI Grant No. 23H01432 pamoja na msaada nambari 23836436 chini ya BRIDGE na Cross-ministerial Strategic Innovation Promotion Program (SIP) inayoendeshwa na Cabinet Office.
Upatikanaji wa data: Hakuna taarifa tofauti ya Data Availability iliyobainishwa katika chanzo kilichopakiwa.
Mgongano wa maslahi: Hakuna taarifa tofauti ya mgongano wa maslahi iliyobainishwa katika chanzo kilichopakiwa. Kuwepo kwa taasisi za kampuni katika uhusiano wa waandishi hakukufasiriwa peke yake kama mgongano wa maslahi ambao haukutangazwa katika chanzo.
Taarifa ya michango ya CRediT: Hakuna sehemu tofauti ya michango ya waandishi ya CRediT iliyobainishwa katika chanzo kilichopakiwa.
Dokezo la uboreshaji ndani ya chanzo: Katika sehemu ya Eq. (5), lengo la kernel-learning linaelezwa kwa umbo la arg max, wakati katika Eq. (12), Kielelezo 3 na maelezo ya matokeo kiasi kinachohusiana kinachukuliwa kama kazi ya hasara na thamani ndogo hufasiriwa kuwa matokeo bora. Maandishi ya chanzo hayaelezi tofauti hii ya ishara/mwelekeo wa uboreshaji. Kwa hiyo, hakuna marekebisho ya kihisabati nje ya chanzo yaliyofanywa katika maandishi ya Verianla.
Kikomo cha kimetodolojia: Utafiti unaonyesha uwezekano wa mbinu kwa modeli ndogo ya GB-RBM ya {10,4,4}, uchukuaji sampuli wa D-Wave Advantage, tatizo moja sintetiki la vipimo 10 na majukumu matatu ya uainishaji wa jozi ya Fashion MNIST. Haipaswi kujumlishwa moja kwa moja kwa mitandao mikubwa, seti tofauti za data au matatizo ya jumla ya ujifunzaji wa mashine.
Kikomo cha faida ya quantum: Utafiti hauthibitishi quantum speedup kihisabati wala kimajaribio. Muda wa uchukuaji sampuli wa mikrosakunde 483 ni kipimo cha uchukuaji sampuli wa maunzi na haumaanishi kasi iliyothibitishwa dhidi ya mbinu sawa za kawaida za mwisho hadi mwisho.
Uaminifu kwa chanzo: Mbinu ya kisayansi, milinganyo, hali za majaribio, matokeo ya nambari na mipaka ya tafsiri zinategemea utafiti wa kurasa 18 uliopakiwa. Vyanzo vya nje vilitumiwa tu kuthibitisha utambulisho wa uchapishaji wa bibliografia, DOI na hali rasmi ya uchapishaji.
Muktadha wa Türkiye: Kwa kuwa utafiti hautumii idadi ya watu, sekta au data maalum za Türkiye, matokeo ya kisayansi hayajafanywa yaonekane kuwa maalum kwa Türkiye. Matumizi yanayowezekana ya mbinu hii nchini Türkiye hayajajaribiwa na chanzo hiki.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *