

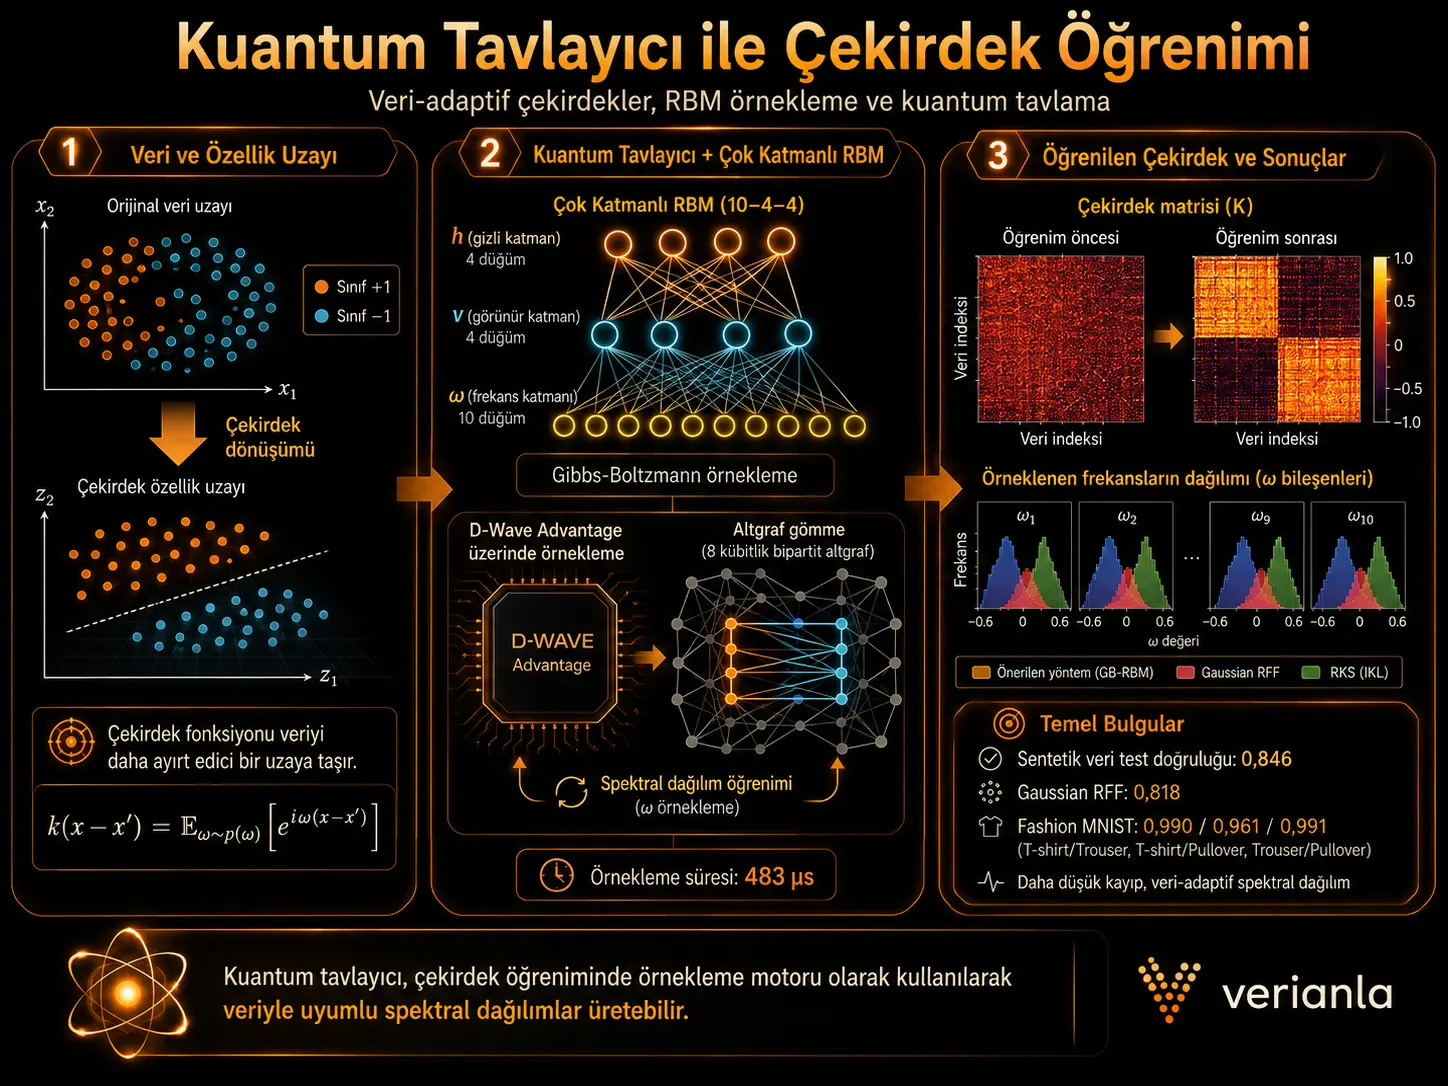
Bu çalışma, kuantum tavlayıcının ürettiği Gibbs-Boltzmann örneklerini kullanarak makine öğrenmesindeki çekirdek fonksiyonunu veriye göre öğrenen hibrit bir yöntem geliştiriyor. Araştırmacılar, çok katmanlı bir Restricted Boltzmann Machine (RBM) ile veri-adaptif spektral dağılım öğreniyor; bu dağılımdan üretilen frekansları Random Fourier Feature (RFF) ile çekirdek fonksiyonuna dönüştürüyor ve son aşamada kernel perceptron ile sınıflandırma yapıyor. D-Wave Advantage üzerinde gerçekleştirilen deneylerde, 10 boyutlu sentetik veride test doğruluğu Gaussian RFF'nin 0,818 değerinden 0,846'ya yükselirken; üç Fashion MNIST ikili sınıflandırma görevinde öğrenilmiş çekirdek sırasıyla 0,990, 0,961 ve 0,991 doğruluk elde ediyor. Çalışmanın asıl dikkat çekici sonucu yalnız doğruluk artışı değil, Gaussian RFF ve RKS with IKL'ye göre daha düşük kayıp değerleri, sınıflara daha iyi uyumlanan çekirdek matrisi ve çoğu frekans bileşeninde iki tepeli veri-adaptif spektral dağılımların öğrenilebilmesidir. Buna karşılık deneyler kuantum hızlanmasını kanıtlamamakta ve sınırlı model boyutu ile birkaç sınıflandırma görevine dayanmaktadır.
Buradaki kuantum bileşeninin rolü özellikle önemlidir: kuantum tavlayıcı doğrudan sınıflandırıcıyı çalıştırmıyor ve çekirdek matrisini tek başına hesaplamıyor. Donanım, Boltzmann makinesinin ayrık görünür ve gizli değişkenleri için Gibbs-Boltzmann benzeri örnekler üreten bir örnekleme motoru olarak kullanılıyor. Sürekli frekans değişkenleri daha sonra klasik bilgisayarda Gaussian-Bernoulli RBM katmanı üzerinden oluşturuluyor. Dolayısıyla yöntem, kuantum ve klasik hesaplamayı aynı öğrenme zincirinde birleştiren hibrit bir yapı sergiliyor.
Çekirdek öğrenme problemi nedir?
Çekirdek yöntemlerinde temel amaç, doğrusal olarak ayrılması zor verileri daha uygun bir özellik uzayında karşılaştırabilmektir. Kaynak çalışmanın Şekil 1'i bunu iki boyutlu, iç içe geçmiş iki sınıf üzerinden gösteriyor: özgün uzayda doğrusal olarak ayrılamayan noktalar, ek bir özellik boyutuyla üç boyutlu uzaya taşındığında bir düzlemle ayrılabilir hale geliyor. Burada çekirdek fonksiyonu, açık biçimde yüksek boyutlu dönüşümü hesaplamak yerine iki veri noktasının yeni özellik uzayındaki benzerliğini temsil ediyor.
Sorun, hangi çekirdek fonksiyonunun belirli bir veri kümesi için en uygun olduğunun baştan bilinmemesidir. Gaussian çekirdek gibi sabit biçimli fonksiyonlar yaygın olsa da, araştırmacılar çekirdeğin kendisini veri üzerinden öğrenmeyi hedefliyor.
Bochner teoremi ve Random Fourier Feature neden merkezde?
Çalışma, kaydırma değişmez bir çekirdek fonksiyonunun bir spektral dağılımın Fourier beklentisi olarak ifade edilebilmesine dayanıyor:
\[ k(x-x')= \int_{\mathbb{R}^d} e^{i\omega(x-x')}dp(\omega) = \mathbb{E}_{\omega\sim p(\omega)} \left[e^{i\omega(x-x')}\right]. \]
Burada \(x\) ve \(x'\) iki veri noktası, \(\omega\) verilerle aynı boyuta sahip bir frekans vektörü ve \(p(\omega)\) çekirdeği belirleyen spektral dağılımdır. Random Fourier Feature yaklaşımında bu beklenti sonlu sayıda \(S\) frekans örneğiyle yaklaşık hesaplanır:
\[ k(x-x') \approx \frac{1}{S} \sum_s \cos\left[\omega_s(x-x')\right]. \]
Buna karşılık gelen özellik dönüşümü kaynakta
\[ \phi(x)= \frac{1}{\sqrt{S}} \left( \cos\omega_1x,\ldots,\cos\omega_Sx, \sin\omega_1x,\ldots,\sin\omega_Sx \right) \]
biçiminde tanımlanıyor. Çalışmanın yaklaşımında kritik değişiklik, frekansların sabit bir Gaussian dağılımdan çekilmemesi; bunun yerine \(p(\omega)\) dağılımının veriye göre bir Boltzmann makinesiyle öğrenilmesidir.
Kuantum tavlayıcı burada ne yapıyor?
Kuantum tavlama geleneksel kullanımında bir Ising Hamiltonyeninin düşük enerjili durumlarını aramakla ilişkilendirilir. Çalışmada kullanılan zaman bağımlı Hamiltonyen şu biçimde veriliyor:
\[ H= \frac{A(s)}{2}\sum_i\hat{\sigma}_i^x+ \frac{B(s)}{2} \left( \sum_i h_i\hat{\sigma}_i^z+ \sum_{i<j}J_{ij}\hat{\sigma}_i^z\hat{\sigma}_j^z \right). \]
\(\hat{\sigma}^x\) ve \(\hat{\sigma}^z\) Pauli operatörlerini, \(h_i\) yerel bias terimlerini, \(J_{ij}\) qubit çiftleri arasındaki etkileşimleri, \(s\) ise tavlama ilerleme parametresini temsil ediyor. Ancak gerçek kuantum tavlayıcı çıktıları yalnız temel durumdan oluşmuyor. Makalenin kullandığı fikir tam da burada ortaya çıkıyor: termal etkiler ve donma süreci nedeniyle çıktıların Gibbs-Boltzmann dağılımıyla ilişkili örnekler üretmesi, Boltzmann makinesinin eğitiminde kullanılabilecek bir özellik haline getiriliyor.
Önerilen çok katmanlı RBM nasıl çalışıyor?
Model üç değişken katmanı kullanıyor ve düğüm sayıları
\[ \{N_\omega,N_v,N_h\}=\{10,4,4\} \]
olarak belirleniyor. Burada \(v\), dört görünür ikili değişkeni; \(h\), dört gizli ikili değişkeni; \(\omega\) ise 10 boyutlu sürekli frekans vektörünü temsil ediyor.
İlk Boltzmann katmanında
\[ P(v,h|b,c,w)= \frac{e^{-E(v,h|b,c,w)}}{Z(b,c,w)} \]
dağılımından örnekleme yapılıyor. Enerji
\[ E(v,h|b,c,w) = -\sum_i b_iv_i -\sum_j c_jh_j -\sum_{ij}v_iw_{ij}h_j \]
şeklinde tanımlanıyor. D-Wave Advantage, \(v\) ve \(h\) değişkenlerinin örneklenmesinde kullanılıyor.
İkinci aşamada kuantum tavlayıcıdan gelen ayrık \(v\) örneği klasik bilgisayarda Gaussian-Bernoulli RBM aracılığıyla sürekli \(\omega\) frekansına dönüştürülüyor:
\[ P(\omega|a,u,v,\sigma) = \frac{1}{\sqrt{2\pi\sigma}} \exp \left[ -\frac{(\omega-(a+Uv))^2}{2\sigma^2} \right]. \]
Bu nedenle yöntem tamamen kuantum bir sınıflandırıcı değildir. Kuantum tavlama RBM örneklemesinin bir bölümünü yürütürken, sürekli değişken oluşturma, parametre güncellemeleri, özellik dönüşümü ve son sınıflandırma klasik hesaplama bileşenleriyle birlikte gerçekleştirilir.
D-Wave Advantage'a nasıl yerleştiriliyor?
Kaynak çalışmanın Şekil 2'si yöntemin donanımsal tarafını gösteriyor. D-Wave Advantage qubit grafiği tam bağlantılı olmadığı için dört görünür ve dört gizli düğümden oluşan RBM, sekiz qubitlik iki parçalı bir altgrafa minor embedding yöntemiyle yerleştiriliyor. RBM bias değerleri fiziksel qubit biaslarına, görünür-gizli bağlantı ağırlıkları ise qubit çiftlerinin etkileşim katsayılarına eşleniyor.
Deney maliyetini azaltmak amacıyla aynı parametrelere sahip 500 RBM eşzamanlı olarak farklı altgraflara gömülüyor. Her gömmeden iki örnek alınarak toplam 1000 örnek elde ediliyor. Bu tasarım, çalışmanın donanımı yalnız teorik olarak önermediğini; gerçek bir kuantum tavlayıcı üzerinde örnekleme gerçekleştirdiğini gösteriyor.
Öğrenme iki aşamada yürütülüyor
Birinci aşama spektral dağılımın öğrenilmesidir. RBM parametreleri güncellenerek aynı sınıfa ait veri çiftlerinin çekirdek benzerliğinin artması, farklı sınıflardaki çiftlerin ise ayrışması hedeflenir. Kaynakta kullanılan amaç büyüklüğü
\[ L= \frac{1}{N^2} \sum_{ij} y_i y_j \mathbb{E}_{\omega} \left[e^{i\omega(x_i-x_j)}\right] \]
biçimindedir. Makalenin farklı bölümlerinde optimizasyon yönüne ilişkin terminolojik bir işaret farkı bulunduğu için bu ifade burada kaynaktaki haliyle korunmuştur.
İkinci aşamada öğrenilen spektral dağılımdan oluşturulan çekirdek bir kernel perceptron içinde kullanılıyor:
\[ f(x)= \operatorname{sign} \left( \sum_i \alpha_i y_i k(x_i,x) \right). \]
Yanlış sınıflandırılan örneklerde \(\alpha_i\) güncelleniyor ve aşırı uyumu sınırlandırmak amacıyla \(\alpha\) büyüklüğü için kaynakta 0,5 sınırı uygulanıyor.
Şekil 3: Kayıp fonksiyonu bize ne söylüyor?
Şekil 3, Fashion MNIST'teki T-shirt/Trouser, T-shirt/Pullover ve Trouser/Pullover görevleri için kernel-learning eğrisini Gaussian RFF ve RKS with IKL referanslarıyla karşılaştırıyor. Önerilen yöntemin eğrisi eğitim ilerledikçe aşağı doğru hareket ediyor ve üç görevde de iki referans yöntemin optimize edilmiş minimum kayıp seviyesinin altına iniyor. Gaussian RFF için spektral dağılımın ortalama ve varyans parametreleri Optuna ile optimize edilmiş olduğundan karşılaştırma yalnız varsayılan bir Gaussian ayarına karşı yapılmıyor.
Grafikten kaynakta açıkça verilmemiş kesin ara iterasyon değerleri okunarak yeni sayılar üretilmemiştir. Bilimsel olarak güvenli sonuç, önerilen yöntemin üç görevin tamamında kaynak tarafından bildirilen referans minimumlardan daha düşük nihai kayıp elde etmesidir.
Şekil 4: Çekirdek matrisi gerçekten değişiyor mu?
Şekil 4'te öğrenme öncesi çekirdek matrisi belirgin sınıf bloklarına sahip değilken, öğrenme sonrasında iki ana diyagonal blok parlak ve sınıflar arası çapraz bölgeler koyu hale geliyor. Veriler 0–999 indekslerinde +1, 1000–1999 indekslerinde −1 etiketiyle düzenlendiği için bu görünüm, aynı etikete sahip veri çiftlerinin \(k(x_i,x_j)\) değerlerinin yükseldiğini ve farklı etiketler arasındaki çekirdek değerlerinin küçüldüğünü gösteriyor.
Bu sonuç, yalnız son sınıflandırma doğruluğuna bakmaktan farklı bir kanıt sunuyor: öğrenilen spektral dağılım gerçekten de veri benzerlik geometrisini sınıf yapısına göre yeniden biçimlendiriyor.
Şekil 5: Gaussian olmayan spektral dağılım neden önemli?
Çalışmanın en ayırt edici çıktılarından biri Şekil 5'te görülüyor. Fashion MNIST verileri PCA ile 10 boyuta indirildiği için frekans vektörü \(\omega\) da 10 bileşenden oluşuyor. Eğitimli GB-RBM'den örneklenen frekans histogramları Gaussian RFF ve RKS with IKL ile karşılaştırılıyor.
Kaynağın açık ifadesine göre \(\omega_7\), \(\omega_8\) ve \(\omega_9\) dışındaki bileşenlerde GB-RBM histogramları iki belirgin tepe sergiliyor. Başka bir ifadeyle 10 bileşenin 7'sinde, sabit Gaussian spektral dağılımın doğrudan temsil etmediği çift tepeli yapı öğreniliyor. Çalışmanın “veri-adaptif çekirdek” iddiasının en görünür karşılığı budur.
Çalışmanın desteklediği sonuçlar
- Kuantum tavlayıcıdan alınan örnekler, önerilen GB-RBM tabanlı çekirdek öğrenme zincirinde pratik olarak kullanılabilir.
- Sentetik veri deneyinde öğrenilmiş çekirdek, Gaussian RFF'ye göre test doğruluğunu 0,818'den 0,846'ya çıkarmıştır.
- İncelenen üç Fashion MNIST ikili görevinde öğrenilmiş çekirdek en yüksek test doğruluğunu vermiştir.
- Fashion MNIST'teki Gaussian RFF farkları küçük olmasına rağmen, öğrenilmiş model her üç görevde de daha düşük kaynak-raporlu kayıp değerleri üretmiştir.
- Öğrenme sonrasında çekirdek matrisi aynı sınıf içindeki benzerlikleri güçlendirip farklı sınıflar arasındaki benzerlikleri azaltacak biçimde yapı kazanmıştır.
- GB-RBM, sabit Gaussian spektral dağılımdan farklı ve çoğu frekans bileşeninde iki tepeli dağılımlar öğrenebilmiştir.
Çalışmanın desteklemediği veya kanıtlamadığı sonuçlar
- Çalışma klasik bilgisayarlara karşı kanıtlanmış bir kuantum hızlanması göstermemektedir.
- 483 mikrosaniyelik kuantum örnekleme süresi, tek başına bütün algoritmanın klasik alternatiflerden daha hızlı olduğunu kanıtlamaz.
- Üç Fashion MNIST ikili görevi üzerindeki küçük doğruluk avantajı, tüm görüntü sınıflandırma problemlerine genellenemez.
- Deneyde kullanılan {10,4,4} boyutlu RBM, daha büyük mimarilerde aynı davranışın korunacağını kanıtlamaz.
- Çalışma fault-tolerant kuantum hesaplamanın genel üstünlüğünü veya evrensel bir “quantum advantage” ortaya koymamaktadır.
- Önerilen yöntemin tüm veri kümeleri ve tüm çekirdek yöntemleri için Gaussian RFF veya IKL'den üstün olduğu sonucuna varılamaz.
Çalışmanın Yöntemi ve Bulguları
Deney 1: 10 boyutlu sentetik veri
Sentetik örnekler
\[ x\sim\mathcal{N}(0,I_d),\qquad d=10 \]
dağılımından üretiliyor. Etiketler
\[ y=\operatorname{sign} \left( \|x\|^2-\sqrt{d} \right) \]
ifadesiyle belirleniyor. Veri kümesi 1000 eğitim ve 1000 test örneğinden oluşuyor.
| Veri | Çekirdek öğrenme öncesi | Çekirdek öğrenme sonrası | Gaussian RFF |
|---|---|---|---|
| Eğitim | 1,000 | 1,000 | 1,000 |
| Test | 0,677 | 0,846 | 0,818 |
Sentetik test setinde önerilen yöntem Gaussian RFF'nin 0,818 doğruluğuna karşı 0,846 elde ediyor. Mutlak fark 0,028, yani yüzde puan biçiminde ifade edildiğinde 2,8 puandır. Öğrenme öncesindeki 0,677 değerine göre artış ise çok daha büyüktür; ancak Gaussian RFF, yöntemin asıl harici karşılaştırma temelidir.
Deney 2: Fashion MNIST ikili sınıflandırma
Araştırmacılar Fashion MNIST'teki belirli iki sınıftan rastgele 1000'er görüntü seçiyor ve özgün 784 boyutlu görüntü vektörlerini PCA kullanarak 10 boyuta indiriyor. Üç ikili görev inceleniyor: T-shirt/Trouser, T-shirt/Pullover ve Trouser/Pullover.
Önerilen yöntem üç karşılaştırmayla değerlendiriliyor: kernel-learning öncesi durum, ortalama ve varyansı optimize edilmiş Gaussian RFF ve Random Kitchen Sinks with Implicit Kernel Learning (RKS with IKL). RKS with IKL temelinde kullanılan ağ, input-noise 10 → hidden (4,4) → output 10 mimarisine sahip; batch size 200 ve random-feature sayısı eğitimde 200, testte 1000 olarak veriliyor.
Fashion MNIST sonuçları nasıl yorumlanmalı?
T-shirt/Trouser görevinde öğrenilmiş çekirdek 0,990, Gaussian RFF 0,988 ve RKS with IKL 0,975 test doğruluğu elde ediyor. T-shirt/Pullover için değerler sırasıyla 0,961, 0,959 ve 0,949; Trouser/Pullover için 0,991, 0,990 ve 0,974.
Bu sonuçlarda önemli bir nüans vardır: önerilen yöntem her üç görevde en yüksek test doğruluğuna sahip olsa da Gaussian RFF'ye karşı farklar yalnız 0,002, 0,002 ve 0,001 düzeyindedir. Dolayısıyla Fashion MNIST deneyinin bilimsel ağırlığı, büyük bir doğruluk sıçramasından çok, aynı veya biraz daha yüksek doğruluğu daha esnek bir spektral dağılım ve daha düşük kayıp ile sağlamasıdır.
Kayıp fonksiyonu karşılaştırması
Şekil 3'te önerilen yöntemin üç görevde de Gaussian RFF ve RKS with IKL için verilen optimize edilmiş yatay referansların altına indiği görülüyor. Kaynak bu sonuçları, öğrenilen spektral dağılımın eğitim verisine sabit Gaussian dağılımdan daha uygun hale gelebildiğinin bir göstergesi olarak yorumluyor.
Grafikteki kesin kayıp değerleri metin içinde tablo halinde verilmediğinden, şekilden yaklaşık piksel okumasıyla yeni sayılar türetilmemiştir.
Çekirdek matrisi karşılaştırması
Şekil 4'te eğitim sonrası çekirdek matrisinin iki bloklu yapısı belirginleşiyor. Aynı etikete sahip örnek çiftlerinde çekirdek değerleri büyürken, farklı etiketli çiftlerde değerler küçülüyor. Bu, sınıflandırma başarısındaki değişikliğin yalnız perceptron katsayılarından değil, çekirdeğin kendisinin veri geometrisine uyarlanmasından kaynaklandığını destekliyor.
Spektral dağılımın yapısı
Şekil 5, 10 frekans bileşeninin tamamını ayrı histogramlarla gösteriyor. Eğitimli GB-RBM'nin \(\omega_1\)–\(\omega_{10}\) bileşenleri Gaussian RFF ve RKS with IKL örnekleriyle karşılaştırılıyor. Kaynağa göre \(\omega_7\), \(\omega_8\) ve \(\omega_9\) dışında GB-RBM dağılımları iki tepeli yapı sergiliyor. Böylece önerilen model, tek tepe çevresinde yoğunlaşan sabit Gaussian spektral varsayımından daha esnek dağılımlar oluşturabiliyor.
Donanım ve süre
Sentetik veri deneyinde bir eğitim iterasyonunun toplam süresi kaynakta yaklaşık 0,4 saniye olarak veriliyor. Bunun içindeki kuantum tavlayıcı örnekleme süresi ise 483 mikrosaniye. Bu ölçüm, örnekleme işleminin toplam iterasyon süresinin küçük bir bölümünü oluşturduğunu gösteriyor.
Ancak bu veri “0,4 saniyelik algoritma klasik yöntemlerden daha hızlıdır” anlamına gelmez. Çalışmada uçtan uca eşdeğer klasik uygulamayla kontrollü quantum-speedup testi yapılmamıştır. Yazarlar da kuantum tavlayıcının örnekleme makinesi olarak gerçek bir kuantum hızlanması sağlayıp sağlamadığını açık bir gelecek araştırma konusu olarak bırakmaktadır.
Çalışmanın temel sınırlılıkları
- GB-RBM'nin düğüm sayısı kuantum tavlayıcıda kolayca çalıştırılabilecek küçük bir model olarak seçilmiştir.
- Gizli katmandaki düğüm sayısının öğrenilen \(\omega\) dağılımı ve tahmin doğruluğu üzerindeki etkisi sistematik olarak araştırılmamıştır.
- Daha büyük modeller ve daha geniş veri kümeleri üzerinde doğrulama gereklidir.
- Kuantum tavlama örneklemesinin klasik örnekleyicilere karşı quantum speedup sağlayıp sağlamadığı gösterilmemiştir.
- Fashion MNIST değerlendirmesi çok sınıflı problemin tamamı yerine üç ikili sınıf çiftine dayanmaktadır.
- Gaussian RFF'ye karşı Fashion MNIST doğruluk farkları küçük olduğundan genel üstünlük iddiası desteklenmez.
Kaynak ve Yöntem Notu
Özgün çalışma: Kernel Learning by Quantum Annealer
Yazarlar: Yasushi Hasegawa; Hiroki Oshiyama; Masayuki Ohzeki.
Sorumlu yazar: Yasushi Hasegawa.
Eş katkı/eş birinci yazarlık: Kaynakta böyle bir beyan bulunmamaktadır.
Afiliyasyonlar: Graduate School of Information Sciences, Tohoku University, Sendai, Japan; Technology Strategy Division, SCSK Corporation, Koto, Tokyo, Japan; Department of Physics, Institute of Science Tokyo, Meguro, Tokyo, Japan; Sigma-i Co., Ltd., Minato, Tokyo, Japan.
Yüklenen kaynak sürümü: arXiv:2304.10144v2 [quant-ph], 8 Temmuz 2026.
Hakemlik ve yayın durumu: Yüklenen belge arXiv v2 sürümüdür; aynı çalışma Journal of the Physical Society of Japan'da hakemli bilimsel makale olarak yayımlanmıştır.
Dergi: Journal of the Physical Society of Japan.
Cilt / sayı / makale numarası: 95 / 7 / 074002.
Yayın tarihi: 15 Temmuz 2026 bibliyografik kayıt tarihi.
DOI: 10.7566/JPSJ.95.074002
Yayımlayan kurum: The Physical Society of Japan.
Resmî yayın kaydı: Journal of the Physical Society of Japan DOI kaydı, 10.7566/JPSJ.95.074002.
Başlık metadata notu: ArXiv dış metadata'sında başlık bazı kayıtlarda “Kernel Learning by quantum annealer” biçiminde görünürken, yüklenen PDF'nin görünür başlığı ve yayımlanmış JPSJ kaydı “Kernel Learning by Quantum Annealer” biçimindedir. Bu makalede kaynak PDF ve yayımlanmış kayıtla aynı olan ikinci biçim korunmuştur.
Lisans/telif: Yüklenen sürümde yeniden kullanıma yönelik açık bir Creative Commons lisansı belirtilmemiştir. Bu nedenle kaynak Şekil 1–5 doğrudan kopyalanmamış; sayısal tablo verileri ve çalışmanın bilimsel açıklamaları kullanılarak özgün Verianla görselleştirmesi hazırlanmıştır.
Finansman: Çalışma JSPS KAKENHI Grant No. 23H01432 ile; Cabinet Office tarafından yürütülen BRIDGE ve Cross-ministerial Strategic Innovation Promotion Program (SIP) kapsamındaki 23836436 numaralı destekle finanse edilmiştir.
Veri erişilebilirliği: Yüklenen kaynakta ayrı bir Data Availability beyanı tespit edilmemiştir.
Çıkar çatışması: Yüklenen kaynakta ayrı bir çıkar çatışması beyanı tespit edilmemiştir. Yazar afiliyasyonları içinde şirket kurumları bulunması, kendi başına kaynakta beyan edilmemiş bir çıkar çatışması olarak yorumlanmamıştır.
CRediT katkı beyanı: Yüklenen kaynakta ayrı bir CRediT yazar katkıları bölümü tespit edilmemiştir.
Kaynak içi optimizasyon notu: Çalışmanın Eq. (5) bölümünde kernel-learning amacı arg max biçiminde ifade edilirken, Eq. (12), Şekil 3 ve sonuç anlatımında ilişkili büyüklük kayıp fonksiyonu olarak ele alınıp daha düşük değerler daha iyi sonuç olarak yorumlanmaktadır. Kaynak metin bu işaret/optimizasyon yönü farkını ayrıca açıklamamaktadır. Bu nedenle Verianla metninde kaynak dışı bir matematiksel düzeltme yapılmamıştır.
Yöntemsel sınır: Araştırma, küçük bir {10,4,4} GB-RBM modeli, D-Wave Advantage örneklemesi, tek bir 10 boyutlu sentetik problem ve üç Fashion MNIST ikili sınıflandırma görevi üzerinde fizibilite göstermektedir. Daha büyük ağlara, farklı veri kümelerine veya genel makine öğrenmesi problemlerine doğrudan genelleme yapılmamalıdır.
Kuantum avantajı sınırı: Çalışma matematiksel veya deneysel olarak bir quantum speedup kanıtlamamaktadır. 483 mikrosaniyelik örnekleme süresi donanımsal örnekleme ölçümüdür ve eşdeğer klasik uçtan uca yöntemlere karşı kanıtlanmış hızlanma anlamına gelmez.
Kaynak sadakati: Bilimsel yöntem, denklemler, deney koşulları, sayısal sonuçlar ve yorum sınırları yüklenen 18 sayfalık çalışmaya dayanmaktadır. Harici kaynaklar yalnız bibliyografik yayın kimliği, DOI ve resmî yayın durumunu doğrulamak için kullanılmıştır.
Türkiye bağlamı: Çalışma belirli bir ülke nüfusuna, sektöre veya Türkiye'ye özgü veri kullanmadığından bilimsel sonuçlar Türkiye'ye özgüymüş gibi yerelleştirilmemiştir. Yöntemin Türkiye'deki olası uygulamaları bu kaynak tarafından test edilmemiştir.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir