

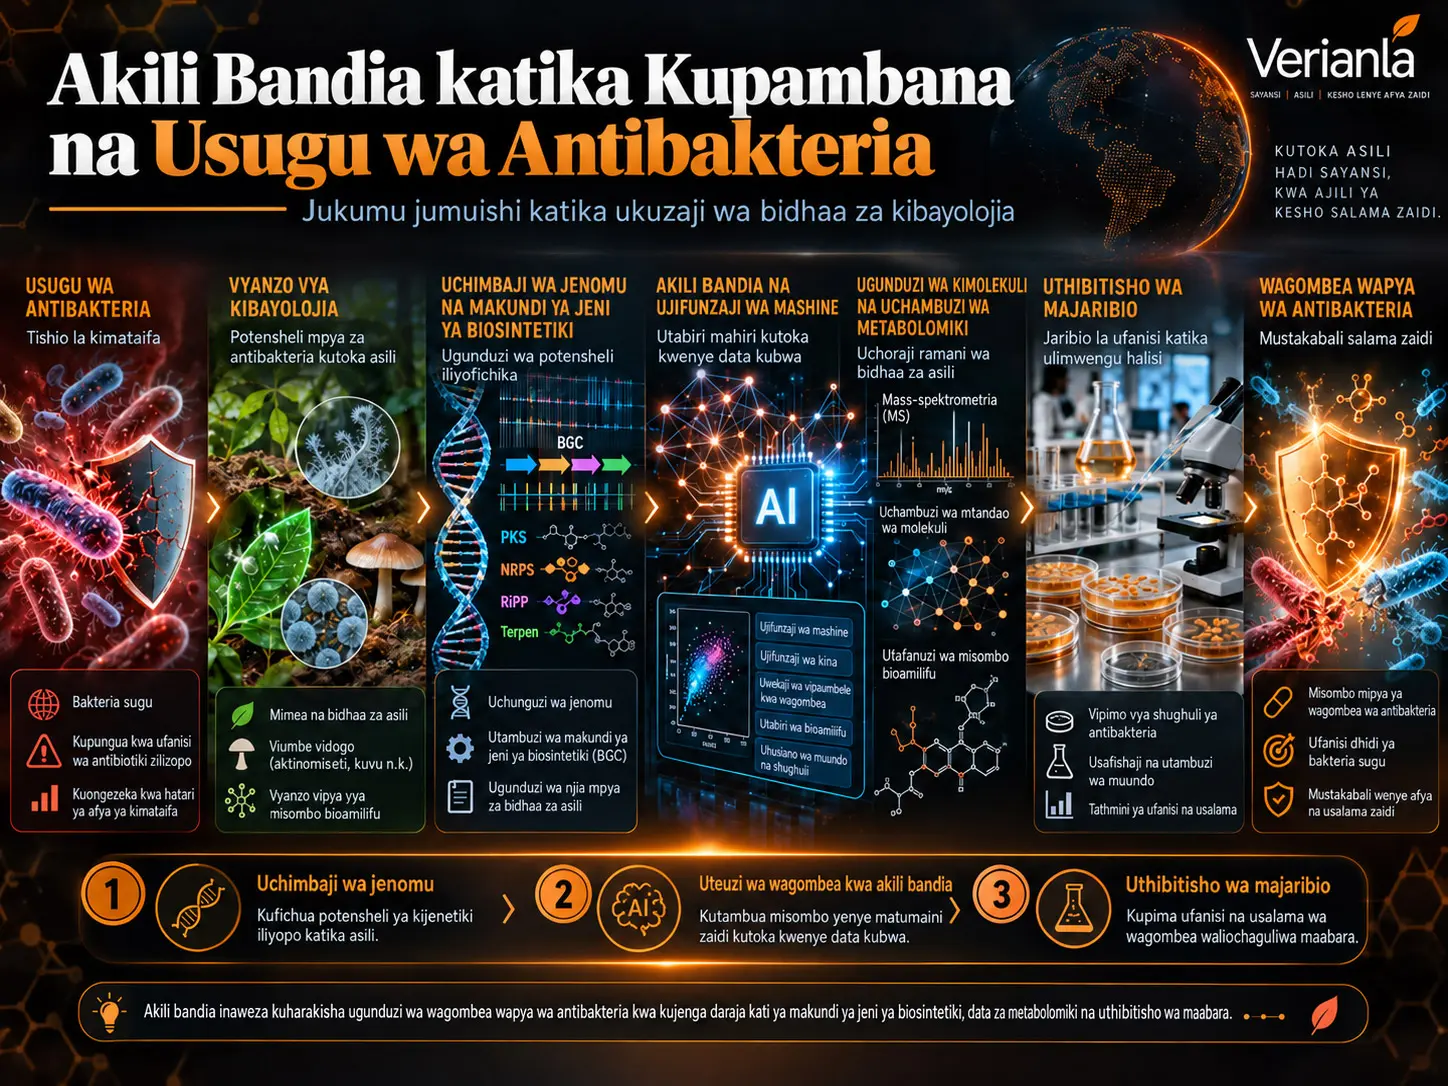
Ugunduzi wa bidhaa asilia unaosaidiwa na akili bandia ni mbinu ya ugunduzi wa dawa inayolenga kuzipa kipaumbele molekuli mpya zinazoweza kuwa na shughuli za antibakteria kwa kuchanganua kwa mbinu za kikokotozi utofauti wa kijenomiki na wa kikemia wa vijiumbe au vyanzo vingine vya kibaolojia. Mapitio haya mapana yanachunguza kwa pamoja, kuanzia misingi ya kimolekuli ya usugu wa antibakteria, vikwazo vya ugunduzi wa jadi wa bidhaa asilia, uchimbaji wa makundi ya jeni za biosintesi, utabiri wa bioactivity unaotegemea machine learning na deep learning, virtual screening, dereplication, ujumuishaji wa metabolomiki–cheminformatics, modeli generative, pamoja na uthibitishaji wa in vitro na in vivo wa wagombea waliopatikana kwa njia za kikokotozi. Chanzo hakikufanya jaribio jipya wala utafiti wa kliniki; kilikusanya mbinu, modeli na matokeo ya uthibitishaji wa kimajaribio kutoka tafiti mbalimbali.
Ujumbe mkuu wa kisayansi wa mapitio ni kwamba akili bandia katika ugunduzi wa antibakteria inaweza kutumiwa si kama algoriti moja au modeli moja ya utabiri, bali kama tabaka la kikokotozi linalounganisha sehemu nyingi za mnyororo wa ugunduzi. Uchimbaji wa jenomu unaosaidiwa na AI unaweza kutambua makundi ya jeni za biosintesi ambayo hayajawahi kuchunguzwa katika makusanyo makubwa ya jenomu; machine learning inaweza kutabiri bioactivity ya molekuli wagombea; mass spectrometry na zana za cheminformatics zinaweza kutenganisha kwa haraka zaidi misombo inayojulikana; mbinu za metabologenomics zinaweza kuunganisha uwezo wa kijeni na metaboliti halisi; na modeli generative zinaweza kupendekeza molekuli mpya au wagombea wa peptidi za antimicrobial.
Chanzo kinatoa matokeo ya kuvutia kama vile e-DeepBGC kutambua makundi 170.685 ya jeni za biosintesi katika jenomu 5666 za bakteria, BioAct-Het kufikia usahihi wa %88,5 katika jukumu maalum la kutabiri bioactivity, na shughuli ya antibakteria kuonekana katika %54 ya wagombea waliochaguliwa na kupimwa kimajaribio katika ultra-large transfer-learning screening. Hata hivyo, thamani hizi zinatokana na majukumu, seti za data na miundo ya majaribio tofauti. Haziwezi kuunganishwa kuwa “kiwango kimoja cha jumla cha mafanikio ya AI”.
Kikomo muhimu zaidi cha tafsiri katika mapitio ni kwamba utendaji wa juu wa modeli haumaanishi mafanikio ya kliniki ya antibiotiki. Ili mgombea anayependekezwa na modeli awe dawa halisi, lazima apitie hatua mfululizo za uthibitishaji kama uthibitishaji wa kikemia, shughuli ya in vitro, uteuzi na sumu, utaratibu wa utendaji, sifa za pharmacokinetics na pharmacodynamics, modeli zinazofaa za wanyama na hatimaye tafiti za kliniki kwa binadamu. Chanzo pia kinakubali wazi matatizo makuu kama reproducibility, publication bias, ubora wa data, ukosefu wa benchmark zilizosanifishwa na uhaba wa data za in vivo.
Kwa nini usugu wa antibakteria unahitaji mbinu mpya za ugunduzi?
Usugu wa antibakteria ni hali ambapo taratibu za kurithiwa au zilizopatikana zinazowezesha bakteria kuepuka athari za antibiotiki hufanya matibabu kuwa magumu katika kiwango cha kliniki. Chanzo kinapotaja mzigo wa kimataifa wa AMR, kinatofautisha kati ya vifo milioni 4,95 vinavyohusishwa na maambukizi sugu na takriban vifo milioni 1,27 vinavyohusishwa moja kwa moja na maambukizi sugu. Namba hizi mbili si dhana moja ya epidemiolojia.
Tatizo la usugu haliwezi kutatuliwa kwa kutumia antibiotiki nyingi zaidi pekee. Madarasa yaliyopo ya antibakteria hukutana kwa wakati mmoja na taratibu nyingi za kinga za kimolekuli. β-lactamases na carbapenemases zinaweza kuvunja antibiotiki; mabadiliko katika molekuli lengwa yanaweza kupunguza kufungamana kwa antibiotiki; pampu za efflux zinaweza kutoa dawa nje ya seli; kupotea kwa porin kunaweza kuzuia kuingia kwa dawa ndani ya seli; na baadhi ya bakteria zinaweza kupita hatua ya kimetaboliki iliyozuiwa kwa kutumia vimeng’enya mbadala.
| Utaratibu | Mantiki ya kibaolojia | Mifano iliyotolewa katika chanzo | Matokeo |
|---|---|---|---|
| Uharibifu au urekebishaji wa kienzymu | Antibiotiki hubadilishwa kikemia au kuvunjwa kabla haijafikia shabaha yenye ufanisi | β-lactamases, ESBLs, KPC, NDM, OXA, IMP, VIM, vimeng’enya vinavyorekebisha aminoglycoside | Shughuli ya darasa moja au zaidi la antibiotiki inaweza kupungua |
| Mabadiliko ya shabaha | Muundo unaofungamanishwa na antibiotiki hubadilishwa huku kazi ya msingi ya seli ikihifadhiwa | mecA/PBP2a, gyrA, gyrB, parC, parE, vanA/vanB/vanC, rpoB | Affinity ya dawa kwa shabaha hupungua |
| Efflux | Antibiotiki hutolewa nje ya seli kupitia mifumo hai ya usafirishaji | MexAB-OprM, AcrAB-TolC na mifumo mingine ya RND/MFS/SMR | Kiwango cha dawa yenye ufanisi ndani ya seli hupungua |
| Kupungua kwa upenyezaji | Njia za kuingia kwenye utando wa nje hupungua au hubadilishwa | ompF, ompC, ompK35/36 | Kuingia kwa antibiotiki huzuiliwa hasa katika bakteria Gram-hasi |
| Metabolic bypass | Hatua ya kimetaboliki iliyozuiwa huendelezwa na vimeng’enya mbadala vyenye usugu | jeni za sul1, sul2 na dfr | Njia mbadala yenye kazi ya mchakato uliozuiwa huhifadhiwa |
Kwa nini ugunduzi wa bidhaa asilia ni muhimu kihistoria?
Antibakteria nyingi muhimu kama penicillin, tetracycline na vancomycin zilitokana na ugunduzi wa asili au wa kibaolojia. Vijiumbe, mimea, fangasi na viumbe vya baharini huzalisha utofauti mpana sana wa kikemia. Hata hivyo, ugunduzi wa jadi wa bidhaa asilia hauishii tu katika kukusanya nyenzo za kibaolojia na kufanya vipimo vya shughuli.
Dondoo moja linaweza kuwa na maelfu ya ishara za kikemia. Mtafiti lazima atofautishe ni ipi molekuli iliyojulikana hapo awali, ipi ni muundo mpya kweli, ipi ni kiwanja chenye shughuli ya kibaolojia, na ipi ni uwezo wa kijenomiki ambao hauzalishwi chini ya hali za maabara.
Chanzo kinajadili vikwazo vikuu vya ugunduzi wa bidhaa asilia kama ugunduzi upya wa misombo inayojulikana, hit rate ndogo ya screening, vijiumbe visivyoweza kukuzwa, makundi ya jeni za biosintesi yaliyo kimya katika hali za maabara, uwezo mdogo wa dereplication, mchakato mrefu wa hit-to-lead na gharama kubwa za uendelezaji.
| Kikwazo | Muktadha wa kiasi uliotolewa katika chanzo | Matokeo ya kisayansi |
|---|---|---|
| Kupatikana tena kwa misombo inayojulikana | Katika untargeted metabolomics inayotegemea LC-MS, takriban %95–98 ya features zinaweza zisitambulike kwa uhakika | Kutofautisha miundo mipya na ishara za kikemia zinazojulikana huwa vigumu zaidi |
| Hit rate ndogo za jadi | Chanzo kinatoa mifano kama takriban %0,3 katika baadhi ya screening za bidhaa asilia na <%0,001 katika maktaba sintetiki | Screening ya kimajaribio ya maktaba kubwa sana inahitajika |
| Utofauti wa vijiumbe usioweza kukuzwa | Chanzo kinataja kwamba takriban %99,9 haiwezi kukuzwa kwa mbinu za kawaida | Sehemu kubwa ya utofauti wa biosintesi inaweza kubaki nje ya ugunduzi wa jadi unaotegemea culture |
| BGC zilizo kimya | Jenomu nyingi zina makundi ambayo hayaelezwi chini ya hali za kawaida za maabara | Uwezo wa kuzalisha kemikali uliopo kwenye jenomu unaweza usionekane katika culture |
| Dereplication | Chanzo kinajadili viwango vya kawaida vya annotation vya LC-MS katika takriban %2–5 | Kuondoa mapema miundo inayojulikana huwa vigumu zaidi |
| Muda na gharama | Chanzo kinataja michakato ya miaka 10–20 kutoka ugunduzi hadi soko na gharama kubwa sana za uendelezaji | Si endelevu kuchunguza kila mgombea kwa kina sawa kimajaribio |
Kundi la Jeni za Biosintesi Ni Nini na Kwa Nini AI Inatumika Hapa?
Kundi la jeni za biosintesi (biosynthetic gene cluster, BGC) ni eneo la jenomu ambako jeni zinazoshiriki pamoja katika biosintesi ya bidhaa fulani ya asili au metaboliti maalum zimepangwa kikazi; modeli za AI hutumiwa kutambua maeneo haya katika makusanyo makubwa ya jenomu, kubaini mipaka yake, kutabiri madarasa ya bidhaa na kuzipa kipaumbele cluster zinazovutia zaidi kwa kazi za kimajaribio.
DeepBGC na e-DeepBGC
DeepBGC hutumia deep learning inayotegemea bidirectional LSTM kutambua maeneo yanayoweza kuwa BGC kwa kuchanganua familia za protini na muktadha wa sequence katika jenomu. Modeli pia inaweza kutoa utabiri wa darasa la bidhaa na shughuli ya kikemia inayowezekana kwa kutumia Random Forest classifiers.
e-DeepBGC imepanua muundo huu kwa BGC zilizothibitishwa, familia za protini za Pfam, kazi za Pfam na taarifa za clan. Kulingana na chanzo, ilitambua BGC 170.685 katika jenomu 5666 za bakteria za RefSeq na kuripoti wastani wa cluster 30,1 kwa kila jenomu.
Modeli za self-supervised
Modeli za self-supervised kama BiGCARP hujifunza mpangilio wa kimuktadha wa protein domains kutoka data ya kijenomiki isiyo na lebo au yenye annotation chache. Chanzo kinaeleza kuwa BiGCARP ilifanyiwa pre-training kwenye BGC 127.294; na ilitambua cluster 4287 katika jenomu 773 za bakteria zisizo na annotation.
Faida inayowezekana ya mbinu hii ni kujaribu kujifunza lugha ya jumla ya mpangilio wa biosintesi badala ya kukariri motif ya BGC inayojulikana tu. Hata hivyo, generalizability kwa madarasa mapya ya BGC yaliyo tofauti sana na mgawanyo wa data ya mafunzo bado ni mojawapo ya vikwazo vikuu.
Kusoma BGC kama “sentensi” ya kibaolojia
Chanzo kinaeleza kwamba baadhi ya modeli za NLP huwakilisha protein domains kama maneno na muundo wa BGC kama sentensi ya kibaolojia. BGCCGB huunganisha mifumo ya attention inayofanana na BERT na Graph Convolutional Networks, huku BGC-Prophet ikitumia transformer encoder.
Mfano huu si kwa urahisi wa maelezo pekee. Maana ya jeni ndani ya BGC inaweza kutegemea si utambulisho wake pekee bali pia muktadha wake na jeni jirani pamoja na vipengele vya biosintesi vilivyo mbali zaidi.
Kwa nini machine learning ya jadi bado ni muhimu?
Deep learning si bora kiotomatiki katika kila tatizo. RFBGCPred ilifanya uainishaji wa BGC kwa kutumia uwakilishi wa Word2Vec, supervised UMAP na Random Forest; ikaripoti %98,0 accuracy, MCC 0,9752 na AUC 0,9928 katika seti ya majaribio iliyosawazishwa. Katika seti ya validation isiyosawazishwa, accuracy ilipungua hadi %94,8, lakini modeli iliendelea kuwa na utendaji mzuri.
Matokeo haya yanaonyesha kwamba katika miundo fulani ya data ML ya jadi iliyoundwa vizuri inaweza kushindana na deep learning. Hata hivyo, metrika zilezile hazipaswi kulinganishwa bila udhibiti kati ya modeli na seti tofauti za data.
Reinforcement learning inajaribu kurekebisha nini?
Kutambua tu kuwepo kwa BGC hakutoshi; mipaka ya kuanzia na kuishia lazima itambuliwe kwa usahihi. Chanzo kinaeleza mbinu ambamo reinforcement learning hutumiwa kujifunza kwa hatua ni jeni zipi zihifadhiwe au ziondolewe katika cluster zilizotabiriwa.
Mbinu hii iliongeza cluster precision kwa zaidi ya %25 katika mifumo kama fungiSMASH na DeepBGC, na gene precision kwa zaidi ya %15 katika baadhi ya zana. Thamani hizi si ongezeko la kudumu la utendaji linaloweza kujumlishwa kwa viumbe wote, bali ni matokeo ya hali husika za validation.
Kwa nini metagenomics ni ngumu zaidi?
Sampuli za metagenomics zina DNA ya vijiumbe wengi badala ya jenomu moja safi. Assembly ya vipande vya jenomu inapokuwa haijakamilika au imegawanyika, kunasa BGC ndefu kwa ukamilifu huwa vigumu zaidi.
HiFiBGC hutumia mbinu ya ensemble inayounganisha assemblies kutoka metagenome assemblers tatu tofauti zinazooana na PacBio HiFi. Kulingana na chanzo, mkakati huu ulitambua kwa wastani %78 BGC zaidi kuliko mbinu bora ya assembler moja, na ensemble assembly iliongeza recovery kwa takriban %25.
Utabiri wa jenomu unaunganishwaje na molekuli?
Kupatikana kwa BGC pekee hakuonyeshi ni molekuli gani ya kikemia inayozalishwa kweli. Kwa sababu hiyo, zana kama Seq2PKS na Seq2Saccharide huunganisha genome mining na mass spectrometry. Miundo mingi ya molekuli inayowezekana hutengenezwa kutoka jenomu; kisha ishara za majaribio za MS hulinganishwa na miundo hii ili kupunguza uwezekano wa matches.
Chanzo kinatoa Seq2PKS kama mfano katika kutambua BGC za monazomycin, oasomycin A na 2-aminobenzamide-actiphenol; huku Seq2Saccharide ikitumika katika kupata BGC ya trestatin B.
Kwa nini BGC zilizo kimya na cryptic ni muhimu?
Jenomu ya kijiumbe inaweza kuwa na uwezo wa kutengeneza bidhaa fulani ya asili, lakini gene cluster husika inaweza isiwe active chini ya hali za kawaida za maabara. Cluster kama hizo zinaweza kuitwa “silent” au “cryptic”.
SYNTERUPTOR kutambua katika Streptomyces ambofaciens gene cluster maalum ya metaboliti ambayo matoleo ya awali ya antiSMASH hayakupata, na baadaye kuonyeshwa kimajaribio kwamba cluster hiyo inaongoza biosintesi ya metaboliti mbili, ni mojawapo ya mifano inayoonyesha kwa nini utabiri wa kikokotozi na uthibitishaji wa maabara vinahitajika pamoja.
Utabiri wa muundo na bioactivity kwa AI
Baada ya genome mining, tatizo la pili kubwa ni kutabiri miundo ya molekuli na shughuli za kibaolojia. Chanzo kinatathmini Random Forest, SVM, gradient boosting, CNN, RNN, GNN, transformer, transfer learning na modeli generative katika majukumu mbalimbali.
Heterogeneous Siamese neural network iitwayo BioAct-Het imetolewa katika chanzo kama mfano wa %88,5 accuracy katika utabiri wa bioactivity. Modeli nyingine zimetathminiwa kwa metrika tofauti kama AUC, MCC, F1, RMSE, Pearson correlation au hit rate. Kwa sababu maana za kihisabati za vipimo hivi ni tofauti, si visawe vinavyoweza kubadilishana vya dhana moja ya “mafanikio”.
Ugunduzi wa peptidi za antimicrobial
AMPlify huainisha sequences za peptidi za antimicrobial kwa kutumia bidirectional LSTM, multi-head attention na context attention. Chanzo kinaripoti %93,71 accuracy, %92,93 sensitivity, %94,49 specificity, %93,66 F1 na %98,37 AUROC kwa sequences 3338 za mafunzo na 835 za majaribio.
Baadaye, peptidi 16 zilitengenezwa kutoka sequences 101 zilizopendekezwa kutoka jenomu ya chura, na peptidi nne mpya zikaonyesha shughuli ya antibakteria kwa majaribio. Hii ni sawa na %25 hit rate kati ya wagombea waliotengenezwa na kupimwa.
Tofauti muhimu hapa ni kwamba usahihi wa uainishaji wa modeli kwenye seti ya majaribio na hit rate ya wagombea wapya waliopatikana kuwa active maabara ni vipimo tofauti.
Virtual screening ya bidhaa asilia kwa D-MPNN
Modeli ya Directed Message-Passing Neural Network ilifunzwa kwa data kutoka screening ya majaribio ya misombo 29.537 dhidi ya Burkholderia cenocepacia. Hit rate ya screening ya awali ya high-throughput ilikuwa %0,87 pekee.
Baadaye modeli ilifanya virtual screening ya misombo 1614 iliyoidhinishwa na FDA na bidhaa asilia 224.205; na hit rate ya %26 na %12 iliripotiwa kwa wagombea wa juu zaidi waliotathminiwa kimajaribio, mtawalia. Chanzo kinatafsiri hili kama angalau mara 14 enrichment ikilinganishwa na screening ya awali yenye uteuzi wa nasibu/majaribio.
Molekuli zaidi ya bilioni moja zinawezaje kufanyiwa screening?
Katika mbinu ya transfer-learning, GNN zilifanyiwa pre-training kwenye data kubwa ya molekuli, kisha fine-tune kwa data ndogo ya shughuli ya antibakteria. Modeli hii iliorodhesha zaidi ya molekuli bilioni moja za virtual kutoka ChemDiv na Enamine.
Wagombea 156 walichaguliwa kwa majaribio; chanzo kinaripoti kwamba %54 ya wagombea waliopimwa walionyesha shughuli ya MIC ≤10 µg/mL dhidi ya E. coli. Hata hivyo, %54 hii haimaanishi kwamba %54 ya molekuli bilioni moja zina shughuli ya antibakteria. Ni hit rate ya subset ndogo ya kimajaribio iliyoprioritizwa na modeli kuwa na uwezekano mkubwa.
Je, AI Hit Rate ya Juu Inamaanisha Mafanikio ya Kliniki ya Antibiotiki?
Hapana. Hit rate inaonyesha sehemu ya wagombea waliochaguliwa kwa njia za kikokotozi wanaokidhi kigezo cha shughuli kilichowekwa awali katika jaribio fulani; mafanikio ya kliniki ya antibiotiki ni kiwango cha juu zaidi cha ushahidi kinachohusu ufanisi, usalama, dozi, pharmacokinetics, pharmacodynamics, maendeleo ya usugu na matokeo ya kliniki kwa binadamu.
Tofauti kati ya metrika ya modeli na shughuli ya kimajaribio
Accuracy au AUC hupima tabia ya uainishaji wa modeli, RMSE hupima kosa la utabiri wa namba, Pearson correlation hupima uhusiano wa mstari kati ya utabiri na thamani halisi, na hit rate hupima ni wangapi kati ya wagombea waliochaguliwa walioonekana active maabara.
Hakuna kipimo kati ya hivi kinachoonyesha peke yake mafanikio ya matibabu kwa binadamu. Kwa mtazamo wa Verianla, mnyororo sahihi wa ushahidi unapaswa kusomwa kama “alama ya modeli → mgombea wa majaribio → shughuli → sumu/uteuzi → utaratibu → uthibitishaji wa in vivo → utafiti wa kliniki”.
Tatizo la out-of-distribution
Modeli ya AI inaweza kuonyesha utendaji wa juu kwa molekuli zinazofanana na ilizoziona wakati wa mafunzo lakini ikashindwa katika maeneo ya nafasi ya kikemia ambayo haijawahi kuyaona. Chanzo kinataja tafiti zinazoshughulikia tatizo hili kwa vipimo kama “unfamiliarity”.
Kwa hiyo, hata kama alama ya modeli ya mgombea mpya kikemia ni ya juu, uaminifu wa modeli katika darasa hilo la muundo lazima utathminiwe kando.
Cell Painting na data ya fenotipu
Badala ya kutumia muundo wa kikemia wa molekuli pekee, fenotipu za kimofolojia ambazo molekuli husababisha katika seli zinaweza pia kuingizwa kwenye modeli. Chanzo kinaripoti kwamba modeli zilizotumia Cell Painting pamoja na taarifa za muundo wa kikemia zilitoa wastani wa AUROC 0,744 ± 0,108 katika assay 140; AUROC ≥0,7 iliripotiwa katika %62 ya assay, ≥0,8 katika %30 na >0,9 katika %7.
Mbinu hii inaweza kutoa taarifa kuhusu athari za seli zaidi ya kufanana kwa miundo, lakini si assay zote zilizotumika ni za antibakteria. Matokeo haya yanaonyesha wigo wa kimetodolojia wa utabiri wa bioactivity wa bidhaa asilia.
Kwa Nini Dereplication Ni Hatua Muhimu katika Ugunduzi wa Bidhaa Asilia?
Dereplication hupunguza muda na rasilimali za majaribio ambazo zingetumika kutenganisha tena molekuli ileile kwa kuamua mapema iwezekanavyo kama ishara za kikemia zinazoonekana katika sampuli ya kibaolojia zinatokana na misombo iliyojulikana tayari; AI na cheminformatics hutumiwa hapa kuoanisha kwa haraka zaidi spektra za MS/MS, fomula za molekuli, wagombea wa miundo na mitandao ya spektra.
GNPS na mitandao ya molekuli
Global Natural Products Social Molecular Networking (GNPS) huunganisha mifumo inayofanana ya fragmentation ya MS/MS katika mitandao ya spektra, na hivyo kufanya familia za kikemia zionekane. Ishara zisizojulikana zilizo karibu na spektra inayojulikana zinaweza kupewa kipaumbele kama sehemu ya familia ya molekuli inayohusiana.
Chanzo kinataja GNPS ikitumika katika mazingira tofauti sana kama Streptomyces ya baharini, tafiti za mwani, sampuli za kliniki, ekstrakti za mimea na metabolomiki ya microbiome.
SIRIUS na CSI:FingerID
SIRIUS hutabiri fomula ya molekuli kutoka data ya tandem MS, huku CSI:FingerID ikitabiri sifa za fingerprint zinazohusiana na muundo wa kikemia na kuorodhesha hifadhidata za miundo wagombea.
Chanzo kinasisitiza kwamba mifumo hii inaweza kuongeza wigo wa annotation katika seti kubwa za data, lakini umuhimu wa mbinu orthogonal kama NMR kwa uthibitishaji wa mwisho wa muundo bado unabaki.
UmetaFlow
UmetaFlow ni workflow inayofanyia otomatiki preprocessing, spectral matching, utabiri wa fomula na muundo wa molekuli pamoja na uchanganuzi wa baadaye unaotegemea GNPS. Katika validation iliyoripotiwa na chanzo, preprocessing ya faili ghafi 1245 kutoka strains 100 za actinomycete ilichukua takriban saa 1 dakika 12; kukamilisha utabiri wa fomula na miundo kulihitaji takriban siku 10.
Mfano huu pia unaonyesha kwamba AI haimaanishi kila wakati uchanganuzi wa “papo hapo”. Workflow kubwa za DL na cheminformatics zinaweza kuhitaji miundombinu mikubwa ya kompyuta.
CSU-MS2 na contrastive learning
CSU-MS2 hutumia contrastive learning kuoanisha spektra za MS/MS na miundo ya molekuli katika nafasi ya uwakilishi ya pamoja. Chanzo kinaripoti Recall@1 ya %75,45 katika benchmark ambayo spektra 1047 zilipimwa dhidi ya molekuli wagombea 1.001.047 zilizokusanywa kutoka hifadhidata 23 za miundo.
Katika benchmark hiyo hiyo, CFM-ID ilitoa %68,38, SIRIUS %64,85, MetFrag %48,59 na CMSSP %30,47 Recall@1. Matokeo haya yanahusu hali mahususi za benchmark; hayamaanishi ubora wa jumla kwa aina zote za data ya metabolomiki.
Mbinu ya foundation model
DreaMS ni modeli inayotegemea transformer inayotumia self-supervised pre-training katika mamilioni ya tandem mass spectra zisizo na annotation. Inalenga kukuza uwakilishi wenye taarifa za muundo wa molekuli kwa kujifunza spectral peaks zilizofichwa na mpangilio wa chromatographic retention.
Chanzo kinaeleza kwamba DreaMS Atlas ina takriban spektra milioni 201 za MS/MS. Kiwango hiki kikubwa hutoa fursa kubwa za annotation na similarity search lakini pia huongeza mahitaji ya uhifadhi wa data na kompyuta.
Kwa nini NMR bado inahitajika?
Fragmentation ya MS/MS inaweza kutoa taarifa nyingi kuhusu muundo, lakini inaweza isitoshe peke yake hasa kwa stereochemistry, utofautishaji wa isomer na uthibitishaji wa uhakika wa miundo mipya kweli. Chanzo kinaendelea kuitambua NMR spectroscopy kwa mbinu za 1D na 2D kama mojawapo ya zana kuu za uthibitishaji wa mwisho wa muundo.
Kwa hiyo, utabiri wa muundo unaotegemea AI si mbadala wa moja kwa moja wa utambuzi wa muundo kwa majaribio, bali ni zana ya kuweka vipaumbele inayofanya kazi za majaribio kuwa lengwa zaidi.
Kwa nini metabolomiki na genomiki hutumiwa pamoja?
Genome mining huonyesha kile ambacho kiumbe kinaweza kuzalisha, huku metabolomiki ikionyesha ni molekuli zipi zinazoonekana kweli katika hali fulani. Metabologenomics hujaribu kuunganisha tabaka hizi mbili za data.
Mbinu ya NPClassScore/NPLinker ilitumia ontolojia za bidhaa asilia kupanga uhusiano unaowezekana kati ya BGC na ishara za MS/MS. Katika validation ya seti tatu za data za omiki zilizooanishwa zenye jumla ya strains 189 za bakteria, ilipunguza idadi ya uhusiano wagombea kwa wastani wa %63 huku ikihifadhi %96 ya uhusiano uliothibitishwa kimajaribio.
Matokeo haya yanaweza kupunguza kwa kiasi kikubwa nafasi ya wagombea, lakini hayamaanishi kwamba kila match iliyobaki ni uhusiano wa kibaolojia wa uhakika; uthibitishaji wa majaribio bado unahitajika.
Isolation lengwa inayoongozwa na AI
Workflow iliyotumia LC-UV-HRMS/MS na supervised ML katika ekstrakti ya tunda la Paulownia tomentosa ilitambua features 2687, ikatambua 42 kwa reference standards, ika-annotate 214 kwa spectral library na kuainisha spektra 1805 za MS/MS katika darasa la prenylated flavonoids.
Uwekaji wa vipaumbele uliofuata ulipelekea isolation lengwa ya misombo mitano; miwili kati yake iliripotiwa kama miundo mipya katika chanzo asilia. Chanzo kinaeleza kupunguzwa kwa nafasi ya wagombea kutoka features 2687 hadi malengo matano ya isolation kama upunguzaji wa characterization mara 537.
Mfano huu unaonyesha nguvu ya mbinu ya ugunduzi wa bidhaa asilia; si utafiti wa moja kwa moja wa ufanisi wa kliniki wa antibakteria.
Je, akili bandia generative inaweza kubuni antibiotiki mpya?
Modeli generative zinaweza kujifunza mifumo ya molekuli au peptidi katika data ya mafunzo na kupendekeza miundo wagombea ambayo haijawahi kuwapo kwenye hifadhidata. Chanzo kinajadili GAN, modeli recurrent na latent diffusion hasa katika ubunifu wa peptidi za antimicrobial.
Katika mbinu ya latent diffusion ya Wang na wenzake, peptidi wagombea 40 zilitengenezwa na 25 (%62,5) zikaonyesha shughuli ya antibakteria au antifungal. AMP-24 ilionyesha shughuli teule dhidi ya bakteria Gram-hasi, huku AMP-29 ikionyesha shughuli teule dhidi ya Candida glabrata.
Modeli generative kuzalisha sequence pekee haitoi hadhi ya mgombea wa tiba. Molekuli lazima itengenezwe, vipimo vya MIC na spectrum vifanywe, hemolysis/cytotoxicity itathminiwe na pale inapohitajika hatua ya uthibitishaji wa kifamasia ifuatwe.
Mbinu na Matokeo ya Utafiti
Makala hii yenyewe inatumia mbinu gani?
Utafiti wa chanzo ni makala pana ya Review ambayo haitoi data mpya ya majaribio. Unajenga usanisi wa kimaudhui kuanzia mzigo wa kimataifa wa AMR na taratibu za molekuli za usugu hadi vikwazo vya ugunduzi wa jadi wa bidhaa asilia, modeli za AI, BGC mining, virtual screening, dereplication, ujumuishaji wa metabolomiki–cheminformatics na uthibitishaji wa preclinical.
Kwa kuwa chanzo hakiripoti methodology tofauti ya systematic search, tarehe ya utafutaji wa hifadhidata, mtiririko wa PRISMA au vigezo rasmi vya inclusion/exclusion, makala ya Verianla haiwasilishi tafiti kama “korpasi ya meta-analysis iliyochaguliwa kwa mfumo wa systematic”.
Muundo wa kisayansi wa chanzo
| Tabaka | Swali kuu | Mbinu zinazosisitizwa katika chanzo |
|---|---|---|
| Mzigo wa AMR na taratibu | Kwa nini antibakteria mpya zinahitajika? | Fasihi ya epidemiolojia, taratibu za usugu, vikwazo mahususi vya darasa |
| Vikwazo vya jadi vya NPD | Kwa nini ugunduzi wa jadi wa bidhaa asilia unasonga polepole? | Dereplication, viumbe visivyoweza kukuzwa, BGC zilizo kimya, gharama na muda |
| Mfumo wa jumla wa AI/ML | Ni familia zipi za modeli zinaweza kutumiwa katika majukumu gani ya ugunduzi? | RF, SVM, KNN, boosting, CNN, RNN, GNN, transformer, RL |
| Genome mining | Uwezo uliofichika wa biosintesi katika jenomu unaweza kupatikanaje? | DeepBGC, e-DeepBGC, BiGCARP, BGC-Prophet, RFBGCPred, HiFiBGC |
| Utabiri wa muundo na shughuli | Ni molekuli zipi zipewe kipaumbele kwa majaribio? | D-MPNN, transfer learning, attention, GNN, QSAR, Cell Painting |
| Dereplication | Molekuli inayojulikana inatofautishwaje na uvumbuzi wa kweli? | GNPS, SIRIUS, CSI:FingerID, UmetaFlow, FIDDLE, CSU-MS2 |
| Metabolomiki–cheminformatics | Ishara za kikemia zinawezaje kuunganishwa na chanzo cha kijenomiki? | Metabologenomics, molecular networking, BGC–metabolite linking |
| Ubunifu generative | Je, molekuli mpya au wagombea wa AMP wanaweza kuzalishwa? | GAN, modeli za lugha, latent diffusion |
| Uthibitishaji wa majaribio | Je, utabiri wa kikokotozi unageuka kuwa uhalisia wa kibaolojia? | MIC, time-kill, cytotoxicity, hemolysis, mechanism na modeli za wanyama |
Mpito kutoka Utabiri wa AI hadi Mgombea wa Antibakteria wa Majaribio Unathibitishwaje?
Ili utabiri wa AI uweze kutathminiwa kama mgombea halisi wa antibakteria, baada ya kipaumbele cha kikokotozi lazima kufuatiwe synthesis au isolation ya molekuli, kipimo cha shughuli ya in vitro, tathmini ya shabaha/uteuzi na sumu, uthibitishaji wa mechanism na modeli za maambukizi za in vivo kwa wagombea wanaofaa; mafanikio katika modeli ya mnyama bado hayamaanishi ufanisi wa kliniki kwa binadamu.
Mnyororo wa uthibitishaji wa P076
Peptidi P001, P002 na P076 zilizozalishwa ndani ya mfumo wa AMPredictor unaotegemea GAN na GCN zilisonga kutoka screening ya kikokotozi hadi vipimo vya majaribio. Modeli iliripoti RMSE 0,5348 na Pearson correlation coefficient 0,7072 katika utabiri wa MIC.
Peptidi zote tatu zilionyesha shughuli ya in vitro dhidi ya strains nane za bakteria. P076 ilionyesha shughuli ya MIC 0,21 µM dhidi ya MDR Acinetobacter baumannii, Kd 56,1 nM iliripotiwa kwa kufungamana na lipid A, na hemolysis hadi 70 µM iliripotiwa kuwa <%1.
Katika modeli ya maambukizi ya peritoneal MDR A. baumannii kwa panya, survival ya saa 48 ya kundi lililopewa 2 mg/kg P076 ilikuwa %50, huku makundi ya udhibiti ya PBS na ciprofloxacin yakiwa %0. Upungufu wa takriban mara 25 wa bacterial burden ya peritoneal uliripotiwa.
Matokeo haya yanatoa ushahidi wa preclinical wa majaribio kwa P076; hayabaini dozi, usalama au ufanisi wa matibabu kwa binadamu.
Ugunduzi unaolenga FtsZ na OmpW
Chanzo kinatoa mifano miwili tofauti ya ugunduzi wa AI unaotegemea shabaha. Katika utafiti mmoja, virtual screening inayolenga protini FtsZ ilipelekea kuwekwa kipaumbele kwa mgombea T3995. Katika utafiti mwingine, QSAR na structure-based screening zilichagua demethoxycurcumin inayolenga protini ya utando wa nje OmpW ya A. baumannii.
Uthibitishaji kwa mutant yenye upungufu wa OmpW ni wa thamani hasa katika kupima uhusiano wa shabaha uliotabiriwa. Udhibiti wa kijeni au wa kimolekuli wa aina hii hutoa taarifa za mechanism zenye nguvu zaidi kuliko hitimisho la “kiwanja kiliua bakteria” pekee.
Mifano ya uthibitishaji wa in vivo
Mapitio yanatoa mifano ya preclinical kama ufanisi wa P12 katika modeli ya jeraha la S. aureus kwa panya na sumu ndogo katika viungo vikuu hadi 400 mg/kg; ufanisi wa EME7(7) katika modeli ya pneumonia ya A. baumannii kwa panya bila kusababisha jeraha la figo; na shughuli za AMP-24 na AMP-29 katika modeli za maambukizi ya ngozi na mapafu.
Hizi si tafiti za kliniki kwa binadamu. Mgombea mwenye ufanisi katika modeli ya panya lazima atathminiwe kando kwa ufyonzwaji, usambazaji, metabolism, dozi, sumu na pathophysiology ya binadamu.
Mfano wa Halicin
Halicin ni molekuli yenye muundo tofauti ambayo shughuli yake ya antibakteria ilipewa kipaumbele baada ya maktaba iliyopo ya molekuli kuchunguzwa upya kwa deep learning. Chanzo kinataja shughuli yake ya in vitro dhidi ya wigo mpana wa bakteria na ufanisi wake katika modeli za panya za C. difficile na A. baumannii yenye pan-resistance.
Mfano huu unaonyesha kwamba AI si lazima itafute tu miundo inayofanana na antibiotiki zilizopo, bali inaweza pia kuzipa kipaumbele scaffolds tofauti za kikemia. Hata hivyo, mfano wa halicin haumaanishi kwamba kila molekuli inayopatikana kwa AI itafikia kwa mafanikio maendeleo ya kliniki.
Hit rate inaweza kuongezeka kwa kiasi gani?
| Mbinu | Nafasi ya kuanzia / wagombea | Matokeo ya majaribio | Kikomo cha tafsiri |
|---|---|---|---|
| D-MPNN, B. cenocepacia | %0,87 hit katika misombo 29.537 ya mwanzo; kisha virtual screening ya dawa za FDA na bidhaa asilia 224.205 | Takriban %26 na %12 hit katika wagombea waliochaguliwa | Matokeo ya maabara ya subset ya wagombea waliochaguliwa |
| Transfer-learning GNN | >1 bilioni molekuli za virtual | %54 shughuli ya E. coli katika wagombea waliopimwa kimajaribio | Haimaanishi kwamba %54 ya molekuli bilioni moja zina shughuli |
| Latent diffusion AMP | Wagombea 40 waliotengenezwa | 25/40 (%62,5) shughuli ya antibakteria au antifungal | In vitro hit; si mafanikio ya kliniki ya dawa |
| AMPlify | Peptidi 16 zilizotengenezwa kutoka wagombea 101 | AMP mpya 4 zilizo active; %25 hit katika zilizotengenezwa | Ni mahususi kwa muktadha wa ugunduzi wa peptidi |
Kwa nini AI inayoelezeka ni muhimu?
Nguvu kubwa ya utabiri wa modeli inaweza isieleze ni sifa gani ya kimolekuli inayosababisha shughuli. Zana za AI inayoelezeka kama SHAP zinaweza kufanya mchango wa amino acid, molecular fragment, sifa ya physicochemical au input nyingine katika uamuzi wa modeli uonekane.
Chanzo kinataja katika mfano wa LLAMP kwamba umuhimu wa mabaki ya amino acid kama tryptophan, lysine na phenylalanine katika shughuli ya AMP ulitambuliwa kwa uchanganuzi wa interpretability na taarifa hii ikatumiwa katika optimization ya peptidi.
Hata hivyo, attribution ya feature si ushahidi wa majaribio wa causality. Ikiwa feature kweli ni sehemu ya mechanism ya athari lazima itathminiwe kwa uthibitishaji huru wa kibaolojia.
Ramani ya kazi za kisayansi za takwimu za chanzo
| Kundi la takwimu | Maudhui ya kisayansi | Namna inayofaa ya kuieleza upya kwa Verianla |
|---|---|---|
| Takwimu 1–2 | Mifano ya compound–protein interaction na meta-learning | Maelezo ya dhana ya utabiri wa bioactivity kwa AI |
| Takwimu 3–7 | Utambuzi wa BGC, metagenomic assembly, utabiri wa muundo na workflow | Mchoro wa mchakato kutoka jenomu hadi BGC |
| Takwimu 8–12 | AMP, D-MPNN, pre-training, ultra-large screening na utabiri wa fenotipu | Mtiririko wa virtual screening na kuweka vipaumbele kwa wagombea |
| Takwimu 13–20 | GNPS, SIRIUS, UmetaFlow na dereplication inayotegemea MS | Workflow kutoka spectrum hadi mgombea wa molekuli |
| Takwimu 21–24 | Metabolomiki–cheminformatics na isolation lengwa | Mtiririko kutoka sampuli hadi feature ya uchanganuzi na isolation lengwa |
| Takwimu 25–26 | Uzalishaji wa AMP kwa ML na latent diffusion | Ubunifu wa peptidi → kuchuja → mstari wa uthibitishaji |
Matokeo yanayoungwa mkono na utafiti
Mapitio yanaunga mkono kwamba AI inaweza kupunguza nafasi ya wagombea katika hatua nyingi za ugunduzi wa bidhaa asilia na antibakteria, kuzipa kipaumbele BGC katika makusanyo makubwa ya jenomu, kuboresha utabiri wa bioactivity na miundo ya molekuli, kuharakisha dereplication, na katika baadhi ya tafiti zilizochaguliwa kutoa wagombea wenye hit rate kubwa za kimajaribio.
Pia yanaonyesha kwamba kwa kutumia pamoja data ya genomiki, metabolomiki na mass spectrometry, uhusiano thabiti zaidi unaweza kujengwa kati ya uwezo wa biosintesi katika jenomu na molekuli ya kikemia inayozingatiwa.
Chanzo pia kinaunga mkono kwamba baadhi ya wagombea wa antimicrobial waliopewa kipaumbele na AI hawakuishia katika hatua ya in silico pekee; kuna mifano ya uthibitishaji iliyofikia shughuli ya in vitro, cytotoxicity/hemolysis, mechanism ya shabaha na modeli za maambukizi ya panya.
Matokeo ambayo utafiti hauungi mkono
Mapitio hayathibitishi kwamba AI imetatua tatizo la uendelezaji wa antibiotiki au kwamba accuracy/AUC ya juu ya modeli inamaanisha antibiotiki mpya yenye mafanikio ya kliniki.
Hit rate zilizo juu ya %50 katika chanzo si kiwango cha jumla cha mafanikio kwa mifumo yote ya AI, maktaba zote za kikemia au bakteria wote. Ni matokeo yaliyochaguliwa ya uthibitishaji wa kimajaribio kutoka tafiti tofauti.
Ufanisi katika modeli za wanyama si ufanisi wa kliniki kwa binadamu. Thamani ya in vitro MIC haibaini dozi ya binadamu. Uzalishaji wa molekuli au peptidi haumaanishi idhini ya dawa.
Kwa kuwa mapitio hayaripoti uteuzi rasmi wa systematic literature wala tathmini ya risk-of-bias, haiwezi kuhitimishwa kwamba mifano ya mafanikio iliyoripotiwa inawakilisha utendaji wa wastani wa fasihi yote ya ugunduzi wa AI–antibakteria.
Katika sehemu ya hitimisho ya chanzo pia inaelezwa kwamba reproducibility ya modeli, ukosefu wa benchmark zilizosanifishwa, publication bias kuelekea matokeo chanya na matatizo ya ubora wa data yanaweza kufanya utendaji wa AI uonekane wa matumaini zaidi kuliko ulivyo.
Ni hatua gani zinahitajika siku zijazo?
Mtazamo wa baadaye wa chanzo unalenga seti kubwa na zilizoratibiwa vizuri za data, ushirikishaji wa wazi wa modeli/kodi, benchmark zilizosawazishwa, foundation models, upimaji bora wa kujiamini wa out-of-distribution, ujumuishaji wa data nyingi za genomiki–transkriptomiki–metabolomiki na kuunganisha kwa karibu utabiri wa AI na uthibitishaji wa kimajaribio.
Hasa ili kuziba pengo kati ya shughuli ya in vitro na ufanisi wa kliniki, data za pharmacokinetics, pharmacodynamics, usambazaji wa tishu, kinga ya mwenyeji na usalama wa in vivo zinapaswa kuingizwa kwa utaratibu zaidi katika modeli za utabiri za baadaye.
Maelezo ya Chanzo na Mbinu
Utafiti asilia: Combating Antibacterial Resistance: The Integrative Role of Artificial Intelligence in Bio-Based Product Development
Waandishi: Renuka Gudepu; Swapna Sirikonda; Ravinaik Banoth; Praveen Kumar Annagowni; Swati Dahariya; Aditya Velidandi.
Mwandishi anayewasiliana: Aditya Velidandi.
Taasisi: Department of Microbiology, Pingle Government College for Women (A), Warangal; Department of Pharmaceutics, School of Pharmacy, Anurag University, Hyderabad; Department of Mechanical Engineering, St. Martin's Engineering College, Secunderabad; Department of Pharmaceutical Sciences, Jawaharlal Nehru Technological University, Anantapur; Department of Biochemistry, School of Life Sciences, University of Hyderabad; Department of Biotechnology, Vaagdevi Degree and P.G. College, Warangal, India.
Jarida: Antibiotics.
Mchapishaji: MDPI, Basel, Switzerland.
Taarifa za uchapishaji: 2026; juzuu 15; toleo 5; makala 478. Tarehe ya uchapishaji: 8 May 2026.
DOI: 10.3390/antibiotics15050478
Aina ya chanzo: Makala ya Review iliyopitiwa na wataalamu na yenye ufikiaji wazi. Kwa kuwa makala haina mbinu tofauti ya systematic literature search, mtiririko wa PRISMA au itifaki rasmi ya inclusion/exclusion, katika maudhui ya Verianla imechukuliwa kama mapitio ya kimasimulizi/mapana.
Leseni: Creative Commons Attribution (CC BY).
Wigo wa chanzo: Mzigo wa AMR; taratibu za molekuli za usugu; vikwazo vya madarasa ya antibiotiki yaliyopo; vikwazo vya ugunduzi wa jadi wa bidhaa asilia; mbinu za ML/DL; BGC mining inayosaidiwa na AI; utabiri wa muundo na shughuli za molekuli; virtual screening; dereplication; metabolomiki na cheminformatics; metabologenomics; ubunifu wa AMP unaotegemea modeli generative; uthibitishaji wa in vitro na in vivo.
Jaribio jipya katika chanzo: Hakuna. Makala inasintetiza matokeo ya tafiti zilizochapishwa hapo awali.
Data mpya: Haikuzalishwa wala kuchanganuliwa.
Bodi ya maadili: Haitumiki.
Ridhaa yenye taarifa: Haitumiki.
Ufadhili: Hakuna ufadhili wa nje uliopokelewa.
Mgongano wa maslahi: Waandishi hawakuripoti mgongano wa maslahi.
Michango ya waandishi: Conceptualization Renuka Gudepu na Swapna Sirikonda; rasimu ya kwanza, review/editing na visualization waandishi wote sita; supervision ilifanywa na Aditya Velidandi.
Tamko la zana ya uandishi: Waandishi walisema walitumia Grammarly kuboresha usomaji na muundo wa sentensi; walipitia na kuhariri matokeo wenyewe na wanawajibika kikamilifu kwa maudhui yote ya uchapishaji.
Dokezo la epidemiolojia ndani ya chanzo: Kauli ya takriban vifo milioni 4,95 katika Abstract imetafsiriwa katika maandishi ya Verianla kwa utofautishaji sahihi zaidi wa Jedwali 1: takriban vifo milioni 4,95 vimeripotiwa kuhusishwa na AMR, huku takriban vifo milioni 1,27 vikihusishwa moja kwa moja na maambukizi sugu. Vipimo hivi viwili si visawe.
Vikwazo vikuu vya kimetodolojia: Chanzo hakiripoti methodology rasmi ya systematic review. Mifano iliyojumuishwa ni heterojeni sana kwa usanifu wa modeli, chanzo cha data, jukumu, metrika, kiwango cha uthibitishaji na eneo la tiba. Baadhi ya mifano ya kimetodolojia haitoki moja kwa moja katika ugunduzi wa antibakteria bali katika fasihi pana ya bidhaa asilia na utabiri wa bioactivity. Kwa hiyo, thamani za utendaji haziwezi kuunganishwa kama matokeo ya pamoja ya meta-analysis.
Vikwazo vya AI vilivyotajwa na chanzo: Kutopatikana wazi kila wakati kwa kodi na modeli zilizofunzwa, ukosefu wa benchmark za kawaida, publication bias kuelekea matokeo chanya, annotation za bioactivity zilizo pungufu au zisizolingana, kuripotiwa kwa upungufu kwa hali za majaribio na rekodi zenye makosa au zilizorudiwa katika hifadhidata za umma hupunguza reproducibility na generalizability.
Mbinu ya uwasilishaji ya Verianla: Maudhui haya si tafsiri ya karibu ya sehemu ya abstract au conclusion ya makala asilia. Taratibu za AMR, vikwazo vya ugunduzi wa bidhaa asilia, familia za modeli za AI, BGC mining, virtual screening, dereplication, metabolomiki–cheminformatics, ubunifu generative wa AMP, kazi za kisayansi za Figure 1–26, metrika za utendaji, uthibitishaji wa kimajaribio na vikwazo vimegawanywa katika tabaka tofauti za kisayansi na kupangwa upya ndani ya muundo wa kufundishia wa Kiswahili.
Kikomo cha tafsiri: Utendaji wa AI au data za wagombea wa antibakteria zilizotolewa hapa si uchaguzi wa antibiotiki au pendekezo la matibabu kwa mgonjwa binafsi. Usahihi wa modeli, shughuli ya in vitro na ufanisi katika modeli za wanyama haviwezi kuchukua nafasi ya ufanisi wa kliniki kwa binadamu.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *