


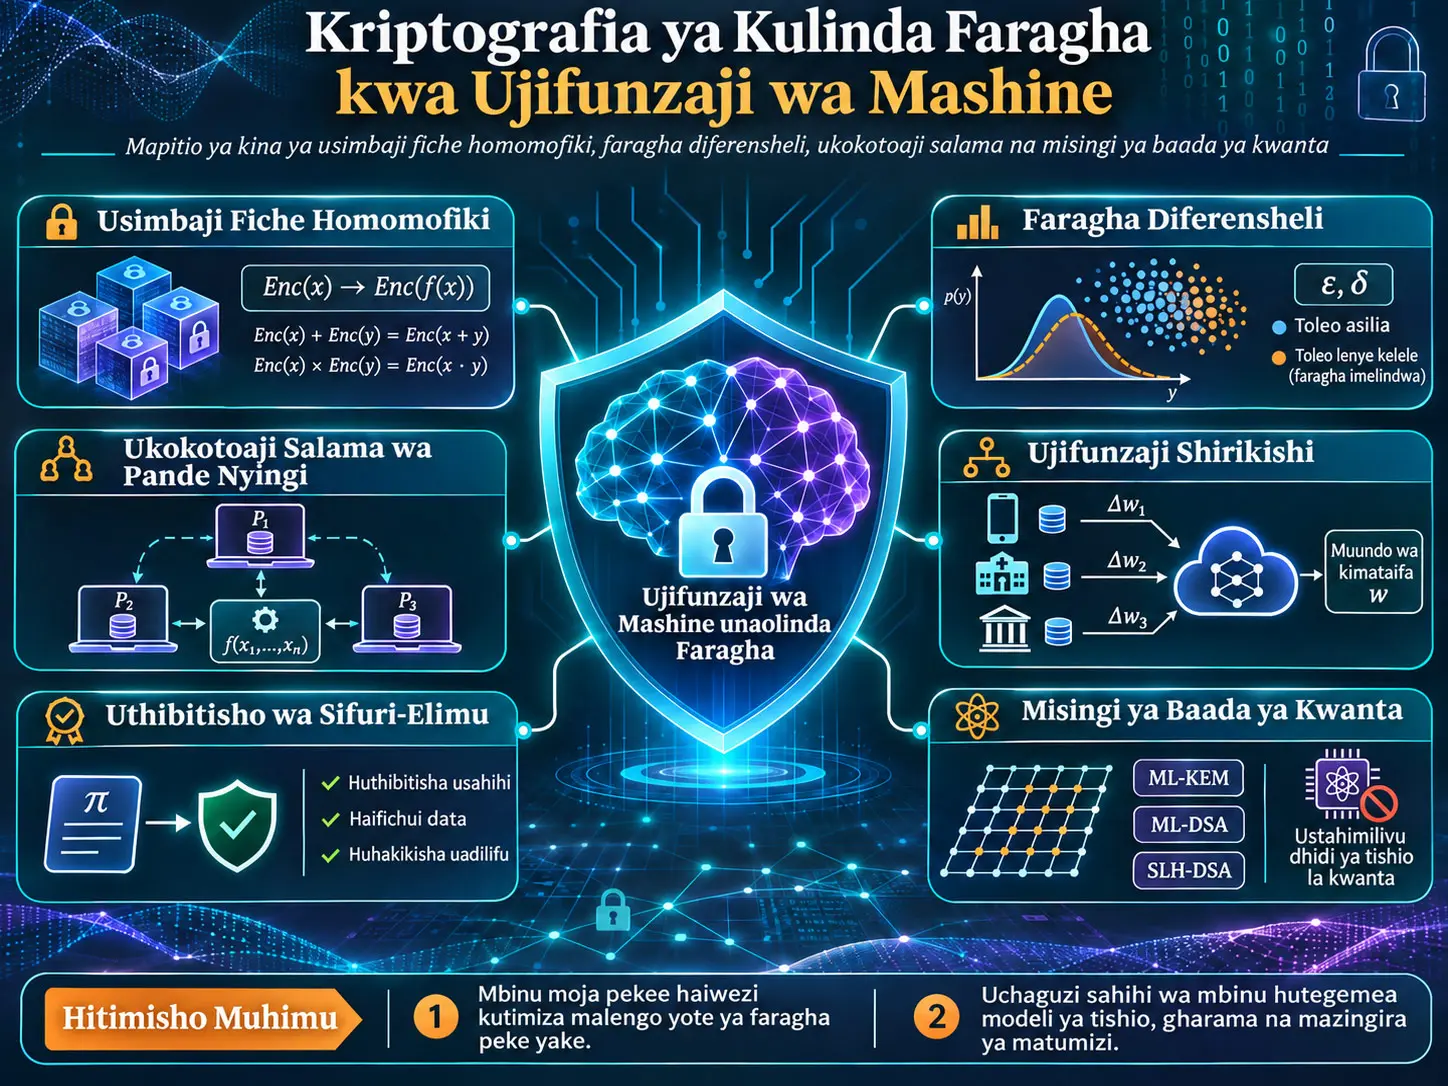
Ujifunzaji wa mashine unaolinda faragha (Privacy-Preserving Machine Learning, PPML) ni nyanja ya utafiti na uhandisi inayounganisha mbinu za kikriptografia, kitakwimu na kimfumo ili kulinda maudhui ya data, rekodi za mtu mmoja mmoja, vigezo vya modeli au uadilifu wa ukokotoaji wakati ujifunzaji wa mashine unafanywa juu ya data nyeti. Mapitio haya ya kina yanalinganisha katika mfumo mmoja usimbaji fiche homomofiki (Homomorphic Encryption, HE), faragha diferensheli (Differential Privacy, DP), ukokotoaji salama wa pande nyingi (Secure Multi-Party Computation, MPC), ujifunzaji shirikishi (Federated Learning, FL), uthibitisho wa maarifa-sifuri (Zero-Knowledge Proofs, ZKP), usimbaji fiche unaoweza kutafutwa, Oblivious RAM na kriptografia ya baada ya kwanta. Hitimisho kuu la utafiti ni kwamba hakuna mojawapo ya mbinu hizi inayoweza, peke yake, kutatua matatizo yote ya usiri, faragha, uadilifu na utumiaji; katika mifumo halisi, uchaguzi unapaswa kufanywa kulingana na mali inayolindwa, mfano wa tishio, bajeti ya ukokotoaji na mawasiliano, upotevu wa usahihi na dhana za uaminifu.
Moja ya tofauti muhimu katika mapitio ni kutotumia dhana za confidentiality na privacy kana kwamba ni kitu kilekile. Usiri wa kikriptografia, au confidentiality, hujaribu kuzuia data au thamani za kati za ukokotoaji zisionekane na upande usioidhinishwa. Privacy katika faragha diferensheli huhusu ni kwa kiwango gani, kutokana na matokeo yaliyochapishwa, inaweza kubainishwa ikiwa mtu fulani yumo katika mkusanyiko wa data au taarifa kuhusu mtu huyo inaweza kutolewa kwa kiasi gani. Usimbaji fiche homomofiki au MPC unaweza kuficha viingizo vya ukokotoaji, lakini hauwekei kikomo moja kwa moja kiasi cha taarifa kuhusu watu ambacho matokeo yaliyochapishwa yanaweza kufichua. Faragha diferensheli hufanya kinyume chake: inaweza kuweka kikomo kwenye makisio yanayoweza kufanywa kutokana na matokeo, lakini peke yake haizuii upande unaochakata data kuona ingizo ghafi. Kwa hiyo mifumo imara ya PPML mara nyingi huunganisha mbinu zaidi ya moja katika tabaka.
Utafiti pia unaonyesha kwamba takwimu za utendaji zinapaswa kusomwa kwa uangalifu. Usimbaji fiche homomofiki unaweza kutoa usiri thabiti wa ingizo lakini gharama ya ukokotoaji ni kubwa sana; MPC inaweza kufanya shughuli nyingi kwa usahihi na kwa ulinzi wa kikriptografia lakini huhitaji mawasiliano makubwa; faragha diferensheli ni nafuu zaidi kwa upande wa ukokotoaji lakini inaweza kusababisha kupungua kwa usahihi au manufaa; ujifunzaji shirikishi huwezesha data ghafi kutohamishwa hadi seva kuu, lakini gradient au masasisho ya modeli yanayoshirikiwa yanaweza yenyewe kuvuja taarifa; usimbaji fiche unaoweza kutafutwa unaweza kukubali uvujaji fulani, kama muundo wa ufikiaji au kurudiwa kwa swali, ili kutoa utafutaji wa haraka. Kwa hiyo upangaji mmoja wa jumla, bila muktadha, kama “mbinu salama zaidi” au “mbinu ya haraka zaidi” hauna maana ya kisayansi.
Sehemu ya baada ya kwanta ya mapitio ni muhimu sana, lakini mada inayochunguzwa hapa si kompyuta mpya ya kwanta wala algoriti mpya ya ujifunzaji wa mashine wa kwanta. Utafiti unasisitiza kwamba kompyuta ya kwanta iliyo kubwa vya kutosha na inayostahimili hitilafu itatishia, kupitia algoriti ya Shor, mifumo ya funguo za umma inayotegemea factoring au discrete logarithm kama RSA, Diffie–Hellman na kriptografia ya mikunjo ya elliptic; kwa upande mwingine, usimbaji fiche wa ulinganifu, faragha diferensheli, secret-sharing ya nadharia ya taarifa na usimbaji fiche homomofiki unaotegemea lattice haviathiriki kwa namna hiyo hiyo. Viwango vya ML-KEM, ML-DSA na SLH-DSA vilivyochapishwa na NIST katika 2024 vinachunguzwa kama vipengele vya msingi vya mpito huu. Kauli “inayostahimili kwanta” hapa haimaanishi usalama kamili uliothibitishwa milele; inamaanisha usalama uliobuniwa chini ya dhana za sasa za kikriptografia dhidi ya mashambulizi ya kawaida na ya kwanta yanayojulikana.
Ujifunzaji wa Mashine Unaolinda Faragha ni Nini?
Ujifunzaji wa mashine unaolinda faragha ni familia ya mbinu inayounganisha kriptografia, takwimu na uhandisi wa mifumo ili kulinda data ghafi, rekodi za mtu mmoja mmoja, masasisho ya modeli au mchakato wa ukokotoaji dhidi ya washambuliaji waliobainishwa katika mfano wa tishio, huku ikijaribu kutumia thamani ya kitakwimu ya data inayohitajika kwa ujifunzaji wa mashine; hata hivyo PPML si algoriti moja, na kila mbinu ya PPML hulinda mali tofauti, dhidi ya mshambuliaji tofauti na kwa gharama tofauti.
Kwa nini kusema “data haitoki kwenye kifaa” peke yake si dhamana ya faragha?
Hoja ya kuanzia ya utafiti ni kwamba kutoshiriki data nyeti moja kwa moja peke yake haitoshi. Hata kama hospitali haitumi picha za wagonjwa kwenye seva kuu, benki inashiriki tu masasisho ya modeli au kibodi ya simu inatuma gradient pekee, uwakilishi huu wa kati unaweza kubeba taarifa kuhusu data. Mashambulizi ya membership inference yaliyoelezwa katika mapitio hujaribu kukadiria kutokana na tabia ya modeli ikiwa rekodi fulani ilikuwamo katika mkusanyiko wa data wa mafunzo. Mashambulizi ya gradient inversion yanaweza hata kufikia kujenga upya picha za mafunzo na lebo kutoka kwenye gradient zilizoshirikiwa.
Kwa hiyo katika PPML swali la kwanza si “data iko kituoni au kwenye kifaa?” bali ni “Mshambuliaji anaweza kuona taarifa gani na anaweza kutoa nini kutokana nayo?”. Ulinganisho wote wa kiufundi katika utafiti chanzo umejengwa juu ya mtazamo huu wa mfano wa tishio.
Kwa nini mfano wa tishio huja kabla ya uchaguzi wote wa kiufundi?
Dai la usalama au faragha halina maana bila kufafanua mshambuliaji anaweza kufanya nini. Chanzo kinatofautisha madaraja mawili makuu ya washambuliaji wa kikriptografia. Mshambuliaji mwaminifu-kiasi (semi-honest au honest-but-curious) hufuata hatua za itifaki kwa usahihi lakini hujaribu kutoa taarifa za ziada kutoka kwenye ujumbe anaouona. Mshambuliaji hasidi/amilifu (malicious) anaweza kupotoka kutoka kwenye itifaki, kutuma ujumbe bandia, kuharibu ukokotoaji au kusitisha itifaki kwa namna ya kupata taarifa.
Mhimili wa pili ni corruption threshold, yaani ni pande ngapi mshambuliaji anaweza kutwaa na kuzifanya zishirikiane. Katika itifaki za MPC, kusema tu “kuna pande tatu” si maelezo ya usalama; kwa mfano, ikiwa inadhaniwa kwamba angalau pande mbili hazitafanya njama kwa siri, dhana hii ya kiutendaji lazima iweze kutetewa pia katika ulimwengu halisi.
| Aina ya dhamana | Wazo la msingi | Mfano wa kawaida | Kikomo muhimu |
|---|---|---|---|
| Usalama wa kihesabu | Inadhaniwa tatizo fulani la kihisabati haliwezi kutatuliwa kwa muda wa kawaida. | HE, ML-KEM, ML-DSA | Usalama hutegemea maendeleo katika cryptanalysis na nguvu ya ukokotoaji. |
| Usalama wa kinadharia wa taarifa / usio na masharti | Hata kama nguvu ya ukokotoaji ya mshambuliaji haina kikomo, chini ya dhana fulani hawezi kupata taarifa. | Baadhi ya miundo ya secret-sharing | Kwa kawaida dhana za kimuundo kama honest-majority huhitajika. |
| Faragha ya kitakwimu | Uwezo wa kutofautisha usambazaji wa matokeo kutoka kwenye mikusanyo jirani ya data huwekewa kikomo. | Faragha diferensheli | Kuna gharama ya usahihi/manufaa na bajeti ya faragha inayokua kwa composition. |
Kwa kweli nini kinalindwa: ingizo, matokeo, modeli au uadilifu wa ukokotoaji?
Usiri wa ingizo ni hali ambapo seva au pande nyingine hazioni data inayoingia kwenye ukokotoaji, kama picha ya mgonjwa, rekodi ya kifedha au swali la faragha. Jukumu kuu la usimbaji fiche homomofiki na MPC liko katika tabaka hili.
Faragha ya matokeo inahusu kiasi cha taarifa ambacho modeli au takwimu iliyochapishwa hufichua kuhusu watu katika data ya mafunzo. Faragha diferensheli inalenga tatizo hili. Hata matokeo yaliyokokotolewa kikamilifu kwa njia ya kikriptografia hayatakuwa na faragha ya matokeo ikiwa yanafichua taarifa nyingi sana kuhusu mtu.
Usiri wa modeli pia ni mali tofauti. Mteja anaweza kutotaka kutuma data yake ya faragha kwa seva; wakati huo huo seva inaweza kutotaka mteja achukue uzito wa modeli yake. Baadhi ya itifaki salama za inference hulenga hitaji hili la usiri wa pande mbili.
Uadilifu (integrity) ni tofauti na faragha. Seva kutoweza kuona ingizo haimaanishi ilifanya ukokotoaji kwa usahihi. Kwa hiyo mbinu kama uthibitisho wa maarifa-sifuri hukamilisha HE au MPC inayotoa usiri kwa swali “je, ukokotoaji ulifanywa kweli kama ulivyoelezwa?”.
Gharama ya faragha inalipwa kutoka kwenye rasilimali gani?
Moja ya mifumo muhimu zaidi ya mapitio inaonyesha kwamba mbinu tofauti huhamishia gharama kwenye rasilimali tofauti. HE hutumia hasa muda wa ukokotoaji na kumbukumbu. MPC hubadilisha ukokotoaji kuwa mawasiliano ya mtandao. Faragha diferensheli hulipia gharama kupitia usahihi wa modeli au manufaa ya kitakwimu. Ujifunzaji shirikishi hupunguza uhamishaji wa data lakini, kwa sababu ya masasisho mengi ya modeli, huleta gharama ya mawasiliano na utofauti wa wateja. Usimbaji fiche unaoweza kutafutwa unaweza kukubali wasifu fulani wa uvujaji ili kupata kasi.
Usimbaji Fiche Homomofiki Huendesha Vipi Ujifunzaji wa Mashine Juu ya Data Iliyosimbwa?
Usimbaji fiche homomofiki ni njia ya ukokotoaji wa kikriptografia inayoruhusu seva kufanya shughuli za kihisabati juu ya thamani zilizosimbwa bila kuona data wazi au funguo ya siri, na kuruhusu matokeo yaliyosimbwa kutafsiriwa tu na mwenye funguo aliyeidhinishwa; faida yake kuu katika ujifunzaji wa mashine ni kutoa usiri wa ingizo usiohitaji mwingiliano kwenye seva moja isiyoaminika, huku hasara kuu ikiwa gharama kubwa sana ya arithmetiki na kumbukumbu ikilinganishwa na ukokotoaji wa plaintext.
Inawezekanaje kufanya ukokotoaji juu ya data iliyosimbwa?
Katika usimbaji fiche wa kawaida, ili kukokotoa juu ya data, mara nyingi data hutafsiriwa kwanza. Lengo la usimbaji fiche homomofiki ni kuondoa ulazima huu. Mteja husimba data \(x\) na kuzalisha \(Enc(x)\). Seva, bila kujua funguo ya siri, hutathmini fungsi fulani \(f\) katika eneo lililosimbwa:
\[ Eval(f, Enc(x)) \rightarrow Enc(f(x)) \]
Mteja anapotafsiri matokeo:
\[ Dec(Enc(f(x))) \approx f(x) \]
hupata. Uwakilishi huu si mlinganyo mpya wa utafiti; ni muhtasari wa dhana unaofundisha kuhusu ukokotoaji homomofiki. Katika skimu za namba kamili kama BFV na BGV, lengo ni arithmetiki sahihi; katika CKKS namba halisi na changamani hukodishwa kwa ukaribu, hivyo kunaweza kuwa na kosa dogo linalodhibitiwa katika matokeo.
Kwa nini LWE na RLWE ni za msingi sana?
Mifumo mingi ya kisasa ya HE katika mapitio hupata usalama kutoka kwa matatizo ya lattice yanayotegemea Learning With Errors (LWE; kujifunza kwa makosa) au matoleo yake ya ring/module. Hisia ya msingi ya kufundishia ni kuingiza kosa dogo lakini lililochaguliwa kwa uangalifu ndani ya uhusiano wa mstari.
Ingawa haijatolewa kama mlinganyo wazi katika chanzo, uandishi wa kawaida wa dhana ya LWE unaweza kuonyeshwa hivi:
\[ \mathbf{b}=\mathbf{A}\mathbf{s}+\mathbf{e}\pmod q \]
Hapa \(\mathbf{A}\) ni muundo wa umma, \(\mathbf{s}\) ni taarifa ya siri na \(\mathbf{e}\) ni neno dogo la kosa; \(q\) ni modulus. Ingawa mshambuliaji anaona \(\mathbf{A}\) na \(\mathbf{b}\), kosa hufanya tatizo la kurejesha \(\mathbf{s}\) kuwa gumu zaidi. Mlinganyo huu si ufafanuzi kamili wa itifaki ya ML-KEM au CKKS; umetolewa tu kufundisha hisia ya msingi ya kihisabati ya familia ya LWE.
Katika skimu zinazotegemea RLWE hutumiwa ringi za polinomu badala ya skala au vekta za kawaida. Muundo huu ni muhimu kwa usalama na pia kwa kufunga thamani nyingi ndani ya ciphertext moja.
Tofauti kati ya BGV, BFV, CKKS na TFHE ni nini?
| Skimu | Eneo asilia la data | Arithmetiki | Tabia ya bootstrapping | Jukumu la kawaida katika ujifunzaji wa mashine |
|---|---|---|---|---|
| BGV | Namba kamili za modulari | Sahihi, ufungashaji wa SIMD | Leveled; husasishwa inapohitajika | Tathmini ya polinomu, takwimu |
| BFV | Namba kamili za modulari | Sahihi, ufungashaji wa SIMD | Leveled; husasishwa inapohitajika | Inference ya modeli ya namba kamili |
| CKKS | Namba halisi/changamani za kukaribia | Ya kukaribia, ufungashaji wa SIMD | Mbinu mbalimbali zinazotegemea upunguzaji modulari wa kukaribia | Inference ya mtandao wa neva wa kina na transformer |
| TFHE | Biti / namba kamili ndogo | Inayolenga Boolean au lookup-table | Bootstrapping ya haraka sana ya gate-by-gate | Ulinganisho, mti wa maamuzi, fungsi zisizo za mstari |
Chanzo kinaeleza kwamba thamani za kawaida za ring dimension \(N\) ziko takriban katika safu ya \(2^{13}\)–\(2^{17}\), na katika ufungashaji wa SIMD zinaweza kutumika takriban slot \(2^{12}\)–\(2^{16}\) za plaintext. Namba hizi si vigezo vilivyowekwa kwa kila matumizi; hubadilika kulingana na kiwango cha usalama, kina cha saketi na uchaguzi wa maktaba.
Kwa nini kuna “noise” ndani ya ciphertext na kwa nini inaongezeka?
Katika mifumo ya usimbaji fiche inayotegemea lattice, kosa au noise si kasoro isiyotakiwa tu; ni sehemu ya usalama. Hata hivyo, uongezaji homomofiki na hasa uzidishaji husababisha kosa hili ndani ya ciphertext kuongezeka. Kosa likivuka kikomo fulani, utafsiri sahihi unaweza kushindwa. Kwa hiyo si tu ni shughuli gani za kihisabati programu homomofiki inafanya iliyo muhimu, bali pia ina uzidishaji mingapi mfululizo.
Katika jedwali la alama la chanzo, \(Q\) huwakilisha ciphertext modulus na jinsi mnyororo wa modulus unavyoamua kina cha uzidishaji kinachopatikana; \(L\) huwakilisha multiplicative depth inayoweza kutumika kabla ya kuhitaji bootstrapping. Mtandao wa kina zaidi unamaanisha uzidishaji zaidi na hivyo matumizi zaidi ya noise-budget.
Bootstrapping ni nini?
Bootstrapping ni mchakato wa kutathmini kwa homomofiki mzunguko wa kutafsiri wenyewe juu ya ciphertext ambayo noise yake imeongezeka ili kuzalisha ciphertext mpya yenye noise ndogo. Mchakato huu huwezesha mpito kutoka HE ya “leveled”, inayounga mkono kina kidogo cha uzidishaji, kwenda fully homomorphic encryption inayoruhusu kinadharia ukokotoaji wa kina kisicho na kikomo.
Hata hivyo, bootstrapping ni mojawapo ya shughuli ghali zaidi za HE. Chanzo kinasisitiza kwamba miundo ya gharama ya familia za CKKS na TFHE ni tofauti. CKKS hupata throughput ya juu kwa kufunga vekta kubwa za namba halisi. TFHE, kwa upande mwingine, hulenga latency ndogo ya shughuli moja katika biti moja moja au namba kamili ndogo kwa kutumia lookup table inayoweza kuratibiwa na mbinu ya gate-level bootstrapping.
Chanzo kinaripoti matokeo ya kihistoria kwa TFHE ambapo muda wa gate bootstrapping kwenye core moja ulipunguzwa hadi takriban 13 ms na funguo ya bootstrapping hadi takriban 16 MB. Thamani hii si utendaji wa sasa wa kila matumizi ya TFHE; ni matokeo ya marejeleo yaliyoripotiwa na utafiti maalum uliopitiwa katika mapitio.
Kwa nini CKKS bootstrapping ni muhimu hasa katika ujifunzaji wa mashine?
Kwa kuwa CKKS inaweza kuchakata thamani halisi na changamani kwa kukaribia, inaendana kwa kawaida zaidi na shughuli za namba za fixed-point za mitandao ya neva. Katika njia ya kawaida ya CKKS bootstrapping hutumiwa mabadiliko ya mstari yanayoitwa CoeffToSlot na SlotToCoeff pamoja na polinomu zinazotekeleza upunguzaji modulari kwa kukaribia. Katika tafiti za karibuni zilizotajwa na chanzo, utenganishaji wa sehemu wa CoeffToSlot umepunguza ugumu; mbinu za level-conserving rescaling zimeweza kuongeza throughput kwa takriban %20–35 chini ya vigezo vinavyofanana.
Mapitio pia yanajadili mbinu za bootstrapping zenye kina kidogo zinazotegemea roots-of-unity, miundo ya blind-rotation kama PaCo na mbinu za functional bootstrapping. Functional bootstrapping haisasishi ciphertext tu; inaweza pia kutumia, katika shughuli hiyo hiyo, fungsi iliyofafanuliwa kwa lookup table. Chanzo kinataja utafiti unaoripoti takriban 0,72 ms kwa kila thamani kwa amortized functional bootstrapping kwenye CKKS kwa lookup table ya biti nane; thamani hii imeripotiwa kuwa takriban oda tatu za ukubwa haraka kuliko mbinu ya DM/CGGI na takriban mara 6,8 haraka kuliko mbinu yenye mipaka zaidi ya amortized functional bootstrapping inayotegemea BFV. Haya ni matokeo ya fasihi yaliyoripotiwa chini ya mifumo na vigezo tofauti; si mgawo wa utendaji wa ulimwengu wote.
Kwa nini scheme switching iliibuka?
Skimu moja ya HE si bora kwa kila aina ya shughuli. CKKS hufanya arithmetiki kwa ufanisi kwenye vekta kubwa za namba halisi, wakati ulinganisho au shughuli za lookup zilizo za hatua zinaweza kuwa za kawaida zaidi katika miundo inayofanana na TFHE. Scheme switching humaanisha kufanya sehemu kubwa ya ukokotoaji kwa CKKS, kubadilika kwa muda kwenda uwakilishi unaotegemea biti wakati ulinganisho au activation kama ReLU inahitajika, kisha kurudi tena CKKS. Kwa njia hii kila tabaka la kihisabati linaweza kuendeshwa kwenye uwakilishi wa kikriptografia unaoweza kulitathmini kwa gharama ndogo.
Kuna maendeleo kiasi gani katika inference ya mtandao wa neva uliosimbwa?
| Mfumo | Mbinu | Modeli / data | Matokeo yaliyoripotiwa katika chanzo | Kikomo cha ulinganisho |
|---|---|---|---|---|
| CryptoNets | Leveled HE | CNN yenye kina kidogo / MNIST | Takriban %99 usahihi; takriban makadirio 51.000/saa throughput | Batch amortization ni kubwa, latency ya swali moja inaweza kuwa katika kiwango cha dakika. |
| RNS-CKKS ResNet-20 | Bootstrapped HE | ResNet-20 / CIFAR-10 | %92,43 usahihi; matokeo sawa na modeli ya plaintext kwa zaidi ya %98 ya viingizo; kiwango cha saa kwa kila picha | Hali za hardware na modeli ni za zamani/maalum. |
| Mbinu ya multiplexed convolution | Bootstrapped HE | ResNet-20/110 | Takriban kupungua kwa latency mara 4,7; kuboreka kwa zaidi ya oda mbili za ukubwa katika muda uliopunguzwa kwa amortization | Mpangilio tofauti wa majaribio. |
| NEXUS | HE isiyoingiliana | Kiwango cha BERT | Inference katika kiwango cha makumi ya sekunde na kupungua kwa bandwidth kwa mamia ya mara ikilinganishwa na baseline zinazoingiliana | Si benchmark iliyodhibitiwa dhidi ya mifumo mingine. |
| PUMA | MPC ya pande 3 | LLaMA-7B | Inference salama katika kiwango cha dakika | Si sawa moja kwa moja na mfumo wa HE-only. |
Jedwali hili halipaswi kutumiwa kujibu moja kwa moja swali “ipi ni haraka zaidi?”. Mifumo inayolenga throughput kama CryptoNets hufunga maelfu ya maswali katika slot za ciphertext moja ili kugawanya gharama iliyowekwa. Katika programu inayoingiliana, muda wa swali moja kufikia matokeo ndio muhimu. Chanzo kinasisitiza kwamba kuchanganya sehemu hizi mbili za uendeshaji kunaweza kufanya utendaji ulioripotiwa kupotosha hadi oda tatu za ukubwa.
Kwa nini modeli za transformer ni ngumu hasa kwa HE?
Ingawa tabaka za mstari katika mitandao ya convolutional zinafaa kiasi chini ya HE, shughuli za softmax, GELU, layer normalization, kugawanya na mzizi wa mraba katika usanifu wa transformer haziendani moja kwa moja na arithmetiki ya polinomu. Suluhisho hugawanywa katika makundi matatu makuu:
- Itifaki mseto zinazotathmini tabaka za mstari kwa HE na tabaka zisizo za mstari kwa MPC/secret sharing.
- Itifaki zisizoingiliana zinazoweka ukokotoaji wote ndani ya HE na kubadilisha softmax na fungsi zinazofanana kwa makadirio ya polinomu.
- Mbinu za ubunifu-shirikishi zinazofanya usanifu wa modeli urafiki kwa usimbaji fiche tangu mwanzo na kupunguza shughuli ghali zisizo za mstari.
Kwa hiyo katika ujifunzaji wa mashine uliosimbwa haitoshi kuharakisha kriptografia pekee; ubunifu wa pamoja wa usanifu wa modeli na uwakilishi wa kikriptografia unazidi kuwa muhimu.
Uharakishaji wa GPU, FPGA na ASIC hubadilisha nini?
Mapitio yanasisitiza kwamba arithmetiki ya HE mara nyingi huzuiwa zaidi na bandwidth ya kumbukumbu na uhamishaji wa data kuliko na idadi tupu ya vitengo vya ukokotoaji. Shughuli za Number-Theoretic Transform (NTT) na key-switching ni muhimu hasa. Kwa optimizasheni za memory-centric kwenye GPU, uharakishaji wa zaidi ya mara 100 umeripotiwa katika baadhi ya mzigo wa bootstrapping uliopunguzwa kwa amortization.
Programu za CPU ni za matumizi ya jumla na zinapatikana kwa urahisi, lakini zinaweza kugonga kikomo cha bandwidth ya kumbukumbu kwa haraka. GPU hutoa ulinganifu na bandwidth ya juu. FPGA zinaweza kubadilishwa kwa shughuli fulani za arithmetiki modulari kupitia njia za data zinazoweza kuratibiwa. ASIC zina uwezo wa utendaji wa juu zaidi lakini gharama za ubunifu na utengenezaji ni kubwa. Chanzo pia kinaonya kwamba sehemu kubwa ya tathmini za sasa za viongeza kasi zimefanywa kwenye modeli ndogo kiasi za convolutional kama CIFAR-10/ResNet-20; haiwezi kudhaniwa kwamba matokeo hayo hayo yanatumika moja kwa moja kwenye mzigo mkubwa wa transformer.
Uthibitisho wa maarifa-sifuri unafidia upungufu gani wa HE?
Usimbaji fiche homomofiki unaweza kuzuia seva kuona ingizo, lakini peke yake hauwezi kuthibitisha kwamba seva ilikokotoa matokeo sahihi. Seva hasidi inaweza kurudisha ciphertext iliyo na muundo sahihi lakini yenye thamani isiyo sahihi. Uthibitisho wa maarifa-sifuri huwezesha seva kuthibitisha kwamba ilifanya ukokotoaji fulani kwa usahihi bila kufichua data ya siri ya msingi.
Mapitio yanaeleza kwamba kazi kama zkCNN zimewezesha kutengeneza uthibitisho kwa utabiri wa convolutional-network na dai la usahihi bila kufichua data ya majaribio ya faragha au uzito wa modeli, na kazi mpya zaidi zimepanuka hadi mchakato wa mafunzo. Hata hivyo, kuthibitisha ukokotoaji mara nyingi ni ghali sana kuliko ukokotoaji wenyewe. Kwa kuwa kuunganisha HE na ZKP hujumlisha gharama za mifumo miwili ghali, mifumo ya sasa mara nyingi hujaribu kuthibitisha hatua ambazo uadilifu ni muhimu tu.
ε na δ Zina Maana Gani katika Faragha Diferensheli?
Faragha diferensheli ya \((\varepsilon,\delta)\) huweka kikomo kwa kiasi ambacho usambazaji wa matokeo ya mekanizimu ya nasibu inayofanya kazi kwenye mikusanyo miwili jirani ya data inayotofautiana kwa rekodi moja unaweza kutengana; \(\varepsilon\) inapokuwa ndogo, kutofautisha usambazaji kunakuwa kugumu zaidi na hivyo kulenga faragha yenye nguvu zaidi, huku \(\delta\) ikiwa neno la ziada linaloruhusu kikomo bora cha kuzidisha kuvukwa kwa uwezekano mdogo, na hakuna mojawapo ya vigezo hivi inayopaswa kutafsiriwa kama kikomo “salama peke yake” bila muktadha.
Ufafanuzi wa msingi wa kihisabati wa faragha diferensheli
Chanzo kinatoa ufafanuzi kwa maneno. Uandishi wake wa kawaida wa kihisabati unaweza kuonyeshwa hivi kwa madhumuni ya ufundishaji:
\[ \Pr[M(D)\in S] \leq e^{\varepsilon}\Pr[M(D')\in S]+\delta \]
Hapa:
- \(M\): ni mekanizimu ya nasibu.
- \(D\) na \(D'\): ni mikusanyo jirani ya data inayotofautiana katika rekodi moja ya mtu.
- \(S\): ni seti yoyote ya matokeo yanayowezekana.
- \(\varepsilon\): huweka kikomo kwa kiasi ambacho uwezekano wa matokeo unaweza kutofautiana kwa kuzidisha.
- \(\delta\): huruhusu uwezekano mdogo sana wa ziada wa kushindwa.
Ukosefu huu wa usawa haumaanishi “data ya mtu haiwezi kamwe kujulikana”. Maana sahihi zaidi ni kwamba kujumuishwa au kutojumuishwa kwa mtu katika mkusanyo wa data hubadilisha usambazaji wa matokeo ya mekanizimu kwa kiwango kilichowekewa kikomo. Chanzo kinaeleza katika jedwali la alama kwamba \(\delta\) kwa kawaida huchaguliwa kuwa ndogo sana kuliko \(1/n\); hapa \(n\) ni idadi ya rekodi katika mkusanyo wa data.
Kwa nini usahihi wa modeli unaweza kupungua ε inapokuwa ndogo?
Faragha diferensheli hupatikana katika mekanizimu nyingi za vitendo kwa kuongeza noise ya nasibu kwenye data au gradient. Kuhitaji noise zaidi kwa faragha yenye nguvu zaidi kunaweza pia kuharibu kwa kiasi fulani ishara muhimu ambayo modeli inajaribu kujifunza. Kwa hiyo mhimili mkuu wa gharama wa DP si muda wa CPU bali ni privacy–utility trade-off, yaani maafikiano kati ya faragha na manufaa.
Chanzo kinaonyesha katika Kielelezo cha 3 maeneo ya \(\varepsilon \leq 1\), \(1 < \varepsilon \leq 4\) na \(\varepsilon > 4\) kama maeneo ya kielelezo kwa faragha yenye nguvu, ya kati na dhaifu mtawalia. Grafu hii si data iliyopimwa na vikomo hivi havipaswi kusomwa kama mipaka ya kisheria au kisayansi ya ulimwengu wote kwa kila matumizi. Ujumbe mkuu wa kielelezo ni kwamba usanifu wa modeli, pretraining, mipangilio ya DP-SGD na ubora wa accounting vinaweza kubadilisha kwa kiasi kikubwa manufaa yanayopatikana kwa thamani ileile ya \(\varepsilon\).
Kwa nini Sensitivity, Δf, ni muhimu?
Unyeti (sensitivity, \(\Delta f\)) wa swali hufafanua ni kiasi gani zaidi matokeo ya swali yanaweza kubadilika ikiwa rekodi moja imebadilishwa. Kiwango cha noise hupangwa kulingana na ukubwa huu. Kuficha swali ambalo mtu mmoja anaweza kubadilisha matokeo yake kwa kiasi kikubwa kunahitaji noise zaidi kuliko swali ambalo mchango wa mtu tayari umewekewa kikomo.
Tofauti kati ya mekanizimu za Laplace na Gaussian
Mekanizimu ya Laplace inaweza kutoa \(\varepsilon\)-DP safi kwa kuongeza noise kulingana na unyeti wa L1. Mekanizimu ya Gaussian hufanya kazi na unyeti wa L2 na hutoa \((\varepsilon,\delta)\)-DP. Katika ujifunzaji wa kina, mekanizimu ya Gaussian ina jukumu kuu kwa sababu clipping ya gradient inaendana na jiometri ya L2.
DP-SGD hufanya kazi vipi?
Differentially Private Stochastic Gradient Descent (DP-SGD) huweka kikomo mchango wa gradient wa kila sampuli ya mafunzo hadi nora fulani, kisha huongeza noise ya Gaussian kwenye gradient iliyojumlishwa na kufuatilia upotevu wa jumla wa faragha wa hatua zote za mafunzo kwa privacy accountant.
Chanzo kinaeleza DP-SGD kwa maneno. Uandishi wa kawaida wa ufundishaji wa mekanizimu hukata kwanza gradient ya sampuli moja hivi:
\[ \bar{\mathbf{g}}_i=\mathbf{g}_i\cdot \min\left(1,\frac{C}{\|\mathbf{g}_i\|_2}\right) \]
\(C\) ni per-example clipping norm. Ikiwa nora ya gradient ya sampuli ni ndogo kuliko \(C\), haibadiliki; ikiwa ni kubwa, mwelekeo wake huhifadhiwa huku ukubwa ukipunguzwa hadi \(C\). Hivyo mchango ambao rekodi moja inaweza kufanya kwenye sasisho huwekewa kikomo.
Kisha, kwa dhana:
\[ \tilde{\mathbf{g}} = \frac{1}{B} \left( \sum_{i=1}^{B}\bar{\mathbf{g}}_i + \mathcal{N}(0,\sigma^2 C^2 I) \right) \]
noise ya Gaussian inaweza kuongezwa. Hapa \(B\) ni ukubwa wa batch, \(\sigma\) ni kigezo kinachohusiana na kiwango cha noise/noise multiplier, \(C\) ni kikomo cha clipping na \(I\) ni matrisi ya utambulisho ya ukubwa unaofaa. Formula hii si matokeo mapya ya chanzo bali ni uwakilishi wa kawaida wa ufundishaji wa mekanizimu ya DP-SGD iliyoelezwa katika chanzo.
\(q\) katika jedwali la alama la chanzo ni sampling rate, yaani uwiano wa ukubwa wa batch unaotarajiwa kwa ukubwa wa mkusanyo wa data; \(T\) huwakilisha mara ngapi mekanizimu imeundwa pamoja, kwa mfano ni hatua ngapi za mafunzo zimefanywa. \(C\), \(\sigma\), \(q\) na \(T\) si mipangilio huru kutoka kwa nyingine; zote hushiriki katika hesabu ya mwisho ya privacy budget.
Privacy amplification ina maana gani?
Kutokujumuishwa kwa kila rekodi katika kila hatua ya mafunzo kunaweza kutoa faida ya faragha. Privacy amplification kupitia subsampling humaanisha kwamba kupungua kwa uwezekano wa mtu fulani kuhusishwa na mekanizimu kwa sababu ya sampuli ya nasibu hupunguza upotevu wa faragha unaofaa. Chanzo pia kinajadili matokeo ya amplification kupitia iteration na shuffling.
Kwa nini privacy accountant inahitajika?
Kuendesha mekanizimu ya DP mara moja si sawa na kuiendesha tena na tena katika makumi ya maelfu ya hatua za mafunzo. Kila matumizi hutumia kiasi fulani cha bajeti ya faragha. Kikomo rahisi zaidi cha composition ni:
\[ \varepsilon_{\mathrm{toplam}} \leq \sum_i \varepsilon_i, \qquad \delta_{\mathrm{toplam}} \leq \sum_i \delta_i \]
Hata hivyo, chanzo kinasisitiza kwamba hii inaweza kuwa ya tahadhari kupita kiasi kwa mafunzo marefu. Advanced composition, Rényi Differential Privacy, Gaussian Differential Privacy na accountant za namba zinazotegemea privacy-loss-distribution zinaweza kukokotoa mipaka mikali zaidi.
Maelezo haya ni muhimu katika vitendo: mifumo miwili inayotumia noise ileile inaweza kuripoti thamani tofauti za \(\varepsilon\) kwa sababu tu inatumia mbinu tofauti za accountant. Kwa hiyo kuandika tu “ε=...” haitoshi; lazima ijulikane ni accountant gani, modeli gani ya sampling na thamani gani ya \(\delta\) iliyotumiwa.
Kwa nini empirical privacy auditing inahitajika?
Accounting ya kihisabati hutoa kikomo cha juu kwa kudhani algoriti imeandikwa kulingana na spesifikesheni. Katika programu halisi, clipping iliyotekelezwa vibaya, kosa la sampling au tatizo la noise generator linaweza kuvunja dhamana hii. Ukaguzi wa faragha wa empiria hujaribu kupima angalau upotevu kiasi gani wa faragha mfumo halisi unaonyesha kwa kuongeza rekodi za canary kwenye mekanizimu na kutekeleza mashambulizi kama membership inference.
Ikiwa kikomo cha juu cha uchambuzi na kikomo cha chini cha empiria vinakaribiana, uchambuzi ni mkali na utekelezaji huenda ni sahihi. Ikiwa tofauti ni kubwa, uchambuzi unaweza kuwa mpana sana au utekelezaji unaweza kuwa na hitilafu. Chanzo kinasisitiza kwamba mbinu zinazowezesha canary nyingi kukaguliwa pamoja katika kukimbia moja kwa mafunzo hufanya ukaguzi huu uwe wa vitendo zaidi kwa mifumo ya uzalishaji.
Kwa nini faragha diferensheli ni ngumu zaidi katika LLM?
Modeli kubwa za lugha zinaweza kukariri mfuatano adimu au nyeti katika data ya mafunzo. DP hutoa ulinzi rasmi dhidi ya uvujaji huu, lakini kusasisha kikamilifu mabilioni ya vigezo kwa DP-SGD ni ghali na noise hutumiwa katika nafasi ya vigezo yenye vipimo vingi sana.
Suluhisho linalosisitizwa na mapitio ni kutofundisha modeli kutoka mwanzo kwenye data ya faragha, bali fine-tune tu modeli iliyofundishwa awali kwenye data ya umma kwa kutumia data nyeti. Mbinu za parameter-efficient kama Low-Rank Adaptation (LoRA) husasisha adapta ndogo tu, hivyo clipping na noise zinaweza kutumiwa kwenye kiwango cha vigezo milioni chache badala ya mabilioni.
Katika utafiti mmoja wa urekebishaji wa LLM shirikishi uliotajwa na chanzo, iliripotiwa kwamba katika kiwango cha \(\varepsilon=2\) na chini ya wateja milioni moja walioigwa, kushuka kwa usahihi kulihifadhiwa chini ya %2 na ongezeko la word-error-rate chini ya %7. Matokeo haya ni ya mfumo na hali maalum za majaribio; hayawezi kujumlishwa kama “LLM zote zenye ε=2 hupoteza %2”.
Ukokotoaji salama wa pande nyingi ni nini?
Secure Multi-Party Computation (MPC) huwezesha pande zisizoaminiana kikamilifu kukokotoa fungsi ya pamoja bila kufichua kwa kila mmoja viingizo vyao vya faragha. Tofauti na usimbaji fiche homomofiki, ukokotoaji haukusanywi kwenye seva moja ya ciphertext; data na ukokotoaji hugawanywa miongoni mwa pande.
Chanzo kinasisitiza mapokeo mawili ya msingi: Yao garbled circuits kwa saketi za Boolean na secret sharing kwa ukokotoaji wa arithmetiki. SPDZ ni mojawapo ya familia muhimu za itifaki zinazoweza kutoa usalama amilifu chini ya hali ya dishonest-majority. ABY3 ni mfumo madhubuti unaoweza kubadilisha kati ya uwakilishi wa arithmetic, Boolean na Yao sharing katika mazingira ya honest-majority ya pande tatu.
Oblivious transfer na Beaver triples hufanya nini?
Oblivious transfer (OT) huruhusu mpokeaji kujifunza ujumbe mmoja tu aliouchagua kutoka kwa ujumbe wa mtumaji, huku mtumaji asijue ni upi uliochaguliwa. OT extension hupanua idadi ndogo ya shughuli ghali za funguo za umma kuwa idadi kubwa ya shughuli za funguo za ulinganifu zilizo nafuu zaidi.
Beaver multiplication triples ni thamani nasibu zilizounganishwa kimahusiano ambazo hutengenezwa mapema ili kuharakisha uzidishaji katika MPC ya arithmetiki inayotegemea secret-sharing. Sehemu muhimu ya kazi nzito ya kikriptografia hufanywa katika hatua ya offline preprocessing; hatua ya online hutumia mahusiano haya yaliyotayarishwa ili kufanya kazi kwa kasi zaidi.
Kwa nini MPC ni nyeti zaidi kwa muunganisho wa mtandao kuliko HE?
MPC hubadilisha sehemu kubwa ya arithmetiki ghali ya public-key na shughuli nafuu za ndani, lakini huhitaji ubadilishanaji wa ujumbe mwingi kati ya pande. Hii inaweza kuwa na maana katika muunganisho wa kituo cha data wenye bandwidth ya juu na latency ndogo. Katika mitandao ya mabara tofauti au ya simu, round-trip latency inaweza kufanya itifaki hiyo hiyo iwe polepole zaidi sana.
Kwa hiyo chanzo kinahusisha uchaguzi kati ya HE na MPC zaidi na swali “ukokotoaji ndio ghali au mtandao ndio ghali?” kuliko swali “kriptografia ya ipi ni bora?”.
Kwa nini shughuli ya ulinganisho ni ghali kwa MPC katika ujifunzaji wa mashine?
Uzidishaji wa matrisi unaendana vizuri na arithmetic sharing, lakini shughuli kama ReLU, max-pooling na argmax zinahitaji ulinganisho. Kwa kuwa ulinganisho ni shughuli ya kiwango cha biti, ni ghali chini ya arithmetic sharing. Kwa hiyo mifumo ya kisasa inaweza kubadilika kutoka arithmetic representation kwenda uwakilishi wa Boolean au garbled-circuit, au kubadilisha fungsi nonlinear kwa ukadiriaji wa gharama ndogo.
Je, ujifunzaji shirikishi peke yake ni mbinu ya faragha?
Hapana. Ujifunzaji shirikishi huwezesha data ghafi kutotoka kwenye kifaa au taasisi, lakini masasisho ya modeli au gradient hutumwa kwa seva. Kama chanzo kinavyosisitiza wazi, FL peke yake si formal privacy guarantee; ni usanifu wa ujifunzaji uliosambazwa ambamo ulinzi kama HE, MPC, secure aggregation na DP unaweza kuwekwa.
Tofauti kati ya federesheni ya cross-device na cross-silo
Cross-device FL inaweza kujumuisha mamilioni ya wateja wenye rasilimali ndogo na ambao mara nyingi hawapo mtandaoni, kama simu. Hapa gharama ndogo ya mteja, uvumilivu wa dropout na ufanisi wa mawasiliano ni muhimu.
Cross-silo FL hujumuisha taasisi chache lakini zenye nguvu, kama hospitali au benki. Idadi ya pande ni ndogo, na mikusanyo ya data ni mikubwa na yenye thamani. Matumizi ya mifumo mizito zaidi ya HE au MPC yanaweza kuwa ya uhalisia zaidi katika mazingira haya.
Secure aggregation hufanya kazi vipi?
Secure aggregation inalenga kufanya seva ijifunze jumla pekee, si masasisho binafsi ya wateja. Hisia ya kihisabati ya ufundishaji ya pairwise-cancelling mask iliyoelezwa na chanzo inaweza kuonyeshwa hivi:
\[ m_i = u_i + \sum_{j>i}r_{ij}-\sum_{j<i}r_{ji} \]
Thamani zilizofichwa za wateja zinapojumlishwa:
\[ \sum_i m_i = \sum_i u_i \]
hupatikana; kwa sababu mask ileile ya \(r_{ij}\) huonekana kwa ishara chanya kwa mteja mmoja na hasi kwa mwingine, hivyo hujifuta katika jumla. Itifaki halisi huwa na mekanizimu za ziada kama dropout, malicious server, makubaliano ya funguo na secret sharing; milinganyo hii miwili hufundisha tu mantiki ya cancellation.
Katika mfano wa BatchCrypt, chanzo kinataja matokeo kwamba kufunga na kukadiria gradient kisha kuzisimba homomofiki kwa ujifunzaji shirikishi wa cross-silo kulitoa uharakishaji wa mafunzo mara 23–93 na kupungua kwa mawasiliano mara 66–100 ikilinganishwa na naive per-value encryption, huku upotevu wa usahihi ukibaki chini ya %1. Haya ni matokeo ya ulinganisho maalum.
Je, picha zinaweza kweli kurejeshwa kutoka kwenye gradient?
Fasihi ya gradient-inversion iliyotajwa katika mapitio inaonyesha kwamba hili linawezekana katika hali fulani. Mshambuliaji huboresha ingizo bandia ili gradient inayozalishwa ikaribiane na gradient halisi iliyoonwa. Tafiti za mwanzo zilifanikiwa kwa picha moja na mitandao midogo, huku mashambulizi ya baadaye yakipanua wigo kwa kutumia image priors, takwimu za batch-normalization na fungsi objective zilizoendelea zaidi.
Somo linalotokana na hili ni kwamba uwakilishi kuonekana “haueleweki” kwa macho ya binadamu si dhamana ya faragha. Ulinzi lazima utegemee mekanizimu rasmi.
Kwa nini FL + DP + usimbaji fiche hutumiwa pamoja?
Secure aggregation huzuia seva kuona sasisho la mteja mmoja lakini haiwekei kikomo kile modeli ya kimataifa iliyochapishwa inaweza kuvuja kuhusu wateja. User-level DP inalenga tatizo hili la pili. Homomorphic aggregation inaweza kuficha masasisho kwa njia ya kikriptografia kutoka kwa seva. Distributed noise generation inaweza kugawa noise ya DP miongoni mwa wateja bila kuhitaji seva moja inayoaminika kuiongeza.
Hata hivyo, kila tabaka huleta gharama mpya na trust assumption mpya. Usalama huamuliwa si na majina ya mbinu zilizotumiwa bali na dhana dhaifu zaidi katika pipeline yote.
Kwa nini faragha inaweza kugongana na Byzantine robustness?
Mteja hasidi anaweza kutuma sasisho la modeli lililotiwa sumu. Mbinu za robust aggregation kama Krum, coordinate-wise median au trimmed mean hujaribu kubaini michango isiyo ya kawaida kwa kukagua masasisho binafsi. Lakini secure aggregation au HE huficha kwa makusudi masasisho haya binafsi kutoka kwa seva.
Kwa hiyo mekanizimu ya privacy inaweza pia kuficha tabia ya mshambuliaji. Suluhisho ni kufanya takwimu robust ndani ya ukokotoaji uliosimbwa, kukubali robustness guarantee dhaifu zaidi, au kumtaka mteja kuthibitisha kwa ZKP kwamba sasisho lake la siri liko ndani ya mipaka fulani. Chanzo kinasisitiza hasa kwamba faragha yenye nguvu, robustness yenye nguvu na gharama ndogo haviwezi kupatikana kwa wakati mmoja bila gharama.
Kwa nini mbinu ya adapter hutumiwa katika LLM shirikishi?
Si jambo la vitendo kutuma modeli yenye mabilioni ya vigezo kwa simu na kuirudisha katika kila raundi. Pia huenda kifaa kisibebe optimizer state. Kwa hiyo chanzo kinaonyesha kama mbinu inayojitokeza kufundisha tabaka ndogo za LoRA/adapter juu ya public backbone iliyowekwa badala ya kufundisha modeli nzima kwa njia shirikishi. Mteja husasisha na kutuma adapta ndogo tu; hii hupunguza mawasiliano na pia ukubwa wa vigezo vitakavyowekewa noise chini ya DP.
Usimbaji fiche unaoweza kutafutwa hutatua nini?
Searchable Symmetric Encryption (SSE) huruhusu mteja kuhifadhi mkusanyo wa nyaraka zilizosimbwa kwenye seva isiyoaminika na kufanya maswali ya maneno muhimu yaliyosimbwa bila kutafsiri nyaraka kikamilifu. Lakini miundo yenye ufanisi ya SSE mara nyingi huvuja taarifa fulani za pembeni kama muundo wa ufikiaji, kurudiwa kwa swali au ukubwa wa matokeo.
Forward privacy na backward privacy ni nini?
Forward privacy inalenga kuzuia hati mpya iliyoongezwa kwenye hifadhidata kuhusishwa na token za utafutaji za zamani. Backward privacy imebuniwa ili nyaraka zilizofutwa zisifichuliwe tena na maswali ya baadaye. Tatizo muhimu la utafiti katika SSE inayobadilika ni kutoa dhamana hizi mbili pamoja na maswali tajiri na gharama ndogo.
Kwa nini shambulio la leakage-abuse ni muhimu?
Hata kama kiini cha kikriptografia cha algoriti ya SSE ni salama kinadharia, mshambuliaji anaweza kuona ciphertext zipi zimefikiwa, kama swali lilelile limerudiwa au ni matokeo mangapi yamerudishwa. Mashambulizi ya access-pattern hutumia seti za ufikiaji wa nyaraka; mashambulizi ya volume hutumia idadi ya matokeo; mashambulizi ya injection hujaribu kukadiria maneno halisi ya swali kwa kutumia mabadiliko yaliyosababishwa na nyaraka maalum zilizoingizwa na mshambuliaji.
Kwa hiyo katika SSE kauli “haikutafsiriwa” haimaanishi “hakuna taarifa iliyovuja”. Chanzo kinasisitiza kwamba usalama halisi unahitaji leakage profile ya scheme na taarifa za pembeni za mshambuliaji kutathminiwa pamoja.
ORAM hufanya nini?
Oblivious RAM (ORAM) huficha muundo wa ufikiaji kwa kulenga kufanya mifuatano miwili ya ufikiaji yenye urefu sawa isiweze kutofautishwa kihesabu kutoka kwa mtazamo wa seva. Path ORAM, kwa muundo wake wa mti, ni mojawapo ya miundo inayojulikana zaidi inayojaribu kutoa ulinzi huu kwa overhead ya bandwidth ya logarithmic.
Faragha hii yenye nguvu zaidi huja kwa gharama kubwa zaidi. SSE ni ya haraka lakini hukubali leakage; ORAM huficha muundo wa ufikiaji kwa nguvu zaidi lakini gharama ya uhamishaji na upangaji upya wa data huongezeka. Private Information Retrieval ipo katika sehemu nyingine hasa kwa maswali ya read-only.
Kompyuta za Kwanta Zinatishia Mbinu Zipi za Faragha?
Kompyuta ya kwanta iliyo kubwa vya kutosha na inayostahimili hitilafu kimsingi hutishia, kwa sababu ya algoriti ya Shor, mekanizimu za funguo za umma kama RSA, Diffie–Hellman ya kawaida na kriptografia ya mikunjo ya elliptic zinazotegemea matatizo ya factoring na discrete logarithm; tishio hili halitumiki kwa namna ileile kwa faragha diferensheli, secret sharing ya nadharia ya taarifa, usimbaji fiche wa ulinganifu au usimbaji fiche homomofiki unaotegemea lattice, na kwa hiyo katika mifumo ya PPML mpito wa kwanta haumaanishi kubadilisha vipengele vyote kwa pamoja, bali kuorodhesha na kubadilisha kwa usahihi tabaka zilizo wazi kwa kwanta.
Je, “baada ya kwanta” katika makala hii ni kriptografia ya kwanta?
Hapana. Post-quantum cryptography (PQC) inamaanisha algoriti za kikriptografia za kawaida zinazoweza kufanya kazi kwenye kompyuta na mitandao ya kawaida tunayotumia leo lakini zilizolengwa kustahimili mashambulizi makubwa ya kwanta yanayojulikana. Dhana hii si sawa na quantum key distribution inayotumia fotoni na njia za kimwili za kwanta. Lengo la chanzo ni algoriti za post-quantum zinazoweza kutekelezwa kwenye programu/hardware ya kawaida na zilizosawazishwa na NIST.
Algoriti ya Shor hubadilisha nini hasa?
Usalama wa RSA unategemea ugumu wa kugawanya namba kamili kubwa katika vigezo vyake, huku usalama wa Diffie–Hellman ya kawaida na kriptografia ya mikunjo ya elliptic ukitegemea ugumu wa tatizo la discrete logarithm katika makundi yanayofaa kwa kompyuta za kawaida. Algoriti ya Shor inaweza kutatua madaraja haya ya matatizo kwa muda wa polinomu kwenye kompyuta bora ya kwanta yenye ukubwa wa kutosha.
Kauli hii haimaanishi “kompyuta za kwanta za leo sasa zinavunja RSA ya intaneti mara kwa mara”. Mfano wa tishio wa chanzo unahusu kompyuta ya kwanta ya baadaye yenye uwezo wa kutosha.
Tishio la harvest-now-decrypt-later ni nini?
Mshambuliaji anaweza kurekodi trafiki iliyosimbwa ambayo hawezi kutafsiri leo na kuihifadhi kwa miaka. Uwezo wa kutosha wa kwanta ukitokea baadaye, anaweza kujaribu kutafsiri ciphertext za zamani. Kwa hiyo kwa rekodi za genomiki, serikali, ulinzi au za muda mrefu za watu ambazo zinahitaji kubaki siri kwa miaka 20–30 kuanzia leo, tishio halianzi tu katika siku zijazo; linaweza kuanza kwa data kukamatwa leo.
Je, algoriti ya Grover huvunja AES kabisa kama Shor?
Hapana. Hii ndiyo tofauti muhimu inayofanywa na chanzo. Algoriti ya Grover huharakisha tatizo la utafutaji wa jumla kwa kiwango cha mraba. Katika utafutaji wa brute-force, nafasi ya funguo za kawaida za biti \(k\) huhitaji takriban:
\[ O(2^k) \]
majaribio, huku modeli bora ya Grover ikiipunguza takriban hadi:
\[ O(2^{k/2}) \]
kiwango cha miito ya oracle. Uwakilishi huu wa kufundishia wa ugumu si matokeo mapya ya utafiti. Matokeo si kwamba usimbaji fiche wa ulinganifu unakuwa usiotumika kabisa, bali kwamba ukingo wa usalama unapungua. Kwa hiyo chanzo kinaeleza kwamba funguo ndefu zaidi za ulinganifu na ukubwa mkubwa wa matokeo ya hash unaweza kutumika katika mipango ya baada ya kwanta.
Kwa nini usalama wa post-quantum haumaanishi “umethibitishwa kihisabati milele”?
Mifumo inayotegemea lattice kama ML-KEM na ML-DSA inaaminika kustahimili mashambulizi madhubuti ya kawaida au ya kwanta yanayojulikana. Hata hivyo, hii si uthibitisho wa kihisabati kwamba hakuna algoriti mpya itakayopatikana baadaye. Sababu ya mchakato wa usanifishaji wa NIST kufanya cryptanalysis ya wazi kwa miaka mingi, baadhi ya wagombea kuvunjwa, na mbadala unaotegemea dhana tofauti kama SLH-DSA ya hash-based kuhifadhiwa pamoja na viwango vya lattice-based ni kusimamia kutokuwa na uhakika huku.
Viwango vya post-quantum vya NIST vya 2024
| Kiwango | Asili ya algoriti | Msingi wa kihisabati | Kazi | Taarifa ya ukubwa iliyotolewa katika chanzo |
|---|---|---|---|---|
| FIPS 203 | ML-KEM / CRYSTALS-Kyber | Module-LWE | Ufungaji wa funguo / kuanzisha funguo | Public key takriban 800–1568 byte; ciphertext takriban 768–1568 byte |
| FIPS 204 | ML-DSA / CRYSTALS-Dilithium | Module-LWE / Module-SIS | Sahihi ya kidijitali | Sahihi takriban 2420–4595 byte |
| FIPS 205 | SLH-DSA / SPHINCS+ | Usalama wa fungsi ya hash | Sahihi ya kidijitali / utofauti wa algoriti | Sahihi takriban 7856–49.856 byte |
Kulingana na chanzo, seti za vigezo vya viwango hivi zinafafanuliwa katika makundi ya usalama ya NIST 1, 3 na 5 na zinahusishwa takriban na malengo ya usalama yanayolingana na gharama za mashambulizi ya kawaida/ya kwanta dhidi ya AES-128, AES-192 na AES-256.
Uhusiano kati ya Module-LWE na usimbaji fiche homomofiki ni upi?
Familia ya Module-LWE ya ML-KEM na ML-DSA pamoja na familia ya LWE/RLWE ambayo CKKS, BFV, BGV na TFHE zinategemea ni sehemu ya familia ileile pana ya matatizo yanayotegemea lattice. Kwa hiyo chanzo huona kiini cha usimbaji fiche homomofiki unaotegemea lattice tayari kuwa na tabia ya post-quantum.
Hii ni tofauti muhimu sana: mfumo wa HE huenda usihitaji kutupwa na kujengwa upya wakati wa mpito wa kwanta. Sehemu dhaifu zaidi inaweza kuwa ubadilishaji wa funguo za TLS wa kawaida, sahihi za ECC, vyeti au vipengele vingine vya classical public-key vinavyozunguka ukokotoaji wa HE.
Tishio la kwanta liko wapi katika ujifunzaji shirikishi?
Katika mfano wa chanzo, masasisho ya modeli katika ujifunzaji shirikishi yaliyolindwa na secure aggregation au lattice-HE yanaweza tayari kuwa na ustahimilivu wa post-quantum. Lakini sahihi za ECC zinazothibitisha utambulisho wa mamilioni ya wateja zinaweza kubaki wazi kwa tishio la kwanta. Kwa hiyo mpito unaweza kutokea zaidi katika tabaka la authentication kuliko katika hisabati ya sasisho la modeli.
Inaripotiwa kwamba sahihi za ML-DSA zinaweza kuwa takriban mara 30–70 kubwa zaidi kuliko sahihi sawia za mikunjo ya elliptic. Katika mfumo wa cross-silo mzigo huu wa ziada unaweza kubaki mdogo, lakini katika federesheni ya cross-device yenye mamilioni ya wateja wa simu wanaoshiriki katika raundi nyingi unaweza kuwa muhimu kwa upande wa bandwidth.
Kwa nini tishio la kwanta linaweza kuwa la haraka zaidi katika nyaraka zilizofichwa?
Ciphertext inayohifadhiwa kwa muda mrefu iko moja kwa moja chini ya tishio la harvest-now-decrypt-later. Kiini cha ulinganifu cha SSE kinaweza kulindwa kwa kuimarisha vigezo kutokana na Grover; lakini ikiwa mekanizimu iliyo wazi kwa kwanta kama classical Diffie–Hellman inatumiwa kwa usambazaji wa funguo au delegation, usalama wa muda mrefu wa mfumo wote unaweza kudhoofika kutoka katika tabaka hilo.
MPC huathiriwaje na kwanta?
Ikiwa hatua ya online ya MPC inayotegemea secret-sharing inaweza kutoa usalama wa nadharia ya taarifa, kompyuta ya kwanta haiondoi dhamana hiyo ya kihisabati. Maeneo muhimu zaidi kwa upande wa kwanta ni mekanizimu za public-key zinazotumiwa wakati wa preprocessing au njia za authentication kati ya pande. Kwa hiyo chanzo hutathmini mzigo wa post-quantum migration wa MPC tofauti na ule wa HE au mfumo unaotegemea PKI ya kawaida.
Je, faragha diferensheli inaathiriwa na kompyuta ya kwanta?
Katika mfumo wa mapitio, dhamana ya faragha diferensheli haitokani na ugumu wa ukokotoaji bali na uhusiano wa kihisabati wa usambazaji wa matokeo. Kwa hiyo kuibuka kwa kompyuta ya kwanta yenye nguvu ya kutosha hakuvunji ufafanuzi wa DP. Hata hivyo, utekelezaji sahihi wa DP, ubora wa uzalishaji wa noise au tabaka nyingine za usimbaji fiche katika mfumo huendelea kuwa masuala tofauti ya usalama.
Kwa nini crypto-agility ni muhimu kama kuchagua kiwango?
Crypto-agility ni uwezo wa mfumo kubadilisha algoriti za kikriptografia unazotumia bila kuandika upya usanifu wote. Chanzo kinapendekeza kwamba katika mpito wa post-quantum, badala ya uchaguzi wa mara moja kama “tumia ML-KEM”, uwezo wa kubadilisha algoriti ufanywe sifa ya usanifu. Hii ni kwa sababu kiwango cha post-quantum kilichochaguliwa leo kinaweza kuhitaji kubadilishwa baadaye.
Mapitio pia yanajadili mbinu ya hybrid migration ambapo mekanizimu ya kawaida na ya post-quantum zinaendeshwa pamoja. Lengo ni kulinda njia ya pamoja maadamu angalau sehemu moja inaendelea kuwa salama. Gharama yake ni kubeba pamoja ukubwa wa funguo, handshake na data wa algoriti mbili.
Je, kutumia algoriti ya post-quantum huondoa matatizo ya side-channel?
Hapana. Skimu yenye nguvu kihisabati ya lattice inaweza kuvuja funguo kupitia shambulio la timing au power-analysis kwa sababu ya utekelezaji mbaya. Kwa hiyo chanzo huona utekelezaji wa constant-time NTT, masked sampler na ulinzi wa njia za pembeni za kimwili kuwa muhimu hasa katika mazingira ambapo mshambuliaji anaweza kukaribia kifaa, kama edge device au mteja shirikishi.
Kwa nini kutumia mbinu pamoja si kila mara “salama zaidi”?
Moja ya usanisi muhimu wa asili wa mapitio ni kwamba hayatoshi kusema mbinu za privacy hukamilishana; pia yanachunguza migongano inayojitokeza wakati wa kuziunganisha.
| Mchanganyiko | Uhusiano | Kwa nini? |
|---|---|---|
| HE + DP | Msuguano | Noise iliyodhibitiwa ya DP lazima ichambuliwe pamoja na ukuaji wa kosa/noise ya kukaribia ya CKKS yenyewe. |
| HE + Secure Aggregation | Sinergia | Wakati wa aggregation utegemezi wa seva kwa sasisho binafsi unaweza kupunguzwa. |
| DP + Secure Aggregation | Sinergia | Kwa distributed noise generation, noise ya jumla ya DP inaweza kuzalishwa kati ya wateja. |
| FL + HE/MPC | Msuguano + ulinzi | Faragha huongezeka lakini mawasiliano ya kikriptografia yanaweza kufuta kwa sehemu faida ya FL ya kupunguza uhamishaji wa data. |
| Privacy + Robust Aggregation | Msuguano | Kuficha masasisho pia hufanya kukagua sasisho hasidi kuwa vigumu. |
| ZKP + Secure Aggregation | Sinergia | Mteja anaweza kuthibitisha bila kufichua sasisho kwamba anafuata masharti ya nora/kikomo. |
| ZKP + HE | Dhamana ya ziada lakini gharama kubwa | Integrity huongezwa kwenye confidentiality; gharama ya proving hulipwa pia. |
Mgongano wa noise kati ya HE na DP
DP huhitaji usambazaji wa noise uliokalibishwa kihisabati. CKKS tayari hubeba kosa la kikriptografia/kihesabu kwa sababu ya arithmetiki ya kukaribia. Noise ya DP inapozalishwa ndani ya encrypted domain, vipengele hivi viwili vya kosa hujumlishwa. Ikiwa kosa la HE halihesabiwi, usambazaji halisi unaweza kutofautiana na ule unaodhaniwa katika uchambuzi wa DP; likihesabiwa kwa tahadhari kupita kiasi, utility ya modeli inaweza kupungua kuliko inavyohitajika.
Kwa hiyo chanzo kinasisitiza kwamba noise inayoongezwa kwa ajili ya privacy na inherent error ya cryptography vinapaswa kuigwa pamoja, si tofauti.
Mgongano kati ya ujifunzaji shirikishi na mawasiliano ya kikriptografia
Moja ya faida kuu za kiutendaji za FL ni kutohamisha data ghafi. Lakini naive secure aggregation inaweza kuhitaji pairwise key agreement nyingi; naive homomorphic encryption inaweza kubadilisha kila kipengele cha gradient kuwa ciphertext kubwa. Katika hali hii, federesheni iliyojengwa ili “kuhamisha data kidogo” inaweza kuzalisha trafiki ya mtandao zaidi kuliko ilivyotarajiwa kwa sababu ya tabaka la faragha.
Umuhimu wa mbinu kama polylogarithmic secure aggregation, sparse communication graph, one-shot mask reconstruction, quantization na batching unatokana na mgongano huu.
Chanzo kinauliza maswali gani katika uchaguzi wa mbinu?
Mapitio yanapunguza uchaguzi wa kiufundi hadi maswali manne ya msingi:
- Data inashikiliwa na nani au kina nani?
- Je, upande unaofanya ukokotoaji unaweza kuona data ghafi?
- Je, matokeo yatafichuliwa kwa pande tatu zisizoaminika au kwa umma?
- Kizuizi kinachotawala ni ukokotoaji, mawasiliano, usahihi au dhana ya uaminifu wa kiutendaji?
| Senario | Mchanganyiko wa kuanzia unaopendekezwa katika chanzo | Kizuizi kinachotawala |
|---|---|---|
| Inference ya wingu kwenye data binafsi ya mteja | HE/CKKS; ZKP ikiwa uadilifu wa seva una shaka | Muda wa ukokotoaji wa seva |
| Hospitali kufundisha modeli ya pamoja ya utambuzi | Cross-silo FL + homomorphic aggregation + DP kwenye modeli iliyochapishwa | Udhibiti na bandwidth ya silo |
| Utabiri wa kibodi ya simu | Cross-device FL + secure aggregation + user-level DP | Mawasiliano ya mteja na dropout |
| Alama ya pamoja ya hatari ya kampuni mbili | MPC ya pande mbili ya mixed-protocol | Latency ya round-trip ya mtandao |
| Kuchapisha takwimu za idadi ya watu | Central DP + numerical privacy accounting | Utility chini ya ε lengwa |
| Telemetry kutoka kwa wateja wasioaminika | Local DP au shuffled DP | Upotevu wa utility unaotokana na noise |
| Utafutaji wa nyaraka zilizosimbwa | Forward/backward-private SSE; ORAM ikiwa access pattern ni muhimu | Leakage profile |
| LLM fine-tuning kwenye corpus nyeti | DP-SGD + low-rank adapter juu ya public backbone | Utility chini ya ε lengwa |
| Hifadhi itakayobaki siri kwa miongo | Post-quantum primitives; mekanizimu mseto wakati wa mpito | Ukubwa wa funguo na sahihi |
Kwa nini kuna tofauti kubwa kati ya prototipu ya utafiti na mfumo wa uzalishaji?
Katika utafiti wa PPML, kuonyesha latency ndogo au throughput kubwa ni sehemu ndogo tu ya mfumo wa uzalishaji. ML pipeline halisi inataka kukagua tensor za kati, kurekodi log, kutengeneza checkpoint, kufanya hyperparameter tuning, kufuatilia distribution drift na debug sampuli yenye hitilafu. Encryption hufanya thamani za kati zisionekane. Katika DP kila diagnostic query ya faragha inaweza kutumia privacy budget mpya. MPC hubadilisha programu ya mchakato mmoja kuwa itifaki iliyosambazwa.
Kwa hiyo tabaka la compiler na framework ni muhimu. Zana kama OpenFHE, CrypTen na SecretFlow-SPU hujaribu kuficha maelezo ya kikriptografia nyuma ya modeli za programu zilizozoeleka zaidi. Hata hivyo, chanzo kinasisitiza kwamba haziondoi mzigo wa ujumuishaji, bali huupunguza tu.
Kwa nini usimamizi wa funguo unaweza kuwa kiungo dhaifu kuliko kriptografia?
Hata kama HE ni thabiti kihisabati, usalama huanguka ikiwa secret key imehifadhiwa mahali pabaya. Katika mfumo wa cross-silo, taasisi moja kushikilia decryption key kunaweza kuvuruga modeli ya uaminifu; kwa hiyo miundo ya threshold au multi-key ni muhimu. Katika federesheni ya cross-device, uzalishaji wa funguo wa mamilioni ya wateja, rotation, wateja waliopotea na usimamizi wa certificate ni matatizo tofauti ya uhandisi.
Evaluation key pia ni kubwa na lazima iwe mikononi mwa seva. Kwa hiyo kusema “algoriti inatoa 128-bit security” haimaanishi mfumo wa uendeshaji ni kweli salama kwa 128-bit.
Je, dhamana rasmi ya faragha kisheria inamaanisha “data isiyomtambulisha mtu”?
Hili ni moja ya maonyo muhimu ya chanzo kuhusu uzalishaji: wakati faragha diferensheli huzungumza kwa lugha ya kihisabati ya \(\varepsilon\) na \(\delta\), sheria za ulinzi wa data hutumia makundi kama data binafsi, utambulishwaji, kikomo cha madhumuni, msingi wa kisheria na haki za mhusika wa data. Hakuna ulinganifu wa moja-kwa-moja wa kiotomatiki kati ya hivi.
Kwa mfano, ikiwa mkusanyo wa data wenye DP katika thamani fulani ya \(\varepsilon\) unakubaliwa kisheria kuwa “anonim” au la haiwezi kutolewa kutoka formula ya kiufundi pekee. Vivyo hivyo, ombi la “right to erasure” haliondoi kiotomatiki taarifa ambayo modeli ilijifunza kutokana na rekodi kwa kuifuta rekodi ya mafunzo kwenye diski; machine unlearning ni mada tofauti ya utafiti iliyo wazi.
Mbinu zipi zimekomaa kiasi gani katika uzalishaji?
Tathmini katika Kielelezo cha 6 cha chanzo si alama iliyopimwa, bali ni usanisi wa ubora uliotolewa na waandishi kutokana na fasihi na ushahidi wa deployment. Faragha diferensheli na ujifunzaji shirikishi zina mifano ya uzalishaji wa kiwango kikubwa. Secure aggregation hutumika katika uzalishaji ndani ya mifumo hii shirikishi. Viwango vya post-quantum vimesanifiwa na viko katika hatua ya migration. SSE na MPC ziko katika matumizi ya majaribio au niche katika uzalishaji. HE iko katika uzalishaji wa mapema kwa workload chache lakini zenye thamani kubwa. Matumizi mengi ya ZKP kwa ujifunzaji wa mashine bado ni ya utafiti.
Somo la pamoja kutoka mifano ya afya, fedha, simu na miji mahiri
| Eneo | Kiwango cha kawaida | Mbinu zinazoongoza | Kizuizi kikuu |
|---|---|---|---|
| Afya / utafiti wa kliniki | Taasisi 2–50 | FL, secure aggregation, DP, HE inayokua | Ulinganifu wa data, idhini ya maadili, taasisi non-IID |
| Majukwaa ya simu ya watumiaji | Vifaa \(10^6\)–\(10^9\) | FL, secure aggregation, user-level/local DP | Mawasiliano, dropout, utofauti wa vifaa |
| Huduma za kifedha | Taasisi 2–20 | FL + homomorphic aggregation, MPC | Udhibiti na unyeti wa ushindani |
| Mji mahiri / pacha wa kidijitali | Vifaa tofauti \(10^4\)–\(10^7\) | FL, local DP | Mtiririko wa data uliounganishwa na kutambua upya kutokana na mwendo |
| Takwimu rasmi | Curator mmoja | Central DP + numerical accounting | Utility chini ya ε inayoweza kutetewa na mawasiliano ya umma |
| Huduma ya ML ya wingu | Mteja + seva | HE inference; TEE katika baadhi ya senario | Latency na gharama kwa kila swali |
Kwa nini chanzo hakipangi moja kwa moja matokeo ya benchmark ya mbinu?
Kwa sababu mifumo inayolinganishwa haifanyi kazi ileile na haijajaribiwa katika hali zilezile. Chanzo kinafafanua matatizo manne makuu ya ulinganishwaji:
- Mfano wa tishio: itifaki inayotoa malicious security hufanya kazi zaidi kuliko itifaki ya semi-honest.
- Kigezo cha usalama: ring dimension au modulus ndogo inaweza kuwa ya haraka zaidi lakini ikatoa usalama mdogo.
- Tofauti ya throughput na latency: mfumo unaofanya batch ya maelfu ya maswali hauwezi kulinganishwa kwa metrika ileile na mfumo ulioboreshwa kwa swali moja la mwingiliano.
- Tofauti ya mali inayolindwa: DP hubebesha gharama kwenye usahihi, HE kwenye muda; hakuna “kiwango cha ubadilishaji” cha ulimwengu wote kati yao.
| Mekanizimu | Mali kuu inayolindwa | Overhead ya ukokotoaji ya kukaribia | Athari ya mawasiliano | Upotevu wa utility | Tathmini ya ukomavu katika chanzo |
|---|---|---|---|---|---|
| Usimbaji fiche homomofiki | Confidentiality ya ingizo | \(10^3\)–\(10^6\times\) | Ciphertext expansion takriban 1–10× | Hakuna au upotevu mdogo kutokana na arithmetiki ya kukaribia | Uzalishaji wa mapema |
| MPC | Confidentiality ya ingizo | Takriban \(10\)–\(10^3\times\) | Juu; hutegemea circuit depth | Hakuna katika arithmetiki sahihi | Majaribio |
| Faragha diferensheli | Privacy ya matokeo | Isiyozingatiwa | Hakuna | Inaweza kuwa ya kati–juu kulingana na ε | Uzalishaji |
| Ujifunzaji shirikishi | Data locality | Takriban 1–10× | Uhamishaji mkubwa wa modeli kila raundi | Ndogo–ya kati kwa data non-IID | Uzalishaji |
| Secure aggregation | Confidentiality ya update binafsi | Ndogo | Ya kati kulingana na itifaki | Hakuna | Uzalishaji |
| Searchable encryption | Confidentiality ya swali na data, pamoja na leakage fulani | Takriban 1–10× | Ndogo | Hakuna | Majaribio |
| ORAM | Access-pattern confidentiality | Takriban 10–100× | Overhead ya logarithmic kwa ukubwa wa hifadhidata | Hakuna | Niche |
| Zero-Knowledge Proof | Uadilifu wa ukokotoaji | Takriban \(10^2\)–\(10^6\times\) kwa proving | Inaweza kuwa ndogo kiasi kwa sababu ya succinct proof | Hakuna | Utafiti |
| Post-quantum primitives | Ustahimilivu wa kikriptografia wa muda mrefu | Takriban 1–2× | Funguo na sahihi kubwa zaidi | Hakuna | Imesanifiwa |
Oda zilizo katika jedwali hili hazijatoka katika jaribio moja la pamoja lililodhibitiwa. Chanzo kimeziunganisha kutoka matokeo ya tafiti tofauti za msingi. Kwa hiyo, kwa mfano, hitimisho kama “HE ni polepole mara 1000 kuliko MPC” haliwezi kutolewa. Workload, algoriti, muundo wa batch, kiwango cha usalama, hardware, modeli ya malicious/semi-honest na latency ya mtandao vinaweza kubadilisha matokeo kwa kiasi kikubwa.
Benchmark iliyounganishwa ya PPML inapaswa kuwaje?
Kulingana na mapitio, benchmark ya pamoja yenye maana inapaswa kujumuisha angalau kazi za batch inference, interactive inference, cross-silo training, cross-device training na analytics. Hardware baseline ileile au mbinu wazi ya scaling inapaswa kutumiwa; mfano wa tishio, corruption threshold na security parameter ziripotiwe wazi; katika mifumo ya DP aina ya accountant pamoja na \((\varepsilon,\delta)\) zionyeshwe na metrika ya gharama itolewe pamoja na metrika ya utility.
Lengo si kutoa “alama moja ya faragha”, bali kuweka mfumo katika nafasi ya privacy–utility–cost.
Mbinu na Matokeo ya Utafiti
Muundo wa kisayansi wa utafiti
Utafiti huu si utafiti wa msingi unaotengeneza jaribio jipya, mkusanyo mpya wa data, utafiti mpya wa kliniki, saketi mpya ya kwanta au itifaki mpya ya PPML. Kama mapitio ya kina ya kiufundi, unaunganisha fasihi iliyopo katika mada saba kuu: usimbaji fiche homomofiki, faragha diferensheli, privacy accounting, ukokotoaji salama wa pande nyingi, ujifunzaji shirikishi, utafutaji/hifadhidata zilizosimbwa na post-quantum cryptography. Uthibitisho wa maarifa-sifuri unashughulikiwa katika sehemu nyingi kama tabaka la integrity linalokamilisha mekanizimu za confidentiality.
Orodha ya marejeleo ya makala inafikia vyanzo 136. Katika sehemu ya michango ya waandishi inaelezwa kwamba Quang-Vinh Dang, Minh Ngoc Dinh na Ngoc-Son-An Nguyen walichangia shughuli za literature search na screening. Hata hivyo, maandishi makuu hayatoi majina ya hifadhidata, misururu ya utafutaji inayoweza kurudiwa, mtiririko wa PRISMA, vigezo wazi vya kujumuisha/kutenga au itifaki rasmi ya tathmini ya ubora. Kwa hiyo, haipaswi kutathminiwa kama meta-analysis ya kiasi au systematic review yenye itifaki inayoweza kurudiwa kikamilifu.
Michango mitano mikuu ya mapitio
- Kuunganisha mbinu za PPML ambazo kwa kawaida huchunguzwa katika fasihi tofauti chini ya mfano mmoja wa tishio, gharama na uaminifu.
- Kukusanya matokeo ya kiasi kama accuracy, latency, throughput, key size na overhead kutoka vyanzo vya msingi na kueleza kwa nini hayawezi kulinganishwa moja kwa moja.
- Kuvuka kauli kwamba “mbinu hukamilishana” na kuchambua kutolingana kama mwingiliano wa HE+DP noise, gharama ya FL+mawasiliano ya kikriptografia na mgongano wa privacy+robustness.
- Kuunda utaratibu wa maamuzi unaolinganishwa na senario ya deployment na mchanganyiko wa kiufundi.
- Kutathmini tofauti kati ya prototipu ya utafiti na mfumo wa uzalishaji kupitia uhandisi, key management, udhibiti na ushahidi wa deployment katika sekta.
Ugunduzi mkuu 1: Mbinu moja ya PPML haitimizi malengo yote ya usalama
HE huficha ingizo lakini haiwekei kikomo kiasi cha data ya mtu kinachoweza kuvuja kupitia matokeo yaliyochapishwa. DP huweka kikomo taarifa ambayo matokeo hutoa kuhusu mtu lakini haitoi confidentiality dhidi ya upande unaochakata data ghafi. MPC huficha ukokotoaji wa pamoja lakini hutumia mawasiliano mengi. FL hutoa data locality lakini iko wazi kwa gradient leakage. SSE hutoa utafutaji wenye ufanisi lakini hubeba leakage profile. ZKP hutoa integrity lakini haichukui nafasi ya confidentiality. Post-quantum primitives si mekanizimu ya privacy peke yake, bali ni tabaka la ustahimilivu wa muda wa dhamana za kikriptografia.
Ugunduzi mkuu 2: Tatizo halisi la ubunifu wa mifumo ya faragha ni composition
Mfumo wa uzalishaji mara nyingi huhitaji primitive zaidi ya moja. Kwa mfano, modeli shirikishi ya cross-silo inaweza kutumia homomorphic secure aggregation, user-level DP inaweza kutumiwa kwa modeli ya kimataifa, tabia ya seva ya aggregation inaweza kuthibitishwa kwa ZKP na tabaka la mawasiliano kulindwa kwa post-quantum key exchange. Hata hivyo, kila tabaka jipya huleta gharama na dhana mpya.
Ujumbe mkuu wa kimbinu wa mapitio ni kwamba uchambuzi wa usalama wa vipengele hivi kuwa sahihi kila kimoja peke yake haumaanishi mfumo mzima ni sahihi kiotomatiki.
Ugunduzi mkuu 3: Usimbaji fiche homomofiki si wa nadharia tu tena lakini bado ni ghali
HE imefikia inference ya mitandao ya kina na transformer. Bootstrapping, packing, scheme switching, compiler na uharakishaji wa GPU/ASIC umeongeza sana uwezekano wa matumizi. Hata hivyo, chanzo kinasema gharama ya HE bado inaweza kuwa oda nyingi za ukubwa juu ya plaintext computation, na encrypted training ni ngumu zaidi hasa kwa modeli kubwa.
Ugunduzi mkuu 4: Tatizo kuu la faragha diferensheli si kuongeza noise pekee
Ubora wa utekelezaji wa DP hutegemea pipeline nzima ya mafunzo, ikiwa ni pamoja na clipping, sampling, accountant, ukubwa wa batch, public pretraining, usanifu wa modeli na audit. Accountant iliyolegea inaweza kusababisha noise isiyohitajika; implementation yenye hitilafu inaweza kufanya privacy guarantee ya kwenye karatasi isiwe halali.
Ugunduzi mkuu 5: Ujifunzaji shirikishi si sawa na privacy
Raw data kutotoka kwenye kifaa ni faida muhimu ya governance, lakini mashambulizi kama gradient inversion na membership inference yanaonyesha kwamba taarifa inaweza kutolewa kutoka kwenye update zenyewe. Ili FL ipate privacy rasmi, mekanizimu za ziada kama secure aggregation, HE au DP zinahitajika.
Ugunduzi mkuu 6: Tabaka la kuhifadhi data linaweza kuwa kiungo dhaifu cha PPML
Hata training protocol ikilindwa kwa nguvu sana, ikiwa feature store, database au query layer inavuja access pattern, taarifa nyeti katika mfumo imehamishwa tu kwenda sehemu nyingine. Kwa hiyo SSE, ORAM, private information retrieval na verifiable search zinapaswa kutathminiwa kama sehemu ya mnyororo wa PPML.
Ugunduzi mkuu 7: Mpito wa kwanta hautabadilisha staki yote ya PPML kwa kiwango sawa
Tabaka za public-key zinazotegemea RSA, Diffie–Hellman na ECC ziko chini ya tishio la Shor. Kwa upande mwingine, lattice-based HE tayari inategemea familia ya matatizo ya post-quantum; DP haitegemei dhana ya ugumu wa ukokotoaji; baadhi ya dhamana za online za MPC inayotegemea secret-sharing ni za nadharia ya taarifa; symmetric encryption inaweza kuimarishwa kwa vigezo vikubwa kutokana na Grover.
Kwa hiyo mpango wa migration si “badilisha kila kitu kuwa PQC”, bali ni kuorodhesha utegemezi wote wa public-key, ciphertext za muda mrefu, miundo ya authentication na mekanizimu za key-distribution katika mfumo.
Ugunduzi mkuu 8: Uendeshaji na shirika ni muhimu kama usalama
Itifaki ya MPC ya pande tatu ya honest-majority kuwa haraka sana kihisabati haitoi faida ya vitendo ikiwa hakuna taasisi tatu huru ambazo kwa kweli hazitafanya njama kwa siri. Funguo ya mfumo wa HE ikisimamiwa vibaya, usalama wa kihisabati unapoteza maana. Thamani ya \(\varepsilon\) ya DP haiamui yenyewe hali ya kisheria ya kutotambulika. Kwa hiyo uamuzi wa deployment wa PPML hauwezi kufanywa kwa benchmark ya algoriti pekee.
Matokeo yanayoungwa mkono na utafiti
- Hakuna mbinu moja ya PPML iliyo bora kwa ulimwengu wote.
- HE inaweza kutoa input confidentiality yenye nguvu lakini ina computational overhead kubwa.
- DP ni mfumo rasmi na composable kwa output privacy lakini huhitaji upotevu wa utility na privacy accounting.
- MPC, hasa katika hali nzuri za mtandao, hutoa sehemu tofauti ya ubunifu kuliko HE na katika hali nyingi ni nzito zaidi kwa mawasiliano.
- FL hupunguza uhamishaji wa data ghafi kwenda kituo kikuu lakini peke yake si privacy guarantee.
- Secure aggregation, DP na HE zinaweza kukamilishana katika mifumo shirikishi.
- Kuna mgongano halisi wa mwonekano kati ya privacy na Byzantine robustness.
- Leakage inayoruhusiwa na SSE inaweza kutumiwa katika mashambulizi ya vitendo; kuangalia tu usalama wa ciphertext haitoshi.
- Post-quantum migration ni muhimu hasa katika tabaka za classical public-key authentication na key-establishment.
- ML-KEM, ML-DSA na SLH-DSA ni muhimu katika mipango ya muda mrefu ya kikriptografia ya staki ya PPML kama viwango vya NIST vya 2024.
- Vikwazo vya production deployment si protocol latency pekee; key management, tooling, udhibiti, ulinganifu wa data na trust ya shirika pia ni muhimu.
- Takwimu tofauti za utendaji katika fasihi ya PPML hazipaswi kupangwa moja kwa moja bila benchmark ya pamoja.
Ujumlishaji ambao utafiti hauungi mkono
Utafiti hauungi mkono hitimisho kwamba “usimbaji fiche homomofiki sasa ni wa vitendo katika workload zote za ujifunzaji wa mashine”, “ujifunzaji shirikishi peke yake huweka data siri”, “data yoyote iliyowekewa faragha diferensheli ni anonim kisheria”, “kuna namba salama ya ulimwengu wote ya ε”, “algoriti za post-quantum haziwezi kuvunjwa milele”, “kompyuta za kwanta za leo huvunja RSA mara kwa mara”, “kriptografia yote ya kawaida haitatumika baada ya kwanta”, “HE ni salama kuliko MPC katika kila hali” au “uwiano wa overhead uliotolewa katika chanzo ni upangaji kamili wa benchmark ileile”.
Vilevile, mapitio hayathibitishi kwamba ML-KEM, ML-DSA au SLH-DSA haziwezi kuvunjwa kihisabati dhidi ya mbinu zote za cryptanalysis zinazoweza kupatikana baadaye. Usalama wa post-quantum unapaswa kutathminiwa ndani ya mifano ya mashambulizi inayojulikana leo na dhana za kihisabati zinazotegemewa.
Mapungufu makuu ya utafiti
- Hali za hardware, model, dataset, threat model, batch na security parameter za mifumo ya msingi iliyochunguzwa ni tofauti.
- Hakuna benchmark iliyounganishwa ya HE–MPC–DP.
- Ingawa mapitio ni ya kina, hayatoi kwa undani itifaki ya utafutaji wa kimfumo inayoweza kurudiwa.
- Sehemu kubwa ya viongeza kasi vya HE vimetathminiwa kwenye workload ndogo za convolutional; tabia ya transformer haijakomaa sana.
- Secure training, hasa kwa modeli kubwa, imekomaa kidogo sana kuliko secure inference.
- Pengo kati ya black-box DP auditing na analytic privacy bounds halijafungwa kikamilifu.
- Hakuna nadharia iliyokomaa ya kuunganisha leakage ya jumla katika pipeline za SSE/ORAM/ML ndani ya bajeti moja composable.
- Ingawa viwango vya post-quantum vimechapishwa, migration kwenye miundombinu halisi ya PPML na ujumuishaji wa crypto-agility haujakamilika.
- Hakuna ulinganifu wa moja-kwa-moja kati ya dhana za kisheria za privacy na dhamana rasmi za kikriptografia/kitakwimu.
Ajenda ya utafiti wa baadaye ya mapitio
Chanzo kinakusanya mahitaji ya utafiti wa baadaye katika mihimili kadhaa mikuu: kuboresha HE bootstrapping na throughput ya modeli kubwa; kubuni kwa pamoja usanifu wa modeli na kriptografia; kufanya DP accounting iwe kali na inayoweza kukaguliwa zaidi; kupunguza mawasiliano ya cross-device secure aggregation; kupima leakage kwa njia rasmi na composable; kuendeleza kiwango cha benchmark cha pamoja; kukamilisha post-quantum migration; na kuhusisha mekanizimu za privacy kwa uwazi zaidi na mahitaji ya kisheria na kiutendaji.
Tatizo la pamoja la utafiti lililo juu ya haya yote ni composition: si kuweka mekanizimu tofauti tu kando kwa kando, bali kuchambua katika kiwango cha mfumo mzima ikiwa mekanizimu moja inafunika kweli residual leakage iliyoachwa na nyingine na ikiwa inaleta gharama mpya au eneo jipya la mashambulizi.
Maelezo ya Chanzo na Mbinu
Utafiti wa asili: Privacy-Preserving Cryptography for Machine Learning: A Comprehensive Review of Homomorphic Encryption, Differential Privacy, Secure Computation, and Post-Quantum Foundations
Waandishi: Quang-Vinh Dang; Dat Le; Minh Ngoc Dinh; Ngoc-Son-An Nguyen.
Mpangilio wa waandishi: Mpangilio uliotolewa katika chanzo umehifadhiwa bila kubadilishwa.
Mchango sawa: Hakuna taarifa ya mchango sawa/uandishi wa kwanza wa pamoja iliyobainishwa katika chanzo.
Mwandishi wa mawasiliano: Dat Le.
Uhusiano wa taasisi 1: School of Computing and Innovative Technologies, British University Vietnam, Hung Yen, Hanoi, Vietnam.
Uhusiano wa taasisi 2: Department of Science, Technology, and International Projects, Ho Chi Minh City University of Economics and Finance, Ho Chi Minh City, Vietnam.
Uhusiano wa taasisi 3: School of Data Science and Information Technology, Millennia Education, Ho Chi Minh City, Vietnam.
Uhusiano wa taasisi 4: Faculty of Information Technology, Industrial University of Ho Chi Minh City, Ho Chi Minh City, Vietnam.
Jarida: Computers, Materials & Continua (CMC).
Mchapishaji: Tech Science Press.
Juzuu / namba: Volume 89, Number 3, 2026.
DOI: 10.32604/cmc.2026.087848.
Tarehe ya kupokelewa: 24 Juni 2026.
Tarehe ya kukubaliwa: 25 Agosti 2026.
Tarehe ya kuchapishwa: 22 Oktoba 2026.
Aina ya chanzo: Review / mapitio ya kina ya kiufundi.
Hali ya mapitio ya rika: Makala ya mwisho iliyochapishwa katika jarida la ufikiaji wazi lililopitiwa na rika.
Toleo maalum: Privacy-Preserving AI: Encryption and Differential Privacy.
Leseni: Creative Commons Attribution 4.0 International (CC BY 4.0).
Kiungo rasmi cha uchapishaji: https://www.techscience.com/cmc/v89n3/69357
Kiungo cha DOI: https://doi.org/10.32604/cmc.2026.087848
Hali ya preprint: Chanzo kilichochunguzwa na rekodi rasmi ni toleo lililochapishwa la jarida; toleo tofauti la preprint kwa utafiti huu halijatajwa katika nyenzo za chanzo zilizotolewa.
Ufadhili: Waandishi wameripoti kwamba hawakupokea ufadhili maalum kwa utafiti.
Upatikanaji wa data na nyenzo: Kwa kuwa ni makala ya review, imeelezwa kwamba hakuna data mpya iliyozalishwa au kuchambuliwa.
Idhini ya maadili: Haitumiki.
Mgongano wa maslahi: Waandishi wametangaza kwamba hakuna mgongano wa maslahi.
Michango ya waandishi: Uundaji wa dhana na ubunifu wa utafiti Quang-Vinh Dang na Dat Le; utafutaji wa fasihi na screening Quang-Vinh Dang, Minh Ngoc Dinh na Ngoc-Son-An Nguyen; uchambuzi na tafsiri ya matokeo yaliyopitiwa Quang-Vinh Dang, Dat Le na Minh Ngoc Dinh; ubunifu wa taksonomia, compositional analysis na selection guide Quang-Vinh Dang na Dat Le; vielelezo na majedwali Minh Ngoc Dinh na Ngoc-Son-An Nguyen; rasimu ya kwanza Quang-Vinh Dang na Dat Le; marekebisho muhimu ya kisayansi yalifanywa na Dat Le, Minh Ngoc Dinh na Ngoc-Son-An Nguyen. Imeripotiwa kwamba waandishi wote walipitia na kuidhinisha toleo la mwisho.
Kikomo muhimu cha mbinu ya mapitio: Ingawa michango ya waandishi inaonyesha kwamba utafutaji wa fasihi na screening ulifanywa, maandishi ya makala hayatoi misururu ya utafutaji wa hifadhidata inayoweza kurudiwa, chati ya mtiririko wa PRISMA, vigezo rasmi vya kujumuisha/kutenga au itifaki ya meta-analysis ya kiasi. Kwa hiyo simulizi la Verianla linafafanua utafiti kama review ya kina ya kiufundi; haliainishi upya kama systematic review au meta-analysis.
Kikomo cha tafsiri ya matokeo ya kiasi: HE latency, transformer inference, DP utility, secure aggregation, cryptographic overhead na ukubwa wa post-quantum key/signature katika makala zimekusanywa kutoka vyanzo tofauti vya msingi. Chanzo chenyewe kinaeleza kwamba kutokana na tofauti za hardware, model, dataset, batch size, threat model na security parameter, hayawezi kulinganishwa kama benchmark moja iliyodhibitiwa.
Kikomo cha tafsiri ya kwanta: Utafiti si jaribio jipya la kompyuta ya kwanta wala modeli ya quantum machine learning. Sehemu ya kwanta inatathmini athari za kikriptografia za algoriti za Shor na Grover na mahitaji ya post-quantum migration ya miundombinu ya PPML kwa msingi wa fasihi. Neno “Post-quantum” halipaswi kutafsiriwa kama kutoweza kuguswa kabisa kihisabati dhidi ya mashambulizi yote yanayowezekana baadaye.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *