


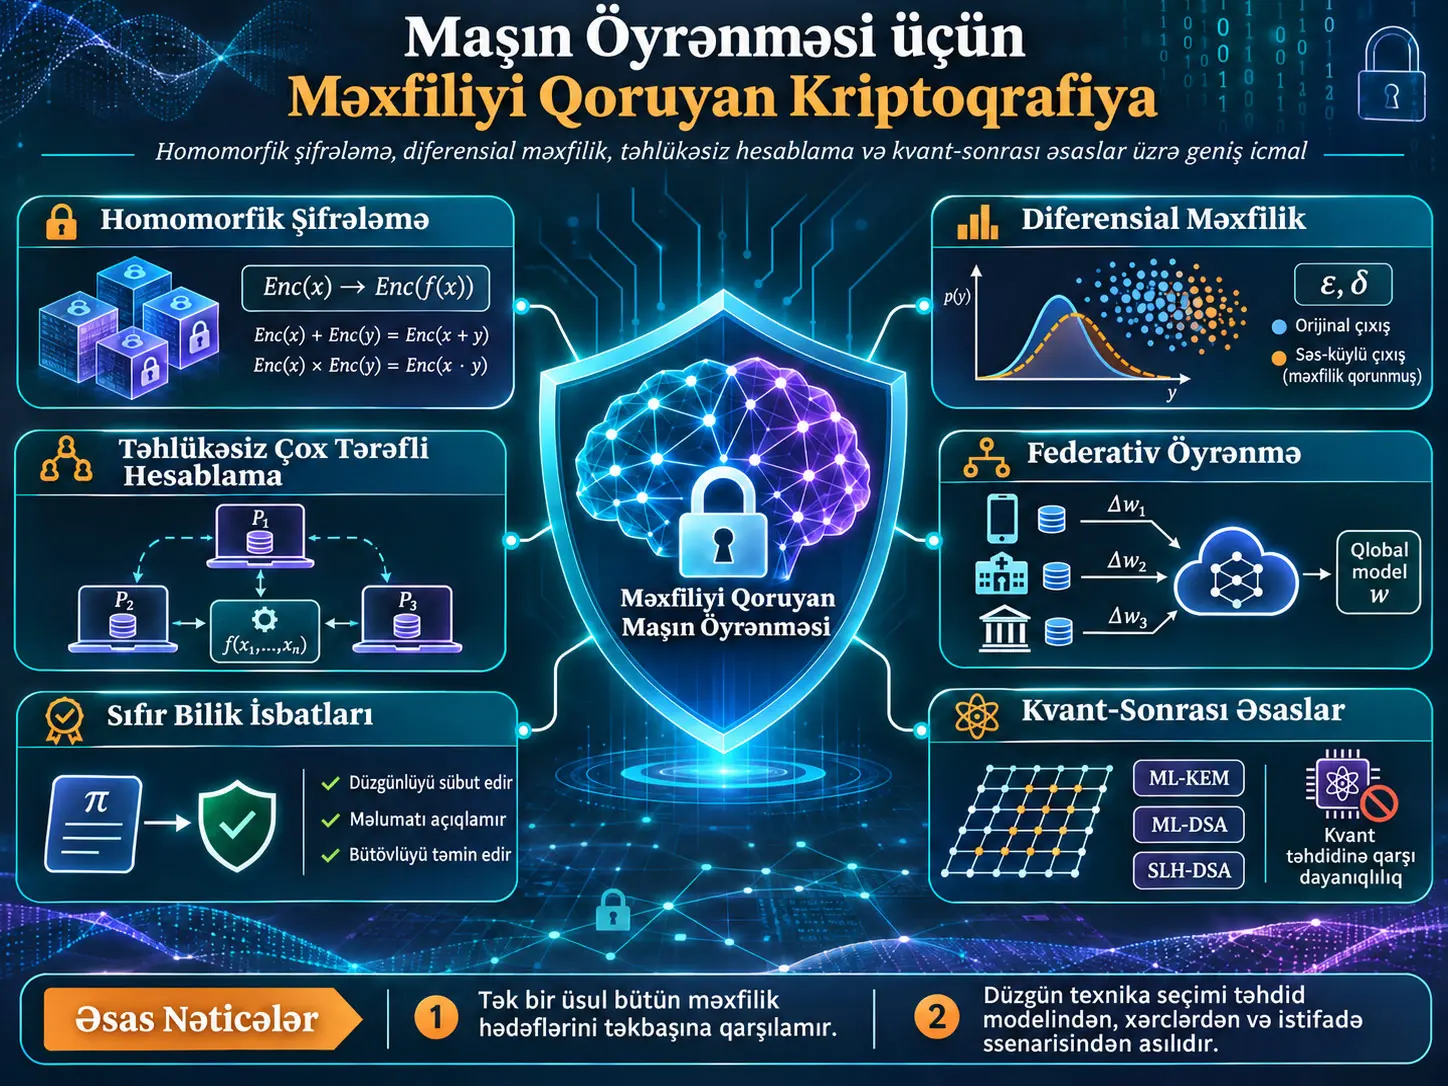
Məxfiliyi qoruyan maşın öyrənməsi (Privacy-Preserving Machine Learning, PPML), həssas məlumatlar üzərində maşın öyrənməsi aparılarkən məlumatın məzmununu, fərdi qeydləri, model parametrlərini və ya hesablamanın bütövlüyünü qorumağı hədəfləyən kriptoqrafik, statistik və sistem səviyyəli texnikaların birlikdə yaratdığı tədqiqat və mühəndislik sahəsidir. Bu geniş icmal homomorfik şifrələməni (Homomorphic Encryption, HE), diferensial məxfiliyi (Differential Privacy, DP), təhlükəsiz çoxtərəfli hesablamanı (Secure Multi-Party Computation, MPC), federativ öyrənməni (Federated Learning, FL), sıfır-bilik sübutlarını (Zero-Knowledge Proofs, ZKP), axtarış edilə bilən şifrələməni, Oblivious RAM-i və kvant-sonrası kriptoqrafiyanı vahid çərçivədə müqayisə edir. Tədqiqatın əsas nəticəsi budur ki, bu üsulların heç biri təkbaşına bütün gizlilik, məxfilik, bütövlük və istifadəolunma problemlərini həll etmir; real sistemlərdə seçim qorunacaq aktivə, təhdid modelinə, hesablama və rabitə büdcəsinə, dəqiqlik itkisinə və etibar fərziyyələrinə görə edilməlidir.
İcmalın mühüm fərqlərindən biri confidentiality ilə privacy anlayışlarını eyni şey kimi işlətməməsidir. Kriptoqrafik gizlilik və ya confidentiality məlumatın və ya aralıq hesablama qiymətlərinin icazəsiz tərəf tərəfindən görünməsinin qarşısını almağa çalışır. Diferensial məxfilikdə privacy isə dərc edilmiş nəticədən konkret bir fərdin məlumat dəstində olub-olmadığının və ya həmin fərdə aid məlumatın nə dərəcədə çıxarıla biləcəyinin məhdudlaşdırılması ilə bağlıdır. Homomorfik şifrələmə və ya MPC hesablamanın girişlərini gizlədə bilər, lakin dərc edilən nəticənin fərdlər haqqında nə qədər məlumat açıqladığını öz-özünə məhdudlaşdırmır. Diferensial məxfilik isə əks istiqamətdə işləyir: nəticədən edilə bilən çıxarışı məhdudlaşdıra bilər, lakin məlumatı emal edən tərəfin xam girişləri görməsinin qarşısını təkbaşına almır. Buna görə güclü PPML sistemləri çox vaxt bir neçə texnikanı qat-qat birləşdirir.
Tədqiqat həmçinin performans rəqəmlərinin ehtiyatla oxunmalı olduğunu göstərir. Homomorfik şifrələmə güclü giriş gizliliyi təmin edə bilər, lakin hesablama xərci çox yüksəkdir; MPC bir çox əməliyyatı düzgün və kriptoqrafik qorunmuş şəkildə yerinə yetirə bilər, lakin intensiv rabitə tələb edir; diferensial məxfilik hesablama baxımından nisbətən ucuzdur, lakin dəqiqlik və ya faydalılıq itkisi yarada bilər; federativ öyrənmə xam məlumatın mərkəzi serverə daşınmamasını təmin edir, lakin paylaşılan qradientlər və ya model yeniləmələri özləri məlumat sızdıra bilər; axtarış edilə bilən şifrələmə sürətli sorğular üçün giriş nümunəsi və ya sorğunun təkrarlanması kimi müəyyən sızıntıları qəbul edə bilər. Buna görə “ən təhlükəsiz üsul” və ya “ən sürətli üsul” kimi kontekstdən qoparılmış vahid sıralama elmi baxımdan mənalı deyil.
İcmalın kvant-sonrası hissəsi xüsusilə vacibdir, lakin burada araşdırılan mövzu yeni kvant kompüteri və ya kvant maşın öyrənməsi alqoritmi deyil. Tədqiqat kifayət qədər böyük və xətaya davamlı kvant kompüterinin Shor alqoritmi vasitəsilə RSA, Diffie–Hellman və elliptik əyri kriptoqrafiyası kimi vuruqlara ayırma və ya diskret loqarifm əsaslı açıq-açarlı sistemləri təhdid edəcəyini; bunun müqabilində simmetrik şifrələmə, diferensial məxfilik, informasiya-nəzəri secret-sharing və qəfəs əsaslı homomorfik şifrələmənin eyni şəkildə təsirlənmədiyini vurğulayır. NIST-in 2024-cü ildə yayımladığı ML-KEM, ML-DSA və SLH-DSA standartları bu keçidin əsas komponentləri kimi araşdırılır. “Kvanta davamlı” ifadəsi burada mütləq və sonsuza qədər sübut olunmuş təhlükəsizlik demək deyil; məlum klassik və kvant hücumlarına qarşı mövcud kriptoqrafik fərziyyələr altında hazırlanmış təhlükəsizliyi ifadə edir.
Məxfiliyi Qoruyan Maşın Öyrənməsi Nədir?
Məxfiliyi qoruyan maşın öyrənməsi, maşın öyrənməsi üçün lazım olan məlumatın statistik dəyərindən istifadə etməyə çalışarkən xam məlumatı, fərdi qeydləri, model yeniləmələrini və ya hesablama prosesini təhdid modelində müəyyən edilmiş hücumçulardan qorumaq üçün kriptoqrafiya, statistika və sistem mühəndisliyini birləşdirən üsullar ailəsidir; lakin PPML tək bir alqoritm deyil və hər PPML texnikası fərqli aktivi, fərqli hücumçuya qarşı və fərqli xərc hesabına qoruyur.
Niyə “məlumat cihazdan çıxmır” demək təkbaşına məxfilik zəmanəti deyil?
Tədqiqatın başlanğıc nöqtəsi həssas məlumatın birbaşa paylaşılmamasının təkbaşına kifayət etməməsidir. Xəstəxana pasiyent görüntülərini mərkəzi serverə göndərməsə, bank yalnız model yeniləmələrini paylaşsa və ya telefon klaviaturası yalnız qradient göndərsə belə, bu aralıq təsvirlər məlumat haqqında informasiya daşıya bilər. İcmalda verilən üzvlük çıxarışı hücumları müəyyən qeydin təlim məlumat dəstində olub-olmadığını model davranışından təxmin etməyə çalışır. Qradient inversiyası hücumları isə paylaşılan qradientlərdən təlim görüntülərini və etiketləri yenidən qurmağa qədər gedə bilər.
Buna görə PPML-də ilk sual “məlumat mərkəzdədir, yoxsa cihazda?” deyil, “Hücumçu hansı məlumatı görə bilir və bundan nə çıxara bilər?” sualıdır. Mənbə tədqiqatın bütün texniki müqayisələri bu təhdid-modeli yanaşması üzərində qurulmuşdur.
Təhdid modeli niyə bütün texniki seçimlərdən əvvəl gəlir?
Təhlükəsizlik və ya məxfilik iddiası hücumçunun nə edə bildiyi müəyyən edilmədən mənalı deyil. Mənbə iki əsas kriptoqrafik hücumçu sinfini ayırır. Yarı-dürüst (semi-honest və ya honest-but-curious) hücumçu protokol addımlarını düzgün yerinə yetirir, lakin gördüyü mesajlardan əlavə məlumat çıxarmağa çalışır. Zərərli/aktiv (malicious) hücumçu isə protokoldan kənara çıxa, saxta mesaj göndərə, hesablamanı poza və ya məlumat əldə etmək üçün protokolu yarımçıq dayandıra bilər.
İkinci ox corruption threshold, yəni hücumçunun neçə tərəfi ələ keçirib birlikdə işlədə bilməsidir. MPC protokollarında “üç tərəf var” demək təkbaşına təhlükəsizlik izahı deyil; məsələn, ən azı iki tərəfin bir-biri ilə gizli razılaşmayacağı fərz edilirsə, bu təşkilati fərziyyə real dünyada da müdafiə oluna bilməlidir.
| Təminat növü | Əsas fikir | Tipik nümunə | Kritik sərhəd |
|---|---|---|---|
| Hesablama təhlükəsizliyi | Müəyyən riyazi problemin məqbul müddətdə həll edilə bilməyəcəyi fərz olunur. | HE, ML-KEM, ML-DSA | Təhlükəsizlik kriptoanaliz və hesablama gücündəki irəliləyişlərdən asılıdır. |
| İnformasiya-nəzəri / şərtsiz təhlükəsizlik | Hücumçunun hesablama gücü məhdudsuz olsa belə, müəyyən fərziyyələr altında məlumat əldə edə bilməz. | Bəzi secret-sharing strukturları | Adətən honest-majority kimi struktur fərziyyələri tələb olunur. |
| Statistik məxfilik | Qonşu məlumat dəstlərindən alınan çıxış paylanmalarının fərqləndirilə bilməsi məhdudlaşdırılır. | Diferensial məxfilik | Dəqiqlik/faydalılıq xərci və kompozisiya ilə böyüyən məxfilik büdcəsi var. |
Əslində nə qorunur: giriş, çıxış, model, yoxsa hesablamanın bütövlüyü?
Giriş gizliliyi, serverin və ya digər tərəflərin hesablamaya daxil olan pasiyent görüntüsü, maliyyə qeydi və ya özəl sorğu kimi məlumatları görməməsidir. Homomorfik şifrələmə və MPC-nin əsas rolu bu qatdadır.
Çıxış məxfiliyi, dərc edilən modelin və ya statistikanın təlim məlumatındakı fərdlər haqqında nə qədər informasiya açıqladığı ilə bağlıdır. Diferensial məxfilik bu problemə yönəlir. Kriptoqrafik baxımdan qüsursuz hesablanmış nəticə belə fərd haqqında həddən artıq məlumat açıqlayırsa, çıxış məxfiliyi təmin edilmiş sayılmır.
Model gizliliyi də ayrıca qorunan aktivdir. Müştəri serverə özəl məlumatını göndərmək istəməyə bilər; eyni zamanda server də öz model çəkilərinin müştəri tərəfindən çıxarılmasını istəməyə bilər. Təhlükəsiz inferensiya protokollarının bir qismi bu ikitərəfli gizlilik tələbini hədəfləyir.
Bütövlük (integrity) isə gizlilikdən fərqlidir. Serverin girişi görə bilməməsi onun düzgün hesablama apardığı anlamına gəlmir. Buna görə sıfır-bilik sübutları kimi üsullar gizliliyi təmin edən HE və ya MPC-ni “hesablama həqiqətən deyildiyi kimi aparıldımı?” sualı ilə tamamlayır.
Məxfiliyin xərci hansı resursdan ödənilir?
İcmalın ən faydalı çərçivələrindən biri müxtəlif texnikaların xərci müxtəlif resurslara daşıdığını göstərməsidir. HE əsasən hesablama vaxtı və yaddaş sərf edir. MPC hesablamanı şəbəkə rabitəsinə çevirir. Diferensial məxfilik xərci model dəqiqliyi və ya statistik faydalılıq üzərindən ödəyir. Federativ öyrənmə məlumatın hərəkətini azaldarkən çoxsaylı model yeniləmələri səbəbindən rabitə və müştəri heterogenliyi xərci yaradır. Axtarış edilə bilən şifrələmə isə sürət qazanmaq üçün müəyyən sızıntı profilini qəbul edə bilər.
Homomorfik Şifrələmə Maşın Öyrənməsini Şifrələnmiş Məlumat Üzərində Necə İşlədir?
Homomorfik şifrələmə serverə açıq məlumatı və ya gizli açarı görmədən şifrələnmiş qiymətlər üzərində riyazi əməliyyatlar aparmağa və əldə etdiyi şifrələnmiş nəticəni yalnız səlahiyyətli açar sahibinin açmasına imkan verən kriptoqrafik hesablama yanaşmasıdır; maşın öyrənməsində əsas üstünlüyü tək bir etibarsız serverdə interaktiv olmayan giriş gizliliyi təmin etməsi, əsas çatışmazlığı isə açıq mətn hesablaması ilə müqayisədə çox yüksək arifmetik və yaddaş xərcidir.
Şifrələnmiş məlumat üzərində əməliyyat aparmaq necə mümkün olur?
Adi şifrələmədə məlumat üzərində hesablama aparmaq üçün məlumat çox vaxt əvvəlcə açılır. Homomorfik şifrələmənin məqsədi bu məcburiyyəti aradan qaldırmaqdır. Müştəri \(x\) məlumatını şifrələyib \(Enc(x)\) yaradır. Server gizli açarı bilmədən müəyyən \(f\) funksiyasını şifrəli sahədə qiymətləndirir:
\[ Eval(f, Enc(x)) \rightarrow Enc(f(x)) \]
Müştəri nəticəni açdıqda:
\[ Dec(Enc(f(x))) \approx f(x) \]
əldə edir. Bu göstərim tədqiqatın yeni tənliyi deyil; homomorfik hesablamanın öyrədici konseptual xülasəsidir. BFV və BGV kimi tam ədəd sxemlərində məqsəd dəqiq arifmetikadır; CKKS-də həqiqi və kompleks ədədlər təqribi kodlaşdırıldığı üçün nəticədə idarə olunan təqribi xəta ola bilər.
LWE və RLWE niyə bu qədər mərkəzidir?
İcmaldakı müasir HE sistemlərinin çoxu Learning With Errors (LWE; Səhvlərlə Öyrənmə) və ya onun halqa/modul törəmələrinə əsaslanan qəfəs problemlərindən təhlükəsizlik əldə edir. Əsas öyrədici intuisiya xətti əlaqənin içinə kiçik, lakin diqqətlə seçilmiş xəta əlavə edilməsidir.
Mənbədə açıq tənlik kimi verilməsə də LWE ideyasının standart konseptual yazılışı belə göstərilə bilər:
\[ \mathbf{b}=\mathbf{A}\mathbf{s}+\mathbf{e}\pmod q \]
Burada \(\mathbf{A}\) açıq struktur, \(\mathbf{s}\) gizli məlumat və \(\mathbf{e}\) kiçik xəta terminidir; \(q\) moduldur. Hücumçu \(\mathbf{A}\) və \(\mathbf{b}\)-ni görsə də, xəta səbəbindən \(\mathbf{s}\)-ni bərpa etmək problemi çətinləşir. Bu tənlik ML-KEM və ya CKKS-nin tam protokol tərifi deyil; yalnız LWE ailəsinin əsas riyazi intuisiyasını öyrətmək üçün verilib.
RLWE əsaslı sxemlərdə skalyar və ya adi vektorlar əvəzinə polinom halqaları istifadə olunur. Bu struktur həm təhlükəsizlik, həm də çoxsaylı qiymətlərin tək ciphertext daxilində paketlənməsi baxımından vacibdir.
BGV, BFV, CKKS və TFHE arasında fərq nədir?
| Sxem | Təbii məlumat sahəsi | Arifmetika | Bootstrapping xarakteri | Maşın öyrənməsində tipik rol |
|---|---|---|---|---|
| BGV | Modulyar tam ədədlər | Dəqiq, SIMD paketləmə | Leveled; lazım olduqda yeniləmə | Polinom qiymətləndirmə, statistika |
| BFV | Modulyar tam ədədlər | Dəqiq, SIMD paketləmə | Leveled; lazım olduqda yeniləmə | Tam ədəd model inferensiyası |
| CKKS | Təqribi həqiqi/kompleks ədədlər | Təqribi, SIMD paketləmə | Təqribi modulyar reduksiya əsaslı müxtəlif üsullar | Dərin neyron şəbəkəsi və transformer inferensiyası |
| TFHE | Bitlər / kiçik tam ədədlər | Boolean və ya lookup-table yönümlü | Çox sürətli gate-by-gate bootstrapping | Müqayisə, qərar ağacı, qeyri-xətti funksiyalar |
Mənbədə ring dimension \(N\) üçün tipik qiymətlərin təxminən \(2^{13}\)–\(2^{17}\) intervalında olduğu, SIMD paketləməsində isə təxminən \(2^{12}\)–\(2^{16}\) plaintext slotunun istifadə oluna bildiyi bildirilir. Bu rəqəmlər hər tətbiq üçün sabit parametr deyil; təhlükəsizlik səviyyəsinə, dövrə dərinliyinə və kitabxana seçiminə görə dəyişir.
Ciphertext daxilindəki “noise” niyə var və niyə böyüyür?
Qəfəs əsaslı şifrələmə sistemlərində xəta və ya noise yalnız arzuolunmaz qüsur deyil; təhlükəsizliyin bir hissəsidir. Lakin homomorfik toplama və xüsusilə vurma əməliyyatları ciphertext daxilindəki bu xətanın böyüməsinə səbəb olur. Xəta müəyyən həddi aşarsa düzgün deşifrləmə uğursuz ola bilər. Buna görə homomorfik proqramda yalnız hansı riyazi əməliyyatların aparıldığı deyil, ardıcıl neçə vurma əməliyyatının olduğu da kritikdir.
Mənbənin simvol cədvəlində \(Q\) ciphertext modulusunu və modulus zəncirinin istifadə edilə bilən vurma dərinliyini necə müəyyən etdiyini; \(L\) isə bootstrapping tələb olunmazdan əvvəl sərf edilə bilən multiplicative depth-i təmsil edir. Daha dərin şəbəkə daha çox vurma və nəticədə daha çox noise-budget sərfi deməkdir.
Bootstrapping nədir?
Bootstrapping, səs-küyü böyümüş ciphertext üzərində deşifrləmə dövrəsinin özünü homomorfik qiymətləndirərək yeni və aşağı səs-küylü ciphertext yaratmaq əməliyyatıdır. Bu əməliyyat yalnız məhdud vurma dərinliyini dəstəkləyən “leveled” HE-dən nəzəri olaraq məhdudiyyətsiz dərinlikli hesablamaya imkan verən fully homomorphic encryption-a keçidi təmin edir.
Lakin bootstrapping HE-nin ən bahalı əməliyyatlarından biridir. Mənbə CKKS və TFHE ailələrinin xərc strukturunun fərqli olduğunu vurğulayır. CKKS geniş həqiqi ədəd vektorlarını paketləyərək yüksək throughput əldə edir. TFHE isə ayrı-ayrı bit və ya kiçik tam ədəd əməliyyatlarında proqramlaşdırıla bilən lookup table və gate-level bootstrapping yanaşması ilə aşağı tək-əməliyyat gecikməsinə yönəlir.
Mənbədə TFHE üçün tarixən tək nüvədə gate bootstrapping vaxtının təxminən 13 ms-yə və bootstrapping açarının təxminən 16 MB-a endirildiyi nəticə verilir. Bu qiymətlər bütün TFHE tətbiqlərinin bugünkü performansı deyil; icmalda araşdırılan konkret tədqiqatın bildirdiyi istinad nəticəsidir.
CKKS bootstrapping niyə xüsusilə maşın öyrənməsində vacibdir?
CKKS həqiqi və kompleks qiymətləri təqribi işləyə bildiyinə görə neyron şəbəkələrinin sabit nöqtəli ədədi əməliyyatlarına daha təbii uyğunlaşır. CKKS bootstrapping-in klassik yolunda CoeffToSlot və SlotToCoeff adlanan xətti çevirmələr ilə modulyar reduksiyanı təqribi həyata keçirən polinomlardan istifadə olunur. Mənbənin verdiyi yaxın dövr tədqiqatlarında qismən CoeffToSlot parçalanması mürəkkəbliyi azaltmış; level-conserving rescaling üsulları oxşar parametrlərlə throughput-u təxminən %20–35 artıra bilmişdir.
İcmal həmçinin roots-of-unity əsaslı daha dayaz bootstrapping yanaşmalarını, PaCo kimi blind-rotation əsaslı strukturları və functional bootstrapping üsullarını nəzərdən keçirir. Functional bootstrapping yalnız ciphertext-i yeniləmir; eyni əməliyyat zamanı lookup table ilə müəyyən edilən funksiyanı da tətbiq edə bilər. Mənbədə səkkiz bitlik lookup table üçün CKKS üzərində qiymət başına amortizasiya olunmuş təxminən 0,72 ms bildirən tədqiqat təqdim olunur; bu qiymət DM/CGGI yanaşmasından təxminən üç böyüklük mərtəbəsi və daha məhdud BFV əsaslı amortizasiya olunmuş functional bootstrapping üsulundan təxminən 6,8 dəfə daha sürətli kimi bildirilir. Bunlar fərqli sistemlər və parametrlər altında bildirilmiş ədəbiyyat nəticələridir; universal performans əmsalı deyil.
Scheme switching niyə ortaya çıxdı?
Tək HE sxemi hər əməliyyat tipində optimal deyil. CKKS böyük həqiqi ədəd vektorlarında arifmetikanı səmərəli yerinə yetirərkən müqayisə və ya diskret lookup əməliyyatları TFHE-bənzər strukturlarda daha təbii ola bilər. Scheme switching, hesablamanın böyük hissəsini CKKS ilə aparıb ReLU-bənzər müqayisə və ya aktivasiya lazım olduqda müvəqqəti olaraq bit-əsaslı təqdimata keçmək, sonra yenidən CKKS-ə qayıtmaq deməkdir. Beləliklə hər riyazi qat özünü daha ucuz qiymətləndirə bilən kriptoqrafik təqdimat üzərində işlədilə bilər.
Şifrələnmiş neyron şəbəkəsi inferensiyasında nə qədər irəliləyiş var?
| Sistem | Yanaşma | Model / məlumat | Mənbədə bildirilən nəticə | Müqayisə sərhədi |
|---|---|---|---|---|
| CryptoNets | Leveled HE | Dayaz CNN / MNIST | Təxminən %99 dəqiqlik; təxminən 51.000 proqnoz/saat throughput | Batch amortizasiyası yüksəkdir, tək sorğu gecikməsi dəqiqələr miqyasında ola bilər. |
| RNS-CKKS ResNet-20 | Bootstrapped HE | ResNet-20 / CIFAR-10 | %92,43 dəqiqlik; plaintext modellə girişlərin %98-dən çoxunda eyni çıxış; şəkil başına saat miqyası | Avadanlıq və model şərtləri köhnə/xüsusidir. |
| Multiplexed convolution yanaşması | Bootstrapped HE | ResNet-20/110 | Təxminən 4,7 dəfə gecikmə azalması; amortizasiya olunmuş vaxtda iki böyüklük mərtəbəsindən çox yaxşılaşma | Fərqli eksperimental quruluş. |
| NEXUS | İnteraktiv olmayan HE | BERT miqyası | Onlarla saniyə miqyasında inferensiya və interaktiv baseline-lara nisbətən yüzlərlə dəfə bant genişliyi azalması | Digər sistemlərlə nəzarətli benchmark deyil. |
| PUMA | 3 tərəfli MPC | LLaMA-7B | Dəqiqələr miqyasında təhlükəsiz inferensiya | HE-only sistemlə birbaşa ekvivalent deyil. |
Bu cədvəl “hansı daha sürətlidir?” sualına birbaşa cavab vermək üçün istifadə edilməməlidir. CryptoNets kimi throughput-yönümlü sistemlər minlərlə sorğunu tək ciphertext-in slotlarına paketləyərək sabit xərci bölüşdürür. İnteraktiv tətbiqdə isə tək sorğunun nəticəyə çatma vaxtı vacibdir. Mənbə bu iki iş rejimini qarışdırmağın bildirilən performansı üç böyüklük mərtəbəsinə qədər yanıltıcı göstərə biləcəyini vurğulayır.
Transformer modelləri HE üçün niyə xüsusilə çətindir?
Convolutional şəbəkələrdə xətti qatlar HE altında nisbətən uyğun olsa da, transformer arxitekturalarında softmax, GELU, layer normalization, bölmə və kvadrat kök əməliyyatları birbaşa polinom arifmetikasına uyğun gəlmir. Həllər üç əsas qrupa bölünür:
- Xətti qatları HE ilə, qeyri-xətti qatları MPC/secret sharing ilə qiymətləndirən hibrid protokollar.
- Bütün hesablamanı HE daxilində saxlayıb softmax və bənzər funksiyaları polinom yaxınlaşmaları ilə əvəz edən interaktiv olmayan protokollar.
- Model arxitekturasını əvvəlcədən şifrələmə-dostu dizayn edərək bahalı qeyri-xətti əməliyyatları azaldan birgə dizayn yanaşmaları.
Buna görə şifrələnmiş maşın öyrənməsində yalnız kriptoqrafiyanı sürətləndirmək kifayət etmir; model arxitekturası ilə kriptoqrafik təqdimatın birlikdə dizaynı getdikcə daha vacib olur.
GPU, FPGA və ASIC sürətləndirilməsi nəyi dəyişir?
İcmalda HE arifmetikasının bir çox halda sırf hesablama vahidlərinin sayından daha çox yaddaş bant genişliyi və məlumat hərəkəti ilə məhdudlaşdığı vurğulanır. Number-Theoretic Transform (NTT) və key-switching əməliyyatları xüsusilə vacibdir. GPU-larda memory-centric optimizasiyalarla bəzi amortizasiya olunmuş bootstrapping iş yüklərində 100 dəfədən çox sürətlənmə bildirilib.
CPU tətbiqləri ümumi təyinatlı və asan əlçatan olsa da, yaddaş bant genişliyi məhdudiyyətinə tez ilişə bilər. GPU-lar yüksək paralellik və bant genişliyi verir. FPGA-lar proqramlaşdırıla bilən məlumat yolları ilə müəyyən modulyar arifmetik əməliyyatlara uyğunlaşdırıla bilər. ASIC-lər ən yüksək performans potensialına malikdir, lakin dizayn və istehsal xərcləri yüksəkdir. Mənbə həmçinin mövcud sürətləndirici qiymətləndirmələrinin böyük hissəsinin CIFAR-10/ResNet-20 kimi nisbətən kiçik convolutional modellərdə aparıldığına diqqət çəkir; böyük transformer iş yüklərində eyni nəticələrin avtomatik keçərli olduğu fərz edilə bilməz.
Sıfır-bilik sübutu HE-nin hansı çatışmazlığını tamamlayır?
Homomorfik şifrələmə serverin girişi görməsinin qarşısını ala bilər, lakin serverin düzgün nəticəni hesabladığını təkbaşına sübut etmir. Zərərli server yanlış qiymətin düzgün formalı ciphertext-ini qaytara bilər. Sıfır-bilik sübutu serverə müəyyən hesablamanı düzgün apardığını altdakı gizli məlumatı açıqlamadan sübut etməyə imkan verir.
İcmal zkCNN kimi tədqiqatlarda özəl test məlumatını və ya model çəkilərini açıqlamadan convolutional-network proqnozu və dəqiqlik iddiası üçün sübut yaradıla bildiyini; daha yeni işlərin isə təlim prosesinə qədər uzandığını bildirir. Lakin hesablamanı sübut etmək çox vaxt hesablamanın özündən xeyli baha başa gəlir. HE ilə ZKP-ni birləşdirmək iki bahalı mexanizmin xərcini üst-üstə qoyduğuna görə bugünkü sistemlər adətən yalnız bütövlüyün kritik olduğu addımları sübut etməyə çalışır.
Diferensial Məxfilikdə ε və δ Nə Deməkdir?
\((\varepsilon,\delta)\)-diferensial məxfilik yalnız bir qeydin dəyişdiyi iki qonşu məlumat dəsti üzərində işləyən təsadüfiləşdirilmiş mexanizmin çıxış paylanmalarının bir-birindən nə qədər fərqlənə biləcəyini məhdudlaşdırır; \(\varepsilon\) kiçildikcə paylanmaları fərqləndirmək çətinləşir və daha güclü məxfilik hədəflənir, \(\delta\) isə ideal multiplikativ sərhədin kiçik ehtimalla aşılmasına imkan verən əlavə termindir; bu parametrlərin heç biri kontekstdən asılı olmayan “təkbaşına təhlükəsiz” hədd kimi şərh edilməməlidir.
Diferensial məxfiliyin əsas riyazi tərifi
Mənbə tərifi sözlə verir. Bunun standart riyazi yazılışı öyrədici fon məqsədilə belə göstərilə bilər:
\[ \Pr[M(D)\in S] \leq e^{\varepsilon}\Pr[M(D')\in S]+\delta \]
Burada:
- \(M\): təsadüfiləşdirilmiş mexanizmdir.
- \(D\) və \(D'\): yalnız bir fərdi qeyddə fərqlənən qonşu məlumat dəstləridir.
- \(S\): mümkün çıxışların istənilən çoxluğudur.
- \(\varepsilon\): çıxış ehtimallarının multiplikativ olaraq nə qədər fərqlənə biləcəyini məhdudlaşdırır.
- \(\delta\): çox kiçik əlavə uğursuzluq ehtimalına imkan verir.
Bu bərabərsizlik “fərdin məlumatı heç vaxt öyrənilə bilməz” demək deyil. Daha dəqiq mənası odur ki, bir fərdin məlumat dəstinə daxil edilib-edilməməsi mexanizmin çıxış paylanmasını məhdud dərəcədə dəyişir. Mənbənin simvol cədvəlində \(\delta\)-nın ənənəvi olaraq \(1/n\)-dən çox daha kiçik seçildiyi bildirilir; burada \(n\) məlumat dəstindəki qeydlərin sayıdır.
ε kiçildikdə niyə model dəqiqliyi azala bilər?
Diferensial məxfilik praktik mexanizmlərin çoxunda məlumatlara və ya qradientə təsadüfi səs-küy əlavə etməklə təmin olunur. Daha güclü məxfilik üçün daha çox səs-küy tələb olunması modelin öyrənməyə çalışdığı faydalı siqnalın da qismən pozulmasına səbəb ola bilər. Buna görə DP-nin əsas xərc oxu CPU vaxtı deyil, privacy–utility trade-off, yəni məxfiliklə faydalılıq arasındakı kompromisdir.
Mənbə Şəkil 3-də \(\varepsilon \leq 1\), \(1 < \varepsilon \leq 4\) və \(\varepsilon > 4\) bölgələrini müvafiq olaraq güclü, orta və zəif məxfilik üçün sxematik bölgələr kimi göstərir. Bu qrafik ölçülmüş məlumat deyil və bu hədlər bütün tətbiqlər üçün hüquqi və ya elmi universal sərhədlər kimi oxunmamalıdır. Şəklin əsas mesajı model arxitekturası, ilkin təlim, DP-SGD parametrləri və accounting keyfiyyətinin eyni \(\varepsilon\) qiymətində əldə olunan faydalılığı əhəmiyyətli dərəcədə dəyişə bilməsidir.
Sensitivity, Δf, niyə vacibdir?
Sorğunun həssaslığı (sensitivity, \(\Delta f\)), tək qeydin dəyişdirilməsi halında sorğunun çıxışının ən çox nə qədər dəyişə biləcəyini müəyyən edir. Səs-küy miqyası bu qiymətə görə tənzimlənir. Tək fərdin çıxışı çox böyük həcmdə dəyişə bildiyi sorğunu gizlətmək, fərdi töhfənin əvvəlcədən məhdud olduğu sorğuya nisbətən daha çox səs-küy tələb edir.
Laplace və Gaussian mexanizmləri arasındakı fərq
Laplace mexanizmi L1 həssaslığına görə səs-küy əlavə edərək saf \(\varepsilon\)-DP təmin edə bilər. Gaussian mexanizmi L2 həssaslığı ilə işləyir və \((\varepsilon,\delta)\)-DP verir. Dərin öyrənmədə qradient clipping əməliyyatının L2 həndəsəsi ilə uyğunluğu səbəbindən Gaussian mexanizmi mərkəzi rol oynayır.
DP-SGD necə işləyir?
Differentially Private Stochastic Gradient Descent (DP-SGD) hər təlim nümunəsinin qradient töhfəsini müəyyən normaya qədər məhdudlaşdırır, sonra ümumi qradientə Gaussian səs-küy əlavə edir və bütün təlim addımlarının ümumi məxfilik itkisini privacy accountant ilə izləyir.
Mənbə DP-SGD-ni sözlə izah edir. Mexanizmin standart öyrədici yazılışında ilk mərhələdə tək nümunənin qradienti belə kəsilir:
\[ \bar{\mathbf{g}}_i=\mathbf{g}_i\cdot \min\left(1,\frac{C}{\|\mathbf{g}_i\|_2}\right) \]
\(C\), per-example clipping normudur. Nümunənin qradient normu \(C\)-dən kiçikdirsə dəyişmir; böyükdürsə istiqaməti saxlanmaqla böyüklüyü \(C\)-yə endirilir. Beləliklə tək qeydin yenilənməyə edə biləcəyi töhfə məhdudlaşdırılır.
Sonra konseptual olaraq:
\[ \tilde{\mathbf{g}} = \frac{1}{B} \left( \sum_{i=1}^{B}\bar{\mathbf{g}}_i + \mathcal{N}(0,\sigma^2 C^2 I) \right) \]
şəklində Gaussian səs-küy əlavə edilə bilər. Burada \(B\) batch ölçüsü, \(\sigma\) səs-küy miqyası/noise multiplier ilə əlaqəli parametr, \(C\) clipping həddi və \(I\) uyğun ölçülü vahid matrisdir. Bu formula mənbənin yeni nəticəsi deyil, mənbədə izah edilən DP-SGD mexanizminin standart öyrədici göstərimidir.
Mənbənin simvol cədvəlindəki \(q\), gözlənilən batch ölçüsünün məlumat dəsti ölçüsünə nisbəti olan sampling rate-i; \(T\) isə mexanizmin neçə dəfə kompozisiya edildiyini, məsələn neçə təlim addımı icra olunduğunu göstərir. \(C\), \(\sigma\), \(q\) və \(T\) bir-birindən asılı olmayan parametrlər deyil; yekun privacy budget hesabında birlikdə rol oynayırlar.
Privacy amplification nə deməkdir?
Hər qeydin hər təlim addımına daxil edilməməsi məxfilik baxımından üstünlük yarada bilər. Subsampling yolu ilə privacy amplification, təsadüfi nümunə götürmə səbəbindən konkret fərdin mexanizmə məruz qalma ehtimalının azalmasının effektiv məxfilik itkisini azaltması deməkdir. Mənbə həmçinin iteration və shuffling yolu ilə amplification nəticələrini müzakirə edir.
Niyə privacy accountant lazımdır?
DP mexanizmini bir dəfə işlətməklə onu on minlərlə təlim addımında təkrar-təkrar işlətmək eyni şey deyil. Hər istifadə müəyyən miqdarda məxfilik büdcəsi sərf edir. Ən sadə kompozisiya sərhədi:
\[ \varepsilon_{\mathrm{toplam}} \leq \sum_i \varepsilon_i, \qquad \delta_{\mathrm{toplam}} \leq \sum_i \delta_i \]
şəklindədir. Lakin mənbə bunun uzun təlimlərdə lazımından artıq bədbin ola biləcəyini vurğulayır. Advanced composition, Rényi Differential Privacy, Gaussian Differential Privacy və privacy-loss-distribution əsaslı ədədi accountant-lar daha sıx sərhədlər hesablaya bilər.
Bu detal praktikada vacibdir: eyni səs-küydən istifadə edən iki sistem yalnız fərqli accountant üsullarından istifadə etdiyinə görə fərqli \(\varepsilon\) qiymətləri bildirə bilər. Buna görə yalnız “ε=...” yazmaq kifayət deyil; hansı accountant-ın, sampling modelinin və \(\delta\) qiymətinin istifadə edildiyi də məlum olmalıdır.
Empirical privacy auditing niyə lazımdır?
Riyazi accounting alqoritmin spesifikasiyaya uyğun yazıldığı fərziyyəsi ilə yuxarı sərhəd verir. Real proqram təminatında clipping-in səhv tətbiqi, sampling xətası və ya noise generator problemi bu zəmanəti poza bilər. Empirik məxfilik auditi mexanizmə canary qeydlər əlavə edib üzvlük çıxarışı kimi hücumlar tətbiq etməklə real sistemin ən azı nə qədər məxfilik itkisi göstərdiyini ölçməyə çalışır.
Analitik yuxarı sərhədlə empirik aşağı sərhəd bir-birinə yaxınlaşırsa analiz sıxdır və implementasiya böyük ehtimalla düzgündür. Aralarında böyük fərq varsa analiz həddən artıq boş ola bilər və ya implementasiyada xəta ola bilər. Mənbə tək təlim icrasında çoxlu canary-nin birlikdə audit edilməsini mümkün edən üsulların bu yoxlamaları istehsal sistemləri üçün daha tətbiqolunan etdiyini vurğulayır.
LLM-lərdə diferensial məxfilik niyə daha çətindir?
Böyük dil modelləri təlim məlumatındakı nadir və ya həssas ardıcıllıqları əzbərləyə bilər. DP bu sızıntıya formal müdafiə verir, lakin milyardlarla parametri tam olaraq DP-SGD ilə yeniləmək bahadır və noise çox yüksəkölçülü parametr fəzasına tətbiq olunur.
İcmalın vurğuladığı həll modeli özəl məlumatda sıfırdan öyrətmək əvəzinə açıq məlumatda əvvəlcədən öyrədilmiş modeli həssas məlumat üzərində yalnız fine-tune etməkdir. Low-Rank Adaptation (LoRA) kimi parameter-efficient üsullar yalnız kiçik adapterləri yenilədiyi üçün clipping və səs-küy bir neçə milyard yox, bir neçə milyon parametr miqyasında tətbiq oluna bilər.
Mənbədə verilən federativ LLM uyğunlaşdırma tədqiqatında \(\varepsilon=2\) səviyyəsində və bir milyon simulyasiya olunmuş müştəri altında dəqiqlik azalmasının %2-dən aşağı, word-error-rate artımının isə %7-dən aşağı saxlandığı bildirilir. Bu nəticə konkret sistem və eksperimental şərtlərə aiddir; “ε=2 olan bütün LLM-lərdə %2 itki olur” kimi ümumiləşdirilə bilməz.
Təhlükəsiz çoxtərəfli hesablama nədir?
Secure Multi-Party Computation (MPC) bir-birinə tam etibar etməyən tərəflərə özəl girişlərini bir-birinə açıqlamadan ortaq funksiya hesablamağa imkan verir. Homomorfik şifrələmədən fərqli olaraq hesablama tək ciphertext serverində cəmlənmir; məlumat və əməliyyat tərəflər arasında paylanır.
Mənbə iki əsas ənənəyə diqqət yetirir: Boolean dövrələri üçün Yao garbled circuits və arifmetik hesablamalar üçün secret sharing. SPDZ, dishonest-majority şərtində aktiv təhlükəsizlik təmin edə bilən mühüm protokol ailələrindən biridir. ABY3 isə üç tərəfli honest-majority mühitində arithmetic, Boolean və Yao sharing təqdimatları arasında keçid edə bilən səmərəli çərçivədir.
Oblivious transfer və Beaver triples nə işə yarayır?
Oblivious transfer (OT) alıcıya göndərənin mesajlarından yalnız seçdiyini öyrənməyə; göndərənə isə hansının seçildiyini öyrənməməyə imkan verir. OT extension az sayda bahalı açıq-açar əməliyyatını çoxsaylı daha ucuz simmetrik-açar əməliyyatına genişləndirir.
Beaver multiplication triples isə secret-sharing əsaslı arifmetik MPC-də vurma əməliyyatlarını sürətləndirmək üçün əvvəlcədən yaradılmış korrelyasiyalı təsadüfi qiymətlərdir. Ağır kriptoqrafik işin mühüm hissəsi offline preprocessing mərhələsində aparılır; online mərhələ bu hazır korrelyasiyaları istifadə edərək daha sürətli işləyir.
MPC niyə şəbəkə bağlantısına HE-dən daha həssasdır?
MPC bahalı public-key arifmetikasının böyük hissəsini daha ucuz lokal əməliyyatlarla əvəz edərkən tərəflər arasında çoxsaylı mesaj mübadiləsi tələb edir. Məlumat mərkəzində yüksək bant genişlikli, aşağı gecikməli bağlantıda bu məntiqli ola bilər. Qitələrarası və ya mobil şəbəkələrdə round-trip latency eyni protokolu xeyli yavaşlada bilər.
Buna görə mənbə HE və MPC seçimini “hansının kriptoqrafiyası daha yaxşıdır?” sualından daha çox “hesablama bahadır, yoxsa şəbəkə?” sualı ilə əlaqələndirir.
Maşın öyrənməsində müqayisə əməliyyatı niyə MPC üçün bahadır?
Matris vurmaları arithmetic sharing-ə yaxşı uyğun gəlsə də ReLU, max-pooling və argmax kimi əməliyyatlar müqayisə tələb edir. Müqayisə bit səviyyəli əməliyyat olduğu üçün arithmetic sharing altında bahadır. Buna görə müasir sistemlər arithmetic representation-dan Boolean və ya garbled-circuit təqdimatına keçə və ya qeyri-xətti funksiyanı daha ucuz yaxınlaşma ilə əvəz edə bilər.
Federativ öyrənmə təkbaşına məxfilik üsuludurmu?
Xeyr. Federativ öyrənmə xam məlumatın cihazdan və ya qurumdan ayrılmamasını təmin edir, lakin serverə model yeniləmələri və ya qradientlər göndərilir. Mənbənin açıq vurğuladığı kimi FL təkbaşına formal privacy guarantee deyil; HE, MPC, secure aggregation və DP kimi qoruma qatlarının yerləşdirilə bildiyi paylanmış öyrənmə arxitekturasıdır.
Cross-device və cross-silo federasiya arasındakı fərq
Cross-device FL telefonlar kimi milyonlarla resursu məhdud və tez-tez offline olan müştərini əhatə edə bilər. Burada aşağı müştəri xərci, dropout tolerantlığı və rabitə səmərəliliyi həlledicidir.
Cross-silo FL isə xəstəxanalar və banklar kimi az sayda, lakin güclü qurumu əhatə edir. Tərəflərin sayı az, məlumat dəstləri böyük və dəyərlidir. Daha ağır HE və ya MPC mexanizmlərindən istifadə bu mühitdə daha real ola bilər.
Secure aggregation necə işləyir?
Secure aggregation serverin fərdi müştəri yeniləmələrini deyil, yalnız cəmini öyrənməsini hədəfləyir. Mənbənin təsvir etdiyi pairwise-cancelling mask yanaşmasının öyrədici riyazi intuisiyası belə göstərilə bilər:
\[ m_i = u_i + \sum_{j>i}r_{ij}-\sum_{j<i}r_{ji} \]
Müştərilərin maskalanmış qiymətləri toplandıqda:
\[ \sum_i m_i = \sum_i u_i \]
alınır; çünki eyni \(r_{ij}\) maskası bir müştəridə müsbət, digərində mənfi işarə ilə olduğu üçün cəmdə bir-birini ləğv edir. Real protokollar dropout, malicious server, açar razılaşması və secret sharing kimi əlavə mexanizmlər ehtiva edir; bu iki tənlik yalnız cancellation məntiqini öyrədir.
Mənbə BatchCrypt nümunəsində cross-silo federativ öyrənmə üçün qradientlərin paketlənərək və kvantlaşdırılaraq homomorfik şifrələnməsinin naive per-value encryption ilə müqayisədə 23–93 dəfə təlim sürətlənməsi və 66–100 dəfə rabitə azalması verdiyini, dəqiqlik itkisinin isə %1-dən aşağı qaldığını bildirən nəticələri təqdim edir. Bunlar konkret müqayisəyə aiddir.
Qradientlərdən həqiqətən görüntünü geri çıxarmaq mümkündürmü?
İcmalda verilən gradient-inversion ədəbiyyatı bunun müəyyən şərtlərdə mümkün olduğunu göstərir. Hücumçu sintetik girişin yaratdığı qradienti müşahidə olunan real qradientə yaxınlaşdıracaq şəkildə girişi optimallaşdırır. Erkən tədqiqatlar tək görüntü və kiçik şəbəkələrdə uğurlu olsa da, sonrakı hücumlar image priors, batch-normalization statistikaları və daha inkişaf etmiş objective funksiyalarından istifadə etməklə əhatəni genişləndirib.
Buradan çıxan dərs budur ki, təqdimatın insan gözünə “anlaşılmaz” görünməsi məxfilik zəmanəti deyil. Qoruma formal mexanizmə əsaslanmalıdır.
FL + DP + şifrələmə niyə birlikdə istifadə olunur?
Secure aggregation serverin tək müştəri yeniləməsini görməsinin qarşısını alır, lakin dərc olunmuş qlobal modelin müştərilər haqqında nə sızdırdığını məhdudlaşdırmır. User-level DP bu ikinci problemi hədəfləyir. Homomorphic aggregation serverdən yeniləmələri kriptoqrafik gizlədə bilər. Distributed noise generation isə DP səs-küyünü tək etibarlı serverin əlavə etməsinə ehtiyac qoymadan müştərilər arasında bölüşdürə bilər.
Lakin hər qat yeni xərc və yeni trust assumption yaradır. Təhlükəsizlik istifadə olunan texnikaların adları ilə deyil, bütün pipeline-ın ən zəif fərziyyəsi ilə müəyyən olunur.
Məxfiliklə Byzantine robustness niyə toqquşa bilər?
Zərərli müştəri zəhərlənmiş model yeniləməsi göndərə bilər. Krum, coordinate-wise median və ya trimmed mean kimi robust aggregation üsulları fərdi yeniləmələri araşdıraraq anomal töhfələri müəyyən etməyə çalışır. Lakin secure aggregation və ya HE məhz bu fərdi yeniləmələri serverdən gizlədir.
Buna görə privacy mexanizmi hücumçunun davranışını da gizlədə bilər. Həllər robust statistikanı şifrəli hesablama daxilində aparmaq, daha zəif robustness guarantee qəbul etmək və ya müştərinin gizli yeniləməsinin müəyyən hədlərə uyğun olduğunu ZKP ilə sübut etməsini tələb etməkdir. Mənbə güclü məxfilik, güclü robustness və aşağı xərcin eyni anda xərcsiz əldə edilə bilmədiyini xüsusilə vurğulayır.
Federativ LLM-lərdə niyə adapter yanaşmasından istifadə olunur?
Milyardlarla parametrli modeli hər turda telefona göndərib geri almaq praktik deyil. Bundan əlavə, cihazın optimizer state saxlaması da mümkün olmaya bilər. Buna görə mənbə bütün modeli federativ şəkildə öyrətmək əvəzinə sabit public backbone üzərində kiçik LoRA/adapter qatlarının öyrədilməsini önə çıxan yanaşma kimi göstərir. Müştəri yalnız kiçik adapteri yeniləyir və ötürür; bu həm rabitəni, həm də DP altında noise tətbiq olunacaq parametr ölçüsünü azaldır.
Axtarış edilə bilən şifrələmə nəyi həll edir?
Searchable Symmetric Encryption (SSE) müştəriyə şifrələnmiş sənəd kolleksiyasını etibarsız serverdə saxlamağa və sənədləri tam açmadan şifrələnmiş açar söz sorğuları etməyə imkan verir. Lakin səmərəli SSE dizaynları çox vaxt giriş nümunəsi, sorğunun təkrarı və ya nəticə həcmi kimi müəyyən yan məlumatları sızdırır.
Forward privacy və backward privacy nədir?
Forward privacy verilənlər bazasına yeni əlavə olunan sənədin keçmiş axtarış tokenları ilə əlaqələndirilə bilməməsini hədəfləyir. Backward privacy isə silinmiş sənədlərin gələcək sorğularla yenidən açıqlanmamasını təmin etmək üçün hazırlanır. Dinamik SSE-nin mühüm tədqiqat problemi bu iki zəmanəti zəngin sorğular və aşağı xərc ilə birlikdə təmin edə bilməkdir.
Leakage-abuse hücumu niyə vacibdir?
SSE alqoritminin kriptoqrafik nüvəsi nəzəri olaraq təhlükəsiz olsa belə, hücumçu hansı ciphertext-lərə giriş edildiyini, eyni sorğunun təkrarlandığını və ya neçə nəticənin qaytarıldığını görə bilər. Access-pattern hücumları sənəd giriş çoxluqlarını; volume hücumları nəticə sayını; injection hücumları isə hücumçunun əlavə etdiyi xüsusi sənədlərin yaratdığı dəyişikliklərdən istifadə edərək həqiqi sorğu sözlərini təxmin etməyə çalışa bilər.
Buna görə SSE-də “şifrə açılmadı” ifadəsi “məlumat sızmadı” demək deyil. Mənbə real təhlükəsizliyin sxemin leakage profile-ı ilə hücumçunun yan məlumatının birlikdə qiymətləndirilməsini tələb etdiyini müdafiə edir.
ORAM nə edir?
Oblivious RAM (ORAM) eyni uzunluqda iki giriş ardıcıllığının server baxımından hesablama cəhətdən fərqləndirilə bilməməsini hədəfləməklə giriş nümunəsini gizlədir. Path ORAM ağac əsaslı quruluşu ilə bu qorumanı loqarifmik bant genişliyi overhead-i ilə təmin etməyə çalışan ən məşhur strukturlardan biridir.
Bu daha güclü privacy daha yüksək xərclə gəlir. SSE sürətlidir, lakin leakage qəbul edir; ORAM giriş nümunəsini daha güclü gizlədir, lakin məlumat daşınması və yenidən təşkil xərci artır. Private Information Retrieval isə xüsusilə read-only sorğular üçün başqa nöqtədə yerləşir.
Kvant Kompüterləri Bu Məxfilik Texnikalarının Hansılarını Təhdid Edir?
Kifayət qədər böyük və xətaya davamlı kvant kompüteri ilk növbədə vuruqlara ayırma və diskret loqarifm problemlərinə əsaslanan RSA, klassik Diffie–Hellman və elliptik əyri kriptoqrafiyası kimi açıq-açarlı mexanizmləri Shor alqoritminə görə təhdid edir; eyni təhdid diferensial məxfiliyə, informasiya-nəzəri secret sharing-ə, simmetrik şifrələməyə və ya qəfəs əsaslı homomorfik şifrələməyə eyni şəkildə tətbiq olunmur və buna görə PPML sistemlərində kvant keçidi bütün komponentləri topdan dəyişmək deyil, kvanta açıq qatları düzgün inventarlaşdırıb əvəz etmək deməkdir.
Bu məqalədəki “kvant-sonrası” kvant kriptoqrafiyasıdırmı?
Xeyr. Post-quantum cryptography (PQC) bu gün istifadə etdiyimiz klassik kompüter və şəbəkələrdə işləyə bilən, lakin məlum böyükmiqyaslı kvant hücumlarına davamlı olması hədəflənən klassik kriptoqrafik alqoritmləri ifadə edir. Bu anlayış fotonlardan və kvant fiziki kanallarından istifadə edən quantum key distribution ilə eyni deyil. Mənbənin diqqəti NIST tərəfindən standartlaşdırılmış və klassik proqram/aparat üzərində tətbiq oluna bilən post-quantum alqoritmlərə yönəlib.
Shor alqoritmi dəqiq olaraq nəyi dəyişir?
RSA-nın təhlükəsizliyi böyük tam ədədlərin vuruqlara ayrılmasının, klassik Diffie–Hellman və elliptik əyri kriptoqrafiyasının təhlükəsizliyi isə uyğun qruplardakı discrete logarithm probleminin klassik kompüterlər üçün çətin olmasına əsaslanır. Shor alqoritmi ideal və kifayət qədər böyük kvant kompüterində bu problem siniflərini polinom zamanda həll edə bilər.
Bu ifadə “bugünkü kvant kompüterləri internetdəki RSA-nı indi rutin şəkildə qırır” demək deyil. Mənbənin təhdid modeli kifayət qədər qabiliyyətli gələcək kvant kompüteri üzərindədir.
Harvest-now-decrypt-later təhdidi nədir?
Hücumçu bu gün aça bilmədiyi şifrələnmiş trafiki qeyd edib illərlə saxlaya bilər. Kifayət qədər kvant tutumu gələcəkdə ortaya çıxdıqda köhnə ciphertext-ləri açmağa cəhd göstərə bilər. Buna görə bu gün 20–30 il gizli qalmalı olan genomik, dövlət, müdafiə və ya uzunömürlü şəxsi qeydlər üçün təhdid yalnız gələcəkdə başlamır; məlumatın bu gün ələ keçirilməsi ilə başlaya bilər.
Grover alqoritmi AES-i Shor kimi tamamilə qırırmı?
Xeyr. Mənbənin etdiyi kritik fərq budur. Grover alqoritmi ümumi axtarış problemini kvadratik sürətləndirir. Kobud qüvvə axtarışında klassik \(k\)-bit açar məkanı təxminən:
\[ O(2^k) \]
sınaq tələb etdiyi halda ideal Grover modeli bunu təxminən:
\[ O(2^{k/2}) \]
oracle çağırışı səviyyəsinə endirir. Bu öyrədici mürəkkəblik göstərimi tədqiqatın yeni nəticəsi deyil. Nəticə simmetrik şifrələmənin tamamilə yararsız olması deyil, təhlükəsizlik marjasının azalmasıdır. Mənbə buna görə daha uzun simmetrik açarların və hash çıxış ölçülərinin kvant-sonrası planlamada istifadə oluna biləcəyini bildirir.
Post-quantum təhlükəsizlik niyə “riyazi olaraq sonsuza qədər sübut olunub” demək deyil?
ML-KEM və ML-DSA kimi qəfəs əsaslı sistemlərin məlum səmərəli klassik və ya kvant hücumlarına davamlı olduğuna inanılır. Lakin bu, gələcəkdə heç bir yeni alqoritmin tapılmayacağının riyazi sübutu deyil. NIST standartlaşdırma prosesinin illərlə açıq kriptoanaliz aparmasının, bəzi namizədlərin qırılmasının və qəfəs əsaslı standartlarla yanaşı hash əsaslı SLH-DSA kimi fərqli fərziyyəyə söykənən alternativ saxlanmasının səbəbi məhz bu qeyri-müəyyənliyi idarə etməkdir.
NIST-in 2024 post-quantum standartları
| Standart | Alqoritm mənşəyi | Riyazi əsas | Vəzifə | Mənbədə verilən ölçü məlumatı |
|---|---|---|---|---|
| FIPS 203 | ML-KEM / CRYSTALS-Kyber | Module-LWE | Açar kapsullaşdırma / açar qurulması | Public key təxminən 800–1568 byte; ciphertext təxminən 768–1568 byte |
| FIPS 204 | ML-DSA / CRYSTALS-Dilithium | Module-LWE / Module-SIS | Rəqəmsal imza | İmza təxminən 2420–4595 byte |
| FIPS 205 | SLH-DSA / SPHINCS+ | Hash funksiyasının təhlükəsizliyi | Rəqəmsal imza / alqoritmik müxtəliflik | İmza təxminən 7856–49.856 byte |
Mənbəyə görə bu standartların parametr dəstləri NIST təhlükəsizlik kateqoriyaları 1, 3 və 5-də müəyyən edilir və təxminən AES-128, AES-192 və AES-256-nın klassik/kvant hücum xərclərinə uyğun təhlükəsizlik hədəfləri ilə əlaqələndirilir.
Module-LWE ilə homomorfik şifrələmə arasında əlaqə nədir?
ML-KEM və ML-DSA-nın Module-LWE ailəsi ilə CKKS, BFV, BGV və TFHE-nin söykəndiyi LWE/RLWE ailəsi eyni geniş qəfəs əsaslı problem ailəsinə aiddir. Buna görə mənbə qəfəs əsaslı homomorfik şifrələmənin nüvəsini artıq post-quantum xarakterli hesab edir.
Bu çox vacib fərqdir: HE sistemi kvant keçidində başlanğıcdan tamamilə atılmalı olmaya bilər. Əsas zəif nöqtə HE hesablamasının ətrafındakı klassik TLS açar mübadiləsi, ECC imzaları, sertifikatlar və ya digər classical public-key komponentləri ola bilər.
Federativ öyrənmədə kvant təhdidi haradadır?
Mənbənin verdiyi nümunədə federativ öyrənmənin secure aggregation və ya lattice-HE ilə qorunan model yeniləmələri artıq post-quantum davamlılığa malik ola bilər. Lakin milyonlarla müştərinin kimliyini doğrulayan ECC imzaları kvant təhdidinə açıq qala bilər. Buna görə keçid model yeniləməsinin riyaziyyatından daha çox authentication qatında baş verə bilər.
ML-DSA imzalarının ekvivalent elliptik əyri imzalarından təxminən 30–70 dəfə daha böyük ola biləcəyi bildirilir. Cross-silo sistemində bu əlavə yük məhdud qala bilər, lakin milyonlarla mobil müştərinin çoxsaylı turlarda iştirak etdiyi cross-device federasiyada bant genişliyi baxımından mühüm ola bilər.
Şifrəli arxivlərdə kvant təhdidi niyə daha təcili ola bilər?
Uzun müddət saxlanılan ciphertext birbaşa harvest-now-decrypt-later təhdidinə açıqdır. SSE-nin simmetrik nüvəsi Grover səbəbindən parametr gücləndirilməsi ilə qoruna bilər; lakin açar paylanması və ya delegation üçün classical Diffie–Hellman kimi kvanta açıq mexanizm istifadə olunursa, bütün sistemin uzunmüddətli təhlükəsizliyi bu qat səbəbindən zəifləyə bilər.
MPC kvantdan necə təsirlənir?
Secret-sharing əsaslı MPC-nin online mərhələsi informasiya-nəzəri təhlükəsizlik təmin edirsə, kvant kompüteri bu riyazi zəmanəti aradan qaldırmır. Kvant baxımından daha kritik sahələr preprocessing zamanı istifadə olunan public-key mexanizmləri və ya tərəflər arasındakı authentication kanallarıdır. Mənbə buna görə MPC-nin post-quantum migration yükünü HE və ya klassik PKI əsaslı sistemdən fərqli qiymətləndirir.
Diferensial məxfilik kvant kompüterindən təsirlənirmi?
İcmalın çərçivəsində diferensial məxfiliyin zəmanəti hesablama çətinliyinə deyil, çıxış paylanmalarının riyazi əlaqəsinə əsaslanır. Buna görə kifayət qədər güclü kvant kompüterinin ortaya çıxması DP tərifini pozmur. Lakin DP-nin düzgün tətbiqi, noise yaradılmasının keyfiyyəti və ya sistemin digər şifrələmə qatları ayrıca təhlükəsizlik problemləri olaraq qalır.
Crypto-agility niyə standart seçmək qədər vacibdir?
Crypto-agility sistemin bütün arxitekturanı yenidən yazmadan istifadə etdiyi kriptoqrafik alqoritmləri dəyişə bilməsidir. Mənbə post-quantum keçidində yalnız “ML-KEM istifadə et” kimi birdəfəlik seçim əvəzinə alqoritm dəyişməsini arxitektura xüsusiyyətinə çevirməyi tövsiyə edir. Çünki bu gün seçilən post-quantum standartın gələcəkdə dəyişdirilməsi lazım ola bilər.
İcmalda həmçinin klassik və post-quantum mexanizmin birlikdə işlədildiyi hybrid migration yanaşması nəzərdən keçirilir. Məqsəd kombinə edilmiş kanalın komponentlərdən ən azı biri təhlükəsiz qaldığı müddətcə qorunmasıdır. Bunun xərci iki alqoritmin açar, handshake və məlumat ölçülərinin birlikdə daşınmasıdır.
Post-quantum alqoritmdən istifadə side-channel problemlərini aradan qaldırırmı?
Xeyr. Riyazi baxımdan güclü lattice sxemi pis implementasiya səbəbindən timing və ya power-analysis hücumu ilə açar sızdıra bilər. Mənbə buna görə constant-time NTT tətbiqlərini, masked sampler-ləri və fiziki yan-kanal qorumasını xüsusilə edge device və ya federativ müştəri kimi hücumçunun cihaza yaxınlaşa bildiyi mühitlərdə vacib hesab edir.
Texnikaları birlikdə istifadə etmək niyə həmişə “daha təhlükəsiz” deyil?
İcmalın mühüm orijinal sintezlərindən biri privacy texnikalarının yalnız bir-birini tamamladığını deməklə kifayətlənməməsi, birləşmə zamanı yaranan ziddiyyətləri ayrıca araşdırmasıdır.
| Kombinasiya | Əlaqə | Niyə? |
|---|---|---|
| HE + DP | Gərginlik | DP-nin idarə olunan səs-küyü CKKS-nin öz təqribi xəta/noise böyüməsi ilə birlikdə təhlil edilməlidir. |
| HE + Secure Aggregation | Sinergetik | Aggregation aparılarkən serverə fərdi yeniləmə etibarı azaldıla bilər. |
| DP + Secure Aggregation | Sinergetik | Distributed noise generation ilə ümumi DP səs-küyü müştərilər arasında yaradıla bilər. |
| FL + HE/MPC | Gərginlik + qoruma | Məxfilik artır, lakin kriptoqrafik rabitə FL-nin məlumat hərəkətini azaltma üstünlüyünü qismən aradan qaldıra bilər. |
| Privacy + Robust Aggregation | Gərginlik | Yeniləmələri gizlətmək zərərli yeniləməni araşdırmağı da çətinləşdirir. |
| ZKP + Secure Aggregation | Sinergetik | Müştəri yeniləməsini açıqlamadan norm/hədd şərtlərinə uyğun olduğunu sübut edə bilər. |
| ZKP + HE | Əlavə zəmanət, lakin yüksək xərc | Confidentiality-yə integrity əlavə olunur; proving xərci ayrıca ödənilir. |
HE ilə DP arasındakı noise ziddiyyəti
DP riyazi olaraq kalibrasiya edilmiş noise paylanması tələb edir. CKKS isə təqribi arifmetika səbəbindən artıq kriptoqrafik/ədədi xəta daşıyır. DP noise-u encrypted domain daxilində yaradıldıqda bu iki xəta komponenti bir-birinə əlavə olunur. HE xətası nəzərə alınmasa real paylanma DP analizində fərz ediləndən fərqli ola bilər; həddən artıq konservativ nəzərə alınsa model utility-si lazımından çox azala bilər.
Mənbə buna görə privacy üçün əlavə olunan noise ilə cryptography-nin inherent error-unun ayrı-ayrı deyil, birlikdə modelləşdirilməli olduğunu müdafiə edir.
Federativ öyrənmə ilə kriptoqrafik rabitə ziddiyyəti
FL-nin əsas əməliyyat üstünlüklərindən biri xam məlumatı daşımamasıdır. Lakin naive secure aggregation çoxsaylı pairwise key agreement tələb edə bilər; naive homomorphic encryption isə hər qradient elementini böyük ciphertext-ə çevirə bilər. Bu halda “daha az məlumat daşıyaq” deyə yaradılan federasiya məxfilik qatı səbəbindən gözləniləndən daha çox şəbəkə trafiki yarada bilər.
Polylogarithmic secure aggregation, sparse communication graph, one-shot mask reconstruction, quantization və batching kimi üsulların əhəmiyyəti bu ziddiyyətdən yaranır.
Texniki seçimdə mənbə hansı sualları verir?
İcmal texniki seçimi dörd əsas suala endirir:
- Məlumatı kim və ya kimlər saxlayır?
- Hesablamanı aparan tərəf xam məlumatı görə bilərmi?
- Nəticə etibarsız üçüncü tərəflərə və ya ictimaiyyətə açıqlanacaqmı?
- Məhdudlaşdırıcı resurs hesablamadır, rabitədir, dəqiqlikdir, yoxsa təşkilati etibar fərziyyəsidir?
| Ssenari | Mənbədə tövsiyə olunan başlanğıc kombinasiyası | Məhdudlaşdırıcı amil |
|---|---|---|
| Özəl müştəri məlumatında bulud inferensiyası | HE/CKKS; server bütövlüyü şübhəlidirsə ZKP | Server hesablama vaxtı |
| Xəstəxanaların ortaq diaqnostika modeli öyrətməsi | Cross-silo FL + homomorphic aggregation + dərc edilən modeldə DP | Requlyasiya və silo bant genişliyi |
| Mobil klaviatura proqnozu | Cross-device FL + secure aggregation + user-level DP | Müştəri rabitəsi və dropout |
| İki şirkətin ortaq risk skoru | İkitərəfli mixed-protocol MPC | Şəbəkə round-trip gecikməsi |
| Əhali statistikasının dərc edilməsi | Central DP + ədədi privacy accounting | Hədəf ε altında utility |
| Etibarsız müştərilərdən telemetry | Local DP və ya shuffled DP | Noise səbəbli utility itkisi |
| Şifrəli sənəd axtarışı | Forward/backward-private SSE; access pattern kritikdirsə ORAM | Leakage profile |
| Həssas korpusda LLM fine-tuning | Public backbone üzərində DP-SGD + low-rank adapter | Hədəf ε altında utility |
| Onilliklərlə gizli qalacaq arxiv | Post-quantum primitives; keçiddə hibrid mexanizm | Açar və imza ölçüləri |
Tədqiqat prototipi ilə istehsal sistemi arasında niyə böyük fərq var?
PPML tədqiqatlarında aşağı latency və ya yüksək throughput göstərmək istehsal sisteminin yalnız kiçik hissəsidir. Real ML pipeline aralıq tensorları yoxlamaq, log toplamaq, checkpoint yaratmaq, hyperparameter tuning aparmaq, distribution drift-i izləmək və səhv nümunəni debug etmək istəyir. Encryption aralıq qiymətləri görünməz edir. DP-də hər özəl diagnostic query yeni privacy budget sərf edə bilər. MPC tək-prosesli proqramı paylanmış protokola çevirir.
Buna görə compiler və framework qatı vacibdir. OpenFHE, CrypTen, SecretFlow-SPU və bənzər alətlər kriptoqrafik detalları daha adi proqramlaşdırma modellərinin arxasında gizlətməyə çalışır. Lakin mənbə bunların inteqrasiya yükünü aradan qaldırmadığını, yalnız azaltdığını vurğulayır.
Açar idarəetməsi niyə kriptoqrafiyadan daha zəif halqa ola bilər?
HE riyazi baxımdan güclü olsa belə, secret key yanlış yerdə saxlanırsa təhlükəsizlik dağılır. Cross-silo sistemində tək qurumun decryption key saxlaması etibar modelini poza bilər; threshold və ya multi-key dizaynlarının əhəmiyyəti buradan gəlir. Cross-device federasiyada milyonlarla müştərinin açar yaratması, rotation, itirilmiş müştərilər və certificate idarəetməsi ayrıca mühəndislik problemidir.
Qiymətləndirmə/evaluation key-ləri də böyükdür və serverin əlində olmalıdır. Buna görə “alqoritm 128-bit security verir” demək əməliyyat sisteminin həqiqətən 128-bit təhlükəsiz olduğu mənasına gəlmir.
Formal məxfilik zəmanəti hüquqi baxımdan “anonim məlumat” deməkdirmi?
Mənbənin mühüm istehsal xəbərdarlıqlarından biri budur: diferensial məxfilik riyazi \(\varepsilon\) və \(\delta\) dili ilə danışdığı halda, məlumat qoruma qanunvericiliyi şəxsi məlumat, müəyyən edilə bilmə, məqsəd məhdudluğu, hüquqi əsas və məlumat subyektinin hüquqları kimi kateqoriyalardan istifadə edir. Bunlar arasında avtomatik bir-bir uyğunluq yoxdur.
Məsələn, müəyyən \(\varepsilon\) qiymətində DP tətbiq edilmiş məlumat dəstinin hüquqi baxımdan “anonim” sayılıb-sayılmayacağı yalnız texniki formuldan çıxarıla bilməz. Eyni şəkildə “right to erasure” tələbi təlim qeydini diskdən silməklə modelin həmin qeyddən öyrəndiyi məlumatı avtomatik silmir; machine unlearning ayrıca açıq tədqiqat mövzusudur.
Hansı texnikalar istehsalda nə qədər yetkindir?
Mənbə Şəkil 6-nın qiymətləndirilməsi ölçülmüş skor deyil, müəlliflərin ədəbiyyat və deployment sübutlarından yaratdığı keyfiyyət sintezidir. Diferensial məxfilik və federativ öyrənmənin genişmiqyaslı istehsal nümunələri var. Secure aggregation bu federativ sistemlərin daxilində istehsalda istifadə olunur. Post-quantum standartları standartlaşdırılıb və migration mərhələsindədir. SSE və MPC pilot və ya niş istehsal istifadəsindədir. HE dar, lakin yüksək dəyərli iş yüklərində erkən istehsal səviyyəsindədir. Maşın öyrənməsi üçün ZKP tətbiqlərinin böyük hissəsi hələ də tədqiqat xarakterlidir.
Səhiyyə, maliyyə, mobil və ağıllı şəhər nümunələrinin ortaq dərsi
| Sahə | Tipik miqyas | Önə çıxan texnikalar | Əsas maneə |
|---|---|---|---|
| Səhiyyə / klinik tədqiqat | 2–50 qurum | FL, secure aggregation, DP, inkişaf edən HE | Məlumat harmonizasiyası, etik təsdiq, non-IID qurumlar |
| İstehlakçı mobil platformaları | \(10^6\)–\(10^9\) cihaz | FL, secure aggregation, user-level/local DP | Rabitə, dropout, cihaz heterogenliyi |
| Maliyyə xidmətləri | 2–20 qurum | FL + homomorphic aggregation, MPC | Requlyasiya və rəqabət həssaslığı |
| Ağıllı şəhər / rəqəmsal əkiz | \(10^4\)–\(10^7\) heterogen cihaz | FL, local DP | Korrelyasiyalı məlumat axınları və hərəkətdən yenidən identifikasiya |
| Rəsmi statistika | Tək curator | Central DP + numerical accounting | Müdafiə oluna bilən ε altında utility və ictimai kommunikasiya |
| Bulud ML xidməti | Müştəri + server | HE inference; bəzi ssenarilərdə TEE | Sorğu başına latency və xərc |
Mənbə niyə texnikaların benchmark nəticələrini birbaşa sıralamır?
Çünki müqayisə edilən sistemlər eyni işi görmür və eyni şəraitdə sınaqdan keçirilmir. Mənbə dörd əsas müqayisəolunma problemini müəyyən edir:
- Təhdid modeli: malicious security təmin edən protokol semi-honest protokoldan daha çox iş görür.
- Təhlükəsizlik parametri: daha kiçik ring dimension və ya modulus daha sürətli ola bilər, lakin daha aşağı təhlükəsizlik verə bilər.
- Throughput ilə latency fərqi: minlərlə sorğunu batch edən sistemlə tək interaktiv sorğunu optimallaşdıran sistem eyni metriklə müqayisə oluna bilməz.
- Qorunan aktiv fərqi: DP dəqiqliyə, HE vaxta xərc qoyur; bunların arasında universal “məzənnə” yoxdur.
| Mexanizm | Qorunan əsas aktiv | Təqribi hesablama overhead-i | Rabitə təsiri | Utility itkisi | Mənbədə yetkinlik qiymətləndirməsi |
|---|---|---|---|---|---|
| Homomorfik şifrələmə | Giriş confidentiality | \(10^3\)–\(10^6\times\) | Ciphertext expansion təxminən 1–10× | Yoxdur və ya təqribi arifmetikadan kiçik itki | Erkən istehsal |
| MPC | Giriş confidentiality | Təxminən \(10\)–\(10^3\times\) | Yüksək; circuit depth-dən asılıdır | Dəqiq arifmetikada yoxdur | Pilot |
| Diferensial məxfilik | Çıxış privacy | Əhəmiyyətsiz | Yoxdur | ε-dan asılı orta–yüksək ola bilər | İstehsal |
| Federativ öyrənmə | Data locality | Təxminən 1–10× | Hər turda yüksək model transferi | Non-IID məlumatda kiçik–orta | İstehsal |
| Secure aggregation | Fərdi update confidentiality | Aşağı | Protokoldan asılı orta səviyyə | Yoxdur | İstehsal |
| Searchable encryption | Sorğu və məlumat confidentiality, müəyyən leakage ilə | Təxminən 1–10× | Aşağı | Yoxdur | Pilot |
| ORAM | Access-pattern confidentiality | Təxminən 10–100× | Verilənlər bazası ölçüsündə loqarifmik overhead | Yoxdur | Niş |
| Zero-Knowledge Proof | Hesablama bütövlüyü | Proving üçün təxminən \(10^2\)–\(10^6\times\) | Succinct proof səbəbindən nisbətən aşağı ola bilər | Yoxdur | Tədqiqat |
| Post-quantum primitives | Uzunmüddətli kriptoqrafik davamlılıq | Təxminən 1–2× | Daha böyük açar və imza | Yoxdur | Standartlaşdırılmış |
Bu cədvəldəki mərtəbələr nəzarətli ortaq eksperimentdən alınmayıb. Mənbə onları fərqli ilkin tədqiqatların nəticələrindən sintez edir. Buna görə, məsələn, “HE mütləq MPC-dən 1000 dəfə yavaşdır” kimi nəticə çıxarıla bilməz. İş yükü, alqoritm, batch quruluşu, təhlükəsizlik səviyyəsi, hardware, malicious/semi-honest modeli və şəbəkə gecikməsi nəticəni böyük dərəcədə dəyişə bilər.
Birləşdirilmiş PPML benchmark-ı necə olmalıdır?
İcmala görə mənalı ortaq benchmark ən azı batch inference, interactive inference, cross-silo training, cross-device training və analytics tapşırıqlarını ehtiva etməlidir. Eyni hardware baseline və ya açıq scaling üsulu istifadə edilməli; təhdid modeli, corruption threshold və security parameter açıq bildirilməli; DP sistemlərində accountant növü ilə \((\varepsilon,\delta)\) göstərilməli və utility metrikinin yanında xərc metriyi də verilməlidir.
Məqsəd tək “məxfilik balı” yaratmaq deyil, sistemi privacy–utility–cost məkanında yerləşdirməkdir.
Tədqiqatın Metodu və Nəticələri
Tədqiqatın elmi dizaynı
Bu tədqiqat yeni eksperiment, yeni məlumat dəsti, yeni klinik tədqiqat, yeni kvant dövrəsi və ya yeni PPML protokolu hazırlayan ilkin araşdırma deyil. Geniş texniki review kimi mövcud ədəbiyyatı yeddi əsas mövzu ətrafında sintez edir: homomorfik şifrələmə, diferensial məxfilik, privacy accounting, təhlükəsiz çoxtərəfli hesablama, federativ öyrənmə, şifrəli axtarış/verilənlər bazaları və post-quantum cryptography. Sıfır-bilik sübutları isə confidentiality mexanizmlərini tamamlayan integrity qatı kimi bir çox bölmədə nəzərdən keçirilir.
Məqalənin ədəbiyyat siyahısı 136 mənbəyə çatır. Müəllif töhfələri bölməsində Quang-Vinh Dang, Minh Ngoc Dinh və Ngoc-Son-An Nguyen-in literature search və screening fəaliyyətlərinə töhfə verdiyi bildirilir. Bununla belə əsas mətndə verilənlər bazalarının adları, təkrar istehsal edilə bilən axtarış sorğuları, PRISMA axını, açıq daxil etmə/xaric etmə meyarları və ya formal keyfiyyət qiymətləndirmə protokolu verilmir. Buna görə iş kəmiyyət meta-analizi və ya protokolu tam təkrar istehsal oluna bilən sistematik icmal kimi qiymətləndirilməməlidir.
İcmalın beş əsas töhfəsi
- Adətən ayrı ədəbiyyatlarda araşdırılan PPML texnikalarını ortaq təhdid, xərc və etibar modeli altında birləşdirmək.
- İlkin mənbələrdən accuracy, latency, throughput, key size və overhead kimi kəmiyyət nəticələrini toplamaq və onların niyə birbaşa müqayisə oluna bilmədiyini izah etmək.
- “Texnikalar bir-birini tamamlayır” ifadəsinin ötəsinə keçərək HE+DP noise qarşılıqlı təsiri, FL+kriptoqrafik rabitə xərci və privacy+robustness ziddiyyəti kimi uyğunsuzluqları təhlil etmək.
- Deployment ssenarisini texniki kombinasiyaya uyğunlaşdıran qərar proseduru yaratmaq.
- Tədqiqat prototipi ilə istehsal sistemi arasındakı fərqi mühəndislik, key management, requlyasiya və sektor deployment sübutları əsasında qiymətləndirmək.
Əsas tapıntı 1: Heç bir PPML texnikası bütün təhlükəsizlik hədəflərini qarşılamır
HE girişi gizlədir, lakin dərc edilən nəticənin fərdi məlumatı sızdırmasını məhdudlaşdırmır. DP çıxışın fərd haqqında verdiyi məlumatı məhdudlaşdırır, lakin xam məlumatı emal edən tərəfə qarşı confidentiality təmin etmir. MPC ortaq hesablamanı gizlədir, lakin yüksək rabitə sərf edir. FL data locality təmin edir, lakin gradient leakage-ə açıqdır. SSE səmərəli sorğu verir, lakin leakage profile daşıyır. ZKP integrity təmin edir, lakin confidentiality-ni əvəz etmir. Post-quantum primitives isə təkbaşına privacy mexanizmi deyil, kriptoqrafik zəmanətlərin zaman daxilində davamlılıq qatıdır.
Əsas tapıntı 2: Məxfilik sistemlərinin real dizayn problemi kompozisiyadır
İstehsal sistemi çox vaxt birdən çox primitive tələb edir. Məsələn, cross-silo federativ model homomorphic secure aggregation istifadə edə bilər, qlobal modelə user-level DP tətbiq oluna bilər, aggregation serverinin davranışı ZKP ilə doğrulana və rabitə qatı post-quantum key exchange ilə qoruna bilər. Lakin hər yeni qat yeni xərc və yeni fərziyyə yaradır.
İcmalın mərkəzi metodoloji mesajı budur ki, bu komponentlərin təhlükəsizlik təhlillərinin ayrılıqda düzgün olması bütün sistemin avtomatik olaraq düzgün olması demək deyil.
Əsas tapıntı 3: Homomorfik şifrələmə artıq yalnız nəzəri deyil, lakin hələ də bahadır
HE dərin şəbəkə və transformer inferensiyasına çatıb. Bootstrapping, packing, scheme switching, compiler-lər və GPU/ASIC sürətləndirilməsi tətbiqolunmanı böyük dərəcədə artırıb. Bununla belə mənbə HE xərcinin açıq mətn computation-dan hələ də bir çox böyüklük mərtəbəsi yuxarı ola biləcəyini və encrypted training-in xüsusilə böyük modellər üçün çox daha çətin olduğunu bildirir.
Əsas tapıntı 4: Diferensial məxfiliyin əsas problemi yalnız noise əlavə etmək deyil
DP-nin tətbiq keyfiyyəti clipping, sampling, accountant, batch ölçüsü, public pretraining, model arxitekturası və audit daxil olmaqla bütün təlim pipeline-ından asılıdır. Boş accountant lazımsız noise-a; səhv implementation isə kağız üzərindəki privacy guarantee-nin etibarsızlaşmasına səbəb ola bilər.
Əsas tapıntı 5: Federativ öyrənmə privacy ilə eynimənalı deyil
Raw data-nın cihazdan çıxmaması mühüm governance üstünlüyüdür, lakin gradient inversion və membership inference kimi hücumlar update-lərin özündən məlumat çıxarıla biləcəyini göstərir. FL-nin formal privacy qazanması üçün secure aggregation, HE və ya DP kimi əlavə mexanizmlər tələb olunur.
Əsas tapıntı 6: Məlumat saxlama qatı PPML-nin zəif halqası ola bilər
Training protocol çox güclü qorunsa belə, feature store, database və ya query layer access pattern sızdırırsa sistemdəki həssas məlumat sadəcə başqa nöqtəyə daşınmış olur. SSE, ORAM, private information retrieval və verifiable search buna görə PPML zəncirinin hissəsi kimi qiymətləndirilməlidir.
Əsas tapıntı 7: Kvant keçidi bütün PPML yığınını eyni dərəcədə dəyişməyəcək
RSA, Diffie–Hellman və ECC əsaslı public-key qatları Shor təhdidi altındadır. Bunun müqabilində lattice-based HE artıq post-quantum problem ailəsinə əsaslanır; DP hesablama fərziyyəsindən müstəqildir; secret-sharing əsaslı MPC-nin müəyyən online zəmanətləri informasiya-nəzəridir; symmetric encryption isə Grover səbəbindən daha böyük parametrlərlə gücləndirilə bilər.
Buna görə migration planı “hər şeyi PQC ilə dəyiş” deyil, sistemdəki bütün public-key dependency-ləri, uzunömürlü ciphertext-ləri, authentication strukturlarını və key-distribution mexanizmlərini inventarlaşdırmaqdır.
Əsas tapıntı 8: Təhlükəsizlik qədər əməliyyat və təşkilat da həlledicidir
Üç tərəfli honest-majority MPC protokolunun riyazi baxımdan çox sürətli olması, əgər həqiqətən bir-biri ilə gizli razılaşmayacaq üç müstəqil qurum yoxdursa praktik üstünlük vermir. HE sisteminin açarı pis idarə olunursa riyazi təhlükəsizlik mənasını itirir. DP-nin \(\varepsilon\) qiyməti hüquqi anonimlik statusunu öz-özünə müəyyən etmir. Buna görə PPML deployment qərarı yalnız alqoritmik benchmark ilə verilə bilməz.
Tədqiqatın dəstəklədiyi nəticələr
- PPML üçün tək və universal olaraq üstün texnika yoxdur.
- HE güclü input confidentiality təmin edə bilər, lakin yüksək computational overhead daşıyır.
- DP output privacy üçün formal və composable çərçivədir, lakin utility itkisi və privacy accounting tələb edir.
- MPC xüsusilə yaxşı şəbəkə şəraitində HE-yə nisbətən fərqli və bir çox halda daha rabitə-ağırlıqlı dizayn nöqtəsi verir.
- FL xam məlumatın mərkəzi daşınmasını azaldır, lakin təkbaşına privacy guarantee deyil.
- Secure aggregation, DP və HE federativ sistemlərdə bir-birini tamamlaya bilər.
- Privacy ilə Byzantine robustness arasında real görünürlük ziddiyyəti var.
- SSE-nin icazə verdiyi leakage praktik hücumlarda istifadə oluna bilər; yalnız ciphertext təhlükəsizliyinə baxmaq kifayət deyil.
- Post-quantum migration xüsusilə classical public-key authentication və key-establishment qatlarında vacibdir.
- ML-KEM, ML-DSA və SLH-DSA 2024 NIST standartları kimi PPML yığınının uzunmüddətli kriptoqrafik planlaşdırılmasında vacibdir.
- Production deployment-a maneələr yalnız protocol latency deyil; key management, tooling, requlyasiya, məlumat harmonizasiyası və təşkilati trust da kritikdir.
- PPML ədəbiyyatındakı fərqli performans rəqəmləri ortaq benchmark olmadan birbaşa sıralanmamalıdır.
Tədqiqatın dəstəkləmədiyi ümumiləşdirmələr
Tədqiqat “homomorfik şifrələmə bütün maşın öyrənməsi iş yüklərində artıq praktikdir”, “federativ öyrənmə təkbaşına məlumatı gizli saxlayır”, “diferensial məxfilik tətbiq edilmiş hər məlumat hüquqi baxımdan anonimdir”, “ε üçün universal təhlükəsiz bir rəqəm var”, “post-quantum alqoritmlər sonsuza qədər qırıla bilməz”, “bugünkü kvant kompüterləri RSA-nı rutin şəkildə qıra bilir”, “bütün klassik kriptoqrafiya kvant sonrasında yararsız olur”, “HE hər halda MPC-dən daha təhlükəsizdir” və ya “mənbədə verilən overhead nisbətləri eyni benchmark-ın dəqiq sıralamasıdır” nəticələrini dəstəkləmir.
Eyni şəkildə icmal ML-KEM, ML-DSA və ya SLH-DSA-nın gələcəkdə tapıla biləcək bütün mümkün kriptoanalitik üsullara qarşı riyazi olaraq qırılmaz olduğunu sübut etmir. Post-quantum təhlükəsizlik bu gün məlum hücum modelləri və əsas riyazi fərziyyələr çərçivəsində qiymətləndirilməlidir.
Tədqiqatın əsas məhdudiyyətləri
- Araşdırılan ilkin sistemlərin hardware, model, dataset, threat model, batch və security parameter şərtləri heterogendir.
- Birləşdirilmiş HE–MPC–DP benchmark-ı yoxdur.
- İcmal geniş olsa da, təkrar istehsal oluna bilən sistematik axtarış protokolunu ətraflı vermir.
- HE sürətləndiricilərinin böyük hissəsi kiçik convolutional workload-larda qiymətləndirilib; transformer davranışı daha az oturuşub.
- Secure training, xüsusilə böyük modellərdə secure inference-a nisbətən xeyli az yetkindir.
- Black-box DP auditing ilə analitik privacy bounds arasındakı boşluq tam bağlanmayıb.
- SSE/ORAM/ML pipeline-larındakı ümumi leakage-i vahid composable büdcədə birləşdirən yetkin nəzəriyyə yoxdur.
- Post-quantum standartları yayımlansa da, real PPML infrastrukturuna migration və crypto-agility inteqrasiyası tamamlanmayıb.
- Hüquqi privacy anlayışları ilə formal kriptoqrafik/statistik zəmanətlər arasında bir-bir uyğunluq yoxdur.
İcmalın gələcək tədqiqat gündəliyi
Mənbə gələcək tədqiqat ehtiyaclarını bir neçə əsas oxda toplayır: HE bootstrapping və böyük model throughput-un yaxşılaşdırılması; model arxitekturası ilə kriptoqrafiyanın birgə dizaynı; DP accounting-in daha sıx və audit edilə bilən hala gətirilməsi; cross-device secure aggregation rabitəsinin azaldılması; leakage-in formal və composable şəkildə kəmiyyətləşdirilməsi; ortaq benchmark standartının hazırlanması; post-quantum migration-ın tamamlanması; privacy mexanizmlərinin hüquqi və əməliyyat ehtiyacları ilə daha açıq əlaqələndirilməsi.
Bunların üzərində dayanan ortaq tədqiqat problemi isə composition-dır: fərqli mexanizmləri yan-yana qoymaq deyil, bir mexanizmin buraxdığı residual leakage-i digərinin həqiqətən bağlayıb-bağlamadığını, yeni xərc və ya yeni hücum səthi yaradıb-yaratmadığını bütün sistem səviyyəsində təhlil etmək.
Mənbə və Metod Qeydi
Özgün iş: Privacy-Preserving Cryptography for Machine Learning: A Comprehensive Review of Homomorphic Encryption, Differential Privacy, Secure Computation, and Post-Quantum Foundations
Müəlliflər: Quang-Vinh Dang; Dat Le; Minh Ngoc Dinh; Ngoc-Son-An Nguyen.
Müəllif sırası: Mənbədə verilən sıra eynilə qorunub.
Bərabər töhfə: Mənbədə bərabər töhfə/birgə birinci müəlliflik bəyanı müəyyən edilməyib.
Məsul müəllif: Dat Le.
Afiliasiya 1: School of Computing and Innovative Technologies, British University Vietnam, Hung Yen, Hanoi, Vietnam.
Afiliasiya 2: Department of Science, Technology, and International Projects, Ho Chi Minh City University of Economics and Finance, Ho Chi Minh City, Vietnam.
Afiliasiya 3: School of Data Science and Information Technology, Millennia Education, Ho Chi Minh City, Vietnam.
Afiliasiya 4: Faculty of Information Technology, Industrial University of Ho Chi Minh City, Ho Chi Minh City, Vietnam.
Jurnal: Computers, Materials & Continua (CMC).
Nəşriyyat: Tech Science Press.
Cild / nömrə: Volume 89, Number 3, 2026.
DOI: 10.32604/cmc.2026.087848.
Qəbul tarixi: 24 iyun 2026.
Təsdiq tarixi: 25 avqust 2026.
Nəşr tarixi: 22 oktyabr 2026.
Mənbə növü: Review / geniş texniki icmal.
Resenziya statusu: Resenziyalı açıq girişli jurnalda yayımlanmış yekun məqalə.
Xüsusi nömrə: Privacy-Preserving AI: Encryption and Differential Privacy.
Lisenziya: Creative Commons Attribution 4.0 International (CC BY 4.0).
Rəsmi nəşr bağlantısı: https://www.techscience.com/cmc/v89n3/69357
DOI bağlantısı: https://doi.org/10.32604/cmc.2026.087848
Preprint statusu: Araşdırılan mənbə və rəsmi qeyd yayımlanmış jurnal versiyasıdır; bu iş üçün ayrıca preprint versiyası verilən mənbə materialında göstərilməyib.
Maliyyələşdirmə: Müəlliflər tədqiqat üçün xüsusi maliyyələşdirmə almadıqlarını bildiriblər.
Məlumat və material əlçatanlığı: Review məqaləsi olduğuna görə yeni məlumat yaradılmadığı və ya təhlil edilmədiyi bildirilir.
Etik təsdiq: Tətbiq olunmur.
Maraqlar toqquşması: Müəlliflər maraqlar toqquşmasının olmadığını bəyan ediblər.
Müəllif töhfələri: Tədqiqatın konseptuallaşdırılması və dizaynı Quang-Vinh Dang və Dat Le; ədəbiyyat axtarışı və screening Quang-Vinh Dang, Minh Ngoc Dinh və Ngoc-Son-An Nguyen; nəzərdən keçirilən nəticələrin təhlili və şərhi Quang-Vinh Dang, Dat Le və Minh Ngoc Dinh; taksonomiya, compositional analysis və selection guide dizaynı Quang-Vinh Dang və Dat Le; şəkil və cədvəllər Minh Ngoc Dinh və Ngoc-Son-An Nguyen; ilkin qaralama Quang-Vinh Dang və Dat Le; kritik elmi reviziya Dat Le, Minh Ngoc Dinh və Ngoc-Son-An Nguyen tərəfindən həyata keçirilib. Bütün müəlliflərin son versiyanı nəzərdən keçirib təsdiqlədiyi bildirilir.
İcmal metodu üçün mühüm sərhəd: Müəllif töhfələri ədəbiyyat axtarışı və screening aparıldığını göstərsə də, məqalə mətnində təkrar istehsal edilə bilən verilənlər bazası axtarış sətirləri, PRISMA axın sxemi, formal daxil etmə/xaric etmə meyarları və ya kəmiyyət meta-analiz protokolu verilmir. Buna görə Verianla mətni işi geniş texniki review kimi təsvir edir; sistematik review və ya meta-analiz kimi yenidən təsnif etmir.
Kəmiyyət nəticələrinin şərh sərhədi: Məqalədəki HE latency, transformer inference, DP utility, secure aggregation, cryptographic overhead və post-quantum key/signature ölçüləri fərqli ilkin mənbələrdən toplanıb. Mənbənin özü hardware, model, dataset, batch size, threat model və security parameter fərqləri səbəbindən bunların nəzarətli vahid benchmark kimi müqayisə edilə bilməyəcəyini bildirir.
Kvant şərhi üçün sərhəd: Tədqiqat yeni kvant kompüteri eksperimenti və ya quantum machine learning modeli deyil. Kvant bölməsi Shor və Grover alqoritmlərinin kriptoqrafik təsirlərini və PPML infrastrukturunun post-quantum migration tələblərini ədəbiyyat əsasında qiymətləndirir. “Post-quantum” termini gələcəkdəki bütün mümkün hücumlara qarşı mütləq riyazi toxunulmazlıq kimi şərh edilməməlidir.
Şərh yazın
E-poçt ünvanınız yayımlanmayacaq. Məcburi sahələr * ilə işarələnib