


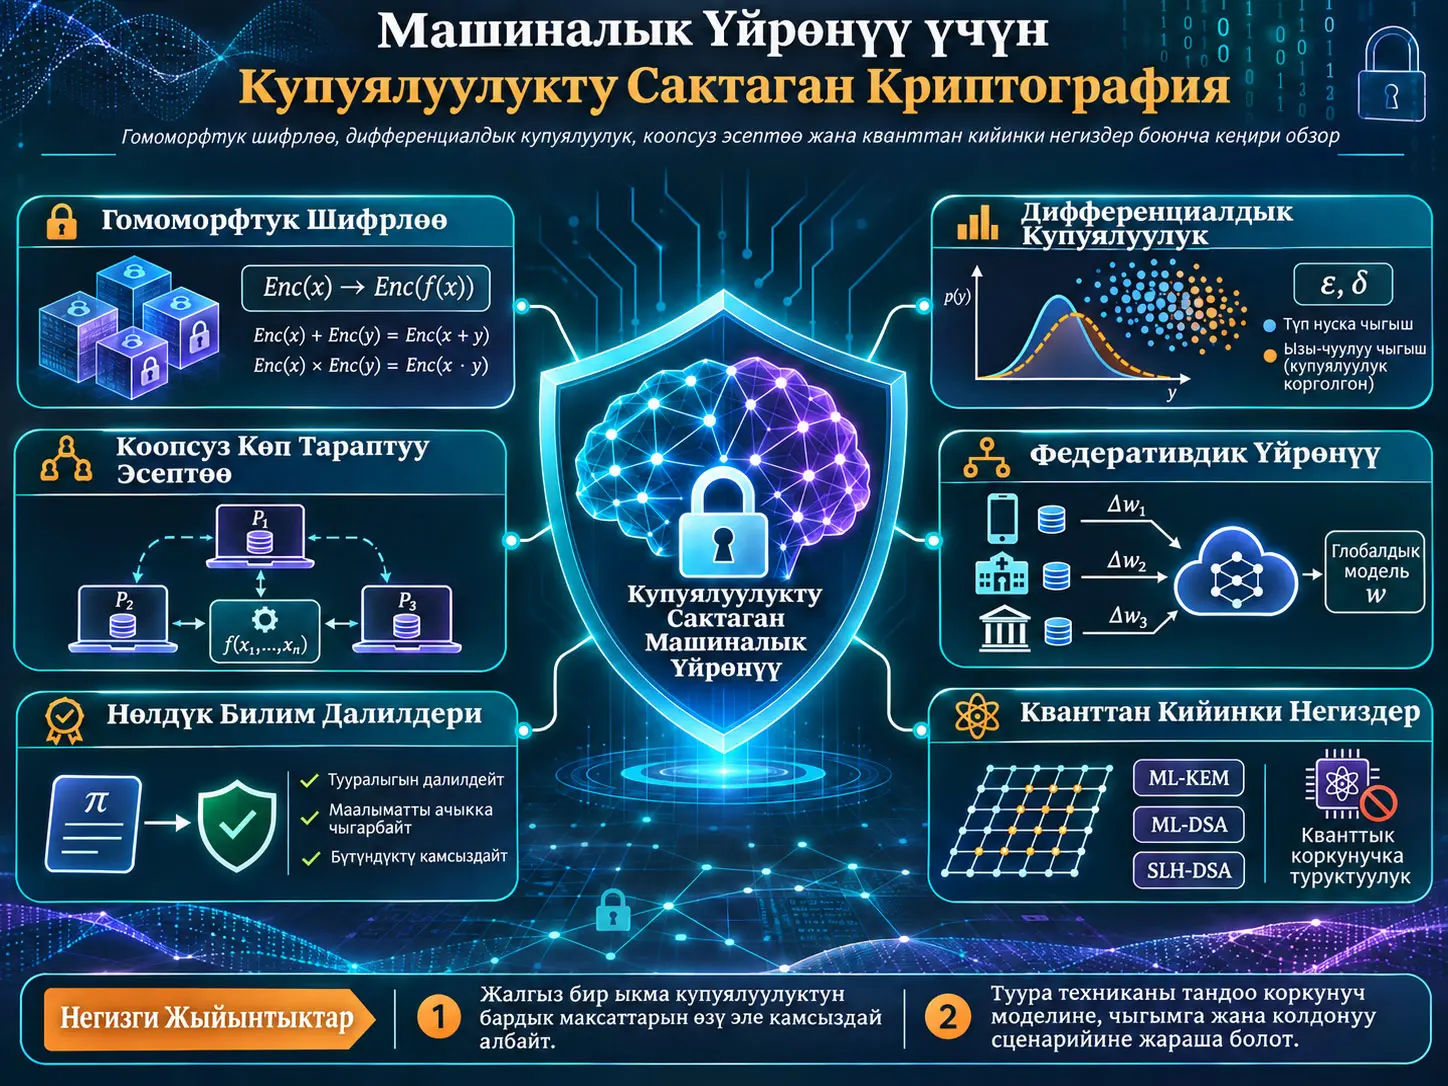
Купуялуулукту сактаган машиналык үйрөнүү (Privacy-Preserving Machine Learning, PPML) — сезимтал маалыматтарда машиналык үйрөнүү жүргүзүлгөндө маалыматтын мазмунун, жеке жазууларды, модель параметрлерин же эсептөөнүн бүтүндүгүн коргоого багытталган криптографиялык, статистикалык жана системалык ыкмалар биригип түзгөн изилдөө жана инженердик тармак. Бул кеңири баяндама гомоморфтук шифрлөөнү (Homomorphic Encryption, HE), дифференциалдык купуялуулукту (Differential Privacy, DP), коопсуз көп тараптуу эсептөөнү (Secure Multi-Party Computation, MPC), федеративдик үйрөнүүнү (Federated Learning, FL), нөлдүк-билим далилдерин (Zero-Knowledge Proofs, ZKP), издөөгө мүмкүндүк берген шифрлөөнү, Oblivious RAM жана кванттан кийинки криптографияны бир алкакта салыштырат. Изилдөөнүн негизги жыйынтыгы — бул ыкмалардын эч бири жалгыз өзү бардык жашыруундук, купуялуулук, бүтүндүк жана колдонууга жарактуулук маселелерин чечпейт; реалдуу системаларда тандоо корголуучу активге, коркунуч моделине, эсептөө жана байланыш бюджети, тактык жоготуусу жана ишеним божомолдоруна жараша жасалышы керек.
Баяндамадагы маанилүү айырмачылыктардын бири confidentiality менен privacy түшүнүктөрүн бир нерсе катары колдонбоосу. Криптографиялык жашыруундук же confidentiality маалыматты же аралык эсептөө маанилерин уруксатсыз тарап көрбөшүн камсыз кылууга аракеттенет. Дифференциалдык купуялуулуктагы privacy болсо жарыяланган жыйынтыктан белгилүү бир адам маалымат топтомунда бар же жок экенин, же ошол адам тууралуу маалымат канчалык деңгээлде чыгарылып алынышы мүмкүн экенин чектөөгө байланыштуу. Гомоморфтук шифрлөө же MPC эсептөөнүн кириштерин жашыра алат, бирок жарыяланган жыйынтык адамдар тууралуу канча маалымат ачарын өз алдынча чектебейт. Дифференциалдык купуялуулук тескерисинче иштейт: жыйынтыктан жасалчу тыянактарды чектей алат, бирок маалыматты иштеткен тараптын чийки киришти көрүшүнө жалгыз өзү бөгөт коё албайт. Ошондуктан күчтүү PPML системалары көп учурда бир нече ыкманы катмар түрүндө айкалыштырат.
Изилдөө ошондой эле өндүрүмдүүлүк көрсөткүчтөрүн этият окуу керек экенин көрсөтөт. Гомоморфтук шифрлөө кириш маалыматтын күчтүү жашыруундугун бере алат, бирок эсептөө баасы өтө жогору; MPC көп операцияларды туура жана криптографиялык корголгон түрдө аткара алат, бирок интенсивдүү байланыш талап кылат; дифференциалдык купуялуулук эсептөө жагынан салыштырмалуу арзан, бирок тактык же пайдалуулук жоготуусун жаратышы мүмкүн; федеративдик үйрөнүү чийки маалыматтын борбордук серверге ташылбашын камсыздайт, бирок бөлүшүлгөн градиент же модель жаңыртуулары өздөрү маалымат чыгарышы мүмкүн; издөөгө мүмкүндүк берген шифрлөө ылдам суроо үчүн кирүү үлгүсү же суроонун кайталанышы сыяктуу айрым агып чыгууларды кабыл алышы мүмкүн. Демек “эң коопсуз ыкма” же “эң тез ыкма” деген контексттен ажыратылган бирдиктүү рейтинг илимий жактан маанилүү эмес.
Баяндамадагы кванттан кийинки бөлүк өзгөчө маанилүү, бирок бул жерде жаңы кванттык компьютер же кванттык машиналык үйрөнүү алгоритми каралбайт. Изилдөө жетиштүү чоң жана каталарга туруктуу кванттык компьютер Shor алгоритми аркылуу RSA, Diffie–Hellman жана эллиптикалык ийри криптографиясы сыяктуу факторлоштурууга же дискреттик логарифмге негизделген ачык ачкыч системаларына коркунуч жаратарын; ошол эле учурда симметриялык шифрлөө, дифференциалдык купуялуулук, маалымат-теориялык secret-sharing жана тор негизиндеги гомоморфтук шифрлөө ошол эле түрдө таасирленбей турганын баса белгилейт. NIST 2024-жылы жарыялаган ML-KEM, ML-DSA жана SLH-DSA стандарттары бул өтүүнүн негизги компоненттери катары каралат. “Квантка туруктуу” деген сөз бул жерде абсолюттук жана түбөлүккө далилденген коопсуздукту билдирбейт; ал белгилүү классикалык жана кванттык чабуулдарга каршы учурдагы криптографиялык божомолдордун негизинде долбоорлонгон коопсуздукту түшүндүрөт.
Купуялуулукту Сактаган Машиналык Үйрөнүү Деген Эмне?
Купуялуулукту сактаган машиналык үйрөнүү — машиналык үйрөнүү үчүн керек болгон маалыматтын статистикалык баасын колдонууга аракет кылып жатып, чийки маалыматты, жеке жазууларды, модель жаңыртууларын же эсептөө процессин коркунуч моделинде аныкталган чабуулчулардан коргоо үчүн криптографияны, статистиканы жана системалык инженерияны бириктирген ыкмалардын үй-бүлөсү; бирок PPML бир алгоритм эмес жана ар бир PPML ыкмасы башка активди, башка чабуулчуга каршы жана башка баа менен коргойт.
Эмне үчүн “маалымат түзмөктөн чыкпайт” деген сөз жалгыз өзү купуялуулук кепилдиги эмес?
Изилдөөнүн баштапкы чекити — сезимтал маалыматты түз бөлүшпөө жалгыз өзү жетишсиз. Оорукана бейтаптын сүрөттөрүн борбордук серверге жибербесе, банк модель жаңыртууларын гана бөлүшсө же телефондун клавиатурасы градиентти гана жөнөтсө да, бул аралык өкүлчүлүктөр маалымат тууралуу маалымат алып жүрүшү мүмкүн. Баяндамада берилген мүчөлүктү аныктоо чабуулдары белгилүү бир жазуу үйрөтүү маалымат топтомунда болгон-болбогонун модель жүрүм-турумунан божомолдоого аракеттенет. Градиентти тескери калыбына келтирүү чабуулдары болсо бөлүшүлгөн градиенттерден үйрөтүү сүрөттөрүн жана белгилерин кайра түзүүгө чейин жетиши мүмкүн.
Ошондуктан PPMLдеги биринчи суроо “маалымат борбордобу же түзмөктөбү?” эмес, “Чабуулчу кайсы маалыматты көрө алат жана андан эмнени чыгара алат?” деген суроо. Булактагы бардык техникалык салыштыруулар ушул коркунуч-модели ыкмасына негизделген.
Коркунуч модели эмне үчүн бардык техникалык тандоолордон мурда келет?
Коопсуздук же купуялуулук тууралуу доомат чабуулчу эмнелерди кыла аларын аныктабай туруп маанилүү болбойт. Булак эки негизги криптографиялык чабуулчу классын айырмалайт. Жарым-жартылай чынчыл (semi-honest же honest-but-curious) чабуулчу протокол кадамдарын туура аткарат, бирок көргөн билдирүүлөрдөн кошумча маалымат чыгарууга аракет кылат. Зыяндуу/активдүү (malicious) чабуулчу болсо протоколдон четтей, жасалма билдирүү жөнөтө, эсептөөнү буза же маалымат алуу үчүн протоколду ортосунда токтото алат.
Экинчи өлчөм corruption threshold, башкача айтканда чабуулчу канча тарапты ээлеп, чогуу иштете аларын көрсөтөт. MPC протоколдорунда “үч тарап бар” деп айтуу жалгыз өзү коопсуздук түшүндүрмөсү эмес; мисалы, жок дегенде эки тарап бири-бири менен жашыруун келишпейт деген божомол болсо, бул уюштуруучулук божомол реалдуу дүйнөдө да негизделе алышы керек.
| Кепилдик түрү | Негизги идея | Типтүү мисал | Критикалык чек |
|---|---|---|---|
| Эсептөө коопсуздугу | Белгилүү математикалык маселе акылга сыярлык убакытта чечилбейт деп болжолдонот. | HE, ML-KEM, ML-DSA | Коопсуздук криптоанализдеги жана эсептөө кубатындагы өнүгүүгө көз каранды. |
| Маалымат-теориялык / шартсыз коопсуздук | Чабуулчунун эсептөө күчү чексиз болсо да, белгилүү божомолдордо маалымат ала албайт. | Айрым secret-sharing түзүлүштөрү | Көп учурда honest-majority сыяктуу структуралык божомолдор талап кылынат. |
| Статистикалык купуялуулук | Коңшу маалымат топтомдорунан алынган чыгыш бөлүштүрүүлөрүн айырмалоо мүмкүнчүлүгү чектелет. | Дифференциалдык купуялуулук | Тактык/пайдалуулук баасы жана композиция менен өсүүчү купуялуулук бюджети бар. |
Чындыгында эмне корголот: кириш, чыгыш, модель же эсептөөнүн бүтүндүгү?
Кириш жашыруундугу — сервер же башка тараптар эсептөөгө кирген бейтап сүрөтү, каржылык жазуу же жеке суроо сыяктуу маалыматтарды көрбөшү. Гомоморфтук шифрлөө жана MPCнин негизги ролу ушул катмарда.
Чыгыш купуялуулугу жарыяланган модель же статистика үйрөтүү маалыматындагы адамдар тууралуу канча маалымат ачаары менен байланыштуу. Дифференциалдык купуялуулук ушул көйгөйгө багытталган. Криптографиялык жактан кемчиликсиз эсептелген жыйынтык да адам тууралуу өтө көп маалымат ачса, чыгыш купуялуулугу камсыздалган болуп эсептелбейт.
Модель жашыруундугу да өзүнчө актив. Кардар серверге жеке маалыматын жөнөткүсү келбеши мүмкүн; ошол эле учурда сервер да өзүнүн модель салмактарын кардар чыгарып алышын каалабашы мүмкүн. Коопсуз inference протоколдорунун бир бөлүгү ушундай эки тараптуу жашыруундук талабына багытталган.
Бүтүндүк (integrity) болсо жашыруундуктан башка нерсе. Сервер киришти көрбөй турганы туура эсептөө жасады дегенди билдирбейт. Ошондуктан нөлдүк-билим далилдери сыяктуу ыкмалар жашыруундукту берген HE же MPCни “эсептөө чын эле айтылгандай аткарылдыбы?” деген суроо менен толуктайт.
Купуялуулуктун баасы кайсы ресурстан төлөнөт?
Баяндамадагы эң пайдалуу алкактардын бири — ар кандай ыкмалар чыгымды ар башка ресурстарга жылдырарын көрсөтүшү. HE негизинен эсептөө убактысын жана эс тутумду керектейт. MPC эсептөөнү тармактык байланыш чыгымына айлантат. Дифференциалдык купуялуулук бааны модель тактыгы же статистикалык пайдалуулук аркылуу төлөйт. Федеративдик үйрөнүү маалымат кыймылын азайтат, бирок көп сандагы модель жаңыртууларынан улам байланыш жана кардар гетерогендүүлүгү чыгымын жаратат. Издөөгө мүмкүндүк берген шифрлөө болсо ылдамдык алуу үчүн белгилүү агып чыгуу профилин кабыл алышы мүмкүн.
Гомоморфтук Шифрлөө Машиналык Үйрөнүүнү Шифрленген Маалымат Үстүндө Кантип Иштетет?
Гомоморфтук шифрлөө серверге ачык маалыматты же жашыруун ачкычты көрбөстөн шифрленген маанилер үстүндө математикалык операцияларды жүргүзүүгө жана алынган шифрленген жыйынтыкты ыйгарым укуктуу ачкыч ээси гана ачууга мүмкүндүк берген криптографиялык эсептөө ыкмасы; машиналык үйрөнүүдөгү негизги артыкчылыгы — бир ишенимсиз серверде интерактивдүү эмес кириш жашыруундугун камсыздашы, негизги кемчилиги болсо ачык тексттик эсептөөгө салыштырмалуу өтө жогорку арифметикалык жана эс тутум чыгымы.
Шифрленген маалымат үстүндө операция жүргүзүү кантип мүмкүн болот?
Кадимки шифрлөөдө маалымат үстүндө эсептөө үчүн маалымат көбүнчө биринчи ачылат. Гомоморфтук шифрлөөнүн максаты ушул зарылдыкты алып салуу. Кардар \(x\) маалыматын шифрлеп \(Enc(x)\) түзөт. Сервер жашыруун ачкычты билбей туруп белгилүү \(f\) функциясын шифрленген мейкиндикте баалайт:
\[ Eval(f, Enc(x)) \rightarrow Enc(f(x)) \]
Кардар жыйынтыкты ачканда:
\[ Dec(Enc(f(x))) \approx f(x) \]
алат. Бул көрсөтүү изилдөөнүн жаңы теңдемеси эмес; гомоморфтук эсептөөнүн түшүндүрмө концептуалдык жыйынтыгы. BFV жана BGV сыяктуу бүтүн сан схемаларында максат так арифметика; CKKSте чыныгы жана комплекс сандар болжолдуу коддолгондуктан жыйынтыкта башкарылуучу болжолдуу ката болушу мүмкүн.
LWE жана RLWE эмне үчүн ушунчалык борбордук?
Баяндамадагы заманбап HE системаларынын көпчүлүгү Learning With Errors (LWE; Каталар менен Үйрөнүү) же анын шакек/модуль туундуларына негизделген тор маселелеринен коопсуздук алат. Негизги түшүндүрмө интуиция — сызыктуу байланыштын ичине кичине, бирок кылдат тандалган ката кошуу.
Булакта ачык теңдеме катары берилбесе да, LWE идеясынын стандарттык концептуалдык жазылышын мындай көрсөтүүгө болот:
\[ \mathbf{b}=\mathbf{A}\mathbf{s}+\mathbf{e}\pmod q \]
Бул жерде \(\mathbf{A}\) ачык структура, \(\mathbf{s}\) жашыруун маалымат жана \(\mathbf{e}\) кичине ката мүчөсү; \(q\) модуль. Чабуулчу \(\mathbf{A}\) жана \(\mathbf{b}\) ни көргөнү менен, катанын айынан \(\mathbf{s}\) ни калыбына келтирүү маселеси татаалданат. Бул теңдеме ML-KEM же CKKSнин толук протокол аныктамасы эмес; LWE үй-бүлөсүнүн негизги математикалык интуициясын түшүндүрүү үчүн гана берилген.
RLWE негизиндеги схемаларда скаляр же кадимки векторлордун ордуна полином шакектери колдонулат. Бул түзүлүш коопсуздук жана көп маанини бир ciphertext ичине пакеттөө жагынан маанилүү.
BGV, BFV, CKKS жана TFHEнин айырмасы эмнеде?
| Схема | Табигый маалымат мейкиндиги | Арифметика | Bootstrapping мүнөзү | Машиналык үйрөнүүдөгү типтүү ролу |
|---|---|---|---|---|
| BGV | Модулдук бүтүн сандар | Так, SIMD пакеттөө | Leveled; зарыл болгондо жаңылоо | Полином баалоо, статистика |
| BFV | Модулдук бүтүн сандар | Так, SIMD пакеттөө | Leveled; зарыл болгондо жаңылоо | Бүтүн сандык модель inference |
| CKKS | Болжолдуу чыныгы/комплекс сандар | Болжолдуу, SIMD пакеттөө | Болжолдуу модулдук азайтууга негизделген ар түрдүү ыкмалар | Терең нейрон тармагы жана transformer inference |
| TFHE | Биттер / кичине бүтүн сандар | Boolean же lookup-table багытталган | Өтө тез gate-by-gate bootstrapping | Салыштыруу, чечим дарагы, сызыктуу эмес функциялар |
Булакта ring dimension \(N\) үчүн типтүү маанилер болжол менен \(2^{13}\)–\(2^{17}\) аралыгында экени, SIMD пакеттөөдө болжол менен \(2^{12}\)–\(2^{16}\) plaintext slot колдонулушу мүмкүн экени айтылат. Бул сандар ар бир колдонмо үчүн туруктуу параметр эмес; коопсуздук деңгээлине, схема тереңдигине жана китепкана тандоосуна жараша өзгөрөт.
Ciphertext ичиндеги “noise” эмне үчүн бар жана эмне үчүн өсөт?
Тор негизиндеги шифрлөө системаларында ката же noise жөн гана каалабаган кемчилик эмес; коопсуздуктун бир бөлүгү. Бирок гомоморфтук кошуу жана өзгөчө көбөйтүү операциялары ciphertext ичиндеги бул катаны чоңойтот. Ката белгилүү чектен ашса туура ачуу ишке ашпай калышы мүмкүн. Ошондуктан гомоморфтук программада кайсы математикалык операциялар аткарылары гана эмес, канча удаалаш көбөйтүү бар экени да критикалык.
Булактын белгилер таблицасында \(Q\) ciphertext modulusун жана modulus чынжырынын колдонууга мүмкүн болгон көбөйтүү тереңдигин кантип аныктарын; \(L\) болсо bootstrapping керек болгонго чейин керектелчү multiplicative depthти билдирет. Тереңирээк тармак көбүрөөк көбөйтүү жана натыйжада көбүрөөк noise-budget чыгымын билдирет.
Bootstrapping деген эмне?
Bootstrapping — ызы-чуусу чоңойгон ciphertext үстүндө шифр ачуу схемасынын өзүн гомоморфтук түрдө баалап, жаңы жана аз ызы-чуулуу ciphertext түзүү операциясы. Бул операция чектелген көбөйтүү тереңдигин гана колдогон “leveled” HEден теориялык жактан чексиз терең эсептөөгө мүмкүндүк берген fully homomorphic encryptionга өтүүнү камсыздайт.
Бирок bootstrapping HEнин эң кымбат операцияларынын бири. Булак CKKS жана TFHE үй-бүлөлөрүнүн чыгым түзүлүшү айырмаланарын баса белгилейт. CKKS кең чыныгы сан векторлорун пакеттеп жогорку throughput берет. TFHE болсо өзүнчө бит же кичине бүтүн сан операцияларында программалануучу lookup table жана gate-level bootstrapping ыкмасы менен аз бир-операциялык кечигүүгө багытталат.
Булакта TFHE үчүн тарыхый түрдө бир өзөктө gate bootstrapping убактысы болжол менен 13 ms га, bootstrapping ачкычы болжол менен 16 MB га чейин азайтылган натыйжа берилет. Бул маанилер бардык TFHE колдонмолорунун бүгүнкү өндүрүмдүүлүгү эмес; баяндамада каралган белгилүү иштин маалымдама жыйынтыгы.
CKKS bootstrapping эмне үчүн машиналык үйрөнүүдө өзгөчө маанилүү?
CKKS чыныгы жана комплекс маанилерди болжолдуу иштете алгандыктан нейрон тармактарынын туруктуу чекиттик сандык операцияларына табигыйыраак ылайык келет. CKKS bootstrappingтин классикалык жолунда CoeffToSlot жана SlotToCoeff деп аталган сызыктуу өзгөртүүлөр жана модулдук азайтууну болжолдуу аткарган полиномдор колдонулат. Булак келтирген акыркы иштерде жарым-жартылай CoeffToSlot ажыратуу татаалдыкты азайткан; level-conserving rescaling ыкмалары окшош параметрлерде throughputту болжол менен %20–35 көбөйтө алган.
Баяндама roots-of-unity негизиндеги тайызыраак bootstrapping ыкмаларын, PaCo сыяктуу blind-rotation негизиндеги түзүлүштөрдү жана functional bootstrapping ыкмаларын да карайт. Functional bootstrapping ciphertextти жаңылоо менен эле чектелбейт; ошол эле операцияда lookup table менен аныкталган функцияны да колдонушу мүмкүн. Булакта сегиз биттик lookup table үчүн CKKSте ар бир мааниге амортизацияланган болжол менен 0,72 ms көрсөткөн иш келтирилет; бул DM/CGGI ыкмасынан болжол менен үч чоңдук даражасына жана чектелүү BFV негизиндеги амортизацияланган functional bootstrapping ыкмасынан болжол менен 6,8 эсе тез деп билдирилет. Бул ар башка системалар жана параметрлерде алынган адабият жыйынтыктары; универсалдуу өндүрүмдүүлүк коэффициенти эмес.
Scheme switching эмне үчүн пайда болду?
Бир HE схемасы бардык операция түрүндө оптималдуу эмес. CKKS чоң чыныгы сан векторлорунда арифметиканы натыйжалуу аткарса, салыштыруу же дискреттик lookup операциялары TFHEге окшош түзүлүштөрдө табигыйыраак болушу мүмкүн. Scheme switching эсептөөнүн көп бөлүгүн CKKS менен аткарып, ReLU сыяктуу салыштыруу же активация керек болгондо убактылуу бит негизиндеги өкүлчүлүккө өтүп, андан кийин кайра CKKSке кайтууну билдирет. Ошентип ар бир математикалык катмар өзүн арзаныраак баалай алган криптографиялык өкүлчүлүктө иштей алат.
Шифрленген нейрон тармак inferenceинде канча өнүгүү бар?
| Система | Ыкма | Модель / маалымат | Булакта берилген жыйынтык | Салыштыруу чеги |
|---|---|---|---|---|
| CryptoNets | Leveled HE | Тайыз CNN / MNIST | Болжол менен %99 тактык; болжол менен 51.000 божомол/саат throughput | Batch амортизациясы жогору, бир суроо кечигүүсү мүнөт масштабында болушу мүмкүн. |
| RNS-CKKS ResNet-20 | Bootstrapped HE | ResNet-20 / CIFAR-10 | %92,43 тактык; plaintext модель менен кириштердин %98-ден көбүндө бирдей чыгыш; сүрөт башына саат масштабы | Аппарат жана модель шарттары эски/атайын. |
| Multiplexed convolution ыкмасы | Bootstrapped HE | ResNet-20/110 | Болжол менен 4,7 эсе кечигүү азайышы; амортизацияланган убакта эки чоңдук даражасынан көп жакшыртуу | Башка эксперименттик түзүлүш. |
| NEXUS | Интерактивдүү эмес HE | BERT масштабы | Он секунддар масштабында inference жана интерактивдүү baselineдарга салыштырмалуу жүздөгөн эсе өткөрүү кеңдиги азайышы | Башка системалар менен көзөмөлдөнгөн benchmark эмес. |
| PUMA | 3 тараптуу MPC | LLaMA-7B | Мүнөт масштабында коопсуз inference | HE-only система менен түз эквиваленттүү эмес. |
Бул таблица “кайсысы тез?” деген суроого түз жооп берүү үчүн колдонулбашы керек. CryptoNets сыяктуу throughput багытталган системалар миңдеген суроолорду бир ciphertextтин slotторуна пакеттеп, туруктуу чыгымды бөлүштүрөт. Интерактивдүү колдонмодо болсо бир суроонун жыйынтыкка жетүү убактысы маанилүү. Булак бул эки иштөө режимин аралаштыруу билдирилген өндүрүмдүүлүктү үч чоңдук даражасына чейин жаңылыш көрсөтүшү мүмкүн экенин баса белгилейт.
Transformer моделдери HE үчүн эмне үчүн өзгөчө кыйын?
Convolutional тармактардагы сызыктуу катмарлар HE астында салыштырмалуу ыңгайлуу болсо, transformer архитектурасындагы softmax, GELU, layer normalization, бөлүү жана квадраттык тамыр операциялары түздөн-түз полином арифметикасына туура келбейт. Чечимдер үч негизги топко бөлүнөт:
- Сызыктуу катмарларды HE менен, сызыктуу эмес катмарларды MPC/secret sharing менен баалаган гибриддик протоколдор.
- Бардык эсептөөнү HE ичинде кармап, softmax жана окшош функцияларды полином жакындашуулары менен алмаштырган интерактивдүү эмес протоколдор.
- Модель архитектурасын башынан шифрлөөгө ыңгайлуу кылып, кымбат сызыктуу эмес операцияларды азайткан биргелешкен дизайн ыкмалары.
Ошондуктан шифрленген машиналык үйрөнүүдө криптографияны гана тездетүү жетишсиз; модель архитектурасы менен криптографиялык өкүлчүлүктү чогуу долбоорлоо барган сайын маанилүү.
GPU, FPGA жана ASIC тездетүүсү эмнени өзгөртөт?
Баяндамада HE арифметикасы көп учурда таза эсептөө блокторунун санынан да көбүрөөк эс тутум өткөрүү кеңдиги жана маалымат кыймылы менен чектелери баса белгиленет. Number-Theoretic Transform (NTT) жана key-switching операциялары өзгөчө маанилүү. GPUларда memory-centric оптимизациялар менен айрым амортизацияланган bootstrapping иш жүктөрүндө 100 эседен көп тездетүү билдирилген.
CPU колдонмолору жалпы максаттуу жана оңой жеткиликтүү болгону менен эс тутум өткөрүү кеңдигине тез такалышы мүмкүн. GPUлар жогорку параллелдүүлүк жана өткөрүү кеңдигин берет. FPGAлар программалануучу маалымат жолдору менен белгилүү модулдук арифметикалык операцияларга ылайыкташтырылат. ASICтер эң жогорку өндүрүмдүүлүк потенциалына ээ, бирок дизайн жана өндүрүш баасы жогору. Булак ошондой эле учурдагы тездеткич баалоолорунун көпчүлүгү CIFAR-10/ResNet-20 сыяктуу салыштырмалуу кичине convolutional моделдерде жүргүзүлгөнүн белгилейт; чоң transformer иш жүктөрүндө ошол эле жыйынтыктар автоматтык түрдө жарактуу деп эсептөөгө болбойт.
Нөлдүк-билим далили HEнин кайсы кемчилигин толуктайт?
Гомоморфтук шифрлөө сервердин киришти көрүшүнө бөгөт коё алат, бирок сервер туура жыйынтык эсептегенин өзү далилдебейт. Зыяндуу сервер туура эмес маанинин туура форматталган ciphertextин кайтара алат. Нөлдүк-билим далили серверге белгилүү эсептөөнү туура аткарганын жашыруун маалыматты ачпастан далилдөөгө мүмкүндүк берет.
Баяндама zkCNN сыяктуу иштерде жеке тест маалыматын же модель салмактарын ачпастан convolutional-network божомолу жана тактык дооматы үчүн далил түзүүгө болорун; жаңы иштер муну үйрөтүү процессине чейин кеңейткенин баяндайт. Бирок эсептөөнү далилдөө көп учурда эсептөөнүн өзүнөн кыйла кымбат. HE менен ZKPни бириктирүү эки кымбат механизмдин чыгымын кошкондуктан, бүгүнкү системалар көбүнчө бүтүндүк критикалык болгон кадамдарды гана далилдөөгө аракет кылат.
Дифференциалдык Купуялуулукта ε жана δ Эмнени Билдирет?
\((\varepsilon,\delta)\)-дифференциалдык купуялуулук бир гана жазуу өзгөргөн эки коңшу маалымат топтомунда иштеген кокусташтырылган механизмдин чыгыш бөлүштүрүүлөрү бири-биринен канчалык айырмалана аларын чектейт; \(\varepsilon\) кичирейген сайын бөлүштүрүүлөрдү айырмалоо кыйындап, күчтүүрөөк купуялуулук максат кылынат, ал эми \(\delta\) идеалдуу көбөйтүү чегинен өтө кичине ыктымалдык менен ашууга жол берген кошумча мүчө; бул параметрлердин эч бири контексттен көз карандысыз “өз алдынча коопсуз” чек катары түшүндүрүлбөшү керек.
Дифференциалдык купуялуулуктун негизги математикалык аныктамасы
Булак аныктаманы сөз менен берет. Анын стандарттык математикалык жазылышын түшүндүрмө максатта мындай көрсөтүүгө болот:
\[ \Pr[M(D)\in S] \leq e^{\varepsilon}\Pr[M(D')\in S]+\delta \]
Бул жерде:
- \(M\): кокусташтырылган механизм.
- \(D\) жана \(D'\): бир гана жеке жазууда айырмаланган коңшу маалымат топтомдору.
- \(S\): мүмкүн болгон чыгыштардын каалаган көптүгү.
- \(\varepsilon\): чыгыш ыктымалдыктары көбөйтүү жагынан канчалык айырмалана аларын чектейт.
- \(\delta\): өтө кичине кошумча ийгиликсиздик ыктымалдыгына жол берет.
Бул теңсиздик “адамдын маалыматын эч качан билүүгө болбойт” дегенди билдирбейт. Такыраак мааниси — адам маалымат топтомуна киргизилгенде же киргизилбегенде механизмдин чыгыш бөлүштүрүүсү чектелген өлчөмдө гана өзгөрөт. Булактын белгилер таблицасында \(\delta\) адатта \(1/n\) ден кыйла кичине тандалары айтылат; бул жерде \(n\) маалымат топтомундагы жазуулардын саны.
ε кичирейгенде эмне үчүн модель тактыгы төмөндөшү мүмкүн?
Дифференциалдык купуялуулук көп практикалык механизмдерде маалыматка же градиентке кокустук ызы-чуу кошуу менен камсыздалат. Күчтүүрөөк купуялуулук үчүн көбүрөөк ызы-чуу керек болушу модель үйрөнүүгө аракет кылган пайдалуу сигналдын да жарым-жартылай бузулушуна алып келиши мүмкүн. Ошондуктан DPнин негизги чыгым огу CPU убактысы эмес, privacy–utility trade-off, башкача айтканда купуялуулук менен пайдалуулуктун ортосундагы компромисс.
Булак 3-сүрөттө \(\varepsilon \leq 1\), \(1 < \varepsilon \leq 4\) жана \(\varepsilon > 4\) аймактарын тиешелүүлүгүнө жараша күчтүү, орточо жана алсыз купуялуулук үчүн схемалык аймактар катары көрсөтөт. Бул график өлчөнгөн маалымат эмес жана бул чектер бардык колдонмолор үчүн укуктук же илимий универсалдуу чек катары кабыл алынбашы керек. Сүрөттүн негизги билдирүүсү — модель архитектурасы, алдын ала үйрөтүү, DP-SGD жөндөөлөрү жана accounting сапаты бирдей \(\varepsilon\) маанисинде алынган пайдалуулукту олуттуу өзгөртө алышы.
Sensitivity, Δf, эмне үчүн маанилүү?
Суроонун сезгичтиги (sensitivity, \(\Delta f\)) бир жазуу өзгөргөндө суроонун чыгышы эң көп канчага өзгөрө аларын аныктайт. Ызы-чуу масштабы ушул чоңдукка жараша жөндөлөт. Бир адам чыгышты өтө чоң өлчөмдө өзгөртө ала турган суроону жашыруу, жеке салым буга чейин чектелген суроого караганда көбүрөөк ызы-чуу талап кылат.
Laplace жана Gaussian механизмдеринин айырмасы
Laplace механизми L1 сезгичтигине ылайык ызы-чуу кошуп таза \(\varepsilon\)-DP бере алат. Gaussian механизми L2 сезгичтиги менен иштеп, \((\varepsilon,\delta)\)-DP берет. Терең үйрөнүүдө градиент clipping операциясы L2 геометриясына ылайык болгондуктан Gaussian механизми борбордук роль ойнойт.
DP-SGD кантип иштейт?
Differentially Private Stochastic Gradient Descent (DP-SGD) ар бир үйрөтүү мисалынын градиент салымын белгилүү нормага чейин чектеп, андан кийин жалпы градиентке Gaussian ызы-чуусун кошот жана бардык үйрөтүү кадамдарынын жалпы купуялуулук жоготуусун privacy accountant менен көзөмөлдөйт.
Булак DP-SGDни сөз менен түшүндүрөт. Механизмдин стандарттык түшүндүрмө жазылышында биринчи кадамда бир мисалдын градиенти мындай кесилет:
\[ \bar{\mathbf{g}}_i=\mathbf{g}_i\cdot \min\left(1,\frac{C}{\|\mathbf{g}_i\|_2}\right) \]
\(C\) — per-example clipping нормасы. Эгер мисалдын градиент нормасы \(C\) ден кичине болсо өзгөрбөйт; чоң болсо багыты сакталуу менен чоңдугу \(C\) ге чейин түшүрүлөт. Ошентип бир жазуунун жаңыртууга кошо ала турган салымы чектелет.
Андан кийин концептуалдык түрдө:
\[ \tilde{\mathbf{g}} = \frac{1}{B} \left( \sum_{i=1}^{B}\bar{\mathbf{g}}_i + \mathcal{N}(0,\sigma^2 C^2 I) \right) \]
түрүндө Gaussian ызы-чуусун кошууга болот. Бул жерде \(B\) batch өлчөмү, \(\sigma\) ызы-чуу масштабы/noise multiplier менен байланышкан параметр, \(C\) clipping чеги жана \(I\) ылайыктуу өлчөмдөгү бирдик матрица. Бул формула булактын жаңы жыйынтыгы эмес, булакта сүрөттөлгөн DP-SGD механизминин стандарттык түшүндүрмө көрсөтүлүшү.
Булактын белгилер таблицасындагы \(q\) күтүлгөн batch өлчөмүнүн маалымат топтомунун өлчөмүнө катышы болгон sampling rateти; \(T\) болсо механизм канча жолу композицияланганын, мисалы канча үйрөтүү кадамы жүргүзүлгөнүн көрсөтөт. \(C\), \(\sigma\), \(q\) жана \(T\) бири-биринен көз карандысыз жөндөөлөр эмес; акыркы privacy budget эсептөөсүндө чогуу роль ойнойт.
Privacy amplification эмнени билдирет?
Ар бир жазуунун ар бир үйрөтүү кадамына кирбеши купуялуулук жагынан артыкчылык бере алат. Subsampling аркылуу privacy amplification — кокустук тандоонун айынан белгилүү адамдын механизмге туш болуу ыктымалдыгы азайганда эффективдүү купуялуулук жоготуусу да төмөндөй турганын билдирет. Булак iteration жана shuffling аркылуу amplification жыйынтыктарын да талкуулайт.
Эмне үчүн privacy accountant керек?
DP механизмин бир жолу иштетүү менен аны он миңдеген үйрөтүү кадамында кайра-кайра иштетүү бирдей эмес. Ар бир колдонуу белгилүү өлчөмдө купуялуулук бюджетин сарптайт. Эң жөнөкөй композиция чеги:
\[ \varepsilon_{\mathrm{toplam}} \leq \sum_i \varepsilon_i, \qquad \delta_{\mathrm{toplam}} \leq \sum_i \delta_i \]
түрүндө. Бирок булак бул узак үйрөтүүдө керектен ашык пессимисттик болушу мүмкүн экенин белгилейт. Advanced composition, Rényi Differential Privacy, Gaussian Differential Privacy жана privacy-loss-distribution негизиндеги сандык accountantтар кыйла тыгыз чектерди эсептей алат.
Бул деталь практикада маанилүү: бирдей ызы-чуу колдонгон эки система башка accountant ыкмаларын колдонгону үчүн ар башка \(\varepsilon\) маанисин билдириши мүмкүн. Ошондуктан “ε=...” деп жазуу гана жетишсиз; кайсы accountant, sampling модели жана \(\delta\) мааниси колдонулганын да билүү керек.
Empirical privacy auditing эмне үчүн керек?
Математикалык accounting алгоритм спецификацияга ылайык жазылган деген божомол менен жогорку чек берет. Реалдуу программалык камсыздоодо clipping туура эмес колдонулса, sampling катасы же noise generator көйгөйү болсо, бул кепилдик бузулушу мүмкүн. Эмпирикалык купуялуулук аудити механизмге canary жазууларын кошуп, мүчөлүктү аныктоо сыяктуу чабуулдарды колдонуп, реалдуу система жок дегенде канча купуялуулук жоготуусун көрсөтөрүн өлчөөгө аракет кылат.
Аналитикалык жогорку чек менен эмпирикалык төмөнкү чек жакындашса, анализ тыгыз жана implementatsiya, сыягы, туура. Арасында чоң айырма болсо, анализ өтө бош болушу же implementatsiyaда ката болушу мүмкүн. Булак бир үйрөтүү жүрүшүндө көп canaryни чогуу аудит кылган ыкмалар бул текшерүүлөрдү өндүрүш системалары үчүн практикалуураак кылганын белгилейт.
LLMдерде дифференциалдык купуялуулук эмне үчүн кыйыныраак?
Чоң тил моделдери үйрөтүү маалыматындагы сейрек же сезимтал ырааттуулуктарды жаттап калышы мүмкүн. DP бул агып чыгууга формалдуу коргонуу берет, бирок миллиарддаган параметрди толук DP-SGD менен жаңылоо кымбат жана noise өтө жогорку өлчөмдүү параметр мейкиндигине колдонулат.
Баяндама белгилеген чечим — моделди жеке маалыматта башынан үйрөтүүнүн ордуна ачык маалыматта алдын ала үйрөтүлгөн моделди сезимтал маалыматта гана fine-tune кылуу. Low-Rank Adaptation (LoRA) сыяктуу parameter-efficient ыкмалар кичине адаптерлерди гана жаңырткандыктан clipping жана ызы-чуу бир нече миллиард эмес, бир нече миллион параметр масштабында колдонулушу мүмкүн.
Булакта келтирилген федеративдик LLM ыңгайлаштыруу изилдөөсүндө \(\varepsilon=2\) деңгээлинде жана бир миллион симуляцияланган кардар шартында тактык төмөндөшү %2-ден аз, word-error-rate өсүшү болсо %7-ден аз кармалганы билдирилет. Бул жыйынтык белгилүү система жана эксперименттик шарттарга тиешелүү; “ε=2 болгон бардык LLMдерде %2 жоготуу болот” деп жалпылоого болбойт.
Коопсуз көп тараптуу эсептөө деген эмне?
Secure Multi-Party Computation (MPC) бири-бирине толук ишенбеген тараптарга жеке кириштерин бири-бирине ачпастан жалпы функцияны эсептөөгө мүмкүндүк берет. Гомоморфтук шифрлөөдөн айырмаланып эсептөө бир ciphertext серверинде топтолбойт; маалымат жана операциялар тараптарга бөлүштүрүлөт.
Булак эки негизги салтты карайт: Boolean схемалар үчүн Yao garbled circuits жана арифметикалык эсептөөлөр үчүн secret sharing. SPDZ dishonest-majority шартында активдүү коопсуздук бере алган маанилүү протокол үй-бүлөлөрүнүн бири. ABY3 болсо үч тараптуу honest-majority чөйрөсүндө arithmetic, Boolean жана Yao sharing өкүлчүлүктөрүнүн ортосунда өтө алган натыйжалуу алкак.
Oblivious transfer жана Beaver triples эмне үчүн керек?
Oblivious transfer (OT) алуучуга жөнөтүүчүнүн билдирүүлөрүнүн ичинен өзү тандаганын гана билүүгө, жөнөтүүчүгө болсо кайсынысы тандалганын билбөөгө мүмкүндүк берет. OT extension аз сандагы кымбат ачык ачкыч операцияларын көп сандагы арзаныраак симметриялык ачкыч операцияларына кеңейтет.
Beaver multiplication triples болсо secret-sharing негизиндеги арифметикалык MPCде көбөйтүү операцияларын тездетүү үчүн алдын ала түзүлгөн корреляцияланган кокустук маанилер. Оор криптографиялык иштин чоң бөлүгү offline preprocessing этабында аткарылат; online этап бул даяр корреляцияларды колдонуп тезирээк иштейт.
MPC эмне үчүн тармак байланышы боюнча HEге караганда сезгич?
MPC кымбат public-key арифметикасынын көп бөлүгүн арзаныраак жергиликтүү операциялар менен алмаштырып жатып, тараптардын ортосунда көп билдирүү алмашууну талап кылат. Маалымат борборунда жогорку өткөрүү кеңдиги жана аз кечигүү болгон байланышта бул пайдалуу болушу мүмкүн. Континенттер аралык же мобилдик тармакта round-trip latency ошол эле протоколду кыйла жайлатат.
Ошондуктан булак HE жана MPC тандоосун “кайсынысынын криптографиясы жакшы?” деген суроодон көбүрөөк “эсептөө кымбатпы, же тармакпы?” деген суроо менен байланыштырат.
Машиналык үйрөнүүдө салыштыруу операциясы эмне үчүн MPCге кымбат?
Матрица көбөйтүүлөрү arithmetic sharingге жакшы ылайык келет, бирок ReLU, max-pooling жана argmax сыяктуу операциялар салыштырууну талап кылат. Салыштыруу бит деңгээлиндеги операция болгондуктан arithmetic sharing астында кымбат. Ошондуктан заманбап системалар arithmetic representationдан Boolean же garbled-circuit өкүлчүлүгүнө өтүшү, же сызыктуу эмес функцияны арзаныраак жакындашуу менен алмаштырышы мүмкүн.
Федеративдик үйрөнүү жалгыз өзү купуялуулук ыкмасыбы?
Жок. Федеративдик үйрөнүү чийки маалымат түзмөктөн же уюмдан чыкпашын камсыздайт, бирок серверге модель жаңыртуулары же градиенттер жөнөтүлөт. Булак ачык белгилегендей, FL жалгыз өзү формалдуу privacy guarantee эмес; HE, MPC, secure aggregation жана DP сыяктуу коргоолор жайгаштырылышы мүмкүн болгон бөлүштүрүлгөн үйрөнүү архитектурасы.
Cross-device жана cross-silo федерациясынын айырмасы
Cross-device FL телефон сыяктуу миллиондогон ресурсу чектелген жана көп учурда offline болгон кардарларды камтышы мүмкүн. Бул жерде аз кардар чыгымы, dropoutка туруктуулук жана байланыш эффективдүүлүгү чечүүчү.
Cross-silo FL болсо оорукана же банк сыяктуу аз сандагы, бирок кубаттуу уюмдарды камтыйт. Тараптардын саны аз, маалымат топтомдору чоң жана баалуу. Оорураак HE же MPC механизмдерин колдонуу мындай чөйрөдө реалдуураак.
Secure aggregation кантип иштейт?
Secure aggregation сервер жеке кардар жаңыртууларын эмес, алардын суммасын гана билишин көздөйт. Булак сүрөттөгөн pairwise-cancelling mask ыкмасынын түшүндүрмө математикалык интуициясы мындай көрсөтүлөт:
\[ m_i = u_i + \sum_{j>i}r_{ij}-\sum_{j<i}r_{ji} \]
Кардарлардын маскаланган маанилери кошулганда:
\[ \sum_i m_i = \sum_i u_i \]
болот; анткени бир эле \(r_{ij}\) маскасы бир кардарда плюс, экинчисинде минус белги менен болуп, суммадан бири-бирин жок кылат. Реалдуу протоколдор dropout, malicious server, ачкыч макулдашуусу жана secret sharing сыяктуу кошумча механизмдерди камтыйт; бул эки теңдеме cancellation логикасын гана түшүндүрөт.
Булак BatchCrypt мисалында cross-silo федеративдик үйрөнүүдө градиенттерди пакеттеп жана кванттап гомоморфтук шифрлөө naive per-value encryptionга салыштырмалуу 23–93 эсе үйрөтүү тездетүүсүн жана 66–100 эсе байланыш азайышын бергени, тактык жоготуусу болсо %1-ден аз болгону билдирилген жыйынтыктарды келтирет. Бул конкреттүү салыштырууга тиешелүү.
Градиенттерден чындап сүрөттү кайра чыгарууга болобу?
Баяндамада берилген gradient-inversion адабияты бул белгилүү шарттарда мүмкүн экенин көрсөтөт. Чабуулчу синтетикалык кириш түзгөн градиентти байкалган чыныгы градиентке жакындата тургандай кылып киришти оптималдаштырат. Алгачкы иштер бир сүрөт жана кичине тармактарда ийгиликтүү болсо, кийинки чабуулдар image priors, batch-normalization статистикасы жана өнүккөн objective функцияларын колдонуп чөйрөнү кеңейткен.
Мындан чыккан сабак — өкүлчүлүктүн адам көзүнө “түшүнүксүз” көрүнүшү купуялуулук кепилдиги эмес. Коргоо формалдуу механизмге таянышы керек.
FL + DP + шифрлөө эмне үчүн чогуу колдонулат?
Secure aggregation серверге жеке кардардын жаңыртуусун көргөзбөйт, бирок жарыяланган глобалдык модель кардарлар тууралуу эмнени чыгарарын чектебейт. User-level DP ушул экинчи көйгөйгө багытталган. Homomorphic aggregation жаңыртууларды серверден криптографиялык жашыра алат. Distributed noise generation болсо DP ызы-чуусун бир ишенимдүү сервер кошушу керек деген талапты алып салып, кардарлардын арасында бөлүштүрө алат.
Бирок ар бир катмар жаңы чыгым жана жаңы trust assumption алып келет. Коопсуздук колдонулган ыкмалардын атынан эмес, бүт pipelineдагы эң алсыз божомолдон аныкталат.
Купуялуулук менен Byzantine robustness эмне үчүн кагылышышы мүмкүн?
Зыяндуу кардар ууланган модель жаңыртуусун жөнөтүшү мүмкүн. Krum, coordinate-wise median же trimmed mean сыяктуу robust aggregation ыкмалары жеке жаңыртууларды карап, анормалдуу салымдарды аныктоого аракет кылат. Бирок secure aggregation же HE дал ушул жеке жаңыртууларды серверден жашырат.
Демек privacy механизми чабуулчунун жүрүм-турумун да жашырышы мүмкүн. Чечимдер robust статистиканы шифрленген эсептөө ичинде жүргүзүү, алсызыраак robustness guarantee кабыл алуу же кардардын жашыруун жаңыртуусу белгилүү чектерге туура келерин ZKP менен далилдөөсүн талап кылуу. Булак күчтүү купуялуулук, күчтүү robustness жана аз чыгымды бир учурда акысыз алуу мүмкүн эмес экенин өзгөчө белгилейт.
Федеративдик LLMдерде эмне үчүн adapter ыкмасы колдонулат?
Миллиарддаган параметрлүү моделди ар бир турда телефонго жөнөтүп кайра алуу практикалык эмес. Мындан тышкары түзмөк optimizer state сактай албашы мүмкүн. Ошондуктан булак бүт моделди федеративдик үйрөтүүнүн ордуна туруктуу public backbone үстүндө кичине LoRA/adapter катмарларын үйрөтүүнү негизги ыкма катары көрсөтөт. Кардар кичине адаптерди гана жаңыртып жөнөтөт; бул байланышты да, DP астында noise колдонулуучу параметр өлчөмүн да азайтат.
Издөөгө мүмкүндүк берген шифрлөө эмнени чечет?
Searchable Symmetric Encryption (SSE) кардарга шифрленген документ коллекциясын ишенимсиз серверде сактоого жана документтерди толук ачпастан шифрленген ачкыч сөз суроолорун берүүгө мүмкүндүк берет. Бирок натыйжалуу SSE дизайндар көбүнчө кирүү үлгүсү, суроонун кайталанышы же жыйынтык көлөмү сыяктуу белгилүү кошумча маалыматты чыгарат.
Forward privacy жана backward privacy деген эмне?
Forward privacy маалымат базасына жаңы кошулган документтин мурунку издөө токендери менен байланыштырылбоосун көздөйт. Backward privacy болсо өчүрүлгөн документтер келечектеги суроолор аркылуу кайра ачылбашы үчүн долбоорлонот. Динамикалык SSEнин маанилүү изилдөө маселеси — ушул эки кепилдикти бай суроолор жана аз чыгым менен бирге камсыз кылуу.
Leakage-abuse чабуулу эмне үчүн маанилүү?
SSE алгоритминин криптографиялык өзөгү теориялык жактан коопсуз болсо да, чабуулчу кайсы ciphertextтерге кирүү болгонун, бир эле суроо кайталанганын же канча жыйынтык кайтарылганын көрө алат. Access-pattern чабуулдары документке кирүү топтомдорун; volume чабуулдары жыйынтык санын; injection чабуулдары болсо чабуулчу кошкон атайын документтер түзгөн өзгөрүүлөрдү колдонуп, чыныгы суроо сөздөрүн божомолдоого аракет кылат.
Ошондуктан SSEде “шифр ачылган жок” деген сөз “маалымат агып чыккан жок” дегенди билдирбейт. Булак реалдуу коопсуздук schemeнин leakage profileы менен чабуулчунун кошумча маалыматын чогуу баалоону талап кыларын белгилейт.
ORAM эмне кылат?
Oblivious RAM (ORAM) бирдей узундуктагы эки кирүү ырааттуулугун сервер жагынан эсептөө аркылуу айырмалоого болбой тургандай кылып, кирүү үлгүсүн жашырууну көздөйт. Path ORAM дарак негизиндеги түзүлүшү менен бул коргоону логарифмдик өткөрүү кеңдиги overheadи менен берүүгө аракет кылган эң белгилүү түзүлүштөрдүн бири.
Бул күчтүүрөөк privacy жогору чыгым менен келет. SSE тез, бирок leakage кабыл алат; ORAM кирүү үлгүсүн күчтүүрөөк жашырат, бирок маалымат ташуу жана кайра иреттөө чыгымы өсөт. Private Information Retrieval болсо өзгөчө read-only суроолор үчүн башка чекитте турат.
Кванттык Компьютерлер Бул Купуялуулук Ыкмаларынын Кайсыларына Коркунуч Жаратат?
Жетиштүү чоң жана каталарга туруктуу кванттык компьютер биринчи кезекте факторлоштуруу жана дискреттик логарифм маселелерине негизделген RSA, классикалык Diffie–Hellman жана эллиптикалык ийри криптографиясы сыяктуу ачык ачкыч механизмдерине Shor алгоритминин айынан коркунуч жаратат; ушул эле коркунуч дифференциалдык купуялуулукка, маалымат-теориялык secret sharingге, симметриялык шифрлөөгө же тор негизиндеги гомоморфтук шифрлөөгө ошол эле түрдө колдонулбайт. Ошондуктан PPML системаларында кванттык өтүү бардык компонентти дароо алмаштыруу эмес, квантка ачык катмарларды туура инвентаризациялап, алмаштыруу дегенди билдирет.
Бул макаладагы “кванттан кийинки” кванттык криптографиябы?
Жок. Post-quantum cryptography (PQC) бүгүн колдонгон классикалык компьютерлерде жана тармактарда иштей алган, бирок белгилүү чоң масштабдуу кванттык чабуулдарга туруктуу болушу көздөлгөн классикалык криптографиялык алгоритмдерди билдирет. Бул түшүнүк фотондор жана кванттык физикалык каналдар колдонулган quantum key distribution менен бир нерсе эмес. Булактын көңүлү NIST стандартташтырган жана классикалык программалык/аппараттык чөйрөдө ишке ашырылуучу post-quantum алгоритмдерге бурулат.
Shor алгоритми так эмнени өзгөртөт?
RSAнын коопсуздугу чоң бүтүн сандарды факторлоштуруунун, классикалык Diffie–Hellman жана эллиптикалык ийри криптографиясынын коопсуздугу болсо ылайыктуу топтордогу discrete logarithm маселесинин классикалык компьютерлер үчүн татаалдыгына таянат. Shor алгоритми идеалдуу жана жетиштүү чоң кванттык компьютерде бул маселелердин класстарын полиномдук убакта чече алат.
Бул “бүгүнкү кванттык компьютерлер интернеттеги RSAны азыр эле кадимкидей бузуп жатат” дегенди билдирбейт. Булактын коркунуч модели жетиштүү мүмкүнчүлүктүү келечектеги кванттык компьютерге багытталган.
Harvest-now-decrypt-later коркунучу деген эмне?
Чабуулчу бүгүн ача албаган шифрленген трафикти жазып алып, жылдар бою сакташы мүмкүн. Келечекте жетиштүү кванттык кубат пайда болгондо эски ciphertextтерди ачууга аракет кылышы мүмкүн. Ошондуктан бүгүн 20–30 жыл жашыруун калышы керек болгон геномдук, мамлекеттик, коргонуу же узак мөөнөттүү жеке жазуулар үчүн коркунуч келечекте гана башталбайт; маалымат бүгүн кармалган учурдан башталышы мүмкүн.
Grover алгоритми AESти Shor сыяктуу толугу менен бузабы?
Жок. Булак берген маанилүү айырма ушунда. Grover алгоритми жалпы издөө маселесин квадраттык түрдө тездетет. Күч менен издөөдө классикалык \(k\)-бит ачкыч мейкиндиги болжол менен:
\[ O(2^k) \]
сыноо талап кылса, идеалдуу Grover модели аны болжол менен:
\[ O(2^{k/2}) \]
oracle чакыруусу деңгээлине түшүрөт. Бул түшүндүрмө татаалдык көрсөтүүсү изилдөөнүн жаңы жыйынтыгы эмес. Натыйжа симметриялык шифрлөө толугу менен колдонууга жараксыз болот дегенди билдирбейт, коопсуздук запасы азаят. Булак ошондуктан кванттан кийинки планда узунураак симметриялык ачкычтарды жана hash чыгыш өлчөмдөрүн колдонууга болорун билдирет.
Post-quantum коопсуздук эмне үчүн “математикалык жактан түбөлүккө далилденген” дегенди билдирбейт?
ML-KEM жана ML-DSA сыяктуу тор негизиндеги системалар белгилүү натыйжалуу классикалык же кванттык чабуулдарга туруктуу деп эсептелет. Бирок бул келечекте эч кандай жаңы алгоритм табылбайт деген математикалык далил эмес. NIST стандартташтыруу процессинде жылдар бою ачык криптоанализ жүргүзүлүп, айрым талапкерлердин бузулушу жана тор негизиндеги стандарттар менен катар hash негизиндеги SLH-DSA сыяктуу башка божомолго таянган альтернатива сакталганы дал ушул белгисиздикти башкаруу үчүн.
NISTтин 2024-жылдагы post-quantum стандарттары
| Стандарт | Алгоритмдин келип чыгышы | Математикалык негиз | Милдети | Булакта берилген өлчөм маалыматы |
|---|---|---|---|---|
| FIPS 203 | ML-KEM / CRYSTALS-Kyber | Module-LWE | Ачкыч капсулалоо / ачкыч орнотуу | Public key болжол менен 800–1568 byte; ciphertext болжол менен 768–1568 byte |
| FIPS 204 | ML-DSA / CRYSTALS-Dilithium | Module-LWE / Module-SIS | Санарип кол тамга | Кол тамга болжол менен 2420–4595 byte |
| FIPS 205 | SLH-DSA / SPHINCS+ | Hash функциясынын коопсуздугу | Санарип кол тамга / алгоритмдик ар түрдүүлүк | Кол тамга болжол менен 7856–49.856 byte |
Булакка ылайык бул стандарттардын параметр топтомдору NIST коопсуздук категориялары 1, 3 жана 5-те аныкталып, болжол менен AES-128, AES-192 жана AES-256-нын классикалык/кванттык чабуул чыгымдарына туура келген коопсуздук максаттары менен байланышат.
Module-LWE менен гомоморфтук шифрлөөнүн байланышы кандай?
ML-KEM жана ML-DSAнын Module-LWE үй-бүлөсү менен CKKS, BFV, BGV жана TFHE таянган LWE/RLWE үй-бүлөсү бир эле кең тор негизиндеги маселелер үй-бүлөсүнө кирет. Ошондуктан булак тор негизиндеги гомоморфтук шифрлөөнүн өзөгүн эле post-quantum мүнөздүү деп карайт.
Бул өтө маанилүү айырма: HE системасын кванттык өтүүдө толугу менен жарактан чыгаруу зарыл болбой калышы мүмкүн. Негизги алсыз жер HE эсептөөсүнүн тегерегиндеги классикалык TLS ачкыч алмашуусу, ECC кол тамгалары, сертификаттар же башка classical public-key компоненттери болушу мүмкүн.
Федеративдик үйрөнүүдө кванттык коркунуч кайда?
Булак берген мисалда федеративдик үйрөнүүнүн secure aggregation же lattice-HE менен корголгон модель жаңыртуулары буга чейин post-quantum туруктуулукка ээ болушу мүмкүн. Бирок миллиондогон кардардын идентификациясын текшерген ECC кол тамгалары кванттык коркунучка ачык калышы мүмкүн. Демек өтүү модель жаңыртуусунун математикасынан көбүрөөк authentication катмарында болушу мүмкүн.
ML-DSA кол тамгалары эквиваленттүү эллиптикалык ийри кол тамгаларынан болжол менен 30–70 эсе чоң болушу мүмкүн экени айтылат. Cross-silo системасында бул кошумча жүк чектелүү болушу мүмкүн, бирок миллиондогон мобилдик кардар көп турга катышкан cross-device федерацияда өткөрүү кеңдиги жагынан маанилүү болушу мүмкүн.
Шифрленген архивдерде кванттык коркунуч эмне үчүн шашылышыраак болушу мүмкүн?
Узак убакыт сакталган ciphertext түздөн-түз harvest-now-decrypt-later коркунучуна ачык. SSEнин симметриялык өзөгү Groverдин айынан параметрлерди күчөтүү менен корголушу мүмкүн; бирок ачкыч бөлүштүрүү же delegation үчүн classical Diffie–Hellman сыяктуу квантка ачык механизм колдонулса, бүт системанын узак мөөнөттүү коопсуздугу ушул катмардан алсырайт.
MPC кванттан кантип таасирленет?
Secret-sharing негизиндеги MPCнин online этабы маалымат-теориялык коопсуздук бере алса, кванттык компьютер бул математикалык кепилдикти жок кылбайт. Квант жагынан маанилүүрөөк аймактар preprocessing учурунда колдонулган public-key механизмдери же тараптар ортосундагы authentication каналдары. Булак ошондуктан MPCнин post-quantum migration жүгүн HE же классикалык PKI негизиндеги системадан башкача баалайт.
Дифференциалдык купуялуулук кванттык компьютерден таасирленеби?
Баяндама алкагында дифференциалдык купуялуулуктун кепилдиги эсептөө татаалдыгына эмес, чыгыш бөлүштүрүүлөрүнүн математикалык байланышынын негизинде берилет. Ошондуктан жетиштүү күчтүү кванттык компьютер пайда болушу DP аныктамасын бузбайт. Бирок DPни туура ишке ашыруу, noise өндүрүүнүн сапаты же системанын башка шифрлөө катмарлары өзүнчө коопсуздук маселеси бойдон калат.
Crypto-agility эмне үчүн стандарт тандоо сыяктуу маанилүү?
Crypto-agility — система бүт архитектураны кайра жазбастан колдонгон криптографиялык алгоритмдерди алмаштыра алышы. Булак post-quantum өтүүдө “ML-KEM колдон” деген бир жолку тандоонун ордуна алгоритмди алмаштырууну архитектуралык касиетке айлантууну сунуштайт. Себеби бүгүн тандалган post-quantum стандартты келечекте алмаштыруу зарыл болушу мүмкүн.
Баяндамада классикалык жана post-quantum механизм чогуу иштеген hybrid migration ыкмасы да каралат. Максат — кошулган канал компоненттердин жок дегенде бири коопсуз болуп турганда корголуп калсын. Мунун баасы эки алгоритмдин ачкыч, handshake жана маалымат өлчөмдөрүн чогуу ташуу.
Post-quantum алгоритм колдонуу side-channel көйгөйлөрүн жок кылабы?
Жок. Математикалык жактан күчтүү lattice схемасы начар implementatsiyaнын айынан timing же power-analysis чабуулу менен ачкыч чыгарып коюшу мүмкүн. Булак ошондуктан constant-time NTT implementatsiyalar, masked samplerлер жана физикалык каптал-канал коргоосун өзгөчө чабуулчу түзмөккө жакындай ала турган edge device же федеративдик кардар сыяктуу чөйрөлөрдө маанилүү деп эсептейт.
Ыкмаларды чогуу колдонуу эмне үчүн ар дайым “коопсузураак” эмес?
Баяндамадагы маанилүү оригиналдуу синтездердин бири — privacy ыкмалары бири-бирин толуктайт деп гана тим болбостон, бириктирүү маалында пайда болгон кагылыштарды да өзүнчө талдоосу.
| Комбинация | Байланыш | Эмне үчүн? |
|---|---|---|
| HE + DP | Кагылыш | DPнин башкарылган ызы-чуусу CKKSтин өзүнүн болжолдуу ката/noise өсүшү менен чогуу талданууга тийиш. |
| HE + Secure Aggregation | Синергиялуу | Aggregation маалында серверге жеке жаңыртуу ишеними азайтылышы мүмкүн. |
| DP + Secure Aggregation | Синергиялуу | Distributed noise generation менен жалпы DP ызы-чуусун кардарлар арасында өндүрүүгө болот. |
| FL + HE/MPC | Кагылыш + коргоо | Купуялуулук өсөт, бирок криптографиялык байланыш FLнин маалымат кыймылын азайтуу артыкчылыгын жарым-жартылай жокко чыгарышы мүмкүн. |
| Privacy + Robust Aggregation | Кагылыш | Жаңыртууларды жашыруу зыяндуу жаңыртууну текшерүүнү да кыйындатат. |
| ZKP + Secure Aggregation | Синергиялуу | Кардар жаңыртуусун ачпастан норма/чек шарттарына туура келерин далилдей алат. |
| ZKP + HE | Кошумча кепилдик, бирок жогорку чыгым | Confidentialityге integrity кошулат; proving чыгымы өзүнчө төлөнөт. |
HE менен DPнин ортосундагы noise кагылышы
DP математикалык түрдө калибрленген noise бөлүштүрүүсүн талап кылат. CKKS болсо болжолдуу арифметиканын айынан буга чейин эле криптографиялык/сандык ката алып жүрөт. DP noise encrypted domain ичинде өндүрүлсө, бул эки ката компоненти кошулат. HE катасы эсепке алынбаса чыныгы бөлүштүрүү DP анализиндеги божомолдон айырмаланышы мүмкүн; өтө консервативдүү эсептелсе модель utilityси керектен ашык төмөндөйт.
Булак ошондуктан privacy үчүн кошулган noise менен cryptographyнин inherent errorун өз-өзүнчө эмес, чогуу моделдөө керектигин белгилейт.
Федеративдик үйрөнүү менен криптографиялык байланыш кагылышы
FLнин негизги иштетүү артыкчылыктарынын бири чийки маалыматты ташыбоо. Бирок naive secure aggregation көп pairwise key agreement талап кылышы мүмкүн; naive homomorphic encryption болсо ар бир градиент элементин чоң ciphertextке айландырышы мүмкүн. Натыйжада “азыраак маалымат ташыйлы” деп түзүлгөн федерация купуялуулук катмарынан улам күтүлгөндөн көбүрөөк тармак трафигин чыгарышы мүмкүн.
Polylogarithmic secure aggregation, sparse communication graph, one-shot mask reconstruction, quantization жана batching сыяктуу ыкмалардын мааниси дал ушул кагылыштан чыгат.
Техникалык тандоодо булак кайсы суроолорду берет?
Баяндама техникалык тандоону төрт негизги суроого түшүрөт:
- Маалыматты ким же кимдер кармайт?
- Эсептөөнү жүргүзгөн тарап чийки маалыматты көрө алабы?
- Жыйынтык ишенимсиз үчүнчү тараптарга же коомчулукка жарыяланабы?
- Чектөөчү ресурс эсептөөбү, байланышпы, тактыкпы же уюштуруучулук ишеним божомолубу?
| Сценарий | Булакта сунушталган баштапкы комбинация | Чектөөчү фактор |
|---|---|---|
| Жеке кардар маалыматы менен булут inference | HE/CKKS; сервер бүтүндүгү күмөн болсо ZKP | Сервер эсептөө убактысы |
| Ооруканалардын жалпы диагноз моделин үйрөтүшү | Cross-silo FL + homomorphic aggregation + жарыяланган модельдө DP | Регуляция жана silo өткөрүү кеңдиги |
| Мобилдик клавиатура божомолу | Cross-device FL + secure aggregation + user-level DP | Кардар байланышы жана dropout |
| Эки компаниянын жалпы тобокел упайы | Эки тараптуу mixed-protocol MPC | Тармак round-trip кечигүүсү |
| Калк статистикасын жарыялоо | Central DP + сандык privacy accounting | Максат ε астындагы utility |
| Ишенимсиз кардарлардан telemetry | Local DP же shuffled DP | Noise себеп болгон utility жоготуусу |
| Шифрленген документ издөө | Forward/backward-private SSE; access pattern маанилүү болсо ORAM | Leakage profile |
| Сезимтал корпуста LLM fine-tuning | Public backbone үстүндө DP-SGD + low-rank adapter | Максат ε астындагы utility |
| Он жылдап жашыруун кала турган архив | Post-quantum primitives; өтүүдө гибриддик механизм | Ачкыч жана кол тамга өлчөмдөрү |
Изилдөө прототиби менен өндүрүш системасынын ортосунда эмне үчүн чоң айырма бар?
PPML изилдөөлөрүндө аз latency же жогорку throughput көрсөтүү өндүрүш системасынын кичине гана бөлүгү. Реалдуу ML pipeline аралык tensorлорду текшерүүнү, log жазууну, checkpoint түзүүнү, hyperparameter tuning жүргүзүүнү, distribution driftти көзөмөлдөөнү жана ката мисалды debug кылууну каалайт. Encryption аралык маанилерди көрүнбөс кылат. DPде ар бир жеке diagnostic query жаңы privacy budget сарпташы мүмкүн. MPC бир процесстүү программаны бөлүштүрүлгөн протоколго айлантат.
Ошондуктан compiler жана framework катмары маанилүү. OpenFHE, CrypTen, SecretFlow-SPU жана окшош куралдар криптографиялык деталдарды көнүмүш программалоо моделдеринин артына жашырууга аракет кылат. Бирок булак алар интеграция жүгүн жок кылбай, гана азайтарын баса белгилейт.
Ачкыч башкаруу эмне үчүн криптографиядан алсызыраак звено болушу мүмкүн?
HE математикалык жактан күчтүү болсо да, secret key туура эмес жерде сакталса коопсуздук бузулат. Cross-silo системасында бир уюмдун decryption key кармашы ишеним моделин буза алат; threshold же multi-key дизайндар ошондуктан маанилүү. Cross-device федерацияда миллиондогон кардардын ачкыч түзүшү, rotation, жоголгон кардарлар жана certificate башкаруу өзүнчө инженердик көйгөй.
Баалоо/evaluation keyлер да чоң жана сервердин колунда болушу керек. Ошондуктан “алгоритм 128-bit security берет” деген сөз операциялык система чындап 128-bit коопсуз дегенди билдирбейт.
Формалдуу купуялуулук кепилдиги укуктук жактан “анонимдүү маалымат” дегенди билдиреби?
Булактын маанилүү өндүрүш эскертүүлөрүнүн бири ушунда: дифференциалдык купуялуулук математикалык \(\varepsilon\) жана \(\delta\) тилин колдонсо, маалыматты коргоо мыйзамдары жеке маалымат, идентификациялануу, максатты чектөө, укуктук негиз жана маалымат ээсинин укуктары сыяктуу категорияларды колдонот. Булардын ортосунда автоматтык бир-бир дал келүү жок.
Мисалы, белгилүү \(\varepsilon\) маанисинде DP колдонулган маалымат топтому укуктук жактан “анонимдүү” деп эсептелеби же жокпу — муну техникалык формуладан гана чыгарууга болбойт. Ошол сыяктуу “right to erasure” талабы үйрөтүү жазуусун дисктен өчүрүү менен модель ал жазуудан үйрөнгөн маалыматты автоматтык жок кылбайт; machine unlearning өзүнчө ачык изилдөө темасы.
Кайсы ыкмалар өндүрүштө канчалык жетилген?
Булак 6-сүрөттөгү баалоо өлчөнгөн упай эмес, авторлор адабият жана deployment далилдеринен чыгарган сапаттык синтез. Дифференциалдык купуялуулук жана федеративдик үйрөнүү чоң масштабдуу өндүрүш мисалдарына ээ. Secure aggregation ошол федеративдик системалардын ичинде өндүрүштө колдонулат. Post-quantum стандарттары стандартташтырылып, migration баскычында. SSE жана MPC пилоттук же тар өндүрүш колдонууда. HE тар, бирок жогорку баалуу иш жүктөрүндө эрте өндүрүш деңгээлинде. Машиналык үйрөнүү үчүн ZKP колдонмолорунун көпчүлүгү дагы эле изилдөө баскычында.
Саламаттык сактоо, каржы, мобилдик жана акылдуу шаар мисалдарынын жалпы сабагы
| Тармак | Типтүү масштаб | Негизги ыкмалар | Башкы тоскоолдук |
|---|---|---|---|
| Саламаттык сактоо / клиникалык изилдөө | 2–50 уюм | FL, secure aggregation, DP, өнүгүп жаткан HE | Маалымат гармонизациясы, этикалык уруксат, non-IID уюмдар |
| Керектөөчү мобилдик платформалар | \(10^6\)–\(10^9\) түзмөк | FL, secure aggregation, user-level/local DP | Байланыш, dropout, түзмөк гетерогендүүлүгү |
| Каржы кызматтары | 2–20 уюм | FL + homomorphic aggregation, MPC | Регуляция жана атаандаштык сезгичтиги |
| Акылдуу шаар / санарип эгиз | \(10^4\)–\(10^7\) гетерогендүү түзмөк | FL, local DP | Корреляцияланган маалымат агымдары жана кыймылдан кайра идентификация |
| Расмий статистика | Бир curator | Central DP + numerical accounting | Корголуучу ε астындагы utility жана коомдук коммуникация |
| Булут ML кызматы | Кардар + сервер | HE inference; айрым сценарийлерде TEE | Суроо башына latency жана чыгым |
Булак эмне үчүн ыкмалардын benchmark жыйынтыктарын түз рейтинг кылбайт?
Анткени салыштырылган системалар бир эле ишти кылбайт жана бирдей шартта текшерилбейт. Булак төрт негизги салыштыруулук көйгөйдү аныктайт:
- Коркунуч модели: malicious security берген протокол semi-honest протоколдон көбүрөөк иш кылат.
- Коопсуздук параметри: кичирээк ring dimension же modulus тезирээк болушу мүмкүн, бирок төмөнүрөөк коопсуздук бериши мүмкүн.
- Throughput менен latency айырмасы: миңдеген суроону batch кылган система менен бир интерактивдүү суроону оптималдаштырган системаны бир метрикада салыштырууга болбойт.
- Корголгон актив айырмасы: DP тактыкка, HE убакытка чыгым салат; алардын ортосунда универсалдуу “курс” жок.
| Механизм | Корголгон негизги актив | Болжолдуу эсептөө overheadи | Байланышка таасир | Utility жоготуусу | Булактагы жетилүү баасы |
|---|---|---|---|---|---|
| Гомоморфтук шифрлөө | Кириш confidentiality | \(10^3\)–\(10^6\times\) | Ciphertext expansion болжол менен 1–10× | Жок же болжолдуу арифметикадан кичине жоготуу | Эрте өндүрүш |
| MPC | Кириш confidentiality | Болжол менен \(10\)–\(10^3\times\) | Жогорку; circuit depthке көз каранды | Так арифметикада жок | Пилот |
| Дифференциалдык купуялуулук | Чыгыш privacy | Эске алынбаган деңгээлде | Жок | εга жараша орто–жогорку болушу мүмкүн | Өндүрүш |
| Федеративдик үйрөнүү | Data locality | Болжол менен 1–10× | Ар бир турда жогорку модель өткөрүү | Non-IID маалыматта кичине–орто | Өндүрүш |
| Secure aggregation | Жеке update confidentiality | Төмөн | Протоколго жараша орто деңгээл | Жок | Өндүрүш |
| Searchable encryption | Суроо жана маалымат confidentiality, белгилүү leakage менен | Болжол менен 1–10× | Төмөн | Жок | Пилот |
| ORAM | Access-pattern confidentiality | Болжол менен 10–100× | Маалымат базасынын өлчөмүндө логарифмдик overhead | Жок | Тар |
| Zero-Knowledge Proof | Эсептөөнүн бүтүндүгү | Proving үчүн болжол менен \(10^2\)–\(10^6\times\) | Succinct proof айынан салыштырмалуу төмөн болушу мүмкүн | Жок | Изилдөө |
| Post-quantum primitives | Узак мөөнөттүү криптографиялык туруктуулук | Болжол менен 1–2× | Чоңураак ачкыч жана кол тамга | Жок | Стандартташтырылган |
Бул таблицадагы даражалар көзөмөлдөнгөн жалпы эксперименттен алынган эмес. Булак аларды ар башка алгачкы изилдөөлөрдүн жыйынтыктарынан синтездейт. Ошондуктан, мисалы, “HE сөзсүз MPCден 1000 эсе жай” деген тыянак чыгарууга болбойт. Иш жүгү, алгоритм, batch түзүлүшү, коопсуздук деңгээли, hardware, malicious/semi-honest модели жана тармак кечигүүсү жыйынтыкты чоң өлчөмдө өзгөртүшү мүмкүн.
Бириктирилген PPML benchmark кандай болушу керек?
Баяндамага ылайык маанилүү жалпы benchmark жок дегенде batch inference, interactive inference, cross-silo training, cross-device training жана analytics тапшырмаларын камтышы керек. Бирдей hardware baseline же ачык scaling ыкмасы колдонулуп; коркунуч модели, corruption threshold жана security parameter ачык билдирилип; DP системаларында accountant түрү жана \((\varepsilon,\delta)\) көрсөтүлүп, utility метрикасынын жанында чыгым метрикасы да берилиши керек.
Максат бир “купуялуулук упайын” түзүү эмес, системаны privacy–utility–cost мейкиндигине жайгаштыруу.
Изилдөөнүн Ыкмасы жана Жыйынтыктары
Изилдөөнүн илимий дизайны
Бул иш жаңы эксперимент, жаңы маалымат топтому, жаңы клиникалык изилдөө, жаңы кванттык схема же жаңы PPML протоколун иштеп чыккан баштапкы изилдөө эмес. Кеңири техникалык review катары ал учурдагы адабиятты жети негизги тема боюнча синтездейт: гомоморфтук шифрлөө, дифференциалдык купуялуулук, privacy accounting, коопсуз көп тараптуу эсептөө, федеративдик үйрөнүү, шифрленген издөө/маалымат базалары жана post-quantum cryptography. Нөлдүк-билим далилдери болсо confidentiality механизмдерин толуктаган integrity катмары катары көптөгөн бөлүмдөрдө каралат.
Макаланын библиографиясында 136 булак бар. Авторлордун салымдары бөлүмүндө Quang-Vinh Dang, Minh Ngoc Dinh жана Ngoc-Son-An Nguyen literature search жана screening иштерине салым кошкону көрсөтүлөт. Ошол эле учурда негизги текстте маалымат базаларынын аттары, кайра өндүрүлө турган издөө сурамдары, PRISMA агымы, ачык киргизүү/чыгаруу критерийлери же формалдуу сапатты баалоо протоколу берилбейт. Ошондуктан аны сандык мета-анализ же протоколу толугу менен кайра өндүрүлө турган системалуу обзор катары баалоого болбойт.
Обзордун беш негизги салымы
- Адатта өзүнчө адабияттарда изилденген PPML ыкмаларын жалпы коркунуч, чыгым жана ишеним модели астында бириктирүү.
- Баштапкы булактардан accuracy, latency, throughput, key size жана overhead сыяктуу сандык жыйынтыктарды топтоп, эмне үчүн аларды түз салыштырууга болбой турганын түшүндүрүү.
- “Ыкмалар бири-бирин толуктайт” деген пикирден ары өтүп, HE+DP noise өз ара таасири, FL+криптографиялык байланыш чыгымы жана privacy+robustness карама-каршылыгы сыяктуу шайкешсиздиктерди талдоо.
- Deployment сценарийин техникалардын комбинациясына дал келтирген чечим процедурасын түзүү.
- Изилдөө прототиби менен өндүрүш системасынын айырмасын инженерия, key management, регуляция жана сектордук deployment далилдери аркылуу баалоо.
Негизги табылга 1: Бир да PPML ыкмасы бардык коопсуздук максаттарын камсыз кылбайт
HE киргизүүнү жашырат, бирок жарыяланган жыйынтык жеке маалыматты канчалык ачыкка чыгарарын чектебейт. DP жыйынтыктын адам жөнүндө берген маалыматын чектейт, бирок чийки маалыматты иштеткен тарапка каршы confidentiality камсыз кылбайт. MPC биргелешкен эсептөөнү жашырат, бирок көп байланыш талап кылат. FL data locality камсыздайт, бирок gradient leakage'ге ачык. SSE натыйжалуу суроо-талап берет, бирок leakage profile алып жүрөт. ZKP integrity камсыздайт, бирок confidentiality'нин ордун баспайт. Post-quantum primitives болсо өз алдынча privacy механизми эмес, криптографиялык кепилдиктердин убакыт өтүшү менен туруктуулук катмары.
Негизги табылга 2: Купуялуулук системаларынын чыныгы дизайн маселеси — композиция
Өндүрүш системасы көбүнчө бир нече primitive талап кылат. Мисалы, cross-silo федеративдик модель homomorphic secure aggregation колдонушу мүмкүн, глобалдык моделге user-level DP колдонулушу мүмкүн, aggregation серверинин жүрүм-туруму ZKP менен текшерилиши жана байланыш катмары post-quantum key exchange менен корголушу мүмкүн. Бирок ар бир жаңы катмар жаңы чыгым жана жаңы божомол жаратат.
Обзордун борбордук методологиялык билдирүүсү — бул компоненттердин коопсуздук талдоолору өз-өзүнчө туура болгону бүт системанын автоматтык түрдө туура экенин билдирбейт.
Негизги табылга 3: Гомоморфтук шифрлөө эми теория гана эмес, бирок дагы эле кымбат
HE терең тармак жана transformer inference деңгээлине жетти. Bootstrapping, packing, scheme switching, compiler'лер жана GPU/ASIC тездетүүсү колдонулмалуулукту олуттуу жогорулатты. Ошентсе да булак HE чыгымы plaintext computation'дан дагы эле көп тартипке жогору болушу мүмкүн экенин жана encrypted training өзгөчө чоң моделдер үчүн кыйла татаал экенин белгилейт.
Негизги табылга 4: Дифференциалдык купуялуулуктун негизги көйгөйү noise кошуу гана эмес
DPнин колдонуу сапаты clipping, sampling, accountant, batch өлчөмү, public pretraining, модель архитектурасы жана audit камтылган бүт окутуу pipeline'ына көз каранды. Бош accountant керексиз noise'га; туура эмес implementation болсо кагаздагы privacy guarantee'нин жараксыз болушуна алып келиши мүмкүн.
Негизги табылга 5: Федеративдик үйрөнүү privacy менен синоним эмес
Raw dataнын түзмөктөн чыкпашы маанилүү governance артыкчылыгы, бирок gradient inversion жана membership inference сыяктуу чабуулдар update'тердин өзүнөн маалымат чыгарууга болорун көрсөтөт. FL формалдуу privacy алышы үчүн secure aggregation, HE же DP сыяктуу кошумча механизмдер керек.
Негизги табылга 6: Маалымат сактоо катмары PPMLнин алсыз звеносу болушу мүмкүн
Training protocol өтө күчтүү корголуп турса да, feature store, database же query layer access pattern агып кетсе, системадагы сезимтал маалымат башка чекитке гана жылдырылган болот. Ошондуктан SSE, ORAM, private information retrieval жана verifiable search PPML чынжырынын бөлүгү катары каралышы керек.
Негизги табылга 7: Кванттык өтүү PPML стегинин бардык бөлүгүн бирдей өзгөртпөйт
RSA, Diffie–Hellman жана ECC негизиндеги public-key катмарлары Shor коркунучунда. Ал эми lattice-based HE буга чейин post-quantum маселелер үй-бүлөсүнө таянат; DP эсептөө божомолунан көз каранды эмес; secret-sharing негизиндеги MPCнин айрым online кепилдиктери маалымат-теориялык; symmetric encryption болсо Groverден улам чоңураак параметрлер менен күчөтүлүшү мүмкүн.
Ошондуктан migration планы “баарын PQC менен алмаштыр” деген эмес, системадагы бардык public-key dependency'лерди, узак мөөнөттүү ciphertext'терди, authentication түзүмдөрүн жана key-distribution механизмдерин инвентаризациялоо.
Негизги табылга 8: Коопсуздук сыяктуу эле операция жана уюм да аныктоочу
Үч тараптуу honest-majority MPC протоколу математикалык жактан абдан тез болгону, эгер чындап бири-бири менен жашыруун келишпей турган үч көз карандысыз уюм жок болсо, практикалык артыкчылык бербейт. HE системасынын ачкычы начар башкарылса, математикалык коопсуздук текке кетет. DPнин \(\varepsilon\) мааниси укуктук анонимдүүлүк статусун өзүнөн-өзү аныктабайт. Ошондуктан PPML deployment чечими алгоритмдик benchmark менен гана кабыл алынбайт.
Изилдөө колдогон жыйынтыктар
- PPML үчүн жалгыз, универсалдуу түрдө эң мыкты ыкма жок.
- HE күчтүү input confidentiality бере алат, бирок жогорку computational overhead алып жүрөт.
- DP output privacy үчүн формалдуу жана composable алкак, бирок utility жоготуусун жана privacy accounting талап кылат.
- MPC өзгөчө жакшы тармак шарттарында HEге салыштырмалуу башка жана көбүнчө байланышка көбүрөөк таянган дизайн чекитин берет.
- FL чийки маалыматты борборго ташууну азайтат, бирок өзү эле privacy guarantee эмес.
- Secure aggregation, DP жана HE федеративдик системаларда бири-бирин толуктай алат.
- Privacy менен Byzantine robustness ортосунда реалдуу көрүнүү карама-каршылыгы бар.
- SSE уруксат берген leakage практикалык чабуулдарда колдонулушу мүмкүн; ciphertext коопсуздугуна гана кароо жетишсиз.
- Post-quantum migration өзгөчө classical public-key authentication жана key-establishment катмарларында маанилүү.
- ML-KEM, ML-DSA жана SLH-DSA 2024 NIST стандарттары катары PPML стегинин узак мөөнөттүү криптографиялык пландоосунда маанилүү.
- Production deployment тоскоолдуктары protocol latency гана эмес; key management, tooling, регуляция, маалыматты гармонизациялоо жана уюмдук trust да критикалык.
- PPML адабиятындагы ар кандай көрсөткүчтөр жалпы benchmark жок түз рейтингделбеши керек.
Изилдөө колдобогон жалпылоолор
Изилдөө “гомоморфтук шифрлөө бардык машиналык үйрөнүү жүктөрүндө эми практикалык болуп калды”, “федеративдик үйрөнүү өзү эле маалыматты жашыруун кармайт”, “дифференциалдык купуялуулук колдонулган ар бир маалымат укуктук жактан анонимдүү”, “ε үчүн универсалдуу коопсуз сан бар”, “post-quantum алгоритмдер түбөлүккө бузулбайт”, “бүгүнкү кванттык компьютерлер RSAны күнүмдүк түрдө бузуп жатат”, “бардык классикалык криптография кванттан кийин жараксыз болот”, “HE ар дайым MPCден коопсуз” же “булактагы overhead катыштары бир benchmark'тын так рейтинги” деген жыйынтыктарды колдобойт.
Ошондой эле обзор ML-KEM, ML-DSA же SLH-DSA келечекте табылышы мүмкүн болгон бардык криптоаналитикалык ыкмаларга каршы математикалык жактан бузулгус экенин далилдебейт. Post-quantum коопсуздук бүгүн белгилүү чабуул моделдери жана негизги математикалык божомолдор алкагында бааланышы керек.
Изилдөөнүн негизги чектөөлөрү
- Каралган баштапкы системалардын hardware, model, dataset, threat model, batch жана security parameter шарттары гетерогендүү.
- Бирдиктүү HE–MPC–DP benchmark жок.
- Обзор кеңири болгону менен кайра өндүрүлө турган системалуу издөө протоколун майда-чүйдөсүнө чейин бербейт.
- HE тездеткичтеринин көпчүлүгү чакан convolutional workload'дарда бааланган; transformer жүрүм-туруму азыраак калыптанган.
- Secure training, өзгөчө чоң моделдерде, secure inference'ге караганда кыйла жетилбеген.
- Black-box DP auditing менен аналитикалык privacy bounds ортосундагы ажырым толук жабыла элек.
- SSE/ORAM/ML pipeline'дарындагы жалпы leakage'ди бир composable бюджетте бириктирген жетилген теория жок.
- Post-quantum стандарттары жарыяланганына карабай, чыныгы PPML инфраструктурасына migration жана crypto-agility интеграциясы бүтө элек.
- Укуктук privacy түшүнүктөрү менен формалдуу криптографиялык/статистикалык кепилдиктердин ортосунда бирден-бир түз шайкештик жок.
Обзордун келечектеги изилдөө күн тартиби
Булак келечектеги изилдөө муктаждыктарын бир нече негизги багытта топтойт: HE bootstrapping жана чоң модель throughput'ун жакшыртуу; модель архитектурасы менен криптографияны бирге долбоорлоо; DP accounting'ди кыйла так жана текшерилүүчү кылуу; cross-device secure aggregation байланышын азайтуу; leakage'ди формалдуу жана composable түрдө сандык баалоо; жалпы benchmark стандартын иштеп чыгуу; post-quantum migration'ды аяктоо; privacy механизмдерин укуктук жана операциялык муктаждыктар менен ачыгыраак байланыштырууу.
Булардын үстүндөгү жалпы изилдөө маселеси composition: ар кандай механизмдерди жөн гана катар коюу эмес, бир механизм калтырган residual leakage'ди экинчиси чындап жабабы, жаңы чыгым же жаңы чабуул бетин жаратабы — муну бүт система деңгээлинде талдоо.
Булак жана Ыкма Жөнүндө Эскертүү
Түпнуска эмгек: Privacy-Preserving Cryptography for Machine Learning: A Comprehensive Review of Homomorphic Encryption, Differential Privacy, Secure Computation, and Post-Quantum Foundations
Авторлор: Quang-Vinh Dang; Dat Le; Minh Ngoc Dinh; Ngoc-Son-An Nguyen.
Авторлордун тартиби: Булакта берилген тартип өзгөртүлбөй сакталды.
Тең салым: Булакта тең салым/тең биринчи авторлук тууралуу билдирүү табылган эмес.
Жооптуу автор: Dat Le.
Аффилиация 1: School of Computing and Innovative Technologies, British University Vietnam, Hung Yen, Hanoi, Vietnam.
Аффилиация 2: Department of Science, Technology, and International Projects, Ho Chi Minh City University of Economics and Finance, Ho Chi Minh City, Vietnam.
Аффилиация 3: School of Data Science and Information Technology, Millennia Education, Ho Chi Minh City, Vietnam.
Аффилиация 4: Faculty of Information Technology, Industrial University of Ho Chi Minh City, Ho Chi Minh City, Vietnam.
Журнал: Computers, Materials & Continua (CMC).
Басмакана: Tech Science Press.
Том / сан: Volume 89, Number 3, 2026.
DOI: 10.32604/cmc.2026.087848.
Кабыл алынган дата: 24 Июнь 2026.
Кабылдоо датасы: 25 Август 2026.
Жарыяланган дата: 22 Октябрь 2026.
Булак түрү: Review / кеңири техникалык обзор.
Рецензия статусу: Рецензияланган ачык жеткиликтүү журналда жарыяланган акыркы макала.
Атайын чыгарылыш: Privacy-Preserving AI: Encryption and Differential Privacy.
Лицензия: Creative Commons Attribution 4.0 International (CC BY 4.0).
Расмий жарыя шилтемеси: https://www.techscience.com/cmc/v89n3/69357
DOI шилтемеси: https://doi.org/10.32604/cmc.2026.087848
Preprint статусу: Каралган булак жана расмий жазуу жарыяланган журнал версиясы; бул эмгек үчүн өзүнчө preprint версиясы берилген булак материалында көрсөтүлгөн эмес.
Каржылоо: Авторлор эмгек үчүн атайын каржылоо албаганын билдиришкен.
Маалымат жана материалдардын жеткиликтүүлүгү: Review макала болгондуктан жаңы маалымат түзүлбөгөнү же талданбаганы көрсөтүлгөн.
Этикалык жактыруу: Колдонулбайт.
Кызыкчылыктардын кагылышы: Авторлор кызыкчылыктардын кагылышы жок экенин билдиришкен.
Автордук салымдар: Эмгектин концептуалдаштырылышы жана дизайны Quang-Vinh Dang жана Dat Le; адабият издөө жана screening Quang-Vinh Dang, Minh Ngoc Dinh жана Ngoc-Son-An Nguyen; каралган жыйынтыктарды талдоо жана чечмелөө Quang-Vinh Dang, Dat Le жана Minh Ngoc Dinh; таксономия, compositional analysis жана selection guide дизайны Quang-Vinh Dang жана Dat Le; сүрөттөр жана таблицалар Minh Ngoc Dinh жана Ngoc-Son-An Nguyen; биринчи долбоор Quang-Vinh Dang жана Dat Le; критикалык илимий ревизия Dat Le, Minh Ngoc Dinh жана Ngoc-Son-An Nguyen тарабынан аткарылган. Бардык авторлор акыркы версияны карап чыгып, жактырганы билдирилген.
Обзор ыкмасы үчүн маанилүү чек: Автордук салымдар адабият издөө жана screening жасалганын көрсөтсө да, макаланын негизги текстинде кайра өндүрүлө турган маалымат базасынын издөө саптары, PRISMA агым схемасы, формалдуу киргизүү/чыгаруу критерийлери же сандык мета-анализ протоколу берилбейт. Ошондуктан Verianla баяны эмгекти кеңири техникалык review катары аныктайт; системалуу review же мета-анализ катары кайра классификациялабайт.
Сандык жыйынтыктарды чечмелөө чеги: Макаладагы HE latency, transformer inference, DP utility, secure aggregation, cryptographic overhead жана post-quantum key/signature өлчөмдөрү ар башка баштапкы булактардан топтолгон. Булактын өзү hardware, model, dataset, batch size, threat model жана security parameter айырмачылыктарынан улам аларды көзөмөлдөнгөн жалгыз benchmark сыяктуу салыштырууга болбой турганын белгилейт.
Кванттык чечмелөө чеги: Бул эмгек жаңы кванттык компьютер эксперименти же quantum machine learning модели эмес. Кванттык бөлүм Shor жана Grover алгоритмдеринин криптографиялык таасирлерин жана PPML инфраструктурасынын post-quantum migration муктаждыктарын адабият негизинде баалайт. “Post-quantum” термини келечектеги бардык мүмкүн болгон чабуулдарга каршы абсолюттук математикалык кол тийгислик катары чечмеленбеши керек.
Пикир калтырыңыз
E-mail дарегиңиз жарыяланбайт. Милдеттүү талаалар * менен белгиленген