


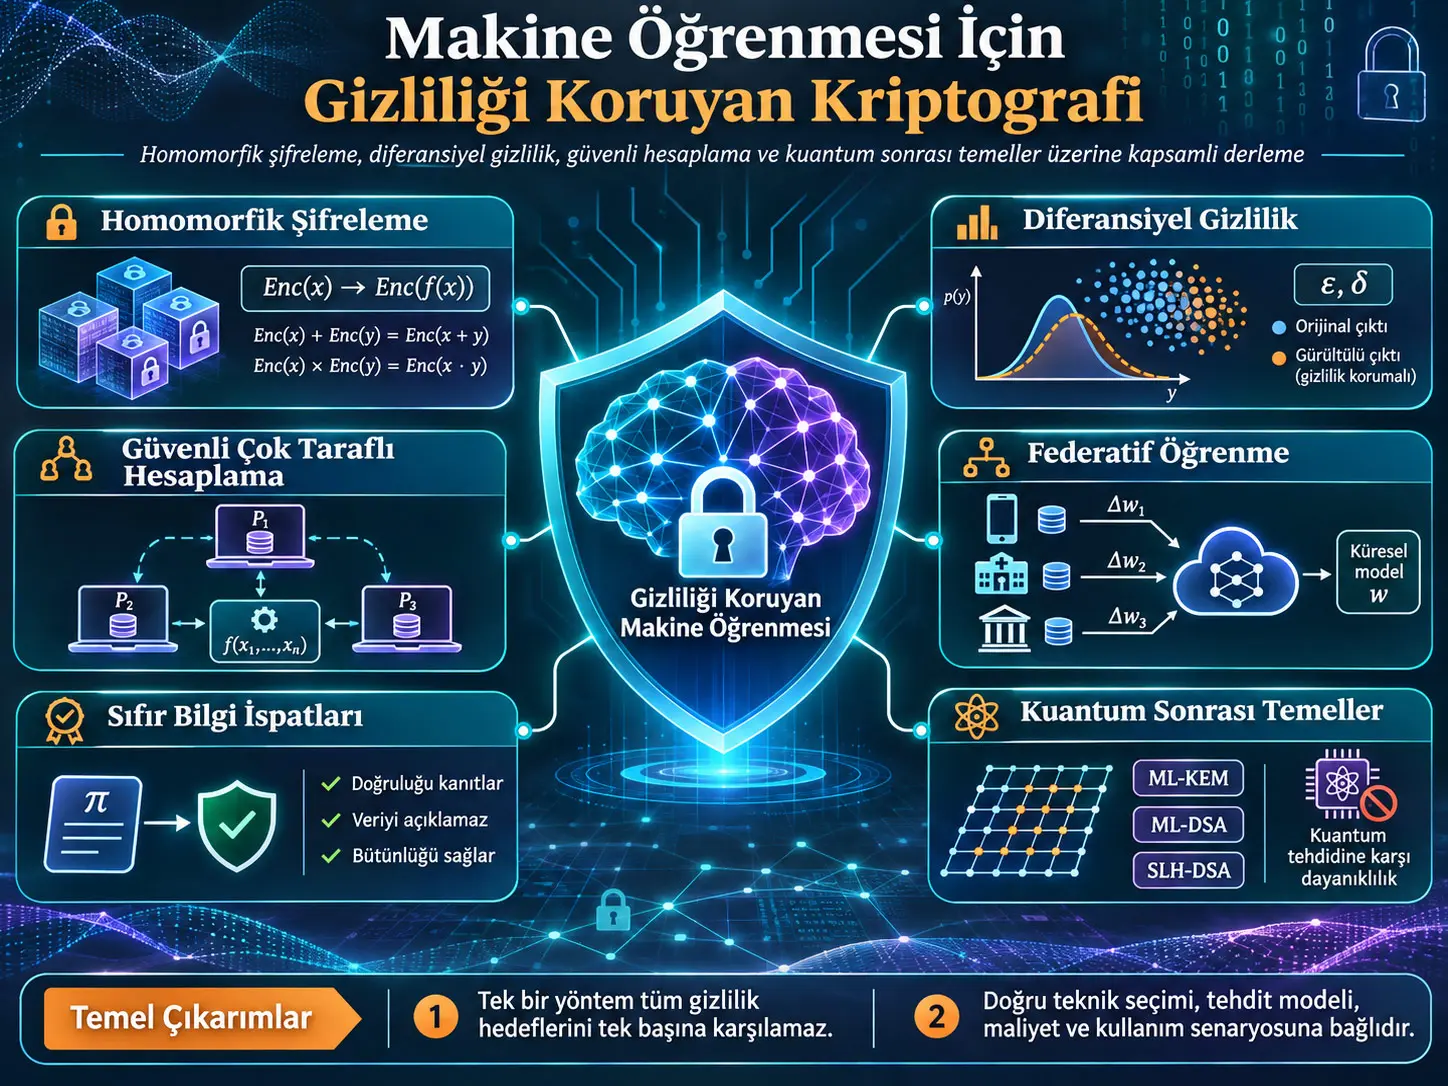
Gizliliği koruyan makine öğrenmesi (Privacy-Preserving Machine Learning, PPML), hassas veriler üzerinde makine öğrenmesi yapılırken verinin içeriğinin, bireysel kayıtların, model parametrelerinin veya hesaplamanın bütünlüğünün korunmasını amaçlayan kriptografik, istatistiksel ve sistemsel tekniklerin birlikte oluşturduğu bir araştırma ve mühendislik alanıdır. Bu kapsamlı derleme; homomorfik şifreleme (Homomorphic Encryption, HE), diferansiyel gizlilik (Differential Privacy, DP), güvenli çok taraflı hesaplama (Secure Multi-Party Computation, MPC), federatif öğrenme (Federated Learning, FL), sıfır bilgi ispatları (Zero-Knowledge Proofs, ZKP), aranabilir şifreleme, Oblivious RAM ve kuantum-sonrası kriptografiyi tek bir çerçevede karşılaştırmaktadır. Çalışmanın temel sonucu, bu yöntemlerden hiçbirinin tek başına bütün gizlilik, mahremiyet, bütünlük ve kullanılabilirlik sorunlarını çözmediğidir; gerçek sistemlerde seçim, korunacak varlığa, tehdit modeline, hesaplama ve iletişim bütçesine, doğruluk kaybına ve güven varsayımlarına göre yapılmalıdır.
Derlemenin önemli ayrımlarından biri confidentiality ile privacy kavramlarını aynı şey gibi kullanmamasıdır. Kriptografik gizlilik veya confidentiality, verinin ya da ara hesaplama değerlerinin yetkisiz tarafça görülmesini engellemeye çalışır. Diferansiyel gizlilikteki privacy ise yayımlanmış bir sonuçtan tek bir bireyin veri kümesinde bulunup bulunmadığı veya o bireye ait bilginin ne ölçüde çıkarılabileceğiyle ilgilidir. Homomorfik şifreleme veya MPC, hesaplamanın girdilerini saklayabilir fakat yayımlanan sonucun bireyler hakkında ne kadar bilgi açığa çıkardığını kendiliğinden sınırlamaz. Diferansiyel gizlilik bunun tersini yapar: çıktıdan yapılabilecek çıkarımı sınırlayabilir fakat veriyi işleyen tarafın ham girdiyi görmesini tek başına engellemez. Bu nedenle güçlü PPML sistemleri çoğu zaman birden fazla tekniği katmanlar halinde birleştirir.
Çalışma aynı zamanda performans rakamlarının dikkatle okunması gerektiğini göstermektedir. Homomorfik şifreleme güçlü girdi gizliliği sağlayabilir ancak hesaplama maliyeti çok yüksektir; MPC çoğu işlemi doğru ve kriptografik olarak korumalı biçimde gerçekleştirebilir ancak yoğun iletişim gerektirir; diferansiyel gizlilik hesaplama açısından görece ucuzdur fakat doğruluk veya yararlılık kaybı yaratabilir; federatif öğrenme ham veriyi merkezi sunucuya taşımamayı sağlar fakat paylaşılan gradyan veya model güncellemelerinin kendisi bilgi sızdırabilir; aranabilir şifreleme hızlı sorgu sağlamak için erişim örüntüsü veya sorgu tekrarı gibi belirli sızıntıları kabul edebilir. Dolayısıyla “en güvenli yöntem” veya “en hızlı yöntem” gibi bağlamdan kopuk tek bir sıralama bilimsel olarak anlamlı değildir.
Derlemenin kuantum-sonrası kısmı özellikle önemlidir ancak burada incelenen konu yeni bir kuantum bilgisayar veya kuantum makine öğrenmesi algoritması değildir. Çalışma, yeterince büyük ve hataya dayanıklı bir kuantum bilgisayarın Shor algoritması aracılığıyla RSA, Diffie–Hellman ve eliptik eğri kriptografisi gibi çarpanlara ayırma veya ayrık logaritma temelli açık anahtarlı sistemleri tehdit edeceğini; buna karşılık simetrik şifreleme, diferansiyel gizlilik, bilgi-kuramsal secret-sharing ve kafes-temelli homomorfik şifrelemenin aynı biçimde etkilenmediğini vurgulamaktadır. NIST'in 2024'te yayımladığı ML-KEM, ML-DSA ve SLH-DSA standartları bu geçişin temel bileşenleri olarak incelenmektedir. “Kuantuma dayanıklı” ifadesi burada mutlak ve sonsuza kadar kanıtlanmış güvenlik anlamına gelmez; bilinen klasik ve kuantum saldırılarına karşı mevcut kriptografik varsayımlar altında tasarlanmış güvenliği ifade eder.
Gizliliği Koruyan Makine Öğrenmesi Nedir?
Gizliliği koruyan makine öğrenmesi, makine öğrenmesi için gerekli verinin istatistiksel değerini kullanmaya çalışırken ham veriyi, bireysel kayıtları, model güncellemelerini veya hesaplama sürecini tehdit modelinde tanımlanan saldırganlardan korumak için kriptografi, istatistik ve sistem mühendisliğini bir araya getiren bir yöntemler ailesidir; ancak PPML tek bir algoritma değildir ve her PPML tekniği farklı bir varlığı, farklı bir saldırgana karşı ve farklı bir maliyet karşılığında korur.
Neden “veri cihazdan çıkmıyor” demek tek başına gizlilik garantisi değildir?
Çalışmanın başlangıç noktası, hassas verinin doğrudan paylaşılmamasının tek başına yeterli olmadığıdır. Bir hastane hasta görüntülerini merkezi sunucuya göndermese, bir banka yalnız model güncellemelerini paylaşsa veya bir telefon klavyesi yalnız gradyan gönderse bile bu ara temsiller veri hakkında bilgi taşıyabilir. Derlemenin aktardığı üyelik çıkarımı saldırıları, belirli bir kaydın eğitim veri kümesinde bulunup bulunmadığını model davranışından tahmin etmeye çalışır. Gradyan tersine çevirme saldırıları ise paylaşılan gradyanlardan eğitim görüntülerini ve etiketleri yeniden oluşturmaya kadar ilerleyebilir.
Bu nedenle PPML'de ilk soru “veri merkezde mi, cihazda mı?” değil, “Saldırgan hangi bilgiyi görebiliyor ve bundan ne çıkarabilir?” sorusudur. Kaynak çalışmanın bütün teknik karşılaştırmaları bu tehdit-modeli yaklaşımı üzerine kuruludur.
Tehdit modeli neden bütün teknik seçimlerinden önce gelir?
Bir güvenlik veya gizlilik iddiası, saldırganın neleri yapabildiği tanımlanmadan anlamlı değildir. Kaynak iki temel kriptografik saldırgan sınıfını ayırır. Yarı dürüst (semi-honest veya honest-but-curious) saldırgan protokol adımlarını doğru uygular fakat gördüğü mesajlardan ek bilgi çıkarmaya çalışır. Kötücül/aktif (malicious) saldırgan ise protokolden sapabilir, sahte mesaj gönderebilir, hesaplamayı bozabilir veya protokolü bilgi elde edecek biçimde yarıda kesebilir.
İkinci eksen corruption threshold, yani saldırganın kaç tarafı ele geçirip birlikte çalıştırabileceğidir. MPC protokollerinde “üç taraf var” demek tek başına güvenlik açıklaması değildir; örneğin en az iki tarafın birbirleriyle gizlice anlaşmayacağı varsayılıyorsa bu organizasyonel varsayım gerçek dünyada da savunulabilmelidir.
| Güvence türü | Temel fikir | Tipik örnek | Kritik sınır |
|---|---|---|---|
| Hesaplamalı güvenlik | Belirli matematiksel problemin makul sürede çözülemeyeceği varsayılır. | HE, ML-KEM, ML-DSA | Güvenlik kriptanaliz ve hesaplama gücündeki ilerlemelere bağlıdır. |
| Bilgi-kuramsal / koşulsuz güvenlik | Saldırganın hesaplama gücü sınırsız olsa bile belirli varsayımlar altında bilgi elde edemez. | Bazı secret-sharing yapıları | Genellikle honest-majority gibi yapısal varsayımlar gerekir. |
| İstatistiksel gizlilik | Komşu veri kümelerinden elde edilen çıktı dağılımlarının ayırt edilebilirliği sınırlanır. | Diferansiyel gizlilik | Doğruluk/yararlılık bedeli ve bileşimle büyüyen gizlilik bütçesi vardır. |
Aslında ne korunuyor: girdi, çıktı, model veya hesaplama bütünlüğü?
Girdi gizliliği, sunucu veya diğer tarafların hesaplamaya giren hasta görüntüsü, finansal kayıt veya özel sorgu gibi verileri görmemesidir. Homomorfik şifreleme ve MPC'nin ana rolü bu katmandadır.
Çıktı gizliliği, yayımlanan modelin veya istatistiğin eğitim verisindeki bireyler hakkında ne kadar bilgi açığa çıkardığıyla ilgilidir. Diferansiyel gizlilik bu soruna yönelir. Kriptografik olarak kusursuz biçimde hesaplanan bir sonuç bile birey hakkında fazla bilgi açıklıyorsa çıktı gizliliği sağlanmış olmaz.
Model gizliliği de ayrı bir varlıktır. Bir müşteri sunucuya özel verisini göndermek istemeyebilir; aynı anda sunucu da kendi model ağırlıklarını müşterinin çıkarmasını istemeyebilir. Güvenli çıkarım protokollerinin bir bölümü bu iki taraflı gizlilik gereksinimini hedefler.
Bütünlük (integrity) ise gizlilikten farklıdır. Sunucunun girdiyi görememesi, doğru hesaplama yaptığı anlamına gelmez. Bu nedenle sıfır bilgi ispatları gibi yöntemler, gizliliği sağlayan HE veya MPC'yi “hesaplama gerçekten söylendiği gibi yapıldı mı?” sorusuyla tamamlar.
Gizliliğin bedeli hangi kaynaktan ödeniyor?
Derlemenin en kullanışlı çerçevelerinden biri, farklı tekniklerin maliyeti farklı kaynaklara taşıdığını göstermesidir. HE ağırlıklı olarak hesaplama süresi ve bellek tüketir. MPC hesaplamayı ağ iletişimine dönüştürür. Diferansiyel gizlilik model doğruluğu veya istatistiksel yararlılık üzerinden bedel öder. Federatif öğrenme veri hareketini azaltırken çok sayıda model güncellemesi nedeniyle iletişim ve istemci heterojenliği maliyeti doğurur. Aranabilir şifreleme ise hız kazanmak için belirli bir sızıntı profili kabul edebilir.
Homomorfik Şifreleme Makine Öğrenmesini Şifreli Veri Üzerinde Nasıl Çalıştırır?
Homomorfik şifreleme, sunucunun düz veriyi veya gizli anahtarı görmeden şifreli değerler üzerinde matematiksel işlemler yapmasına ve elde ettiği şifreli sonucu yalnız yetkili anahtar sahibinin çözebilmesine izin veren bir kriptografik hesaplama yaklaşımıdır; makine öğrenmesindeki temel avantajı tek bir güvenilmeyen sunucuda etkileşimsiz girdi gizliliği sağlaması, temel dezavantajı ise düz metin hesaplamasına göre çok yüksek aritmetik ve bellek maliyetidir.
Şifreli veri üzerinde işlem yapmak nasıl mümkün oluyor?
Normal şifrelemede veri üzerinde hesaplama yapabilmek için veri çoğu zaman önce çözülür. Homomorfik şifrelemenin amacı bu zorunluluğu kaldırmaktır. İstemci \(x\) verisini şifreleyip \(Enc(x)\) üretir. Sunucu gizli anahtarı bilmeden belirli bir \(f\) fonksiyonunu şifreli alanda değerlendirir:
\[ Eval(f, Enc(x)) \rightarrow Enc(f(x)) \]
İstemci sonucu çözdüğünde:
\[ Dec(Enc(f(x))) \approx f(x) \]
elde eder. Bu gösterim çalışmanın yeni bir denklemi değildir; homomorfik hesaplamanın öğretici kavramsal özetidir. BFV ve BGV gibi tam sayı şemalarında hedef kesin aritmetiktir; CKKS'de gerçek ve karmaşık sayılar yaklaşık kodlandığından sonuçta kontrollü bir yaklaşık hata bulunabilir.
LWE ve RLWE neden bu kadar merkezi?
Derlemedeki çağdaş HE sistemlerinin çoğu, Learning With Errors (LWE; Hatalarla Öğrenme) veya bunun halka/modül türevlerine dayanan kafes problemlerinden güvenlik elde eder. Temel öğretici sezgi, doğrusal bir ilişkinin içine küçük fakat dikkatle seçilmiş bir hata eklenmesidir.
Kaynakta açık denklem olarak verilmemekle birlikte LWE fikrinin standart kavramsal yazımı şu şekilde gösterilebilir:
\[ \mathbf{b}=\mathbf{A}\mathbf{s}+\mathbf{e}\pmod q \]
Burada \(\mathbf{A}\) kamuya açık yapı, \(\mathbf{s}\) gizli bilgi ve \(\mathbf{e}\) küçük hata terimidir; \(q\) modüldür. Saldırgan \(\mathbf{A}\) ve \(\mathbf{b}\)'yi görmesine rağmen hata nedeniyle \(\mathbf{s}\)'yi geri kazanma problemi zorlaştırılır. Bu denklem ML-KEM veya CKKS'nin tam protokol tanımı değildir; yalnız LWE ailesinin temel matematiksel sezgisini öğretmek için verilmiştir.
RLWE tabanlı şemalarda skaler veya sıradan vektörler yerine polinom halkaları kullanılır. Bu yapı hem güvenlik hem de çok sayıda değerin tek bir ciphertext içine paketlenmesi açısından önemlidir.
BGV, BFV, CKKS ve TFHE arasındaki fark nedir?
| Şema | Doğal veri alanı | Aritmetik | Bootstrapping karakteri | Makine öğrenmesindeki tipik rol |
|---|---|---|---|---|
| BGV | Modüler tam sayılar | Kesin, SIMD paketleme | Leveled; gerektiğinde yenileme | Polinom değerlendirme, istatistik |
| BFV | Modüler tam sayılar | Kesin, SIMD paketleme | Leveled; gerektiğinde yenileme | Tam sayılı model çıkarımı |
| CKKS | Yaklaşık gerçek/karmaşık sayılar | Yaklaşık, SIMD paketleme | Yaklaşık modüler indirgeme tabanlı çeşitli yöntemler | Derin sinir ağı ve transformer çıkarımı |
| TFHE | Bitler / küçük tam sayılar | Boolean veya lookup-table odaklı | Çok hızlı gate-by-gate bootstrapping | Karşılaştırma, karar ağacı, doğrusal olmayan işlevler |
Kaynakta ring dimension \(N\) için tipik değerlerin yaklaşık \(2^{13}\)–\(2^{17}\) aralığında olduğu, SIMD paketlemede yaklaşık \(2^{12}\)–\(2^{16}\) plaintext slotunun kullanılabildiği belirtilmektedir. Bu sayılar her uygulama için sabit parametre değildir; güvenlik seviyesi, devre derinliği ve kütüphane seçimine göre değişir.
Ciphertext içindeki “noise” neden var ve neden büyüyor?
Kafes-temelli şifreleme sistemlerinde hata veya noise yalnız istenmeyen bir kusur değildir; güvenliğin bir parçasıdır. Ancak homomorfik toplama ve özellikle çarpma işlemleri ciphertext içindeki bu hatanın büyümesine yol açar. Hata belirli eşiği aşarsa doğru çözme başarısız olabilir. Bu nedenle bir homomorfik programın yalnız hangi matematiksel işlemleri yaptığı değil, kaç ardışık çarpma içerdiği de kritiktir.
Kaynağın sembol tablosunda \(Q\), ciphertext modulusunu ve modulus zincirinin kullanılabilir çarpımsal derinliği nasıl belirlediğini; \(L\) ise bootstrapping gerekmeden önce tüketilebilen multiplicative depth'i temsil eder. Daha derin bir ağ, daha fazla çarpma ve dolayısıyla daha fazla noise-budget tüketimi demektir.
Bootstrapping nedir?
Bootstrapping, gürültüsü büyümüş bir ciphertext üzerinde şifre çözme devresinin kendisini homomorfik olarak değerlendirerek yeni ve düşük gürültülü bir ciphertext üretme işlemidir. Bu işlem, yalnız sınırlı çarpımsal derinliği destekleyen “leveled” HE'den teorik olarak sınırsız derinlikte hesaplamaya izin veren fully homomorphic encryption'a geçişi sağlar.
Ancak bootstrapping HE'nin en pahalı işlemlerinden biridir. Kaynak CKKS ve TFHE ailelerinin maliyet yapısının farklı olduğunu vurgular. CKKS geniş gerçek sayı vektörlerini paketleyerek yüksek throughput elde eder. TFHE ise tek tek bit veya küçük tam sayı işlemlerinde programlanabilir lookup table ve gate-level bootstrapping yaklaşımıyla düşük tek-işlem gecikmesine yönelir.
Kaynakta TFHE için tarihsel olarak tek çekirdekte bir gate bootstrapping süresinin yaklaşık 13 ms'ye ve bootstrapping anahtarının yaklaşık 16 MB'a indirildiği bir sonuç aktarılmaktadır. Bu değer bütün TFHE uygulamalarının bugünkü performansı değildir; derlemede incelenen belirli çalışmanın bildirdiği referans sonucudur.
CKKS bootstrapping neden özellikle makine öğrenmesinde önemli?
CKKS gerçek ve karmaşık değerleri yaklaşık olarak işleyebildiği için sinir ağlarının sabit noktalı sayısal işlemlerine daha doğal uyum sağlar. CKKS bootstrapping'in klasik yolunda CoeffToSlot ve SlotToCoeff adı verilen doğrusal dönüşümler ile modüler indirgemeyi yaklaşık gerçekleştiren polinomlar kullanılır. Kaynağın aktardığı yakın dönem çalışmalarında kısmi CoeffToSlot ayrıştırması karmaşıklığı azaltmış; level-conserving rescaling yöntemleri benzer parametrelerde throughput'u yaklaşık %20–35 artırabilmiştir.
Derleme ayrıca roots-of-unity tabanlı daha sığ bootstrapping yaklaşımlarını, PaCo gibi blind-rotation tabanlı yapıları ve functional bootstrapping yöntemlerini ele alır. Functional bootstrapping yalnız ciphertext'i yenilemez; aynı işlem sırasında lookup table ile tanımlanan bir fonksiyonu da uygulayabilir. Kaynakta sekiz bitlik lookup table için CKKS üzerinde değere başına amortize edilmiş yaklaşık 0,72 ms bildiren bir çalışma aktarılmakta; bu değer DM/CGGI yaklaşımından yaklaşık üç büyüklük mertebesi ve daha sınırlı BFV tabanlı amortize functional bootstrapping yönteminden yaklaşık 6,8 kat daha hızlı olarak raporlanmaktadır. Bunlar farklı sistemler ve parametreler altında raporlanmış literatür sonuçlarıdır; evrensel performans katsayısı değildir.
Scheme switching neden ortaya çıktı?
Tek bir HE şeması her işlem tipinde optimum değildir. CKKS büyük gerçek sayı vektörlerinde aritmetiği verimli yaparken karşılaştırma veya kesikli lookup işlemleri TFHE-benzeri yapılarda daha doğal olabilir. Scheme switching, hesaplamanın çoğunu CKKS ile yapıp ReLU benzeri karşılaştırma veya aktivasyon gerektiğinde geçici olarak bit-temelli temsile geçmek, ardından tekrar CKKS'ye dönmek anlamına gelir. Böylece her matematiksel katman, kendisini daha ucuza değerlendirebilen kriptografik temsil üzerinde çalıştırılabilir.
Şifreli sinir ağı çıkarımında ne kadar ilerleme var?
| Sistem | Yaklaşım | Model / veri | Kaynakta bildirilen sonuç | Karşılaştırma sınırı |
|---|---|---|---|---|
| CryptoNets | Leveled HE | Sığ CNN / MNIST | Yaklaşık %99 doğruluk; yaklaşık 51.000 tahmin/saat throughput | Batch amortizasyonu yüksek, tek sorgu gecikmesi dakika ölçeğinde olabilir. |
| RNS-CKKS ResNet-20 | Bootstrapped HE | ResNet-20 / CIFAR-10 | %92,43 doğruluk; plaintext modelle girdilerin %98'den fazlasında aynı çıktı; görüntü başına saat ölçeği | Donanım ve model koşulları eski/özeldir. |
| Multiplexed convolution yaklaşımı | Bootstrapped HE | ResNet-20/110 | Yaklaşık 4,7 kat gecikme azalması; amortize sürede iki büyüklük mertebesinden fazla iyileşme | Farklı deney düzeni. |
| NEXUS | Etkileşimsiz HE | BERT ölçeği | Onlarca saniye ölçeğinde çıkarım ve interaktif baseline'lara göre yüzlerce kat bant genişliği azalması | Başka sistemlerle kontrollü benchmark değildir. |
| PUMA | 3 taraflı MPC | LLaMA-7B | Dakika ölçeğinde güvenli çıkarım | HE-only sistemle doğrudan eşdeğer değildir. |
Bu tablo “hangisi daha hızlı?” sorusuna doğrudan cevap vermek için kullanılmamalıdır. CryptoNets gibi throughput-odaklı sistemler binlerce sorguyu tek ciphertext'in slotlarına paketleyerek sabit maliyeti paylaşır. Etkileşimli bir uygulamada ise tek sorgunun sonuca ulaşma süresi önemlidir. Kaynak bu iki işletim noktasını karıştırmanın bildirilen performansı üç büyüklük mertebesine kadar yanıltabileceğini vurgular.
Transformer modelleri HE için neden özellikle zor?
Convolutional ağlardaki doğrusal katmanlar HE altında görece uygunken transformer mimarilerindeki softmax, GELU, layer normalization, bölme ve karekök işlemleri doğrudan polinom aritmetiğine uymaz. Çözümler üç ana grupta toplanır:
- Doğrusal katmanları HE ile, doğrusal olmayan katmanları MPC/secret sharing ile değerlendiren hibrit protokoller.
- Bütün hesaplamayı HE içinde tutup softmax ve benzeri fonksiyonları polinom yaklaşıklarıyla değiştiren etkileşimsiz protokoller.
- Model mimarisini baştan şifreleme-dostu hale getirerek pahalı doğrusal olmayan işlemleri azaltan ortak tasarım yaklaşımları.
Dolayısıyla şifreli makine öğrenmesinde yalnız kriptografiyi hızlandırmak yetmez; model mimarisi ile kriptografik temsilin birlikte tasarlanması giderek daha önemli hale gelir.
GPU, FPGA ve ASIC hızlandırması neyi değiştiriyor?
Derlemede HE aritmetiğinin çoğu durumda salt hesaplama birimi sayısından çok bellek bant genişliği ve veri hareketi tarafından sınırlandığı vurgulanmaktadır. Number-Theoretic Transform (NTT) ve key-switching işlemleri özellikle önemlidir. GPU'lardaki memory-centric optimizasyonlarla bazı amortize bootstrapping iş yüklerinde 100 kattan fazla hızlanma bildirilmiştir.
CPU uygulamaları genel amaçlı ve kolay erişilebilirken bellek bant genişliğine çabuk takılabilir. GPU'lar yüksek paralellik ve bant genişliği sunar. FPGA'lar programlanabilir veri yolları ile belirli modüler aritmetik işlemlerine uyarlanabilir. ASIC'ler en yüksek performans potansiyeline sahiptir ancak tasarım ve üretim maliyetleri yüksektir. Kaynak aynı zamanda mevcut hızlandırıcı değerlendirmelerinin büyük kısmının CIFAR-10/ResNet-20 gibi görece küçük convolutional modeller üzerinde yapıldığına dikkat çeker; büyük transformer iş yüklerinde aynı sonuçların otomatik olarak geçerli olduğu varsayılamaz.
Sıfır bilgi ispatı HE'nin hangi eksiğini kapatıyor?
Homomorfik şifreleme sunucunun girdiyi görmesini engelleyebilir fakat sunucunun doğru sonucu hesapladığını tek başına kanıtlamaz. Kötücül bir sunucu yanlış değerin düzgün biçimli ciphertext'ini döndürebilir. Sıfır bilgi ispatı, sunucunun belirli bir hesaplamayı doğru yaptığını altta yatan gizli veriyi açmadan ispatlamasına olanak sağlar.
Derleme zkCNN gibi çalışmaların özel test verisini veya model ağırlıklarını açıklamadan convolutional-network tahmini ve doğruluk iddiası için kanıt üretilebildiğini; daha yeni çalışmaların eğitim sürecine kadar uzandığını aktarır. Ancak bir hesaplamayı kanıtlamak çoğu zaman hesaplamanın kendisinden çok daha pahalıdır. HE ile ZKP'yi birleştirmek iki pahalı mekanizmanın maliyetini üst üste bindirdiği için bugünkü sistemler genellikle yalnız bütünlüğün kritik olduğu adımları ispatlamaya çalışır.
Diferansiyel Gizlilikte ε ve δ Ne Anlama Gelir?
\((\varepsilon,\delta)\)-diferansiyel gizlilik, yalnız bir kaydın değiştiği iki komşu veri kümesi üzerinde çalışan rastgeleleştirilmiş bir mekanizmanın çıktı dağılımlarının birbirinden ne kadar ayrılabileceğini sınırlar; \(\varepsilon\) küçüldükçe dağılımların ayırt edilmesi zorlaşarak daha güçlü gizlilik hedeflenir, \(\delta\) ise ideal çarpımsal sınırın küçük bir olasılıkla aşılmasına izin veren ek terimdir ve bu parametrelerin hiçbirisi bağlamdan bağımsız “tek başına güvenli” bir eşik olarak yorumlanmamalıdır.
Diferansiyel gizliliğin temel matematiksel tanımı
Kaynak tanımı sözlü olarak vermektedir. Bunun standart matematiksel yazımı, öğretici arka plan amacıyla şu şekilde gösterilebilir:
\[ \Pr[M(D)\in S] \leq e^{\varepsilon}\Pr[M(D')\in S]+\delta \]
Burada:
- \(M\): rastgeleleştirilmiş mekanizmadır.
- \(D\) ve \(D'\): yalnız bir bireysel kayıtta farklı olan komşu veri kümeleridir.
- \(S\): olası çıktıların herhangi bir kümesidir.
- \(\varepsilon\): çıktı olasılıklarının çarpımsal olarak ne kadar ayrılabileceğini sınırlar.
- \(\delta\): çok küçük bir ek başarısızlık olasılığına izin verir.
Bu eşitsizlik “bir bireyin verisi hiçbir zaman öğrenilemez” demek değildir. Daha kesin anlamı, bir bireyin veri kümesine dahil edilip edilmemesinin mekanizmanın çıktı dağılımını sınırlı ölçüde değiştirmesidir. Kaynak sembol tablosunda \(\delta\)'nın geleneksel olarak \(1/n\)'den çok daha küçük seçildiğini belirtmektedir; burada \(n\) veri kümesindeki kayıt sayısıdır.
ε küçüldüğünde neden model doğruluğu düşebilir?
Diferansiyel gizlilik çoğu pratik mekanizmada veriye veya gradyana rastgele gürültü ekleyerek sağlanır. Daha güçlü gizlilik için daha fazla gürültü gerekmesi, modelin öğrenmeye çalıştığı yararlı sinyalin de kısmen bozulmasına yol açabilir. Bu nedenle DP'nin baskın maliyet ekseni CPU süresi değil privacy–utility trade-off, yani gizlilik ile yararlılık arasındaki ödünleşimdir.
Kaynak Şekil 3'te \(\varepsilon \leq 1\), \(1 < \varepsilon \leq 4\) ve \(\varepsilon > 4\) bölgelerini sırasıyla güçlü, orta ve zayıf gizlilik için şematik bölgeler olarak göstermektedir. Bu grafik ölçülmüş veri değildir ve söz konusu eşikler bütün uygulamalar için hukuki veya bilimsel evrensel sınırlar olarak okunmamalıdır. Figürün asıl mesajı, model mimarisi, ön eğitim, DP-SGD ayarları ve accounting kalitesinin aynı \(\varepsilon\) değerinde elde edilebilen yararlılığı önemli ölçüde değiştirebilmesidir.
Sensitivity, Δf, neden önemlidir?
Bir sorgunun duyarlılığı (sensitivity, \(\Delta f\)), tek bir kaydın değiştirilmesi halinde sorgu çıktısının en fazla ne kadar değişebileceğini tanımlar. Gürültü ölçeği bu büyüklüğe göre ayarlanır. Tek bir bireyin çıktıyı çok büyük miktarda değiştirebildiği bir sorgunun gizlenmesi, bireysel katkının zaten sınırlı olduğu bir sorguya göre daha fazla gürültü gerektirir.
Laplace ve Gaussian mekanizmaları arasındaki fark
Laplace mekanizması L1 duyarlılığına göre gürültü ekleyerek saf \(\varepsilon\)-DP sağlayabilir. Gaussian mekanizması L2 duyarlılığıyla çalışır ve \((\varepsilon,\delta)\)-DP verir. Derin öğrenmede gradyan clipping işleminin L2 geometrisiyle uyumu nedeniyle Gaussian mekanizması merkezi rol oynar.
DP-SGD nasıl çalışıyor?
Differentially Private Stochastic Gradient Descent (DP-SGD), her eğitim örneğinin gradyan katkısını belirli bir norma kadar sınırlar, daha sonra toplu gradyana Gaussian gürültü ekler ve bütün eğitim adımlarının toplam gizlilik kaybını bir privacy accountant ile izler.
Kaynak DP-SGD'yi sözlü olarak açıklamaktadır. Mekanizmanın standart öğretici yazımı ilk aşamada tek örneğin gradyanını şu şekilde kırpar:
\[ \bar{\mathbf{g}}_i=\mathbf{g}_i\cdot \min\left(1,\frac{C}{\|\mathbf{g}_i\|_2}\right) \]
\(C\), per-example clipping normudur. Eğer bir örneğin gradyan normu \(C\)'den küçükse değişmez; büyükse yönü korunarak büyüklüğü \(C\)'ye indirilir. Böylece tek bir kaydın güncellemeye yapabileceği katkı sınırlandırılır.
Ardından kavramsal olarak:
\[ \tilde{\mathbf{g}} = \frac{1}{B} \left( \sum_{i=1}^{B}\bar{\mathbf{g}}_i + \mathcal{N}(0,\sigma^2 C^2 I) \right) \]
biçiminde Gaussian gürültü eklenebilir. Burada \(B\) batch büyüklüğü, \(\sigma\) gürültü ölçeği/noise multiplier ile ilişkili parametre, \(C\) clipping sınırı ve \(I\) uygun boyutlu birim matristir. Bu formül kaynağın yeni sonucu değil, kaynakta açıklanan DP-SGD mekanizmasının standart öğretici gösterimidir.
Kaynağın sembol tablosundaki \(q\), beklenen batch büyüklüğünün veri kümesi büyüklüğüne oranı olan sampling rate'i; \(T\) ise mekanizmanın kaç kez bileştirildiğini, örneğin kaç eğitim adımı yürütüldüğünü temsil eder. \(C\), \(\sigma\), \(q\) ve \(T\) birbirinden bağımsız ayarlar değildir; nihai privacy budget hesabında birlikte rol oynarlar.
Privacy amplification ne anlama geliyor?
Her kaydın her eğitim adımına dahil edilmemesi gizlilik açısından avantaj yaratabilir. Subsampling yoluyla privacy amplification, rastgele örnekleme nedeniyle belirli bir bireyin mekanizmaya maruz kalma olasılığının azalmasının efektif gizlilik kaybını düşürmesini ifade eder. Kaynak ayrıca iteration ve shuffling yoluyla amplification sonuçlarını tartışır.
Neden privacy accountant gerekiyor?
Bir kez DP mekanizması çalıştırmak ile on binlerce eğitim adımında tekrar tekrar çalıştırmak aynı şey değildir. Her kullanım belirli miktarda gizlilik bütçesi tüketir. En basit bileşim sınırı:
\[ \varepsilon_{\mathrm{toplam}} \leq \sum_i \varepsilon_i, \qquad \delta_{\mathrm{toplam}} \leq \sum_i \delta_i \]
şeklindedir. Ancak kaynak bunun uzun eğitimlerde gereğinden fazla kötümser olabileceğini vurgular. Advanced composition, Rényi Differential Privacy, Gaussian Differential Privacy ve privacy-loss-distribution tabanlı sayısal accountant'lar çok daha sıkı sınırlar hesaplayabilir.
Bu ayrıntı pratikte önemlidir: aynı gürültüyü kullanan iki sistem yalnız farklı accountant yöntemleri kullandığı için farklı \(\varepsilon\) değerleri raporlayabilir. Dolayısıyla yalnız “ε=...” yazılması yeterli değildir; hangi accountant'ın, sampling modelinin ve \(\delta\) değerinin kullanıldığı da bilinmelidir.
Empirical privacy auditing neden gerekli?
Matematiksel accounting, algoritmanın spesifikasyona uygun yazıldığı varsayımıyla üst sınır verir. Gerçek yazılımda clipping'in yanlış uygulanması, sampling hatası veya noise generator problemi bu garantiyi bozabilir. Ampirik gizlilik denetimi, mekanizmaya canary kayıtlar ekleyip üyelik çıkarımı gibi saldırılar uygulayarak gerçek sistemin en az ne kadar gizlilik kaybı gösterdiğini ölçmeye çalışır.
Analitik üst sınır ile ampirik alt sınır birbirine yaklaşıyorsa analiz sıkı ve uygulama muhtemelen doğrudur. Aralarında büyük fark varsa analiz fazla gevşek olabilir veya implementasyonda hata bulunabilir. Kaynak, tek eğitim koşusunda birçok canary'nin birlikte denetlenmesini mümkün kılan yöntemlerin bu kontrolleri üretim sistemleri için daha uygulanabilir hale getirdiğini vurgular.
LLM'lerde diferansiyel gizlilik neden daha zor?
Büyük dil modelleri eğitim verilerindeki nadir veya hassas dizileri ezberleyebilir. DP bu sızıntıya formal bir savunma sağlar fakat milyarlarca parametreyi tam olarak DP-SGD ile güncellemek pahalıdır ve noise çok yüksek boyutlu parametre uzayına uygulanır.
Derlemenin vurguladığı çözüm, modeli özel veride baştan eğitmek yerine kamuya açık veride önceden eğitilmiş bir modeli hassas veri üzerinde yalnız fine-tune etmektir. Low-Rank Adaptation (LoRA) gibi parameter-efficient yöntemler yalnız küçük adaptörleri güncellediği için clipping ve gürültü birkaç milyar yerine birkaç milyon parametre ölçeğine uygulanabilir.
Kaynakta aktarılan bir federatif LLM uyarlama çalışmasında, \(\varepsilon=2\) düzeyinde ve bir milyon simüle istemci altında doğruluk düşüşünün %2'nin altında, word-error-rate artışının ise %7'nin altında tutulabildiği raporlanmaktadır. Bu sonuç belirli sistem ve deney koşullarına aittir; “ε=2 olan bütün LLM'lerde %2 kayıp olur” şeklinde genellenemez.
Güvenli çok taraflı hesaplama nedir?
Secure Multi-Party Computation (MPC), birbirine tam güvenmeyen tarafların özel girdilerini birbirlerine açıklamadan ortak bir fonksiyon hesaplamalarını sağlar. Homomorfik şifrelemenin aksine hesaplama tek bir ciphertext sunucusunda yoğunlaşmaz; veri ve işlem taraflara dağıtılır.
Kaynak iki temel gelenek üzerinde durur: Boolean devreler için Yao garbled circuits ve aritmetik hesaplamalar için secret sharing. SPDZ, dishonest-majority koşulunda aktif güvenlik sağlayabilen önemli protokol ailelerinden biridir. ABY3 ise üç taraflı honest-majority ortamında arithmetic, Boolean ve Yao sharing temsilleri arasında geçiş yapabilen etkili bir çerçevedir.
Oblivious transfer ve Beaver triples ne işe yarar?
Oblivious transfer (OT), alıcının gönderenin mesajlarından yalnız seçtiği birini öğrenmesini; gönderenin ise hangisinin seçildiğini öğrenmemesini sağlar. OT extension, az sayıda pahalı açık anahtar işlemini çok sayıda daha ucuz simetrik anahtar işlemine genişletir.
Beaver multiplication triples ise secret-sharing tabanlı aritmetik MPC'de çarpma işlemlerini hızlandırmak için önceden oluşturulan korelasyonlu rastgele değerlerdir. Ağır kriptografik işin önemli bir bölümü offline preprocessing aşamasında yapılır; online aşama bu hazır korelasyonları tüketerek daha hızlı çalışır.
MPC neden ağ bağlantısına HE'den daha duyarlıdır?
MPC, pahalı public-key aritmetiğinin büyük bölümünü daha ucuz yerel işlemlerle değiştirirken taraflar arasında çok sayıda mesaj alışverişi gerektirir. Veri merkezindeki yüksek bant genişlikli, düşük gecikmeli bağlantıda bu mantıklı olabilir. Kıtalar arası veya mobil ağlarda round-trip latency aynı protokolü çok daha yavaş hale getirebilir.
Bu nedenle kaynak HE ve MPC seçimini “hangisinin kriptografisi daha iyi?” sorusundan çok “hesaplama mı pahalı, ağ mı pahalı?” sorusuyla ilişkilendirir.
Makine öğrenmesinde karşılaştırma işlemi neden MPC için pahalıdır?
Matris çarpımları arithmetic sharing'e iyi uyarken ReLU, max-pooling ve argmax gibi işlemler karşılaştırma gerektirir. Karşılaştırma bit düzeyinde işlem olduğundan arithmetic sharing altında pahalıdır. Bu nedenle modern sistemler arithmetic representation'dan Boolean veya garbled-circuit temsilinə geçebilir ya da nonlinear fonksiyonu ucuz bir yaklaşımla değiştirebilir.
Federatif öğrenme tek başına gizlilik yöntemi midir?
Hayır. Federatif öğrenme ham verinin cihaz veya kurumdan ayrılmamasını sağlar ancak sunucuya model güncellemeleri veya gradyanlar gönderilir. Kaynağın açık biçimde vurguladığı gibi FL, tek başına formal bir privacy guarantee değil; HE, MPC, secure aggregation ve DP gibi korumaların içine yerleştirilebildiği dağıtık öğrenme mimarisidir.
Cross-device ve cross-silo federasyon arasındaki fark
Cross-device FL, telefonlar gibi milyonlarca kısıtlı ve sık sık çevrimdışı olan istemciyi kapsayabilir. Burada düşük istemci maliyeti, dropout toleransı ve iletişim verimliliği belirleyicidir.
Cross-silo FL ise hastaneler veya bankalar gibi az sayıda fakat güçlü kurumu kapsar. Taraf sayısı düşük, veri kümeleri büyük ve değerlidir. Daha ağır HE veya MPC mekanizmalarının kullanılması bu ortamda daha gerçekçi olabilir.
Secure aggregation nasıl çalışır?
Secure aggregation, sunucunun bireysel istemci güncellemelerini değil yalnız toplamını öğrenmesini hedefler. Kaynağın tarif ettiği pairwise-cancelling mask yaklaşımının öğretici matematiksel sezgisi şu şekilde gösterilebilir:
\[ m_i = u_i + \sum_{j>i}r_{ij}-\sum_{j<i}r_{ji} \]
İstemcilerin maskelenmiş değerleri toplandığında:
\[ \sum_i m_i = \sum_i u_i \]
olur; çünkü aynı \(r_{ij}\) maskesi bir istemcide artı, diğerinde eksi işaretle bulunarak toplamda birbirini götürür. Gerçek protokoller dropout, malicious server, anahtar anlaşması ve secret sharing gibi ek mekanizmalar içerir; bu iki denklem yalnız cancellation mantığını öğretmektedir.
Kaynak BatchCrypt örneğinde cross-silo federatif öğrenme için gradyanların paketlenip nicemlenerek homomorfik şifrelenmesinin naive per-value encryption'a göre 23–93 kat eğitim hızlanması ve 66–100 kat iletişim azalması sağladığı, doğruluk kaybının ise %1'in altında kaldığı bildirilen sonuçları aktarır. Bunlar belirli karşılaştırmaya aittir.
Gradyanlardan gerçekten görüntü geri çıkarılabilir mi?
Derlemede aktarılan gradient-inversion literatürü bunun belirli koşullarda mümkün olduğunu gösterir. Saldırgan, sentetik bir girdinin oluşturduğu gradyanı gözlenen gerçek gradyana yaklaştıracak şekilde girdiyi optimize eder. Erken çalışmalar tek görüntü ve küçük ağlarda başarılıyken sonraki saldırılar image priors, batch-normalization istatistikleri ve daha gelişmiş objective fonksiyonları kullanarak kapsamı genişletmiştir.
Buradan çıkan ders, bir temsilin insan gözüne “anlaşılmaz” görünmesinin gizlilik garantisi olmadığıdır. Koruma, formal bir mekanizmaya dayanmalıdır.
FL + DP + şifreleme neden birlikte kullanılıyor?
Secure aggregation sunucunun tek istemci güncellemesini görmesini engeller fakat yayımlanmış global modelin istemciler hakkında ne sızdırdığını sınırlamaz. User-level DP bu ikinci problemi hedefler. Homomorfik aggregation, sunucudan güncellemeleri kriptografik olarak gizleyebilir. Distributed noise generation ise DP gürültüsünü tek bir güvenilir sunucunun eklemesine gerek bırakmadan istemciler arasında paylaştırabilir.
Ancak her katman yeni bir maliyet ve yeni bir trust assumption getirir. Güvenlik, kullanılan tekniklerin isimlerinden değil tüm pipeline'ın en zayıf varsayımından belirlenir.
Gizlilik ile Byzantine robustness neden çatışabilir?
Kötücül bir istemci zehirli model güncellemesi gönderebilir. Krum, coordinate-wise median veya trimmed mean gibi robust aggregation yöntemleri tekil güncellemeleri inceleyerek anormal katkıları belirlemeye çalışır. Fakat secure aggregation veya HE tam olarak bu bireysel güncellemeleri sunucudan gizler.
Dolayısıyla privacy mekanizması saldırgan davranışını da saklayabilir. Çözümler robust istatistiği şifreli hesaplama içinde yapmak, daha zayıf bir robustness guarantee kabul etmek veya istemcinin gizli güncellemesinin belirli sınırlar içinde olduğunu ZKP ile ispatlamasını istemektir. Kaynak güçlü gizlilik, güçlü robustness ve düşük maliyetin aynı anda bedelsiz elde edilemediğini özellikle vurgular.
Federatif LLM'lerde neden adapter yaklaşımı kullanılıyor?
Milyarlarca parametreli modeli her turda telefona gönderip geri almak pratik değildir. Ayrıca cihazın optimizer state'i taşıması da mümkün olmayabilir. Bu nedenle kaynak, tam modeli federatif olarak eğitmek yerine sabit bir public backbone üzerine küçük LoRA/adaptör katmanlarının eğitilmesini öne çıkan yaklaşım olarak gösterir. İstemci yalnız küçük adaptörü günceller ve iletir; bu hem iletişimi hem DP altında noise uygulanacak parametre boyutunu azaltır.
Aranabilir şifreleme neyi çözüyor?
Searchable Symmetric Encryption (SSE), bir istemcinin şifreli belge koleksiyonunu güvenilmeyen sunucuda tutmasına ve belgeleri tamamen çözmeden şifreli anahtar kelime sorguları yapmasına izin verir. Ama verimli SSE tasarımları çoğu zaman erişim örüntüsü, sorgu tekrarı veya sonuç hacmi gibi belirli yan bilgileri sızdırır.
Forward privacy ve backward privacy nedir?
Forward privacy, veritabanına yeni eklenen bir belgenin geçmiş arama tokenlarıyla ilişkilendirilememesini amaçlar. Backward privacy ise silinmiş belgelerin gelecekteki sorgular tarafından yeniden açığa çıkarılmaması için tasarlanır. Dinamik SSE'nin önemli araştırma problemi bu iki garantiyi zengin sorgular ve düşük maliyetle birlikte sağlayabilmektir.
Leakage-abuse saldırısı neden önemli?
Bir SSE algoritmasının kriptografik çekirdeği teorik olarak güvenli olsa bile, saldırgan hangi ciphertext'lere erişildiğini, aynı sorgunun tekrarlandığını veya kaç sonuç döndüğünü görebilir. Access-pattern saldırıları doküman erişim kümelerini; volume saldırıları sonuç sayısını; injection saldırıları ise saldırgan tarafından eklenen özel belgelerin oluşturduğu değişimleri kullanarak gerçek sorgu kelimelerini tahmin etmeye çalışabilir.
Dolayısıyla SSE'de “şifre çözülmedi” ifadesi “bilgi sızmadı” anlamına gelmez. Kaynak, gerçek güvenliğin scheme'in leakage profile'ı ile saldırganın yan bilgisinin birlikte değerlendirilmesini gerektirdiğini savunur.
ORAM ne yapıyor?
Oblivious RAM (ORAM), aynı uzunluktaki iki erişim dizisinin sunucu açısından hesaplamalı olarak ayırt edilemez olmasını hedefleyerek erişim örüntüsünü gizler. Path ORAM ağaç tabanlı yapısıyla bu korumayı logaritmik bant genişliği overhead'i ile sağlamaya çalışan en bilinen yapılardan biridir.
Bu daha güçlü privacy daha yüksek maliyetle gelir. SSE hızlıdır fakat leakage kabul eder; ORAM erişim örüntüsünü daha güçlü saklar fakat veri taşıma ve yeniden düzenleme maliyeti büyür. Private Information Retrieval ise özellikle read-only sorgular için başka bir noktada yer alır.
Kuantum Bilgisayarlar Bu Gizlilik Tekniklerinin Hangilerini Tehdit Ediyor?
Yeterince büyük, hataya dayanıklı bir kuantum bilgisayar öncelikle çarpanlara ayırma ve ayrık logaritma problemlerine dayanan RSA, klasik Diffie–Hellman ve eliptik eğri kriptografisi gibi açık anahtarlı mekanizmaları Shor algoritması nedeniyle tehdit eder; aynı tehdit diferansiyel gizlilik, bilgi-kuramsal secret sharing, simetrik şifreleme veya kafes-temelli homomorfik şifrelemeye aynı biçimde uygulanmaz ve bu nedenle PPML sistemlerinde kuantum geçişi bütün bileşenleri toptan değiştirmek değil, kuantuma açık katmanları doğru biçimde envanterleyip değiştirmek anlamına gelir.
Bu makaledeki “kuantum-sonrası” kuantum kriptografisi mi?
Hayır. Post-quantum cryptography (PQC), bugün kullandığımız klasik bilgisayar ve ağlarda çalışabilen fakat bilinen büyük ölçekli kuantum saldırılarına dayanıklı olması hedeflenen klasik kriptografik algoritmaları ifade eder. Bu kavram, fotonlar ve kuantum fiziksel kanalları kullanan quantum key distribution ile aynı şey değildir. Kaynağın odağı NIST tarafından standardize edilen klasik yazılım/donanımda uygulanabilir post-quantum algoritmalardır.
Shor algoritması tam olarak neyi değiştiriyor?
RSA'nın güvenliği büyük tam sayıların çarpanlarına ayrılmasının, klasik Diffie–Hellman ve eliptik eğri kriptografisinin güvenliği ise uygun gruplardaki discrete logarithm probleminin klasik bilgisayarlar için zor olmasına dayanır. Shor algoritması ideal yeterli büyüklükteki kuantum bilgisayarda bu problem sınıflarını polinom zamanda çözebilir.
Bu ifade “bugünkü kuantum bilgisayarlar internetteki RSA'yı şu anda rutin biçimde kırıyor” anlamına gelmez. Kaynağın tehdit modeli yeterince yetenekli gelecekteki kuantum bilgisayar üzerinedir.
Harvest-now-decrypt-later tehdidi nedir?
Bir saldırgan bugün çözmeyi başaramadığı şifreli trafiği kaydedip yıllarca saklayabilir. Yeterli kuantum kapasitesi ileride ortaya çıktığında eski ciphertext'leri çözmeye çalışabilir. Bu nedenle bugün 20–30 yıl gizli kalması gereken genomik, devlet, savunma veya uzun ömürlü kişisel kayıtlar için tehdit yalnız gelecekte başlamaz; verinin bugün yakalanmasıyla başlayabilir.
Grover algoritması AES'i Shor gibi tamamen kırıyor mu?
Hayır. Kaynağın yaptığı kritik ayrım budur. Grover algoritması genel arama problemini kuadratik olarak hızlandırır. Kaba kuvvet aramasında klasik \(k\)-bit anahtar uzayı yaklaşık:
\[ O(2^k) \]
deneme gerektirirken ideal Grover modeli yaklaşık:
\[ O(2^{k/2}) \]
oracle çağrısı düzeyine indirir. Bu öğretici karmaşıklık gösterimi çalışmanın yeni sonucu değildir. Sonuç, simetrik şifrelemenin tümden kullanılamaz hale gelmesi değil, güvenlik marjının azalmasıdır. Kaynak bu nedenle daha uzun simetrik anahtar ve hash çıktı boyutlarının kuantum sonrası planlamada kullanılabileceğini belirtir.
Post-quantum güvenlik neden “matematiksel olarak sonsuza kadar kanıtlanmış” demek değildir?
ML-KEM ve ML-DSA gibi kafes-temelli sistemlerin bilinen verimli klasik veya kuantum saldırılara dirençli olduğuna inanılmaktadır. Ancak bu, gelecekte hiçbir yeni algoritmanın bulunamayacağının matematiksel ispatı değildir. NIST standardizasyon sürecinin yıllarca açık kriptanaliz yürütmesinin, bazı adayların kırılmasının ve kafes-temelli standartların yanında hash-temelli SLH-DSA gibi farklı varsayıma dayanan bir alternatif tutulmasının nedeni tam olarak bu belirsizliği yönetmektir.
NIST'in 2024 post-quantum standartları
| Standart | Algoritma kökeni | Matematiksel temel | Görev | Kaynakta verilen boyut bilgisi |
|---|---|---|---|---|
| FIPS 203 | ML-KEM / CRYSTALS-Kyber | Module-LWE | Anahtar kapsülleme / anahtar kurulumu | Public key yaklaşık 800–1568 byte; ciphertext yaklaşık 768–1568 byte |
| FIPS 204 | ML-DSA / CRYSTALS-Dilithium | Module-LWE / Module-SIS | Dijital imza | İmza yaklaşık 2420–4595 byte |
| FIPS 205 | SLH-DSA / SPHINCS+ | Hash fonksiyonu güvenliği | Dijital imza / algoritmik çeşitlilik | İmza yaklaşık 7856–49.856 byte |
Kaynağa göre bu standartların parametre setleri NIST güvenlik kategorileri 1, 3 ve 5'te tanımlanır ve yaklaşık olarak AES-128, AES-192 ve AES-256'nın klasik/kuantum saldırı maliyetlerine karşılık gelen güvenlik hedefleriyle ilişkilendirilir.
Module-LWE ile homomorfik şifreleme arasındaki bağ nedir?
ML-KEM ve ML-DSA'nın Module-LWE ailesi ile CKKS, BFV, BGV ve TFHE'nin dayandığı LWE/RLWE ailesi aynı geniş kafes-temelli problem ailesine aittir. Bu yüzden kaynak, kafes-temelli homomorfik şifrelemenin çekirdeğini zaten post-quantum karakterde görür.
Bu çok önemli bir ayrımdır: bir HE sistemi kuantum geçişinde baştan çöpe atılmak zorunda olmayabilir. Asıl zayıf nokta HE hesaplamasının etrafındaki klasik TLS anahtar değişimi, ECC imzaları, sertifikalar veya diğer classical public-key bileşenleri olabilir.
Federatif öğrenmede kuantum tehdidi nerede?
Kaynağın verdiği örnekte federatif öğrenmenin secure aggregation veya lattice-HE ile korunan model güncellemeleri zaten post-quantum dayanıklılığa sahip olabilir. Fakat milyonlarca istemcinin kimliğini doğrulayan ECC imzaları kuantum tehdidine açık kalabilir. Dolayısıyla geçiş, model güncellemesinin matematiğinden çok authentication katmanında gerçekleşebilir.
ML-DSA imzalarının eşdeğer eliptik eğri imzalarından yaklaşık 30–70 kat daha büyük olabileceği aktarılmaktadır. Cross-silo sisteminde bu ek yük sınırlı kalabilirken milyonlarca mobil istemcinin çok sayıda tur katıldığı cross-device federasyonda bant genişliği açısından önemli olabilir.
Şifreli arşivlerde kuantum tehdidi neden daha acil olabilir?
Uzun süre saklanan ciphertext doğrudan harvest-now-decrypt-later tehdidine açıktır. SSE'nin simetrik çekirdeği Grover nedeniyle parametre güçlendirmesiyle korunabilir; ancak anahtar dağıtımı veya delegation için classical Diffie–Hellman gibi kuantuma açık mekanizma kullanılıyorsa bütün sistemin uzun vadeli güvenliği bu katmandan zayıflayabilir.
MPC kuantumdan nasıl etkileniyor?
Secret-sharing tabanlı MPC'nin online aşaması bilgi-kuramsal güvenlik sağlayabiliyorsa kuantum bilgisayar bu matematiksel garantiyi ortadan kaldırmaz. Kuantum açısından daha kritik alan preprocessing sırasında kullanılan public-key mekanizmaları veya taraflar arasındaki authentication kanallarıdır. Kaynak bu nedenle MPC'nin post-quantum migration yükünü HE veya klasik PKI tabanlı bir sistemden farklı değerlendirir.
Diferansiyel gizlilik kuantum bilgisayardan etkileniyor mu?
Derlemenin çerçevesinde diferansiyel gizliliğin garantisi hesaplama zorluğuna değil çıktı dağılımlarının matematiksel ilişkisine dayanır. Bu nedenle yeterince güçlü kuantum bilgisayarın ortaya çıkması DP tanımını bozmaz. Ancak DP'nin doğru uygulanması, noise üretiminin kalitesi veya sistemin diğer şifreleme katmanları ayrı güvenlik sorunları olmaya devam eder.
Crypto-agility neden standart seçmek kadar önemli?
Crypto-agility, bir sistemin bütün mimariyi baştan yazmadan kullandığı kriptografik algoritmaları değiştirebilmesidir. Kaynak, post-quantum geçişinde yalnız “ML-KEM kullan” gibi tek seferlik bir seçim yerine algoritma değişimini mimari özellik haline getirmeyi önerir. Çünkü bugün seçilen post-quantum standardın gelecekte değiştirilmesi gerekebilir.
Derlemede ayrıca klasik ve post-quantum mekanizmanın birlikte çalıştırıldığı hybrid migration yaklaşımı ele alınır. Amaç, bileşik kanalın bileşenlerden en az biri güvenli kaldığı sürece korunmasıdır. Bunun bedeli iki algoritmanın anahtar, handshake ve veri boyutlarının birlikte taşınmasıdır.
Post-quantum algoritma kullanmak side-channel sorunlarını ortadan kaldırır mı?
Hayır. Matematiksel olarak güçlü bir lattice şeması, kötü implementasyon nedeniyle timing veya power-analysis saldırısıyla anahtar sızdırabilir. Kaynak bu nedenle constant-time NTT uygulamaları, masked sampler'lar ve fiziksel yan kanal korumasını özellikle edge device veya federatif istemci gibi saldırganın cihaza yaklaşabildiği ortamlarda önemli görür.
Teknikleri birlikte kullanmak neden her zaman “daha güvenli” değildir?
Derlemenin önemli özgün sentezlerinden biri, privacy tekniklerinin yalnız birbirini tamamladığını söylemekle yetinmemesi; birleşim sırasında ortaya çıkan çatışmaları ayrıca incelemesidir.
| Kombinasyon | İlişki | Neden? |
|---|---|---|
| HE + DP | Gerilim | DP'nin kontrollü gürültüsü CKKS'nin kendi yaklaşık hata/noise büyümesiyle birlikte analiz edilmelidir. |
| HE + Secure Aggregation | Sinerjik | Aggregation yapılırken sunucuya tekil güncelleme güveni azaltılabilir. |
| DP + Secure Aggregation | Sinerjik | Distributed noise generation ile toplam DP gürültüsü istemciler arasında üretilebilir. |
| FL + HE/MPC | Gerilim + koruma | Gizlilik artar fakat kriptografik iletişim, FL'nin veri hareketini azaltma avantajını kısmen yok edebilir. |
| Privacy + Robust Aggregation | Gerilim | Güncellemeleri gizlemek, kötü niyetli güncellemeyi incelemeyi de zorlaştırır. |
| ZKP + Secure Aggregation | Sinerjik | İstemci güncellemesini açıklamadan norm/sınır koşullarına uyduğunu kanıtlayabilir. |
| ZKP + HE | Ek güvence fakat yüksek maliyet | Confidentiality'ye integrity eklenir; proving maliyeti ayrıca ödenir. |
HE ile DP arasındaki noise çatışması
DP, matematiksel olarak kalibre edilmiş bir noise dağılımı gerektirir. CKKS ise yaklaşık aritmetik nedeniyle zaten kriptografik/numarik hata taşır. DP noise'u encrypted domain içinde üretildiğinde bu iki hata bileşeni birbirine eklenir. Eğer HE hatası hesaba katılmazsa gerçek dağılım DP analizinde varsayılandan farklı olabilir; aşırı muhafazakâr hesaba katılırsa model utility'si gereğinden fazla düşebilir.
Kaynak bu nedenle privacy için eklenen noise ile cryptography'nin inherent error'unun ayrı ayrı değil birlikte modellenmesi gerektiğini savunur.
Federatif öğrenme ile kriptografik iletişim çatışması
FL'nin temel işletim avantajlarından biri ham veriyi taşımamaktır. Ancak naive secure aggregation çok sayıda pairwise key agreement gerektirebilir; naive homomorphic encryption ise her gradyan elemanını büyük ciphertext'e dönüştürebilir. Bu durumda “daha az veri taşıyalım” diye kurulan federasyon, gizlilik katmanı nedeniyle beklenenden daha fazla ağ trafiği üretebilir.
Polylogarithmic secure aggregation, sparse communication graph, one-shot mask reconstruction, quantization ve batching gibi yöntemlerin önemi bu çatışmadan kaynaklanmaktadır.
Teknik seçiminde kaynak hangi soruları soruyor?
Derleme teknik seçimini dört temel soruya indirger:
- Veriyi kim veya kimler tutuyor?
- Hesaplamayı yapan taraf ham veriyi görebilir mi?
- Sonuç güvenilmeyen üçüncü taraflara veya kamuya açıklanacak mı?
- Bağlayıcı kaynak kısıtı hesaplama mı, iletişim mi, doğruluk mu, yoksa organizasyonel güven varsayımı mı?
| Senaryo | Kaynakta önerilen başlangıç kombinasyonu | Bağlayıcı kısıt |
|---|---|---|
| Özel istemci verisinde bulut çıkarımı | HE/CKKS; sunucu bütünlüğü şüpheliyse ZKP | Sunucu hesaplama süresi |
| Hastanelerin ortak tanı modeli eğitmesi | Cross-silo FL + homomorfik aggregation + yayımlanan modelde DP | Regülasyon ve silo bant genişliği |
| Mobil klavye tahmini | Cross-device FL + secure aggregation + user-level DP | İstemci iletişimi ve dropout |
| İki firmanın ortak risk skoru | İki taraflı mixed-protocol MPC | Ağ round-trip gecikmesi |
| Nüfus istatistiği yayımlama | Central DP + sayısal privacy accounting | Hedef ε altında utility |
| Güvenilmeyen istemcilerden telemetry | Local DP veya shuffled DP | Noise kaynaklı utility kaybı |
| Şifreli belge arama | Forward/backward-private SSE; access pattern kritikse ORAM | Leakage profile |
| Hassas korpusta LLM fine-tuning | Public backbone üzerinde DP-SGD + low-rank adapter | Hedef ε altında utility |
| On yıllarca gizli kalacak arşiv | Post-quantum primitives; geçişte hibrit mekanizma | Anahtar ve imza boyutları |
Araştırma prototipi ile üretim sistemi arasında neden büyük fark var?
PPML araştırmalarında düşük latency veya yüksek throughput göstermek, üretim sisteminin yalnız küçük bir kısmıdır. Gerçek bir ML pipeline'ı ara tensorları incelemek, log almak, checkpoint oluşturmak, hyperparameter tuning yapmak, distribution drift izlemek ve hatalı örneği debug etmek ister. Encryption ara değerleri görünmez hale getirir. DP'de her özel diagnostic query yeni privacy budget tüketebilir. MPC tek süreçli programı dağıtık protokole dönüştürür.
Bu nedenle compiler ve framework katmanı önemlidir. OpenFHE, CrypTen, SecretFlow-SPU ve benzeri araçlar kriptografik ayrıntıları daha alışıldık programlama modellerinin arkasına gizlemeye çalışır. Ancak kaynak bunların entegrasyon yükünü ortadan kaldırmadığını, yalnız azalttığını vurgular.
Anahtar yönetimi neden kriptografiden daha zayıf halka olabilir?
HE matematiksel olarak güçlü olsa bile secret key yanlış yerde tutuluyorsa güvenlik çöker. Cross-silo sisteminde tek bir kurumun decryption key tutması güven modelini bozabilir; threshold veya multi-key tasarımlar bu yüzden önemlidir. Cross-device federasyonda milyonlarca istemcinin anahtar üretimi, rotation, kaybolan istemciler ve certificate yönetimi ayrı mühendislik problemidir.
Değerlendirme/evaluation key'leri de büyüktür ve sunucunun elinde bulunmak zorundadır. Dolayısıyla “algoritma 128-bit security veriyor” demek operasyonel sistemin gerçekten 128-bit güvenli olduğu anlamına gelmez.
Formal gizlilik garantisi hukuken “anonim veri” demek midir?
Kaynağın önemli üretim uyarılarından biri budur: diferansiyel gizlilik matematiksel \(\varepsilon\) ve \(\delta\) diliyle konuşurken veri koruma mevzuatı kişisel veri, tanımlanabilirlik, amaç sınırlaması, hukuki dayanak ve veri sahibinin hakları gibi kategoriler kullanır. Bunların arasında otomatik birebir eşleme yoktur.
Örneğin belirli bir \(\varepsilon\) değerinde DP uygulanmış veri setinin hukuken “anonim” kabul edilip edilmeyeceği teknik formülden tek başına çıkarılamaz. Benzer biçimde “right to erasure” talebi, eğitim kaydını diskten silmekle modelin o kayıttan öğrendiği bilgiyi otomatik olarak kaldırmaz; machine unlearning ayrı bir açık araştırma konusudur.
Hangi teknikler üretimde ne kadar olgun?
Kaynak Şekil 6'nın değerlendirmesi ölçülmüş bir skor değil, yazarların literatür ve deployment kanıtlarından ürettiği nitel bir sentezdir. Diferansiyel gizlilik ve federatif öğrenme geniş ölçekli üretim örneklerine sahiptir. Secure aggregation bu federatif sistemlerin içinde üretimde kullanılmaktadır. Post-quantum standartları standardize edilmiş ve migration aşamasındadır. SSE ve MPC pilot veya niş üretim kullanımındadır. HE dar fakat yüksek değerli iş yüklerinde erken üretim düzeyindedir. Makine öğrenmesi için ZKP uygulamalarının büyük kısmı hâlâ araştırma niteliğindedir.
Sağlık, finans, mobil ve akıllı şehir örneklerinin ortak dersi
| Alan | Tipik ölçek | Öne çıkan teknikler | Başlıca engel |
|---|---|---|---|
| Sağlık / klinik araştırma | 2–50 kurum | FL, secure aggregation, DP, gelişmekte olan HE | Veri harmonizasyonu, etik onay, non-IID kurumlar |
| Tüketici mobil platformları | \(10^6\)–\(10^9\) cihaz | FL, secure aggregation, user-level/local DP | İletişim, dropout, cihaz heterojenliği |
| Finansal hizmetler | 2–20 kurum | FL + homomorfik aggregation, MPC | Regülasyon ve rekabet hassasiyeti |
| Akıllı şehir / dijital ikiz | \(10^4\)–\(10^7\) heterojen cihaz | FL, local DP | Korelasyonlu veri akışları ve hareketten yeniden tanımlama |
| Resmî istatistik | Tek curator | Central DP + numerical accounting | Savunulabilir ε altında utility ve kamu iletişimi |
| Bulut ML hizmeti | İstemci + sunucu | HE inference; bazı senaryolarda TEE | Sorgu başına latency ve maliyet |
Kaynak neden tekniklerin benchmark sonuçlarını doğrudan sıralamıyor?
Çünkü karşılaştırılan sistemler aynı işi yapmıyor ve aynı koşullarda test edilmiyor. Kaynak dört ana karşılaştırılabilirlik problemini tanımlar:
- Tehdit modeli: malicious security sağlayan protokol, semi-honest protokolden daha fazla iş yapar.
- Güvenlik parametresi: daha küçük ring dimension veya modulus daha hızlı olabilir fakat daha düşük güvenlik verebilir.
- Throughput ile latency farkı: binlerce sorguyu batch yapan sistemle tek interaktif sorguyu optimize eden sistem aynı metrikle kıyaslanamaz.
- Korunan varlık farkı: DP doğruluğa, HE zamana maliyet yükler; bunların arasında evrensel bir “kur” yoktur.
| Mekanizma | Korunan temel varlık | Yaklaşık hesaplama overhead'i | İletişim etkisi | Utility kaybı | Kaynakta olgunluk değerlendirmesi |
|---|---|---|---|---|---|
| Homomorfik şifreleme | Girdi confidentiality | \(10^3\)–\(10^6\times\) | Ciphertext expansion yaklaşık 1–10× | Yok veya yaklaşık aritmetikten küçük kayıp | Erken üretim |
| MPC | Girdi confidentiality | Yaklaşık \(10\)–\(10^3\times\) | Yüksek; circuit depth'e bağlı | Kesin aritmetikte yok | Pilot |
| Diferansiyel gizlilik | Çıktı privacy | İhmal edilebilir | Yok | ε'ya bağlı orta–yüksek olabilir | Üretim |
| Federatif öğrenme | Data locality | Yaklaşık 1–10× | Her turda yüksek model transferi | Non-IID veride küçük–orta | Üretim |
| Secure aggregation | Bireysel update confidentiality | Düşük | Protokole bağlı orta düzey | Yok | Üretim |
| Searchable encryption | Sorgu ve veri confidentiality, belirli leakage ile | Yaklaşık 1–10× | Düşük | Yok | Pilot |
| ORAM | Access-pattern confidentiality | Yaklaşık 10–100× | Veritabanı boyutunda logaritmik overhead | Yok | Niş |
| Zero-Knowledge Proof | Hesaplama bütünlüğü | Proving için yaklaşık \(10^2\)–\(10^6\times\) | Succinct proof nedeniyle görece düşük olabilir | Yok | Araştırma |
| Post-quantum primitives | Uzun dönem kriptografik dayanıklılık | Yaklaşık 1–2× | Daha büyük anahtar ve imza | Yok | Standardize |
Bu tablodaki mertebeler kontrollü ortak deneyden çıkmamıştır. Kaynak bunları farklı primer çalışmaların sonuçlarından sentezlemektedir. Dolayısıyla örneğin “HE kesin olarak MPC'den 1000 kat daha yavaştır” gibi bir sonuç çıkarılamaz. İş yükü, algoritma, batch yapısı, güvenlik seviyesi, hardware, malicious/semi-honest modeli ve ağ gecikmesi sonucu büyük ölçüde değiştirebilir.
Birleşik PPML benchmark'ı nasıl olmalı?
Derlemeye göre anlamlı ortak benchmark en azından batch inference, interactive inference, cross-silo training, cross-device training ve analytics görevlerini içermelidir. Aynı hardware baseline veya açık scaling yöntemi kullanılmalı; tehdit modeli, corruption threshold, security parameter açıkça raporlanmalı; DP sistemlerinde accountant türü ile \((\varepsilon,\delta)\) belirtilmeli ve utility metriğinin yanında maliyet metriği de verilmelidir.
Amaç tek bir “gizlilik puanı” üretmek değil, sistemi privacy–utility–cost uzayında konumlandırmaktır.
Çalışmanın Yöntemi ve Bulguları
Çalışmanın bilimsel tasarımı
Bu çalışma yeni bir deney, yeni bir veri kümesi, yeni bir klinik çalışma, yeni bir kuantum devresi veya yeni bir PPML protokolü geliştiren primer araştırma değildir. Kapsamlı teknik bir review olarak mevcut literatürü yedi ana tema etrafında sentezlemektedir: homomorfik şifreleme, diferansiyel gizlilik, privacy accounting, güvenli çok taraflı hesaplama, federatif öğrenme, şifreli arama/veritabanları ve post-quantum cryptography. Sıfır bilgi ispatları ise confidentiality mekanizmalarının tamamlayıcısı olan integrity katmanı olarak birçok bölümde ele alınmaktadır.
Makalenin kaynakçası 136 kaynağa ulaşmaktadır. Yazar katkıları bölümünde Quang-Vinh Dang, Minh Ngoc Dinh ve Ngoc-Son-An Nguyen'in literature search ve screening faaliyetlerine katkıda bulunduğu belirtilmektedir. Bununla birlikte ana metinde veri tabanı adları, yeniden üretilebilir arama sorguları, PRISMA akışı, açık dahil etme/dışlama kriterleri veya formal kalite değerlendirme protokolü verilmemektedir. Bu nedenle nicel meta-analiz veya protokolü tam olarak yeniden üretilebilir sistematik derleme olarak değerlendirilmemelidir.
Derlemenin beş ana katkısı
- Genellikle ayrı literatürlerde incelenen PPML tekniklerini ortak tehdit, maliyet ve güven modeli altında birleştirmek.
- Primer kaynaklardan accuracy, latency, throughput, key size ve overhead gibi nicel sonuçları toplayıp bunların neden doğrudan karşılaştırılamadığını açıklamak.
- “Teknikler birbirini tamamlar” söyleminin ötesine geçerek HE+DP noise etkileşimi, FL+kriptografik iletişim maliyeti ve privacy+robustness çatışması gibi uyumsuzlukları analiz etmek.
- Deployment senaryosunu teknik kombinasyonuna eşleyen karar prosedürü oluşturmak.
- Araştırma prototipi ile üretim sistemi arasındaki farkı mühendislik, key management, regülasyon ve sektör deployment kanıtları üzerinden değerlendirmek.
Ana bulgu 1: Tek bir PPML tekniği bütün güvenlik hedeflerini karşılamıyor
HE girdiyi gizler fakat yayımlanan sonucun bireysel veriyi sızdırmasını sınırlamaz. DP çıktının birey hakkında verdiği bilgiyi sınırlar fakat ham veriyi işleyen tarafa karşı confidentiality sağlamaz. MPC ortak hesaplamayı gizler fakat yüksek iletişim tüketir. FL data locality sağlar fakat gradient leakage'e açıktır. SSE verimli sorgu sağlar fakat leakage profile taşır. ZKP integrity sağlar fakat confidentiality'nin yerine geçmez. Post-quantum primitives ise tek başına privacy mekanizması değil, kriptografik garantilerin zaman içindeki dayanıklılık katmanıdır.
Ana bulgu 2: Gizlilik sistemlerinin gerçek tasarım problemi kompozisyondur
Üretim sistemi çoğu zaman birden fazla primitive gerektirir. Örneğin cross-silo bir federatif model homomorphic secure aggregation kullanabilir, global modele user-level DP uygulanabilir, aggregation sunucusunun davranışı ZKP ile doğrulanabilir ve iletişim katmanı post-quantum key exchange ile korunabilir. Ancak her yeni katman yeni maliyet ve varsayım oluşturur.
Derlemenin merkezi metodolojik mesajı, bu bileşenlerin güvenlik analizlerinin ayrı ayrı doğru olmasının bütün sistemin otomatik olarak doğru olduğu anlamına gelmediğidir.
Ana bulgu 3: Homomorfik şifreleme artık yalnız teorik değil fakat hâlâ pahalı
HE derin ağ ve transformer çıkarımına ulaşmıştır. Bootstrapping, packing, scheme switching, compiler'lar ve GPU/ASIC hızlandırması uygulanabilirliği büyük ölçüde artırmıştır. Bununla birlikte kaynak, HE maliyetinin düz metin computation'ın hâlâ birçok büyüklük mertebesi üzerinde olabileceğini ve encrypted training'in özellikle büyük modeller için çok daha zor olduğunu belirtmektedir.
Ana bulgu 4: Diferansiyel gizliliğin asıl problemi yalnız noise eklemek değildir
DP'nin uygulama kalitesi clipping, sampling, accountant, batch büyüklüğü, public pretraining, model mimarisi ve audit dahil bütün eğitim pipeline'ına bağlıdır. Gevşek accountant gereksiz noise'a; hatalı implementation ise kağıt üzerindeki privacy guarantee'nin geçersizleşmesine yol açabilir.
Ana bulgu 5: Federatif öğrenme privacy ile eşanlamlı değildir
Raw data'nın cihazdan çıkmaması önemli bir governance avantajıdır fakat gradient inversion ve membership inference gibi saldırılar update'lerin kendisinden bilgi çıkarılabileceğini göstermektedir. FL'nin formal privacy kazanması için secure aggregation, HE veya DP gibi ek mekanizmalar gerekir.
Ana bulgu 6: Veri depolama katmanı PPML'nin zayıf halkası olabilir
Training protocol çok güçlü biçimde korunurken feature store, database veya query layer access pattern sızdırıyorsa sistemdeki hassas bilgi yalnız başka noktaya taşınmış olur. SSE, ORAM, private information retrieval ve verifiable search bu nedenle PPML zincirinin parçası olarak değerlendirilmelidir.
Ana bulgu 7: Kuantum geçişi bütün PPML yığınını eşit derecede değiştirmeyecek
RSA, Diffie–Hellman ve ECC tabanlı public-key katmanları Shor tehdidi altındadır. Buna karşılık lattice-based HE zaten post-quantum problem ailesine dayanır; DP hesaplama varsayımından bağımsızdır; secret-sharing tabanlı MPC'nin belirli online garantileri bilgi-kuramsaldır; symmetric encryption ise Grover nedeniyle daha büyük parametrelerle güçlendirilebilir.
Bu nedenle migration planı “her şeyi PQC ile değiştir” değil, sistemdeki bütün public-key dependency'lerini, uzun ömürlü ciphertext'leri, authentication yapılarını ve key-distribution mekanizmalarını envanterlemektir.
Ana bulgu 8: Güvenlik kadar operasyon ve organizasyon da belirleyici
Bir üç taraflı honest-majority MPC protokolünün matematiksel olarak çok hızlı olması, gerçekten birbirleriyle gizlice anlaşmayacak üç bağımsız kuruluş yoksa pratik avantaj sağlamaz. Bir HE sisteminin anahtarı kötü yönetiliyorsa matematiksel güvenlik boşa gider. DP'nin \(\varepsilon\) değeri hukuki anonimlik statüsünü kendiliğinden belirlemez. Bu nedenle PPML deployment kararı yalnız algoritmik benchmark ile verilemez.
Çalışmanın desteklediği sonuçlar
- PPML için tek, evrensel olarak üstün teknik bulunmamaktadır.
- HE güçlü input confidentiality sağlayabilir fakat yüksek computational overhead taşır.
- DP output privacy için formal ve composable bir çerçevedir fakat utility kaybı ve privacy accounting gerektirir.
- MPC özellikle iyi ağ koşullarında HE'ye göre farklı ve çoğu durumda daha iletişim-ağırlıklı bir tasarım noktası sağlar.
- FL ham verinin merkezi taşınmasını azaltır fakat tek başına privacy guarantee değildir.
- Secure aggregation, DP ve HE federatif sistemlerde birbirini tamamlayabilir.
- Privacy ile Byzantine robustness arasında gerçek bir görünürlük çatışması vardır.
- SSE'nin izin verdiği leakage pratik saldırılarda kullanılabilir; yalnız ciphertext güvenliğine bakmak yeterli değildir.
- Post-quantum migration özellikle classical public-key authentication ve key-establishment katmanlarında önemlidir.
- ML-KEM, ML-DSA ve SLH-DSA 2024 NIST standartları olarak PPML yığınının uzun dönem kriptografik planlamasında önemlidir.
- Production deployment'ın engelleri yalnız protocol latency değildir; key management, tooling, regülasyon, veri harmonizasyonu ve organizasyonel trust da kritiktir.
- PPML literatüründeki farklı performans rakamları ortak benchmark olmadan doğrudan sıralanmamalıdır.
Çalışmanın desteklemediği genellemeler
Çalışma “homomorfik şifreleme bütün makine öğrenmesi iş yüklerinde artık pratik hale gelmiştir”, “federatif öğrenme tek başına veriyi gizli tutar”, “diferansiyel gizlilik uygulanmış her veri hukuken anonimdir”, “ε için evrensel güvenli bir sayı vardır”, “post-quantum algoritmalar sonsuza kadar kırılamaz”, “bugünkü kuantum bilgisayarlar RSA'yı rutin biçimde kırabilmektedir”, “bütün klasik kriptografi kuantum sonrası işe yaramaz hale gelir”, “HE her durumda MPC'den daha güvenlidir” veya “kaynakta verilen overhead oranları aynı benchmark'ın kesin sıralamasıdır” sonuçlarını desteklememektedir.
Aynı şekilde derleme, ML-KEM, ML-DSA veya SLH-DSA'nın gelecekte bulunabilecek bütün olası kriptanalitik yöntemlere karşı matematiksel olarak kırılmaz olduğunu kanıtlamamaktadır. Post-quantum güvenlik, bugün bilinen saldırı modelleri ve dayanak matematiksel varsayımlar çerçevesinde değerlendirilmelidir.
Çalışmanın başlıca sınırlılıkları
- İncelenen primer sistemlerin hardware, model, dataset, threat model, batch ve security parameter koşulları heterojendir.
- Birleşik HE–MPC–DP benchmark'ı bulunmamaktadır.
- Derleme kapsamlı olmasına rağmen yeniden üretilebilir sistematik tarama protokolünü ayrıntılı vermemektedir.
- HE hızlandırıcılarının büyük bölümü küçük convolutional workload'larda değerlendirilmiştir; transformer davranışı daha az yerleşiktir.
- Secure training, özellikle büyük modellerde secure inference'a göre çok daha az olgundur.
- Black-box DP auditing ile analitik privacy bounds arasındaki boşluk tamamen kapanmış değildir.
- SSE/ORAM/ML pipeline'larındaki toplam leakage'i tek composable bütçede birleştiren olgun bir teori yoktur.
- Post-quantum standartları yayımlanmış olsa da gerçek PPML altyapısına migration ve crypto-agility entegrasyonu tamamlanmış değildir.
- Yasal privacy kavramları ile formal kriptografik/istatistiksel garantiler arasında birebir eşleme bulunmamaktadır.
Derlemenin gelecek araştırma gündemi
Kaynak gelecekteki araştırma gereksinimlerini birkaç ana eksende toplar: HE bootstrapping ve büyük model throughput'unun iyileştirilmesi; model mimarisi ile kriptografinin ortak tasarlanması; DP accounting'in daha sıkı ve denetlenebilir hale getirilmesi; cross-device secure aggregation iletişiminin azaltılması; leakage'in formal ve composable biçimde nicelendirilmesi; ortak benchmark standardı geliştirilmesi; post-quantum migration'ın tamamlanması; privacy mekanizmalarının hukuki ve operasyonel ihtiyaçlarla daha açık ilişkilendirilmesi.
Bunların üzerinde yer alan ortak araştırma problemi ise composition'dır: farklı mekanizmaları yan yana koymak değil, bir mekanizmanın bıraktığı residual leakage'i diğerinin gerçekten kapatıp kapatmadığını, yeni maliyet veya yeni saldırı yüzeyi oluşturup oluşturmadığını bütün sistem düzeyinde analiz etmek.
Kaynak ve Yöntem Notu
Özgün çalışma: Privacy-Preserving Cryptography for Machine Learning: A Comprehensive Review of Homomorphic Encryption, Differential Privacy, Secure Computation, and Post-Quantum Foundations
Yazarlar: Quang-Vinh Dang; Dat Le; Minh Ngoc Dinh; Ngoc-Son-An Nguyen.
Yazar sırası: Kaynakta verilen sıra aynen korunmuştur.
Eşit katkı: Kaynakta eşit katkı/eş birinci yazarlık beyanı tespit edilmemiştir.
Sorumlu yazar: Dat Le.
Afiliasyon 1: School of Computing and Innovative Technologies, British University Vietnam, Hung Yen, Hanoi, Vietnam.
Afiliasyon 2: Department of Science, Technology, and International Projects, Ho Chi Minh City University of Economics and Finance, Ho Chi Minh City, Vietnam.
Afiliasyon 3: School of Data Science and Information Technology, Millennia Education, Ho Chi Minh City, Vietnam.
Afiliasyon 4: Faculty of Information Technology, Industrial University of Ho Chi Minh City, Ho Chi Minh City, Vietnam.
Dergi: Computers, Materials & Continua (CMC).
Yayıncı: Tech Science Press.
Cilt / sayı: Volume 89, Number 3, 2026.
DOI: 10.32604/cmc.2026.087848.
Alınma tarihi: 24 Haziran 2026.
Kabul tarihi: 25 Ağustos 2026.
Yayın tarihi: 22 Ekim 2026.
Kaynak türü: Review / kapsamlı teknik derleme.
Hakemlik durumu: Hakemli açık erişimli dergide yayımlanmış nihai makale.
Özel sayı: Privacy-Preserving AI: Encryption and Differential Privacy.
Lisans: Creative Commons Attribution 4.0 International (CC BY 4.0).
Resmî yayın bağlantısı: https://www.techscience.com/cmc/v89n3/69357
DOI bağlantısı: https://doi.org/10.32604/cmc.2026.087848
Preprint durumu: İncelenen kaynak ve resmî kayıt yayımlanmış dergi sürümüdür; bu çalışma için ayrı bir preprint sürümü verilen kaynak materyalde belirtilmemiştir.
Finansman: Yazarlar çalışma için özel bir finansman almadıklarını bildirmiştir.
Veri ve materyal erişilebilirliği: Review makalesi olduğu için yeni veri üretilmediği veya analiz edilmediği belirtilmiştir.
Etik onay: Uygulanabilir değil.
Çıkar çatışması: Yazarlar çıkar çatışması olmadığını beyan etmiştir.
Yazar katkıları: Çalışmanın kavramsallaştırılması ve tasarımı Quang-Vinh Dang ile Dat Le; literatür taraması ve screening Quang-Vinh Dang, Minh Ngoc Dinh ve Ngoc-Son-An Nguyen; incelenen sonuçların analizi ve yorumlanması Quang-Vinh Dang, Dat Le ve Minh Ngoc Dinh; taksonomi, compositional analysis ve selection guide tasarımı Quang-Vinh Dang ile Dat Le; şekil ve tablolar Minh Ngoc Dinh ile Ngoc-Son-An Nguyen; ilk taslak Quang-Vinh Dang ile Dat Le; kritik bilimsel revizyon Dat Le, Minh Ngoc Dinh ve Ngoc-Son-An Nguyen tarafından gerçekleştirilmiştir. Tüm yazarların son sürümü gözden geçirip onayladığı bildirilmiştir.
Derleme yöntemi için önemli sınır: Yazar katkıları literatür taraması ve screening yapıldığını gösterse de makale gövdesinde yeniden üretilebilir veri tabanı arama dizgileri, PRISMA akış şeması, formal dahil etme/dışlama kriterleri veya nicel meta-analiz protokolü verilmemiştir. Bu nedenle Verianla anlatımı çalışmayı kapsamlı teknik review olarak tanımlamaktadır; sistematik review veya meta-analiz olarak yeniden sınıflandırmamaktadır.
Nicel sonuçların yorum sınırı: Makaledeki HE latency, transformer inference, DP utility, secure aggregation, cryptographic overhead ve post-quantum key/signature boyutları farklı primer kaynaklardan derlenmiştir. Kaynağın kendisi hardware, model, dataset, batch size, threat model ve security parameter farklılıkları nedeniyle bunların kontrollü tek benchmark gibi karşılaştırılamayacağını belirtmektedir.
Kuantum yorumu için sınır: Çalışma yeni bir kuantum bilgisayar deneyi veya quantum machine learning modeli değildir. Kuantum bölümü, Shor ve Grover algoritmalarının kriptografik etkilerini ve PPML altyapısının post-quantum migration gereksinimlerini literatür temelinde değerlendirmektedir. “Post-quantum” terimi gelecekteki bütün olası saldırılara karşı mutlak matematiksel dokunulmazlık olarak yorumlanmamalıdır.
Bir yorum bırakın
E-posta adresiniz yayınlanmayacaktır. Gerekli alanlar * ile işaretlenmiştir