

Miundo ya ujifunzaji wa mashine inaweza kuonyesha mafanikio makubwa katika majaribio ya benchmark. Hata hivyo, kuendesha modeli katika hospitali, kampuni ya bima au mifumo ya taasisi inayokabiliwa na shinikizo la udhibiti ni tatizo tofauti kabisa. Hii ni kwa sababu katika ulimwengu halisi data haijapangika, watumiaji huwa waangalifu, na maamuzi yana matokeo ya kisheria na kiutendaji.
Utafiti huu unachunguza tofauti hiyo kupitia uzoefu miwili ya uzalishaji. Mfumo wa kwanza ni mfumo wa urejeshaji nyaraka unaotegemea NLP na unaozingatia mahitaji ya compliance, uliotengenezwa kwa mteja mkubwa wa taasisi. Uzoefu wa pili ni miundo ya utabiri iliyosambazwa kwa wateja 15 wa taasisi katika maeneo ya afya na bima. Mifumo hii haikushindwa kiufundi; lakini ilikumbana na vizuizi visivyotarajiwa kuhusu kuelezeka kwa maamuzi, tofauti za data kati ya taasisi na imani ya watumiaji.
Ujumbe mkuu wa utafiti uko wazi: Katika mazingira ya uzalishaji, akili bandia hailazimiki tu kutoa utabiri sahihi. Pia inapaswa kueleza uamuzi wake, kuendana na njia tofauti ambazo taasisi huzalisha data, na kutoa mazingira ya maamuzi ambamo watumiaji wanaweza kuelewa ni katika hali gani wanaweza kuiamini modeli.
Tatizo ni Nini?
Katika fasihi ya akili bandia, tatizo la kupeleka modeli uzalishaji mara nyingi huelezwa kwa mada za kiufundi kama mabadiliko ya usambazaji wa data, ukosefu wa miundombinu, seti ndogo ya mafunzo au kushuka kwa utendaji wa modeli. Haya ni muhimu; lakini utafiti huu unaangazia tatizo tofauti zaidi: Hata modeli inapofanya kazi kwa usahihi, watu wanaweza kutokuwa na sababu ya kutosha ya kuitumia.
Katika mifumo ya afya na bima, pato la modeli si alama ya kiufundi tu. Utabiri wa muda wa kusubiri mgonjwa unaweza kuathiri upangaji wa rasilimali. Utabiri wa madai ya bima unaweza kutumiwa katika ukokotoaji wa akiba. Mfumo wa urejeshaji nyaraka unaweza kutoa matokeo ambayo yanahitaji kutetewa mbele ya mdhibiti katika ukaguzi wa compliance. Kwa hiyo, swali “modeli ina usahihi wa asilimia ngapi?” pekee halitoshi.
Tatizo huwa kali zaidi katika muktadha wa ukaguzi wa compliance. Mfumo wa urejeshaji nyaraka unapopata hati fulani kuwa husika kwa alama ya kujiamini 0,87, alama hiyo si maelezo ya kutosha kwa afisa wa compliance. Afisa huyo anahitaji kujua: Hati hii ililetwa kwa sababu ya kifungu gani, dhana gani au msingi gani wa udhibiti? Swali lilelile likibadilishwa kidogo, je, matokeo hayo yataweza kuelezwa kwa mantiki ileile?
Kwa hiyo, tatizo lililo katikati ya utafiti si “modeli imeshindwa?” Swali gumu zaidi ni hili: Hata modeli inapotoa matokeo sahihi, tunaweza kuyafanya yawe yanayoweza kukaguliwa, kuendana na muktadha wa taasisi na kuingizwa kwa kuaminika katika michakato ya maamuzi ya binadamu?
Mbinu Inapendekeza Nini?
Badala ya kupendekeza algoriti mpya, utafiti unaandika kwa utaratibu maeneo matatu ya msingi ya matatizo yaliyotokana na uzoefu wa uzalishaji. Tatizo la kwanza ni pengo la kuelezeka. Modeli inaweza kutoa matokeo, lakini isiweze kutoa maelezo yanayoweza kutetewa katika muktadha wa compliance, ukaguzi au udhibiti.
Tatizo la pili ni hali inayoweza kuitwa institutional domain shift. Domain shift ni tofauti kati ya usambazaji wa data ambao modeli ilifunzwa nao na usambazaji wa data unaokutana nao katika uzalishaji. Hata hivyo, tofauti inayosisitizwa na utafiti si ya kitakwimu pekee. Taasisi za afya na bima huzalisha, husimba, huchakata na kutafsiri data kwa njia tofauti. Kwa mfano, mara ambazo misimbo ya uchunguzi ya ICD-10 hutumiwa zinaweza kuakisi si tu idadi ya wagonjwa bali pia utamaduni wa taasisi wa uwekaji kumbukumbu.
Tatizo la tatu ni urekebishaji wa imani, yaani trust calibration. Modeli inaweza kutoa utabiri sahihi; lakini ikiwa watendaji, madaktari, actuary au timu za uendeshaji hawajui ni katika hali gani wanapaswa kuamini utabiri huo, modeli haitatumika. Imani haitokei moja kwa moja kutokana na usahihi. Mtumiaji anapaswa kuelewa mipaka ambayo modeli hufanya kazi ndani yake na jinsi inavyopaswa kutumiwa pamoja na uamuzi wa kitaalamu wa binadamu.
Sehemu ya majaribio ya utafiti inalinganisha mbinu tatu za maelezo ya post-hoc kwenye modeli ya NLP inayotegemea BGE-M3 ili kupima tatizo la kuelezeka: Attention, LIME na SHAP. Maelezo ya post-hoc ni mbinu zinazojaribu kueleza uamuzi wa modeli baada ya modeli kufunzwa. Jaribio linafanywa kwa kutumia mifano 50 kutoka aina za government na slate za seti ya data ya MultiNLI.
Maelezo yanatathminiwa kwa vigezo viwili: stability na faithfulness. Stability hupima kiwango ambacho maelezo hubaki thabiti wakati kuna mabadiliko madogo katika ingizo. Faithfulness hupima kama token zinazotajwa kuwa muhimu katika maelezo ndizo kweli zinazobeba uamuzi wa modeli. Utafiti unaunganisha vigezo hivi viwili ili kuhesabu kiwango cha maelezo ya audit-ready, yaani yaliyo tayari kwa ukaguzi.
Formuli Zinaeleza Nini?
Katika utafiti, dhana mbili kuu hutumiwa kupima ubora wa maelezo: stability na faithfulness. Zinaweza kuelezwa kwa msomaji kwa urahisi kama ifuatavyo.
Stability hupima kama alama za maelezo zinabaki zinazofanana katika ingizo lilelile au lililobadilishwa kidogo sana. Katika utafiti, kufanana huku kunatathminiwa kwa korelesheni ya Spearman kati ya viwango vya umuhimu wa token.
Hapa \(E_i\) na \(E_j\) zinawakilisha alama za umuhimu wa token zinazotolewa kwa matoleo tofauti ya mfano mmoja yaliyofanyiwa mabadiliko madogo; \(\rho_{\text{Spearman}}\) inawakilisha kufanana kwa upangaji wa viwango. Ikiwa maelezo hubadilika kabisa kutokana na mabadiliko madogo, huwa vigumu kuyakubali kuwa ya kuaminika katika mazingira ya ukaguzi.
Faithfulness hupima kama maelezo yanakamata taarifa ambayo kweli hubeba uamuzi wa modeli. Utafiti unatumia mkabala wa sufficiency: Ni kiasi gani kujiamini kwa modeli katika uamuzi wake wa awali kunahifadhiwa ikiwa token 5 tu zinazoonekana kuwa muhimu zaidi zinaachwa?
Hapa \(P_{\text{original}}(\hat{y})\) ni kiwango cha kujiamini cha utabiri ambacho modeli hutoa kwa maandishi kamili; \(P_{\text{top-5 tokens}}(\hat{y})\) ni kujiamini kwa modeli katika utabiri huo huo wakati token muhimu tu zilizochaguliwa na mbinu ya maelezo zinaachwa. Ikiwa uwiano ni mkubwa, sehemu zilizochaguliwa na mbinu ya maelezo zinaweza kuwa na ushawishi halisi katika uamuzi wa modeli.
Kigezo cha audit-ready katika utafiti kinategemea kutimizwa kwa pamoja kwa vizingiti viwili:
Kwa hiyo, maelezo yanahesabiwa kuwa tayari kwa ukaguzi ikiwa yana uthabiti wa kutosha dhidi ya mabadiliko madogo na pia yanakamata kwa kiwango cha kutosha taarifa inayobeba uamuzi wa modeli.
Somo kuu la uzalishaji la utafiti linaweza pia kufupishwa kama ifuatavyo:
Kauli hizi mbili za mwisho hazipo katika utafiti kama milinganyo halisi; ni maonyesho ya uhariri yaliyotayarishwa kwa msomaji wa Verianla ili kurahisisha wazo kuu la makala.
Ujumbe Mkuu wa Grafu, Jedwali na Mchoro
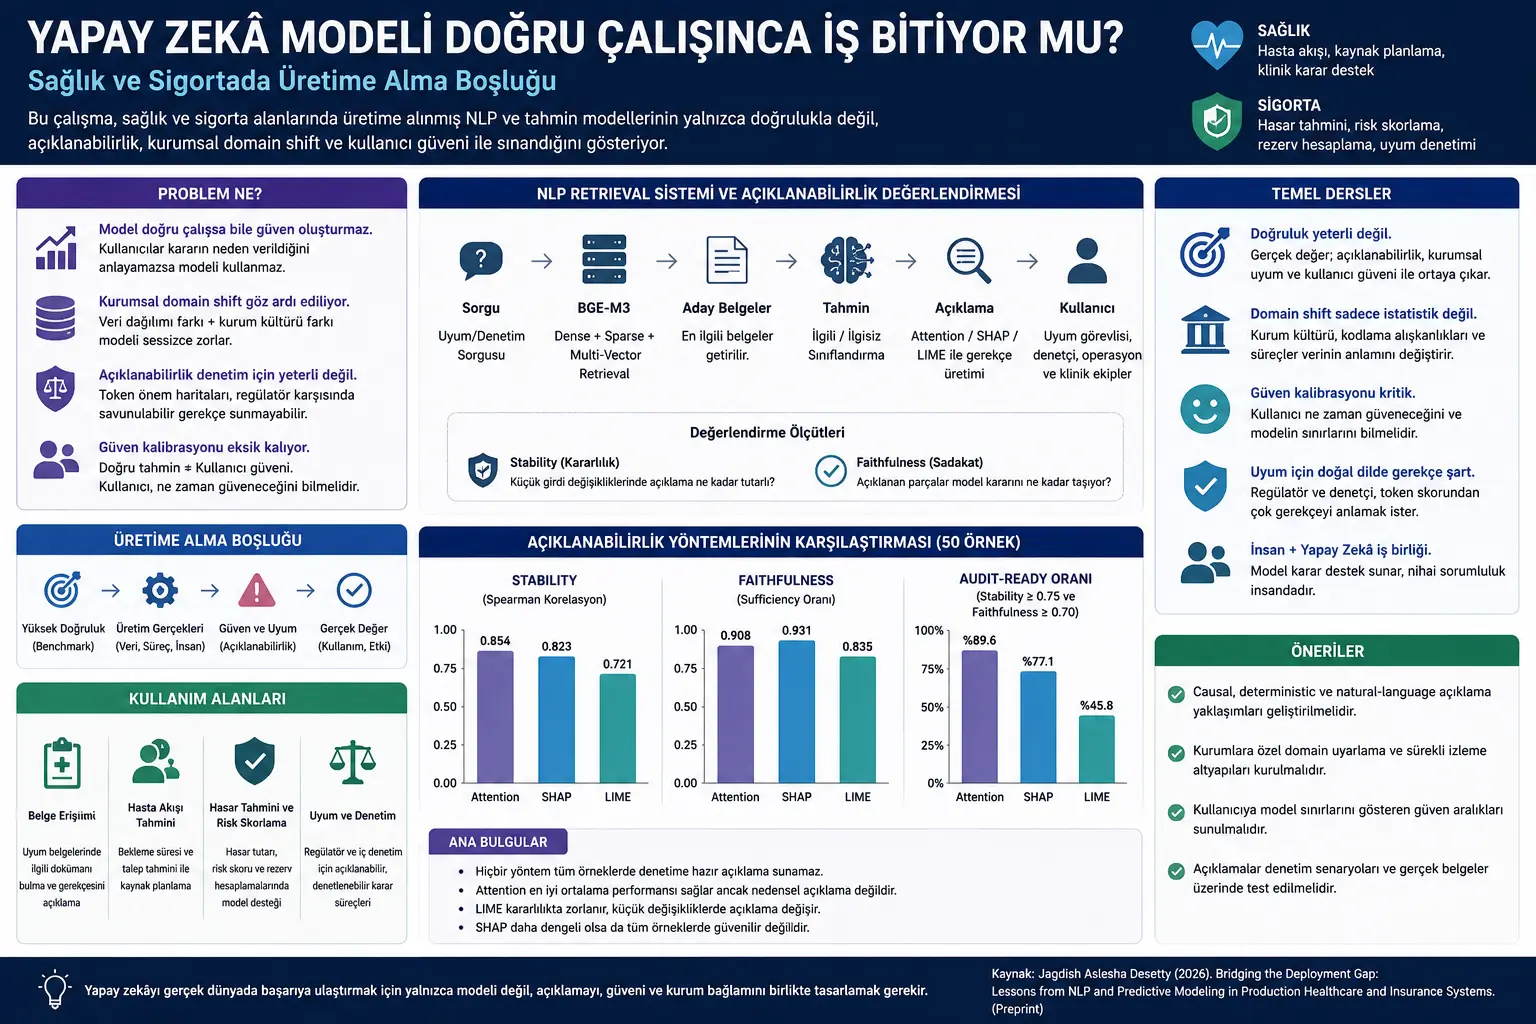
Ujumbe mkuu wa jedwali na mchoro ni kwamba mbinu zilizopo za maelezo hazitimizi kikamilifu mahitaji ya compliance katika uzalishaji. Mbinu ya Attention inafikia kiwango cha juu zaidi cha audit-ready: asilimia 89,6. Hii inaweza kuonekana kuwa yenye nguvu mwanzoni; lakini kwa mtazamo wa ukaguzi wa compliance bado inamaanisha kwamba katika takribani mfano 1 kati ya kila 10, maelezo hayafikii kizingiti kinachotarajiwa.
Mbinu ya LIME hupata ugumu hasa katika stability. Thamani ya wastani ya stability inaripotiwa kuwa 0,721 na iko chini ya kizingiti cha 0,75. Hii inaonyesha kwamba mabadiliko madogo ya usemi yanaweza kubadilisha kwa kiasi kikubwa upangaji wa umuhimu wa token. Katika ukaguzi, uamuzi mmoja kuelezwa kwa njia tofauti katika nyakati tofauti ni tatizo kubwa la uaminifu.
SHAP inaonekana kuwa yenye usawa zaidi. Thamani ya faithfulness ni kubwa na wastani wa stability ni bora kuliko LIME. Hata hivyo, utafiti unasisitiza kwamba wastani hautoshi. Ikiwa katika baadhi ya mifano maelezo yanashuka chini ya kizingiti cha ukaguzi, hali hiyo bado huleta hatari katika uzalishaji.
Katika mchoro, mitazamo mitatu inaonyeshwa pamoja: uthabiti wa maelezo, uwezo wa maelezo kubeba uamuzi wa modeli na uwiano wa mifano inayotimiza vigezo vyote viwili kwa wakati mmoja. Tathmini hii ya pande tatu ni muhimu kwa sababu badala ya kuuliza tu “maelezo yanaonekana mazuri?” inauliza pia “yanabaki sawa, yanabeba kweli uamuzi, na yanaweza kutetewa katika ukaguzi?”
Matokeo ya kuona ya utafiti yanaonyesha tofauti kati ya kuelezeka kwa kiufundi na kuelezeka kulikotayari kwa ukaguzi. Mbinu inaweza kutoa ramani ya umuhimu wa token; lakini ikiwa ramani hiyo haiwezi kubadilishwa kuwa sababu ya asili, thabiti na ya kisababishi ambayo afisa wa compliance anaweza kutumia mbele ya mdhibiti, haiwezi kutimiza hitaji halisi la uzalishaji.
Majaribio Yalifanywaje?
Katika majaribio, modeli ya kisasa ya retrieval embedding iitwayo BGE-M3 hutumiwa. BGE-M3 inachukuliwa kuwa inayofaa kwa mifumo ya taasisi ya urejeshaji nyaraka kwa sababu inaunga mkono dense retrieval, sparse retrieval na multi-vector retrieval na ina uwezo wa kuchakata nyaraka ndefu.
Badala ya nyaraka halisi za compliance, utafiti hutumia aina za government na slate za seti ya data ya MultiNLI iliyo wazi kwa umma kama proxy. Kwa kuwa aina hizi zinaonekana kuwa karibu zaidi na maandishi rasmi au yaliyopangwa, zinatumiwa kuiga jaribio la urejeshaji nyaraka za compliance. Sehemu ya premise inachukuliwa kama hati na sehemu ya hypothesis kama swali la compliance. Uhusiano wa entailment unachukuliwa kama hati husika, wakati contradiction au neutral huchukuliwa kama hati isiyohusika.
Mbinu tatu za maelezo zinajaribiwa kwenye jumla ya mifano 50. Kwa Attention, uzito wa attention katika safu ya mwisho ya transformer hutumiwa. LIME inaendeshwa kwa mifano 75 ya perturbation ili kutoa maelezo ya mstari ya eneo. SHAP hutengeneza umuhimu wa token kwa makadirio ya thamani za Shapley yanayotegemea partition.
Katika jaribio la stability, badala ya kuendesha ingizo lilelile mara kwa mara, perturbation ndogo hufanywa. Baadhi ya maneno huondolewa, mabadiliko ya visawe yaliyodhibitiwa hufanywa au alama za uakifishaji hubadilishwa kidogo. Kwa njia hii hupimwa jinsi maelezo yanavyobaki thabiti dhidi ya mabadiliko madogo ya maandishi.
Katika jaribio la faithfulness, token 5 ambazo mbinu ya maelezo inaona kuwa muhimu zaidi zinaachwa, na hupimwa ni kiasi gani kujiamini kwa modeli katika utabiri wa awali kunahifadhiwa. Ikiwa modeli inaweza kufikia uamuzi uleule kwa kujiamini karibu sawa kwa token hizo pekee, maelezo yanachukuliwa kuwa faithful zaidi.
Matokeo yanaonyesha kwamba Attention inafikia asilimia 89,6 ya audit-ready, SHAP asilimia 77,1 na LIME asilimia 45,8. Hata hivyo, tafsiri ya utafiti iko wazi: Ukweli kwamba hata mbinu bora haiwezi kutoa maelezo ya compliance yanayoaminika katika mifano yote unaonyesha pengo kubwa la utafiti kwa mifumo ya uzalishaji.
Matokeo Yanaonyesha Nini?
Matokeo ya kwanza ni kwamba tatizo la kuelezeka si tatizo la kuona la kiufundi pekee. Katika muktadha wa compliance, maelezo hayawezi kuwa tu alama za umuhimu wa token ambazo timu ya kiufundi inaelewa. Mkaguzi au afisa wa compliance anapaswa kuweza kueleza msingi wa udhibiti wa uamuzi kwa lugha ya kawaida na kwa namna inayoweza kutetewa.
Matokeo ya pili ni kwamba, ingawa Attention inatoa matokeo bora zaidi kwa vigezo vilivyopimwa, haitoshi peke yake. Ramani ya Attention inaweza kuonyesha sehemu ambazo modeli imezielekezea umakini; lakini hiyo haimaanishi kwamba inaeleza kisababishi cha kwa nini modeli ilitoa uamuzi huo.
Matokeo ya tatu ni kwamba LIME ina tatizo kubwa la stability katika muktadha wa compliance. Ikiwa mabadiliko madogo ya maandishi yanaweza kubadilisha maelezo kwa kiasi kikubwa, kuna hatari ya uamuzi uleule kuelezwa kwa sababu tofauti katika maswali tofauti. Hali hii inaweza kutokubalika katika maeneo yenye ukaguzi wa kisheria au compliance.
Matokeo ya nne ni kwamba SHAP ni yenye nguvu zaidi lakini bado si ya kuaminika vya kutosha. Wastani mzuri wa utendaji haumaanishi kwamba kizingiti cha ukaguzi kinatimizwa katika kila mfano. Compliance katika uzalishaji huweka matarajio yaliyo karibu zaidi na kutokuwa na makosa na uthabiti kuliko mafanikio ya wastani.
Matokeo ya tano ni kwamba tatizo la domain shift linaweza kuhusishwa na utamaduni wa taasisi. Katika taasisi za afya na bima, uga uleule wa data unaweza kuwa na maana tofauti. Mazoea ya usimbaji, sera za kutathmini madai, utamaduni wa uwekaji kumbukumbu na michakato ya uendeshaji hubadilisha muundo wa data. Inaweza kuwa vigumu kuondoa tofauti hii kwa statistical reweighting pekee.
Matokeo ya sita ni kwamba usahihi hauzalishi imani kiotomatiki. Ikiwa watumiaji hawaelewi ni lini modeli inaaminika, mipaka yake ni ipi na jinsi inavyopaswa kutumiwa pamoja na uamuzi wao wa kitaalamu, hata utabiri sahihi unaweza kutotumiwa.
Kwa Nini Hili ni Muhimu?
Utafiti huu unaweka wazi jambo linalopuuzwa mara nyingi wakati akili bandia inapohamishwa kwenda ulimwengu halisi: Modeli kufanya kazi haimaanishi mfumo unafanya kazi kwa mafanikio. Hasa katika maeneo yenye athari kubwa kama afya na bima, pato la modeli linapaswa kuwa linaloelezeka, linaloweza kukaguliwa, linaloweza kuendana na muktadha wa taasisi na linaloweza kueleweka na mtumiaji.
Katika afya, pendekezo lisilo sahihi au lisiloelezeka linaweza kuathiri mtiririko wa wagonjwa, matumizi ya rasilimali au uamuzi wa kliniki. Katika bima, alama ya hatari isiyoelezeka inaweza kufanya uhusiano na mteja, usimamizi wa madai au ukaguzi wa compliance kuwa mgumu. Katika mifumo ya compliance, modeli ya retrieval isiyoweza kueleza kwa nini ilileta hati inaweza kuwa haiwezi kutetewa mbele ya mdhibiti hata ikiwa ni sahihi kiufundi.
Utafiti pia unaimarisha upande wa vitendo wa mjadala wa “explainable AI”. Mbinu ya maelezo haipaswi kutoa tu grafu inayopendeza katika makala ya utafiti. Inapaswa kutoa sababu yenye maana kwa mtumiaji halisi, katika wakati halisi wa uamuzi na kwa lugha halisi ya taasisi.
Kwa hiyo, haitoshi kwa utafiti wa baadaye kulenga tu alama kubwa zaidi ya benchmark. Mahitaji matatu yanayoweza kufupishwa kama causal, deterministic na natural-language explanation yanajitokeza: maelezo yanapaswa kuwa na msingi wa kisababishi, yatende kwa uthabiti katika hali zinazofanana kwa ingizo lilelile na yawasilishwe kwa lugha ya kawaida ambayo wadau wasio wa kiufundi wanaweza kutumia.
Mambo ya Kuzingatia
Jambo la kwanza la kuzingatia ni kwamba utafiti ni preprint. Matokeo yanaweza kubadilika baada ya tathmini ya rika. Kwa hiyo, yanapaswa kusomwa si kama kiwango cha kitaaluma kilichokamilika, bali kama wito wenye nguvu wa utafiti unaotokana na uzoefu wa uzalishaji.
Jambo la pili ni ukubwa mdogo wa sampuli ya jaribio. Jaribio la kuelezeka limefanywa kwenye mifano 50 na aina maalumu za seti ya data ya MultiNLI. Data hii imetumiwa kama proxy badala ya nyaraka halisi za compliance. Tathmini pana zaidi kwa nyaraka halisi za compliance katika afya au bima inahitajika.
Jambo la tatu ni kwamba jaribio linalenga ubora wa maelezo badala ya downstream task accuracy. Kichwa cha uainishaji kilichotumiwa hakikufanyiwa fine-tune; lengo si kupima mafanikio ya modeli katika kazi yake kuu bali kujaribu sifa za stability na faithfulness za mbinu za maelezo. Ingawa muundo huu una maana kwa tathmini ya XAI, matokeo hayapaswi kuenezwa moja kwa moja kwa utendaji wote wa uzalishaji.
Jambo la nne ni kutotafsiri vibaya matokeo ya Attention. Kiwango kikubwa cha audit-ready cha Attention hakimaanishi kwamba uzito wa attention ni maelezo halisi ya kisababishi. Utafiti unasisitiza hili: Ramani ya umakini inaweza kuonyesha sehemu ambazo modeli inalenga, lakini haiwezi lazima kueleza kikamilifu sababu ya uamuzi.
Jambo la tano ni ulazima wa usimamizi wa binadamu katika matumizi ya afya na bima. Mifumo ya aina hii inapaswa kufikiriwa kama zana za kusaidia maamuzi; haipaswi kugeuzwa kuwa mamlaka ya kiotomatiki pekee katika maamuzi ya kliniki, kisheria, kifedha au ya bima.
Hitimisho
Utafiti huu unaweka wazi tofauti muhimu katika kupeleka mifumo ya akili bandia uzalishaji: Modeli kufanya kazi kwa usahihi haitoshi. Katika maeneo yenye athari kubwa kama afya na bima, modeli pia inapaswa kuwa inayoelezeka, inayoweza kukaguliwa, inayolingana na muktadha wa taasisi na inayoweza kurekebisha kwa usahihi imani ya mtumiaji.
Matokeo ya majaribio yanaonyesha kwamba mbinu za kawaida za post-hoc explanation kama Attention, SHAP na LIME zina mipaka muhimu. Attention inafikia kiwango cha juu zaidi cha audit-ready lakini haitoi maelezo ya kisababishi. SHAP inaonekana yenye usawa zaidi lakini si ya kuaminika katika kila mfano. LIME ni dhaifu hasa katika stability kwa ukaguzi wa compliance.
Somo pana zaidi kutoka uzoefu wa uzalishaji ni muhimu pia. Institutional domain shift si tu tofauti ya usambazaji wa data; ni tofauti ya kimuundo inayotokana na jinsi taasisi huzalisha, husimba na kutafsiri data. Imani ya mtumiaji pia haitokani tu na usahihi; mtumiaji anapaswa kuelewa mipaka ya modeli na nafasi yake katika mchakato wa uamuzi.
Kwa Verianla, ujumbe mkuu wa utafiti ni huu: Kupeleka akili bandia katika ulimwengu halisi si suala la ku-deploy modeli pekee. Mafanikio halisi ya uzalishaji yanahitaji kuelezeka, muktadha wa taasisi, imani ya mtumiaji na michakato ya maamuzi inayoweza kukaguliwa kubuniwa pamoja.
Dokezo la Chanzo na Mbinu
Maudhui haya yameandaliwa kwa kutegemea preprint ya Jagdish Aslesha Desetty yenye kichwa “Bridging the Deployment Gap: Lessons from NLP and Predictive Modeling in Production Healthcare and Insurance Systems”. Utafiti unajadili urejeshaji nyaraka unaotegemea NLP katika mifumo ya uzalishaji ya afya na bima, miundo ya utabiri, mbinu za kuelezeka, institutional domain shift, imani ya mtumiaji na matatizo ya audit-readiness.
Maudhui haya si tafsiri ya neno kwa neno; wazo kuu la utafiti limerahisishwa na kubadilishwa kuwa makala asilia ya uhariri kwa Kiswahili kulingana na mtindo wa uchapishaji wa Verianla.
Acha maoni
Anwani yako ya barua pepe haitachapishwa. Sehemu za lazima zimewekewa alama ya *